一座城的经济活动,能用新注册企业画出来吗?
论文名片|Lei Dong、Xiaohui Yuan、Meng Li、Carlo Ratti、Yu Liu,A gridded establishment dataset as a proxy for economic activity in China,Scientific Data 8, 5(2021)。原论文 · 数据描述论文。
想象你正在比较两个街区:夜间灯光一样亮,一个是制造业园区,另一个是商务办公区。灯光可以告诉你哪里有人造照明,却很难告诉你经济活动的类型,也很难区分亮度已经饱和的市中心街区。城市统计年鉴又太粗,往往只给全市一个数。
这篇论文换了一种观察对象:把企业注册记录放到地图上,看看每年哪里有新企业、属于什么行业。得到的不是每个街区的 GDP,而是一套可以长时间比较、细到城市内部的企业新设活动代理指标。
先说结论
- GED 覆盖中国大陆 2005—2015 年约 2555 万条企业新设记录,以经纬各 0.01°的网格汇总,并区分三次产业。
- 在 2015 年城市尺度的回归中,企业数量对 GDP、财政收入和就业的拟合均优于夜间灯光;与灯光结合还能提高拟合。但这不等于已经验证每个网格的经济产出。
- 注册地址不必然是经营地址。地图的精细程度也不等于每条地址的定位精度:小城市匹配到门牌或兴趣点的比例明显较低。
- 数据中的年份是注册年份,企业状态则取自 2018 年。它不能直接用于逐年还原企业注销数量或每年存续企业总数。
把企业放进地图,先要决定数的是什么
原始数据来自国家企业信用信息公示系统,企业名称目录来自天眼查。研究收集了 8370 万条注册记录,先去掉 5780 万条个体工商户记录。这类记录不仅经营规模通常较小,注册地址也常只到村镇,难以可靠定位。清洗后保留 25,545,850 条企业记录。
这里的 establishment 被操作化为企业注册记录,不能机械理解成每一个实体门店,也不能理解成每个工作岗位。大公司与小公司都各计一条;员工数和营业额在原始数据里没有记录。
论文表 1 把行业归为第一、第二、第三产业。企业还按 2018 年采集时的状态区分为存续、注销和其他。这个状态标签没有改变企业归属的注册年份。例如,一家 2010 年注册、2017 年注销的企业仍归入 2010 年的新设记录,不能把它当成 2010 年的注销事件。
为了避免重名街道被定位到别的城市,流程先从地址、登记机关等字段推断城市,再调用高德地图做地理编码(geocoding,即把地址转换成坐标)。约 3%的记录无法识别对应城市或区县。坐标从 GCJ-02 转成 WGS84 后,再汇入经纬各 0.01°的网格。
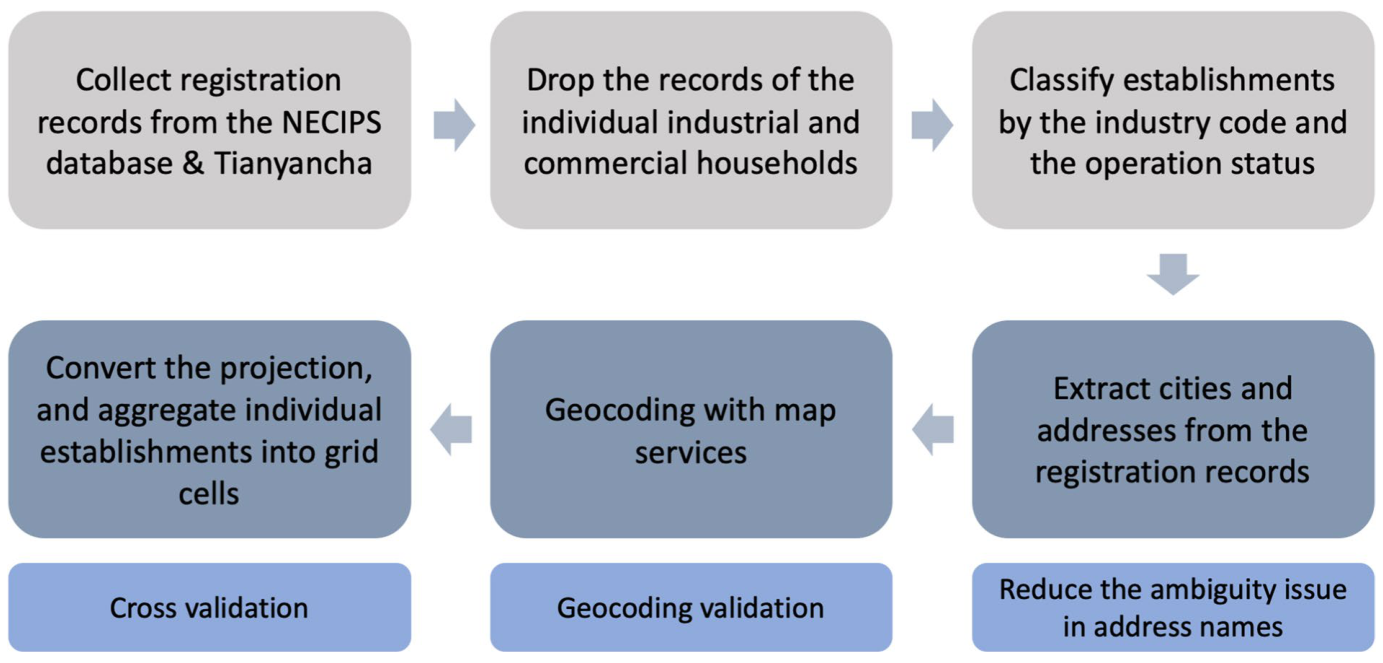
图 1|一份企业名录怎样变成可比较的空间数据?
本图没有字母子图。上排依次为收集注册信息、排除个体工商户、添加行业及经营状态标签;沿箭头进入下排,先提取城市与地址,再做地理编码、坐标转换和网格汇总。底部标出减少地址歧义、验证定位、交叉验证三个质量环节。来源:原论文 Fig. 1。
数量对得上,是否就说明记录完整?
2015 年数据中有约 485 万家新设企业,官方报告折算全年约 445 万家,数据与官方之比为 109.2%。作者提出,官方可能扣除了当年注册又注销的企业,而本数据保留了注册事件。这个超过 100%的比例提醒我们:所谓覆盖率同时受到统计口径影响,不能读成超额发现了真实企业。
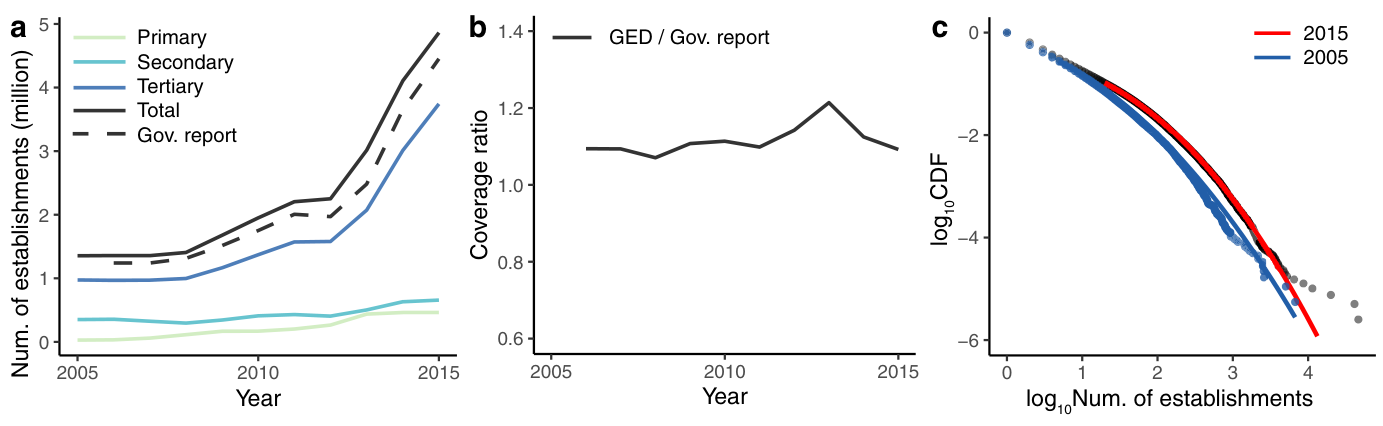
图 2|这套数据在时间和网格尺度上呈现什么分布?
(a)横轴为年份,纵轴为当年新设企业数,单位为百万;彩线区分三次产业,黑线为总量,虚线为官方报告,总量增长主要伴随第三产业增长。
(b)横轴为年份,纵轴为 GED 与官方报告的数量比,曲线围绕 1 以上波动;它比较的是两个统计来源,不能独自证明逐条记录无遗漏。
(c)横轴为网格企业数的常用对数,纵轴为累积分布的常用对数;红、蓝分别对应 2015、2005 年,并给出对数正态拟合。少数企业极密集的网格处于尾部,后续微观分析需要留意。来源:原论文 Fig. 2。
2015 年的空间分布显示,企业新设集中在东部沿海及主要城市群。和一片亮到顶的夜间灯光相比,直接计数仍能区分市内网格。但企业注册集中可能也来自注册优惠政策,而非同等强度的现场生产和就业。
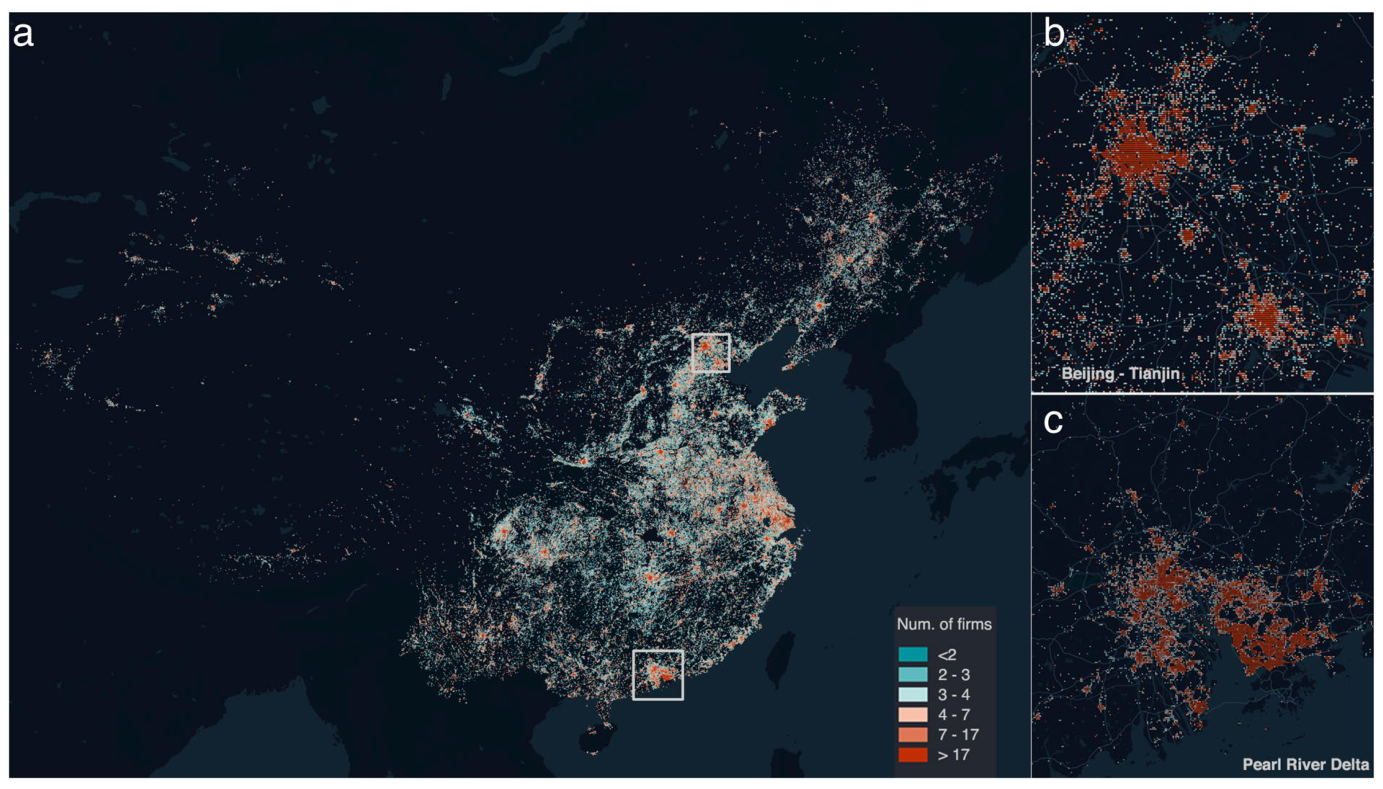
图 3|全国分布之外,能否看到城市内部差异?
(a)中国大陆总体分布;颜色图例对应网格企业数,暖色表示更多。
(b)京津冀局部放大,展示城市群内集聚及网格差异。
(c)珠三角局部放大,揭示不同城市及其内部的密集区。三幅图都是 2015 年新设企业记录的地理汇总,不是 GDP 热力图。来源:原论文 Fig. 3。
网格画得细,地址真的定得准吗?
研究选取北京、长沙和鞍山,分别抽样 10,000 条地址检查定位。高德返回的匹配层级中,达到门牌或兴趣点(POI)的比例,北京约 88%、长沙约 77%、鞍山约 48%;若把村、镇层级也算进去,比例升为约 96%、95%、84%(表 4)。后一个标准更宽松,不能把两个比例都称为同样的定位准确率。
另一项检查用百度地图重新编码同一批地址。按照其置信指标所对应的规则,误差小于 1000 米的比例分别为 93.1%、92.2%、74.1%。这仍是地图服务返回指标的检验,并非逐家实地核查;北京优于鞍山的差异也说明,误差不能在全国一概而论。
能代表经济活动,证据在哪个尺度上成立?
研究把 2015 年新设企业数汇总到城市,与同年的 GDP、财政收入和就业人数比较,并排除年鉴数据缺失的城市。模型 1 用企业总数解释各指标;模型 2 把三次产业的数量分别放入回归,两者均采用对数。作为基线,夜间灯光也在城市边界内汇总。
拟合优度采用调整后的 R²:数值越高,表示这组城市数据中回归能够解释的差异越多。企业总数模型对 GDP、财政收入、就业的调整后 R² 分别为 0.782、0.817、0.761;灯光单独模型分别为 0.749、0.710、0.708。进一步区分产业,前者提高到 0.812、0.860、0.787。把产业分项与灯光结合,三项分别达到 0.847、0.868、0.813。
这支持两类数据提供互补信息,不能解释成企业注册增加必然引起财政收入增加,也不是对未见城市进行预测的准确率。
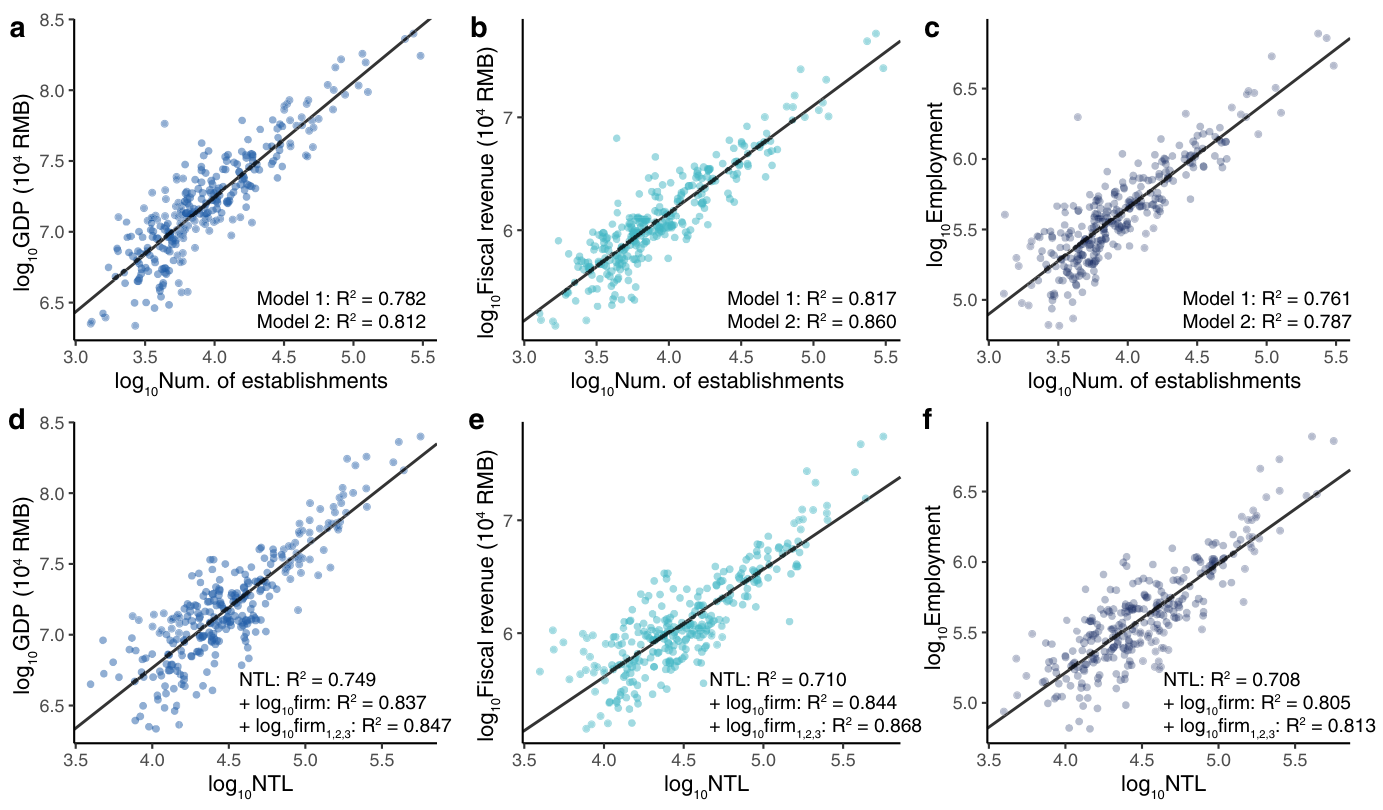
图 4|企业注册和灯光,分别解释了哪些城市差异?
(a、b、c)横轴为新设企业数的常用对数,纵轴依次为 GDP、财政收入、就业的常用对数;散点是城市,图中同时报告企业总数与三次产业分项模型的调整后 R²。
(d、e、f)横轴改为夜间灯光的常用对数,纵轴依次对应同三项指标;图内列出灯光单独、加入企业总数、加入三次产业企业数的拟合结果。不能只凭散点线条,把三种多变量模型误读成同一个一元回归。来源:原论文 Fig. 4。
市级相关还留下一个问题:网格尺度也有合理结构吗?研究将北京企业网格与手机数据估计的人口网格匹配,只分析人口密度不低于每平方公里 1000 人的区域。人口与企业数呈超线性关系,幂律指数约为 1.16:在这组空间比较中,人口较多的网格,企业数平均增加得更快。
这是一项与城市标度理论相容的有效性检查,并非证明每个网格的真实产值,也不是北京人口增长 1%必定带来企业增长 1.16%的时间因果关系。
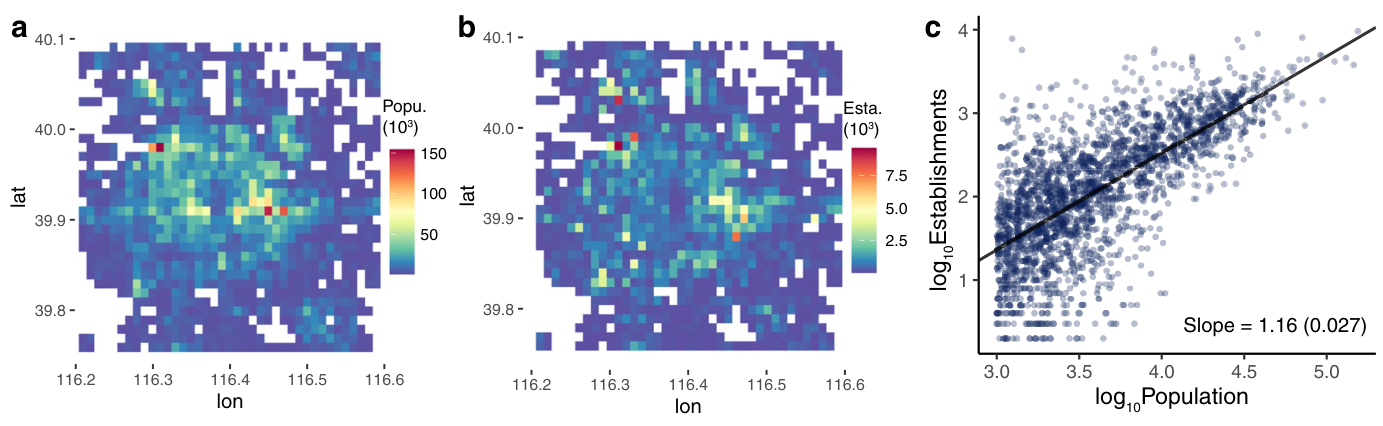
图 5|人口较密集的城市网格,是否也汇集更多企业?
(a)北京人口空间分布,颜色图例单位为千人。
(b)企业空间分布,颜色图例单位为千家;横纵轴仍为经纬度,不能把两幅图的颜色数值直接等同。
(c)横轴为人口、纵轴为企业数,均取常用对数;拟合斜率为 1.16,括号中报告 0.027。点之间的空间关联支持超线性模式,不能识别其成因。来源:原论文 Fig. 5。
真正使用时,还要守住哪些口径?
主文件一行是一个网格在某注册年份的汇总,含网格中心坐标、企业总数、行业分项及状态分项(表 2)。没有注册记录的网格—年份组合不写入文件。用作完整空间面板前,应先建立所需网格与年份集合,区分缺行与其他来源的数据缺失。论文还提供 2005、2010、2015 年未聚合数据,便于改变分析尺度。
省级汇总表 3 描述的是全期企业数量及网格分布,不能把其网格均值当作全省任一地方的典型经营密度。行政区名称对应 2019 年边界,和其他年份统计资料连接时需处理区划变化。经纬网格也不等面积:赤道附近约为 1.1 × 1.1 公里,北京约为 0.85 × 1.1 公里;跨纬度比较密度时必须用实际面积。
最难靠技术消除的误差来自注册地址与经营地址分离。税收优惠区可能吸纳大量注册企业,部分网格超过一万家。作者建议微观分析可考虑上限截断或对数变换,但这些处理只能减弱极端值影响,无法自动找回企业真正经营的位置。历史地名变更、没有企业规模信息,以及被排除的个体工商户,也共同限定了 GED 能回答的问题。
一句话总结
企业注册能把经济新设活动画得更细、追得更久,但这张图测的是企业登记的空间分布,不能直接替代每个街区的产出、就业或真实经营现场。
核心来源
- Dong, L., Yuan, X., Li, M., Ratti, C. & Liu, Y.(2021)原论文及完整图表,Scientific Data 8, 5。本文图 1—5 均源自该论文。
- GED 数据集。
- 论文所列预处理与验证代码。
作者介绍
- Lei Dong:论文署名单位为北京大学遥感与地理信息系统研究所、MIT Senseable City Laboratory 和 QuantUrban;承担研究实施、数据分析和论文写作。
- Xiaohui Yuan:署名 QuantUrban,参与研究设计。论文披露其与 Lei Dong 为该公司共同创始人。
- Meng Li:署名 QuantUrban,参与数据分析。
- Carlo Ratti:署名 MIT Senseable City Laboratory,参与研究设计。
- Yu Liu:署名北京大学遥感与地理信息系统研究所,参与研究设计并为通讯作者之一。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一个园区的企业注册迅速增长,手机估计的工作人口却没有同步增长,这不应立即被归为其中一份数据错误。它也可能揭示注册地与经营地正在分离。可以把企业注册、工作日白天人口、夜间灯光三种信号对齐:只在注册上突增的网格,先检查注册地址政策;三种信号共同变化的网格,再研究实际开发和就业变化。
这里需要额外区分时间顺序。企业注册往往早于正式经营,人口和用电变化可能滞后。若用注册当年的同步相关筛选异常,就可能把正在建设的真实新园区误判成空壳集聚。一个更可检验的问题是:注册增加之后的几年内,哪些地方出现了持续的工作人口增长,哪些地方始终只有名录变长?