出租车走过的路,能教导航怎样更快到达吗?
论文名片|Jing Yuan、Yu Zheng、Chengyang Zhang、Wenlei Xie、Xing Xie、Guangzhong Sun、Yan Huang,T-Drive: Driving Directions Based on Taxi Trajectories,ACM SIGSPATIAL GIS 2010,99–108 页。论文原文。这是一项利用北京出租车历史 GPS 轨迹进行路径规划的方法与系统研究。
想象两条通向同一目的地的路线:一条路程短,却要穿过很多路口;另一条稍远,但行驶更顺畅。如果导航只看长度和限速,就可能低估等灯、转弯和拥堵造成的时间。熟悉城市的出租车司机往往知道这些差别,可怎样把分散在许多司机身上的经验变成可计算的导航建议?
T-Drive 的回答是:不必逐条道路还原完整经验,可以先找到出租车经常经过的关键路段,学习这些路段之间在不同时间的通行耗时,再把一条粗略路线细化为可驾驶的道路序列。
先说结论
- 研究用 33,000 多辆出租车连续三个月的数据构建模型,预处理后得到约 496 万条行程轨迹;这里的数量是轨迹,不是乘客数。
- 在 1,200 条合成查询上,取 9,000 个地标、参数 α=0.7 时,相对按限速规划的基线,67.2% 的推荐路线更快,21.4% 相同。该比较主要属于模型实验。
- 两组实地比较中,T-Drive 的平均行驶时间分别为 25.80 分钟和 23.18 分钟,对照为 29.28 分钟和 27.00 分钟,平均节省比例分别为 11.9% 和 14.1%。
- 历史经验的优势依赖轨迹覆盖与相对稳定的交通模式,不能保证应对突发事故,也不能把 2010 年的对照结果套到今天的导航服务上。
为什么有几千万个定位点,仍然看不清一条路?
研究中的北京路网包含 106,579 个道路节点、141,380 条路段。出租车数据共有约 7.9 亿个 GPS 点、累计超过 4 亿公里,但平均每 3.1 分钟才记录一个点,相邻点平均相隔约 600 米。点很多,并不意味着每辆车的每次转弯都被记录下来。
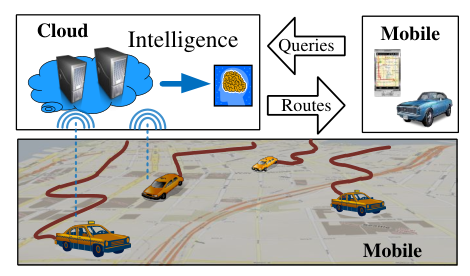
图 1|出租车经验怎样服务另一位驾驶者?
图中没有字母子图。下方车辆提供历史轨迹,云端汇总经验,右侧移动端提交查询并接收推荐路线。这是服务架构示意,并非性能比较。来源:原论文 Fig. 1。
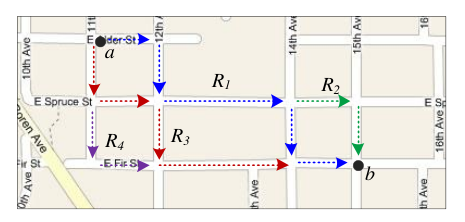
图 2|知道两个定位点,能唯一确定中间怎样走吗?
图中没有字母子图。a、b 是两个采样位置,R1–R4 表示都可能经过它们的候选路线。它说明低频采样不能唯一还原中间路径,不能把其中任一条线直接当作真实路线。来源:原论文 Fig. 2。
因此,T-Drive 没有要求每条路都具备足够的即时速度记录。它先按照计价器的上下客记录把日志切成单次行程,再用地图匹配(map matching)将 GPS 点对应到路段;随后在轨迹较密集的关键路段之间学习耗时。
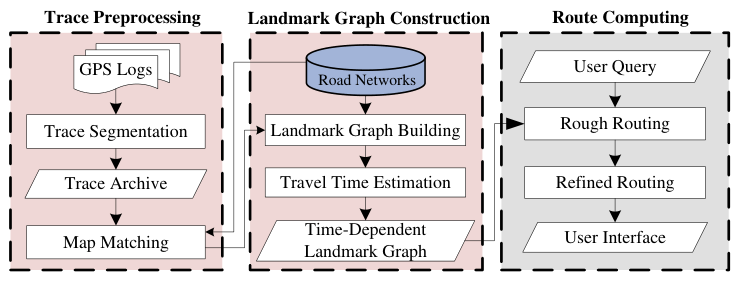
图 3|哪些工作可以提前完成?
图中没有字母子图。左列进行轨迹切分和地图匹配,中列构建地标图并估计时间,右列在查询到来后进行粗路线与细路线计算。前两列离线完成,轨迹库更新时再更新模型。来源:原论文 Fig. 3。
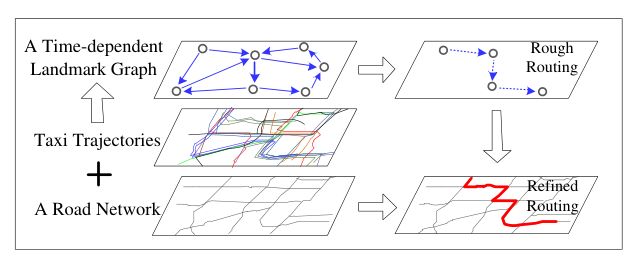
图 4|为什么先规划大方向,再连接具体道路?
图中没有字母子图。底层是实际路网,中层是出租车轨迹,上层是较小的时变地标图;右侧分别表示粗规划和细化。地标图减少搜索范围,最终输出仍须回到真实路网。来源:原论文 Fig. 4。
这里的地标,为什么是一段路?
地标(landmark)在本文中指被出租车频繁经过的路段,不是景点或建筑。系统选择经过频次最高的 k 条路段作为节点。如果历史行程中相邻两个被记录的地标之间有足够多次转移,就建立有向连接,并保存相应的进入和离开时间。
频率门槛用于剔除证据太少的连接;最长转移时间门槛减少低频采样漏掉中间地标带来的长连接。评估中,边的最低频率设为平均每天至少 10 次,最长转移时间为 30 分钟。工作日和周末各建一张图,避免用同一套模式强行描述两种日程。
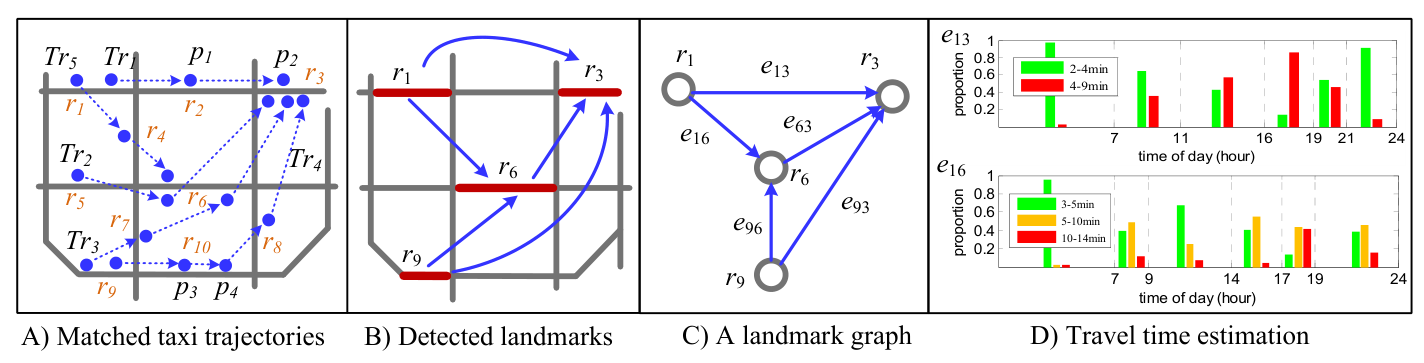
图 5|从原始轨迹到时变连接,保留了什么?
(A)地图匹配后的出租车轨迹;多个点可能落在同一路段,不能因此重复计算经过次数。
(B)选出频繁经过的路段作为地标,示例取四个。
(C)将相邻地标间的历史转移转换成有向边。
(D)两条地标边的耗时分布随一天中的时段变化;横轴是时间,纵轴是不同耗时组所占比例,颜色区分耗时区间。不同边的分段边界和分布都可以不同。来源:原论文 Fig. 5。
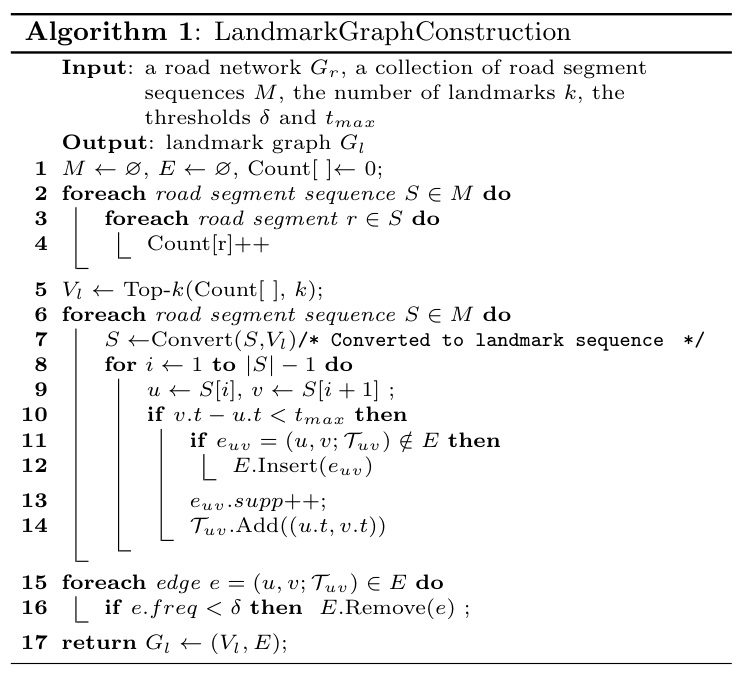
图 6|哪些历史连接会被保留?
图中没有字母子图。算法先统计路段频次、选取前 k 个地标,再把轨迹变成地标序列,记录满足时间限制的转移,最后剔除频率过低的边。它具体化图 5 的构建规则,没有提供独立效果验证。来源:原论文 Fig. 6。
为什么不能给每一对地标只写一个通行时间?
同一对地标,在同一时段也可能存在不同耗时:司机选的中间道路不同,遇到的红绿灯、拥堵与驾驶习惯也不同。把所有记录压成一个平均值,会隐藏这些差异;给所有边机械地规定同一组早晚高峰时间,也可能错过局部变化。
方差–熵聚类(Variance-Entropy-Based Clustering,VE-Clustering)分两步处理。先按通行耗时聚类,使每组内部的耗时差异尽量小;再沿一天中的进入时间分段,使每段内的耗时类别分布相对稳定。方差衡量组内离散程度,熵衡量类别混杂程度,二者分别服务于耗时分组和时段划分。
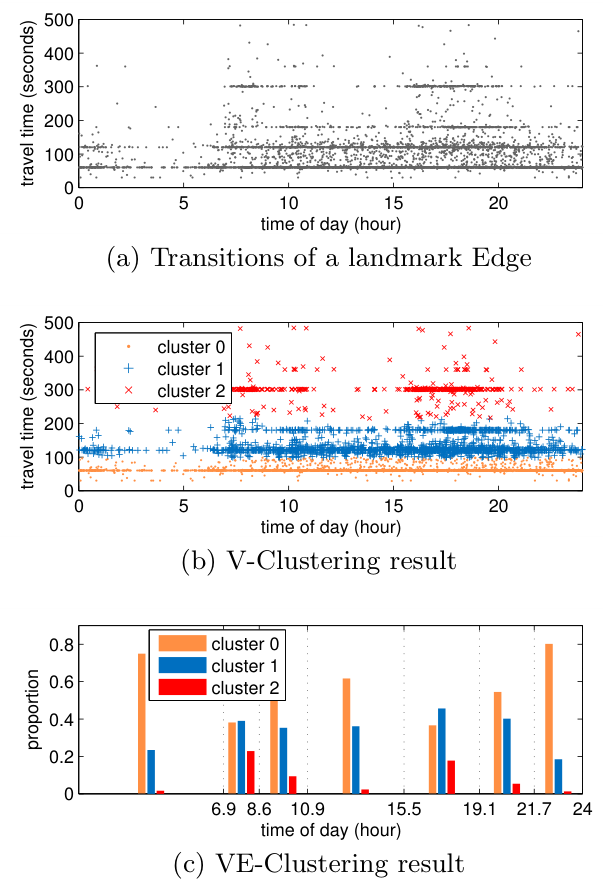
图 7|怎样让时段边界从数据中长出来?
(a)真实地标边的转移记录;横轴为进入时刻,纵轴为通行秒数,同一时刻附近并非只有一个耗时。
(b)按耗时进行 V-Clustering 后,不同颜色和符号标出三个耗时类别。
(c)再由 E-Clustering 划分进入时段;横轴为一天中的时刻,纵轴为每个耗时类别的比例。各时间段的分布变化解释了为什么不能只保留全天平均。来源:原论文 Fig. 7。
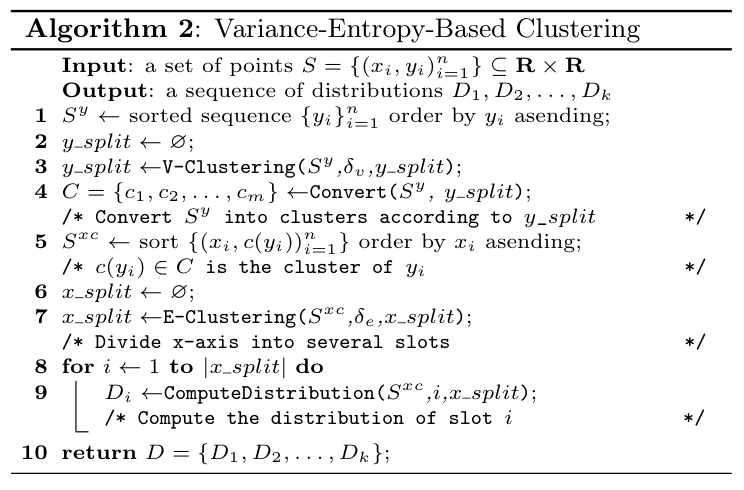
图 8|两次聚类怎样接起来?
图中没有字母子图。先排序和划分耗时类别,再按进入时间排序这些类别,用信息增益选择时间切分点,最终输出各时段的分布。它展示操作顺序,不能单独证明所得分段最适用于所有城市。来源:原论文 Fig. 8。
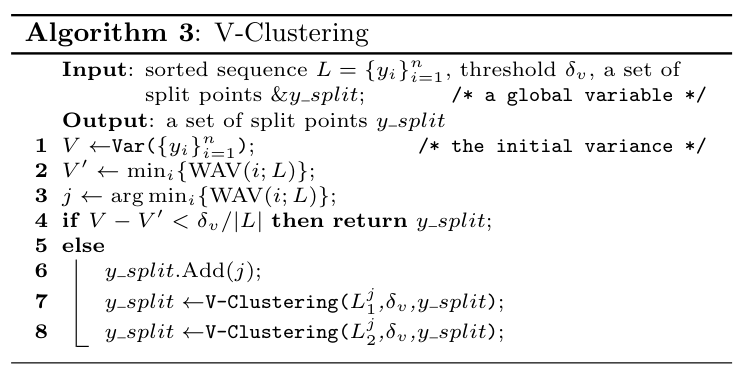
图 9|什么时候停止把耗时继续细分?
图中没有字母子图。算法寻找使加权组内方差最小的切点,改善不足时停止,否则继续递归划分。停止门槛控制细分程度,避免每条记录各成一类。来源:原论文 Fig. 9。
学到的是一组耗时,导航怎样选出一条路线?
系统用参数 α(原文称 optimism index)从耗时分布中选择一个代表值,使估计能适配不同驾驶者。在原文中,α 的文字定义与图 10 的累积频率例子对数值方向的表述存在不一致,因此这里不把 α 直接翻译成一条“越大就开得越快”的规则;理解后续结果只需知道,它是从同一分布选择耗时的模型参数。
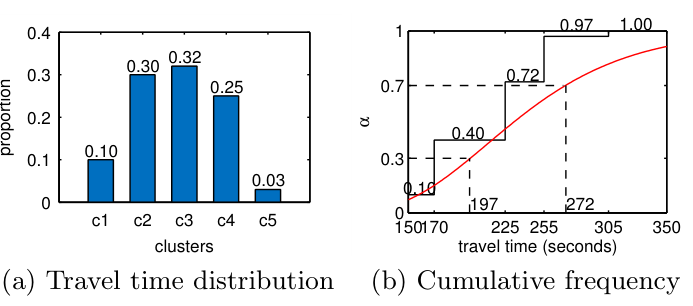
图 10|同一时段为什么能对应不同的预计耗时?
(a)横轴为耗时类别,纵轴为类别比例,五个柱形构成示例分布。
(b)横轴为通行秒数,纵轴为累积频率;曲线把不同分位位置映射为不同耗时。图示 α=0.3 对应 197 秒、α=0.7 对应 272 秒,应与原文“高 α 更快”的文字说明区分。来源:原论文 Fig. 10。
粗规划时,起终点各找三个附近地标,形成九组候选地标对,再在时变图中计算最快的地标序列。时间依赖的含义是:到达某条边的时刻变了,该边的代价也会变化。算法还需处理先进先出(FIFO)条件,即在同一边上晚出发不能反而更早到达的模型要求。
细规划再用动态规划决定如何连接各个地标路段,并处理路段方向。缺少地标边覆盖的部分,用道路长度除以限速来估计。因此,“学习出租车经验”不意味着所有局部路段的通行时间都来自真实观测。
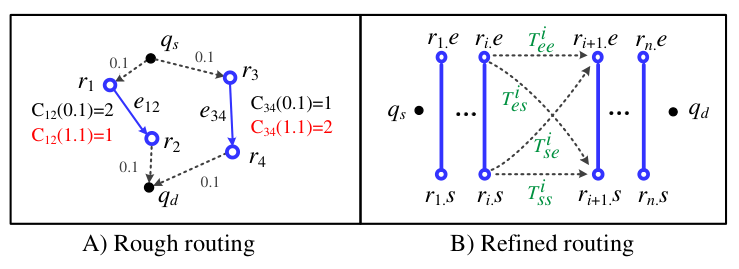
图 11|为什么出发时刻会改变推荐的大方向?
(A)粗规划:两条候选路径的边耗时随进入时刻变化,早出发和晚出发可能选择不同地标序列。
(B)细规划:相邻地标路段各有起点和终点,需要比较不同连接方向。图中的虚线是待比较的连接,并非实际行驶轨迹。来源:原论文 Fig. 11。
更小的图,时间估计还能可信吗?
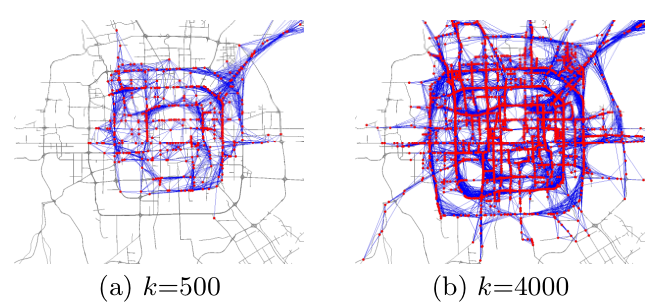
图 12|增加地标会怎样改变覆盖?
(a)k=500,红点为地标,蓝线为地标连接。
(b)k=4,000,覆盖更密集。地图反映网络覆盖,不能单凭视觉密度推断所有道路的估时都准确。来源:原论文 Fig. 12。
原论文表 3 显示,4,000 个地标形成 10,999 条边,地标节点数约为原路网节点数的 3.8%,边数约为原路段数的 7.8%。这是用路段代表地标节点后的存储规模比较,不能误读成保留了 3.8% 的道路面积。
估时验证使用 30 位真实驾驶者两个月的历史 GPS 记录,平均约 10 秒一个点。它们比出租车建模数据密集,可较清楚地对应真实道路和耗时。误差比 ER 定义为“估计时间减真实时间,再除以真实时间”;正值是高估,负值是低估。
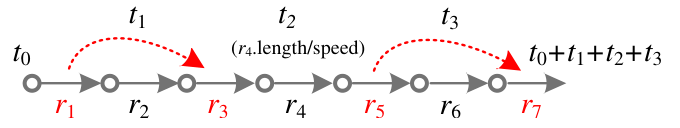
图 13|不完全由地标边覆盖的路线怎么算时间?
图中没有字母子图。路线由两段地标连接和一段未覆盖路段组成;后者使用长度与限速估计,再把各段时间相加。它解释 ER 的计算对象是一整条路线。来源:原论文 Fig. 13。
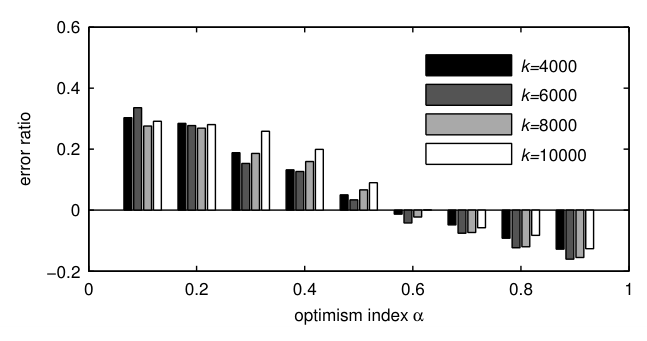
图 14|估计误差会受参数选择影响吗?
图中没有字母子图。横轴为 α,纵轴为有正负号的 ER,不同灰度对应不同地标数。α 较低时整体偏高估,较高时偏低估;论文在 α=0.6、k=10,000 附近报告较小误差。接近零的汇总有符号误差不能当作每条路线误差都小于 1%。来源:原论文 Fig. 14。
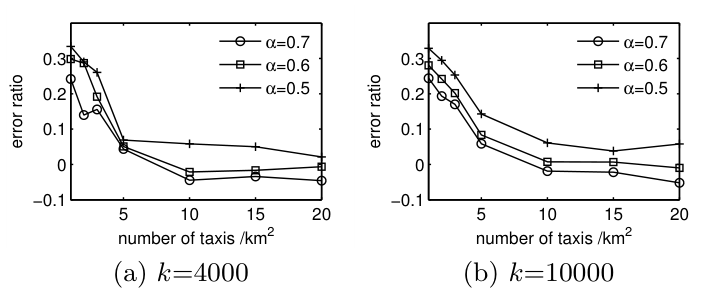
图 15|历史轨迹太稀疏会怎样?
(a)k=4,000,(b)k=10,000。两图横轴均为每平方公里出租车数量,纵轴为 ER,不同曲线代表 α。密度较低时误差更大,增加后趋稳;文中“每平方公里超过五辆”的经验条件来自这组北京数据,不是普遍的数据充足阈值。来源:原论文 Fig. 15。
更多推荐路线更快,究竟快多少?
1,200 条合成查询的起终点直线距离在 3–23 公里间均匀分布,出发时间在 6–22 时之间随机生成。两种对照分别是按道路限速估计时间的 SC,以及根据当时道路传感器和出租车读数估计速度的 RT。
FR1 是推荐路线比对照更快的查询比例;FR2 是每条路线相对对照节省的时间比例;SR 是两者推荐相同路线的比例。FR1 高不等于每条路线节省同样多时间,三者不能混用。
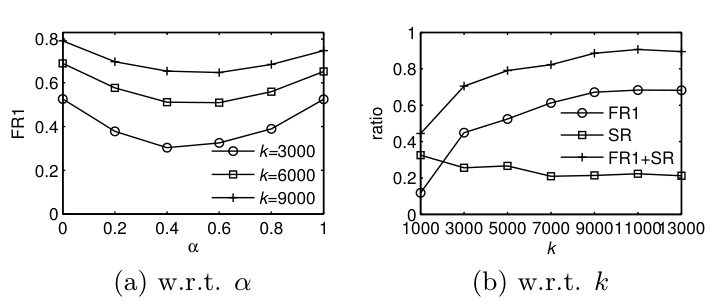
图 16|增加地标是否一直有用?
(a)横轴为 α,纵轴为 FR1,不同曲线为不同 k。
(b)横轴为 k,纵轴比较 FR1、SR 及两者之和;优势在 k 接近 9,000 后趋于稳定。表 4 中 α=0.7、k=9,000 的 FR1=0.672、SR=0.214,二者合计 0.886,其余约 11.4% 的查询并未优于 SC。来源:原论文 Fig. 16、Table 4。
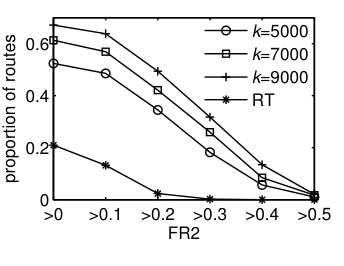
图 17|有多少路线达到了较大的节省幅度?
图中没有字母子图。横轴为 FR2 的下限,纵轴为超过该下限的路线比例,不同曲线比较地标数与 RT。在 k=9,000 时,超过一半的推荐路线相对 SC 节省至少 20% 的估计时间。该分布来自合成查询实验,不能直接当作实地驾驶者的节省分布。来源:原论文 Fig. 17。
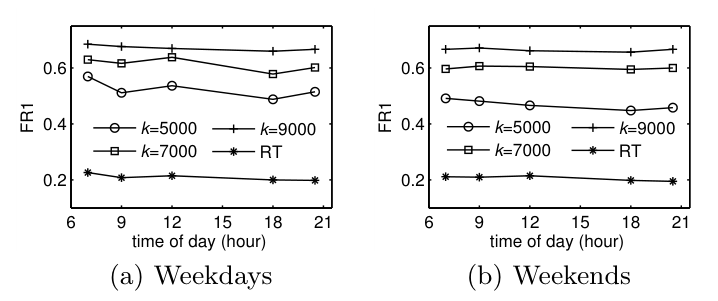
图 18|优势是否只存在于某个时段?
(a)工作日,(b)周末;横轴为一天中的时刻,纵轴为相对 SC 的 FR1。不同 k 的 T-Drive 曲线与 RT 曲线比较显示,这组查询中的优势并不只集中于单一时点。来源:原论文 Fig. 18。
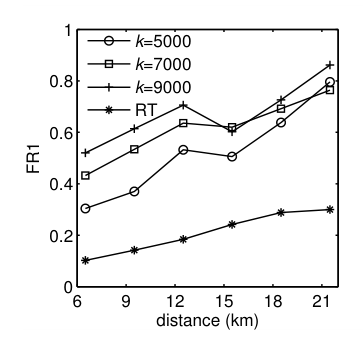
图 19|长距离查询为什么更可能受益?
图中没有字母子图。横轴为起终点地理距离,纵轴为 FR1;较远查询中 T-Drive 和 RT 相对 SC 的优势都更明显。作者解释为较长路线涉及更多交通状态不同的路段,这是一种对实验模式的解释,不是距离增长必然改善导航的定理。来源:原论文 Fig. 19。
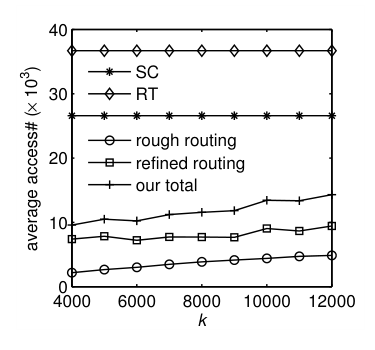
图 20|少搜索了多少网络节点?
图中没有字母子图。横轴为 k,纵轴为每次查询平均节点访问量,单位为千次;曲线区分粗规划、细规划、总量和两种对照。T-Drive 的总访问量更低,但节点访问次数不是毫秒耗时,不能直接换算为运行速度倍数。来源:原论文 Fig. 20。
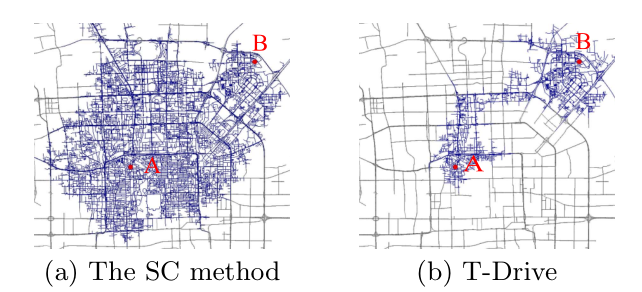
图 21|先定大方向怎样减少搜索?
(a)SC 方法搜索的道路区域较广;(b)T-Drive 在地标序列约束下缩小搜索区域。两图是同一问题的示例,不是总体平均效果。来源:原论文 Fig. 21。
真正上路之后,还能省下时间吗?
合成查询主要检验算法在模型内的表现。实地验证更接近用户真正关心的时间,但仍需看清比较设计。
第一组由 30 位驾驶者在不同时间驾驶不同方法推荐的路线,10 天内共记录 360 条轨迹、5,304 公里、165.24 小时。第二组由两位驾驶技能与习惯相近的驾驶者同时走不同推荐路线,6 天内共记录 60 条轨迹、814 公里、25.09 小时。数量口径来自原论文表 1;不能把 360 条轨迹写成 360 位驾驶者。
| 原论文指标 | 第一组 T-Drive / Google | 第二组 T-Drive / Google |
|---|---|---|
| 平均距离 | 13.91 / 15.56 公里 | 13.58 / 13.55 公里 |
| 平均行驶时间 | 25.80 / 29.28 分钟 | 23.18 / 27.00 分钟 |
| T-Drive 更快的比例 | 80.8% | 75.0% |
| 平均时间节省比例 | 11.9% | 14.1% |
| 平均静止等待时间 | 未报告 | 4.77 / 6.50 分钟 |
表中来自原论文表 5、表 6。第一组平均节省 3.48 分钟,文中报告 t 检验 p<0.005;第二组平均节省 3.82 分钟,路线长度几乎相同,而平均等待时间减少 1.73 分钟。这说明优势并不只是来自选择更短的路。
不过,第一组在不同时间驾车,仍可能受交通变化影响;第二组同时出发改善了这一点,但只有两位驾驶者。α 又由这些驾驶者的历史记录学习,不能把该结果称为完全未经个体适配的外部验证。对照还是当年的 Google 路线服务及论文定义的 SC、RT,不能据此断言它优于今天的商业导航。
哪些情况下,过去的经验可能失效?
出租车可能拥有普通私家车不能使用的道路权限,也可能偏向其运营活动集中的区域。低采样率、地图匹配误差和覆盖不足并未被彻底消除。重大事故、临时管制和施工也会让历史规律失效,作者因此把历史方法与实时信息看作可以互补。
另一个边界来自推荐本身:如果许多驾驶者都按同一建议走,原来较快的路可能变堵。论文提出未来结合负载均衡与更频繁更新,但没有在这里完成全城同时采用推荐后的均衡评估。
一句话总结
T-Drive 说明,低频出租车轨迹可以通过时变地标图转化为有用的路线经验,但效果需要用真实行驶、数据覆盖和交通变化共同检验。
核心来源
- Yuan, J., Zheng, Y., Zhang, C., Xie, W., Xie, X., Sun, G., & Huang, Y. (2010). T-Drive: Driving Directions Based on Taxi Trajectories. Proceedings of the 18th SIGSPATIAL International Conference on Advances in Geographic Information Systems, 99–108. DOI: 10.1145/1869790.1869807。全部原图和表内数字来自该论文。
作者介绍
- Jing Yuan:第一作者,本文署名单位为中国科学技术大学计算机科学与技术学院和微软亚洲研究院。
- Yu Zheng:本文作者,署名单位为微软亚洲研究院。
- Chengyang Zhang:本文作者,署名单位为北得克萨斯大学计算机科学系。
- Wenlei Xie:本文作者,署名单位为微软亚洲研究院。
- Xing Xie:本文作者,署名单位为微软亚洲研究院。
- Guangzhong Sun:本文作者,署名单位为中国科学技术大学计算机科学与技术学院。
- Yan Huang:本文作者,署名单位为北得克萨斯大学计算机科学系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
这项方法的一个启发是,数据稀疏时可以改变建模单位。单段路上看不清的速度,可能在两处常见路段之间积累成可估计的耗时分布。不过,改变单位也会隐藏中间细节:同一地标连接可能包含多条道路,其中一条突然封闭时,历史总体分布未必及时反映变化。
一个可检验的后续方向,是让地标图同时表达经验和证据新鲜度:某条连接的近期记录太少,或近期耗时明显偏离历史分布时,就降低其推荐置信程度,并交给实时信息补充。评价也应同时报告正常日、事故日和低覆盖区域,判断系统究竟在哪些条件下可靠。