地图上那条线,能告诉你当时怎样出行吗?
论文名片|Yu Zheng、Longhao Wang、Ruochi Zhang、Xing Xie、Wei-Ying Ma,GeoLife: Managing and Understanding Your Past Life over Maps,第九届国际移动数据管理会议(MDM),2008,211–212 页。论文原文。本文是一篇系统原型展示论文。
假设你翻出一段几个月前的 GPS 记录。地图上有一条折线,但你可能想不起来:当时为什么停在这里?这段路是开车还是步行?拍下的照片又属于哪一次出行?保存了坐标,不代表保存下来的经历已经容易理解。
GeoLife 的出发点,就是把轨迹从一串经纬度变成可以检索、回看和解释的个人记录。它把地图、多媒体、时空索引和出行方式识别放进同一套系统。不过,这篇两页论文展示的是系统设计与运行案例,并没有提供完整的定量评测。
先说结论
- 轨迹可与照片、音频和视频关联,使用者能沿着地图回看经历,而不只是浏览一组文件。
- 检索可以直接按时间段和地图区域发起,不必完全依赖事先添加的文字标签。
- 索引设计利用近期轨迹更常被上传这一观察,在更新频繁和更新稀少的数据组之间使用不同结构。
- 出行方式识别考虑一段行程内部的切换;论文展示了驾车后停车、再改为步行的案例,但没有在本文报告识别准确率或泛化实验结果。
为什么要把地图、照片和检索放在一起?
一张旅行照片和一段 GPS 轨迹如果分开保存,回忆时就要靠人自己把两者重新对应。GeoLife 接收轨迹与相关多媒体文件,解析后给多媒体内容关联拍摄地点的 GPS 坐标;轨迹经过组织后,也可以按空间和时间检索。用户决定记录用于个人还是公共用途。
图 1 把系统的两个方向放在一起:个人档案帮助回看自己的经历;公共数据则被设想用于发现热门地点、路线和交通状况,并向用户推荐。这里的热门路线和生活规律是系统计划挖掘的知识类型,不能据此认定本文已经逐项验证了这些服务的效果。
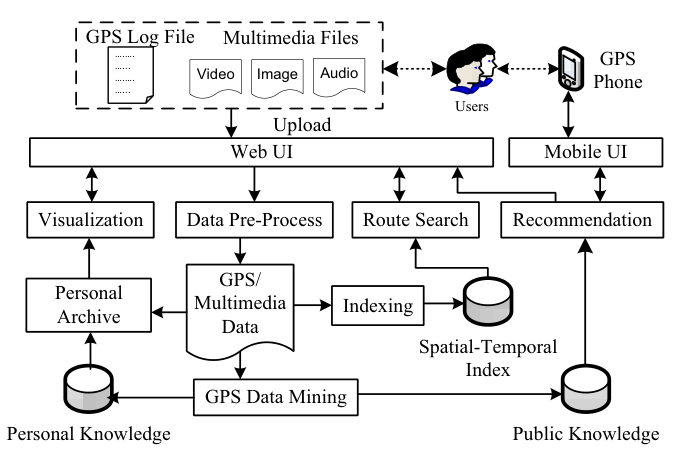
图 1|一段轨迹怎样进入个人档案和公共服务?
这张架构图没有字母子图。上方是 GPS 日志、多媒体和上传入口,中间是可视化、预处理、检索及推荐,下方连接个人档案、时空索引与数据挖掘。箭头说明模块间的数据流,并不表示这些模块的预测性能。来源:原论文 Fig. 1。
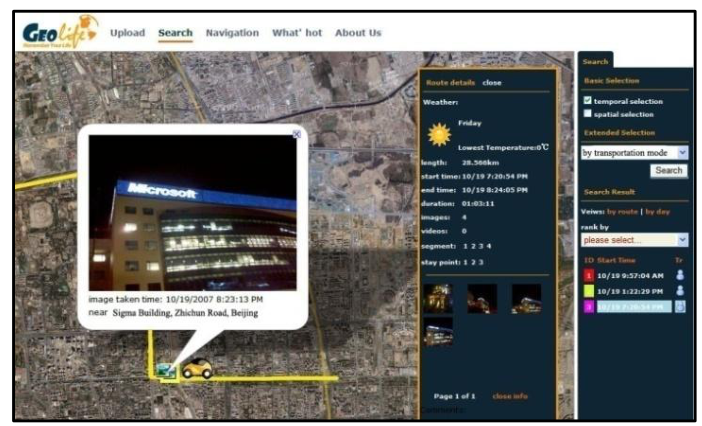
图 2|地点和照片怎样帮助回忆一次出行?
这张界面图没有字母子图。地图上显示轨迹,照片在相关地点弹出,侧栏提供记录与操作入口。图中展示的是交互形式,没有用户实验来证明这种界面使回忆更准确。来源:原论文 Fig. 2。
记录越来越多,为什么不一直用同一种索引?
如果你今天上传昨天的出行记录,数据组会频繁变化;很久以前的记录却可能已经很少补充。作者观察到,使用者更容易上传近期而非久远的 GPS 数据,因此不同时间组承受的更新压力并不相同。
GeoLife 对频繁更新的数据组使用 B+ 树,对少更新的数据组使用有序动态数组;当一组数据的更新频率低于阈值时,将其索引从前者转换为后者。用白话说,就是还经常添东西的抽屉和基本归档完毕的抽屉,不必采用完全相同的整理方式。
作者称这种方案能够减少索引占用和更新成本,同时维持令人满意的检索性能。但本文没有列出数据规模、阈值、检索耗时或对照实验表。因此,可以解释设计为什么有针对性,却不能从这篇展示论文算出它比其他索引快多少。
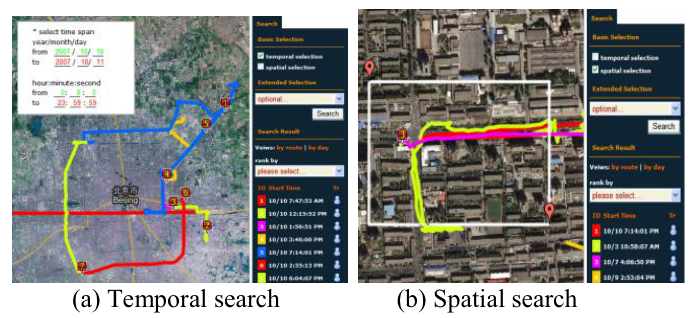
图 3|怎样在大量历史记录里找回需要的轨迹?
(a)时间检索:通过时间条件选择记录,地图显示检索到的轨迹;这里展示的是时间条件如何进入界面。
(b)空间检索:通过地图区域查找经过该范围的轨迹。两幅图说明可用的查询方式,没有速度曲线或检索准确性指标。来源:原论文 Fig. 3。
一段轨迹里换了交通工具,系统怎样处理?
把整次出行只标成一种交通工具,会丢掉重要信息。例如一次行程可能先驾车,到停车场后再步行。GeoLife 使用监督学习(supervised learning),即利用带有已知类别的样本训练分类模型,尝试从原始 GPS 数据识别步行、公交、自行车和驾车。
它先把轨迹拆成行程,再把行程划为片段,提取各片段的特征。这样,识别的基本对象是轨迹片段,不是整位用户,也不是整天活动。
论文提出两条推断路线。第一条把片段当作独立样本分类,再用出行方式之间的转移概率进行后处理,让前后片段的标签更协调。第二条使用条件随机场(conditional random field,CRF),在推断中直接考虑类别之间的条件关系,因此不再使用同样的后处理。本文没有给出特征清单、训练样本量、转移概率数值或两条路线的性能比较。
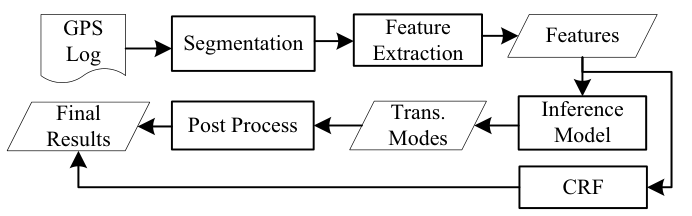
图 4|为什么识别出行方式不能只看一个片段?
这张流程图没有字母子图。从 GPS 日志到分段和特征提取后,一条路径经过推断模型与后处理,另一条路径通过 CRF 得到最终结果。两条路径的区别在于怎样纳入片段之间的方式转换关系,不代表图中已经比较出了最佳模型。来源:原论文 Fig. 4。
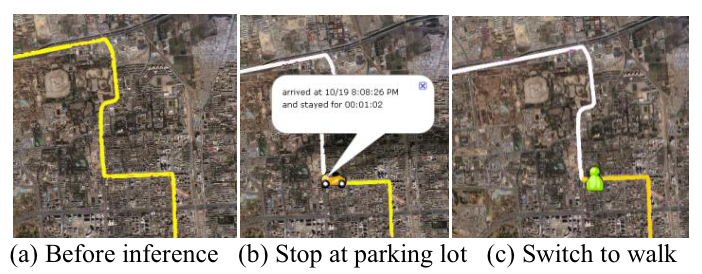
图 5|同一条路线,增加方式标签后能看懂什么?
(a)识别前:路线提供基本位置和路径信息。
(b)停车点:结合停留位置,界面展示车辆停在停车场的节点。
(c)改为步行:后续片段被解释为步行,显示行程内部发生了交通方式切换。这是一条示例轨迹,不能作为总体准确率或跨用户泛化能力的估计。来源:原论文 Fig. 5。
这篇展示论文能支持到哪里?
GeoLife 展示了一套把轨迹管理与轨迹理解结合起来的原型,也明确提出了不依赖地图及其他传感器来识别复合行程的思路。作者还称,在部分用户上学习的模型可以应用到其他人的数据;但本文没有给出训练集、测试集或跨用户实验,不能把这项陈述写成本文已经充分检验的普遍结论。
同样,系统将挖掘结果用于健康习惯、路线推荐等目标,并不等于已经证明这些结果改善了健康或推荐体验。理解这篇论文的贡献,应把系统集成、设计动机、运行示例与定量验证区分开来。
一句话总结
GeoLife 让历史 GPS 轨迹更容易被找到、回看和解释,但这篇原型论文的主要证据是系统与案例,尚不足以量化识别或推荐效果。
核心来源
- Zheng, Y., Wang, L., Zhang, R., Xie, X., & Ma, W.-Y. (2008). GeoLife: Managing and Understanding Your Past Life over Maps. 9th International Conference on Mobile Data Management, 211–212. DOI: 10.1109/MDM.2008.20。本文全部原图均来自该论文。
- 原论文将交通方式学习和索引细节分别指向其参考文献 [3]、[4];上述解读仅将本篇实际呈现的内容作为证据。
作者介绍
- Yu Zheng:本文第一作者,论文署名机构为微软亚洲研究院。
- Longhao Wang:本文作者,论文署名机构为微软亚洲研究院。
- Ruochi Zhang:本文作者,论文署名机构为微软亚洲研究院。
- Xing Xie:本文作者,论文署名机构为微软亚洲研究院。
- Wei-Ying Ma:本文作者,论文署名机构为微软亚洲研究院。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
轨迹档案的价值可能来自两个不同环节:找到一段记录,以及正确解释那段记录。前者失败,使用者什么也看不到;后者失败,使用者却可能看到一个流畅但错误的故事。例如 GPS 中一次减速,既可能意味着下车步行,也可能只是堵车。
因此,若把这种原型发展为个人出行日记,一个可检验的设计方向是让使用者查看或修正方式切换,而不是把所有推断标签都当作事实。评估时也应分别测检索耗时、标签正确性和回忆体验,避免用其中一个环节的改善替代整套系统的有效性。