只知道人口和地图,能补出一座城市的出行网络吗?
论文名片|Jinming Yang、Shaoyu Huang、Zongyuan Huang、Yaohui Jin、Xiaokang Yang、Marta C. González、Yanyan Xu,Nature Computational Science 6,630–641(2026),2026 年 6 月 12 日发表。期刊原文 · 预印本
假设你要为一座城市调整公交线路。地图上看得见住宅、学校、商店和道路,也知道各片区住了多少人;可真正决定线路该往哪里走的,是每天有多少人从哪个片区去往哪个片区。偏偏这张出行表最难拿到:全面调查成本高,手机定位数据又受覆盖范围和使用权限限制。
能不能只掌握少量出行记录,就补全整座城市的联系?再进一步,能不能把在波士顿学到的规律,带到没有本地出行记录的城市?
neuroGravity 给出的办法,是把引力模型与图神经网络放在一起。它确实提高了重建和迁移能力,但哪些信息在训练时可见、哪些只在评估时用于校准,会直接影响我们怎样理解它的成绩。
先说结论
- 在只观测 10% 区域之间内部流量的重建实验中,可见连接通常仅占全城有效连接的约 1%。六城各自 30 次实验的 R² 中位数再取平均,neuroGravity 为 0.614,最强平均基线 GNN 为 0.444,相对提高约 38%;这组主要比较预先知道哪些 OD 对存在非零流量。
- 波士顿训练的模型,可以不使用目标城市的逐条 OD 流量进行再训练,迁移到洛杉矶、旧金山湾区等地。但图 5 的主要精度使用真实全城出行总量做了事后校准,不能直接当作完全没有目标城市信息时的精度。
- 为出行任务学到的区域表示,也包含与收入、教育、碳足迹和污染相关的信息。不过,这组实验使用完整出行数据学习表示,随后还要用已知指标训练预测器,并非只看一张地图就能直接读出收入。
- 跨城迁移并不只看地理距离。五座城市之间,收入空间隔离程度越接近,模型往往迁移得越好。这是一组有启发性的关联,还不是适用于任意城市的普遍规律。
人口和距离有用,为什么还不够?
把城市划成若干统计区域,每个区域是一个节点,区域之间的起讫点组合就是 OD 对(origin–destination pair)。这里要重建的是区域之间的典型日出行流量,不是个人轨迹,也不是某条道路的实时车流,不能直接读成公交客流。
传统引力模型的直觉很清楚:两端人口越多,往来潜力通常越大;距离越远,联系通常越弱。可同样的人口和距离,并不能保证同样的出行量。住宅区连着就业中心,与两片住宅区之间的联系,可能很不一样;周围还有哪些目的地,也会影响人流怎么分配。
只用简单公式,容易漏掉这些差别;只用复杂神经网络,在观测很少时又容易记住局部特征,换一座城市就失灵。neuroGravity 尝试保留人口与距离的基本结构,同时让神经网络学习公式没能解释的部分。
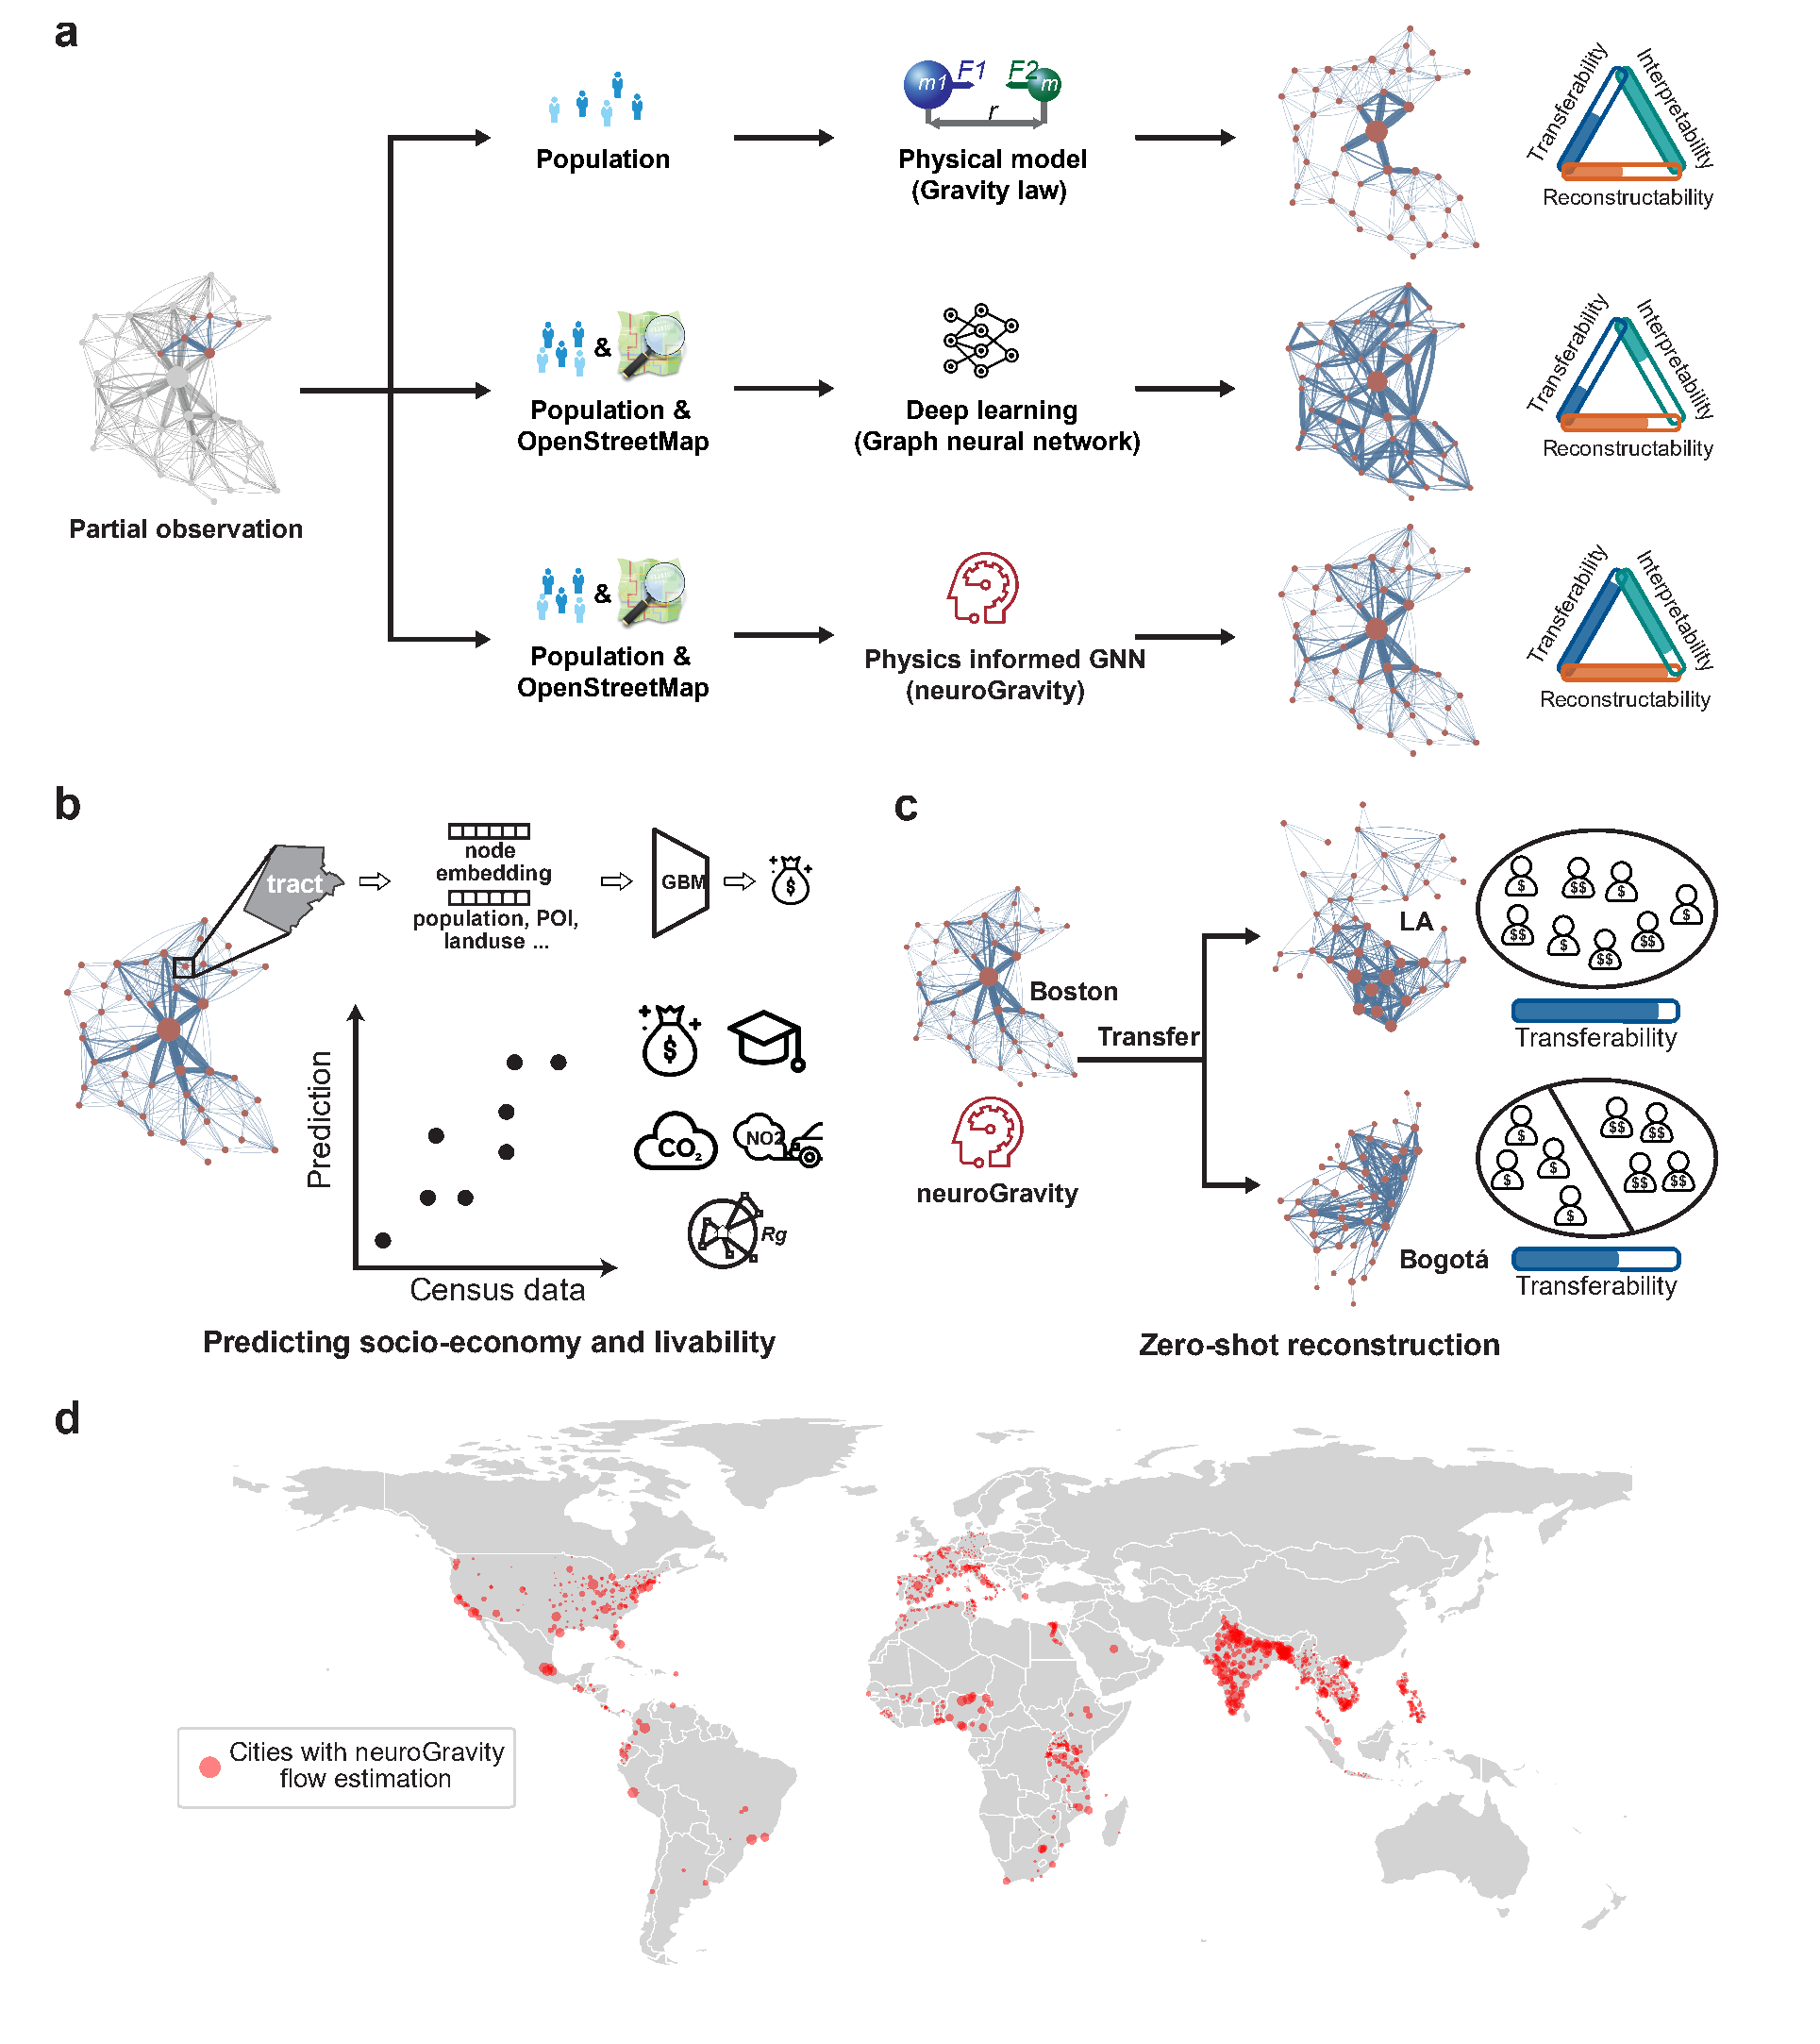
图 1|从少量观测补全网络,到把模型带到另一座城市。
- (a)比较引力模型、普通图神经网络和 neuroGravity 的设计取向;右侧三角形是能力示意,不是定量评分。
- (b)用模型学到的区域表示,辅助估计社会经济和宜居性指标。
- (c)跨城迁移示意:相同的源城市模型,在不同目标城市的效果可能不同。
- (d)全球生成范围:红点标出已有模型估计的 1,200 多座城市和地区,不代表每座城市都已有实测数据验证。
来源:原论文 Fig. 1。
先判断有没有流量,再估计流量有多大
模型需要的公开输入,包括区域边界、人口、区域间距离,以及从 OpenStreetMap(OSM)提取的 52 类建成环境特征:各类建筑和用地占比、兴趣点密度、道路长度密度等。美国采用邮政编码统计区(ZCTA),其他城市使用当地的区域划分;同样一个节点,在不同城市对应的面积并不相同。
用于训练和检验的出行数据,则主要来自匿名手机通信记录(CDR)和基于位置的服务数据(LBS)。手机样本不覆盖所有居民,因此 CDR 轨迹经过 TimeGeo 出行模型扩展,再汇总为人口尺度的典型日 OD 流量;LBS 也按居住地人口扩样。论文中的参考流量因此包含数据处理和模拟成分,并非全体居民逐次出行的直接计数。
有了这些信息,重建分成三步。
第一步,找出可能存在稳定流量的 OD 对。城市里并不是每两个区域之间都有可观测往来;若把所有区域都连上,会给后续学习引入大量不合适的连接。LightGBM 分类器根据两端特征和距离判断是否连边,阈值在波士顿确定为 0.4,并统一用于其他城市。
第二步,用 meta-Gravity 给出初步流量。它保留引力模型的形式:初步流量等于 G 乘以两端人口之积,再除以距离的 α 次方。不同的是,G 和距离衰减参数 α 不再全城固定,而由两端区域特征决定,使不同类型的区域组合可以遵循不同的联系强度。
第三步,用图神经网络修正估计。初步流量与距离成为连接的特征,区域的建成环境成为节点的特征;节点和连接通过多层注意力机制一起更新。这样,模型估计一对区域的流量时,也能利用它们与其他区域的联系,而不是只孤立地看这两个地方。
训练在对数空间进行,既便于表达引力模型中的乘法和幂关系,也能减轻少数超大流量对学习的支配。模型先训练引力模块,再联合训练两个部分,采用对异常误差较稳健的 Huber 损失,并用留出的验证数据提前停止训练。
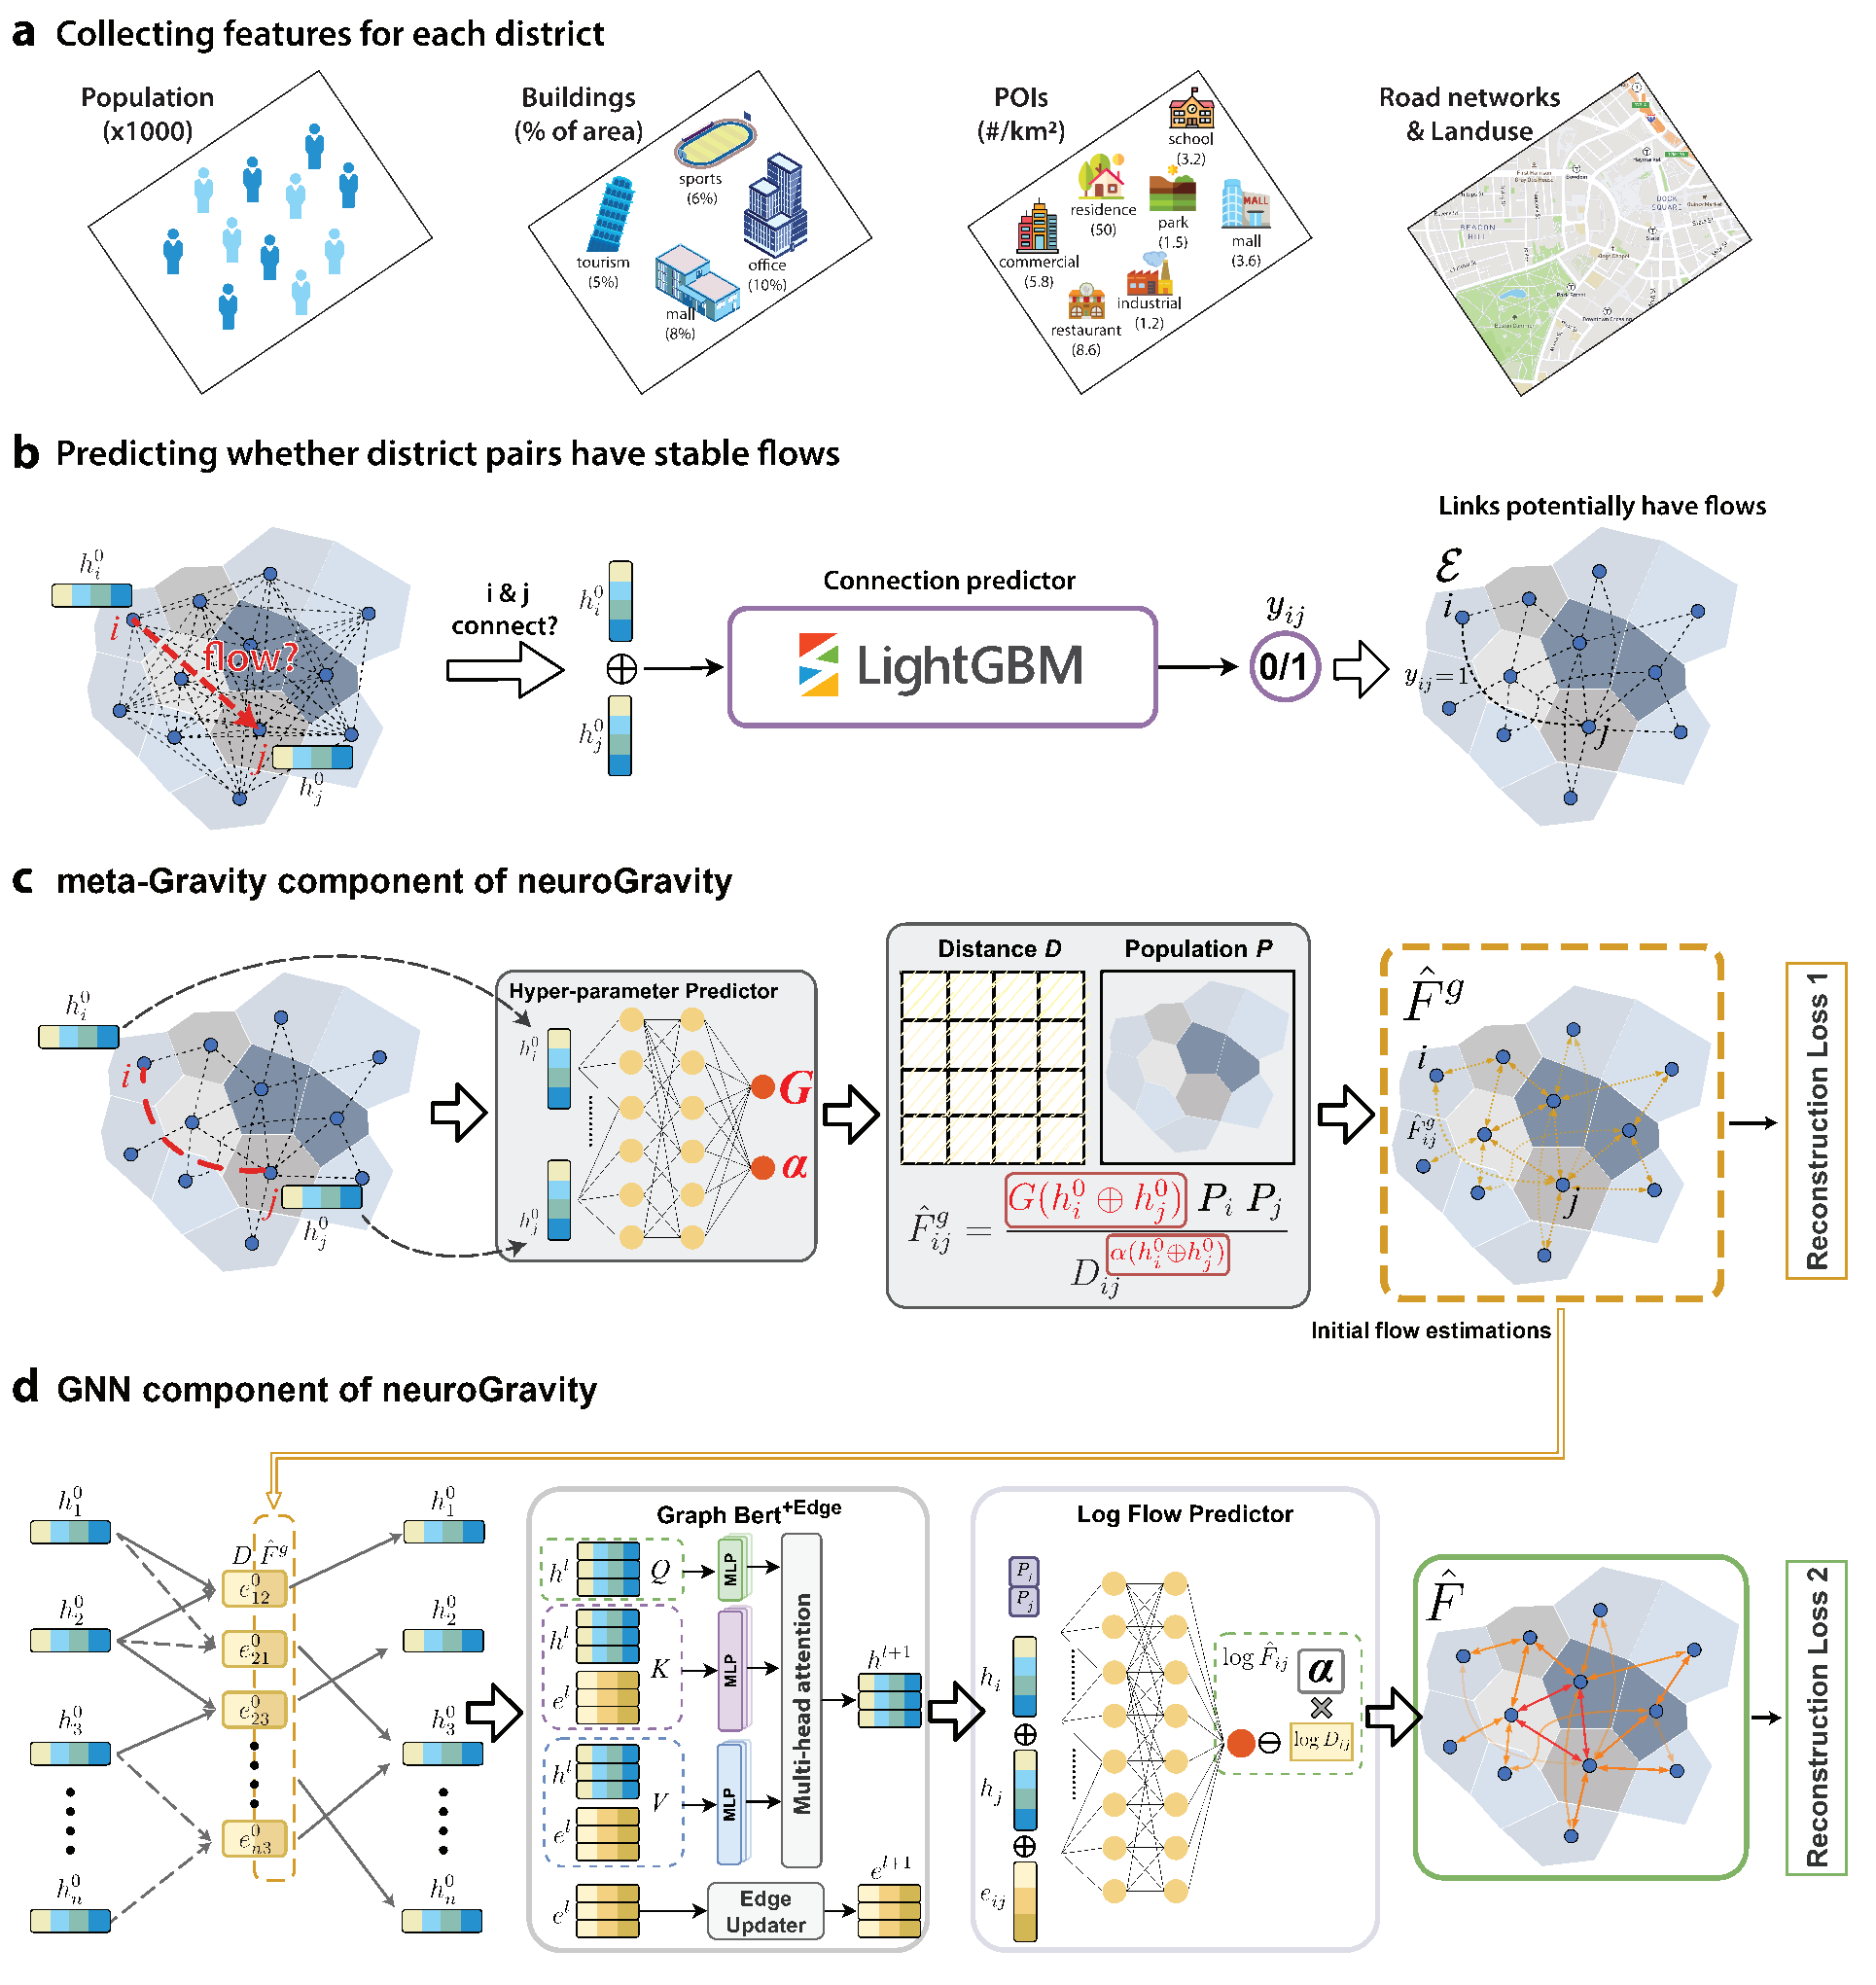
图 2|公开地图信息怎样一步步变成 OD 流量。
- (a)输入准备:人口、建筑占比、兴趣点密度、用地与道路特征。
- (b)连接预测:LightGBM 判断哪些区域对可能存在流量,构成供图网络学习的连接集合。
- (c)初步估计:神经网络根据两端特征生成引力参数,再结合人口和距离估计流量。
- (d)图网络修正:节点与连接表示共同更新,最终在对数空间预测流量;两路模块通过损失函数训练。
来源:原论文 Fig. 2。
只看一小部分区域,能补出多少?
这里的 10% 观测比例,指随机选取 10% 的区域,只开放这些区域彼此之间的流量,不是随机开放全城 10% 的连接。两端都必须落在这小部分区域里,所以能见到的连接要少得多。
图 3 的波士顿案例包含 250 个 ZCTA、51,786 条有效 OD 连接。只看其中约 1% 的连接,neuroGravity 的 R² 为 0.77、CPC 为 0.73;引力模型分别为 0.59 和 0.63。地图上,引力模型过于集中于城市中心,neuroGravity 则更接近参考网络中的主要联系与外围结构。为看清主干,地图只画了流量最高的 30% 连接。
两个指标回答的问题不同:R² 看逐条流量偏差有多大,1 表示完全吻合,低于 0 表示还不如用参考流量的均值作统一预测;CPC 衡量预测与参考流量的重叠程度,范围为 0 到 1,越高越好。CPC 的名字虽含通勤者,这里比较的是研究定义下的出行流量,不能把它读成通勤识别准确率。
单次表现还不够。研究在波士顿、洛杉矶、旧金山湾区、波尔图、波哥大和利雅得分别随机抽样 30 次。补充表 4 显示,neuroGravity 的六城 R² 中位数均超过各自基线;前面提到的 38%,就是各城中位数取平均后,从 0.444 到 0.614 的相对提升,并非准确率增加 38 个百分点。CPC 的平均提升则约为 3%,说明不同指标下的优势幅度并不一样。
这组主要测试有一个条件:为单独检验流量预测器,非零连接的位置被视为已知。真正从头重建时,还得承担连边预测的误差。补充表 9 单独比较了两种情况:波士顿 30 次实验的平均 R² 从已知连接时的约 0.707,变为预测连接时的约 0.695;旧金山湾区则从约 0.581 变为 0.533。方法的优势仍在,但完整流程的难度不能被省略。
图 3f 中,引力模型的 R² 随观测比例增加而下降,也不能简单理解为数据越多越差:剩余测试连接随观测范围改变,R² 又对逐条的大误差敏感;这不是固定测试集上的单纯加样本实验。
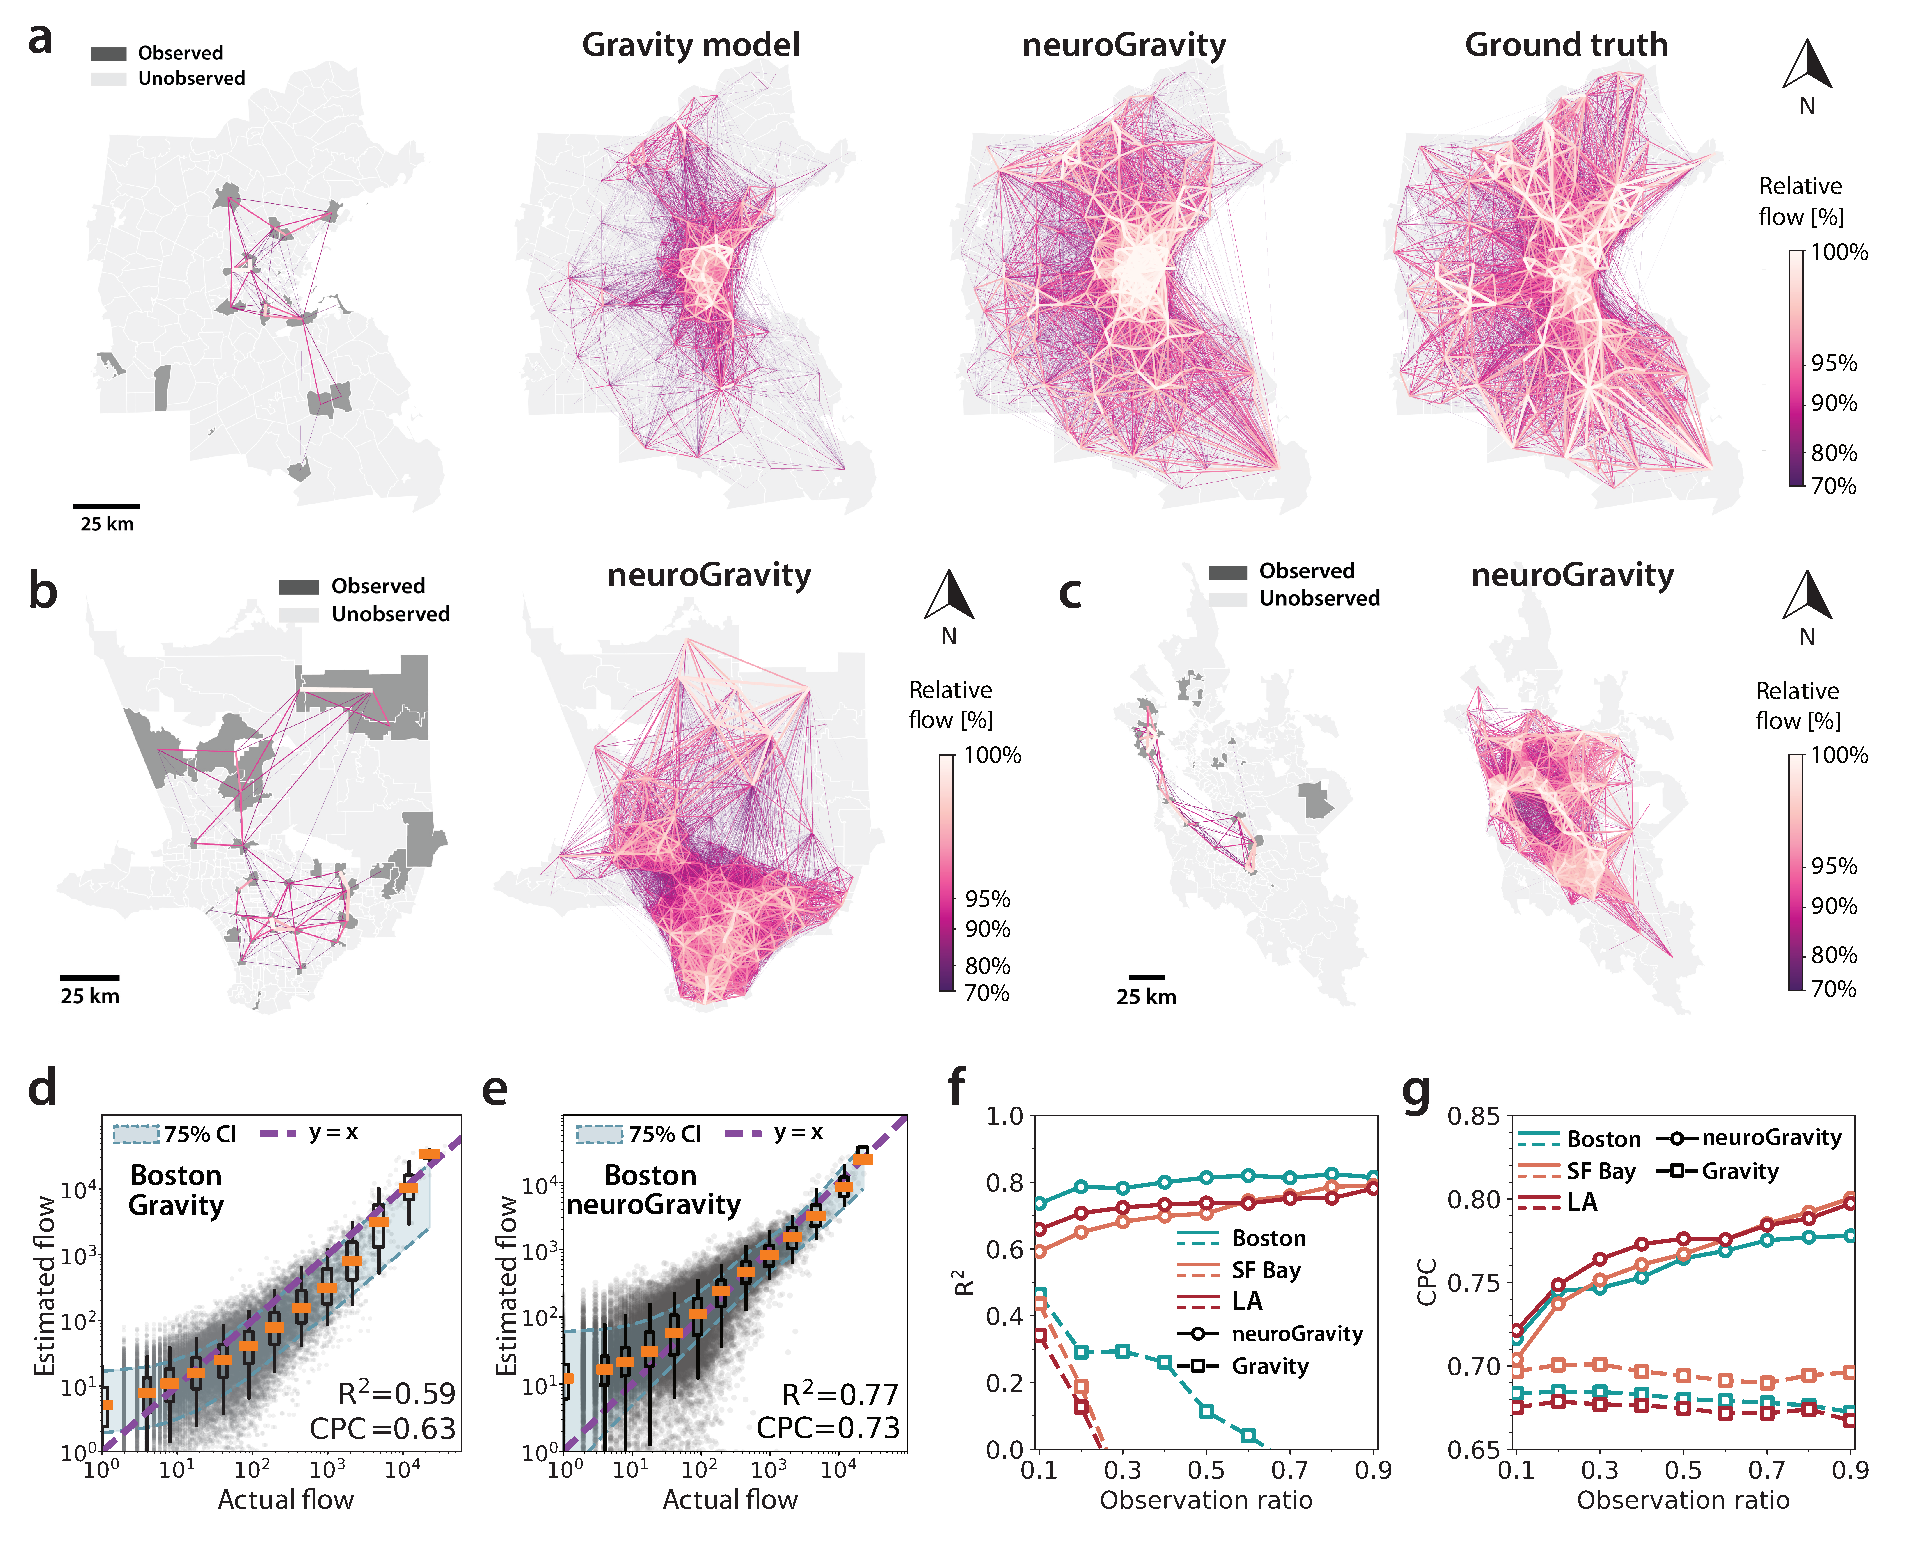
图 3|既看地图上的联系是否合理,也看逐条流量是否接近参考值。
- (a)波士顿从左到右为可见观测、引力模型、neuroGravity 和参考网络;颜色及线宽突出高流量连接。
- (b)洛杉矶的观测范围与重建网络,示例 R² 为 0.70。
- (c)旧金山湾区的观测范围与重建网络,示例 R² 为 0.60。
- (d)引力模型的流量对照:横轴为参考值,纵轴为预测值,双轴采用对数刻度;点越偏离相等线,逐条误差越大。
- (e)neuroGravity 的同类对照,点云更集中于对角线附近。
- (f)不同区域观测比例下的 R²;每个点汇总 30 次独立抽样实验。
- (g)相同实验的 CPC;实线为 neuroGravity,虚线为引力模型。
来源:原论文 Fig. 3。
学会人流联系,为什么也能看出区域差别?
如果两个片区的建筑、设施和出行联系相似,模型是否也会把它们表示成相似的区域?图 4a 将波士顿的节点嵌入——模型为每个区域学到的一组数字特征——投影到二维。收入相近但相距较远的区域可能靠近,地理相邻但收入不同的区域也可能分开。图 4b 进一步显示,嵌入距离越大,区域收入差距的中位数通常越大。
这还只是相关性的展示。要检验这些表示有没有额外预测价值,研究另用 LightGBM 估计五类区域指标,比较只用 OSM、只用嵌入,以及两者合用。波士顿两者合用时,收入和大学学历人口比例的 R² 约为 0.42、0.35;家庭碳足迹、二氧化氮浓度和活动回转半径分别约为 0.73、0.78、0.76。活动回转半径描述活动地点围绕活动重心的分散程度,可理解为活动范围的一种度量。
这些成绩来自 20 轮带重采样的五折交叉验证。用于生成嵌入的 neuroGravity 在本城完整出行数据上训练,后续指标预测器也需要有标签的样本。因此,它说明出行表示能为指标估计补充信息,不能据此宣称无需出行调查和收入样本就能得到同样结果。改为空间分块验证后,波士顿收入的 R² 从约 0.418 降到 0.385,反映了更严格空间外推的难度。
这种联系也因城市而异。洛杉矶的活动回转半径预测 R² 约为 −0.07,旧金山湾区约为 0.13。论文以单中心与多中心结构的差别解释这种异质性,但这些实验没有单独识别城市结构的因果作用。SHAP 排名显示嵌入特征重要,也不等于证明了收入或设施如何导致出行。
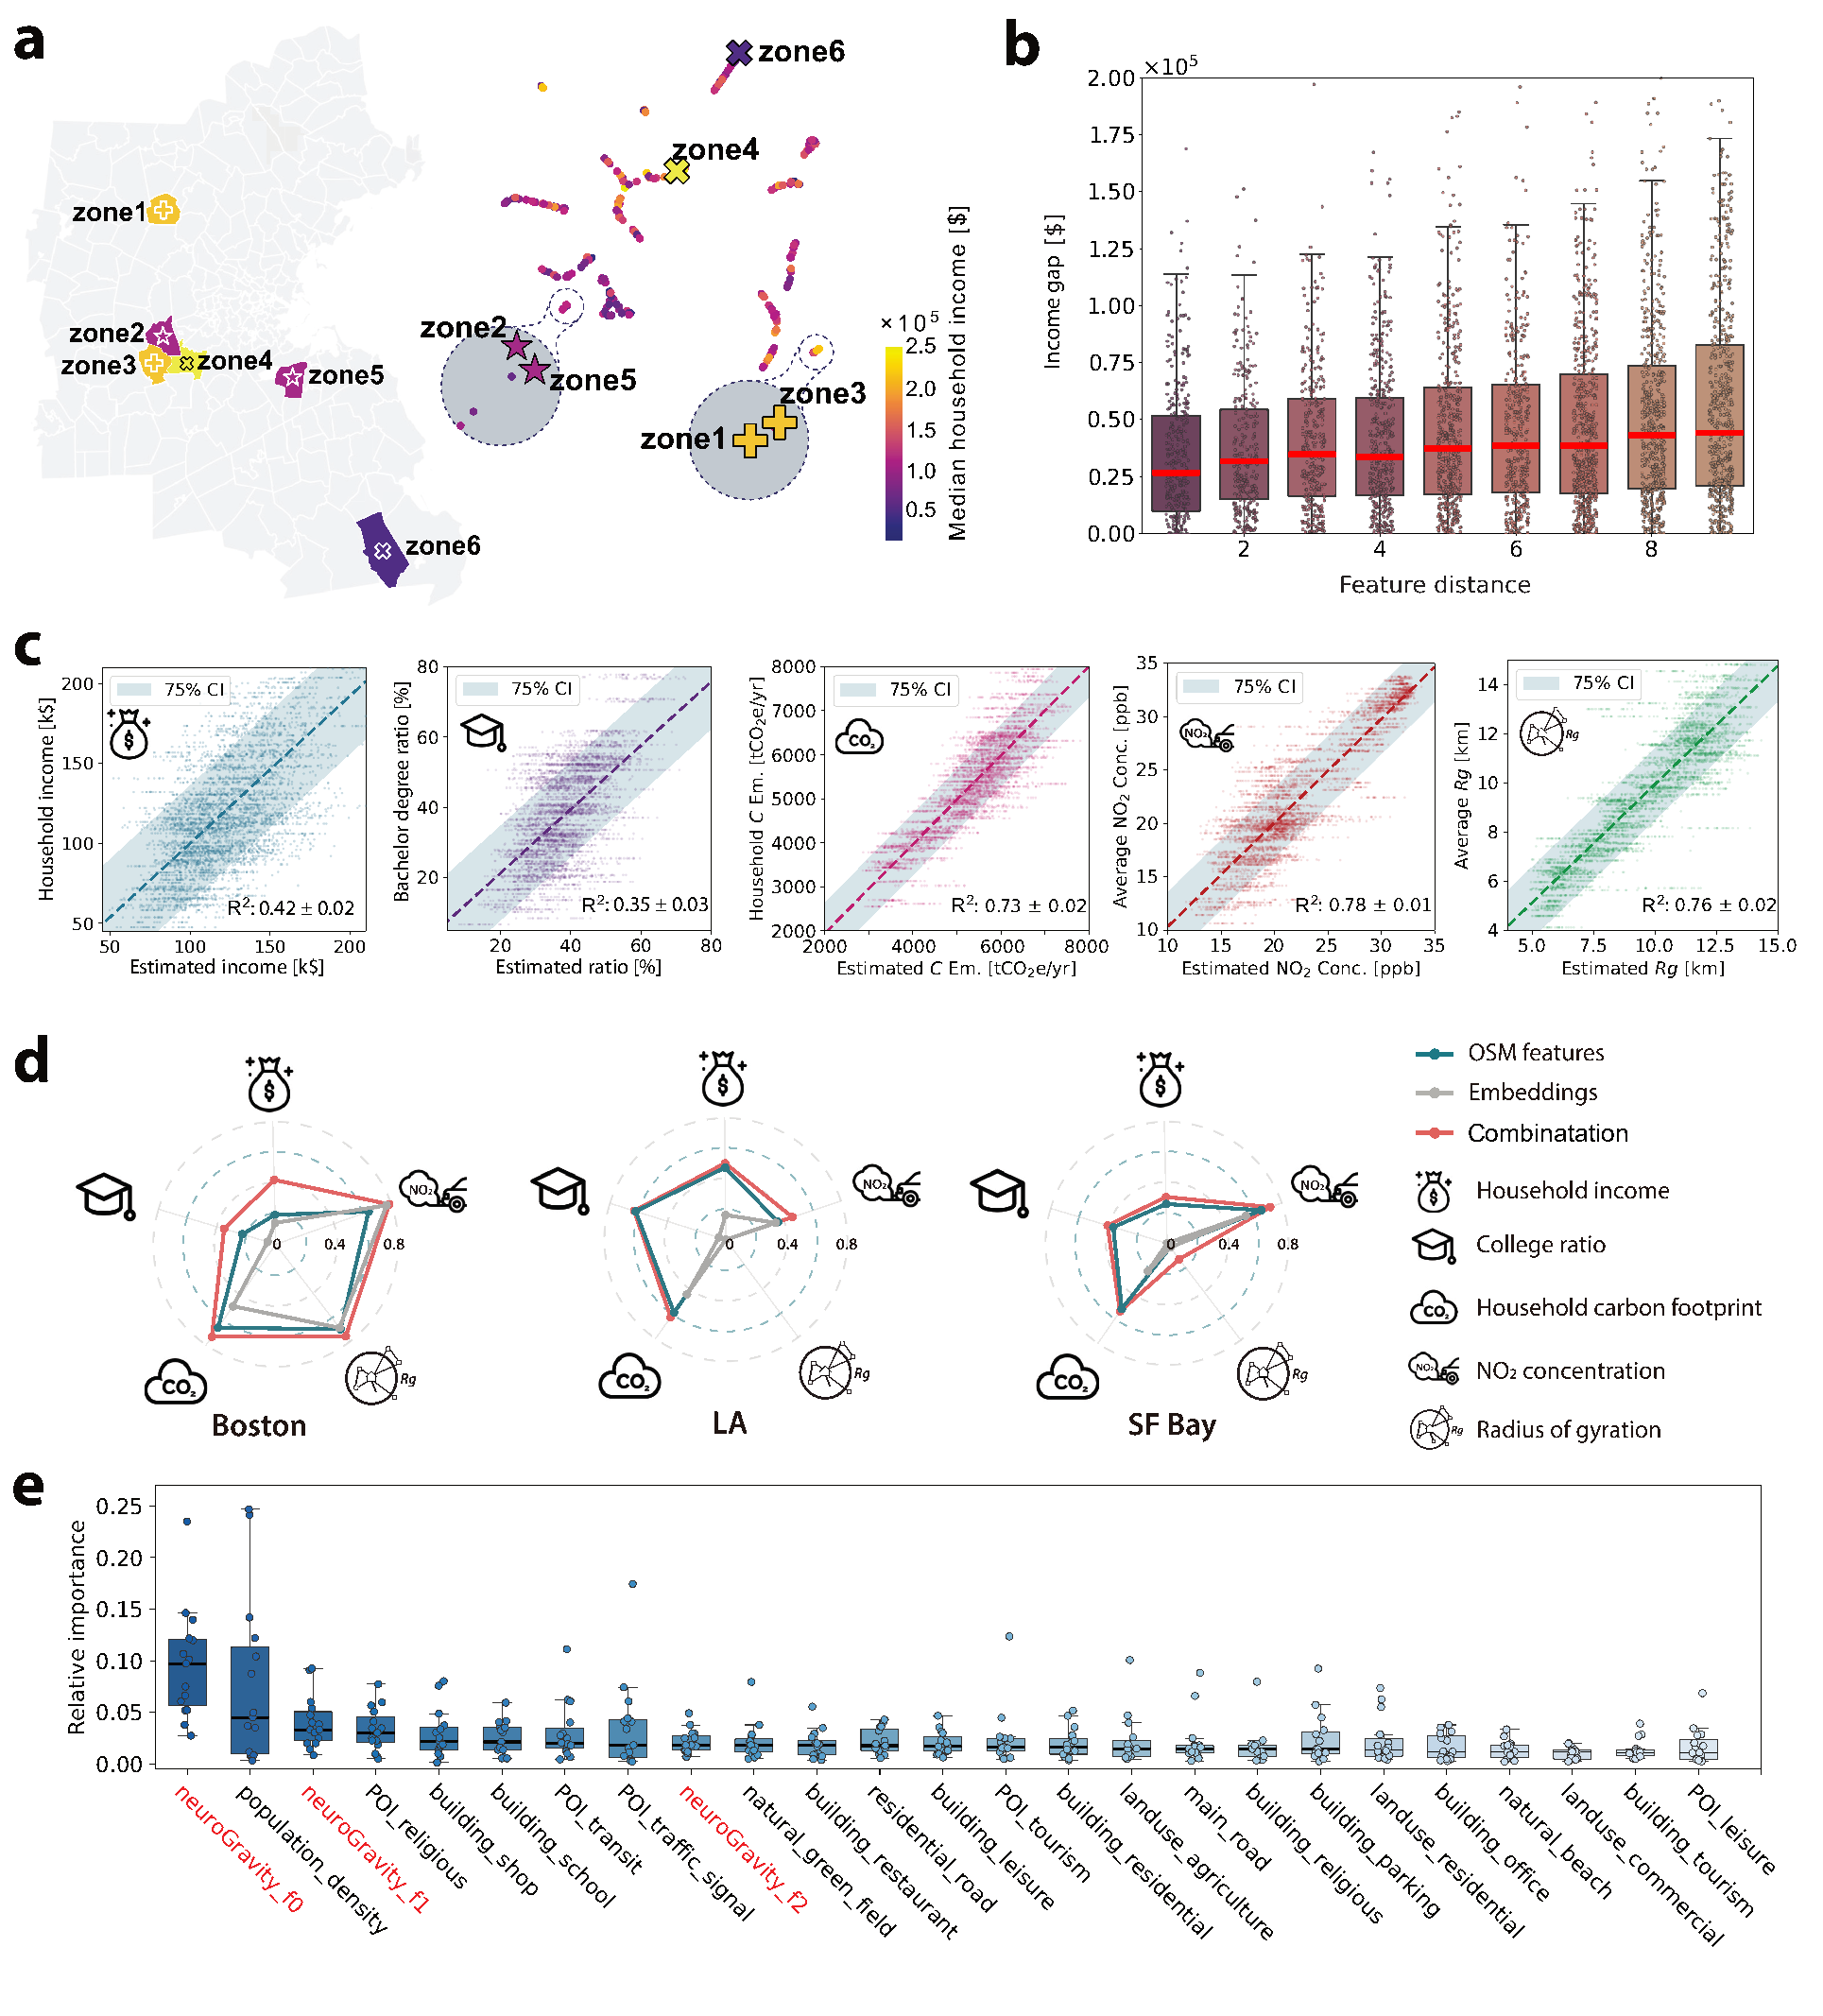
图 4|模型学到的区域表示,是否包含地图原始特征之外的信息?
- (a)左为区域地图,右为嵌入的二维投影,颜色表示家庭收入;投影上的接近不等于地理接近。
- (b)横轴为嵌入距离,纵轴为两区收入差,红线表示各距离组的中位数。
- (c)波士顿五项指标的预测与参考值对照,标注重复交叉验证的 R² 均值及标准差。
- (d)三城分别比较 OSM、嵌入及两者合用的结果,揭示不同指标与城市的差别。
- (e)三城五项任务的 SHAP 相对重要性;嵌入先降为四个主成分用于此项解释分析,红字标出相关特征。
来源:原论文 Fig. 4。
换一座城市,真正能带走什么?
更难的检验,是在源城市训练后,直接把连接预测器和流量模型用于目标城市,不再用目标城市的逐条 OD 流量训练。为减轻偶然抽样的影响,研究在源城市训练 20 个模型,对每条目标连接的预测去掉最高、最低值后取平均;基线采用同样的集成方式。官方代码说明,跨城实验的物理模块使用较简单的传统引力模型,少量本地观测的重建版本则默认使用 meta-Gravity。
图 5a 中,波士顿迁移到洛杉矶、旧金山湾区、波哥大、里约热内卢的 R² 分别约为 0.69、0.61、0.48、0.42。不过,这些主要迁移指标先把预测的全城流量总和,缩放到目标城市的真实总量。它检验的是总量对齐后,各条连接能否分配得合理,尚不完全等于总量也未知时的表现。
补充表 19 给出了不校准的成绩:
| 波士顿迁移到 | 按真实总量校准的 R² | 不校准总量的 R² |
|---|---|---|
| 洛杉矶 | 0.69 | 0.59 |
| 旧金山湾区 | 0.60 | 0.60 |
| 波尔图 | 0.68 | 0.61 |
| 波哥大 | 0.48 | 0.46 |
| 利雅得 | 0.51 | 0.43 |
| 里约热内卢 | 0.42 | 0.15 |
这里采用补充表的舍入数值。无需目标城市逐条流量再训练,是有价值的进步;无需目标城市总量就能保持同样精度,则不是所有城市都成立。里约的下降尤其说明,绝对出行规模仍可能成为跨城应用的难点。
为什么有些城市之间更容易迁移?
一个可能的原因是,城市的贫富区域怎样在空间上排列,会影响人们能到哪里、需要去哪里。两座城市即使平均收入不同,若高低收入群体在空间上的组织方式相近,出行规律也可能更容易迁移;反之,同样人口和设施,未必形成相同联系。
研究用五座有收入数据的城市检验这个想法。空间收入隔离指数 SI 的计算,不只看各区收入差多少,还看相似收入区域是否连片:先反复合并相邻且收入接近的区域,最终得到 7 个大区域,再把全城收入差异拆成大区域之间与内部两部分。
SI = 大区域之间的收入差异 ÷ 全城总收入差异。
如果高收入区、低收入区各自连片,大部分差异会保留在合并后的区域之间,SI 就较高。它量的是收入差异的空间组织,不能直接当作基尼系数,也不能直接读成不同收入者实际接触的程度;结果还依赖区域划分与合并尺度。
图 5d 显示,同一源城市对应的迁移 R² 通常随源、目标城市的 SI 差距增大而下降。再把两城 SI、SI 差距、区域面积和 OSM 密度等因素放入线性回归,拟合迁移成绩的 R² 达到 0.97。这个 0.97 是对迁移表现的解释拟合,不是出行流量预测达到 97% 准确率;数据来自五城之间的 20 组定向迁移,也不能据此保证新城市的迁移精度。
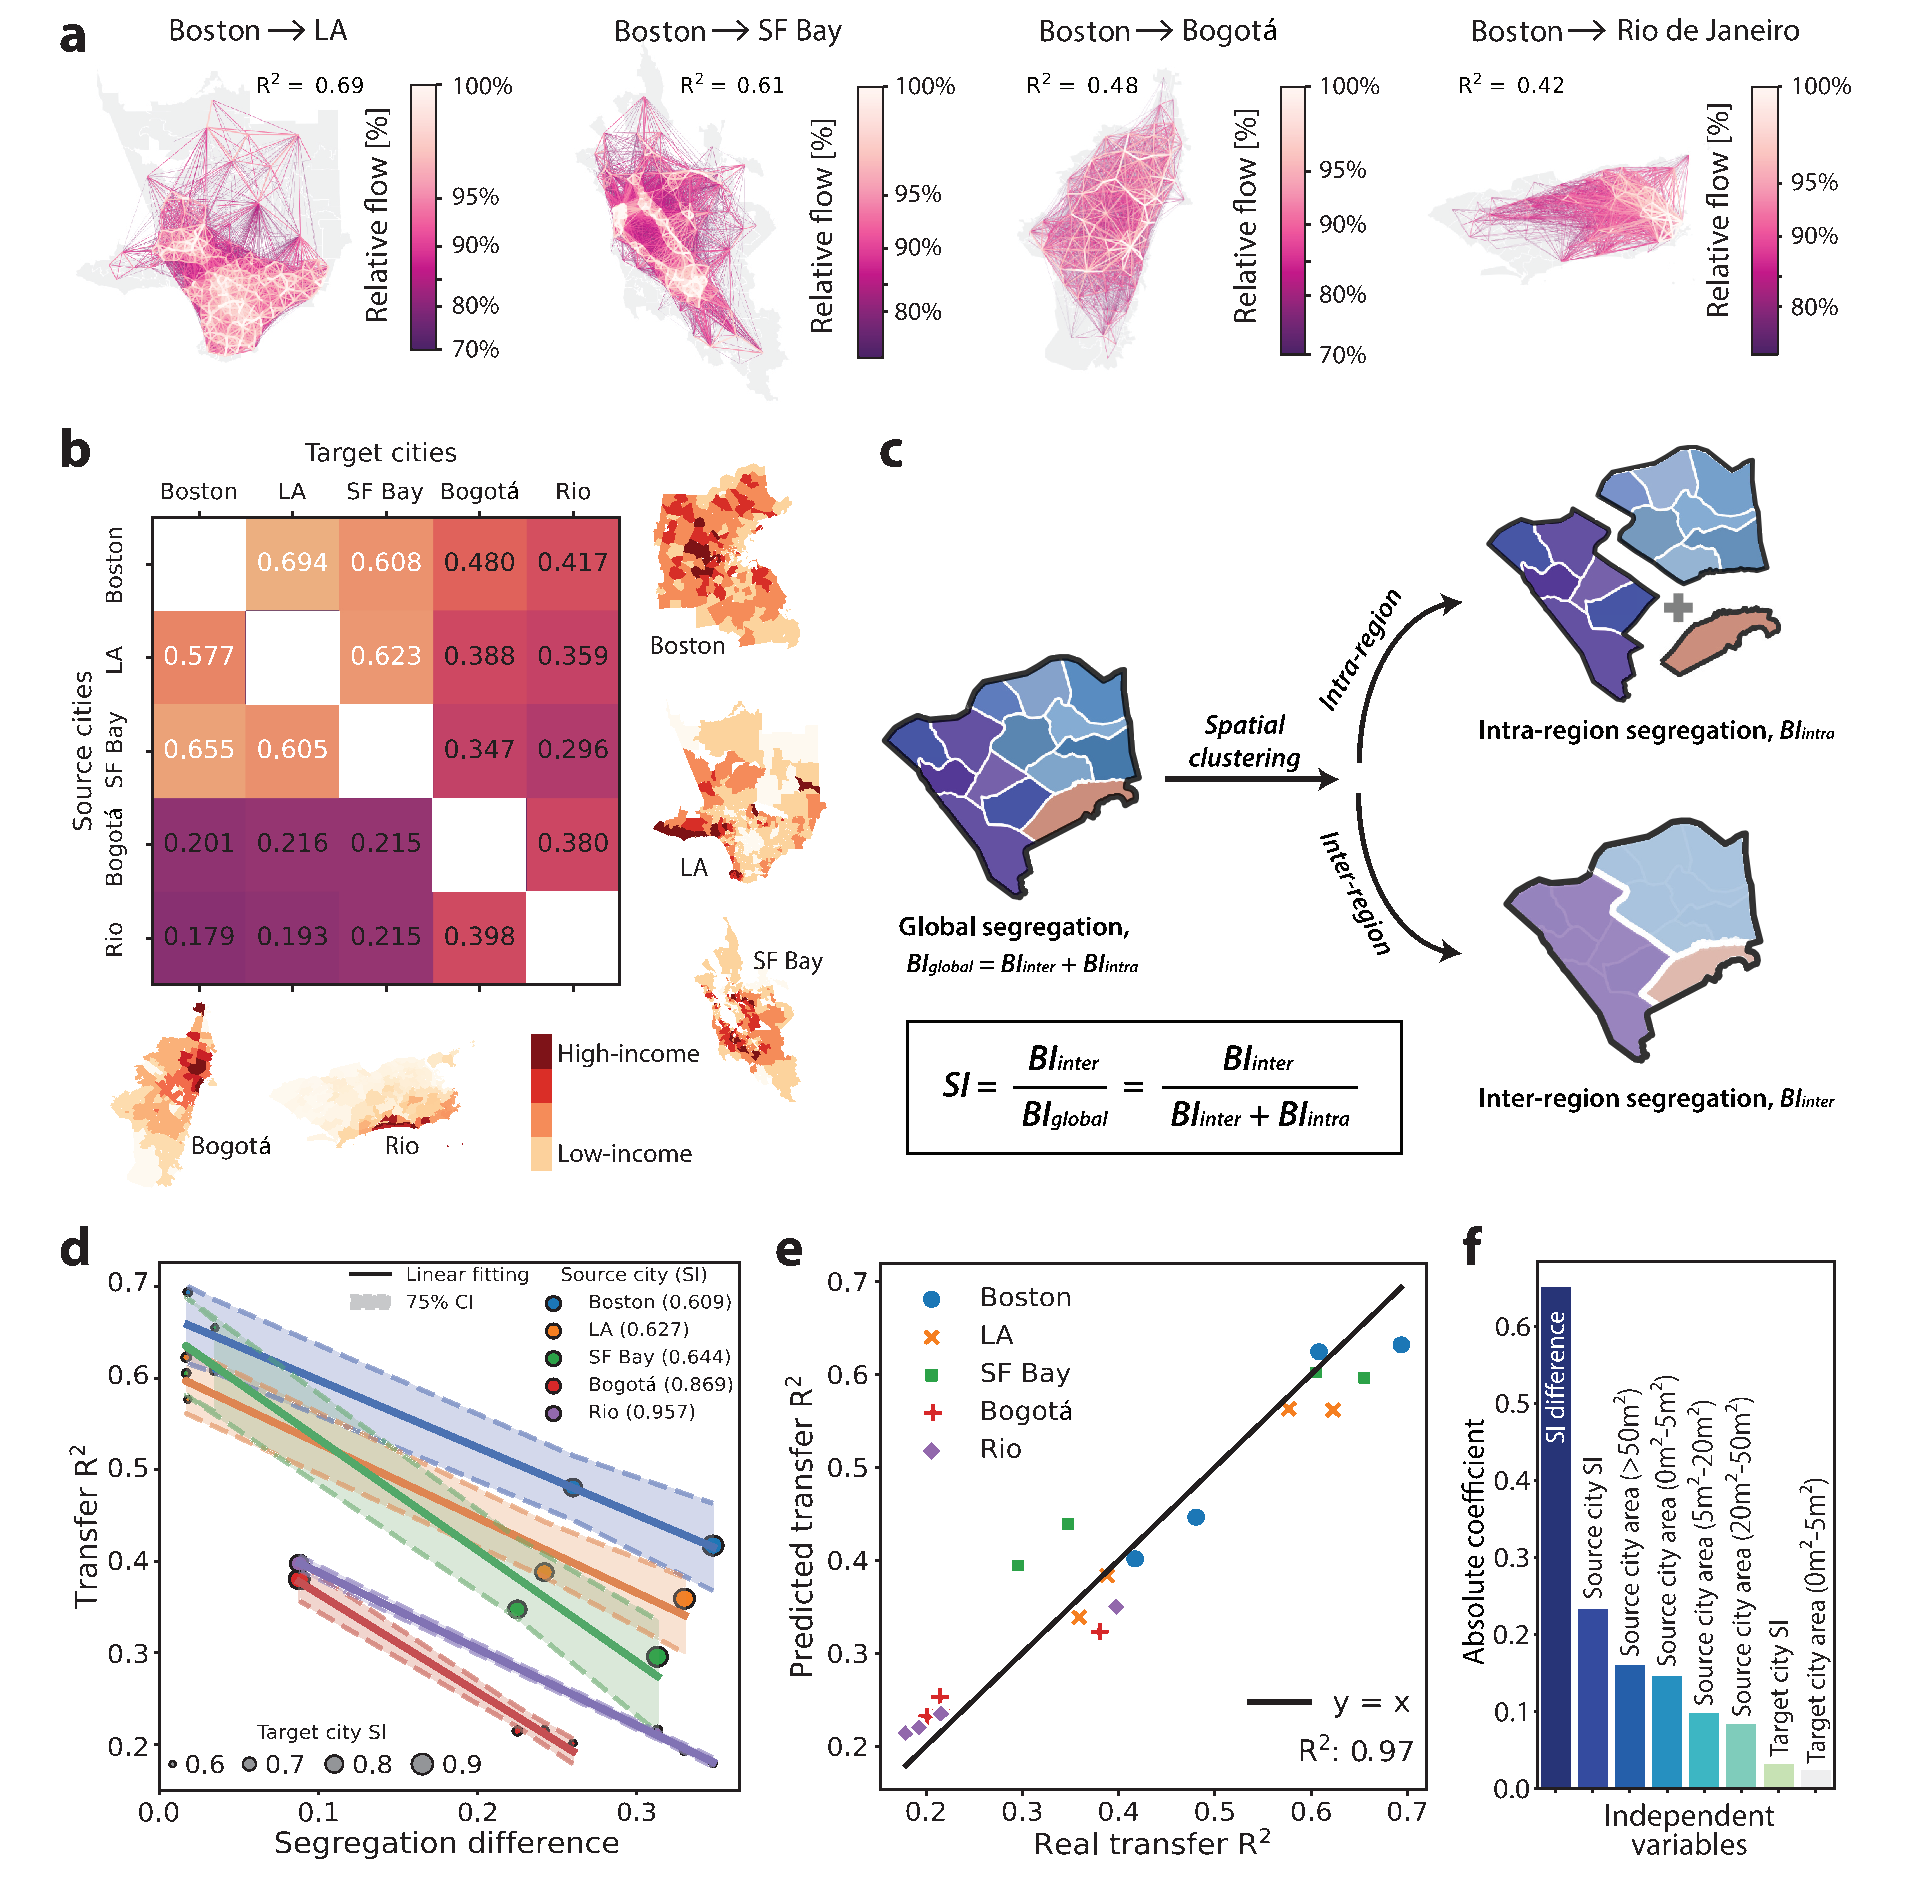
图 5|迁移不只是把模型搬过去,还取决于两座城市的相似之处。
- (a)波士顿模型在四座目标城市的生成网络;标注成绩采用全城总量校准。
- (b)五城定向迁移的 R² 矩阵与收入地图,行是源城市,列是目标城市。
- (c)SI 的分解示意:把相邻且收入接近的区域合并,区分区域内部与区域之间的差异。
- (d)横轴是两城 SI 差距,纵轴是迁移 R²;每条线对应一个源城市的四个目标城市。
- (e)线性回归估计的迁移 R² 与实际迁移 R² 对照,0.97 是这组回归的拟合优度。
- (f)回归中八个变量的系数绝对值;SI 差距最突出,但系数排序不是因果证明。
来源:原论文 Fig. 5。
从实验走向缺数据的城市,还差哪一步?
研究已为全球 1,200 多座城市和地区生成出行网络代理数据,并用生成网络驱动洛杉矶、旧金山湾区的易感—潜伏—感染—康复(SEIR)模拟。与使用参考出行网络的模拟相比,neuroGravity 更接近相应的传播曲线和空间格局。这是在相同模型条件下比较不同出行输入,不是对真实疫情的独立预测验证。
非洲调查提供了更接近缺数据情境的检验,也显示了困难。瓦加杜古及周边保留 930 份出行样本,赞比亚曼萨周边为 132 份;原调查记录过去一年至少住宿一晚的出行,与典型日城市出行并不完全同类。neuroGravity 对部分主要联系和排序有优势,但补充表 22、23 中的 R² 仍分别约为 −3.03 和 −0.69,不能说已经把这些地区的流量规模重建准确。
输入地图同样有边界。补充实验中的 30% 缺失,主要指 OSM 特征类别缺失,不是随意漏掉 30% 的建筑或居民。特征归一化和随机失活能缓解部分问题,却不能保证在贫困片区系统性漏标、交通方式差异很大或真实行为突变时仍然可靠。生成数据适合提供初始估计、提出假设和识别需要补充调查的位置;重要交通决策仍要结合当地验证。
一句话总结
neuroGravity 让人口与地图更有能力补全出行网络,也说明了一个实际问题:把模型带到另一座城市之前,既要看两城的空间社会结构是否相似,也要弄清哪些流量信息仍被用于校准和检验。
核心来源
- Yang, J., Huang, S., Huang, Z., Jin, Y., Yang, X., González, M. C. & Xu, Y. Transferable human mobility network reconstruction with neuroGravity. Nature Computational Science 6,630–641(2026)。
- 预印本全文与作者公开的补充材料。文中五张研究图来自原论文 Fig. 1—5;重建条件、总量校准和外部验证详见补充章节 5、6、7、8 及表 4、9、11、19、22、23。
- 官方代码与使用说明;全球估计网络数据。代码仓库中的示例流量为合成数据,原始手机数据并未公开。
作者介绍
- Jinming Yang:上海交通大学人工智能研究院及数据驱动管理决策实验室署名作者,与 Yanyan Xu 共同设计研究和模型,负责分析并参与写作。
- Shaoyu Huang:上海交通大学人工智能研究院署名作者,参与手机出行数据处理。
- Zongyuan Huang:上海交通大学人工智能研究院署名作者,参与手机出行数据处理。
- Yaohui Jin:上海交通大学人工智能研究院及数据驱动管理决策实验室署名作者,参与计算平台建设、研究指导,为通讯作者之一。
- Xiaokang Yang:上海交通大学人工智能研究院署名作者,参与计算平台建设与研究指导,为通讯作者之一。
- Marta C. González:加州大学伯克利分校及劳伦斯伯克利国家实验室署名作者,提供手机数据,参与分析讨论与写作。
- Yanyan Xu:上海交通大学人工智能研究院及数据驱动管理决策实验室署名作者,共同设计研究与模型,参与写作和指导,为通讯作者之一。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
这篇研究给交通数据采集带来的启发,可能不是少做多少调查,而是把有限调查放到哪里。若模型在某些区域反复预测失准,这些地方可能恰好具有地图没记录的工作机会、非正式交通或社会边界。与其只在已有数据丰富的中心区继续补样,不如把模型的不确定性与弱势群体的服务需求放在一起,优先调查最可能被忽略的联系。
同时,收入空间隔离既能帮助选择迁移源城市,也可能成为值得干预的城市问题。若交通规划把预测网络直接当成理想需求,就可能继续强化现有隔离。重建人们目前怎样出行,与判断他们应该获得怎样的可达性,是两个需要分别回答的问题。