刚走过的路口,加上以前的活动链,这次终点能近多少?
论文名片|Xiaotong Zhang、Zhipeng Gui、Yuhang Liu、Dehua Peng、Qianxi Lan、Zhangxiao Shen、Huan Chen、Yuhui Zuo、Yao Yao、Huayi Wu、Kai Li、Kun Qin,Individual mobility prediction by considering current traveling features and historical activity chain,Geo-spatial Information Science,2025年2月4日在线发表。DOI:10.1080/10095020.2025.2455005。收稿日期 2024年9月3日,接受日期 2025年1月13日。文内注明最初发表有误,网上版本已更正,更正说明 DOI:10.1080/10095020.2025.2470548。下面的数字来自这份带更正提示的在线发表 PDF。这是一项针对私家车未完成行程的目的地坐标预测研究。
从单位停车场开出来,车才过了几个路口。速度在降,下一个转弯还没发生。只看这一小段,家、超市和另一个常去的地方都还说得通。若把前几天每次行程的出发地、到达地和大致活动类型接成一条链,有的傍晚行程会更像回家,有的仍然像临时起意。
这项研究预测的是私家车这次行程的终点经纬度,而且要在车还没到的时候,随着已走比例不断更新。它把当前行程特征和历史活动链放进同一个模型。在深圳 2019 年 20 位出行者的行程上,这个模型的平均终点误差低于四个对照。下降幅度随特征和人群而不同:当前路口上的运动状态和路口关联贡献更大,历史链有帮助但更有限;链长会改变误差,不常去的终点仍然更难。
先说结论
- 摘要中的实验样本是 20 位出行者的 21,890 条轨迹,他们从 1,916 名深圳私家车出行者中按聚类各抽 1 人。完整模型的平均终点误差为 MAE 760.362 米、RMSE 1,438.317 米、MRE 20.86%。相对最接近的深度对照 ITP-CMM,MAE 和 RMSE 约降 12%;相对 LSI-LSTM,MAE 约降 37.9%,MRE 只从 20.99% 降到 20.86%。摘要写的约 10%–15% 不能覆盖每一格。
- 只使用坐标时,平均 MAE 是 1,398.025 米。单独加入当前行程特征后降到 879.745 米,相对下降 37.1%。单独加入历史活动链后降到 1,164.468 米,相对下降 16.7%。两套消融互相独立,不能把两个降幅相加。
- 历史链长度试了 5、10、15、25、30、40 次行程。20 人的平均 MAE 在链长 5 到 15 时落在 747.263 米到 760.234 米。链长 25 时,低频访问比例最高的那一组,组平均 MAE 达到各长度中的最大值 1,706.047 米。
- 终点按 200 米、至少 10 个点的聚类分成常去与不常去。常去终点的误差更低。四位出行者的访问次数与 MAE 都呈负相关,Pearson r 为 −0.187、−0.124、−0.235、−0.519,对应 R² 只有 0.035、0.015、0.055 和 0.270。访问次数解释不了大部分误差。
未完成的这次车程,预测的是哪一个点?
个体移动预测(individual mobility prediction)在这里有一个很窄的任务:给定一条还没走完的子轨迹,输出这次行程终点的经纬度,并让预测点与真实终点的距离尽量小。它不预测明天会去的一串地点,也不把人在城市之间的搬家算进来。私家车轨迹记录的是开车行程,步行、公交和没有被这套设备记下来的活动都不在里面。
已走部分越短,当前几何能区分的终点就越少。历史活动链(historical activity chain)因此只保留以往行程的起点、时间和出行意图,不再把历史行程里每个路口的速度、转角塞进来。当前行程则相反,保留已经经过的路口,因为这些路口还在告诉模型车正在往哪一边转。
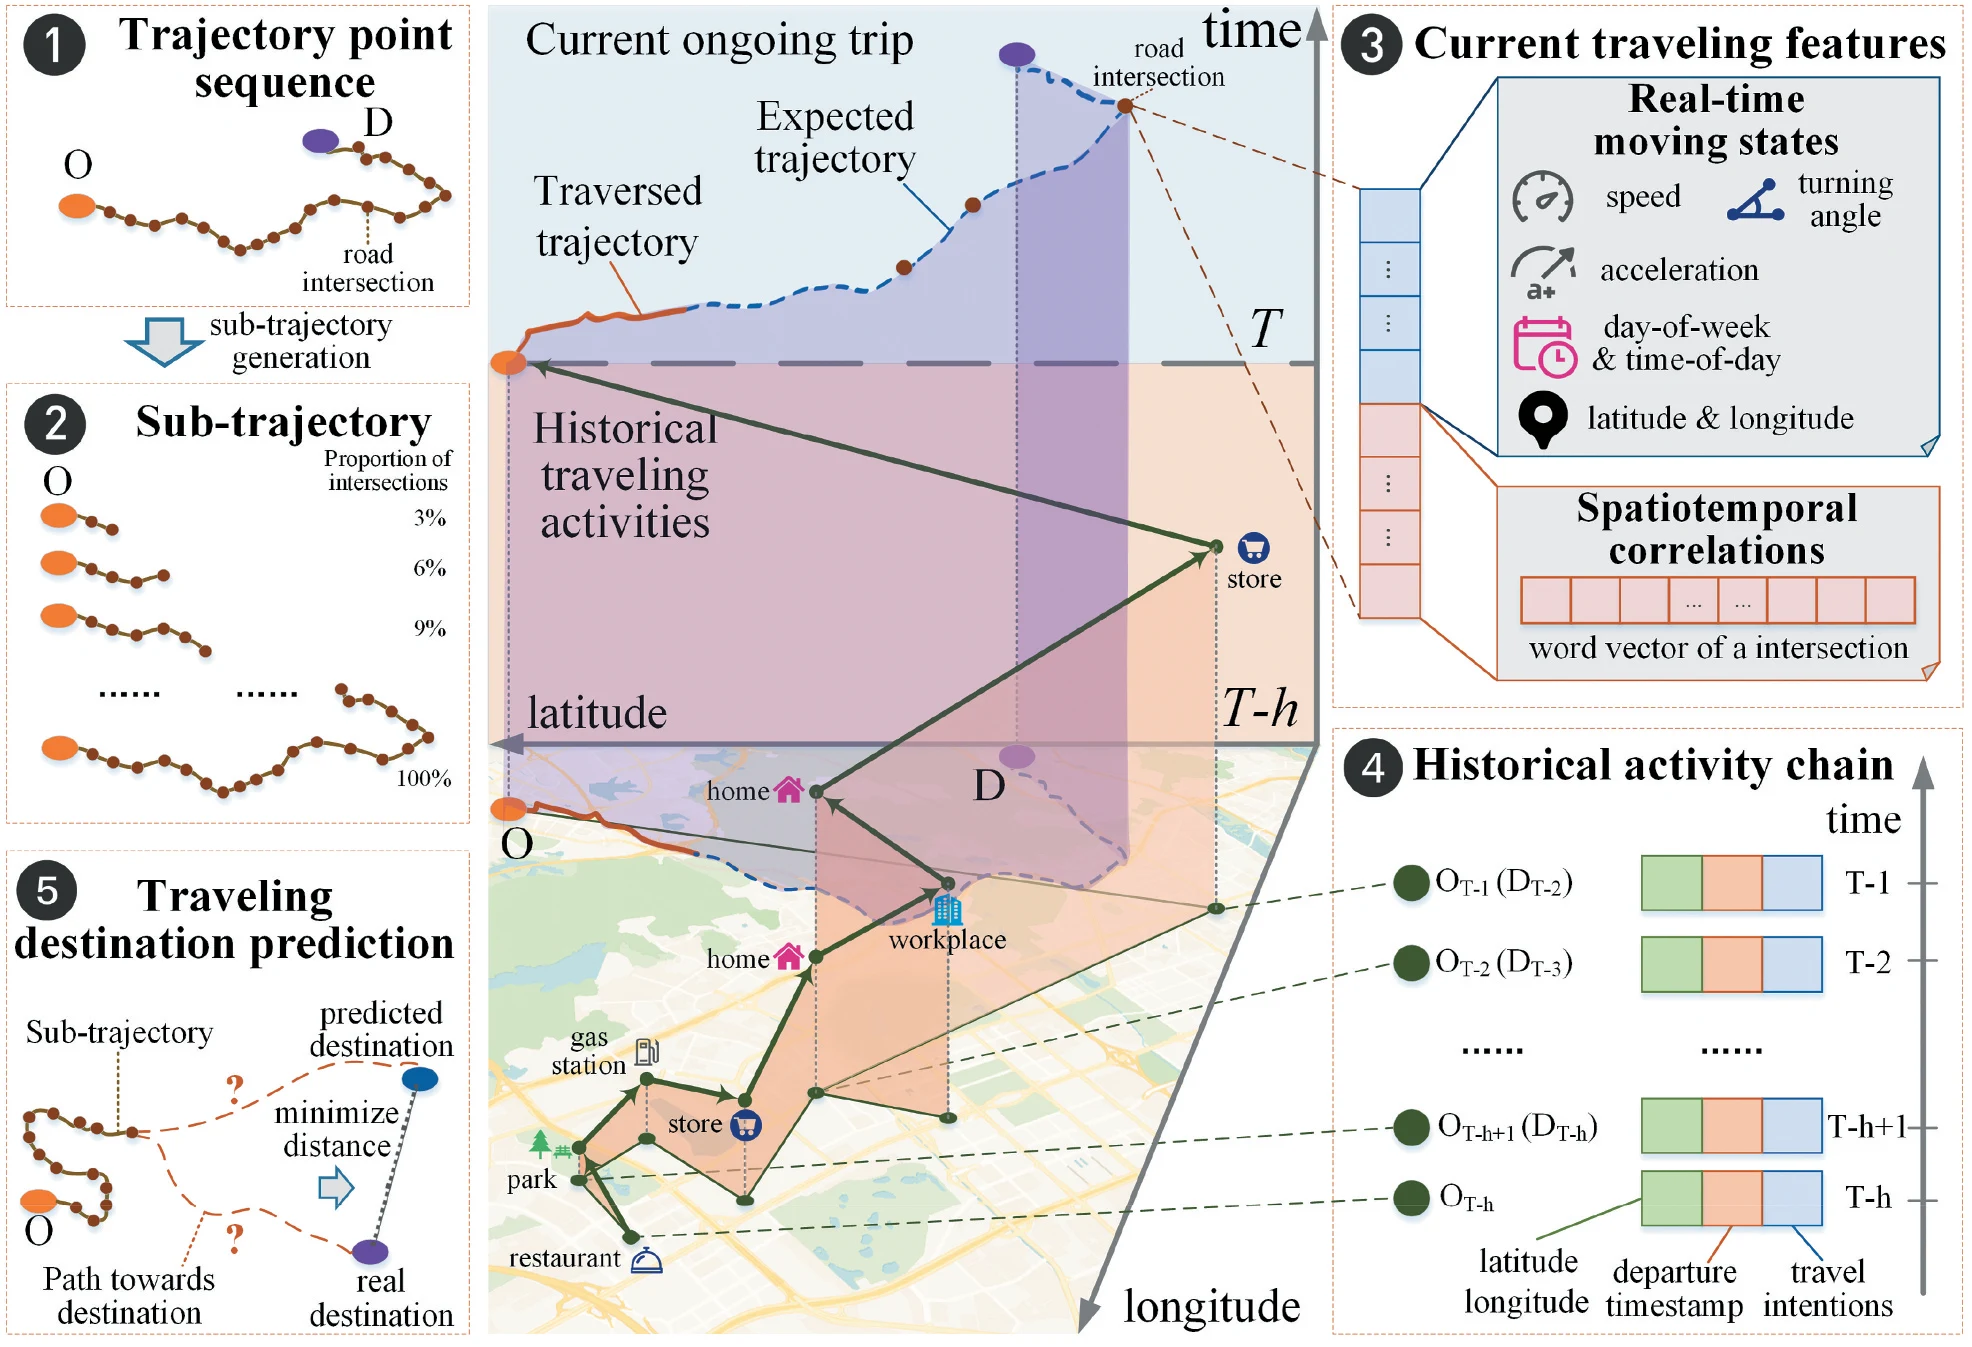
图 1|这次预测到底拿哪些信息去对终点?
图中按 1 到 5 编号。(1)一条完成行程从起点 O 到终点 D,中间只保留落在路口的点。(2)子轨迹从 O 往前生长,示意比例为 3%、6%、9% 直到 100%,对应实验里每次增加约 3% 轨迹点。(3)当前行程特征分成实时运动状态和路口的词向量。(4)历史活动链按时间往回看 T−1 到 T−h,每一步带经纬度、出发时间和出行意图;前一次行程的终点被画成下一次的起点。(5)预测目标是让预测终点靠近真实终点。这是任务示意图。来源:原论文 Fig. 1。
20 个人、一年、一座城市,误差是相对谁算的?
数据是一套匿名私家车 GPS。2019 年 1 月 1 日至 12 月 31 日,深圳 1,916 名出行者留下超过 50 万条轨迹。摘要写明实验用的是其中 20 位代表、共 21,890 条轨迹。21,890 除以 20 约等于每人 1,094.5 条,这只是平均数,论文没有给出每人的条数。因为原始轨迹超过 50 万条,这 21,890 条不到原始规模的 4.4%。
代表不是从 1,916 人里简单随机抽的。出行时长不足一个月的人先被排除,论文没有写出排除后还剩多少人。随后用起讫点熵 EOD、平均出行距离 TDavg 和低频访问地点比例 RIVL 做 DBSCAN,得到 20 个簇,每簇随机抽 1 人。RIVL 是一个人在居住、工作和常去地点之外活动的倾向。再按 RIVL 从高到低做自然断点,分成(I)(II)(III)(IV)四组,人数为 2、6、8、4。这 20 人覆盖了作者得到的不同活动类型,不能当成深圳驾车者的随机样本,也不能推出全体居民。
路网来自 2018 年高德的深圳建成区,兴趣点是 2019 年的 334,831 条,分餐饮、医疗、居住、酒店、生活服务、旅游景点、教育和公司八类。轨迹是 2019 年的,路口却来自前一年的路网。论文没有报告有多少点因为道路变化而匹配失败。
清洗规则写得很具体,删掉的数量没有写。速度超过 120 km/h 的轨迹点被去掉;含有研究区以外点的轨迹被整段排除;原始点数少于 10 的轨迹不进入后续处理。终点先做 DBSCAN,邻域 200 米、最少 10 个点。簇中心算常去终点,噪声点算不常去终点。这里的“常去”是聚类结果,不是“访问次数高于中位数”。
完成的轨迹按 3:2 随机分成 Ptrain 和 Ptest。子轨迹按约 3% 的点逐步变长。Ptrain 的全部子轨迹进入训练。Ptest 里完整度低于 60% 的子轨迹也进入训练,其余才作为测试。因此,一条测试行程在走到 70% 时,它自己的前 60% 已经参与过训练。终点坐标不一定出现在那前 60% 里,但这段行程的前半几何并没有被完全留出。常去与不常去的聚类也用了全部行程,发生在划分之前。表 1 的米数是这种划分下的终点误差,不是“整段新行程从未进入训练”的误差。
评价指标有三个,分母不同。MAE 和 RMSE 的单位是米,衡量预测终点与真实终点的欧氏距离,也就是地图上的直线距离,不是沿路里程。MRE 把每一次的距离误差除以该次行程的总出行距离,再取平均,所以它可以超过 100%。随机森林的平均 MRE 为 411.57%,也就是终点误差平均约为行程总出行距离的 4.12 倍。训练时最小化的是坐标上的平均绝对误差加一个正则项;实验设置没有给出正则系数的取值。表里的米来自评价阶段的直线距离。
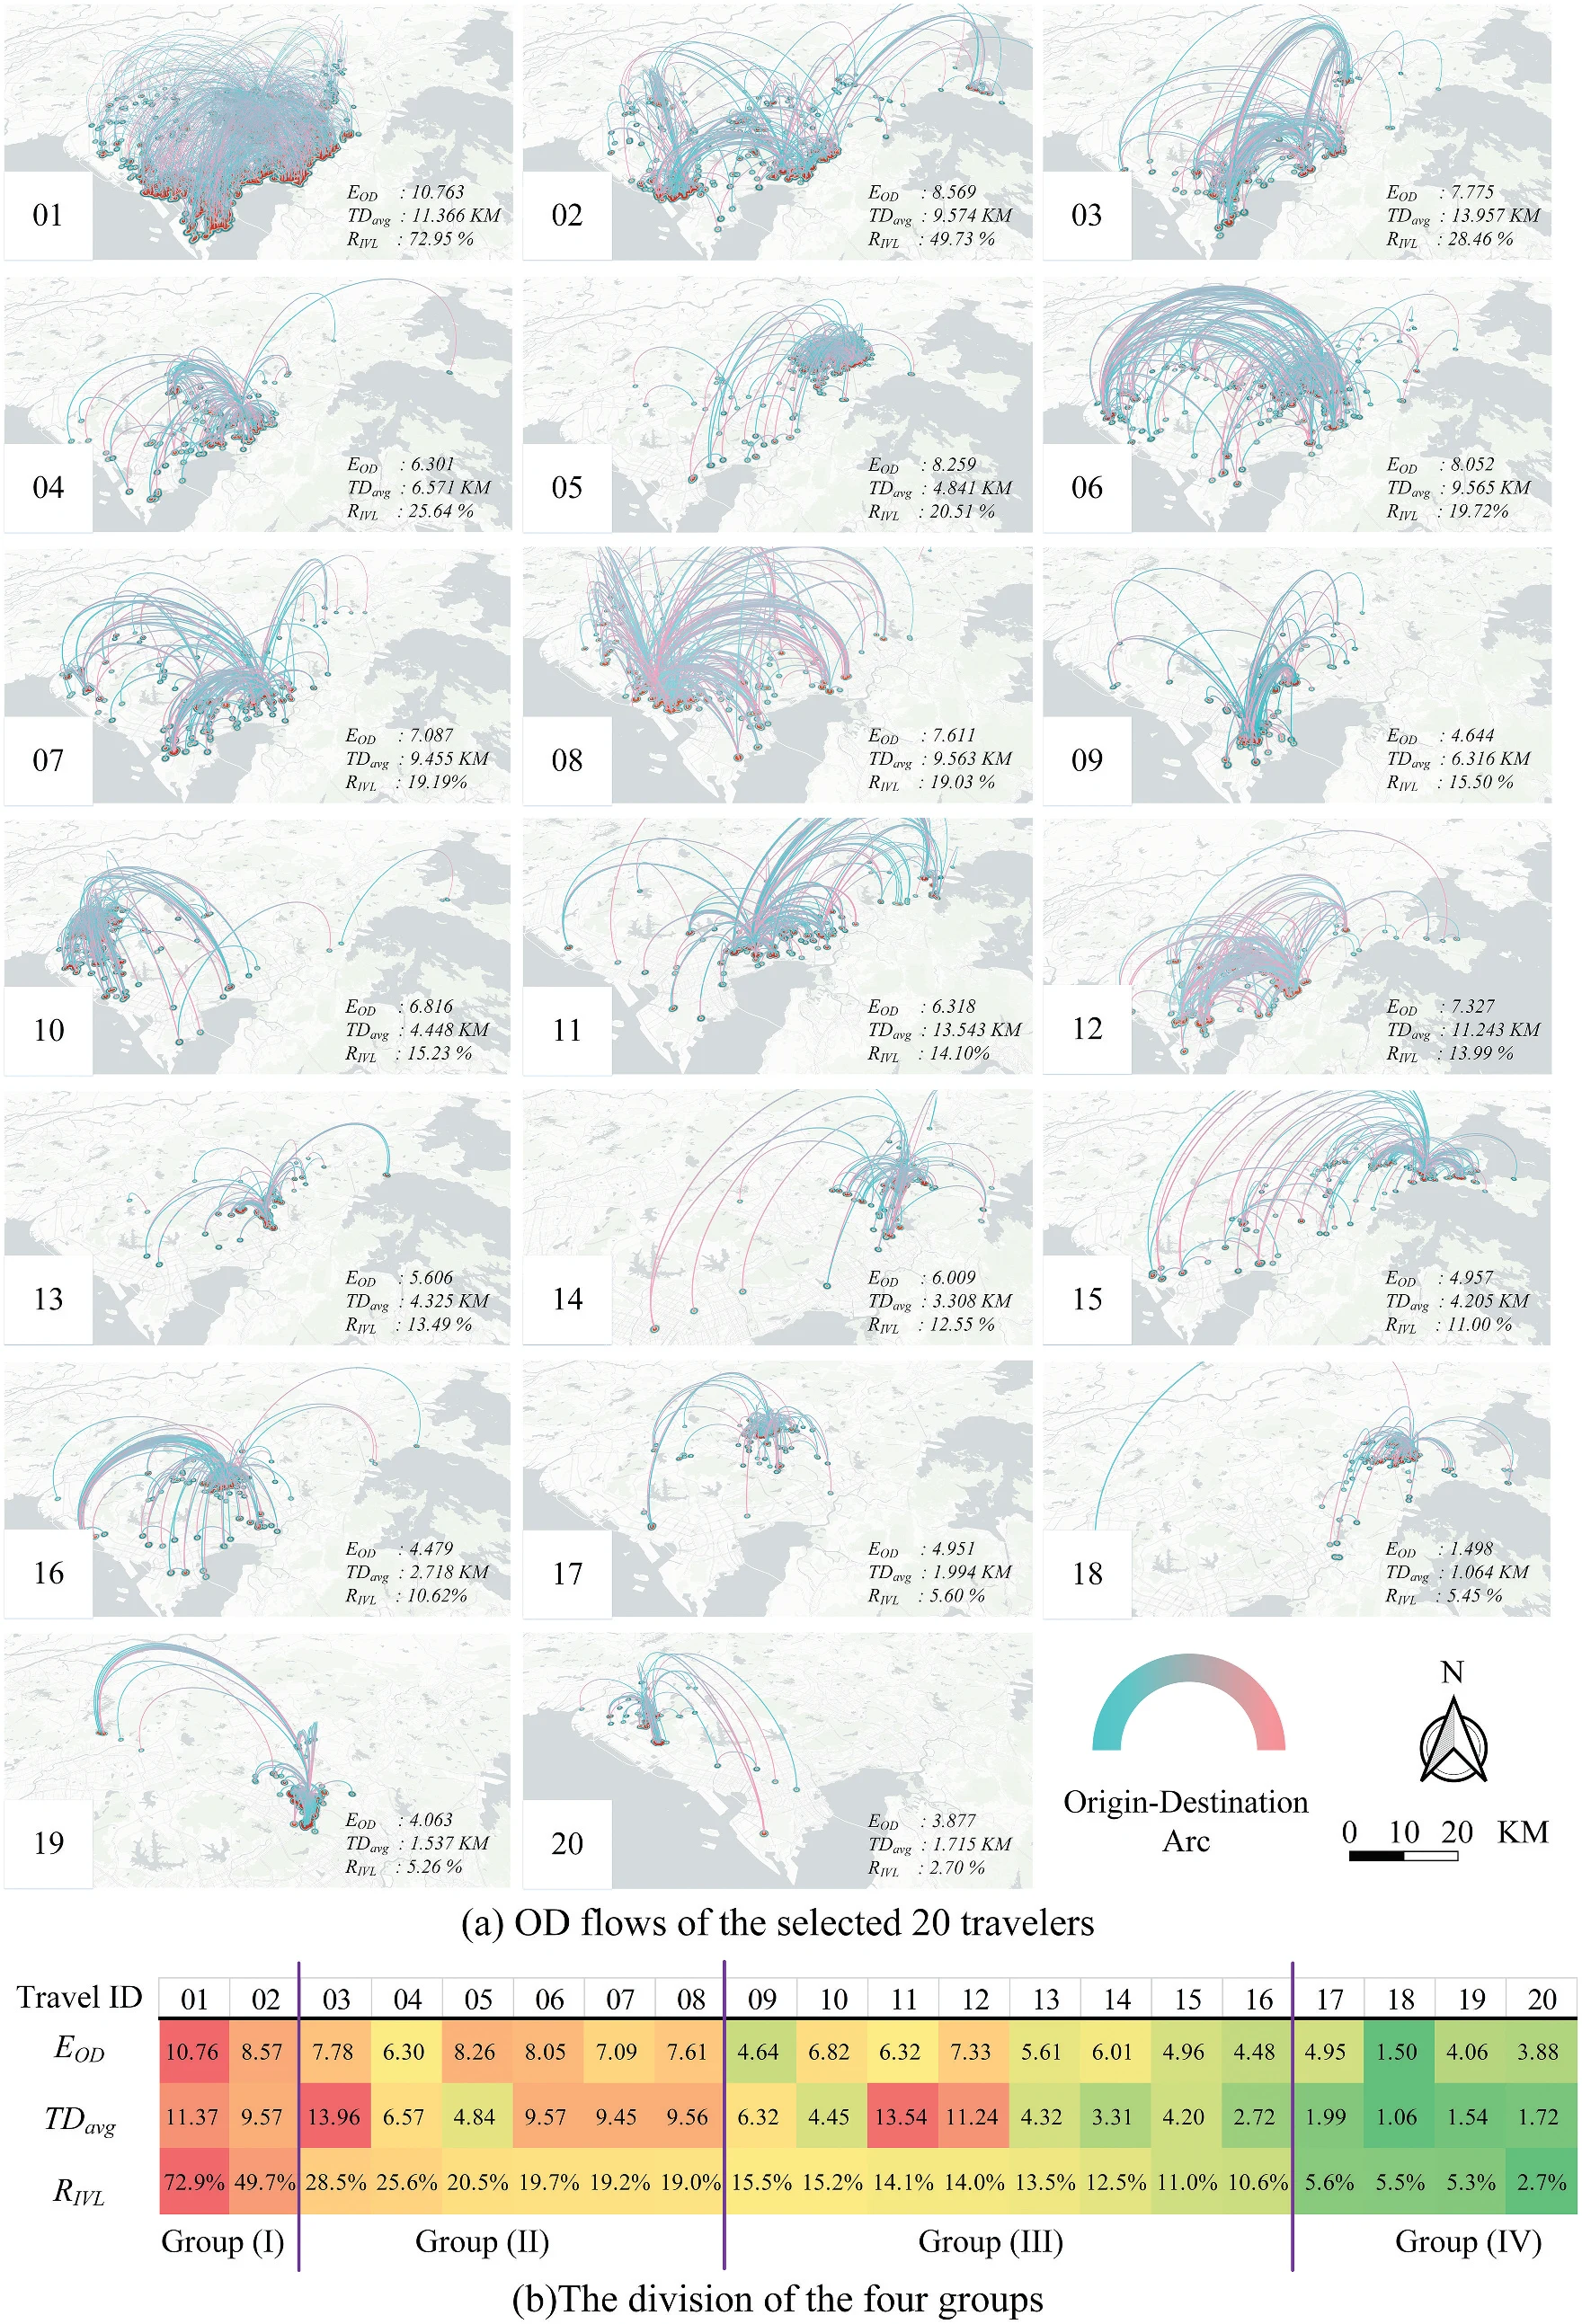
图 7|这 20 个人的活动范围一样吗?
(a)20 位出行者在 2019 年全年的起讫弧线,蓝到红表示流量由低到高,每幅小图标注 EOD、以公里为单位的平均出行距离和 RIVL。弧线疏密和跨度相差很大。(b)同一批指标排成热力表,出行者按 RIVL 从高到低分成四组,红高、绿低。三个指标大体同向,但并不重合;正文举的例子是 11 号平均出行距离高、RIVL 却只处于中等。小图上的逐人数字以图为准,后文只使用正文写明的比较。来源:原论文 Fig. 7。
当前路口和历史活动链,各自交给模型什么?
模型分三块。当前运动模式看这条还没走完的行程;历史运动模式看此前若干次行程的链;两边的表示拼在一起,经残差层输出经纬度。实时运动状态、路口关联和出行意图被做成 12 维、3 维和 5 维向量。
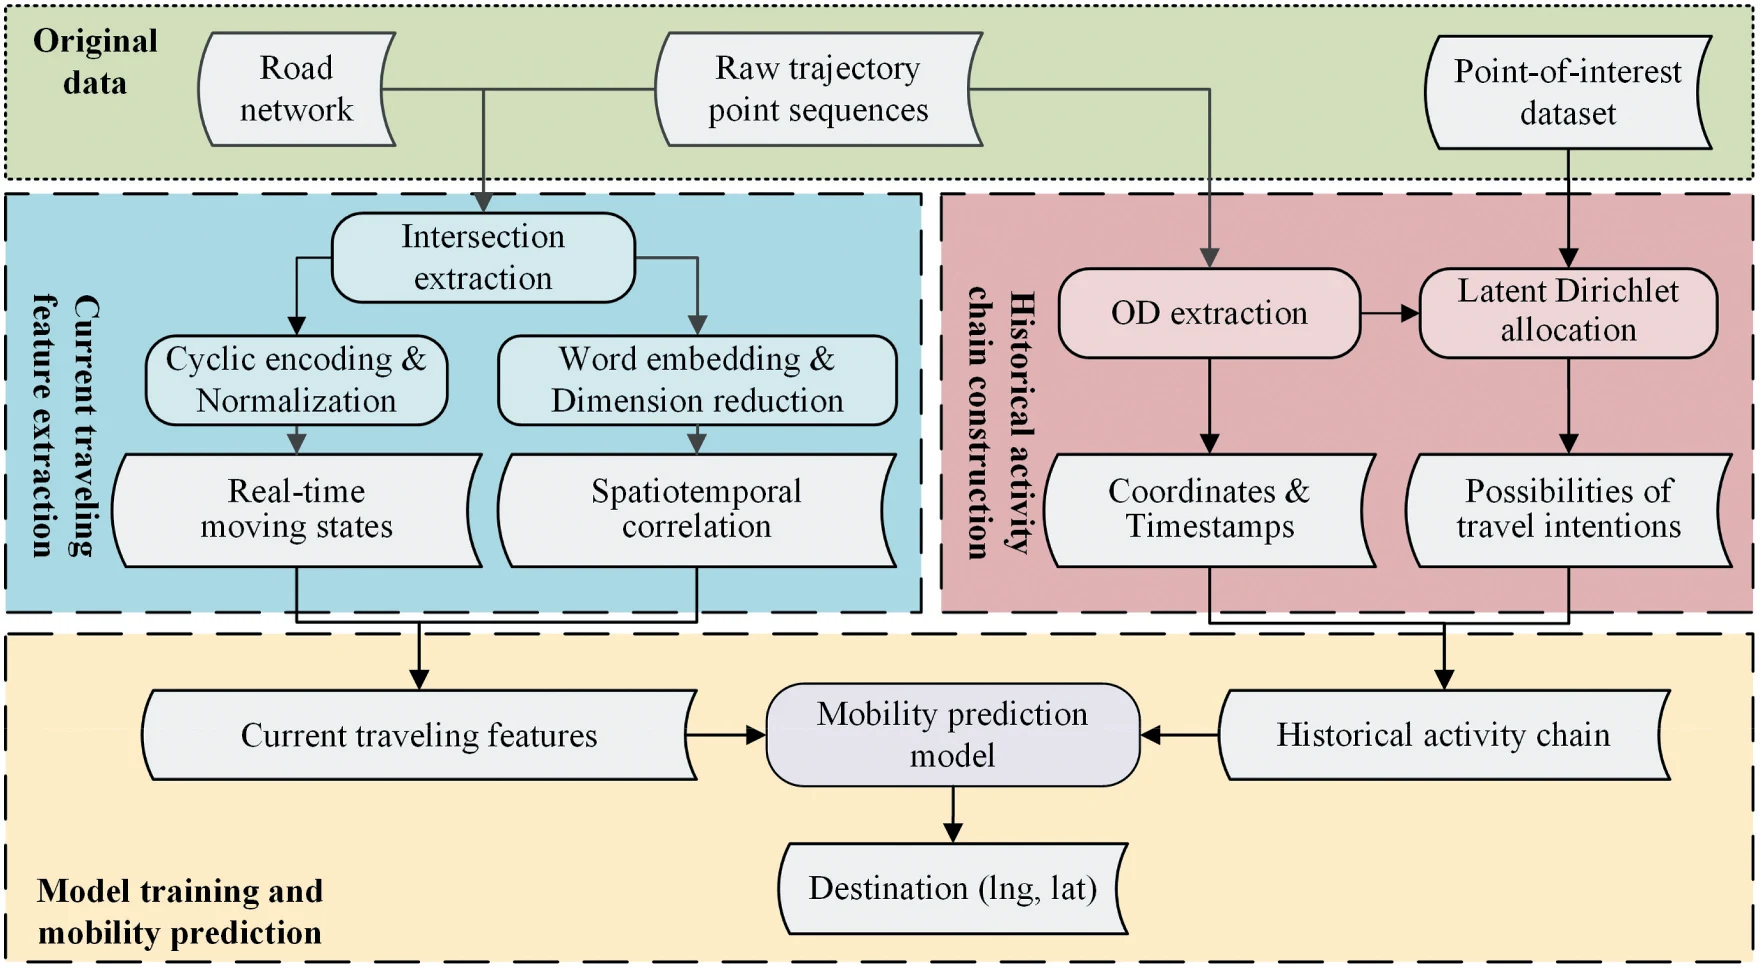
图 2|三条数据怎样汇成一个终点坐标?
无字母分块。上方是路网、原始轨迹和兴趣点。左侧蓝色支路从路口提取实时运动状态和时空关联,合成为当前行程特征。右侧红色支路从历史行程提取坐标、时间,并用 LDA 得到出行意图,合成为历史活动链。下方模型同时接收两边,输出终点经纬度。来源:原论文 Fig. 2。
实时运动状态(real-time moving states,RMState)描述车开到当前路口时的状况:经纬度、从起点累计的路网距离、上一路段平均速度、转角、已用时间和加速度,再加上星期与一天中的时刻。星期记为 0 到 6,周日到周六。一天切成 48 个半小时。整数会让周六和周日相差 6,所以再用正弦和余弦把周期绕起来。论文写这些量用 Z-Score 缩放到 [−1, 1]。
路口时空关联(spatiotemporal correlation,STCorrelation)处理的是另一件事。同一对起终点,不同的人可以在中间路口左转、右转或直行。论文把一位出行者经过的路口当成词,把一条轨迹当成句子,用连续词袋(Continuous Bag-of-Words,CBoW)学习路口向量,再用 t-SNE 压到 3 维,避免高维向量盖过坐标和时间。文中举例,一位出行者全年遇到 2,435 个路口,词表就是这 2,435 维。上下文窗口的具体长度没有给出。
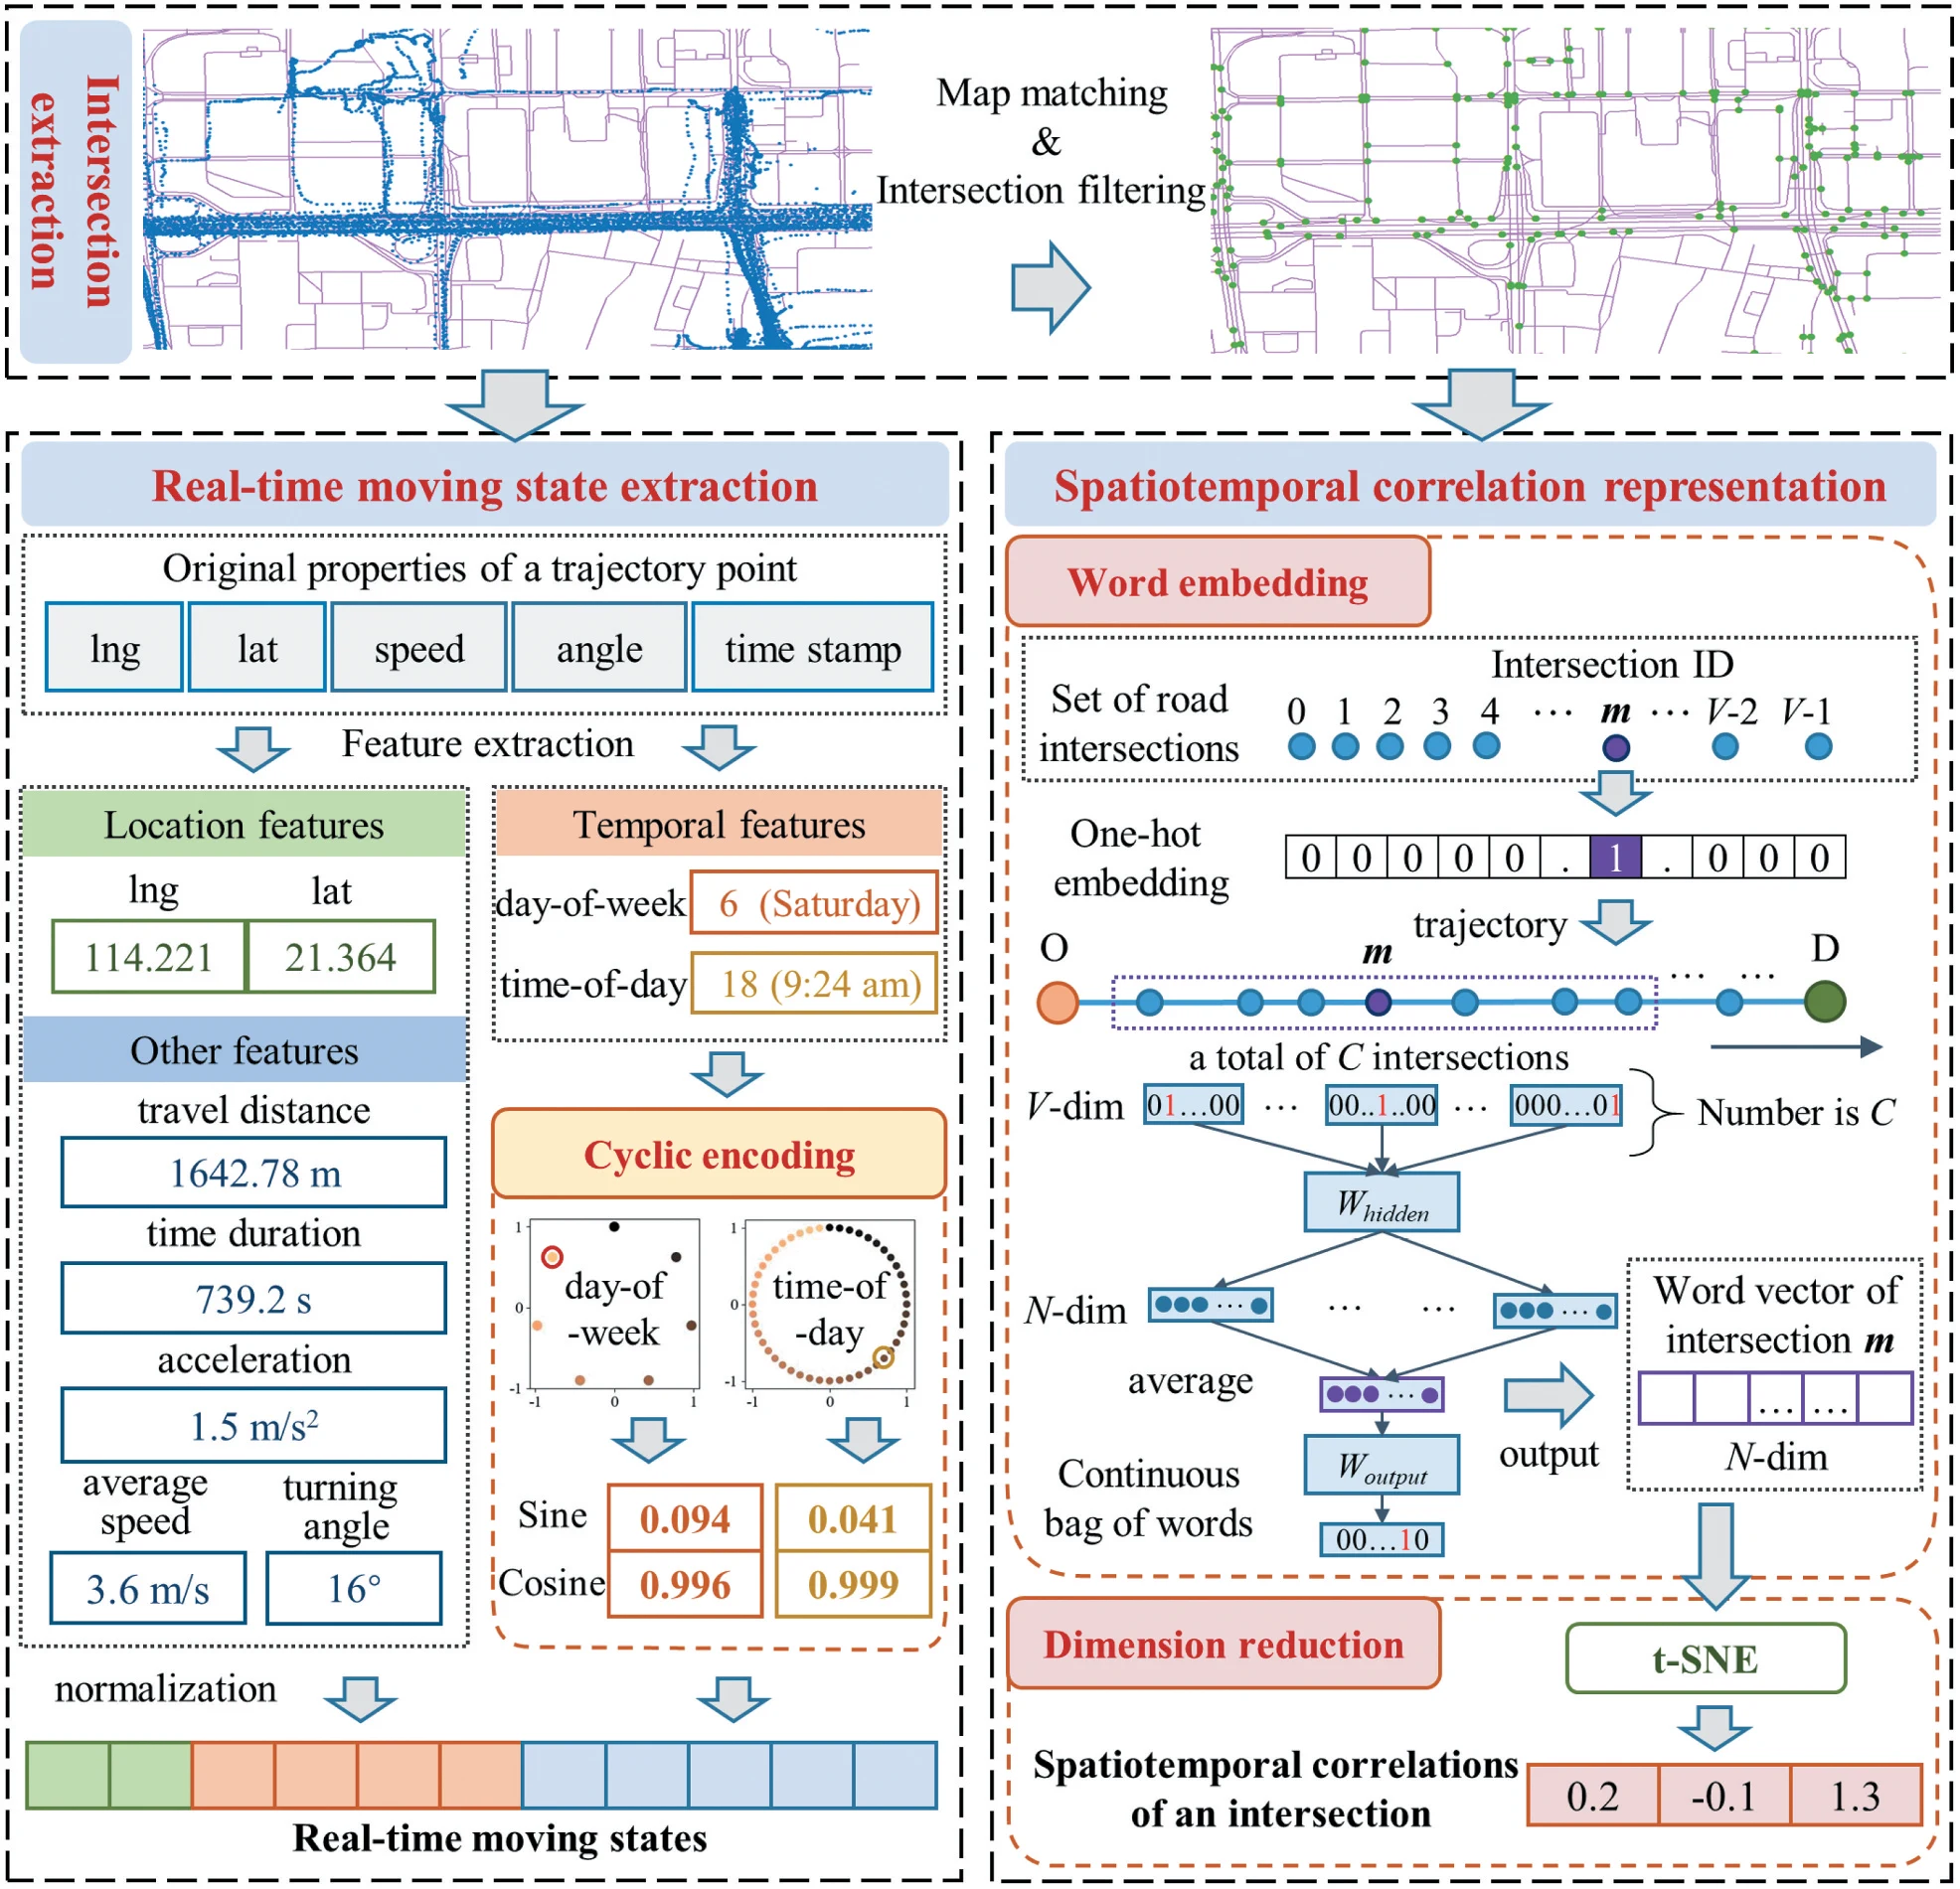
图 3|一个路口点怎样变成两类当前特征?
无字母分块,图中的坐标、速度和概率样式数字是流程示例,不是实验结果。上排把原始点匹配到路网,只留下路口。左列把位置、时间和速度、转角等运动量做成实时运动状态,星期与时刻走正弦、余弦。右列把路口做成独热向量,用连续词袋得到词向量,再降成 3 个数。来源:原论文 Fig. 3。
历史链上的出行意图(possibilities of travel intentions,PTIntention)不是问卷里的“我要去上班”。目的地被放进 1,000 米网格,格内八类兴趣点的数量被当成一篇文档里的词,LDA 给出 5 维意图向量。模型输入写明这是 5 维。附录给出了算法骨架,没有把主题数以外的先验取值列进实验设置。历史链因此是一串“以前某次行程的起点坐标、出发时间、5 维意图”,长度记为 T。
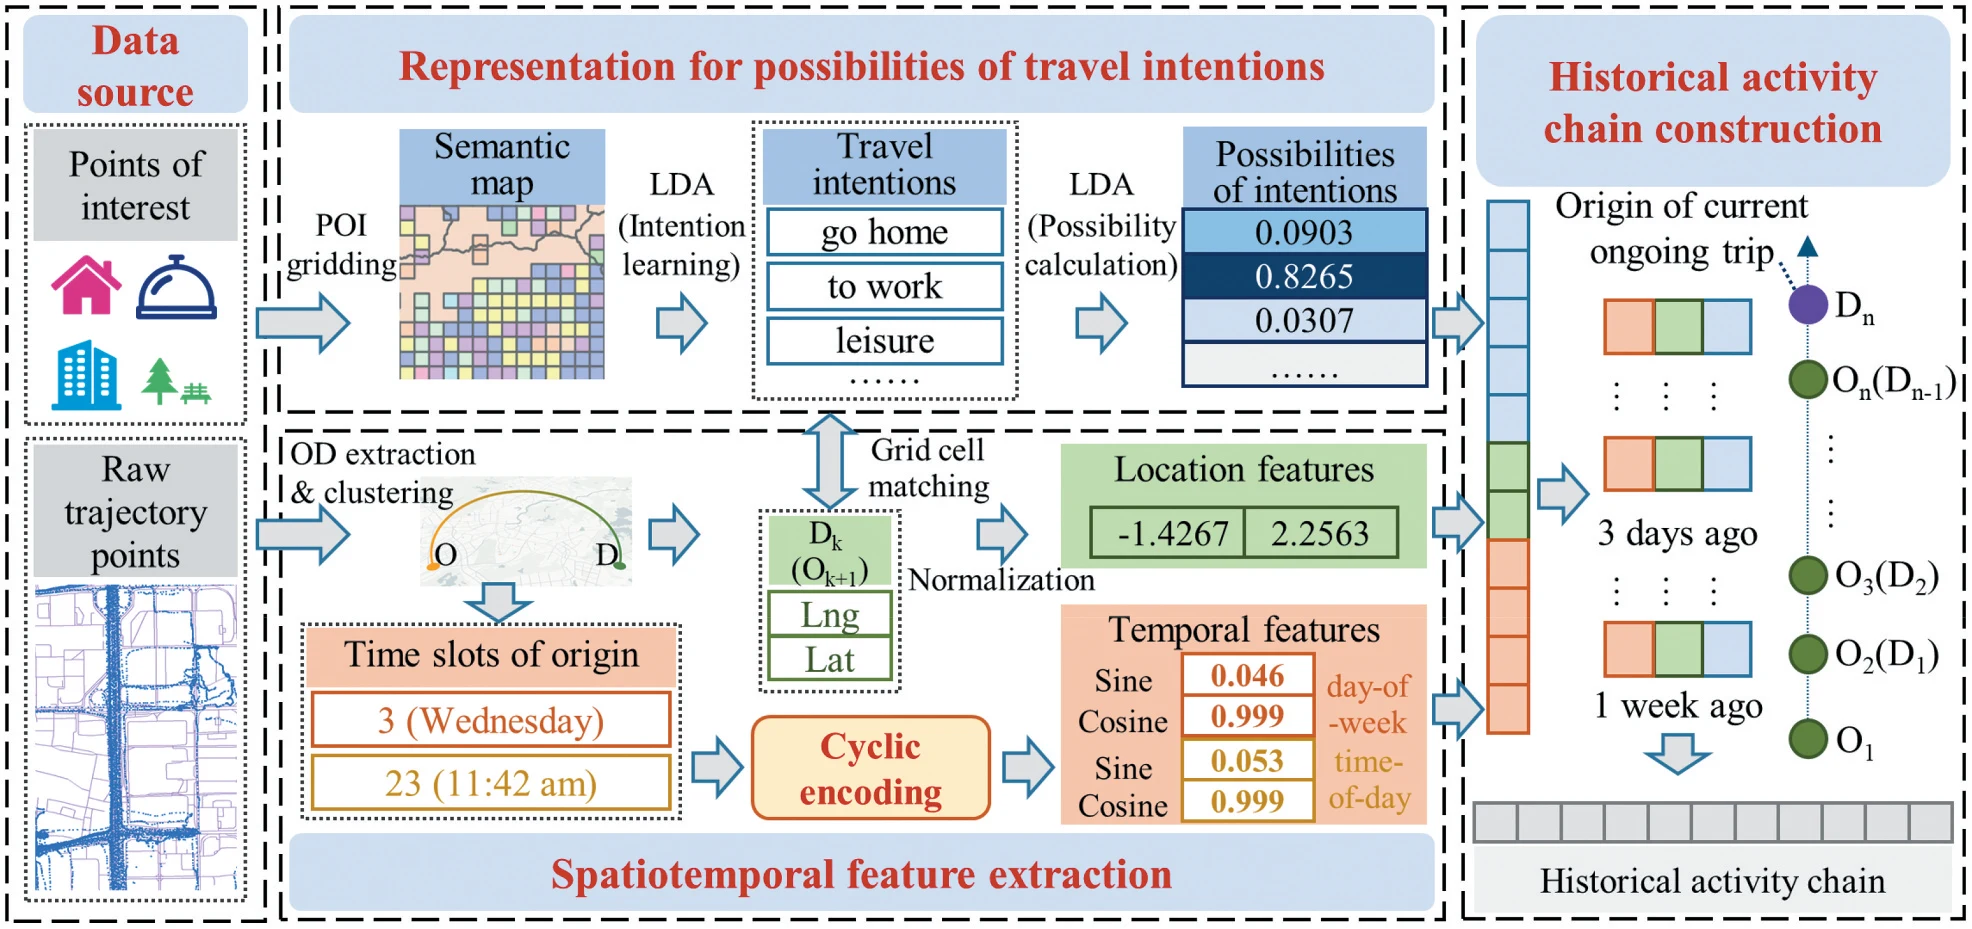
图 4|历史行程怎样被压成一条链?
无字母分块,图中的意图分量和归一化坐标是示意。左侧进入兴趣点和原始轨迹。中间上支把网格里的兴趣点经 LDA 变成意图向量;下支保留起点的经纬度,并把星期、时刻做成正弦余弦。右侧按时间把这些向量接起来,靠近当前行程的历史点在上。来源:原论文 Fig. 4。
当前分支用两套各两层的 LSTM,分别读运动状态和路口关联,交叉后按转角、累计距离和历时打分,得到当前运动模式。历史分支用双向 LSTM 读整条链。时间评分计算当前行程与某次历史行程在星期、时刻上的正弦差和余弦差,再取倒数,得到 4 个分数,让出发时刻更接近的历史行程权重大。两路表示拼接后进入残差全连接层。隐藏层宽度 128,CBoW 隐藏层 256。优化器用 Adam,学习率 0.001,训练 80 轮,批大小 32。主实验使用的历史链默认长度,正文没有单列。
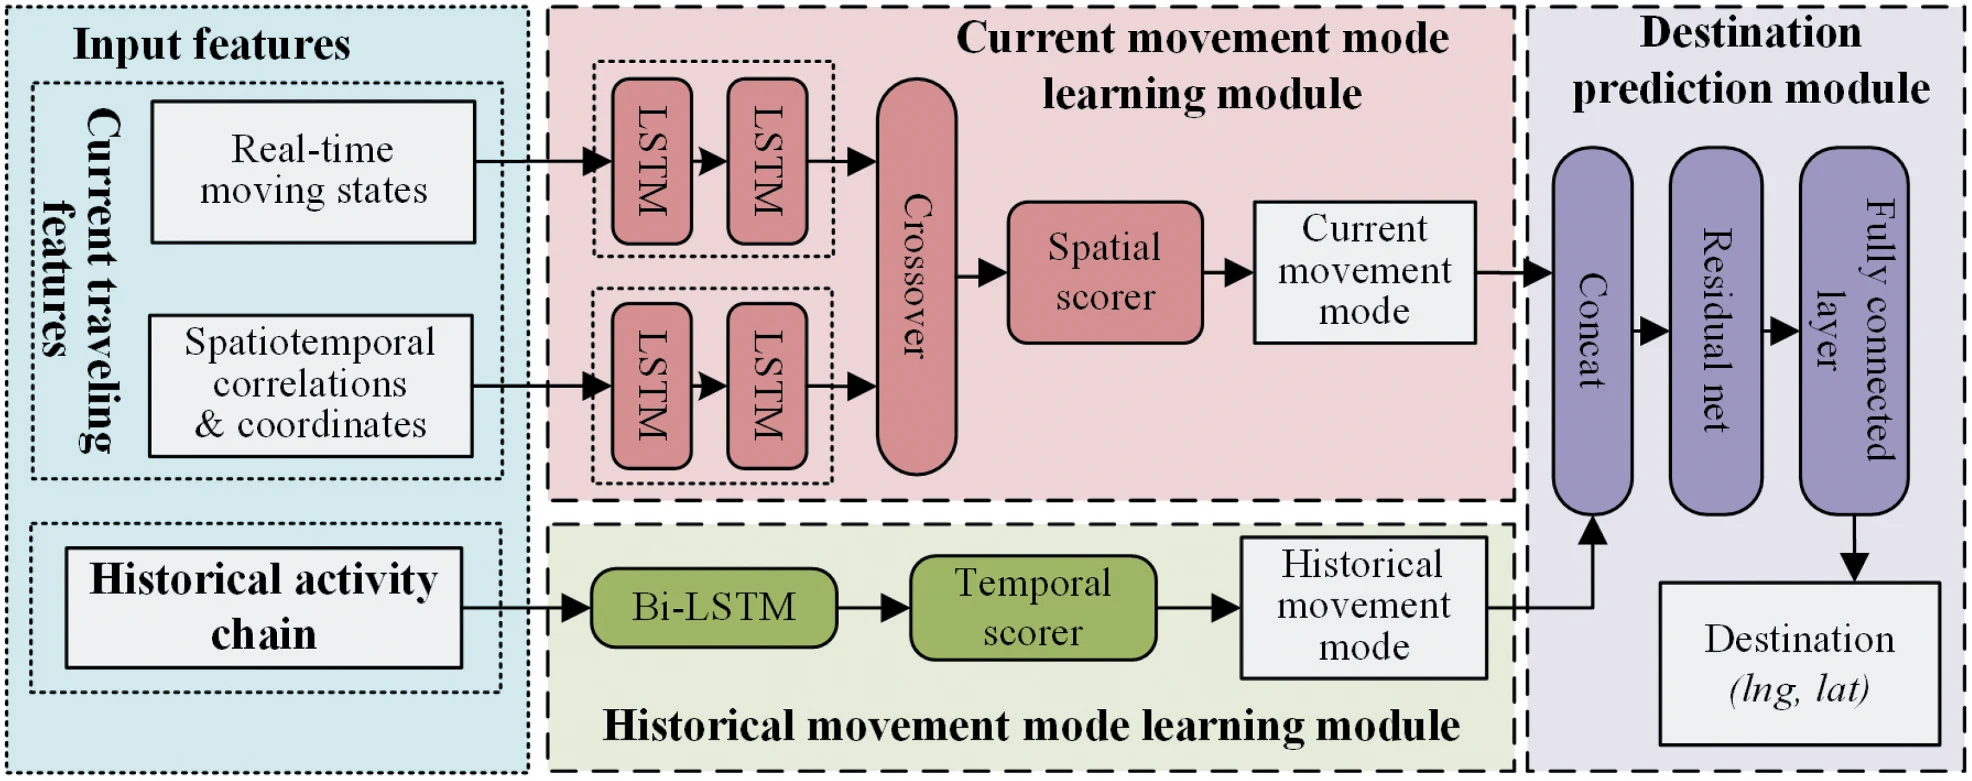
图 5|当前分支和历史分支在哪里会合?
无字母分块。左侧输入分成当前特征和历史活动链。上方粉色模块用并行 LSTM、交叉层和空间评分得到当前运动模式。下方绿色模块用双向 LSTM 和时间评分得到历史运动模式。右侧把两者拼接,经残差网络和全连接层输出经纬度。来源:原论文 Fig. 5。
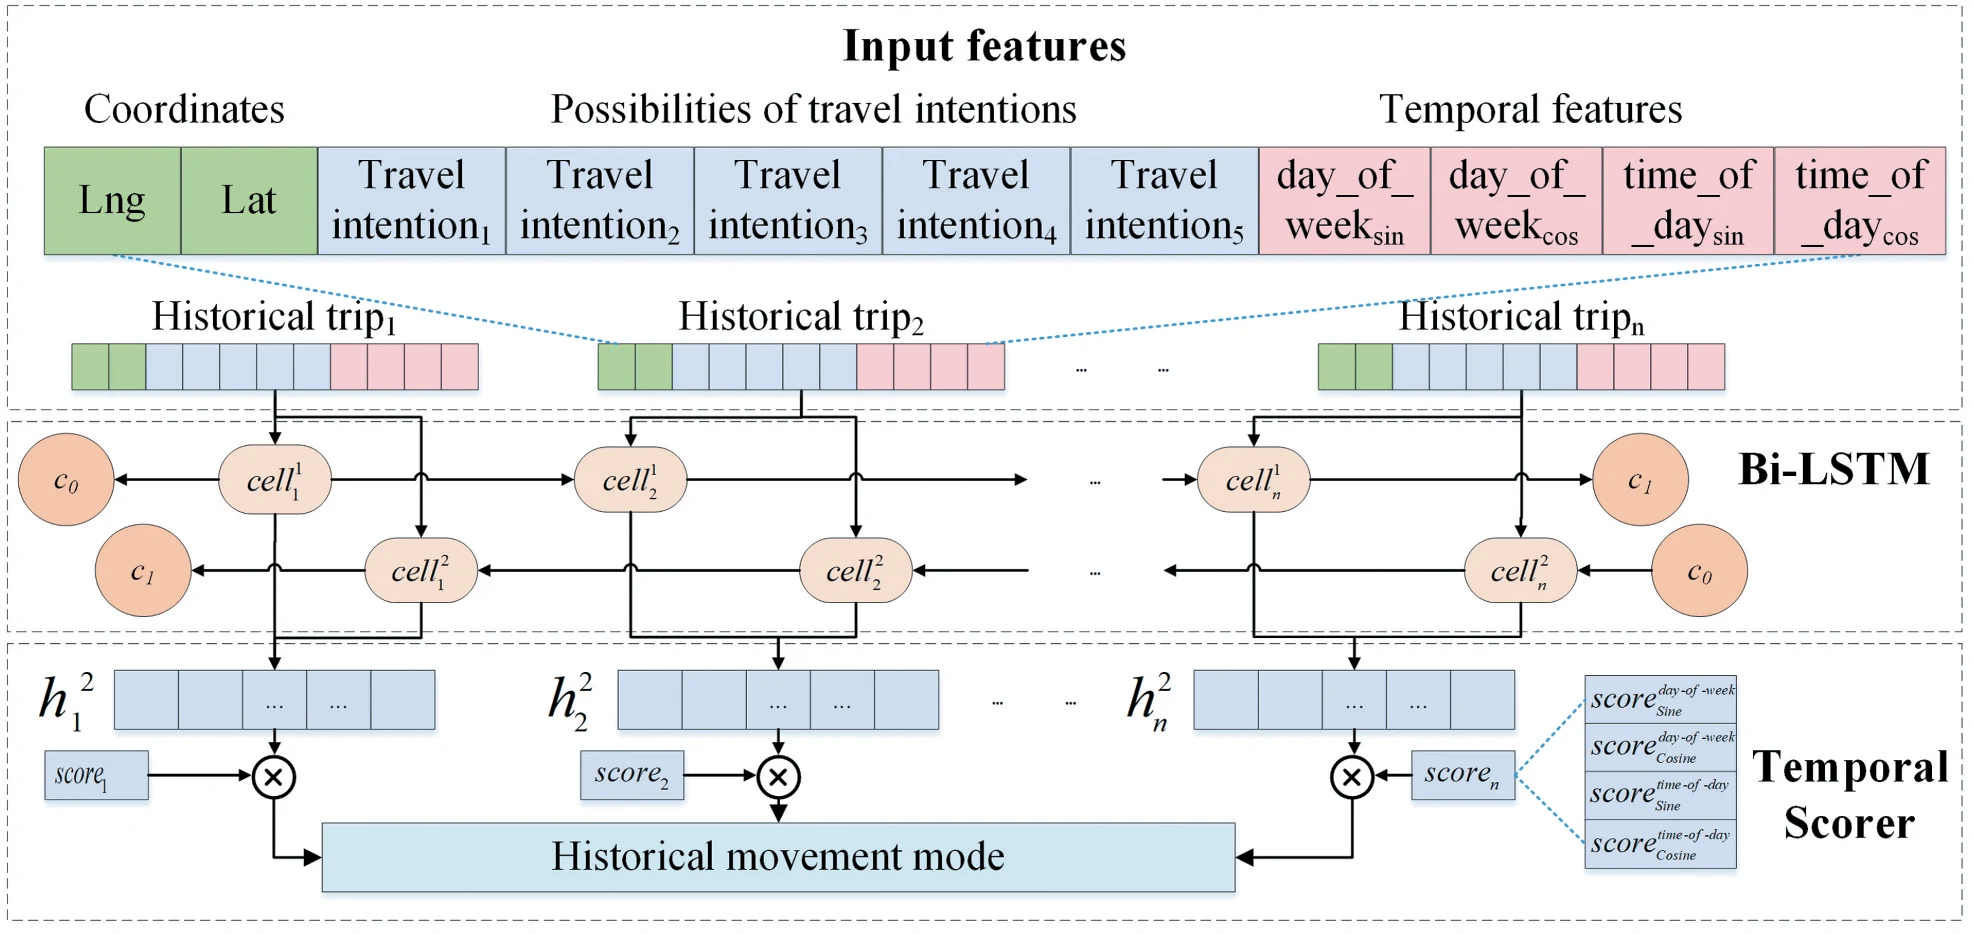
图 6|历史链上的权重看的是时刻,还是整段路线?
无字母分块。每个历史行程的输入是经纬度、5 个意图分量,以及星期和时刻的正弦、余弦。双向 LSTM 产生每个行程的隐藏状态,再乘以 4 个时间分数:星期正弦、星期余弦、时刻正弦、时刻余弦。求和后得到历史运动模式。权重比较的是与当前出发时刻有多像,不比较历史行程的中间路口。来源:原论文 Fig. 6。
同一对起终点仍可能走出不同的路。图 16 用两位示意出行者说明这件事,具体差异留到嵌入结果之前。
平均米数下降了,每一组和每一个指标都下降了吗?
四个对照使用同一套清洗、路口提取、子轨迹和数据划分。随机森林(Random Forest,RF)代表由轨迹特征直接回归的集成树。远邻依赖(Distant Neighboring Dependencies,DND)也把路口嵌成向量,但不用速度、时间这类运动状态。LSI-LSTM 用兴趣点表示轨迹点的位置语义和位置重要性。ITP-CMM 表示相邻路口之间的转移偏好和当前运动方式。后两者用来对照所提方法的意图向量和路口关联。
表 1 是 20 人总体的均值和标准差。正文把这里的标准差解释为不同批次之间的波动。
| 方法 | MAE 均值(米) | MAE 标准差 | RMSE 均值(米) | RMSE 标准差 | MRE 均值 | MRE 标准差 |
|---|---|---|---|---|---|---|
| RF | 8,399.702 | 6,904.124 | 11,053.489 | 17,553.287 | 411.57% | 1993.09% |
| DND | 2,726.059 | 1,119.194 | 4,193.545 | 4,139.467 | 111.51% | 185.36% |
| LSI-LSTM | 1,224.925 | 856.028 | 2,188.102 | 2,617.243 | 20.99% | 23.14% |
| ITP-CMM | 867.609 | 360.435 | 1,637.270 | 1,740.398 | 41.22% | 79.46% |
| 所提模型 | 760.362 | 439.973 | 1,438.317 | 1,786.882 | 20.86% | 26.76% |
相对 ITP-CMM,所提模型的 MAE 从 867.609 米降到 760.362 米,少 107.247 米,约降 12.4%;RMSE 从 1,637.270 米降到 1,438.317 米,约降 12.2%;MRE 从 41.22% 降到 20.86%,约为原来的一半。相对 LSI-LSTM,MAE 从 1,224.925 米降到 760.362 米,约降 37.9%,RMSE 约降 34.3%,MRE 只少 0.13 个百分点。相对 DND 和 RF,三个指标的相对下降都在 65% 以上,因为这两个对照的基线误差高得多。摘要写“准确率大约提高 10%–15%”,正文写相对 LSI-LSTM 和 ITP-CMM 大约提高 10%。表 1 说明,这句话更接近 ITP-CMM 的 MAE 和 RMSE,不能代表 LSI-LSTM 的 MRE,也不能代表相对 RF 的降幅。
MRE 的分母是行程总出行距离。LSI-LSTM 的 MRE 低于 ITP-CMM,作者据此认为它对长距离行程的终点更准。长距离会把同样的米数误差除以一个更大的分母,所以这是对指标的解释,不是单独报告了长距离子集。
三项标准差里,作者的模型排在第二附近。ITP-CMM 的 MAE 标准差是 360.435,作者模型是 439.973;LSI-LSTM 的 MRE 标准差是 23.14%,作者模型是 26.76%。正文说作者模型三项标准差排第二、接近第一。对少数近期没去过的终点,历史链可能引入噪声,这是作者对波动仍然不小的解释。
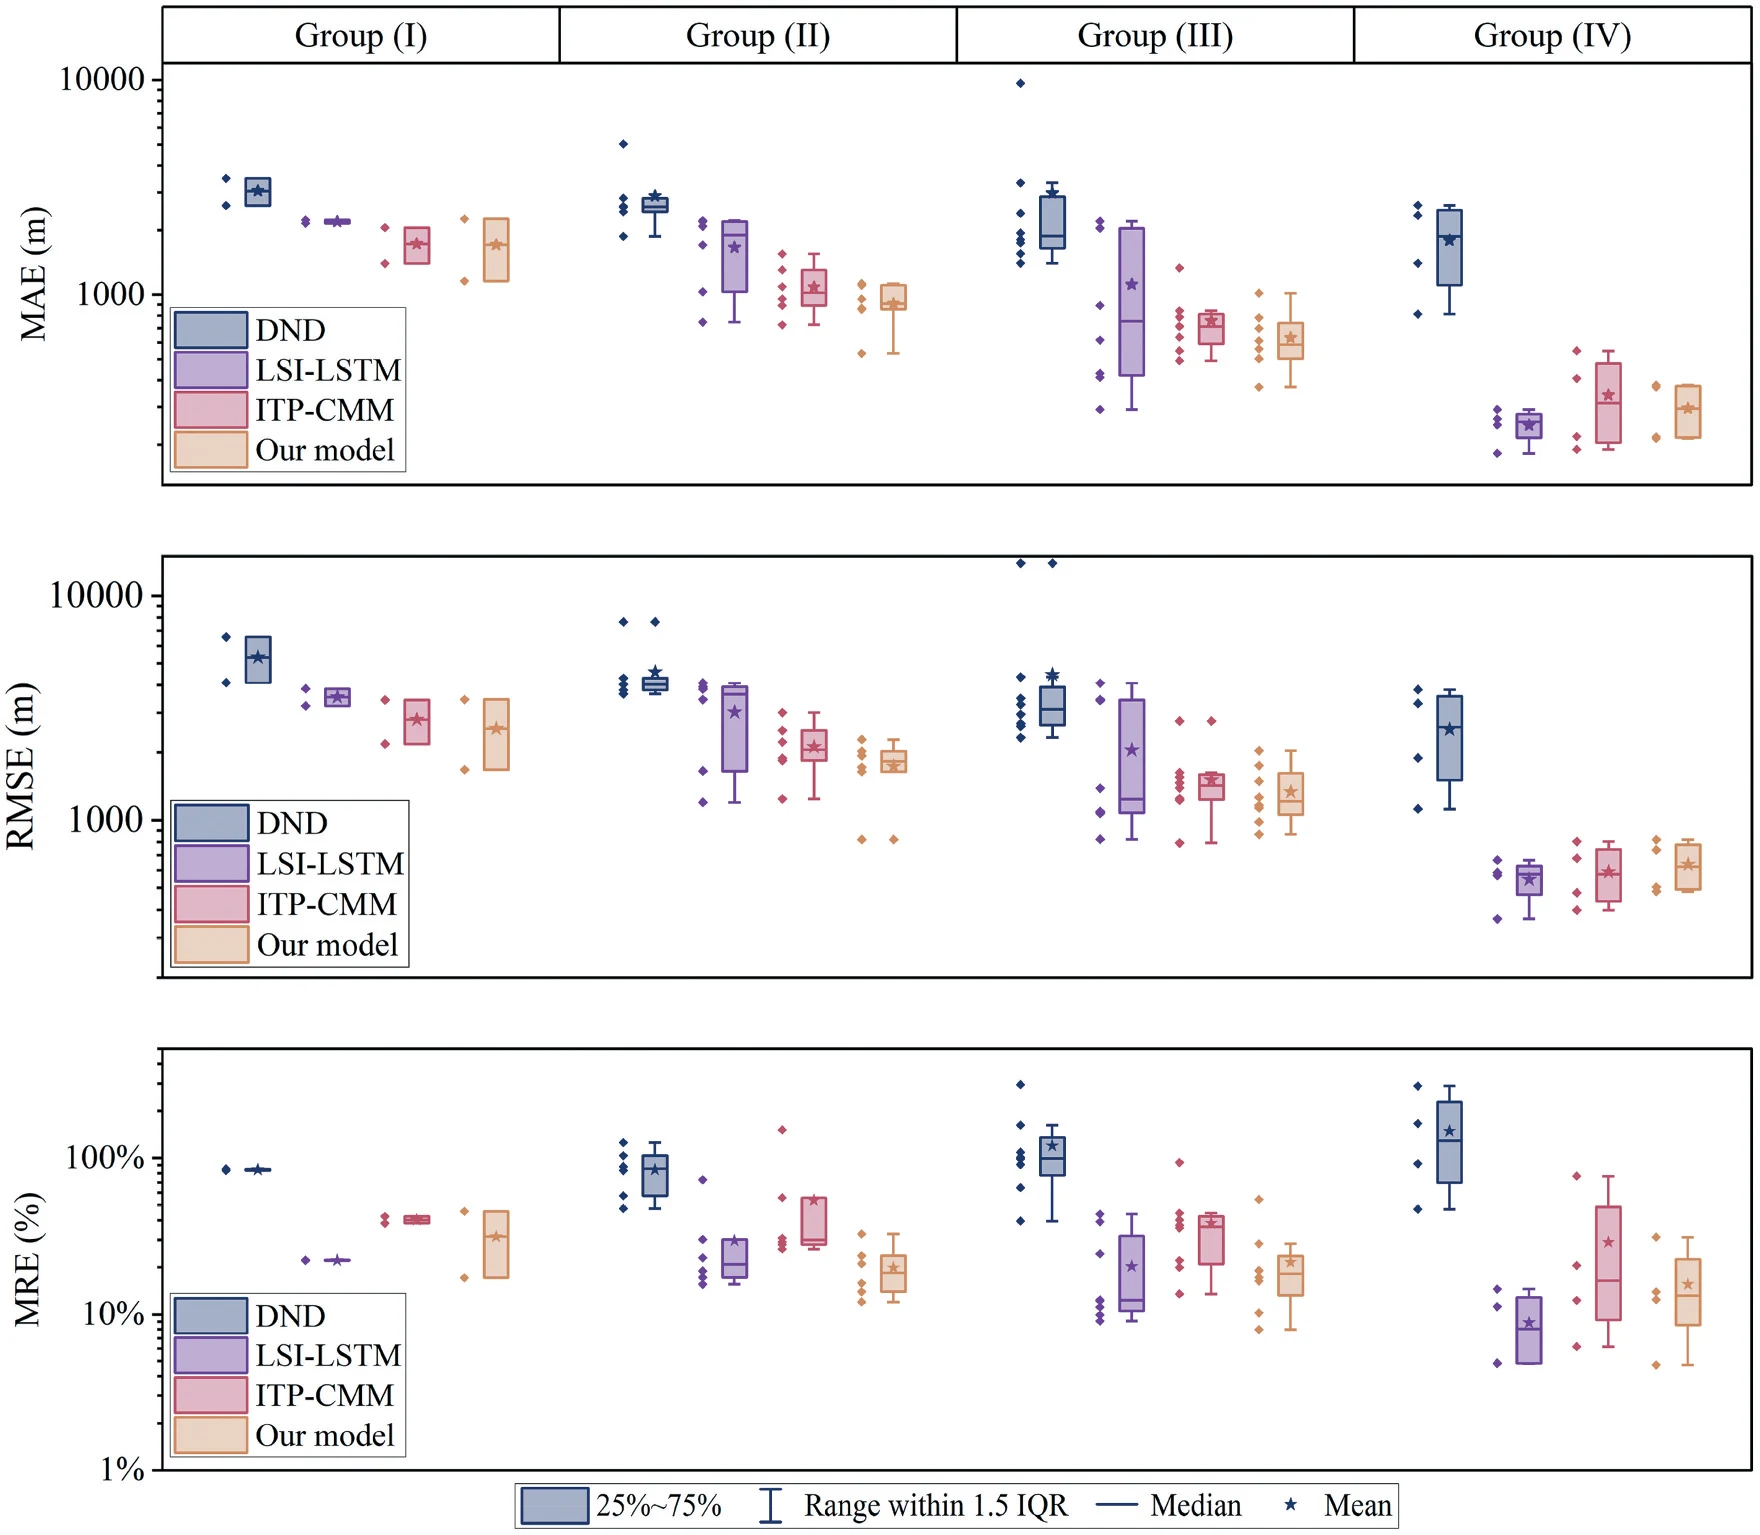
图 8|高 RIVL 和低 RIVL 的人,优势还在吗?
无字母,上、中、下分别是 MAE、RMSE 和 MRE。横轴四组按 RIVL 从高到低,人数为 2、6、8、4。蓝、紫、粉、橙分别是 DND、LSI-LSTM、ITP-CMM 和所提模型。箱体为四分位,须为 1.5 倍四分位距内的范围,线为中位数;图注写五边形表示组内均值。从(I)到(IV),MAE 和 RMSE 的水平下降,MRE 的组间差异小得多。所提模型在前三组的 MAE、RMSE 上优于三个深度对照;在 RIVL 最低的第(IV)组,误差略高于 LSI-LSTM。箱体位置不宜读成精确到米的数字,总体均值以表 1 为准。来源:原论文 Fig. 8。
第(IV)组的例外把总体均值和分组结果分开。作者模型的总平均误差最低,在 RIVL 最低的这一组里,误差仍略高于 LSI-LSTM。作者的解释是,活动很规律的人若被塞进过长的历史上下文,不相关行程会干扰模型。这是对分组结果的解释,分组来自 RIVL 的自然断点。
去掉速度和路口关联,误差会回到哪里?
当前特征的消融从只使用坐标(COOR)出发,先加 RMState,再加 STCorrelation。这套实验单独考察当前特征,不把表 1 的完整模型拆开。
| 方案 | MAE 均值(米) | MAE 标准差 | RMSE 均值(米) | RMSE 标准差 | MRE 均值 | MRE 标准差 |
|---|---|---|---|---|---|---|
| 只使用坐标 | 1,398.025 | 642.919 | 2,684.803 | 2,754.096 | 45.61% | 69.96% |
| 坐标 + 运动状态 | 1,032.979 | 460.046 | 1,887.246 | 2,124.168 | 41.72% | 66.00% |
| 再加入路口关联 | 879.745 | 457.747 | 1,722.694 | 2,044.872 | 31.54% | 51.35% |
相对只使用坐标,运动状态把 MAE 降到 1,032.979 米,约降 26.1%。再加入路口关联后降到 879.745 米,相对坐标模型约降 37.1%,相对“坐标 + 运动状态”再降约 14.8%。RMSE 从 2,684.803 米降到 1,722.694 米,约降 35.8%。MRE 从 45.61% 先到 41.72%,再降到 31.54%:第一步少 3.89 个百分点,第二步少 10.18 个百分点。路口关联对 MRE 的这一步下降更大,因为词向量提供的是“接下来还可能经过哪些路口”,而不只是当前点的速度。正文说当前特征带来超过 20% 的改进,表 2 的 MAE 相对降幅是 37.1%,这句话对得上。
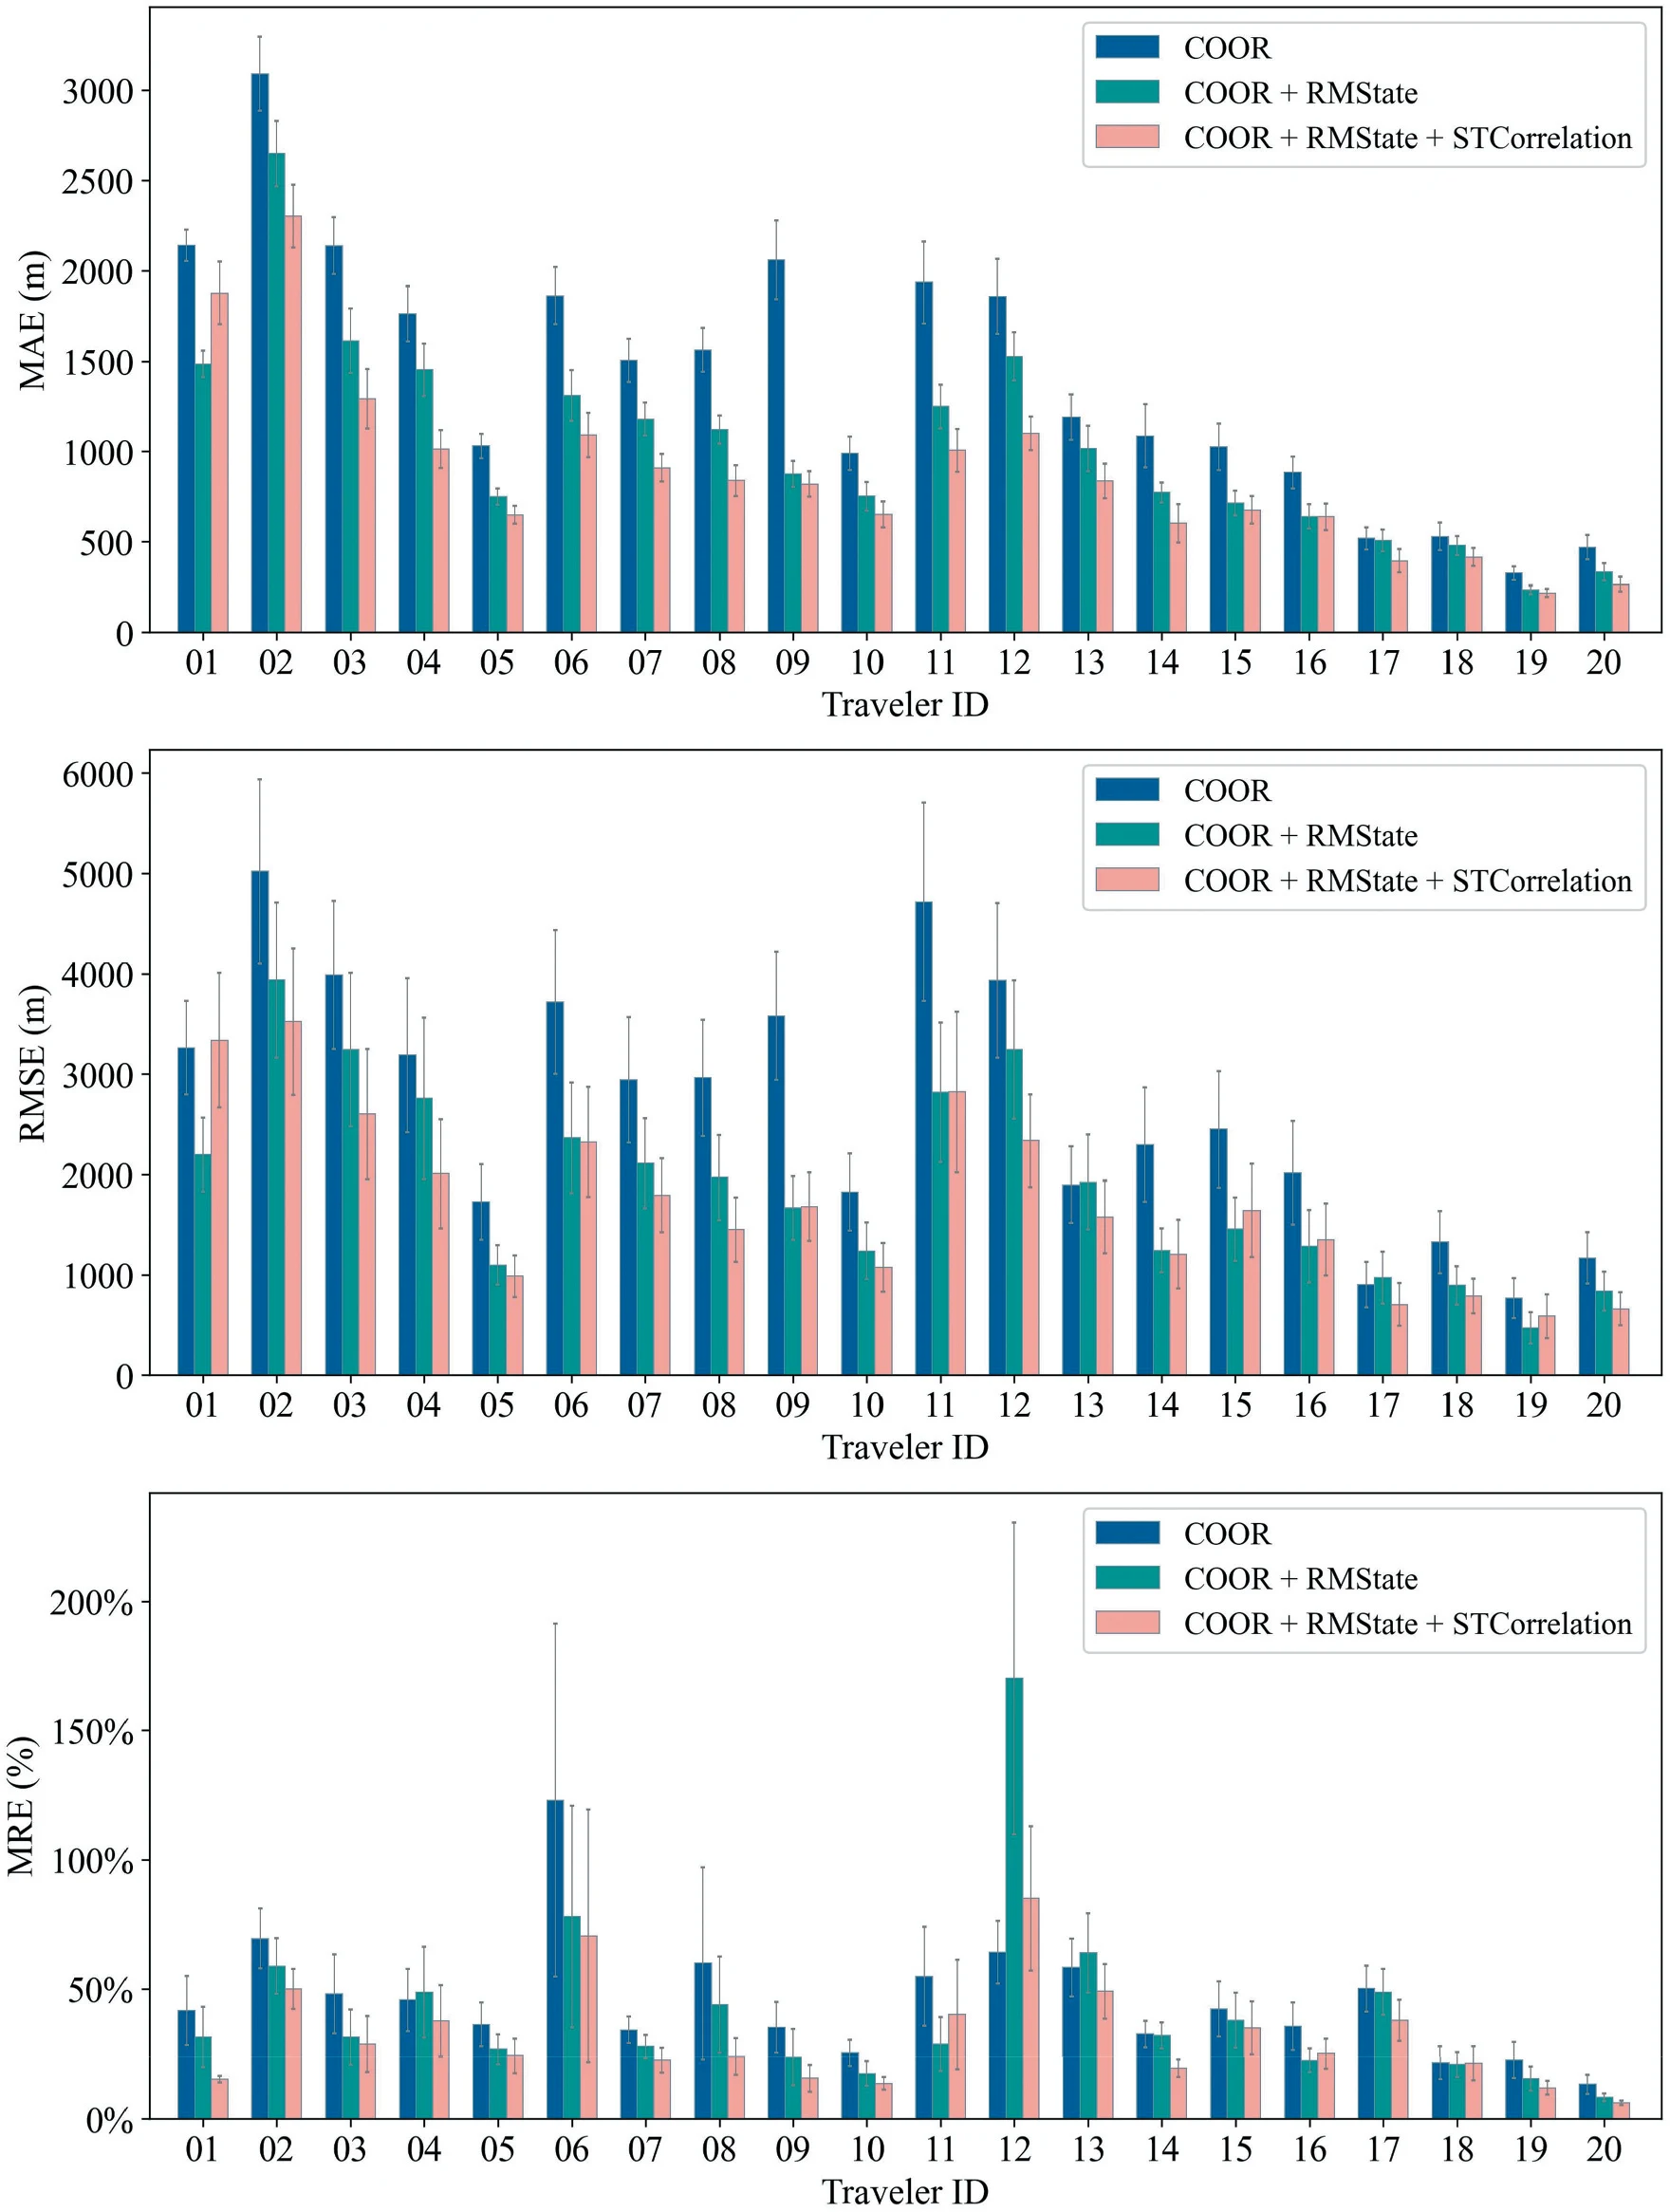
图 9|当前特征对 20 个人是同一种下降吗?
无字母,上、中、下为 MAE、RMSE、MRE,横轴是出行者 01 到 20,误差棒是三项指标的标准差。蓝为只使用坐标,绿为加上运动状态,粉为再加入路口关联。随着编号往后、RIVL 降低,误差总体变小,但不是每个编号都单调下降。05 和 10 的 RIVL 分别高于 06 和 11,误差却可以更低;正文把这归于他们更小的平均出行距离或起讫点熵。来源:原论文 Fig. 9。
RIVL 与可预测性负相关,却不是唯一因素。这一点在后面的八个统计量里还会再出现。
路口向量是否真的把“常一起经过的路口”放近,图 10 用 05 号出行者的四条轨迹做了检查。同一频繁集合里的路口,余弦相似度更高;不在同一次日常路线上同时出现的路口,相似度更低。颜色从绿到红对应相似度由 1.00 到 −1.00。这支持“词向量保留了路径偏好”这一用途。它不证明这些路口在因果上决定了终点,也不把一位匿名出行者的日常路线还原成可跟随的转向说明。
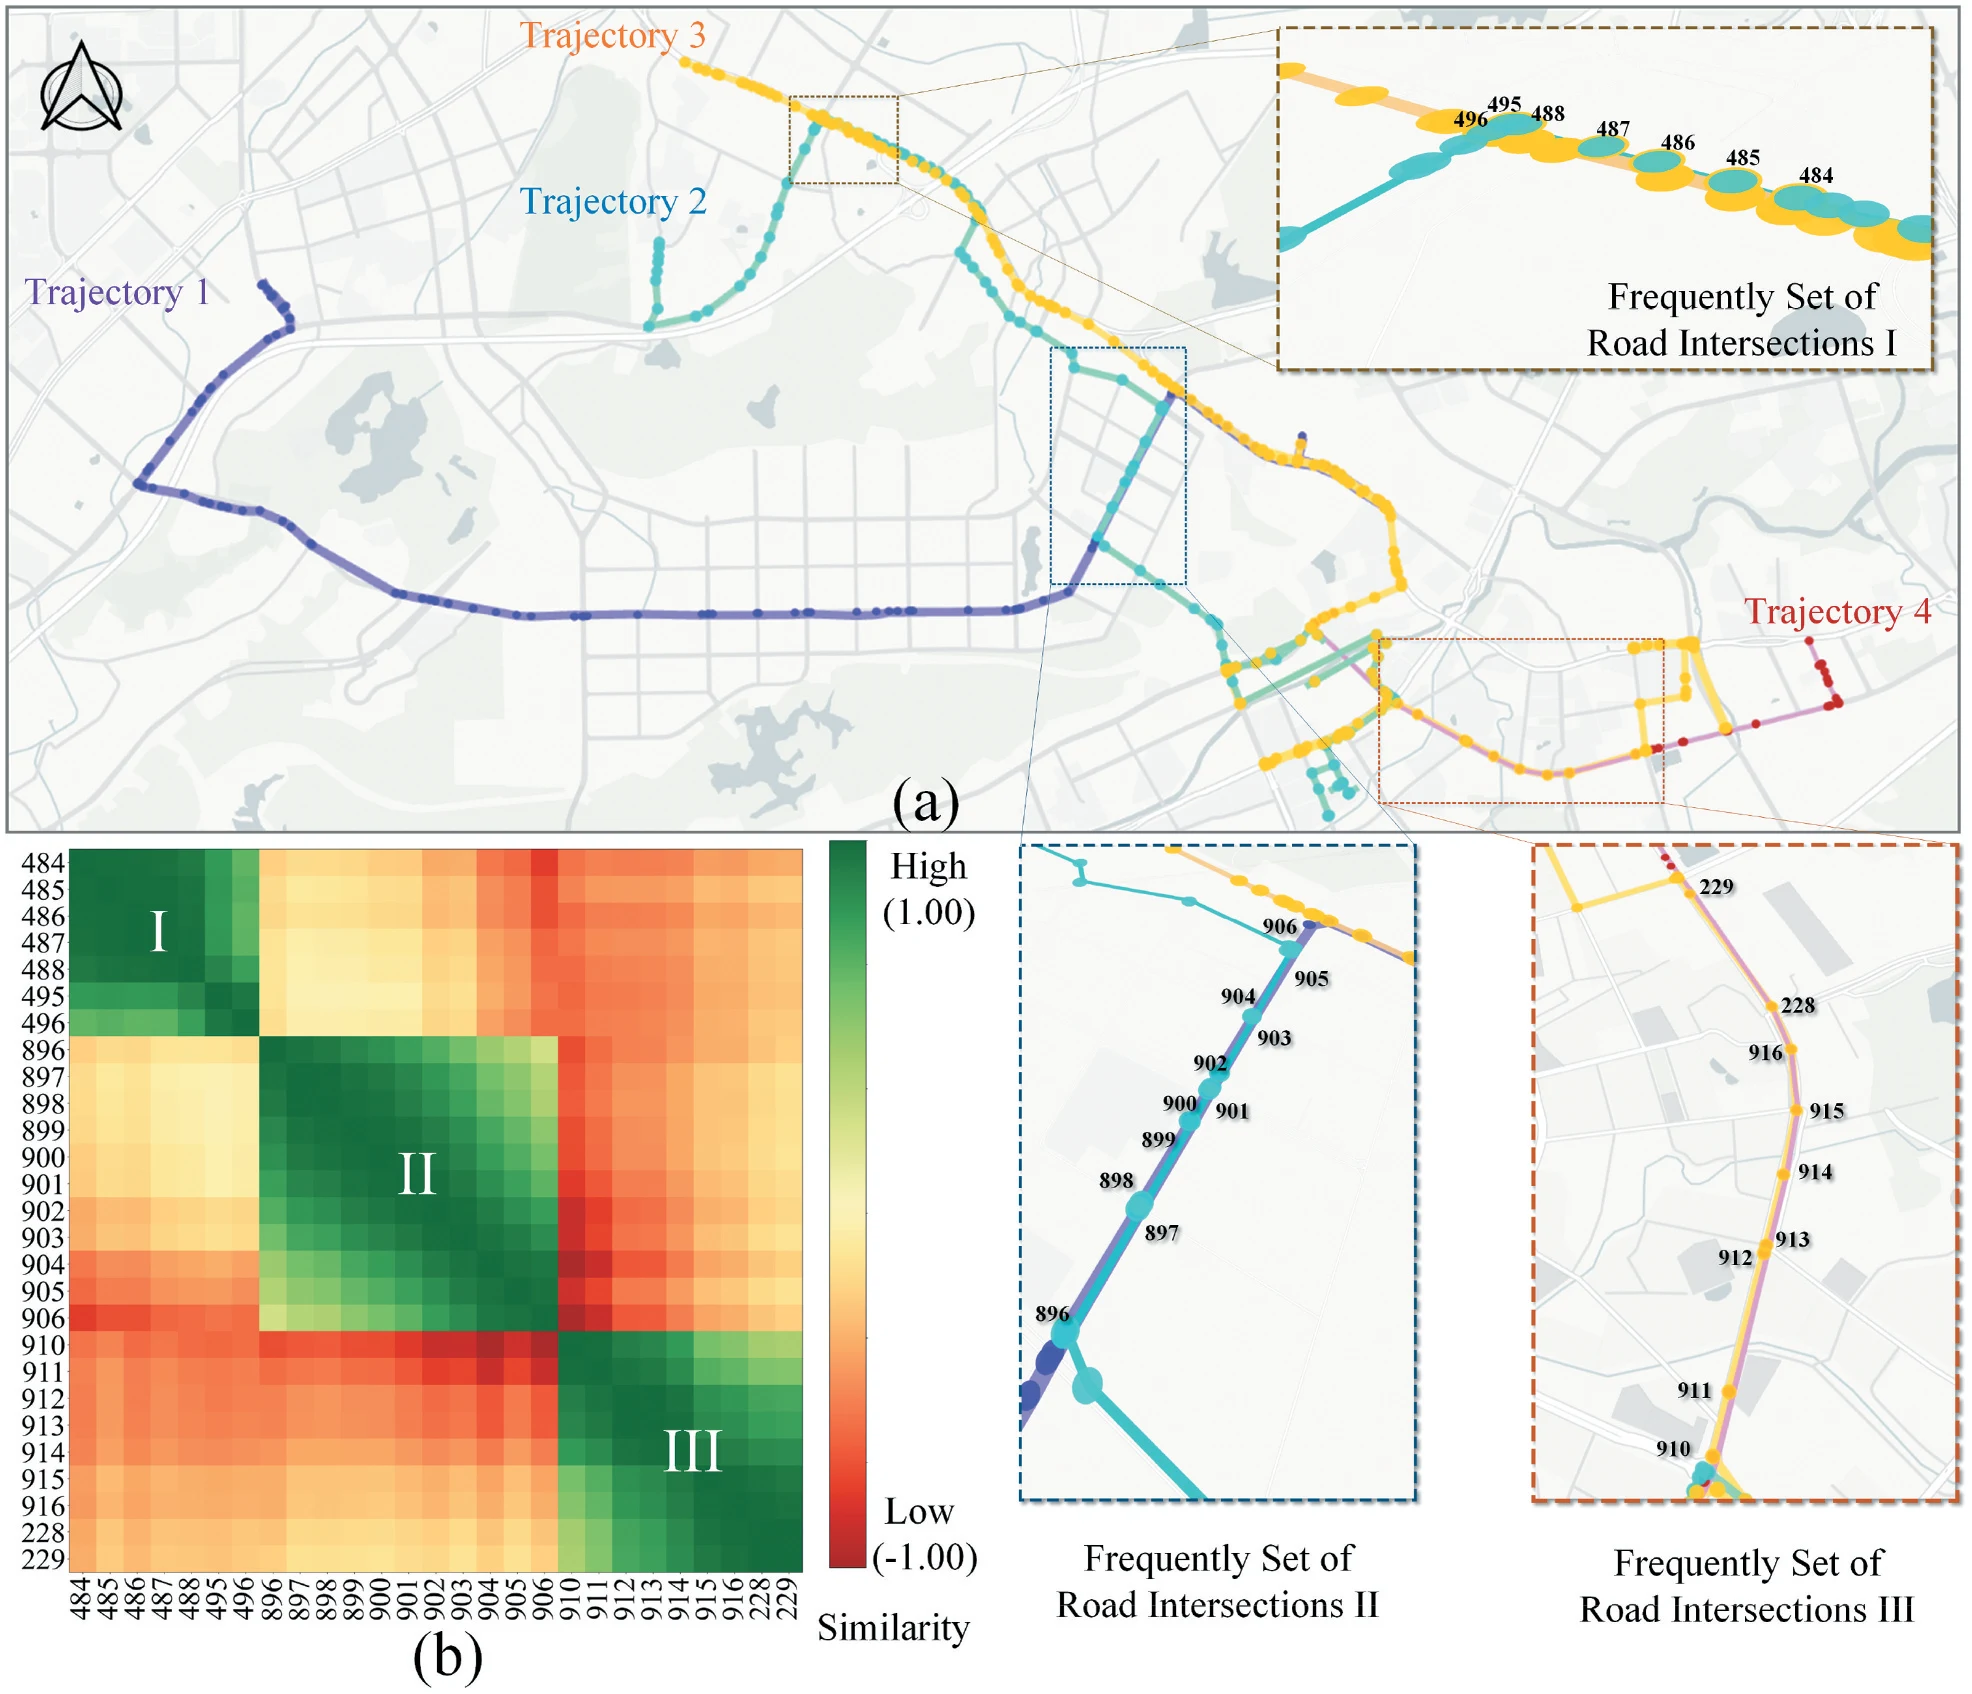
图 10|常一起经过的路口,向量会更近吗?
(a)05 号出行者的四条轨迹用不同颜色画出,三个放大框标出反复共同经过的路口集合。(b)这些路口的余弦相似度矩阵,绿高、红低,色标从 1.00 到 −1.00。对角块内更绿,块与块之间更红。读图结论是同一日常路径上的路口更相似;矩阵不是终点误差。来源:原论文 Fig. 10。
图 16 把同一想法画成对照:两位出行者可以前往相近的起点和终点,出发时刻的热力和中间路口的转向仍然不同。附录写一位傍晚 8 点左右动身、在两个中间路口分别右转和直行,另一位在傍晚 6 点前动身、在同样两个路口直行和左转。这是示意图里的路径偏好,用来说明为什么只知道起终点还不够。
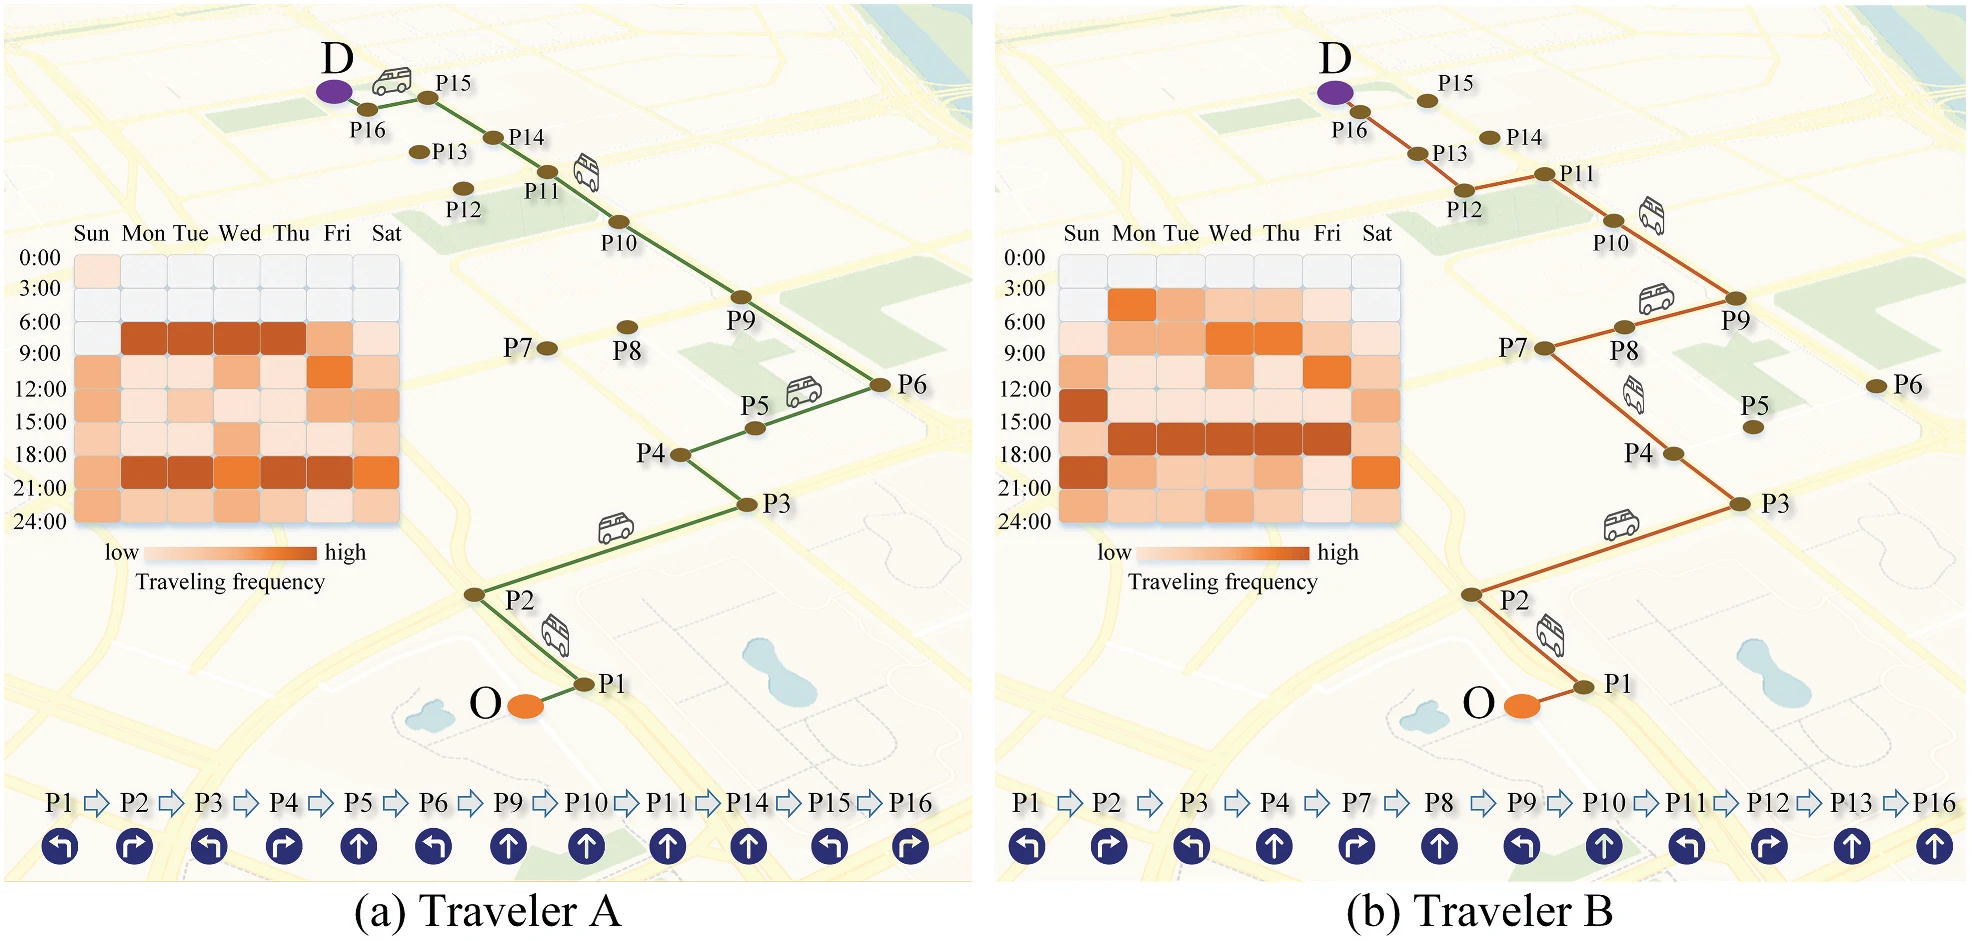
图 16|起终点相近时,路线和出发时刻仍可以不同吗?
(a)和(b)各画一位出行者。橙点为起点,紫点为终点,中间是路口。左下热力是一周七天、一天中各时段的出行频率,颜色越深越高。底部箭头表示途中路口的转向。两位的起终点位置相近,热力和转向不同。图是概念示意,不提供沿街追踪步骤。来源:原论文 Fig. 16。
历史链单独加入,能再近多少?
历史链的消融同样从只使用坐标出发。第二步加入历史行程的坐标和时间,第三步再加入 5 维意图。它没有建立在“运动状态和路口关联已经打开”的模型上。
| 方案 | MAE 均值(米) | MAE 标准差 | RMSE 均值(米) | RMSE 标准差 | MRE 均值 | MRE 标准差 |
|---|---|---|---|---|---|---|
| 只使用坐标 | 1,398.025 | 642.919 | 2,684.803 | 2,754.096 | 45.61% | 69.96% |
| 坐标 + 历史时空 | 1,221.113 | 541.159 | 2,364.756 | 2,440.096 | 44.59% | 82.50% |
| 再加入出行意图 | 1,164.468 | 530.031 | 2,278.339 | 2,453.924 | 42.10% | 67.59% |
历史时空把 MAE 从 1,398.025 米降到 1,221.113 米,约降 12.7%;再加上意图后降到 1,164.468 米,相对只使用坐标约降 16.7%,相对前一步再降约 4.6%。RMSE 从 2,684.803 米降到 2,278.339 米,约降 15.1%。MRE 从 45.61% 到 44.59%,只少 1.02 个百分点;加入意图后再到 42.10%,少 2.49 个百分点。意图这一步对 MRE 的下降大于只加坐标和时间的那一步,绝对值仍然小于表 2 里路口关联带来的 10.18 个百分点。
正文因此说,当前特征的改进超过 20%,历史链的贡献相对有限。表 2 和表 3 支持这个比较。表 1 完整模型的 MAE 是 760.362 米,低于两张消融里最好的 879.745 米。因为两张消融都从坐标模型分开做起,不能把 37.1% 和 16.7% 加在一起,也不能把 879.745 米与 760.362 米的差直接记成历史链的净贡献。
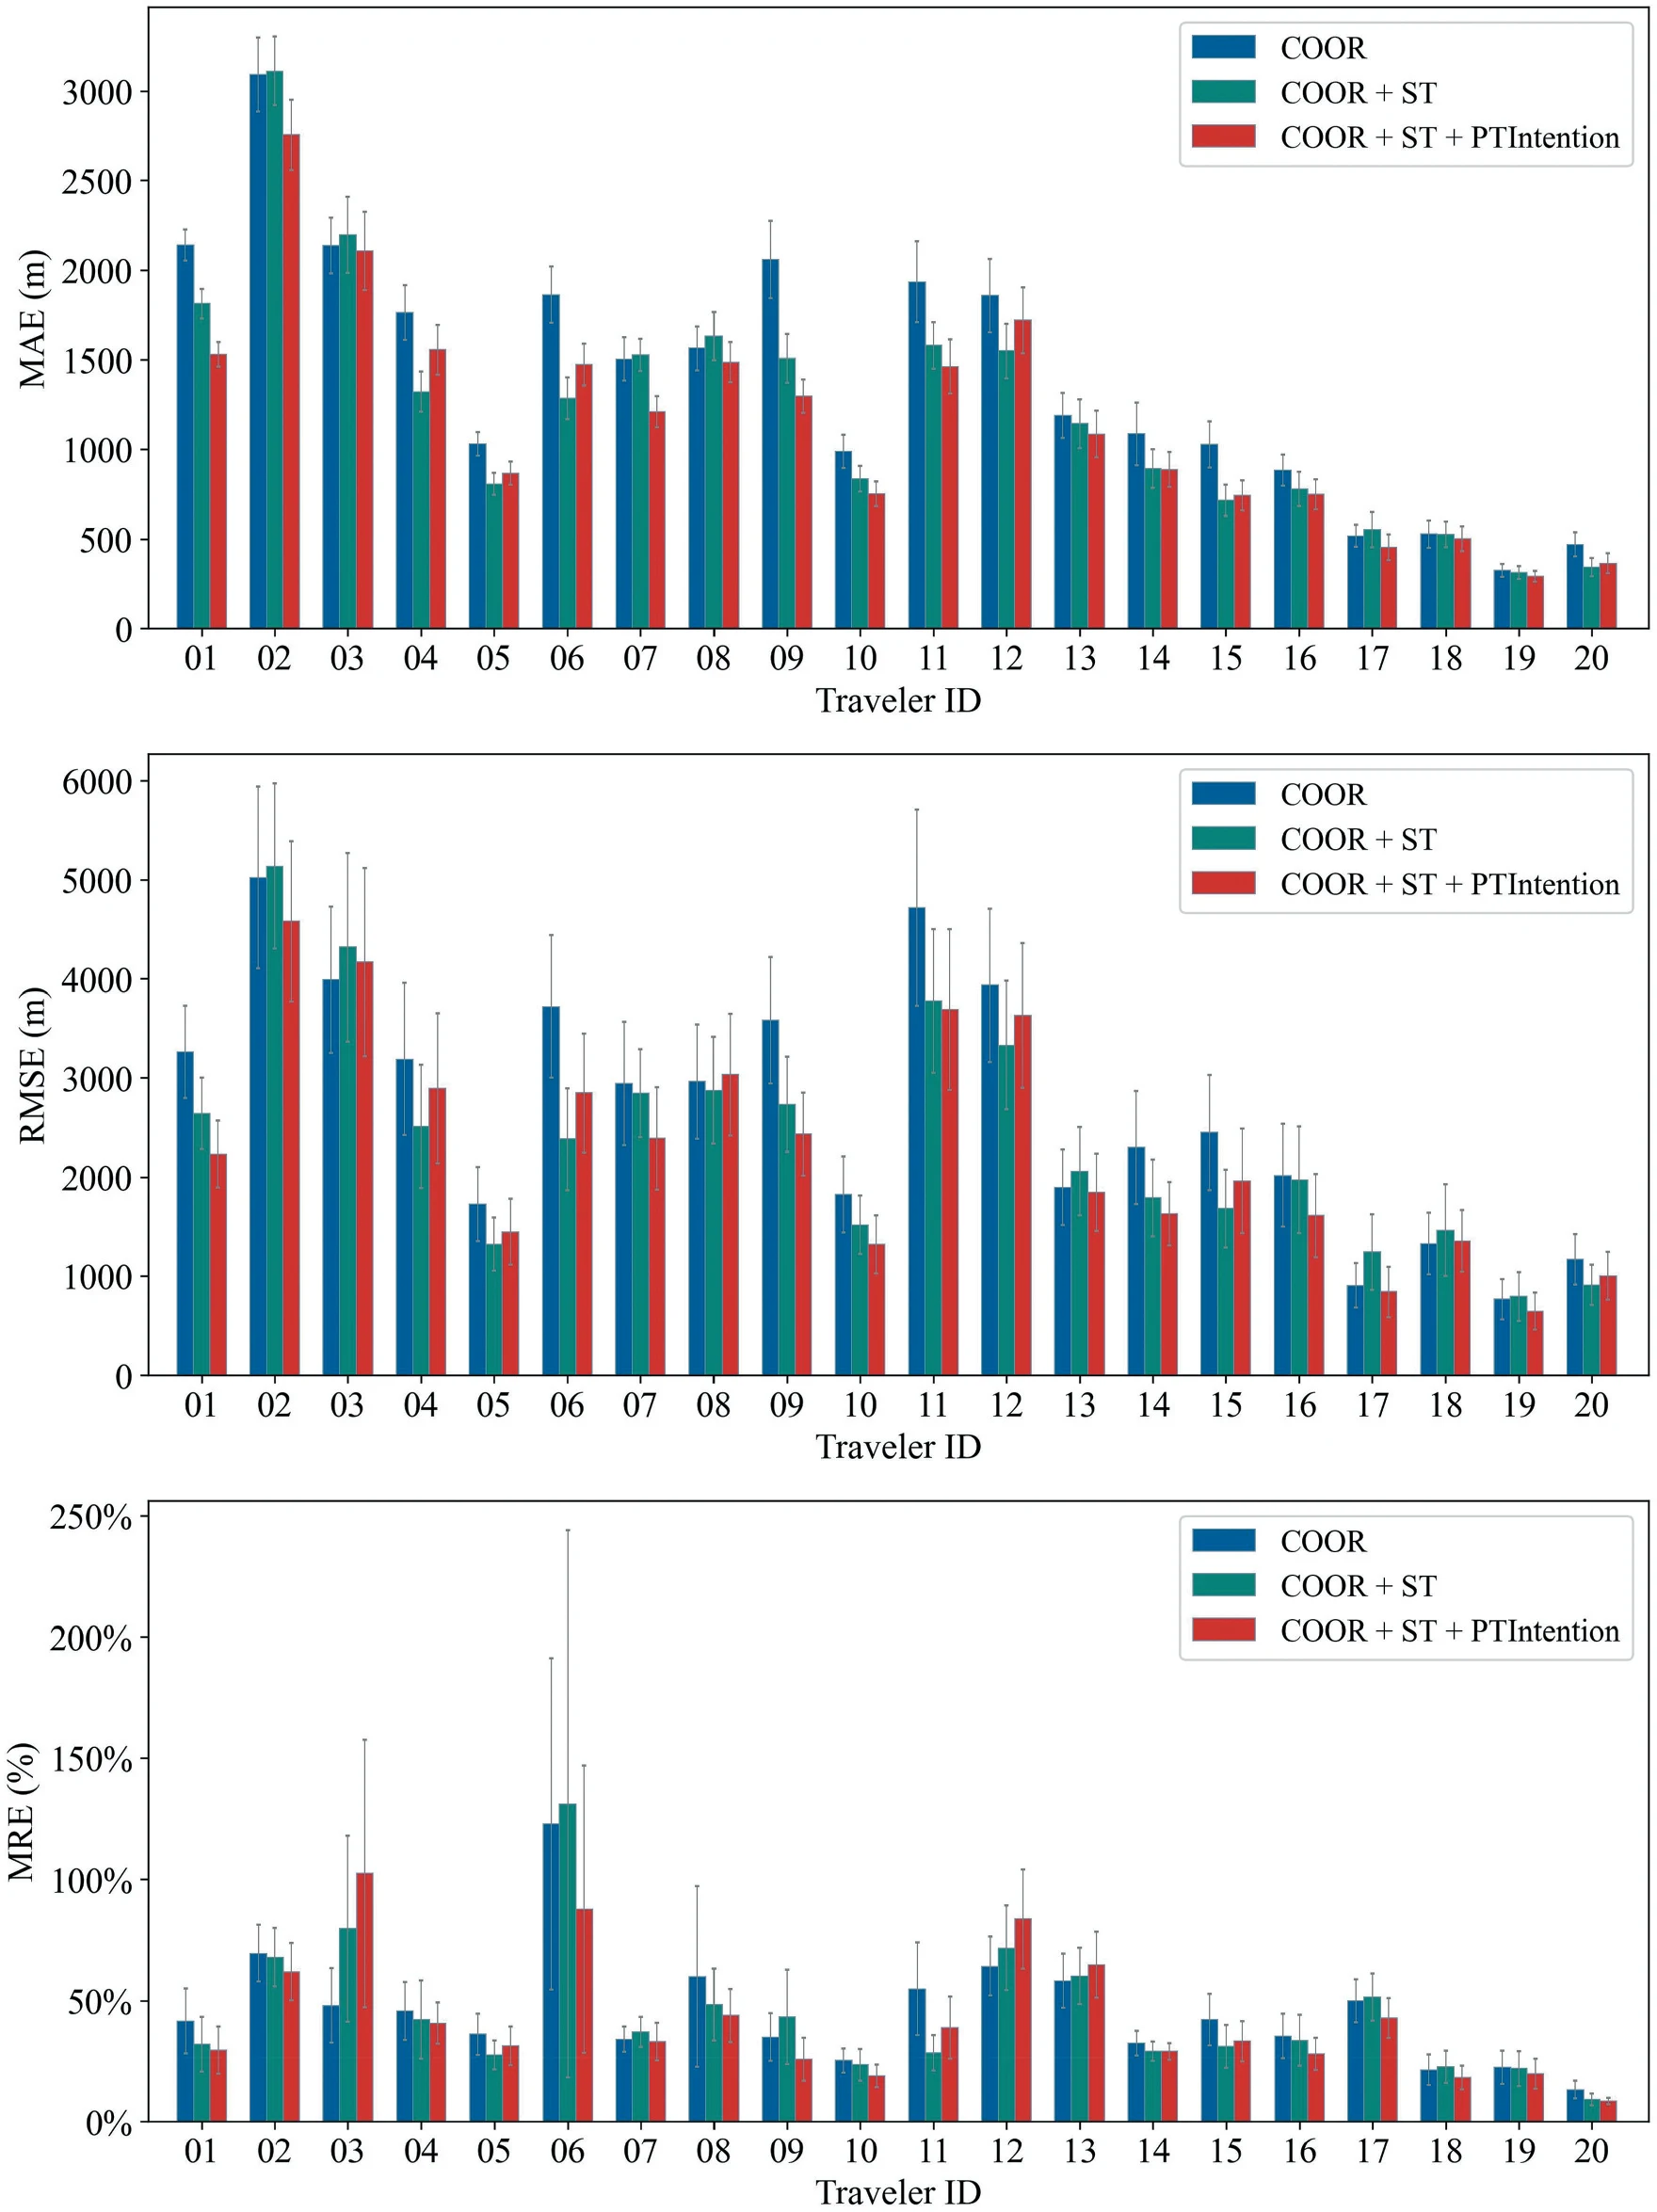
图 11|历史链对每个人都是最低误差吗?
无字母,三行仍是 MAE、RMSE、MRE,误差棒为标准差。蓝为只使用坐标,绿为加上历史时空,红为再加入意图。相对只使用坐标,方案 3 的 MAE 在 20 人里都下降。其中 9 人在同时加入时空与意图后最低,5 人只加时空特征时最低,6 人只加意图时最低。作者点名 01、06、07、09、10、11、15 这 7 人的 MAE 和 RMSE 都有明显下降,正文没有给出检验的 p 值。20 人中有一半在加入意图后 MRE 下降超过 5%,例子是 06 和 09;原文没有逐人列出前后数值。来源:原论文 Fig. 11。
时间评分想利用的现象是:出发时刻接近的历史行程,意图向量也更接近。正文用 05 号的一条六天链说明。一次夜间行程在第五个意图分量上为 0.480,作者认为它更像回家;两次中午前后的行程在第一个意图分量上较高;两次下午 1:30 到 2:00 之间的行程在第二和第四个分量上相似。0.480 是这一次行程的 5 维意图向量里的一个分量。图 12 把这条链画出来,图注只说明行列的含义。
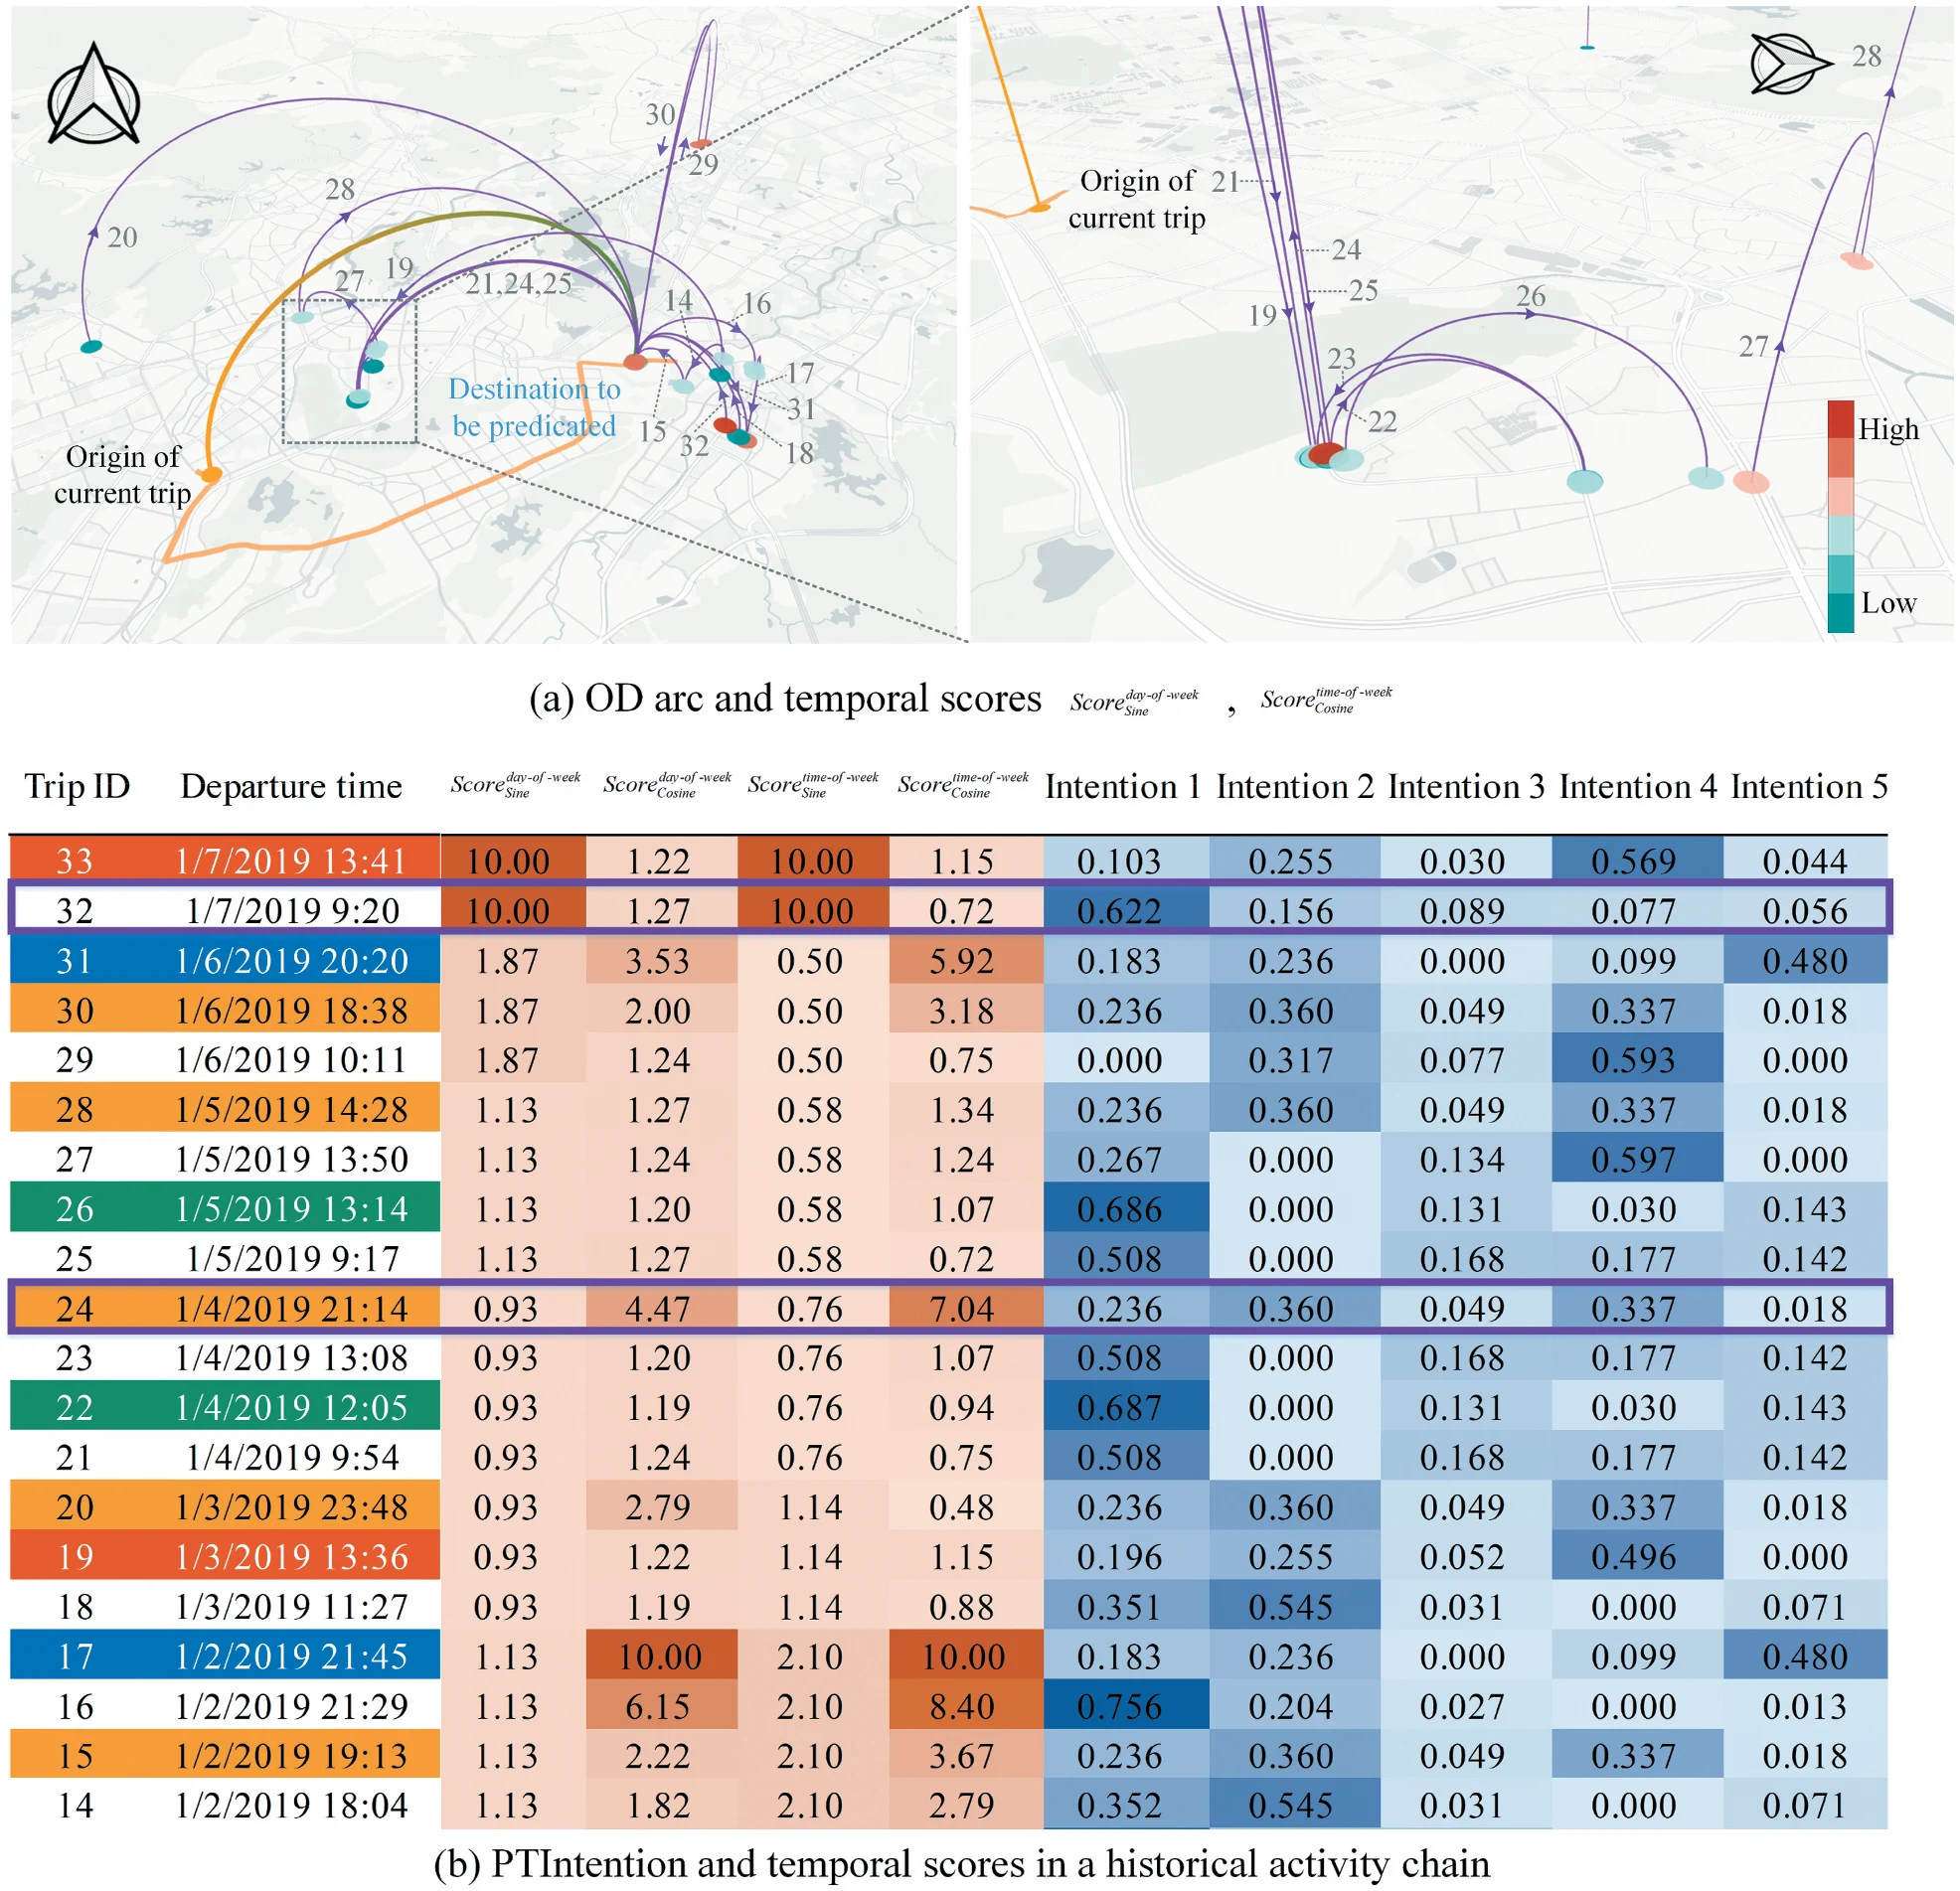
图 12|时间接近的历史行程,意图也会接近吗?
(a)一条历史链的起讫弧,点的颜色使用四个时间分数中的两个,蓝低红高;左右两幅分别看链的空间范围和靠近当前行程的一段。(b)各次历史行程的四个时间分数和五个意图分量,颜色深浅表示数值高低。相近出发时刻的行,意图颜色更接近。这是一位匿名出行者的例子,用来说明评分机制,不构成可复现的个人行踪还原。来源:原论文 Fig. 12。
链越长,终点就越近吗?
链太短,可能错过反复出现的节奏;链太长,训练更贵,也更容易混入无关行程。实验把长度设为 5、10、15、25、30 和 40,分组方式与前面相同。
链长取 5、10、15 时,20 人平均 MAE 落在 747.263 米到 760.234 米,平均 MRE 落在 20.178% 到 23.375%。这两个指标在所试长度里达到最小。同一档的平均 RMSE 落在 1,388.127 米到 1,407.478 米,是各长度里的次低,不是最低。链长 25 时,第(I)组的平均 MAE 达到各长度中的最大值 1,706.047 米;第(II)组的平均 MAE 为 887.899 米,在该组各长度里排次低。
分组曲线的方向也不一致。RIVL 次高的第(II)组在较短的链上 RMSE 更好;RIVL 次低的第(III)组在较长的链上更好。作者的解释是,第(II)组只有一小部分终点会重新出现在历史链里,第(III)组更可能重访历史终点。RIVL 最低的第(IV)组并没有沿用第(III)组的模式。组内也同样不是 RIVL 决定一切:02 的 RIVL 低于 01,预测误差却更高,正文将其联系到更大的活动范围和更低的星期熵。这些都是 20 个人上的对照,不是把链长随机分配后的因果效应。主实验最终采用哪一个默认长度,正文没有写。
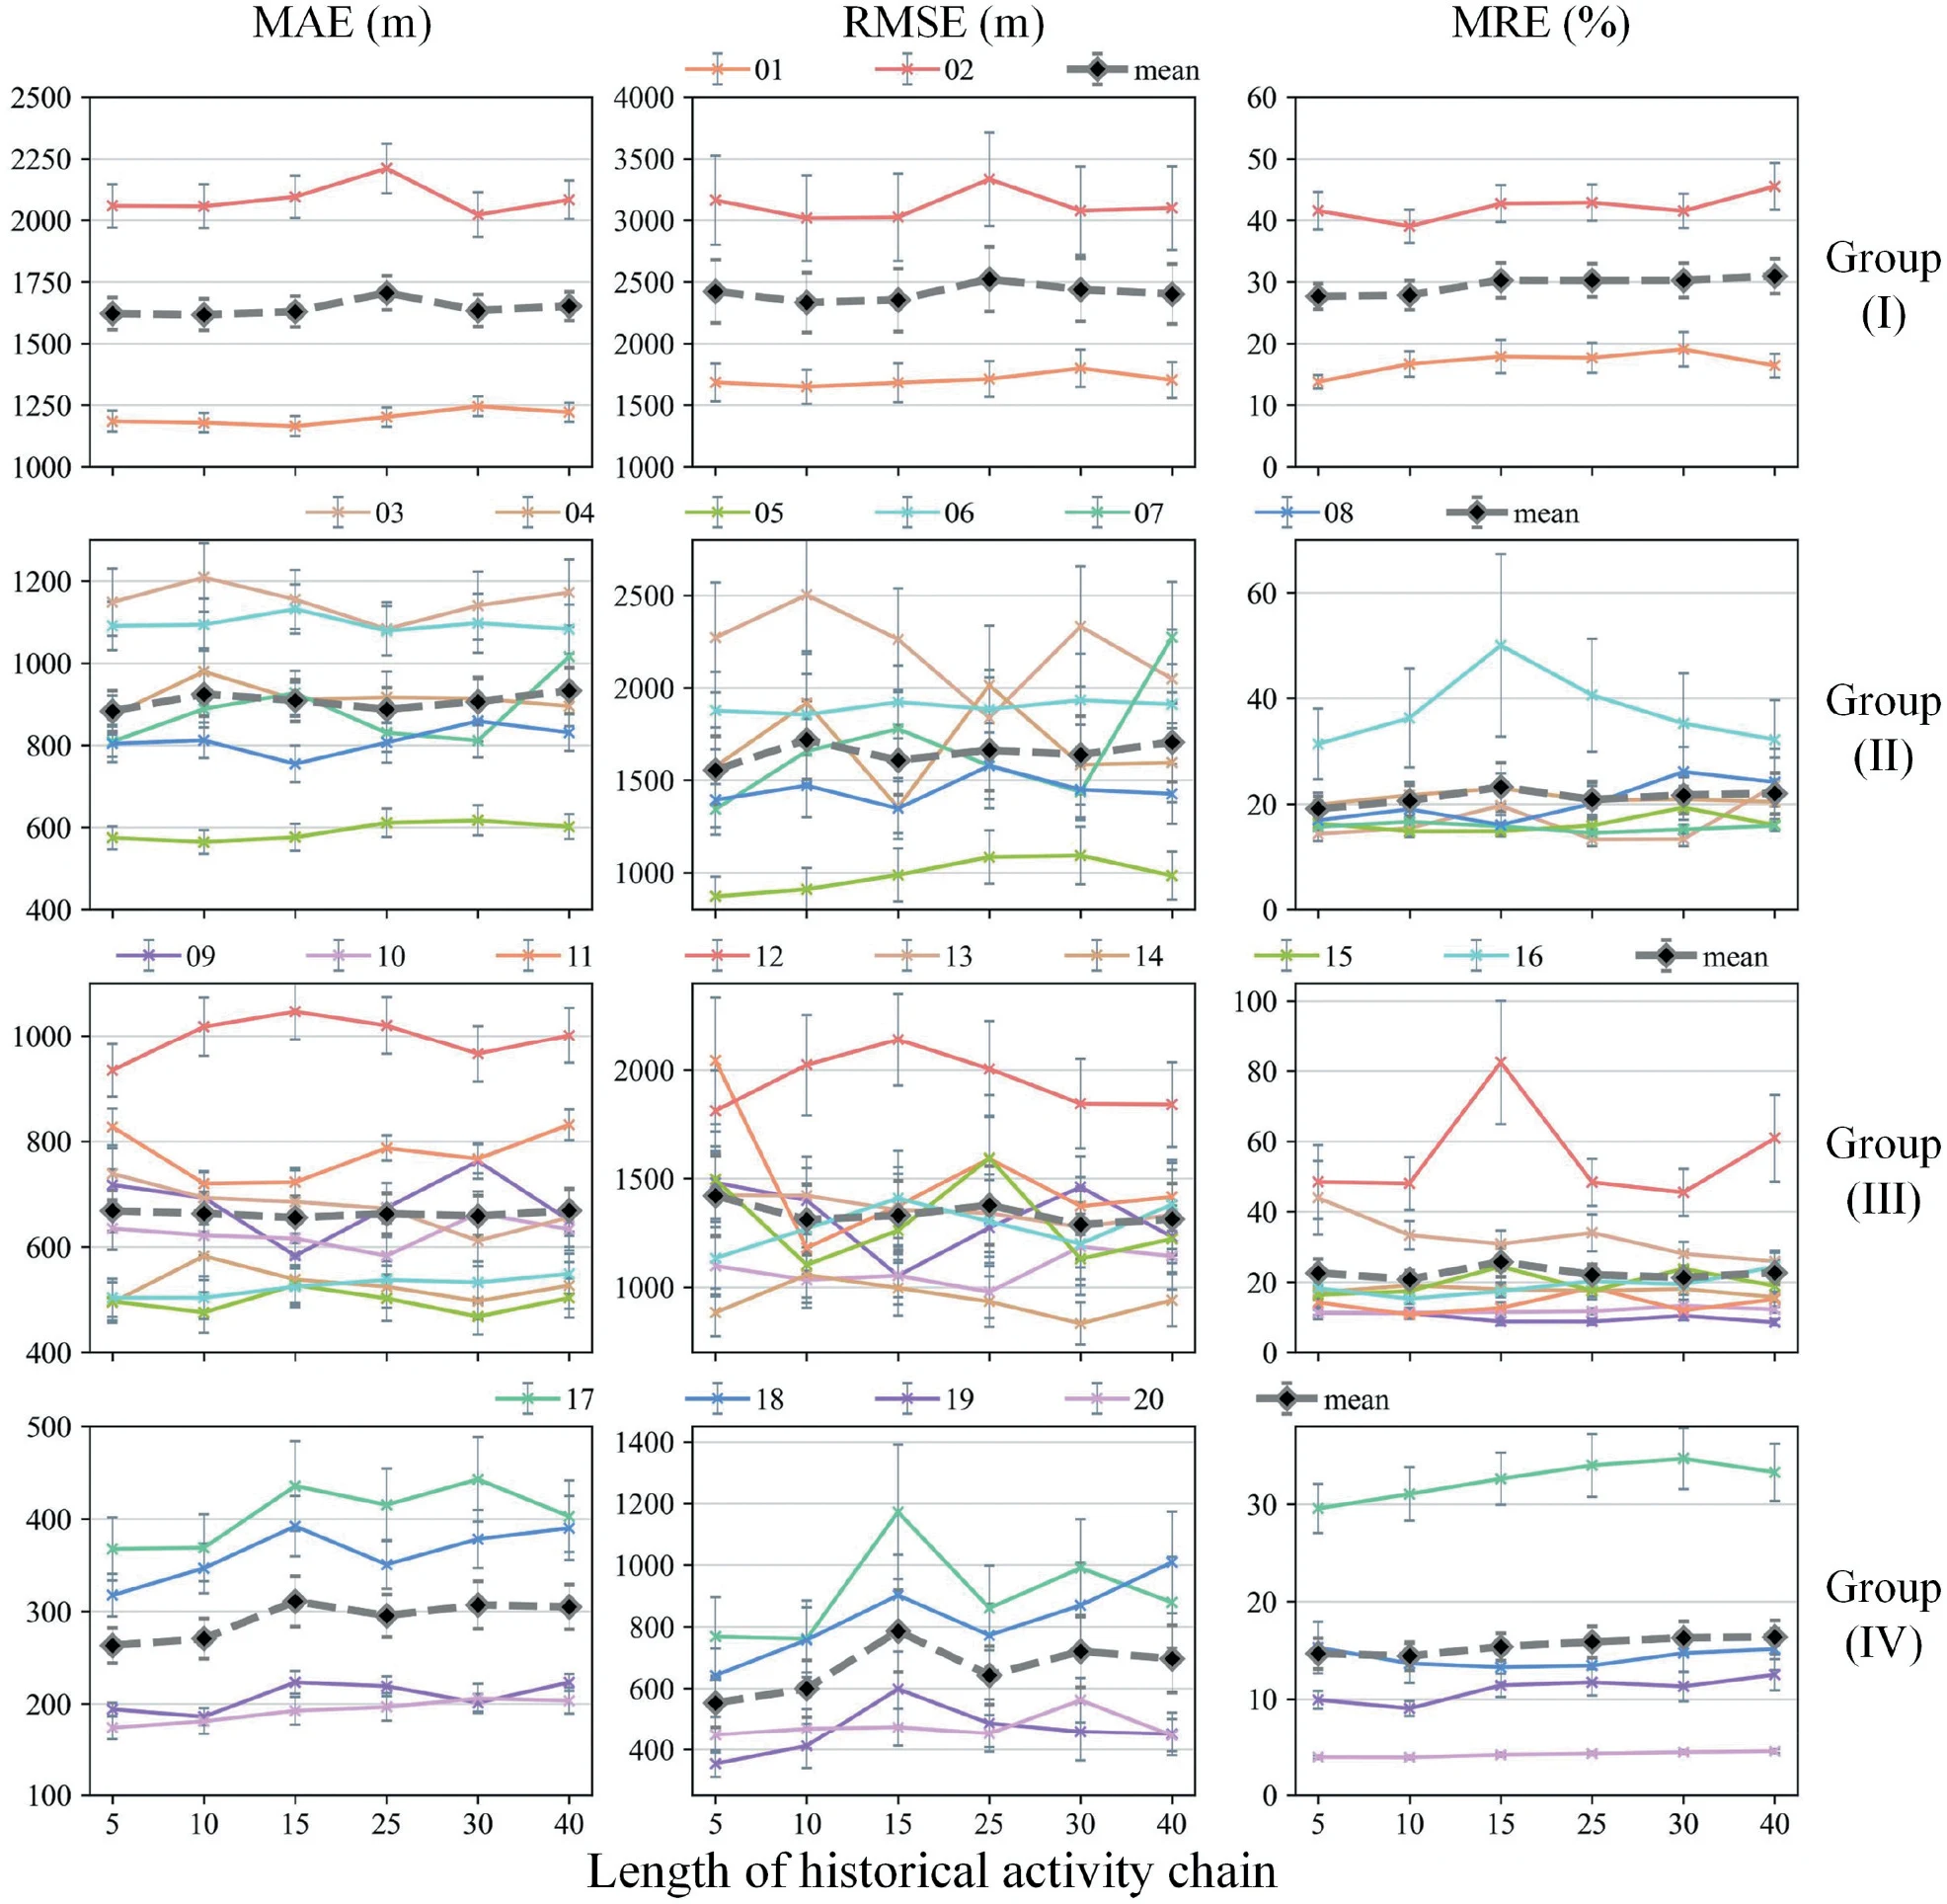
图 13|哪一种链长对哪一组更合适?
无字母。十二个小图按四行三列排列,行是(I)到(IV)组,列是 MAE、RMSE、MRE。横轴是链长 5 到 40,彩色线是组内出行者,带标记的线是组均值。各小图纵轴刻度不同,不能把某一行的高低直接当成另一行的米数。曲线起伏,没有一条“越长越低”的共同斜率。正文给出的组均值以文字为准,不从折线另读精确点。来源:原论文 Fig. 13。
常去的终点更近,访问次数能解释多少误差?
常去终点是 200 米内至少聚起 10 个点的簇中心,不常去终点是聚类后的噪声点。图 14 比较 LSI-LSTM、ITP-CMM 和所提模型。三个模型在常去终点上的误差都更低。所提模型在两类上都低于两个对照,不常去终点上的差距更受作者强调。深度学习依赖重复样本,稀少终点的样本少,误差就高。所提模型缩小了两类终点之间的落差。稀少终点的误差仍然更高,只是高出来的部分小于两个对照。
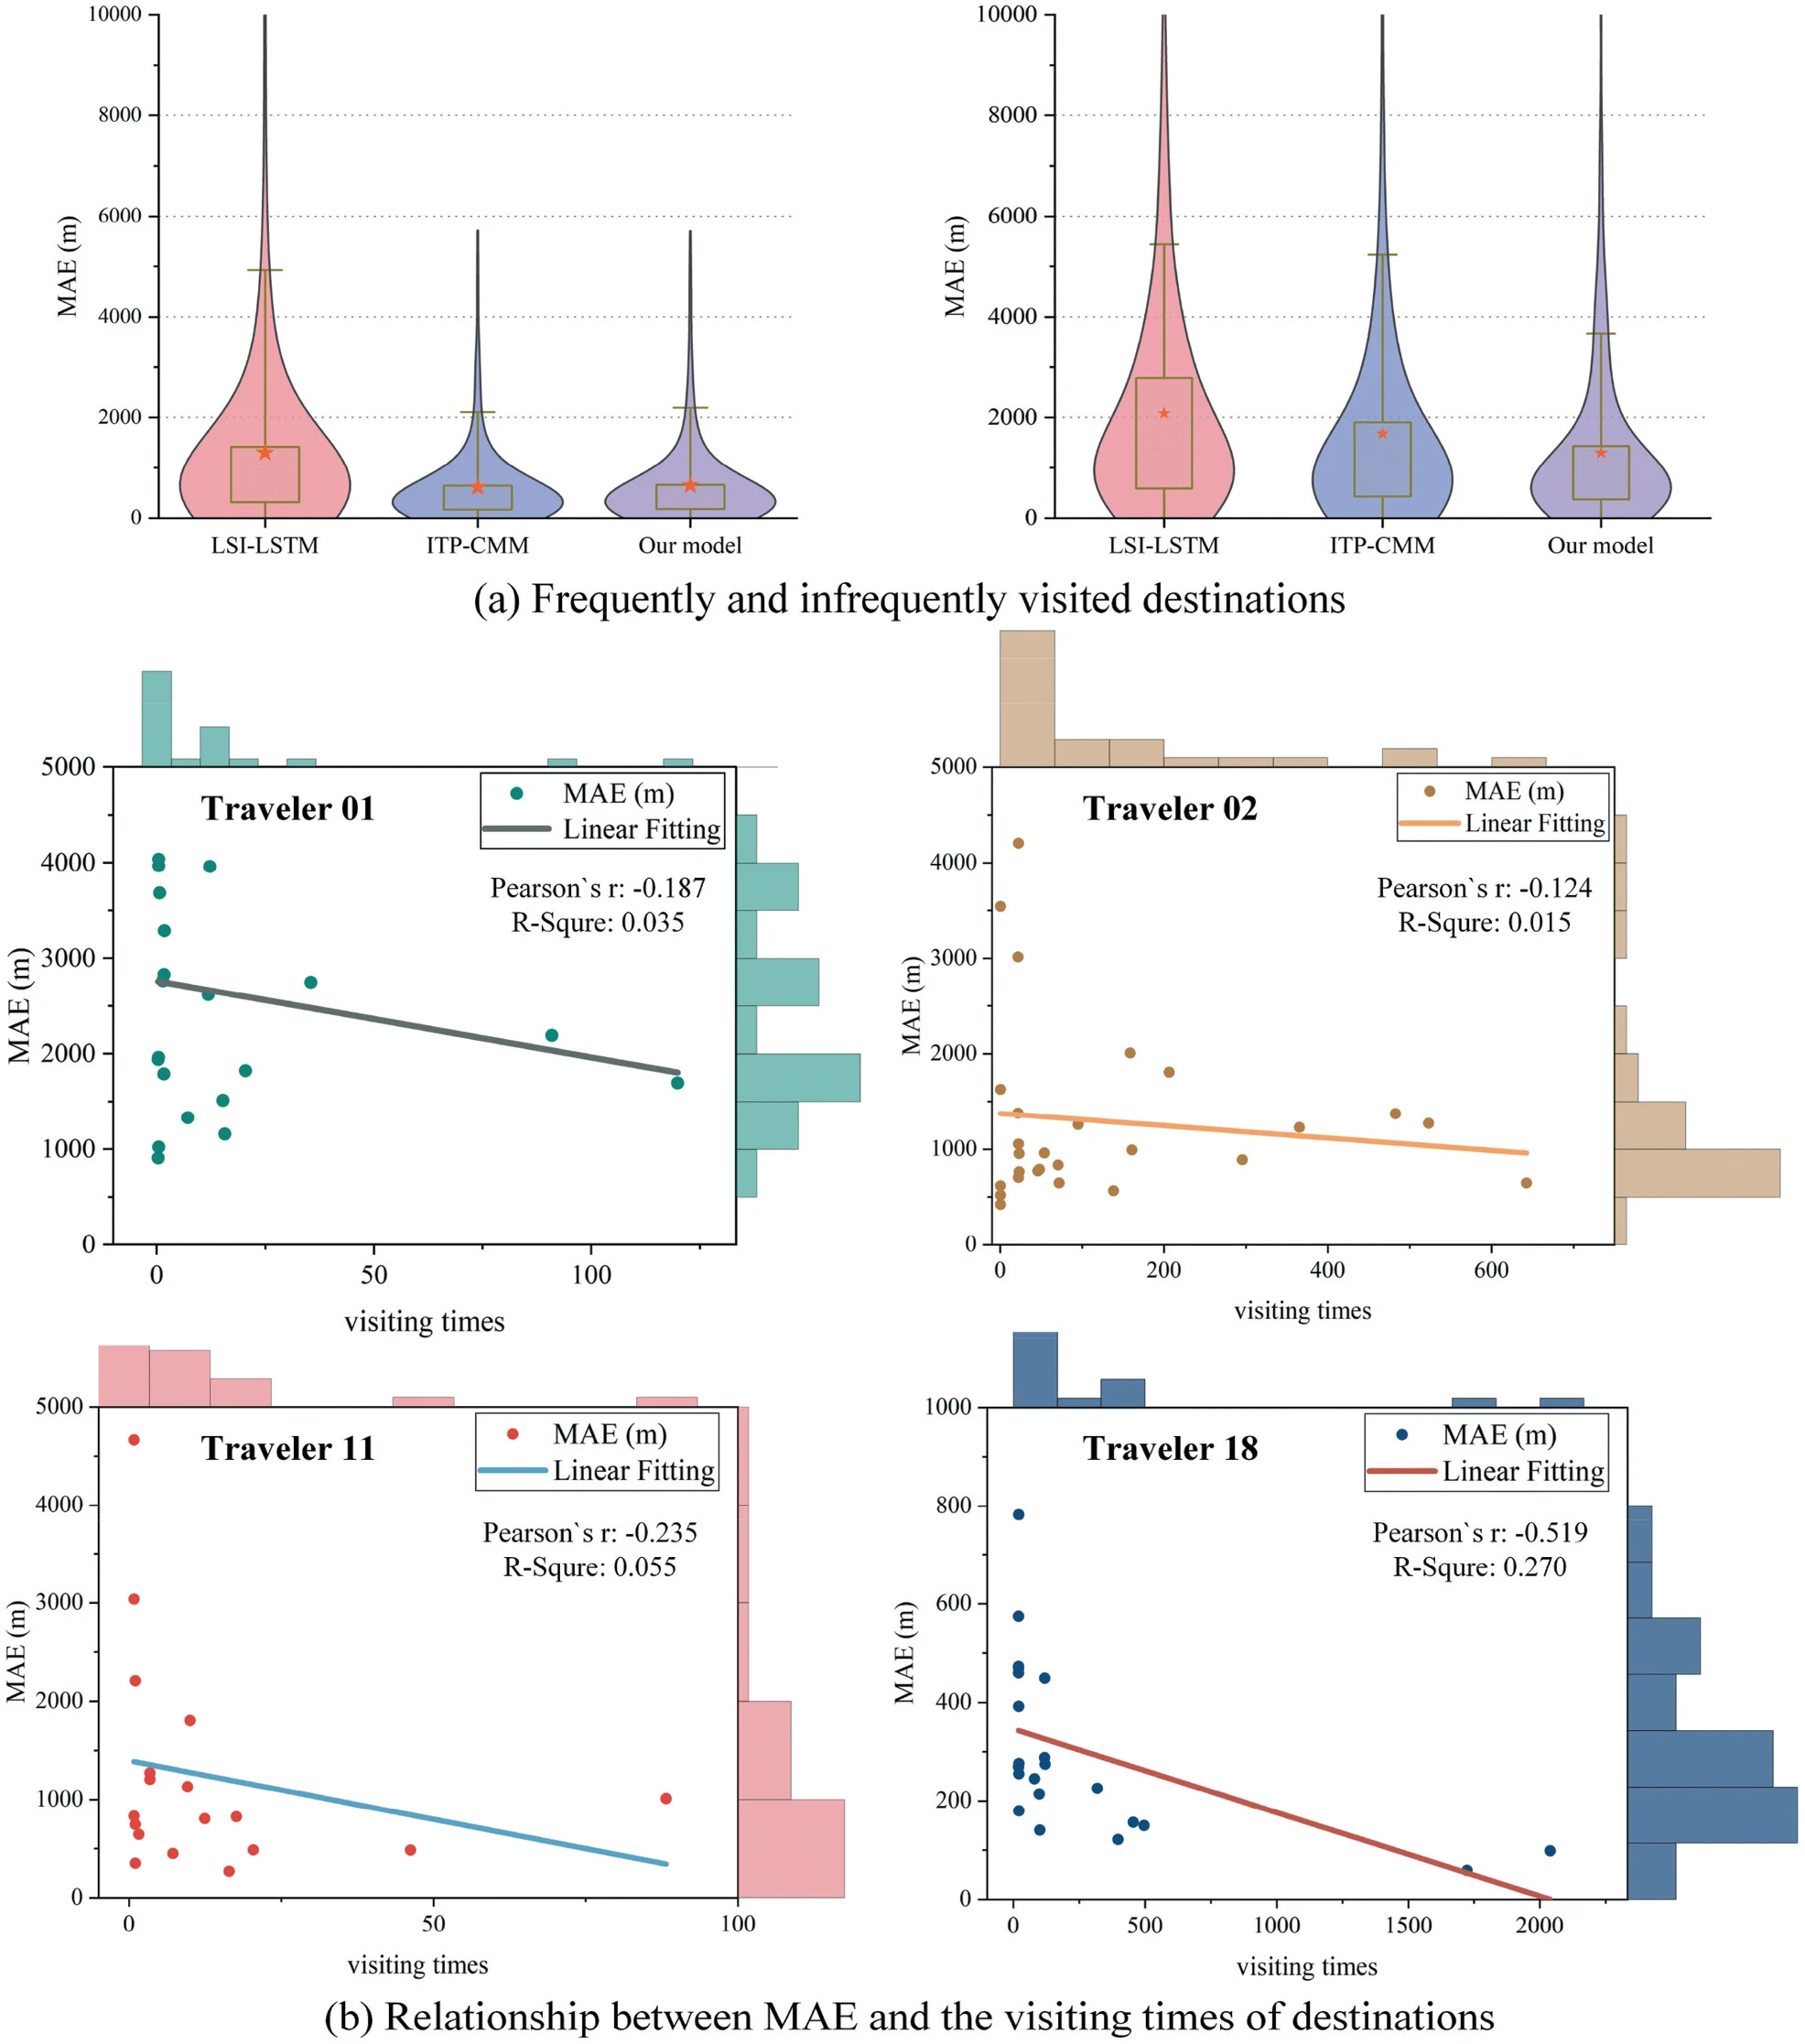
图 14|去得越勤,终点误差越低吗?
(a)左右两图按图题顺序对应常去和不常去的终点。纵轴是 MAE,单位米。每个模型一条小提琴,箱体为四分位,星为均值。左图的箱体和星更低,右图更高,长尾都可以拉到数千米。所提模型在两图中的位置都低于另外两个对照。(b)01、02、11、18 四位出行者,每个点是一个终点的访问次数和 MAE,直线是线性拟合,边缘直方图显示大多数终点访问次数很低。图上印出的 Pearson r 与 R² 依次为:01 号 −0.187 与 0.035,02 号 −0.124 与 0.015,11 号 −0.235 与 0.055,18 号 −0.519 与 0.270。斜率为负,前三人的访问次数几乎解释不了 MAE 的方差。来源:原论文 Fig. 14。
负相关在这四个人里方向一致,强度差很多。18 号的 R² 为 0.270,访问次数能说明约四分之一的 MAE 方差;01、02、11 号的 R² 都低于 0.06。正文写“访问越勤,可预测性越好”,图上的拟合同时说明,这句话不能写成访问次数决定误差。作者提出复制低频终点的轨迹来补充样本。那是对未来做法的建议,这篇实验没有报告复制之后误差变成了多少。
哪几种活动统计和更低的误差排在一起?
20 人的误差差异,被放回八个活动统计上看:平均出行距离 TDavg、RIVL、回转半径 rg、只看两个最常去地点的 Top 2 rg,以及随机熵、地点熵、星期熵和起讫点熵。Top 2 把居住地和工作地当作两个锚点。随机熵假设各地点等概率,地点熵则计入实际访问频率。图 15 按 MAE 从高到低排列这 20 人,紫线是 MAE 的中位数。
平均出行距离和回转半径与误差的同向关系最明显。01、02、03、06、12 在这两项上偏高,MAE 也处于高的一端。他们会偶尔离开居住地周围,那些少见的长距离行程更难预测。11 号是对照:回转半径和平均出行距离都超过 10,三项误差却都偏低。正文把这联系到长距离行程本身很频繁,重复出现的长途比偶发的长途更容易学。图中平均出行距离以公里标注;“超过 10”是正文的说法。
Top 2 rg 的关系弱得多。01 和 08 在这项上排名低,MAE 和 RMSE 仍然高;09 和 17 在这项上高,可预测性只是中等。居住地和工作地之间的来回次数多,距离远近本身不一定拉开误差。
空间熵高的人往往误差也高,01、02、06 被正文作为例子。05 和 10 的空间熵同样不低,却处在可预测性较高的一半。01 的三项误差又低于 02。作者认为更低的星期熵、回转半径或平均出行距离,可以减轻空间熵的影响。这是同一张热力图上的阅读,不是把这些变量拆开后的检验。
星期熵高的人,误差可以仍然处在中位数以下。15 和 18 的星期节奏更散,误差却不高于 09、14、16、17、19、20 这些 MAE 低于中位数的人。正文据此认为作者的模型能够跟上时间上不规则的活动,依据是星期熵与三项误差的相关性较弱。这个相关只说明,给这 20 人按星期熵排序,排不出同样的误差名次。时间上的不规则是否已经被模型吸收,还需要别的检验。
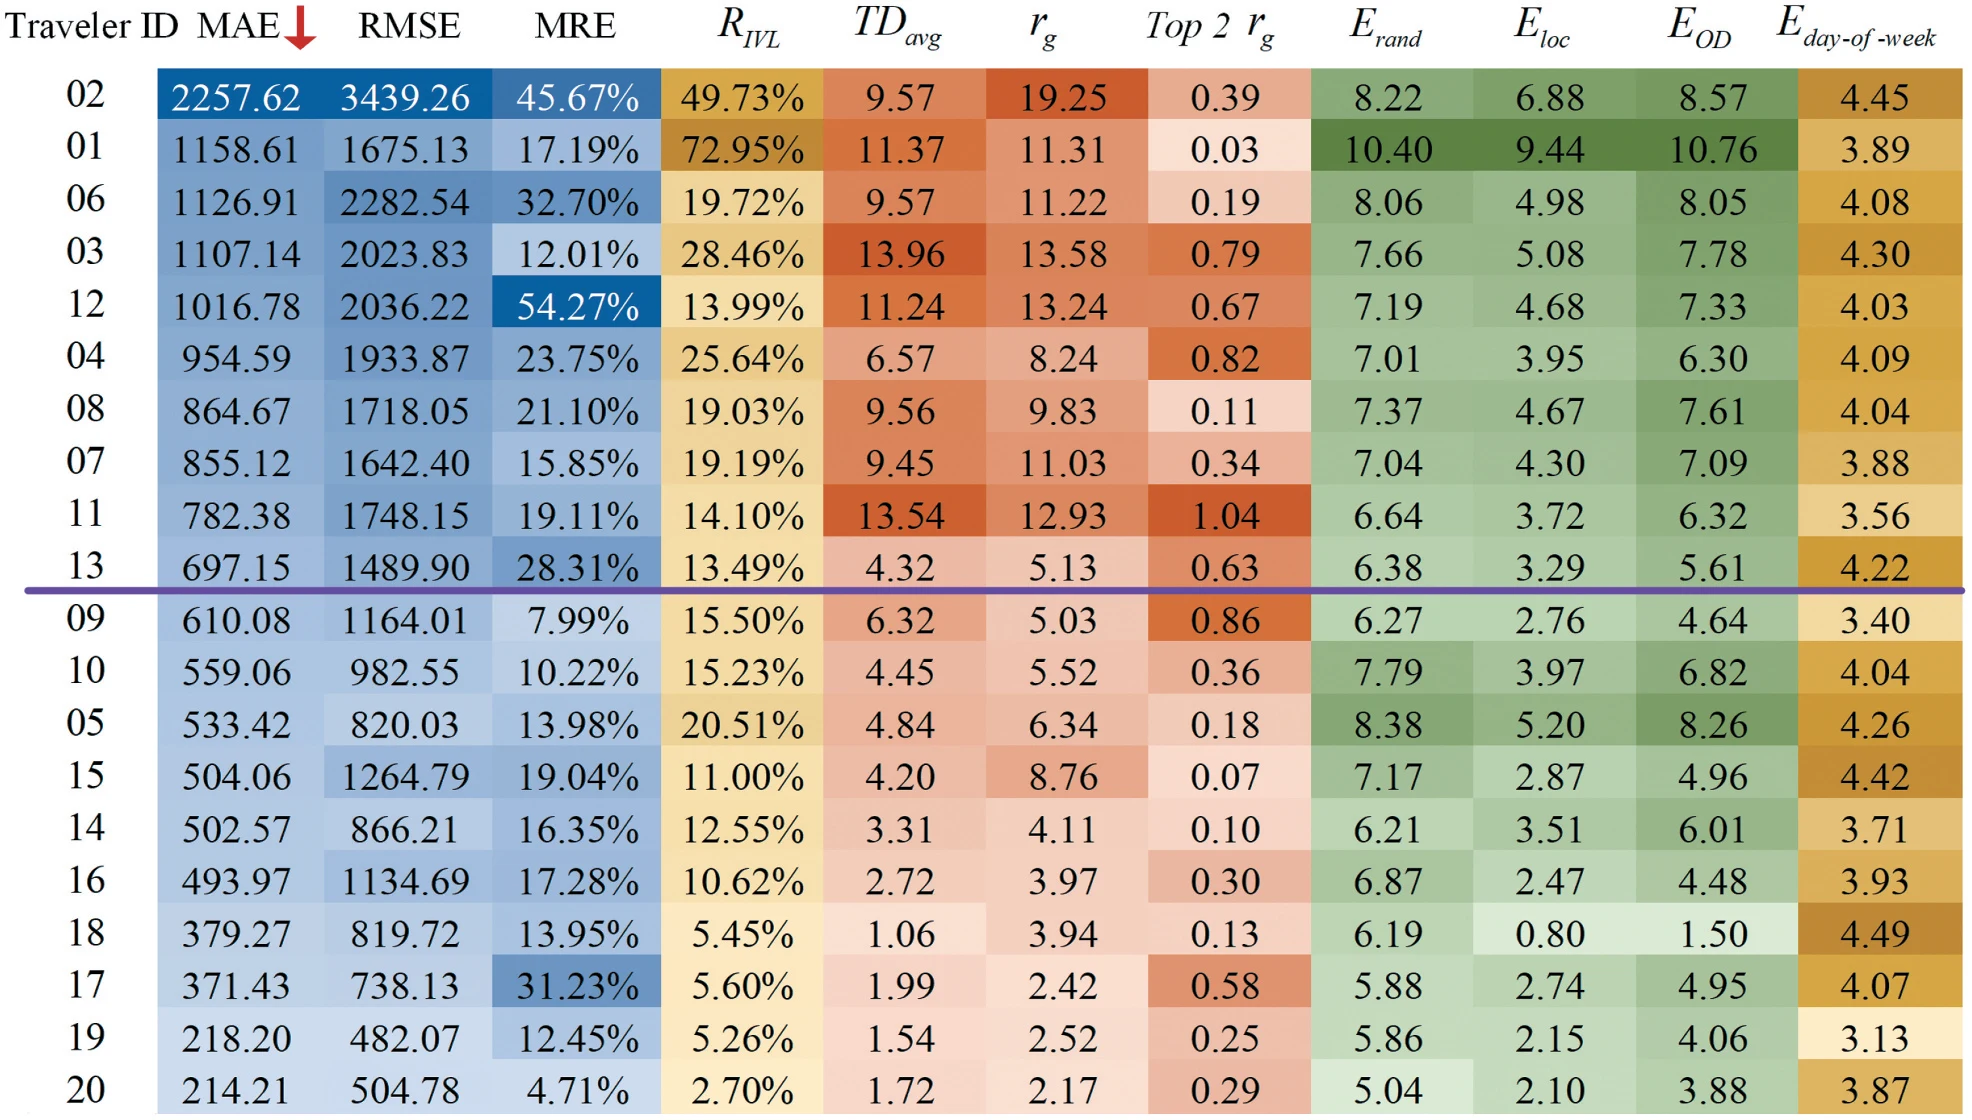
图 15|误差高的人,活动统计也更高吗?
无字母,一整张热力表。行按 MAE 从高到低排列 20 位出行者,紫线是 MAE 中位数。列包括 MAE、RMSE、MRE 和八个活动统计,颜色在各列内部比较高低。平均出行距离和回转半径与左侧误差列更同向,Top 2 rg 和星期熵的列没有同样整齐的梯度。逐格数字以图为准;正文已经点名的对照见上一段。20 行的相关不是因果,也不能外推到这 20 人以外。来源:原论文 Fig. 15。
这些比较还留着哪些边界?
最稳的结论局限在这 20 位深圳私家车出行者、2019 年这一年和作者规定的特征集合里。开车轨迹不是一个人的全部移动。20 个簇各抽 1 人,有助于看到不同类型,也使总体均值对每一个人的权重都很大。
测试行程的前 60% 子轨迹进入了训练,终点聚类又使用了全部行程。表 1 适合比较同一划分下的模型,不适合直接当成对一段从未见过的新行程的承诺。历史链长度的主实验取值没有写明,链长实验本身表明 5 到 15 与 25 的组均值可以差到 1,706.047 米对 747 米这一档。
MRE、MAE 会把模型排成不同的“谁更接近”。LSI-LSTM 的 MRE 几乎与所提模型相同,MAE 却高出约 37.9%。服务若在意短途上的米数,只看 MRE 会把短途的大误差缩小。第(IV)组上所提模型的误差仍略高于 LSI-LSTM。
意图向量来自 1,000 米网格里的兴趣点构成,不是出行者说出的目的。第五个分量上的 0.480 被解释成可能回家,这是作者对一个例子的阅读。路口词向量能把共同经过的路口聚在一起,拟合更好也不等于找到了唯一的出行机制。访问次数与 MAE 的负斜率,在四个人里有三个人的 R² 低于 0.06。
论文没有报告独立的下一年或另一座城市。未来工作里提到的轨迹复制、多任务路线预测和用相似人群弥补冷启动,都还没有在这篇实验里给出新的误差表。
一句话总结
在这 20 位深圳私家车出行者的 2019 年行程上,当前路口特征把平均终点误差拉近得更多,历史活动链提供了有限且因人而异的补充;链多长、终点是否常去都会改变米数,总平均更低的同时,组间、人和终点类型之间的差距仍然在。
核心来源
- Geo-spatial Information Science 在线发表页面,DOI:10.1080/10095020.2025.2455005。2025年2月4日在线发表,文内注明初版有误并已在网上更正。
- 论文图 1 至图 16 都在这份 PDF 中。图 16 的说明和出行意图算法位于文末附录。论文给出的代码与实验统计数据入口为 GitHub 上的 Travel-Destination-Prediction。公开的是代码和实验统计,原文没有把原始个人轨迹写成公开数据。
作者介绍
署名机构以论文首页为准。武汉大学遥感信息工程学院、测绘遥感信息工程国家重点实验室、地理空间技术协同创新中心,以及宁夏大学、中国地质大学(武汉)、东京大学和武汉大学经济与管理学院分别出现在不同作者名下。以下只采用论文中的作者简介。
- Xiaotong Zhang:中国地质大学(武汉)与武汉大学地理信息工程专业毕业,解读时为香港理工大学土木与环境工程学系博士生。论文列出的兴趣是个体移动预测和人对城市环境的感知。
- Zhipeng Gui:武汉大学遥感信息工程学院教授,通讯作者。兴趣包括地理空间人工智能、时空数据分析和高性能地理计算。
- Yuhang Liu:武汉大学遥感与地理信息科学专业毕业,解读时为测绘遥感信息工程国家重点实验室博士生,兴趣是人类移动性与地理信息科学。
- Dehua Peng:武汉大学遥感与地理信息科学专业毕业,解读时为遥感信息工程学院博士后。兴趣包括机器学习、空间分析和点模式挖掘。
- Qianxi Lan:武汉大学遥感科学与技术专业毕业,解读时为遥感信息工程学院硕士生,兴趣是人类移动性。
- Zhangxiao Shen:武汉大学测绘工程专业毕业,解读时为测绘遥感信息工程国家重点实验室硕士生,兴趣是时空数据挖掘。
- Huan Chen:武汉大学测绘工程专业毕业,解读时为该国家重点实验室博士生。兴趣包括流的模式、人类移动性和空间数据挖掘。
- Yuhui Zuo:中国地质大学(北京)地理信息科学专业毕业,解读时为该国家重点实验室硕士生,兴趣是时空大数据。
- Yao Yao:论文介绍其为中国地质大学(武汉)教授、东京大学研究人员。兴趣是地理空间大数据挖掘、分析和计算城市科学。
- Huayi Wu:武汉大学测绘遥感信息工程国家重点实验室教授。兴趣是高性能地理计算和智能地理空间网络服务。
- Kai Li:武汉大学经济与管理学院气候变化与能源经济研究中心副教授。论文列出的研究方向是世界经济、低碳经济与产业创新。
- Kun Qin:武汉大学遥感信息工程学院教授。兴趣包括时空大数据、遥感影像挖掘,以及面向人文社会科学的地理计算。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
链长实验已经暗示,一组人的合适记忆长度会妨碍另一组。若第(II)组在短链上更好、第(III)组在长链上更好,给所有人固定一个长度,就是在用一组的米数换另一组的米数。更有信息量的检验,是先只用每个人过去的重访比例选择链长,再在完全没有参与选择的后续月份上报告 MAE。2019 年内部按 3:2 划分、又把测试行程前 60% 放回训练的做法,回答不了“下个月还是否成立”。
另一个值得分开的量是短途上的米数。LSI-LSTM 的 MRE 几乎追平所提模型,MAE 仍高出约 464.563 米,因为 MRE 的分母是行程总出行距离,长途会把大误差缩小。若把行程按总出行距离分成短、中、长三档,并事先写明切分点,两个模型的排名可能对调。访问次数的 R² 在四个人里有三个人低于 0.06。地点熟不熟只盖住图上那一小部分方差,剩下的大头仍可能来自当天已经走过的路口。