没有逐人出行记录,人口和距离能不能代替行为数据?
论文名片|Zhenyu Han、Fengli Xu、Yong Li、Tao Jiang、James Evans,Model predicted human mobility explains COVID-19 transmission in urban space without behavioral data,Scientific Reports,2025,15:6365。DOI:10.1038/s41598-025-87363-3。稿件于2024年6月15日收到、2025年1月17日接收。本文依据这份正式发表版解读。
城市里要比较哪些一公里见方的格子更该限制出行,常见办法是调手机轨迹、问卷接触表或公交刷卡。这些行为数据既涉及隐私,在不少中低收入国家也很难拿到。另一端是把整座城市当成一个均匀混合的池子,曲线往往只剩指数上升,或者几乎不上升。
这项研究把格子之间的人流交给一个很短的引力模型:人多的地方更吸引到访,距离远的地方更少人去。出行强度不从轨迹里统计,而和病例曲线一起校准。在美国、印度、巴西共30个发病较多的县和城市里,这样算出的累计确诊曲线都能跟上各自不同的形状。它给出的是模型里的出行强度和格子上的集中程度,是拟合和情景比较,不是把每个人的行程直接数出来。
先说结论
- 30个县市的累计确诊曲线,本文模型的 R² 都高于 0.980。对照是把整座城市当成均匀混合,只能得到指数增长或几乎不增长。
- 美国20个县在4月第一周前后的出行降幅,模型估计与苹果出行趋势的皮尔逊相关为 0.872。拟合出的平均出行强度 M 从 1.09×10⁻⁴ 降到 7.26×10⁻⁵,相对下降 33.4%;正文给出的观测降幅平均约 30.3%。
- 按邻里平均的感染者—被感染者比排序后,感染风险最高的 20% 邻里对应 68.3% 的后续感染。只保留“终点人口吸引流量”时,空间不均衡接近完整模型;只保留距离成本时,接近随机走动。
- 美国县把被限制人口定为全市人口的 5% 时,按模型风险选格子,累计感染比不干预少 60.13%;只选人口最多的格子,少 28.49%。德里与模型选点的重合度为 8.70%,圣保罗为 84.38%,洛杉矶图题为 57.14%。
- 把20个美国县的出行活动在现实水平上提高 10%,相对各县实际期末确诊的中位数变为 2.93 倍(四分位距 1.57–7.24);降低 10% 则变为 0.525 倍(四分位距 0.237–0.783)。这是模型情景。
格子之间的人流,用什么代替手机轨迹?
分析单位是城市里的邻里:1 公里 × 1 公里的格子。每个格子的人口取自 WorldPop。格子内部,模型假定人与人的接触机会相同。这个假定把格子内部的行为差异先放平,格子之间的差别才交给出行模型。
格子 m 到格子 n 的预测流量写成:
预测流量 = M ×(起点人口的 ρ 次方)×(终点人口的 θ 次方)÷ exp(两地曼哈顿距离 / r)。
M 是全城出行强度,ρ 和 θ 表示两端人口对流量的拉力,r 表示距离衰减有多快。距离用的是曼哈顿距离,也就是沿格子横平竖直走的距离,不是路网时间,也不是欧氏直线。正文说 ρ、θ、r 是预先给定的系数,具体数值放在补充表,不在这份正文里。流出的人按出发格子当时的人口构成比例分配到目的地。
真正从病例曲线里学习的出行量,是这个 M。作者按各国全国性干预把模拟时期切开,每一段单独拟合,因此 M 可以在政策前后取不同值。拟合只用官方累计确诊,不喂入轨迹。实验在 40 次运行里保留 10 个最优模型。图 1 的色带是 99% 置信区间;正文没有写出这个区间的计算公式。
对照模型把一座城市收成一个池子,人与尚未被隔离的人均匀接触,中间没有格子之间的流量。它和本文模型共享“城市是分区还是一整锅”这一处差别,用来看异质的格子间流动是否必要。
样本是美国、印度、巴西发病最多的 30 个县和城市,不是从全部城市里随机抽取。图 1A 的 20 个美国县是 Bergen、Cook、Davidson、Harris、Hillsborough、Hudson、King、Los Angeles、Miami-Dade、Middlesex、Nassau、New Haven、New Orleans、New York City、Oakland、Ocean、Philadelphia、Suffolk、Union、Will。印度是 Bengaluru、Delhi、Mumbai、Pune、Thane。巴西是 Belo Horizonte、Brasília、Fortaleza、Rio de Janeiro、São Paulo。确诊分别来自约翰斯·霍普金斯大学汇总、covid19india.org 和巴西卫生部。各城窗口的起止日期在补充表,正文只给出曲线和干预时点。
均匀混合为什么对不上这 30 条曲线?
这 30 条累计曲线形状并不一样。正文把它们分成四类:Hudson、King 和多数巴西城市接近直线;Bergen、Miami-Dade、Nassau 等向下弯;Cook、Davidson、Los Angeles 等向上弯;Harris、New Orleans、Will 和多数印度城市呈 S 形。分类用的是“等”和“多数”,其余县市没有在正文里逐一归类。
均匀混合对照在基本再生数大于 1 时给出指数增长,小于 1 时几乎不增长,跟不上这些弯曲。加上引力流量之后,蓝色曲线在全部 30 个县市的 R² 都高于 0.980。R² 的分母是各城市自己的累计确诊相对其均值的波动;累计曲线本身平滑,这个分数容易偏高。正文另外报告日新增的确诊,R² 最高到 0.936,相对均匀混合对照的改进在所有城市里至少有 12.3%。日新增的分城市分数在补充图里,这份正文只给了这个上界和最小改进。
把引力模型换成辐射模型,正文说与图 1 的差别可以忽略。把格子从 1 公里放大到 10 公里,R² 下降不到 5%;方法部分写明,线性增长的情形降幅仍不到 5%。这两项检验说明“必须有某种随人口和距离变化的格子间流动”,并没有单独证明引力公式是唯一写法。
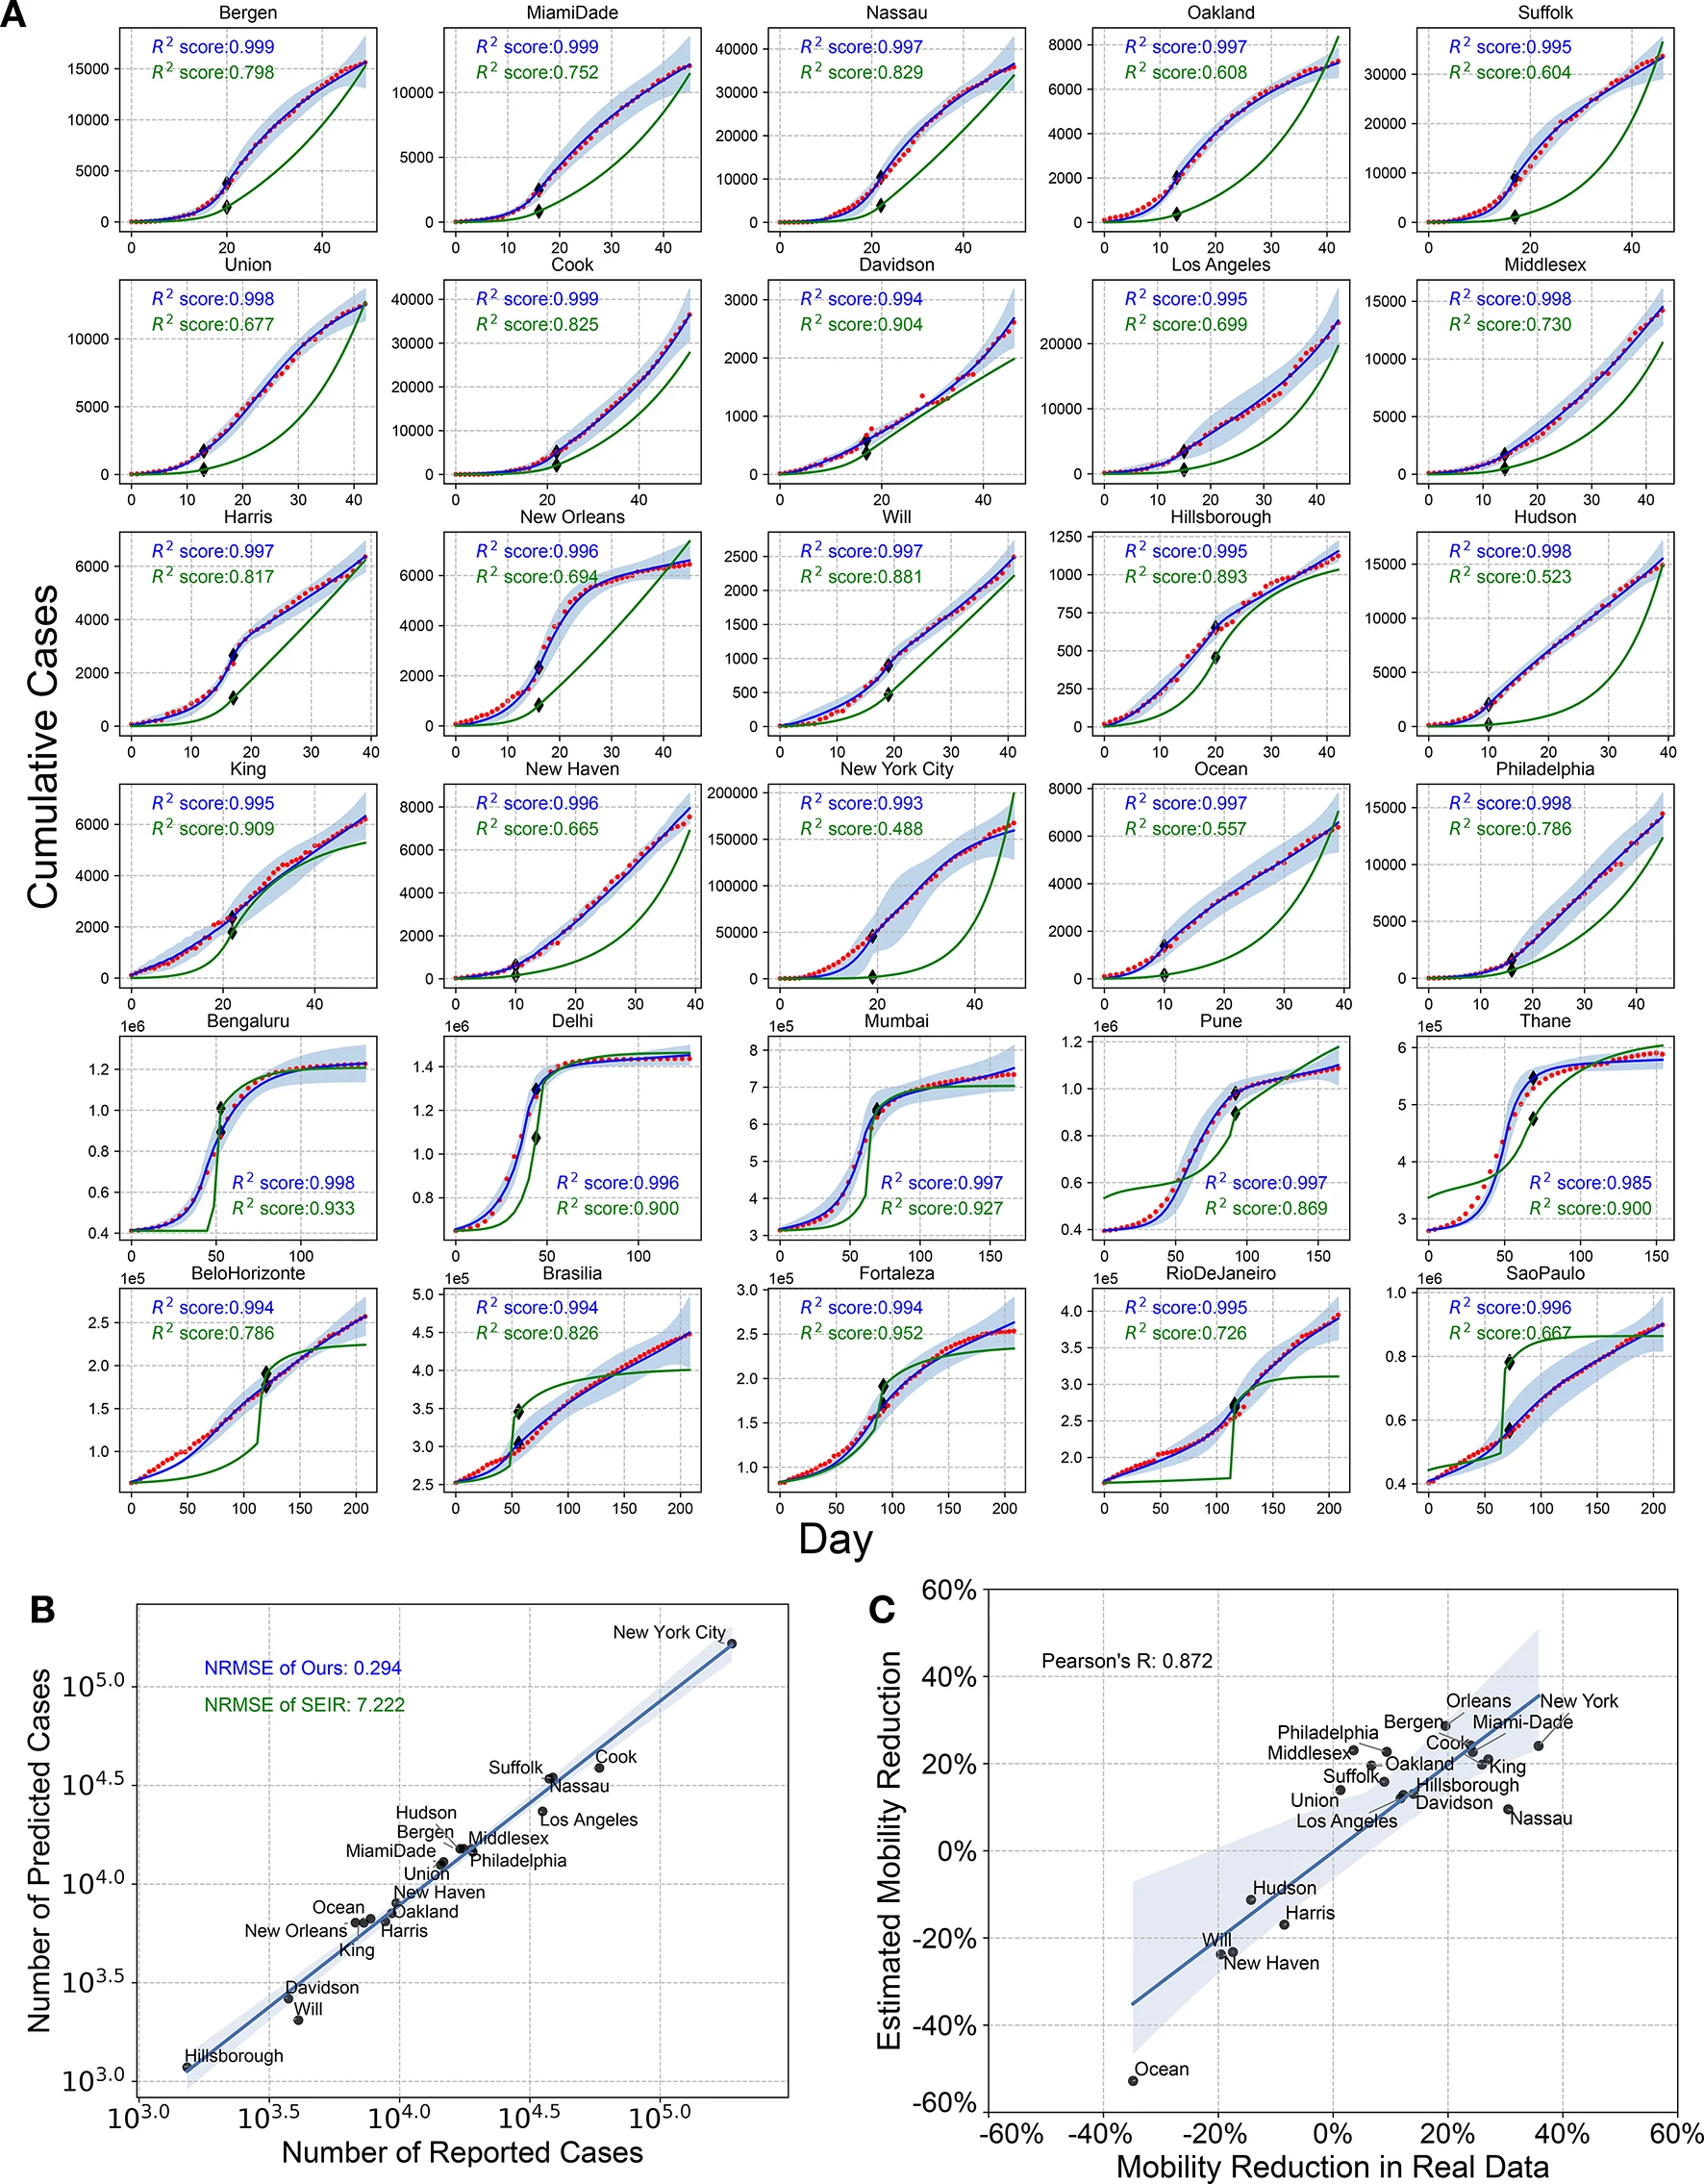
图 1|没有轨迹时,累计曲线和出行降幅还能对上吗?
(A)30 个小图各是一个县或城市。横轴是模拟日,窗口长度并不相同,美国县大多画到约 40 天,巴西城市大多画到约 200 天。纵轴是累计确诊。红点是官方记录,蓝线是引力模型,绿线是均匀混合对照,菱形是干预时点,色带是 99% 置信区间。每个小图印有蓝、绿两个 R²;正文概括蓝色 R² 全部高于 0.980。(B)20 个美国县未来 14 天确诊的预测。横轴是报告确诊数,纵轴是预测数,均为对数坐标。本文模型的归一化均方根误差 NRMSE 为 0.294;图上把均匀混合对照标成 SEIR,并印出 7.222。正文没有说明 NRMSE 除以什么。(C)仍是这 20 个美国县,比较 4 月第一周前后的出行降幅。横轴是苹果出行趋势里的实际降幅,纵轴是模型估计的降幅,皮尔逊相关 0.872,色带是 99% 置信区间。Ocean 等点明显离开拟合线,相关是县与县之间的一次前后对比。来源:原论文 Fig. 1。
模型估计的 M 是在病例曲线上校准出来的出行强度,不是行程次数。对上述美国县,M 的平均水平从 1.09×10⁻⁴ 降到 7.26×10⁻⁵,以前者作分母,降幅为 33.4%。正文另引补充图写明,这些县观测到的出行降幅平均约 30.3%,四分位距为 0.227–0.392。33.4% 和 30.3% 量级接近,分母却不同:前者是拟合参数 M 的相对变化,后者是外部出行报告的降幅。0.872 描述的是各县这两个降幅是否一起高低,不是把 33.4 和 30.3 当成同一个数。
未来 14 天的预测只覆盖 20 个美国县,NRMSE 0.294 对的是这段前瞻窗口里的报告确诊。它说明用已经校准的出行强度可以外推一小段累计规模,不能换成“任意城市、任意长度的预报误差”。
风险集中在少数格子,是因为人多,还是因为人往人多的地方去?
全城一条曲线对上之后,还要看感染是不是均匀摊在格子上。论文用感染者—被感染者比给邻里排序:每个时间点上,先前感染者对应多少后续感染,再对整个时期取平均。比值越高,这个格子在该时点的后续感染越集中。若风险在空间上均匀,累计分布应沿着图中的黑色虚线上升。
实际分布偏斜。按这个比值从低到高排列,最低的 80% 邻里只占感染者的 42.2%、后续感染的 31.7%;剩下 20% 的邻里对应 68.3% 的后续感染。基尼系数把这种不均衡压成 0 到 1 之间的一个数,后续感染为 0.630,感染者为 0.553。色带是各城市县的四分位距。这里的分母是模型在这些邻里上算出的感染者和后续感染,不是接触追踪登记的人数。
纽约市用社区尺度的实际确诊做了一次外部对照。预测确诊的名次和实际确诊的名次,斯皮尔曼相关为 0.583。0.583 表示名次大体同向,离“每个社区都排对”还远。图 2B 的颜色是 10 级核密度,越亮表示点越密。
人口分布本身高度不均。正文报告,人口规模与感染风险的斯皮尔曼相关为 0.74,散点在补充图中。只把人口地图留下、把引力流动换成随机走动,基尼系数降到感染者 0.090、后续感染 0.198。只保留距离成本时,图上的基尼系数是后续感染 0.175、感染者 0.108,和随机走动同一量级。只保留终点人口对流量的吸引时,后续感染 0.632、感染者 0.539,和完整模型的 0.630、0.553 接近。
因此,偏斜主要出现在“真实的人口地图”加上“人往人多的格子去”这一条规则上。距离成本单独加上去,并没有制造同样的集中。这仍是模型规则的对照,说明哪一条出行假设能再现空间不均衡,并不是把某次聚集事件的成因做成了个案鉴定。
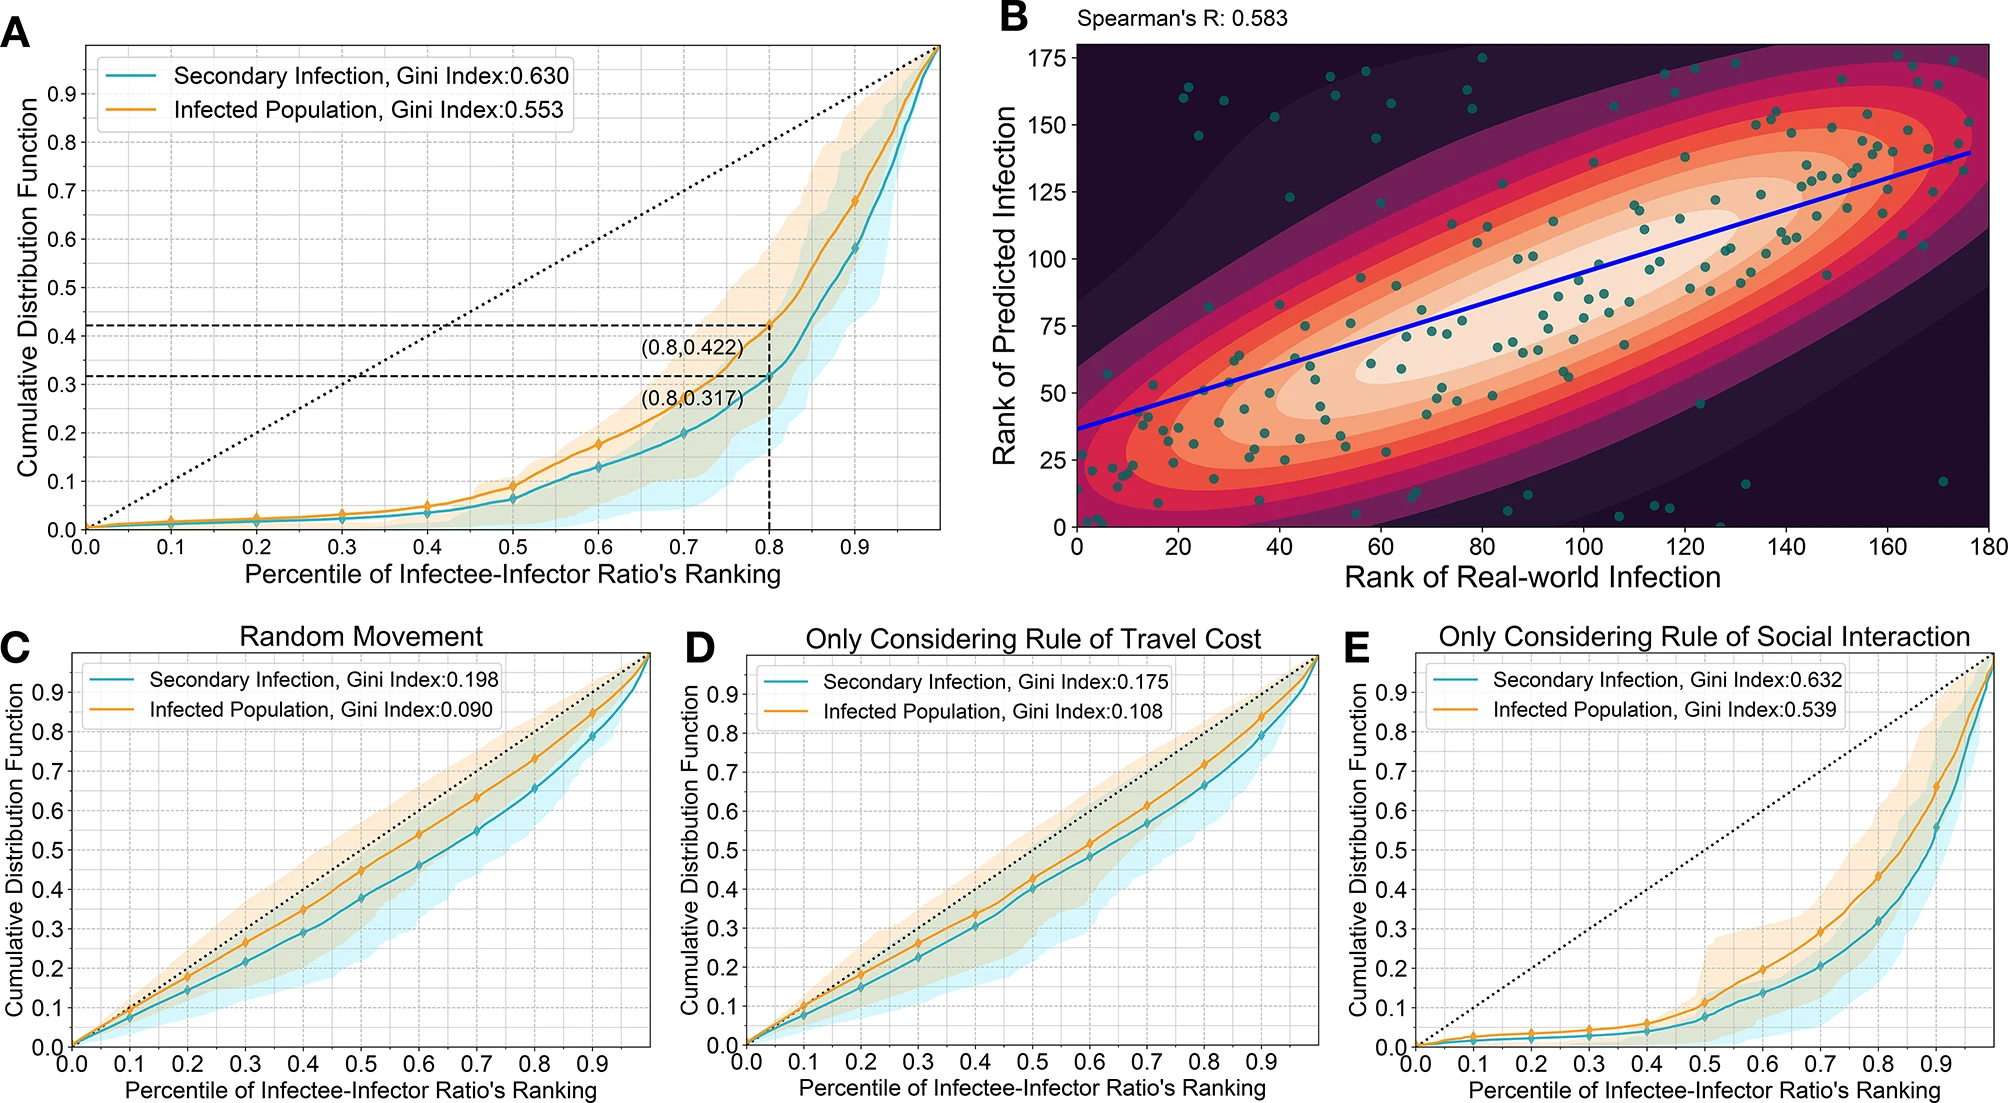
图 2|少数格子占掉大部分后续感染,换掉哪条出行规则它就消失?
(A)横轴是感染者—被感染者比的排名百分位,纵轴是累计分布。橙色是感染者,蓝色是后续感染,黑色虚线是均匀分布,色带是四分位距。竖线标在 0.8,对应感染者 0.422、后续感染 0.317。基尼系数分别为 0.553 和 0.630。(B)纽约市各邻里。横轴是实际感染名次,纵轴是预测名次,范围大约到 180;蓝线为趋势,颜色从暗到亮是 10 级核密度。斯皮尔曼相关 0.583。(C)保留人口分布、改为随机走动。后续感染基尼系数 0.198,感染者 0.090。(D)只保留距离成本。后续感染 0.175,感染者 0.108。(E)只保留社会互动、也就是终点人口对流量的吸引。后续感染 0.632,感染者 0.539。来源:原论文 Fig. 2。
同样只限制一小部分人口,选哪些格子差很多?
若后续感染集中在少数格子,限制出行就可以只覆盖一小部分人口。论文把社会成本定义成被限制人口占全市人口的比例。美国县的预算明确写成 5%。效果定义成:与不干预相比,累计确诊少掉的比例。图里的黑色线标为完全重新开放,对应这个不干预情景。
两种对照共用同一个预算。一种是随机选格子,一种是优先选人口最多的格子,正文称后者为人口优先。人口优先在美国县能少掉 28.49% 的累计确诊,已经高于随机选择。按模型预测风险从高到低选格子,累计确诊少 60.13%。印度和巴西重复同一类比较,模型政策分别少 34.41% 和 51.14%。这两个国家的人口预算写在补充表里,正文没有给出百分比,因此这里不能把 5% 套到德里或圣保罗上。
图 3 的纵轴是模型里的累计感染人口比例,实线是各县市的中位数,色带是四分位距。美国、印度、巴西的纵轴刻度不同,线的高度不能直接跨国比较。60.13%、28.49%、34.41%、51.14% 是相对不干预情景的减少比例,不是纵轴上的终点读数。印度和巴西的曲线在第 0 天已经高于 0,窗口开始时已有累计感染。
选点重合度解释了为什么人口优先有时够用、有时不够。洛杉矶被正文当成单中心:人口优先会漏掉中心区周围、人口较少但与密集区联系强的格子;图题给出的重合度是 57.14%。德里中心密、外围疏,人口优先很难覆盖外围,与模型选点只重合 8.70%。圣保罗的人口高峰彼此离得远,格子的重要性更接近人口规模本身,重合度达到 84.38%。重合度的分母是两套政策选出的位置,正文没有逐城列出被选格子的个数。
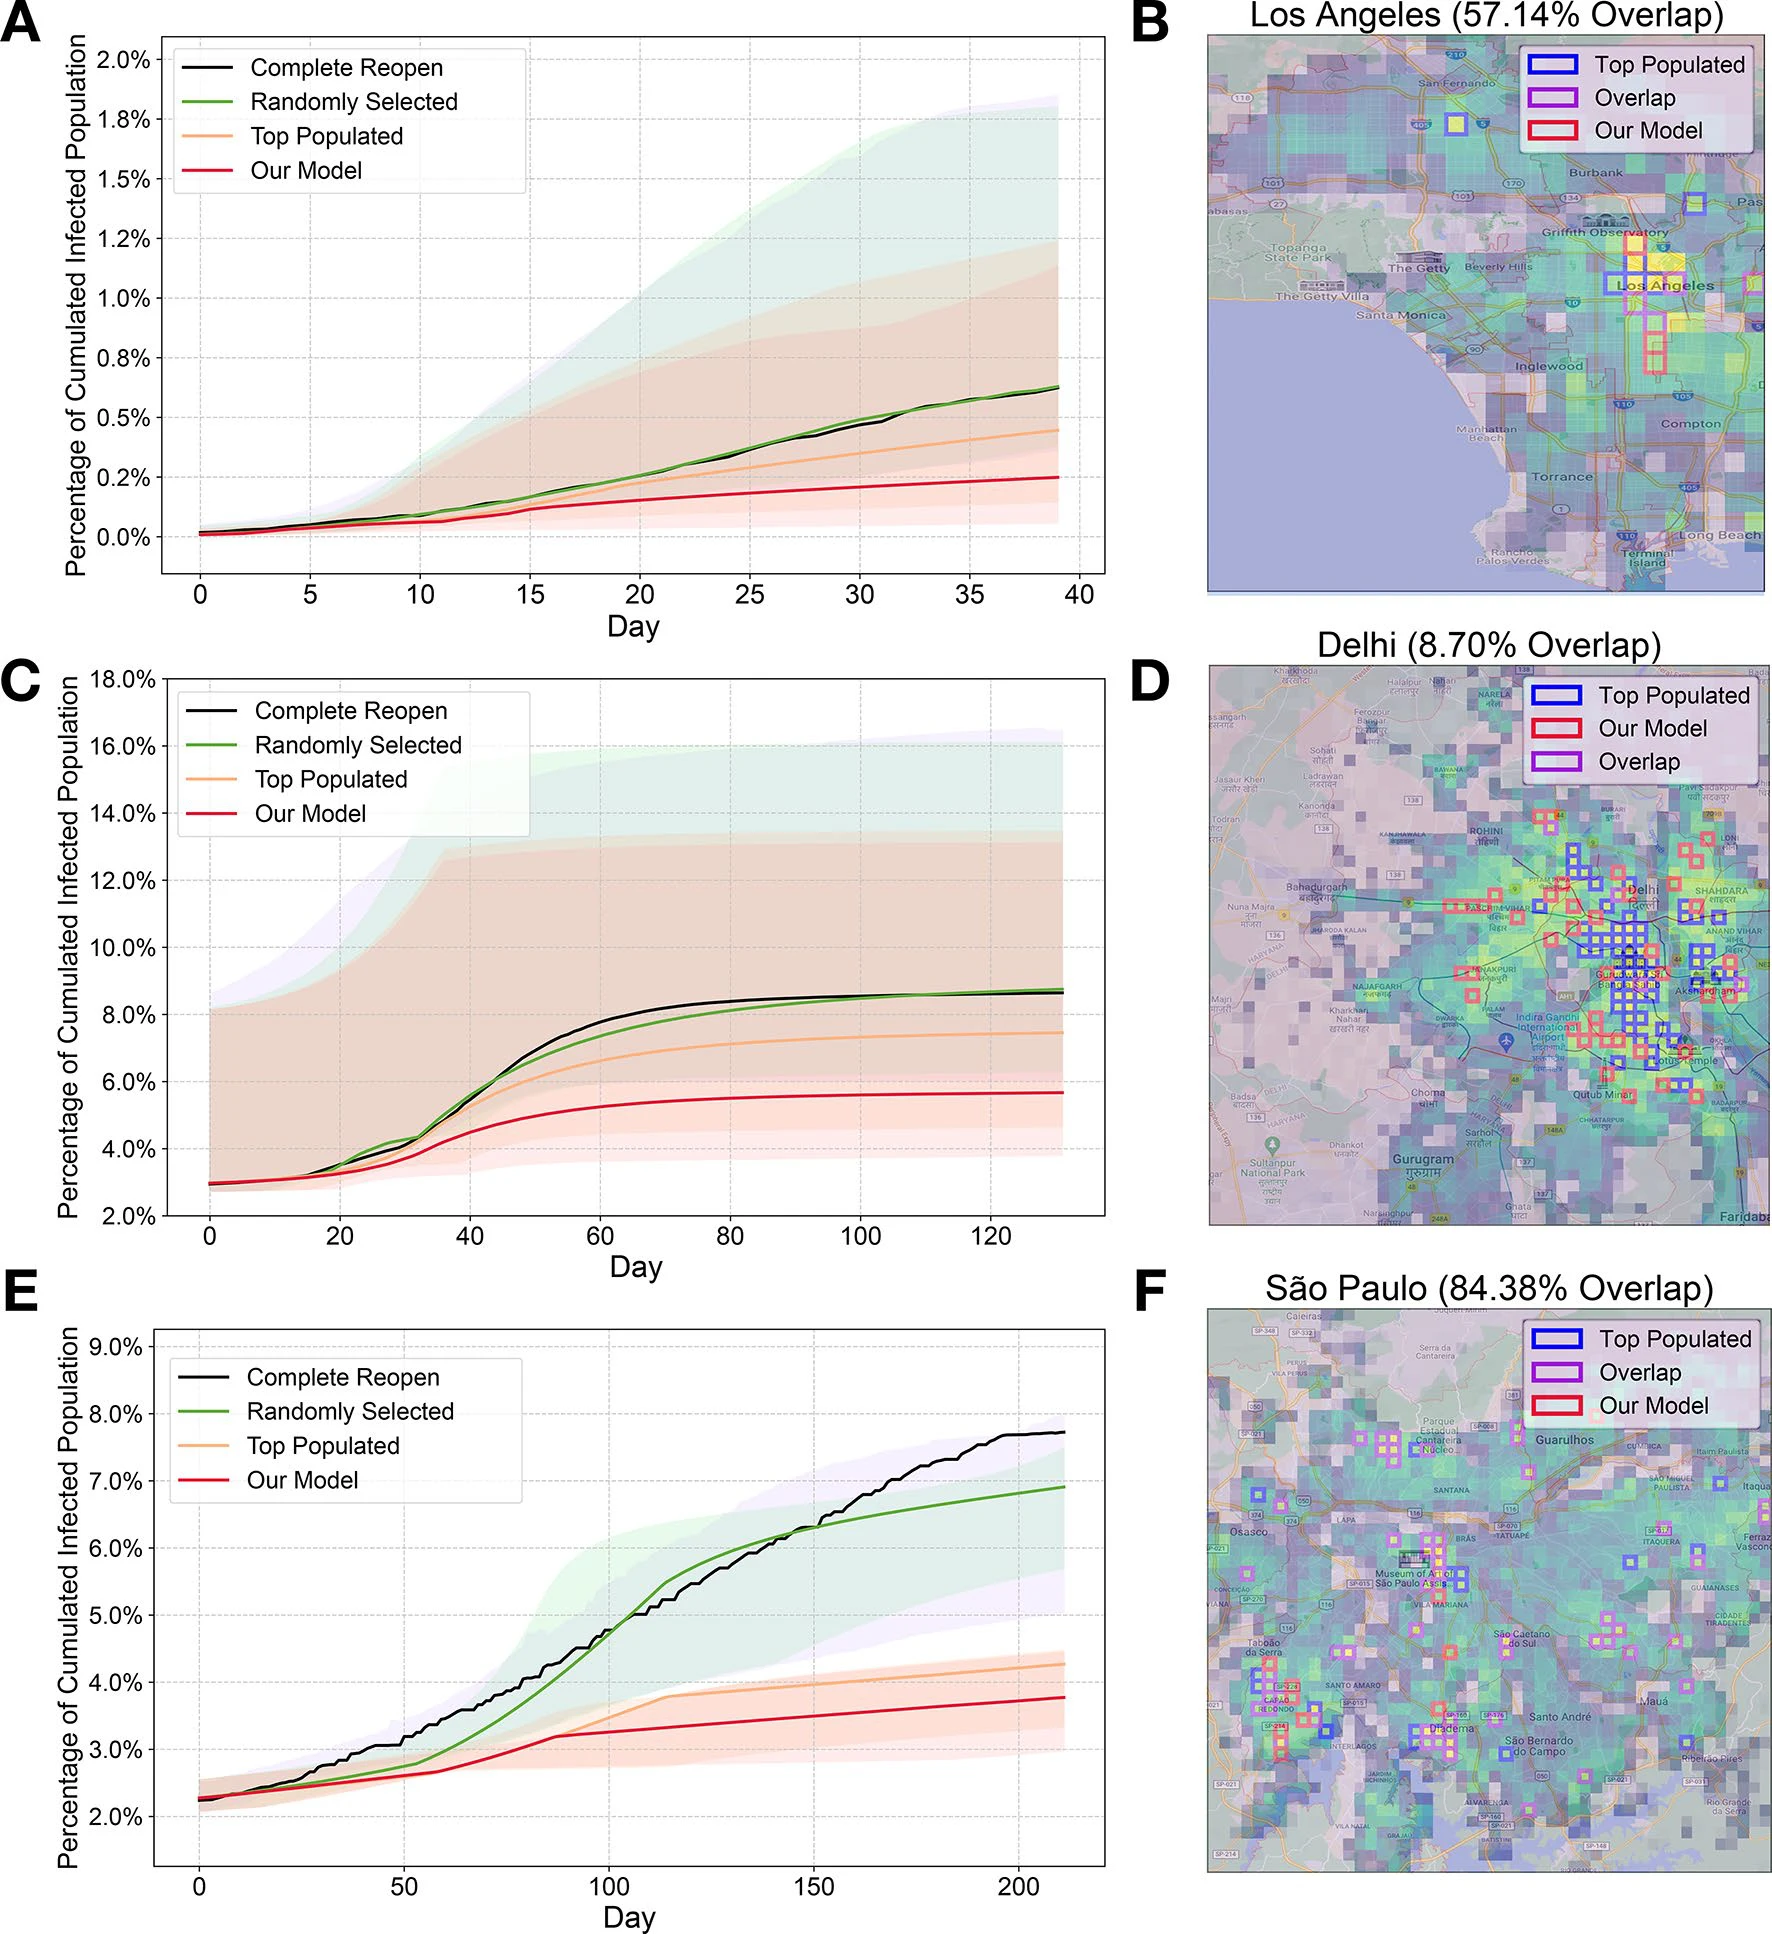
图 3|人口预算相同时,按风险选格子和按人口选格子差在哪里?
(A、C、E)分别是美国县、印度城市和巴西城市。纵轴是累计感染人口比例,横轴是日。黑线为完全重新开放,绿线为随机选择,橙线为人口优先,红线为本文模型;实线是中位数,色带是四分位距。三国纵轴刻度不同。(B、D、F)洛杉矶、德里和圣保罗的选点。蓝框是人口优先,红框是本文模型,紫框是二者重合。图题重合度依次为 57.14%、8.70%、84.38%。底图是人口或建成区的空间分布,颜色深浅不是第三套政策。来源:原论文 Fig. 3。
只改出行强度,城市合计的规模怎么变?
前一张图比较的是“限制哪些格子”。图 4 改的是全城强度,对象仍是 20 个美国县。每个县的累计规模,都除以该县研究期末的实际确诊数,所以现实情景的线靠近 1。实线是 20 个县的中位数,色带是四分位距,横轴大约 50 天。
出行活动比现实高 10% 时,这个归一化规模的中位数为 2.93 倍,四分位距 1.57–7.24;低 10% 时为 0.525 倍,四分位距 0.237–0.783。分母是各县自己的实际期末确诊,不是 20 个县加总后再除一次。四分位距很宽:中位数 2.93 不能当成每个县都会变成大约三倍。作为对照,前面说的观测降幅平均约 30.3%,大于这里的 10% 情景。图上还有 5% 的增减曲线,正文没有给出对应倍数。
(B)把感染率增减 5% 或 10%。(C)把隔离率增减 5% 或 10%。(D)把出行行为改变的时点提前或延后 5 天、10 天,竖线标出这些时点。正文报告的 10% 或 10 天结果,用的仍是“相对各县实际期末确诊”的中位数:感染率降低 10% 为 0.524 倍(四分位距 0.231–0.661);隔离率降低 10% 为 1.29 倍(1.06–2.38),提高 10% 为 0.221 倍(0.0739–0.525);延后 10 天为 3.26 倍(1.58–9.53),提前 10 天为 0.425 倍(0.12–0.71),也就是少 57.5%。这些是同一套模型里的情景倍数。速率和时间点怎样设进方程,不属于出行测量,这里不展开。
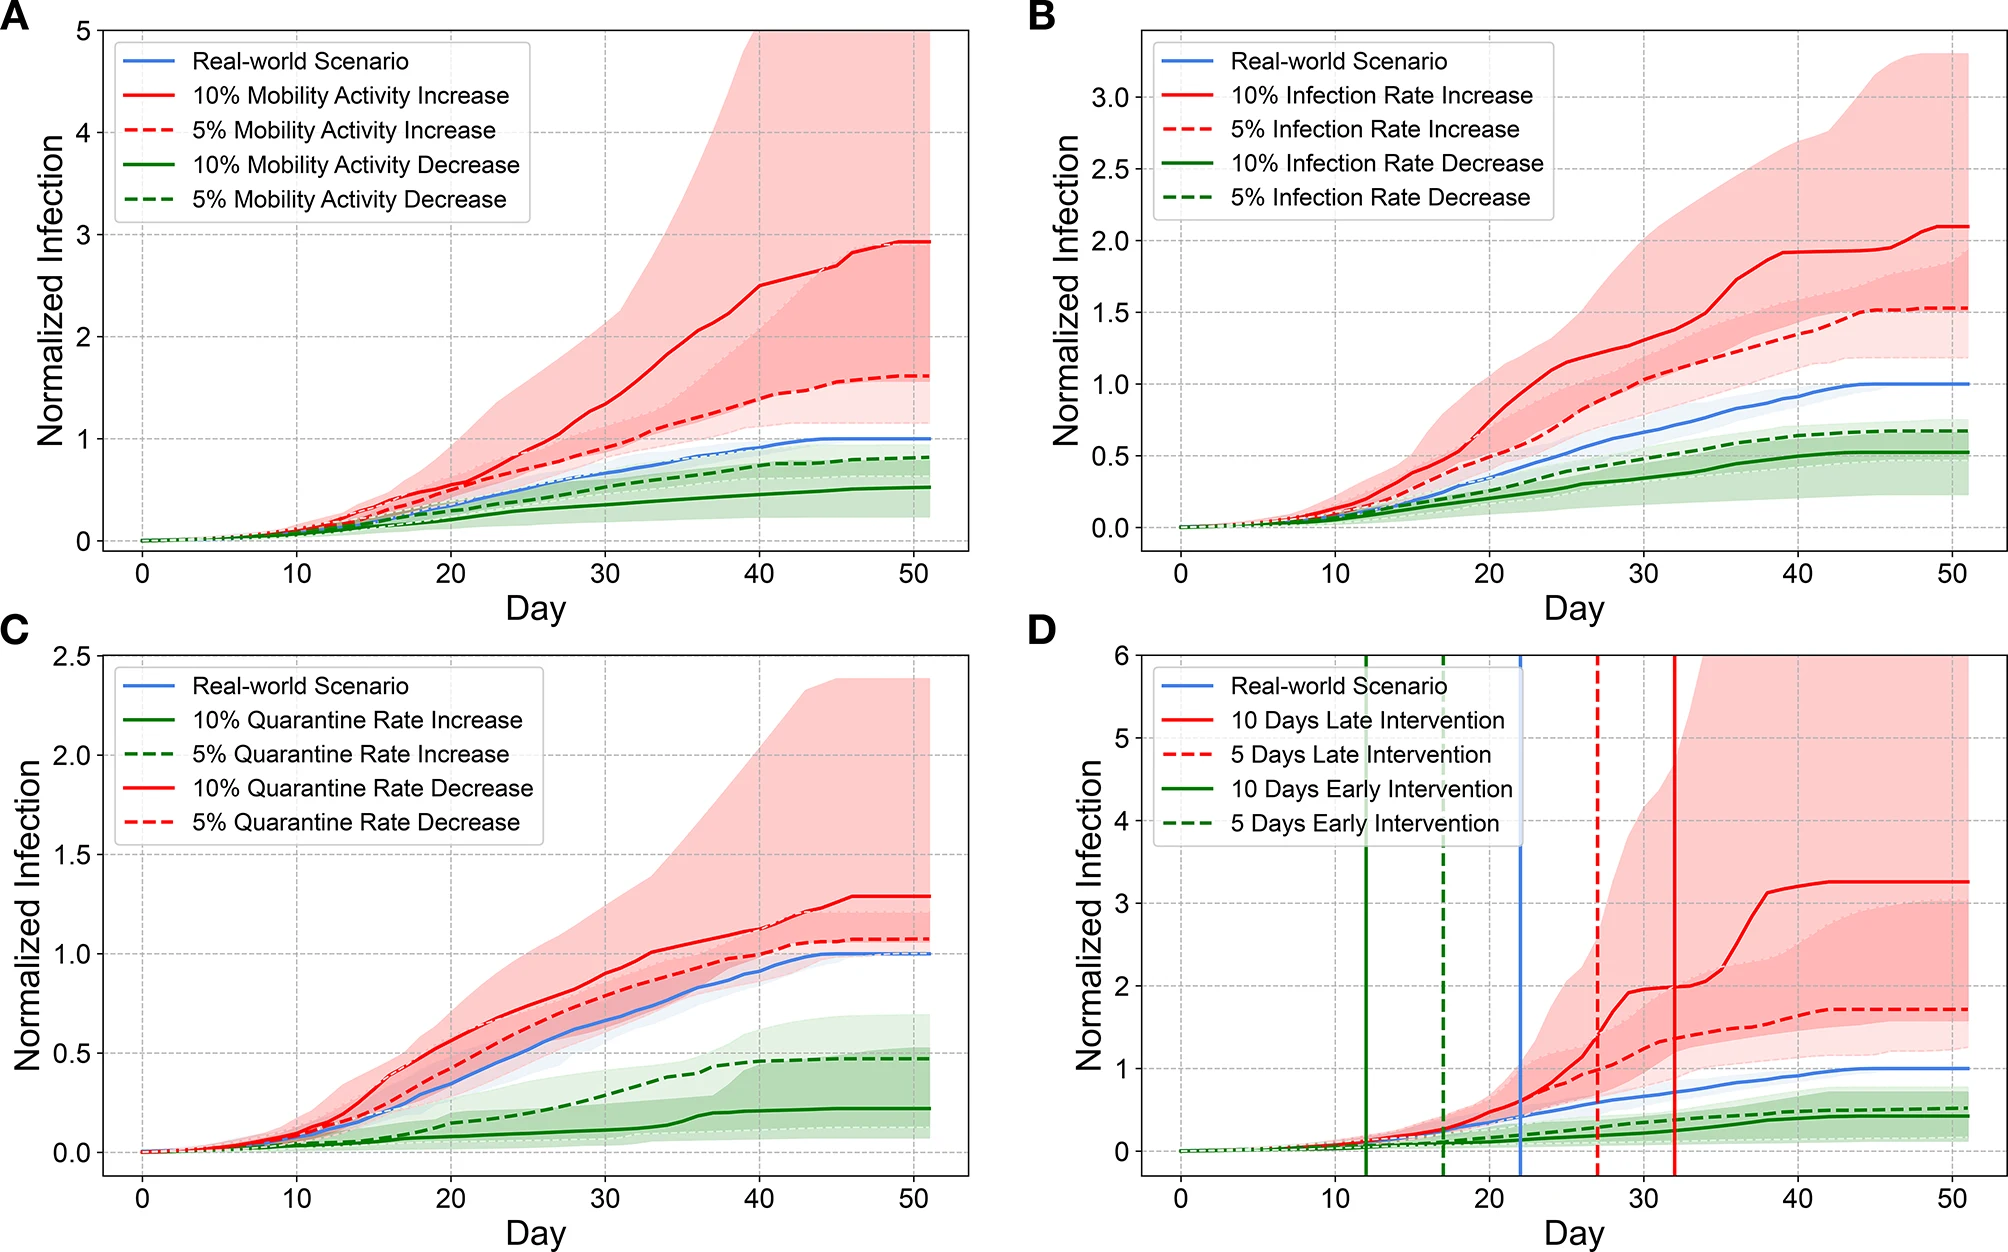
图 4|相对各县实际期末确诊,情景曲线的中位数差多少?
四个面板的纵轴都是归一化感染规模,横轴是日,蓝线是现实情景,色带是 20 个美国县的四分位距。(A)红线、橙虚线是出行活动增加 10% 和 5%,绿线、绿虚线是减少 10% 和 5%。正文给出的 10% 倍数是 2.93 和 0.525。(B)感染率增减,图例用实线和虚线区分 10% 与 5%,增加为红色,减少为绿色。(C)隔离率增减,配色与线型同(B)。(D)红实线、红虚线是延后 10 天和 5 天,绿实线、绿虚线是提前 10 天和 5 天,竖线为对应时点。来源:原论文 Fig. 4。
这些数字能用到什么范围?
样本是三个国家里发病最多的 30 个县市。曲线分型和 5% 人口预算下的减少比例,都不能直接写成“一般城市都会如此”。低发病城市没有进入这组对照。
M、基尼系数和限制政策的曲线都是模型输出。苹果报告只参与了美国县一次前后降幅的相关,没有参与拟合;社区尺度的实际确诊对照只做了纽约市,相关 0.583。城市合计的 R² 高于 0.980,与社区名次只达到中等相关,可以同时成立。
引力模型和辐射模型的整体表现接近,所以“人口加距离的短公式够用”得到支持,“必须是这一个引力公式”没有得到支持。格子内部接触相同,是为了把差异留给格子之间的流量;它没有测量过街角、家庭和工作场所的差别。天气、人们对防控的态度、各国典型出行距离,正文都列为没有放进模型的因素。
政策曲线是在固定人口预算下的情景。60.13% 与 28.49% 的差别,依赖于美国县 5% 这一预算、模型排出的风险顺序,以及不干预那条基线。它不是一次已经执行过的限制实验。
一句话总结
在这 30 个高发病县市里,用人口和曼哈顿距离写出的引力流量,可以代替手机轨迹来跟上不同形状的累计确诊,并把更集中的风险指向“人往人多的格子去”;拟合出的出行强度仍是病例曲线上的参数,不是直接观测的行程。
核心来源
- Scientific Reports 正式页面,核对题目、作者、卷期和收稿日期。正文图为 Fig. 1–4。
- 人口来自 WorldPop。确诊来自约翰斯·霍普金斯大学 COVID-19 数据仓库、covid19india.org 和巴西卫生部。
- 出行降幅的外部对照来自苹果出行趋势。苹果已停止提供该数据,论文写明可向 Zhenyu Han(hanzy19@tsinghua.org.cn)合理申请。存档页为 Apple Mobility Trends。
- 纽约市社区确诊来自纽约市政府 COVID-19 数据页。数值仿真代码见 COVID19-urban-mobility-model。
作者介绍
以下只写论文署名机构和贡献说明里能够核对的内容。
- Zhenyu Han:清华大学电子工程系、北京信息科学与技术国家研究中心。论文脚注写明与 Fengli Xu 贡献相同,并由他完成实验和绘图。
- Fengli Xu:同时署清华大学上述单位,以及芝加哥大学知识实验室与社会学系。与 Yong Li、James Evans 共同发起研究,并参与提纲、设计、修改、结果分析和写作。
- Yong Li:清华大学电子工程系、北京信息科学与技术国家研究中心,通讯作者(liyong07@tsinghua.edu.cn)。共同发起研究,并参与提纲、设计、修改、结果分析和写作。
- Tao Jiang:华中科技大学电子信息与通信学院。参与提纲、设计、修改、结果分析和写作。
- James Evans:芝加哥大学知识实验室与社会学系,以及圣塔菲研究所,通讯作者(jevans@uchicago.edu)。共同发起研究,并参与提纲、设计、修改、结果分析和写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同样一份人口地图,模型相对于“只选人口最多的格子”的增益,在这篇文章里随城市结构差很多。德里的选点只重合 8.70%,圣保罗重合 84.38%,洛杉矶图题是 57.14%。若一座城市的人口高峰彼此离得远、高峰之间的流量本来就弱,先按人口排序也许就接近模型的选择;若中心密、外围也通过短距离流量连到中心,只看人口规模会漏掉中心周围的格子。这个差别可以用重合度和 5% 人口预算下的减少比例来检查,不必先假定每座城市都需要同一套轨迹数据。
另一处不宜外推的是强度。出行活动提高 10% 时,20 个美国县的中位数是实际期末确诊的 2.93 倍,四分位距却从 1.57 伸到 7.24。拿中位数给所有县做同一个乘数,会把县与县的差别抹平。城市合计 R² 高于 0.980,同时纽约社区名次相关只有 0.583,也说明全城曲线贴合之后,格子排序仍要单独核对。