收入差更大的两条普查区,人流会不会被估得更偏?
论文名片|Zhewei Liu、Lipai Huang、Chao Fan、Ali Mostafavi,FairMobi-Net: A Fairness-aware Deep Learning Model for Urban Mobility Flow Generation,arXiv:2307.11214v1 [cs.LG],2023年7月20日。arXiv:2307.11214v1。本文依据这一预印本解读。
设想一份给公交或商店选址用的区际人流图。全市平均误差不大时,图看起来就能用;若家庭收入差很大的两条普查区之间总是估得更偏,线路和店址仍会跟着这张图偏。这只是帮助进入问题的场景,论文没有做这项规划实验。作者担心,现有人流生成方法会低估弱势人群所在地区之间的流量。实验实际比较的,是起点与终点普查区家庭收入中位数之差不同的三组区对,它们的预测误差分布是否接近。
在亚特兰大都市统计区、休斯敦哈里斯县、西雅图金县和纽约州萨福克县四套普查区流量上,FairMobi-Net 的归一化误差低于深度引力模型,组别之间的公平差距也更小。被拉近的是这三个收入差组别的误差分布。实验没有测量低收入社区是否因此得到更公平的设施。
先说结论
- 公平在本文中是比例人口统计均等(proportional demographic parity,PDP)。它比较三个收入差组别里,误差落在“该模型总体损失附近一条区间”内的比例。比例越接近,PDP 越低。组别按区对的家庭收入中位数之差排序:最小的 20% 为 a1,其后到 50% 为 a2,其余 50% 为 a3。
- 表 1 的四个地区里,FairMobi-Net 的归一化均方根误差(NRMSE)、平均绝对误差(MAE)、詹森–香农散度(JSD)都低于深度引力模型(Deep Gravity,DG),相关系数 Corr. 更高,PDP 也更低。亚特兰大 NRMSE 从 DG 的 0.102 降到 0.076,降幅是 DG 这一数值的 25.5%;PDP 从 0.607 降到 0.118。金县的 PDP 只从 0.196 降到 0.137。
- 去掉公平损失后,哈里斯县的 NRMSE 已经从 0.102 降到 0.077,公平项再降到 0.069。亚特兰大去掉公平损失时 NRMSE 仍是 0.100,Corr. 只有 0.121;加上公平损失后 NRMSE 到 0.076,Corr. 到 0.642,PDP 从 0.528 降到 0.118。公平项在亚特兰大同时改变了误差和组别差距。
- SHAP 分解的是模型输出。距离在亚特兰大、哈里斯县和萨福克县的展示特征里影响最大;金县把终点普查区的街道总长度排在距离之前。这与距离衰减的方向相符,并不证明出行成本已经测到。
公平比的是收入差组别,不是某类人的轨迹
预测对象是普查区 i 到普查区 j 的人流。论文把流量写成起点特征、终点特征和两区共有特征的函数。流量来自 Spectus 的匿名设备位置数据,汇总到普查区之间。平台在美国约有 1500 万活跃用户;这是平台规模。论文引用既有研究说明这套数据的人口代表性,没有在这四个地区重新检验代表性。下面只讨论区与区的流量。
四个地区分开建模,报告的人流条数是:
| 地区 | 论文写出的空间单元 | 人流条数 |
|---|---|---|
| 亚特兰大 | 都市统计区(MSA) | 82,198 |
| 休斯敦 | 哈里斯县 | 507,994 |
| 西雅图 | 金县 | 137,019 |
| 纽约州 | 萨福克县 | 36,208 |
这些条数的单位是论文所称的 human mobility flows。人数和普查区个数都要另有口径。正文又说,多数普查区和其他普查区之间没有流量,训练数据里零值占多数。PDF 没有说明上表条数是否已经包含这些零流量区对,也没有给出普查区个数或数据采集日期。82,198 就是亚特兰大被列出的人流条数。
每个地区用 60% 的数据训练,20% 做验证并调节超参数,20% 做测试。PDF 没有写明划分是按区对随机抽取,还是按普查区或按收入差组别分层,也没有写明时间先后。亚特兰大、哈里斯、金县、萨福克的学习率依次是 5×10⁻⁴、1×10⁻³、1×10⁻³、1×10⁻³,优化器为 Adam,权重衰减 5×10⁻⁴,各训练 1000 个 epoch。学习率按地区分开设置,结果也按地区报告。
每条区对有 44 个输入。起点 20 个、终点 20 个:九类设施或兴趣点计数,六类土地利用面积(平方千米),街道总长度(米)、路段数和交叉口数,以及人口和人均收入(美元)。两区共有的 4 个特征是直线距离(英尺),加上收入差组别的三个独热编码。分组用的是两区家庭收入中位数之差的绝对值,输入里的收入却是人均收入。距离是直线距离,路网特征是各普查区内部的汇总,不是两区之间的路程时间。
公平组别就定义在这些区对上。收入差从小到大排序后,最小的 20% 是 a1,论文称为低收入差;排到 50% 的一段是 a2,称为中等收入差;其余 50% 是 a3,称为高收入差。a1 里同时有“都较高”和“都较低”的区对。指标看不见 a1 内部这两类区对谁更不准。
PDP 的比较是:对每一对组别,计算误差落在总体损失加减阈值 τ 这一区间内的比例,取绝对差,再加权相加。权重等于三个组的样本量之和,除以正在比较的两个组的样本量之和,所以两组合计越少,这一对差距占的分量越大。τ 的数值 PDF 没有给出,区间又以各模型自己的总体损失为中心。表 1 的 PDP 可以在这套定义下互比,不能读成相对某个外部固定误差标准的达标率。
先分开“有没有流”,再把组别误差拉齐
零流量占多数时,一个直接回归容易被大量的零拉向“都预测得很小”。FairMobi-Net 把预测拆成三步:先做二分类,判断这条区对有没有流,输出 0 或 1;再做数值回归,估计有流时的强度;两者相乘得到最终人流。分类器判为 0 时,最终预测就是 0。
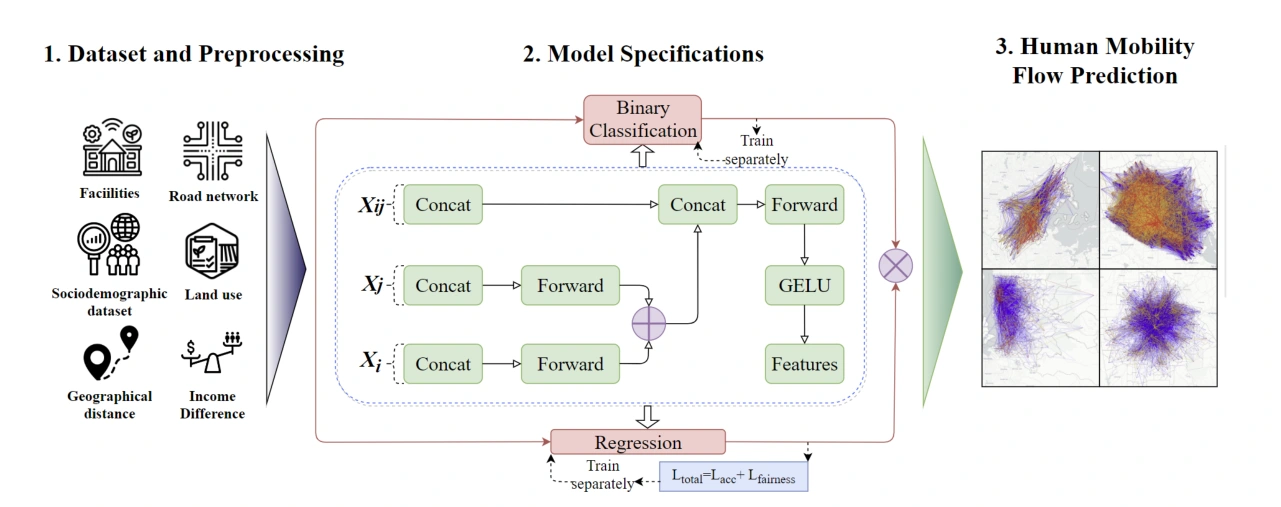
图 7|生成一条区际人流时,公平损失加在哪一段?
图内按 1、2、3 从左到右排列,没有 a、b、c 子图字母。(1)设施、路网、社会人口、土地利用、直线距离和收入差进入起点、终点和共有特征。(2)起点与终点分支相加后,与共有特征再合并;二分类和回归分开训练,公平损失写在回归一侧的总损失里,最终由二者相乘。(3)右侧小图是生成的流量示意。来源:原论文 Fig. 7。
正文把总损失写成平均绝对误差加上 ζ 乘以公平损失,公平损失就是 PDP。ζ 是拉格朗日乘子,在 0 到 1 之间每隔 0.1 取一个值,共 11 档,取得 PDP 最低的那一档。图 7 把公平项画在回归分支上,正文的绝对误差则是最终预测和观测人流的差。两处对得上的部分是:分类和回归分开训练,公平项用来拉齐组别误差。PDF 没有单独报告分类器是否也使用这条公平损失。
起点、终点和共有特征各自先过一层全连接网络,激活函数是 GELU,并带有批归一化和 dropout。起点与终点的表示按位相加,再与共有特征叠在一起。这个结构是为了贴近“两端规模、中间距离”的流量形式,同时应付大量精确为零的区对。它仍然使用观测到的区对流量来训练,不能当成完全没有流量观测时的从零生成。
对照有两个。一个是论文引用的深度引力模型,表中记为 DG。另一个是 FairMobiNet-NoFL:同一套 FairMobi-Net 去掉公平损失,用来看 ζ 这一项本身带来什么。表 1 的表注写着 MMLP 与 MMLP-FL,并说 MMLP-FL 的系数为 0;表内行名却是 DG、FairMobiNet-NoFL 和 FairMobi-Net。读表时按正文和行名:NoFL 是去掉公平损失的模型。不要把表注里的系数 0 安到 FairMobi-Net 上。
四个地区的误差都降了,降幅并不一样
NRMSE、MAE、JSD 和 PDP 都是越低越好。JSD 越低,预测值与观测值的分布越接近。Corr. 在表 1 里随模型变化;方法段却把它写成输入特征与目标变量的相关。同一批输入下三个模型的 Corr. 差得很大,这个句子对不上表。图 2 明确标的是观测值与预测值的相关。下面把表内 Corr. 和图 2 的相关分开读。
| 地区 | 模型 | NRMSE | PDP | Corr. | JSD | MAE |
|---|---|---|---|---|---|---|
| 亚特兰大 | DG | 0.102 | 0.607 | 0.005 | 0.404 | 0.938 |
| 亚特兰大 | FairMobiNet-NoFL | 0.100 | 0.528 | 0.121 | 0.391 | 0.900 |
| 亚特兰大 | FairMobi-Net | 0.076 | 0.118 | 0.642 | 0.330 | 0.781 |
| 哈里斯 | DG | 0.102 | 0.272 | 0.781 | 0.382 | 1.997 |
| 哈里斯 | FairMobiNet-NoFL | 0.077 | 0.150 | 0.779 | 0.370 | 1.703 |
| 哈里斯 | FairMobi-Net | 0.069 | 0.082 | 0.801 | 0.353 | 1.610 |
| 金县 | DG | 0.128 | 0.196 | 0.761 | 0.341 | 3.062 |
| 金县 | FairMobiNet-NoFL | 0.113 | 0.163 | 0.756 | 0.320 | 2.710 |
| 金县 | FairMobi-Net | 0.095 | 0.137 | 0.794 | 0.301 | 2.413 |
| 萨福克 | DG | 0.131 | 0.198 | 0.782 | 0.342 | 3.185 |
| 萨福克 | FairMobiNet-NoFL | 0.111 | 0.160 | 0.747 | 0.320 | 2.792 |
| 萨福克 | FairMobi-Net | 0.090 | 0.081 | 0.819 | 0.284 | 2.394 |
亚特兰大 NRMSE 相对 DG 的降幅,正文写 25.5%。(0.102−0.076)/0.102 正好是 25.5%,分母是 DG 的 NRMSE。相对 NoFL,正文写低 23.2%,并给出 0.076 和 0.100;(0.100−0.076)/0.100 等于 24.0%。25.5% 与表一致,23.2% 与表中这三位小数不一致。萨福克相对 DG 的降幅,正文写 31.3%,(0.131−0.090)/0.131 与此一致。按同一算法,哈里斯相对 DG 低 32.4%,金县低 25.8%。PDF 没有写出 NRMSE 的归一化公式,所以 0.076 和 0.069 可以比大小,不能换算成“每条流量平均少了多少人”。
MAE 保留流量的原始尺度。亚特兰大 FairMobi-Net 的 MAE 是 0.781,金县是 2.413,萨福克是 2.394。金县 NRMSE 为 0.095,亚特兰大为 0.076;金县 MAE 是亚特兰大 MAE 的 3.09 倍,萨福克则是 3.07 倍。跨城市比较准确性时,论文主要靠 NRMSE;MAE 保留各自流量数字的量级。
PDP 的降幅也差很多。亚特兰大从 0.607 降到 0.118,减少的 0.489 占 DG 这一 PDP 的 80.6%。哈里斯从 0.272 降到 0.082,减少的 0.190 占 DG 的 69.9%。萨福克从 0.198 降到 0.081,减少的 0.117 占 DG 的 59.1%。金县从 0.196 降到 0.137,减少的 0.059 占 DG 的 30.1%。四地方向一致,金县的公平收益最小。PDF 没有给出显著性检验,这些是表中的点估计。
亚特兰大 DG 的 Corr. 只有 0.005,NoFL 为 0.121,FairMobi-Net 为 0.642。另外三地的 DG 已经在 0.76 到 0.78,完整模型升到 0.80 左右。0.005 不能读成“亚特兰大的特征与人流无关”:它随模型改变,而且下面这张合图里的相关是另一个汇总。
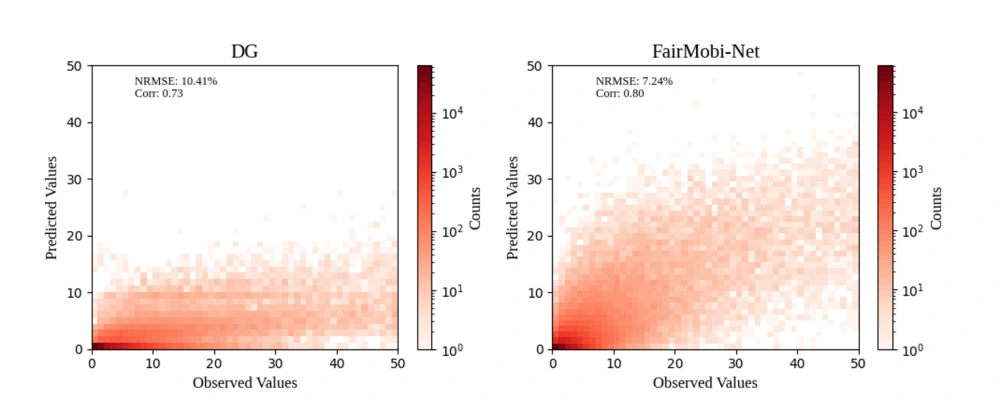
图 2|四个地区合在一起时,预测还跟着观测走吗?
没有子图字母。左为 DG,右为 FairMobi-Net。横轴是观测流量,纵轴是预测流量,范围都到 50;颜色是落入该格子的区对数量,色标从 10⁰ 到 10⁴。图内文字:DG 的 NRMSE 为 10.41%、相关为 0.73;FairMobi-Net 为 7.24%、0.80。来源:原论文 Fig. 2。
10.41% 比 7.24% 低出的 3.17 个百分点,相当于 DG 这一合图 NRMSE 的 30.5%。它不等于四个城市表 1 数值的简单平均:DG 四城 NRMSE 的算术平均是 0.1158,也就是 11.58%,对不上 10.41%。合图把大量小流量堆在原点,右上角的大流量很稀。印在图里的相关会被数量巨大的小流量拉动,图没有另行给出“流量大于 10”的误差。两张图的高观测值一侧都更散,合图不能证明大流量已经被同样准确地生成。
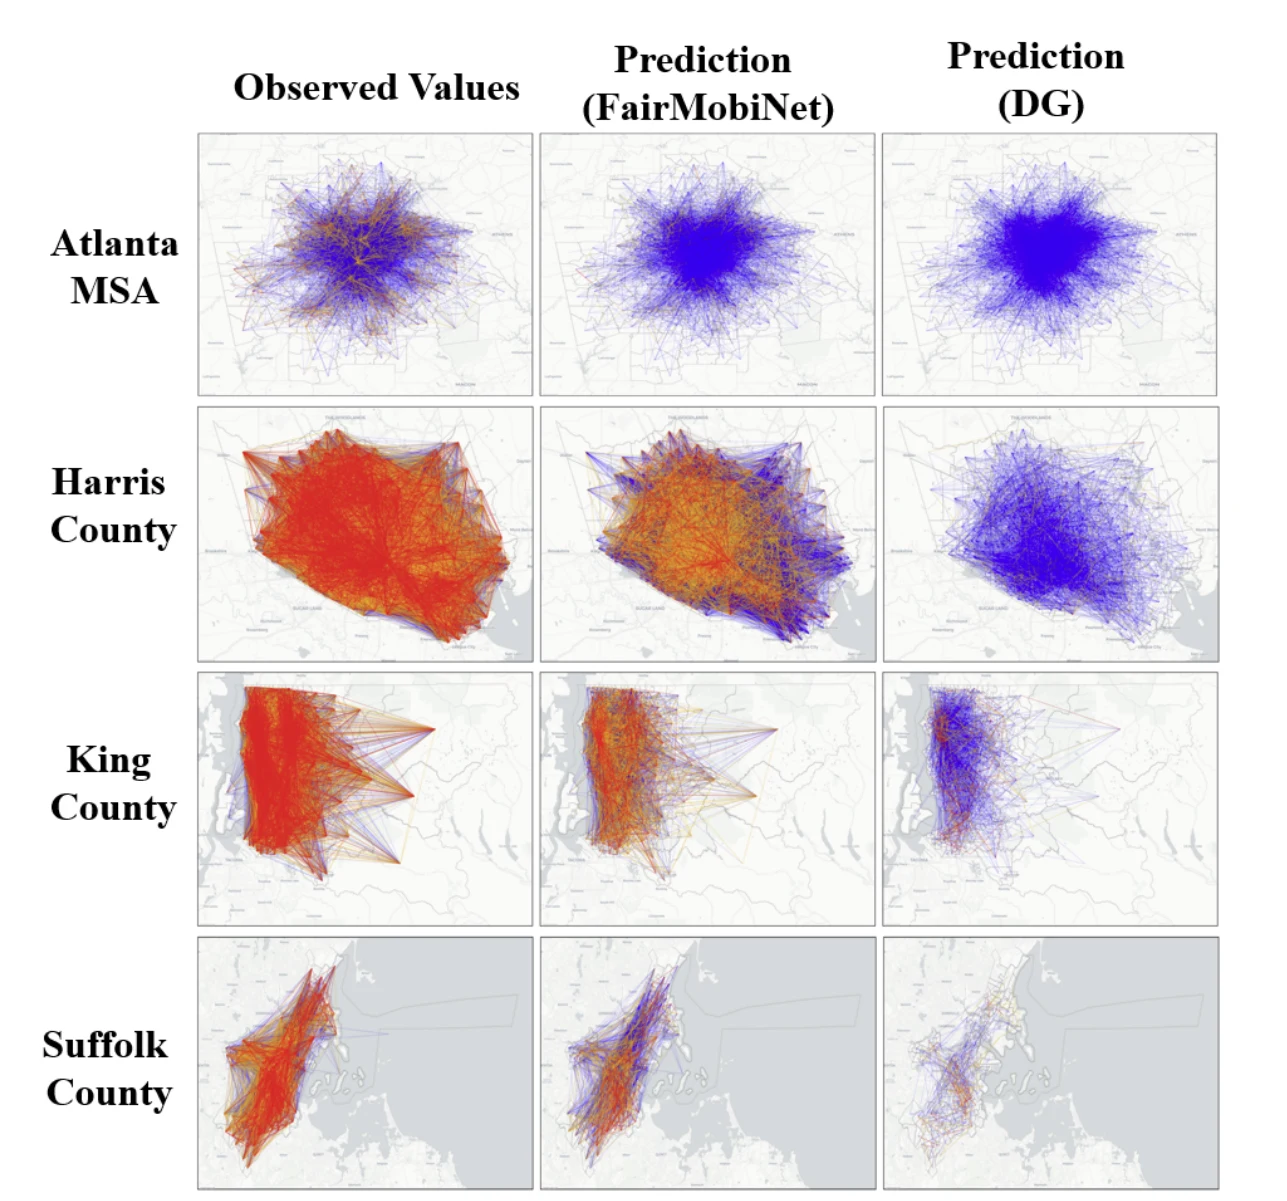
图 3|把流量画成线之后,大流量还在吗?
没有子图字母。四行是亚特兰大 MSA、哈里斯县、金县、萨福克县;三列是观测、FairMobi-Net 预测、DG 预测。颜色表示流量大小:蓝为 1–3,橙为 4–9,红为大于 10。来源:原论文 Fig. 3。
哈里斯、金县和萨福克的观测以红线为主,DG 预测大面积变成蓝线;FairMobi-Net 保留了更多橙色和红色。亚特兰大的观测本身就有大量蓝线和橙线,两个模型都画出密集的中心。这是视觉比较。线的颜色接近,不能推出每一条区对都预测对了,也不能推出红线对应同一批人。
公平损失的权重,是按 PDP 选出来的
ζ 每一档都重新看 NRMSE 和 PDP。图 1 的左轴都是 NRMSE,刻度 0 到 0.200;右轴是 PDP,四行的右轴上限分别约为 0.600、0.250、0.200 和 0.200。粉线的高低不能跨行比较。红方块是该行 PDP 最低的 ζ。
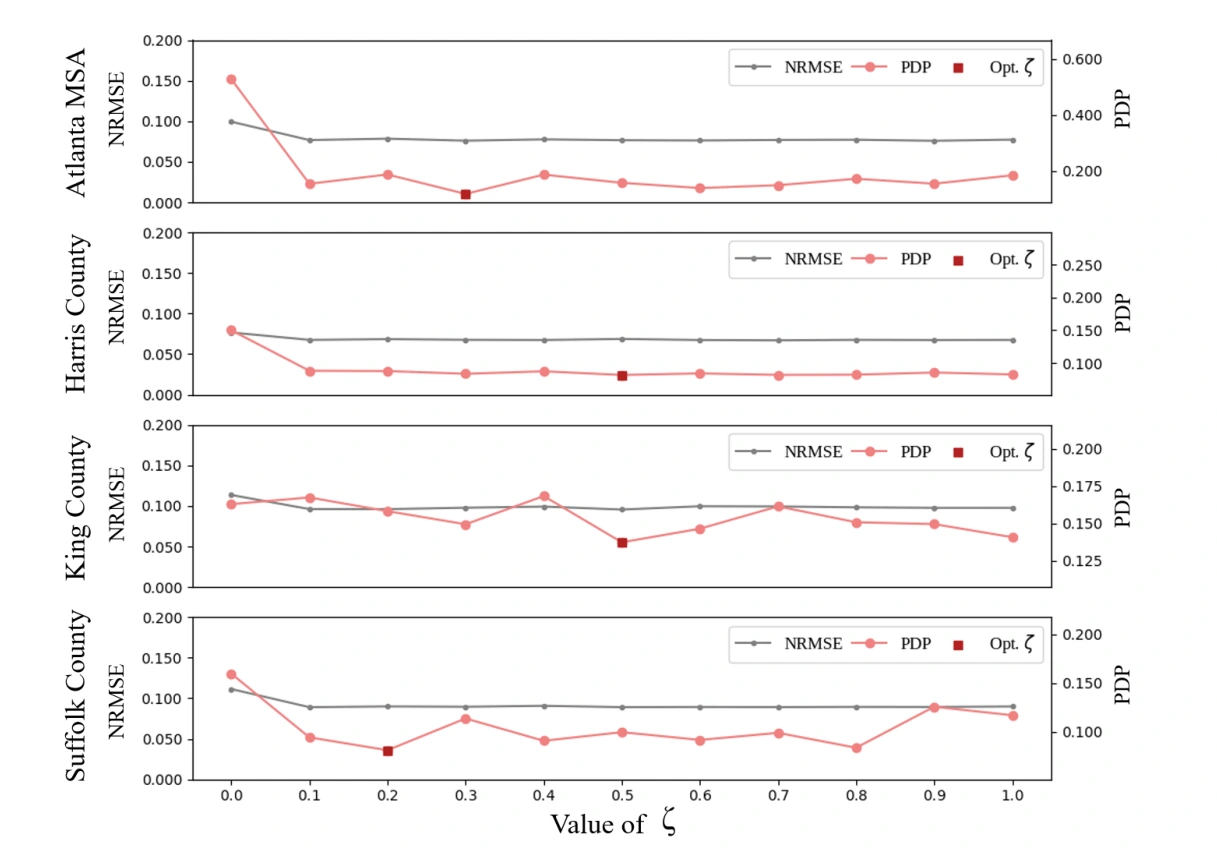
图 1|公平损失要加多重,误差会不会跟着变坏?
没有子图字母。四行依次为亚特兰大 MSA、哈里斯县、金县、萨福克县。横轴是 ζ,从 0 到 1,间隔 0.1。灰线为 NRMSE,粉线为 PDP,红方块为该地区 PDP 最低的 ζ。方块分别落在 0.3、0.5、0.5 和 0.2。来源:原论文 Fig. 1。
ζ 从 0 增大一点之后,四行的 NRMSE 都降到一个较平的区间,继续加大 ζ,灰线变化不大。亚特兰大和萨福克的 PDP 在离开 0 之后下降最明显;金县的粉线起伏,最低点相对邻点的优势不大。这与表 1 对得上:在选中的 ζ 上,NRMSE 和 PDP 都低于去掉公平损失的那一行。图上没有印出每个 ζ 的精确读数。PDF 也没有写明这些曲线来自验证集还是测试集。ζ 若在报告 PDP 的同一批数据上挑选,表中的 PDP 会偏乐观。验证集被说明用于调节超参数,但图 1 本身没有标明数据划分。
去掉公平损失再和 DG 比,可以看到准确性并不全是公平项带来的。哈里斯县 NoFL 的 NRMSE 已是 0.077,相对 DG 的 0.102 低 24.5%;公平项再降到 0.069,PDP 则从 0.150 降到 0.082,减少量是 0.150 的 45.3%。亚特兰大 NoFL 的 NRMSE 只从 0.102 到 0.100,PDP 从 0.607 到 0.528;加上公平项之后,PDP 再降到 0.118,相对 NoFL 的 0.528 减少了 77.7%。金县的 PDP 从 NoFL 的 0.163 到 0.137,公平项的额外作用最小。
组别之间更齐,地图上仍有深色普查区
表 1 的 PDP 是三个组的汇总。图 5 把 a1、a2、a3 的柱并排放出。纵轴写成 MAE,刻度却有正有负:四地的 a1 在零线以上,a2 在零线以下;a3 在亚特兰大、哈里斯和金县也在零线以下,萨福克的 a3 接近零。同一侧的柱,FairMobi-Net 多半短于 DG。PDF 没有解释负号。零线以下只说明这些柱与 a1 方向相反,柱的方向还不是某一组被高估或低估的证据。
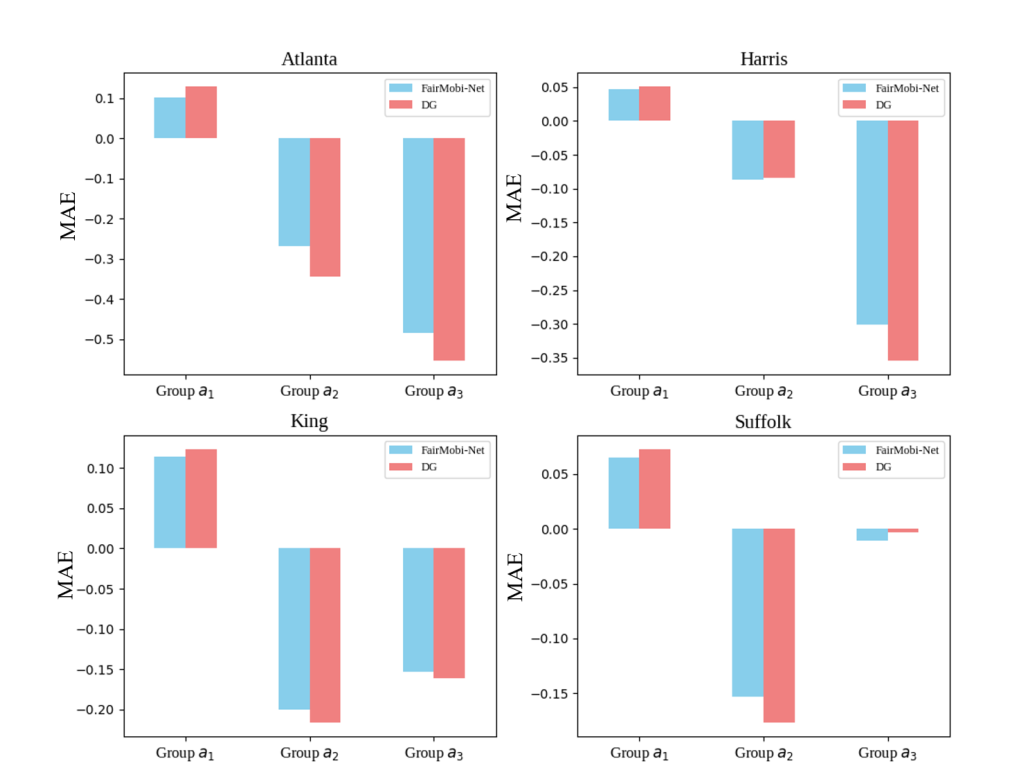
图 5|三个收入差组别的误差,起伏差多少?
没有子图字母。四块分别是亚特兰大、哈里斯、金县、萨福克。横轴为 a1、a2、a3,蓝柱为 FairMobi-Net,红柱为 DG。各块纵轴刻度不同,零线以上和零线以下同时出现。来源:原论文 Fig. 5。
正文给出的是这三个组水平值的方差,分母是一组三个数,不是每条区对误差的方差。FairMobi-Net 为 0.089(亚特兰大)、0.031(哈里斯)、0.029(金县)、0.012(萨福克);DG 为 0.122、0.043、0.033、0.016。四地都更小。亚特兰大从 0.122 降到 0.089,仍远不是 0。方差更小表示三个数更靠拢,不表示三个组已经相同,PDF 也没有做检验。
图 4 改到普查区。前两列是平均 MAE,共用 0 到 5 的色标;第三列是 FairMobi-Net 相对 DG 的改进,色标从 −1 到 1。图注一度写成 DP,列标题是 DG。
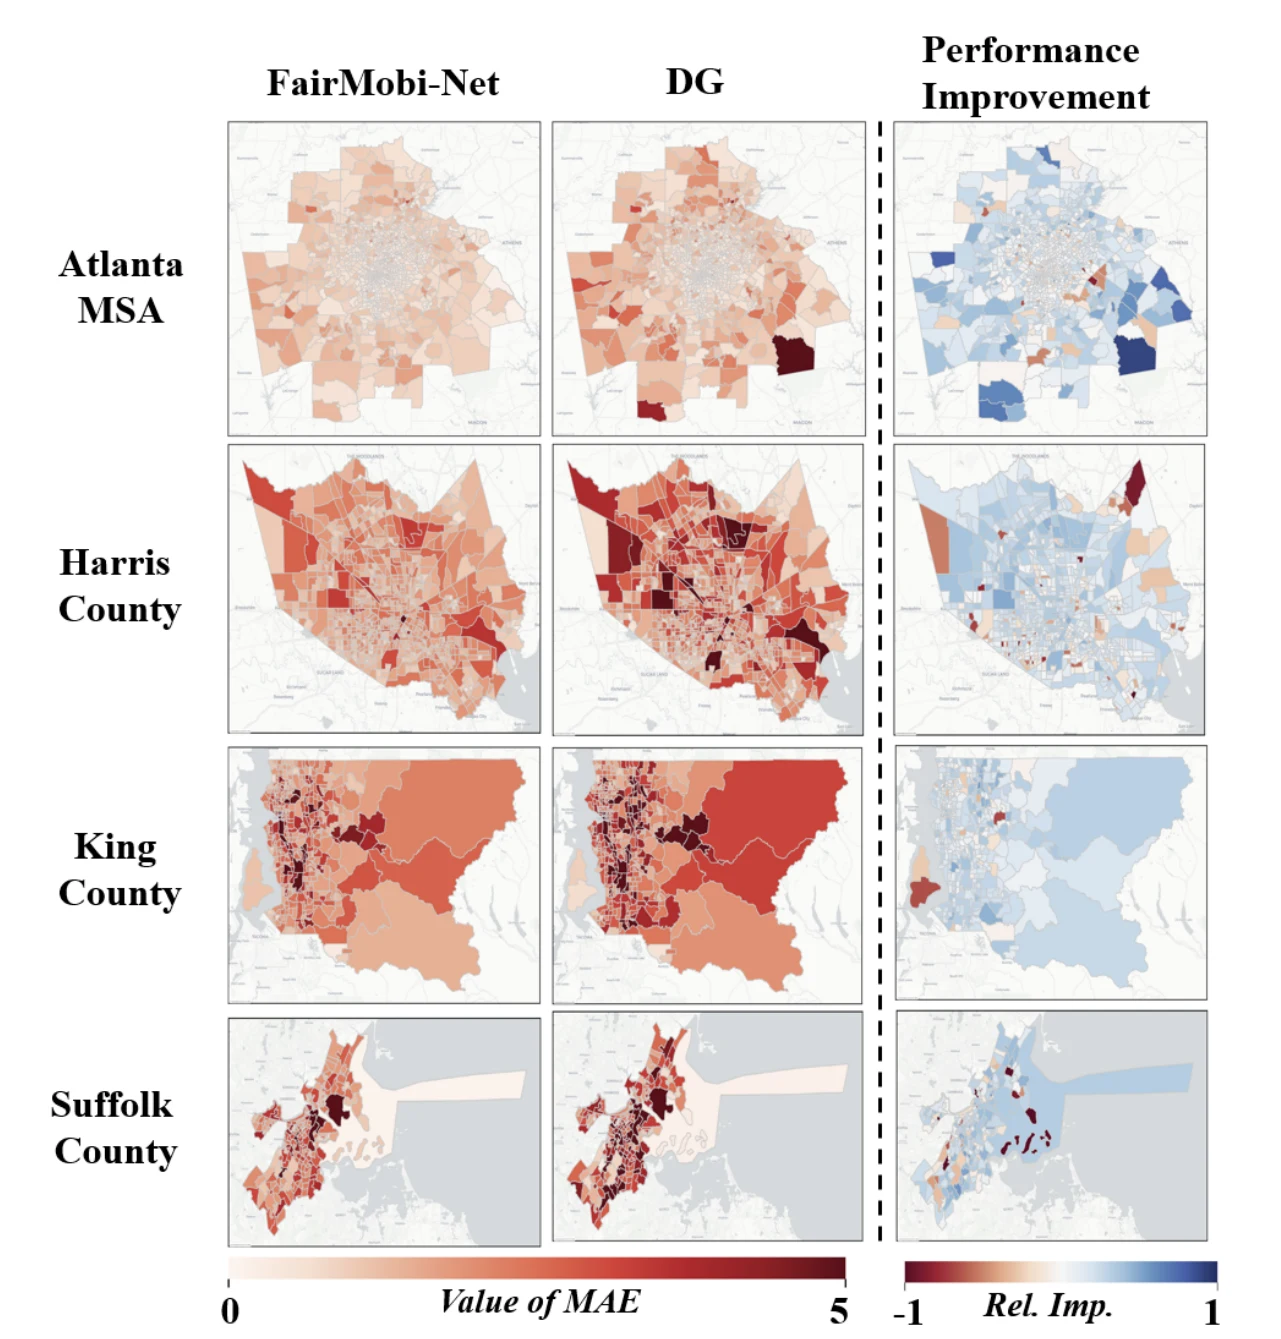
图 4|误差画回普查区后,是不是每一块都更浅?
没有子图字母。四行仍是四个地区。左列 FairMobi-Net 的平均 MAE,中列 DG,右列相对改进。MAE 由浅到深对应 0 到 5;改进由棕到蓝对应 −1 到 1。来源:原论文 Fig. 4。
亚特兰大整体更浅,和表中 MAE 0.781 对 0.938 的量级相符。金县和萨福克在 0–5 的共用色标上深得多,对应表中 MAE 2.413 和 2.394。金县东部在两个模型里都偏深,右列只是较浅的蓝,绝对误差仍然高。右列蓝色较多,也夹着棕色普查区,所以改进不是处处发生。PDF 没有给出相对改进的计算公式,也没有报告变好的普查区占全部普查区的比例,更没有写明平均 MAE 是对该区全部连边、只对测试集,还是只对流出取平均。
模型最依赖距离,金县则把终点路网排到前面
SHAP 把一次预测的输出拆到各个输入上。横轴是对模型输出的推动,颜色是该特征本身的高低。图注写 i 来自起点普查区,j 来自终点普查区。每张图只展示排序靠前的一批特征,不是全部 44 个。四张图的横轴刻度不同:亚特兰大伸到约 −60,哈里斯大约在 −5 到 2.5,金县大约 −10 到 10,萨福克大约 −20 到 10。不能拿不同城市的 SHAP 数字直接比大小。
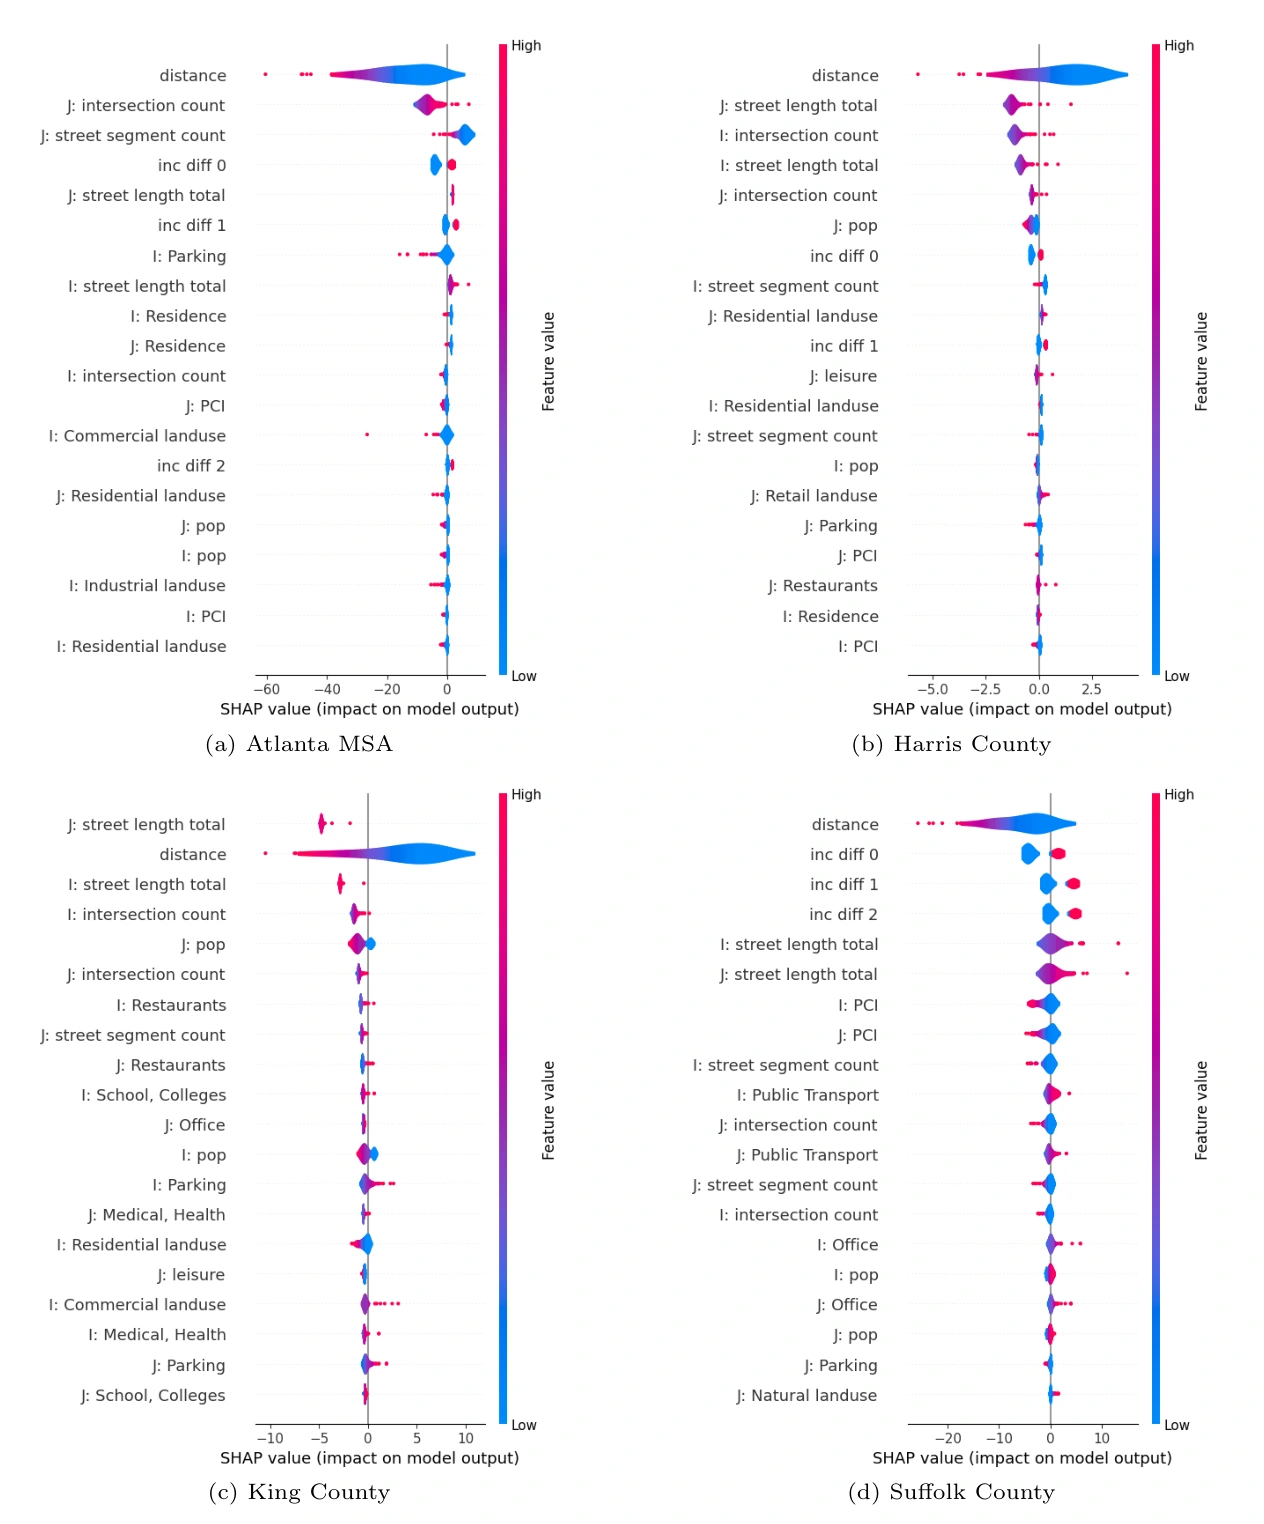
图 6|模型生成流量时,最倚重哪一类输入?
(a)亚特兰大 MSA,距离的色带最宽,高距离偏向负的 SHAP 一侧。(b)哈里斯县,距离同样排在首位,其后是终点街道长度和两端的交叉口、街道长度。(c)金县,终点街道总长度排在距离之前。(d)萨福克县,距离仍最宽,紧接着是三个收入差指示,色带窄得多。来源:原论文 Fig. 6。
正文的读法与(a)(b)(d)一致:距离是这三地影响最大的因素,距离越大,模型给出的人流越低,和距离衰减的方向相同。金县是例外,终点街道总长度排第一,距离第二。正文据此认为,更长的街道可能代表更建成的环境,从而吸引人流。图 6 本身没有印出 SHAP 的精确数字。四张图横轴刻度不同,金县排第一的街道长度和亚特兰大的距离效应要分开看。
路网的长度、路段数和交叉口在多地都排在土地利用、兴趣点和人均收入之前。收入差的独热编码会出现在图里,说明模型看得到组别;在亚特兰大和哈里斯,它们的色带远窄于距离。萨福克把 inc diff 0、1、2 排到距离后面,宽度仍然小。PDF 没有写明这三个编号哪个是 a1、a2 或 a3。土地利用、兴趣点和社会经济特征的方向还随地区变化。SHAP 说明的是这一个已经训练好的模型如何使用输入,不是这些因素造成人流的证据。模型已经把收入差组别当作输入,公平损失又按同一组别约束误差;组别标签因此同时出现在信息和惩罚里。
这些比较停在哪里
表 1 支持的结论可以收成一句:在这四套分开训练的普查区流量上,选中 ζ 之后,FairMobi-Net 的 NRMSE、MAE、JSD、PDP 都低于 DG 和去掉公平损失的版本,Corr. 更高。金县的 PDP 改善最小。亚特兰大 DG 的 Corr. 为 0.005,是四地里模式对不上最明显的一格。
再往外推,材料就不够了。流量的计数单位没有定义,看图只能知道数值可以大于 10,合图轴放到 50。NRMSE 的归一化方式和 τ 都没有给出。没有数据采集日期,没有普查区数量,没有写测试集是否按收入差分层。PDP 使用模型自己的损失区间,而且可能与挑选 ζ 的数据有关。地图改进没有公式,也没有“变好普查区”的占比。没有显著性检验,没有另一座城市或另一年份的检验。结果表只包含 DG 和去掉公平损失的对照,没有把经典引力模型或辐射模型放进同一张表。
分组本身也划定了结论的形状。a1 按收入差最小的 20% 区对构成,高收入区之间和低收入区之间可以同组。PDP 下降表示这三个组的误差比例更接近。它不报告低收入普查区连向其他低收入普查区时,误差是不是仍然更大,也不报告公交、商店或排放是否因此改变。
一句话总结
收入差更大的普查区对,在深度引力模型里可以伴随更不齐的误差;FairMobi-Net 在四个地区都缩小了这种不齐,并降低了归一化误差,被拉齐的是三个收入差组别的误差分布。
核心来源
- arXiv:2307.11214v1,2023年7月20日。本预印本 22 页,图 1–7 与表 1 都在正文中,没有另附补充材料。
- 文末说明部分工作受美国国家科学基金会项目 CMMI-1846069(CAREER)支持,并写明观点不属于基金会。同一节没有给出数据或代码链接。
- 深度引力基线出自本文引用的 Simini、Barlacchi、Luca、Pappalardo,A Deep Gravity model for mobility flows generation,Nature Communications,2021。表 1 使用的是这一对照的结果。
作者介绍
四位作者的介绍只采用论文署名页上的单位和通讯关系。
- Zhewei Liu:署名德州农工大学 Zachry 土木与环境工程系 UrbanResilience.AI Lab。
- Lipai Huang:署名同一实验室与院系。
- Chao Fan:通讯作者,署名克莱姆森大学土木、环境工程与地球科学学院。
- Ali Mostafavi:署名德州农工大学同一实验室与院系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
a1 把收入差最小的区对放在一起,于是高收入区之间和低收入区之间共用一个公平组别。三个组的 PDP 可以下降,而低收入区指向其他低收入区的误差仍然更大,只是被同组里另一类区对的较小误差抵消。把区对再按两端收入的高低拆开,同一套模型和同一批流量,组别差距的排序可能改变。这一步论文没有做。
收入差组别已经是输入。部署时如果不能把家庭收入差送进模型,表 1 里的 PDP 不一定还在。一个直接的检查是:用现在的方式训练,再把三个独热编码置零后重新计算 PDP 和 NRMSE。若公平差距立刻回到 NoFL 或 DG 的水平,公平就主要来自模型看见了组别,而不是来自路网和土地利用把流量结构学全了。
图 3 的颜色以 10 为红线的门槛。哈里斯、金县和萨福克的 DG 预测大量停在蓝色的 1–3,观测却以大于 10 的红线为主。若决策只保留预测流量大于 10 的联系,MAE 下降仍可能留不下这些红线。按 a1、a2、a3 分别计算“是否跨过 10”的错分比例,会比现在的 PDP 更接近这种门槛决策。论文没有报告这个比例。