工作日夜里的中下城,和周末的中央公园,是同一套聚集吗?
论文名片|Haytham Assem、Teodora Sandra Buda、Declan O’Sullivan,RCMC: Recognizing Crowd-Mobility Patterns in Cities Based on Location Based Social Networks Data,ACM Transactions on Intelligent Systems and Technology,2017,8(5):Article 70(2017年8月),30页。DOI:10.1145/3086636。依据2017年8月正式发表版;2016年12月收稿,2017年3月修回,2017年4月录用。研究类型是城市签到数据上的测量与方法:用核密度和主题模型描述人群聚集,用聚类给邮区贴功能标签。
设想周三21时站在时报广场,再设想周日17时穿过中央公园。前一个画面里中城很亮,后一个画面里公园那一条长方形会亮起来。这只是帮助读图的画面,不是论文记下的某一次出行。若把两张图连成“同一批人先去公园、再去中城”,就超出了这项研究真正比较的东西。
论文用的是2013年1月至2014年12月、曼哈顿边界内的 Twitter 地理标签。它要看的是:哪些邮政编码区在哪个四小时里反复一起变挤,以及这些邮区在同一钟点的 Foursquare 签到更像餐饮、游憩还是别的类别。工作日和周末可以分成两套聚集;再拆开时,周六的深色更常落在20时至24时,周日更常落在16时至20时。中午和傍晚,同一批邮区的主导类别也会改名。这些是推文和签到的聚集配方,还不是一批人的出行路径。
先说结论
- 过滤后的曼哈顿地理标签共13,296,244条,来自596,757名用户,论文给出的人均是22.28条。分布的低端有170,185名用户,高端有1名用户发出89,999条。后面的“拥挤”按推文点的空间密度计算,没有先把每人压成一票。
- 一天切成6段、每段4小时。只设2个主题时,工作日隶属至少0.8,周六0.73,周日0.8。设4个主题才能把周六和周日拆开,工作日隶属则降到周一、周二约0.45,周三至周五高于0.5。
- 两主题的工作日地图里,20时至24时的中下城最深,8时至12时最浅。合并后的周末地图里,16时至20时最满,中央公园一带在12时至20时着色。图15(图题为周六)最深在20时至24时,图16(图题为周日)最深在16时至20时。
- 功能标签只用 Foursquare 签到,占全部地理标签推文的10.97%。层次聚类、k=13、一天6段时,论文认为轮廓系数最好;完全不分时段的聚类最差。12时至16时,中下城大片被标成社会服务,16时至20时大片转为餐饮。
- 稳定性的分母是测试集里的词数,不是人数。24个月分成18个月与6个月。两主题下,工作日的“中等拥挤”和周末的“高度拥挤”在6个时段都达到100%,高于用推文计数再做LDA或TF-IDF的基线。上午8时至12时在四主题里是反复出现的例外。没有独立的真实人流对照。
两年推文里,谁发得特别多?
基于位置的社交网络(location-based social networks,LBSN)在这里指带经纬度、常常还带场所的社交平台记录。本文的人类移动性指人在城市里的日常位置痕迹,不是户籍意义上的人口迁移。原始记录来自 Twitter,时间覆盖2013与2014两个完整年份,空间用 BetaNYC 的曼哈顿边界裁剪,该边界数据注明最后更新于2015年1月5日。裁完以后是596,757名用户、13,296,244条地理标签推文,文件大小3.39GB。
13,296,244÷596,757=22.28,与论文写的人均22.28条一致。这是平均值。低端有170,185名用户,论文的说法是每人至少1条;170,185÷596,757约28.5%。高端是1名用户89,999条,89,999÷13,296,244约0.68%。图2(a)的最高柱就在推文数为1的位置。少数账户对总条数的贡献,和“一名用户一票”差得很远。
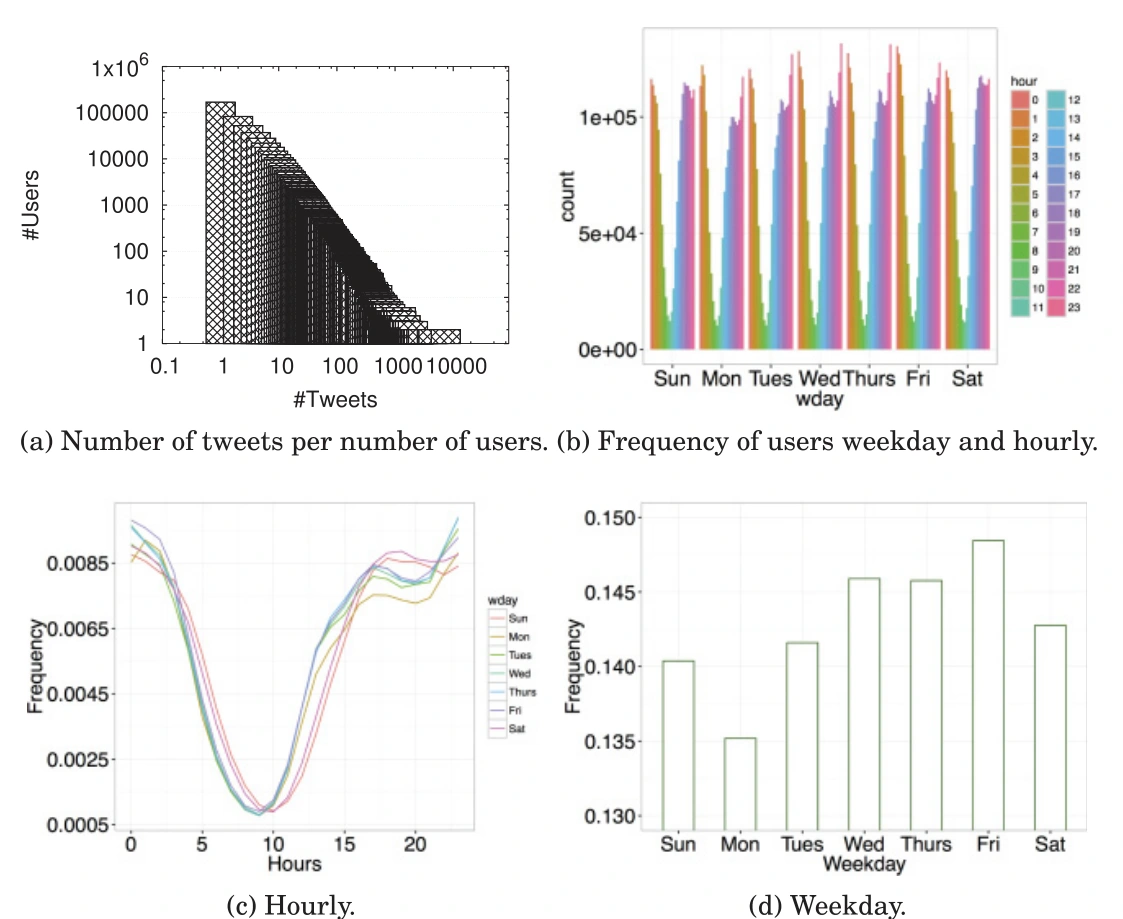
图 2|这些地理标签在用户、小时和星期几上有多不均匀?
(a)横轴是每名用户的推文数,纵轴是用户数,两轴都取对数。推文数为1的柱最高,右尾一直延伸到一万条量级;论文同时写道,10到1,000条是最密集、最典型的区间。两句的分母并不相同:高柱对应的是用户数,10到1,000条没有写明是用户数还是推文数。(b)横轴是星期几,彩色图例是0时至23时,纵轴标的是 count,子图题却写成 frequency of users。柱高接近1×10⁵的是两年合计,不能读成某个周三晚上的在场人数。(c)横轴是小时,纵轴是频率,七天各一条线。清晨约8时至10时降到0.001附近,晚间升到0.008以上。论文写周三上午9时最低、周三晚上11时最高,并说2时以后下降,5时至8、9时很低,15时前逐步上升,傍晚到午夜最高。纵轴没有说明分母,不能把0.009读成占总推文的0.9%。(d)横轴是星期几,纵轴频率的刻度在0.130到0.150。周五最高,周一最低,七天的差距远小于(c)里早晚的差距。来源:原论文 Fig. 2。
推文来自1,115个应用。表I只列出最常见的六种,六行之和是95.00%,其余5.00个百分点落在表外应用。分母都是这13,296,244条。
| 来源 | 占地理标签推文的比例 |
|---|---|
| Twitter for iPhone | 51.98% |
| 20.36% | |
| Foursquare | 10.97% |
| Twitter for Android | 9.91% |
| Twitter for iPad | 1.03% |
| dlvr.it | 0.75% |
后面的人群聚集用的是全部地理标签的位置。功能区另一步才筛到 Foursquare,也就是这10.97%。两条产物的样本并不一样。iPhone 客户端、Instagram 照片、Foursquare 签到和自动发布工具混在同一张密度图里。
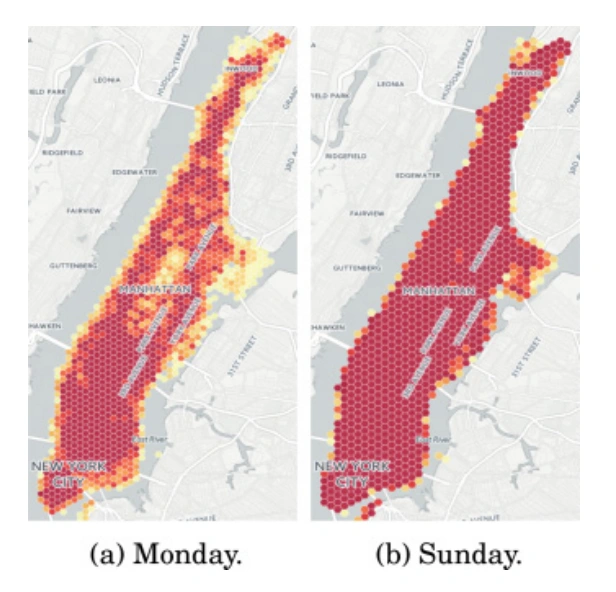
图 3|周一和周日,推文在岛上铺开的方式一样吗?
(a)周一,(b)周日。都是六边形网格上的平均密度,黄到深红表示由疏到密,图上没有数字色标。周日的深红色铺得更满,北端也更实;周一的北端和边缘更多浅黄。论文据此说周日在空间上比周一密得多。图2(d)里周一的推文频率最低,但周日并不是频率最高的一天,周五才是。空间铺得更满,和全天推文更多,是两件分开的事。来源:原论文 Fig. 3。
聚集配方和功能标签,为什么要分成两路?
既有研究里,有人用主题模型找个人的日常惯例,也有人预测每个区域内的人流量。本文把问题改成城市尺度的人群:一个邮区在哪些钟点反复变挤,以及这个钟点的签到类别是什么。邮区用纽约市信息技术与电信局提供的曼哈顿邮政编码边界。作者认为邮区比任意路段更容易被城市规划阅读;代价是邮区内部的街道差异会被抹平。
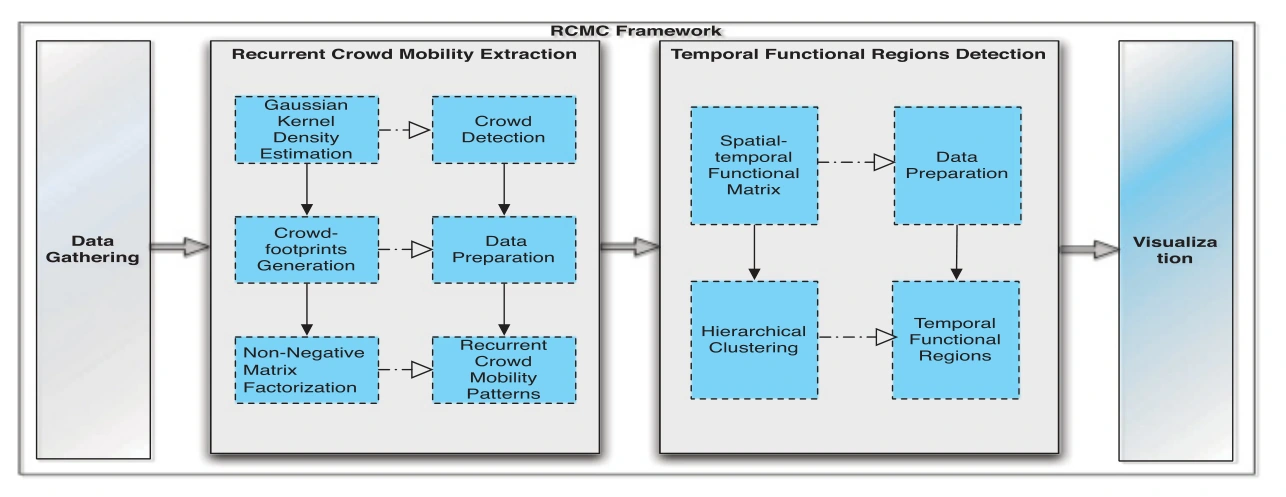
图 1|同一批地理标签,怎样分成聚集和功能两条线?
无字母子图。左端是数据汇集。中间左框用高斯核密度找出拥挤位置,再整理成人群足迹,经非负矩阵分解得到反复出现的人群流动模式。中间右框把签到整理成时空功能矩阵,做数据准备和层次聚类,得到随钟点变化的功能区。右端把两边画到地图上。虚线箭头表示对应步骤,实线表示主流程。这张图是框架示意图,不是曼哈顿的测量结果。来源:原论文 Fig. 1。
用户标识留在原始记录里,用来统计每人发了多少条。进入人群模式以后,保留下来的是“四小时时段 + 邮区”。同一星期几的全部记录合成一份文档。一周因此只有七份文档。分解问的是哪些邮区时段反复一起出现,不是某人下一站去哪。
多密才算拥挤?
拥挤区域的定义是:一个点的核密度,不低于该空间分布上各点密度估计的平均值。算法1把这个平均值放在每个邮区内部计算。于是“拥挤”是邮区内部相对更密的那些点,不是全市统一的人数门槛。一个推文很少的邮区,只要内部有一半点更密,仍然会贡献足迹。
密度用多元核密度估计,核选高斯核。印刷公式把点 p 的密度写成周围 n 个点的平均,核是 K(x, h) = α · exp(x² / (2h²))。常见高斯核会在指数上加负号,离中心越远贡献越小;正文这一行的指数是正的。α 没有给出数值。论文另称在 [−1, 1] 的参数网格上做交叉验证,把带宽 h 定为0.1。负的带宽在核密度里并不常见,正文没有解释搜索区间为何包含负数;后文使用的数值是0.1。读结果时,应把0.1理解成他们报告的平滑尺度,不要把缺了负号的印刷式当成已经写明的距离惩罚。
人群模式与功能区使用同一套钟点,一天6段、每段4小时:0时至4时、4时至8时、8时至12时、12时至16时、16时至20时、20时至24时。论文分别称为深夜、清晨、上午晚段、下午、傍晚和前半夜。选6段有两个理由:它接近规划里常用的早晚分段;功能区实验里,再切到2小时或1小时,轮廓系数的提高没有超过他们设的阈值。
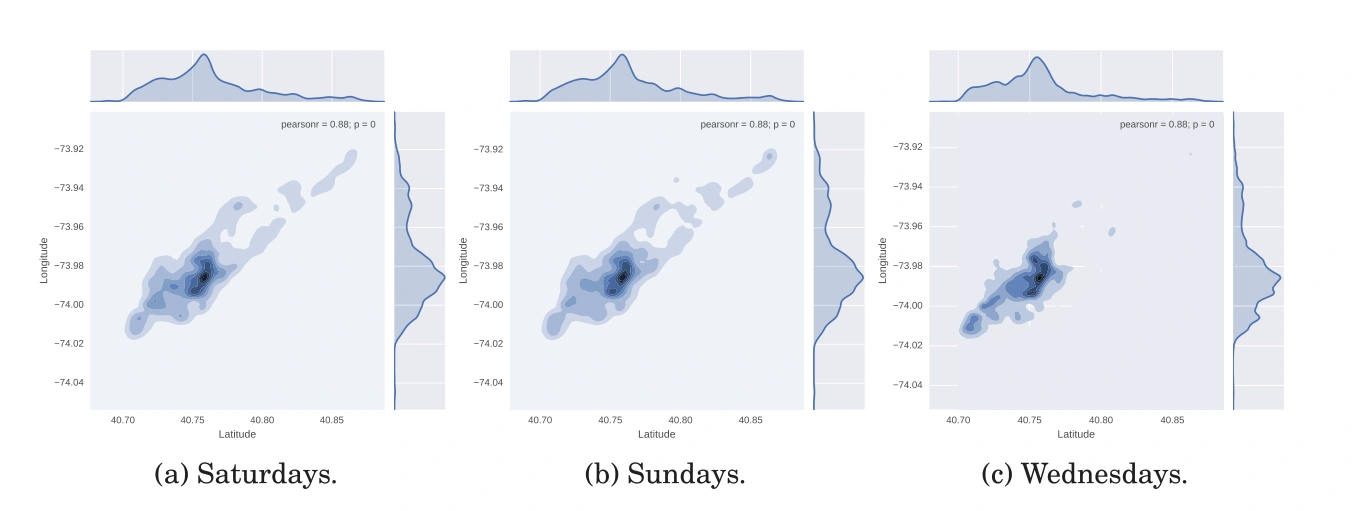
图 9|同一个下午,周末和周三的密度云一样吗?
(a)周六,(b)周日,(c)周三,时段都是12时至16时。横轴纬度,纵轴经度,颜色越深表示该处密度越高;上下和右侧的曲线是纬度、经度方向的边际分布。周六和周日除了南端的深色团,还有一块分开的北端密度;周三的深色更集中在南端,北端只剩一条薄尾。三个小图都印着 pearsonr = 0.88、p = 0。正文没有讨论这个系数。曼哈顿岛沿东北—西南倾斜,纬度和经度会一起变化,它不是周末对周三的模型得分,p = 0 只是图上印出的检验输出。来源:原论文 Fig. 9。
一周七天,怎样变成反复一起出现的邮区?
每个不低于密度均值的点,记成一个“词”:时段编号加上邮区。图4把文本挖掘的说法直接换到城市上。语料是一周七天,文档是其中一天,词是这样的人群足迹,主题就是要提取的聚集配方。图里的 4zip10003 是示意图上的例子,不是后文地图的测量结果。
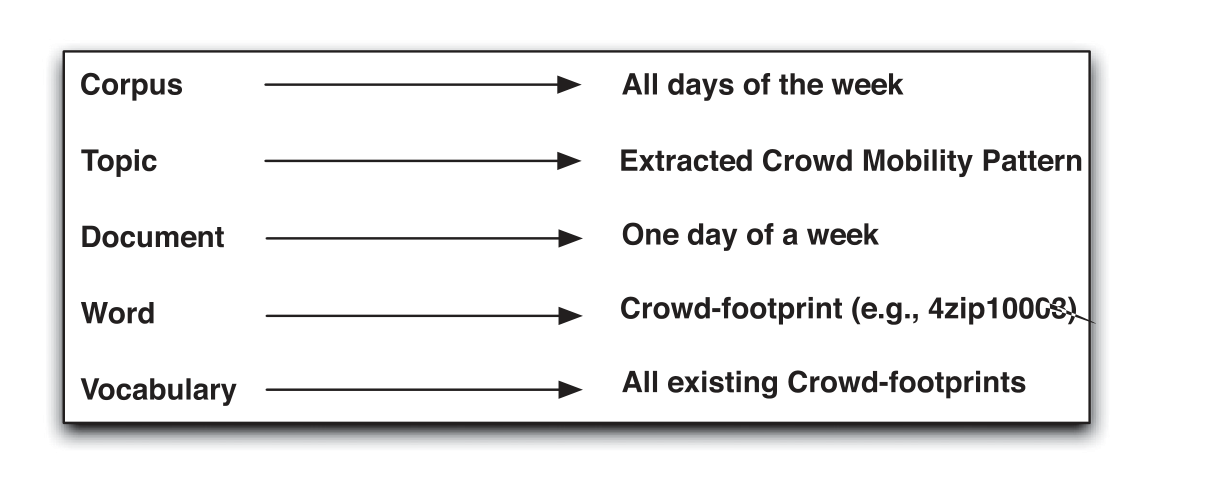
图 4|文本里的词和主题,在这里各指什么?
无字母子图。语料对应一周全部天数,主题对应提取出的人群流动模式,文档对应星期几中的一天,词对应一条人群足迹,词表是全部出现过的足迹。括号里的 4zip10003 说明“词”长什么样:一个时段编号加一个邮区。来源:原论文 Fig. 4。
非负矩阵分解(non-negative matrix factorization,NMF)把这张非负表拆成两个仍非负的矩阵,使二者的乘积尽量接近原表。他们先做词频—逆文档频率(TF-IDF)和文档长度归一化:天天都出现的邮区时段权重下降,只在少数天变挤的权重上升。初始值用非负双奇异值分解(NNDSVD),避免随机起步每次得到不同主题。优化目标是原表与乘积之间的平方重建误差。
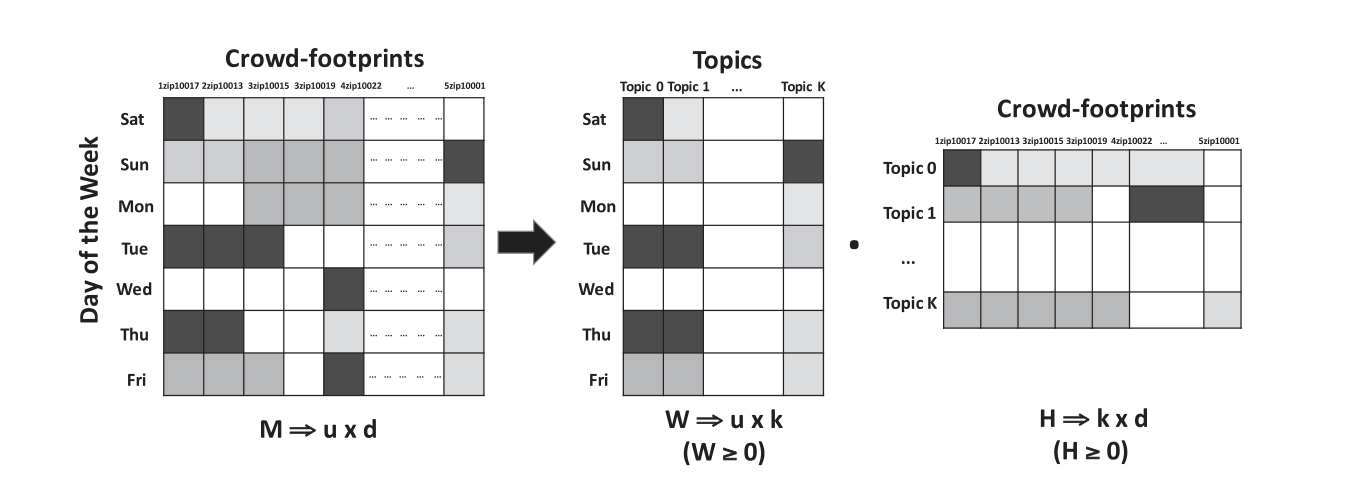
图 5|七天的足迹表,被拆成哪两块?
无字母子图。左表的行是周六到周五,列是人群足迹,格子深浅表示该天是否出现该足迹,图下写成 M ⇒ u × d。中间是每一天在各个主题上的权重,W ⇒ u × k,且 W ≥ 0。右表是每个主题由哪些足迹组成,H ⇒ k × d,且 H ≥ 0。正文另把 u 说成词数、d 说成文档数,和这张图把“天”放在行上并不同一种朝向。读图时按画面:中间回答“这一天有多像某个模式”,右边回答“这个模式由哪些时段—邮区组成”。列名里的邮区是示意图,不是排名结果。来源:原论文 Fig. 5。
因为中间矩阵只有七行,主题数最多设到7。每个数是某一天属于某个主题的权重。下表每一行七个数相加为1,所以分母是这一天自己,不是七天合计。蓝色在原表里标出该行最大的一格。正文说周末两天分别落在 Topic 3 和 Topic 4,工作日共用 Topic 0。表上的最大格是:周六 Topic 3 为0.57040886,周日 Topic 1 为0.71091948;周一至周五的最大格确实都在 Topic 0。Topic 4 的最大出现在周五,也只有0.29060095。主题编号以这张表为准。
| 星期 | Topic 0 | Topic 1 | Topic 2 | Topic 3 | Topic 4 | Topic 5 | Topic 6 |
|---|---|---|---|---|---|---|---|
| 周六 | 0.23102539 | 0.18439917 | 0 | 0.57040886 | 0.01416657 | 0 | 0 |
| 周日 | 0.28908052 | 0.71091948 | 0 | 0 | 0 | 0 | 0 |
| 周一 | 0.41321829 | 0.02970232 | 0.39386167 | 0.11050093 | 0.04348833 | 0 | 0.00922846 |
| 周二 | 0.36381954 | 0.02375433 | 0.11015824 | 0.18867259 | 0 | 0.31359530 | 0 |
| 周三 | 0.52313879 | 0.00003962 | 0.03673921 | 0.02144045 | 0.01621852 | 0.00797331 | 0.39445011 |
| 周四 | 0.62695577 | 0 | 0.10387766 | 0 | 0.11728928 | 0.15187729 | 0 |
| 周五 | 0.40699213 | 0.09169875 | 0 | 0.11397975 | 0.29060095 | 0.06595809 | 0.03077032 |
“工作日共用一个模式”指的是最大格落在同一列,不是每一天都有很高的隶属。周四的 Topic 0 有0.627,周三0.523;周一的 Topic 0 只有0.413,Topic 2 还有0.394,两者相差0.019。周二的 Topic 0 是0.364,Topic 5 还有0.314。周五的 Topic 0 是0.407,Topic 4 还有0.291。七个主题里,真正分开的是周六、周日和工作日的最大格,而且周一、周二、周五的领先幅度不大。
主题个数没有用自动准则。作者的规则是:用尽量少的主题,仍能保住7个主题里看到的那三种差异。他们试了6、5、4、3,认为4是还能保住三种差异的最少个数,并另外报告2个主题的结果。3、5、6个主题的完整权重表没有给出。
拥挤强度也不按推文条数分档。每个主题取出排名靠前的词,按该词属于这个主题的概率分成低、中、高,界线写在0.33和0.66。正文括号的开闭并不完全一致。地图上的浅红、中红、深红对应这三档概率,不是现场人数。
两套模式和四套模式,各自分开了什么?
2个主题时,Topic 0 在所有工作日上至少0.8,Topic 1 在周六是0.73、周日是0.8。图10里周五的工作日柱最接近0.8,周一至周四更高;周六在周末主题上约为0.73,周日约为0.8,两边大致互补。这是“这一天有多像这套配方”的权重,分母是该天的主题权重,不是当天的推文条数。
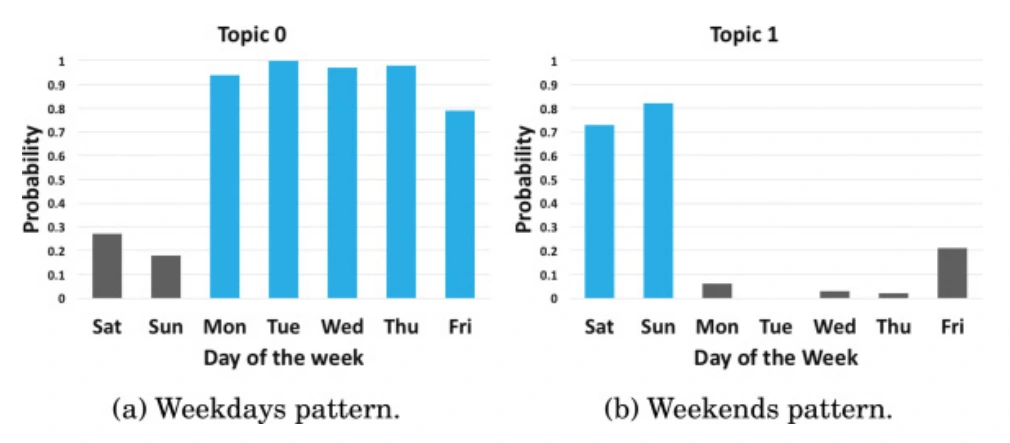
图 10|两个主题,能不能把工作日和周末分开?
(a)Topic 0,图题为工作日模式。周一至周四的蓝柱接近1,周五约0.8,周六、周日是灰柱,大约0.2到0.3。(b)Topic 1,图题为周末模式。周六约0.73,周日约0.8,工作日大多接近0,周五约0.2。纵轴是概率。它说明七天可以分成两套配方,没有标出配方落在哪些邮区。来源:原论文 Fig. 10。
地图用每个主题里排名前150的词来画。论文把中下城的深色联系到时报广场、卡内基音乐厅、世贸中心一号楼和唐人街,把上西区联系到剧院和大都会歌剧院。这些是作者对深色邮区的地点解释,图上没有印出场所名称。
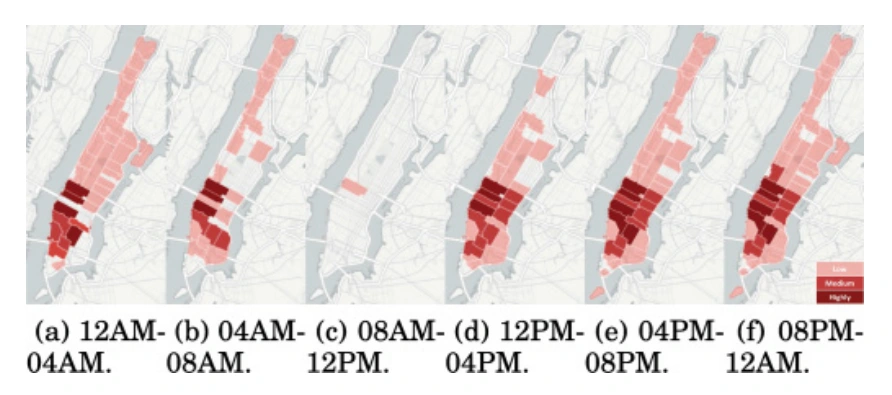
图 11|工作日的深色,集中在哪些钟点?
Topic 0。浅红、中红、深红表示低、中、高三档。(a)0时至4时,中下城有成片深红,北端多为浅红。(b)4时至8时,深红仍在中下城,范围略收。(c)8时至12时,几乎只剩浅色,是六个时段里最空的一张。(d)12时至16时,中下城的深红重新出现。(e)16时至20时,中下城深红保持,上城仍较浅。(f)20时至24时,深红最满,北端的浅红也更连贯。最深和最浅的对比发生在(f)和(c),不是发生在传统的上班高峰。来源:原论文 Fig. 11。
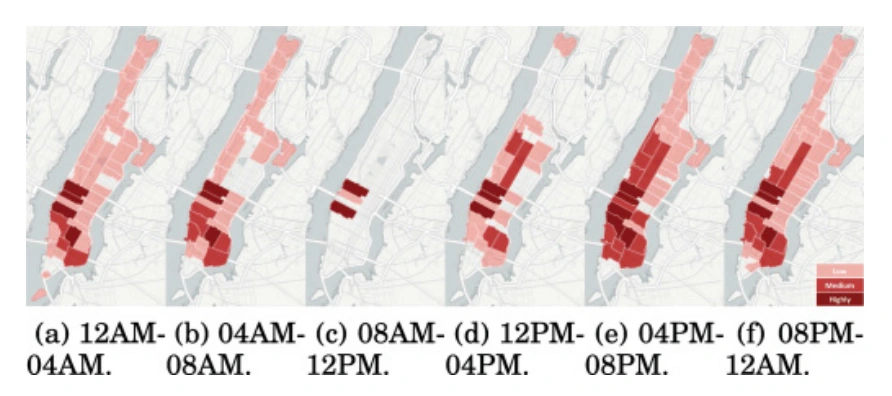
图 12|周末合在一起时,最满的是哪个下午?
Topic 1,周六和周日还没有拆开。(a)0时至4时,中下城深红,北端浅红。(b)4时至8时,深红仍在,北端更碎。(c)8时至12时,岛上几乎空白,只剩中部一小块深色。(d)12时至16时,中下城变深,中央公园一带出现南北向色带。(e)16时至20时,色带和中下城同时达到最满,是这组里深色范围最大的一张。(f)20时至24时,中下城仍深,中央公园色带变浅。论文据此说,全周最反复的拥挤时段是周末的16时至20时;8时至12时仍最空,但比工作日同一时段留下的颜色多。来源:原论文 Fig. 12。
4个主题时,图13把 Topic 0 标成工作日、Topic 1 标成周日、Topic 3 标成周六。周日的蓝柱高于0.7,周六高于0.5。工作日主题对周三、周四、周五高于0.5,对周一、周二约0.45,周五的柱最高。和2个主题相比,周末被拆开了,工作日的隶属变弱。
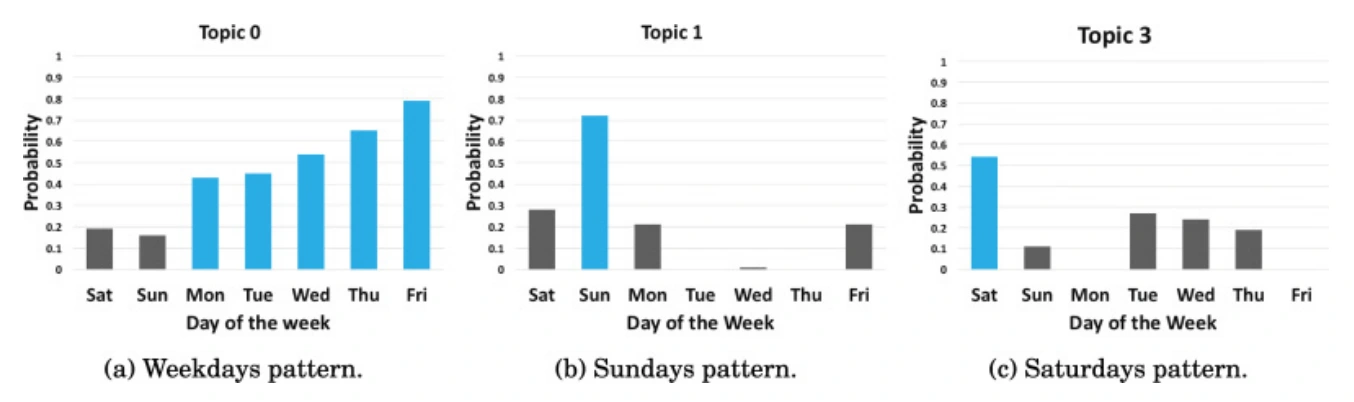
图 13|四个主题里,周六和周日还共用一个模式吗?
(a)Topic 0,工作日。从周一到周五蓝柱上升,周一、周二约0.45,周五接近0.8;周六、周日是较低的灰柱。(b)Topic 1,图题为周日。周日高于0.7,周六约0.3,周一和周五约0.2,周二、周四接近0。(c)Topic 3,图题为周六。周六高于0.5,周二至周四约0.2到0.3,周一和周五接近0。纵轴仍是某一天属于该主题的概率。来源:原论文 Fig. 13。
图14至图16的图题把 Topic 1 写成周六、Topic 3 写成周日,和表II、图13的编号相反。后文讲“周六最挤在20时至24时、周日最挤在16时至20时”时,指的是图15和图16的日期图题。下面按地图上的日期读空间,不把两套主题编号合成一个编号。
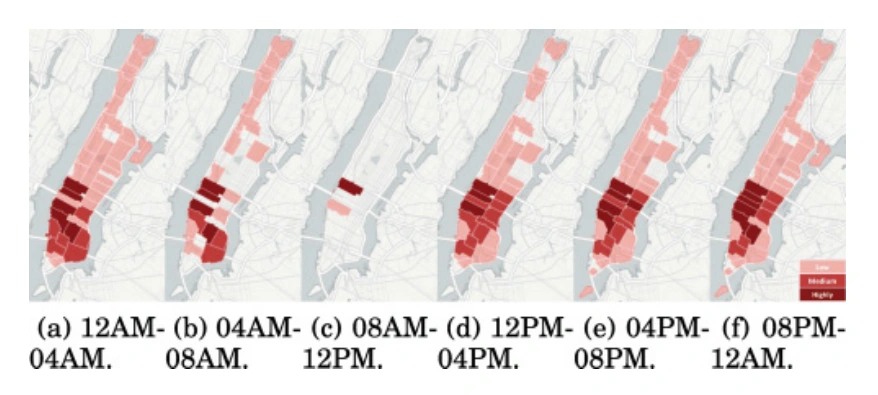
图 14|四主题下的工作日,是否还是夜里最深?
图题为 Topic 0、工作日。(a)0时至4时到(f)20时至24时的红阶与图11接近:(c)8时至12时最浅,(f)20时至24时的深红最满,中下城在下午以后重新变深。四主题没有改写工作日地图的主要钟点,它换来的是周末被拆开。来源:原论文 Fig. 14。
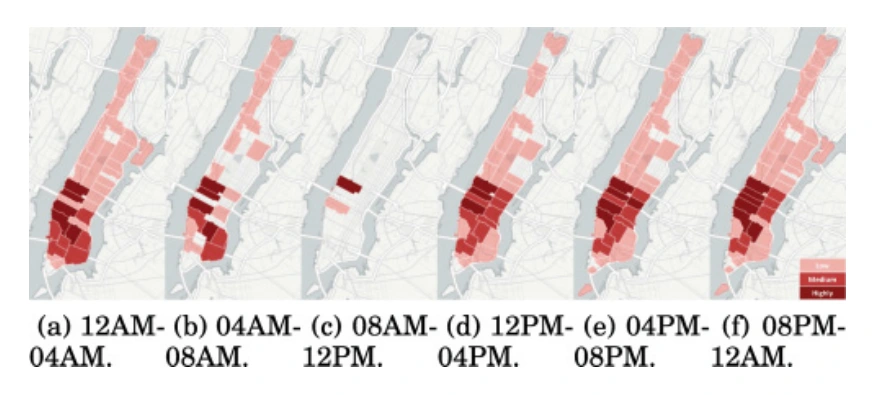
图 15|图题写成周六的那一张,深色停在多晚?
图题为 Topic 1、周六。(a)0时至4时和(b)4时至8时,深红在中下城。(c)8时至12时几乎空白。(d)12时至16时开始重新变深。(e)16时至20时中下城已有大片深红。(f)20时至24时深红最满,并连到更北的邮区。论文把这张图的最挤时段写成20时至24时。来源:原论文 Fig. 15。
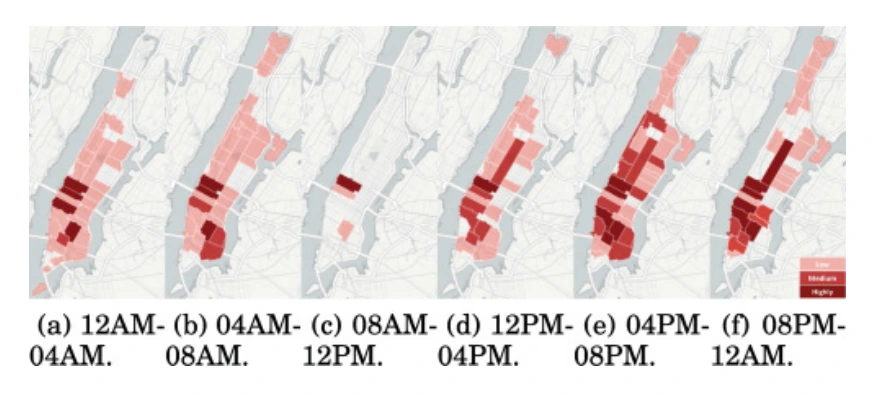
图 16|图题写成周日的那一张,上西区什么时候变深?
图题为 Topic 3、周日。(a)0时至4时,深色偏西侧和南端,范围小于周六夜。(b)4时至8时仍是窄的深色带。(c)8时至12时只剩零星深色。(d)12时至16时,中央公园一带的纵向色带出现。(e)16时至20时,西侧和中部的深色带最长,是这组最满的一张。(f)20时至24时色带还在,但不如(e)连贯。论文写周日最挤在16时至20时,并说上西区在这个时段几乎都挤;中央公园在下午、傍晚和前半夜着色。来源:原论文 Fig. 16。
把图12、图15、图16放在一起,周末并不是简单地把工作日推迟几小时。合并周末时最满的是16时至20时;按地图日期拆开后,周六的最满移到20时至24时,周日仍停在16时至20时,并多出一条偏西的纵向深色带。论文把周日更早变空理解成人们为周一做准备。这是对地图的常识解释,不是对同一批人回家时间的测量。
另一个和数据一致的空档是8时至12时。图2(c)里,大约7时至12时也是全周推文频率最低的一段。地图变空,至少和这段签到变少是同一方向;它还不能区分“人少了”和“醒着的人没有发地理标签”。
同一个邮区,中午和傍晚是同一种地方吗?
功能区只用 Foursquare 签到。场所关键词共532个,归进九类:娱乐(Entertainment)、教育(Education)、夜生活(Night Life)、游憩(Recreation)、社会服务(Social Services)、居住(Residence)、购物(Shopping)、出行(Travelling)、餐饮(Eating)。社会服务的脚注是药房、回收设施、洗衣等面向社区的服务。一个邮区在某个四小时里的标签,是该时段签到类别计数的最大项,不是规划图上的用地性质。
静态功能区把整天合成一个标签。随时间变化的功能区则允许同一邮区在不同钟点改标签。作者用图书馆紧挨商场的例子说明:若只按兴趣点数据库里有什么来解释行程,人去了图书馆也可能被记成购物。签到类别直接来自用户标出的场所,可以躲开这种错配。这也意味着,标签跟着的是发了 Foursquare 签到的人,不是经过该邮区的全部行人。
聚类比较了凝聚式层次聚类、k-means 和谱聚类。轮廓系数(silhouette coefficient)写成 (b − a) / max(a, b):a 是点到同簇其他点的平均距离,b 是到最近另一簇的平均距离。系数靠近1表示簇又紧又分开,靠近0表示重叠,靠近−1表示分错。k 从2试到14。
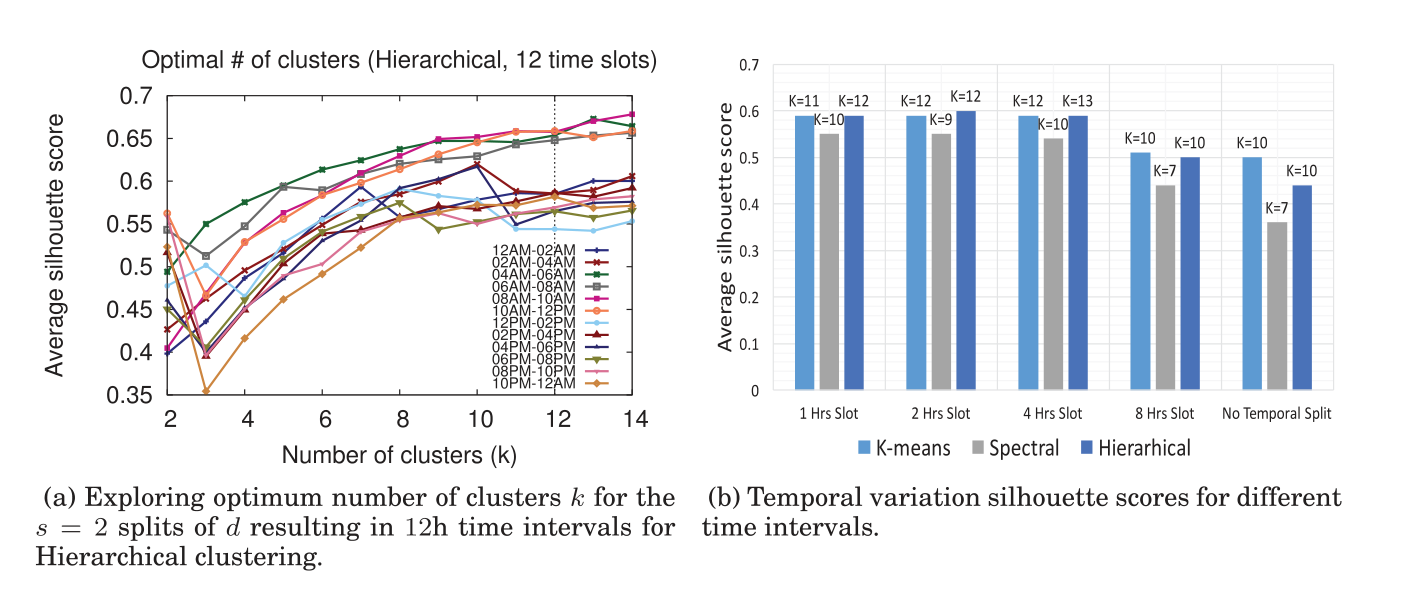
图 6|功能区要分几段、分几类?
(a)图内标题写的是层次聚类、12个时间段,图例是12AM–02AM直到10PM–12AM的2小时分段,竖虚线标在 k=12。子图说明却写成 s=2、每段12小时。曲线从 k=2 时大约0.35到0.55,升到 k=12 至14时大约0.55到0.68,并非每条都单调。读槽宽时以图例里的2小时为准;正文把这张图说成12小时一段,和标题、图例不一致。(b)五组从左到右是1小时、2小时、4小时、8小时和不分时段。每组三根柱依次是 k-means、谱聚类、层次聚类,柱顶是该次选出的 k:1小时为11、10、12;2小时为12、9、12;4小时为12、10、13;8小时为10、7、10;不分时段为10、7、10。4小时和1至2小时的柱高于8小时和不分时段;不分时段的谱聚类最矮,落在0.3与0.4之间。4小时那组里,k-means 与层次聚类的柱高接近,层次聚类并不高出一截。来源:原论文 Fig. 6。
正文的选择是:4小时相对8小时有明显提高;再切到2小时和1小时,提高不超过阈值 τ=0.001,因此停在一天6段。最终采用层次聚类、k=13。算法4的更新条件是,新的轮廓系数必须比当前最高分再高出 τ 以上,才改记最优槽数。正文另有一句写成“差值小于 τ 时改用更多时段”,和算法以及最终的6段不一致。采用结果以6段、4小时、层次聚类、k=13为准。
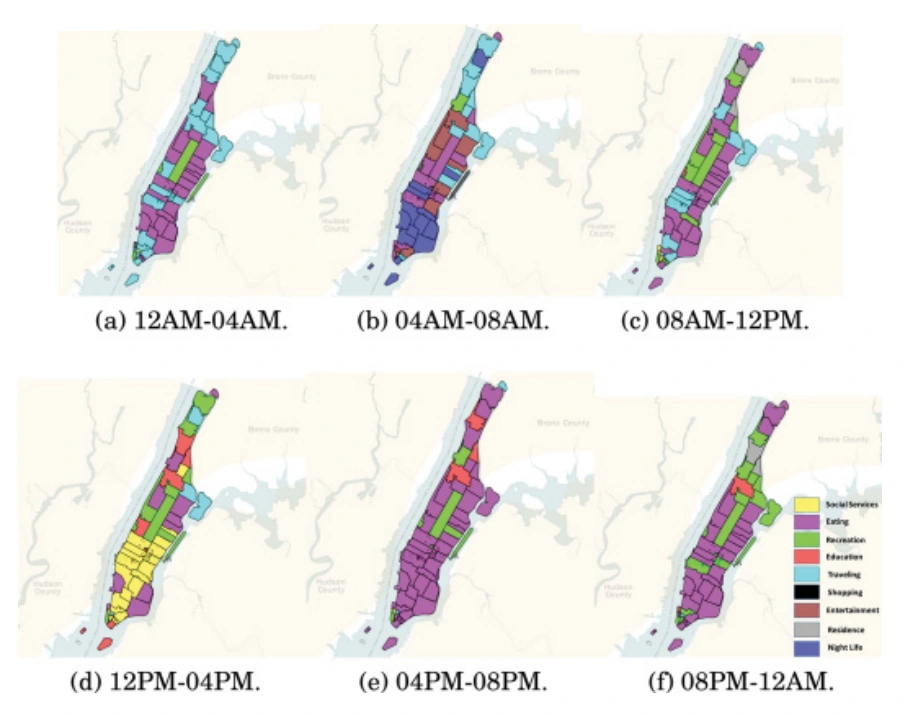
图 7|曼哈顿的主导签到类别,一天里怎样改色?
颜色见(f)旁图例:黄为社会服务,紫为餐饮,绿为游憩,红为教育,青为出行,黑为购物,棕为娱乐,灰为居住,深蓝为夜生活。(a)0时至4时,紫色最多,北端和南端有青色,中部有一条绿色。(b)4时至8时,南端和中城出现大片深蓝,并夹着红色教育斑块。(c)8时至12时,回到紫、绿和北端青色,北端还有灰色。(d)12时至16时,中下城大片变成黄色,绿色长条仍留在中部。(e)16时至20时,紫色几乎铺满全岛,只留下中部绿条。(f)20时至24时,仍以紫色为主,北端有红、青、黑、灰。同一邮区从(b)的夜生活、到(d)的社会服务、再到(e)的餐饮,是这张图要展示的时间变化。标签是该时段的最大项,没有画出第二名的比例。来源:原论文 Fig. 7。
六个邮区里,颜色和功能对得上吗?
案例对照的是两主题地图,也就是图11和图12,再配上图7的功能色。图8只标出位置,不带强度。
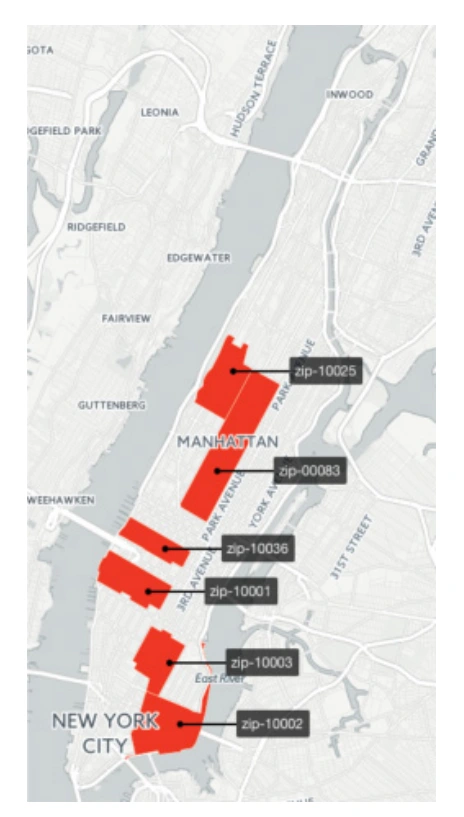
图 8|案例讨论的六个邮区在岛上的哪里?
无字母子图。红色多边形从北到南标为 zip-10025、zip-00083、zip-10036、zip-10001、zip-10003、zip-10002。论文写 zip-00083 对应中央公园;这不是纽约常用的邮政编码写法,位置画在公园一带。10036靠近中城西侧,10001在其南,10003和10002更靠下城。图上没有拥挤档次,也没有功能色。来源:原论文 Fig. 8。
10025在除4时至8时以外的时段都被标成餐饮,4时至8时为夜生活。工作日各时段都是低拥挤;下午和傍晚为中等,论文把这档和餐饮目的连在一起。连在一起是对同一邮区、同一钟点的并列阅读,不是目的调查。
00083在几乎所有时段都是游憩,和地图上的绿色长条一致。案例写它在工作日为低或未标成拥挤,周末的傍晚和前半夜为中等。前文对图12的阅读是周末12时至16时和16时至20时着色。两处正文差了一个时段:一个包括12时至16时,一个包括20时至24时。图12的色带主要出现在(d)和(e)。中央公园“周末会挤”可以看见,“挤在哪两个四小时”要以所引的那张图为准。
10036含时报广场。案例说它在工作日和周末的多数时段都是高拥挤,工作日8时至12时除外。功能句子彼此冲突:一处把0时至4时和12时至16时都写成出行,另一处把12时至16时写成社会服务;4时至8时为夜生活,傍晚和前半夜为餐饮。图7(d)在12时至16时把中下城大片涂黄,和社会服务这一个标签一致。12时至16时的功能以这张图的大片黄色为准,不把案例段落里互相冲突的两个标签并成一个结论。
10001在0时至4时为高拥挤,功能被写成出行。论文把它和24小时开放的宾夕法尼亚车站、33街车站连在一起,这个车站位置和10001相符。周末8时至12时再次为高拥挤,功能仍是出行。12时至16时在工作日和周末都为高拥挤,功能为社会服务,和图7(d)的黄色一致。论文还把联合广场写进10001。常用邮区里,联合广场更接近10003。这句是作者的地点解释,不是本文新测出的边界。
10003在工作日0时至4时为高拥挤、餐饮;4时至8时为中等、夜生活。同一钟点的10036被写成高拥挤的夜生活,所以“夜生活”这个标签并不对应同一档强度。8时至12时为低或未标拥挤,12时至16时转回餐饮,傍晚和前半夜再次为高拥挤。
10002在工作日为低或未标拥挤;周末除8时至12时外为中等,功能是餐饮。论文把这理解成周末人群为了餐饮而来。同样,这是标签和颜色的并列,不是从住宅到餐馆的路径。
六个例子说明同一件事:邮区的主导类别会随钟点更换,拥挤档次也会更换,两者有时一起变,有时并不成比例。10036的夜生活可以是高档,10003同一标签只是中档。功能回答“签到文字更像哪一类”,强度回答“这个时段—邮区在主题词里的概率落在哪一档”。
换六个月,同样的词还在吗?
聚集地图没有真实人流可以逐区核对。作者改问另一件事:24个月切成18个月和6个月,在覆盖同样多方差的词表上,高、中、低三档还能重合多少。哪6个月被留作测试,正文没有写明。
一个主题被写成低、中、高三个词集合。某一档的稳定性是两个集合交集的大小,除以测试集该档的词数,再乘100%。分母是测试集,不是训练集,也不是两边的并集。论文用一套假想邮区演示:测试集3个词里有2个也出现在训练集,2÷3×100%=66.67%。这是公式例子,不是曼哈顿的实测。
为了让18个月和6个月可比,两边先取到相同的方差。论文认为保留90%方差就够,并写训练集用前150个词、测试集用前60个词。图17把训练集竖线标在150个词,测试集竖线标在90个词,横线是方差0.9。60和90没有对齐。比较“词表取多长”时,正文是60与150,图上的测试标记是90。
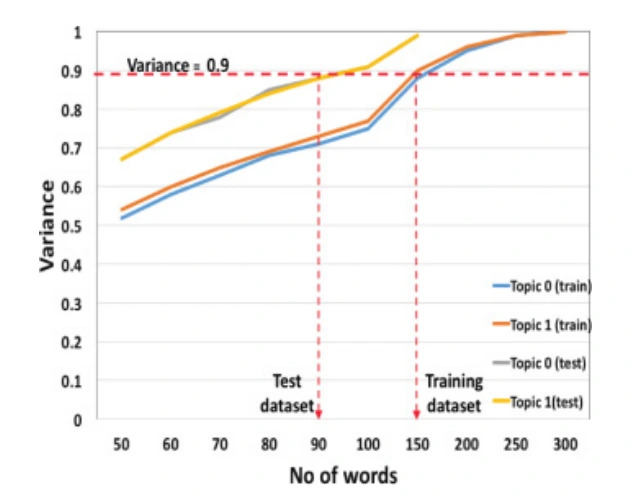
图 17|前多少个词,才覆盖主题里90%的方差?
无字母子图,主题数为2。横轴是词数,纵轴是方差。蓝色、橙色是 Topic 0 和 Topic 1 的训练曲线,在150个词附近穿过0.9。灰色、黄色是对应的测试曲线,上升更快,竖虚线标在90个词。50个词时,测试曲线约在0.67到0.70,训练曲线约在0.52到0.55。这张图只说明词表要取多长,不是稳定性本身。来源:原论文 Fig. 17。
基线有两个。LDA基线先按推文条数找拥挤区域,再用潜在狄利克雷分配提取主题,做法接近 Ferrari 等人2011年的城市模式提取。TF-IDF基线同样先计数,再按词在多少文档里出现来打分。RCMC则先做核密度,再做非负矩阵分解。三者的差别同时来自“怎样定义拥挤”和“怎样提取主题”,不能把全部分数差记到其中一步。
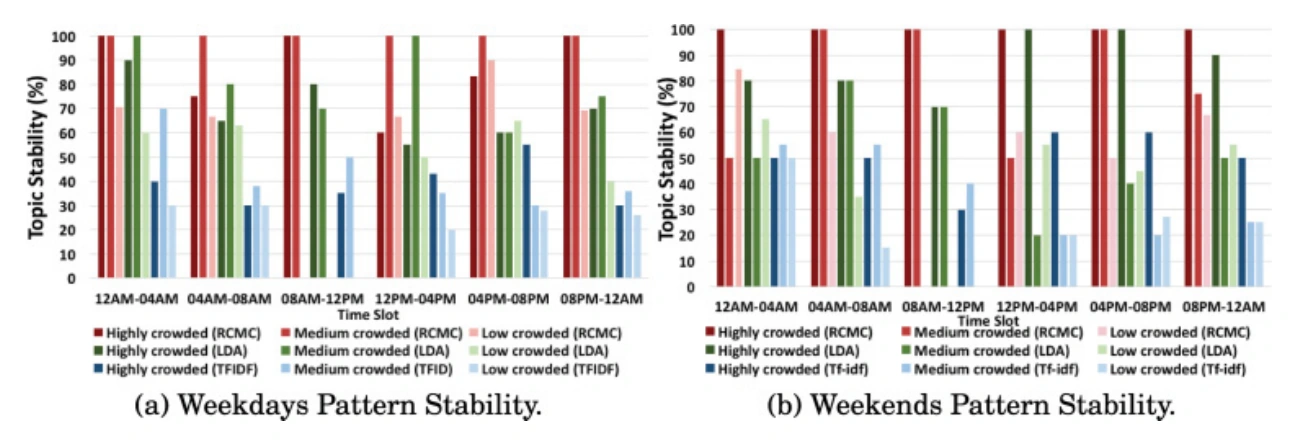
图 18|两个主题时,哪一档在六个月后还对得上?
纵轴是主题稳定性,单位是百分数,分母为测试集词数。颜色区分 RCMC、LDA 和 TF-IDF,深浅区分高、中、低拥挤;图例里 TF-IDF 的拼写并不统一。(a)工作日。论文写 RCMC 的中等拥挤在全部6个时段都是100%;LDA只在0时至4时和12时至16时达到同样的100%,其余时段论文写至少比 RCMC 差20%;TF-IDF在0时至4时为20%,其余时段为50%。这两个20%不是同一件事:前者是相对 RCMC 的差距,后者是 TF-IDF 自己的稳定性。(b)周末。论文写 RCMC 的高度拥挤在全部时段为100%;LDA只在其中两个时段同样达到,其余至少比 RCMC 差20%;TF-IDF仍然最差。100%表示测试集该档的词全部出现在训练集对应档,不是人流预测全对。来源:原论文 Fig. 18。
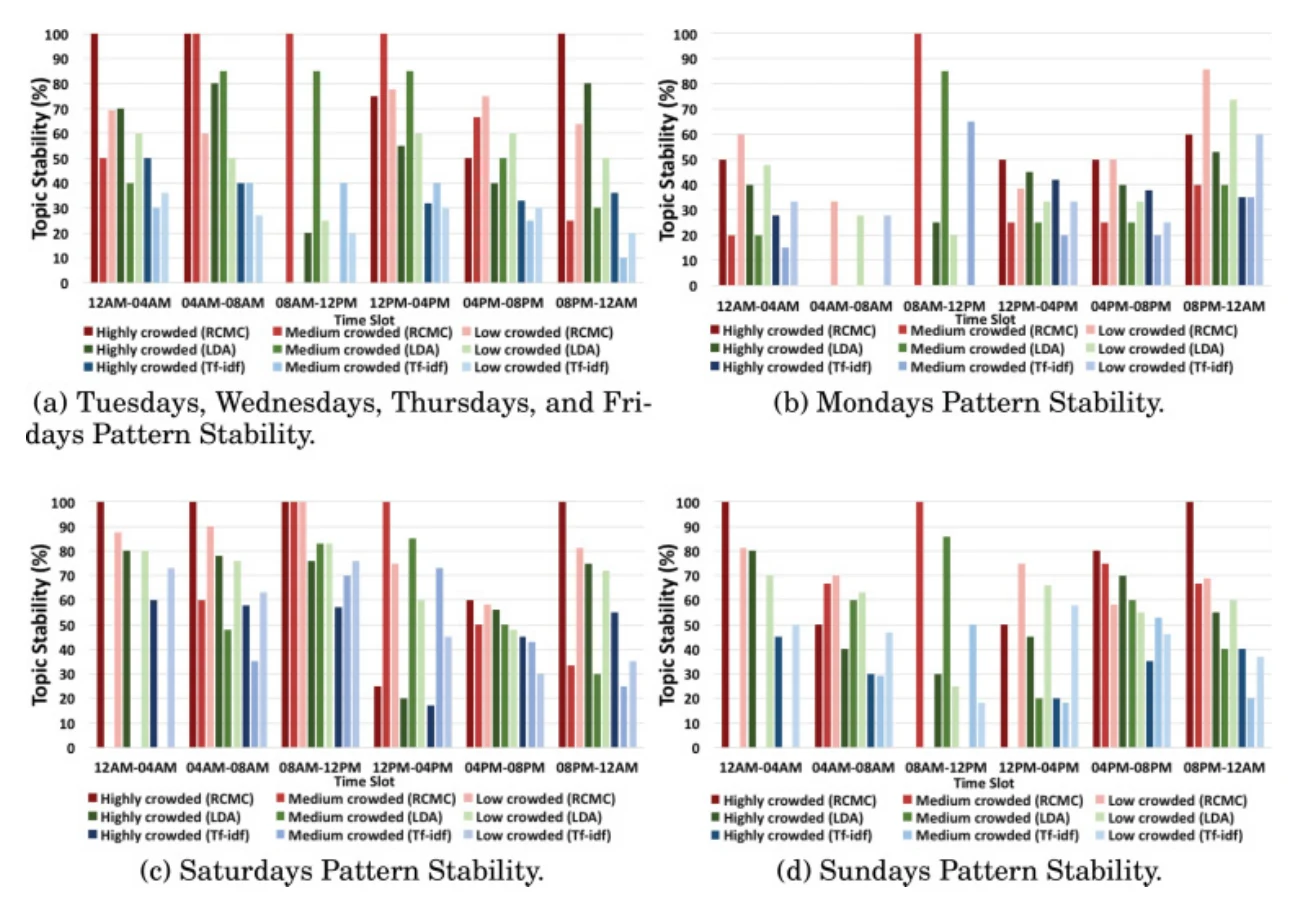
图 19|拆成四个主题以后,稳定性还保持吗?
纵轴和颜色与图18相同。(a)周二至周五。(b)周一。(c)周六。(d)周日。论文写,除8时至12时的高、低两档外,RCMC 在(a)的各时段最好;周一也是总体最好,但8时至12时的高、低两档上基线更好。周六至少与基线相差10%到20%。周日同样整体更好,8时至12时再次例外。四主题的整体稳定性低于两主题。测试集只有6个月,主题切得更细以后,更难在测试词表里找到同一批词。来源:原论文 Fig. 19。
8时至12时的例外,和前面地图最空的时段是同一个钟点。作者写道,这一段的人群模式本身不明显,除此之外没有更清楚的解释。空的时段里,前150或前60个词更不稳定,符合“信号弱时重合下降”;这仍然是词表重合,不是对上午出行人数的误差。
这些图能支持到哪一步
能够站住的是一套描述。在这批曼哈顿地理标签上,工作日的反复深色位于20时至24时的中下城,8时至12时最浅;周末合在一起时,16时至20时最满,中央公园一带在午后到傍晚着色。按地图日期拆开后,周六的最满更晚,周日的纵向深色带更偏西,并在16时至20时达到最满。Foursquare 子集上,同一邮区的最大签到类别会随四小时改变,12时至16时的中下城大片为社会服务,16时至20时大片为餐饮。两主题的中等或高度拥挤词表,在另一段6个月里可以完全重合,并且高于两个计数基线。
支持不到的也同样具体。连续两个时段的深色邮区,是两张聚集图的差别,不是同一批人从甲邮区走到乙邮区。密度按点计算,1名用户的89,999条可以占到全部地理标签的约0.68%,图上的深色可能被高频账户拉动。功能只用10.97%的 Foursquare 签到,和画拥挤地图的全量地理标签不是同一样本。主题个数是为了保住三种差异而手选的。表II、图13与图15、图16的主题编号不一致;图6(a)的槽宽、图17的60与90、案例里10036在12时至16时的两个功能标签,也不能并成一个数。稳定性没有地面真值,18个月与6个月的词重叠也不是下一天的预测准确率。
论文希望这套配方能用于动态调配资源、发现异常聚集、帮游客或购房者看一个地区白天夜里是否改功能,以及按下一站的功能改推荐。这些是提出的用途。正文没有事件清单、没有资源调度实验,也没有比较推荐是否更合适。异常聚集若定义成“这个钟点不该挤的邮区挤了”,节日、游行和发帖习惯的改变都会触发它,本文没有把这些情形分开。
一句话总结
曼哈顿一周里反复出现的,是地理标签在邮区和四小时上的聚集配方:工作日夜里中下城更深,周末午后到傍晚中央公园一带会着色,周六的深色更晚、周日更早,邮区的主导签到类别也会随钟点改名;这还不能说明同一批人从一处走到了另一处。
核心来源
- ACM Digital Library 正式页面,核对题目、作者、卷期和 DOI:10.1145/3086636。正文图1至图19及表I、表II均出自2017年8月这一版。
- 邮区边界在文中指向纽约市开放数据中的邮政编码统计区,曼哈顿裁剪边界指向 BetaNYC,最后更新说明为2015年1月5日。
作者介绍
以下只写论文署名和本文参考文献里能够核对的研究方向。
- Haytham Assem:署名单位是 IBM Ireland 与都柏林三一学院 ADAPT 中心,地址写在 IBM Innovation Exchange 的认知计算组。参考文献中的 Assem 与 O’Sullivan(2015、2016)讨论机器学习如何被实际使用,以及如何从城市数据里识别社会人口意义上的分区模式。
- Teodora Sandra Buda:署名单位是 IBM Ireland,地址同属该认知计算组。参考文献中与 Assem、O’Sullivan 合写过把机器学习做成物联网与人联网服务的论文。
- Declan O’Sullivan:署名单位是都柏林三一学院计算机科学与统计学院的 ADAPT 中心。他是上述城市分区论文的共同作者,也是本文三位署名作者之一。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若公交或警力只按工作日20时至24时的深红邮区排班,周六更晚的深色、周日16时至20时偏西的纵向色带会被漏掉。论文让人看见签到聚集的钟点不同,没有测量客流、警情或网络负荷是否跟着这些邮区移动。排班要先问深色代表的是到场的人,还是到场并且发帖的人。
同一问题可以用这批数据做一次反证。现在每个点都进入核密度,1名用户最多可贡献89,999条。若每个用户在每个四小时、每个邮区只留一条,再重做密度阈值和主题,中下城的深红可能收缩,也可能仍然最深。收缩,说明配方里有高频账户;不收缩,说明许多用户都把地理标签留在同一带。论文没有报告按人去重后的地图。
12时至16时的大片黄色也需要第二条规则。社会服务在脚注里包括药房、回收和洗衣,地图却只保留聚类后的最大项。若餐饮只比社会服务少几个百分点,整片中下城仍会被涂成同一种黄。把这张图读成“中午全城都在办社会服务”,就把胜出标签当成了土地用途。要判断它是不是一种真实的城市节奏,至少得看到每个邮区九类签到的占比,而不是只看赢的那一类。