同一个网格,会不会进入高风险,和会高风险多久,为什么对不上同一套原因?
论文名片|Lu Zhao、Xiaoxu Wu,Multi-level urban environments and population mobility shape urban epidemic dynamics: A study in Beijing,Sustainable Cities and Society,2026。DOI:10.1016/j.scs.2026.107394。2025年11月1日收稿,2026年4月9日修回,2026年4月10日接收。本文依据期刊预校样解读;出版方写明这一版已经过接收后的编排,仍会再做文字加工,尚未成为最终正式版。研究在六边形网格上解释官方高风险记录。
2022年11月21日之后,北京被标成新冠高风险的地点开始陡增,12月5日接近1万处。研究窗口是10月29日到12月7日,首尾都算上共40天。后文的聚类给出两类高风险网格,平均持续天数分别是6.6天和15.3天。可以借这两个平均数想象两个都进过名单的网格,一个接近一周解除,另一个超过两周。这只是帮助读数,论文没有追踪某一对相邻网格。
楼密、人多、店多的地方,似乎既容易开始,也会更难结束。论文把这两件事拆开测。网格在这40天里会不会至少进入一次高风险,更多跟着它自己的建筑肌理、居住功能和生活服务设施;高风险能维持多久,更多跟着它与其他高风险网格的联系,尤其是公交和地铁带来的长距离联系。西城和海淀的楼房与车站并不少,高风险天数却偏短,持续天数也就没有从市中心向外简单递减。
先说结论
- 高风险地点从11月21日起上升,12月5日接近1万处。它们集中在中心城区和郊区行政中心,乡村更分散。持续天数的图例从0画到33天;朝阳、丰台偏长,西城、海淀偏短。东城因缺少疫情数据,没有进入分析。
- 只放入本地环境时,识别有没有暴发的 AUC 为 0.921 ± 0.004。只放入溢出风险时,解释持续天数的调整后 R² 为 0.529 ± 0.034。四层变量合在一起,分别是 0.939 ± 0.004 和 0.564 ± 0.019。
- 合并后的暴发模型里,本地特征占贡献的 54.77%,建筑离散度最高;短距离邻域溢出排在它后面,强于长距离客流溢出。持续模型里,溢出风险占 57.25%,长距离指标最高,短距离指标次之。这四个百分比的分母是四类贡献之和,加总为 100%;分子是该层特征的贡献,分母里没有网格数或人数。
- 按各特征的 SHAP 值聚类后,论文给出的平均暴发风险从城市核心一带的 0.83,到密集乡村聚落的 0.18,再到稀疏乡村、工业和农林用地的 0.01。已经进入高风险的网格再分成平均 6.6 天和 15.3 天两类。正文没有给出每一类有多少个网格。
- 人口来自《北京人口普查年鉴 2020》,公交地铁刷卡来自 2019 年 5 月 13 日至 19 日。模型解释的是网格记录怎样被预测,不直接给出一个人被感染的概率。
官方名单记下的是地点,分析单位是网格
北京在论文里被分成两组区。中心六区是西城、东城、朝阳、海淀、丰台、石景山。外围是通州、顺义、房山、大兴、昌平、怀柔、平谷、密云、延庆、门头沟。到 2024 年末,常住人口 2183 万,其中流动人口占 37.9%,城镇化率 88.2%。这三个数描述的是 2024 年末的城市背景。疫情窗口在 2022 年秋冬,不能把 2183 万当作这 40 天的病例分母。
作者选这段时间,是因为这是中国全面放开新冠管控之前北京报告的最后一波。当时日常活动和人员往来已经大体回到疫情前的水平,城市仍处在常态化防控之下。分析只保留城乡建设用地,因为高风险主要出现在有人活动的地方。东城整区被排除。
高风险名单来自国家卫健委网站,经 GitHub 仓库 COVID-Risk-Region 整理。与感染者相关的居住、工作和活动地点,以小区或建筑为单位被标成高风险;连续 5 天没有新增感染后,降为低风险。论文引用的是 2022 年 11 月 11 日中央政府关于进一步优化防控措施的通知,这个日期落在研究窗口里面。持续天数因此含着这套 5 天解除规则。
每个六边形网格有两个结果。暴发是 0 或 1:窗口内有没有出现过至少一段连续的高风险。持续天数是这段高风险有多长。正文写的是每一次暴发事件的长度。同一网格若有多段高风险,模型按事件还是按网格收成一行,正文没有说明。
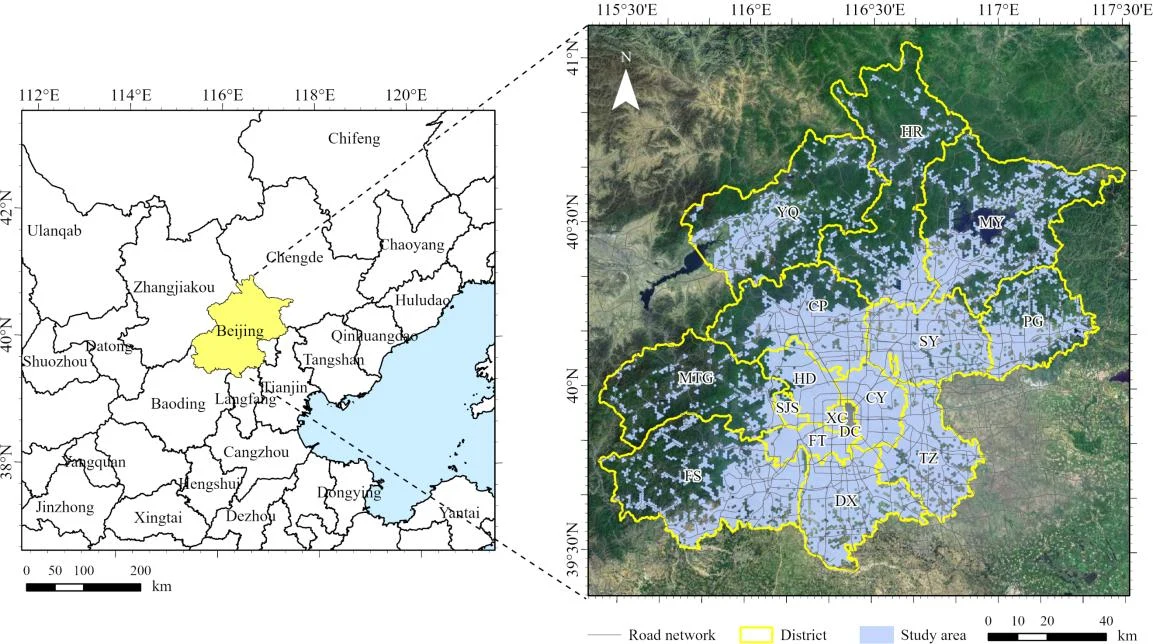
图 1|分析落在北京哪些土地上?
左图用华北区位标出北京。右图黄线是区界,灰线是路网,浅蓝色块是研究范围,铺在卫星影像上。范围呈斑块状,对应有人活动的建设用地,各区界内仍有大片未纳入的土地。东城仍被标在中心,因缺少疫情数据没有进入后文模型。来源:原论文 Fig. 1。
网格必须先定大小。作者用六边形,是因为后面要用 Queen 邻接:两个格子只要共边或共顶点就算相邻,六边形能让一个格子到各个邻居的距离相等。他们试过面积从 0.04 km² 到 9 km² 的一套格子,对应正方形边长从 200 米到 3000 米、每步 200 米。比较指标是全局莫兰指数(Global Moran’s I,看高风险在空间上聚不聚)和地理探测器的 q 统计量(看某种分区能解释多少空间差异)。正文没有列出每个尺度的指数,最后采用面积 0.64 km² 的六边形。0.64 km² 等于边长 800 米的正方形面积,格子本身仍是六边形。进入模型的格子一共有多少、其中多少曾被标成高风险,正文没有给出。
环境分三层,流动分成近和远
特征框架分本地、周边、街道或乡镇三层,再加一组由人员联系算出来的溢出风险。图 2 是这套框架的示意图。
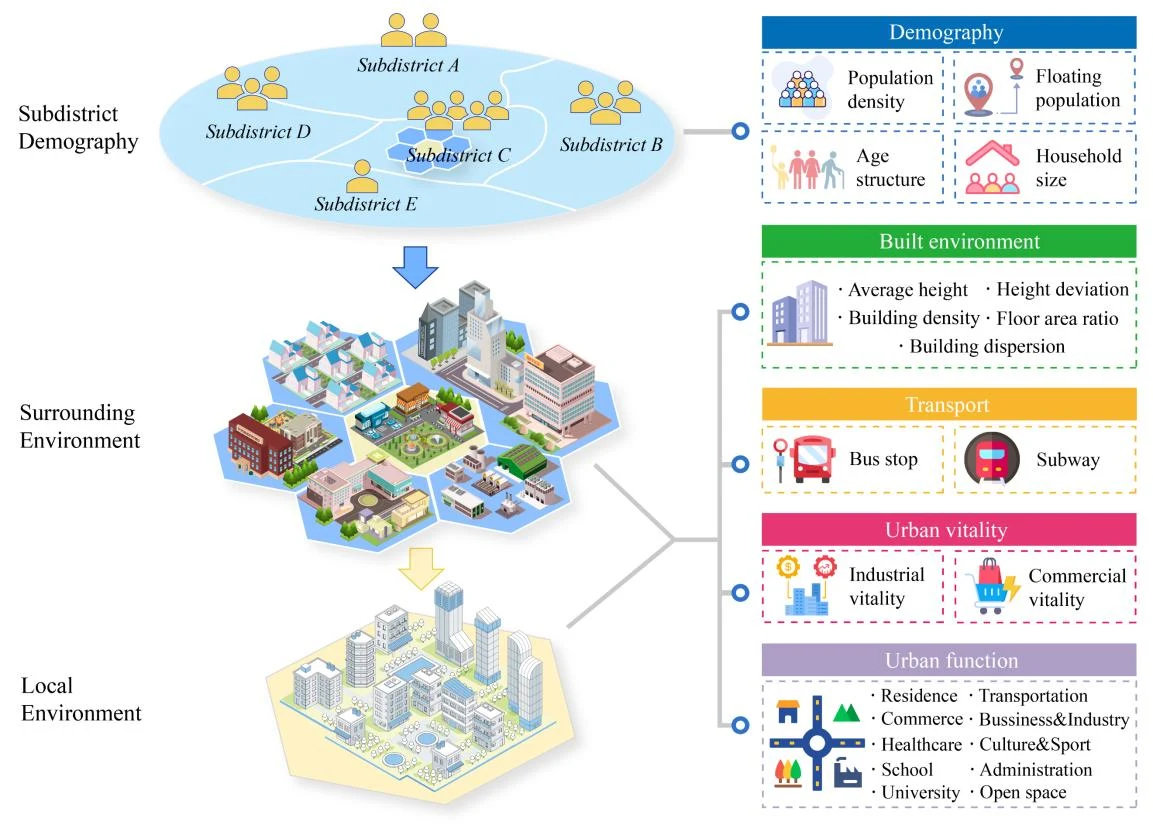
图 2|一个网格的解释变量从哪三层来?
左侧自上而下是街道或乡镇的人口、周边若干格子的环境、格子自己的环境。右侧列出五组内容:人口、建成环境、公交与地铁、城市活力、城市功能。图中的工业活力、商业活力,对应正文的商务活力与生活活力。这张图只说明变量怎么分组。来源:原论文 Fig. 2。
本地变量都在 0.64 km² 的格子里计算。建成环境有平均建筑高度、高度标准差、建筑密度、容积率和建筑离散度。交通有公交站和地铁站数量,分别把格子再向外扩 300 米和 800 米,用来减轻格子边界把站点一切两半的问题。生活活力是零售、餐饮、住宿、休闲娱乐兴趣点的个数;商务活力是企业、产业和金融机构的个数。兴趣点是 2022 年高德数据。十类用地来自百度地图和 OpenStreetMap 的面状兴趣区,包括居住、商业、交通、商务与工业、医疗、文化体育、行政、中小学与幼儿园、高校与科研机构、开敞空间。开敞空间含公园、景点、水面、农田、林地和道路等。
建筑离散度衡量的是建筑底面有多碎。计算时把各建筑底面轮廓的周长加总,再除以 4 倍的底面积之和的平方根。小而碎、轮廓总长相对面积更长的建筑群,数值更高。后文把它和低层、排布很密的乡村聚落放在一起,数值高对应的是轮廓碎,对应的场景可以仍然很密。容积率在文字定义里是总建筑面积相对格子内建设用地面积;预校样印出的公式则是各建筑的底面积与高度相乘后再除以建设用地面积。若底面积已经按建筑面积理解,再乘高度会和常见容积率错开。后文只把它当作建筑强度的一项候选变量,并沿用正文的文字定义来理解方向。
用地占比也做了两步缩放,用来减轻某一类用地总面积特别大时对格子的支配。某一类在这个格子里的面积,先相对该类用地的总体量缩放,再在格子内部变成各类之间的份额。正文称为 Chi 等人的算法。周边变量则是把本地指标拿到相邻格子上做平均。多数日常活动被放在 2 公里、也就是 15 分钟生活圈里考虑,大型商业和公园可以更远,所以滞后最远收到 4 公里以内。每一项具体用多远,选的是随机森林预测误差最低的那一档。
街道或乡镇变量来自 2020 年人口普查年鉴,再赋到格子上。因此同一个街道里的格子,人口密度、流动人口占比、年龄结构和户规模是同一套数。人口密度按建成区面积计算,单位是人每平方公里。流动人口在这里是居住地不在户籍地的人口占比,统计的是户籍与居住地的差别。年龄分成 0–14 岁、15–64 岁、65 岁及以上。户规模包括户均人数,以及一人户、两人户、三到四人户、五人及以上户的占比。
溢出风险要回答另一件事:别的格子的高风险,会按联系强度分多少到这个格子头上。短距离用一阶 Queen 邻接,权重按行标准化,只连紧挨着的格子。长距离用公交和地铁刷卡。数据是 2019 年 5 月 13 日至 19 日这个非节假日周;两次乘车如果换乘间隔少于 30 分钟,就并成一次行程。站点仍用公交 300 米、地铁 800 米的服务范围。两个站点之间的客流,会分给所有落在这两个服务范围里的格子对,所以一条行程可以进入许多格子对。流量矩阵再做成对称,并除以观测天数,得到日均联系强度。对称之后,图上读不出早出晚归的方向,只剩两地之间的相互作用有多强。
计算时,每个格子的溢出风险是联系强度乘上对方格子的风险,再对所有其他格子求和。暴发用的风险窗口,是目标格子变成高风险之前的 5 天,不含当天:对方只要有一天处于高风险,就记 1,否则记 0。持续用的窗口更长,从这 5 天之前一直加到目标格子回到低风险,把对方每一天的高风险状态累加起来。于是暴发有两个溢出指标,邻域的叫 HRisk_NB,客流的叫 HRisk_Flow;持续也有两个,DRisk_NB 和 DRisk_Flow。
这四套时间要对在一起读。疫情记录是 2022 年 10 月 29 日至 12 月 7 日,兴趣点是 2022 年,人口是 2020 年普查,刷卡是 2019 年 5 月。作者认为职住结构不大可能根本改变,所以用 2019 年的公共交通网络代理恢复日常活动之后的联系。这个判断是假设。2019 年的客流强度,不能直接换成 2022 年 11 月某一天的乘车人数。
先让每一层单独预测,再看合在一起多出多少
解释变量先做两步筛选。斯皮尔曼相关只用来看变量两两之间的关系。真正决定去留的是方差膨胀因子:超过 5 的变量,用向后逐步回归拿掉。暴发模型去掉 8 个,持续模型去掉 9 个。被去掉的变量名单在补充表里,正文没有逐一列出。
留下来的变量分成五套极端梯度提升模型(extreme gradient boosting,XGBoost)。它用一棵棵决策树去拟合前一棵还没拟合好的部分,适合弯弯曲曲的关系,也不需要事先写好公式形状。五套模型的分工如下。
| 模型 | 放入的变量 |
|---|---|
| 模型 1 | 本地环境 |
| 模型 2 | 周边环境 |
| 模型 3 | 街道或乡镇人口 |
| 模型 4 | 溢出风险 |
| 模型 5 | 上面四层全部 |
超参数用 Optuna 在 Python 3.9 里搜索,五折交叉验证,整个搜索重复 10 次,留下表现最好的一组。暴发看对数损失和 AUC。对数损失越小,模型给出的概率越贴近这个格子实际有没有暴发;AUC 越接近 1,越能把暴发格子排到非暴发格子前面。持续天数看均方根对数误差 RMSLE 和调整后 R²。RMSLE 先取对数再算误差,特别长的天数不会把误差完全主导;调整后 R² 在解释掉的变异里扣掉变量多少带来的虚高。表里的加减号,正文没有说明是折间标准差还是标准误。
| 结果 | 指标 | 模型 1 | 模型 2 | 模型 3 | 模型 4 | 模型 5 |
|---|---|---|---|---|---|---|
| 暴发 | 对数损失 | 0.296 ± 0.008 | 0.372 ± 0.006 | 0.379 ± 0.007 | 0.454 ± 0.006 | 0.260 ± 0.009 |
| 暴发 | AUC | 0.921 ± 0.004 | 0.860 ± 0.002 | 0.856 ± 0.005 | 0.844 ± 0.004 | 0.939 ± 0.004 |
| 持续 | RMSLE | 0.546 ± 0.013 | 0.529 ± 0.007 | 0.529 ± 0.009 | 0.434 ± 0.009 | 0.406 ± 0.009 |
| 持续 | 调整后 R² | 0.104 ± 0.040 | 0.178 ± 0.021 | 0.205 ± 0.036 | 0.529 ± 0.034 | 0.564 ± 0.019 |
四套单层模型的 AUC 都高于 0.8,所以任何一层单独拿来给格子排序,都能分出不少高风险格子。本地环境在暴发上最好。溢出风险单独预测持续天数最好,调整后 R² 为 0.529;本地环境单独解释持续天数时,调整后 R² 只有 0.104。合在一起的模型 5 两项都最好:暴发 AUC 从最好的单层 0.921 升到 0.939,持续天数的调整后 R² 从 0.529 升到 0.564。多出来的一截说明几层变量一起用有增量,增量小于单层之间的差距。后文解释的是这个合并模型。
解释用 SHAP(SHapley Additive exPlanations)。它把一次预测相对平均预测的偏差,分给每个特征:这个特征放进来之后,预测平均变动多少。全局重要性是所有格子上绝对贡献的平均。另外用置换重要性做对照:把某一列打乱,看模型变差多少。SHAP 解释的是这组树的预测。它还没有把建成环境、人口和流动互相造成的那部分拆成因果。
地点数在十二月初接近一万,天数不按圈层排
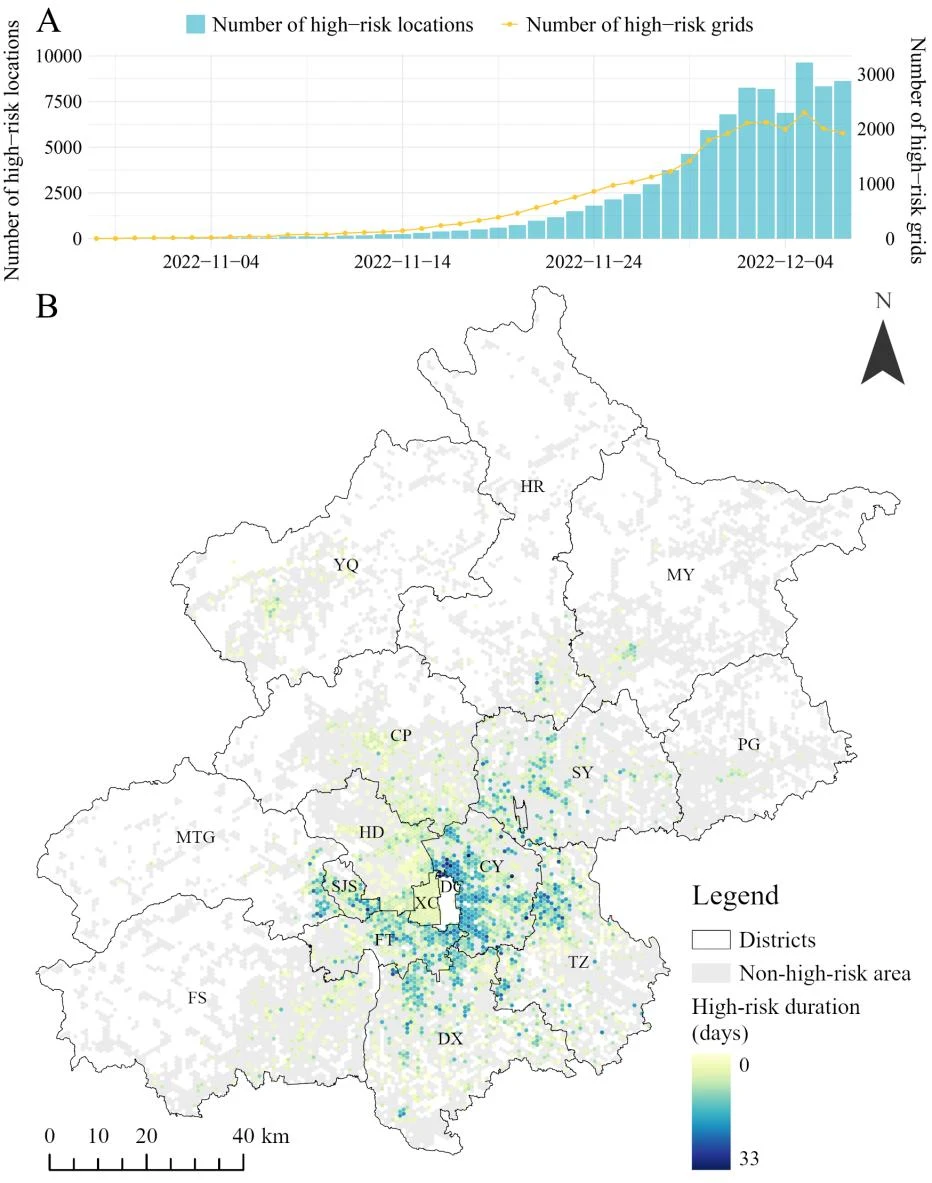
图 3|这 40 天里,高风险在何时变多、在何处停留更久?
(A)青色柱是每日高风险地点数,左轴刻度到 10000;黄色折线是高风险网格数,右轴刻度到 3000。11 月中旬以前两条线都靠近底部,11 月 21 日之后上升。正文写地点数在 12 月 5 日达到接近 10000;图上最高的柱也顶到 10000 刻度附近。网格折线在 12 月初升过 2000,仍远低于地点数,因为一个网格里可以有许多地点。(B)灰色是非高风险区域,白线是区界。高风险网格按持续天数着色,图例从 0 天的浅黄到 33 天的深蓝。深色集中在朝阳、丰台一带和若干郊区行政中心;西城、海淀颜色更浅。乡村格子更散。来源:原论文 Fig. 3。
地点数和网格数一起上升,说明这波记录既是点变多,也是成片的格子被卷进来。空间上却分成两张图。有没有高风险,城区和郊区中心更密。高风险能涂多久,不服从离天安门越近越久。西城、海淀位于中心城区,持续天数偏短;通州、石景山、门头沟、大兴、顺义的行政中心虽然更靠外,也有成片的较长天数。图 3 只描述名单本身,还没有加入建筑、人口和刷卡。
楼和车站跟着高风险走,开敞空间大体相反
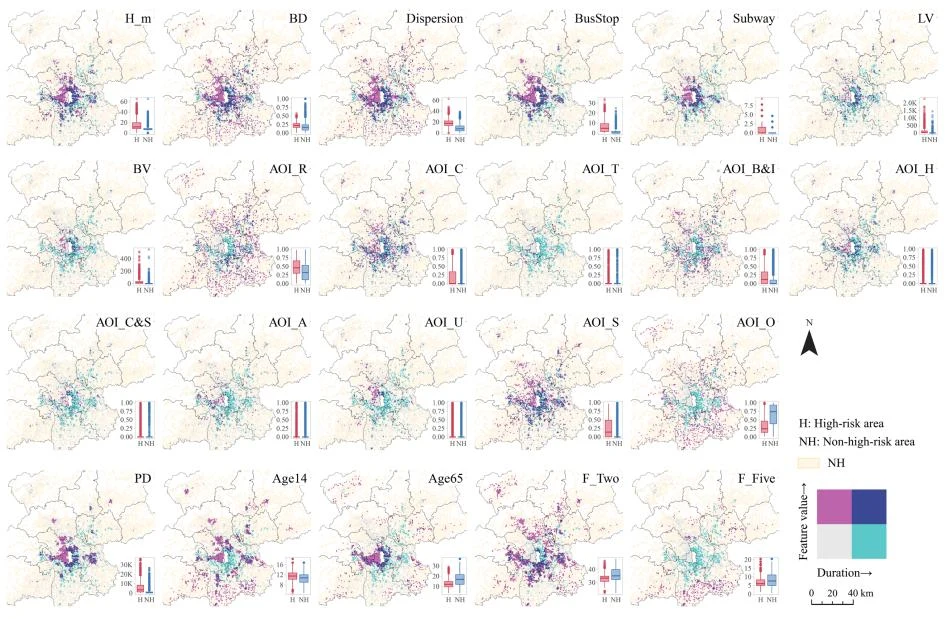
图 4|哪些环境指标和高风险天数在地图上同向?
这张图没有子图字母。每一小图是一个指标:颜色同时表示该指标高低和高风险持续长短,角上的箱线图比较高风险格子(H)和非高风险格子(NH),米色底是非高风险区域。第一行是平均建筑高度、建筑密度、建筑离散度、公交站、地铁站、生活活力。第二行是商务活力、居住、商业、交通、商务与工业、医疗用地占比。第三行是文化体育、行政、高校、中小学、开敞空间。第四行是人口密度、0–14 岁占比、65 岁及以上占比、两人户占比、五人及以上户占比。高度标准差、容积率、流动人口占比和其余户型没有画在这张图上。来源:原论文 Fig. 4。
正文的读法分成几组。平均高度、建筑密度、离散度、公交站和地铁站,在高风险格子里更高,也和中心城区较长的持续天数同向;西城、海淀是例外,指标高、天数短。生活活力和商务活力的箱线图重叠更多,空间上没那么齐。居住、商业、商务与工业、中小学用地在高风险格子里相对更高。商业和中小学的高值更贴近城区里拖得久的地方,居住、商务与工业的高值更多在外围。开敞空间在高风险格子里整体更低,地图方向也和高风险天数相反。交通、医疗、文化体育、行政、高校这几类,正文认为没有清楚的空间规律,箱线图差异也不明显。
人口描述和后面的模型方向要分开记。人口密度、0–14 岁占比在高风险格子里相对更高;65 岁及以上、两人户、五人及以上户则相反。若只看和长持续天数叠在一起的高值区,人口密度和 65 岁及以上集中在海淀、丰台靠近城区的一侧,两人户集中在丰台和大兴。0–14 岁和五人及以上户与持续天数的空间同向性为负。这些箱线图没有互相控制。一个指标在高风险格子里更高,仍然可能只是因为它和楼密度、区位绑在一起。
暴发的贡献落在本地,拖久的贡献落在联系上
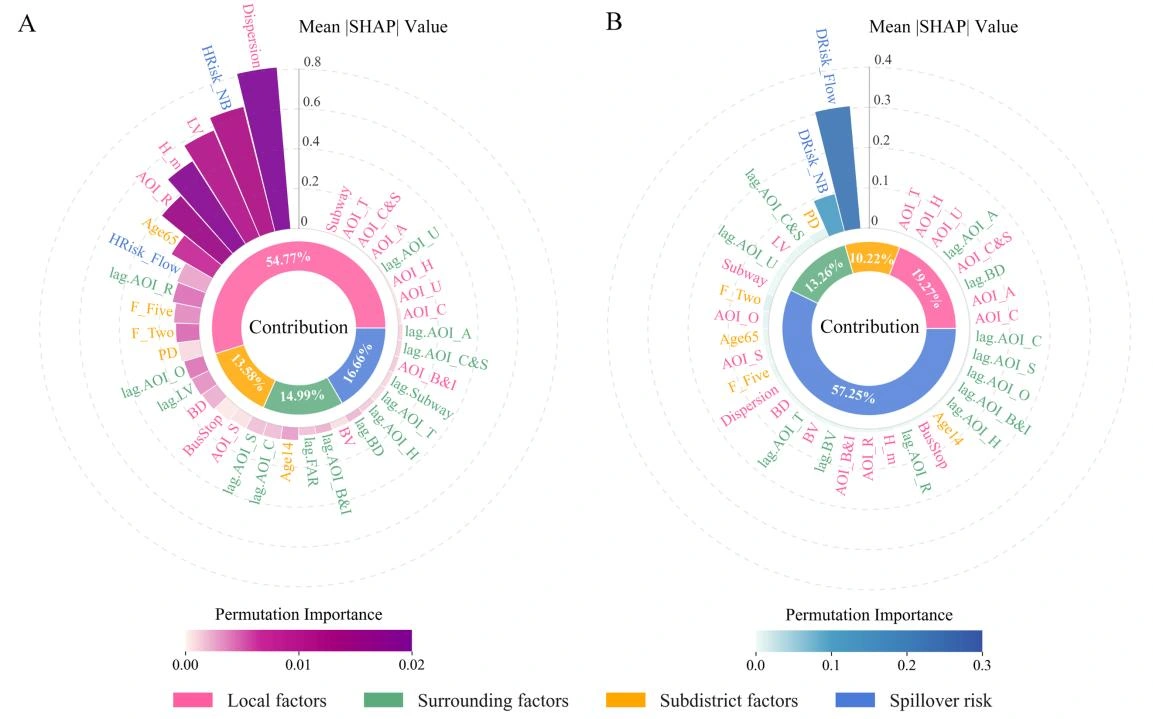
图 5|合并模型里,哪一层变量贡献更大?
(A)暴发。(B)持续天数。环中的百分比是该层特征的贡献份额:粉色为本地,绿色为周边,橙色为街道或乡镇,蓝色为溢出风险。外圈条形的长度是平均绝对 SHAP,颜色是置换重要性;左右两图的颜色条各自有刻度,深浅不能跨图比较。(A)的份额是本地 54.77%、溢出 16.66%、周边 14.99%、街道或乡镇 13.58%。(B)的份额是溢出 57.25%、本地 19.27%、周边 13.26%、街道或乡镇 10.22%。两组百分比各自加总为 100%。来源:原论文 Fig. 5。
暴发一侧,最长的条是建筑离散度,置换重要性同样把它放在首位,方向为正。生活活力、平均建筑高度、居住用地占比也长。两个溢出指标里,邻域溢出 HRisk_NB 强于客流溢出 HRisk_Flow,紧跟在离散度之后。周边变量整体较短,正文指出周边居住用地占比与暴发风险为负向关系。街道变量都参与区分高风险格子,其中 65 岁及以上占比的负向作用最强。两人户和五人及以上户被描述为非线性:偏低和相对偏高的两端,都对应更高的暴发风险。这条曲线画在补充图里,正文没有给出转折点的具体数值。
持续天数一侧,最长的条是长距离溢出 DRisk_Flow,方向为正,短距离溢出 DRisk_NB 次之。其余本地、周边和人口变量的条短很多。也就是说,一旦格子已经进入高风险,模型用来拉开 6 天和 15 天的信息,主要是它连着多少别的高风险格子,以及这种连接来自邻接还是公共交通。
两边的集中程度不同。持续天数的 57.25% 压在溢出这一层里。暴发的 54.77% 虽然也过半,但本地层内部还有好几项长度接近的条,是一组环境特征一起在起作用。作者还计算了特征两两之间的 SHAP 交互。正文说这些交互比较弱,不改变上述主次。具体是哪一对,写在补充文本里。
市中心看邻居,城乡交界看房子和店铺
每个格子取绝对 SHAP 最大的那一项,当作它的主导因素。图 6 只在高风险格子里画出前四名,其余主导因素涂成灰色。
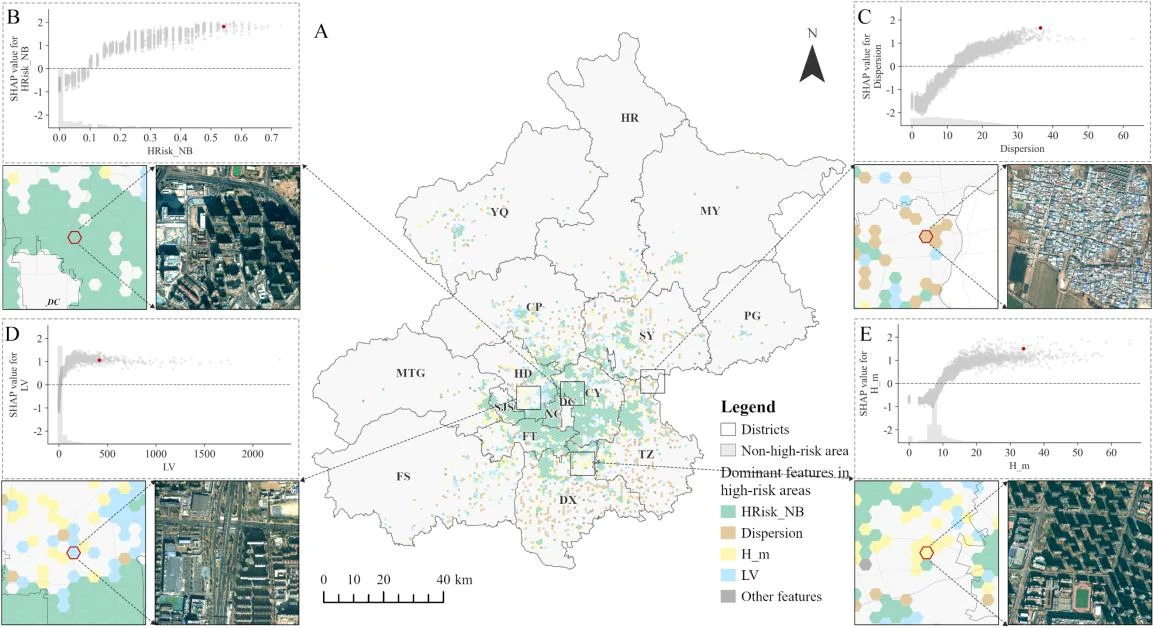
图 6|高风险格子的主导因素怎样从城区换到城外?
(A)前四名的分布:青色是邻域溢出 HRisk_NB,棕色是建筑离散度,黄色是平均建筑高度,浅蓝是生活活力,灰色是其他因素。中心城区和其他行政中心以青色为主,城乡交界和更外的郊区更多是棕色、黄色和浅蓝。(B–E)依次是 HRisk_NB、离散度、生活活力、平均高度。每组上面是该指标对 SHAP 的散点,红点是选出来看的格子;下面是这个格子附近的放大图和卫星影像。四个散点总体向右上,指标越高,对暴发预测的推动越大;低值一端可以落到负的 SHAP。来源:原论文 Fig. 6。
四种主导因素对应的建成形态不同。邻域溢出主导的地方,多是多层居住小区,也是居民活动强度高的地带。离散度主导的地方,主要是低层、排布很密的乡村聚落,和周围农田、农业设施、工业用地能分开。生活活力和建筑高度主导的格子围在邻域溢出区的外圈,位于城乡交界。生活活力高的例子是商场和批发市场这一类商业服务集中的地方。建筑高度主导的例子是人口相对集中的新建居住区。
因此,城区高风险格子在模型里更常被邻居的高风险推动,郊区和乡村高风险格子更常被本地的房子、高度和店铺推动。这是主导因素的空间分工。拿全城一起算,图 5 里本地特征仍占暴发贡献的 54.77%。图 6 问的是另一件事:在已经进入高风险的格子里,哪一项贡献排第一。
长距离联系在四个格子里长得不一样
持续天数最依赖 DRisk_Flow 之后,作者挑了四个代表性格子看联系的形状。
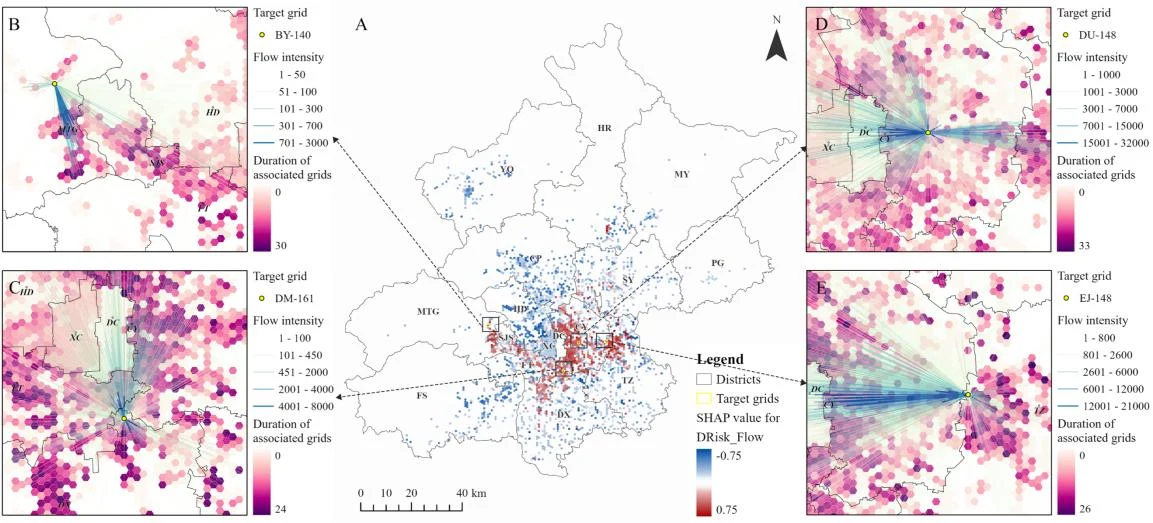
图 7|长距离溢出高的地方,连的是哪一种格子?
(A)DRisk_Flow 的 SHAP 值。蓝色到 −0.75,表示这项把持续天数的预测往下拉;红色到 0.75,表示往上推。正值成片出现在朝阳、通州、大兴和门头沟。黄框是四个例子。(B)门头沟 BY-140。(C)大兴 DM-161。(D)朝阳 DU-148。(E)通州 EJ-148。黄点是目标格子,线是它与其他格子的流量强度,底图颜色是相连格子自己的高风险天数。四张小图的流量分档和天数色标各自独立,最深一档对应的流量各不相同。来源:原论文 Fig. 7。
流量强度是站点客流分配到格子之后的联系强度,图例没有再标明人次。各图最高一档不同:朝阳 DU-148 为 15001–32000,通州 EJ-148 为 12001–21000,大兴 DM-161 为 4001–8000,门头沟 BY-140 为 701–3000。相连格子的持续天数色标上沿,分别是 33、26、24 和 30 天。
朝阳 DU-148 同时连着近处和远处,周围相连格子的高风险天数长,格子自己也被维持在高风险环境里。通州 EJ-148 位于城市副中心,既有周围联系,也有指向远处城区的联系,两边的持续高风险一起对应它较长的天数。大兴 DM-161 的格局接近通州,和相邻格子的来往更多。门头沟 BY-140 的强联系主要留在门头沟行政中心方向;作者把它和山区、公共交通选择较少放在一起解释。四张图共同说明,长距离溢出是一类指标,地理形状可以是全市枢纽、副中心双向联系、近邻来往,或山区内部联系。
暴发风险沿城乡梯度下降,天数在西城和海淀离开这条梯度
作者把每个格子的一整组 SHAP 值放进层次聚类,联结方式是 Ward 法,用来看哪些格子被同一组特征推着走。聚类输入是每个格子的 SHAP 值组合,分组完成后再查看各类的平均风险。
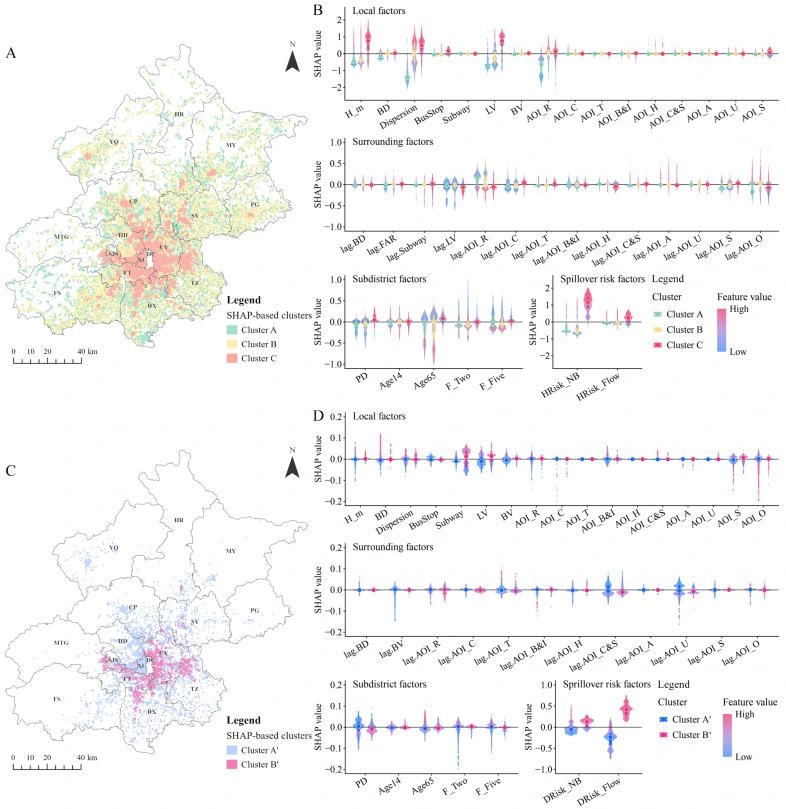
图 8|格子按贡献组合分成哪几类,每类的平均风险是多少?
(A)暴发模型的三类:A 为稀疏乡村、工业和农林用地,B 为人口较密的乡村聚落,C 为历史城区和在发展的郊区居住社区。(B)三类在本地、周边、街道和溢出四组特征上的 SHAP 分布,点的颜色表示该特征值高低。(C)只在高风险格子里再分的两类持续天数:A’ 较短,B’ 较长。(D)这两类的 SHAP 分布,溢出两项明显分开,其余特征的贡献更靠近 0。来源:原论文 Fig. 8。
论文给出的平均暴发风险,C 类 0.83,B 类 0.18,A 类 0.01。暴发指标本身是有或无,这三个数落在 0 到 1 之间。正文没有说明它们是类内实际出现高风险的格子比例,还是模型预测概率的平均,也没有给出三类各有多少格子。空间上,C 类覆盖历史城区和正在发展的郊区居住社区,B 类是密集乡村聚落,A 类是稀疏乡村、工业用地和农林用地。这条从 0.83 到 0.01 的下降,和北京由历史建设与规划形成的城乡梯度放在一起。
C 类的高风险来自一组正贡献:平均建筑高度、生活活力、建筑离散度、居住用地占比,以及 HRisk_NB、HRisk_Flow。65 岁及以上占比在这里是负贡献。A 类则是这些正贡献指标的取值更低,预测被一起压低。B 类大多数特征的 SHAP 在 0 附近或以下,居住用地、离散度和 65 岁及以上占比除外。正文的说法是,在这一带,较低的老年人口占比,与较密的建筑、以居住为主的用地一起,对应更高的暴发风险。
高风险格子再按持续模型的 SHAP 分成两类,平均天数 6.6 天和 15.3 天。分母是各自类里的高风险格子,个数未报告。和暴发那张几乎整片偏高的城区图相比,西城、海淀的多数格子落在 6.6 天的 A’。通州、大兴、顺义、怀柔、门头沟等郊区行政中心更多落到 15.3 天的 B’。把两类分开的,主要是 DRisk_Flow 和 DRisk_NB 的正贡献,其他特征的贡献较弱。短距离相邻和长距离公共交通在这里是同一方向的两股联系,流动是它们进入模型的方式。
讨论里对西城、海淀的短天数给了一个可能原因:高校和科技企业集中,校园里的生活设施使严格封控更容易切断出校流动,企业的远程办公也减少长距离通勤。这是作者依据职住关系提出的解释,本文没有直接测量这两个区的远程办公比例或校园封闭天数。讨论还提到,这张暴发风险的空间格局与 2003 年北京 SARS 病例的历史分布相似,大兴机场附近的榆垡在这一轮相对 SARS 时期风险更高。这两句比较引用的是既有研究,本文没有报告新的空间重叠统计量。
讨论中的防控建议按阶段分开。高风险出现之前,作者认为应按本地环境做差别化检测和监视,并在高密度居住、商业服务场所减少接触。进入持续阶段之后,建议转向活动范围、错时出行和对高风险区向外的长距离高强度流动的管理,并提到步行和骑行。这些是策略推论。模型没有比较任何一项措施实施前后的天数变化。
关联能说到哪,就停在哪
结果支持的判断可以收成三句。第一,在这 40 天的北京网格记录里,会不会进入高风险,和进入之后能持续多久,主导特征不同。第二,暴发一侧权重最大的是格子自己的建成环境和生活服务,持续一侧权重最大的是跨格子的溢出,长距离公共交通联系排在短距离相邻之前。第三,暴发风险的空间高低与城乡梯度同向,持续天数还会在西城、海淀离开这条梯度。
说到这里为止,还有几道边界。高风险名单记录的是居住、工作和活动地点的行政标记,再叠加连续 5 天无新增才解除。指标里有标记是否出现、标记持续几天,没有发病率,也没有格子内的感染人数。SHAP 百分比是模型贡献的份额。持续模型的调整后 R² 为 0.564,约 43.6% 的变异仍留在这组变量之外。这个数表示拟合程度,机制是否如此还要另做检验。
流动用的是 2019 年 5 月一个星期的公交地铁,并且做了对称和缓冲区分配。步行、骑行、驾车、网约车和 2022 年 11 月的实时出行都没有进入流量矩阵。非药物干预也没有作为变量进入模型,研究窗口中间又有防控措施调整。东城缺失,结果覆盖的是其余区里的城乡建设用地。0.64 km² 的格子会把小区内部的差异平均掉。作者写明,这套城乡梯度受疫情阶段、社会行为和防控政策影响,换一座城市或换一波疫情就可能不同;他们举出的美国研究里,另一波疫情中乡村县的负担高于城市县。
一句话总结
在 2022 年秋冬北京这套网格记录里,一个格子会不会进入高风险,更多由它自己的建筑肌理、居住功能和生活设施参与预测;高风险能持续多久,更多由它与其他高风险格子的相邻关系和公共交通联系参与预测。两套格局都叠在城乡梯度上,西城和海淀的较短天数说明,持续多久还会离开“越中心越久”的直觉。
核心来源
Lu Zhao、Xiaoxu Wu,Multi-level urban environments and population mobility shape urban epidemic dynamics: A study in Beijing,Sustainable Cities and Society,2026。DOI:10.1016/j.scs.2026.107394。高风险点位整理自 COVID-Risk-Region。2019 年 5 月北京公交地铁刷卡数据见 Liu(2022),ChinaGEOSS Data Sharing Network(https://www.noda.ac.cn/),doi:10.11878/db.202204.001857。人口为《北京人口普查年鉴 2020》。
Lu Zhao 的论文署名有两处:中山大学 School of Geospatial Engineering and Science,同时标注南方海洋科学与工程广东省实验室(珠海);以及北京师范大学地理科学学部遥感科学国家重点实验室。同一作者与 Xiaoxu Wu 等合作的 2024 年 Cities 论文,讨论的是散发疫情的传播格局和城市网络,与本文同属城市疫情的空间分析。
Xiaoxu Wu(吴晓旭)是本文通讯作者,署名单位为上述中山大学学院。学院网站现用中文名遥感科学与技术学院,页面邮箱与论文通讯作者一致;页面介绍其研究方向包括全球变化与人类健康,方法上使用遥感、GIS 和时空统计。本文致谢写明该项工作得到中山大学启动经费支持。两位作者声明没有已知的竞争性利益。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
6.6 天和 15.3 天的差距,有一部分可能写在解除规则的日历上。论文用来定义降级的通告日期是 11 月 11 日,而地点数的陡增要到 11 月 21 日才开始。若把格子分成 11 月 11 日之前转入高风险和之后转入高风险两组,再看 A’、B’ 的天数差是否还在,就可以检验持续天数里有多少是同一套 5 天时钟、有多少仍和 DRisk_Flow 一起变化。这个分组论文没有做。如果早期格子普遍更短,郊区行政中心较长的天数里,还要分开行政解除时钟和公共交通各自占多少。
2019 年客流用在 2022 年,还会在西城、海淀产生一个可检验的错位。作者猜测这两个区因校园和远程办公减少了长距离通勤,可模型里的长距离联系仍是 2019 年的刷卡。若海淀、西城那些 2019 年 DRisk_Flow 很高的格子,2022 年仍然落在 6.6 天一类,就说明旧的通勤网络高,并不等于这一波的实际暴露高。模型可能把“过去连得很紧、这一波却能把通勤停下来的地区”学成了另一种持续模式。要核验它,需要 2022 年 11 月的分区出行强度。
建筑离散度改变的速度是建房和拆迁,这一波暴发窗口只有 40 天。在 40 天的窗口里,它更适合用来排列检测和监视的优先区域。一个直接的反例是:密集乡村聚落可以因为离散度和居住用地进入中等暴发风险那一类,平均风险在论文里是 0.18;若公共交通联系很弱,持续天数仍可能靠近 6.6 天。论文没有把高离散度的乡村格子再按 DRisk_Flow 高低交叉列表。若交叉表里短天数的格子很多,本地肌理标出的是需要盯住的地方,流动标出的是可能拖久的地方。两套用途对应两种日程,贡献百分比本身还不是施工指令。