县界只是地图上的线,还是会让济南的日常出行变少?
论文名片|Jiajie Liu、Tao Liu、Guangzhong Cao,Examining inter-county border effects on daily population mobility in China’s metropolitan area: The case of Jinan,Cities,2026,178:107363。DOI:10.1016/j.cities.2026.107363。2025年8月17日收稿,2026年4月23日修回,2026年7月1日接受,2026年7月8日在线发表。这是济南都市圈的个案:用两天网约车网格流,在引力模型上用倾向得分匹配估计县级行政区边界的影响。
济南都市圈按区县划定,规划要做的却是让中心城和周围连成一片。设想两对 1 公里网格,直线距离都在数公里,常住人口也接近。一对留在同一个区县,另一对跨过区界。若叫车只看远近和目的地规模,跨县不该让流量系统地变少。
2019年8月5日和6日,论文统计的跨县移动占 39.8%,县内占 60.2%。文中的山东省对照是跨县 20.7%、县内 79.3%。把距离、人口、地形和交通对齐之后,跨县网格对的流量仍然平均大约少 4%到 5%。这个平均数盖不住区县之间的差别:有的边界像隔断,有的边界像接口。
先说结论
- 两天共 341,555 条网约车起讫记录。去掉网格内部行程后剩 337,119 次,汇成 84,905 条有流量的有向网格对。地图上是济南主中心,加上南边泰安、东边淄博两个次中心;外围的人流并不一律薄于近郊。
- 一对一匹配后,全部出行用 45,312 条网格对回归,跨县系数为 −0.045;早高峰 6:00–9:00 用 7,220 条,系数为 −0.053。因变量是流量的自然对数,两个系数大约相当于流量少 4.4% 和 5.2%。作者概括为平均大约少 5%。
- 25 个区县配对之后,全部出行有 11 对在 5% 水平上显著。最强的抑制是历城—长清,对数流量上的处理效应为 −0.466;槐荫—长清、张店—周村、泰山—岱岳则为正。早高峰只有市中—槐荫一对显著为负。
- 直线距离的对数弹性在全部出行样本中是 −0.591。距离翻倍大约对应流量少 34%,大于全区平均的县界系数。海拔、坡度和到主干路的距离也有独立系数,读的是这套网约车记录。
没有县界的平原,和被切开的中心城
都市圈在这里对应城市区域(city-region):中心城与腹地之间有通勤,也有产业、消费和公共服务的联系。中国的都市圈(metropolitan area,政策语境里常称 dushiquan)由县级单元拼成,规划范围往往和实际功能范围错开。县级政府的学校、医疗和其他公共资源,常常认本地居民身份。论文用一个假想例子说明负向边界:最好的综合医院在中心,行政区把中心切成两半,分属不同区的居民去这家医院的次数会下降。另一个假想例子在外围:离本县县城远的村子,可能去邻县办事。前一种边界被预期为负,后一种方向事先不确定。
边界效应(border effect)在这里指:一对地点分属不同县时,流量相对同县地点多出来或少掉的那一部分。它最初用于国家边界如何压低国际贸易,后来被用来看行政边界对迁移和日常移动的影响。既有引力模型常加一个跨界虚拟变量。那个系数告诉读者跨界和境内有差别,还没有把边界做成一次可对照的干预。本文要补的是两件事:全区平均的抑制有多大,以及这种差别是否随区县的位置改变。
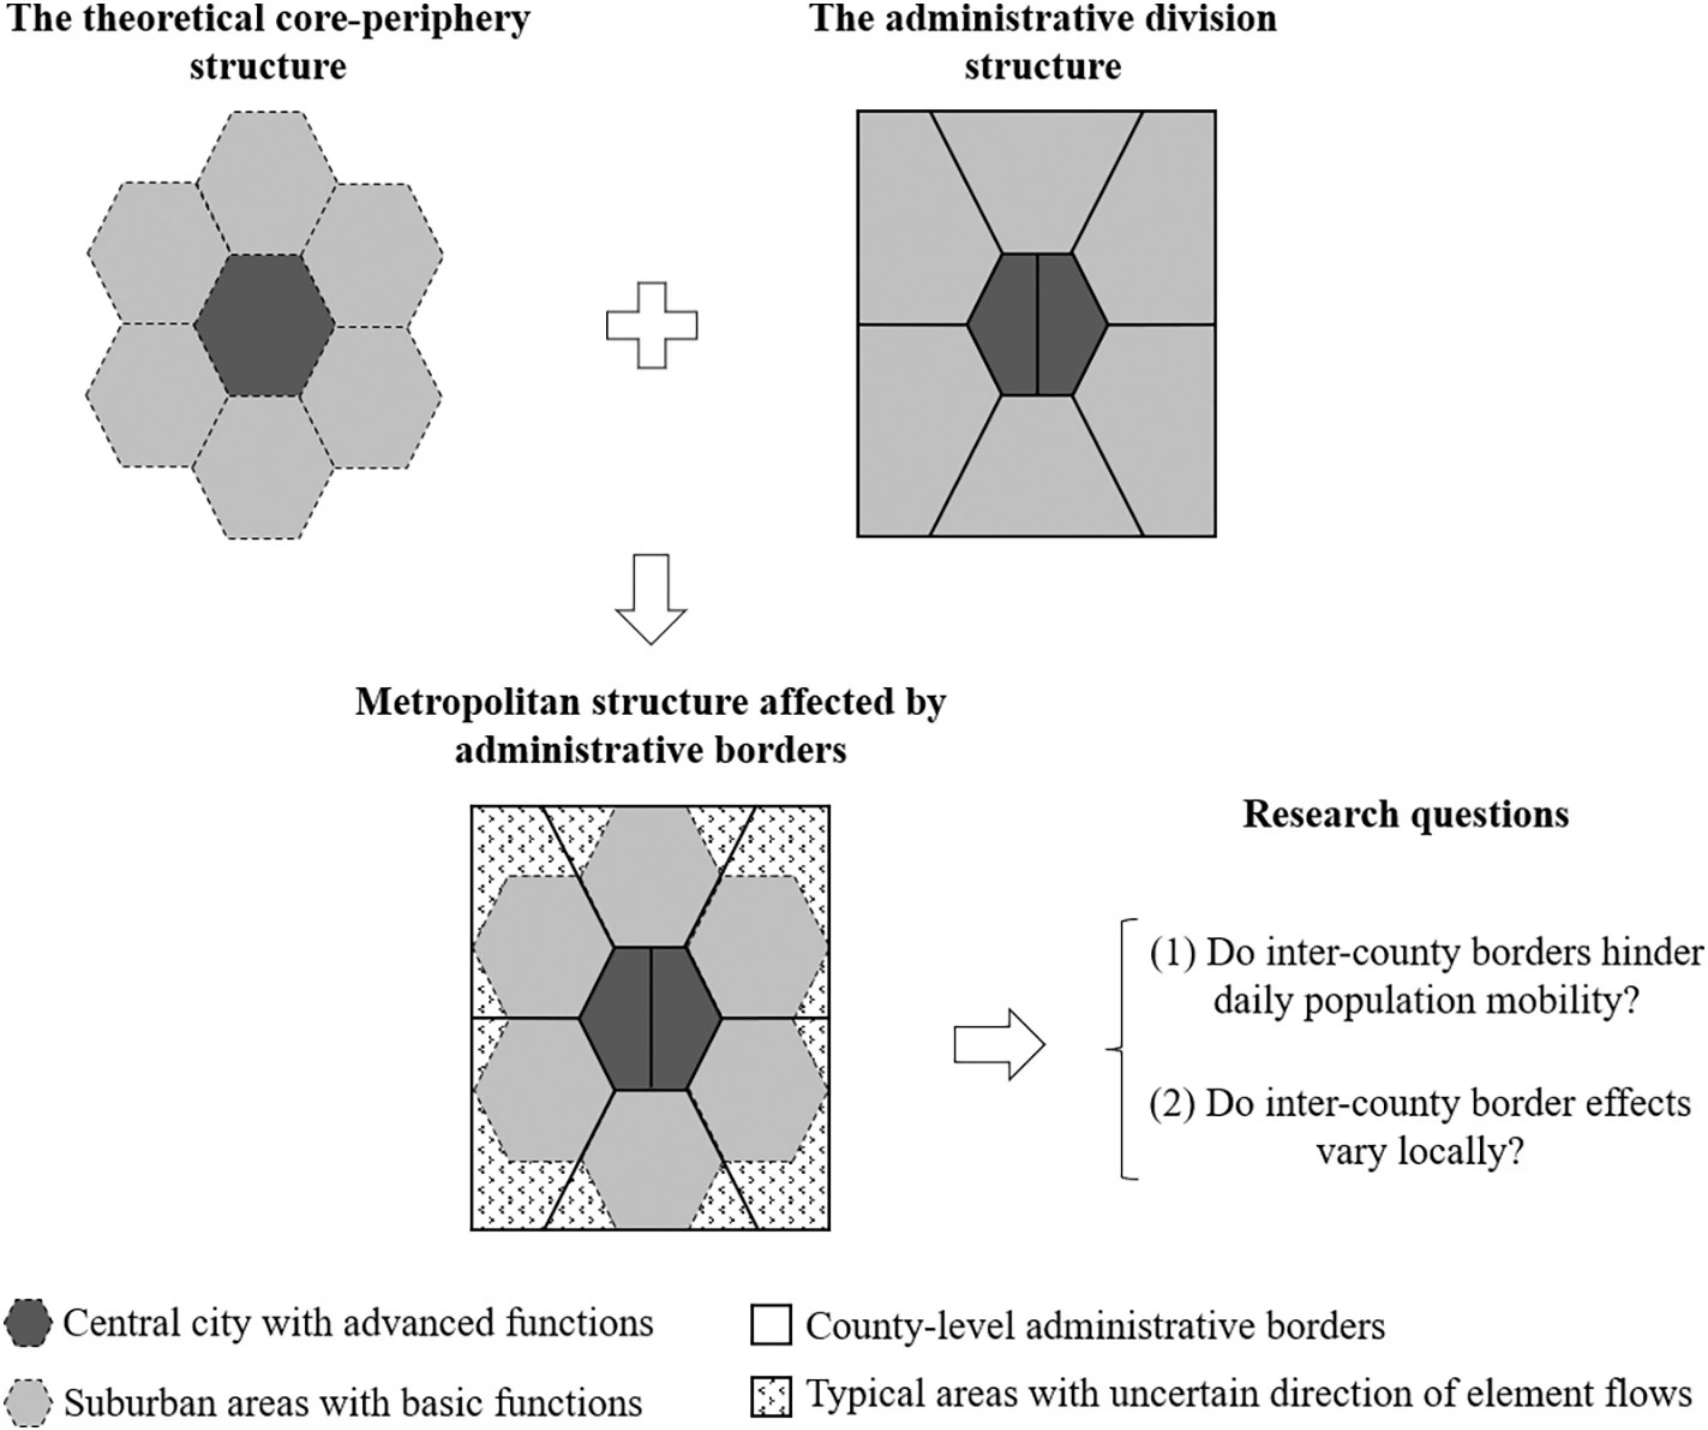
图 1|县界怎样改写核心—外围?
无字母子图。左上是没有行政区时的核心—外围:深色中心提供高等级功能,浅色外围提供日常功能。右上把同一片中心切进县级边界。下方把两种结构叠在一起,斜线格表示要素流向不确定的地区。右侧两个问题是后文要检验的:县际边界是否抑制日常人口移动,以及这种效应是否因地而异。医院和邻县办事是示意图中的机制设想,图本身没有数据。来源:原论文 Fig. 1。
25 个区县分属哪一圈?
研究区来自山东省提出、国家发展改革委批复的《济南都市圈发展规划(2024–2030)》。规划范围约 22,300 平方公里,2022 年常住人口约 1,810 万,地区生产总值 1.88 万亿元。范围含 25 个县级单元:12 个在济南市,13 个在相邻地级市。
论文把它们分成三圈。中心城是四个城市化程度高的市辖区,接近济南城区,远小于济南市的行政范围。近郊是济南市域内、中心城以外的 8 个区县。外围是相邻地级市的 13 个区县。
中心城:历下 C1、市中 C2、槐荫 C3、天桥 C4。近郊:历城 S1、长清 S2、章丘 S3、济阳 S4、莱芜 S5、钢城 S6、平阴 S7、商河 S8。外围:淄川 P1、张店 P2、临淄 P3、周村 P4,泰山 P5、岱岳 P6、肥城 P7,临邑 P8、齐河 P9、禹城 P10,茌平 P11、东阿 P12,邹平 P13。临邑属于德州,图例英文写作 Linyi County。
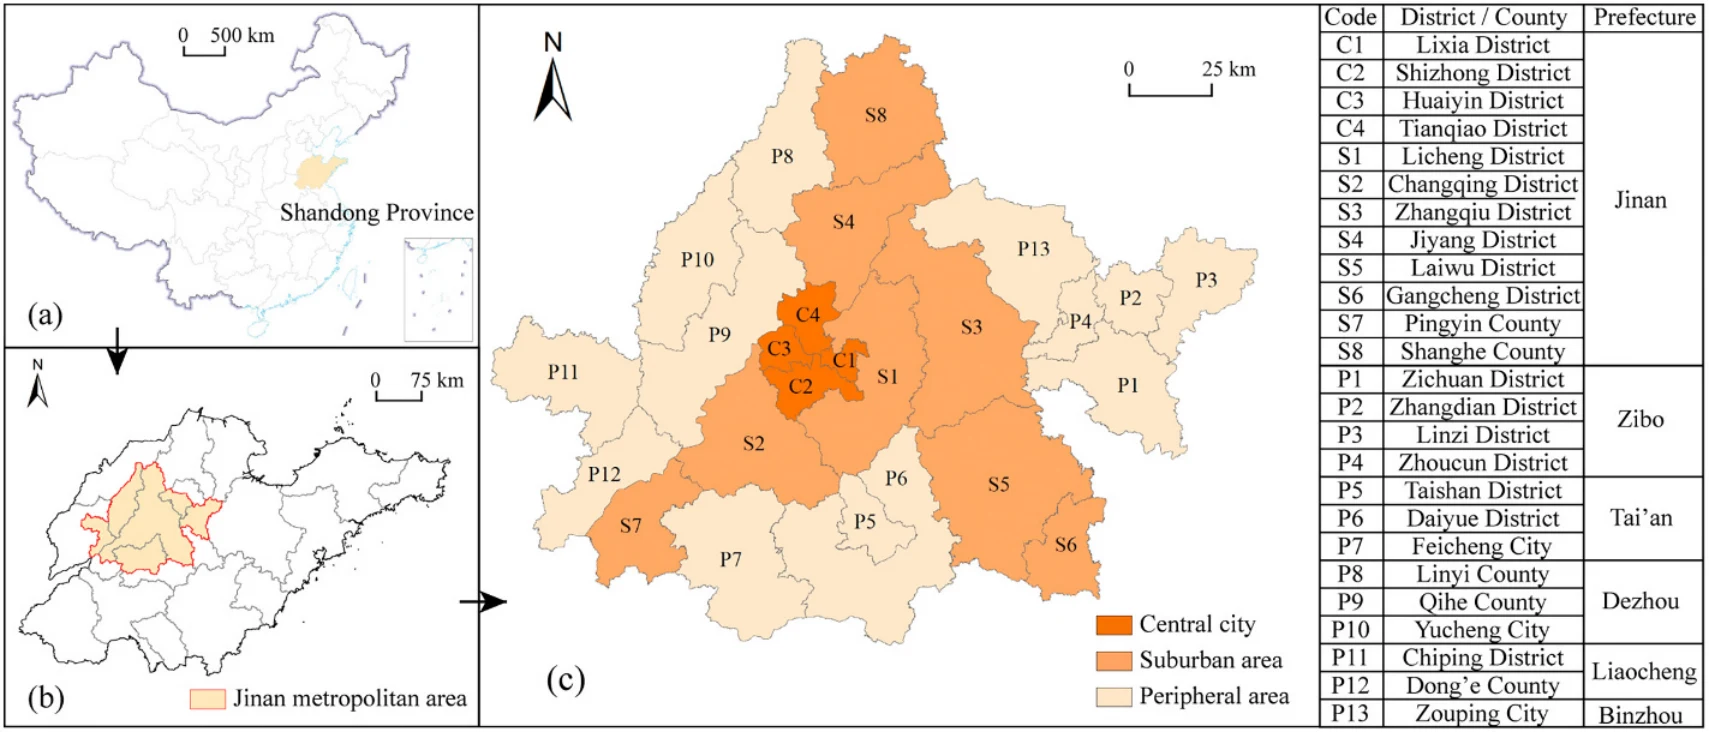
图 2|这 25 个县级单元怎样编码?
(a)山东省在全国的位置,比例尺 0–500 公里。(b)都市圈在山东省的范围,比例尺 0–75 公里。(c)三圈着色:深橙是中心城,浅橙是近郊,米色是外围,比例尺 0–25 公里;右侧表把编码对应到区和所属地级市。这张图只定义研究区,颜色不表示出行强度。来源:原论文 Fig. 2。
选济南,是因为它同时有强政府规划、平原丘陵山地,以及较密的路网。南部山地和北部平原差别大,县界有可能沿着地形走。路网足以支撑网约车,观察到的流动才更能反映城与城之间的联系。
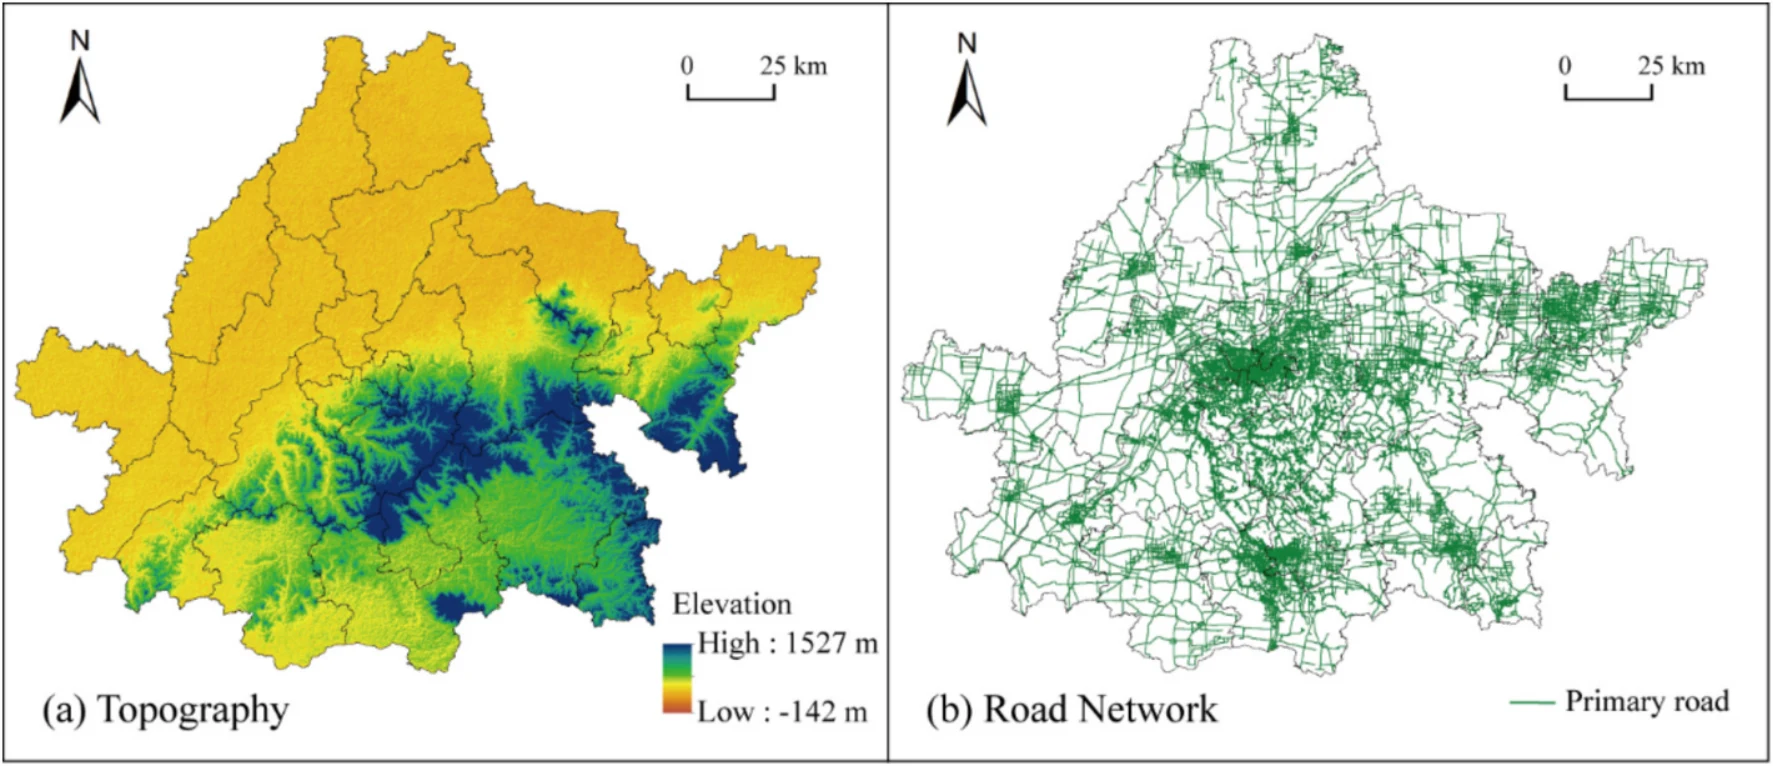
图 3|地形和主干路长什么样?
(a)海拔,色标从 −142 米到 1527 米,南部山地明显高于北部平原。(b)主要道路,绿色为高速和城市内外主干路。两幅比例尺都是 0–25 公里。后文把海拔、坡度和到主干路的距离放进对照,避免把山和路的影响算进县界。来源:原论文 Fig. 3。
两天叫车,怎样变成一条网格流?
数据来自一家未点名的国内主要网约车平台,空间分辨率 1 平方公里。时间是 2019 年 8 月 5 日和 6 日,共 48 小时,原始起讫记录 341,555 条。这两天处于学校暑假。论文认为上学行程的规模小于通勤、商务和休闲,因此总体空间形态不会被暑假明显改写;这个判断引用了其他研究,本文没有用学期数据做对照。
同一网格内部的行程被删除,因为极短距离的网约车很特殊。341,555 减 337,119,删去 4,436 条,保留 337,119 次跨网格行程。再按有向网格对加总,得到 84,905 条至少有 1 次行程的观测。算术平均每对 337,119 / 84,905 = 3.97 次。表 1 的因变量均值是对数流量 0.72,还原大约 2.05 次;它低于算术平均,因为少数网格对的单量很高。早高峰 6:00–9:00 另聚合为 23,823 条有向网格流。这三小时的原始行程条数,正文没有单列。
因此,回归解释的是已经出现的网格对有多大流量。若县界让一些网格对根本没有订单,那部分不会进入 84,905,也不会进入后面的系数。
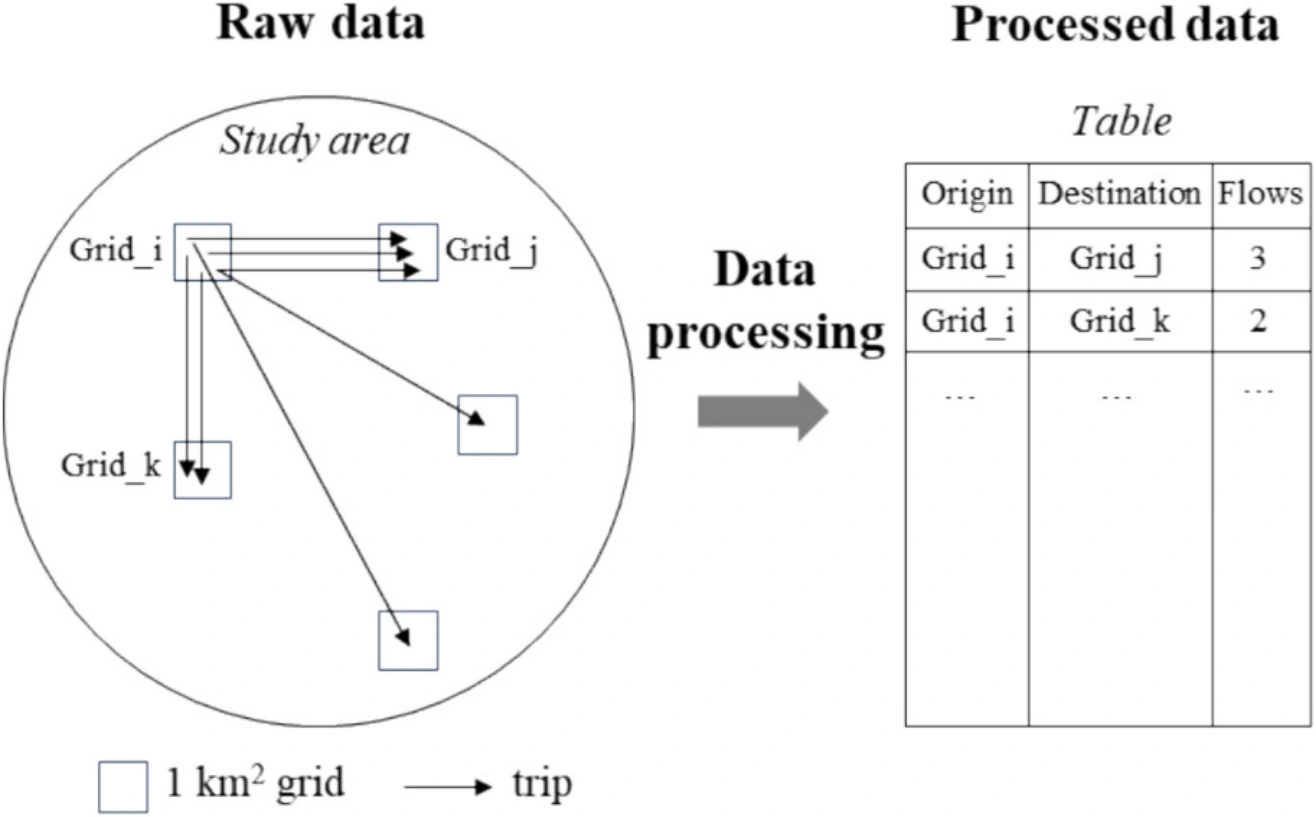
图 4|一次叫车怎样进入样本?
无字母子图。左侧圆是研究区,方块是 1 平方公里网格,箭头是行程。右侧把同一对网格上的行程加总成流量。表中的 3 和 2 是加工示意,不是济南的实测值。网格内部行程不在这张表里。来源:原论文 Fig. 4。
对照变量都落到 1 平方公里网格。直线距离用 ArcGIS 10.8 按地理距离计算,进入回归时取米的对数。人口来自 2020 年全国人口普查的网格估计,比出行晚大约一年。海拔和坡度来自地理空间数据云,道路来自 OpenStreetMap 的高速和主干路,交通设施兴趣点来自高德地图。全部自变量的方差膨胀因子低于 10,论文据此认为没有严重的多重共线性。
表 1 把这些变量取对数或保留原单位后描述。全部出行样本里,跨县虚拟变量均值 0.43,也就是 84,905 条网格对中约 43% 跨县;早高峰这一均值是 0.39,分母是 23,823 条。距离的对数均值分别为 8.86 和 8.65,还原后大约是 7.0 公里和 5.7 公里,属于对数意义上的典型距离。起点海拔均值约 73 米,统计的是有网约车的网格对;图 3 的色标则覆盖到 1527 米。
正文的 39.8% 与表 1 的 0.43 不宜当成同一个数。39.8% 和 60.2% 是论文所称的跨县、县内移动比例;0.43 是 84,905 条有流量网格对里跨县对的比例。论文没有写出 39.8% 的逐笔计算。全省 20.7% 也没有说明是否来自同一平台、同样两天,这里只按论文给出的对照阅读。早高峰正文另写大约 60% 的通勤行程在县内、40% 跨县;表 1 的对应均值是 0.39,分母是 23,823 条早高峰网格流。
线密集的地方,并不只有市中心
全部出行和早高峰都呈核心—外围,而且在都市圈、地级市、县三级都能看见。都市圈尺度上,四个中心区的流量最高,南边泰安城区、东边淄博城区形成两个次中心。因为有次中心,外围的强度可以高于一部分近郊,从中心城到外围可以呈高—低—高。
济南市内部,四个中心区之间联系多,其他区与中心区仍有联系,更远的县则相对独立。县内则是城镇多、乡村少。论文把乡村线条稀少和农村居民较少使用网约车联系起来,并认为这套数据更适合看城与城、城内的关系。
早高峰比全天更贴产业和人口分布。章丘(S3)与中心城的通勤联系强,论文将其近期的先进制造和新能源装备作为就业次中心的背景。南部外围的岱岳(P6)与周围也有较多通勤,论文提到产业园区和旅游度假区提供了就业。这些是作者对地图的功能解释,回归并没有放入行业或园区变量。
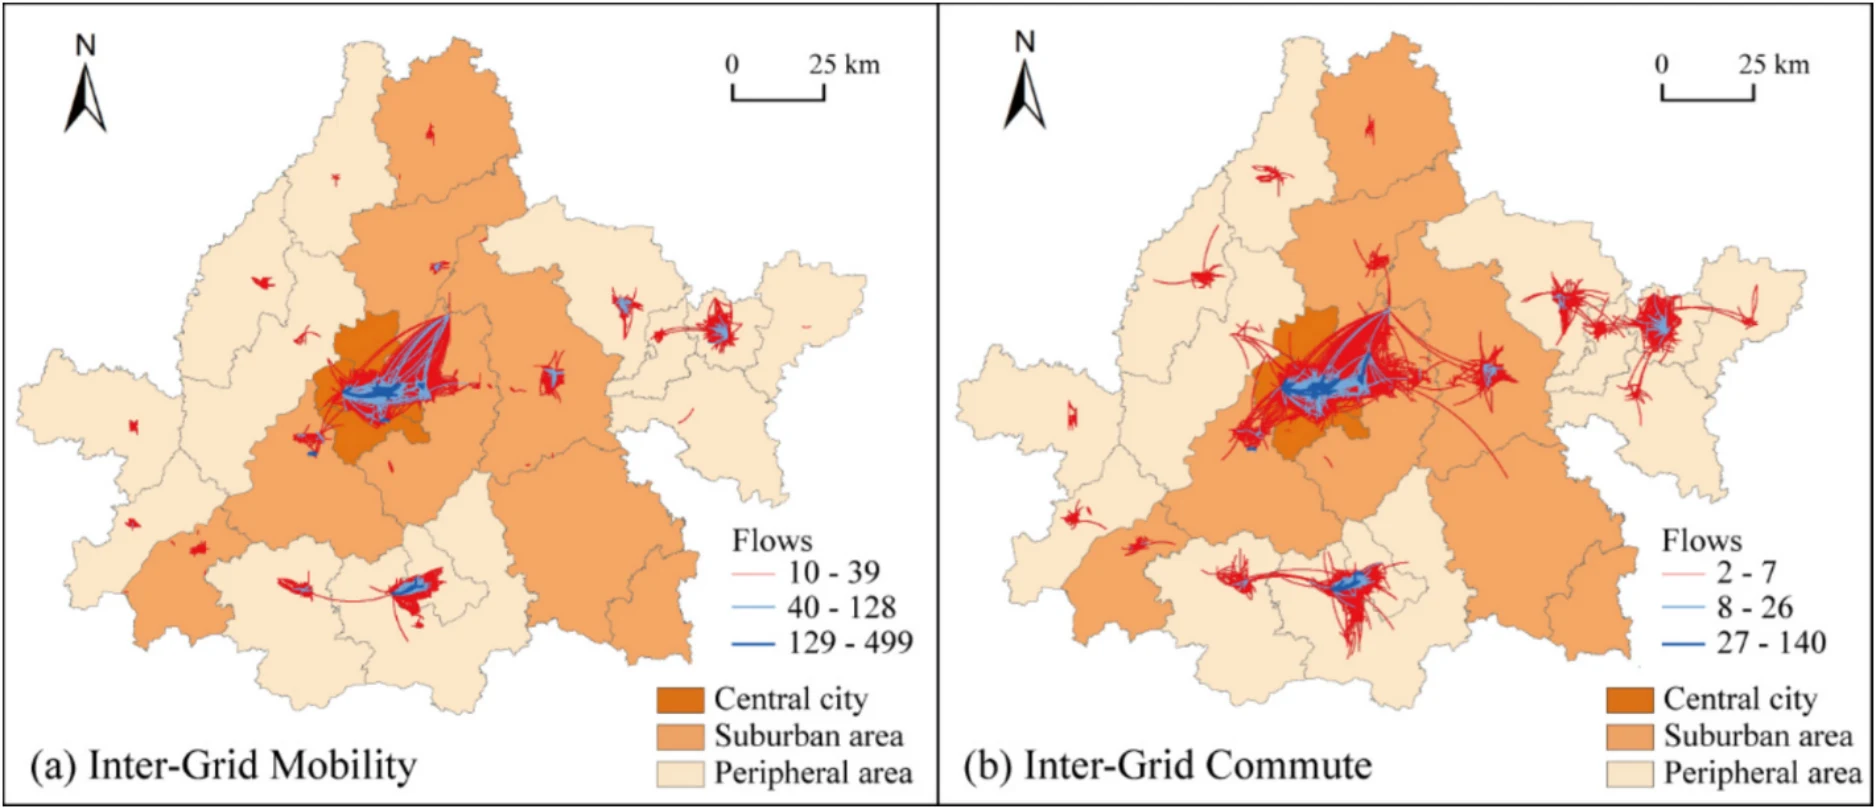
图 5|较大的网约车流量集中在哪里?
曲线按顺时针从起点画到终点,底色仍是三圈。自然断点只画出较大流量,更小的网格对没有画成线。
(a)全部跨网格出行:浅红 10–39,浅蓝 40–128,深蓝 129–499。最密的线在四个中心区内部和彼此之间,向东连到章丘、淄博,向南连到泰安。(b)6:00–9:00:浅红 2–7,浅蓝 8–26,深蓝 27–140。高流量更集中在中心城、章丘以及泰安、淄博城区。线条疏密是网约车大流量的形态;低于图例下限的网格对没有画出来。来源:原论文 Fig. 5。
对齐之后,平均少的是哪一个 5%?
基本式是对数引力模型。网格对流量的对数,等于常数,加上是否跨县,加上距离、两端人口、海拔、坡度、到主干路的距离和交通设施数量,再加上起点县、终点县的固定效应和残差。方程文字把固定效应写成每个起点和终点,表 2 实际放入的是县。人口和海拔这些网格属性仍留在方程中。若每个 1 公里网格都有自己的固定效应,这些属性会被吸收。读数以表 2 为准:控制的是县均值和网格协变量。
这个跨县系数仍是条件差异。论文把分属不同县记为处理组,同县记为对照组,用两端的局部特征做 logit,得到跨县倾向得分,再做一对一、不放回的最近邻匹配,并修剪样本。匹配后的全部出行样本是 45,312 条,早高峰是 7,220 条。全区结果是在匹配样本上重新回归的系数。区县对结果是处理组平均处理效应(ATT)。方法段有一句写边界效应是 ATT 的相反数;表 3 注明所报数值就是 ATT,正文把负号解释为流量更少。下文按表格和结果段阅读,不再把符号反转。
下表只摘跨县系数、距离弹性和匹配后的样本量。人口、地形、道路和交通设施的系数在表后说明;两个模型都包含起点县和终点县固定效应。
| 模型 1:全部出行 | 模型 2:早高峰 | |
|---|---|---|
| 跨县系数(标准误) | −0.045(0.008) | −0.053(0.015) |
| 距离的对数弹性 | −0.591(0.004) | −0.397(0.008) |
| 匹配后样本量 | 45,312 | 7,220 |
| 调整后 R² | 0.664 | 0.689 |
两个跨县系数都在 1% 水平显著。因为因变量是自然对数,−0.045 表示可比的跨县流量约为县内的 e^(−0.045) = 0.956 倍,即少 4.4%;−0.053 约为少 5.2%。作者在结果和结论里都写成平均大约减少 5%,并认为通勤受到的影响更大。两点估计确实是早高峰更负,但 −0.045 的标准误是 0.008,−0.053 的标准误是 0.015,区间重叠很多。论文没有检验两个系数之差。
距离弹性说明,直线距离增加 1%,全部出行流量约减少 0.591%。距离翻倍约减少 ln(2) × 0.591 = 0.410 个对数点,流量大约少 34%。全区县界的 −0.045 比这段距离衰减小。0.664 和 0.689 是县固定效应与全部控制变量一起的拟合,县界只是其中一项很小的系数。
其他系数里有几处不能读成“人更愿意去”。全天样本中,起点人口弹性 0.136,终点 0.079;早高峰终点人口弹性转为 −0.030。常住人口衡量居住规模,早高峰的目的地更多对应就业。论文没有单独解释这个符号变化。全天起点和终点海拔都是每米 −0.001,100 米大约对应流量少 9.5%;早高峰起点海拔系数转为 +0.001,在 5% 水平显著。全天坡度系数为正,起点 0.017、终点 0.024;早高峰起点坡度为 0.001,标准误 0.004。全天到主干路的对数距离为正,起点 0.008、终点 0.010,作者据此说离主干路越远,网约车越多。早高峰起点这一项转为 −0.005,只在 10% 水平显著。终点交通设施的对数弹性在全天达到 0.353,是控制变量里最大的正系数。这些系数都附在网约车流量上。离主干路更远而网约车更多,可以来自公交不便时的方式替代,不能推出全部出行方式都变多。
哪几对区县是隔断,哪几对是接口?
25 个区县继续两两估计。有些对的跨县样本太小,论文没有给出可估计对的总数,只报告全部出行里 11 对在 5% 水平显著的 ATT。早高峰只有市中—槐荫显著为负,表中用 △ 标出,没有给出这对在早高峰的具体数值。
| 区县对 | 对数流量上的 ATT |
|---|---|
| 历下—市中 C1–C2 | −0.118 |
| 历下—槐荫 C1–C3 | −0.329 |
| 市中—槐荫 C2–C3 △ | −0.137 |
| 槐荫—天桥 C3–C4 | −0.087 |
| 历城—长清 S1–S2 | −0.466 |
| 平阴—东阿 S7–P12 | −0.414 |
| 周村—邹平 P4–P13 | −0.116 |
| 槐荫—长清 C3–S2 | 0.097 |
| 淄川—周村 P1–P4 | 0.085 |
| 张店—周村 P2–P4 | 0.049 |
| 泰山—岱岳 P5–P6 | 0.101 |
四个中心区之间,进入显著列表的是上面四对,方向都为负。历下—天桥、市中—天桥没有出现。论文的概括是:一个本应服务整个都市圈的功能中心,被行政区切成几块,各区目前主要服务本区居民。四对负号支持中心区之间存在抑制;没有列出的两对,正文没有说明是样本不足、估计后不显著,还是没有估计。
近郊远郊也有很负的对。历城和长清的主要联系都指向中心城,彼此的 ATT 为 −0.466,约相当于流量少 37%。平阴主要连济南中心,东阿的功能指向聊城中心,二者分属济南和聊城,ATT 为 −0.414,约少 34%。周村与邹平分属淄博和滨州,ATT 为 −0.116。论文用这些对说明,地级市边界也会叠在县界上。37% 和 34% 是 e^(ATT) − 1 的换算,表 3 印出的是对数点上的 ATT。
正向的四对方向相反。槐荫—长清为 0.097,约多 10%。淄川—周村、张店—周村、泰山—岱岳约为多 8.9%、5.0% 和 10.6%。论文的解释是:有人住在本县中心够不着的边界附近时,邻县成为获取服务的目的地,行政边界这时会把目的地变多,而不是变少。
讨论把具体制度配到了其中几对,但这些制度没有进入回归。中心四区的负向效应,被联系到各区小学入学同时要求本地户口和本地住房;北京各区住房与入学政策被当作更明显的旁例,来自其他文献。槐荫与长清的正向效应,被联系到济南西站附近的西部新城。淄博一侧,论文提到 2001 年以来张店与周村交界的淄博新区,以及后来的张店—周村一体化发展区。泰山与岱岳的正号,和讨论中“中等地级市的市辖区可能更接近单中心”同向,图上没有单独证明这对区县的机制。
这些正负号放在一起,比中心地理论的单一层级更杂。层级模型期待每个地方主要连向更高一级的中心。这里的估计显示,近郊县之间可以很弱,相邻县也可以形成一组联系。论文把这种形态称为行政边界塑造的网络,而不是单纯的核心—外围。证据等级仍是匹配之后的流量差:它支持“在观测到的协变量相近时,这对区县的跨界流量更高或更低”,还没有测到人因为某项政策改变了目的地。
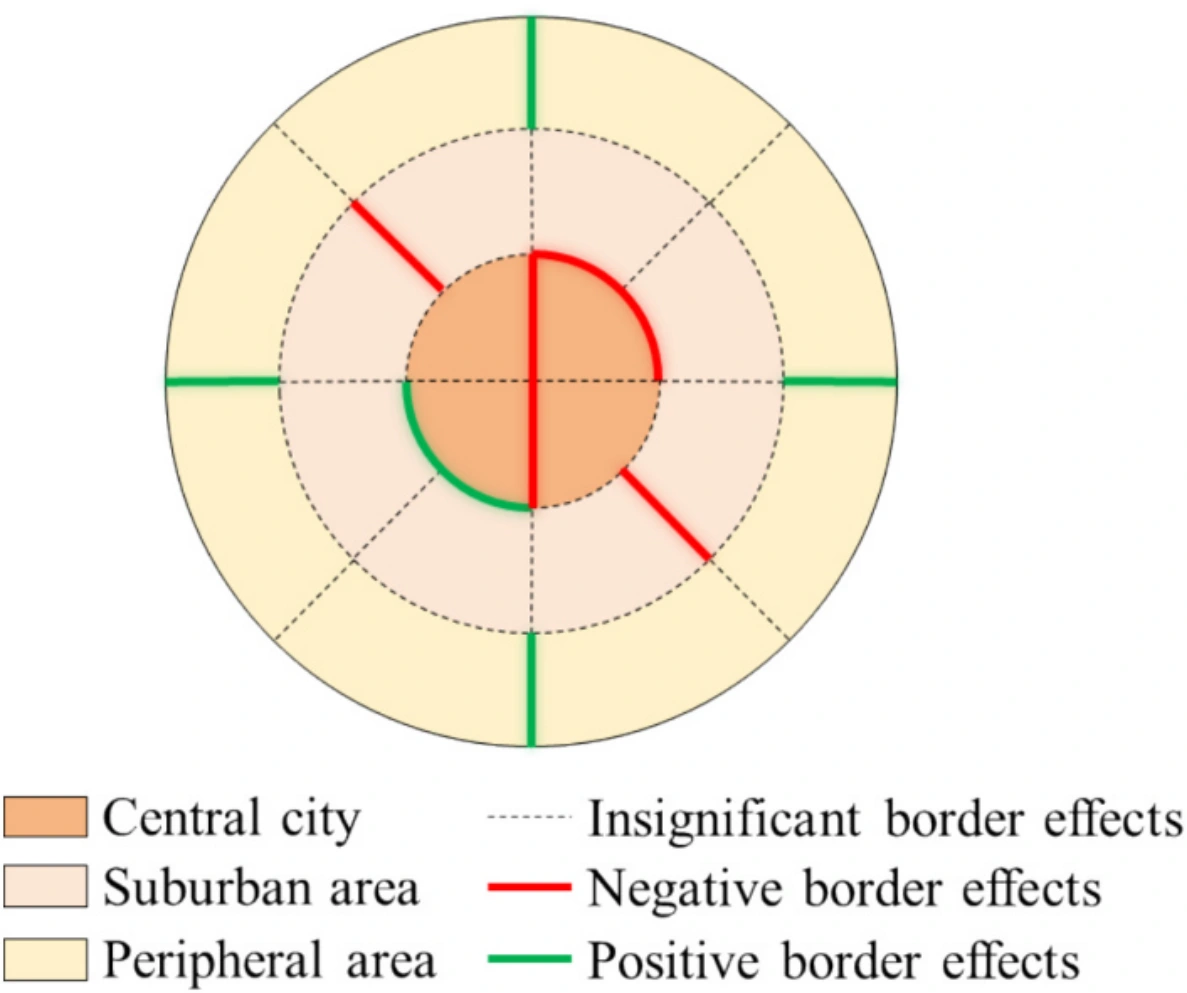
图 6|三圈边界在假想平原上如何分工?
无字母子图,也没有济南的区县名。深橙、浅橙、米色仍是中心城、近郊、外围。红线是负向边界效应,绿线是正向,灰虚线是不显著。讨论用它归纳三种类型:中心城因负向边界形成碎片化的多中心,近郊的负向边界更像彼此不衔接的平行发展,外围的一部分边界表现为促进联系。线条位置是类型示意,不能按角度对回表 3 的 11 对区县。来源:原论文 Fig. 6。
作者据此提出分圈政策:中心区保持功能完整,同时做有选择的协作;近郊减少同质竞争,承接中心城溢出的功能;外围可以分别承担产业或居住。泰山和黄河被写成自然阻隔,前者影响泰安与济南,后者影响济南近郊与中心城。回归里与之对应的是海拔和坡度,没有山体或河流的单独变量。2019–2025 年国家已批复 19 个都市圈规划。跨县协调机构、分圈政策和都市圈快线,是这一案例引出的建议,本文没有评估这些政策实施后的流量变化。
这些数字停在哪一层?
匹配把跨县写成干预,依赖的条件是:在倾向得分使用的距离、人口、地形和交通上相近的网格对,是否跨县可以视为外生。土地用途、产业、房价和具体入学政策没有进入匹配。正文也没有匹配平衡表或共同支撑图。县固定效应吸收的是县的平均水平,剩下的 β 仍可能混有未观测的网格差异。
样本是一家平台的两天订单,而且只保留有流量的跨网格对。早高峰用钟点筛选,公交和轨道上的出行没有被计进行程。控制交通设施和到主干路的距离,只是在网约车方程里放入交通条件,不能把缺失的公交出行补回来。人口是 2020 年普查网格,行程在 2019 年 8 月。直线距离也不是通勤时间。
11 对显著结果不能外推到 25 个区县的全部组合。局部 ATT 没有报告标准误和每对样本量,−0.466 与 −0.087 的差别方向明确,精度无法从正文再核。济南同时有省会政府、山地和平原,论文希望它对其他都市圈有参考;外推仍要重新测量当地的边界、地形和出行方式。
一句话总结
对齐距离、人口、地形和交通之后,济南都市圈的县界仍使已观察到的跨县网约车流量平均大约少 5%;这是有订单的网格对上的条件差异,区县对之间可以从大约少三分之一转到大约多一成。
核心来源
- Cities 论文页,核对题目、作者、卷期和 DOI。正文为 Cities 178 (2026) 107363,正式版共图 1–6、表 1–3。
- 数据可用性说明写明作者无权共享数据。平台名称、早高峰的原始行程条数、匹配平衡和未显著的区县对,正文都没有给出。
- 曹广忠个人简历、刘涛个人简历,以及学院对刘嘉杰本科毕业去向的新闻,用于核对中文姓名、职务和研究方向。
作者介绍
三位作者都署名北京大学城市与环境学院、城市未来研究中心,以及自然资源部国土空间规划与开发保护重点实验室。
- Jiajie Liu(刘嘉杰):第一作者。学院新闻确认,他 2019 年本科毕业后进入曹广忠课题组攻读博士。本文承担概念、调查、方法、软件、形式分析、可视化和写作。
- Tao Liu(刘涛):通讯作者,邮箱 liutao@pku.edu.cn。学院简历载明其为研究员,研究方向包括人口迁移流动与城镇化、城市土地开发与空间规划。本文承担概念、方法、数据整理、基金、项目管理与监督。
- Guangzhong Cao(曹广忠):通讯作者,邮箱 caogzh@pku.edu.cn。学院简历载明其为教授,研究方向为城市地理与城乡规划、人口迁移与城镇化,并担任北京大学未来城市研究中心主任。本文承担监督、资源与基金。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
暑假这两天,可能恰好把中心区那个最像“入学规则”的机制测轻了。论文用其他活动规模更大,说明都市圈总体形态不会被暑假改写。讨论又把四个中心区的负号联系到小学入学要本地户口和本地住房。若这条制度解释成立,抑制应集中在学期内、带孩子的早高峰,并且主要出现在中心区对,而不是均匀地落在 25 个区县上。同一平台的 3 月或 10 月数据可以检验:全区系数仍接近 −0.05,而历下、市中、槐荫、天桥之间的 ATT 明显更负。
另一个可分开的量是出行方式。全天样本里,离主干路越远,网约车越多;交通节点上的单量也更大。4.4% 因此是网约车方程里的县界。若公交和轨道更多沿跨区走廊运行,同一对网格的全方式出行会比 4.4% 更接近 0。若公交线路本身停在区界,全方式的抑制会更大。把网约车、公交和轨道放进同一套匹配,才能判断现在这个 5% 是偏高还是偏低。
表 3 还会影响政策该覆盖多宽。四个中心区有六对组合,显著为负的是四对。图 6 已经为不显著的边界留了灰虚线,正文却没有给出其余区县对的估计。未列出的对若大多接近 0,需要单独处理的是历城—长清、平阴—东阿这样的强抑制,而不是一条都市圈平均线。它们若同样为负、只是样本不够,中心城的隔断就比现在这四对更完整。平均少 5%,和某一对少 37%,对应的协调范围并不一样。