只凭年龄、工作和同住的人,生成的一天能拿去算一座城市的车流吗?
论文名片|Xishun Liao、Qinhua Jiang、Brian Yueshuai He、Yifan Liu、Chenchen Kuai、Jiaqi Ma,Deep Activity Model: A Generative Deep Learning Approach for Human Mobility Pattern Synthesis,IEEE Transactions on Intelligent Transportation Systems,2026,27(6):6519–6536,2026年4月23日在线发表。DOI:10.1109/tits.2026.3678542。这是一项生成式方法研究:用家庭出行调查学习一天的活动链,再把活动分配到交通小区,并加载到路网仿真。
下面这个场面只用来进入问题,不是论文里的某一次真实规划会议。洛杉矶县要估计明天高速路上的车流,规划者手里有一批人的年龄、职业和家庭构成,却没有这些人的定位轨迹。传统的基于活动的模型(activity-based model,ABM)会为每个人编排一天的活动再推导出行,南加州既有实践要覆盖大约 2600 万人口,数据和标定都很重。许多深度学习模型则要求这个人已经有历史轨迹。Deep Activity 模型把问题收成:只读社会人口和家庭属性,写出一天的活动顺序,再把活动放进交通小区,这套合成需求能不能拿去算路网。
方向是:活动类型、起止时间和链长的总体分布可以写得很接近调查;地点一步的目标是各子区活动次数和距离、转角的统计形态,加载之后,合成需求与南加州政府协会(Southern California Association of Governments,SCAG)的活动模型在起讫格局和高速路车英里数上接近。这组接近发生在模型对模型之间。路面传感器被画出来供对照拥堵时段,方法说明里的走廊百分比误差并不是相对传感器计算的。
先说结论
- 在 2017 年全美家庭出行调查的 18,106 条测试活动链上,Deep Activity 的 Jensen–Shannon 散度(Jensen–Shannon divergence,JSD,0 表示两个分布相同)为链长 0.002、活动时长 0.002、开始时间 0.003、结束时间 0.003、活动类型 0.005。真实活动转移图里的边,它覆盖 92.2%。15 类活动本身,表中所有模型都达到 100% 的节点完整率。
- 同一张表里,LSTM 的活动类型散度是 0.003,转移概率矩阵差的 Frobenius 范数是 0.377,两项都低于 Deep Activity 的 0.005 和 0.643。边是否出现,与边上的概率是否接近,是两件分开的事。
- 去掉时间软标签后,边完整率从 92.2% 降到 65.6%,开始时间散度从 0.003 升到 0.039。允许相邻 15 分钟格子分担概率,对这批调查数据的时间分布影响最大。
- 微调之后,加州、普吉特湾和墨西哥城的边完整率分别是 83.6%、79.5% 和 63%。普吉特湾只用 7,791 条训练链,结束时间散度升到 0.051;墨西哥城开始时间散度是 0.056,活动分类也只有 10 类。
- 洛杉矶县用约 100 万名合成个体做规模测试时,活动地点分配与 SCAG 模型的起讫矩阵余弦相似度是 0.997,全高速路网小时车英里数的平均绝对百分比误差(mean absolute percentage error,MAPE)是 4.97%。I-405 上相对同一套 SCAG 需求的流量 MAPE 为北向 5.85、南向 9.32,速度 MAPE 为北向 4.45、南向 4.36。
要生成的是一天的活动顺序,不是下一次定位
人类移动性在这里被写成活动链:一个人按时间排列的活动。第 j 项活动有类型、开始时间和结束时间,再配上一个小区级地点,才成为轨迹。模型在生成时只接收这个人以及同住者的社会人口属性,不读取这个人过去的行程。训练阶段用的仍是真实调查日记,所以“生成时不看历史轨迹”不等于“模型从未见过别人的出行日记”。
数据是家庭出行调查(household travel survey,HTS),记录家庭成员、车辆和非商业出行。全美底模用 2017 年 National Household Travel Survey(NHTS),论文写明调查规模超过 129,600 户。活动按发生地点归成 15 类:家、工作、上学、照料、买商品、买服务、买餐、一般杂务、娱乐、锻炼、访友、医疗、宗教、其他,以及接送。在家办公并入家。图里的 EatOut、ChildCare、BuyGoods 等是这 15 类的短标签。
一天被切成 96 个 15 分钟格子,时间编码从 1 到 96。开始和结束因此都是 96 类分类,不是连续回归。空白或拒答的属性用一个虚拟编码填上。
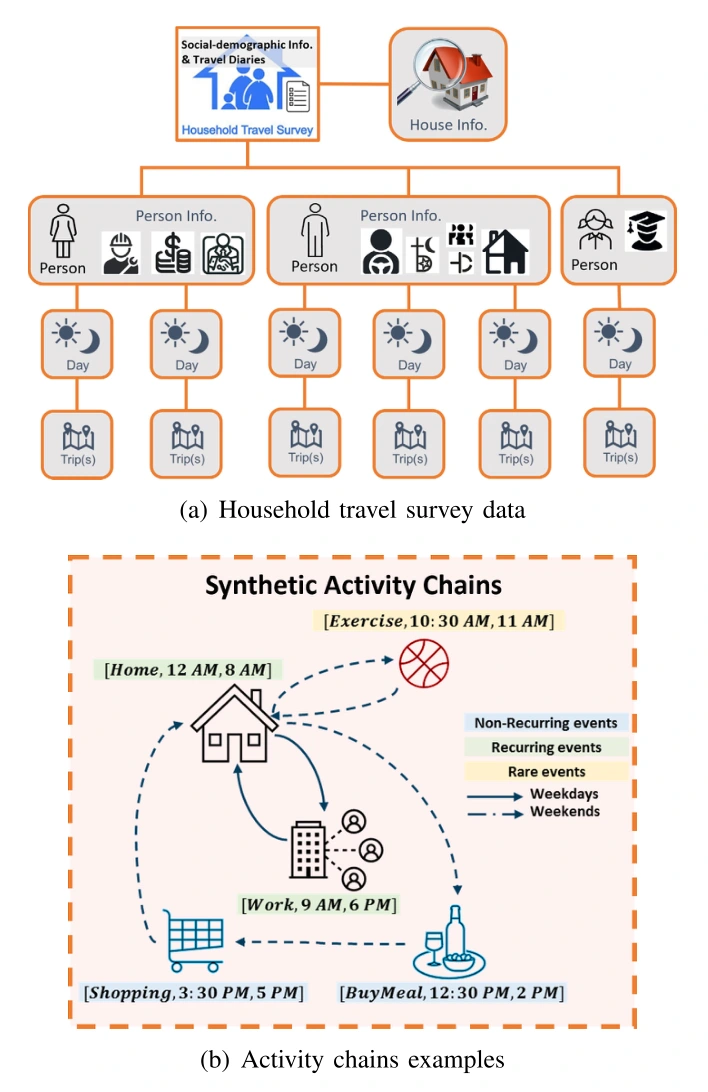
图 1|调查记录怎样变成一条可生成的活动链?
(a)一户调查向下展开为个人属性、出行日和行程,是模型的输入来源。(b)示意图里的家、工作、购物、买餐和锻炼标出起止时刻,实线表示工作日、虚线表示周末,颜色区分重复、偶发和少见事件。这些时刻是图中的例子,不是某个人的测量结果,也不能当成后文的误差。来源:原论文 Fig. 1。
区域数据与全美调查分开。2010–2012 年加州家庭出行调查来自 42,500 户;2017 年普吉特湾区域出行研究来自 3,285 户;2017 年墨西哥城都市区起讫调查来自 66,625 个住房单元。下面的训练、验证、测试数字是活动链条数,和户数不是同一个单位。一户可以贡献多名成员的日记,所以链条数可以多于户数。
| 数据 | 训练链 | 验证链 | 测试链 | 调查采集规模 |
|---|---|---|---|---|
| 2017 年 NHTS | 160,831 | 18,106 | 18,106 | 超过 129,600 户 |
| 加州,2010–2012 | 53,823 | 7,889 | 15,378 | 42,500 户 |
| 普吉特湾,2017 | 7,791 | 1,113 | 2,226 | 3,285 户 |
| 墨西哥城,2017 | 185,233 | 23,154 | 23,154 | 66,625 个住房单元 |
四套划分合计分别是 197,043、77,090、11,130 和 231,541 条活动链。加州的测试集 15,378 条大约是验证集的两倍,其他三套的验证和测试更接近。论文没有把户数逐户对应到这些链条,因此不能把 160,831 读成 160,831 户。
另有一套合成需求来自 SCAG 的活动模型,覆盖南加州六县、人口超过 1900 万,以 15 分钟记录一天的活动、起止和小区。作者从中称为 1000 万名个体的池子里抽样本:10 万用于把全美模型迁到当地并调节地点分配,约 100 万用于看放大之后还是否稳。洛杉矶县有 5,967 个交通分析小区(transportation analysis zone,TAZ)。这 100 万是抽样,不是六县全部人口,也不是路面计数。
模型同时读这个人、家里其他人,以及已经写好的前一项
26 项属性被写成 13 项个人属性和 13 项家庭共享属性。表中包括驾照、教育、性别、种族或族裔、家庭角色、年级、就业地点类型、工作数量、就业状态、工作日天数、职业、年龄、每周公交使用,以及收入、户规模、车辆、住房权属、学生数、生命周期、住宅类型、住房密度、人口密度和出租住房比例。它们的作用类似语言模型里的提示:先定下这个人是谁,再逐项往下写活动。
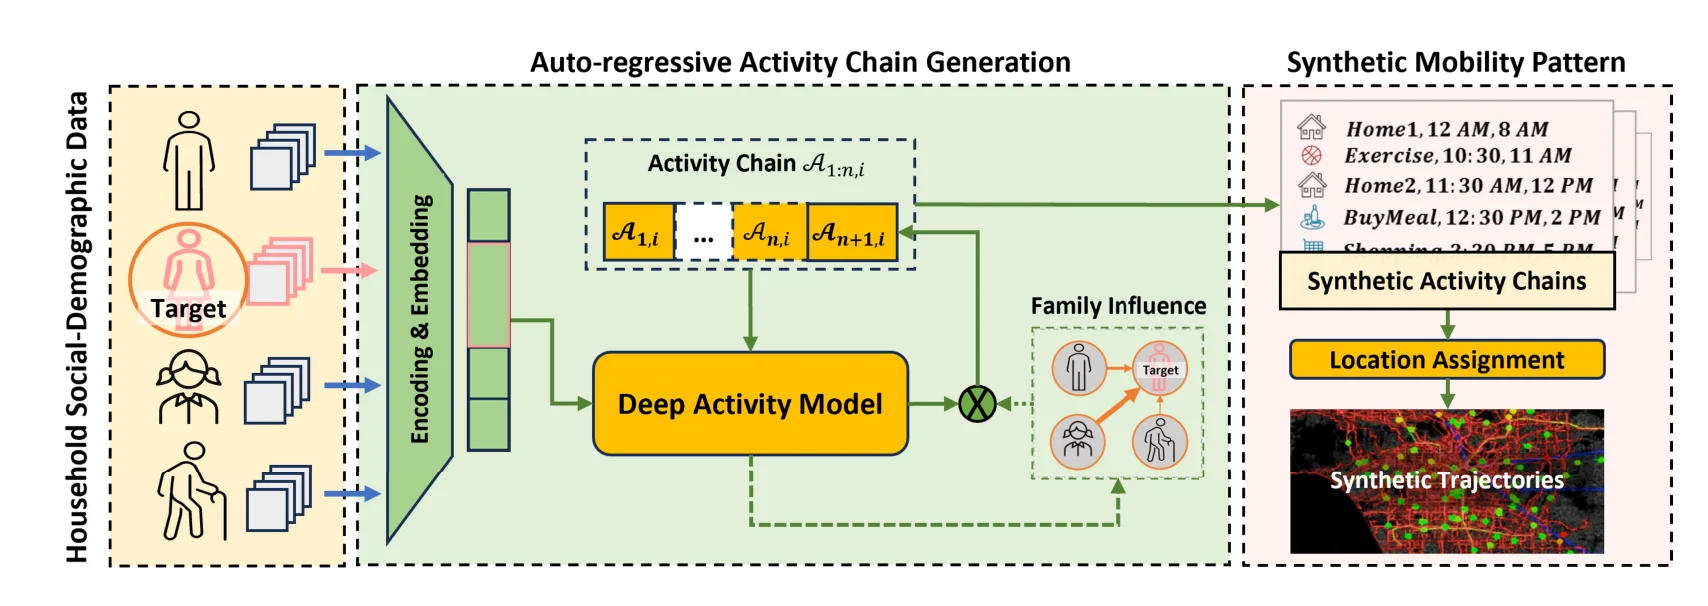
图 2|从家庭属性到路网上的轨迹,中间经过哪几步?
图中无字母子图。左侧是目标人和同住者的属性,中间用自回归方式一次写出下一项活动,并画有家庭影响;右侧先得到活动链,再做地点分配,最后画成轨迹。右侧小字里的时刻仍是流程示意。来源:原论文 Fig. 2。
网络是 Transformer 编码器—解码器。选择它,是因为下一项活动依赖前面的活动、时间和同住者,而不仅是上一个隐藏状态。编码器看个人、家庭和已有活动;解码器在因果掩码下从左到右预测,不能看见还没生成的后项。预测类型、开始和结束,直到出现结束符或达到最大长度。
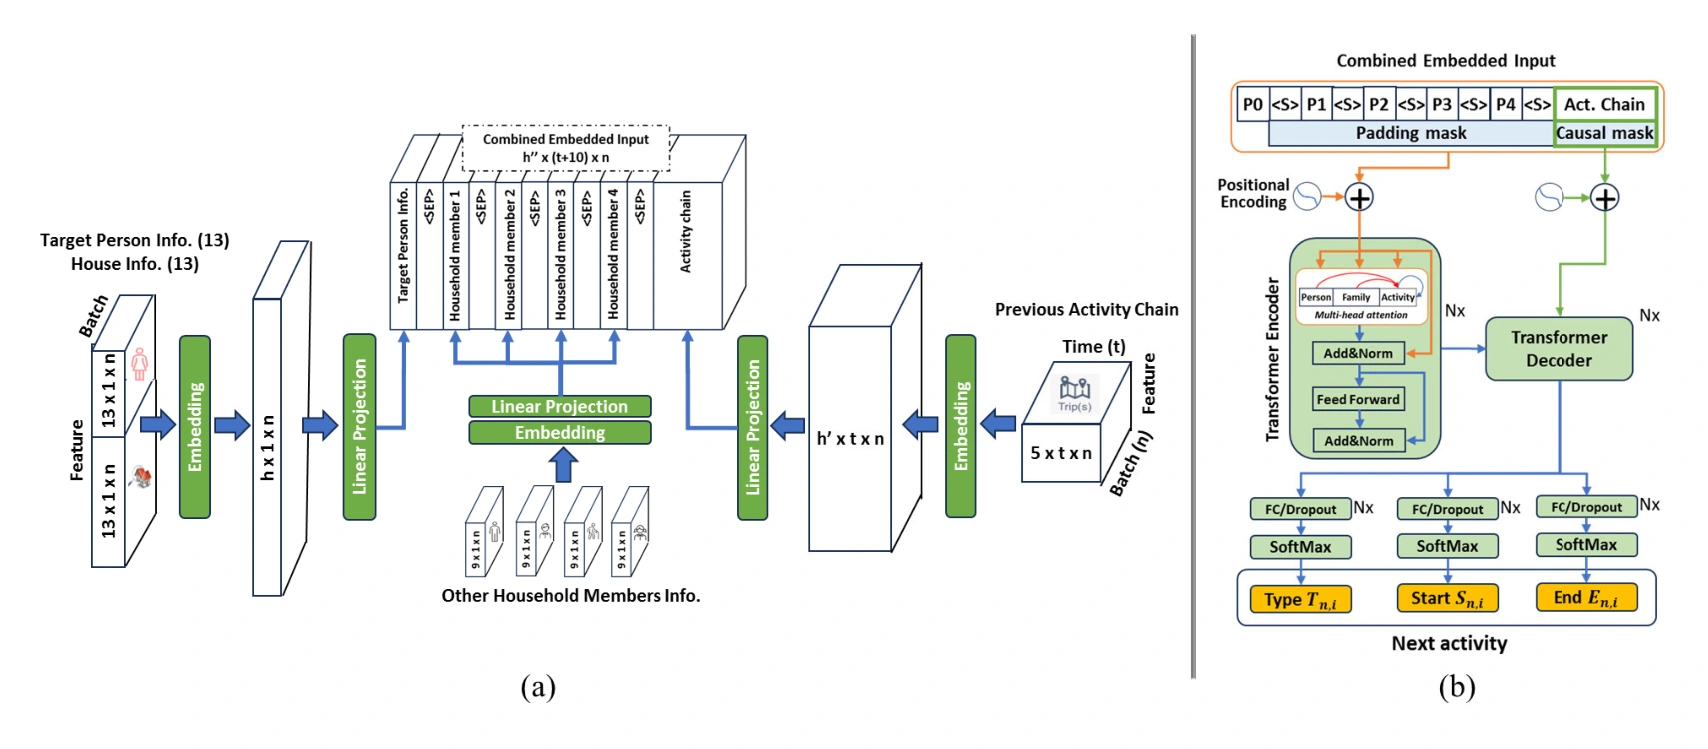
图 3|同住者的信息怎样进入下一项活动的预测?
(a)目标人 13 项与住房 13 项各自嵌入,其他成员的信息用分隔符隔开,再与已有活动链拼在一起。模型最多处理五名成员,因为 NHTS 中 95% 的家庭不超过这个规模。(b)编码器使用填充掩码,把不存在的成员和分隔符挡在注意力之外;解码器使用因果掩码。三个头分别输出下一项的类型、开始时间和结束时间。来源:原论文 Fig. 3。
墨西哥城一节写的是:当地调查只提供全美模型 60 项输入中的 40 项,活动类型也改成当地的 10 类。图 3 画的是单人 13+13。论文没有另给一张表,把 26 与 60 逐项对应起来。后文迁移时,墨西哥城会更换嵌入后的线性层和最后的 10 类分类头;加州和普吉特湾的属性编码与全美调查接近,沿用原来的编码器和解码器,只做冻结后再微调。
为什么不拿某一个人对没对上当成绩
生成的目标是一批新的、行为上说得通的人,把调查里的原日记逐条抄出来就失去了合成的意义。人的一天本身也有弹性。因此评价看的是总体分布:活动频率、开始、结束、每天活动个数、每项时长,再加上活动转移图是否缺类型、缺边,以及转移概率矩阵差多少。
JSD 比较的是生成分布 P 和调查分布 Q。先取二者的平均 M,再看 P、Q 各自离 M 有多远。它回答“两套比例像不像”,不回答“张三周二的第二项活动有没有被猜中”。边完整率的分母是真实活动转移图里出现过的“从一类活动到下一类”的边,论文没有给出这些边的绝对条数。Frobenius 范数把两张转移概率矩阵逐格相减、平方后求和再开方,数值低表示概率更接近。节点完整率看 15 类活动有没有都出现。
对比模型包括普通循环网络、GRU、LSTM、只有解码器的 Transformer,以及按先前检索增强做法调用的 GPT-4、LLaMA3.1-70B 和 DeepSeek-R1。大模型的温度和 top-p 都是 1.0,提示大约 700 个词元,生成的活动链平均大约 4 个词元。论文估计按当时速度,每 1,000 条链约 0.8 美元;GPT-4 与文中所写的 DeepSeek-V3 接口大约每条 0.5 秒,4 比特量化的 LLaMA3.1-70B 在 48GB 的 L40S 上大约每条 1 秒。速度这句使用的是 DeepSeek-V3 这个名字,模型名单里写的是 DeepSeek-R1,两处名称没有在文中对齐。
| 模型 | 链长 | 时长 | 开始 | 结束 | 类型 | 边完整率 | 转移差 |
|---|---|---|---|---|---|---|---|
| GRU | 0.015 | 0.032 | 0.085 | 0.217 | 0.013 | 51.6% | 0.934 |
| RNN | 0.064 | 0.029 | 0.067 | 0.121 | 0.024 | 50.9% | 1.291 |
| LSTM | 0.006 | 0.003 | 0.019 | 0.004 | 0.003 | 91.4% | 0.377 |
| 仅解码器 Transformer | 0.011 | 0.011 | 0.014 | 0.012 | 0.013 | 67.1% | 0.784 |
| GPT-4 | 0.011 | 0.018 | 0.064 | 0.074 | 0.009 | 42.4% | 1.111 |
| LLaMA3 | 0.011 | 0.023 | 0.090 | 0.081 | 0.024 | 45.9% | 1.203 |
| DeepSeek | 0.040 | 0.013 | 0.013 | 0.026 | 0.009 | 43.2% | 0.987 |
| Deep Activity | 0.002 | 0.002 | 0.003 | 0.003 | 0.005 | 92.2% | 0.643 |
除边完整率和转移差以外,表中数字都是 JSD,对照的是相应测试集上的活动链分布。Deep Activity 在链长、时长、开始和结束四列最低,边完整率最高。LSTM 在活动类型和转移差上更好。DeepSeek 的开始时间散度是 0.013、时长散度也是 0.013,结束时间是 0.026,链长散度 0.040,边完整率 43.2%。正文里“开始和结束都是 0.013”这句,和表中的结束时间不一致;读数以表为准。大模型输出平均只有大约 4 个词元,边完整率落在 42.4% 到 45.9%,说明短输出没有铺开调查里的转移种类。
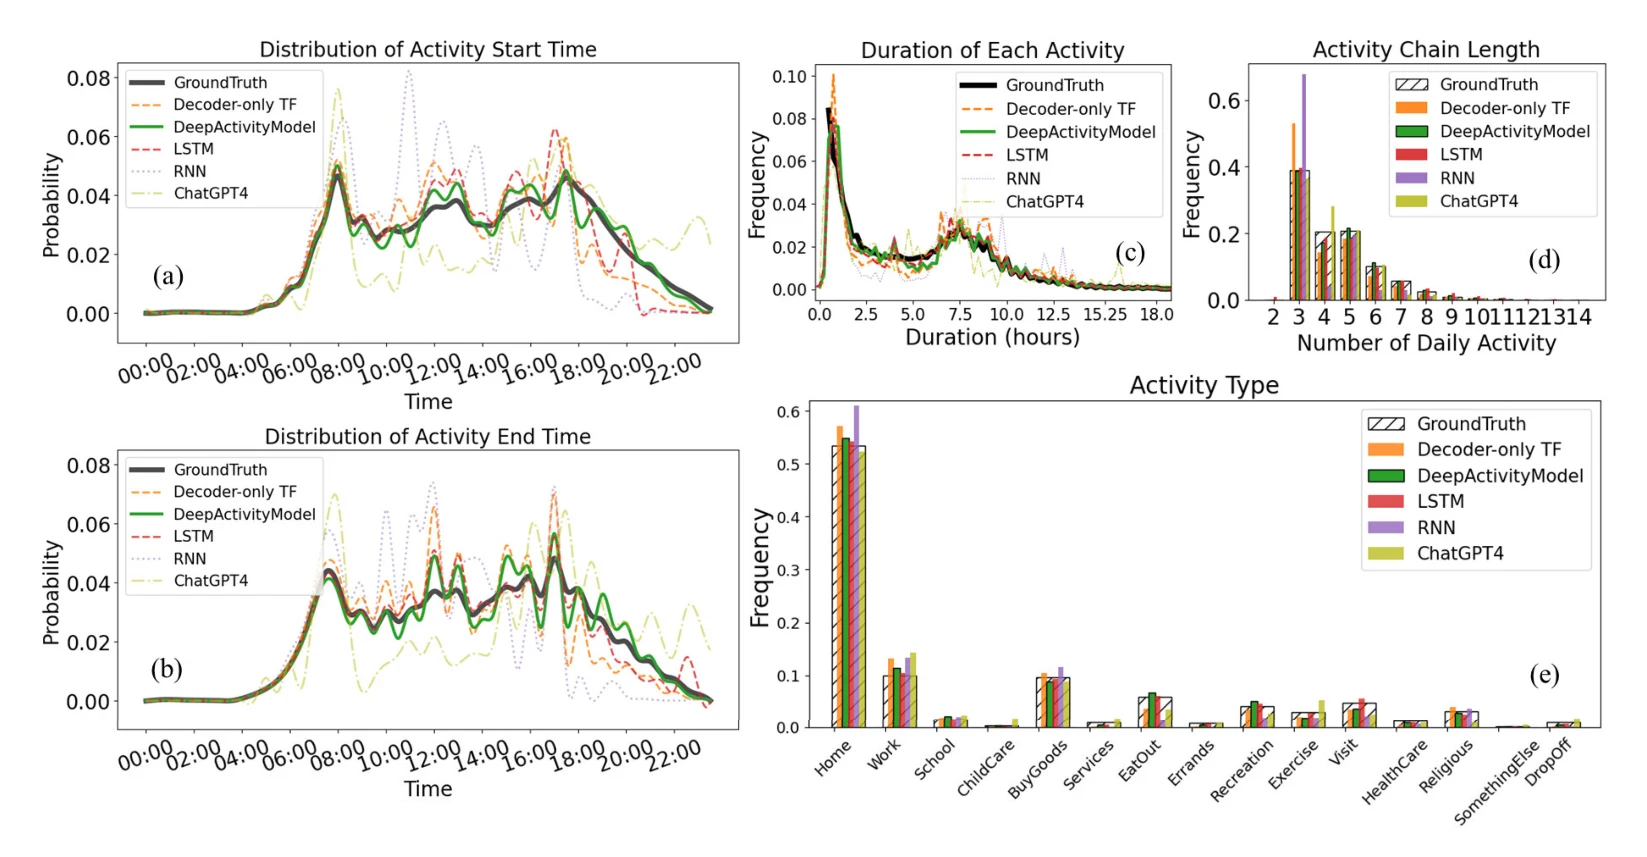
图 5|分布接近之后,一天里的哪一段仍对不齐?
图中保留调查真值、Deep Activity、仅解码器 Transformer、LSTM、RNN 和 ChatGPT4。GRU、LLaMA3 和 DeepSeek 出现在上表,没有画进这张图。(a)开始时间,横轴从 0 点到 22 点,纵轴为概率。各模型都有早高峰;LSTM 和仅解码器模型少估了傍晚,ChatGPT4 起伏更大。(b)结束时间。总体结束时间散度是 0.003,但 10 点到 15 点的结束被高估,这一段的散度大约 0.005,主要来自购物、用餐和办事这类非必要活动。上班和上学的规律更容易被跟上。(c)单次活动时长,单位是小时。短活动占最高的一档,Deep Activity 的绿线贴近真值。(d)每天活动个数。仅解码器模型把很多人写成 3 项;除 ChatGPT4 外,各模型都少估了 4 项的链。横轴画到 14,长链的比例已经很低。(e)15 类活动的频率,家最高,其次是工作。这张图支持“总体比例接近”,不支持“每一个人的下一项被点对”。来源:原论文 Fig. 5。
时间可以偏一刻钟,顺序不能反
活动类型用交叉熵。时间若也要求格子完全点中,8:00 和 8:15 会被当成两个互斥的类。软标签在真值格子上放较大权重,在左右若干个 15 分钟格子上放较小权重,再按这个软分布计算交叉熵。论文举例时把主权重写成 1.0、侧权重写成 0.1,没有给出最终使用的侧格数,也没有给出五项损失的权重数值。
另外两项惩罚看顺序。前一项的结束晚于后一项的开始,就产生跨活动顺序损失;同一项的开始晚于结束,就产生项内顺序损失。总损失是类型交叉熵、开始软标签、结束软标签和这两项惩罚的加权和。
去掉软标签后,七项指标一起变差:链长 0.025、时长 0.012、开始 0.039、结束 0.024、类型 0.018、边完整率 65.6%、转移差 0.907。去掉跨活动顺序惩罚,边完整率降到 68.5%,链长散度升到 0.024。去掉项内顺序惩罚,时长散度仍是 0.006,边完整率 72.6%,转移差升到 0.739。顺序惩罚更关系到链的结构和转移概率,软标签更关系到时间分布能不能容下人的弹性。五项一起用时,数字回到上表的 Deep Activity 一行。消融没有单独去掉活动类型的交叉熵。
工作日、周末和年龄,分布有没有分开
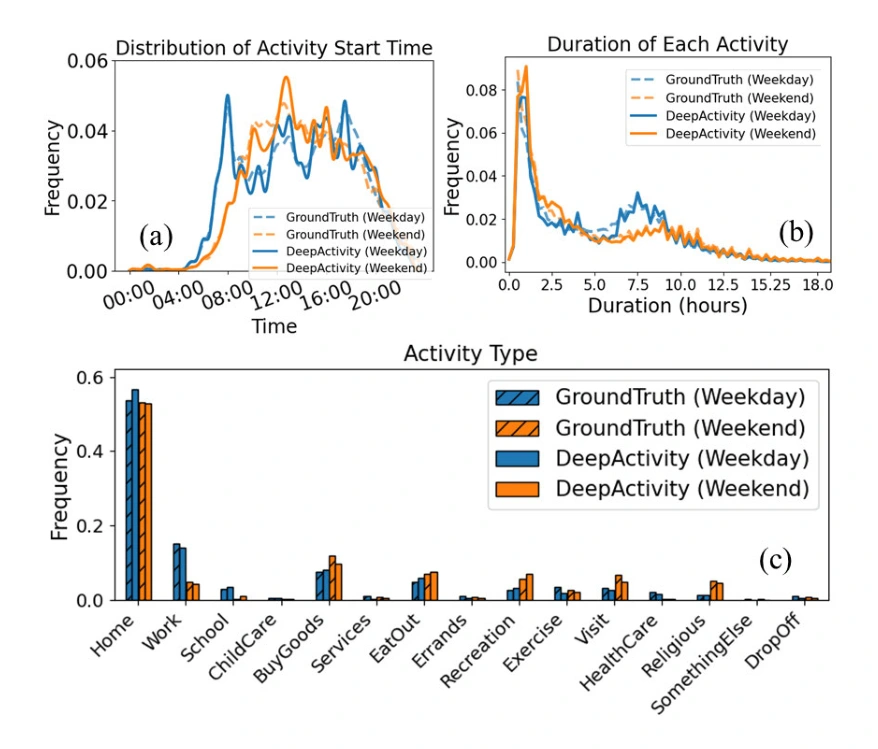
图 6|同一套模型能不能同时写出工作日和周末?
虚线或斜线为调查,实线或实心为模型;蓝是工作日,橙是周末。(a)周末的开始时间高峰比工作日更靠向中午。(b)时长。工作日在大约 7.5 小时附近更高,对应文中所说的工作时长;周末这条隆起更弱。短活动仍是最高的一档。(c)工作在工作日更高,外出就餐和拜访在周末更高,家在两天都超过一半的频率刻度。模型曲线跟着这些差别走。表 II 的 26 项里没有单独列出“今天是不是周末”,论文也没有说明这个差别由哪个输入字段打开。图 6 说明生成分布能分开两种日期,没有说明条件变量的具体编码。来源:原论文 Fig. 6。
年龄按 0–18 岁、19–65 岁和 65 岁以上分开。
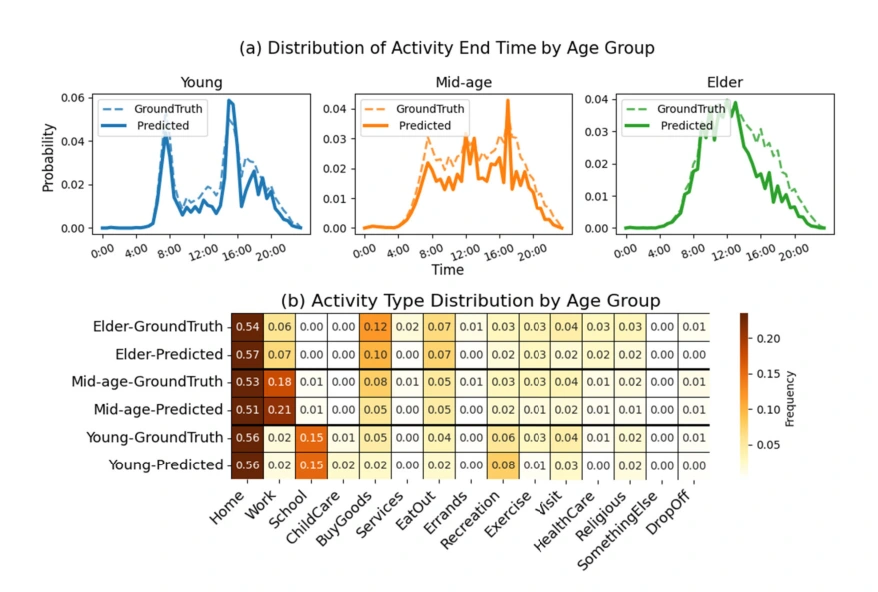
图 7|不同年龄的结束时间和活动份额,模型有没有跟着变?
(a)年轻人的结束时间有两个尖峰,位置对应上学作息;中年人更分散,傍晚还有一峰;老年人从上午缓升,中午附近最高。实线是生成,虚线是调查。(b)热力格是该行活动频率。家在六行里都在 0.51 到 0.57。年轻人上学的调查值和生成值都是 0.15,工作都是 0.02。中年人工作的调查值是 0.18、生成值是 0.21。老年人工作的调查值是 0.06、生成值是 0.07,买商品分别是 0.12 和 0.10。这些格子说明年龄组的主要份额被跟上了。热力图是组内频率,一行里的人并不是同一个人,也不能推出某个 70 岁受访者周二的日程。来源:原论文 Fig. 7。
家里少一个孩子,这条链会改写吗
注意力取自编码器第一层,对象是一个五口之家:目标人是在业的父亲。这是一个例子,用来看输入里的同住者会不会改变输出,不是对真实家庭决策的统计检验。
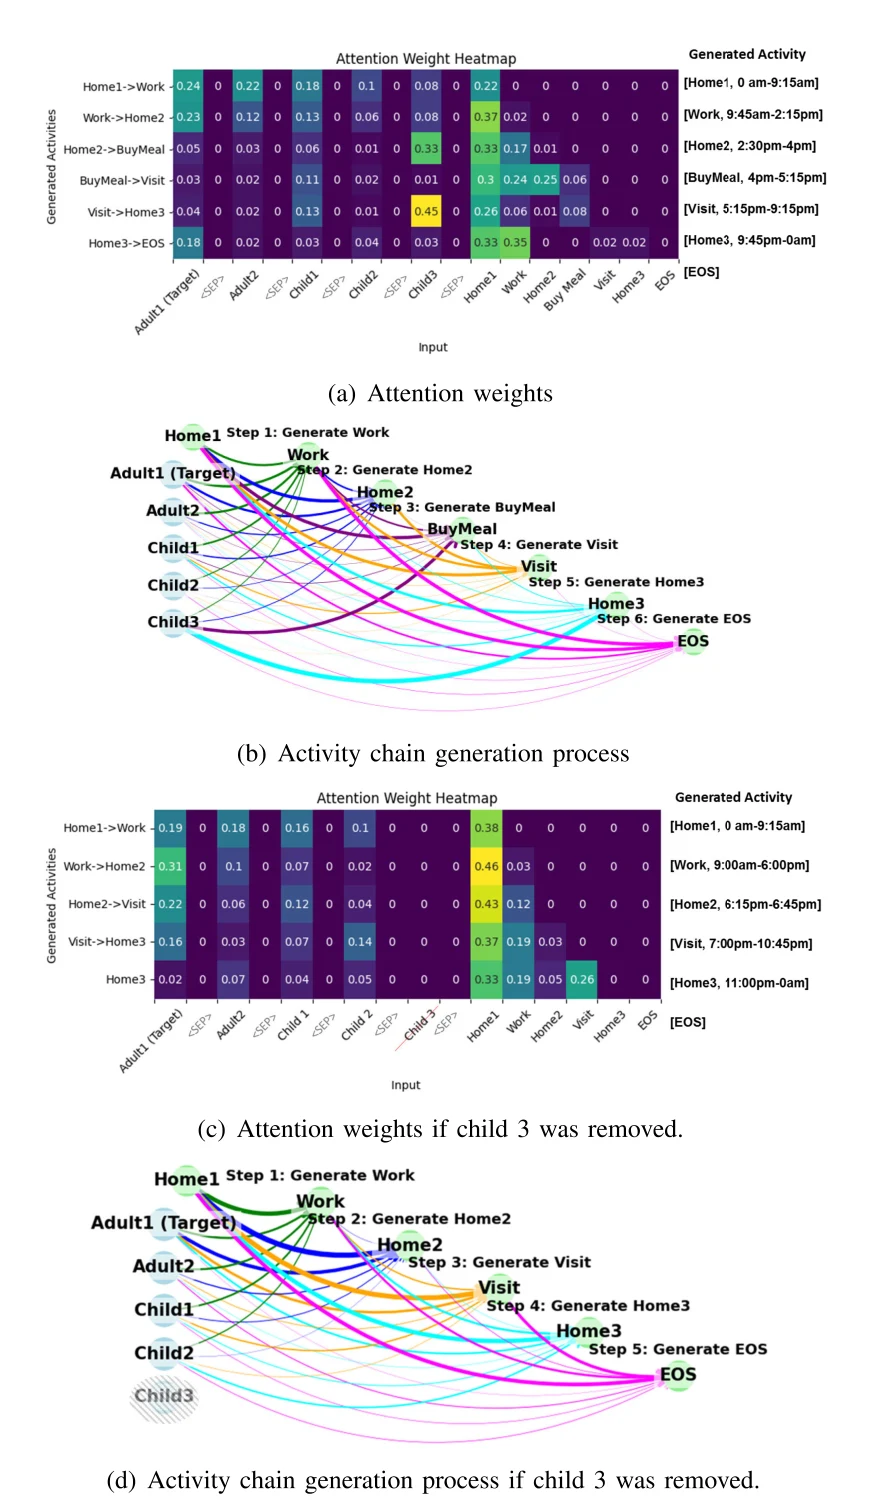
图 8|拿掉第三个孩子之后,同一个父亲的活动链变成什么样?
(a)行是已生成的转移,列是大人、孩子、分隔符和已有活动。颜色越亮,这一步对该输入的权重越高。完整家庭的生成链是:家 0:00–9:15,工作 9:45–14:15,家 14:30–16:00,买餐 16:00–17:15,拜访 17:15–21:15,再回家至午夜。(b)用线的颜色和步骤标出这条链的生成顺序,第三个孩子连到买餐和拜访。(c)从输入中去掉第三个孩子后,注意力重新分布。(d)买餐这一步消失,工作变成 9:00–18:00,随后是一段很短的在家、傍晚的拜访,以及 23:00 之后的回家。论文据此说明同住者的特征进入了生成。一次举例可以证明模型对这个输入敏感,不能当成“家里少一个孩子就会少一次买餐”的因果估计,也没有报告这样的家庭有多少户。来源:原论文 Fig. 8。
换一座城市时,要改的是分类头,还是整套习惯
三地的结束时间、短活动比例、链长和活动构成并不一样。普吉特湾和加州的结束时间高峰在 17:00–18:00 附近;墨西哥城有三个峰,正文特别指出 8:00 和 14:00–15:00。普吉特湾时长少于 0.5 小时的活动更多。墨西哥城长度为 3 的链更多,家的比例更高,工作更少。美国调查里的外出就餐、儿童照料和拜访,在墨西哥城调查的类别中没有单列,锻炼并进了娱乐。
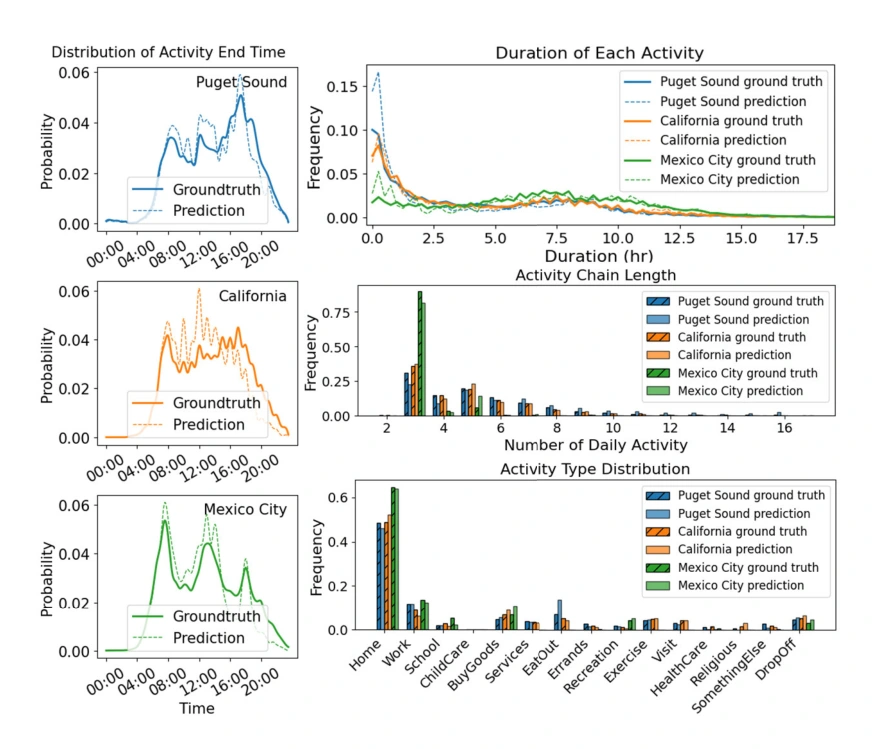
图 9|微调之后,三地的调查分布和生成分布还差在哪里?
图中没有子图字母。左列三幅是结束时间,实线为调查、虚线为生成,自上而下为普吉特湾、加州和墨西哥城。普吉特湾和加州在傍晚升高,墨西哥城在早晨、午后和傍晚出现多个峰,生成曲线跟着这些峰,峰高并不每处重合。右上是时长,普吉特湾在接近 0 小时处有一根明显高于另外两地的尖峰。右中是每天活动个数,墨西哥城在 3 项处的柱子远高于另外两地,并越过 0.75 的刻度。右下是活动类型,家在三地都最高,墨西哥城的家更高、工作更低;图中仍使用美国调查的类别名,所以墨西哥城没有单列的活动会落在这些名字之外。来源:原论文 Fig. 9。
微调后的分布指标如下。列顺序与全美那张表不同:时长放在结束时间之后。
| 地区 | 链长 | 开始 | 结束 | 时长 | 类型 | 边完整率 | 转移差 |
|---|---|---|---|---|---|---|---|
| 加州 | 0.004 | 0.013 | 0.033 | 0.002 | 0.007 | 83.6% | 0.460 |
| 普吉特湾 | 0.030 | 0.009 | 0.051 | 0.010 | 0.012 | 79.5% | 0.652 |
| 墨西哥城 | 0.010 | 0.056 | 0.010 | 0.006 | 0.009 | 63% | 0.339 |
全美模型的边完整率是 92.2%,结束时间散度是 0.003。三地的边完整率都更低,普吉特湾的结束时间和墨西哥城的开始时间比全美测试高出一个数量级。加州和墨西哥城的转移差小于全美的 0.643,但墨西哥城只有 10 类活动,矩阵更小,这个范数不能拿来和 15 类的全美结果排名次。训练链的分母也不同:加州 53,823 条,普吉特湾 7,791 条,墨西哥城 185,233 条,全美预训练 160,831 条。迁移说明少量本地日记可以改写全国模型,同时说明边的种类和某些时段并没有保持全美测试上的接近程度。
四套实验共用训练设置:Adam,初始学习率 0.005,每个轮次乘 0.95,批大小 1024,最多 150 个轮次或提前停止。计算用一张 NVIDIA RTX A5000。
最常见的一天太常见时,稀有活动还学得会吗
多数人的活动链相似,直接训练会偏向家、工作和长度为 3 的链。平衡时不直接打乱整条链,而是取三个代表:去掉首尾都在家之后,链里最常出现的活动类型、最常出现的时长,以及链长。用调查加权里的 raking 给每条链一个权重,使目标分布落在真实分布和均匀分布之间,再有放回地重抽样。常见模式被降权,稀有活动被加重,经验分布不被拉成完全平坦。
论文对 NHTS 和墨西哥城的训练集做了这一步,并用偏斜更明显的墨西哥城作图。正文有一处写可视化时去掉了占优的家;图中的活动类型面板仍画着家。读图以图为准。
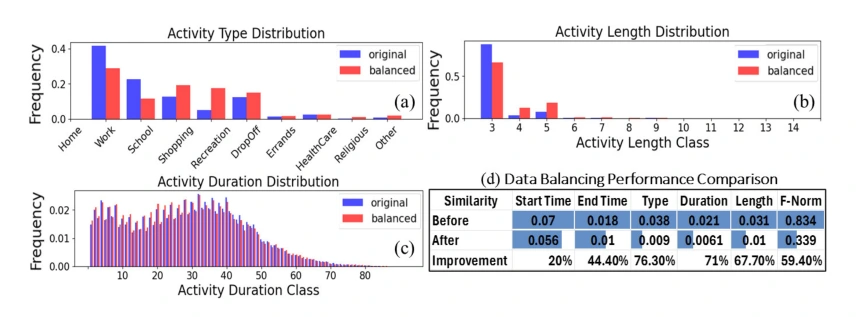
图 10|重抽样之后,哪些分布被拉开,哪些几乎没动?
蓝是原始训练集,红是平衡后。(a)家、工作、上学的份额下降,购物、娱乐和接送上升,家仍然是最高的一类。(b)长度为 3 的链被压低,长度为 5 的链上升。(c)时长直方图两条几乎叠在一起,横轴是 15 分钟一档的时长类别。(d)平衡前的散度是开始 0.07、结束 0.018、类型 0.038、时长 0.021、链长 0.031,转移差 0.834。平衡后变为 0.056、0.01、0.009、0.0061、0.01 和 0.339。相对下降分别是 20%、44.40%、76.30%、71%、67.70% 和 59.40%,分母是平衡前的对应数字。类型从 0.038 到 0.009、转移差从 0.834 到 0.339,与墨西哥城微调表里的 0.009 和 0.339 一致。时长直方图看起来变化很小,散度仍从 0.021 降到 0.0061,因为两项本来就不大,相对降幅可以很高。来源:原论文 Fig. 10。
活动有了,地点怎样落到洛杉矶的路上
调查常常没有精确坐标。地点模块不预测下一项的确切小区,而是让活动在空间上的距离、方向和土地使用看起来像当地。家的位置事先给定。先给上班、上学这类必要活动抽一个符合该子区的家到单位距离,再在土地使用匹配的小区里找距离接近的一个,这些地点成为一天里的锚点。锚点之间的购物、休闲等活动,再按到下一点的距离,以及相对“直奔下一个锚点”的转角来抽。大都市按子区使用不同的距离和转角分布。抽完后再小幅改这些分布,直到各子区的活动次数接近目标次数。停止条件和要展示的空间接近是同一件事:次数先被调到接近,再看流量格局。
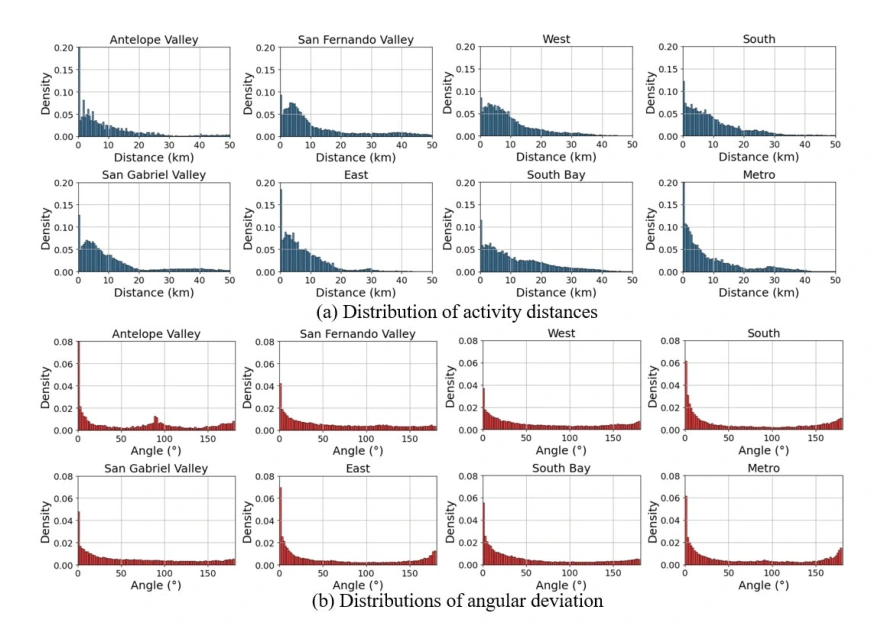
图 4|洛杉矶县八个子区的出行距离和转角,能不能共用一条分布?
(a)八个距离直方图,横轴 0–50 公里,纵轴密度。子区为羚羊谷、圣费尔南多谷、西区、南区、圣加布里埃尔谷、东区、南湾和都会核心。多数质量集中在 10 公里以内,尾部长短不同。(b)同样八个子区的转角,横轴 0–150 度,密度在 0 度附近最高。后文的地点分配按子区使用这些形态,而不是全县共用一个距离。来源:原论文 Fig. 4。
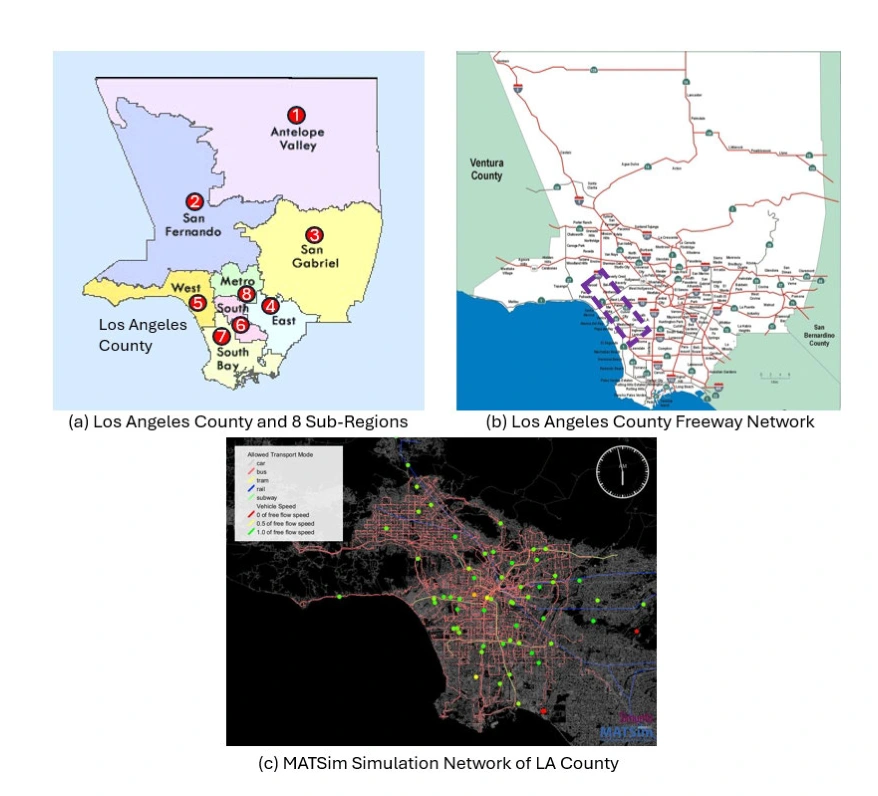
图 11|仿真加载的是哪一块地方、哪一张路网?
(a)洛杉矶县八个子区:1 羚羊谷、2 圣费尔南多、3 圣加布里埃尔、4 东区、5 西区、6 南区、7 南湾、8 都会核心。(b)县内高速路网。紫色框标在西侧的一段路上。正文把这个框写成 Fig. 12(b),而 Fig. 12(b) 是后面的车英里数曲线;走廊曲线在图 13,论文称所选路段为 I-405。(c)LASim 使用的 MATSim 路网示意。图例里的车速按自由流速度的 0、0.5 和 1.0 倍上色,并列出小汽车、公交、火车和地铁。这是仿真网络的画法,不是 Deep Activity 直接输出的出行方式。活动链本身预测的是类型、起止和小区。来源:原论文 Fig. 11。
10 万人的样本用来迁移活动模型,并调节各地的距离与转角分布;约 100 万人用来看放大后的需求。对照始终是 SCAG 活动模型这套合成日记,不是 GPS。
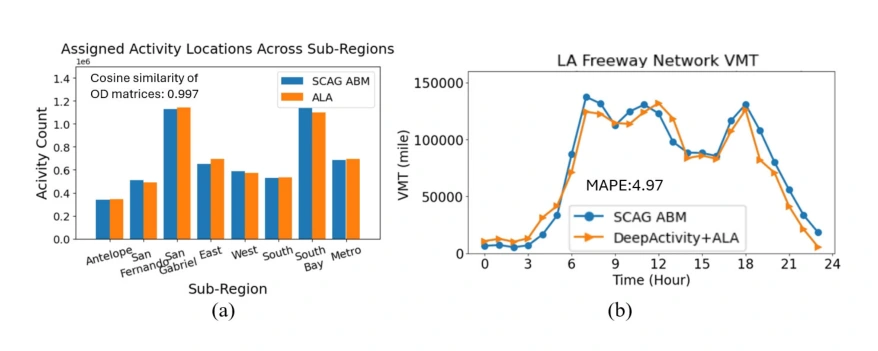
图 12|子区活动次数和高速路车英里数,与既有活动模型差多少?
(a)纵轴活动次数以百万计。蓝是 SCAG,橙是地点分配结果。圣加布里埃尔和南湾最高,羚羊谷最低,两套柱子逐区接近。图内写明起讫矩阵的余弦相似度是 0.997。因为停止条件就是各子区活动次数接近目标,这张柱状图的接近包含了这一步调节。(b)全部高速路段加总的小时车英里数,纵轴到 15 万英里。两条线都在早晨和傍晚升高,图内标注的 MAPE 是 4.97,对照是 SCAG。正文另给出同一路网比较下的速度 MAPE 1.16,这个 1.16 没有印在图上。纵轴是这次实验加载出的车英里数,不宜直接读成洛杉矶县真实的全部车辆里程。来源:原论文 Fig. 12。
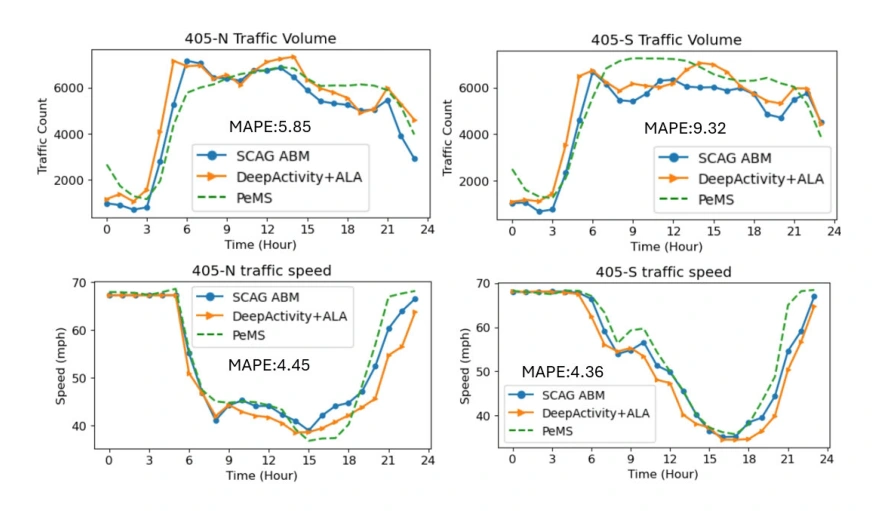
图 13|I-405 两个方向上,流量和速度各跟谁比?
四幅图都没有字母。上排是流量,下排是速度,左为北向、右为南向。蓝线是 SCAG 需求跑出的仿真,橙线是 Deep Activity 加地点分配,绿虚线是 Caltrans PeMS 传感器。图上印出的 MAPE 为北向流量 5.85、南向流量 9.32、北向速度 4.45、南向速度 4.36。方法部分写明这些百分比在生成结果和 SCAG 之间计算,PeMS 用来看拥堵出现的时段和程度。北向速度从早晨降到下午,南向的低速更多出现在中午之后,与正文所说北向约 6:00–20:00 拥堵、南向午后到傍晚拥堵相一致。摘要把流量 5.85% 和速度 4.36% 写成与 PeMS 相比。摘要选取的是四个印出数字里的北向流量和南向速度,方法说明给出的计算对象是 SCAG。南向流量图上,绿线在日间明显高于蓝线和橙线,传感器与两套仿真之间的差别肉眼可见,而 9.32 这个更大的流量误差印在南向面板上。来源:原论文 Fig. 13。
层数加深,这 18 万条调查够不够喂
复杂度实验在 NHTS 上比较九种 Transformer,参数量从 434,000 到 2,344,000,由编码器层数、解码器层数和注意力头数组合而成。正文把这里的样本量写成 180,000。表 IV 的训练链是 160,831,加上验证链 18,106 后是 178,937。180,000 更接近训练加验证的约数,论文没有写明这 180,000 是否含测试集。
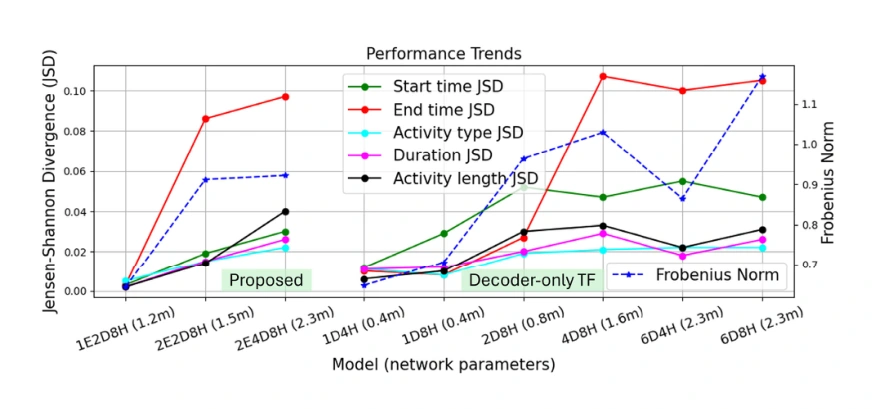
图 14|在这批调查的规模上,更深的 Transformer 有没有更好?
无字母子图。横轴九个结构,括号里是约略的参数量,单位百万。左轴是各 JSD,右轴是转移差。Proposed 标在 1 层编码器、2 层解码器、8 个注意力头,约 120 万参数,各散度贴在低位。再增加编码器或解码器层数后,结束时间的红线升到 0.08 以上,4 层和 6 层解码器的结束时间超过 0.10。仅解码器的对照标在 2 层 8 头、约 80 万参数。头数从 4 改到 8 带来的起伏,小于把层数从 1 加到 4。图的含义是:以眼下的调查规模,更小的结构已经够用,加深没有带来更低的散度。来源:原论文 Fig. 14。
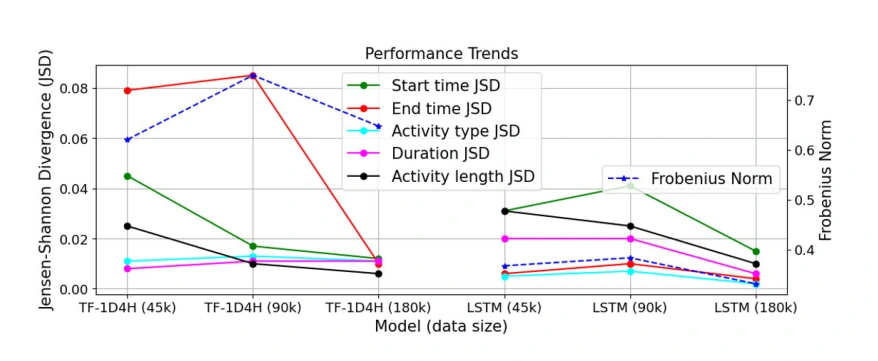
图 15|样本从 4.5 万增到 18 万时,谁还在下降?
无字母子图。左侧是 1 层解码器、4 个头的 Transformer,右侧是 LSTM,样本量依次为 45,000、90,000 和 180,000。Transformer 的结束时间散度在前两档仍在 0.08 上下,到 180,000 才降到与其他曲线接近的低位;链长和开始时间随样本增加下降。LSTM 各线变化更小,结束时间一直较低。正文据此认为 Transformer 还能利用更多数据,LSTM 在当前规模上趋于平台。4.5 万条时,这张图里的 Transformer 结束时间差于 LSTM,所以“更能利用大数据”不等于“小样本时已经更好”。来源:原论文 Fig. 15。
作者最后选择 Transformer,用的是可查看家庭成员注意力,以及能够微调到其他地区这两点,加上上图里层数不必堆高的结果。
这些数字能支持到哪一步
活动链的指标回答的是:在对应测试集的活动链集合上,生成出来的类型、时间、时长、链长和转移,与调查分布有多像。全美测试集是 18,106 条链。它不回答某一个受访者的日记是否被复原。
地点模块的停止条件是各子区活动次数接近目标,距离和转角分布还可以被小幅调整。0.997 的余弦相似度是调节之后、与 SCAG 合成需求的起讫矩阵相比。SCAG 本身是活动模型的产出,人口口径是六县超过 1900 万,实验用的是从约 1000 万个体中抽出的约 100 万。车英里数 MAPE 4.97 和速度 MAPE 1.16 都是相对这套合成需求,而且是高速路段汇总。I-405 上印出的四个 MAPE 按方法说明也相对 SCAG;PeMS 提供的是这一条走廊上拥堵时段的外部参照。摘要对 5.85% 和 4.36% 的对照写法与方法说明不同。
家庭注意力只有一个五口之家的例子。工作日与周末能够分开,但 26 项属性表没有列出日期类型。模型设计上限是五名家庭成员,对应 95% 的 NHTS 家庭。加州调查是 2010–2012 年,其余主要调查是 2017 年,年代并不对齐。墨西哥城的类别和输入字段都换过,63% 的边完整率发生在 10 类活动上。
调查可能漏掉部分人群和少见活动,地点目前停在交通小区。论文把条件变分自编码器、生成对抗网络和扩散模型留作后续,理由是那些模型通常需要更密、连续的轨迹。午间非必要活动的结束时间,仍是时间分布里散度较高的一段。
一句话总结
只读社会人口和家庭属性,模型可以写出接近调查分布的一天活动链;把地点调到各子区次数接近之后,洛杉矶的合成需求在起讫格局和高速路车英里数上接近既有活动模型。每个人的真实坐标、以及相对路面传感器的误差,还不是这些百分比已经回答的问题。
核心来源
- IEEE Xplore 正式版,IEEE Transactions on Intelligent Transportation Systems,2026,27(6):6519–6536。正文图 1–15 与表 I–VII 均来自这一版。
- 2017 National Household Travel Survey,以及论文引用的加州、普吉特湾、墨西哥城家庭出行调查。文中的链条数与户数、住房单元数是不同计数单位。
- SCAG 2016 年区域出行需求模型及验证报告,作为洛杉矶县空间对照的合成需求。
- Caltrans PeMS,作为 I-405 走廊上的传感器参照曲线。
作者介绍
以下身份来自论文首页单位和文末作者简介。
- Xishun Liao:论文首页署名为加州大学洛杉矶分校 Mobility Laboratory。简介写明他于 2023 年在加州大学河滨分校获得电气与计算机工程博士学位,曾任加州大学洛杉矶分校助理项目科学家,现为中佛罗里达大学助理教授。研究方向包括人类移动性建模、城市地理空间智能、自动驾驶和数字孪生。
- Qinhua Jiang:北京交通大学土木工程学士和硕士,正在加州大学洛杉矶分校土木与环境工程系攻读博士。研究包括基于活动的出行需求、机器学习交通预测和大规模智能交通系统。
- Brian Yueshuai He:2020 年在纽约大学获得交通规划与工程博士学位,曾任加州大学洛杉矶分校研究科学家,现为路易斯维尔大学土木与环境工程系助理教授。工作集中在交通系统建模、人类移动性和可持续交通规划。
- Yifan Liu:加州大学戴维斯分校计算机科学与工程学士,2024 年在纽约大学获得计算机科学硕士,正在加州大学洛杉矶分校土木与环境工程系攻读博士。研究包括大语言模型、强化学习和面向智能交通的深度学习。
- Chenchen Kuai:2022 年在东南大学获得公路与桥梁工程学士,2024 年在加州大学洛杉矶分校获得交通工程硕士,正在得克萨斯农工大学土木与环境工程系攻读博士。研究包括智能交通、复杂网络、深度学习和人类移动性。
- Jiaqi Ma:通讯作者,IEEE 高级会员。2014 年在弗吉尼亚大学获得交通工程博士学位,现为加州大学洛杉矶分校工程学院教授,并担任交通研究所新出行项目的教师负责人。研究包括智能交通、自动驾驶和协同驾驶自动化。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
地点模块停在各子区活动次数接近目标。若把距离和转角分布在一半子区上调好,再拿到没参与调节的另一半日期或另一半人群上,余弦相似度还会不会停在 0.997 附近,可以直接分开“边际次数被调齐”和“链本身带着可用的空间约束”。更硬的检查是同一户里的约束:第三个孩子还在输入里时,父亲的买餐和儿童照料在空间上是否落在彼此可及的小区,而不是只在全县计数上分别合格。
墨西哥城的边完整率是 63%,而且外出就餐、儿童照料和拜访没有当地的单独类别。若把全美 15 类的分类头直接用于当地审计,模型会写出调查无法核对的活动名。迁移之前先列一张类别对照表,并只在两边都存在的活动上计算边完整率,得到的百分比才和全美的 92.2% 使用同一种分母。
时间上最弱的一段是 10 点到 15 点的结束,散度大约 0.005,而全天结束时间散度是 0.003。午餐时段的商业或公交方案如果直接使用这条合成需求,用到的正是非必要活动最不稳定的几小时。把 JSD 按活动类型和小时分开报告,会比一个全天数字更早露出这个问题。高速路车英里数已经能到 4.97% 的总体 MAPE,仍然可以和午间错峰同时发生。