一个人的手机只响了几次,凭什么补出他的一整天?
论文名片|Shan Jiang、Yingxiang Yang、Siddharth Gupta、Daniele Veneziano、Shounak Athavale、Marta C. González,The TimeGeo modeling framework for urban mobility without travel surveys,Proceedings of the National Academy of Sciences,2016,113:E5370–E5378,2016年8月29日在线发表。DOI:10.1073/pnas.1524261113。印刷版标题曾把 mobility 印成 motility,2016年10月24日的勘误改回 mobility。本文依据这篇机制模型的主文:用被动手机记录提取参数,生成 10 分钟、数百米分辨率的个人轨迹,再与出行调查和规划机构的通勤估计对照。
大波士顿有一名用户,30 天里只被记下 4 个不同地点、一共 10 次停留。电话、短信和数据业务没发生的时候,人仍可能在某处停着,详单里却是空的。另一头,论文对主流入户调查的概括是:多数情况下大约只覆盖城市家庭的 1%,约十年一次,每人只有一天或少数几天。人数大的记录缺过程,过程完整的问卷缺人数。
TimeGeo 把这件事拆成可测量的规则。家和工作地先从记录里认出来;灵活活动则由三个个人时间参数,加上按远近排序的探索与返回来生成。它能让活跃非通勤者的停留时长、每日地点数和访问频率接近手机数据,也能让大波士顿 164 个市镇的家到工作人次与规划机构的估计排得很近。生成出来的是符合这些统计的轨迹。某次没被手机记下的真实停留,并没有被逐条找回。
先说结论
- 2010 年大波士顿 6 周通话详单有 1.92 百万匿名用户。识别出家的有 1.44 百万,占初始用户的 75%。再要求总停留超过 50 次、在家停留至少 10 次之后,有通勤者 133,448 人,无通勤者 43,606 人。
- 详细结果针对无通勤者。每周从家出发的出行次数 n_w、离家后的出行强度 n_wβ₁、连续外出强度 n_wβ₂ 的中位数是 7.4、34.2 和 355.6。停留率 β₁ 的中位数是 4.6:同一时刻,离开其他地点的概率是离开家的概率的 4.6 倍。
- 两名极端个人若用各自参数,停留时长分布与数据的 KS 统计量为 0.12 和 0.11;改用全体中位数后升到 0.25 和 0.20。每日访问地点数的 KS 从 0.05 和 0.12 升到 0.40 和 0.50。KS 在这里衡量分布差距,越小越接近,主文没有把它写成显著性检验的 p 值。
- 全体活跃非通勤者中,令 β₁=1、不再区分家和其他地点,停留时长的 KS 从 0.04 升到 0.27。去掉爆发率 β₂ 后,每日地点数的 KS 从 0.03 升到 0.22。探索地点若不按距离排序、而从经验距离里随机抽取,出行距离的 KS 为 0.52;改用排序后为 0.39。第 L 常去地点的访问频率约为 L 的 −1.2±0.1 次方。
- 把有通勤者和无通勤者扩到都会区 16 岁及以上的 3.54 百万人,并生成一个工作日。家到工作的人次与波士顿地区大都会规划组织 2010 年模型相比,164 个市镇之间的皮尔逊相关系数为 0.90,市镇内部为 0.99。停留时长相对 2010–2011 年马萨诸塞出行调查的 KS 为 0.23,相对 2009 年全国入户出行调查为 0.59。每日地点数的对应 KS 为 0.07 和 0.23。出行距离只与马萨诸塞调查比较,KS 为 0.24,长距离偏多。
一次通话记录,还不是一次停留
数据是 AirSage 为两家运营商业务收集的通话详单(call detail records,CDR)。一条记录在用户打电话、发短信或使用蜂窝数据时产生,格式为用户编号、经度、纬度和时间。城区定位精度大约 200–300 米。模型声称的空间分辨率是数百米,时间上则把一天切成 144 个 10 分钟,一周共 1,008 个间隔。
人在一地停下来做事,论文称为停留(stay)。提取时去掉信号跳跃和路过点。再按到达时刻和访问次数,把停留标成家(home)、工作(work)或其他(other)。家的位置固定,出发时刻和停留时长可变;工作被当作地点、开始时刻和时长都已确定的活动;其他活动三者都可变。因此模型要生成的是灵活部分。通勤者的工作日程视为事先给定,群体节律里也不再计入上下班行程。
1.92 百万是初始用户。1.44 百万是其中认出家的人,75% 的分母是初始用户。活跃用户是另一层筛选:观察期内总停留超过 50 次,且在家停留至少 10 次。论文把这些活跃用户分成有上班行程的通勤者 133,448 人,和没有上班行程的非通勤者 43,606 人,两者合计 177,054 人。参数分布来自这层活跃用户,不能写成 192 万人每人都能单独估计。
手机不用,停留就可能消失。一次停留期间若没有多于一次的手机使用,这次停留检测不到;即使用了多次,停留时长也只是近似。连续超过 2 天的停留被拿掉,因为无法区分人真的停了两天,还是两天没使用手机。模型也就不会再现这种超长停留。
另有一名研究生用 OpenPaths 在同一地区自愿记录了 2013–2014 年共 14 个月,并提供知情同意。研究程序得到麻省理工学院人体受试者委员会批准(协议 1405006399,2014 年 6 月 10 日批准)。这名学生用来展示提取和模拟长什么样,个人参数不能当成 14 万通勤者的平均值。
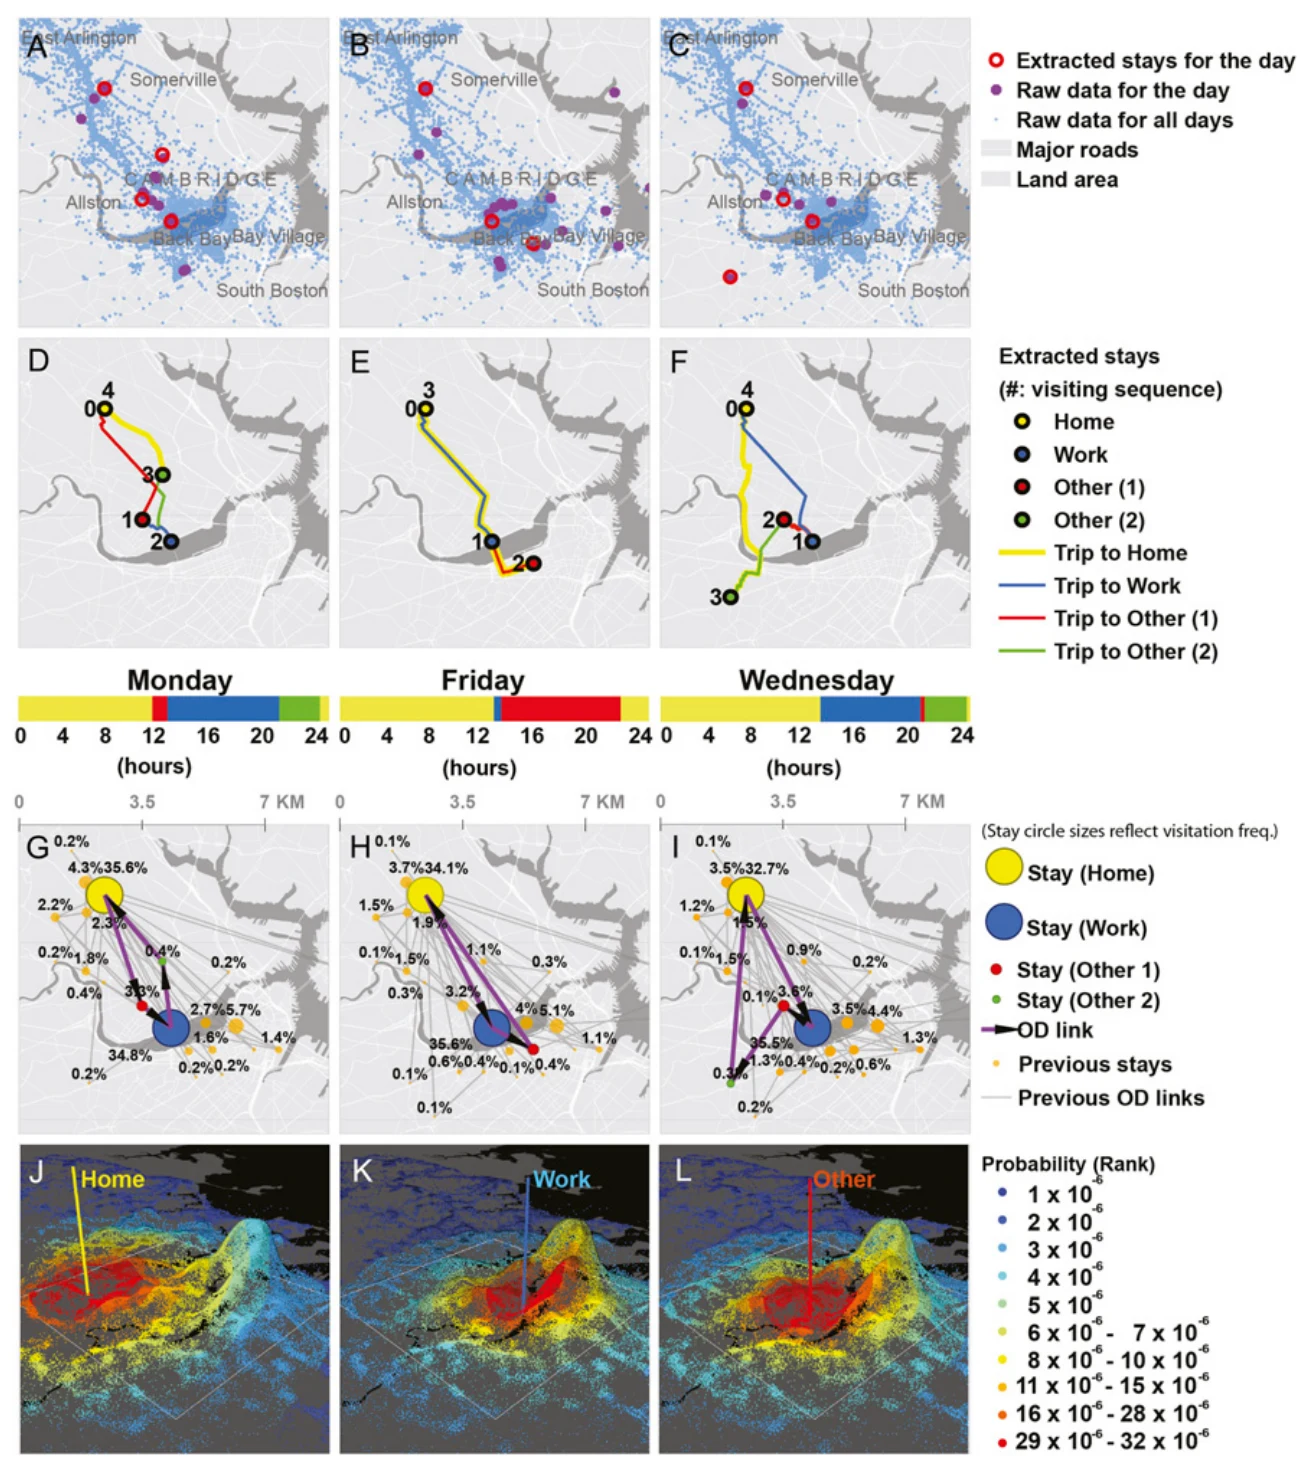
图 1|稀疏定位怎样变成一天的停留、行程和候选目的地?
(A、B、C)这名学生三个样例日的原始点与提取出的停留。蓝色是 14 个月的原始点,紫色是当日原始点,红色是当日停留;灰线为主要道路。(D、E、F)连续停留之间的行程,分别标成周一、周五和周三。颜色区分回家、去工作、去两处其他地点;上方色条是停留起止和时长,0–24 小时。(G、H、I)从观察第一天累计到当日的访问频率,圆圈越大访问越多。家和工作主导访问,箭头标出当日行程,浅色线是此前的联系。(J、K、L)从家、工作地和一处其他地点出发时,按距离排序后的目的地概率。越近排序越靠前、被选概率越高;点的高度表示周围其他活动地点的密度,其他活动最密的地方在波士顿市中心。来源:原论文 Fig. 1。
这张图回答的是提取流程,样本是一个人的三天。家和工作占主导,说明后面把这两类地点先固定、只生成其他活动,有这名长期记录者的直观对应。它还不能说明 192 万用户的拟合误差。
每个十分钟先问走不走,再问去不去下一个灵活地点
时间部分是一条随时刻变化的马尔可夫链。状态主要是家和其他。家是较不活跃的状态,因为在家的平均停留明显长于在其他地点。
人在家时,某个 10 分钟间隔 t 里出发的概率是 n_w P(t),并且这个乘积小于 1。n_w 是每周从家出发、前往其他地方的出行次数,每人不同。P(t) 是全体人在一周里的出行节律,1,008 个间隔加起来等于 1。图 2B 画的是活跃非通勤者的 P(t)。通勤者另有一条节律,其中不含上下班。因此同一个人在家的出发概率,等于自己一周从家出发的总次数,乘上全体人在这个钟点的份额。
人已经在其他地点时,出发概率写成 β₁ n_w P(t)。β₁ 称为停留率(dwell rate):相对在家,此人在外有多容易再走。β₁ n_w 越大,灵活活动的停留 Δt 越短。
若人已经决定离开当前的其他地点,下一步是回家,还是再去一个其他地点。论文把二者的概率比写成:
P(再去其他地点) / P(回家) = β₂ n_w P(t) / (1 − β₂ n_w P(t))。
β₂ 称为爆发率(burst rate)。下午 P(t) 高时,比值变大,更可能把几个短活动接在一起;P(t) 低时,更可能回家。β₂ n_w 越大,一天访问的地点数 N 越多。n_w 只数从家出发的行程,N 则数一天里的访问地点,两者分母不同。
以前的一些模型从全体分布里随机抽取等待时间或活动个数。这里改成每人三个数:n_w、β₁、β₂。β₁ 和 β₂ 不是直接读出来的,而是让模型的停留时长分布和每日地点数靠近该用户的数据。目标是停留时长分布的绝对差,加上每日地点数之差的绝对值;后者权重 η=0.035。因为目标不是凸的,β₁ 只在 1、2、…、20 里找,β₂ 只在 1、6、11、…、101 里找。个人参数因此是这套网格上的离散值。
非通勤者的联合分布里,最可能的组合是 n_w=6.1、n_wβ₁=22.4、n_wβ₂=508.0。中位数却是 7.4、34.2、355.6。最常见的那个人和位于中位的那个人不是同一组参数,后面用中位数做平均情形时,比较的就是这组中位数。
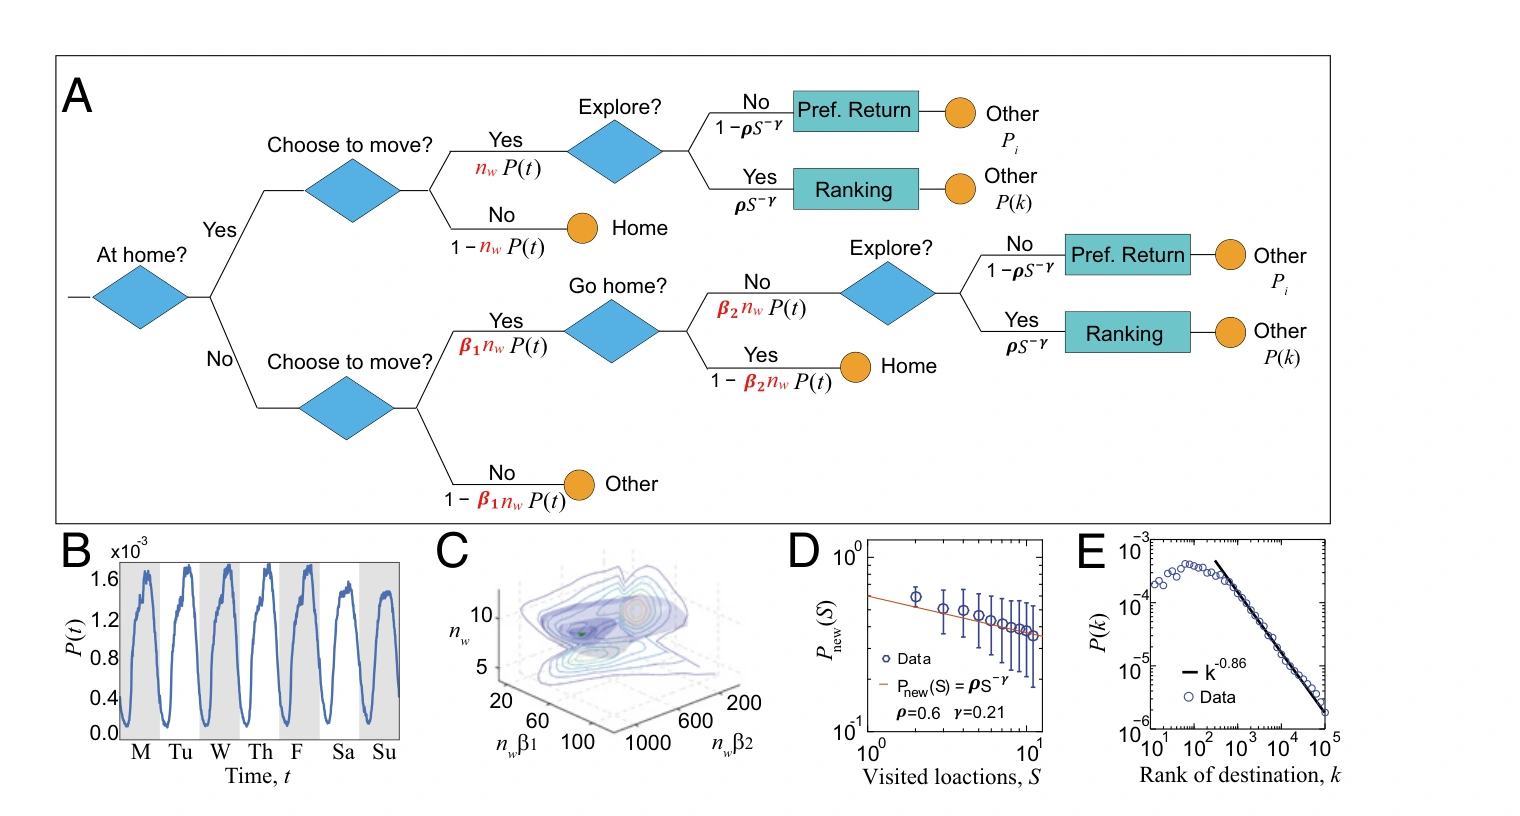
图 2|一个十分钟里,走、回家、返回旧地和探索新地怎样分支?
(A)每个时间步的选择。在家时,出发概率为 n_w P(t);在其他地点时为 β₁ n_w P(t)。已决定离开其他地点后,再去下一处其他地点的倾向由 β₂ n_w P(t) 控制。探索新地走排序,返回旧地走历史访问频率。(B)活跃非通勤者的一周出行节律 P(t),横轴从周一到周日,纵轴数量级为 10⁻³,与 1,008 个间隔总和为 1 相符。(C)n_w、n_wβ₁、n_wβ₂ 的联合分布及两两边缘。绿点是最可能组合:6.1、22.4、508.0。(D)访问过的不同地点数 S 越多,探索新地的概率越低,拟合为 P_new=0.6 S^(−0.21)。(E)选中距离排序第 k 的地点的概率约按 k^(−0.86) 下降。来源:原论文 Fig. 2。
空间上的三个全局参数也在这张图里:探索概率 P_new=ρ S^(−γ),ρ=0.6,γ=0.21;排序概率 P(k)∼k^(−α),α=0.86。S 是已经去过的不同地点数。只去过 1 类地点时,公式给出的探索概率是 0.6;地点种类增加后,探索按 S 的 −0.21 次方下降。若选择返回,地点 i 被选中的概率等于它以往的访问频率。α、ρ、γ 来自用户汇总。6 周里多数人的探索次数不多,主文没有给每人一条排序曲线。
新地点按远近排队,土地使用决定这条队有多密
原有的探索与偏好返回(exploration and preferential return,EPR)能解释各地点访问次数为什么差很多,但选新地点时,只是从全体跳跃距离分布里随机抽一个距离。TimeGeo 改成基于排序的探索与偏好返回(rank-based EPR,r-EPR)。候选新目的地按到当前位置的距离排队:最近为 k=1,次近为 k=2。被选中的经验概率约按 k^(−0.86) 下降。图 1 的 J、K、L 就是这套概率:近处更热,市中心的其他活动地点更密,所以同样的名次在市中心和郊区对应的实际距离不同。
土地使用进入的方式,是供给点在空间里怎么铺。论文用层级乘法级联来描述。整个都会区先看成边长 48 千米的正方形,再逐次分成 4、16、64…个方格,格子边长从 24 千米收到 187 米,共八级。家是需求,其他地点是供给。每一级的密度等于上一级密度乘上随机因子。大格子上几乎没有空格,家和供给正相关,因子可看成联合对数正态;小格子会出现空格,居住和其他用地甚至互相避开,因子改用允许空格的 β 级联。
一次探索越出第 i 级格子的概率 P_>(i),是格子里已有的供给没被选中的概率,再按格子内供给数量的分布平均。供给数量又取决于这个尺度上家和其他地点是否叠在一起。于是出行距离同时依赖排序规则和城市结构。主文据此说明,这套框架以后可以做土地利用情景;正文实际展示的,是级联计算、模拟和手机数据在越格概率上的对照,没有给出改完一块用地之后的新流量表。
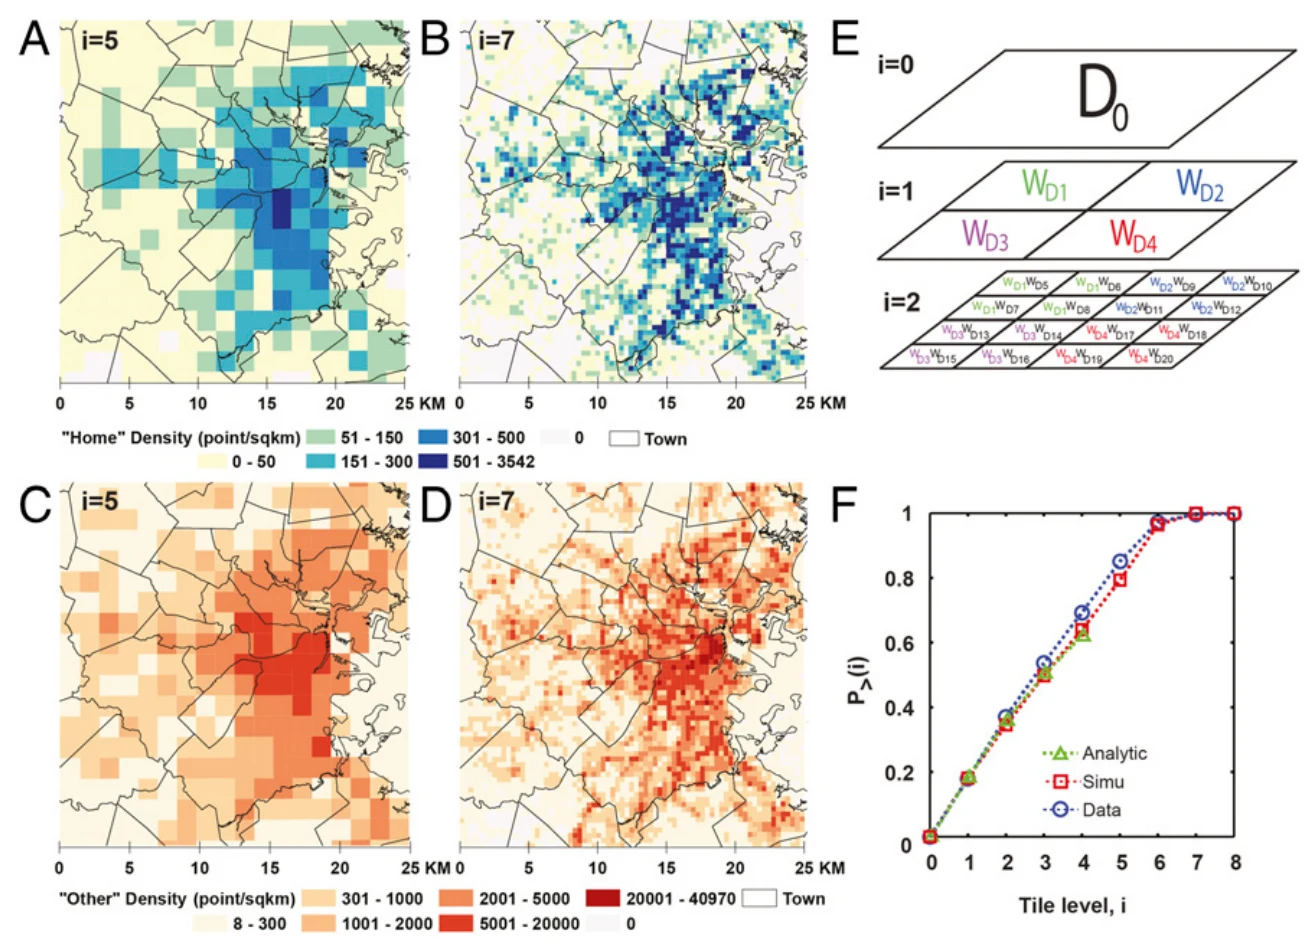
图 3|家和其他地点在不同格子尺度上如何错开,又如何拉长出行?
(A、B)家的密度,级联层级 i=5 与 i=7。i 越大格子越小,颜色是每平方千米的地点数,地图窗口约 25 千米,小于后面用于计算的 48 千米见方范围。(C、D)其他地点在同样两级上的密度。粗格子里两类密度的高低更一起起伏,细格子里居住和其他用地更容易分开。主文没有给出这两层的相关系数。(E)需求 D 逐级乘上因子 W,每块母格分成四块子格。(F)探索出行越出第 i 级起点格子的概率。解析计算、模拟和手机数据三条线一起上升。边长 24、12、6、3 千米的最大四级用对数正态级联即可解析计算。越出 24 千米格子的探索出行占 10%,越出 3 千米格子的超过 60%。来源:原论文 Fig. 3。
10% 和 60% 的分母是探索出行是否越出所在格子,不是全部行程的公里数,也不是人口比例。最大四级上,数据、模拟和解析计算彼此接近,说明在这些尺度上,排序规则加上家与供给的空间相关,已经能说明越格概率。更细的空格子和互斥用地仍留在 β 级联里,主文没有单独给出那几级的误差。
同一套规则,换三个数就会走出不同的一天
学生的参数是 β₁=4、β₂=36、n_w=7。论文写他的爆发率低于总体平均,所以连续的短活动较少。家和学校的位置固定,学校按工作地处理。模拟出的日子以家和学校之间的行程为主,另有少量其他地点。比较的日子都从家出发并回到家。地点是点,行程是边。占主导的是一天只在两个地点之间往返;为看清少见的网络,频率用了对数刻度。模型抓到了 2 个节点和 3 个节点的较高比例,也出现一些更复杂的日模式。主文没有列出这名学生每种网络的百分比。
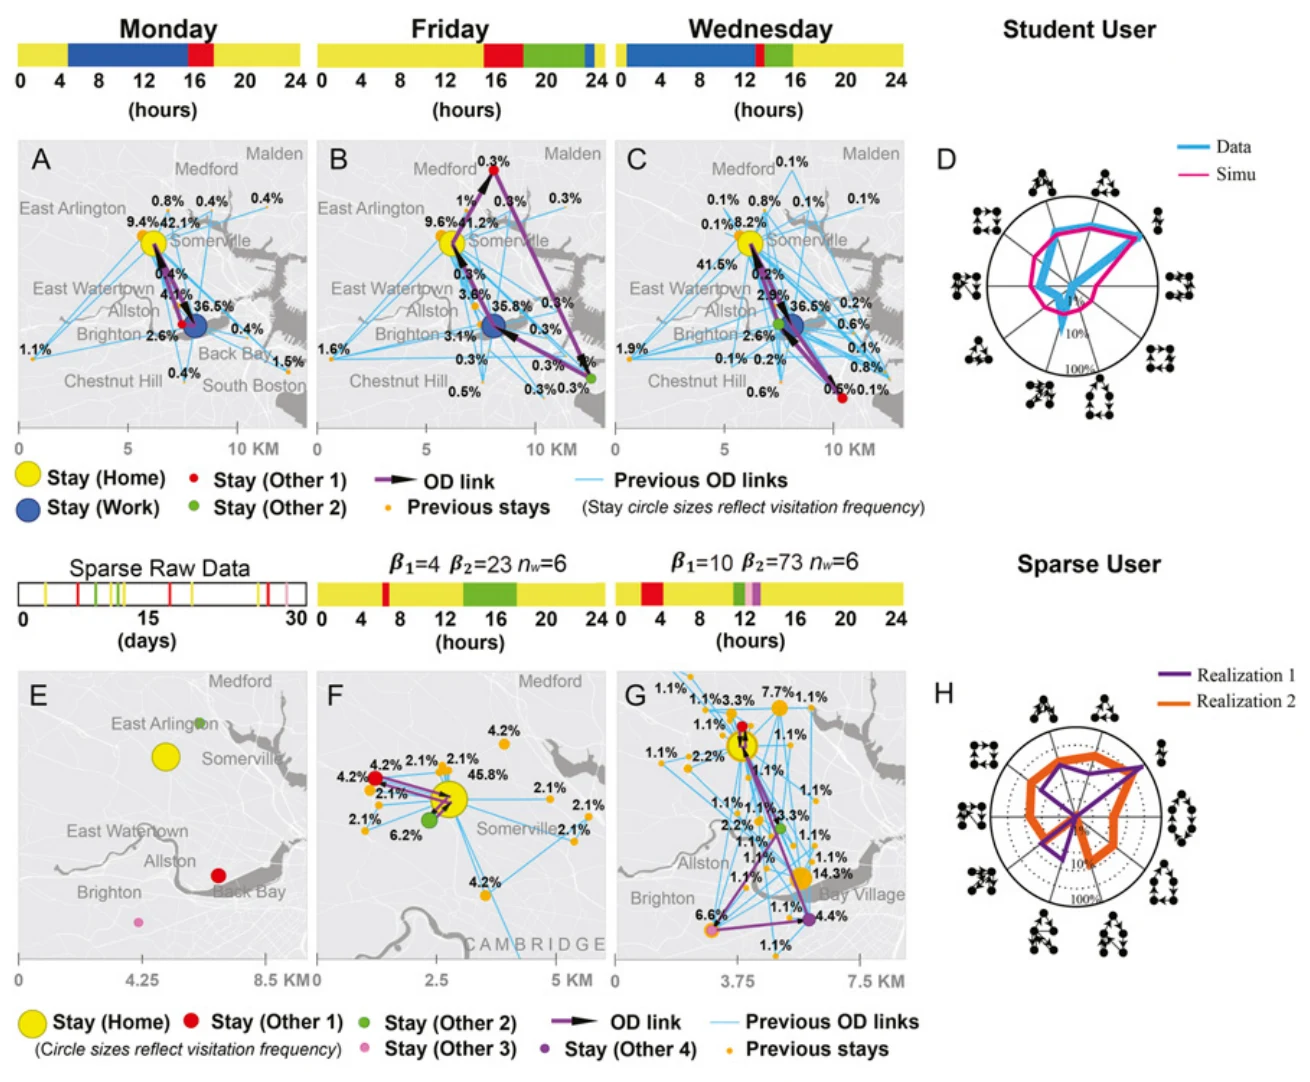
图 4|参数换了以后,学生和稀疏用户的一天分别长什么样?
(A、B、C)学生三个模拟日,行程为紫色,圆圈是累计到当日的访问频率,上方是周一、周五、周三的活动色条。(D)该学生从家出发并回家的每日出行网络。蓝线为数据,洋红线为模拟,径向百分比用对数刻度;两地点和三地点的模式更高。(E)一名稀疏用户 30 天里 10 次停留、4 个地点的原始提取结果。(F、G)同一用户的两种生成。F 使用 n_w=6、β₁=4、β₂=23;G 使用 n_w=6、β₁=10、β₂=73。β₁ 和 β₂ 更大时,连续的外出和当日地点更多。(H)两种生成的每日网络。参数小,简单网络更多;参数大,活动链更复杂。来源:原论文 Fig. 4。
稀疏用户说明输入可以有多缺。两次生成使用图 2C 那类联合分布里的不同参数,n_w 都是 6,β₁ 从 4 增到 10,β₂ 从 23 增到 73。较大的停留率和爆发率把更多外出接在同一天。对这个人,模型给出的是两种与其稀疏记录相容的可能日记。主文没有说哪一种更接近他未被记录的真实周二。
个人参数的作用,要靠同一个人的数据与平均情形对照。论文取两名非通勤极端用户:出行更频繁的一人 n_w=10.86、β₁=6、β₂=41,图中用方块;出行较少的一人 n_w=5.51、β₁=1、β₂=36,图中用圆点。第三人用 n_w、β₁、β₂ 的中位数。较少出行的人停留更长、每天地点更少。
停留时长上,两人各自模拟与自己数据的 KS 为 0.12 和 0.11;若都去对中位数那个人,KS 升到 0.25 和 0.20。每日地点数上,各自参数的 KS 为 0.05 和 0.12,对上平均情形后为 0.40 和 0.50。顺序都是先频繁出行者、后较少出行者。这组对照支持的结论是:用全体中位数会把两端的人拉向中间。它还不说明三个参数在因果上改变了某人的偏好,因为参数本身就是靠靠近该用户的停留和地点数校准出来的。
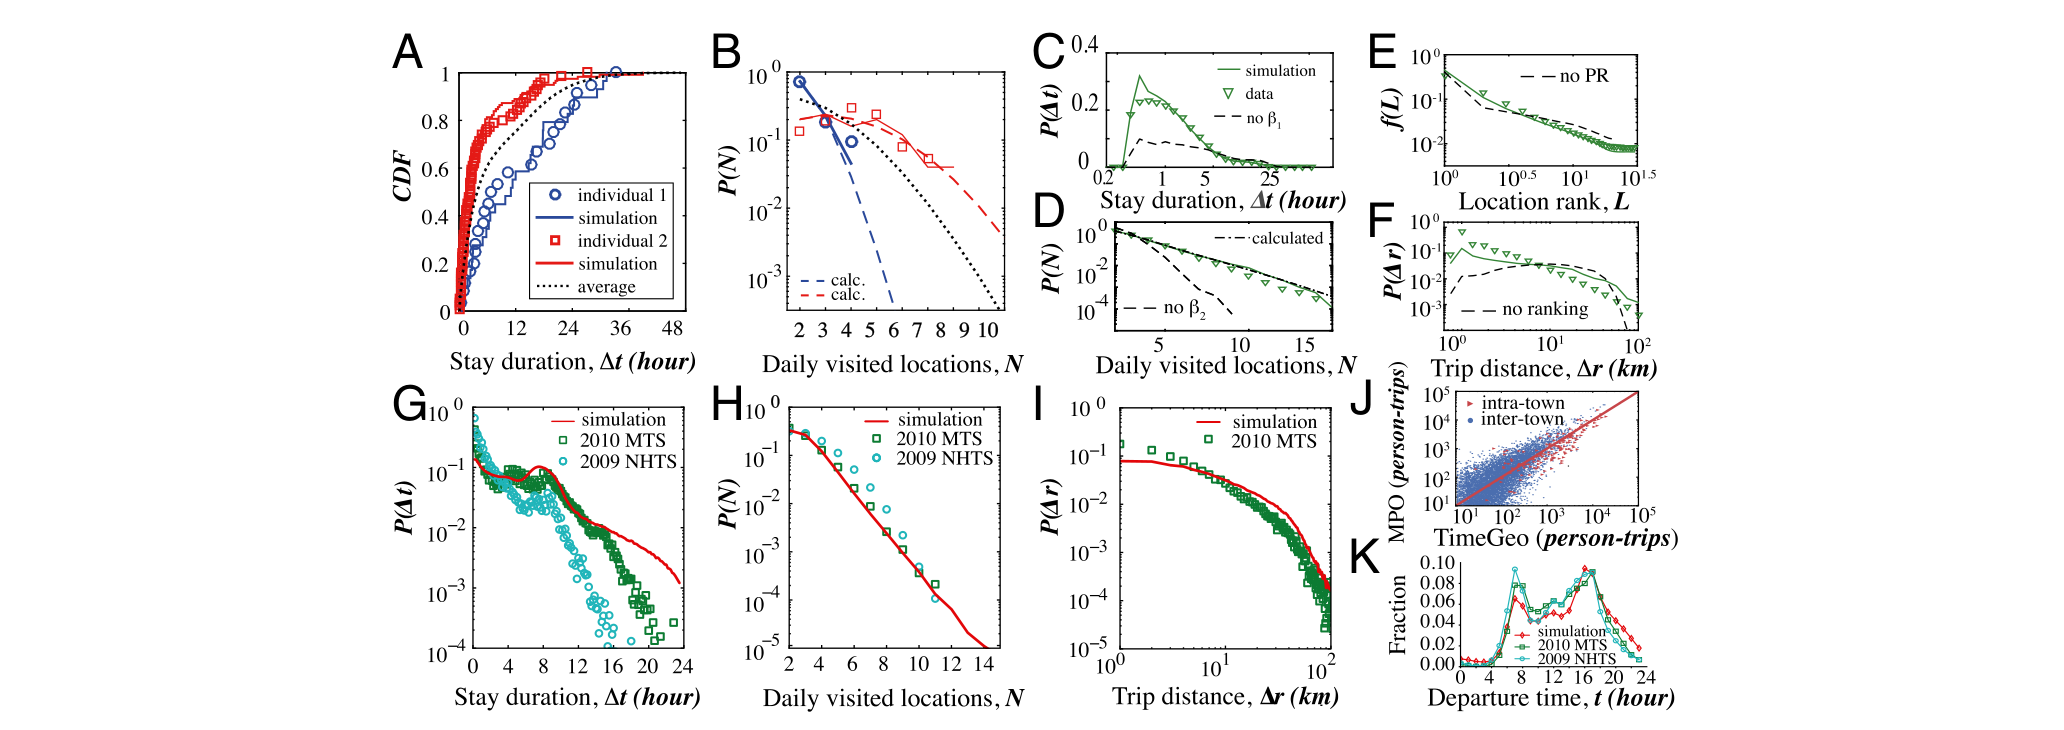
图 5|个人差异、机制删减和全城调查对照分别差多远?
(A)两名极端非通勤者及中位数情形的停留时长累积分布,横轴为小时。方块是停留较短、出行更频繁的人,圆点是出行较少的人,点线是中位数参数。(B)每日访问地点数。虚线是马尔可夫框架的计算,实线一类为模拟。(C)全体活跃非通勤者的停留时长分布。β₁=1 的基准低估短停留。(D)每日地点数。带 β₂ 的计算和模拟靠近数据,去掉 β₂ 后偏离。(E)第 L 常去地点的访问频率,约按 L^(−1.2±0.1) 下降;虚线是去掉偏好返回的基准。(F)出行距离。排序探索靠近数据,不排序的随机探索在距离形状上偏离。(G)扩样人口的停留时长,对照 2010 年马萨诸塞出行调查和 2009 年全国入户出行调查。(H)每日地点数的同样对照。(I)出行距离,只画模拟与 2010 年马萨诸塞调查。(J)164 个市镇内部和市镇之间的家到工作人次,横轴为 TimeGeo,纵轴为规划组织模型,两轴为对数人次。(K)一天中各小时出发行程所占份额,三条线为模拟、2010 年马萨诸塞调查和 2009 年全国调查。来源:原论文 Fig. 5。
全体活跃非通勤者的删减实验给出另一组分母:比较对象是这群人的汇总分布。β₁=1 时,家和其他地点共用同一条出发节律,短停留被低估,停留时长 KS 从 0.04 升到 0.27。保留 β₂ 时每日地点数 KS 为 0.03,去掉后为 0.22。访问频率的幂次 −1.2±0.1 来自偏好返回;图 5E 的虚线是去掉这一机制后的基准。距离分布从随机探索的 KS 0.52 降到排序机制的 0.39。0.39 仍然不是 0,排序改善了距离形状,同时留下可见差距。汇总的每日网络分布放在补充材料,主文没有给出全体用户每种网络的份额。
扩到 354 万人以后,通勤总量最近,停留时长最远
活跃用户的参数被扩到都会区 16 岁及以上人口,通勤者和非通勤者都进入,共 3.54 百万人,生成一个工作日。扩样权重的具体做法在补充材料,主文直接给出扩样后的分布和调查对照。
停留时长与马萨诸塞出行调查、全国入户出行调查的 KS 分别为 0.23 和 0.59。论文指出,一日调查很少报告超过 12 小时的停留,而模拟使用了活跃手机用户的记录;这类长停留在图 5A 的累积分布里最高可占到数据的 20%。因此 0.59 里有很大一块来自测量口径:问卷一天和手机会跨过夜晚的停留,记的不是同一段时间。每日地点数接近得多,相对两项调查的 KS 为 0.07 和 0.23。
出行距离只与马萨诸塞调查比较,KS 为 0.24。模型在返回已访地点时不考虑距离,长距离行程偏多。全国调查的距离没有拿来比,因为出行距离直接依赖城市形态,而全国样本跨过许多城市。
家到工作的总人次与波士顿地区大都会规划组织 2010 年模型相比,164 个市镇之间的相关系数是 0.90,市镇内部是 0.99。相关系数比较的是各市镇对上的人次排得是否一致,不是每一条通勤都被配对成功。家到其他地点、以及其他地点之间的行程,差别更大;主文没有给出这两类的相关系数。出发时刻的总份额与 2009 年全国调查、2010 年马萨诸塞调查整体接近,傍晚非家目的地之间的出发多于调查所报。分目的的细比较在补充图里,主文没有列出各目的的百分比。
生成得像统计,仍然留着四条用图划出的边界
第一,输入是活跃用户的不完整停留。超过 2 天的停留被删除,电话沉默造成的漏记也不会自动补成观测。图 4 的两种生成可以都像这套规则,同时对应不同的一天。
第二,α、ρ、γ 全体共用,时间参数又被假设与当前地点无关。6 周数据撑不起每人的排序指数。换一座排序斜率不同的城市时,沿用 0.86 缺乏正文里的跨城检验。论文把跨城市、跨人口组的参数差异列为后续问题。
第三,返回旧地点不看距离,所以图 5I 的长距离偏高是机制里写明的缺口。排序只约束探索新地点。
第四,与调查最接近的是家到工作的市镇人次,以及每日地点数。停留时长受 12 小时以上停留的影响,其他目的和傍晚的非家行程差得更多。通勤相关系数高,说明这张家到工作的表与规划模型同向;它没有单独证明零售、办事或夜间活动也已经校准完成。
工作日程仍是输入,不是被三个参数预测出来的。土地利用情景在框架上可做,主文完成的是现有波士顿结构下的越格概率,不是一块用地改变后的政策评估。
一句话总结
稀疏手机记录可以靠家、工作地和三个个人速率,加上按远近排序的探索,生成接近大波士顿通勤总量和若干出行分布的轨迹;这些轨迹衡量的是分布和市镇人次,不是某人漏记的那一次停留。
核心来源
- PNAS 在线论文,核对题目、作者、2016 年 8 月 29 日在线发表、卷 113、页码 E5370–E5378 与 DOI 10.1073/pnas.1524261113。
- 2016 年 10 月 24 日勘误,只更正印刷标题中的 motility,正式题目为 mobility。
- 主文注明补充材料位于 PNAS 的 DCSupplemental 页面。停留提取、通勤者节律、全体每日网络、扩样步骤和分目的对照图的细节在补充材料中;上面的数值均来自主文和图。
作者声明存在利益冲突:工作属于一项待批专利的一部分,麻省理工学院案号 18887,名称为 UrbanFlows: Improving Urban Traffic Without Surveys,由 Marta C. González 提出。
作者介绍
六位作者的单位以论文署名为准。Jiang 与 Yang 对本文贡献相同。
- Shan Jiang:麻省理工学院土木与环境工程系。参与研究设计、数据分析与写作。
- Yingxiang Yang:同一学系。参与研究设计、研究实施、数据分析与写作。
- Siddharth Gupta:同一学系。参与研究实施与数据分析。
- Daniele Veneziano:同一学系。参与研究实施与写作。文中的层级乘法级联接在他与 González 2010 年关于供给和需求空间模型的出行距离分析之后,即参考文献 38。
- Shounak Athavale:福特汽车公司帕洛阿尔托研究与创新中心。参与研究实施。
- Marta C. González:通讯作者,隶属土木与环境工程系和高级城市研究中心,邮箱为论文所载 martag@mit.edu。参与研究设计、研究实施与写作。个体访问规律、探索与偏好返回、每日出行网络,分别对应她参与的参考文献 13、14 和 19。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要把波士顿的 α=0.86 用到另一座城市,先要单独检查那里的目的地排序曲线。时间参数可以因人而异,空间指数在本文却是全市一个数。一座城市若把大量就业集中在更远的少数中心,同样的 k=1 会对应更长的距离;只调 n_w 和 β₁,改变的是出门次数和停留长短,不会自动改写这条空间队形。
另一个可检验的用法是把图 4 的两次生成当成预测区间,而不是两份候选日记里挑好看的一份。稀疏用户在 β₂ 从 23 增到 73 时,一天的地点数明显变多。需要某一个人下周二行程的应用,至少应同时报告参数网格上其他合格组合的分布。只输出一次抽样,会把校准目标里 η=0.035 的取舍藏进一条看似确定的路线。
通勤人次的 0.99 也不适合直接外推到傍晚的非家活动。主文已经看到后者多于调查。若规划问题是晚间商店或社区设施该放在哪一级格子里,应先重做其他目的的市镇对照,再谈是否减少问卷。家到工作的高相关回答的是通勤总量,细格子上的其他用地仍会通过排序改变探索距离。