卫星图里的街区样子,能不能估出上班的人往哪流?
论文名片|Yichen Xu、Song Gao、Qunying Huang、Aslıgül Göçmen、Qiang Zhu、Feng Zhang,Predicting human mobility flows in cities using deep learning on satellite imagery,Nature Communications,2025,16:10372。2024年10月21日收稿,2025年10月13日接收,2025年11月24日在线发表。DOI:10.1038/s41467-025-65373-z。
纽约都会区里,两个普查区之间有多少人从家去上班,通常要等人口普查的通勤统计。统计更新慢,个人手机轨迹又涉及隐私。一个省事的想法是:房顶、道路和绿地已经印在卫星图上,再配上两地距离,人流也许就能估出来。
这项研究在美国十个最大的都会统计区(metropolitan statistical area,MSA)上试了这件事。模型叫 Imagery2Flow。输入主要是 10 米或 30 米卫星图,以及普查区之间的邻接关系。在同一座都会区内部,它把已经有至少 10 名通勤者的家—工作联系估得相当接近调查;换到地表和城市形态不像的另一座都会区,直接沿用权重就会明显变差。它估的是普查区之间的通勤流量,不是一个人一天的轨迹,也不是所有可能的街区组合。
先说结论
- 评估对象是 2020 年 LODES 通勤调查里、两个人口普查区之间至少 10 名通勤者的联系。十个都会区图注中的条数相加为 568,769 条。纽约有 4,953 个普查区、120,559 条联系,平均每条 22.3 人,中位数 16 人。
- 同一都会区内,用 10 米影像的 Imagery2Flow-LGBM,十城 CPC 为 0.80 到 0.84。纽约的 RMSE 是 13.44 人、MAE 是 7.36 人,分母是这 120,559 条保留联系,不是全部普查区配对。
- 相对直接使用同一套图像特征的树模型,论文概括 RMSE 降低 4.5% 到 13.9%。两端可以在表 1 对上:纽约相对 LGBM 是 (14.07−13.44)/14.07,芝加哥相对 XGBoost 是 (25.26−21.74)/25.26。
- 通勤距离分布更接近指数衰减。图 3 红线的 λ 从达拉斯 0.052 到纽约 0.106。λ 与紧凑度、中心性的 Pearson 相关约在 0.6 到 0.8,其中人口密度 0.74、就业指标 0.70,都是十个都会区、p 值小于 0.05。
- 双线性模型换城市时,市内对角线 CPC 仍是 0.76 到 0.80,但洛杉矶训练、亚特兰大测试只有 0.03,反向是 0.00。用 2020 年权重去读约十年或二十年前的影像,十城 CPC 仍不低于 0.67,纽约 RMSE 则从 13.44 升到 2010 年的 21.02 和 2002 年的 22.72。
被估的是普查区之间的上班人数
人类移动性(human mobility)在这里不是搬家,也不是手机上一天的地点序列。地面真值来自美国人口普查局 2020 年就业起讫统计 LODES:家在哪个普查区,工作地在哪个普查区,中间有多少通勤者。起讫流量(origin–destination flow,OD 流量)的分析单位是一对普查区,流量是人数。
少于 10 名通勤者的联系被删掉,理由是它们不容易代表稳定的两地联系。因此后面的误差都站在保留下来的联系上。纽约 4,953 个普查区若两两都算,配对数量会到千万级;论文没有报告模型对零流量或 10 人以下联系的识别。平均 22.3 人、中位数 16 人,也只描述这 120,559 条保留联系。
十个都会区按图 3 图注的保留条数是:纽约 120,559,洛杉矶 68,712,芝加哥 67,090,达拉斯 57,311,休斯敦 40,628,华盛顿 46,261,费城 45,025,迈阿密 39,593,亚特兰大 43,147,凤凰城 40,443。后文用中心城市简称,指的都是整个都会统计区,不是市界以内。
每个都会区按普查区人口做分层抽样,60% 训练、20% 验证、20% 测试,再用五折交叉验证把预测铺满全城。测试折里的普查区不会作为训练流量的起点出现。它们仍可能在训练时当过终点,所以这是未见起点,不是从未见过的地块。距离用普查区质心之间的驾驶路线长度,由 OSRM 计算,单位是米;图上画成公里。这不是地图直线距离。
影像是 Sentinel-2 的 10 米数据和 Landsat-8 的 30 米数据,在 Google Earth Engine 里去掉云和云影。一幅都会区要拼多景,同一座城市里的影像季节可能并不一致。
图像先自己学,流量再靠邻接图来估
模型分三步。第一步不看通勤人数。同一普查区的卫星图做两次随机裁剪、缩放到 224×224 并扰动颜色,对比学习把这两张视图拉近,把其他普查区推远。实验骨干是 ViT-L/16。公式里出现的 ResNet 是编码器的写法示例,不是最终选用的网络。嵌入训练 120 轮,温度参数 0.5。
第二步把普查区当成节点,地理上相邻就连边,边的特征是驾驶距离。图注意力网络(graph attention network,GAT)用三层、512 维,让每个节点按邻居的重要程度更新自己的表示。第三步有两个解码器。双线性层只用起点和终点的向量估流量;变体 Imagery2Flow-LGBM 再把这两个向量和距离交给 LightGBM。后文的 LGBM 变体因此多看了一次距离,也换成了树模型,不能把 CPC 从 0.79 升到 0.83 只记成同一网络多训了几轮。
流量分布很偏,少数联系特别大。训练时对流量取以 2 为底的对数,并用批次蒙特卡洛损失对付这种不平衡。论文说它优于均方误差,正文没有给出两项损失的具体差值。
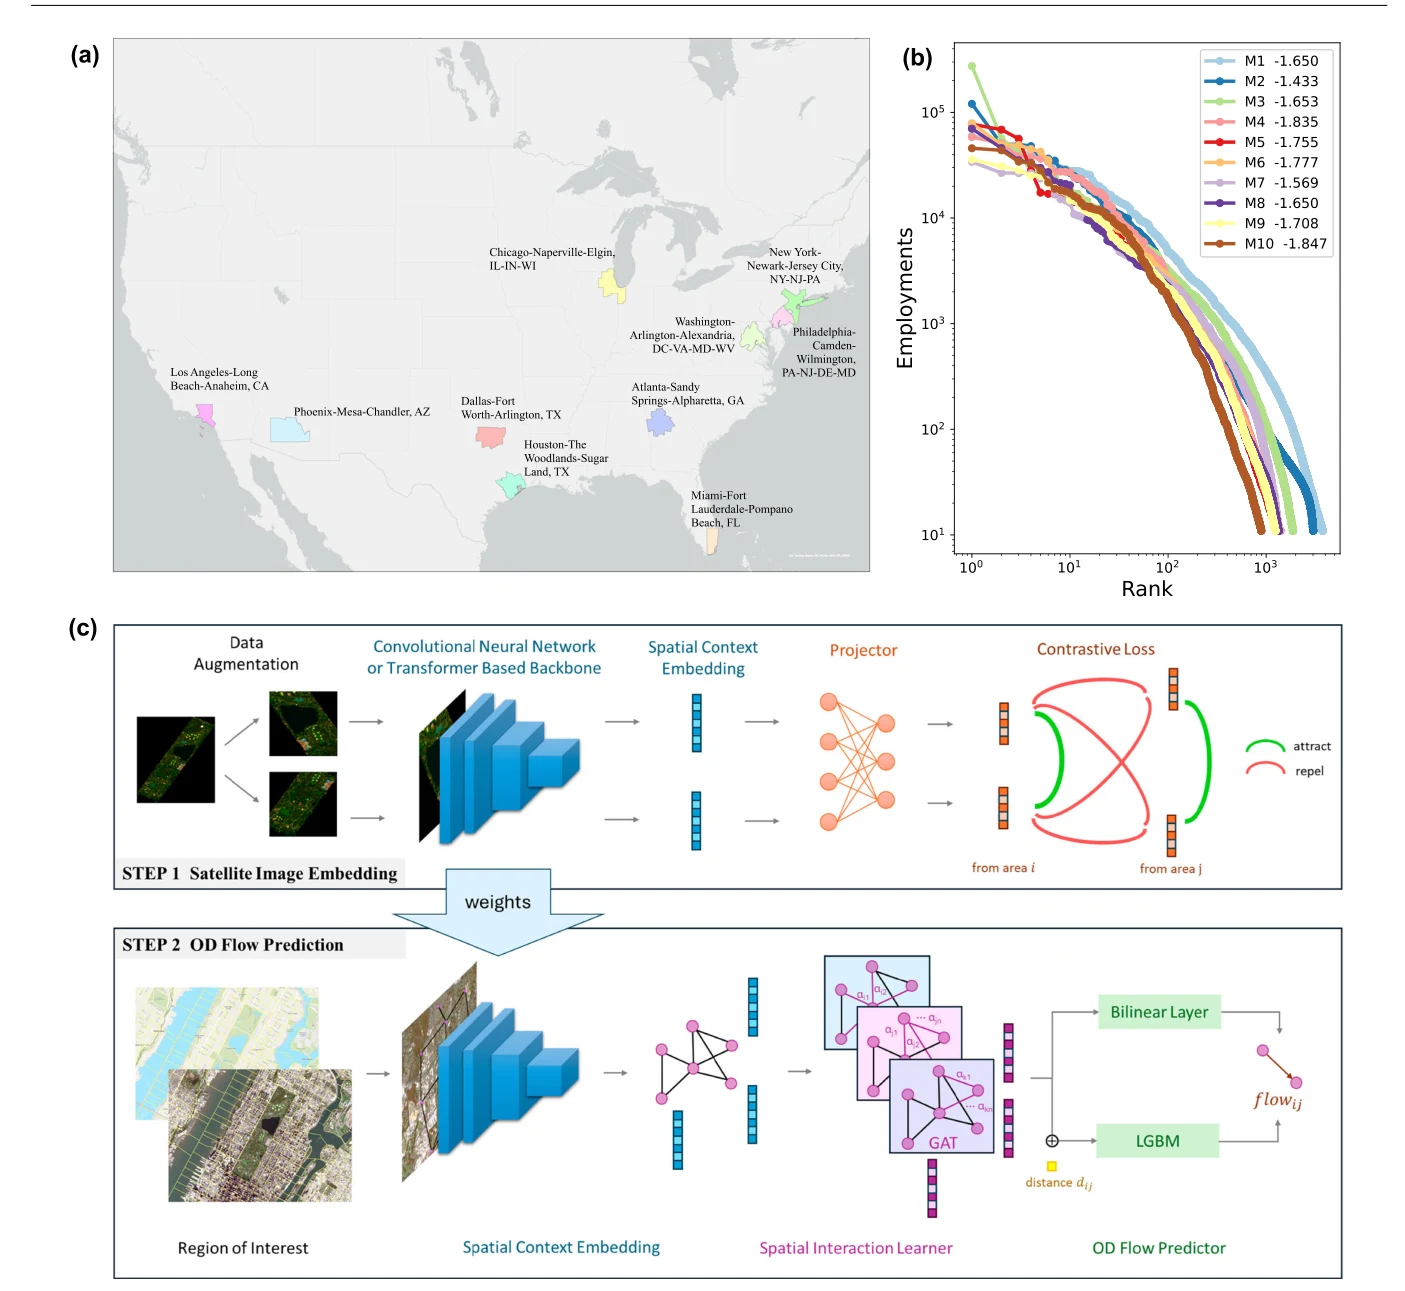
图 1|卫星图和邻接关系怎样变成一条通勤流量?
(a)十个都会统计区的位置,M1 到 M10 依次是纽约、洛杉矶、芝加哥、达拉斯、休斯敦、华盛顿、费城、迈阿密、亚特兰大和凤凰城。(b)各普查区就业人数对位序的双对数图,图例斜率都是负数,洛杉矶标为 −1.433,凤凰城标为 −1.847;纵轴就业人数,横轴位序。(c)上半是图像对比学习,下半是邻接图上的注意力编码,再分双线性层或 LGBM 输出流量。来源:原论文 Fig. 1。
正文把更负的斜率解释成就业随位序下降更慢、因而更多中心。按对数斜率的通常读法,−1.847 比 −1.433 更陡,下降更快。图例本身没有改写这个符号。后面和 λ 相关的就业指标是另一个量,数值只在补充图里,正文给出的是相关系数 0.70。
同一座城市里,它比旧模型好多少?
表 1 把每个都会区单独训练、单独测试。CPC(common part of commuters,通勤者公共部分)是
2 × 各条联系上真实与预测的较小值之和 /(真实总人数 + 预测总人数)。
它接近 1 表示两边的人流量叠合得多。0.83 不是 83% 的普查区对被完全猜中。RMSE 和 MAE 的单位是这条联系上的通勤人数,分母是该都会区保留下来的 OD 条数。五折铺满全城,所以纽约的分母是 120,559,不是其中一折的 20%。
纽约这一列最容易看清对照。辐射模型 RMSE 50.44、MAE 25.61、CPC 0.16。引力模型 RMSE 50.58、MAE 24.72、CPC 0.02。只用水人口和距离的深度引力模型 Deep Gravity-P 是 26.60、19.61、0.22。换成 10 米图像特征的 Deep Gravity-V 升到 CPC 0.67,RMSE 18.48。Imagery2Flow 双线性解码是 16.47、8.97、0.79;LGBM 解码是 13.44、7.36、0.83。
深度引力模型在估计时使用每个起点已知的总流出。Imagery2Flow 的测试没有把这个总流出当成已知约束。SIGCN 的图还按已知流量来连边。因此 0.83 对 0.22 不是同一信息量下的比赛,方向是:少用这项流量约束的图像模型,误差仍然更低。论文也写明,总流出未知时,深度引力那种高表现拿不到;SIGCN 依赖已知流量建图,换城时更受限制。
直接把起点图像、终点图像和距离拼起来的树模型已经不差。纽约 10 米 LGBM 的 RMSE 是 14.07,XGBoost 是 14.33,CPC 都是 0.83。加上图网络之后,纽约 RMSE 再降到 13.44,相对 14.07 是 4.5%。芝加哥 XGBoost 的 RMSE 是 25.26,Imagery2Flow-LGBM 是 21.74,相对下降 13.9%。MAE 的两端是:洛杉矶相对 XGBoost,(7.82−7.72)/7.82,约 1.3%;休斯敦相对直接 LGBM,(11.47−10.23)/11.47,约 10.8%。CPC 的相对升幅,论文写的是 1.3% 到 2.6%;休斯敦从直接 LGBM 的 0.78 到 0.80,除以 0.78 就是约 2.6%。这些百分比的分母是对照模型自己的指标,不是通勤人数。
GMEL 同样用图嵌入再加梯度提升,和本文最接近。10 米结果里,它相对 Imagery2Flow-LGBM 的 RMSE 高出幅度最低出现在纽约:(13.83−13.44)/13.83,约 2.8%。深度引力图像版和 SIGCN 的最低高出幅度,分别是芝加哥 (28.43−21.74)/28.43,约 23.5%,以及凤凰城 (17.26−13.50)/17.26,约 21.8%。这是各模型最接近本文的那一座城市,不是十城平均。
十个都会区里,10 米 LGBM 变体的三项指标如下。CPC 一列的分母都是该城真实总人数与预测总人数之和。
| 都会区 | 保留 OD 条数 | RMSE | MAE | CPC |
|---|---|---|---|---|
| 纽约 | 120,559 | 13.44 | 7.36 | 0.83 |
| 洛杉矶 | 68,712 | 14.90 | 7.72 | 0.84 |
| 芝加哥 | 67,090 | 21.74 | 9.42 | 0.82 |
| 达拉斯 | 57,311 | 15.54 | 8.76 | 0.82 |
| 休斯敦 | 40,628 | 20.48 | 10.23 | 0.80 |
| 华盛顿 | 46,261 | 15.45 | 9.02 | 0.83 |
| 费城 | 45,025 | 14.30 | 8.23 | 0.83 |
| 迈阿密 | 39,593 | 14.71 | 8.34 | 0.83 |
| 亚特兰大 | 43,147 | 12.51 | 7.29 | 0.84 |
| 凤凰城 | 40,443 | 13.50 | 7.49 | 0.84 |
迈阿密是例外:30 米 LGBM 的 RMSE 14.38、MAE 8.20、CPC 0.84,三项都好于上表的 10 米结果。其余九城是 10 米的 RMSE 和 MAE 更低,CPC 持平或更高。分辨率从 30 米提到 10 米有帮助,但没有差到换一种模型的程度。表 1 里达拉斯和休斯敦的引力模型都印成 RMSE 135.98、MAE 37.74、CPC 0.03,两城三项完全相同;正文没有解释这个重合。
图像特征也优于论文用来对照的 OpenStreetMap 兴趣点计数,双线性解码和 LGBM 解码都是如此。正文没有列出兴趣点那一版的 RMSE。兴趣点在曼哈顿和在新泽西郊区的完整程度本来就不一样,卫星图则盖住整个都会区。
人少的地方会不会突然估不准?
纽约的结果被拆开看。图 2 的分母仍是这 120,559 条联系、4,953 个起点普查区。人口十分位是把普查区按人口排序后等分成十组:第 1 组是人口最多的 10% 个普查区,第 10 组最少。这不是把总人口切成十等份。
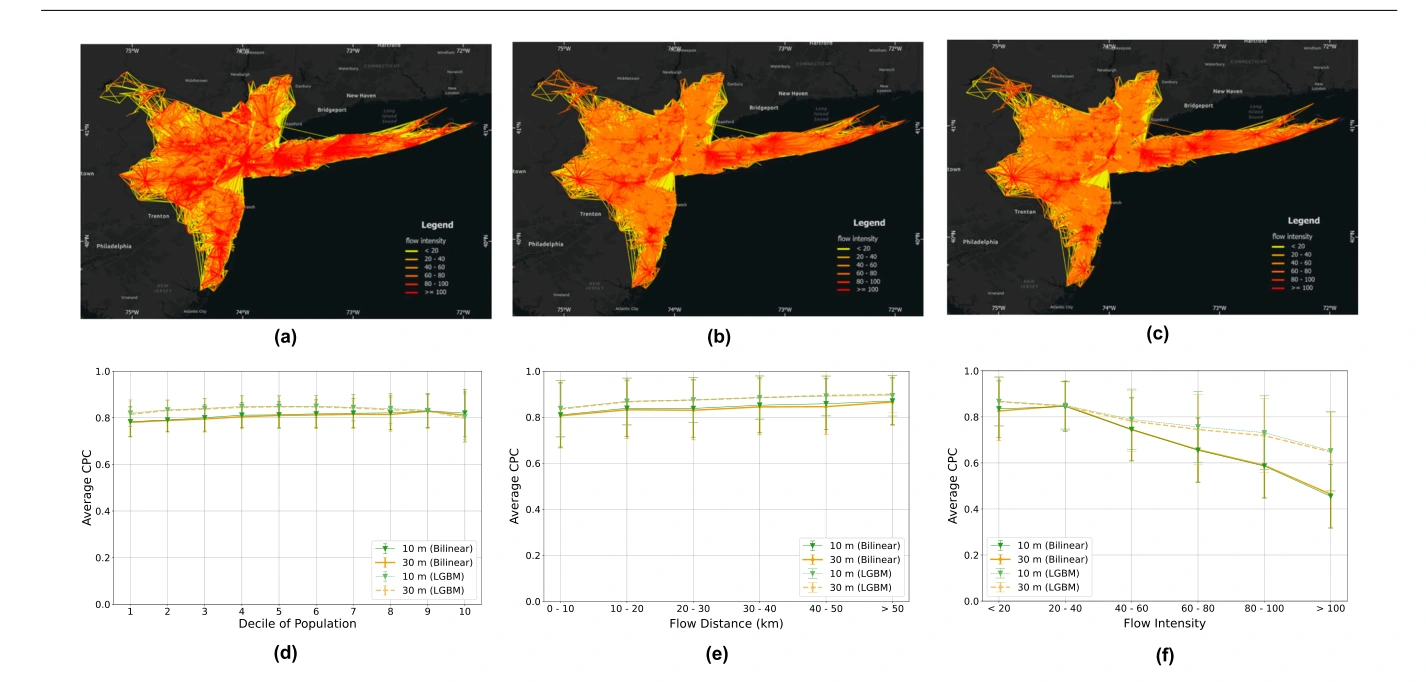
图 2|纽约都会区里,误差会不会只出在某一种联系上?
(a)调查通勤流量。(b)10 米影像、LGBM 解码的预测。(c)30 米影像、LGBM 解码的预测。三张图的颜色表示流量强度,从不超过 20 人到超过 100 人。(d)横轴是起点人口十分位,纵轴是平均 CPC。(e)驾驶距离分为 0–10、10–20、20–30、30–40、40–50 和大于 50 公里。(f)流量强度分为小于 20、20–40、40–60、60–80、80–100 和大于 100 人。误差线是各起点 CPC 的标准差,不是均值的置信区间。来源:原论文 Fig. 2。
人口从高到低,平均 CPC 大体停在 0.8 附近,没有随郊区人口变少而塌掉。LGBM 在前九个十分位高于双线性解码,到人口最少的一组才略低于双线性解码。距离六个档也都保持较高 CPC,远距离没有单独失效。
强度一变,差别就出来了。低强度两档的平均 CPC 明显高于大于 100 人的一档;图上没有逐点标数。正文给出的可核对结果是,高强度下 LGBM 仍能达到 0.6,双线性解码下降得更多。误差线是各起点 CPC 的标准差,所以 0.6 是起点之间的平均,不是每一条大流量都达到 0.6。大流量更难,是因为训练集里小流量占绝大多数。
距离衰减跟城市形状有关吗?
十个都会区的通勤距离分布都更接近指数,而不是幂律或截断幂律。这个选择用赤池权重做,具体权重在补充表,正文只确认指数形式更好。预测分布和调查分布的 KL 散度、JS 散度被说成很小,正文同样没有写出数字。
拟合写成 P(d) ~ e^(−λd),d 是公里。λ 越大,长距离通勤在这条指数里掉得越快。图上的 λ 是:纽约 0.106,洛杉矶 0.088,芝加哥 0.072,达拉斯 0.052,休斯敦 0.061,华盛顿 0.075,费城 0.099,迈阿密 0.083,亚特兰大 0.062,凤凰城 0.058。达拉斯最小,纽约最大。每多 1 公里,指数密度要乘上 e^(−λ):达拉斯约 0.949,纽约约 0.899。这是拟合曲线的衰减因子,不是调查里数出来的人数比,也不是距离翻倍、人数减半。
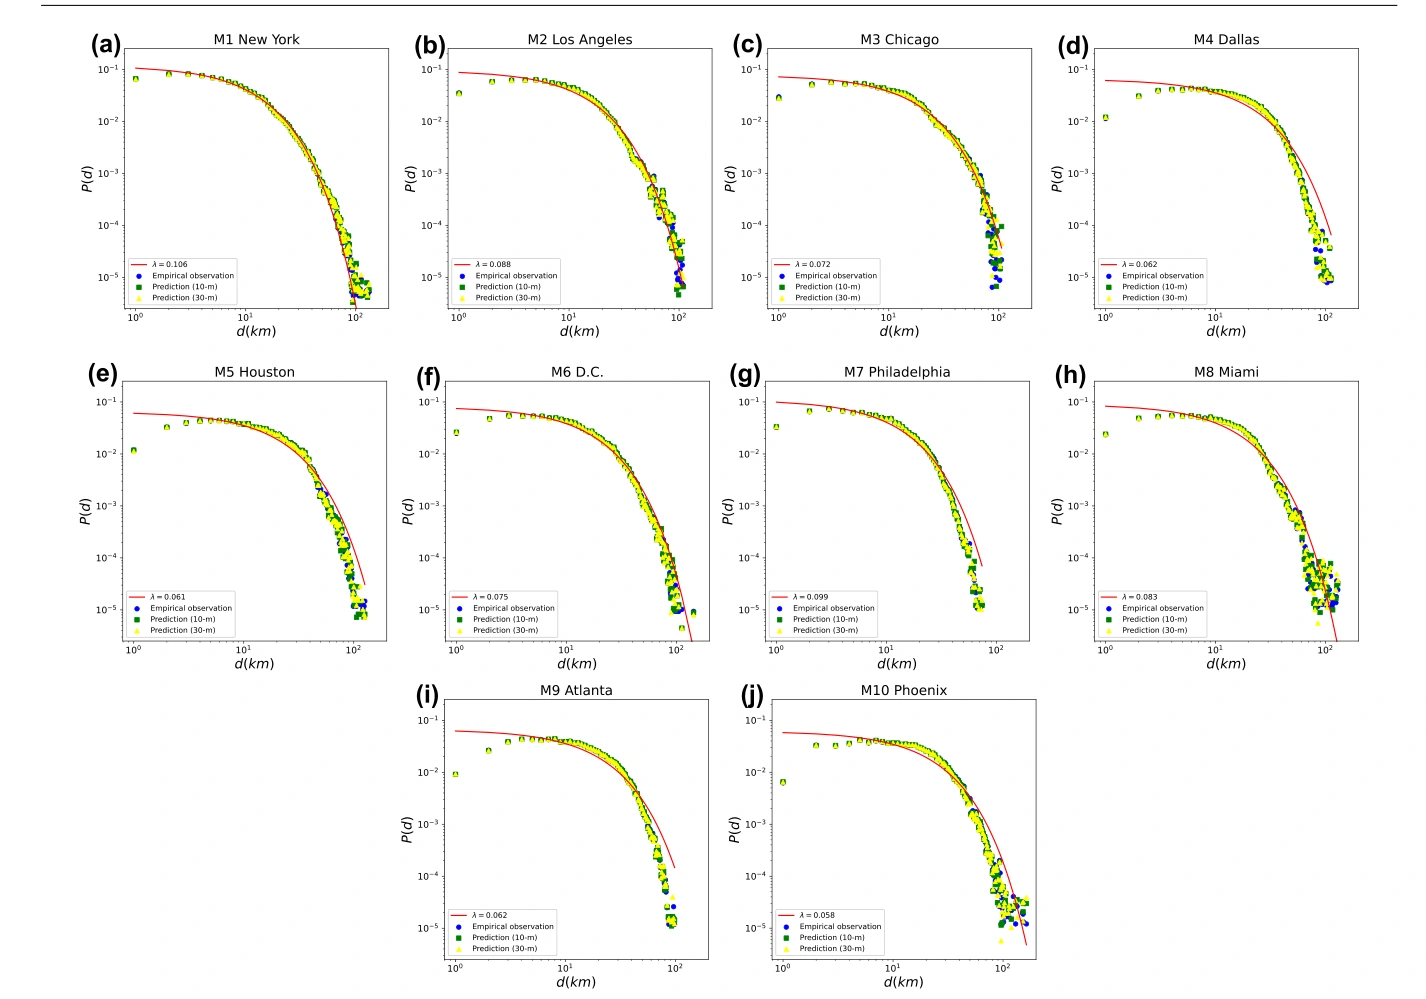
图 3|十座都会区的通勤距离,是不是同一条衰减?
(a)纽约,λ = 0.106,120,559 条。(b)洛杉矶,0.088,68,712 条。(c)芝加哥,0.072,67,090 条。(d)达拉斯,0.052,57,311 条。(e)休斯敦,0.061,40,628 条。(f)华盛顿,0.075,46,261 条。(g)费城,0.099,45,025 条。(h)迈阿密,0.083,39,593 条。(i)亚特兰大,0.062,43,147 条。(j)凤凰城,0.058,40,443 条。横轴驾驶距离的公里数,对数刻度;纵轴概率密度。红线是对调查分布的指数拟合,点是调查和两种分辨率的预测。来源:原论文 Fig. 3。
近处 1 公里附近,好几座城市的调查点低于红线。一条 λ 概括的是整段距离上的指数拟合,不是第一公里的人数。
λ 再拿去和城市形态做相关,样本只有这十个都会区。紧凑度用 Boyce-Clark 形状指数:从都会区质心以相等角度射出 36 条射线,看半径是否整齐。各半径越接近,指数越低;0 对应正圆,形状越不规则指数越高。正文给出的公式是各射线相对长度偏离均等份额的绝对值之和。BCSI 与 λ 正相关:形状越不规则,λ 越大,长距离通勤的指数份额越少。作者的解释是,更接近圆形时,各方向半径更匀,长距离通勤的成本更低,所以长距离比例更高。
这和一项用手机数据、看个人回转半径的旧研究相反。论文给出三种可能,都不是新的因果检验:手机数据包含多种日常活动,通勤调查的活动类型和频率是固定的;这里的距离是两个普查区质心之间的距离,有聚合;各城出行方式和对长距离的偏好也不同。
中心性看两件事。人口密度从低到高时,论文引用既有研究说城市会从单中心走向多中心。就业则用图 1b 的位序曲线。λ 与人口密度的相关是 0.74,与就业指标是 0.70,p 值都小于 0.05。正文又说,多中心城市的长距离通勤成本更低。十个点、两个正相关,加上图 1b 斜率方向和正文那句更负等于下降更慢并不一致,所以这里只能保留相关,不能当成多中心已经降低了通勤成本。
误差为什么堆在市中心和某些用地上?
全市一个 CPC 会把位置抹平。纽约的起点误差地图显示,郊区更接近零误差,中心和若干圈出来的地区更容易大幅高估。高值饱和在遥感估算人口、植被和碳排放时也常见。其余九城,正文的概括同样是郊区更准、中心更差,没有在正文逐城列出 CPC。
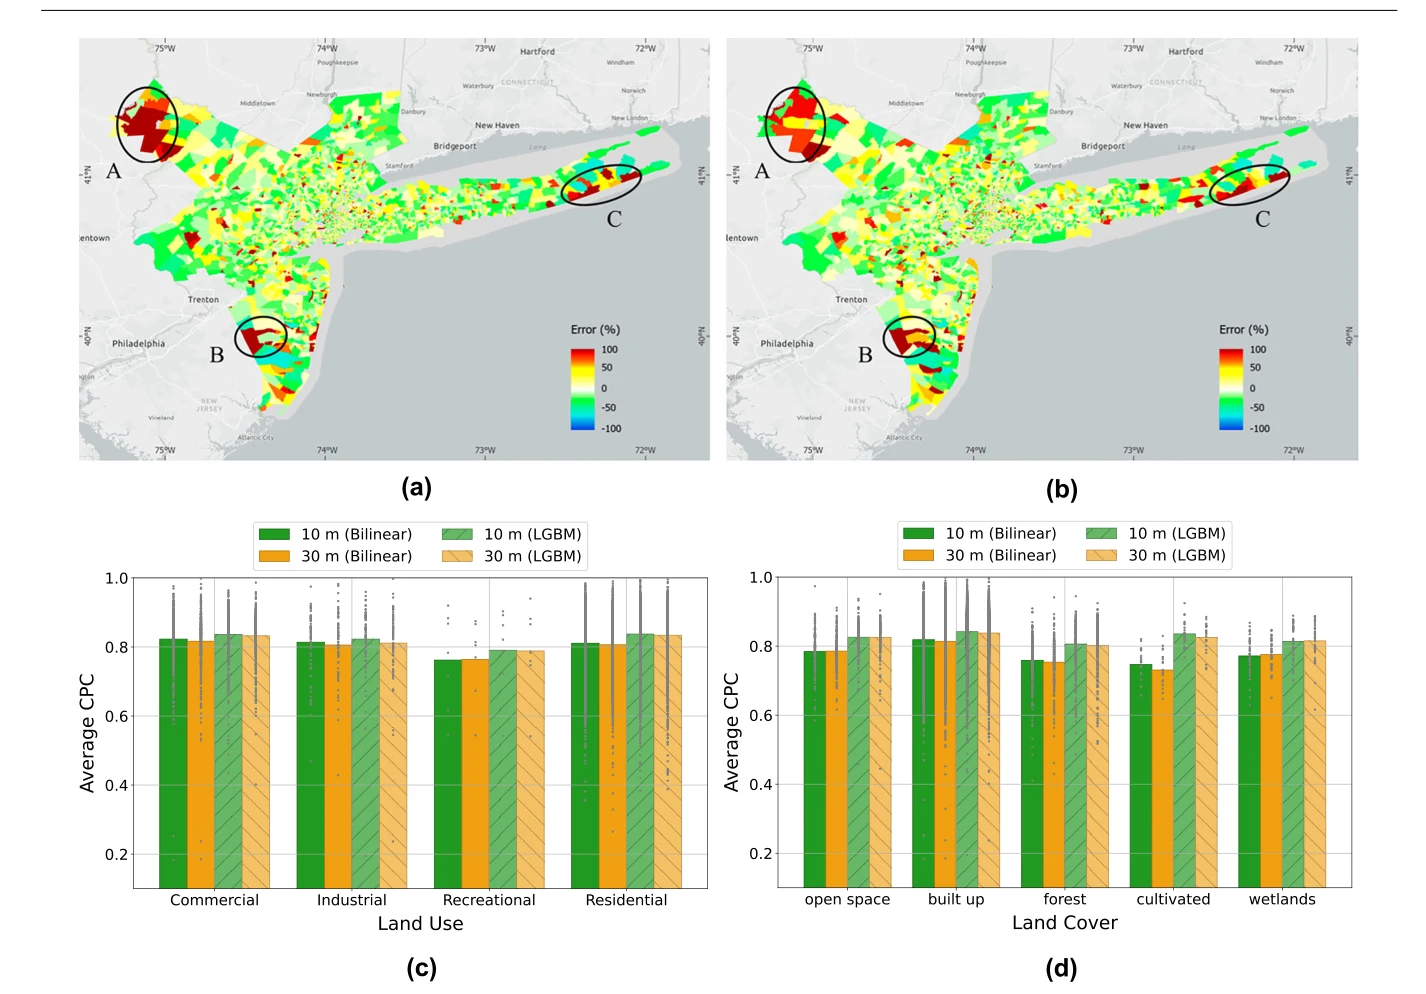
图 4|纽约的误差贴着哪一类地方?
(a)10 米影像、LGBM 解码,按起点画出的流量误差百分比,红为高估,蓝为低估,色标到 ±100%。(b)30 米影像的同一地图。A 是植被覆盖,B 是功能混杂的用地,C 是社会经济差异较大的地区;三个圈分别落在都会区西北、中南部和长岛东端,正文没有给出圈内普查区名单。(c)按起点主导土地利用分组的平均 CPC:商业、工业、休闲、居住。(d)按主导土地覆盖分组:开放空间、建成区、森林、耕地、湿地。灰色竖线是组内起点的离散程度。共 4,953 个起点。来源:原论文 Fig. 4。
(c)(d)没有标出每个柱的数字。可见休闲用地低于商业、工业和居住,建成区高于森林和耕地。竖线很长,同一地类内部的起点可以差很多,柱高差不是稳定的地类效应。正文强调的是另一面:植被在图像里样子多,森林和湿地更难;学校、机场、工业和商业建筑可能长得像住宅或办公,模型就会高估人流。中位年龄大于 55 岁的家庭所在地区也被明显高估。年龄、收入和族裔没有进入模型,这个高估是残差里看出来的模式,不是模型学会了年龄。
土地利用来自 2015 年 HISDAC-US,土地覆盖来自 2020 年 NLCD。流量和覆盖是 2020 年,用地早了五年。分组按起点的主导地类,一条流量的终点可以是另一种地类。
换一座城市,权重还能用吗?
迁移实验的读法要先分开。图 5 的横轴是训练城市,纵轴是拿去测试的城市。对角线是在本城训练、本城测试。双线性模型把学到的权重直接用到另一座城市,测试时要有该城的卫星图和普查区邻接图。LGBM 变体在迁移时会重新训练解码器;正文没有写明重训用了多少目的城市样本。有监督解码器若用当地流量来重训,(c)(d)更高就不能理解成和双线性模型同一种零样本换城。
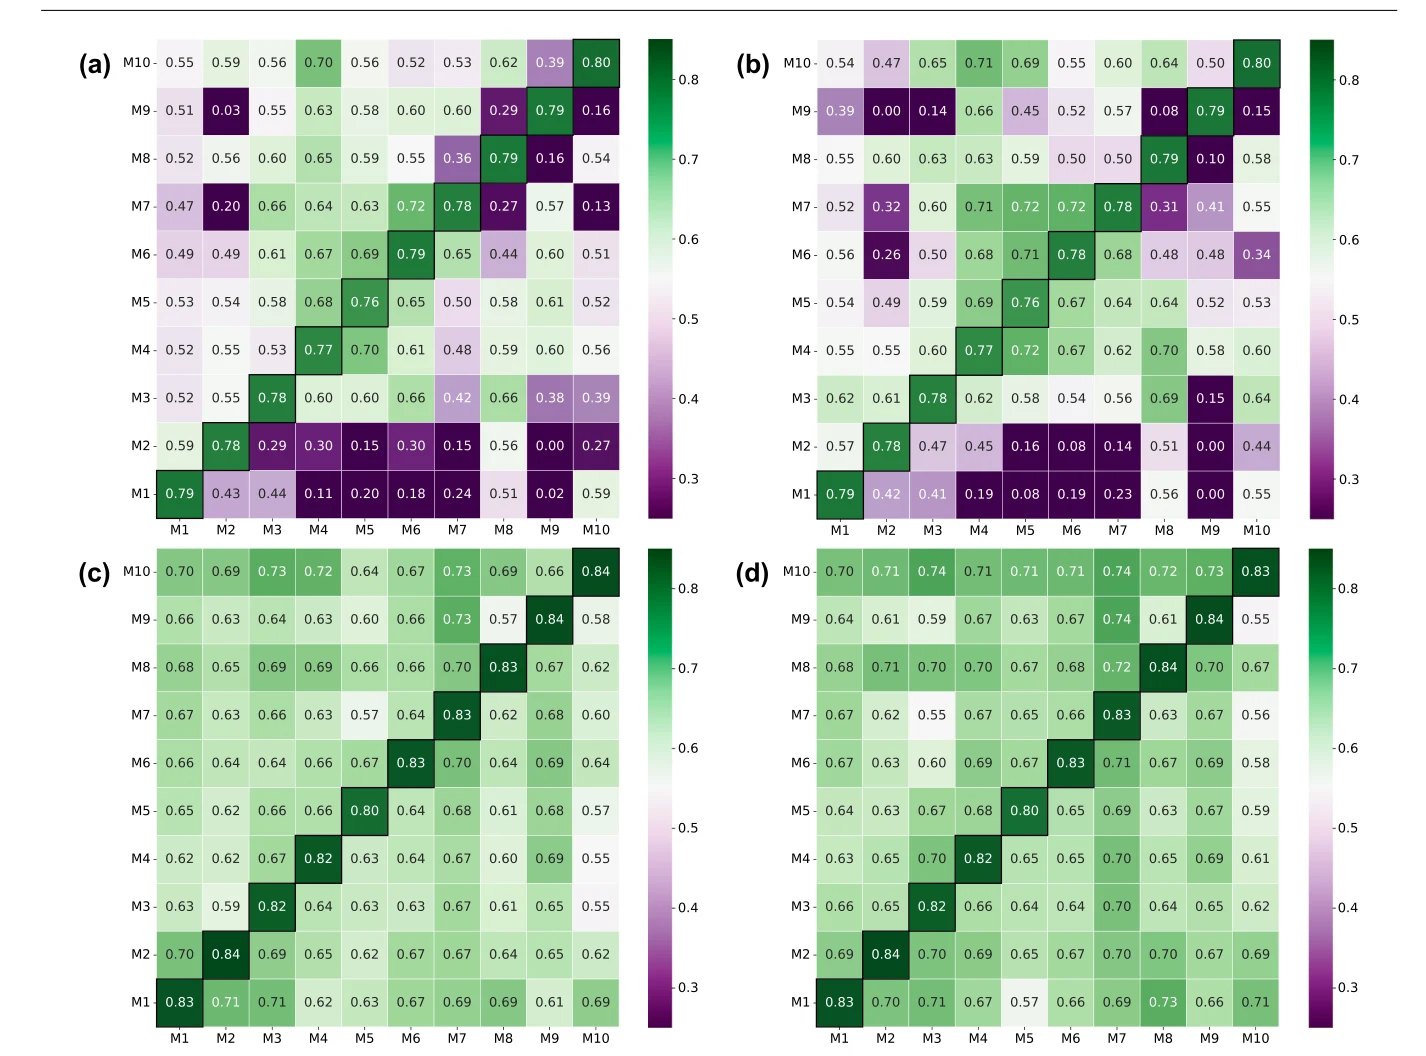
图 5|在一座都会区学到的权重,换到另一座还剩多少 CPC?
(a)10 米影像,双线性解码。(b)30 米影像,双线性解码。(c)10 米影像,LGBM 解码。(d)30 米影像,LGBM 解码。行是测试城市,列是训练城市,颜色和数字都是 CPC。对角线与表 1 的市内结果一致。来源:原论文 Fig. 5。
10 米双线性的市内对角线是 0.76 到 0.80。跨城则很散。达拉斯训练、休斯敦测试是 0.68,反向是 0.70。华盛顿训练、费城测试是 0.72,反向是 0.65。洛杉矶训练、亚特兰大测试是 0.03,反向是 0.00。迈阿密到亚特兰大是 0.29,反向是 0.16。费城到纽约是 0.24,华盛顿到纽约是 0.18。同一对城市两个方向也不对称,例如达拉斯到纽约是 0.11,纽约到达拉斯是 0.52。
10 米 LGBM 的对角线升到 0.80–0.84,跨城大多落在 0.55 到 0.73。达拉斯到休斯敦是 0.66,反向 0.63;华盛顿到费城是 0.64,反向 0.70;洛杉矶到亚特兰大是 0.63,反向 0.65。底部被抬高了,但仍然低于本城结果。解码器经过重训,这组数字不能和(a)(b)的直接换城放在同一种零样本比较里。
土地覆盖解释了一部分。图 6 没有标出百分比,只能看相对构成。迈阿密的湿地面很大,凤凰城和亚特兰大的森林很长,芝加哥的耕地块很大,达拉斯有一大段草本。华盛顿和费城的分段更像:开放空间、建成区、森林,然后是耕地。洛杉矶—亚特兰大、迈阿密—亚特兰大的主导覆盖不同,双线性 CPC 也极低。可是达拉斯和休斯敦的主导覆盖并不相同,迁移却较好;费城、华盛顿和纽约若只看主要覆盖,并不能解释它们到纽约时的低 CPC。
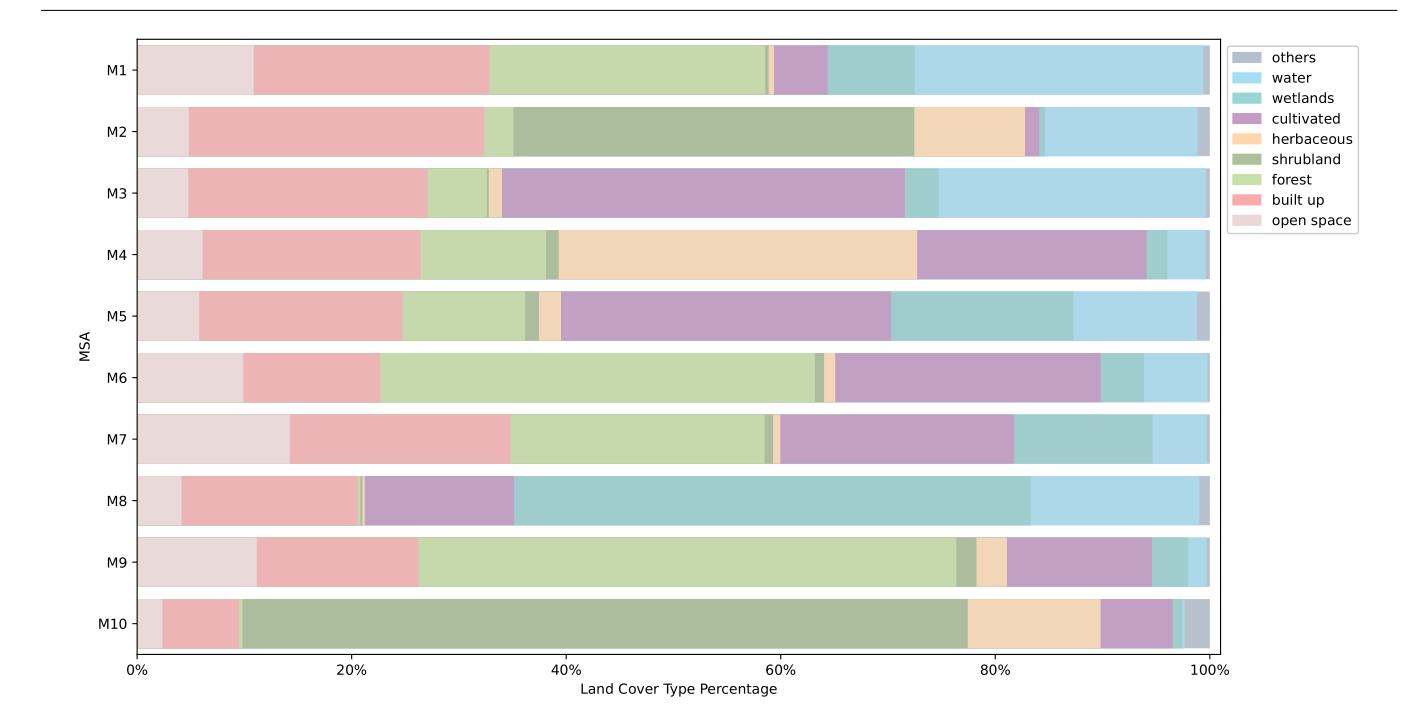
图 6|十个都会区的土地覆盖构成差在哪里?
无字母子图。每一行是一个都会区,横轴是各类覆盖占该都会区的百分比。图例从下到上的阅读顺序对应开放空间、建成区、森林、灌丛、草本、耕地、湿地、水体和其他。各行没有印出分类数值。来源:原论文 Fig. 6。
论文借用 2014 年对美国都市蔓延的三分法,把这十个都会区放进三类,用来补土地覆盖解释不了的部分。洛杉矶、芝加哥、迈阿密、亚特兰大和凤凰城被归为强度较低、最紧凑、混合较少、单中心较弱。纽约、达拉斯和休斯敦被归为强度更高、更紧凑、混合更多、多中心。华盛顿和费城被归为强度最低、紧凑度较低、混合最多、最单中心。达拉斯—休斯敦、华盛顿—费城正好落在同一类里。洛杉矶和亚特兰大也在同一类,迁移却很差,所以类型相同并不足够,还要看覆盖是否相像。类型本身来自那篇都市形态研究,不是 Imagery2Flow 新算出来的。
30 米的跨城格子不会一律比 10 米更好。论文的判断是,拼图时的云、阴影和季节,比分辨率更影响换城表现。
十年前的影像,还能对上当时的通勤吗?
时间迁移用的是各城在 2020 年训练好的 Imagery2Flow-LGBM,再去读更早的 Landsat 影像。2015 年以前没有 Sentinel-2,所以 2010 年和 2002 年用 Landsat-5。凤凰城最早可用的是 2004 年,不是 2002 年。华盛顿特区最早从 2010 年起有数据,因此 2002 年那一格只用都会区里另外三个州的流量来算,不含特区。
正文说十城 CPC 都高于 0.67。表 2 里最低就是 0.67,出现在迈阿密 2010 年、休斯敦 2002 年和迈阿密 2002 年。高于 0.67 这句话略强于表格:表格是不低于 0.67。
纽约 2020 年的 RMSE 是 13.44、CPC 是 0.83。同一套权重读 2010 年影像,RMSE 21.02、MAE 10.78、CPC 0.75;读 2002 年影像,RMSE 22.72、MAE 11.38、CPC 0.73。21.02 比 13.44 高 7.58,约 56%;22.72 约高 69%。分母是 2020 年纽约模型的 RMSE。分子是另一个年份、另一批通勤联系上的误差,不是同一批 OD 对测了两次。
其余城市 2010 年的 CPC 是:洛杉矶 0.77,芝加哥 0.70,达拉斯 0.73,休斯敦 0.72,华盛顿 0.68,费城 0.74,迈阿密 0.67,亚特兰大 0.75,凤凰城 0.75。2002 年(凤凰城为 2004 年)是:洛杉矶 0.75,芝加哥 0.69,达拉斯 0.69,休斯敦 0.67,华盛顿 0.69,费城 0.71,迈阿密 0.67,亚特兰大 0.73,凤凰城 0.73。
建筑变密、道路变多、建成区外扩,这类慢变化能被影像带着走。模型没有预测某一周的通勤,也没有用上一次流量当输入。短周期波动、罢工或新开通线路的头几个月,不在这个实验里。
这些数停在哪里
市内的 0.80 到 0.84,是在美国十个最大都会区、普查区尺度、至少 10 名通勤者的家—工作联系上,用五折铺满后得到的流量叠合。它不包含被删掉的小联系,也不证明模型知道哪些配对本来就没有人通勤。
图像编码器不看流量,流量解码器看过训练起点的流量。换城时,双线性权重是直接拿去用的;LGBM 解码器按正文会重新训练,正文没有写明当地样本的用量。两种迁移不能写成同一种零样本能力。
形态分析是十个都会区的相关。紧凑、多中心和 λ 的方向,论文给了解释,也给了和旧研究相反的理由,没有做改变城市形状后的对照。误差地图里的年龄和收入差异,是事后对照,不是模型输入。
土地覆盖是 2020 年,土地利用是 2015 年。影像季节在同一都会区内可能不一致。实验只在美国大型都会区。论文把下一步放在遥感和社会感知的融合,以及其他国家、其他尺度,这些实验还没有做。
一句话总结
在同一座美国大都会里,10 米或 30 米卫星图加上普查区邻接,可以把调查中至少 10 名通勤者的家—工作联系估到 CPC 约 0.80–0.84;换到地表和形态不像的城市,或者拿它去填调查里根本没有的联系,这个数就不成立。
核心来源
- Nature Communications 论文页面,核对题目、作者、2025 年卷期与收稿、接收信息。正文图 1–6、表 1–2 均出自该文。
- 通勤流量来自美国人口普查局 LODES,普查区边界来自 TIGER,影像为 Sentinel-2、Landsat-8 与 Landsat-5,驾驶距离由 OSRM 计算,土地覆盖为 2020 年 NLCD,土地利用为 2015 年 HISDAC-US。
- Imagery2Flow 代码,论文实验版本见 Zenodo:10.5281/zenodo.17156793。
作者介绍
- Yichen Xu:第一作者,署名浙江大学地球科学学院。威斯康星大学麦迪逊分校 GeoDS 实验室页面介绍他为浙江大学博士生、该实验室访问学生,本科毕业于浙江大学,研究兴趣是地理人工智能和时空数据挖掘。论文中负责收集数据、建立模型并完成实验。
- Song Gao:通讯作者,威斯康星大学麦迪逊分校地理系教授,GeoDS 实验室负责人。实验室页面列出的方向包括地理人工智能、人类移动性和空间网络。与 Feng Zhang 共同指导本研究。
- Qunying Huang:威斯康星大学麦迪逊分校地理系教授,空间计算与数据挖掘实验室主任。参与结果解释和写作。
- Aslıgül Göçmen:署名威斯康星大学麦迪逊分校地理系。地理系人员页写明为副教授,并列在地理系与 Nelson Institute for Environmental Studies。参与结果解释和写作。
- Qiang Zhu:署名浙江大学计算机科学与技术学院。参与结果解释和写作。
- Feng Zhang:通讯作者,署名浙江大学地球科学学院,以及自然资源部时空信息与智能服务重点实验室。与 Song Gao 共同指导本研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个没有通勤调查的城市只在卫星图上像休斯敦,图 5a 里达拉斯到休斯敦的 CPC 是 0.68,分母仍是两边人流量之和。0.68 不是 68% 的普查区对被猜中。用这个输出去决定一条轨道的站距之前,还要单独看最大的几条联系,因为图 2f 里大于 100 人时,LGBM 的平均 CPC 只到正文所说的 0.6,而且各起点的标准差很大。
另一个容易误用的地方是年龄。模型没有年龄输入,却在中位年龄大于 55 岁的地区高估通勤。若把高估当成实际需求,去增开服务或调整班次,会把图像看错功能的误差写成规划依据。先在当地用一小部分调查核对高估集中在哪类用地,比直接采纳全图更符合这篇论文已经暴露的残差。
时间上的 0.67 也有边界。纽约 RMSE 从 2020 年的 13.44 增到 2002 年的 22.72,增加的是另一个年份整套联系上的均方根误差。建成区十年的缓慢扩张可以被影像看见;一次限行、一条新线开通后的第一个月,卫星图不会跟着改。需要周尺度流量时,这篇模型的输入里没有那一周。