不重放每个人的一周行程,生成出来的移动还能不能用于传播推演?
论文名片|Jie Feng、Zeyu Yang、Fengli Xu、Haisu Yu、Mudan Wang、Yong Li,Learning to Simulate Human Mobility,Proceedings of the 26th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD ’20),2020年8月23–27日,Virtual Event,页眉标为 Health Day Paper,会议论文集第3426–3433页。DOI:10.1145/3394486.3412862。本文依据这篇8页的KDD 2020正式论文解读。
设想一个城市要估计疫情会怎样顺着日常移动传开。运营商已经存着一周基站记录。论文指出,原始记录因隐私和商业原因难以直接共用;只重放已采集的一周,也不足以讨论反事实,论文举的例子是更多人改乘公共交通。常见的两条路是:先规定回家、在附近活动等少数带物理含义的参数,或者让神经网络直接模仿真实轨迹,不再把这些规律写进模型。
这篇论文认为两条路都不够。参数模型写不下随时间变化的高阶转移;不带移动规律的生成模型又很难从噪声轨迹里自己学稳。作者把二者放进同一个生成对抗框架 MoveSim:仍从真实数据学习生成轨迹,同时把城市结构、空间连续和日周期写进网络与损失。在后文两套数据的十二个“数据集×指标”比较里,MoveSim有十个取得最低的分布距离。把合成轨迹和真实轨迹放进同一种比较后,论文报告 7 天平均绝对百分比误差降到 2% 左右。这个 2% 衡量的是两次结果是否接近。
先说结论
- 运营商数据的六项Jensen–Shannon散度里,MoveSim有四项最低,距离和每日地点数两项第二低。论文称四项第一名相对最优基线的降幅都超过35%。按表1重算,回转半径、停留时长、全局访问秩约降35.2%、46.2%、49.8%;个体访问秩从0.0125降到0.0087,降幅是30.4%,并没有超过35%。
- GeoLife的六项都是MoveSim最低。论文称降幅超过14%。其中最小的是全局访问秩,从SeqGAN的0.0964降到0.0833,约13.6%;最大的是停留时长,从0.0079降到0.0018,约77.2%。
- 晚上六点的人口地图只支持目视上的高值区相近。论文没有给出网格误差。
- 后文比较的参照,是用 2016 年 4 月那一周真实基站轨迹跑出的人数。图 5 只画了 TimeGeo 和本文方法。2% 的分母是那次比较里的人数,论文没有使用实际确诊人数。
重放记录和少数参数,各自停在哪里?
人类移动性(human mobility)在这里指人在城市空间中的日常地点序列。居住地迁移是另一类行为,本文的轨迹是日常所在位置。论文要生成的是细粒度记录:大量人在一天之中各时段出现在何处,供传染病的空间扩散使用。直接重放采集数据既受共享限制,也构造不出论文所举的反事实,例如更多人乘坐公共交通。
已有做法被分成两类。基于模型的方法假定少数参数就够用,例如时间上的周期、空间上的连续,再用决策树或马尔可夫过程去模拟。论文认为真实移动还有随时间变化的高阶转移、不规则模式和多种探索方式,简化假设会漏掉这些。不预设显式公式的方法则用生成对抗网络(generative adversarial network,GAN)直接向真实轨迹学习。论文认为,丢掉移动规律之后,学习既慢,也难从缺失、噪声的原始记录里抓住隐藏模式。两类方法若生成的移动不真实,架在上面的疫情模型也会跟着偏离。
因此MoveSim仍是一个生成器对判别器的对抗,但生成器里加入城市结构,判别器的损失里加入空间连续和日周期,训练前还用这两条规律做预训练。后文的实验比的是完整框架对七个外部基线,论文没有报告拆掉其中任一块之后的数字。读到后文的降幅时,还不能把改进分配给某一个模块。
生成的一条轨迹,对应哪些人、哪些地点?
一条移动轨迹写成按时间排列的记录,每个记录是地点和时刻。地点可以是经纬度,也可以是区域编号。生成问题是:给定一批真实轨迹,用带参数的生成模型产生新轨迹,使整条轨迹的概率等于逐步条件概率的乘积。也就是每一步地点都依赖已经生成的前缀,而不是一次画出整张图。
实验把空间和时间都离散化。基本时间片是半小时,论文说这样设定是为了建模方便、也便于跨数据使用。最后一层对下一地点做softmax,所以学习的是“下一个格子去哪”,时间轴按格子往前走。起点的地点按人口密度抽取,起始时刻固定为0。
两套数据的规模差得很远,后面基线谁更强,和这个差别有关。
| 项目 | 移动运营商 | GeoLife-GPS |
|---|---|---|
| 时间范围 | 2016年4月1日至7日,1周 | 2007年4月至2012年8月,表2记为5年 |
| 用户数 | 100,000 | 182 |
| 每人记录数 | 261 | 453 |
| 地点 | 9,000个基站 | 表2写GPS坐标;实验投影到保留三位小数的网格 |
| 轨迹条数 | 正文未单列 | 17,621 |
| 训练∶验证∶测试 | 1∶1∶1 | 7∶2∶1 |
用户数、每人记录数、一周或5年、9,000个基站和GPS坐标来自表2。起止日期、17,621条轨迹、三位小数网格和划分比例来自正文。运营商数据由论文所称中国一座主要城市的一家主要运营商采集,记录匿名用户编号、接入基站和时间戳,城市名字没有写出。GeoLife来自被引用的MSRA Geolife项目。用户数是这批数据里的人数,论文没有把它写成城市人口。每人记录数是表2给出的统计,论文没有写明是均值还是中位数。
一周有7×48=336个半小时。表2给出每人261条记录,少于336个格子,记录并没有按这个时间片填满。论文没有说明261是均值还是中位数,也没有说明多条记录是否先并进同一时间片、空时间片如何处理。这里只比较两个印刷数字。GeoLife的采集跨度长、用户少。论文同时写明采样密、单条轨迹的时间窗短,因此453条记录要和一条轨迹内部的密集采样放在一起理解,不能按5年摊成均匀的日记录。
测试集用于最终指标。表1比较的是生成轨迹与真实轨迹在六种移动模式上的分布,论文没有写明直方图怎么分箱,也没有写历史转移矩阵是否只用训练集统计。
整套框架里,生成器和判别器各看什么?
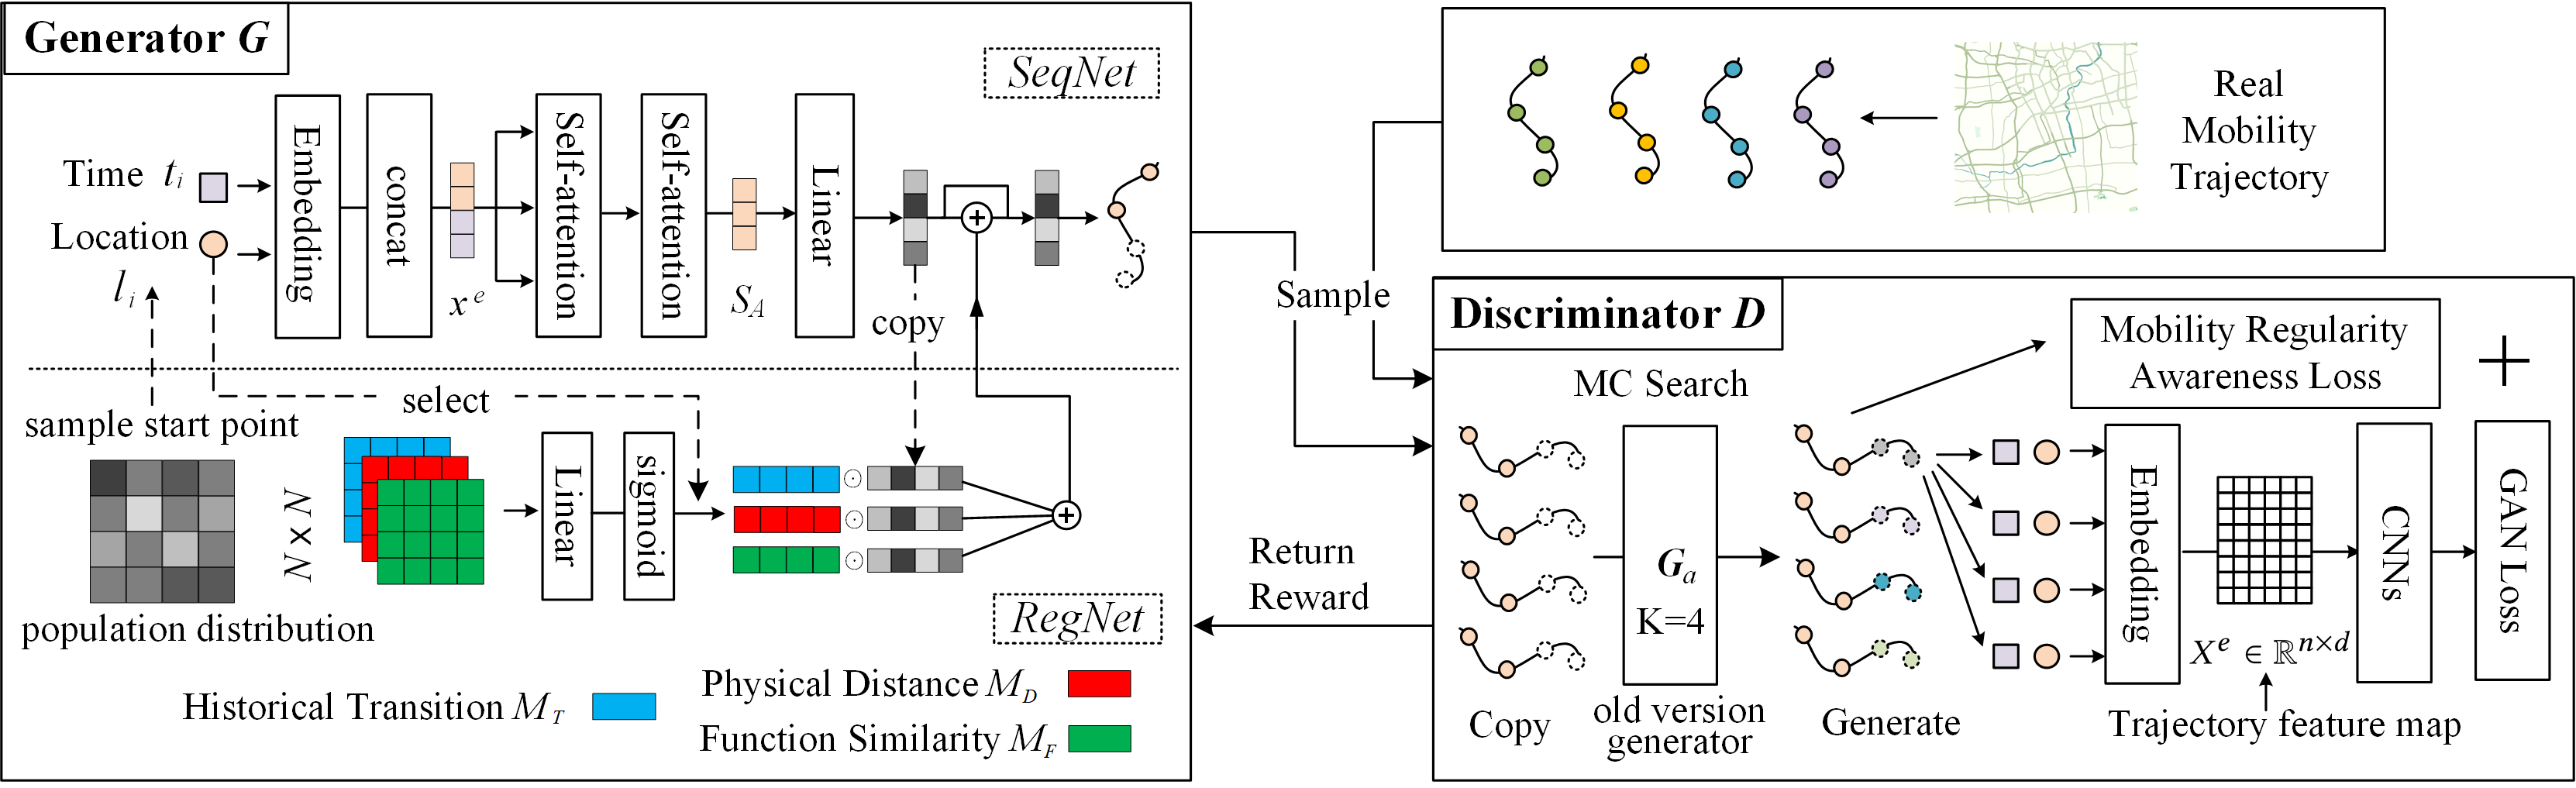
图 1|生成一条轨迹时,哪些信息在生成器里流动,判别器又把什么信号送回去?
无字母子图。左半是生成器:按人口密度抽取起点,SeqNet用自注意力产生下一步,RegNet用三张地点关系修正。图例中历史转移为蓝色,物理距离为红色,功能相似为绿色。右半是判别器:上一版生成器把未完成序列补全,图中标为K=4,再与真实轨迹一起送入卷积网络;移动规律损失与对抗损失写在一起。来源:原论文 Fig. 1。
生成器分成两块。SeqNet负责序列转移,RegNet负责城市结构对移动的影响。判别器要给生成器提供学习信号,论文故意不用同样复杂的自注意力,以免判别器过强、生成器难以逐步学。图1还画出蒙特卡洛补全:未完成的轨迹由上一版生成器用不同随机种子补全,图中次数为4;补全后的整条轨迹交给判别器,分数取平均,当作这段前缀的质量。正文只写重复K次,这个4出现在图里。
下一步地点怎样用到更早的行程?
只根据上一个地点做一阶转移,会错过更早的停留和“这个钟点通常去哪”。SeqNet把地点和时间都编成独热向量,再嵌成一个向量。论文把嵌后的表示写成地点嵌入与时间嵌入拼接后过tanh。自注意力让序列中任意两个已生成点直接发生关联,用来表达高阶和长时间依赖;地点与时间写在同一个向量里,转移就可以随钟点变化。论文认为这比循环网络更适合这种长依赖。查询、键、值由非线性变换得到,再做缩放点积注意力;多层、多头用来从不同子空间看同一段过去。线性层加softmax输出下一地点的概率。
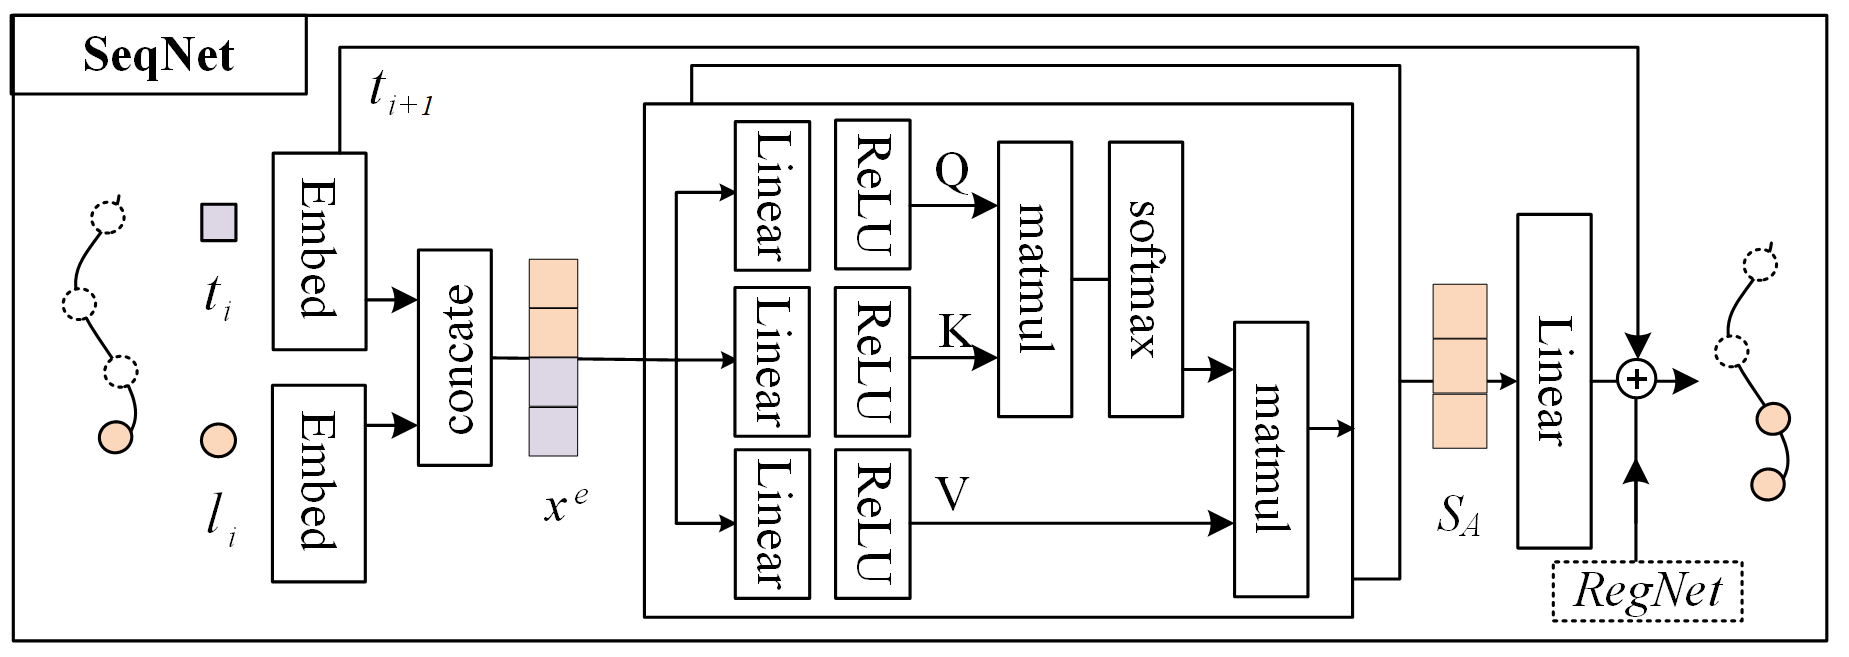
图 2|已知前缀之后,下一地点的概率从哪几条支路来?
无字母子图。紫色方块表示时间,橙色圆点表示地点。当前地点与时间嵌入后拼接,分成查询、键、值三条支路,得到对已有序列的加权表示,再经线性层输出。图上方还有下一步时间进入网络。虚线框表示这一输出还要送到RegNet。来源:原论文 Fig. 2。
图2把下一步时间画成输入,把输出画成地点序列。这与正文一致:模型给出的是下一地点分布,半小时的时间轴是规定好的格子。这张图说明生成过程在用整段前缀,不能把它看成已经证明了某种特定的个人日程机制。
三张地点关系补的是什么?
人在城市里怎么走,还受地点属性和地点之间关系的影响。这些关系原则上可以只靠判别器的分数,让SeqNet自己学。论文说纯靠这种方式在实践中很难训练,于是为N个地点建三张N×N的关系矩阵,都按行归一化。
物理距离矩阵是所有地点对的欧氏距离,也就是地图上的直线距离,不是沿路里程或行程时间。功能相似矩阵先算每个地点的兴趣点(point of interest,PoI)类别分布,再计算分布之间的相关。兴趣点来自哪份地图数据,论文没有写。历史转移矩阵是真实移动数据里地点间转移的汇总,代表论文所说的经验和偏好的直接证据。论文没有写这张矩阵只统计训练集,还是用到了全部真实转移。若验证或测试中的转移也被写进矩阵,后文的分布距离会被低估。
使用时,用上一地点的概率向量从这三张矩阵取出关系,再以逐元相乘的方式修正当前这一步的地点概率,并作为残差加回去,最后做softmax。于是下一步既看SeqNet从序列里学到的转移,也看距离、功能和历史流量。历史转移是群体层面的汇总,不是沿着某一个匿名编号继续追踪的步骤。
判别器除了分辨真假,还在看哪两条规律?
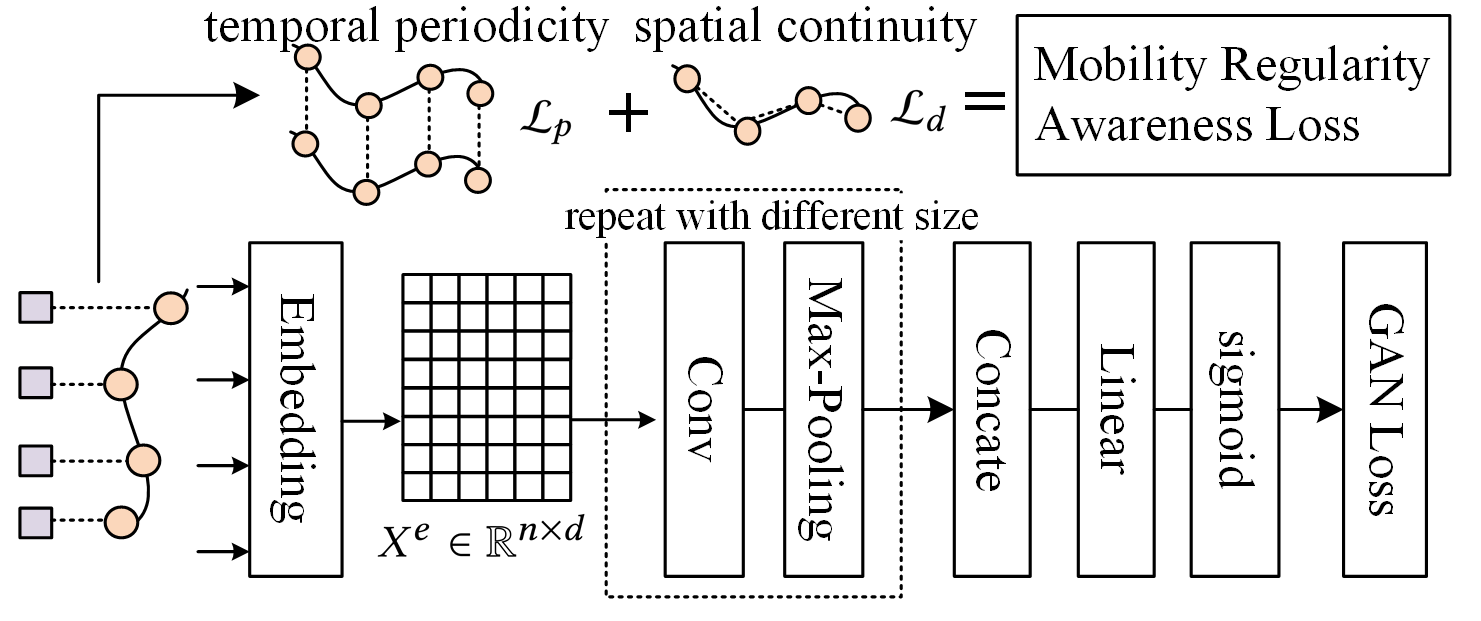
图 3|一条轨迹的分数由哪两部分相加?
无字母子图。上方日周期损失与空间连续损失相加,记为移动规律损失。下方轨迹嵌入成矩阵后,经过不同尺度的卷积和池化、拼接、线性层和sigmoid,得到对抗损失。来源:原论文 Fig. 3。
判别器的输入是真实轨迹和生成轨迹。结构分三步:时空嵌入把序列变成n×d的特征矩阵,卷积提取特征,线性层加sigmoid给出分数。图3还画出不同尺度的卷积与池化后再拼接。这样得到的是整条轨迹的分数。因为轨迹是一步步生成的,只在结尾打分会让生成器不知道误差从哪一步累积。图1里的多次补全,就是为了给中间前缀也一个分数。
只靠真假分类,判别器不会显式执行移动规律。论文把空间连续和时间周期当作修正项。空间连续损失把相邻地点在墨卡托平面上的直线距离累加,促使相邻转移不要太远。日周期损失看相隔固定周期P的两个地点是否相同:相同记0,不同记1,再沿轨迹累加。论文举例,若基本时间窗是1小时,P取24,这项就是不同日期、同一小时地点不一致的次数;人若每天同一时刻回到同类地点,这项的期望更低。
实验部分又把建模时间片定为半小时。论文没有说明在半小时格子下P取多少,也没有说明1小时的例子是否就是最终实验设置。因此“每天同一时刻”这条约束的严格对齐方式,不能从正文唯一确定。两项损失鼓励的是短跳转和周期重复,它们是训练目标里的偏好,不是对每个人动机的测量。
地点一旦离散抽样,模型靠什么继续学习?
生成器输出的是地点类别上的抽样。抽样不可导,判别器的梯度传不回生成器。论文提到可以把地点改成连续经纬度来绕过这个问题,但认为这种低维表示容量不够,并说实验和既有工作支持这一点;正文没有另外给出那次连续坐标实验的数字。实际训练把生成看成序列决策:状态是已经生成的前缀,动作是下一地点,奖励来自判别器。参数按REINFORCE的策略梯度更新,学习率在正文里只作为一个符号出现,没有给出数值。嵌入维度和注意力头数也没有给出。
从零开始对抗训练仍然困难,所以两边都先预训练。生成器的预训练是移动预测:以一条轨迹为单位随机划分训练和测试;长度为n的轨迹,用前n−1个点预测后移一位的n−1个点。这是在真实前缀已知时预测下一个地点,论文称之为整条生成任务的弱版本。这里的划分比例,没有写明是否就是后面运营商1∶1∶1、GeoLife 7∶2∶1那一次。
判别器的预训练是二分类,用来识别轨迹是否还保留日周期和空间连续。负例用两种方式破坏真实轨迹:把其中一个地点换成整个空间里远离原地点的地点,或者打乱一个周期内的地点顺序。论文没有给出“远离”的距离阈值。这一步是在教判别器认识规律被破坏后的样子,不是一套把匿名记录重新对应到具体个人的流程。
六项分布距离里,谁更接近真实轨迹?
评价比较的是生成轨迹与真实轨迹在六种模式分布上的Jensen–Shannon散度(Jensen–Shannon divergence,JSD),而不是某一次有没有命中下一个基站。论文写为JSD(p, q)=h((p+q)/2)−(h(p)+h(q))/2,h是香农信息。数值越低,两个分布越接近。表里的0.002是很小的分布距离,论文没有把它换算成地点命中率。
六项的含义是:距离,固定时间间隔内每人的累计出行距离,间隔长度没有另给;回转半径(radius of gyration),每天活动的空间范围;停留时长,每次访问地点的停留时间;每日地点数,每人每天访问的地点个数;全局访问秩,访问量最高的100个地点的到访频率;个体访问秩,论文称为全局访问秩的个人版本,没有写出公式。前四项先在人身上计算再比较分布,全局访问秩是地点层面的热度。
七个基线可以分成三组。Markov用地点间的一阶转移。DeepMove是下一地点预测模型,用注意力和循环网络捕捉周期,这里被拿来生成轨迹,训练目标仍是短期的下一步。TimeGeo用基于家的周出行次数、停留率和爆发率描述时间,用论文所写的r-EPR机制描述空间选择。IO-HMM先从轨迹标注活动,再为每个用户生成移动,家和工作地由人工指定。GAN用LSTM生成、CNN判别。TrajGAN把轨迹摊成二维矩阵再当图像生成。SeqGAN用强化学习处理离散序列,这里直接用来生成地点序列。
运营商数据上的JSD如下。最低值与次低值按数字比较,不在表中另做标记。
| 模型 | 距离 | 回转半径 | 停留时长 | 每日地点数 | 全局访问秩 | 个体访问秩 |
|---|---|---|---|---|---|---|
| Markov | 0.0023 | 0.0659 | 0.0239 | 0.4212 | 0.1301 | 0.0431 |
| DeepMove | 0.0497 | 0.0206 | 0.0206 | 0.2599 | 0.6172 | 0.1163 |
| TimeGeo | 0.0040 | 0.0105 | 0.0074 | 0.0891 | 0.3079 | 0.0125 |
| IO-HMM | 0.0027 | 0.0118 | 0.0085 | 0.0724 | 0.2715 | 0.0196 |
| GAN | 0.0146 | 0.0299 | 0.043 | 0.1534 | 0.2981 | 0.0653 |
| TrajGAN | 0.1152 | 0.2194 | 0.0921 | 0.2843 | 0.1028 | 0.1514 |
| SeqGAN | 0.0052 | 0.0158 | 0.0026 | 0.1193 | 0.0998 | 0.0129 |
| 本文 | 0.0025 | 0.0068 | 0.0014 | 0.0844 | 0.0501 | 0.0087 |
GAN的停留时长在表中印为0.043,其余多数保留四位小数。相对该项最低的基线,本文的变化是:
- 回转半径,TimeGeo 0.0105降到0.0068,(0.0105−0.0068)/0.0105≈35.2%。
- 停留时长,SeqGAN 0.0026降到0.0014,(0.0026−0.0014)/0.0026≈46.2%。
- 全局访问秩,SeqGAN 0.0998降到0.0501,(0.0998−0.0501)/0.0998≈49.8%。
- 个体访问秩,TimeGeo 0.0125降到0.0087,(0.0125−0.0087)/0.0125=30.4%。
- 距离,Markov 0.0023更低,本文0.0025,高出(0.0025−0.0023)/0.0023≈8.7%。
- 每日地点数,IO-HMM 0.0724更低,本文0.0844,高出(0.0844−0.0724)/0.0724≈16.6%。
摘要把模拟质量的改进概括为35%,正文写四项第一名的JSD降幅都超过35%。前三项与这句话相符,个体访问秩的30.4%不符。距离上看,本文只比Markov略高,但Markov的每日地点数高达0.4212。论文的解释是:Markov靠只在很少地点之间来回,换来了很小的距离差。这是对表的解读;表本身只给出分布距离。DeepMove的全局访问秩为0.6172,是这张表里最大的一项,与“用下一步预测目标去生成长轨迹”的设定相符。IO-HMM取得了最低的每日地点数,而它生成时使用人工指定的家和工作地,输入信息与按人口密度抽起点的本文方法并不相同。
GeoLife上的JSD如下。
| 模型 | 距离 | 回转半径 | 停留时长 | 每日地点数 | 全局访问秩 | 个体访问秩 |
|---|---|---|---|---|---|---|
| Markov | 0.0176 | 0.1452 | 0.0746 | 0.2845 | 0.2502 | 0.0964 |
| DeepMove | 0.1654 | 0.1038 | 0.0356 | 0.2279 | 0.3463 | 0.0567 |
| TimeGeo | 0.0193 | 0.1124 | 0.0093 | 0.1235 | 0.2764 | 0.0495 |
| IO-HMM | 0.0158 | 0.0972 | 0.0096 | 0.0986 | 0.2867 | 0.0557 |
| GAN | 0.0233 | 0.0946 | 0.0834 | 0.2645 | 0.2876 | 0.0457 |
| TrajGAN | 0.1326 | 0.1954 | 0.0692 | 0.3362 | 0.1742 | 0.1034 |
| SeqGAN | 0.0165 | 0.0757 | 0.0079 | 0.0846 | 0.0964 | 0.0242 |
| 本文 | 0.0088 | 0.0539 | 0.0018 | 0.0635 | 0.0833 | 0.0096 |
六项都是本文最低。相对各自最低基线:距离从IO-HMM的0.0158降到0.0088,约44.3%;回转半径从SeqGAN的0.0757降到0.0539,约28.8%;停留时长从SeqGAN的0.0079降到0.0018,约77.2%;每日地点数从SeqGAN的0.0846降到0.0635,约24.9%;全局访问秩从SeqGAN的0.0964降到0.0833,约13.6%;个体访问秩从SeqGAN的0.0242降到0.0096,约60.3%。正文概括为降幅超过14%。最小的那一项约13.6%,略低于这个概括。
论文对GeoLife的解释是:数据量小、采样密、时间窗短,移动规律不那么明显,需要先估准规律参数的TimeGeo和IO-HMM变差,SeqGAN相对更强。这是作者对两套数据差异的说明。表1没有置信区间,也没有显著性检验,所以上述百分比是点估计的相对差。两套数据上的共同结论只到这一步:在这些分布距离上,完整的MoveSim多数时候低于列出的基线。它还不等于某一编号用户的下周行程被逐点复现。
晚上六点的人,是否还聚在同一片区域?
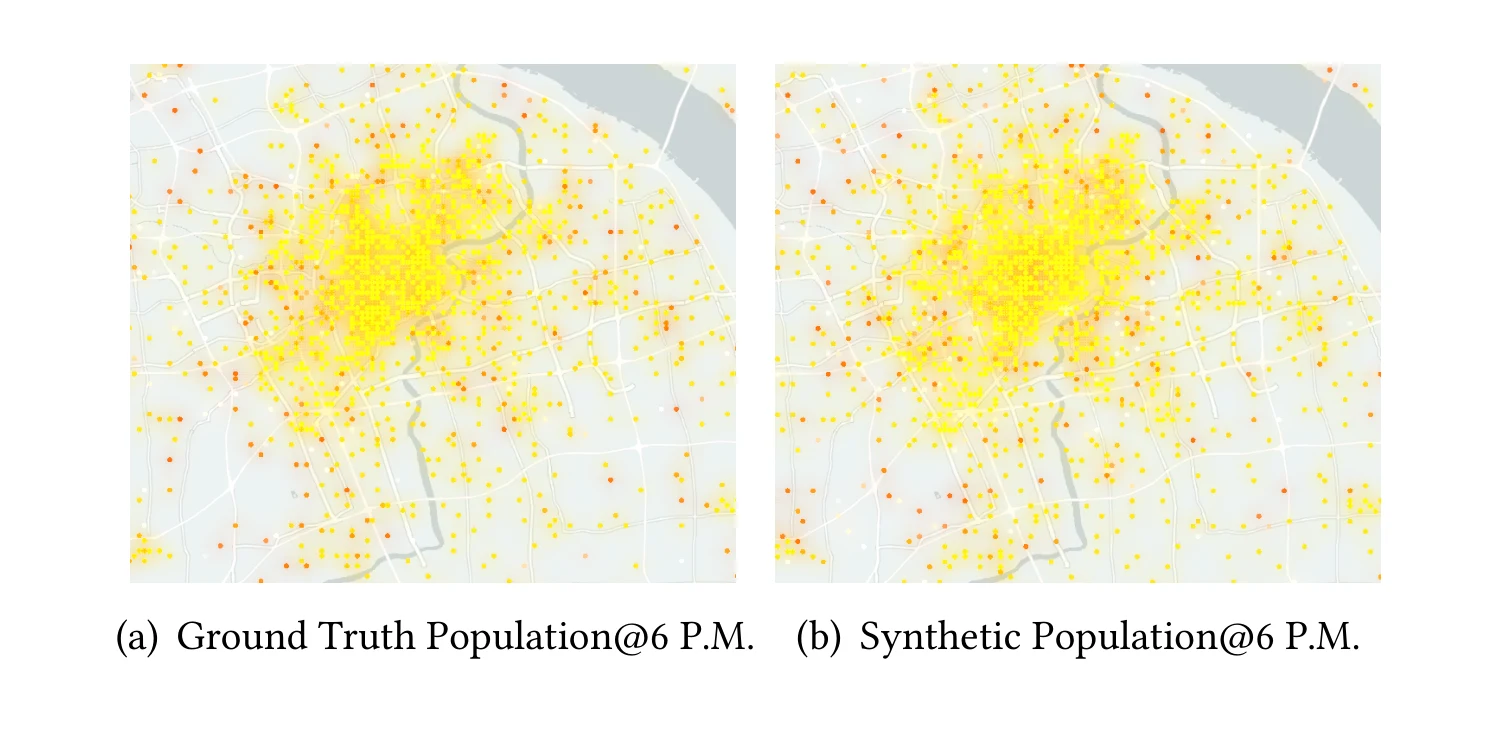
图 4|运营商数据在晚上六点的汇总人口,合成轨迹是否再现同一格局?
(a)真实轨迹按基站汇总到邻近网格后的人口,越亮表示人越多。(b)本文合成轨迹的同期汇总。两幅图的高值集中区位置接近,外围更稀疏。论文没有给出网格级误差或相关系数,也没有解释底图里浅色区域的含义。来源:原论文 Fig. 4。
这张图只来自运营商数据,是群体在空间上的叠加,不是个人轨迹是否重合。目视相似与表1里的低JSD指向同一方向,但不能互相换算。
这个 2%,分母是什么?
这项比较只用运营商数据。论文报告三类人数在 7 天上的平均绝对百分比误差。参照是用真实运营商轨迹跑出的人数,分母是那次比较里的人数。论文没有印出逐日分子,也没有使用确诊、住院或检测人数。每个设定至少重复 10 次。
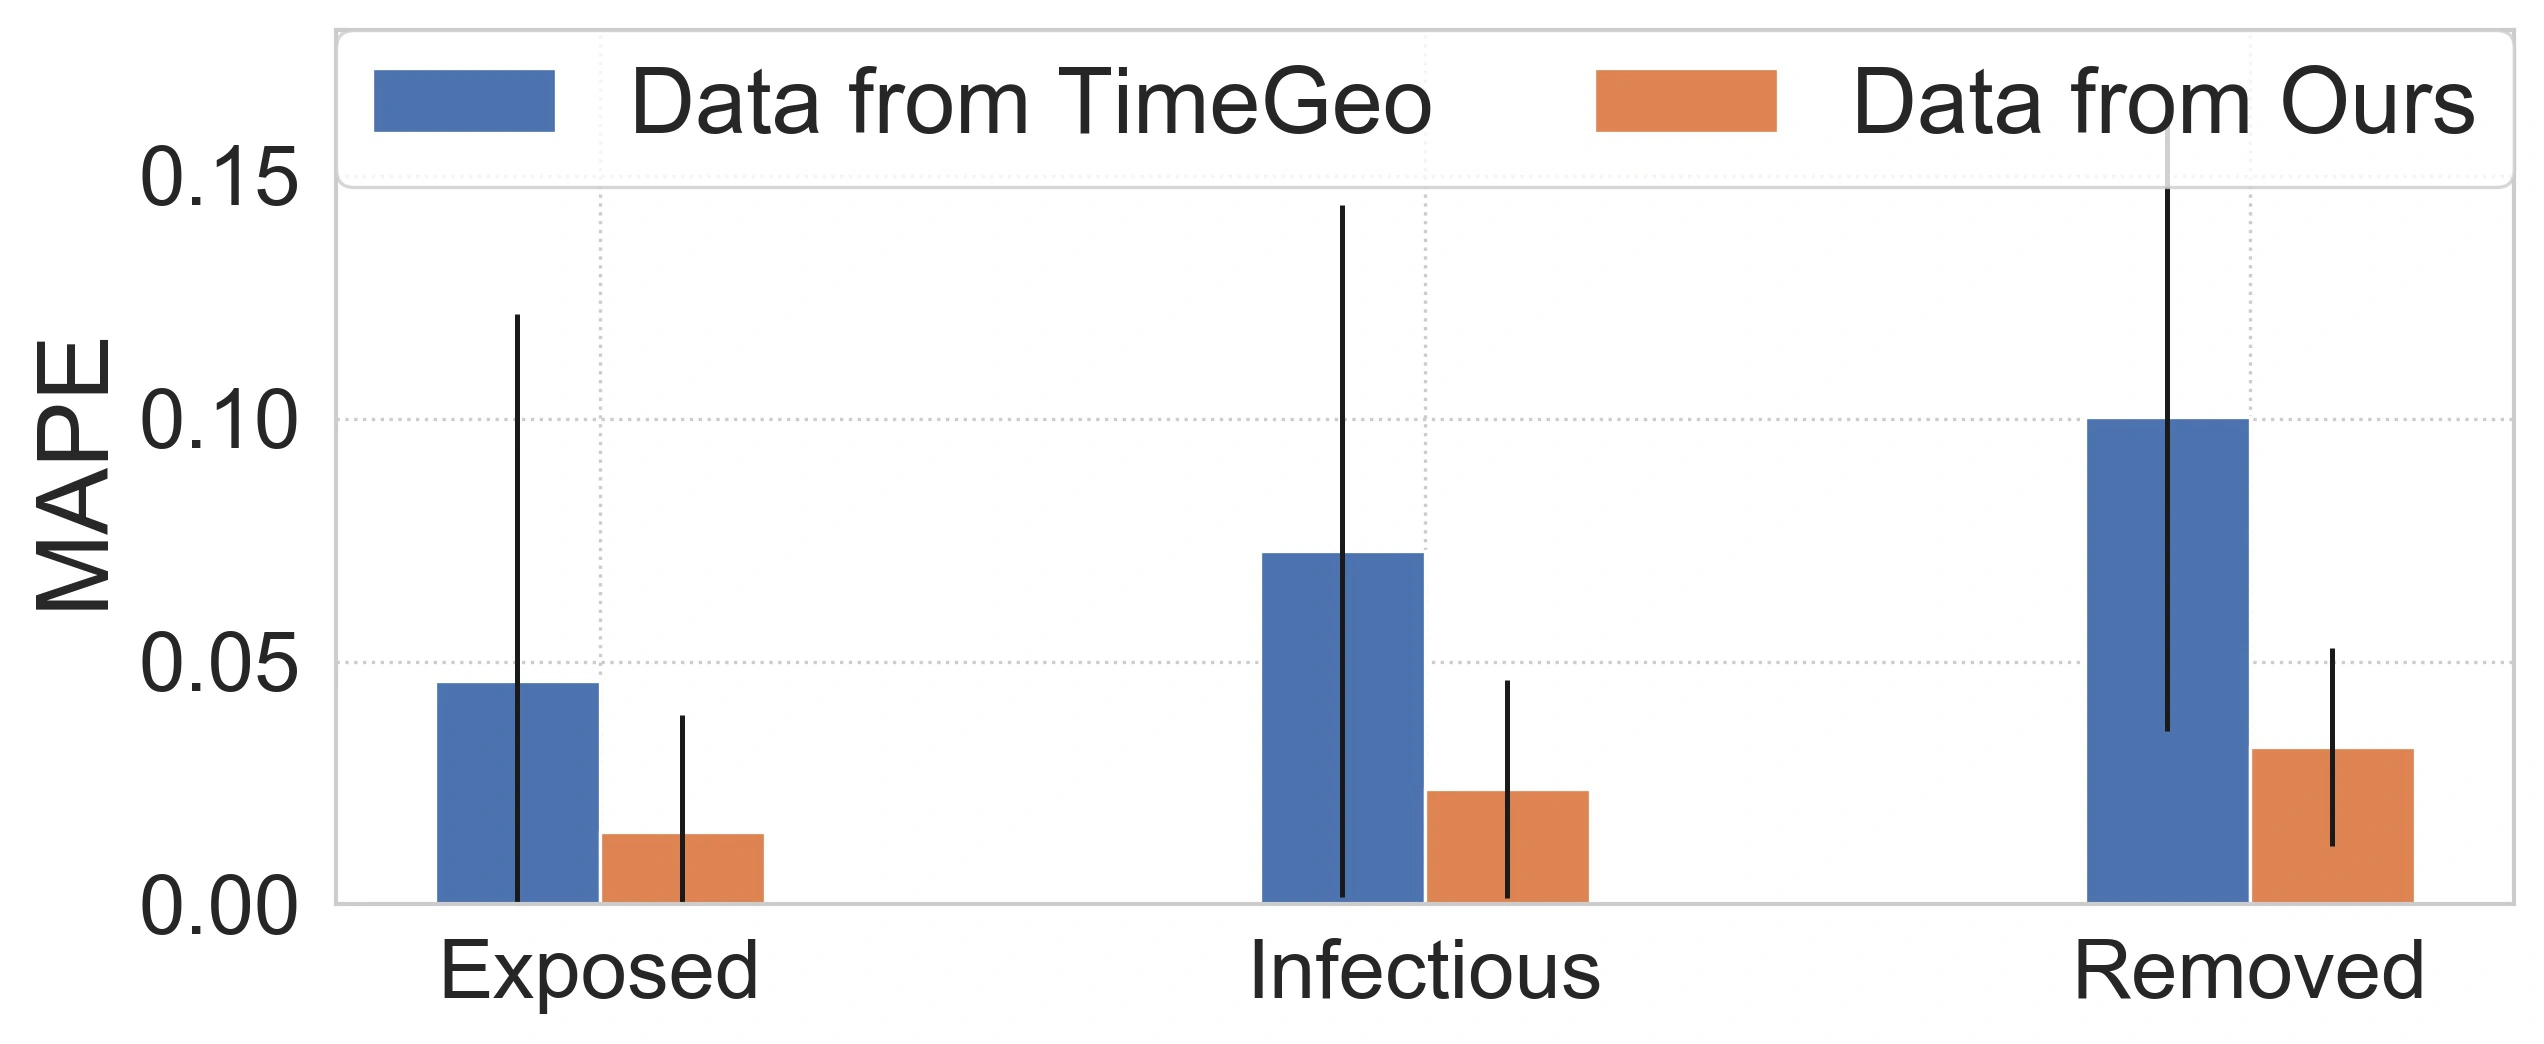
图 5|换成合成轨迹后,三类人数相对真实轨迹模拟的百分比误差处于什么范围?
无字母子图。横轴为三类人数,纵轴为平均绝对百分比误差,刻度到 0.15。蓝色为TimeGeo轨迹,橙色为本文轨迹,柱顶有竖线。正文把7天平均概括为从5%~10%降到2%,图上没有印出每根柱的精确读数,也没有定义竖线是标准差、标准误还是各次模拟的范围。来源:原论文 Fig. 5。
图 5 的基线只有 TimeGeo,不是表 1 的全部七个模型。蓝色柱高于橙色柱,与正文的方向一致;竖线在 TimeGeo 一侧更长,说明重复之间有明显起伏。因此 2% 是论文对平均误差的概括。它不能被读成每一次都精确等于 2%,也不能被读成对 2020 年实际病例的预测误差。移动记录是 2016 年 4 月 1 日至 7 日的基站访问。实验没有改公交分担率,也没有回答论文引言里的那种反事实。
这些比较停在什么范围?
表1支持的是:在给定的离散方式和六种分布下,MoveSim的生成结果多数更接近真实轨迹的统计。图4支持晚上六点的汇总人口在目视上相似。图 5 支持,在这次 TimeGeo 对照里,合成轨迹驱动的三类人数更接近真实轨迹驱动的结果。
分布接近还不等于机制已经被识别,也不等于某个匿名用户的行程可被还原。历史转移矩阵若含有评估数据中的流量,表1会偏乐观,而论文没有交代矩阵的统计范围。兴趣点数据源、城市名称、I-rank公式、JSD分箱、学习率数值都没有给出。没有模块消融,就不能把降幅记到自注意力、三张矩阵或规律损失中的某一项上。运营商结果来自一家运营商的10万匿名用户、一周、9,000个基站;GeoLife是182名用户。两套划分比例不同,不能合成一个“所有城市、所有年份”的误差。
合成数据的动机包括少共享原始轨迹。论文没有测量生成结果是否复述了训练序列,也没有给出隐私预算。可以共享,和已经证明无法对应回个人,是两件需要分别验证的事。
一句话总结
MoveSim 能让合成轨迹在多项移动统计上更接近真实轨迹,并让合成轨迹驱动的人数更接近真实轨迹驱动的结果;以文中实验,它还不能代替真实病例,也不能回答出行方式改变之后会怎样。
核心来源
- KDD 2020正式论文,题目、作者、机构、DOI、表1至表3及图1至图5均以这篇8页会议论文为准。
- 论文脚注给出的代码入口为 https://github.com/FIBLAB/MoveSim。
作者介绍
六位作者均署名清华大学电子工程系、北京信息科学与技术国家研究中心(Beijing National Research Center for Information Science and Technology)。论文标明Yong Li为通讯作者,邮箱为liyong07@tsinghua.edu.cn,没有列出个人贡献分工。
- Jie Feng:本文作者。文中作为基线引用的DeepMove(2018)由Jie Feng、Yong Li等完成。
- Zeyu Yang:本文作者。参考文献中与Jie Feng、Yong Li共同署名一篇关于人类移动预测的论文。
- Fengli Xu、Haisu Yu、Mudan Wang:本文作者,署名机构同上。
- Yong Li:通讯作者,并出现在本文所引DeepMove的作者列表中。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
引言把更多人改乘公共交通当作需要模拟的情形。实验没有改任何出行方式,只替换了喂进去的轨迹。若下一步固定生成器,只拉长一部分行程或提高某种地点之间的往返,再看汇总人数是否朝可解释的方向变化,才能把较低的分布距离和反事实用途连起来。只在原始数据上把 JSD 做低,回答不了政策问题。
历史转移矩阵已经汇总了真实地点之间的流量。对接收合成轨迹的建模方,更有信息量的检验是:这张矩阵若只用来自更早一周或更粗网格的计数,图5里的MAPE是否还停在论文概括的2%附近。同一周数据上的分布接近,不能代替这种时间或尺度错开之后的稳定性。
运营商数据上,MoveSim 输给 IO-HMM 的那一项是每人每天去多少个不同地点,赢下的则包括最热的 100 个地点有多热。论文没有把六个分布距离逐一拆开,去看它们各自对图 5 的贡献。在这张对应表出现之前,用六项的整体印象挑选模型,可能放过真正带动误差的那一项。