未来情景下的城市出行流量,现在就能生成吗?
论文名片|Seanglidet Yean、Jiazu Zhou、Bu-Sung Lee、Markus Schläpfer,FloGAN: Scenario-Based Urban Mobility Flow Generation via Conditional GANs and Dynamic Region Decoupling,arXiv:2507.12053v1 [cs.LG],2025年7月16日。预印本 v1。这是一篇方法论文:用条件生成对抗网络,按关注区域生成城市起讫流量。
设想规划者想先看淡滨尼多一片商业、或只把裕廊东画细、岛上其余地方画粗之后,早晨会有多少人从一块地方到另一块地方。这个情景只帮助想象问题,不是论文中的真实案例。常见办法是套一个重力公式,或者等新的出行记录重新标定。重力模型和个体行为模型都要靠历史数据校准;辐射模型在城市内部的细尺度上又往往不够用。历史轨迹生成模型则不容易把用地和人口密度的变化放进去。
这篇论文把生成对象收成情景下的人群起讫流量:历史流量与一张可切换的关注区地图一起交给条件生成网络。在新加坡 2019 年 9 月已经发生的出行上,按六张关注区地图生成的流量,重合程度平均高于无条件生成模型和重力模型。最大流量仍被成倍高估。实验切换的是同一历史月份里的关注范围,还不是一块尚未发生的新用地。
先说结论
- 比较的是格子之间的出行量,不是一个人的路线。匿名手机记录汇总之后,30 天、6 个时段、6 张动态地图,共 1,080 个起讫矩阵;汇总前有 104,976 名活跃用户的到访序列。
- 关注区用 1.5 公里见方的格子,周围用 3 公里,最外层用 12 公里见方的格子;格子总数不超过 64,以便对齐生成网络常见的 64×64 输入。进入网络前,出行量 x 先变成 ln(1+x)。
- 共同部分系数 CPC 在 0 到 1 之间,衡量起讫对上生成流量与真实流量的重合。表 II 中 FloGAN 在六张地图上都最高,六个数的平均是 0.8619,对照 MoGAN 的 0.40975 和重力模型的 0.3923。
- 表 I 里,真实流量最大值为 84,480,平均值为 29.28。FloGAN 的平均值 28.62 最接近,最大值却是 442,412.39,约为真实最大值的 5.24 倍(442,412.39÷84,480)。论文写出重力模型的最大值高估倍数为 2.84。
- 图像指标并不在每张地图上给出同一个名次。结构相似度上,重力模型在淡滨尼 2 略好于 FloGAN。感知相似度 LPIPS 上,淡滨尼 2 的 FloGAN 落到 0.3–0.4;这个指标从 0 到 1,越接近 0 越相似。实验里送进网络的条件是地图名称。
要生成的是两片地方之间的人流
城市里的人怎么移动,会跟着用地和人口密度一起变。交通网络、拥堵和设施够不够用,都要看一群人从哪里到哪里,而不只是看一个人的下一条轨迹。这篇论文生成的是起讫流量(origin–destination flow,OD flow):从格子 i 到格子 j 有多少次出行。矩阵里的一个数是人群合计,不能读回某一部手机的行程。
数据来自 CITYDATA.ai 提供的新加坡匿名手机记录,时间是 2019 年 9 月 1 日至 30 日,共 30 天。论文写明,记录经过另一项工作中的预处理后,得到 104,976 名活跃用户的到访序列,也就是带时间的地点访问次序。到访点如何从原始记录里确定,这篇正文没有展开。随后这些记录按空间和时段加总。104,976 是加总前的用户数,不是 CPC 或图像指标的分母。
空间上有六张动态地图,每张把细格子放在不同的关注区:裕廊东(Jurong East,JE)、市中心(Downtown,DT)、榜鹅(Punggol,PG),以及淡滨尼(Tampines)里的三个子区 TM0、TM1、TM2。模型的条件输入就是这些地图的名称。
时段按新加坡已有出行节奏切成六段:早晨出行 5:00–8:00,上午 8:00–11:00,午间 11:00–14:00,下午 14:00–17:00,傍晚 17:00–20:00,夜间 20:00–次日 5:00。前五段各 3 小时,夜间跨午夜,窗口是 9 小时。论文没有把计数除以小时数。因此夜间矩阵里的出行量对应更长的时间,不能直接当成与早晨同一长度的出行率。
每一天、每一段、每一张动态地图各有一个起讫矩阵。30×6×6=1,080,这 1,080 是矩阵个数。结果解释的是这些矩阵所代表的跨格子人群流量。格子内部的移动、以及没有进入这 30 天样本的出行,都不在比较之内。
为什么不能把全城切成同样细的格子?
生成对抗网络通常要固定尺寸的输入,常见是 64×64 的图像;若再把图像切成一样大的格子,关注区和非关注区就只能共用一种粗细。全城都用 1.5 公里,格子数会超过这个输入;全城都用很粗的格子,关注区里的差异又会被抹平。起讫流量还会连接远处的格子,把城市切成互不相连的几块再分别生成,会把跨区出行切断。
动态区域解耦(dynamic region decoupling)要解决的就是这组矛盾:仍然用一张矩阵覆盖整片范围,但格子大小随关注区改变。论文按试验把格子分成三档,边长分别为 1.5 公里、3 公里和 12 公里,并规定活跃格子数 n 不超过 nmax=64。关注区用 1.5 公里格子,周围用 3 公里格子,最外层用 12 公里见方的格子。活跃格子少于模型所需时,矩阵用 0 补齐。每个格子对上的数,是这一对格子之间的出行量。
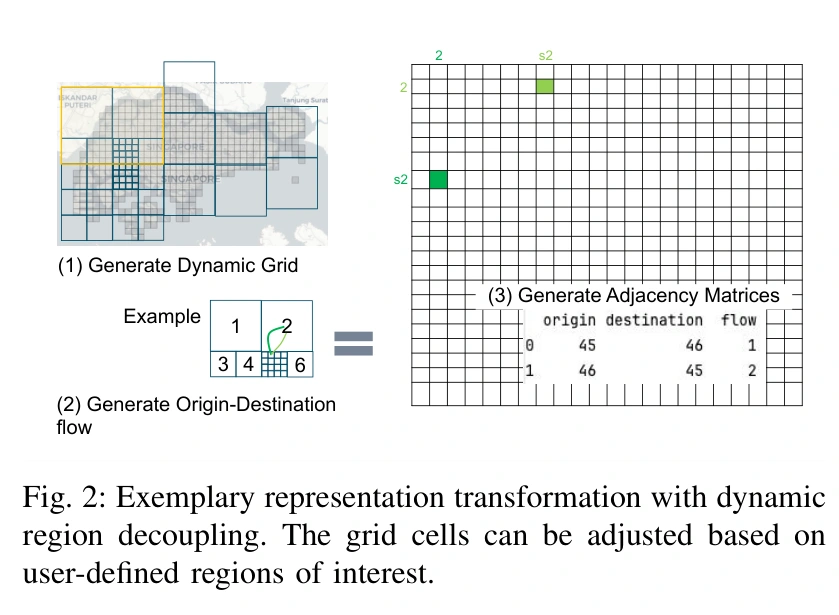
图 2|一张可调粗细的地图,怎样变成起讫矩阵?
无字母子图,按图中的三步阅读。(1)先画动态网格:关注处格子更密,外围更疏,范围可以由使用者指定。(2)再数格子之间的出行,示意里用一小块编号网格表示起讫关系。(3)把这些出行写成邻接矩阵,行和列对应起点与终点。图中的小数字是示意,不是新加坡的实测流量。来源:原论文 Fig. 2。
出行量的分布很偏,少数格子对特别大,多数很小。直接把原始计数画成像素时,小流量几乎看不见。论文因此做自然对数变换:
Norm(x) = ln(1+x)
x 是邻接矩阵中的出行量。加 1 是为了让 0 也能取对数。这不是把流量变成概率,也不改变后来要回答的问题:生成结果仍要和真实的人群出行量比较。对数只是让中低流量在图像表示里保留下来。
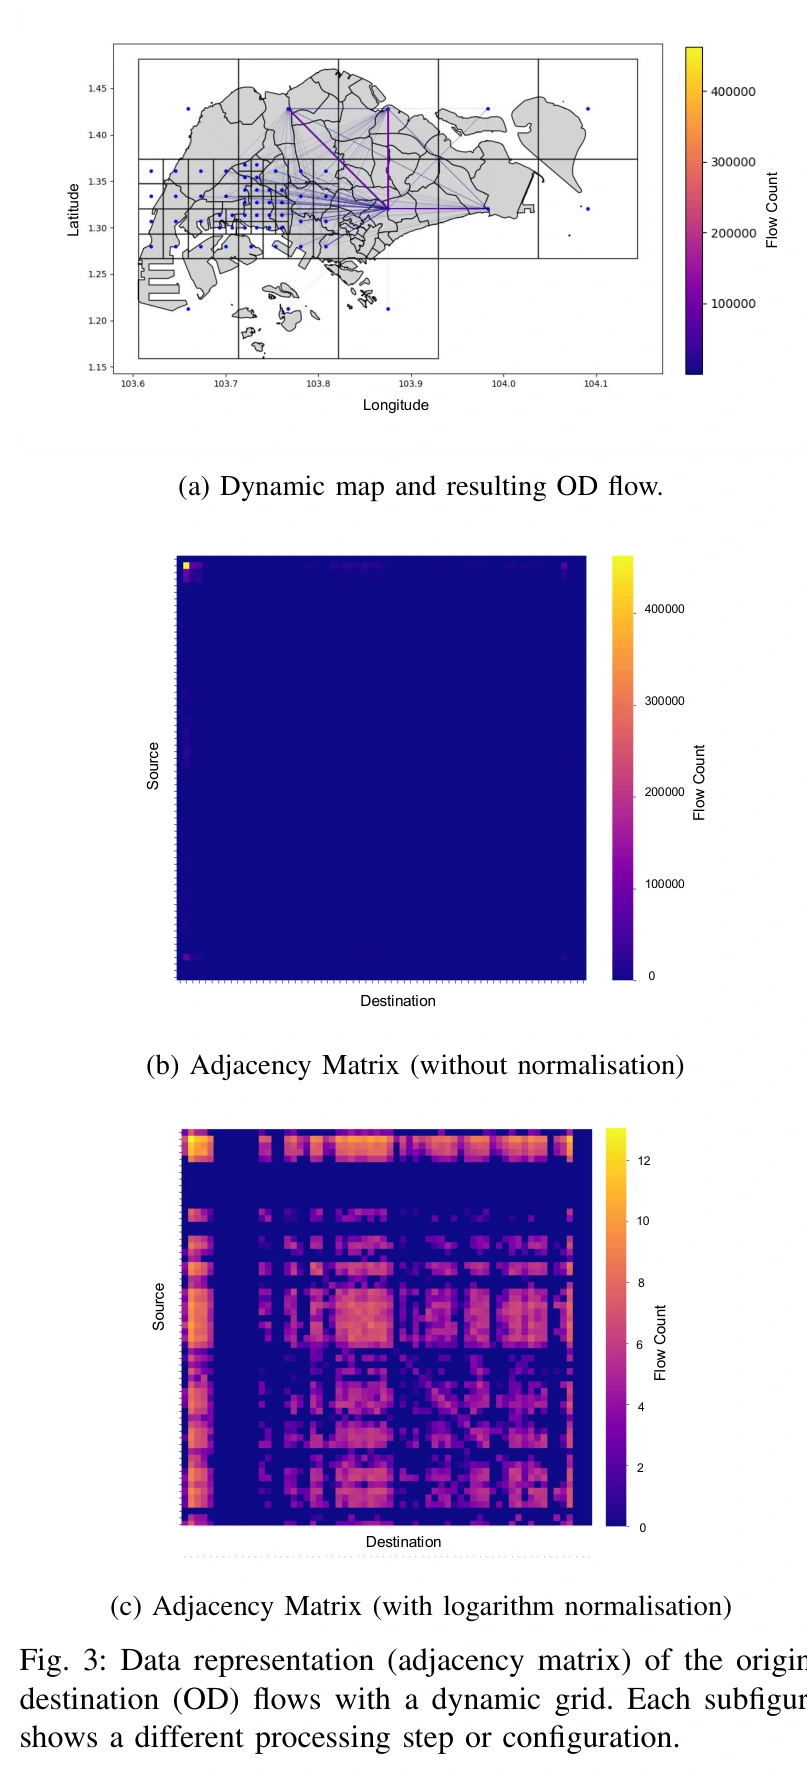
图 3|同一批起讫流量,取对数之前和之后看起来差在哪里?
(a)新加坡地图上的动态网格和由此得到的起讫线,颜色表示流量,色标最高标到 400,000。这是该图的颜色上限,不能当成表 I 的最大流量。(b)未取对数的邻接矩阵,横轴终点、纵轴起点,色标同样标到 400,000;画面几乎全暗,只有极少数格子较亮。(c)取 ln(1+x) 之后,色标标到 12,更多中低流量的格子能够看见。图中色标和线条都不是表 I 那个最大值 84,480 的逐条清单。来源:原论文 Fig. 3。
网络的条件,是地图名称还是未来用地?
FloGAN 由三部分组成。编码器把到访序列汇总成动态地图上的起讫矩阵。条件编码把辅助信息送进生成过程,用来控制生成结果的特征;论文举例包括时段和用地情景。生成器则是选定的生成对抗网络。摘要把动态区域大小和用地原型都列为可调节因素。实验部分写明送进网络的条件,是六张动态地图的名称。用地差异出现在结果解释里,正文没有给出各类用地的比例,也没有把一张改变后的用地图编码成输入。时段用来把同一天切成六张矩阵,正文没有写时段编号也作为条件输入。
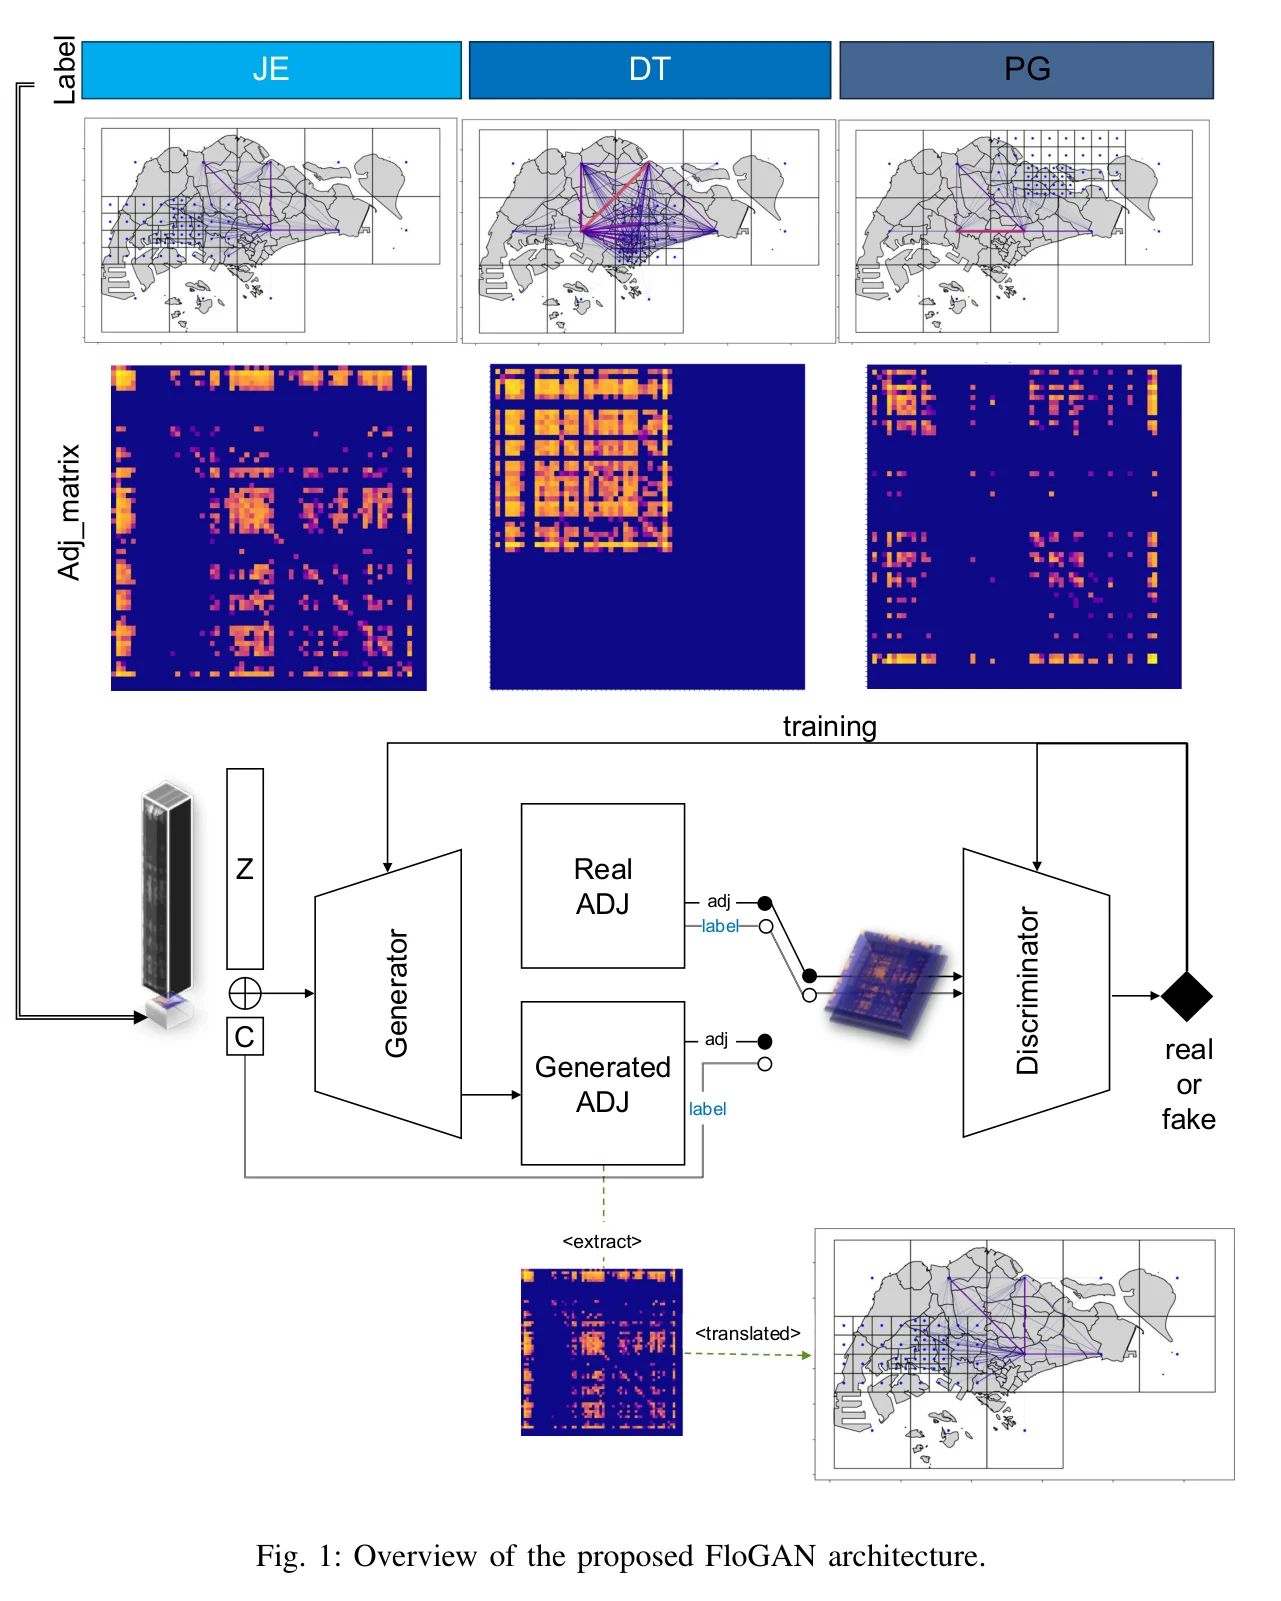
图 1|关注区标签如何进入流量生成?
无字母子图。上方三列示例是裕廊东 JE、市中心 DT 和榜鹅 PG,实验实际还有淡滨尼的三张子区地图。每一列上面是动态网格上的流量线,下面是对应的邻接矩阵。标签与矩阵进入生成器;生成器同时接收噪声 Z 和条件 C,并与真实矩阵一起训练判别器,由判别器判断真假。下方把生成矩阵译回地图上的流量。图中只展示三张地图的流程,不能看成六张地图的精度排名。来源:原论文 Fig. 1。
若每张动态地图单独训练一个网络,数据被拆开,也学不到各图共用的结构。条件生成对抗网络(conditional GAN,cGAN)共用一套参数,再用辅助输入区分该生成哪一张地图。论文在 MoGAN 所用的深度卷积生成对抗网络上加入这个条件。变分自编码器和扩散模型也能生成复杂分布,但前者把条件藏进潜空间,后者要多步采样。这里选择 cGAN,是为了单次生成,并把邻接矩阵当图像来处理。
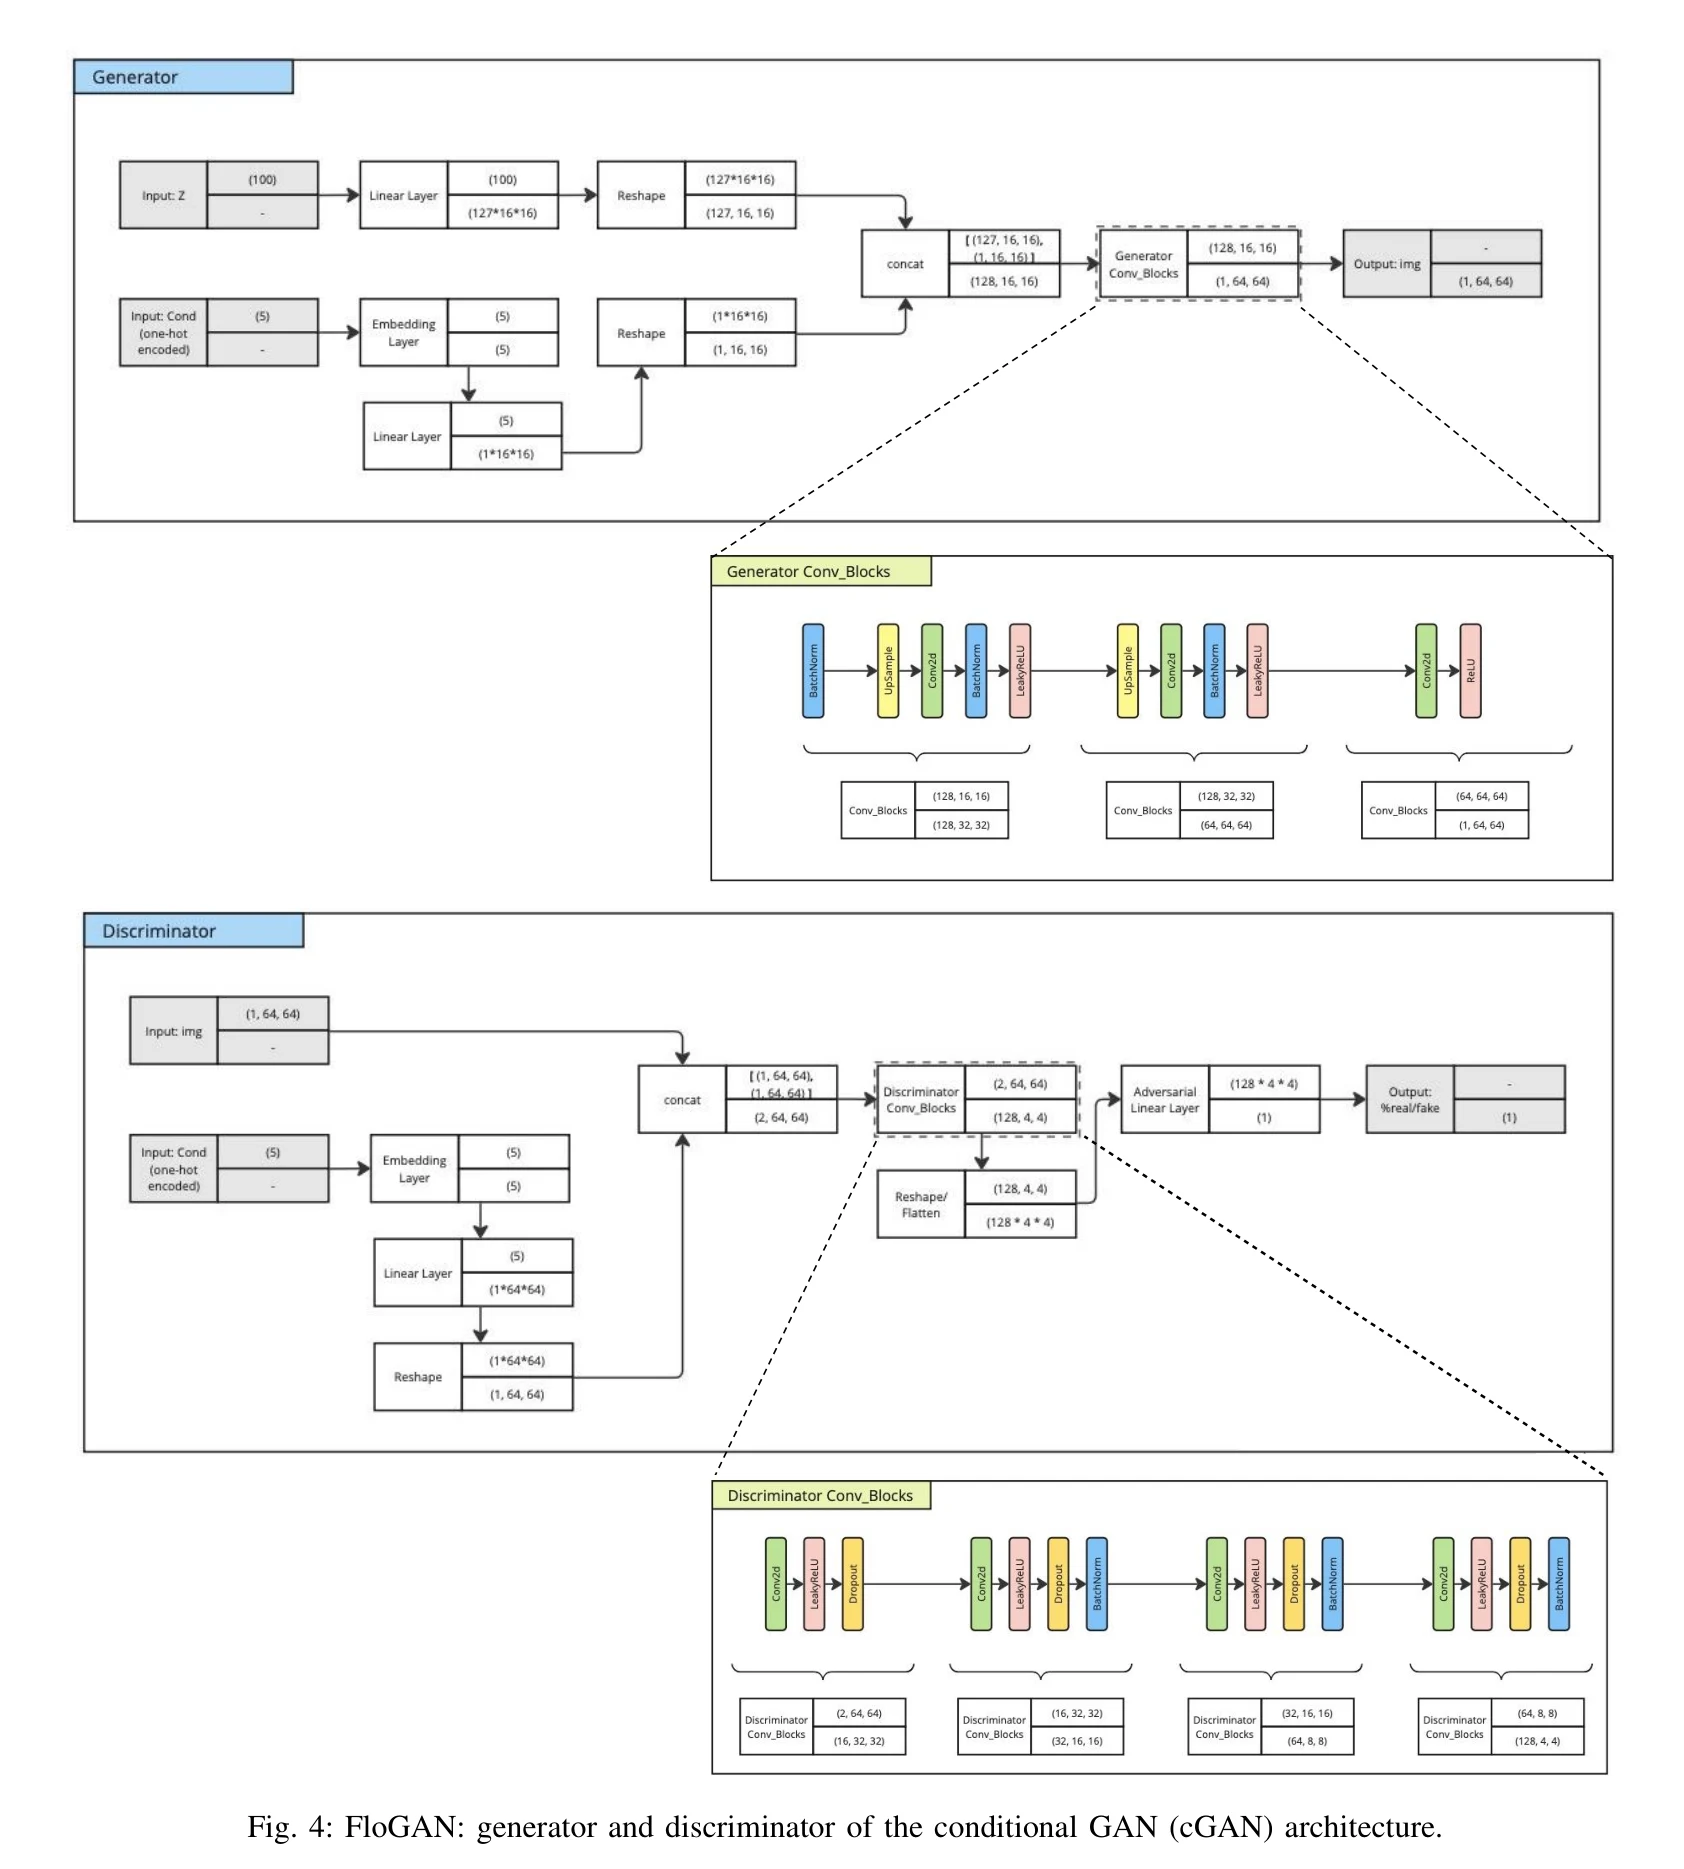
图 4|条件和流量矩阵在网络里怎样拼到一起?
无字母子图。上半是生成器:一维条件先嵌入,再变成 1×4×4 的特征图;起讫矩阵变成 127×4×4。二者沿通道拼成 128×4×4;若没有条件,流量矩阵会被放到 128×4×4。随后的卷积块输出 1×64×64 的邻接图。下半是判别器:真实或生成的 1×64×64 图像,与同样变成 1×64×64 的条件拼成 2×64×64,最后得到 0 到 1 之间的真假分数。图中还有各卷积块的形状,正文明确给出的是上述拼接尺寸。来源:原论文 Fig. 4。
这套尺寸说明,条件只占拼接后 128 个通道中的 1 个。它能告诉网络当前是哪一张关注区地图,并不能单独携带一块新用地上有多少商店或住宅。论文后文把更细的用地信息留作后续工作。
和谁比,比的是重合,还是像素?
对照有两个。MoGAN 是为合成移动流量设计的生成对抗网络,原先用于纽约和芝加哥的自行车与出租汽车流量;在这里它不接收地图条件,而是在全部邻接矩阵上一起训练,输出会朝全体训练分布的平均靠。重力模型(也称引力模型)把两地流量写成与两端质量的乘积成正比、并随距离下降,论文举例质量可以是人口或活动水平,距离可以是幂律。但正文没有写明这次拟合用的质量到底是人口、出行量还是别的量,也没有给出估出的距离指数。重力模型按所选动态地图的一份随机训练样本来做,因此它能随地图改变;那份样本有多大,正文没有写。
评价分三层。校验和看生成流量的最大值和平均值,用来检查数值是否还落在说得通的范围。因为矩阵可以看成灰度图,论文使用峰值信噪比 PSNR、结构相似性 SSIM,并在方法里列出弗雷歇起始距离 FID。结果图实际画出的是 PSNR、SSIM 和学习感知图像块相似度 LPIPS,不是 FID。CPC 则回到交通研究常用的口径:每条起讫对上,生成出行量与真实出行量有多少重合,0 是对不上,1 是完全一致。正文没有写出 CPC 的计算公式。
| 数据 | 最大值 | 平均值 |
|---|---|---|
| 真实流量 | 84,480 | 29.28 |
| FloGAN | 442,412.39 | 28.62 |
| MoGAN | 1,202,603.28 | 54.76 |
| 重力模型 | 240,095.27 | 13.62 |
表 I 的最大值是极端格子有多高,平均值是流量的平均水平。论文没有说明平均是对全部格子(含补上的 0)计算,还是只对有出行的起讫对计算。补零会把平均值拉低,所以 29.28 不能直接读成典型一条起讫链路有 29 次出行。三个模型的最大值都带小数,比较的是模型输出的流量数值,不是清点得到的整数人次。
所有模型都高估极端值。论文给出重力模型的高估倍数为 2.84,对应 240,095.27÷84,480。FloGAN 的最大值约为真实最大值的 5.24 倍(442,412.39÷84,480),MoGAN 约为 14.24 倍(1,202,603.28÷84,480);这两个倍数是由表中两行相除,不是论文另给的指标。平均值上,FloGAN 的 28.62 与真实 29.28 相差 0.66,重力模型低 15.66,MoGAN 高 25.48。这三处都是与表 I 真实平均值相减,不是相对误差的百分比。因此 FloGAN 更接近整体水平,并不等于它更接近最大的那几条流量。论文把极端值难拟合归因于历史数据里这类事件少,这是解释,不是单独的因果检验。
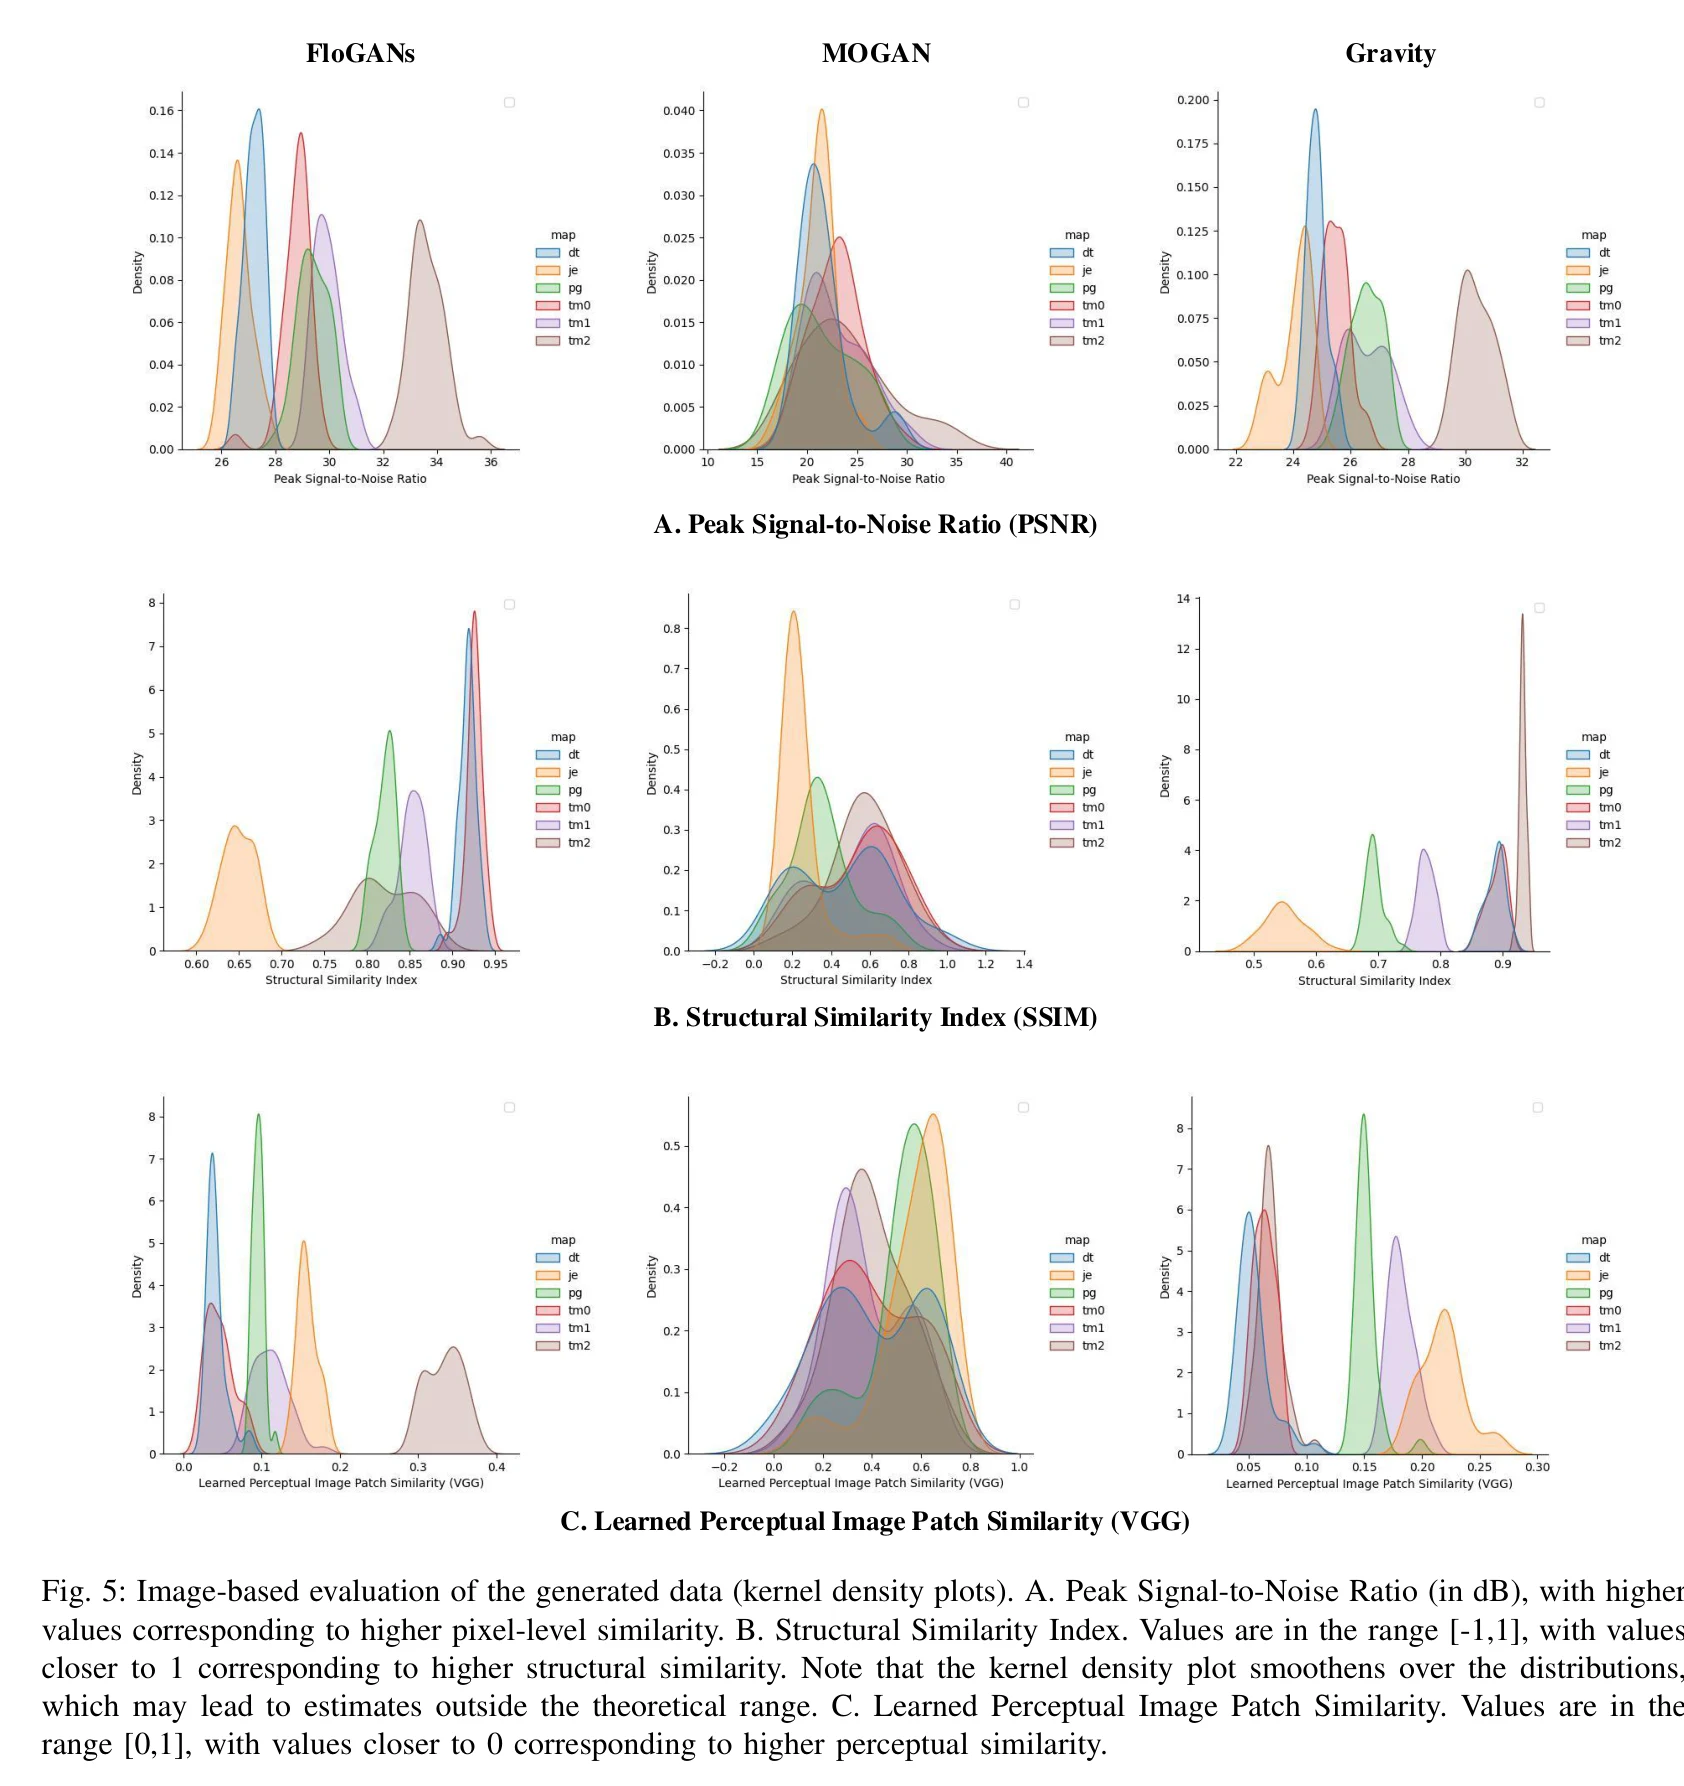
图 5|按图像来看,三套流量谁更接近真实矩阵?
(A)峰值信噪比,单位是分贝,越高表示像素级流量差异越小。三列分别是 FloGAN、MoGAN 和重力模型,颜色是六张动态地图;三列横轴刻度不同,不能把峰的左右位置当成同一把尺子上的高低。FloGAN 的最低值高于 MoGAN 的最低值,与重力模型则按地图大体相当。(B)结构相似性,越接近 1 越相似;图注写明理论范围是 −1 到 1,核密度平滑可能画出这个范围之外的估计。论文写 MoGAN 大约落在 0.5–0.95,FloGAN 从约 0.6 起更好,并在几乎所有地图上优于重力模型;淡滨尼 2 是重力模型略好的例外。(C)VGG 特征上的感知相似度,范围 0 到 1,越接近 0 越相似。MoGAN 铺在整个 0 到 1;FloGAN 与重力模型整体更低。淡滨尼 2 上 FloGAN 落到 0.3–0.4,重力模型更好;裕廊东上 FloGAN 更好。来源:原论文 Fig. 5。
这些图像指标比较的是矩阵作为图像有多像。它们不是某条起讫链少算了多少人,也没有在正文里写成独立测试集上的误差。PSNR 更敏感于每个格子的数值差,SSIM 和 LPIPS 更敏感于结构。一张图在结构上接近,仍可以在最大流量上差好几倍,表 I 已经表现出这种分裂。
六张地图的重合都更高,说明了什么?
| 动态地图 | FloGAN | MoGAN | 重力模型 |
|---|---|---|---|
| 裕廊东 JE | 0.7381 | 0.5260 | 0.2279 |
| 市中心 DT | 0.8139 | 0.2959 | 0.5118 |
| 榜鹅 PG | 0.9292 | 0.2567 | 0.2824 |
| 淡滨尼 TM0 | 0.8741 | 0.4141 | 0.4832 |
| 淡滨尼 TM1 | 0.9281 | 0.4398 | 0.4533 |
| 淡滨尼 TM2 | 0.8884 | 0.5260 | 0.3957 |
| 平均 | 0.8619 | 0.40975 | 0.3923 |
表 II 为每张动态地图各报告一个 CPC,最后一行是这六个数的平均。FloGAN 六张都高于另外两列。它自己的六个数里,最低是裕廊东 0.7381,最高是榜鹅 0.9292。重力模型并不是每张都低于 MoGAN:市中心重力模型 0.5118,高于 MoGAN 的 0.2959;裕廊东则是重力模型最低,只有 0.2279。平均之后,FloGAN 比 MoGAN 高 0.45215(0.8619−0.40975),比重力模型高 0.4696(0.8619−0.3923)。这两个差仍是 0 到 1 的重合系数之差,分母是六张地图各自的 CPC,不是出行人次。
和图像指标合在一起看,名次会变。淡滨尼 2 的 CPC 仍是 FloGAN 更高(0.8884,对照重力模型 0.3957),但 SSIM 上重力模型略好,LPIPS 上也是重力模型更接近。榜鹅的 CPC 最高,不能因此说它在每一种图像指标上都同样领先。论文把裕廊东写成居住、商业和商务活动集中、因而流量最复杂的地方,把市中心写成商业与商务功能集中;淡滨尼 2 与相邻的 TM0 同为居住导向。这是对地图差异的说明,正文没有给出各类用地的面积比例。
还有三项边界直接限制这些数字能说到哪里。第一,正文没有报告训练日和留出日如何划分,也没有报告 FID 的数值、训练轮数或学习率。重力模型使用的随机训练样本没有样本量。因此表 II 的优势是这批新加坡矩阵上的报告结果,不能当成下一个月或另一座城市已经得到同样的 0.8619。第二,方法部分说预训练模型可以在数秒内生成,结果部分没有给出计时实验,秒数还不是测量值。第三,贡献里写需要的校准数据相对少、不必手写复杂行为模型;实验仍然使用了这 30 天的历史流量,并没有展示在完全没有历史起讫矩阵时如何生成。
一句话总结
按关注区生成的人群起讫流量,可以在同一历史月份里比无条件生成和重力模型更重合,但极端流量仍被高估,而且还没有在一块尚未发生的用地变化上得到检验。
核心来源
- arXiv:2507.12053v1,2025年7月16日预印本。正文图 1–5 与表 I、表 II 都出自这一版。
- 数据在论文中引自 CITYDATA.ai 的新加坡匿名手机记录,以及作者此前对电动汽车充电需求的手机数据处理。原始个人记录不在这篇正文里。
- 对照方法来自论文引用的 MoGAN,以及 Barbosa 等人综述中的重力模型与 CPC 用法。本文只采用这篇正文实际报告的比较。
作者介绍
四位作者的身份以论文署名为准。星号、剑号和双剑号分别对应文中的三处机构。
- Seanglidet Yean:署名 Future Cities Laboratory Global、Singapore-ETH Centre。除本篇外,论文参考文献中还有一项与 Zhou、Lee、Schläpfer 共同署名的工作,用手机数据估计电动汽车充电需求。
- Jiazu Zhou:同一实验室署名。在上述充电需求文献的作者顺序中,Zhou 列在首位。
- Bu-Sung Lee:署名南洋理工大学计算与数据科学学院。论文参考文献中,他参与上述手机数据研究,并与 Schläpfer 共同署名一项用高斯过程讨论移动流量预测不确定性的工作。
- Markus Schläpfer:署名哥伦比亚大学土木与工程力学系。本篇参考文献中,他还出现在人类移动到访规律、法国城市空间使用效率,以及流量预测不确定性这几项工作的作者名单里。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若生成结果要进入设施或道路容量的讨论,右尾需要单独过关。表 I 里整体平均几乎对齐,最大格子却可以是真实最大值的数倍;表 II 的平均 CPC 是 0.8619,只说明六张地图上的重合系数较高。按最大格子去配公交或充电容量,会把少数被高估的格子放得过大。一个后续实验可以把损失分成两部分:大部分格子继续看重合,最大的若干格子单独限制不能超过真实最大值的某个倍数。
另一项检验是把条件从地图名称换成真正改变的量。例如只增加某一类用地的比重,或把关注区人口提高一档,再看生成流量是否沿重力模型也会预期的方向变化,并在改变之后的独立月份里核对。同一月份内切换六张关注区,回答的是分辨率开关能否被学会;用地情景是否改变人流,要有一次用地输入不同、出行结果也随之不同的对照。夜间 9 小时和其余 3 小时的窗口也不应直接比总量,按时长换算之后,时段之间的高低顺序可能改变。