总流量还像往常,司机是不是已经改了路?
论文名片|Bei Pan、Yu Zheng、David Wilkie、Cyrus Shahabi,Crowd Sensing of Traffic Anomalies based on Human Mobility and Social Media,Proceedings of the 21st ACM SIGSPATIAL International Conference on Advances in Geographic Information Systems,2013年11月5–8日,美国奥兰多,第334–343页。DOI:10.1145/2525314.2525343。本文依据这次会议论文集的正式版本解读。这是一篇用观测数据做检测的方法论文,对照的是交通部门已经上报的事件,不是随机实验。
2011年5月12日早晨,北京有一块路同时接着主路和辅路。8:30到9:00这半小时里,两条路加在一起的车流量和往常差不多,只看合计流量的方法没有把异常报出来。同一档里,走主路的行程份额已经下降,走辅路的份额上升。论文的方法抓住的是这一下改路。到了9:00到9:30,路径份额开始回到往常,合计流量才明显掉下去。
所以,交通异常(traffic anomaly)不一定先表现为某一条路的车突然变少。这篇论文把异常定义成路网上一小块连通区域:从一些起点路段到一些终点路段,司机在几条路径之间的份额偏离了历史。出租车轨迹用来发现这块区域,微博里同一路名、同一时段突然变常见的词用来描述它可能对应什么事。在北京这三个月的数据上,它比只看路段流量的方法找回更多已经上报的事件。两个案例里的词对得上事故和展会,但论文没有做词语对不对的正式检验。
比较的是一批行程在路径上的份额,以及这块区域的行程时间。不是把某一辆车或某一个人从人群里认出来。
先说结论
- 论文先用一张说明图把两种异常分开。200辆车从 O 到 D 时,平时三条路是 160辆(80%)、20辆(10%)、20辆(10%)。只是总流量减半时,份额可以仍是 80%、10%、10%。改路时总流量仍是 200辆,份额变成 25%、30%、30%,并多出一条 15% 的新路。这是构造例子,表1给出对应辆数,不是某天的实测。
- 数据最后三周里,本文方法的平均召回是 86.7%,只看流量、再用主成分分析找异常路段的基线大约是 46.7%。分母都是这三周交通部门上报的异常,不是路上全部真实异常。论文因此不用精确率。
- 5月12日 7:00–9:00,本文方法找回了该时段全部已上报异常,基线只找回 2 件。16:00–18:00,本文找回 8 件已上报异常,基线找回 7 件。论文另写这一组对照的召回比基线提高 85.6%,但没有给出这一天两边各自的召回分数。
- 5月19日莲花桥北向的两车事故,提到该区域的微博从对照时段的 1.6×10² 条增到异常时段的 1.9×10² 条,accident 的词权重从 0.202 升到 0.978。5月27日北京展览馆的婚博会没有官方交通上报,微博从 2.0×10² 条增到 5.6×10² 条,wedding 的权重从 0.121 升到 0.447。权重不是概率,也没有对过人工标注。
- 详细数据表写的是 13,597 辆出租车、51 个有效日、19,455,948 次行程。摘要和结论写的是超过 30,000 辆出租车、约 3 个月。论文没有解释这两个车数为什么不同。
车还在,只是不走原来那几条路
只给每条路记一个车流量,会把两件不同的事混在一起。一件是从 O 到 D 的车整体变少,每条路仍按原来的比例分这些车。另一件是车的总数没变,但原来走主路的人改去了旁边的路,甚至走出一条以前几乎没人走的路。前一件,流量方法能看见。后一件,如果只盯着合计,或者只盯着事故点那一条路,旁边被挤满的辅路和可以绕行的路都会漏掉。
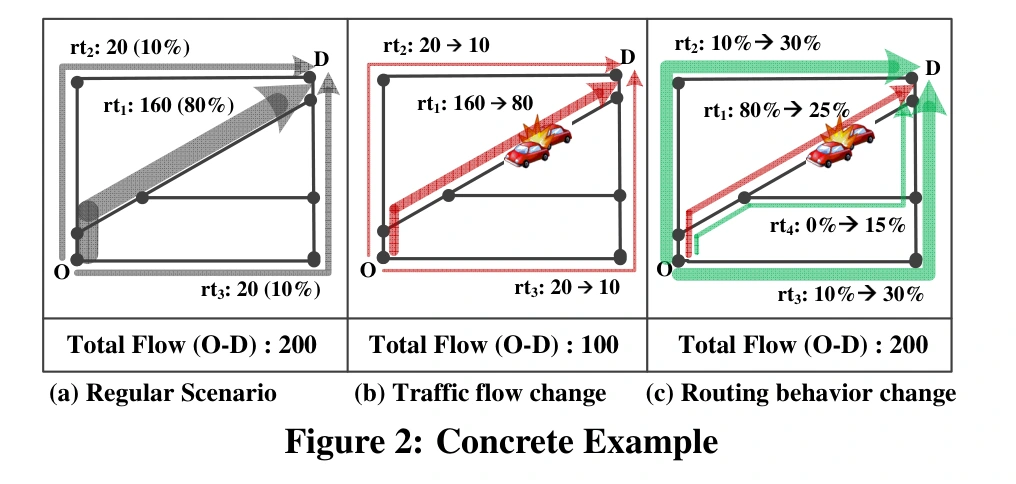
图 2|总流量变化和路径份额变化,是不是同一种异常?
(a)平时 200 辆车里,rt1 为 160 辆、占 80%,rt2 和 rt3 各 20 辆、各占 10%。(b)总流量降到 100 辆,三条路仍按 80%、10%、10% 分配,图上写成 160→80、20→10、20→10。(c)总流量仍是 200 辆,rt1 的份额从 80% 降到 25%,rt2 和 rt3 从 10% 升到 30%,新出现的 rt4 从 0% 到 15%。来源:原论文 Fig. 2。
表1把这三张图写成路径模式。t1 是 ⟨160, 0.8, 20, 0.1, 20, 0.1⟩,t2 是 ⟨80, 0.8, 10, 0.1, 10, 0.1⟩,t3 是 ⟨50, 0.25, 60, 0.3, 60, 0.3, 30, 0.15⟩。尖括号里交替写的是每条路径的车辆数和它占 O 到 D 总流量的比例。50+60+60+30=200,0.25+0.3+0.3+0.15=1。t2 的比例和 t1 相同,变的是总人数。t3 的总人数和 t1 相同,变的是比例,并且多了一条路。
后面的检测要找的是 t3 这种份额变化,而且要把它扩成一张连通的路网子图,不只留下画着车祸图标的那一条边。
北京这三个月,比的是出租车行程
人类移动性在这里具体落到出租车的一次次载客行程,不是居民搬家,也不是全市每一种车。行程按出租车交易记录切开,再把 GPS 点放到路网上。论文写出租车通常 1 到 2 分钟报一个点,表3的平均采样间隔是 70.45 秒。相邻两点中间可能断着好几条路段,作者用一条连接路径把它们补上,并假设两点之间的行程时间沿这条路径均匀分摊。因此,路段上的行程时间是分摊出来的,不是在每个路口用秒表量到的。这个假设会进入后面的延误。
| 项目 | 数值 |
|---|---|
| 数据时段 | 2011年3–5月 |
| 出租车数 | 13,597 辆 |
| 有效天数 | 51 天 |
| 行程数 | 19,455,948 次 |
| 平均采样间隔 | 70.45 秒 |
| 路段数 | 162,246 |
| 路网节点数 | 121,771 |
| 交通上报 | 平均每天 23 条 |
这些数都在表3。分析单位是行程和路段,不是人。用表3可以算出大约 28.1 次行程每车每个有效日,算法是 19,455,948÷13,597÷51。论文自己没有写这个平均数。它只说明:13,597 是车,不是 13,597 个人;近两千万是行程次数,一个人或一辆车会反复出现。
摘要、引言和结论都写超过 30,000 辆出租车、大约 3 个月,并说这约占路网交通流量的 20%,引用的是郑宇等人 2011 年关于出租车城市计算的工作。表3没有 30,000,也没有 20%。20% 是作者加引用后的陈述,不是这张表算出来的。3 个月的日历长度也大于 51 个有效日。两个车数为何不一致,正文没有解释。后文凡是写样本,都以表3为准,并保留摘要的不同说法。
路网是北京的 162,246 条有向路段、121,771 个节点。交通部门发布的异常上报被当作评测用的地面真值,但作者明确说上报只是真值的一个子集:有些确实改了路、也拖长了行程时间的事件,部门没有报。全数据平均每天 23 条上报。论文没有给出最后三周的上报总件数,所以 86.7% 不能还原成“检出了多少件、一共多少件”。
作者认为方法不绑死在出租车上,公共交通或带位置的签到只要能反映路网上的移动就可以用。实验只做了这批出租车,这个推广没有另做验证。
一块异常为什么是一张子图?
路径选择模式(routing pattern)定义在一对起点路段和终点路段上。把从起点走到终点的各条路径上的车辆数,以及这些车辆数占该起讫总流量的百分比,排成一条向量。常规模式不是用均值:先取每条路径在历史里的流量中位数,再用这些中位数之和把它们换成百分比。两条模式的路径条数不同时,短的那条用 0 补到一样长。
两条模式差多少,用马氏距离(Mahalanobis distance)。它和欧氏距离的差别是:各条路径的份额往往一起变化,马氏距离把这种相关算进去,而且不因某一条路的车辆数特别大就把距离撑大。当前模式离历史中位数模式的马氏距离,要达到历史各时段相对这个中位数的均方根的 3 倍,才算这对起讫出现了异常份额。论文把右侧叫作 3 倍标准差,中心用的是中位数。子图还得连通;每条起点路段至少要有一条终点路段满足这个条件,反过来也一样。
真正开始搜索时,作者并不是把每对起讫都查一遍。他们先找种子路段:当前流量离开历史中位流量的绝对差,达到历史流量相对该中位数的均方根的 3 倍。流量极低的路段直接丢掉,因为历史太少,不知道什么叫偏离;论文没有给出“极低”的数值门槛。种子按相对变化而不是绝对变化排序,一次只取一条,把子图扩完,再把已经落在这张子图里的其他候选从池子里去掉。
这里有一个必须说清的边界。图2(c) 的极端情形是每条路的流量都变化不大、只是份额在变。论文说只看流量的方法会漏掉这种情形。可是本文自己的种子也要求某条路段的流量先偏离 3 倍尺度。合计流量不变时,主路减少、辅路增加,仍可以让其中一条路成为种子,5月12日的例子就是这种。若每条路段的流量都不越过这道线,按正文写下的规则,搜索不会开始。实验没有单独报告这样一种“每条路流量都几乎不变”的检出例子。
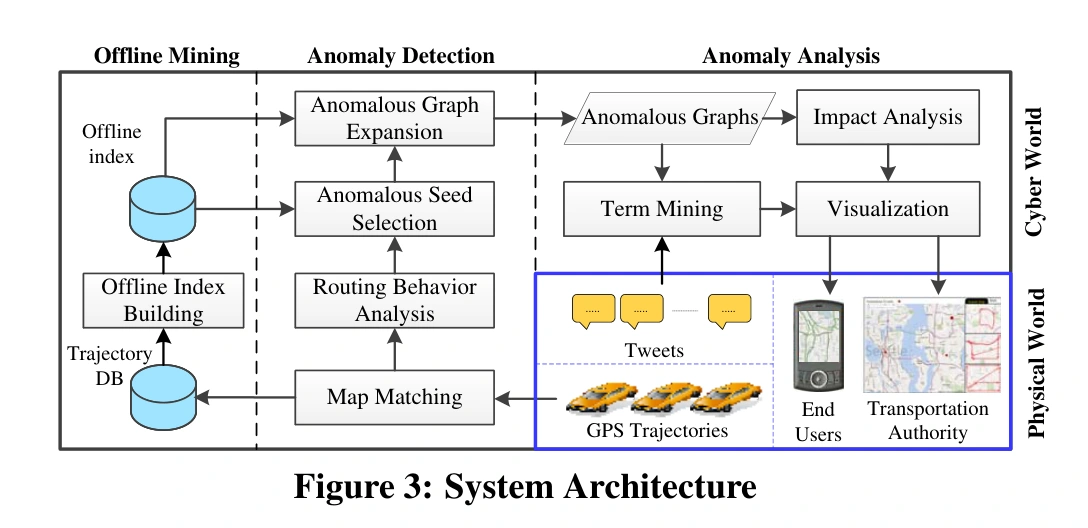
图 3|从行程和微博到一块异常区域,系统分哪几步?
左侧离线部分积累历史行程,建立路段与行程的索引,并统计各路段平时的流量和行程时间。中间在线部分把新到的轨迹放到路网上,选出种子路段,再扩成异常子图。右侧用子图做两件事:算行程时间延误,以及按路名和时间从微博里抽词,然后分别画给司机和交通部门。底下一行是材料来源:出租车轨迹、微博、终端用户、交通部门。来源:原论文 Fig. 3。
评测时,这个在线步骤每 30 分钟做一次。当前档用这 30 分钟里的行程,历史用这一档之前的全部行程,不是只拿以前同一钟点来比。30 分钟是作者选定的折中,他们引用既有研究说间隔越短越及时、计算也越重,但本文没有再报告 15 分钟或 60 分钟的对照实验。
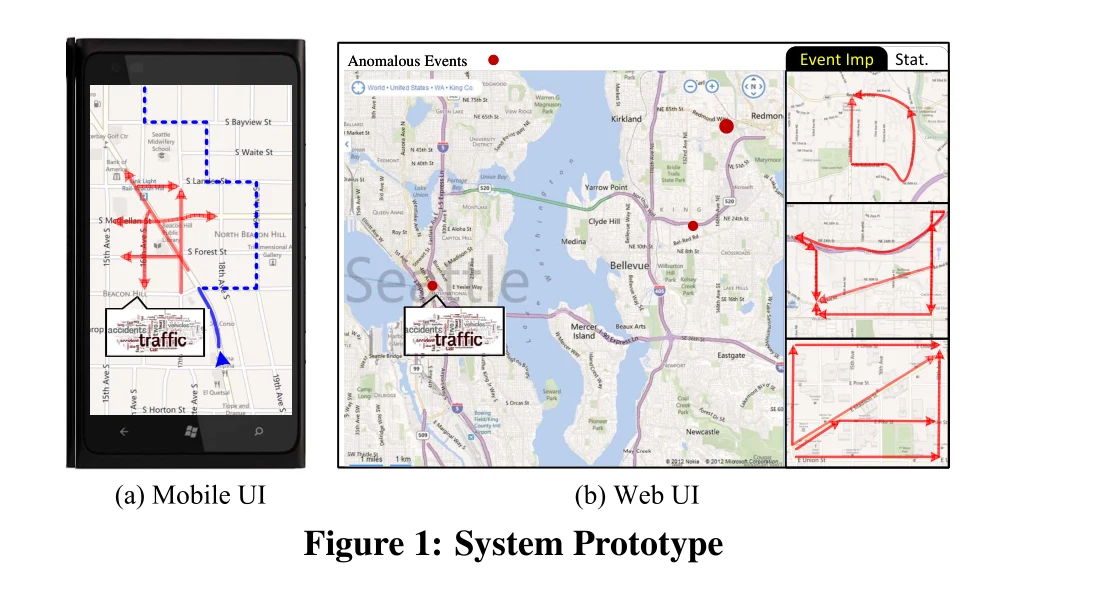
图 1|检测结果打算怎么展示?这张图是界面原型,不是北京实验的成绩。
(a)手机界面把异常路段画成红线,并标出 traffic、accident 一类词。蓝框和箭头表示周围可留意的范围和方向。(b)网页界面在地图上用红点标出多起事件,右侧列出若干块用红线画出的影响区域。底图是西雅图一带,用来演示界面;后文的数据和案例在北京。论文没有报告司机是否因此改道,也没有报告部门是否因此更快疏导。来源:原论文 Fig. 1。
5月12日早上,两种方法差在哪半小时?
地面真值用的是交通部门的上报。召回的分子是这些上报里被方法也找到的件数,分母是该时段全部上报件数。作者不用精确率,因为上报不全:方法找到、部门没写的事件,不能当成误报。基线改自 Chawla、Zheng 和 Hu 在 2012 年的流量方法:对全部路段的流量做主成分分析,找出偏离的路段,再把附近路段收成一张连通图。它不看路径份额。
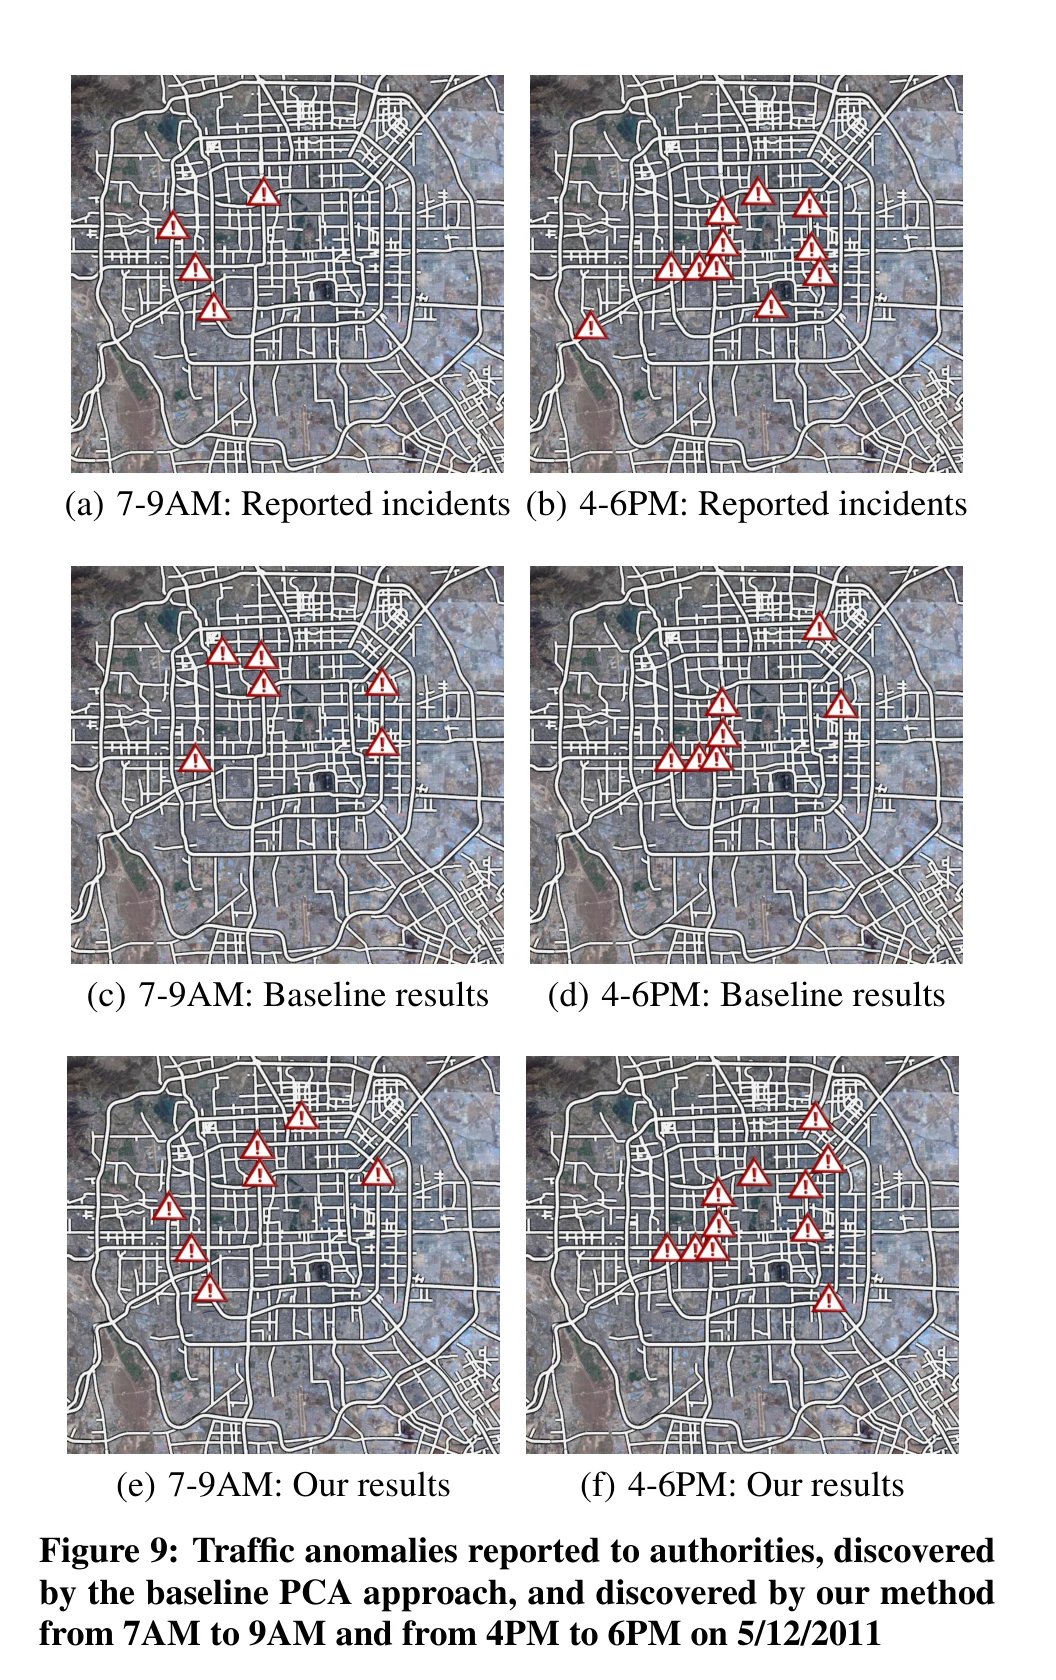
图 9|2011年5月12日两个高峰里,上报、流量基线和本文方法各标出哪些位置?
(a)7:00–9:00 的已上报事件。(b)16:00–18:00 的已上报事件。(c、d)同一两个时段里,只看流量的基线标出的位置。(e、f)本文方法标出的位置。警示标记只表示位置,论文没有在图上标出每个标记对应的件数。文字给出的件数是:早晨本文找回全部已上报事件,基线找回 2 件;下午本文找回 8 件已上报事件,基线找回 7 件。来源:原论文 Fig. 9。
论文接着写,在这一组对照里召回比基线提高 85.6%。这句话没有附上当天的两个召回分数,也没有写明 85.6% 的分子和分母。不能从“早晨全部对 2 件、下午 8 件对 7 件”推出 85.6%,因为早晨和下午的上报总数都没有给出,下午的 8 件也没有被说成就是全部上报。
对最后三周全部上报,本文平均召回 86.7%,基线大约 46.7%。分母同为这三周的上报异常。两者大约差 40 个百分点;基线带有 around,这个差只按论文印出的两位数字理解。作者把差距归因于:本文除了流量变化,还看路径份额。这是方法之间的检出差异,不是对事故原因的因果估计。
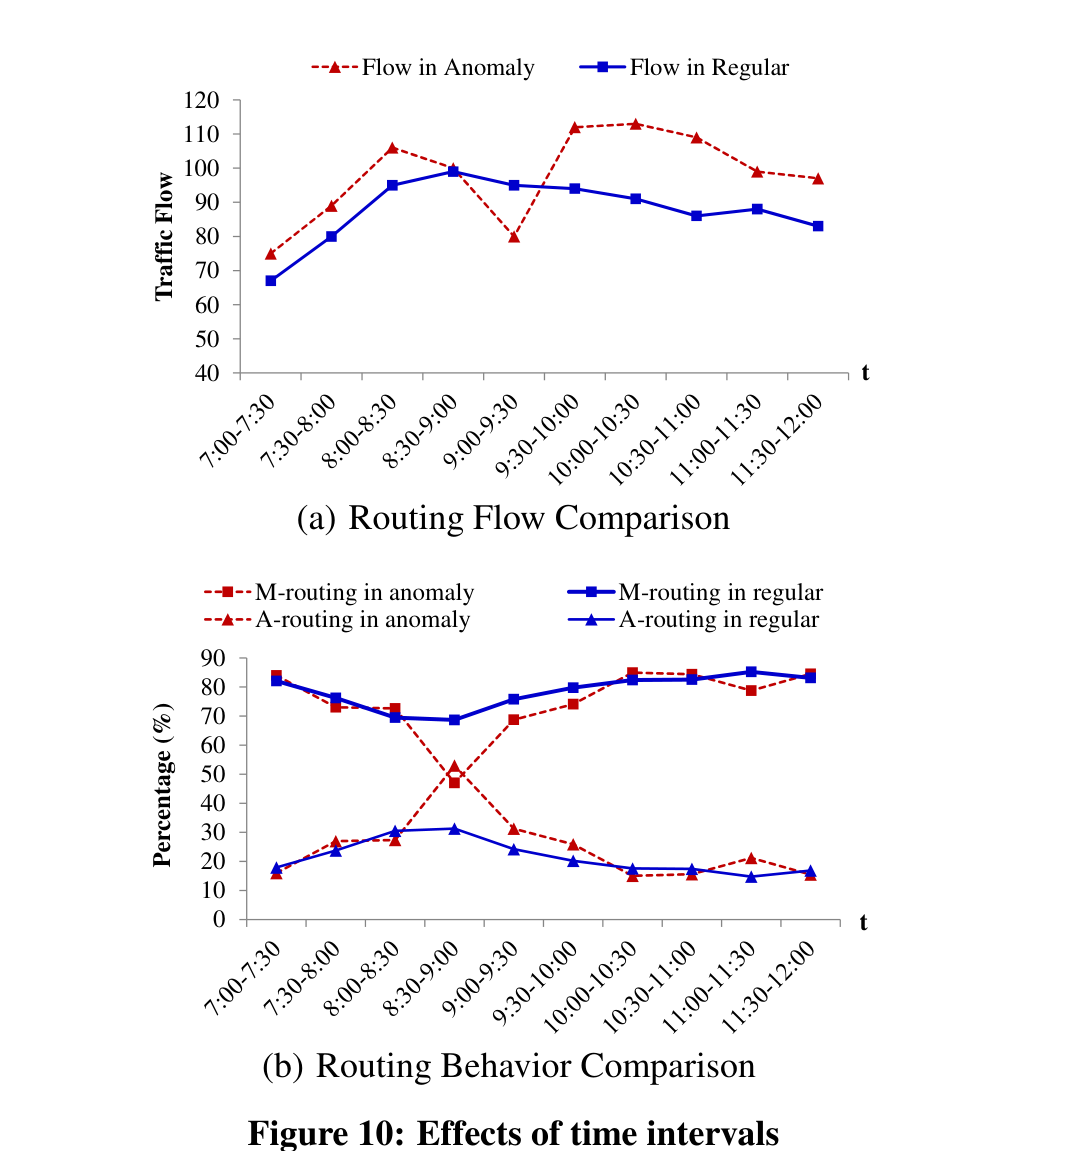
图 10|同一次异常里,合计车流和主路辅路份额哪一个先变?
(a)红虚线是异常当天两条路的合计车流,蓝实线是往常合计车流。纵轴约从 40 到 120,横轴从 7:00–7:30 到 11:30–12:00。(b)红线是异常当天的主路份额和辅路份额,蓝线是往常的主路份额和辅路份额,纵轴是 0 到 90 的百分比。论文没有在曲线上标出每个点的读数。文字说明的是:8:30–9:00 合计流量与往常差不多,路径份额已经变化;9:00–9:30 份额开始恢复,合计流量反而变得异常。图题写的是时间间隔的影响,图内并没有把 15 分钟、30 分钟、60 分钟拿来对比。来源:原论文 Fig. 10。
这个早晨说明,合计流量正常并不表示没有人改路。流量基线要等到下一档合计下降才有机会看见,本文在份额已经变化的那一档就能标出这块区域。它仍然是一个案例,不是三周里每一件上报都早了 30 分钟的统计。
慢下来的路,和只是改道的路
份额变了,司机可能只是换了一条一样快的路,也可能整片区域都在拖时间。作者更关心后一种,因为延误同时花掉司机和城市的时间。一条路段在某时段的代表行程时间,是用该时段各小段的流量做权重、对行程时间求平均:分子是流量乘对应行程时间的总和,分母是流量总和。异常时段相对过去同时段的延误,定义为这两个平均值之差;如果异常时段反而更快,延误记 0,不记负值。子图的影响等于其中每条路段的延误之和。
只有子图总延误达到历史各时段子图行程时间波动的 3 倍,才被留下当作严重异常。论文写明,计算这个标准差时,中心用的是行程时间的中位数,不是均值。没通过这一关的,仍可能是份额异常,只是作者不把它算作严重延误。评测章节没有分别给出过滤前和过滤后的召回,所以 86.7% 不能拆成“只改路”和“又慢”两套成绩。
导航视图用颜色表示当前行程时间相对历史行程时间的倍数:不到 2 倍为绿,不到 3 倍为黄,超过 3 倍为红。黄和绿在“不到 3 倍”的字面上有重叠,图的用法是把更慢的标黄、最慢的标红。若没有行程时间,流量下降标红,否则标黄。分析视图另外用线的宽度表示流量,当前流量用上述颜色,历史流量用黑色。
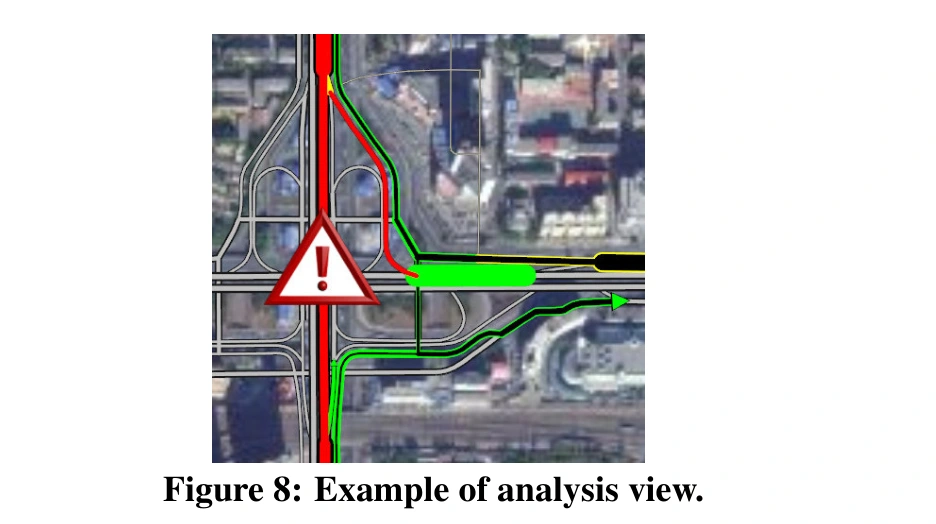
图 8|分析视图怎样同时画出流量和快慢?这是方法说明,不是莲花桥案例。
红、绿是当前流量的宽度和颜色,黑色是历史流量的宽度。论文对这张示意图的读法是:事故附近当前流量低于历史,速度比历史慢超过 3 倍;匝道流出方向流量增加,速度至少还有历史的一半;一些绕行路线流量增加,速度也至少还有历史的一半;匝道流入方向的速度降到不及历史的三分之一。图上没有标出分钟数。来源:原论文 Fig. 8。
两个北京案例用的是导航视图。第一个有上报,第二个没有。
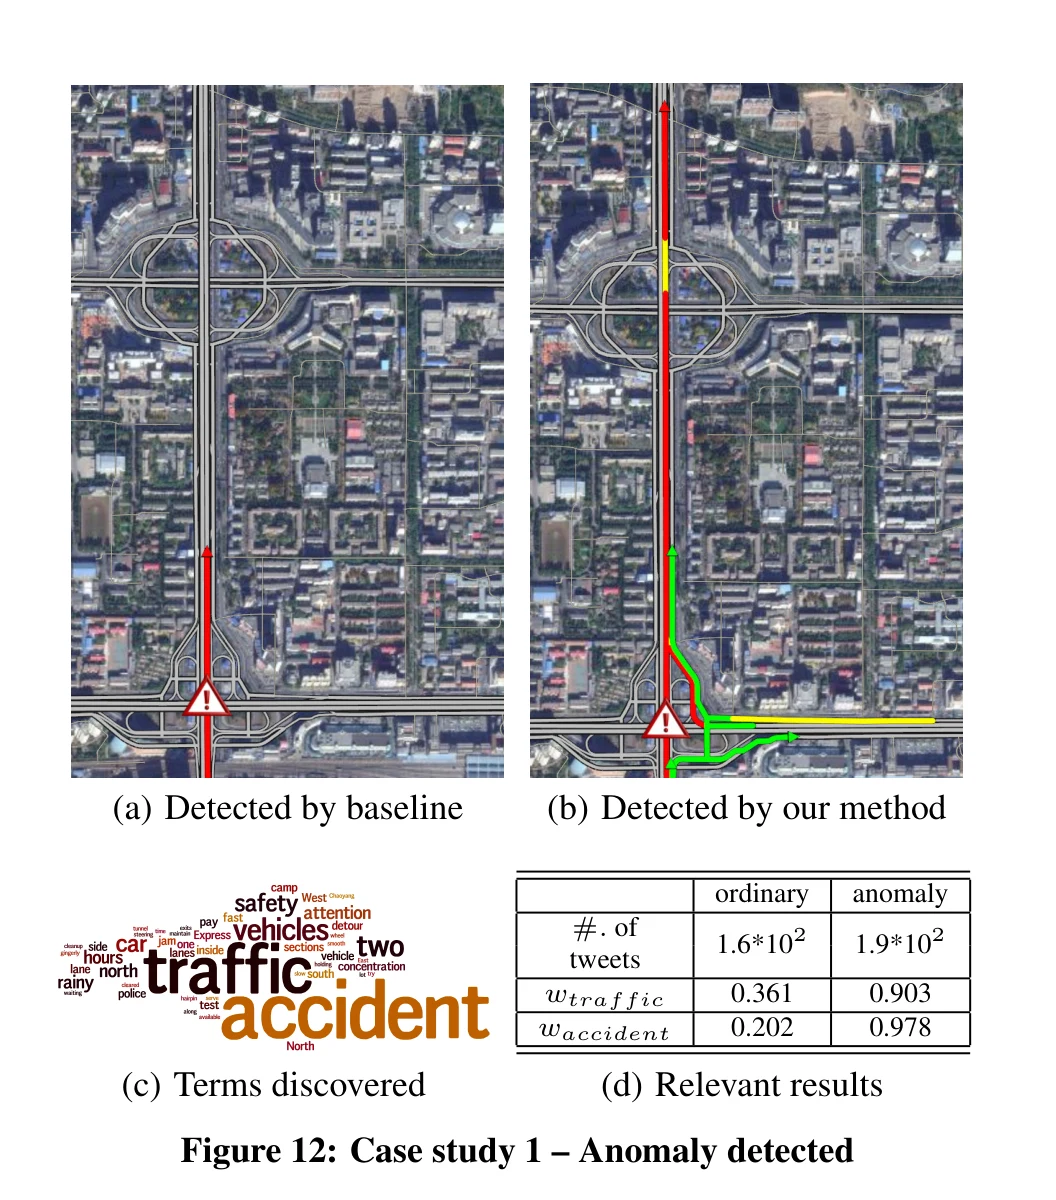
图 12|莲花桥这场已上报事故,流量方法和路径方法画出的范围差在哪里?
(a)基线只标出桥附近高速公路上的一小段红线。(b)本文的子图沿路延伸得更远,红、黄、绿按上面的行程时间倍数着色。作者把其中的黄和绿读成可以绕开红段的辅路;颜色本身只表示快慢倍数,不自动等于推荐路线。(c)权重最高的 50 个词里,最显眼的是 traffic 和 accident,论文还点出 two、vehicles、car、north、rainy。这些词被作者读成两车、北向和当时有雨,与北京交通局的上报一致;论文没有另附天气记录或中文原文。(d)对照时段微博 1.6×10² 条,异常时段 1.9×10² 条;traffic 的权重从 0.361 到 0.903,accident 从 0.202 到 0.978。条数增加不多,变的是用词。来源:原论文 Fig. 12。
上报写的时间是 2011年5月19日 16:00–16:30,地点是莲花桥北向,两车相撞。后文解释历史微博时,又把第一例的时间窗写成每天 16:30–17:00、5月19日之前。两个时间窗在正文里同时出现,论文没有说明为什么差了半小时。
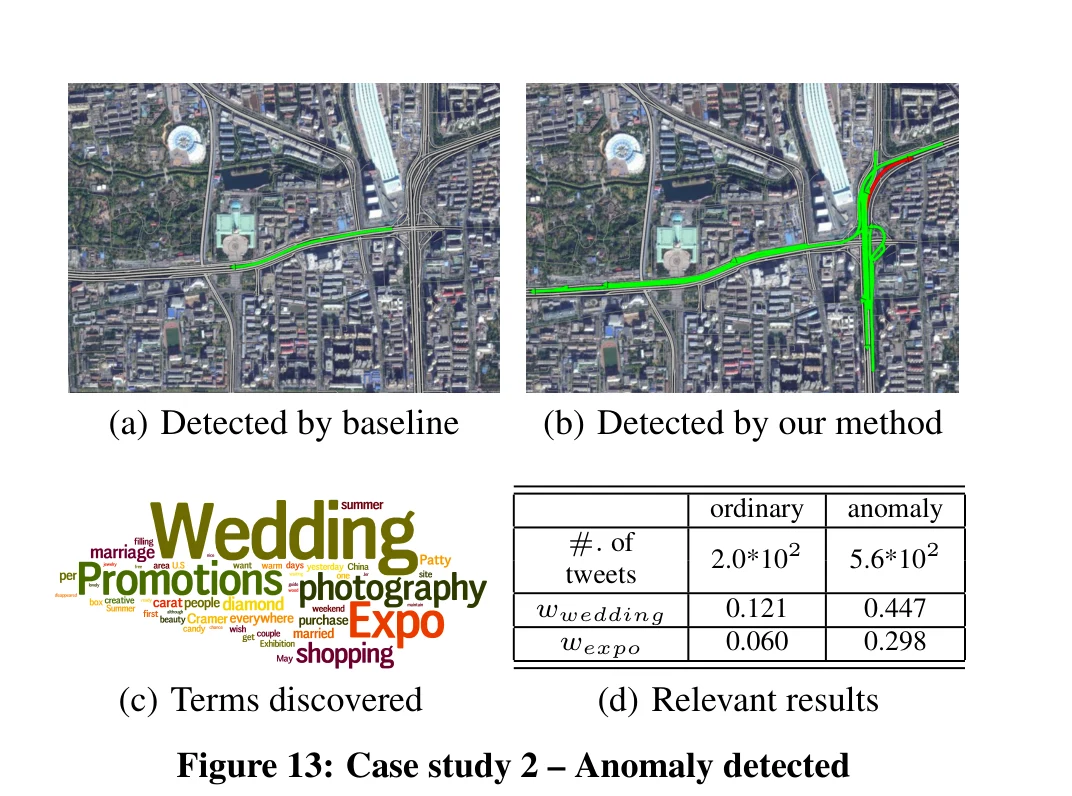
图 13|没有官方上报时,子图和微博词还能不能对上一次活动?
(a)基线只画出一条绿色路段。(b)本文画出更长的一块路网,大部分为绿,其中有一段红。红仍表示行程时间超过历史 3 倍。(c)最显眼的词是 Wedding 和 Expo,论文还点出 promotions 和 shopping。(d)对照时段 2.0×10² 条微博,异常时段 5.6×10² 条;wedding 的权重从 0.121 到 0.447,expo 从 0.060 到 0.298。来源:原论文 Fig. 13。
这一例检测于 2011年5月27日 8:30–9:00,地点在北京展览馆附近。交通部门在这个时间和地点没有上报。作者根据微博和当地新闻写:第 18 届北京婚博会 9:00 开幕,往年会吸引多家婚庆公司和数以千计的年轻人。这个人数来自作者对新闻的转述,不是从出租车轨迹里数出来的。检测窗结束在开幕时刻,所以看到的是开幕前后的路网变化。作者用 probably caused 来推断展会带来了延误。这是词、时间和地点放在一起之后的解释,不是把到场人数和延误做了对照。
微博词是线索,分母要换成同一地点的历史
子图的作用之一,是把微博从全城收成“这些路名、这段时间”。检索范围包括发在这个位置的帖子,以及正文提到这些路名的帖子。同一天、同一个时间窗里的帖子合成一份当前文档;历史上每一天的同一时间窗各合成一份文档。词的权重是当前文档里的相对词频,乘上它在历史日文档里的逆文档频率。相对词频的分母是当前文档中出现最多的那个词的次数,不是帖子总数。逆文档频率是历史日文档数,除以含有这个词的历史日文档数,再取对数。一个词要在当前窗里常见、在过去同一钟点少见,权重才高。
论文自己举的反例是:异常若发生在一家有名的餐馆旁边,这个时间窗里既会有人写堵车,也会有人写菜名。和历史同一钟点比过之后,天天都出现的菜名权重会低下去。这只能去掉长期常见的词,不能证明留下的词就是堵车原因。
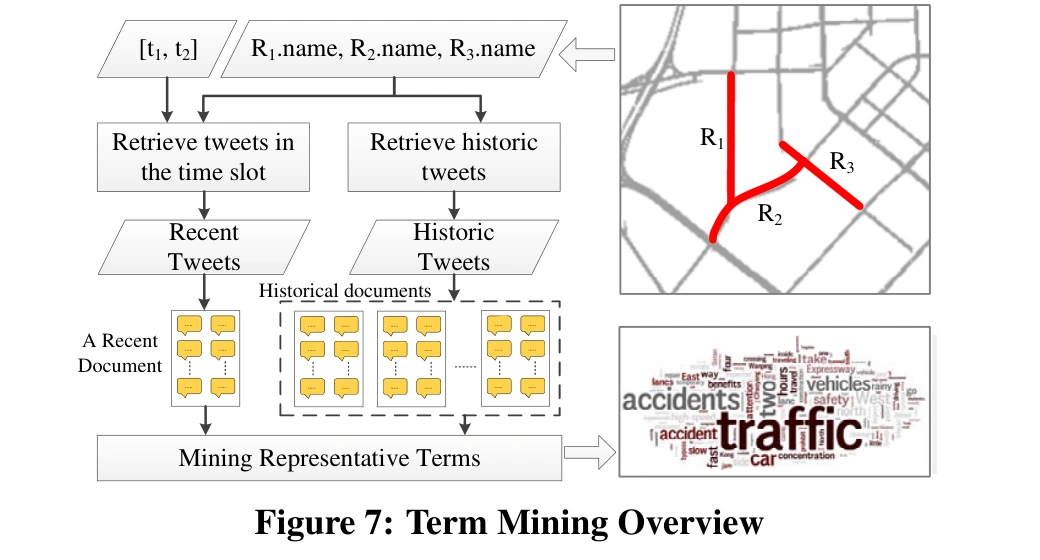
图 7|词是怎样被路名和时间窗收窄的?
左侧用异常时间窗 [t1, t2] 和路名 R1、R2、R3 分别取出当前帖与历史帖。当前帖合成一份文档,历史帖按天分成多份。右侧地图是这三条路段的示意,下方词云的字号按权重缩放,示意里最大的词是 traffic。这张图没有子图字母。来源:原论文 Fig. 7。
和只靠社交媒体的基线比,作者借用的是 Sakaki 等人用微博探测地震的思路,但去掉了关键词过滤。地震检测可以事先写死 earthquake 一类词,交通异常事先不知道该写事故、封路还是展会。于是基线保留“不按关键词过滤”的大范围帖子,本文则先用子图的路名和时间把范围缩小。表5比的是用了多少条微博,不是两种文本方法的召回。
| 案例 | 基线历史帖 | 基线当时帖 | 本文历史帖 | 本文当时帖 |
|---|---|---|---|---|
| 莲花桥 | 9.1×10⁷ | 1.7×10⁶ | 9.7×10³ | 1.9×10² |
| 婚博会 | 8.5×10⁷ | 1.9×10⁶ | 3.4×10⁴ | 5.6×10² |
本文当时帖的 1.9×10² 和 5.6×10²,与图12、图13里异常时段的条数一致。历史帖是异常时刻在历史上的帖子;作者举例说,第一例的历史是 5月19日之前每天 16:30–17:00 的帖子。基线的条数比本文高两到四个数量级。论文的解释是本文同时限制了空间和时间。表5只有这两行,正文却写成 three cases,没有第三行数字。全文也没有给出微博总库的条数、用户数或采集起止日期。
结论里作者写明,社交媒体用来解释交通异常是否正确、是否有用,留待以后研究。因此,accident 升到 0.978、wedding 升到 0.447,只能说明这些词在当前窗里相对历史更突出,不能当成已经核对过的事件标签。
子图变大以后,清点路径为什么会变慢?
扩子图时要反复看每对起讫上有哪些行程。若把全城所有路段组合都预先做成索引,条目会随路网规模急剧变多。作者的做法是准备两层对照:一层事先记下每条路段被哪些行程经过,另一层在扩展过程中只为当前子图记录“以这条边结束的路径,以及这些路径上的行程”。图4到图6画的是这种归并。它们服务的是路径份额,不是把某一辆车从数据里单独跟下去。下面只说明图上各块是什么,不把更新顺序写成追踪步骤。
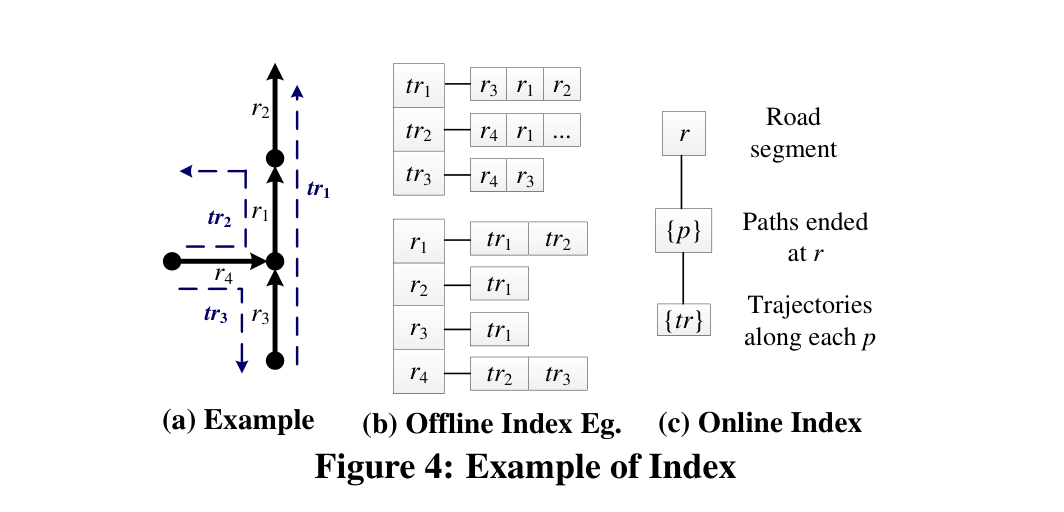
图 4|路段、路径和行程组是怎样对照的?
(a)四条有向路段 r1 到 r4,三条虚线行程 tr1 到 tr3 从上面经过。(b)离线对照分两个方向:从上往下是每条行程包含哪些路段,从下往上是每条路段被哪些行程经过。(c)在线对照的三层是路段、以该路段结束的路径、每条路径上的行程组。来源:原论文 Fig. 4。
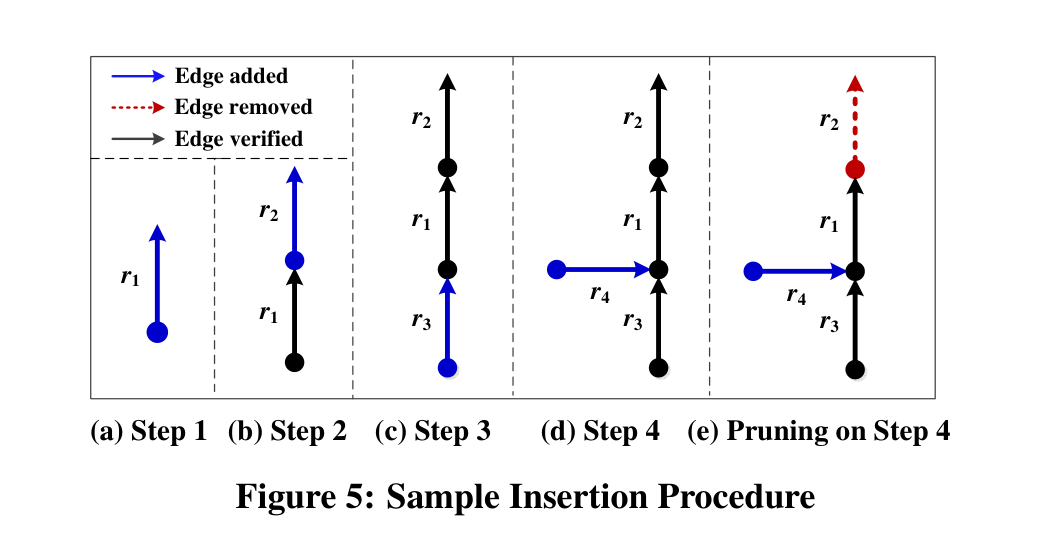
图 5|子图向外加边时,哪条边被留下、哪条边被停掉?
蓝实线是新加入的边,红虚线是去掉的边,灰线是已经核过的边。(a)先放入 r1。(b)在 r1 之后接上 r2。(c)在起点一侧加入 r3。(d)再从另一侧加入 r4。(e)若 r4 到 r1 这一小段的路径份额没有明显变化,更长的延伸不再继续,r2 被画成去掉。来源:原论文 Fig. 5。
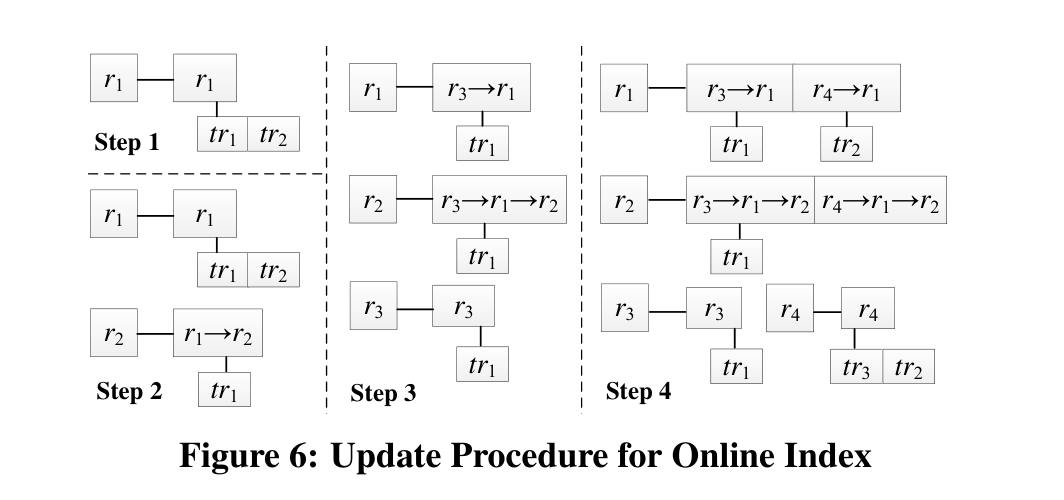
图 6|每加一条边,路径和行程组的对照表怎样变长?
Step 1 只有 r1,下面挂着 tr1 和 tr2。Step 2 接上 r2,路径变成 r1→r2,行程组收成 tr1。Step 3 从 r3 进入,已有路径前面都加上 r3。Step 4 再从 r4 进入,并行增加一组以 r4 开头的路径,其中一组下面是 tr3 和 tr2。来源:原论文 Fig. 6。
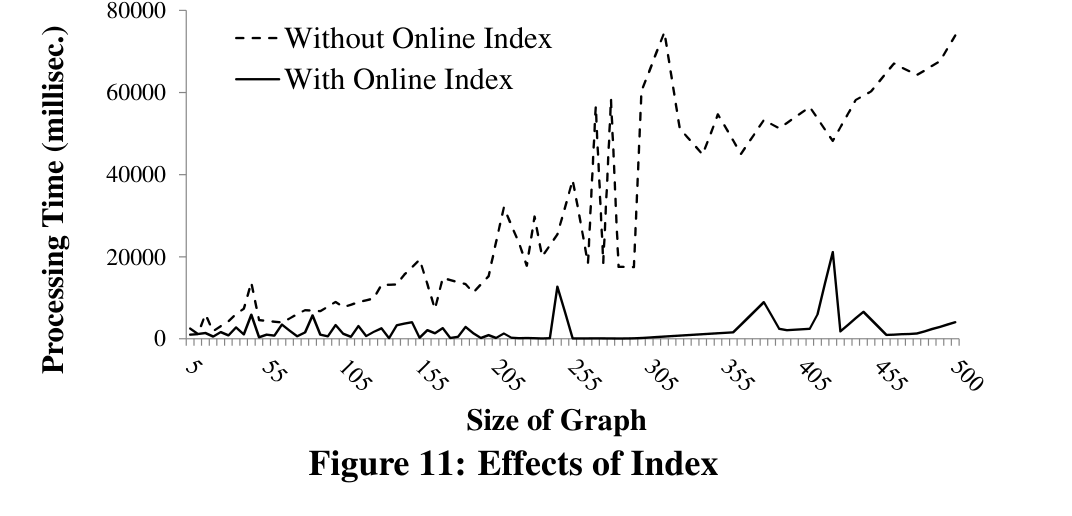
图 11|子图变大时,有没有这层在线对照,耗时差多少?
纵轴是处理时间,刻度到 80000 毫秒;横轴是子图规模,刻度大约从 5 到 500。虚线是没有在线对照,实线是有。虚线随规模变大升到坐标上半区,实线大多数时候留在底部,只有少数尖峰。论文没有标出每个点的毫秒数,所以这里不引用未标注的峰值。来源:原论文 Fig. 11。
另有一张平均耗时表,不要和图11的曲线读数混用。在一台 64 位 Windows Server 2008 上,用 2.66 GHz 处理器的一个线程、16 GB 内存:路径行为分析平均 1.2 秒,种子选择不到 1 秒,子图扩展平均 5.2 秒。结论里的大约 6 秒,对得上这三项之和,不含后台的地图匹配。单条轨迹的地图匹配平均 0.085 秒。作者假设每 30 分钟的异常少于 10 个,则 1 到 2 分钟内可以检完。这是运行时间,而且 10 个是假设,不是测得的每半小时异常个数。它也不提高前面的召回。
这些数停在哪里
召回的分母是上报,不是全部堵车。精确率没有做。86.7% 和大约 46.7% 是最后三周的平均,论文没有给出这三周的上报总件数,也没有按事故、封路、活动拆开。5月12日说明份额可以比合计流量早一个 30 分钟档发生变化,这没有被汇总成全部事件的平均提前量。
出租车不是路面交通的随机样本。作者引用的约 20% 是出租车在北京路面交通里的份额陈述,不是表3里的测量。机场、医院和夜间订单若在出租车里更常见,学校接送和私家车通勤就会较少进入这套份额。检出的是出租车行程所反映的改路。
行程时间沿补全路径均匀分摊,延误因此带有分配误差。3 倍尺度和中位数是检测门槛,不是事故机制的证明。种子依赖流量偏离,所以“每条路流量都几乎不变、只有份额在变”并没有被这套流程单独验证。微博词没有正确率;作者把这件事留到未来。界面原型用的是西雅图底图,也没有用户是否受益的试验。数据是 2011 年北京的 51 个有效日,不能直接当成其他城市、其他年份或其他车种的检出率。
一句话总结
北京出租车上,主路和辅路加在一起的车流还可以像往常,路径份额已经变了;把这种改路收成一块路网区域,再用同一路名、同一时段的微博词来描述,能对上更多交通部门已经上报的事件,但这些词还不是核对过的原因。
核心来源
Pan, B., Zheng, Y., Wilkie, D., & Shahabi, C. (2013). Crowd Sensing of Traffic Anomalies based on Human Mobility and Social Media. In Proceedings of the 21st ACM SIGSPATIAL International Conference on Advances in Geographic Information Systems (pp. 334–343). ACM. https://doi.org/10.1145/2525314.2525343
Bei Pan,论文署名为南加州大学。脚注写明,第一作者和第三作者完成本文时在微软亚洲研究院实习,由第二作者指导。南加州大学 InfoLab 的研究页把 Bei Pan(Penny)列在交通预测相关工作中,并列出本文,以及她与 Demiryurek、Shahabi 关于事故对路网时空影响的研究。
Yu Zheng(郑宇),论文署名为微软研究院(北京)。脚注写明本文实习由他指导。微软研究院城市计算项目的发表列表收录了本文。
David Wilkie,论文署名为北卡罗来纳大学教堂山分校,同样在微软亚洲研究院实习。本文可视化部分引用了他与 Sewall、Lin 关于把 GIS 路网转成可用于仿真的道路模型的工作。
Cyrus Shahabi,论文署名为南加州大学。脚注写明作者的部分工作受美国国家科学基金会项目 IIS-1115153 和 IIS-1320149 资助。南加州大学 Viterbi 教师页介绍他为计算机科学、电子工程与空间科学方向的教授,研究包括空间数据库和地理信息系统。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
出租车若大约只占路面交通的两成,这两成也不是随便抽出的两成。医院、机场和夜间的订单更容易进出租车轨迹,学校接送和单位班车更容易缺席。一套以出租车路径份额为准的报警,可能在出租车走廊上早半小时看见事故,却在以私家车为主的校门前几乎没有信号。86.7% 回答的是“已上报事件里有多少也被出租车份额看见”,没有回答“私家车的延误里有多少会被看见”。
婚博会这例正好卡在官方没有上报、而词已经升高的半小时:微博从 2.0×10² 条到 5.6×10² 条,wedding 从 0.121 到 0.447,检测窗结束于 9:00 开幕。若实际用途是提醒司机一件部门还没写出的事,这比再发现一次已经上报的事故更有信息量。可是权重没有时间单位。司机仍然不知道红段会再红 20 分钟,还是红一整个上午。论文没有用随后几个 30 分钟档检验这个词能不能预测延误还要持续多久。
还有一种相反的触发。若导航软件或一条新的潮汐车道把主路份额从大约八成稳定地挪到一半,历史上的中位数会被打破,子图可以是真的,微博里却没有 accident,也没有 expo。三周召回只和已上报事件比,数不出这种计划中的改路会被报成异常的频率。作者已经把“词是否真能解释异常”留作以后的工作;在那之前,一块红线和一个升高的词,仍是两件需要分开核实的事。