全城路况测不全时,移动数据加深层网络能提前说出下一段交通吗?
论文名片|Zhidan Liu、Zhenjiang Li、Kaishun Wu、Mo Li,Urban Traffic Prediction from Mobility Data Using Deep Learning,IEEE Network,2018,32(4):40–46,2018年7—8月。DOI:10.1109/MNET.2018.1700411。这是一篇综述:它整理移动数据如何进入速度、流量和事故风险的预测,并讨论深层网络在其中的位置。
早高峰出发前,导航要回答的是接下来一段时间某条路会怎样,而不是只描述此刻。把这条路过去的速度顺着时间外推,看起来就够用。线圈和摄像头却通常装在一部分重要路口,部署和维护成本使它们难以铺满全城。出租车和公交车的定位、公交与地铁刷卡、事故记录、社交媒体,能把观测扩到更大范围,也把高峰与平峰、工作日与周末、天气、管制和偶发事件叠在同一些记录里。
这篇综述的方向性判断是:深层网络可以从这些移动数据里自动抽出多层特征,用来预测路段或区域上的速度、流量和事故风险;文中回顾的早期尝试被认为已经好于浅层对照。文章没有印出那些对照的误差定义、样本量和差值,因此这里能核对的是任务怎么拆、模型怎么对应,以及作者还留出的两个未完成方向。
先说结论
- 预测目标被收成三类,单位是路段或区域。速度是该路段上全部抽样车辆的平均行驶速度,还可以按未给出的规则映射成慢、正常、快。流量是一段时间内通过该路段或区域的车辆数或人数。事故风险是该路段或区域发生事故的可能性。
- 文章推荐的链路里,深层网络先做特征提取。原始移动数据经过多层抽象后,再交给人工神经网络、支持向量机或逻辑回归等传统模型输出预测。图4画的是这条分工,文章没有为此新做一次消融实验。
- 模型跟着数据的形状更换。单路段的速度序列用受限玻尔兹曼机、循环网络或长短期记忆网络;整网速度排成“路段×时间”的矩阵后用卷积神经网络。城市各区域的流入流出被分成近期、近历史、远历史三组,各自卷积,再与天气、节假日等外部因素合成,一共四个部分。事故风险用堆叠去噪自编码器提取特征,再做逻辑回归。文中对这些尝试只写“更高”或“优于”,没有百分点。
- 作者提出两个尚未在本文完成的方向:为每个指标联合选择数据来源、模型结构和融合方式;用参数服务器训练通常含数百到数千层的模型,并按地理位置放置数据。文章没有加速比,也没有因此得到的精度。
预测的是哪三种数,分母分别是什么?
文章采用的定义是:依据当前和历史交通信息,预测未来几秒到几小时的交通状况。这个时间范围引自一篇短时交通预测综述,是领域里的说法,不是本篇自己实验的预测步长。
移动数据(mobility data)在这里是车辆、乘客和路侧设备留下的交通观测。文章把它分成四类。路侧设施包括埋在重要车道下的线圈检测器,以及架在路口上方的摄像头。线圈检测车辆通过,并被用来计算每辆通过车辆的行驶速度,以及一段时间内通过的车辆总数,也就是该处的流量;摄像头则靠计算机视觉得到速度和流量。第二类是装有定位设备的出租车和公交车:车辆定期报告位置、速度和方向,这些报告被当作道路交通状况的测量。第三类是公交和地铁的自动收费记录(automatic fare collection,AFC)。乘客上下车时刷卡,系统记下车站和时间,全部记录可以汇总成站与站之间的客流起讫矩阵。第四类是事故报告、社交媒体、基站尺度的手机数据,以及众包传感。事故报告含地点、严重程度和事件;社交媒体被看成探测城市异常的传感器;手机数据停在基站这一级,为交通状况提供线索。
图1把这条链路画成三个台阶:左边收集数据,中间用历史数据训练并固定一个交通模型,右边在实时数据进入后输出预测。图上画出的来源是线圈、摄像头、装有定位设备的出租和公交、自动收费和社交媒体。事故报告、基站尺度的手机数据和众包写在正文里,没有全部画进这张图。
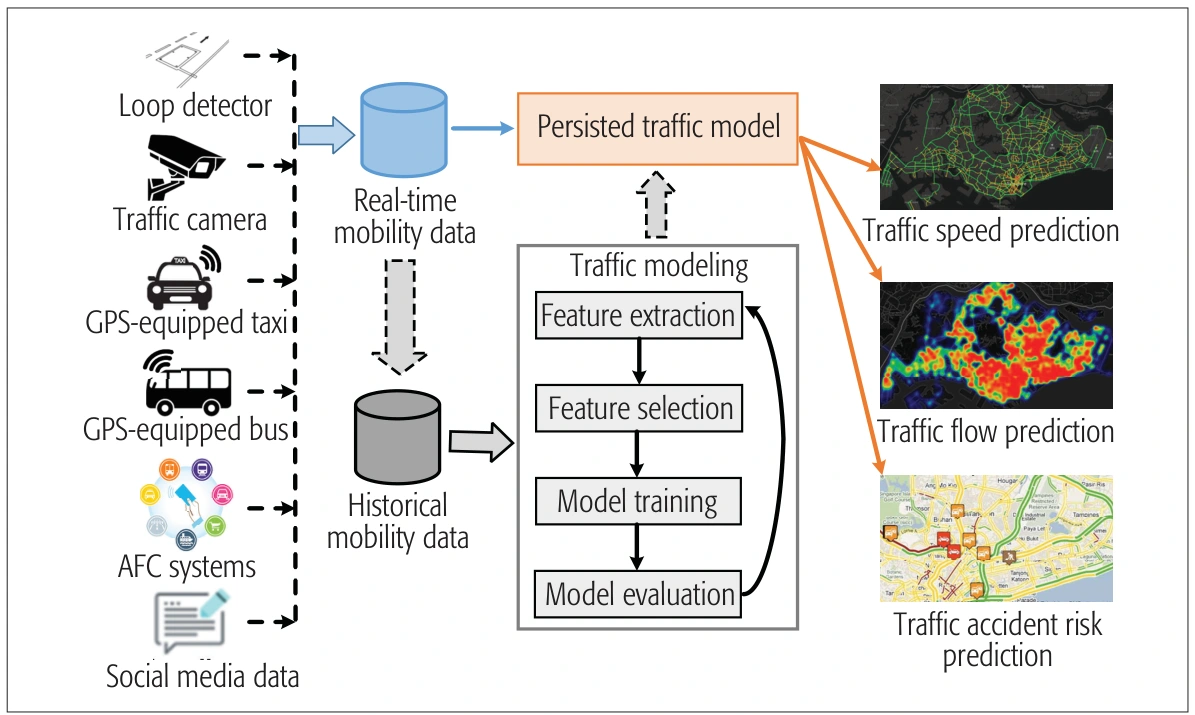
图 1|移动数据怎样变成速度、流量和事故风险三种预测?
无字母子图。左侧图标经虚线汇入两类数据:蓝色圆柱是实时移动数据,灰色圆柱是历史移动数据。历史数据进入中间的交通建模循环,依次为特征提取、特征选择、模型训练和模型评估,评估后的弯箭头回到提取,表示可以重复。向上的虚线箭头指向已经固定的交通模型,实时数据也指向这个模型。橙色箭头分到右侧三幅示意:路网着色表示速度预测,热力表示流量预测,街道地图表示事故风险预测。三幅图都没有色标单位,底图上的街道名也没有被正文指定为案例城市。来源:原论文 Fig. 1。
传统建模被写成一个可以反复的过程。先从原始记录里取出与目标有关的量,再按信息熵等标准留下一小部分互不冗余的特征,用大量训练数据调节参数,用测试数据评估,直到达到所要求的表现,例如精度。固定下来的模型接收实时输入,给出预测。文中用一条路段说明这些特征为什么同时包含空间和时间:路段 sᵢ 的交通状况 cᵢ,既受相邻路段影响,也受一天中的时刻影响,例如高峰与平峰,还受一周中的日子影响,例如工作日与周末。这是对因素的列举,文章没有估计这三项各自的系数。
表1把三个目标和它们在文中对应的数据、输出对齐。速度一行的数据是路侧设施和装有定位设备的车辆,输出是平均速度或拥堵等级。流量一行是路侧设施和自动收费,输出是通过道路或区域的对象总数。事故风险一行加上社交媒体和历史事故报告,输出是每条路或每个区域的事故风险概率。手机数据和众包出现在正文的数据分类里,没有进入这张表的单元格。
| 类别 | 涉及的数据来源 | 希望得到的输出 |
|---|---|---|
| 交通速度预测 | 路侧设施,装有定位设备的车辆 | 平均交通速度(或拥堵等级) |
| 交通流量预测 | 路侧设施,自动收费系统 | 一段时间内通过某条道路或某个区域的对象总数 |
| 交通事故风险预测 | 路侧设施,自动收费系统,社交媒体,历史事故报告 | 每条道路或每个区域的事故风险概率 |
速度的分母是“该路段上的全部抽样车辆”。抽样可以来自线圈和摄像头的间接推算,也可以来自定位车辆的直接报告。预测速度再映射成慢、正常、快时,文章只给出这三个等级名称,没有给出速度阈值。流量的分母是一段时间、一个路段或一块区域;分子是通过的车辆数或人数。事故风险是可能性,分母不是已经发生的事故次数。三类数不能当成同一种“堵不堵”。
手工挑选的特征,为什么被说成不够?
已有工作主要用自回归积分滑动平均(ARIMA)、人工神经网络(artificial neural network,ANN)和支持向量机(support vector machine,SVM)描述交通。ARIMA用过去观测的线性组合外推下一步;ANN和SVM在这里被归入浅层结构。文章认为,这些模型的上限很大程度取决于人先选出的特征,而选特征依赖经验和专门知识。交通还会受到管制、天气等因素影响,手工选定的特征被认为不足以把交通特征说全,因而预测不够准。这个“不够”引用的是一项用深层模型预测流量的既有研究,比较发生在那篇文献里,本篇没有重做对照,也没有抄录误差。
深层网络被拿来对照的,是它有多层结构:每一层从不同角度取特征,合在一起形成多层抽象。图2画的是这种全连接网络的通用骨架,用来说明后面几种模型共享的层次,而不是某个城市已经训练好的交通网络。
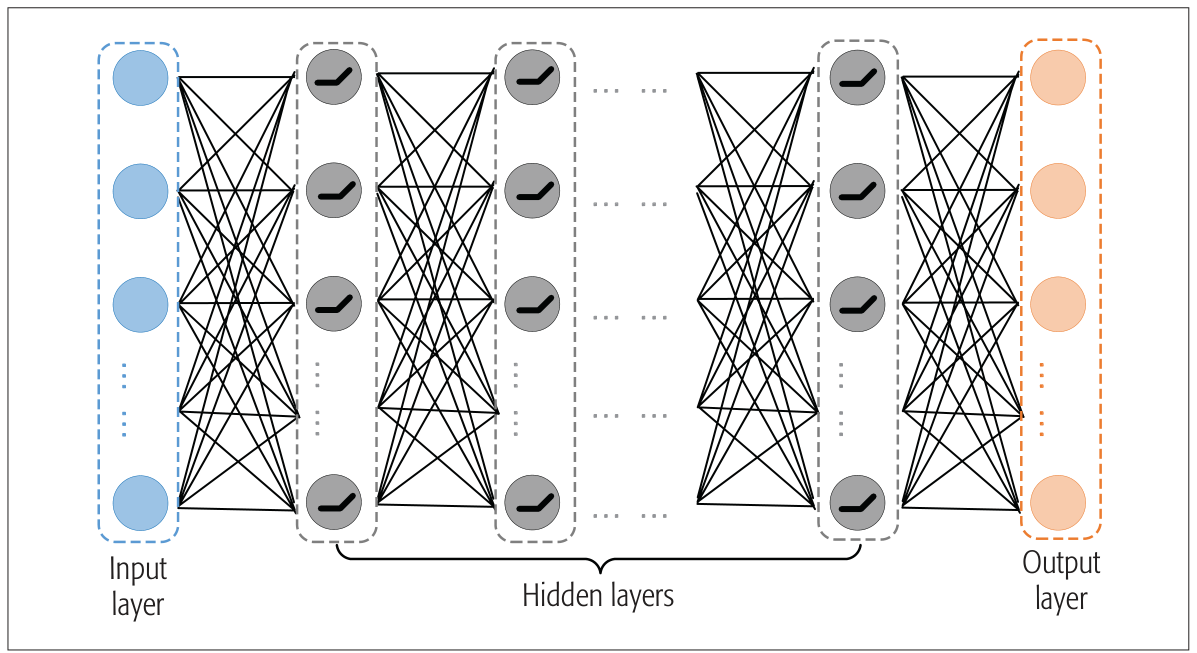
图 2|深层网络的通用骨架里,一层到底在算什么?
无字母子图。蓝色虚线框是输入层,灰色虚线框是隐藏层,橙色虚线框是输出层。隐藏单元上的折线对应正文所说的线性整流单元(rectified linear unit,ReLU):输入 x 变成 max(x, 0),小于 0 的部分变为 0,大于 0 的部分保持原值。相邻层的单元彼此相连,连线带有权重。省略号表示还可以有更多单元和更多隐藏层。正文说隐藏层可以从若干层到一千层以上;图中没有标出任何一个交通模型的实际层数。来源:原论文 Fig. 2。
每个单元用激活函数,根据紧挨着的上一层计算自己的状态,再把状态传给下一层。原始数据初始化输入层,输出层给出想要的推断,中间各层负责把输入状态变成这些推断。这仍是结构说明。它不表示某一座城市的速度已经由这个全连接网络测出。
数据排成序列还是排成矩阵,模型为什么跟着换?
文章接着介绍三种已经用于交通任务的结构,并把早期文献按模型和任务列进表2。表里的“适用情形”是这些模型原本擅长的数据形状,右侧文献号是文中用来举例的交通预测工作。
| 模型 | 适用情形 | 文中举例 |
|---|---|---|
| 卷积神经网络 CNN | 二维数据,例如图像、视频 | 速度预测[7, 8];流量预测[5] |
| 循环神经网络 RNN | 序列数据,例如语音、语言 | 速度预测[8, 9] |
| 长短期记忆网络 LSTM | 长序列数据,例如语音、语言 | 速度预测[10];流量预测[11] |
| 堆叠自编码器 SAE(含堆叠去噪自编码器 SdAE) | 表示学习 | 流量预测[2];事故风险预测[12] |
| 受限玻尔兹曼机 RBM、深度信念网络 DBN | 表示学习 | 速度预测[9, 13, 14] |
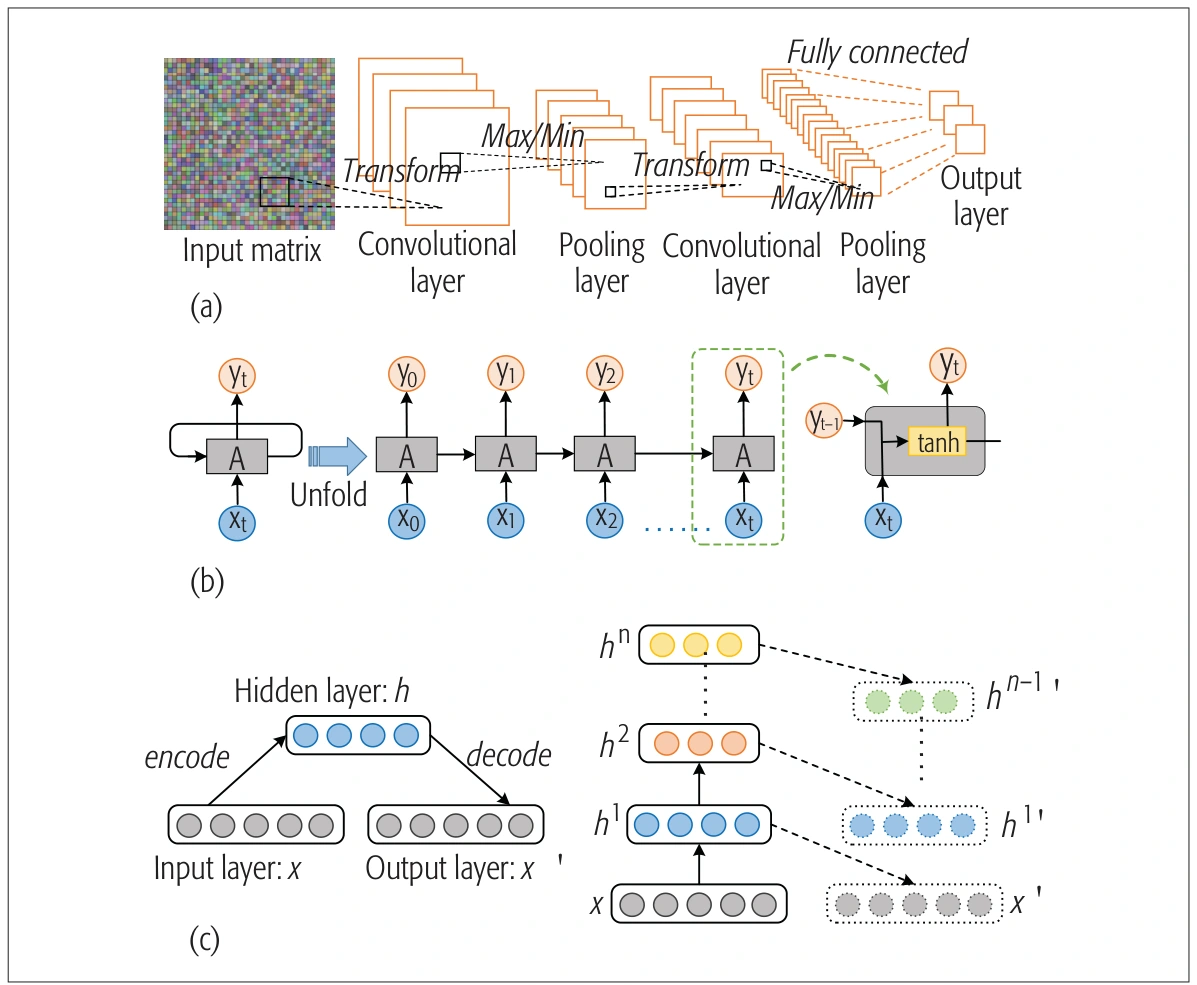
图 3|卷积、循环和自编码器,各自保住哪种数据形状?
(a)输入是一张二维矩阵。卷积层对局部做变换,池化层用最大或最小把一片单元收成下一个单元,从而降低维度;后面可以再接卷积和池化,最后由全连接层完成推断。(b)左侧圆环表示循环网络把信息从一步传到下一步;中间是把圆环展开后的一串网络,各步之间传递相当于记忆的参数;右侧把当前输入 xₜ 与上一时刻输出 yₜ₋₁ 一起送入 tanh,得到当前输出 yₜ。正文认为这种循环能描述时间变化,却难以维持长期依赖。(c)左侧是三层自编码器:输入 x 被编码到隐藏层,再解码成 x′,输出被故意设成输入的重建,隐藏层因此称为特征层。右侧把这样的特征层叠高,得到更上层的抽象。来源:原论文 Fig. 3。
在这个骨架上,长短期记忆网络(long short-term memory,LSTM)用专门的记忆单元把输入保留得更久,并能自己决定预测时回看多长。堆叠去噪自编码器则把故意加扰的样本当作输入,仍要求恢复原来的未加扰数据;叠起来之后,文章认为它能找到较稳定的特征,对噪声输入更稳。这两句是模型性质,不是本篇用某一噪声水平做出来的实验结果。
速度有两条用法,差别在于一次看一条路,还是一次看整张路网。
第一条守在单条路段。以 DeepSense 为例,目标路段记为 s。先选出若干与它相关的路段,把这些路段的速度、若干状态、时间间隔,以及它们到 s 的地理距离送入受限玻尔兹曼机,自动抽出特征,再用这些特征训练支持向量机。训练使用大量出租车轨迹。文章只说它的预测精度高于竞争方法,没有写出精度的定义、竞争方法的名字、轨迹条数、天数或路段数。随后的工作把深度信念网络、受限玻尔兹曼机与循环网络的混合、以及 LSTM 用到单路段的速度序列上,范围主要是一小块路网。
第二条把整网、较长时间的速度排成一张二维矩阵,以匹配卷积神经网络擅长的输入。Ma 等人把路网交通动态变成这样一张“图像”:每一行是一条路段沿时间的演变,每一列是某一时刻整张路网的状况。卷积网络从中提取网络尺度的特征,再交全连接网络做全网速度预测。文章说,这个做法处理二维数据的能力突出,并优于基于 ANN 的方法,也优于基于 RNN 和 LSTM 的方法。优于的幅度、城市、路段数和预测步长都没有印在这里。Wang 等人在卷积输出之后增加一层误差反馈的循环层,用以往时段的预测去补偿当前误差。补偿了多少,本文同样没有数字。
流量被要求放在更大的空间里看,因为人的移动往往跨过一大片地区。做法是把路网或全城划成格子,每个时刻的流量变成一张网格快照。Zhang 等人预测城市每个区域的流入和流出,输入包括历史移动数据、天气和节假日。流入流出可以是行人数、附近道路上驶过的车辆数,或其他与人的移动有关的计数;文章没有指定被引用实验最终用的是哪一种计数。为了同时照顾时间和空间,历史与当前的流入流出被变成类似图像的矩阵,并分成近期、近历史、远历史三组。每一组只用保留卷积层的网络提取空间结构,残差单元序列用来把网络叠深。天气和节假日另走一个全连接网络。三组时间加上这一路外部因素,四个部分各自先预测流入流出,再合并成最终结果。四个部分的权重、格子大小和三组时间各是多少分钟,本文都没有给出。Lv 等人则用堆叠自编码器预测特定路段上的流量,粒度比全市网格更细。文章还点到一项 LSTM 工作,目标是一个人后续的移动和交通方式;正文没有展开数据如何链接到个人,也没有给出误差。本篇展开的流量预测,单位仍是区域或路段上的总数。
事故风险更难,因为拥堵、驾驶行为、道路和天气都可能有关。文章认为风险与人的移动、土地利用和历史事故高度相关,但他们找到并展开的尝试只有 Chen 等人这一项。该方法把城市分成区域、把一天分成时间段。对时间段 t 和区域 r,用历史事故计算风险等级,用历史定位记录计算平均移动密度,分别得到事故矩阵和移动矩阵。两个矩阵进入堆叠去噪自编码器,抽出的特征用来建立逻辑回归。再输入实时的人类移动数据,输出一张风险地图,供可能发生事故时的早期提醒。这张图是模型给出的可能性。文章自己写明,这一方法只使用了人类移动,没有把天气和土地利用放进去,因此还不是综合的风险评估。
说深层网络适合交通预测,适合的是哪一层工作?
文章把手工特征理解成一系列假设:人们事先猜测管制、路况、天气、随机事件和土地利用会怎样影响交通,再把这些猜测做成输入。关系如果又复杂又难写全,事先选中的特征就会漏。多层处理则被描述为另一条路:低层抽象先从输入中取出,再送给后面的层,叠成更高层抽象。作者希望这样得到的高层特征同时对细微差别敏感,例如一天中的不同时刻,并对无关变化不敏感,例如路上经过的是哪一类车。
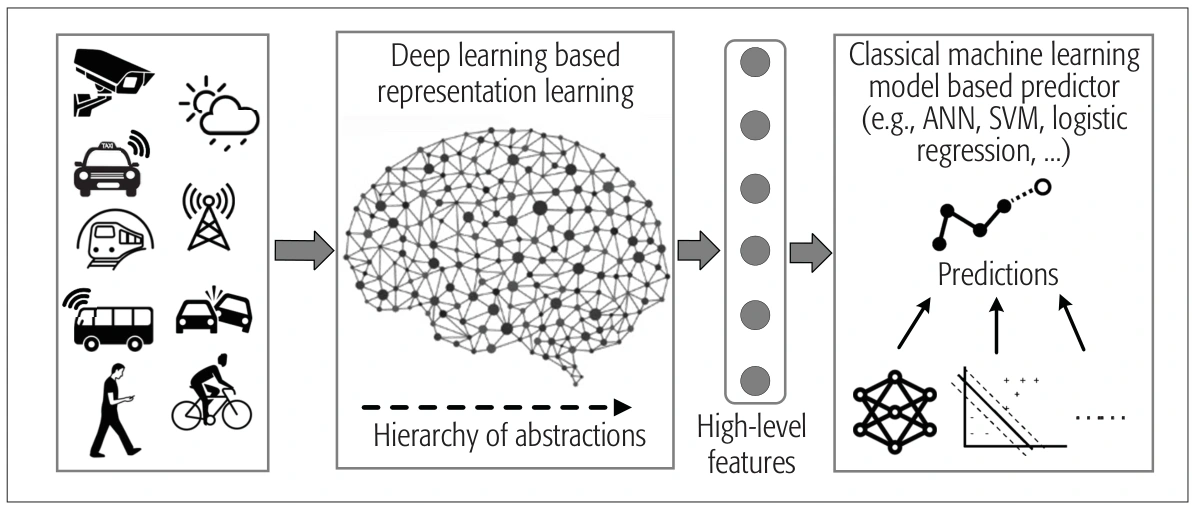
图 4|深层网络和传统预测器在链路里如何分工?
无字母子图。左框是摄像头、天气、定位出租、轨道、公交、事故、行人和骑行等原始观测的图标。中间是标为基于深度学习的表示学习的网络,底部箭头写着抽象的层次。一列圆点被标成高层特征,再进入右侧的传统机器学习预测器,例子是人工神经网络、支持向量机和逻辑回归。右侧小图是曲线、小型网络和带散点的斜线,共同指向预测。大脑形状是示意,不是实测的网络结构图。来源:原论文 Fig. 4。
“对时刻敏感、对车型不敏感”是作者对高层特征所希望的性质,本文没有用开关实验测量这种敏感度。在这个叙述里,深层网络的角色是通用的特征提取器,用来免去繁重的手工特征工程。建在这些特征上的交通模型被说成更有信息、更稳定,因而预测更好。这个“更好”来自对先驱研究的检视,本文没有把各篇误差换成同一个指标再汇总。
要铺到全城,作者还缺哪两步?
第一件未完成的事,是数据来源和模型的联合选择。每个指标未必能从任何单一数据源可靠推出,可是该为每个指标选哪些移动数据,文章认为尚不清楚。即便选定了,还要决定用几个模型、什么类型、多少层,以及怎样把多源输入和多种输出接起来。他们提出的一种做法是先使用全部可得数据源:每个来源各自用深层网络提取特征、各自给出一个预测,再把这些预测融合。融合可以借用集成学习,实践上对不同数据源使用不同的深层模型,并用加权平均得到最终预测,权重由训练过程决定。文章写明,这样做是先放下“选哪些数据”的问题,转为每个数据源单独设计模型。权重用什么损失、是否随小时变化,没有给出,也没有在任何一个城市上报告融合前后的误差。
第二件是用并行计算加快训练和预测。文章说,为抽出这些抽象,深层模型通常含数百到数千层,参数很多;多源数据再加进来,存储和计算会更重。这里的层数是对深层模型计算负担的一般说明,不是表2中某个交通模型的实测层数,也和前面“隐藏层可超过一千层”一样,不能读成 Ma 或 Zhang 等人的网络深度。
他们认为一项训练可以被拆成多台机器上的任务,但怎样在通信和计算都尽量小的同时保住建模效果,仍然困难:任务如何并行、各台机器学到的参数如何合成一个可立刻预测的完整模型,都还要探索。训练数据若在机器之间来回传送,开销会落在训练样本和中间参数上。建议的结构是参数服务器:服务器节点保存最新参数并提供给工作节点,工作节点用分到的训练数据更新参数。另外,由于邻近区域的交通流彼此相关,可以按地理位置把移动数据放到各台机器上,以减少训练时的数据传输。这个相关没有相关系数。文章也没有给出机器数、通信量或加速比,只说还可以把更多交通领域知识放进模型和系统设计。
作者在结尾把全文收成三句:丰富的移动数据和深层网络有潜力推进城市交通预测;表示学习已经带来一些初步成功;上面两个方向用来进一步提高大规模预测的精度和效率。初步成功指的是所综述的早期尝试,成功的幅度不在本文。
这些判断能用到哪一步
这篇是综述和展望。作者写到,据他们所知,这是第一篇专门梳理基于深度学习的城市交通预测的文章。这句话是作者的判断,文章没有附文献检索范围。
文中所有“精度更高”“优于 ANN、RNN 和 LSTM”都是对已发表尝试的定性转述。读者不能从本篇算出提升了几个百分点,也不能把不同文献的误差当成同一个分母下的比较。图1右侧和文中的风险地图是目标或模型输出的示意,不是本篇观测到的事故次数。速度里的“快”没有阈值。流量定义允许人数或车辆数,被引用实验用的是哪一个,本文没有钉死。
深层网络在这里被论证为特征提取器。抽出可用特征,并不等于已经证明交通演化的机制,也不等于一条管制或一项天气已经造成了速度变化。事故模型遗漏天气和土地利用,这两项仍可以是风险差异的其他解释。参数服务器和加权融合是提议,邻近区域相关是放置数据的理由。数百到数千层描述的是计算规模,不是某一套已部署系统的层数。
一句话总结
移动数据加深层网络,在这篇文章里被组织成路段和区域上的速度、流量与事故风险预测;本文能够核对的是三类指标的分母,以及数据形状如何对应到卷积、循环和自编码器。
核心来源
- Liu, Z., Li, Z., Wu, K., Li, M. Urban Traffic Prediction from Mobility Data Using Deep Learning. IEEE Network, 2018, 32(4): 40–46. DOI:10.1109/MNET.2018.1700411。
- 图1至图4、表1和表2均出自该文。被引用实验只按本文的转述使用;那些论文自身的误差、样本量和城市没有印在这篇文章中。
作者介绍
单位以论文首页为准,经历以文末传记为准。传记里的“目前”指2018年刊出时。
- Zhidan Liu:东北大学计算机科学与技术学士(2009),浙江大学计算机科学与技术博士(2014)。刊出时为深圳大学计算机与软件学院助理教授。研究兴趣包括分布式感知、移动计算、大数据分析和城市计算。
- Zhenjiang Li:西安交通大学计算机科学与技术学士(2007),香港科技大学电子与计算机工程 M.Phil.(2009)、计算机科学与工程博士(2012)。刊出时为香港城市大学计算机科学系助理教授。研究兴趣包括可穿戴与移动感知、深度学习与数据挖掘、分布式与边缘计算。
- Kaishun Wu:本文通讯作者。香港科技大学计算机科学与工程博士(2011),其后在香港科技大学任研究助理教授,2013年以教授身份加入深圳大学计算机与软件学院。传记写明六项美国专利、43项中国专利申请(其中13项已授权),以及 2014 IEEE ComSoc Asia-Pacic Outstanding Young Researcher Award。
- Mo Li:清华大学计算机科学与技术学士(2004),香港科技大学计算机科学与工程博士(2009)。刊出时为新加坡南洋理工大学计算机科学与工程学院副教授。研究兴趣包括网络化与分布式感知、无线与移动系统、信息物理系统、智慧城市和城市计算。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
速度的分母是抽样车辆。定位出租车给出的平均,统计的是仍在报告的出租车;线圈统计的是通过断面的车辆。两类“平均速度”在融合之前,需要先在同一条路段、同一个小时上对照一次。文章把两类来源都列入速度预测,但没有做这个对照。若两者在高峰差得很远,加权平均会把定义不一致当成同一种路况。
加权也值得按场景拆开。社交媒体往往在异常已经被谈论之后才密集出现,它的误差和事故本身可能一起发生。用普通日训练出的一套固定权重,到了已有事故报告的小时,可能会过高估计这一路数据。文章提出按数据源加权,并没有检验权重是否应该随小时、以及是否已经存在事故报告而改变。
按地理位置把训练数据放在同一台机器,依据的是邻近区域的交通流相关。地铁走廊或过江通道会让地图上相距较远的区域一起涨落。只把地理邻居放在一起,一条通勤走廊仍可能被拆进不同机器,训练时照样交换中间参数。这是对文中放置办法的一个反例,需要用走廊两端的流量相关来检验,文章没有给出这个相关。