同一批轨迹,换格子、换时间箱、换掉原地停留,可预测性为什么能差出几十个百分点?
论文名片|Kamil Smolak、Katarzyna Siła-Nowicka、Jean-Charles Delvenne、Michał Wierzbiński、Witold Rohm,The impact of human mobility data scales and processing on movement predictability,Scientific Reports,2021,11:15177。2021年3月22日收稿,6月30日接收。DOI:10.1038/s41598-021-94102-x。本文依据这一正式版本解读。这是一项测量研究:同一批高精度轨迹被做成不同的地点序列,再比较可预测性上限如何变化。
一个人下班后先在办公室附近吃饭,再坐地铁回家。若每小时只问一次“还在不在刚才那一片”,很多小时的答案都是还在办公室,或已经在家。若改问“下一次真正换到哪个地点”,饭馆、车站和只去过一次的地方会把答案拆开。前一种问法很容易答对。容易,来自问法把留在原地也算进了待猜的符号。
这项研究用伦敦 500 人、连续约四周的手机卫星定位轨迹,把两种问法放到一组空间尺度和一组时间尺度上。方向性结论是:可预测性上限量的是某种符号序列有多好猜。保留原地停留、并把格子或时间箱放宽,上限会升高;只保留地点更换时,上限低得多。序列被收成极少几个符号以后,上限可以在定义上接近全部,短序列上的估计也同时失去精度。
先说结论
- 细空间尺度上,下一时间箱序列的实际可预测性中位数,网格为 87.6%,基于密度的聚类为 94.8%;聚合到研究范围的粗端,分别升到 99.8% 和 99.9%。分母是这 500 人各自序列的上限,图中画的是中位数。
- 只保留地点更换的下一地点序列,细尺度中位数为网格 36.3%、聚类 46.7%;空间参数到大约 10³ 米时,两种聚合都超过 70%。网格在最粗一档为 79.5%。
- 时间箱变宽时,下一时间箱的实际上限先下降,聚类大约降到 1 天、网格大约降到 6 天,其后升到 99.9%。此时序列里反复出现的是同一个人最常去的地点。
- 下一时间箱的记录数和原地停留次数由时间箱宽度决定,与时间箱呈对数关系,决定系数 R² > 0.99。空间聚合大体不改变这两项,停留区个数则会减少。
- 缺测下的三种熵估计里,误差修正法在表 1 的四档中误差最低。主结果没有使用这三种估计:筛选后轨迹的小时空箱缺失比例全部低于 0.15,中位数为 0.04。
这 500 人的轨迹,先被收成什么样的地点?
数据来自英国伦敦居民的手机应用。位置由手机里的全球导航卫星系统接收机确定,时间和空间都比基站记录细。作者沿用 Song 等人用小时空箱缺失比例 q、以及轨迹长度 d(天)筛选轨迹的办法,并把条件收紧,以减弱缺测和过短轨迹的影响。保留的是 q ≤ 0.15、且连续天数 d ≥ 28 的轨迹。q 的这一筛选按 1 小时的时间箱计算。
初始数据有近 500 万部设备。满足条件后,作者从中随机抽取 500 人。抽中的轨迹长度为 28 至 31 天,小时空箱缺失比例的中位数 q = 0.04,合计近 500 万个定位点。通过筛选却未被抽中的人数,论文没有给出。500 人是筛选后的随机子集;近 500 万部设备与这 500 人之间还隔着一道未报告人数的筛选。
原始点里有很大一部分记在地点之间的路上,也有堵车造成的短停。作者认为,从移动预测的角度看,这些点没有保留成地点的必要。所有后续比较之前,轨迹先按既有研究的阈值收成停留点:距离 300 米、持续 10 分钟。靠近的停留点再收成停留区。论文主张网格聚合前也应先做停留点这一步;既有可预测性研究在网格之前通常没有这样做。
空间聚合使用两种常见做法。网格把停留点划进边长为 G 的规则格子,并归到格子中心。聚类使用带噪声的基于密度的空间聚类(density-based spatial clustering of applications with noise,DBSCAN):与簇中某个停留点的距离小于 ε,就归入该停留区,至少一个点即可成簇。两种方法都测试 30 个取值,在对数轴上从 10 米排到 10^4.8 米。最粗一档大致相当于这批数据最大空间范围的一半。作者预期可预测性在细尺度上更敏感,所以用对数间隔。10^4.8 米由论文给出的端点换算,约为 6.3 万米。
ε 和格子边长可以取同一个数,地面上得到的停留区却不一定一样大。聚类结果还取决于点的空间分布,ε 不能直接读成时间或空间分辨率。
时间维度只进入下一时间箱序列。每个时间箱宽度为 Δt,箱内若有多个停留区,保留停留更久的一个;停留时间相同,则保留到访更频繁的一个。整箱没有位置时记为空。论文列出的宽度为 5、10、15、30、45、60 分钟,以及 1、6、12、24、48、72、144 小时。其中 60 分钟与 1 小时等长,最宽的 144 小时等于 6 天。空间聚合放在时间聚合之前;顺序颠倒会造成地点损失。
下一地点序列走另一条路:从停留区序列中去掉连续重复的地点,时间箱也不再存在。它保留的是地点更换。
三种上限,各自假设我们已经知道什么?
可预测性在这里是理论上限,由信息熵解出。它回答的是:在某种信息假设下,猜测序列中下一个符号,最多能有多高的比例猜对。它是这 500 条序列的性质,论文没有训练一个已经达到该比例的预测模型。
随机熵只使用不同地点的个数 L,写成 log₂ L。它假设每个地点出现的机会相同。由此解出的随机可预测性 Π^rand,对应只知道有多少个不同符号时、随机猜测所能达到的上限。
不相关熵再使用每个地点的到访频率 p_k,写成各频率与 log₂ p_k 乘积之和的相反数。不相关可预测性 Π^unc 对应按这个频率抽取符号的上限,不使用先后顺序。
实际熵进一步使用按时间排列的子序列。直接枚举子序列很慢,论文沿用 Lempel–Ziv 压缩估计实际熵。估计值要在序列长度趋于无穷时才收敛到实际熵。由它解出的实际可预测性 Π^max,是利用全部顺序信息时的理论上限。
三种熵都通过 Fano 不等式换成可预测性。把熵 E 放进
E = −Π log₂ Π − (1−Π) log₂(1−Π) + (1−Π) log₂(L−1)
解出的 Π,在 E 分别取随机熵、不相关熵和估计的实际熵时,就是 Π^rand、Π^unc 和 Π^max。对数的底必须与计算熵时相同。地点个数越少,随机猜测越容易;顺序越有规律,实际熵越低,Π^max 越高。
前人用不同数据和不同切法得到过相差很大的上限,这正是本文要拆开的对象。Song 等人 2010 年用约 45,000 名用户的基站位置、1 小时时间箱,报告 Π^max = 93%。后续研究的上限从 43% 分布到 95%。Lu 等人在基站空间尺度、但时间分辨率为天的数据上得到 85%;在平均约数平方公里的低空间分辨率上得到 88%。Ikanovic 与 Mollgaard、以及 Cuttone 等人指出,下一时间箱会制造大量自我转移,也就是下一个时间箱仍落在同一地点。可预测性按猜对的符号计数,原地不动很容易猜,上限会被抬高。同一条序列改成下一地点之后,上限从 Π^max = 95% 降到大约 70%。这些百分比的分母是各篇论文自己的用户和序列。
既有高精度定位研究主要只做了下一时间箱加网格,空间大约从一百米到几百米,时间大约从 5 分钟到 2 小时。本文把两种序列、网格和 DBSCAN 放到上述更宽的尺度上。
格子变大以后,上限升高的是哪一种序列?
图 1 把三种上限画在同一组空间参数上。线是 500 名用户的中位数,阴影是用户之间的四分位距。横轴为对数坐标,网格图的横轴是格子边长,聚类图的横轴是 ε,单位都是米。
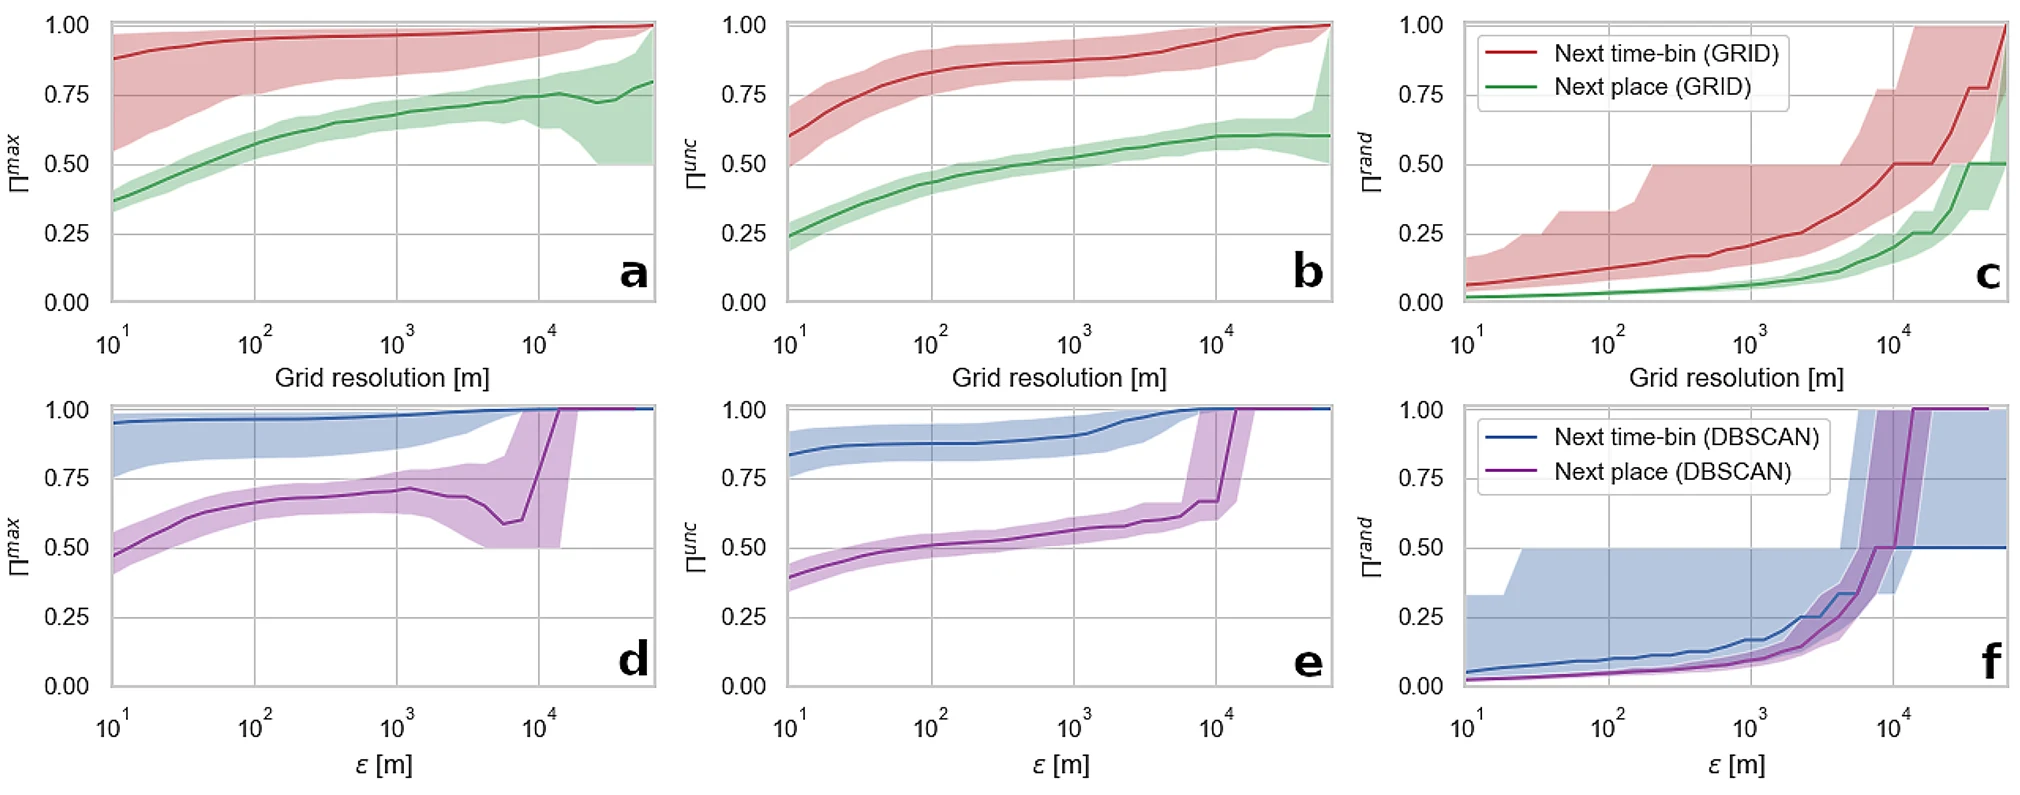
图 1|空间聚合加强时,三种可预测性上限怎样变化?
(a)网格的实际可预测性 Π^max。红线为下一时间箱,绿线为下一地点。(b)网格的不相关可预测性 Π^unc,颜色含义与(a)相同。(c)网格的随机可预测性 Π^rand。(d)DBSCAN 的 Π^max。蓝线为下一时间箱,紫线为下一地点;横轴改为 ε。(e)DBSCAN 的 Π^unc。(f)DBSCAN 的 Π^rand。细尺度上,下一时间箱中位数为网格 87.6%、DBSCAN 94.8%,粗端升至 99.8% 和 99.9%。下一地点从 36.3% 和 46.7% 起步,大约 10³ 米以后两种聚合都超过 70%;网格最粗一档为 79.5%,DBSCAN 的下一地点先降、再在更高聚合处升高。来源:原论文 Fig. 1。
下一时间箱在整个空间参数范围内都很高,DBSCAN 高于网格。论文给出的用户间四分位距为网格 17.6 个百分点、DBSCAN 14.5 个百分点,并写明它随空间聚合加强而缩小。下一时间箱的 Π^max 与空间参数呈指数关系,R² > 0.88。这个决定系数描述的是中位数曲线的形状。
下一地点低一个台阶。大约 10³ 米以前,聚类序列高于网格。过了这一档,网格的 Π^max 继续升到最粗尺度的 79.5%;DBSCAN 先下降,再在更高聚合水平达到它的高值。下一地点的用户间四分位距为 DBSCAN 14.4 个百分点、网格 11.5 个百分点。讨论部分另写 DBSCAN 在所有聚合水平上更可预测。与结果段并读时,这句话不能覆盖下一地点在 10³ 米以后的那段波动:那里网格仍在上升,聚类先降后升。
波动来自序列长度。DBSCAN 生成的簇更大。聚合很高时,全部停留点可能落入同一个停留区。下一地点序列会去掉重复符号,最后只剩一个符号;按定义,这种序列完全可预测。若只剩两个停留区,且两地机会相同,可预测性为 50%。完全可预测和 50% 都是作者对短序列的定义性说明,图上没有把它们标成某一档的实测中位数。
细空间尺度上,下一地点的 Π^unc 已经接近 Π^max。顺序信息在去掉原地停留之后,能再提高的幅度有限。高度空间聚合时,Π^unc 反而高于 Π^max。理论上限若真包含频率信息,不应低于只用频率算出的上限。作者指出,Lempel–Ziv 估计在序列不够长时会有误差;Teixeira 等人也提醒,短的下一地点序列和很低的时间分辨率不宜当成精确值。因此图 1 右端、尤其是下一地点曲线的陡升,可以说明符号已经所剩无几,不能把那里的 Π^max 读成一个稳定、精确的预测天花板。
Π^unc 与空间参数被写成指数关系,R² > 0.89;Π^rand 同样被写成指数关系,R² > 0.91。这两句没有写明拟合是否只包含下一时间箱。R² > 0.88 那一句则明确属于下一时间箱的 Π^max。Π^rand 由不同地点的个数决定,下一时间箱和下一地点彼此接近,DBSCAN 更低,因为同样的控制参数下簇更大、不同符号更少。
时间箱变宽,为什么会先变难、再在最粗处回到极高?
下一地点序列没有时间箱。图 2 只比较下一时间箱。横轴是 Δt,单位小时,对数坐标;红线为网格,蓝线为 DBSCAN,仍是 500 人的中位数和四分位距。
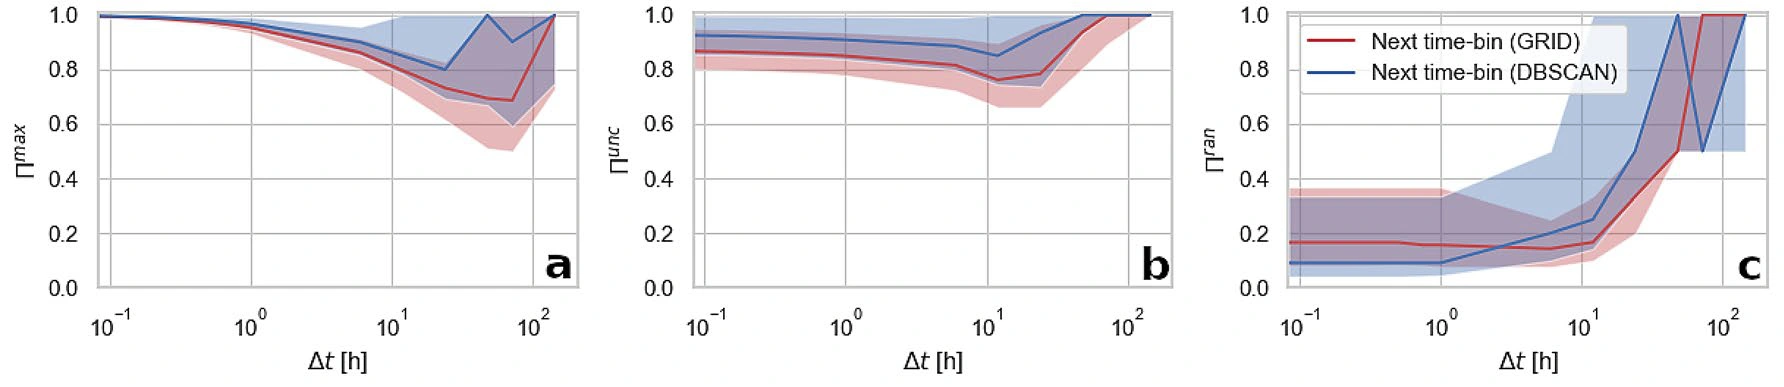
图 2|时间箱放宽时,下一时间箱的三种上限如何变化?
(a)实际可预测性先降后升。DBSCAN 大约降到 1 天,网格大约降到 6 天,其后升到 99.9%;阴影随 Δt 变宽。(b)不相关可预测性也下降,降幅小于(a)。(c)随机可预测性随时间箱变宽而上升,方向与前两幅相反。粗端的 99.9% 对应序列收成最常去地点的重复符号。来源:原论文 Fig. 2。
这条关系是不规则的。Π^max 随 Δt 增大而下降,转折分别在聚类的大约 1 天和网格的大约 6 天,之后升到 99.9%。6 天等于方法列出的最宽时间箱 144 小时。正文说上升发生在转折之后;网格的转折已经落在这一最宽档附近,更粗一档的单独中位数没有列出。99.9% 的含义在正文里是明确的:轨迹由同一个符号反复组成,该符号是最常访问的地点。
Π^max 的用户间离散程度随 Δt 增大而增加。论文没有给出时间维度上的四分位距数字。Π^unc 同样下降,降幅小于 Π^max。Π^rand 随 Δt 增大而上升。随机上限只依赖不同地点的个数;后面会看到,停留区个数在大约 1 小时以后下降。方向与 Π^rand 的上升一致。论文没有为这条时间曲线报告决定系数。
停留区变大,序列里还剩下多少个符号?
可预测性变化的直接来源,是聚合改写了符号序列。图 3 先看几何:同样的控制参数下,停留区有多大,以及只出现一次的停留区占多少。这里的中位数和四分位距按数据集中的停留区计算,口径与按 500 名用户计算的图 1、图 2 不同。横轴仍是空间参数,网格对应格子边长,DBSCAN 对应 ε。
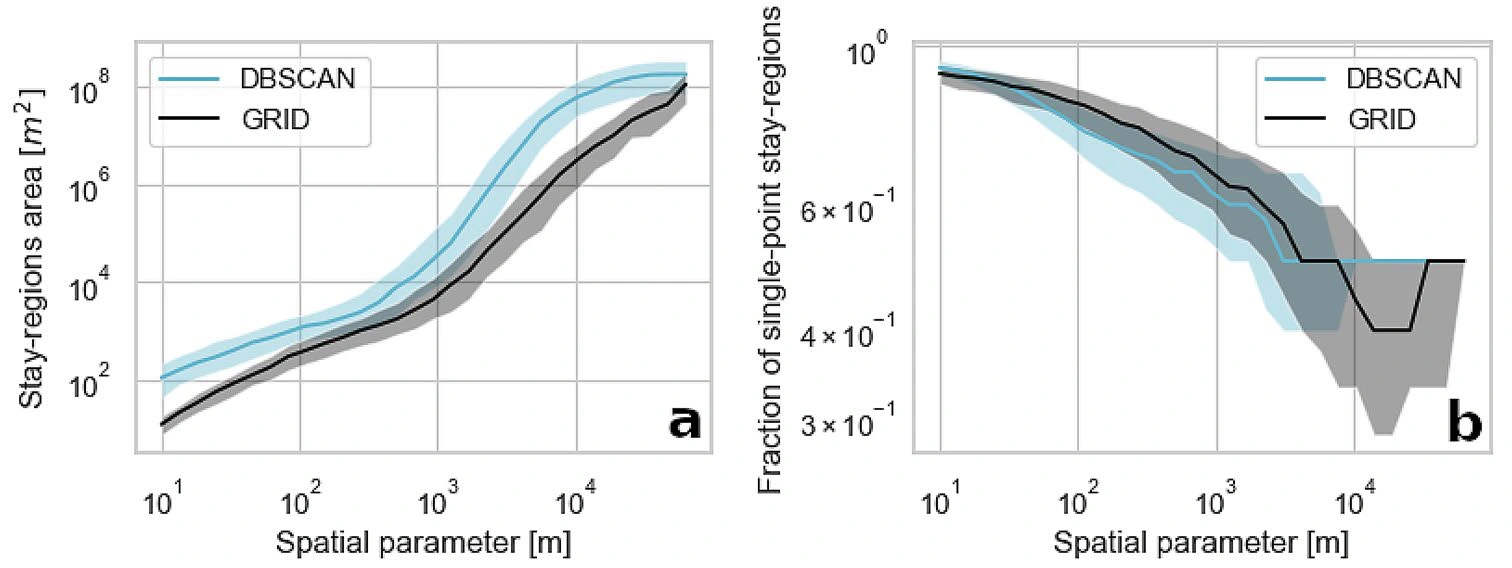
图 3|同一控制参数下,两种聚合的停留区一样大吗?
(a)停留区面积,纵轴为平方米的对数坐标。青线为 DBSCAN,黑线为网格。聚类簇通常更大;参数超过几百米后,面积加快上升。(b)单点停留区占全部停留区的比例,纵轴为对数坐标。网格的比例更高,两条线都随参数增大而下降。正文没有给出某一档的具体面积或具体比例。来源:原论文 Fig. 3。
有研究建议删掉只含一次停留的单点停留区,理由是它们没有明确含义。作者仍统计其占比。这类地点在序列里只出现一次,常规猜测无法从重复中认出它们。网格更容易把原本相邻的停留拆进不同格子,从而造出更多单点停留区。停留区大小不一、空间上也不均匀,没有任何一个固定边长能同时对准所有地点。这是网格额外不确定性的来源,也是 DBSCAN 在下一时间箱上更可预测的原因。
面积在几百米以上加快增长,表示停留区开始互相合并,不同符号变少,可预测性随之升高。网格面积随边长的增长并不是线性的。图 3 能支持“同样的参数,聚类簇更大、网格的单点停留区更多”;它不能支持某一个人的某一次停留被正确归入了家或工作地。论文没有报告家、工作地的识别结果。
图 4 把几何变化换成序列里的三个计数:停留区个数、记录数、自我转移次数。中位数和四分位距改回按用户计算。
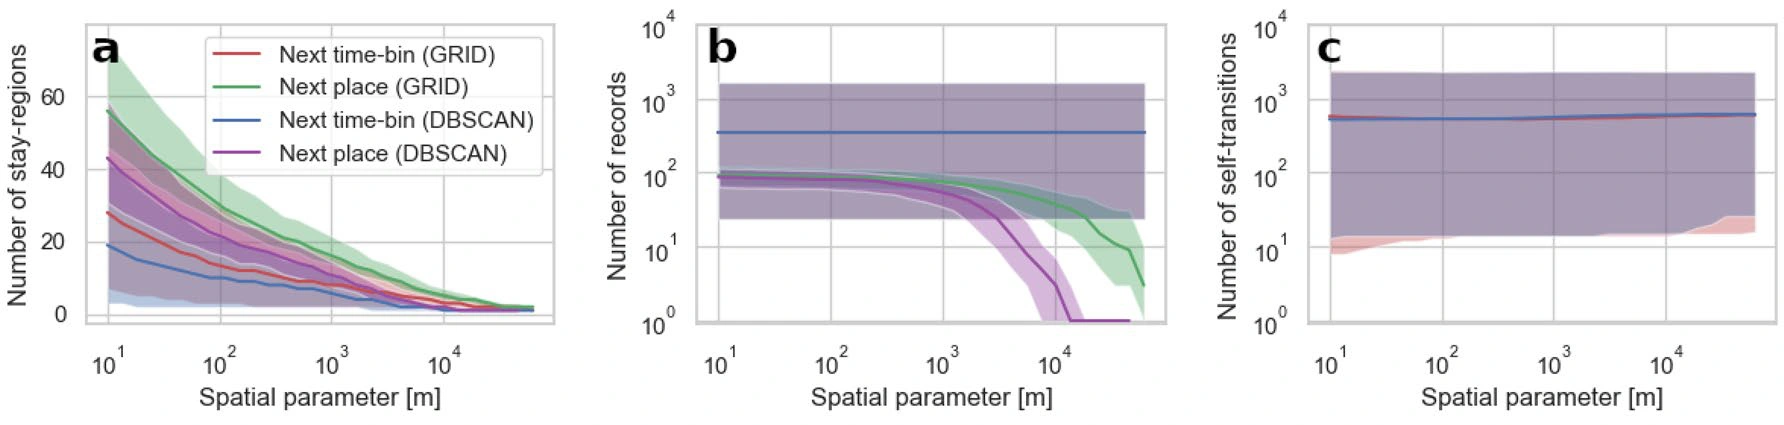
图 4|空间聚合改变的是地点个数,还是原地停留的次数?
(a)停留区个数随空间参数增大而减少。红、绿为网格的下一时间箱和下一地点,蓝、紫为 DBSCAN 的两类序列。(b)记录数,纵轴为对数坐标。下一时间箱的两条线大体水平;下一地点在高聚合处下降。(c)自我转移次数,纵轴为对数坐标。下一时间箱的次数大体不随空间参数变化,高聚合处有可见起伏。来源:原论文 Fig. 4。
停留区个数随空间聚合加强而减少,下一地点序列通常多于下一时间箱。原因是短访问。用户在两个不同停留区的访问开始时刻之间,中位间隔为 167 分钟;超过 27% 的停留区,访问时长不超过 60 分钟。分母是停留区,不是 500 人。论文没有写明这两个数对应哪一档格子或 ε,因此它们说明短访问大量存在,不能被当成某一个边长下的唯一测量。
时间箱较宽时,短时间里去过的地点只留下停留最久的一个,下一地点序列则把这些地点都保留下来。停留区更多,不同符号更多,序列更难猜。结果段末句把更低的 Π^max 写成了下一时间箱。同段明确写的是下一地点保留全部短访问、停留区更多;后文也写下一地点更不可预测。末句与这两处对不上。本文按停留区更多的下一地点序列更难预测来理解图 4。
空间聚合大体不改变下一时间箱的记录数和自我转移次数。这两项主要由 Δt 决定。下一地点序列则不同:空间分辨率下降后,停留区变大并被合并,记录数减少。记录数变得很少时,图 1 里下一地点上限出现快速变化。
原地不动解释了时间尺度上的升高,解释不了全部空间差异
图 5 只看下一时间箱,横轴仍是小时为单位的 Δt。
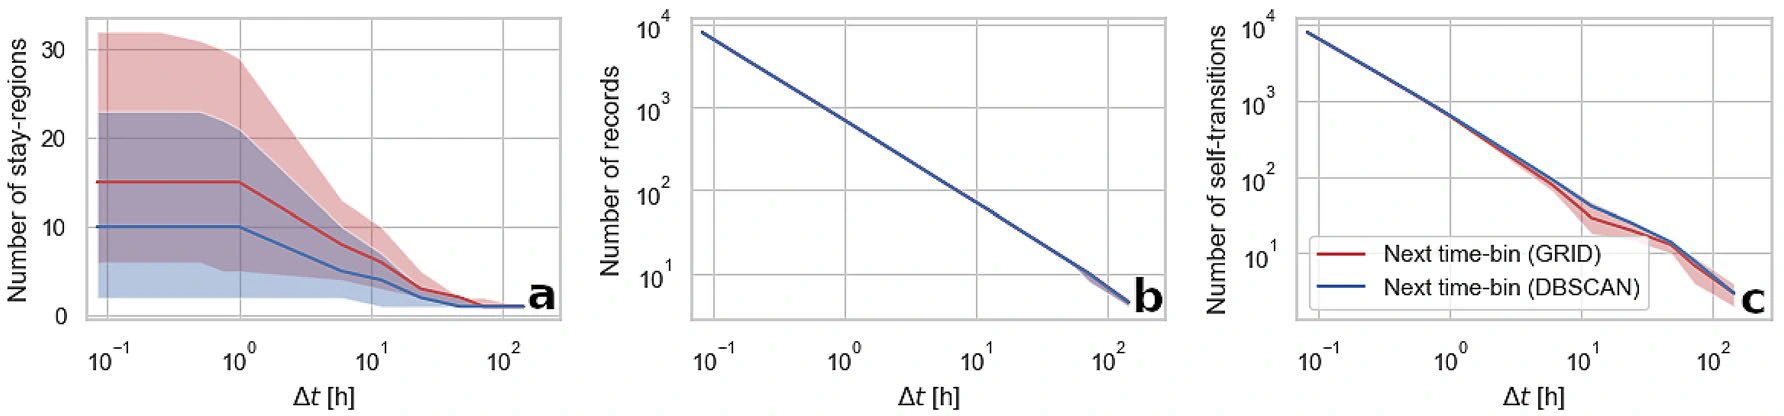
图 5|时间箱放宽时,地点个数、记录数和自我转移怎样减少?
(a)停留区个数在大约 1 小时以前基本平稳,其后下降。红线为网格,蓝线为 DBSCAN;阴影是用户间四分位距。正文没有列出各档的中位个数。(b)记录数随 Δt 下降,两条线重合,纵轴为对数坐标。(c)自我转移次数同样随 Δt 下降,网格与 DBSCAN 接近。记录数和自我转移次数与 Δt 的关系为对数,R² > 0.99。来源:原论文 Fig. 5。
下一时间箱的可预测性主要受自我转移次数影响,该次数与序列长度大致成线性,聚类序列上这种关系更强。高度聚合时,网格数据里记录数与自我转移次数的线性关系会被打乱。图 4c 已经显示,空间参数本身大体不推动自我转移次数。因此,空间分辨率下降带来的上限升高,主要对应停留区变少。作者用国家与建筑物作逻辑对照:容器越大,位置越好猜。本文最粗的空间参数大约是这批数据范围的一半,对照停在作者的举例里。
时间方向上,更高的时间分辨率意味着更窄的时间箱、更多记录、更多自我转移,上限也更高。图 5c 的下降和图 2a 前半段的下降是同一关系的两面:时间箱变宽,原地不动的符号变少,实际上限先变低。最粗端再升到 99.9%,发生时自我转移次数仍在减少。那段回升来自序列缩短成重复的单一地点,不能再归到自我转移变多。作者也写明,下一时间箱上限的升高,并不能全部由自我转移的增加解释。
可变面积单元问题指点数据按不同区域汇总后,统计结果会改变;可变时间单元问题是时间切法带来的同类偏差。本文的证据支持这两种切法都会改写移动序列和可预测性。它没有证明某一种格子或时间箱是真实活动的唯一尺度。Alessandretti、Aslak 与 Lehmann 提出,个体移动嵌在不同空间层级的容器里。作者用停留区个数随尺度减少来与这一图像衔接。嵌套容器来自被引用的研究;本文直接给出的是停留区个数和可预测性随聚合的变化。
缺测会改写熵,这 500 人的主结果用了补缺吗?
下一时间箱按固定时间索引,没有定位的箱子是空的。空箱会抬高序列的熵。q 是空箱比例,最初按 Δt = 1 小时定义。作者对 5 分钟到 12 天的时间箱计算了每条序列的平均 q,并写明 Δt 越大,q 越低;又写比 1 小时更低的分辨率不再有空记录。表 1 实际列出的是 5 分钟、10 分钟、30 分钟和 1 小时。1 小时的平均空箱比例已降到 0.7% ± 0.6%。结合“Δt 越大 q 越低”,那句“不再有空记录”更像是在说比 1 小时更粗的时间箱。表 1 没有给出那些粗档的 q,方法列出的最宽时间箱是 6 天,缺失比例那段则写到 12 天。12 天这一档没有单独的空箱比例或可预测性数字。
文献里有三种从缺测估计实际熵的方法。Song 等人的方法记为 Ĥshuf。Ikanovic 等人改用频率公式计算不相关熵,再沿类似步骤外推,记为 Ĥ_unc。Lin 等人估计不同缺失比例下的熵误差,再用该误差修正缺测序列,记为 ĤΔe。结果段列举符号的顺序与方法段的这一对应不完全一致;本文按方法段里写明作者的定义。
检验用 100 条 q < 0.15 的序列计算完整序列上的真实熵 H,作为参照。引用的既有结论认为 q < 0.25 时估计熵可以视为真实熵;作者仍把参照收紧到 q < 0.15。随后逐步删去记录,使 q 取 0.15、0.20,一直到 0.60,再比较估计熵与 H。用于拟合 Ĥ_Δe 误差的轨迹不参加这次误差评估,避免把评估做低。
| Δt | 平均空箱比例 q(%) | Ĥ_shuf / H(%) | Ĥ_Δe / H(%) | Ĥ_unc / H(%) |
|---|---|---|---|---|
| 5 分钟 | 5.2 ± 0.2 | 50.6 ± 4.8 | 3.0 ± 0.6 | 43.2 ± 2.1 |
| 10 分钟 | 4.2 ± 0.2 | 40.2 ± 4.4 | 3.5 ± 0.9 | 23.9 ± 1.5 |
| 30 分钟 | 2.0 ± 0.1 | 26.5 ± 1.7 | 4.5 ± 1.4 | 19.6 ± 1.3 |
| 1 小时 | 0.7 ± 0.6 | 25.0 ± 1.8 | 5.7 ± 1.9 | 19.4 ± 1.3 |
表 1 比较的是 q ≤ 0.60 条件下、不完整序列的实际熵估计误差,对照是完整序列的真实熵 H。q 列是实验所用轨迹在该时间箱下的平均空箱比例。百分比旁是序列之间的 95% 置信区间。来源:原论文 Table 1。
论文把更小的 Ĥ/H 称为更低的误差,四档里 ĤΔe 都最小,因此表现最好。5 分钟一档,平均空箱比例为 5.2% ± 0.2%,三种方法的平均结果为 50.6% ± 4.8%、3.0% ± 0.6% 和 43.2% ± 2.1%。时间箱增到 1 小时,ĤΔe 升到 5.7% ± 1.9%,另外两列下降。方法正文把误差写成估计熵除以真实熵。按字面,3% 会表示估计值远小于真实熵,这和“误差最低、表现最好”对不上。这些百分比的比较方向符合相对误差。本文只按表内的大小比较三种方法,不把它们换算成熵恢复到了百分之几,也不换成可预测性。
作者还检查估计值与缺失比例之间能否用函数外推。他们把决定系数 R² > 0.9 当作拟合较好。Ĥ_Δe 和 Ĥ_unc 都可以用带偏移的指数函数估计;Ĥ_shuf 有时是线性的,呈现线性关系的用户数随 Δt 增大而增加。论文没有给出线性用户的人数。Ĥ_unc 因为始终是指数关系,比有时呈线性的 Ĥ_shuf 更容易外推,误差也略低。这两列在细时间尺度上仍然较高。
Ĥ_Δe 需要数据集里有一些 q < 0.25 的代表性轨迹,适用面因此受限。作者引述的相关文献里,手机数据的 q 大约在 0.7 到 0.9,卫星定位数据大约在 0.2 到 0.9。那是其他数据集的完整程度。本文筛选后的轨迹全部 q < 0.15,讨论据此说明主分析没有调用这三种估计,表 1 的误差没有进入图 1 至图 5。筛选条件写的是 q ≤ 0.15,讨论写的是全部低于 0.15。两个 q 的口径不同。0.04 是 500 人在小时时间箱上的中位数,表 1 的 q 是 100 条参照序列在各时间箱上的平均空箱比例。
这些上限能带到另一座城市、另一种采集方式吗?
作者把主要边界写得很窄。第一,样本是伦敦、连续约四周、缺失较低的 500 条手机卫星轨迹。天气和气候会改变移动,另一地区的处理效应可以不同。论文没有做城市或季节对照。第二,作者没有完全解释某些具体尺度上可预测性为什么改变,并指出下一时间箱的升高不能全部归于自我转移。第三,短序列和很低的时间分辨率使 Lempel–Ziv 估计偏离实际熵,Π^unc 高于 Π^max 的区段应看成估计限制。第四,DBSCAN 在相同参数下簇更大、也更可预测,ε 仍不能换算成唯一的地面分辨率。
可预测性上限随表示方式改变,这一方向与前人在更窄尺度上的发现一致,本文把尺度和两种序列补全了。上限升高同时来自原地停留变多、以及不同地点被收成同一个符号。国家比建筑物好猜,是这种合并的极端说法。它没有证明伦敦居民的出行意图在粗尺度上更有规律,也没有给出一个应当用于所有应用的最佳格子。
作者写明,后续工作要解释这些依赖,并指出移动数据应当怎样处理,才能多保留信息、少引入偏差、提高可用性。把 Π^max 调到最大,会偏好更粗的符号和更多原地停留,与少引入偏差可以朝相反方向走。
一句话总结
同一批轨迹的可预测性上限差出几十个百分点,是因为上限在回答不同的猜符号问题:留在原地、格子变大或时间箱只剩一个常去地点,都会让答案变好猜;下一站去哪,仍然难得多。
核心来源
- Scientific Reports 正式版本,核对题目、作者、单位、收稿与接收日期。正文图 1–5、表 1 均出自该版本。
- 统计量数据:10.5281/zenodo.4893432。论文写明公开的是研究中计算和分析的统计量。
- 代码属于 HuMobi 程序库:10.5281/zenodo.4893369。
- 伦理审批来自地球测量与地理信息研究所人类移动伦理委员会。论文写明参与者知晓采集过程并提供知情同意,可以退出。正式版本采用知识共享署名 4.0。
作者介绍
五位作者的单位和分工以论文署名及作者贡献说明为准。
- Kamil Smolak:通讯作者,署名地球测量与地理信息研究所,Wrocław University of Environmental and Life Sciences,弗罗茨瓦夫。论文邮箱域名为 upwr.edu.pl。与 Jean-Charles Delvenne 共同构思实验,并完成实验、结果分析和文章撰写。
- Katarzyna Siła-Nowicka:同时署名该研究所、格拉斯哥大学城市大数据中心、奥克兰大学环境学院。参与结果分析。
- Jean-Charles Delvenne:署名鲁汶天主教大学通信技术、电子与应用数学研究所,地点为新鲁汶。参与构思实验和结果分析。
- Michał Wierzbiński:署名克拉科夫 Spyrosoft S.A.。论文写明数据由他提供。
- Witold Rohm:署名同一地球测量与地理信息研究所。参与结果分析。
五位作者都审阅了稿件。论文声明没有利益冲突。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
读到一个很高的可预测性时,可以先把四个伴随数字要来:序列是下一时间箱还是下一地点,格子或 ε 是多少,时间箱多宽,自我转移占记录的比例是多少。本文里,只改序列类型,细尺度的中位数就能从 36.3% 或 46.7% 变到 87.6% 或 94.8%。Song 等人的 93% 来自基站和 1 小时时间箱,原地停留算进了猜对的符号。拿它来评判一套只关心下一次地点更换的卫星轨迹,比的是两道不同的题。
另一个可以单独检验的规则是:同时报告停留区个数、序列长度和 Π^unc 与 Π^max 的高低。一旦只用频率的上限高过所谓实际上限,图 1 的粗端说明估计已经不可靠,继续把格子放大只会把符号收成一个、并把上限推到定义上的全部。超过 27% 的停留区不超过 60 分钟。关心短暂停留的应用,和每小时只保留停留最久地点的应用,面对的是两套地点集合。上限跟着决策要猜的那个符号走。数值更大的图回答的是更粗、或把原地停留也计为猜对的那一道题。