只数方向、不数里程,为什么朝起点返回的轨迹会更多?
论文名片|Erjian Liu、Mattia Mazzoli、Xiao-Yong Yan、José J. Ramasco,A generalized vector-field framework for mobility,Communications Physics,2024,7:190。2023年8月25日收稿,2024年5月22日接收,2024年6月13日发表。DOI:10.1038/s42005-024-01672-z。本文依据这一正式版及其补充材料解读。
一辆货车早上从仓库出发,先开到城外的一处货点,再就近卸几站,傍晚回到仓库。若只问每段路是在离开仓库还是在朝仓库开,短短两公里的回程和几十公里的去程会得到同样的一票。直觉上,去和回应该差不多对半。这篇论文把这个计数做完,发现朝参考点返回的轨迹稳定地更多,而且这种不平衡可以收成城市地图上每个格子的一个方向。
方向性结论是:个人轨迹能够定义一个中尺度移动场。要复现经验数据里的方向不平衡,停留点必须随离市中心变远而变少,较长的行程要按总距离重排停靠顺序,较短的行程则保留近乎随机的探索。这样得到的场大体满足散度定理,旋度也低于把方向打乱后的对照,因此可以在中尺度上定义一个势。这个势是场的数学对象,不是直接测到的通勤时间,也不是规划评分。
先说结论
- 以每条轨迹自己的起点为参考点,北京、上海、成都全部货车轨迹的不平衡比 ρ 分别为 0.284、0.282、0.291。ρ 的分母是负向轨迹条数,分子是正向轨迹条数,平衡轨迹不进入这个比。三座城市的负向份额都是 65.2% 或 65.3%。
- 纽约 Foursquare 签到的全部轨迹 ρ 为 0.266,分母同样是负向轨迹。签到和货车不是同一种移动,数值不同,方向却同样偏负。
- 停靠点完全随机时,大尺度上不产生稳定的场。停靠点随离市中心衰减,会把 ρ 压到三套模型里的最低;所有行程都做旅行商重排,又把 ρ 抬到最高。只有平均站间距超过 1.72 km 才重排的混合规则,能把北京全部轨迹的 ρ 配到 0.284。1.72 km 只在北京、用全部轨迹的 ρ 标定。
- 混合模型场的周界通量与散度的面积分,两条曲线的决定系数 R²ₚ 为 0.98。北京、上海、成都实证场的对应值是 0.97、0.98、0.98。用真实停靠点、只按规则重排顺序后,模型势与实证势的 R²ₚ 为 0.97、0.93、0.96。
流量对上了,方向仍可能完全不同
两地之间有多少人流或货流,引力模型和介入机会模型都能给出一个强度。比较只看强度时,两类模型常常差不多。一旦要问每个地方的出行主要朝哪边,差别就出来了。2019 年已有工作用向量场比较多座城市的通勤,并发现引力模型能同时贴近强度和方向。那一套输入是居住地到工作地的起讫矩阵。
这次要回答的是另一件事:任意一种移动,只要手里是一个人或一辆车的停靠序列,能不能定义同样的场;个体怎样选下一站,才会在格子尺度上留下经验数据里的那种方向。格子尺度在这里叫中尺度(mesoscopic scale):比单次停靠粗,比全市总量细。正文用 1 km² 说明格子可以有多大,这是举例,不是后文地图实际使用的边长。实证场的格子边长,正文和补充材料都没有写出。
每一段行程先变成单位向量,再在格子里求平均
微观对象是一条轨迹上的连续停靠。大多数轨迹是闭合的,起点和最后一站相同,但闭合不是定义场的条件。
设停靠 X 的下一站是 Y。向量放在 X 上,指向 Y,然后收成单位向量:长度为 1。因此 1 km 的挪动和 30 km 的干线,在这个场里各算一票。这是定义选择。它回答的是每个格子离开的行程主要朝哪边,不是吨公里,也不是路上花了多少时间。
空间划成等面积格子。格子 i 里所有出发的单位向量相加,得到合向量 Tᵢ。再除以从 i 出发的行程段数,得到移动场 Wᵢ。除法的作用类似把力除以质量或电荷:行程段数多的格子不会只因为样本多就得到更长的箭头。Wᵢ 短,表示这个格子里的方向互相抵消;Wᵢ 长,表示方向比较一致。
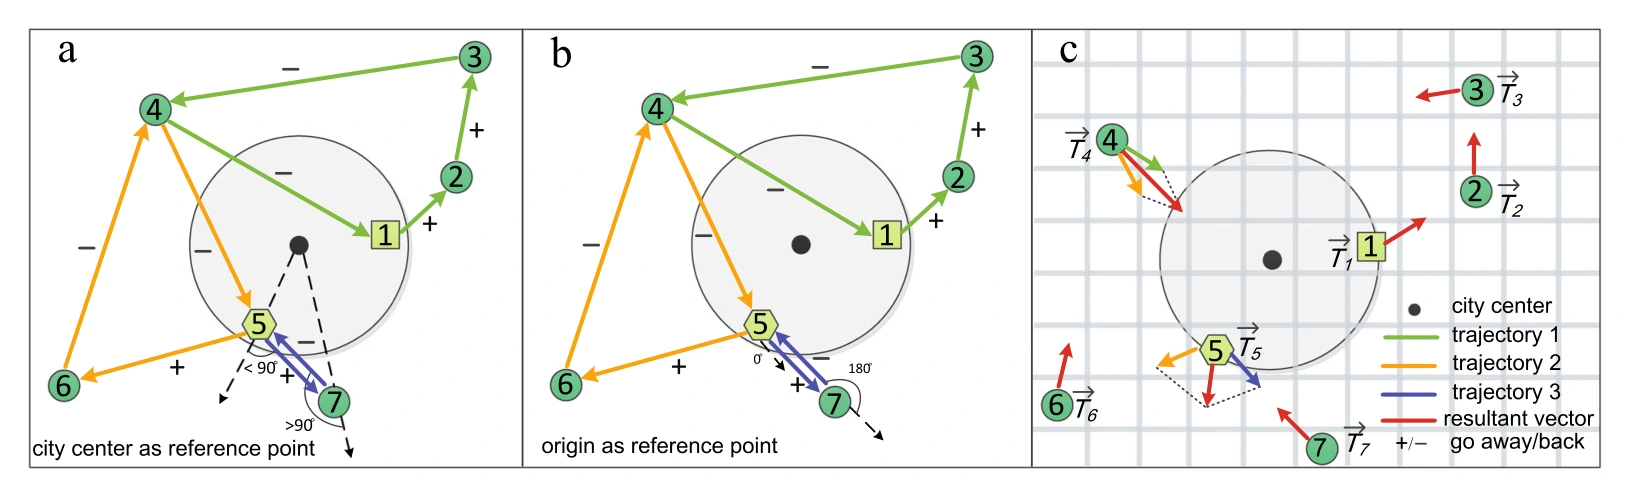
图 1|一条停靠序列怎样变成每个格子的一个方向?
(a)参考点是城市中心。灰圆是理想城市,黑点是中心,绿点是停靠顺序。箭头与从中心指向该停靠的位置向量夹角绝对值小于 90° 时记为正,表示远离中心;否则记为负。从起点出发的第一段按约定为正。(b)参考点改成该轨迹自己的起点,正负号的几何规则不变,但每条轨迹的参考点不同。(c)格子里的单位向量相加得到 T,再除以离开该格子的行程段数得到场。红箭头示意远离,另一侧示意返回。来源:原论文 Fig. 1。
参考点有两种。城市地理中心对所有轨迹相同。轨迹起点则每条轨迹一个,后文主要结果用的是这一种。符号只看方向夹角,不看这段路有多长、停了多久。一条轨迹的平均朝向 Hₜ,是各段符号之和再除以段数,范围从 −1 到 1。Hₜ = 1 表示每段都远离参考点,Hₜ = −1 表示每段都朝向它,Hₜ = 0 表示正负段数恰好相等。
不平衡比定义为
ρ = N₊ / N₋。
N₊ 是 Hₜ > 0 的轨迹条数,N₋ 是 Hₜ < 0 的条数。Hₜ = 0 的平衡轨迹单独计数,不进入分子或分母。所以 ρ = 0.28 的意思是:在已经分出正负的轨迹里,正向条数约是负向条数的 0.28 倍。它不是正向轨迹占全部轨迹的 28%。
段数是奇数时,正负号不可能正好抵消,Hₜ 不可能为 0。3 段和 5 段的饼图因此没有平衡扇区。4 段和 6 段可以正好抵消,平衡扇区会很大。这首先是 ±1 相加的算术,不能直接读成司机在偶数站特别喜欢走成对称路线。
ρ 明显偏离 1,才可能在空间里留下净方向。补充注 4 说明,ρ < 1 意味着存在场,是在本文测到的轨迹统计下成立的推论,不是对任意轨迹都成立的定理。补充表 5 给出的临界值 ρc,北京、上海、成都、纽约分别为 0.85、0.84、0.84、0.84,都小于 1。换一套轨迹长度结构,这个蕴含可以不成立。ρ = 1 也不保证没有场,因为局部仍可能有方向。
货车和签到,参考点用起点时都偏负
数据有两套,分析单位都是轨迹,不是人的全天出行,也不是城市之间的迁居。
D1 是中国 21 座城市的重型货车轨迹,来自国家道路货运监管与服务平台,时间是 2018 年 5 月 18 日至 5 月 31 日,原始记录超过 270 万条。一条记录是卡车编号、时间、经纬度、速度,不是一条完整轨迹。停靠沿用既有货运研究的识别结果:停留短于 26 分钟的临时停车不算,长于 13 小时的收车停放也不算有效趟末;本文使用的是停留超过 26 分钟且短于 13 小时的停靠。起点是整个观测期内最常去、停留也最长的基地,轨迹是连续两次回到这个基地之间的停靠序列。摘要和引言有一处写成 20 座城市;结果部分和补充表 2 是 21 座。后文按 21 座。
补充表 2 把 21 座城市的轨迹数逐城列出。相加得到 1,712,103 条。其中合肥 582,171 条,582,171 ÷ 1,712,103 = 34.0%;拉萨只有 1,906 条。图 2 只印份额,没有印每张饼的绝对条数,不能把补充表 2 的条数直接当成饼图分母。各城权重差得很大,不能把 21 座城市理解成每城样本量相近。北京 123,036 条,上海 180,293 条,成都 45,121 条。表中人口的单位是 ×10⁴ 人:北京 2154.2、上海 2423.78、成都 1633.00、拉萨 55.44。GDP 一栏的表头是 ×10⁶,论文没有写货币单位,这里不换算。
D2 是纽约市的 Foursquare 签到。数据中有 42,035 人,其中 23,520 人在不同的 2010 年人口普查区之间有行程。起点是签到次数最多的普查区。签到不是全部真实出行,只是用户主动记录的地点。
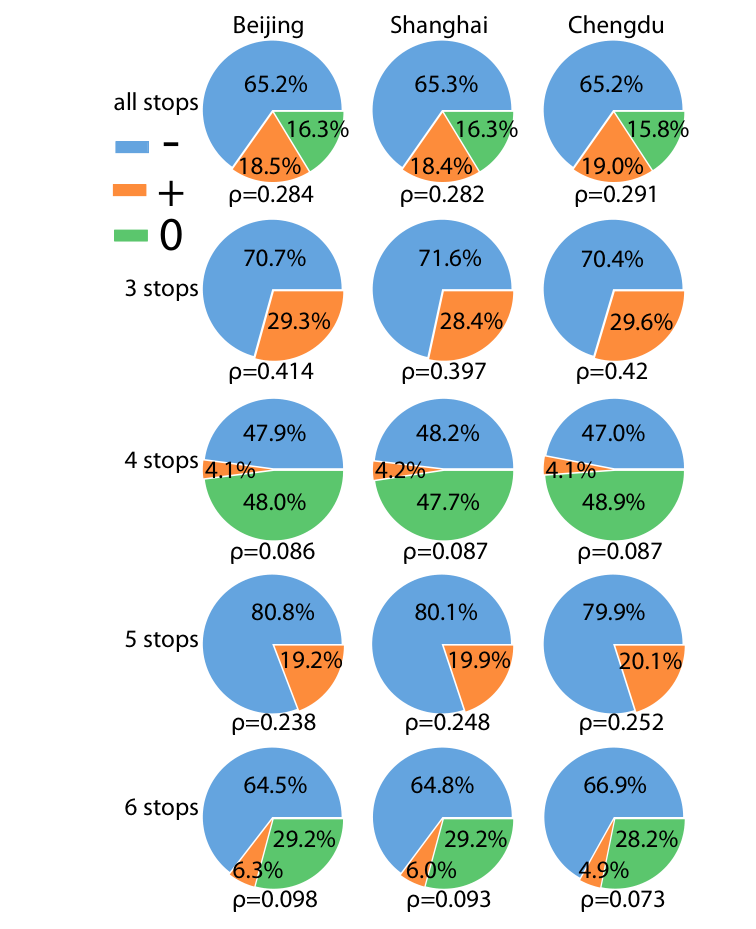
图 2|以轨迹起点为参考点时,三座城市的轨迹有多偏负?
原图没有子图字母。三列是北京、上海、成都,五行从上到下是全部轨迹、3、4、5、6 个停靠。蓝是负向,橙是正向,绿是平衡。ρ 印在每张饼下,等于橙除以蓝。图上没有印每张饼的绝对条数,下面的百分比是份额。
全部轨迹:北京负向 65.2%、正向 18.5%、平衡 16.3%,ρ = 0.284,因为 18.5 ÷ 65.2 = 0.284;上海 65.3%、18.4%、16.3%,ρ = 0.282;成都 65.2%、19.0%、15.8%,ρ = 0.291,因为 19.0 ÷ 65.2 = 0.291。3 个停靠没有绿扇区:北京 70.7% 对 29.3%,ρ = 0.414;上海 71.6% 对 28.4%,ρ = 0.397;成都 70.4% 对 29.6%,ρ = 0.42。4 个停靠时正向只剩约 4%:北京 4.1 ÷ 47.9 = 0.086,上海 4.2 ÷ 48.2 = 0.087,成都 4.1 ÷ 47.0 = 0.087,其余约一半负向、一半平衡。5 个停靠再次没有平衡扇区,ρ 回到 0.238、0.248、0.252。6 个停靠的正向又降到 6.3%、6.0%、4.9%,ρ 为 0.098、0.093、0.073。来源:原论文 Fig. 2。
负向占优不依赖轨迹有几个停靠,21 座城市都如此。补充图 9 给纽约全部轨迹的份额:负向 70.4%、正向 18.7%、平衡 10.9%,ρ = 0.266,即 18.7 ÷ 70.4。3 至 6 个停靠的 ρ 分别是 0.357、0.09、0.19、0.05。签到的 ρ 低于货车,不能把 0.266 和 0.284 说成同一个数。
若改用城市地理中心做参考点,补充图 5 至 7 显示各城 ρ 拉开,并与人口有关。街道、城市形状和公路会进入这个参考点。用轨迹起点时,这些差别被吸收掉,后文的圆形城市模型才有理由不去先画真实路网。
随机选点不够,全程优化又过头
模型城市是半径 R = 20 km 的圆,放在边长 L = 400 km 的方框里,每次生成 100,000 条轨迹。起点抽在圆内。每条起点发出多少条轨迹、每条有几个停靠,按经验分布的幂律近似来抽。补充表 3 列出的指数,北京是距离 2.20、停靠数 2.41、同一起点的轨迹数 1.02;上海 2.26、2.44、1.14;成都 2.24、2.45、1.06;纽约 3.86、2.42、1.02。补充图同时写明,图上的虚线是示意,不是正式拟合的产物。模型只要求停靠概率随距离下降,具体是哪一个递减函数,定性结果还在。
完全随机的 Rand 模型把其余停靠均匀撒在方框里。开放边界时,通量只在靠近方框边缘才变负,这是有限尺寸效应;改成周期边界后,通量在零附近波动,不形成稳定的场。这个模型随后不再使用。
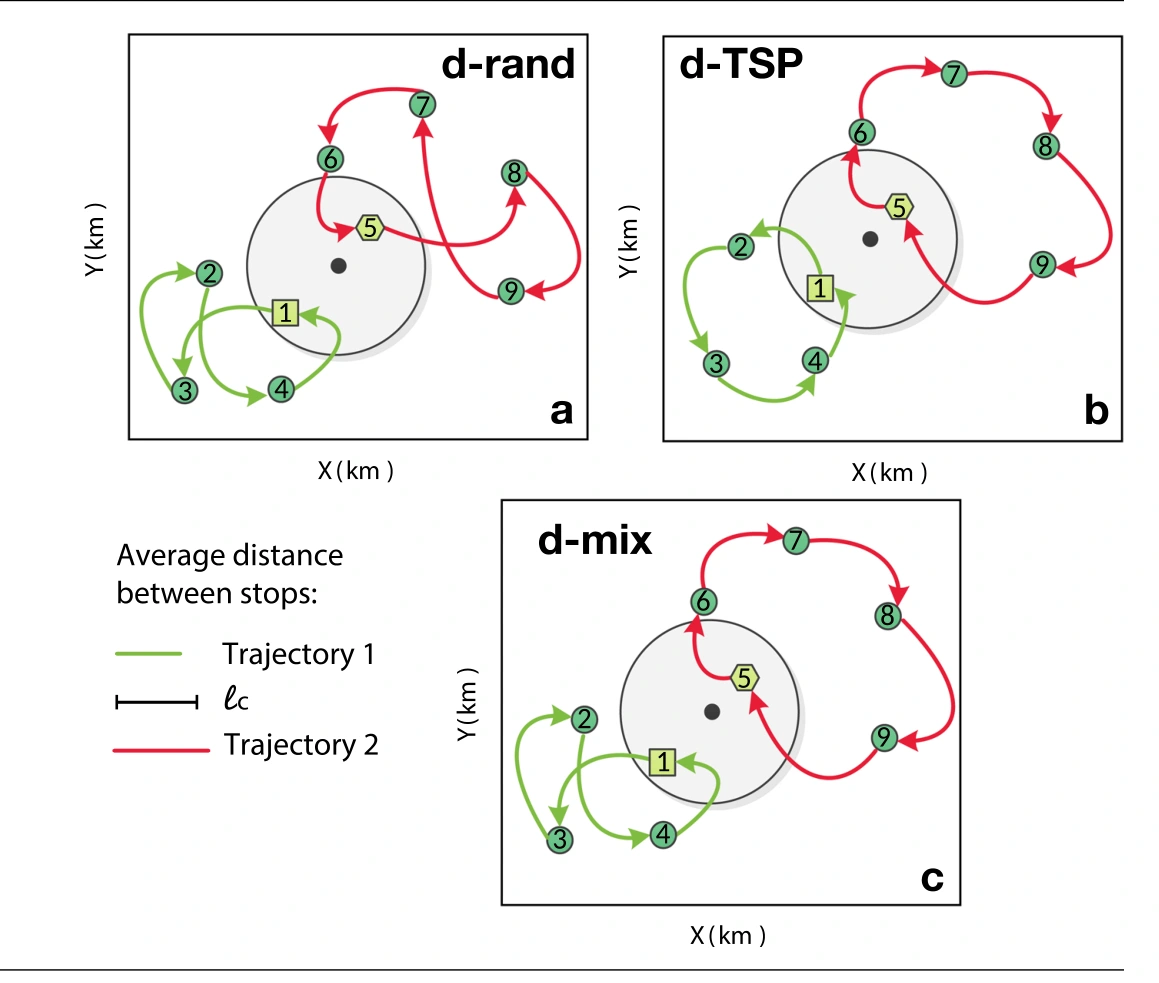
图 3|三种模型差在停靠点按什么顺序走?
灰圆是城市,黑点是中心。绿、红两条轨迹的平均站间距分别低于和高于阈值 ℓc。坐标是公里。
(a)d-rand:停靠半径按随市中心衰减的分布抽取,方向随机,顺序不优化,路径会在城市两侧来回穿越。(b)d-TSP:停靠点与 d-rand 相同,但从第 1 站到最后一站按总路程重排,示意里两条轨迹都收成较少折返的环。(c)d-mix:只有平均站间距超过 ℓc 的那条做重排,另一条保持原顺序。来源:原论文 Fig. 3。
d-rand 使用的衰减是:离市中心 r ≥ 1 km 时,D(r) = 1.2 r^(−2.2);r < 1 km 时在城内均匀,D(r) = 1/R²。方向仍随机。因为停靠更可能位于中心一侧的远处,下一次抽到城市另一侧的机会不低,朝参考点穿越的负向段就多,ρ 最低。
d-TSP 不改停靠位置,只重排顺序,使总路程变短。算法是遗传算法,对旅行商问题给出近似解,不是每条轨迹的精确最短路。重排后,车更常先走完同一侧的邻近停靠,少做横穿,ρ 升到三套模型里最高,但仍小于 1。
d-mix 站在两者之间。一条轨迹的平均站间距大于 ℓc 才做旅行商重排,否则保持抽取顺序。ℓc 很小就变成全程优化,ℓc 很大就变回 d-rand。阈值只在北京、用全部轨迹、以起点为参考点,最小化 |ρ数据 − ρ(ℓc)|。补充图 24 的这条绝对误差在 ℓc = 1.72 km 处最小。它是为了对齐北京的 ρ,不是从司机问卷里测到的决策距离。
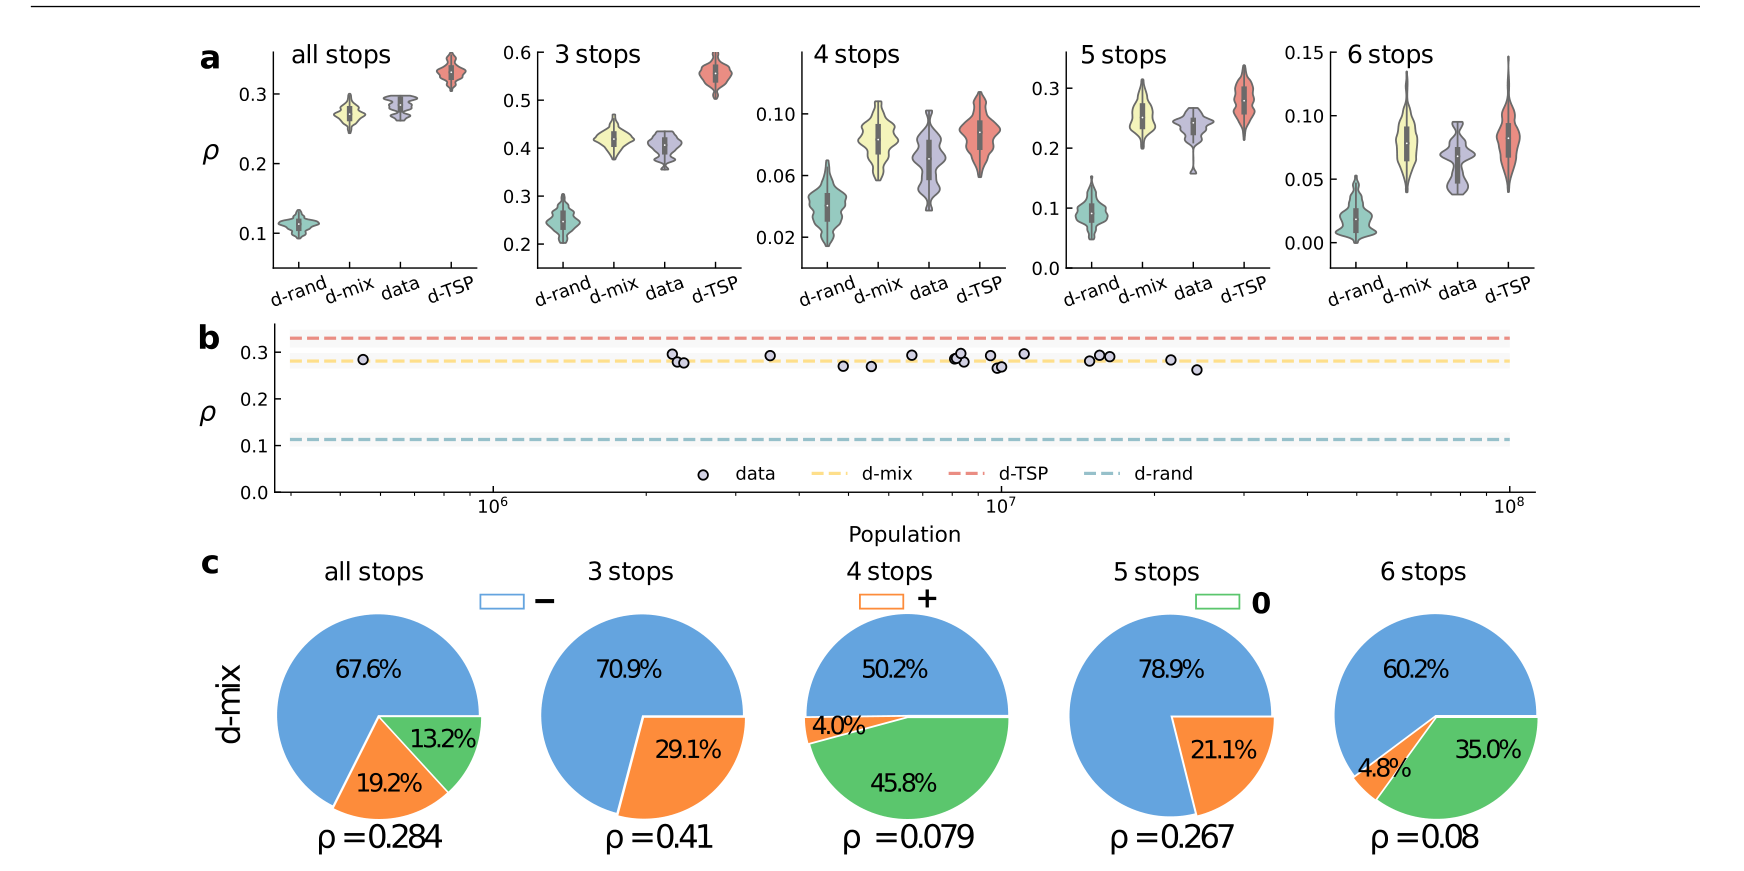
图 4|哪一种个体规则能把 ρ 配到 21 座城市的范围内?
(a)纵轴是 ρ。绿是 d-rand,黄是 d-mix,紫是 D1 的 21 座城市,红是 d-TSP。从左到右为全部轨迹和 3、4、5、6 个停靠。各面板纵轴刻度不同。三套模型都给出 ρ < 1;d-rand 最低,d-TSP 最高,d-mix 与紫色彩重叠。小提琴是随机重复的分布,正文没有写明重复次数,不要把小提琴中位读成某一次模拟的唯一真值。(b)横轴是人口,大约从 10⁶ 到 10⁸。紫点是各城全部轨迹的 ρ,落在 d-mix 的 5% 至 95% 区间里,看不出随人口升高或降低。黄、红、青虚线是三个模型全部轨迹的 ρ 中位数。ℓc 只在北京标定。(c)拟合后的 d-mix 饼图,颜色同图 2。全部轨迹:负向 67.6%、正向 19.2%、平衡 13.2%,ρ = 0.284,与北京的标定目标相同,因为 19.2 ÷ 67.6 = 0.284。3 个停靠 ρ = 0.41,5 个停靠 ρ = 0.267。4 个停靠正向只占 4.0%,负向 50.2%,平衡 45.8%,ρ = 0.079。6 个停靠正向 4.8%、负向 60.2%、平衡 35.0%,ρ = 0.08。这些份额接近图 2,但不是逐扇区相等。来源:原论文 Fig. 4。
全部轨迹的 ρ 对上,是因为目标函数只用了这一个数。正向、负向、平衡三者的份额仍可比:北京实证是 18.5%、65.2%、16.3%,模型是 19.2%、67.6%、13.2%。平衡份额差了约 3 个百分点。按固定停靠数来看,4 站和 6 站的 ρ 也靠近实证,5 站模型 0.267、北京实证 0.238,差距大于全部轨迹。
换城市半径和方框边长后,补充图 18 的全部轨迹 ρ 仍约为 0.28:R = 15 或 25 km、L = 400 km,以及 R = 20 km、L = 200 或 600 km,负向份额都在 67.7%–67.8%,正向在 19.0%–19.1%。把幂律 D(r) 换成经验分布,或换成别的递减函数,ρ 仍小于 1。等长步长的对照模型把相邻停靠固定成 2、4 或 8 km,轨迹依然偏负,有的比原 d-rand 更偏。所以不平衡不能写成短途和长途在单位向量里权重相同这一个原因。
场在城外较清楚,城里的通量模型没有对上
ρ < 1 的模型会产生净场。检验用的是高斯散度定理:沿半径 r 的圆周计算 W 的通量,应等于圆内散度的面积分。两条曲线对距离的决定系数 R²ₚ,是它们的皮尔逊相关系数的平方。模型设定仍是 ℓc = 1.72 km、R = 20 km、L = 400 km、100,000 条轨迹。
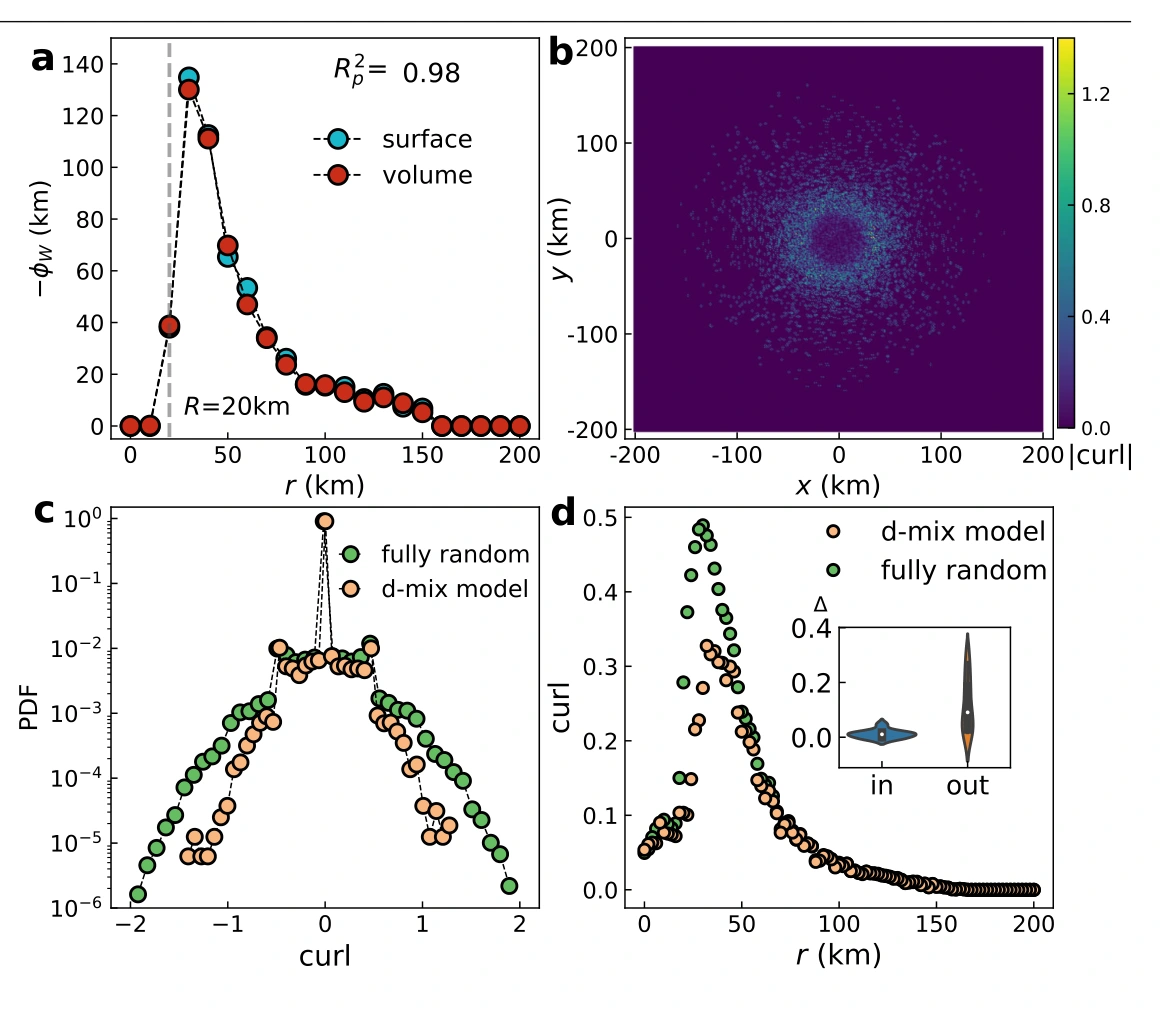
图 5|混合模型产生的场,能不能定义势?
(a)纵轴是通量的相反数 −ΦW,横轴是到市中心的距离。青点是圆周上的通量,红点是散度的面积分,R²ₚ = 0.98。虚线是模型城市半径 20 km。城内两条通量都接近零,正文说明散度定理的这项对照主要不在城内。(b)每个格子的旋度大小,单位是 km⁻¹,颜色从 0 到约 1.2。非零旋度靠近城市边缘,数值仍小于把方向打乱的对照。(c)旋度数值的分布。绿是完全随机对照:保持每个格子的向量长度,方向重抽。橙是 d-mix。模型分布比对照更窄。(d)平均旋度绝对值随距离变化。r ≤ 20 km 时两者接近;城外橙点系统性更低。插图把城内、城外逐格差值画成小提琴,城外对照的差值散得更开。来源:原论文 Fig. 5。
旋度低,才谈得上势。势 V 满足 −∇V = W,并假定旋度可以当作零。d-mix 的这个条件在城外成立,城内并不比随机对照更干净。计算时让方框边界上 V = 0,从角点做差分,再把四个角出发的结果平均,用来压低噪声。
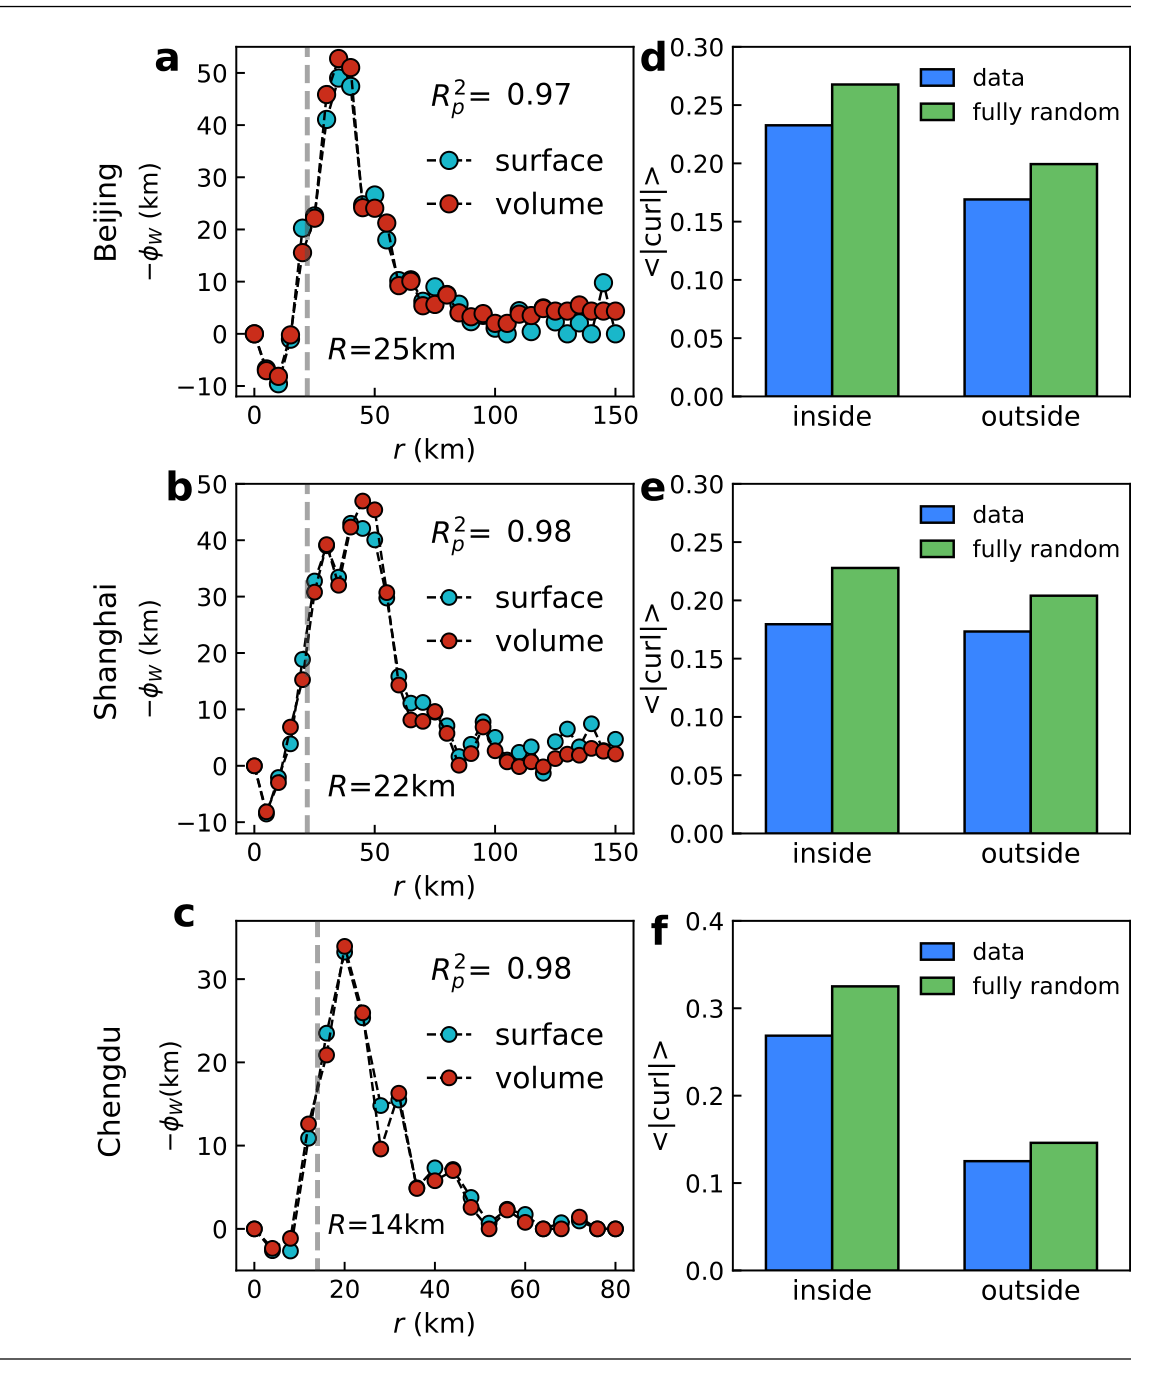
图 6|三座城市的实证场,通量和旋度各自说明什么?
(a、b、c)北京、上海、成都。纵轴仍是 −ΦW,所以图上的正峰对应场平均指向内侧的负通量;靠近 r = 0 的小段负值,对应核心区指向外侧的正通量。青点、红点分别是圆周通量和散度面积分。决定系数:北京 0.97,上海 0.98,成都 0.98。虚线标的 R 是通量降到峰值一半的距离 rc:北京 25 km,上海 22 km,成都 14 km。正文给出的通量峰位大约在北京 35 km、上海 50 km、成都 20 km,是读图的约数。(d、e、f)rc 以内和以外的平均旋度绝对值。蓝是实证,绿是把实证向量的方向随机重指。三座城市、城内和城外,蓝柱都低于绿柱。柱顶没有印出精确读数。城外统计收到 r = 50 km 为止;更远之后,北京和成都的行程向量变稀,论文认为不再有代表性。来源:原论文 Fig. 6。
实证核心区的正通量,论文解释为货车多在近郊发车、到核心区卸货,所以核心区的合方向朝外。d-mix 是各向同性的圆,城内通量接近零,没有复现这段向外的核心。散度定理在三座城市的全空间都对得上,不能因此说圆模型已经复现了城内的货流组织。
其余 18 座城市的通量曲线在补充图 20。决定系数并不都接近 0.98。图上印出的较低值包括海口 0.49、贵阳 0.54、西宁 0.60、拉萨 0.66。补充说明把海口、拉萨、西宁偏低联系到货车较少:补充表 2 中这三城分别是 5,942、1,906、7,892 条轨迹。两条曲线相关高,表示场在数值上比较规整;样本少时,这个相关会掉下来。
纽约签到场在补充图 22。通量的 R²ₚ = 0.95,半高距离 rc = 4 km,同样是先正后负。城内城外的平均旋度都低于完全随机对照。
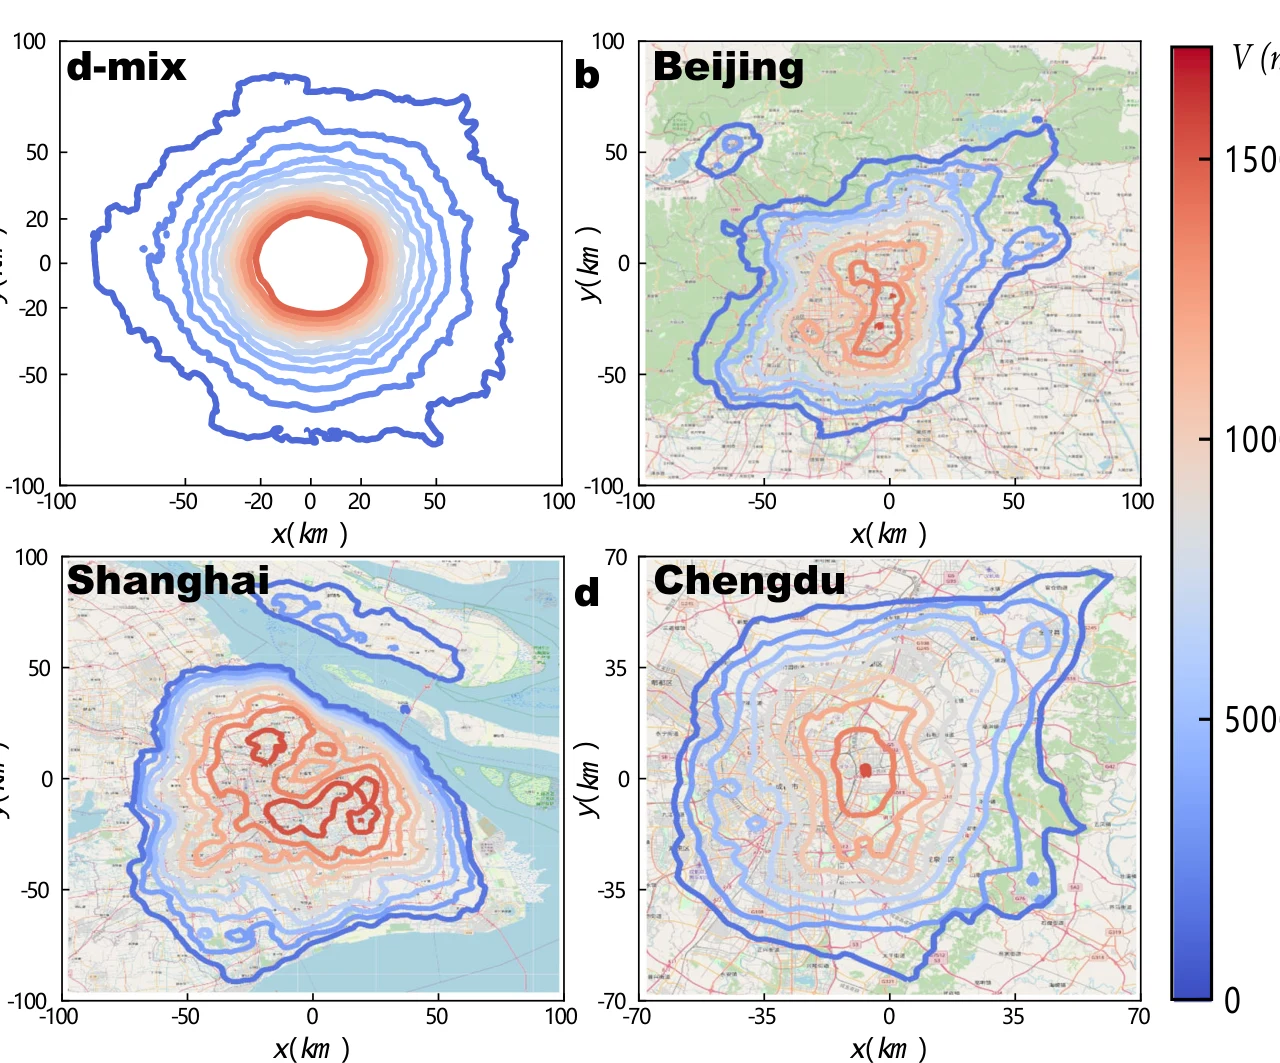
图 7|势的等值线跟着城市形状走,还是跟着圆形假设走?
颜色表示势,单位是米。d-mix 面板的坐标约到 ±100 km;三座城市的坐标范围不同。
(a)d-mix,100,000 条轨迹,R = 20 km,L = 400 km。等值线接近同心圆,城内是空白,因为这个模型的势主要在城外定义。(b)北京。(c)上海,等值线避开水面,并在江上留下分离的一块。(d)成都,等值线更接近单中心。北京和上海的等值线能看出外围的次级中心。等值线向外几十公里后变模糊;场可以继续延伸,但样本不足以再画清楚。底图来自 OpenStreetMap。来源:原论文 Fig. 7。
圆形等势线是模型的各向同性假设,不是北京或上海的实测形状。实证等势线吸收了海岸、河流和建成区。把它读成活动中心的一种中尺度图像可以,把它读成宜居性、步行性或设施短缺的测量则超出了这张图。
停靠点用真实的,顺序按规则重排
ρ 对城市形状不敏感,势的形状则直接依赖真实停靠点在哪里。混合模型的下一步是:保留每条实证轨迹的起点和其他停靠位置,先打乱除起点以外的顺序,再按 d-mix 的规则决定要不要重排。重排结果不必等于原来的顺序。
正文给出的轨迹重合比例是北京 79%、上海 71%、成都 79%,纽约签到 71%。前后文指的是重排后的轨迹与实证原轨迹相同的比例。论文没有再写分母是全部轨迹,还是只计停靠数达到某个值的轨迹。不重合的部分超过 20%。问题是,这 20% 以上的顺序差别会不会改掉中尺度的势。
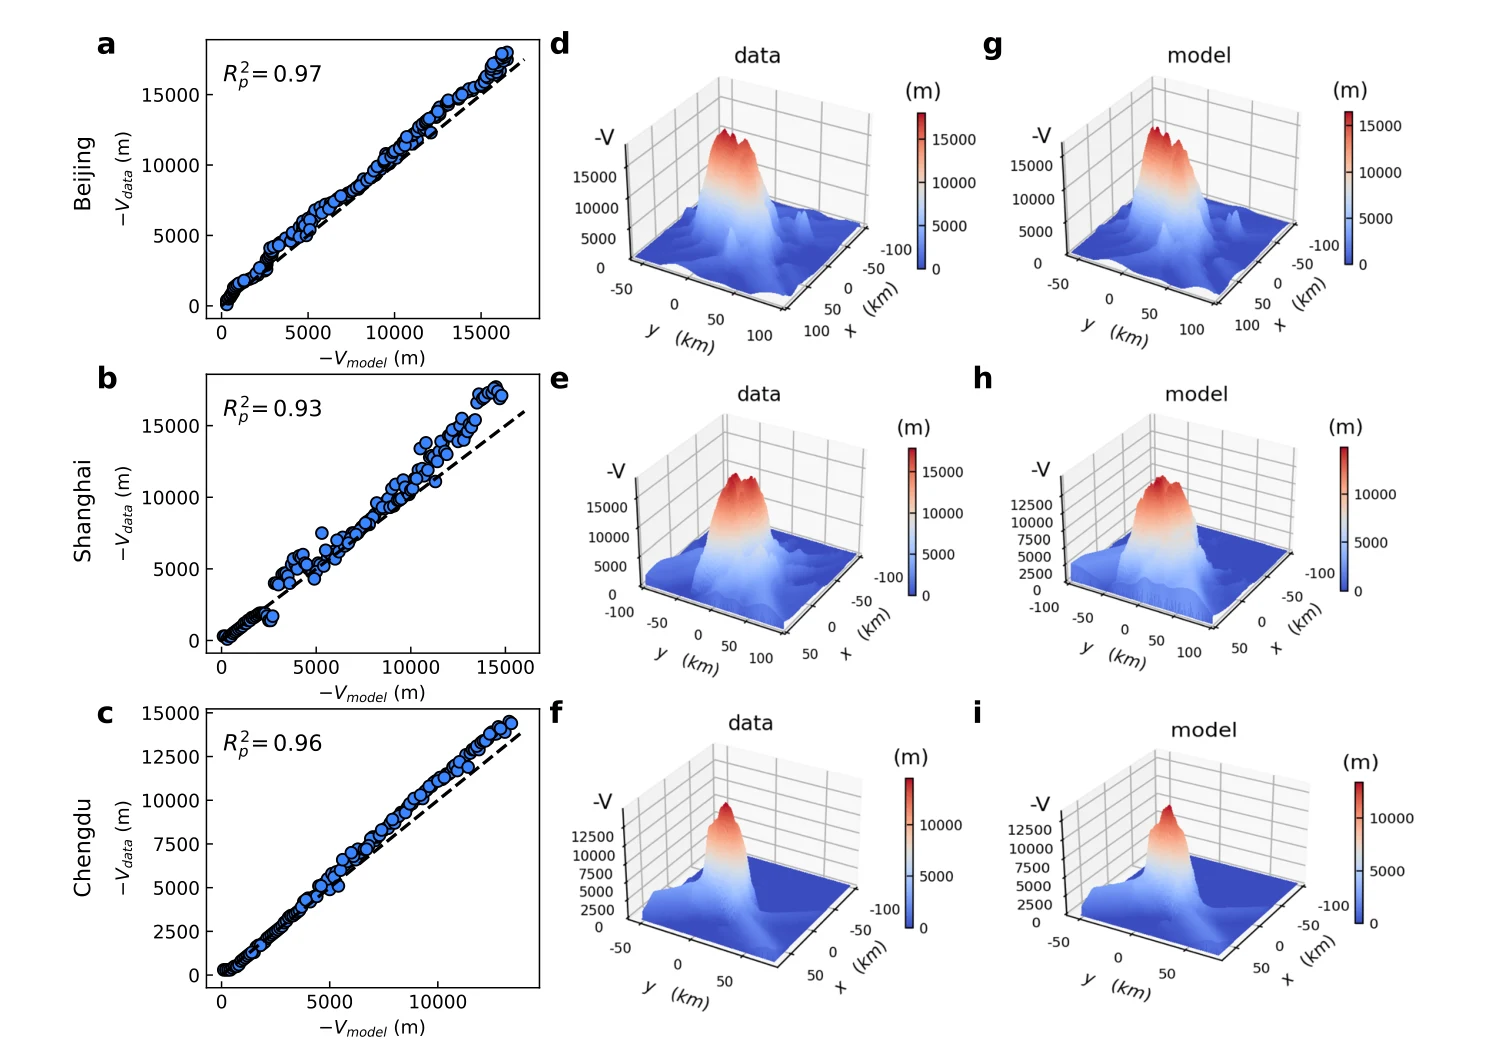
图 8|顺序只按规则重排时,势还像原来的城市吗?
(a、b、c)北京、上海、成都。横轴是模型势的相反数 −Vmodel,纵轴是实证势的相反数 −Vdata,单位米。决定系数 R²ₚ 为 0.97、0.93、0.96。整体变号不改变这一相关系数的平方。北京和上海的刻度画到约 1.5×10⁴ m,成都散点的纵轴也以 2,500 m 为间隔画到 1.5×10⁴ m。虚线是对照。(d、e、f)实证势的三维形状,纵轴是 −V。(g、h、i)同一城市的混合模型。北京、上海有多个高点,成都更集中。最大偏差出现在势最高、靠近市中心的位置;纯 d-mix 的势在那里没有定义,阈值也不是按城内通量标定的。来源:原论文 Fig. 8。
纽约的对应散点在补充图 23,图上印的 R²ₚ = 0.9;正文写成超过 0.9。中尺度上,真实停靠位置加上长行程优化、短行程不优化,已经能恢复势的主要起伏。这仍是在观察到的停靠点上重排顺序,不是在空白地图上预测下一趟货会停在哪里。
这些数不能推出的事
相关和拟合停留在场的定义之内。单位向量场描述方向是否一致,不描述货运吨位、费用或排放。1.72 km 能对齐北京全部轨迹的 ρ,不能单独证明司机在这个距离上切换策略。旅行商步骤是启发式近似。圆形模型故意去掉了路网,所以它解释不了上海的江和海,也解释不了核心区向外的实证通量。
签到用户是会在应用里记录地点的人,货车是 2018 年 5 月下半月的重型卡车。两种数据都出现 ρ < 1,说明方向不平衡不只属于货车调度;两种 ρ 并不相等,也不能外推到步行、公交或人口迁移。21 座城市的轨迹条数相差两个数量级,合肥一城占补充表 2 合计的约三分之一。海口、拉萨等城市的通量决定系数明显更低,全市平均的规整场不能自动套到样本稀的城市。
势可以在实证数据的城内和城外定义,是因为旋度低于方向被打乱的对照。低于对照不等于旋度为零,也不等于找到了像电荷那样的唯一源。讨论里把势设想为优化城市移动策略的基础,这是后续用途,不是本文完成的规划实验。
一句话总结
只数方向时,朝轨迹起点返回的轨迹稳定地多于离开起点的轨迹;停留点近城心更密、长行程少走回头路、短行程近乎随机,这三条一起才能把这种不平衡收成一张大体可定义势的中尺度场。
核心来源
- Communications Physics 正式版,题目、作者、单位、2024 年 6 月 13 日发表信息,以及正文图 1–8。
- 同一 DOI 下的补充材料,含补充注 1–12、补充图 1–24、补充表 1–5。轨迹条数、幂律指数、纽约饼图、其余城市的通量决定系数和 ℓc 的误差曲线都在这里。
- 作者代码仓库。货车原始记录的入口是国家道路货运监管与服务平台;停靠识别见 Yang 等,Transportation Research Part C 136,103564(2022),以及 Transportation Research Part E 157,102590(2022)。纽约签到来自 Bao、Zheng、Mokbel,ACM SIGSPATIAL 2012。
- 通勤起讫矩阵上的前作:Mazzoli 等,Field theory for recurrent mobility,Nature Communications 10,3895(2019),即本文参考文献 54。
作者介绍
- 刘二见(Erjian Liu):论文署名为 IFISC(CSIC-UIB)、北京交通大学系统科学学院和 Beijing Transport Institute(北京,100073),通讯作者之一。与 Mazzoli、Ramasco 设计研究并完成分析,与闫小勇收集、分析实证数据。北京交通大学教师页将他与闫小勇合作的中文综述署名为刘二见。IFISC 出版物页面记载其 2023 年博士论文由闫小勇与 Ramasco 联合指导。
- Mattia Mazzoli:论文署名为意大利都灵 ISI Foundation。与刘二见、Ramasco 共同设计并完成研究。本文参考文献 54 的作者名单中有他和 Ramasco,那篇论文处理的是通勤起讫矩阵上的场。
- 闫小勇(Xiao-Yong Yan):论文署名为北京交通大学系统科学学院。与刘二见负责实证数据。学校教师页列其为系统科学学院教授,方向包括系统科学、系统理论与复杂性、复杂交通系统建模与调控。论文致谢中的国家自然科学基金 72271019,与教师页所列、由他主持的面上项目编号相同。
- José J. Ramasco:论文署名为 IFISC(CSIC-UIB),通讯作者,协调本研究,并与刘二见、Mazzoli 一起设计场的定义和模型。本文从他与 Mazzoli 等人 2019 年的通勤场论,推广到由个体轨迹直接构造的场。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
单位向量让 1 km 和 30 km 在同一个格子里各算一票。若调度要省的是燃油或吨公里,就应给长段更高的权重,合向量会改写。论文已经表明,把步长一律改成 2、4 或 8 km 仍得到 ρ < 1,所以不能把不平衡完全归咎于长短段权重相同。下一步可以同时报告两张图:一张仍是现在的方向场,一张按段长加权。只有两张图的高值区还重合,才适合用这张势去讨论货运走廊。
1.72 km 是对齐北京货车全部轨迹 ρ 的阈值。纽约全部签到轨迹的 ρ 是 0.266,分母是负向轨迹条数,低于北京的 0.284。用同一套绝对误差、只换纽约数据重新找 ℓc,得到的距离不必仍是 1.72 km。若签到需要明显更短或更长的阈值,长途优化、短途随机就还带着交通方式,而不是一个跨城市的固定米数。
等势线把北京、上海的外围中心显出来,很容易被当成新枢纽该落在哪一层。这张势继承了货车样本、单位向量和起点参考点。居民通勤若换成 2019 年那种居住地—工作地场,同一座城市的等值线可以改道。把货运势直接用作设施选址分数之前,至少应在同一网格上比较货车势和通勤势,看次级中心是两套数据共有的,还是只有夜间回库的卡车才看得到。