停留、路线和通话并排之后,这张关系图能说明什么?
论文名片|Wei Chen、Jing Xia、Xumeng Wang、Yi Wang、Jun Chen、Liang Chang,RelationLines: Visual Reasoning of Egocentric Relations from Heterogeneous Urban Data,ACM Transactions on Intelligent Systems and Technology,2018,10(1):Article 2(2018年12月),21页。DOI:10.1145/3200766。稿件2017年8月收到,2018年2月修订,2018年3月接收。本文依据这一正式发表版。
两部手机在工作日下午反复出现在相邻的地方。把它们看成同事,很快;它们也可能只是去了同一家商场。RelationLines 要处理的就是这种含糊:直接联系可以是一通电话,间接联系只是两个人在时间和空间上叠在一起。系统把停留、路线和通话画成可以对照的线,让分析者自己把猜测收紧或放下。
方向先说清楚。这是一套城市数据上的关系可视化,不是一份已经测过准确率的认人实验。线的长短表示轨迹重叠或界面上的筛选结果。家人、同事、交接班司机,都是看图的人给出的假设。论文自己也写了:没有直接证据时,只能停在假设。
先说结论
- 五类数据不在同一套日历上。基站移动和出租车都是 2014 年 1 月 20 日至 28 日;通话是 2013 年 12 月 15 日至 22 日。论文写明两组数据没有时间重叠,所以一通来电只能标记“另一周有过联系”,不能证明移动数据这一周两人在一起。
- 界面把任务拆开。停留条先画超过 30 分钟的地方,还可以再标出超过 60 分钟、或到访超过 3 次的地方。关系列表展示前 30 人;每一条约束先留下匹配度前 100 名、或匹配度超过 0.8 的人,再从同时落入这些组的人里取前 30。30、100 和 0.8 都是界面限额,分母不是数据集里的 500 多万名用户。
- 三个案例用同一套图提出不同假设:帖子和兴趣点给地点一种读法,出租车时间线上约 2 小时的空档被读成交接班,通勤重复被读成住处与工作地。论文没有给出这些读法的正确率。
- 性能表量的是查询时间。约束里有 10 个基站区间时,MonetDB 平均 3.34 秒;20 个为 5.92 秒;100 个为 30.75 秒。按编号取一个人的一周轨迹,MySQL 是数十毫秒,MonetDB 是 3.3 秒。
- 用户评估是两位公共安全从业者的定性意见,没有任务人数、完成时间和正确率。
五类数据并不覆盖同一周
数据来自一座论文没有点名的大城市,只说有数百万居民。分析单位随数据变化:有的是手机进出基站的记录,有的是出租车轨迹点,有的是一通电话,有的是一条带地理标签的微博,有的是一个兴趣点。它们不能换成同一个人的全天行程。
基站移动数据有 6 亿条记录,涉及超过 500 万名市民、9303 个基站,时间是 2014 年 1 月 20 日至 28 日,体积 34 GB。手机进入或离开某个基站范围时记一条。这条记录不是人脚下的坐标。手机不一定连到最近的基站,还受信号强度、4G 优先和基站容量影响;市中心的基站比远郊和山区密;手机关机,或被人留在别处,轨迹就会断,或者根本不是这个人在移动。
通话数据有 5.5 亿条,时间是 2013 年 12 月 15 日至 22 日。每条有主叫、被叫(被叫在这座城市内才有)、双方基站、时间和时长。它是这批数据里唯一能直接确认两人有过联系的来源。实验不用它来挑选目标,因为和其余数据没有重叠的日期。作者把它当作联系是否存在的参照,理由正是它不能从同一周的轨迹里循环得来。
出租车 GPS 有 3610 辆,2014 年 1 月 20 日至 28 日每 20 秒记一个精确位置。兴趣点由移动服务商标注类型,例如商场、医院、政府和教育机构;论文收集了全市兴趣点的位置,再按基站汇总,但没有给出兴趣点总数。微博约 93491 条带地理标签的帖子,时间从 2014 年 1 月 14 日到 2 月 28 日,比那九天的移动窗口更长;涉及 38000 个账号,其中 1347 个账号的带地理标签帖子超过 10 条,316 个超过 20 条。这里的分母是这批微博账号,不是九天里的全部手机用户。
同一个格子,为什么还不是同一个人在一起?
基站轨迹和出租车轨迹的时间和空间粒度不同。前者稀疏、位置粗;后者密、坐标细。论文用一棵四叉树把它们放进同一套网格:矩形区域的对角线长 35.57 千米,位置编成 14 位编码。第 1 级格子的对角线约 17.78 千米,第 14 级约 2.17 米。所谓落在同一局部区域,是落在分析者选定的某一级格子里,不是站在同一个门口。市中心格子可以取得更细,稀疏地区只能更粗;放宽格子会多找出候选人,收紧格子会漏掉对不上的点。论文写明,数据不准带来的误差无法靠网格单独消掉。
偶遇也会制造重叠。住在同一片区的人会去附近商场,于是出现一批地理上的共同出现。作者举的对照是:若两个人每个工作日都在位置上重叠,才更像同事。因此共同出现只是候选线索。通话、兴趣点类型和重复出现的时间段,要另外拿来核对。聚类被作者认为容易抹掉这些细节,所以界面从一个人的轨迹开始,而不是先给所有人分组。
五块视图分别卡住哪一个问题?
自我中心网络(egocentric network)在这里指以一个目标为中心的成对联系:有哪些人、联系是通话还是共同出现、条有多长。系统把工作拆成四项:找到目标,阅读这个人怎么移动,搭出关系列表,再用共同出现去复核。五块视图里,目标、时间线、关系列表和共同出现时间线各对应一项;地图在各项里都用来核对位置。
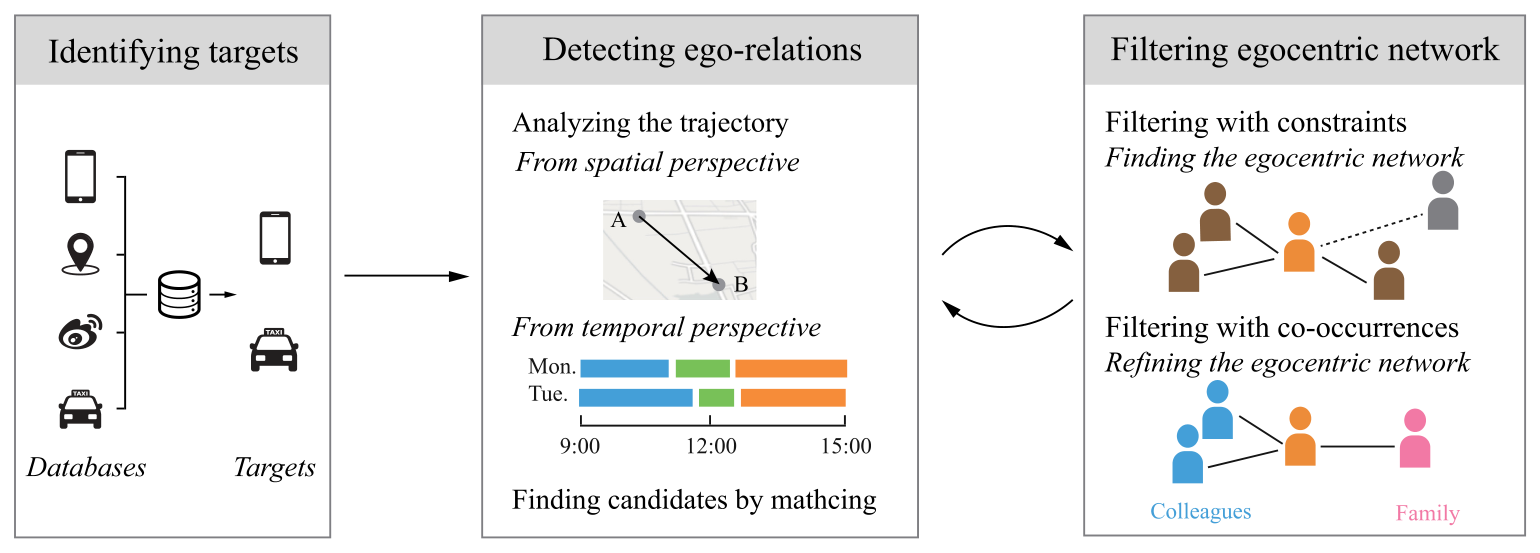
图 1|从多源记录到一张以个人为中心的关系草图,界面打算分几步看?
这张示意图没有子图字母。左栏从手机、地点、社交帖子和出租车等数据里指定目标,目标可以是一部手机或一辆出租车。中栏把目标轨迹分成空间上的一段位移,以及按星期和时间画出的色条,用来找候选人。右栏先按约束筛关系,再按共同出现把候选人收成同事或家人这类标签。图中的同事和家人是示意标签。来源:原论文 Fig. 1。
界面用代号而不是昵称,时间轴用星期而不是具体日期。图上因此看不到真实账号名,也不能把某一行直接对到日历上的哪一天。
条的长短,量的是重叠,不是关系
一条轨迹被拆成若干基站区间:开始时间、结束时间、一个位置。点约束是一个时刻加一个位置。某个区间盖住这个时刻,而且两个位置落在同一级格子里,这条轨迹就满足该点约束。
两段停留的匹配度,论文定义为:不在同一局部区域,记 0;时间不重叠,记 0;否则取重叠的时长。两条轨迹的匹配度,是各段这种重叠时长的加总。图 2 里的灰色方块就是这种重叠。示意图同时又把两段重叠除以从 T1 到 T6 的整段窗口,写成一个比例。加总公式和这个比例不是同一个口径。后面的界面还会把不同人的匹配度缩放到 0 到 1,用条的长度来画。所以条长是相对排序,不是“认识的概率”。
另一种计分只数有多少段对得上。示意图里,这种计数等于 2。论文有一句把“完全对上”和 0、1 的对应写反了,和“结果为 2”对不上。读条的长度时,以重叠时长、段数和 0 到 1 的归一化为准,不要用那一句反过的定义。
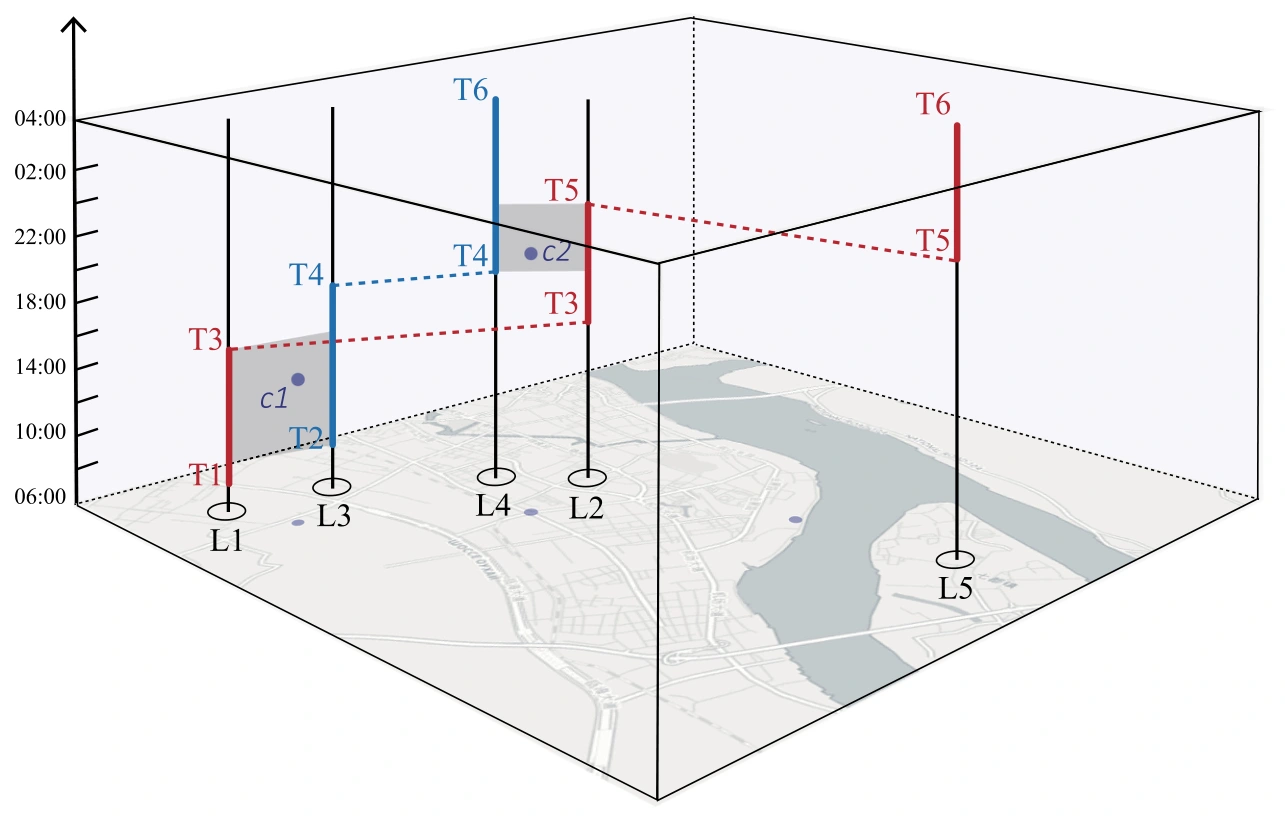
图 2|怎样把“同一地点、时间重叠”画成可以比较的一段?
这张示意图没有子图字母。竖轴是时刻,底图是地图,L1 到 L5 是地点。红色和蓝色竖线是两条轨迹在各地点的停留。c1、c2 是点约束,灰色块是位置相近且时间重叠的部分;c3 没有被任何停留盖住。红色轨迹在 L5 还有单独的一段,不和蓝色重叠。来源:原论文 Fig. 2。
点约束可以在地图上点,也可以从选中的微博来。轨迹约束则拿一条已知轨迹去和其他轨迹比。论文说,停着不动的轨迹更适合比重叠时长,正在移动的轨迹更适合数对上的段数。这个选择影响的是条怎么排序,不是自动给出社会关系的类型。
环和日历怎样把一周摊开?
目标视图先按数据集、时间和地图上的标记缩小范围。图 3 的例子从基站位置数据出发,时间从周一 0 点到周二 0 点,两个标记都在周一,分别是 20:00 和 22:00。论文说这样可以找到两名候选人,再放到地图和时间线上检查。地图上的线是候选人的轨迹,不是已经确认的同行关系。
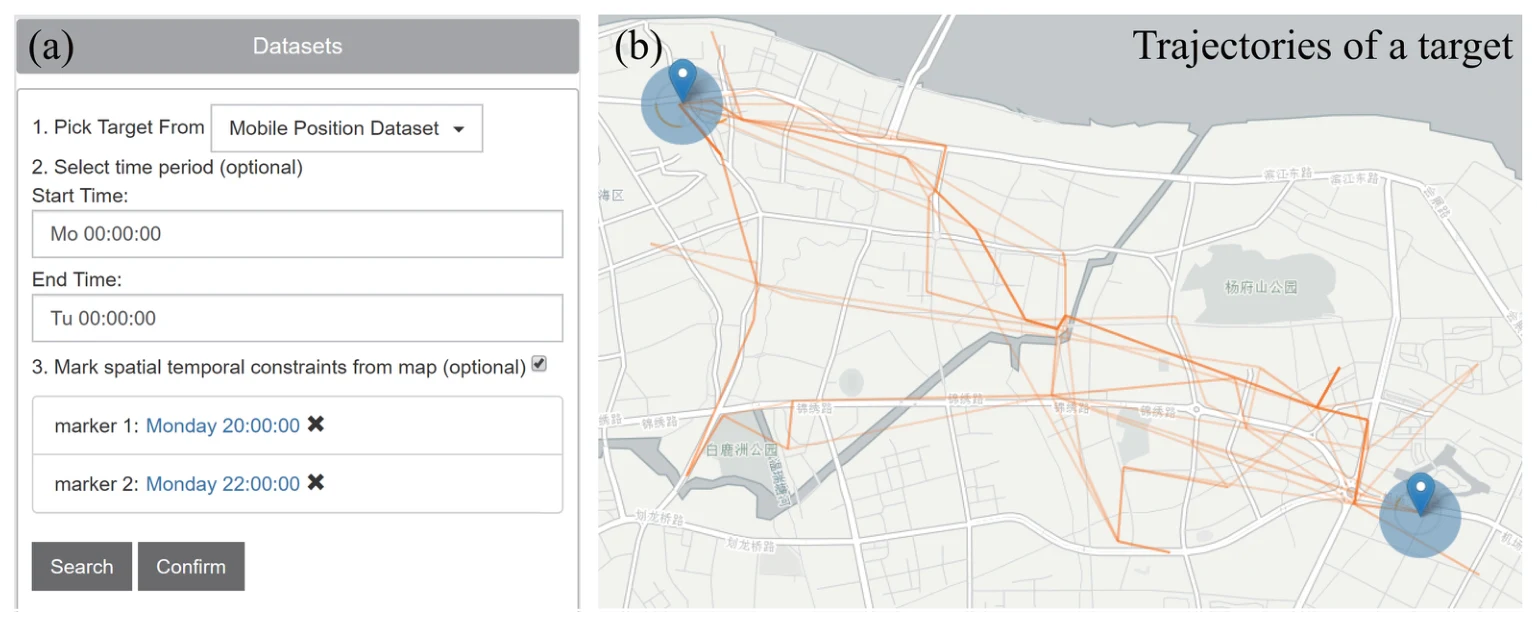
图 3|找目标时,时间和地点约束怎样同时出现?
(a)目标视图列出数据来源、起止时间和两个地图标记。(b)地图上两个蓝点对应这些标记,橙色线是由此看到的轨迹。来源:原论文 Fig. 3。
选定一个人之后,地图上每个常去地点放一枚径向图。一圈是一天,按顺时针转 24 小时;看一天就只有一圈,看许多天就有许多圈。地点按经纬度做 K 均值聚类,类的个数可以调,同一类用色轮上邻近的颜色。因此颜色相近表示位置相近,不是论文已经判定的家或公司。
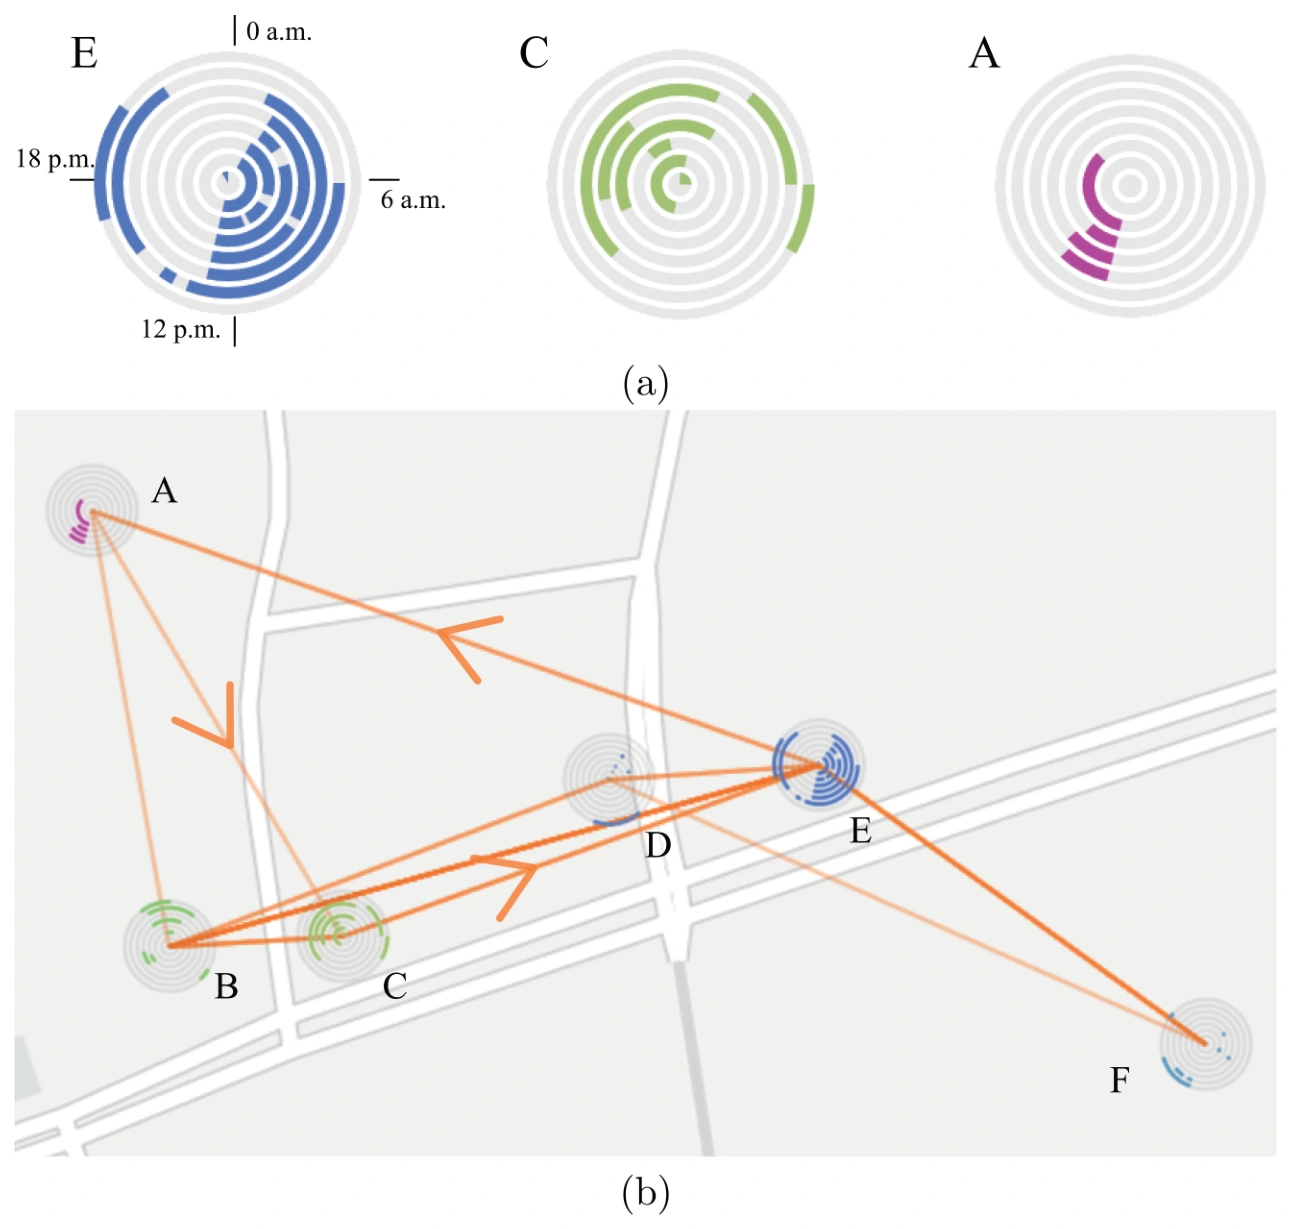
图 4|一周的停留,怎样既留在地图上,又看出每天的钟点?
(a)E、C、A 三处各有一串同心环。论文从这组环读出:E 在六天里大约各停半天,A 出现在四个上午,C 出现在多数下午。环上没有另附天数统计表,这是对弧段的读数。刻度印着 0 a.m.、6 a.m.、12 p.m.,以及图上写成 18 p.m. 的那一格。(b)同一套颜色放回地图,橙色线和箭头画出地点之间的路径。论文标出其中一条 E 到 A、再到 C、再回到 E。B、D、F 也在图上,但这一条路径没有把它们算进去。来源:原论文 Fig. 4。
日历视图把横轴固定为 0 点到 24 点,纵轴是一天又一天。基站数据里,色条只表示停留超过 30 分钟的地方,两条之间的空白是转移。分析者可以再突出停留超过 60 分钟、或到访超过 3 次的地方。出租车数据里,色条表示载客时段,颜色不再区分地点,因为一趟车会经过许多地方。
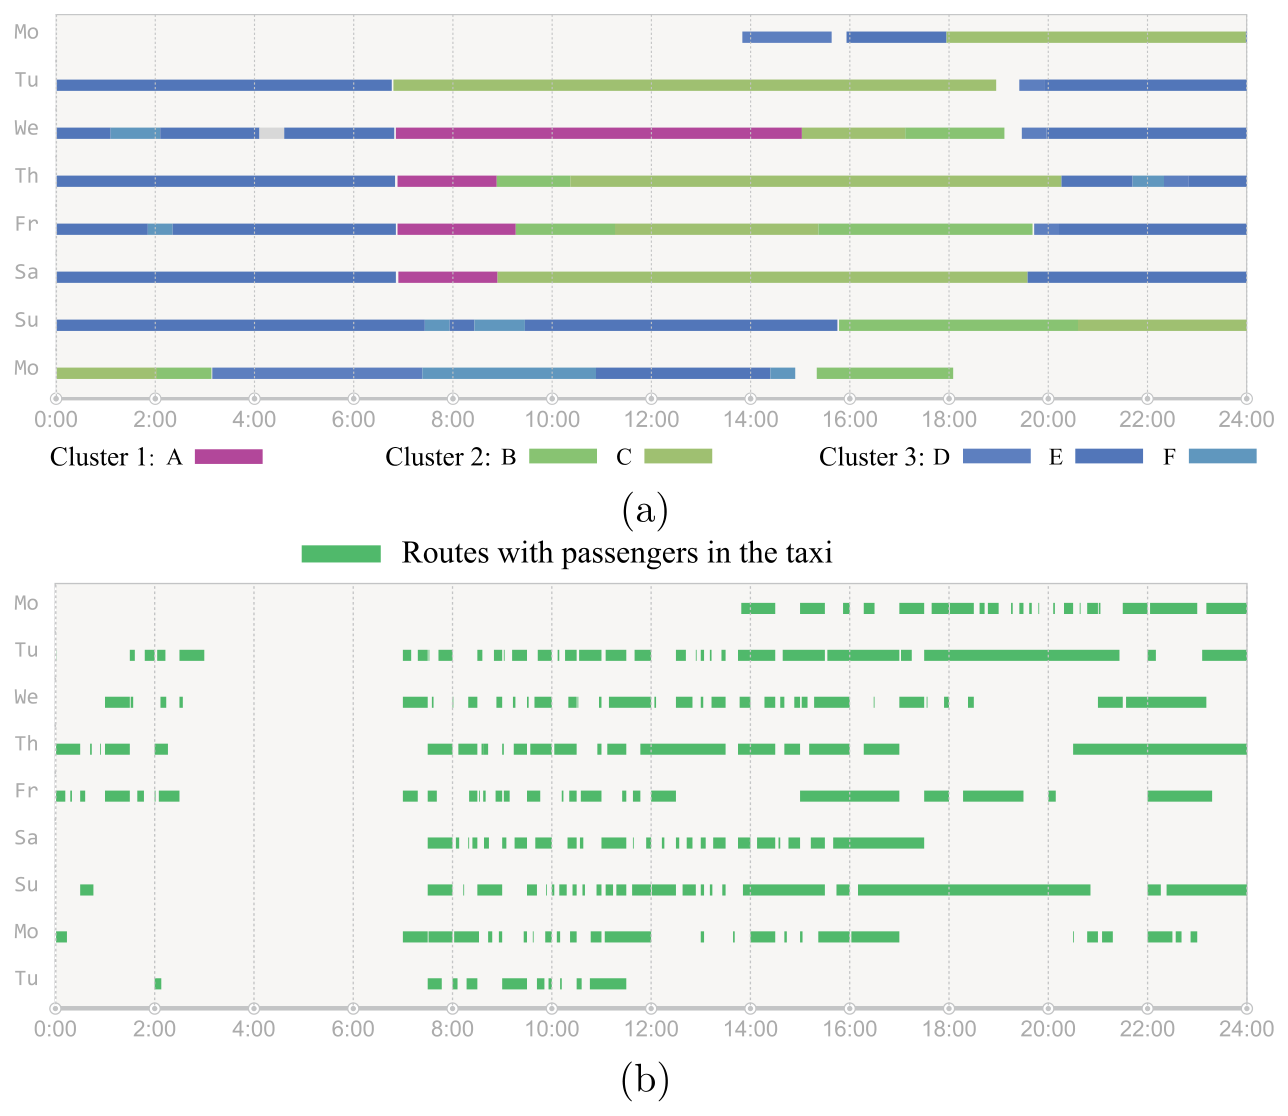
图 5|同一种日历,手机停留和出租车载客看起来有什么不同?
(a)纵轴按星期排列,图上不印公历日期;基站数据窗口本身是九天,但论文没有逐行标明每一行对应哪一个公历日。图例把 A 画成洋红,B 和 C 画成两种绿,D、E、F 画成蓝色系。正文说这个人有四天停在同一类绿色地点,而且常在下午,于是猜测那是工作地。图注却写蓝色条暗示下午的工作地,又说颜色是随机指定的。图例、正文和图注对不上,不能把某一种颜色直接当成工作地。(b)全部载客时段用同一种绿色短条表示。密集的白天短条和夜间长条是这辆车的出车节奏,不是乘客之间的社会关系。来源:原论文 Fig. 5。
列表为什么只留下最靠前的一小撮?
关系视图叫匹配时间线列表。行是候选人,列是分析者加上的约束。通话列用橙色,长度可由人调整;共同出现之类的间接约束按顺序叫 M1、M2、M3,用深浅不同的灰,长度是归一化到 0 到 1 的匹配度。可以按某一列或全部列排序,也可以删掉一条约束,或拖动表头改变权重。
为了限制计算量,每条约束保留匹配度前 100 名,或匹配度超过 0.8 的人。改完约束后,系统从同时属于这些组的人里返回前 30 名。前 30 的分母是通过各条约束筛选后的交集,不是 500 多万名用户,也不是 6 亿条记录。论文没有报告 0.8 在全体用户中的假阳性有多少。分析者还可以在行旁做标注。标注是人的判断,会写进之后看到的图,但不会变成新的测量。
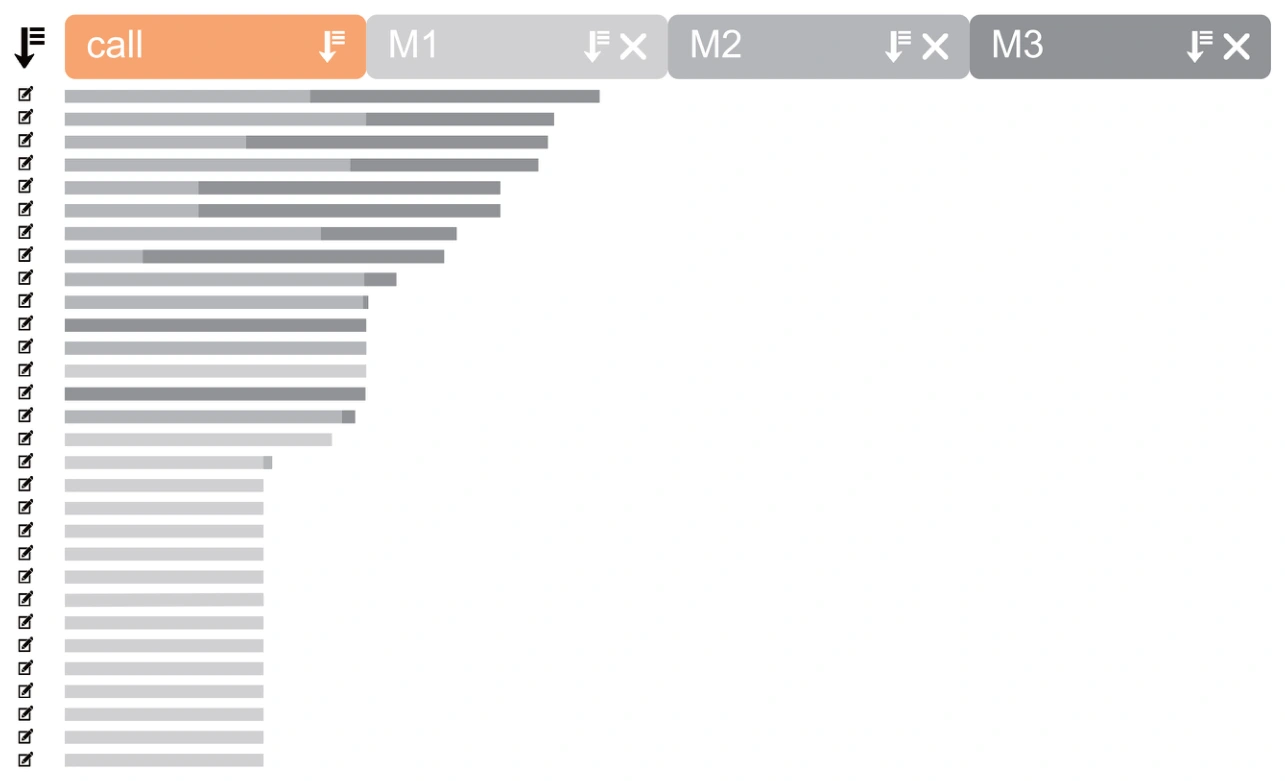
图 6|多条约束怎样排成一张可以排序的关系列表?
这张图没有子图字母。橙色 call 是直接通话,M1 到 M3 是依次加入的间接约束。每一行是一名候选人,灰条越长,表示按当时的归一化越靠前。图注写明这里显示的是前 30 名。来源:原论文 Fig. 6。
共同出现时间线把这 30 人的重叠再摊回钟点。总览行用橙色深浅表示有多少人在该时段重叠。分析者可以点一段以前没选过的时间,把这段里重叠的人标出来。论文用图 5 里圈出的傍晚时段做例子,又发现早晨的重叠其实更大;再点凌晨约 1:00 到 2:50,其中一名候选人几乎整段都和目标重叠。作者因此假设这是家人。这是看图之后的假设。凌晨重叠也可以来自同一部手机的记录方式、同住但并非亲属,或电话留在住处。图本身分不开这些情况。
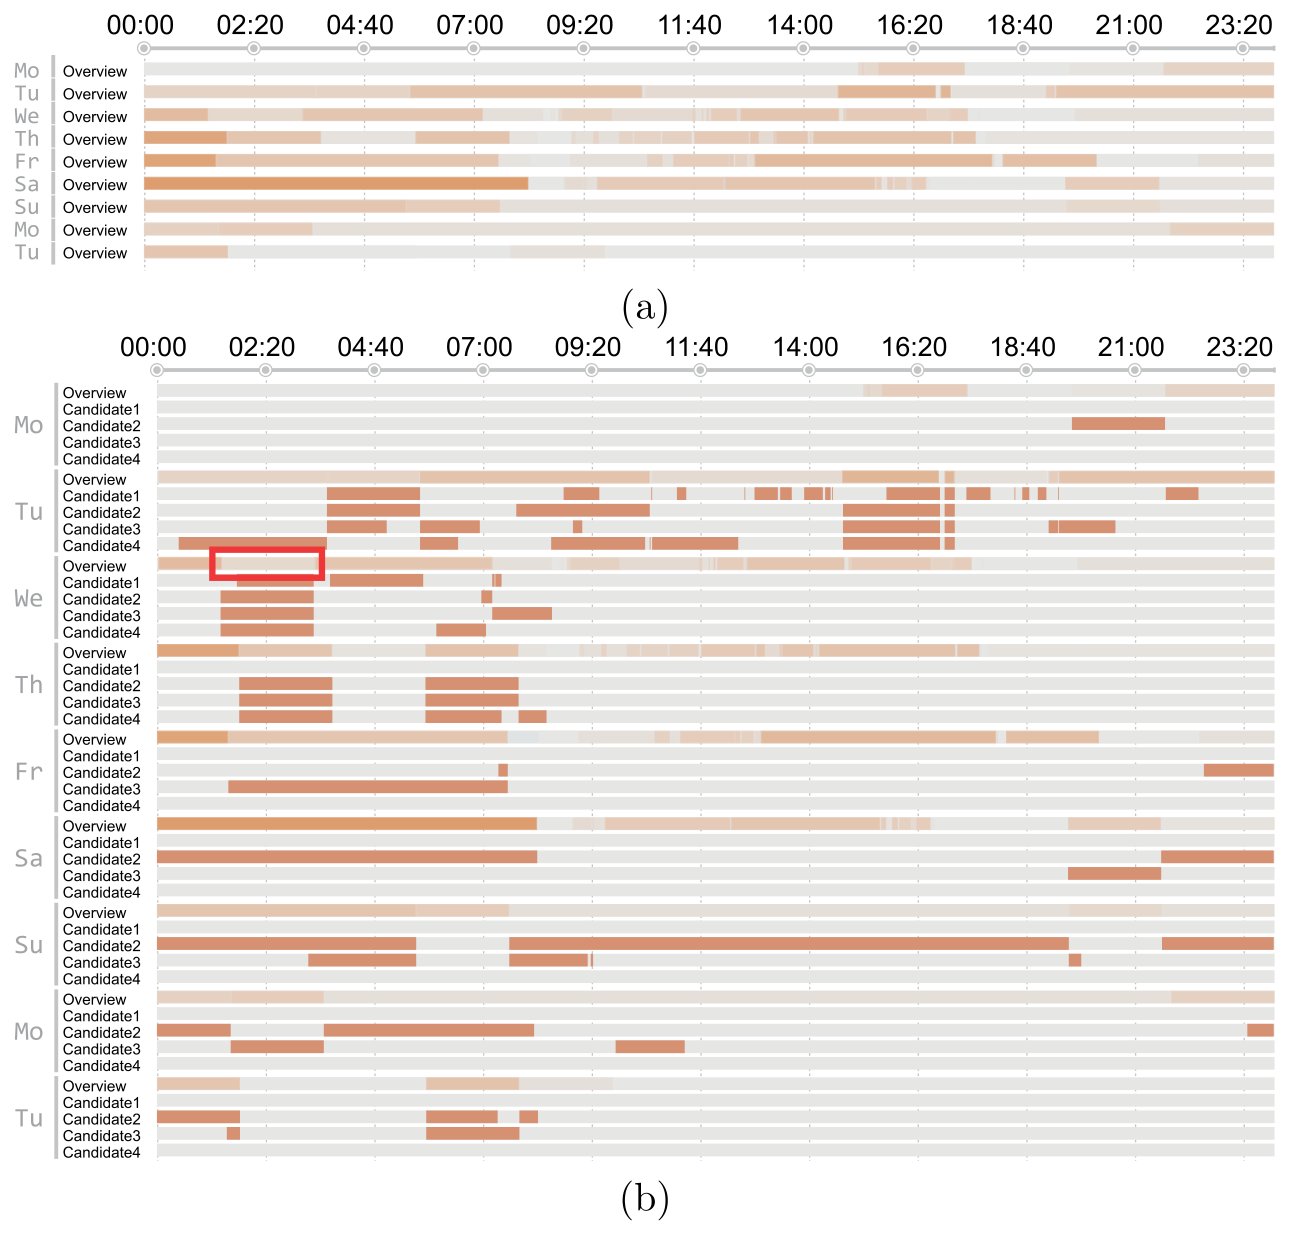
图 7|前 30 人的重叠,在哪些钟点真正挤在一起?
(a)每一天一行总览,橙色越深表示该钟点的共同出现越多。横轴约为 0:00 到 23:20。(b)每一天再拆成总览和 Candidate1 到 Candidate4。红色框落在周二总览靠近凌晨的位置。论文写明,选中凌晨约 1:00 到 2:50 后,该时段与目标重叠的候选人被另行标出。来源:原论文 Fig. 7。
三个例子里,图允许哪一种读法?
评估是三个案例加一次专家访谈,没有对照算法,也没有留出一部分关系做正确率。下面只对照每张图已经画出的板块。
第一个案例先去掉九天里有意义帖子少于 10 条的不活跃账号。这个“少于 10 条”的分母是九天,和前面 38000 个账号里 1347 个超过 10 条带地理标签帖子不是同一批计数。论文根据帖子把一名用户读作女性,并称其有 7 条带地理位置和时间的帖子,地点只有 A、B 两处。兴趣点把 B 标成医院,帖子内容涉及生育,和医院这一类相符。时间线上,蓝色覆盖更长,被读成住处 A;另一色对应医院 B。轨迹是在 A 停留约一天半,两地之间来回,在 B 停留数日,再回到 A。周四到周五没有轨迹,作者猜测手机关机。
关系列表里,有一名候选人既和目标有过通话,轨迹重叠也多。作者据此猜测是家人,并进一步看到另有两人常和这名候选人停在同一处,猜测是家人或亲近的朋友。通话来自另一个星期。重叠和通话并排,只能说明分析者把两类记号放在一起看,不能说明这一周的每一段停留都有第二个人在场。
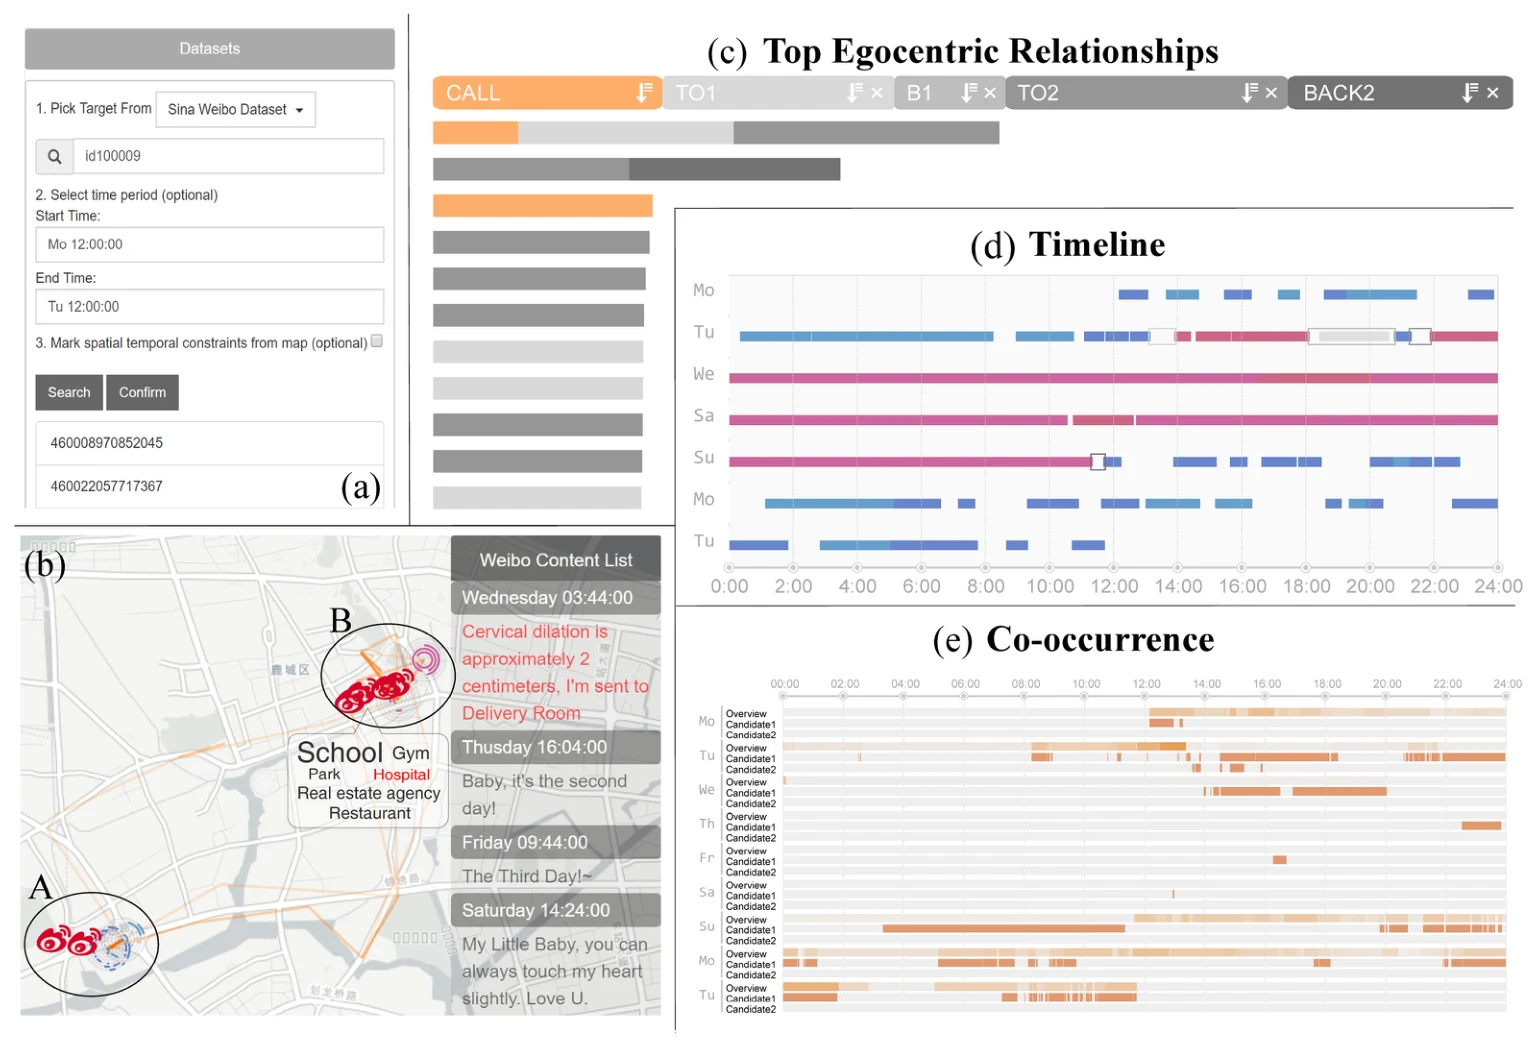
图 8|帖子、兴趣点、时间线和通话怎样放在同一屏?
(a)目标视图从微博数据进入,并用代号而不是昵称。(b)地图标出 A、B 两处,旁列兴趣点类别和带时间的帖子;医院这一类与帖子内容被作者用来解释 B。(c)关系条同时有橙色通话和若干灰色间接约束。(d)时间线用蓝、红两色区分两处停留,中间有成段空白。(e)共同出现图把候选人和目标的重叠再按天展开。来源:原论文 Fig. 8。
第二个案例从 3610 辆出租车里随机抽一辆。载客条几乎铺满每一天,只有早晨 7 点前后约 2 小时的空档。作者先按常见的两人轮班来理解这个空档。关系列表最初显出两部匹配的手机,其中一部更好。把轨迹摊开以后,这一部昼夜都和车重叠,另一部主要在夜间重叠。作者改口:昼夜都在的那一条更像留在车上的手机,只在夜间重叠的更像夜班司机。继续看白天,又出现其他候选人;周一到周六能对上的人,到了后面几天对不上,周日之后的白天则由另一条轨迹补上。作者最后数出三名司机和一部与车相关的手机。这个计数的分母是这一辆车的筛选列表,不是 3610 辆车的司机总数,论文也没有第二名标注者来复核。
交接位置被标成早晨一处、夜间一处。两处都离上一趟载客的终点很近。论文说这符合司机倾向于接到终点靠近交接地点的乘客,但没有给出“很近”的米数。
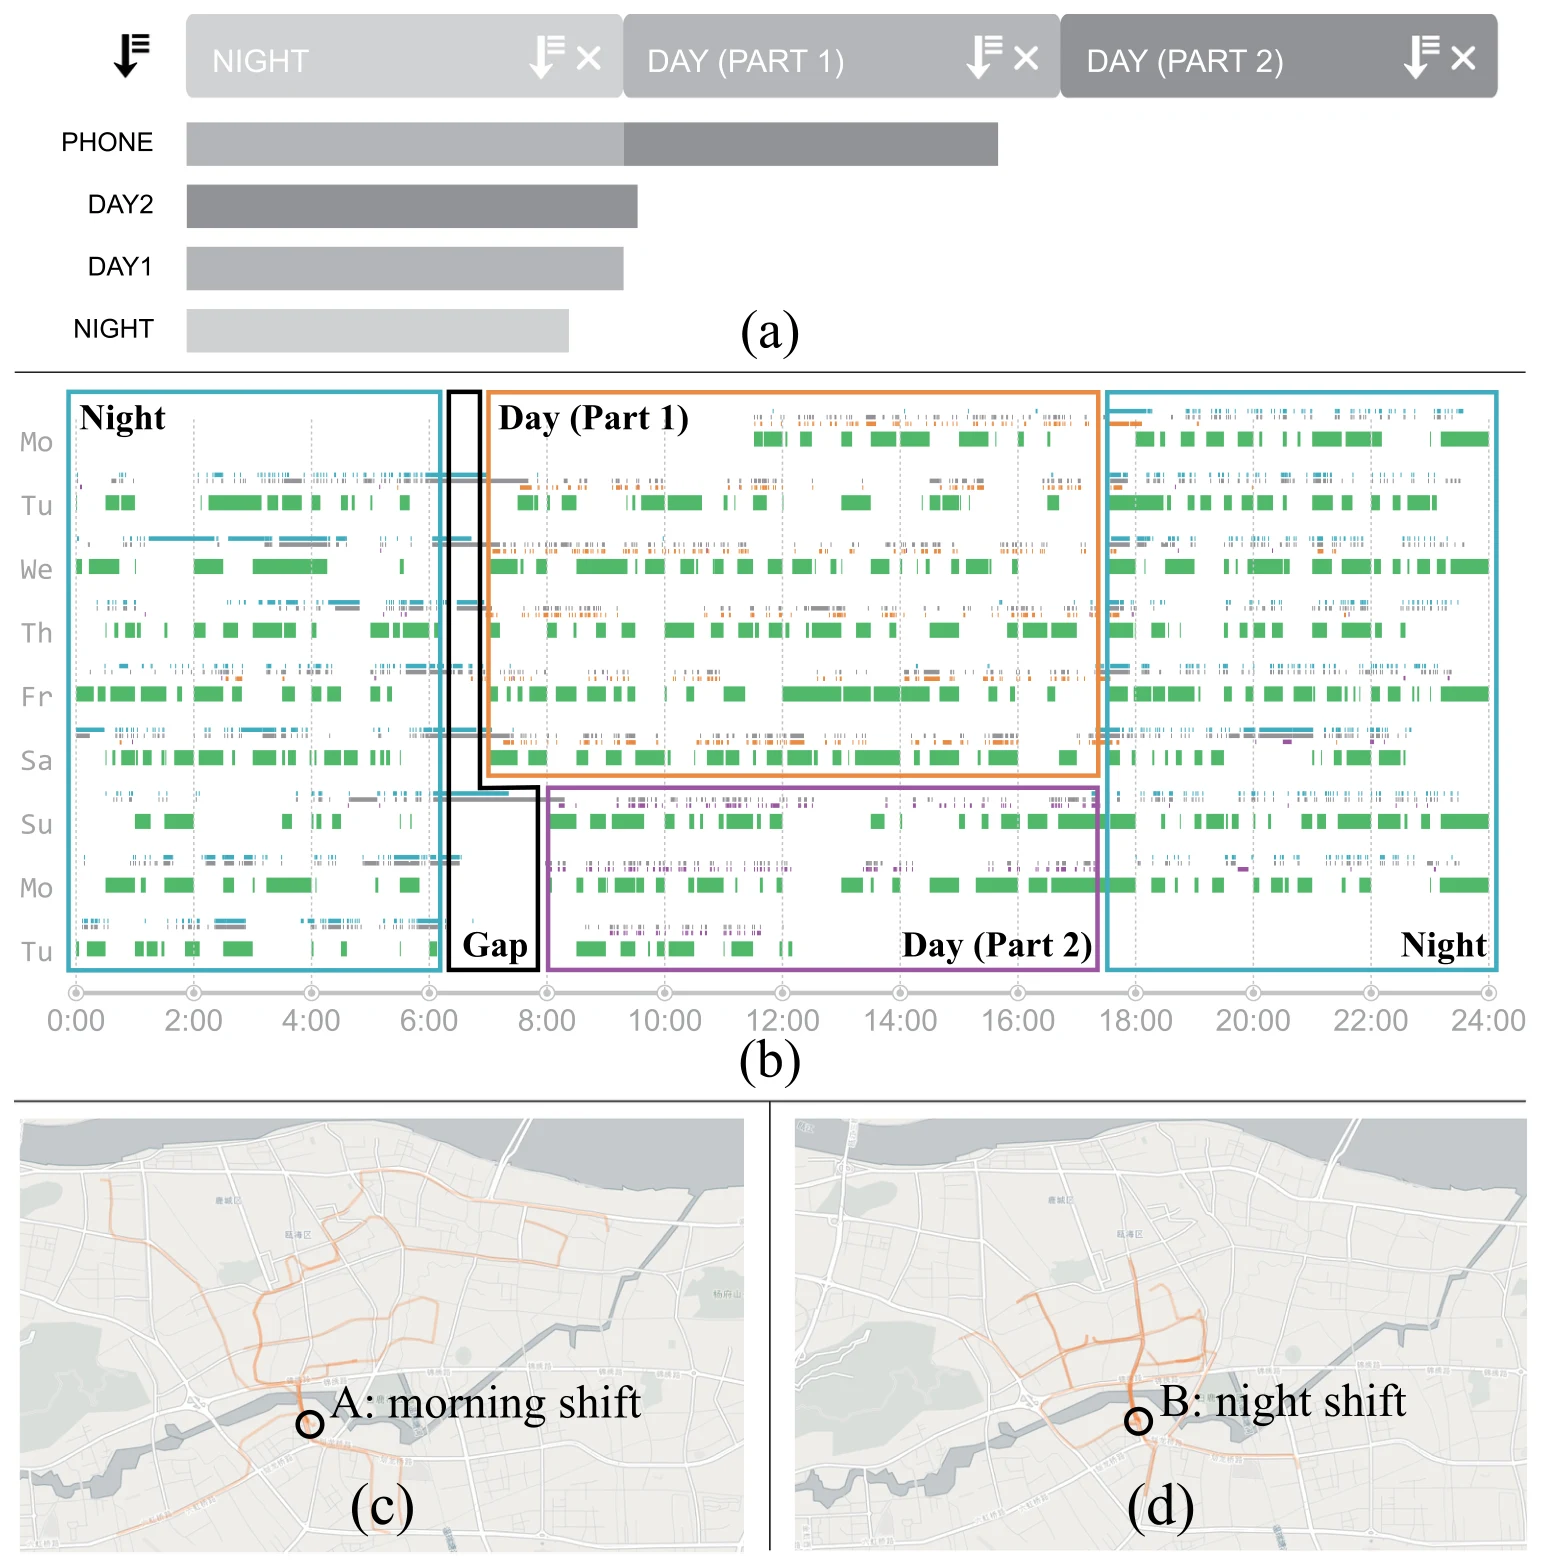
图 9|一辆出租车的空档,怎样被画成不同的值班条?
图注把(a)(b)写成 7:00 与约 17:30 的交接地点,把(c)(d)写成不同出租车轨迹的匹配和四条编号的共同出现。图面上的字母不是这个顺序,正文把早晨地点指到(c)、夜间地点指到(d)。这里按图面上的字母读。(a)四行条分别标成 PHONE、DAY2、DAY1、NIGHT,列是夜间、白天前半和白天后半。(b)九天的载客短条上,夜间、两段白天和早晨的空档被框出来。(c)地图把一处标成早晨交接。(d)地图把另一处标成夜间交接。来源:原论文 Fig. 9。
第三个案例找了一名几乎每天下午都停在作者所理解的公司的人。论文用“假定为男性”来称呼,依据没有单独给出。时间线和地图显示出两片区域之间的重复往返,作者把它读成从住处到工作地的通勤。绿色和洋红色的圈选同时带出可能的同住者或邻居,以及可能的同事。通话列被用来确认其中一名长时间和住处轨迹重叠的人,以及另一名长时间和工作地轨迹重叠的人。确认一词在这里指“图上同时看见通话和长时间重叠”,不是独立调查已经核实的亲属或雇佣关系。
第三片区域打乱了这个读法。作者起初看到早晨在那里走动、中午停留约一小时,猜测是购物和吃饭。再去看一起出现的人,多数却和前面的工作地重叠一致。查公交时,这片区域也不在住处到工作地的线路上。共同出现图显示他们在这片区域里一起活动近 2 小时,而且有人在第二个周一之前连续若干天也去。作者于是改猜那里是外勤地点,家人那天也去了。论文把这次改猜留在假设层。
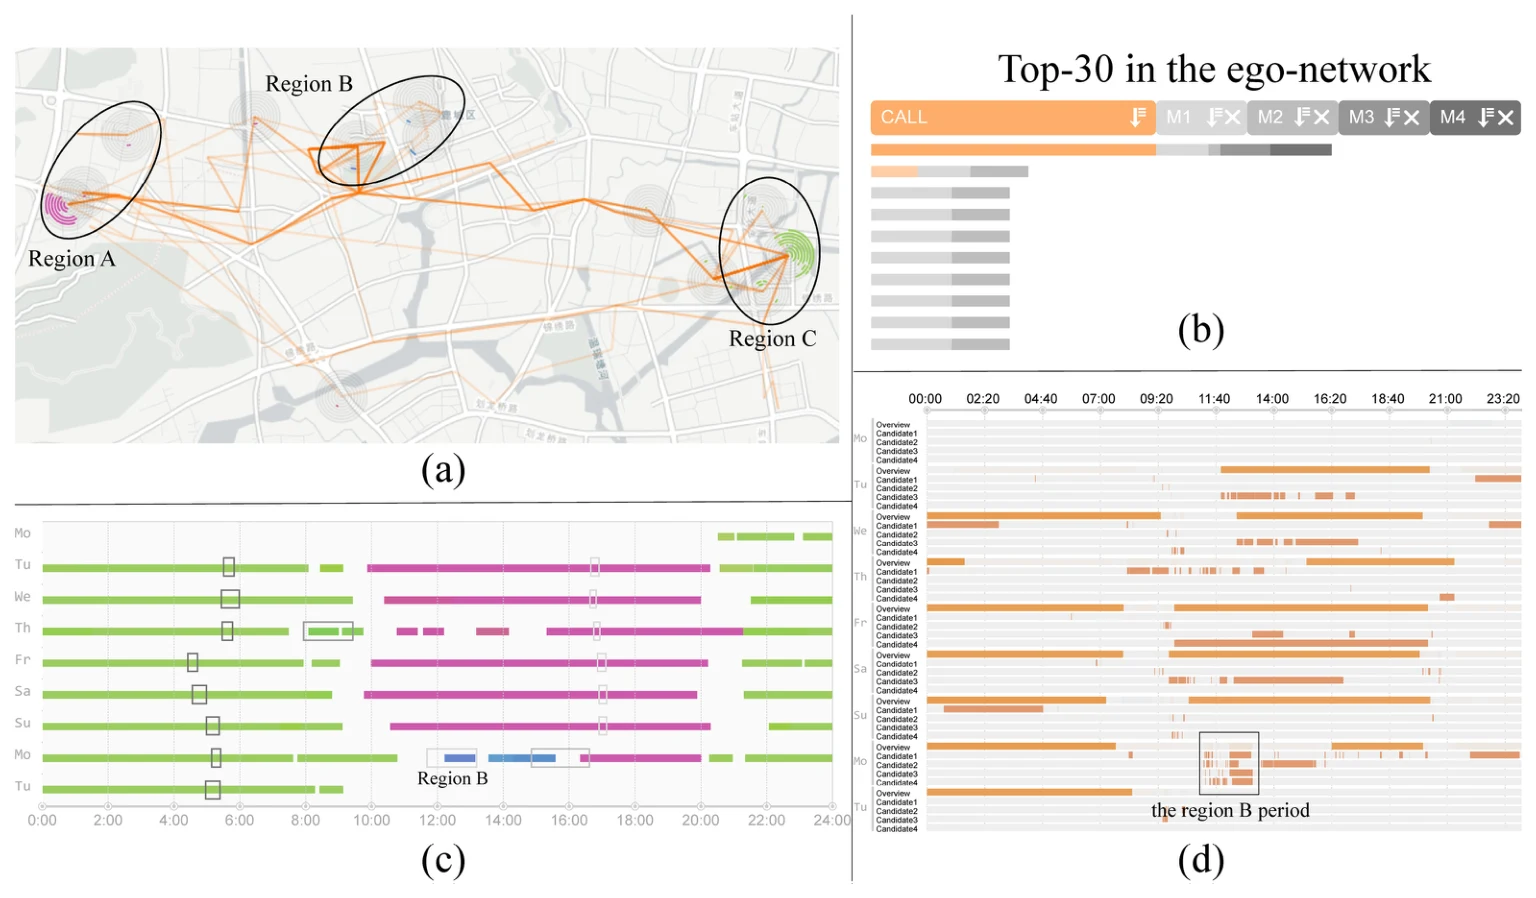
图 10|通勤轨迹上的第三片区域,为什么让购物这个读法站不住?
(a)地图上的三片区域和往返路线。(b)自我中心网络的前 30 人;橙色通话列只覆盖部分行,灰色 M1 到 M4 是其他约束。前 30 的分母仍是筛选后的列表。(c)九天时间线。正文说一片区域是浅蓝、另一片是粉色;印刷图的长条主要是绿色和洋红,和这组颜色词不一致。空心框是作者圈出的时段,细线被图注说成 Candidate4 的轨迹。(d)共同出现图把其中一段标成那片第三区域的时段,用来展示一起出现的人更像此前的工作地关系,而不是又一批家人。来源:原论文 Fig. 10。
秒数量的是查询,不是认人
6 亿条基站记录放在列式数据库 MonetDB 里。一个区域超过 100 万条就再拆成四张表,最后得到 74 张表,对应的四叉树编码头为 3 到 5 位。作者用 5 位区域盖住目标附近,以免一次查询跨很多表。列式库按整行取出一个人的一周轨迹要 3.3 秒,于是同样的数据又放进 MySQL:按编号查询可以在数十毫秒内返回。两台机器不一样。MonetDB 在一台 256 GB 内存、24 颗 Xeon E7540(2.00 GHz)的工作站上;MySQL 在一台 8 GB 内存、4 核 i7 4770(3.4 GHz)的台式机上。秒数差不能单独写成数据库种类的优劣。
点约束和轨迹约束走 MonetDB。表 1 是基站区间个数与平均查询时间:
| 基站区间个数 | 2 | 5 | 10 | 20 | 30 | 40 | 50 | 100 |
|---|---|---|---|---|---|---|---|---|
| 平均查询时间(秒) | 0.35 | 1.67 | 3.34 | 5.92 | 9.39 | 11.88 | 12.82 | 30.75 |
正文另写,取出含 20 个点的一条基站区间可以在 4 秒内完成。表中 10 个区间是 3.34 秒,20 个区间是 5.92 秒。4 秒和 5.92 秒对不上,论文没有解释差在“点”和“区间”哪一个口径。这些时间只说明交互查询是否等得起,不说明列出来的人是否真有社会关系。
两位从业者说了什么,没有测什么?
专家评审只有两人,都已从业数十年。一位是退休警员,以前负责查案;一位是公安局指挥中心主任,工作涉及视频监控。作者向他们演示了系统和三个案例。
第一位认为行为轨迹是警务里的主要数据,停留和活动范围可以用来组织同事、朋友、家人等不同关系,并把系统和公共安全业务结合起来看成说得通。第二位强调调查要找人和人、人和现场在时空上的交叉,并认为若能较快看到相关人员的关系网和活动轨迹,有助于提高调查效率、降低司法成本。论文用“强烈肯定”概括第二位的态度。
两人的话说明这种图和既有工作流程谈得上话。它们不是计时实验,也没有报告认错了多少人。系统能否缩短调查、会不会把陌生人留在前 30 名里,这篇论文没有测量。
哪些人会让这张图失效?
轨迹不完整,或者人几乎不移动,分析就缺少可重复的地点。常去地点稳定的人更容易被看图的人说出一种行为;没有稳定地点的人,看图者也说不出那段停留是什么。第三个案例里,住处和工作地之外的那片区域正因为缺少直接证据,才从购物改猜成外勤。作者写明,把关系推广到前 30 人时,共同出现图只能加强“看起来接近”,并在全部时段的约束下查看小群体。它不能把假设升成事实。
空间粒度变化时,论文认为只要先把轨迹放进选定层级的网格,别的轨迹数据也可以接进来。时间粒度则在重叠时长和段数之间切换。这两种适配都还是同一套重叠定义。换数据集不会自动带来正确率。
一句话总结
RelationLines 把一个人的停留、共同出现和通话画成可对照的线,用来提出并收紧关系假设;这些线没有测量谁和谁确实认识。
核心来源
Chen, W., Xia, J., Wang, X., Wang, Y., Chen, J., & Chang, L. (2018). RelationLines: Visual reasoning of egocentric relations from heterogeneous urban data. ACM Transactions on Intelligent Systems and Technology, 10(1), Article 2. https://doi.org/10.1145/3200766
Wei Chen,论文署名浙江大学 CAD&CG 国家重点实验室,论文邮箱为 chenwei@cad.zju.edu.cn。该室主页写明他是教授,研究方向为可视化与可视分析。
Jing Xia,论文署名浙江大学 CAD&CG 国家重点实验室和阿里巴巴集团,邮箱为 jing.xia@alibaba-inc.com。论文没有写更细的职务。
Xumeng Wang,论文署名浙江大学 CAD&CG 国家重点实验室。其个人主页收录本文,并标明 ACM TIST 2018;该页现在的单位是南开大学讲师。
Yi Wang 与 Jun Chen,论文只给出浙江大学 CAD&CG 国家重点实验室和两个公开邮箱。同名研究者很多,这里不借用其他主页上的头衔。
Liang Chang,通讯作者,论文署名桂林电子科技大学,邮箱 changl@guet.edu.cn。论文地址栏写作 Gulin, Guangzhou,与这所学校的通常所在地不一致,介绍只采用学校署名。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果按条长自动把第一名标成家人,留在出租车上的手机会很占优势,因为它昼夜都和车辆重叠。论文的出租车例子正是靠人眼把这种全天重叠从夜班司机里改读出来。排序本身没有这一步。另一周的通话被画在这一周的时间线旁边,两条线对齐了,两本日历没有对齐。商场和医院还会把只去过一次的人送进前 30 名。界面允许人继续加约束,但论文没有计数:加了第二、第三条约束之后,陌生人还剩多少。城市分析若只想看一类地点有没有重复的人群节奏,这套日历和地图够用;若想把某一行写成已经证实的社会关系,缺的是另一套独立核对,而不是更长的色条。