下班的地铁,为什么不能只按更近和机会更多来选?
论文名片|Shuyang Shi、Lin Wang、Shuangdie Xu、Xiaofan Wang,Prediction of Intra-Urban Human Mobility by Integrating Regional Functions and Trip Intentions,IEEE Transactions on Knowledge and Data Engineering,2022,34(10):4972–4981。DOI:10.1109/TKDE.2020.3047406。稿件 2020 年 2 月 27 日收到,11 月 12 日修回,12 月 17 日接收;2020 年 12 月 25 日在线发表,当前版本日期为 2022 年 9 月 12 日,刊于 2022 年 10 月号。通讯作者为 Lin Wang 与 Xiaofan Wang。
17 点从办公楼出来,人更可能去一个能停留、能见面的地方,而不是再进另一栋办公楼。走多远也有限制:太远的站就算机会多,也不如不远、选择又多的站。这是论文开头设想的场景,用来提出问题;文中没有某一个乘客的跟踪记录与之对应。
若只按介入机会来分,乘客会被分到行程时间更短、沿途机会更少的站,出行时间会变成越短人越多。上海地铁刷卡记录并不是这样。把车站按进出站的钟点分成办公、综合和居住,先用该小时的类别转移概率决定去哪一类,再让同一类里的站互相竞争,17–18 点的行程时间才会先升后降。
比较时,各站出发量和类别之间的转移概率都取自记录,模型只把这些已经出门的人分到具体车站。
先说结论
- 2016 年 9 月的 129,964,604 条地铁记录中,289 个站按工作日与周末、进站与出站、7 点到 22 点的份额分成三类:第 1 类办公、第 2 类综合、第 3 类居住。市中心大体是前两类,郊区多数是居住类,郊区也有少数办公或综合站。
- 工作日 8 点,不论从哪一类站出发,超过 60% 的行程结束在第 1 类。傍晚升高的是进入第 3 类的比例,进入第 1 类的比例下降。
- 聚类数为 1 时,模型退回不分功能的介入机会模型,17–18 点的行程时间单调下降。聚类数为 3 时,行程时间先升后降。经验行程时间被拟合为对数正态,μ=4.006、σ=0.3937,横轴单位是分钟;经验站间流量的幂律指数 γ=2.0329。
- 站间流量和出站人数的索伦森相似指数,上午与聚类数 1 很接近,午后和晚上才拉开。均方根误差则是聚类数 3、5、9 在每个小时都低于聚类数 1。再把类别加到 5 和 9,曲线形状几乎不变,准确度只略升。流量分布的形状大家都能贴近;行程时间的形状,聚类数 1 明显更差。
- 龙华站在三类划分下,从 2015 年 4 月的综合变为 2016 年 9 月的办公。18–19 点到达龙华的前 30 个来源站,两年名单重合 13 个,因而新进入前 30 的有 17 个。模型命中 2015 年实际前 30 中的 20 个、2016 年的 19 个。论文点出的 5 个新来源站,全月出发量从 175 万增到 220 万,前往龙华的平均次数从 7465 增到 42242。全体车站里,新进入前 30 的来源中,超过三分之一也被模型判中。
刷卡记下的是站与站的一小时,不是一个人的全天
数据来自上海开放数据应用(Shanghai Open Data Apps,SODA)提供的公共交通卡。这种卡可以坐地铁、公交、出租车和轮渡,但只有地铁记录同时有进站和出站。研究从中取出 2016 年 9 月的 129,964,604 条地铁行程。每条有卡号、站名和进出站时间;卡号被丢掉,因为要算的是站与站在各小时的流量,不是同一个人的轨迹。
当时上海地铁有 14 条线、289 个站。论文写,地铁承担了全市公共交通客流的将近一半,没有给出精确份额。地铁大约 5 点开、24 点停,各站开关门时间并不一致,所以只保留 7 点到 22 点出发的行程,共 15 个整点小时,记为 [7, 8) 直到 [21, 22)。车站周围的区域客流,用这个站的客流代表,后文说的区域 i 就是车站 i 周围。
分析单位是车站对在某一个钟点的客流,以及车站在该钟点的出站人数。它不能推出一个人全天去了几处,也不能代表没有刷这张卡的出行。
办公、综合和居住,是进出站曲线分出来的
功能来自进出站钟点的聚类,土地利用图和兴趣点没有进入这一步。每个站先做成一条 60 维曲线:工作日进站 15 小时、工作日出站 15 小时、周末进站 15 小时、周末出站 15 小时。某一个小时的份额,是该小时在相应日子里的客流之和,除以这 15 个小时的客流之和。四段各自加总为 1,再拼在一起做 K 均值聚类。工作日和周末因此进的是同一次聚类,一个站只有一个类别标签。
正文写,在这套数据上,K 均值在三种聚类评价指标上优于所比较的常见无监督算法。指标名称和分数在在线附录,正文没有列出。
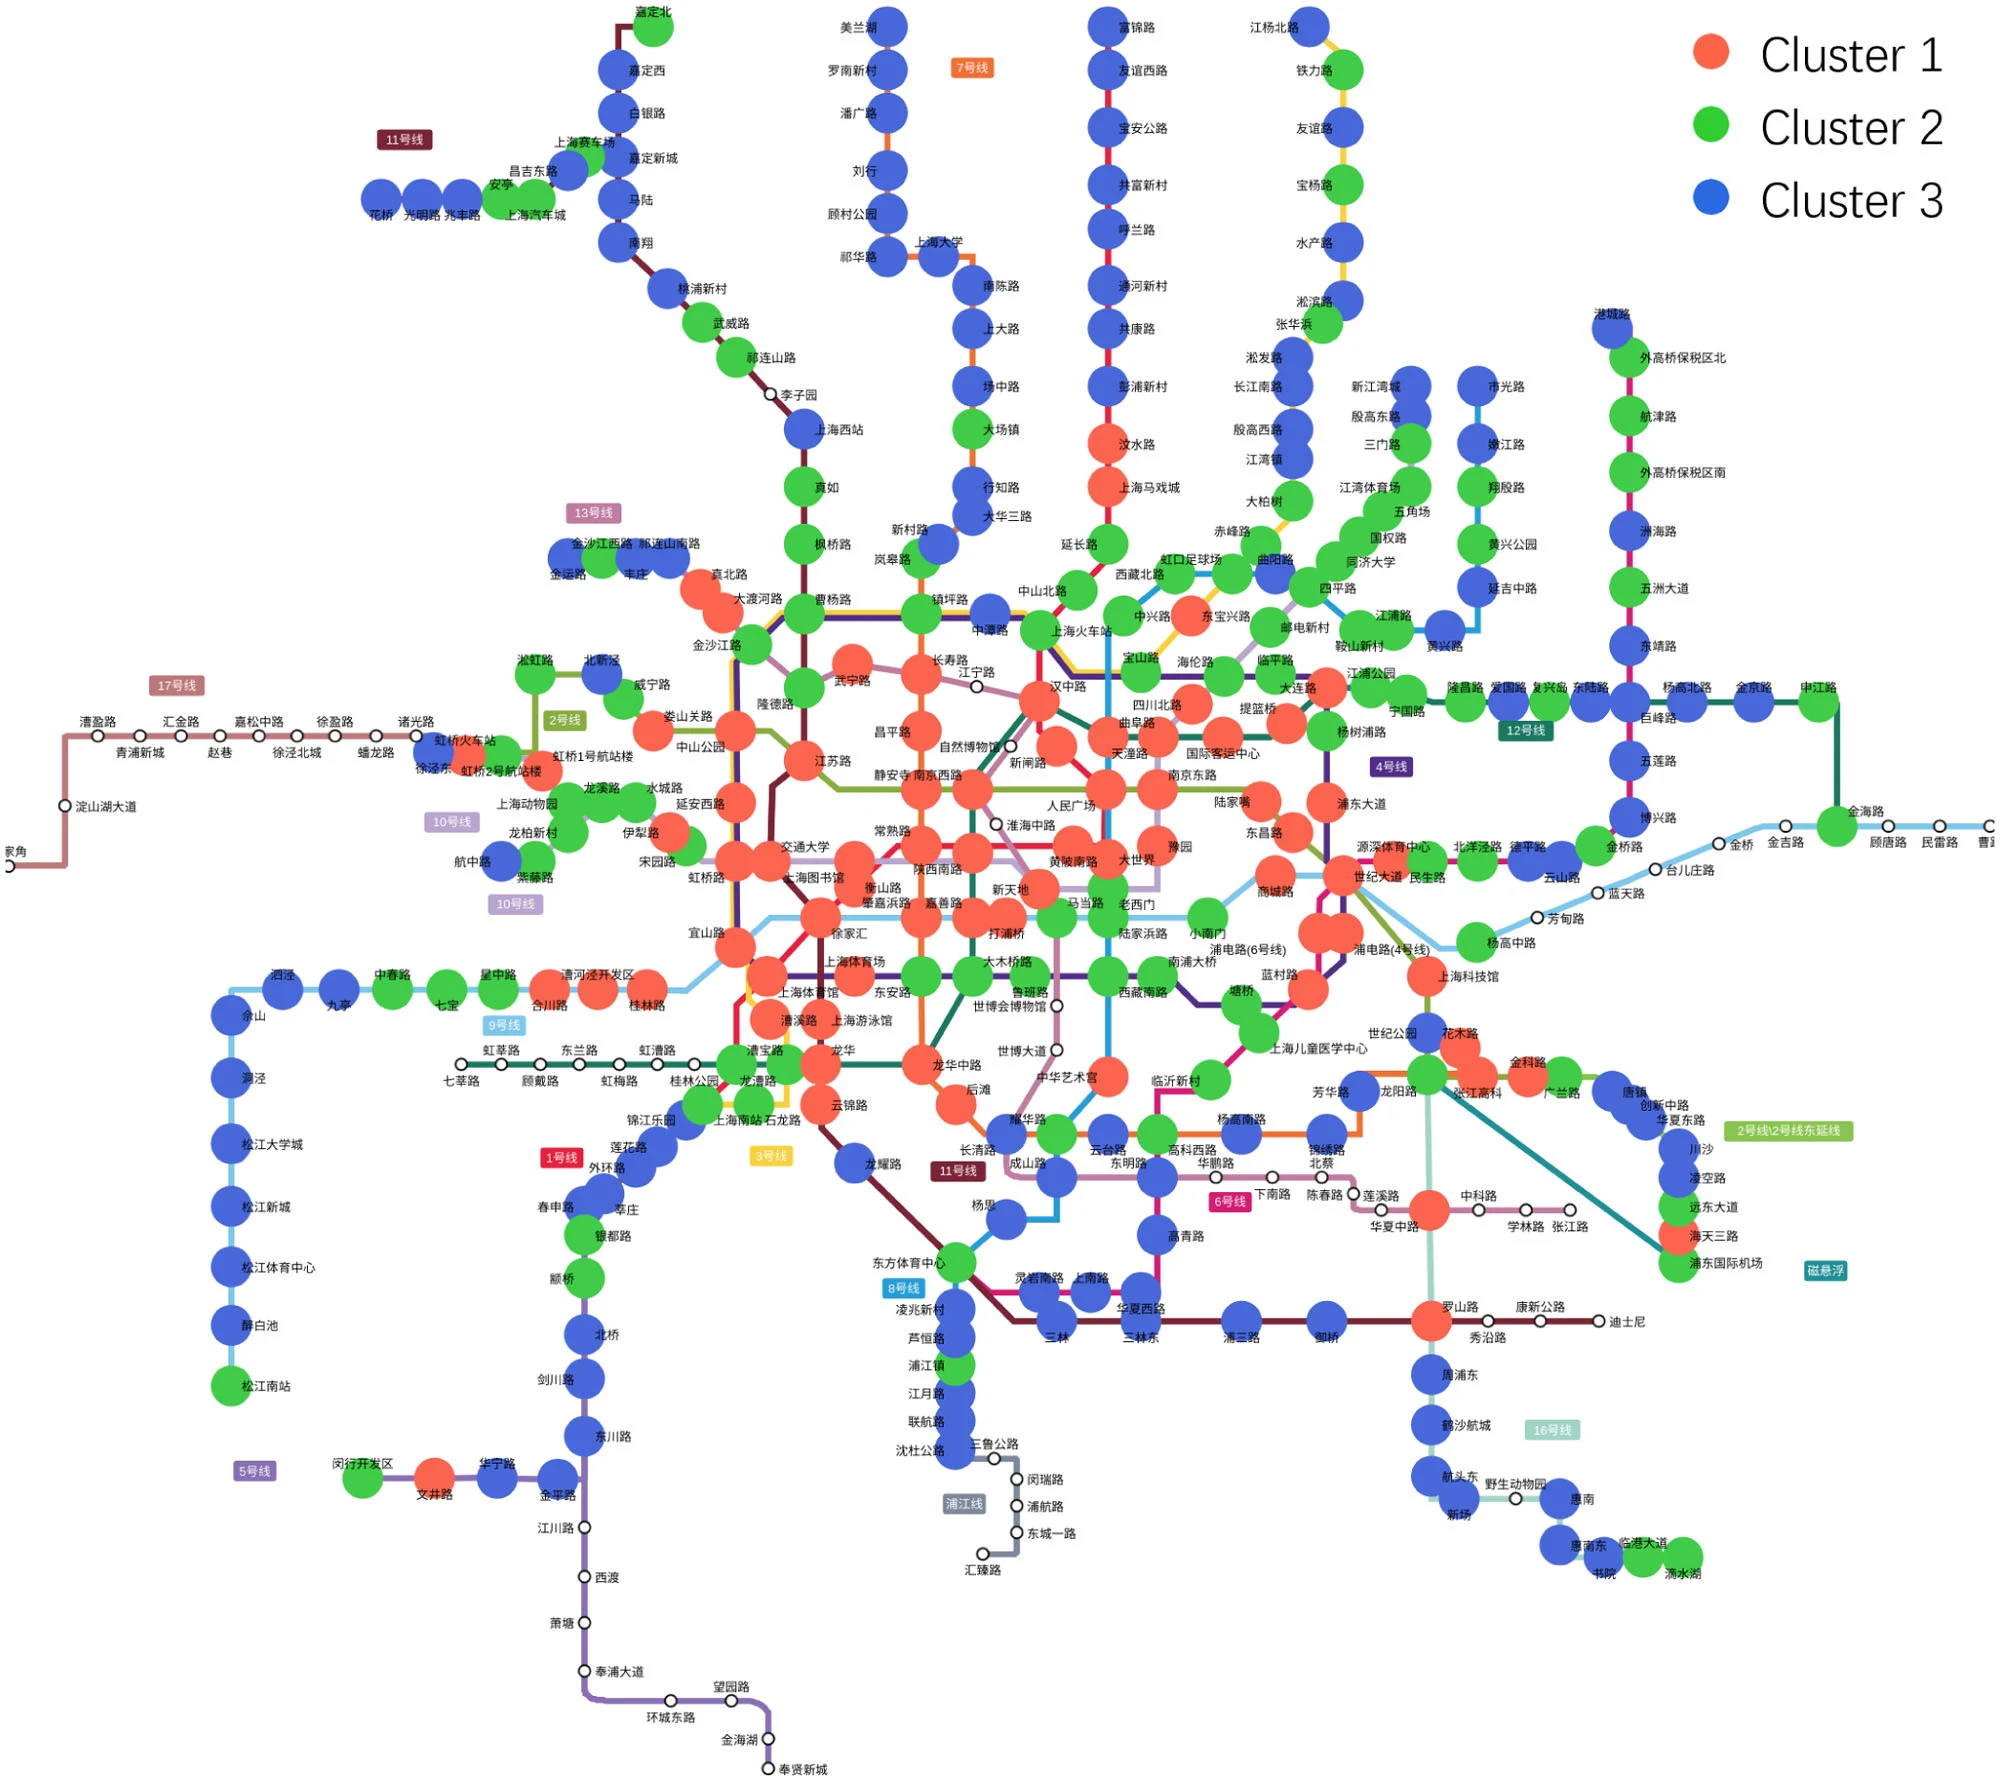
图 1|三类站在路上是怎么铺开的?
无字母子图。红、绿、蓝分别是聚类 1、2、3。红色办公站和绿色综合站集中在中心城区,蓝色居住站拉出各条郊区放射线;郊区线上仍有红点和绿点。未着色的新站不在研究范围内。图是简化地图,只部分反映真实位置。来源:原论文 Fig. 1。
聚类数为 3 时,论文把第 1 类称为办公,第 2 类称为综合,第 3 类称为居住。市中心大体被第 1、2 类覆盖,并大致落在中环以内。第 3 类多在郊区。郊区仍有第 1、2 类站,作者把它们解释成次中心,例如郊区政府机构和高新技术园区;正文没有逐站列出这些站的名称,也没有给出每一类各有多少站。
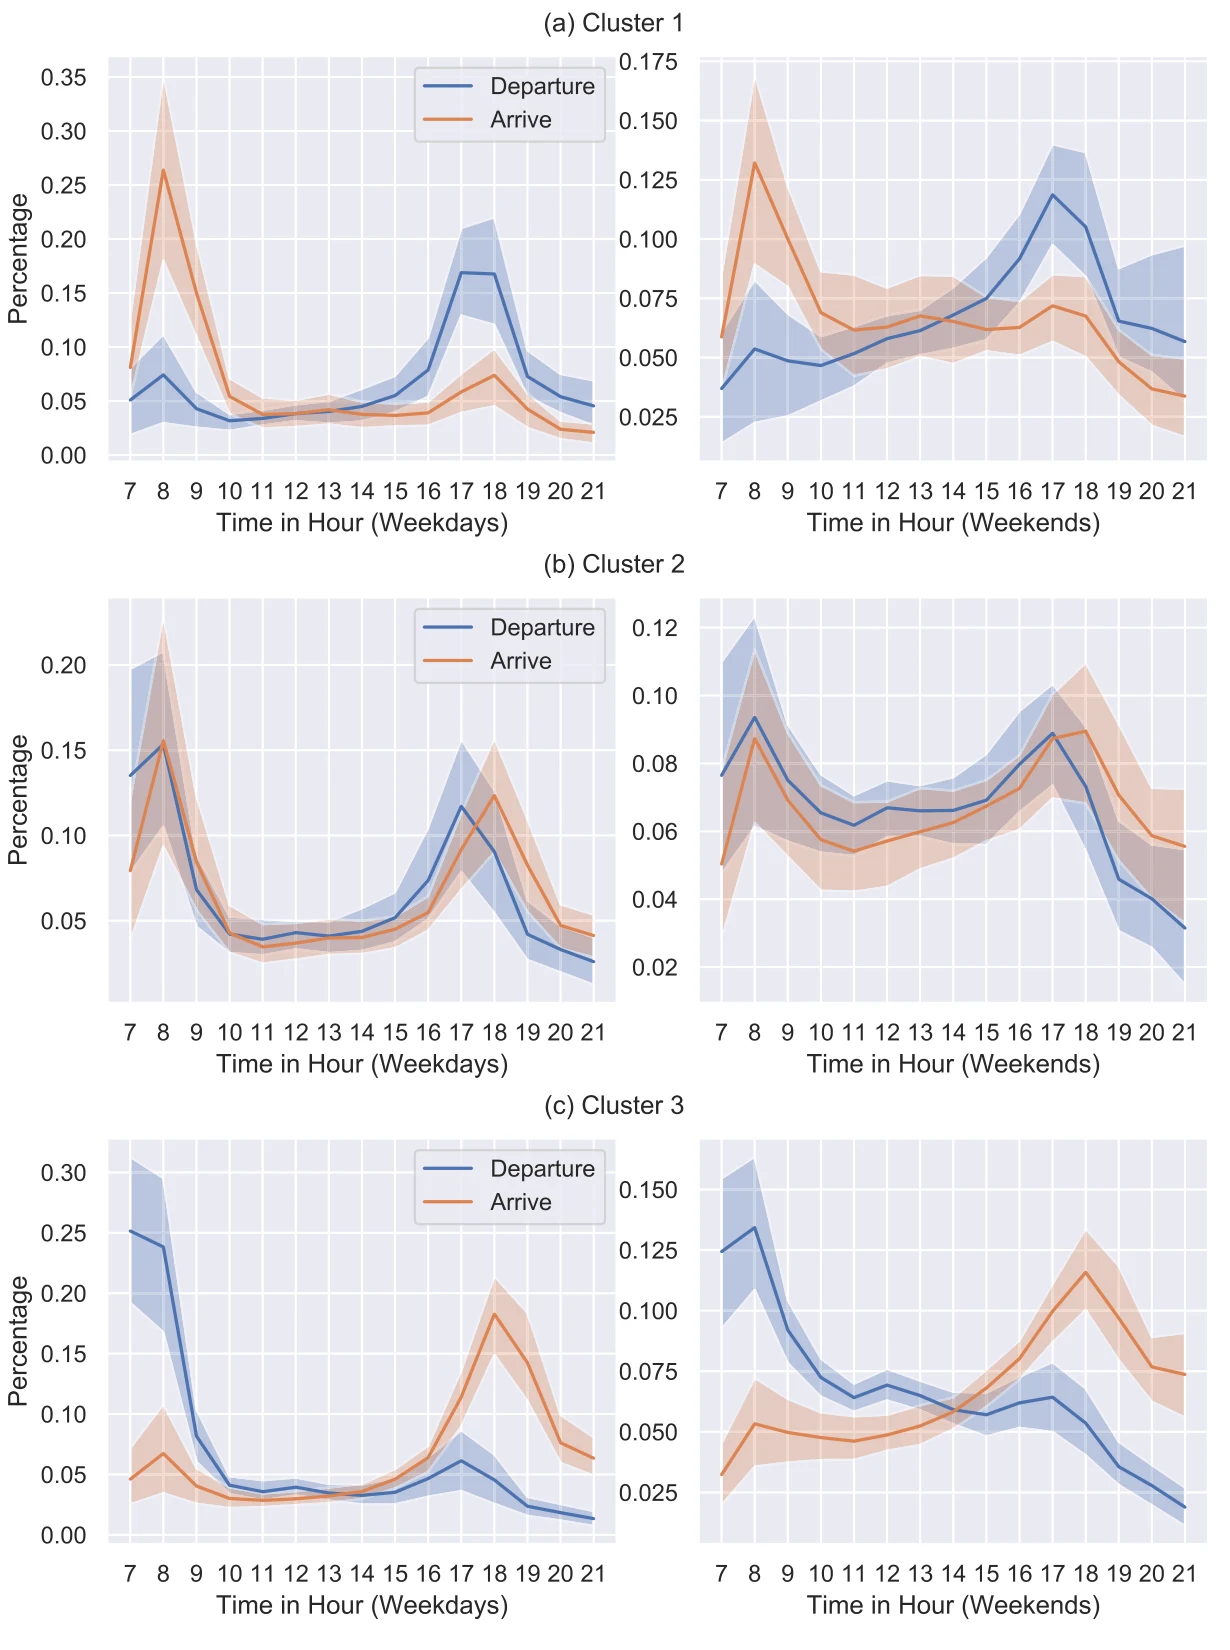
图 2|三类站的一天,进站和出站各在什么时候鼓起来?
纵轴是该类车站进出站份额的平均值,阴影是论文所称的 91% 置信区间。同一字母下左为工作日、右为周末,左右纵轴刻度不同,不能拿波峰的画图高度直接比较。蓝线是离开(进站乘车),橙线是到达(出站)。
(a)第 1 类办公。工作日到达在早晨鼓起,离开在傍晚鼓起;论文指出工作类到达的明显高峰在 8 点到 9 点。(b)第 2 类综合。工作日的离开和到达在早晨、傍晚都有一截,白天中间较低。(c)第 3 类居住。工作日离开集中在早晨,到达集中在傍晚;论文指出居住类出发的明显高峰在 7 点到 9 点。周末三张图的起伏都更缓。来源:原论文 Fig. 2。
这些标签描述的是进出站钟点,不是独立测量的土地用途。后面的预测又使用同一批刷卡记录,所以类别并不是从客流之外拿来的外部事实。
8 点去办公类,傍晚流回居住类
类别之间的转移概率,直接从刷卡记录按小时计算。它就是论文所说的城市昼夜节律,也是模型里代表出行意图的那一项。这里的意图,就是某一小时从一类站出发、结束在另一类站的比例。
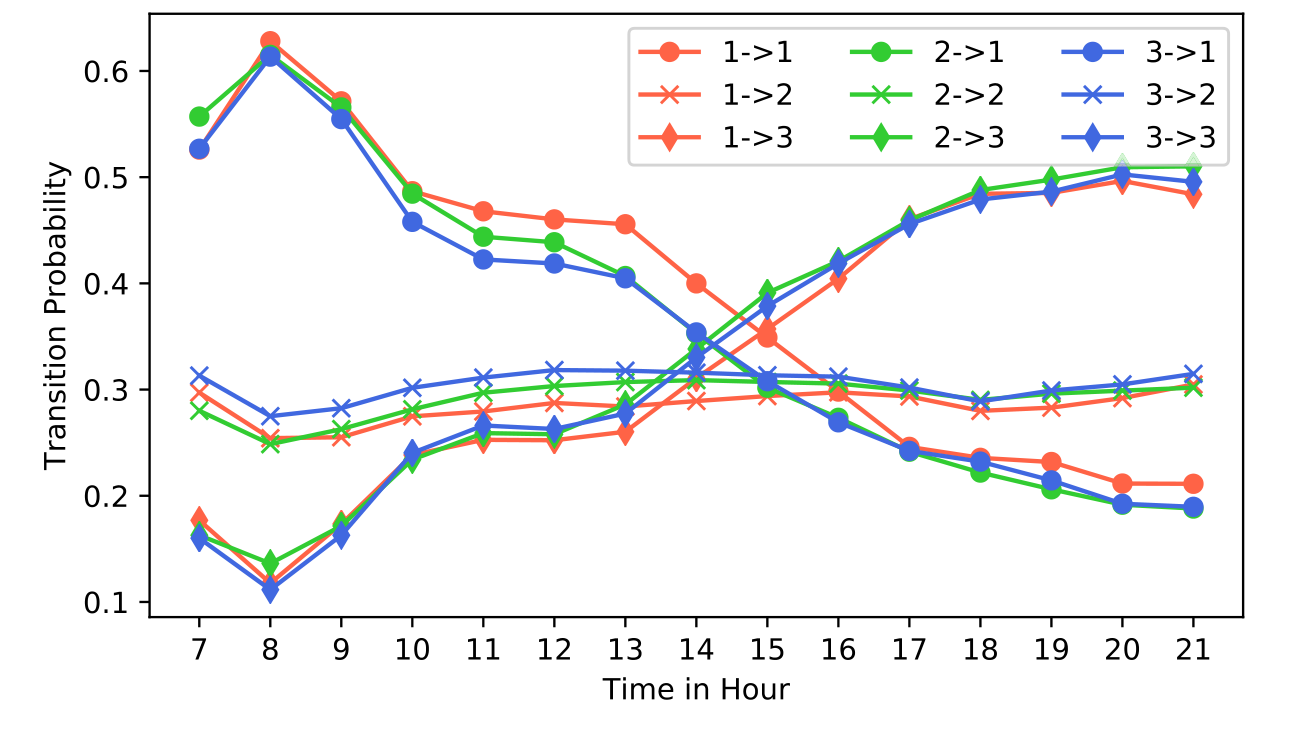
图 3|工作日每个小时,行程结束在哪一类?
无字母子图。九条线是三类起点到三类终点的比例,红、绿、蓝对应起点 1、2、3,圆点、叉和菱形对应终点 1、2、3。8 点时,三条进入第 1 类的线都高于 0.6,与正文“超过 60%,而且不因出发站而改变”一致。午后这三条下降,到晚上落到 0.2 附近。进入第 3 类的三条线早晨最低,傍晚升到 0.5 附近。进入第 2 类的比例全天多在 0.3 上下。图只画了工作日。来源:原论文 Fig. 3。
正文把午后的驱动力解释成休闲和游憩。图上傍晚最明显的变化,是进入居住类的比例上升、进入办公类的比例下降,综合类并没有变成主导终点。回家和去休闲场所,不能从这张转移图里分开。
同一类里才竞争,各站出发总量是给定的
介入机会的想法是:去某个地方的可能,随那里的机会变多,也随路程上已经遇到的机会变多而变小。本文把吸引力写成
A(j←i) 正比于 Oⱼ × rankᵢ(j) 的 α 次方,α=−0.84。
Oⱼ 是车站 j 的机会数,设为与该站全天客流成正比。rankᵢ(j) 是名次:在 j 所属的类别里,从 i 出发的平均行程时间不大于到 j 的站,有多少个。j 自己一定算进去,所以最近的站名次至少为 1;名次越大,j 越靠后。α 为负,靠后的站吸引力更低。这个 −0.84 来自既有研究对 34 个城市的拟合,不是用上海数据重新估计的。
正文有一句话,说名次是在从 i 到所有其他站的费用里排的。公式却把参与排名的站限制在 j 的类别里。下面按公式理解。
d(i, j) 不用直线距离,也不用线网上的最短路长度。换乘和列车速度差都会影响乘客,所以费用取站点对之间的经验平均行程时间,仍然来自这批刷卡记录。
某一小时从 i 到 j 的预测流量是
Tₜ(i→j) = Tₜ(i) × pₜ(i 的类别 → j 的类别) × A(j←i) / 该类别里各站吸引力之和。
Tₜ(i) 是 i 在这一小时的实际出发人数。pₜ 是图 3 那种类别转移概率,当作已知。分母只加 j 所属类别里的站:论文规定,不同功能的站之间不做这种机会竞争。机会数的比例系数在同类内部相除时消掉。若各类转移概率加总为 1,各站预测流量加总就等于该站实际出发量。模型分配的是去向,不是这一小时有多少人出门。
聚类数为 1 时,全城只有一类,转移概率不再提供信息,模型退回普通的介入机会模型。论文还计算了聚类数 3、5 和 9。选 9,是因为既有研究把出行目的分成 6 类、把区域功能分成 8 类,9 已经足够细。K≥3 的结果彼此相似,图 4 因此只把 K=1 和 K=3 摆在一起,例子是工作日 17 点到 18 点出发的行程。
不分功能时,行程时间会变成越短人越多
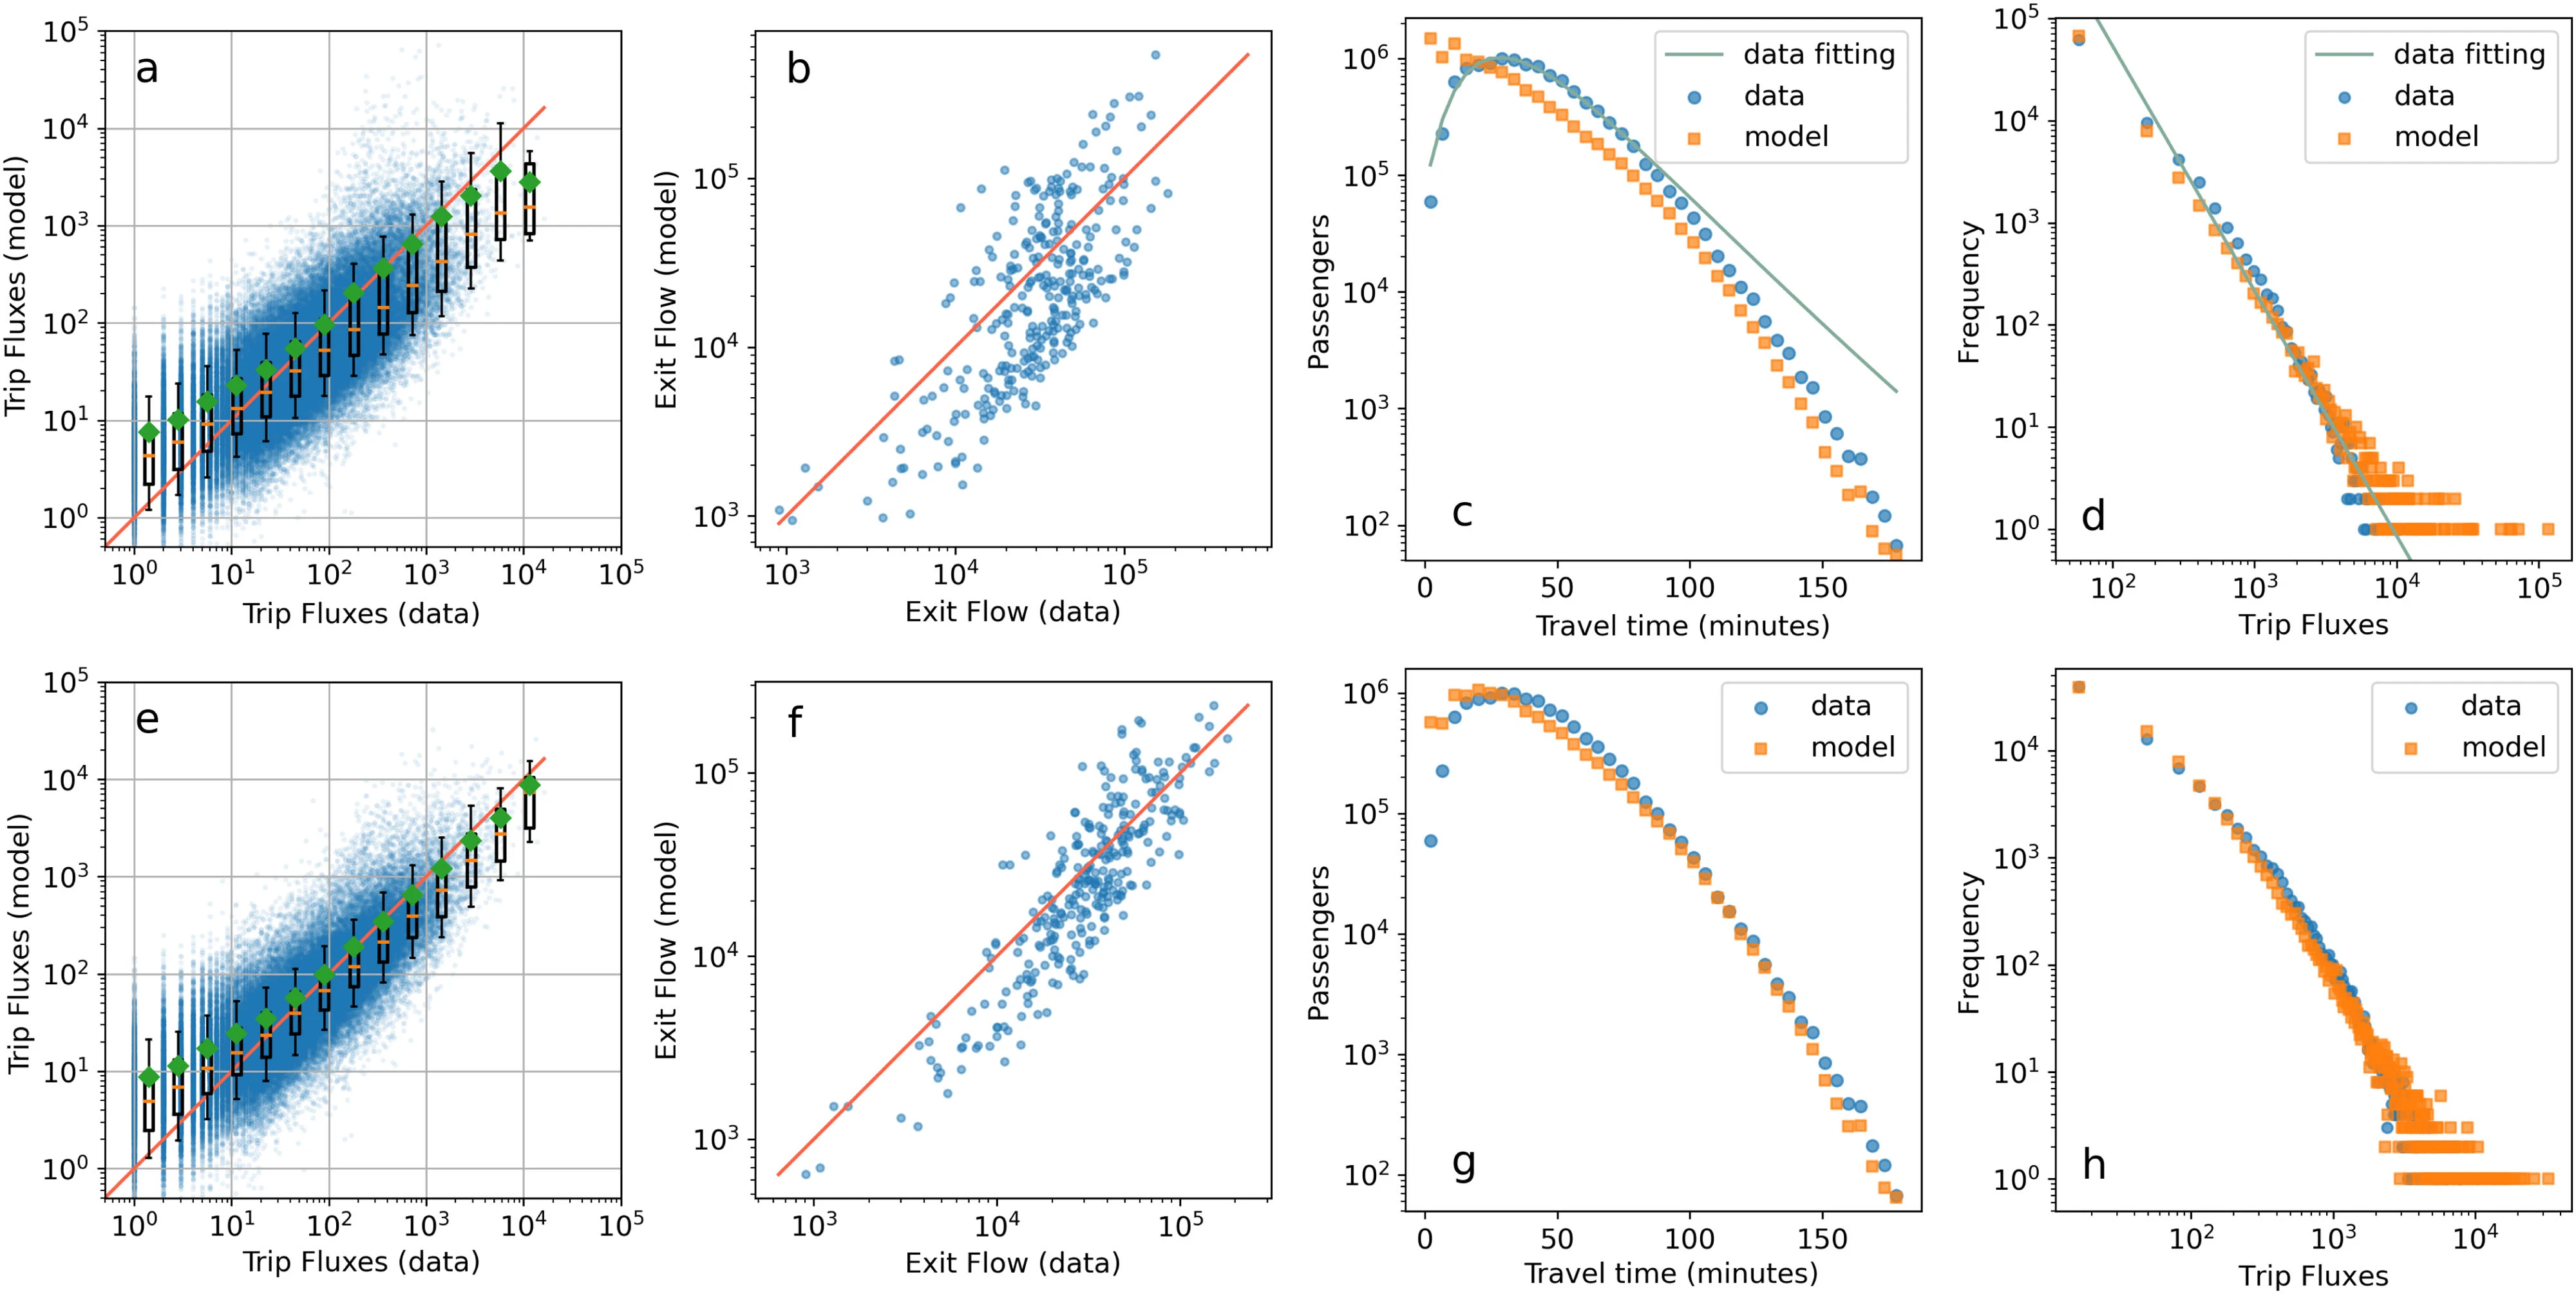
图 4|不分功能,和分成三类,17–18 点各对得上哪一部分?
上排聚类数为 1,下排为 3。蓝点是站对或车站,红线是斜率为 1 的参照线。箱线的绿点是该流量档里预测人数的均值,须线是第 9 和第 91 百分位。
(a、e)预测站间流量对实际站间流量。(a)的箱线更宽,大流量档的均值也更容易偏离红线;(e)的均值贴着红线,须线更短。正文指出,分了功能之后,剩下的偏差主要落在流量较小的站对上。(b、f)各站出站人数,红线仍是 y=x;(f)比(b)更贴线。(c、g)行程时间分布,横轴单位是分钟。绿色 data fitting 曲线是对经验数据的对数正态拟合,参数为 μ=4.006、σ=0.3937,标在(c)。橙点是模型。(c)里模型从最短的时间档单调下降,经验数据却先升后降;(g)里模型跟着这个峰走。论文把 K=1 的形状称为近似指数分布。(d、h)站间流量的频数分布,经验分布的幂律指数 γ=2.0329,标在(d)。两行都能走出一条重尾;流量分布的形状在 K=1 和 K=3 下都接近经验数据。来源:原论文 Fig. 4。
K=1 会偏向行程时间更短的站,因为规则里只有机会和费用。K=3 先接受“这一小时要去的那一类可能整体都比较远”,行程时间就可以出现一个峰。这仍是同一批 17–18 点记录上的分配结果,不是留出另一天再做的预报。
上午的相似指数几乎不涨,绝对误差则全天都更低
定量比较用三个指标,工作日和周末都算,聚类数取 1、3、5、9。
索伦森相似指数(Sørensen similarity index,SSI)看的是相对差别。站间流量的 SSI,是对全部 289×289 个有序站对,计算 2×min(实际, 预测)/(实际+预测),再取平均。出站人数的 SSI 同样计算,只是对 289 个站平均。指数在 0 和 1 之间,1 表示两列数完全一致。作者用一个数字例子说明它和绝对误差的差别:一对站实际 1 人、预测 50 人,另一对实际 2000 人、预测 2400 人。按比例,后者更可接受;按地铁负荷,前者的 49 人误差轻得多。这是说明指标的例子,不是上海某一对站的实测。
出站人数的均方根误差,是 289 个站上(实际−预测)平方的平均再开方,越小越接近。站间流量的印刷公式却把括号写成了(实际+预测)的平方,再对 289² 个站对平均后开方。两条定义并不一致。图 5 仍把流量误差画成 K=1 全天更高。正文没有另给一张按差值重算的表,所以下面只比较各条线谁高谁低,不把流量误差的刻度当成常见的均方根误差。
赫林格系数(Hellinger coefficient)是两个离散分布对应格子上 √(p q) 的和。论文用它表示分布有多像:越接近 1 越像,并用来比较行程时间分布和站间流量分布。
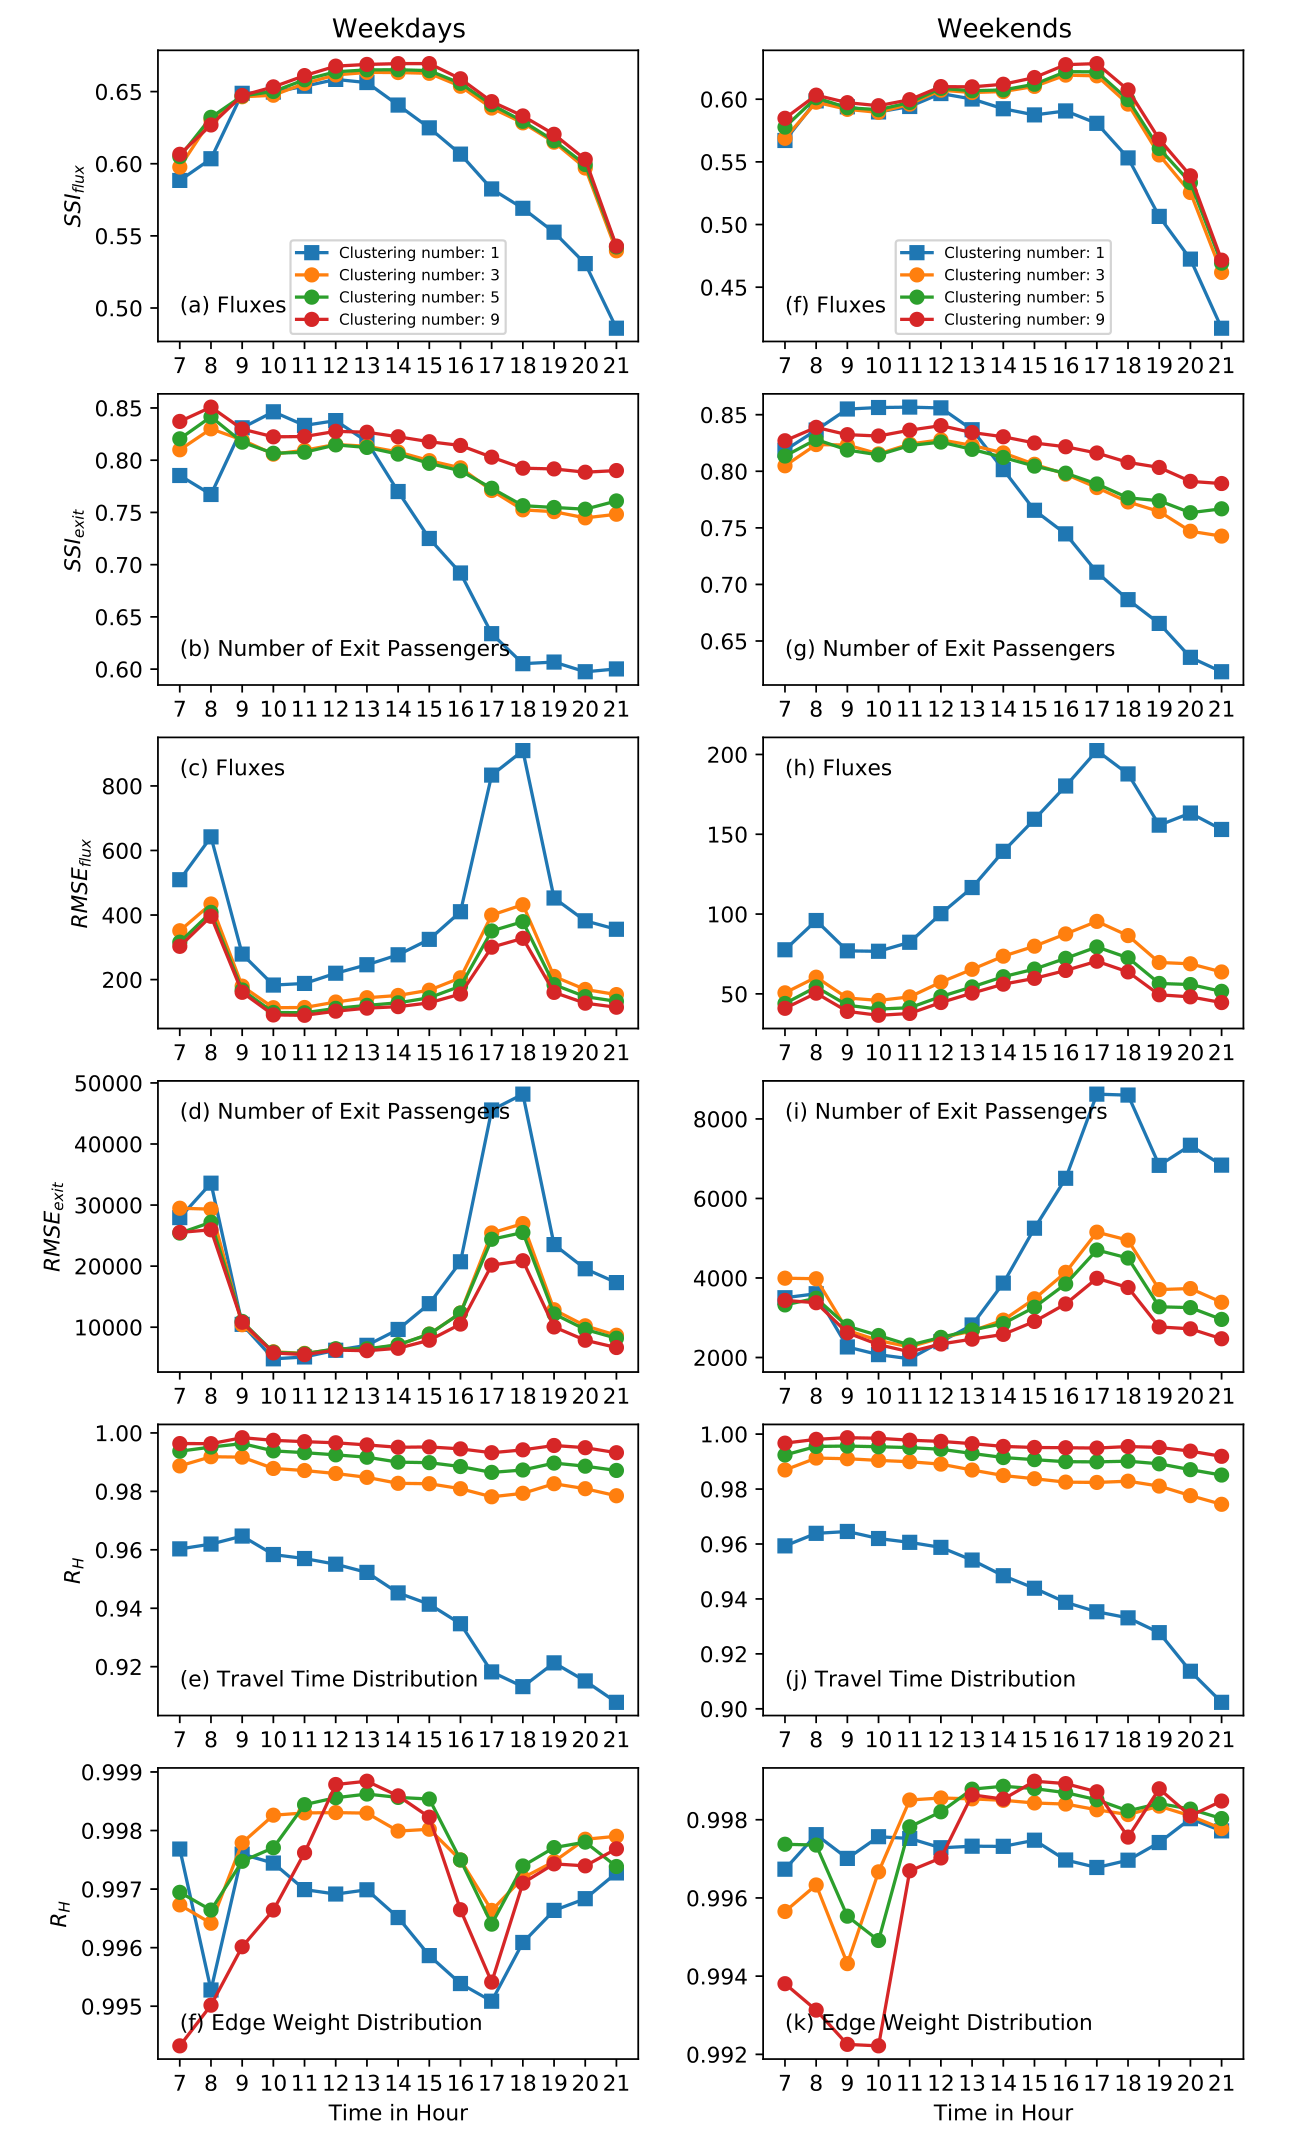
图 5|分成 3、5、9 类之后,哪些小时、哪些指标真的更好?
蓝、橙、绿、红是聚类数 1、3、5、9。左列工作日,右列周末,两列纵轴刻度不同,不能把高度直接相减。周末流量 SSI 也标成(f),与左列底部的流量分布赫林格系数字母重复;图注同样把(f)写进了两类指标。下面按图中的位置读。
(a)工作日站间流量 SSI。上午四条线都在 0.60 附近;午后 K=1 下滑,21 点落到 0.50 下方,另外三条仍高于它,日间高点超过 0.65。(b)工作日出站 SSI。K=1 傍晚降到 0.60 附近,K≥3 仍在 0.75 上方。(c)工作日流量误差。K=1 全天更高,17–18 点冲到纵轴上端;另外三条午后有一截隆起,但低得多。(d)工作日出站误差。K=1 在傍晚再次大幅高于另外三条。(e)工作日行程时间的赫林格系数。K≥3 保持在 0.98 上方;K=1 从 0.96 附近降到 0.92 下方。(f,左下)工作日流量分布的赫林格系数,四条线都挤在 0.995 到 0.999。(f,右上)周末站间流量 SSI,K=1 的落后主要出现在傍晚。(g)周末出站 SSI,K=1 午后下降,K≥3 保持在更高处。(h)周末流量误差,K=1 全天更高;纵轴只到 200 出头,与(c)的刻度不同。(i)周末出站误差,傍晚仍是 K=1 更高,纵轴与(d)不同。(j)周末行程时间的赫林格系数,K=1 降到 0.90 附近,K≥3 贴近 1。(k)周末流量分布的赫林格系数,四条线都在 0.992 到 1 之间。来源:原论文 Fig. 5。
正文有一处把图 5e 到 5k 都说成赫林格系数接近 1。图上(g)(h)(i)是周末的 SSI 和误差,不是分布相似度。真正的分布比较是(e)、左下(f)、(j)、(k)。流量分布的重尾,K=1 也能贴近;行程时间分布则随功能信息明显改善,而且越到晚上,K=1 越差。
绝对误差上,K≥3 在每个小时都低于 K=1。相对指数上,上午几乎分不出功能模型和好坏,差距出现在午后和晚上。K=3、5、9 的曲线缠在一起。正文的判断是:类别数达到 3 以后,准确度只随类别数略增;K=3 已经同时有清楚的功能含义和足够的准确度。作者还提到一项出租车研究:非负矩阵分解要得到稳定结果,基的个数也是 3,分别对应家与工作地、工作地与工作地,以及其他活动。那是被引用的既有结果,不是这套地铁数据重新分解出来的。
为什么早上补上功能也帮不大?论文的解释是,早晨和夜间的终点往往是固定的工作地和家。找工作首先看的是收入,不是行程费用;晚上要回的是自己的家,不是别人家里机会更多的那一站。这两件事都在模型的竞争规则之外。
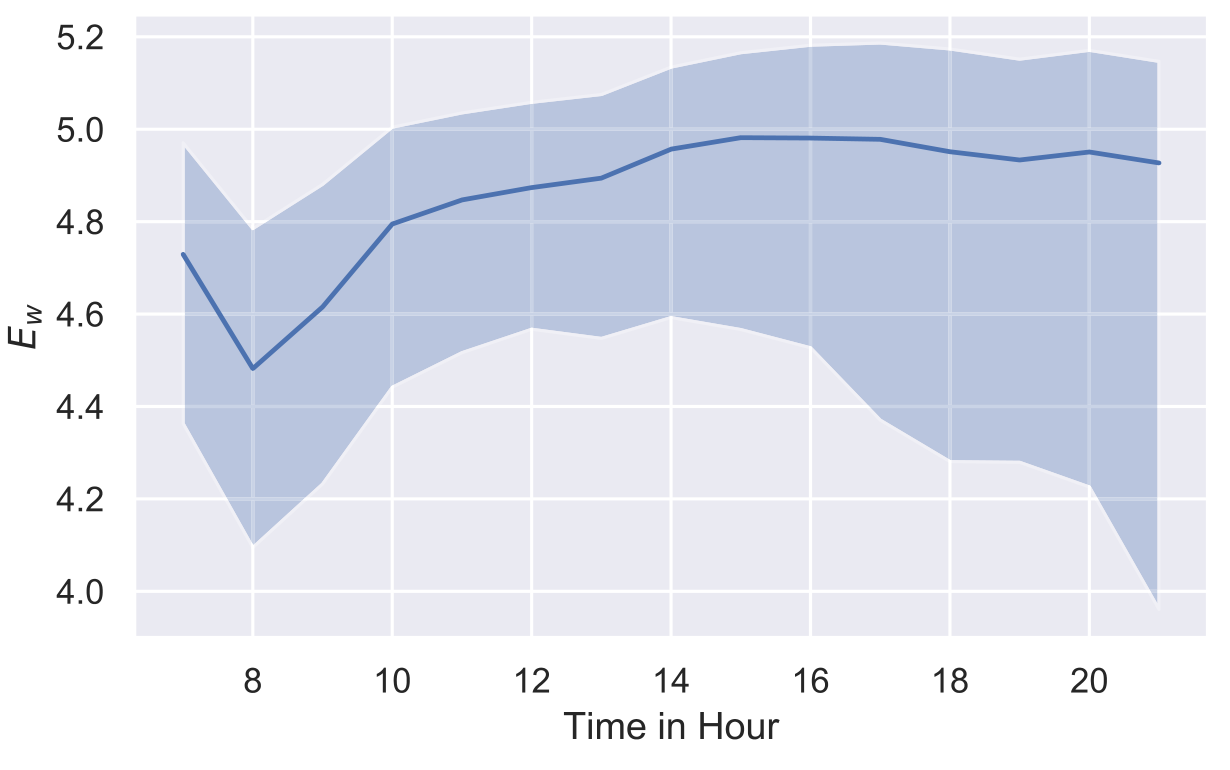
图 6|午后的目的地,是不是比早高峰更分散?
无字母子图,只画工作日。某个站在某一小时的熵,是 −Σ p log p;p 是从该站出发、到达各站的实际比例。曲线是按各站出发人数加权的平均熵,阴影是论文所称的 91% 置信区间。对数的底正文没有写明。8 点的曲线落在 4.4 与 4.6 之间,是全天最低;14 点以后升到 5.0 下方并保持到晚上。阴影在 18 点以后仍很宽,上沿接近 5.2,下沿降到 4.2 附近,并在 21 点继续向下。站与站的差别大于这条平均曲线的升降。来源:原论文 Fig. 6。
熵高只表示目的地更分散。作者据此认为,午后人们更有机会按自己的意愿出行,同类车站之间的竞争才重要。这是对熵的解释。图 6 没有记录出行目的,也不能说明每一个站的选择集都变大了。
龙华从综合改成办公,前 30 个来源站换了 17 个
功能如果变了,来源站会不会跟着变?论文另取 2015 年 4 月的公共交通卡,与 2016 年 9 月对比。两个月的地铁网络拓扑相同。多数功能变化发生在郊区,作者认为那里线网简单,对实际流量影响不大。例外是靠近中心的龙华站;论文写,研究时段内龙华站附近有改造工程。K=3 时,它的标签从第 2 类综合变为第 1 类办公。
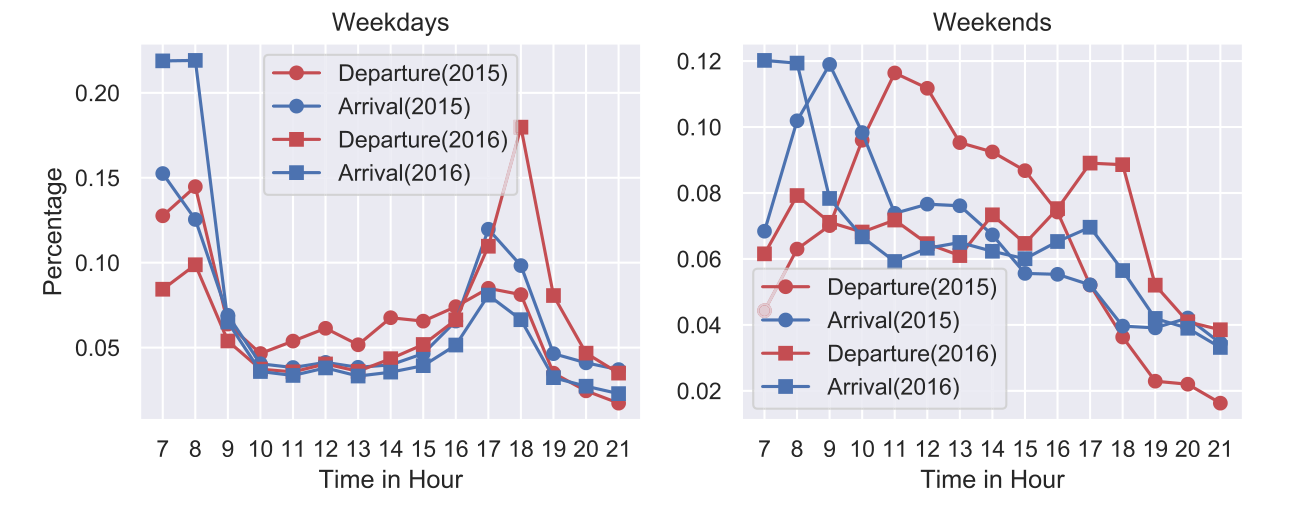
图 7|龙华站自己的进出站曲线,两年差在哪里?
无字母子图。左为工作日,右为周末;周末纵轴只到 0.12 左右,工作日超过 0.20,两幅图的波峰高度不能直接比。圆点是 2015 年 4 月,方点是 2016 年 9 月;红是离开,蓝是到达。2016 年工作日更清楚:早晨到达高、傍晚离开高。2015 年工作日的早晨到达也高,但早晨的离开同时抬起,傍晚离开仍有尖峰。聚类把前一种标成办公、后一种标成综合。周末曲线更碎,不能单独看出同一个标签变化。来源:原论文 Fig. 7。
比较来源站时,取的是 18–19 点、终点为龙华的客流。两年各自按出发人数列出前 30 个站,称为主要来源站。两年的前 30 名里只有 13 个站重复,所以 2016 年新进入这份名单的有 30−13=17 个。
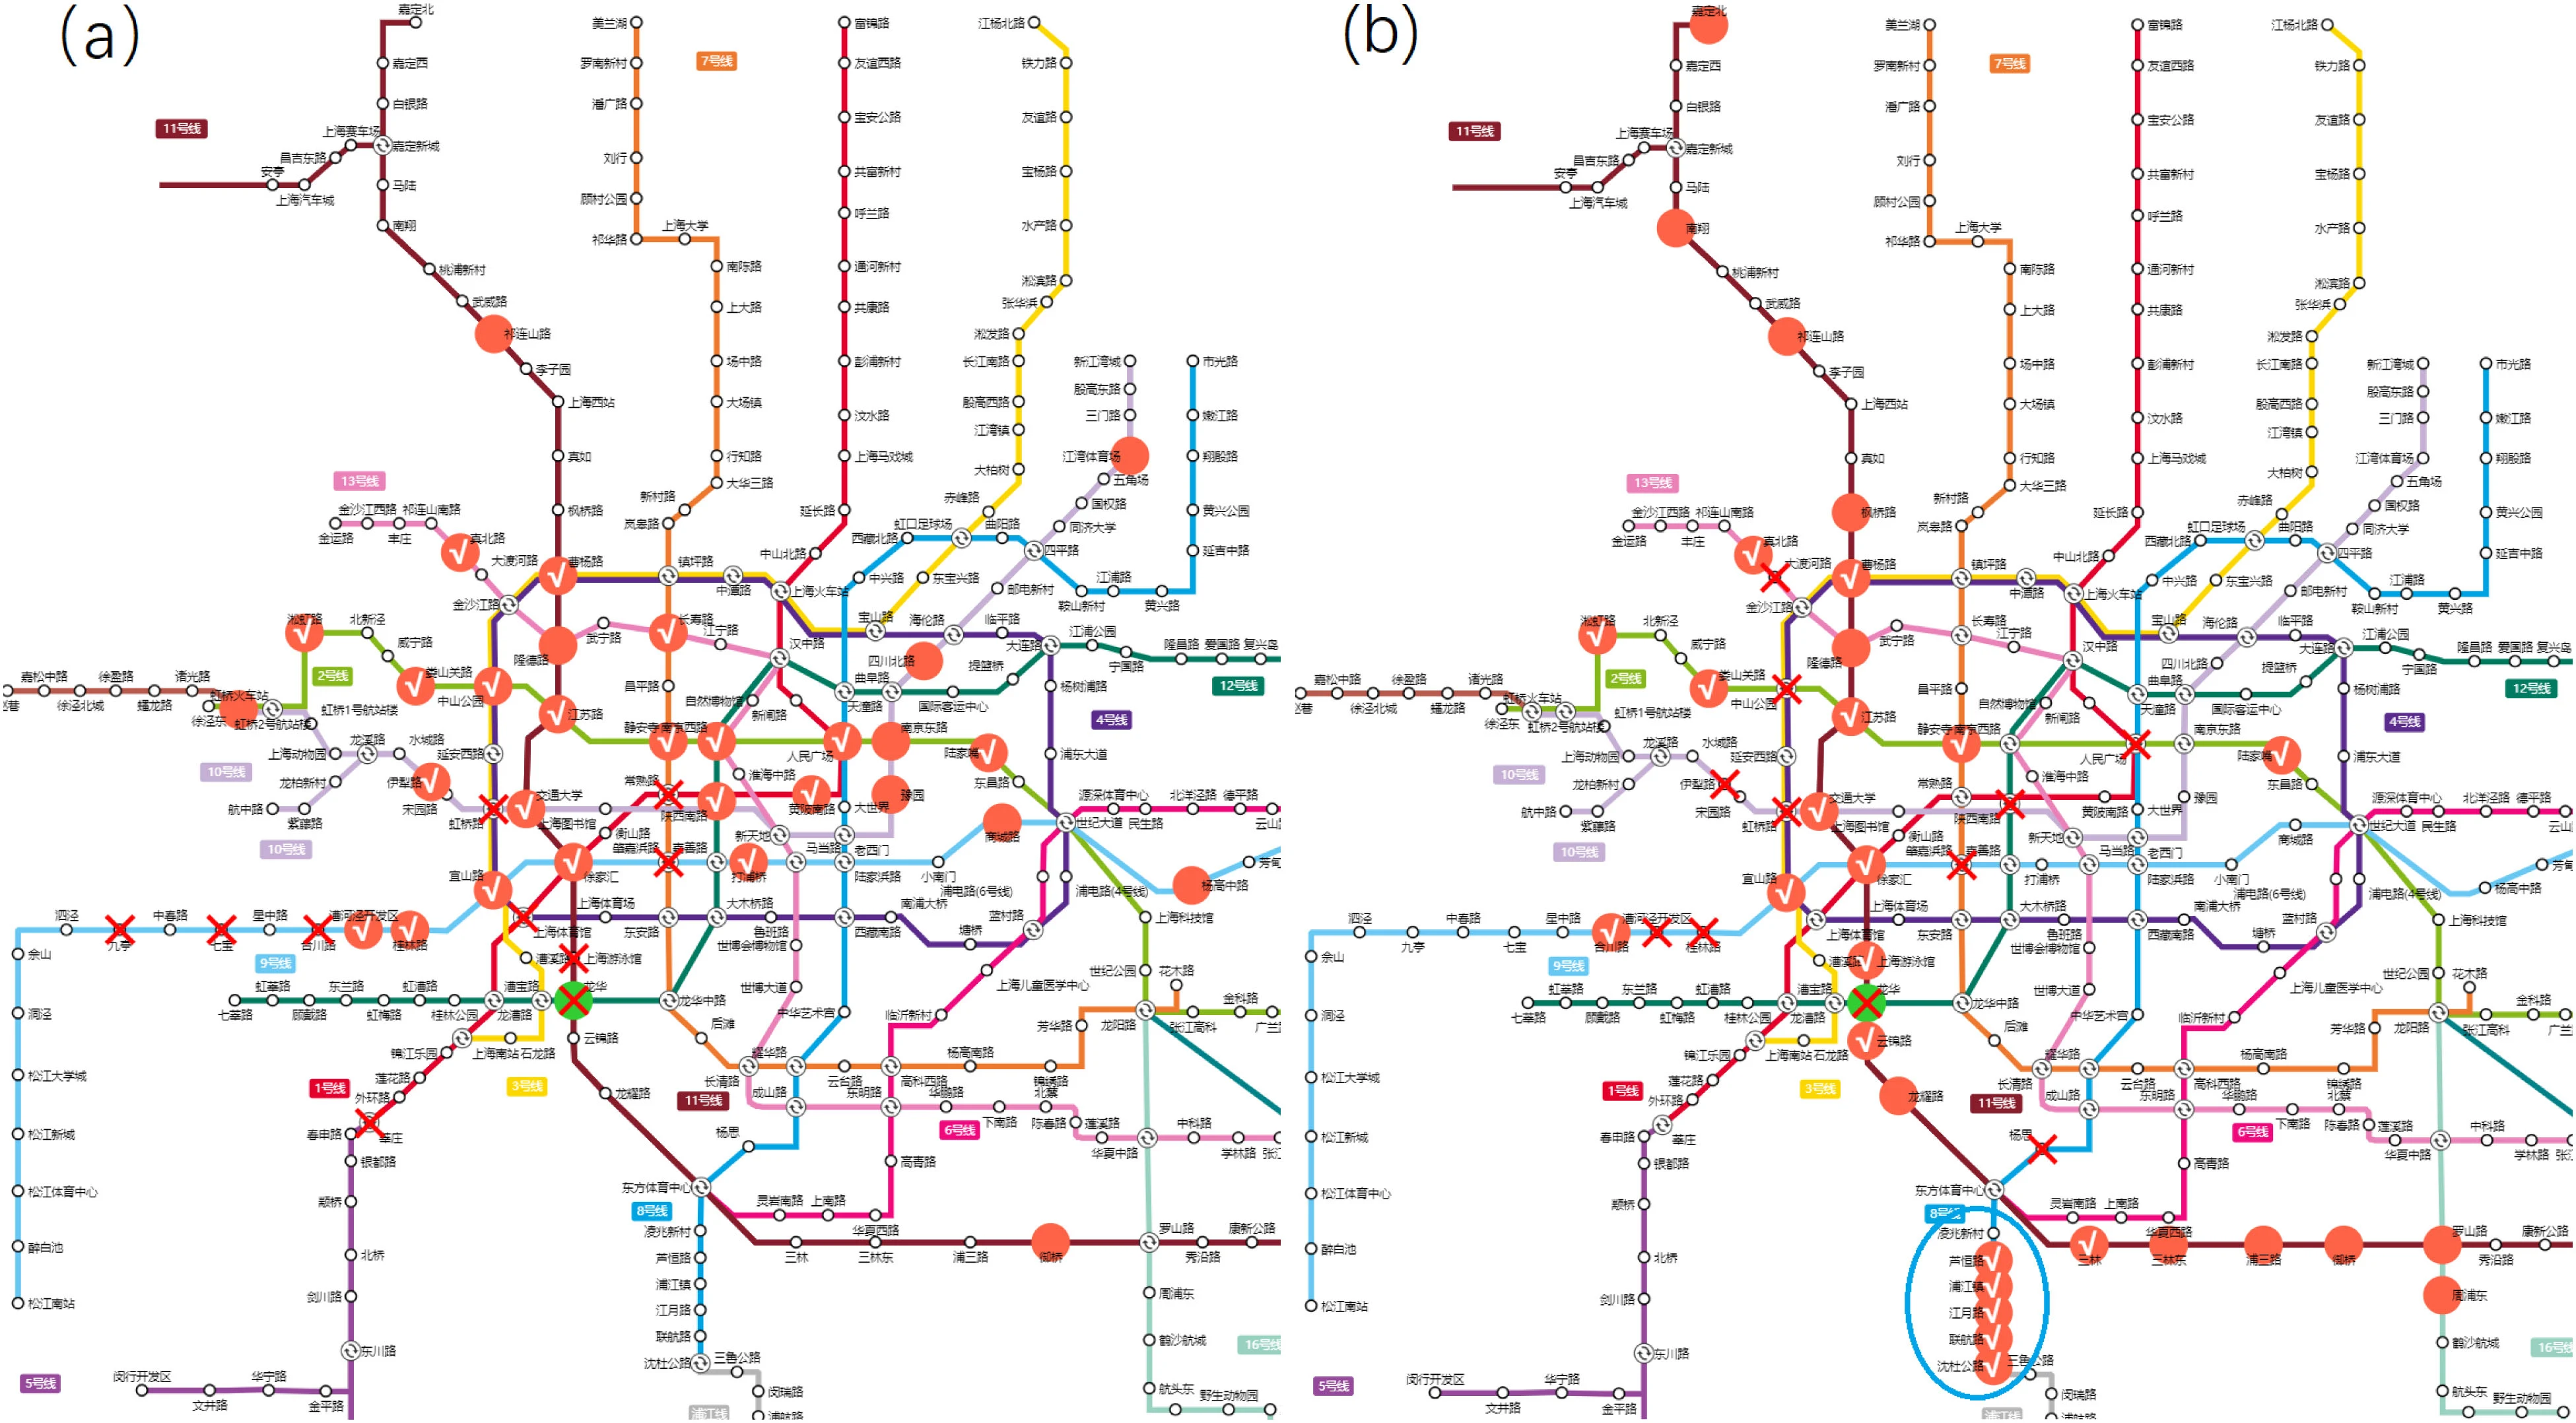
图 8|龙华的前 30 个来源站,模型抓住了哪些?
(a)2015 年 4 月。(b)2016 年 9 月。绿色圆点是龙华。橙色圆点是实际的主要来源站;白色勾表示模型也把它放进前 30,红色叉表示没有。模型命中 2015 年 30 个里的 20 个、2016 年 30 个里的 19 个。(b)南部的蓝圈是论文标出的 5 个新来源站,模型把这 5 个变化都算了进去。来源:原论文 Fig. 8。
这 5 个站的全月出发总量从 175 万增到 220 万,是 220/175=1.26 倍。论文给出的、它们前往龙华的平均次数从 7465 增到 42242,是 42242/7465≈5.66 倍。前 30 名的划分用的是 18–19 点;175 万、220 万、7465 和 42242 是正文写出的全月数字。出发总量只略增,去龙华的次数却增到原先的五倍多。作者认为,这不是起点变忙就能解释的,而应归到龙华的功能变化,并认为模型反映了这个变化。
这里的“预测”仍然用各自月份的出发量、类别转移概率和全天客流。龙华换了标签之后,它进入另一套转移概率,也换了一批同类竞争者。模型能够改口,是因为输入里的功能标签变了,不是把 2015 年 4 月的参数冻结后,直接报出 2016 年 9 月的地图。
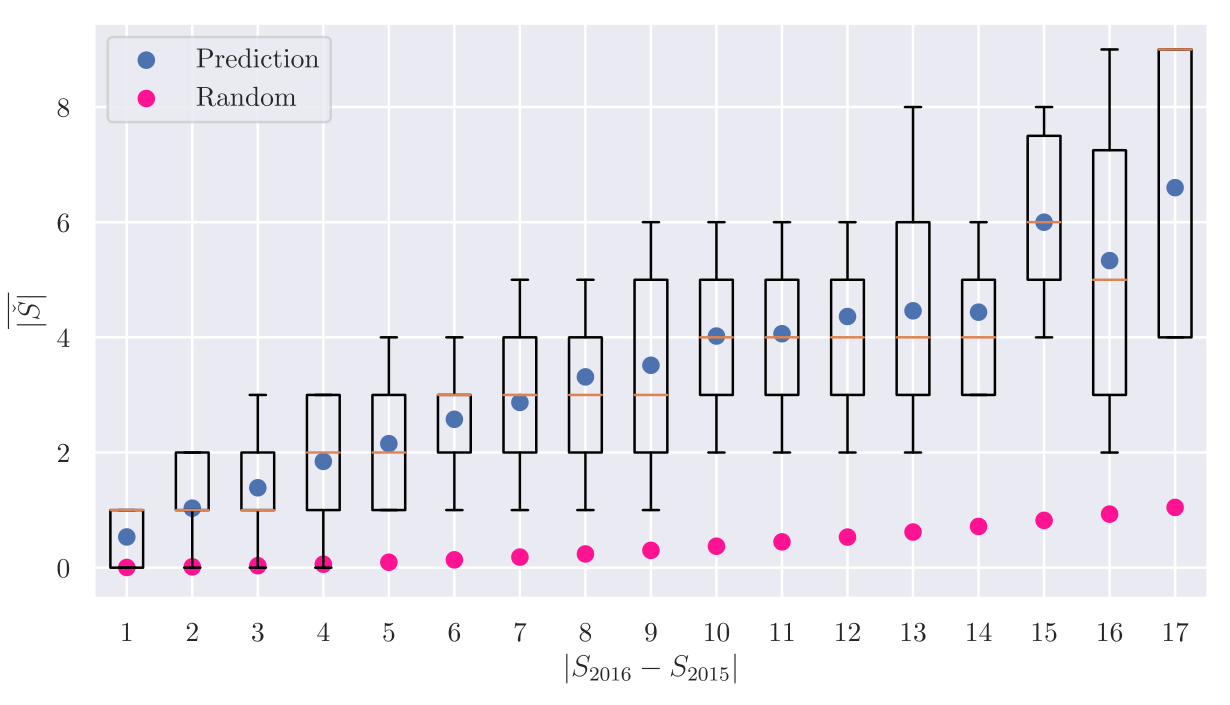
图 9|换进前 30 的站里,模型比随机抽取多抓住多少?
无字母子图。横轴是某站 2016 年前 30 个来源中、不属于 2015 年前 30 的个数。纵轴是这些新来源里、也被模型放进 2016 年前 30 的个数。蓝点是模型,粉点是从这组新来源里随机抽取的期望。箱线画法与图 4 相同,须线为第 9 和第 91 百分位。横轴从 1 画到 17,每个位置上蓝点都高于粉点。正文的概括是:这些变化里超过三分之一能被模型抓住。超过 17 的只有一个站,论文写它没有统计意义,图中未画。来源:原论文 Fig. 9。
超过三分之一的分母,是新进入前 30 的站,不是前 30 个位置全部。退出前 30 的站不在这个比例里。20/30 和 19/30 是另一件事:模型前 30 与实际前 30 的重合,不限于新出现的那些站。
这些比较不能直接拿去报下个月的客流
功能、转移概率、行程时间和机会数都来自客流本身。模型说明的是:在已知各站出发量和类别去向之后,同类车站之间的行程时间名次,能否把人分到合适的站。它没有证明土地用途改变导致了客流改变,也没有在留出的日期上做预报。
范围也限于地铁。7 点以前和 22 点以后、公交和出租车、没有刷这张卡的出行,都不在数据里。未着色的新站被排除。兴趣点只出现在讨论里,作为规划者可以进一步汇总的资料,没有进入这篇文章的计算。α=−0.84 是借来的。不同功能之间不竞争,是模型假设。早上相似指数改善很小,正好说明固定的家和工作地还在这套规则外面。
K=3 的三类名称是对曲线的解释。在线附录里的三项聚类指标,正文没有给出名称和分数,因此这里不能比较 K 均值赢了多少。图 5 里流量误差的印刷公式与出站误差不一致,绝对刻度不宜外推;线与线的高低仍是图上的结果。
一句话总结
下班的地铁不能只按更近和机会更多来选:先按钟点决定这一小时流向办公、综合还是居住,再在同类车站里竞争,傍晚的行程时间才对得上上海地铁记录;只留下后一半规则,人流会被写成越近越多。
核心来源
- Shi S., Wang L., Xu S., Wang X. Prediction of Intra-Urban Human Mobility by Integrating Regional Functions and Trip Intentions. IEEE Transactions on Knowledge and Data Engineering, 2022, 34(10): 4972–4981. DOI:10.1109/TKDE.2020.3047406。2020 年 12 月 25 日在线发表,期刊期次为 2022 年 10 月。
- 数据为 SODA 提供的上海公共交通卡。主体记录是 2016 年 9 月的 129,964,604 条地铁行程;功能变化一节另用 2015 年 4 月。地图由高德绘制。
- α=−0.84 引自 Noulas 等 2012 年对 34 个城市的拟合,不是本文估计。介入机会的经典表述见 Stouffer 1940。经验流量的幂律,论文对照 Roth 等 2011。K=3 的可解释性,作者还引用 Peng 等 2012 对出租车活动的三个基。
- 正文写明,聚类指标的比较见在线附录,补充材料可由 DOI 页面获取。正文没有列出指标名称和分数。
作者介绍
以下只写论文署名机构和文末作者介绍中可核对的内容。
- Shuyang Shi:2015 年获上海交通大学自动化系学士,文末介绍写明当时在该系攻读控制理论与控制工程博士。介绍中的研究方向为人类移动网络、数据科学和城市科学。署名单位还有系统控制与信息处理教育部重点实验室。
- Lin Wang:山东师范大学数学科学学院 2003 年学士、2006 年硕士,2009 年在中国科学院数学与系统科学研究院获运筹学与控制论博士。文末介绍写明为上海交通大学自动化系教授、IEEE 高级会员,研究方向包括多智能体系统、自适应复杂网络和多机械臂协调。本文通讯作者。
- Shuangdie Xu:上海交通大学电气工程系 2017 年学士、2020 年硕士。文末介绍写明当时为国网浙江省电力有限公司杭州供电公司助理工程师,研究方向包括电力系统可靠性、不确定性分析和分布式电源接入。
- Xiaofan Wang:1996 年获东南大学博士。文末介绍写明,2002 年起为上海交通大学教授,2008 年起为上海交通大学特聘教授,撰写该介绍时任上海大学副校长;研究方向为复杂动态网络的分析与控制。论文同时署名上海交通大学自动化系和上海大学自动化系。本文通讯作者,IEEE 高级会员。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要在改造完成之前判断龙华会把哪些站变成新来源,这套模型仍然先要人指定新的功能标签,并给出新的类别转移概率和各站出发量。论文展示的是标签已经变了之后,分配结果会跟着改口。把 2015 年 4 月的输入冻结,并不能从文中推出 2016 年 9 月那张南部蓝圈。
那 5 个站的全月出发量只增到 1.26 倍,前往龙华的平均次数却增到约 5.66 倍。只监测周围车站是否变得更忙,会漏掉这种重新分配:起点的总出门人数可以几乎没变,去某一个新功能站的人数已经翻了几倍。站点选址若只看本地进站增量,看到的是另一件事。
早高峰也不该用同一组旋钮。早上的相似指数几乎不升,是因为工作地不是按行程时间名次挑的。在办公站附近增加“机会”,不会按这个模型把早高峰改道。午后的综合站才是同类竞争更站得住的部分;即便如此,图 6 的阴影宽于平均曲线的升降,全市一个熵不能代表每一个站的选择集。再往前一步,模型假定居住站和综合站之间不竞争。若新建的商场被标成综合,而乘客实际上把它当成回家的替代,这套规则从一开始就不会让它和居住站抢同一批人。