手机记下的一个点,究竟是在认识人、认识地方,还是认识一条路?
论文名片|Eran Toch、Boaz Lerner、Eyal Ben-Zion、Irad Ben-Gal,Analyzing large-scale human mobility data: a survey of machine learning methods and applications,Knowledge and Information Systems,2019,58:501–523。2018年3月30日在线发表。DOI:10.1007/s10115-018-1186-x。综述论文,依据这一正式期刊版。
早上八点,同一个人的手机在地图上留下一串点。导航想知道下一段路会不会堵,商场想知道这个路口今天有多少人经过,广告想知道这个人明天还会不会走同一条路线。三件事可以共用同一次定位,被拿来建模的对象却不一样:一个人、一块地方、一条路径。
这篇综述没有新测一座城市,也没有报告统一的下一地点准确率。Toch 等人审阅了一百多篇使用地理坐标的研究,认为方法难以迁移,是因为对象、定位方式和模型假设经常对不上。房间里的定位模型,可以直接在跨城通勤上失效。他们把应用分成用户建模、地点建模和轨迹建模,再对照模型属于通用规律、监督学习还是无监督学习,以及数据在追踪谁、用什么定位、覆盖多大范围。
因此,这套分类用来判断一篇论文的做法能不能搬到另一个场景。它不能代替一次统一再实验,也不能证明某一种算法在所有城市都更准。
先说结论
- 同样的坐标可以服务三类任务。用户建模看同一个人在较长时间里的位置;地点建模看一个区域怎样被人使用;轨迹建模看一串时空点组成的路径,移动者身份不必进入分析。
- 在作者按主题相关性、引用影响和自身判断选出的样本里,2002至2016年三类研究追踪的对象数量都沿对数尺度上升。数量最大的数据集集中在用户和地点研究;轨迹研究里,出租车和货车车队多为中等规模。图中的直线是这份样本上的回归趋势。
- 精度和覆盖互相牵制。专用 GPS 的精度在数米量级,样本通常较小。通话详单可以覆盖很多人,综述点名的最大一套超过160万用户,位置却只到基站扇区,不确定性大约1平方英里,人口更稀的地区更粗。
- 文献分布与有没有标签有关。用户和地点更容易拿到已知类别,监督学习更常见;轨迹更常使用聚类,因为专门的真值难获得,而时空点本身就能定义距离。这是综述对文献的观察,不是算法优劣的重新比赛。
- 综述转述 Cho 等人的结果:社交关系大约解释人类移动的10%–30%,周期性行为大约解释50%–70%。分母是该项研究里的人类移动,不是本综述重新计算的份额,两项也没有被写成必须加总为100%的互斥分解。
为什么房间里的模型,不能直接拿去解释跨城通勤?
定位手段变多之后,手机基站、全球导航卫星系统(文中以 GPS 为代表)和 Wi-Fi 定位都能给出地理坐标。坐标都叫位置,分析单位可以完全不同。Sohn 等人在通话详单上的做法,后来被 Reddy 等人用到 GPS 与加速度计的组合数据上。传感器换了,模型仍可能沿用;反过来,只为房间内部定位设计的模型,不能自动解释城市之间的每日通勤。
作者用三个轴整理文献。应用类是用户、地点或轨迹。建模途径是非机器学习、监督机器学习或无监督机器学习。追踪属性包括被追踪的对象、定位方式,以及数据范围。分类是他们反复对照数据前提、准备过程、算法和输出之后整理出来的,不是从随机抽样里估计出的自然种类。
入选有三条口径。第一,工作要使用基于坐标的位置;少数使用加速度计的研究,只有在位置仍是主要信息时才保留,例如 Monreale 等人和 Eagle 等人。第二,追踪对象是人,或车辆这种人的代理;动物、自然现象,以及火车和固定公交线路被排除。第三,论文要有影响力,作者主要看 Google Scholar 的引用,并辅以定性判断;新论文影响力难估,他们也纳入自己认为值得注意的近期工作。所以后文的趋势描述的是这批入选论文。
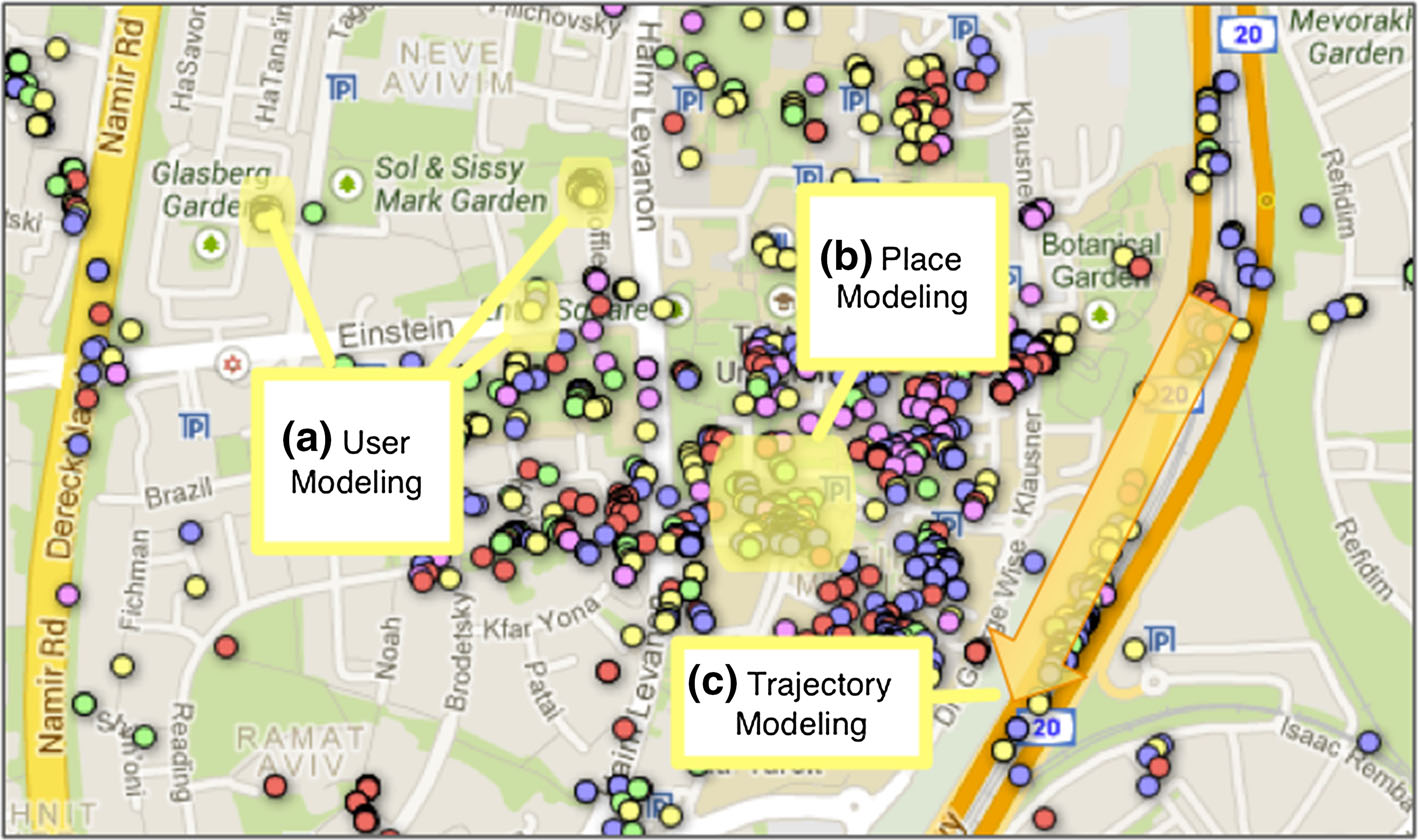
图 1|同一个区域里,三类建模各把什么当成对象?
(a)用户建模把同一种颜色的圆点看成同一个人在不同位置的记录,关心这个人在一天中的不同时刻会在哪里。(b)地点建模看一块地理区域,不同颜色代表不同的人,可以用来估计进出人数、客流形态和地点类型。(c)轨迹建模把同一人的时空点连成路径,图中用箭头表示,对象是路段或路网,而不是单独一个停留点。底图由 Google 地图生成,点的颜色和箭头是示意,不是某次抽样的计数结果。来源:原论文 Fig. 1。
三类还可以再按汇总尺度分开。有的模型只描述一个对象,有的把一群人放在一起,例如按共同位置做群体建模。用户建模通常保留身份,并使用较长时间的轨迹。轨迹建模可以把许多移动者合在一起看,身份不是必需项。地点建模的实体是一个位置或一组位置,轨迹建模的实体是位置之间的路线。
追踪的人数在变大,这是全部文献的普查吗?
图2把入选论文按发表年份和追踪对象数量摊开。纵轴是对象数量的常用对数,从1到1,000,000。作者用线性回归为三类各画一条趋势,并写道:就这一数量而言,最大的数据集用于用户建模和地点建模;出租车、货车车队这类中等规模数据用于轨迹建模。一种解释是,很多数据来自通话详单这类事务记录,位置和时间都稀,细不到轨迹建模所需要的程度。
他们同时写明,这些论文只是有代表性的样本,不是完整清单。三类的数据规模都随时间以对数方式变大。对数上升意味着数量级在提高,不能读成每年增加固定人数,也不能外推到2016年之后。图上个别轨迹研究也会靠近纵轴高处,所以“中等规模”说的是车队数据的常见情形,不是每一篇轨迹论文的人数上限。
综述点名的最大通话详单来自 Fan 等人,超过160万人。他们用张量分解刻画这些人的日常惯例,并观察2011年东日本大地震期间惯例如何变化。160万是这一套数据里的用户数,不是图2全部蓝点的合计,也不是全球手机用户。
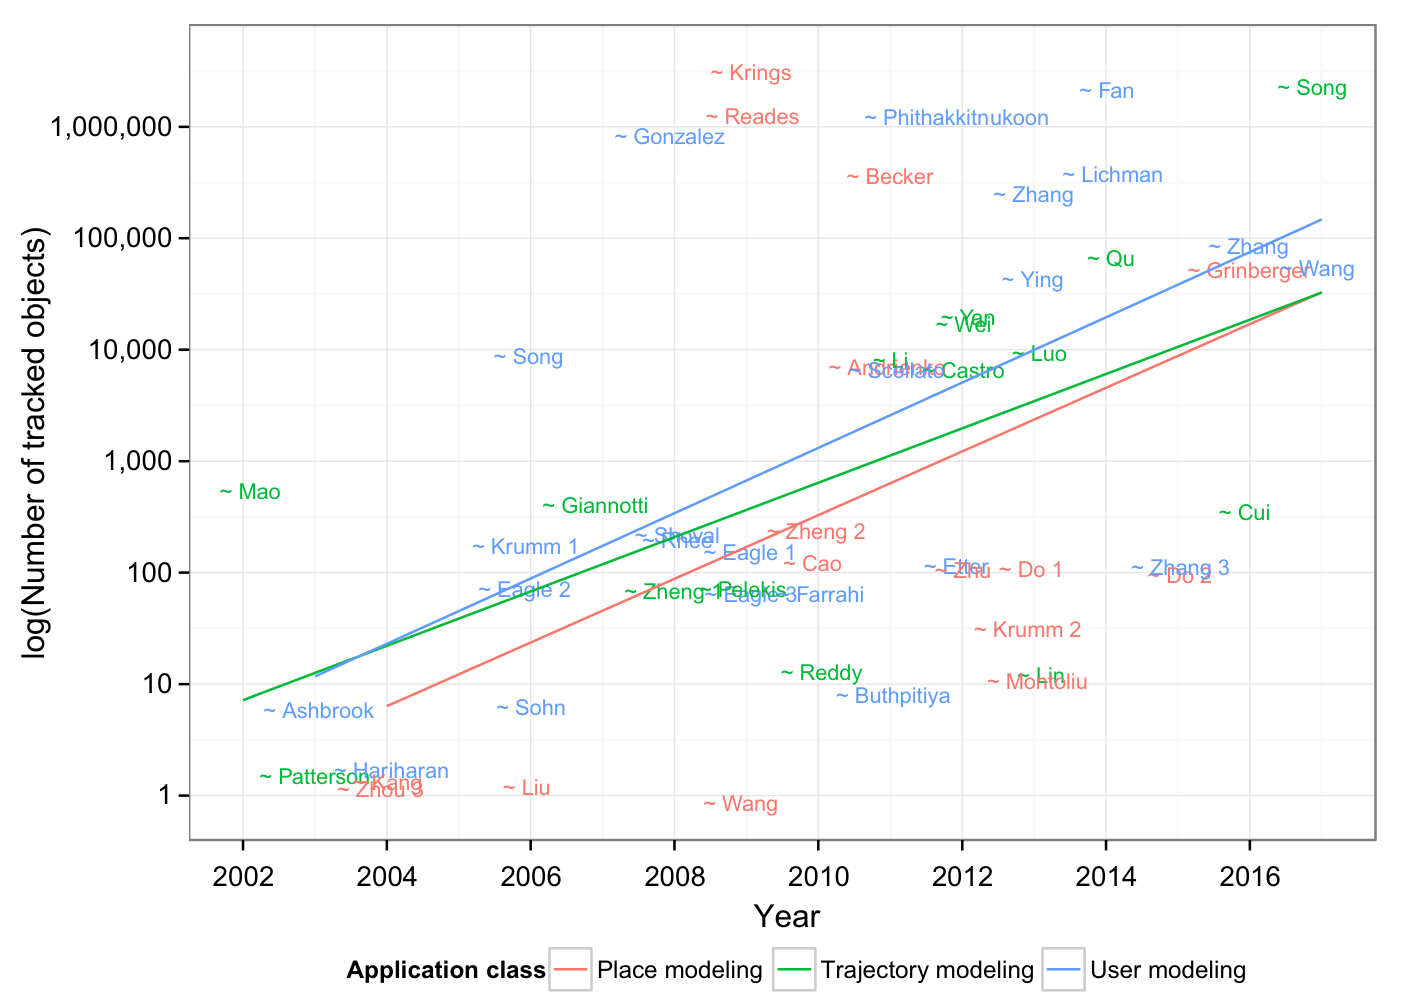
图 2|入选论文追踪了多少对象,三类是否一样大?
无字母子图。横轴是发表年份,大约从2002到2016。纵轴是追踪对象数量的常用对数。红色为地点建模,绿色为轨迹建模,蓝色为用户建模;直线是各类在这份样本上的线性回归。标签是第一作者,同一作者有多篇时加序号。名字标在点的附近,会互相遮挡,不能把标签高度当成该论文的精确样本量。来源:原论文 Fig. 2。
一个点有多细,决定了哪类问题问得下去?
时间分辨率和空间分辨率一起约束模型。密的一端,专用传感器可以每隔几分钟记一次位置。稀的一端,通话详单往往只在通信事件发生时产生,其余时间用户在位置上是看不见的。GPS 轨迹的精度在数米。通话详单粗到基站扇区,不确定性大约1平方英里,人口更少的地区可以更粗。
覆盖人数通常和这种精度对调。通话详单可以包含数以百万计的人的信息,专用 GPS 设备大多是更小的样本。运营商收集位置时,常常只能看到详单给出的位置,看不到 GPS 位置,综述写明原因是隐私限制。因此,详单难以分析小尺度移动;多数 GPS 数据也难以单独画出全体用户的稳定统计轮廓。被追踪的对象主要是人或车:人来自详单、专用 GPS,以及后来带 GPS 的智能手机;车来自出租车或货车车队的 GPS。
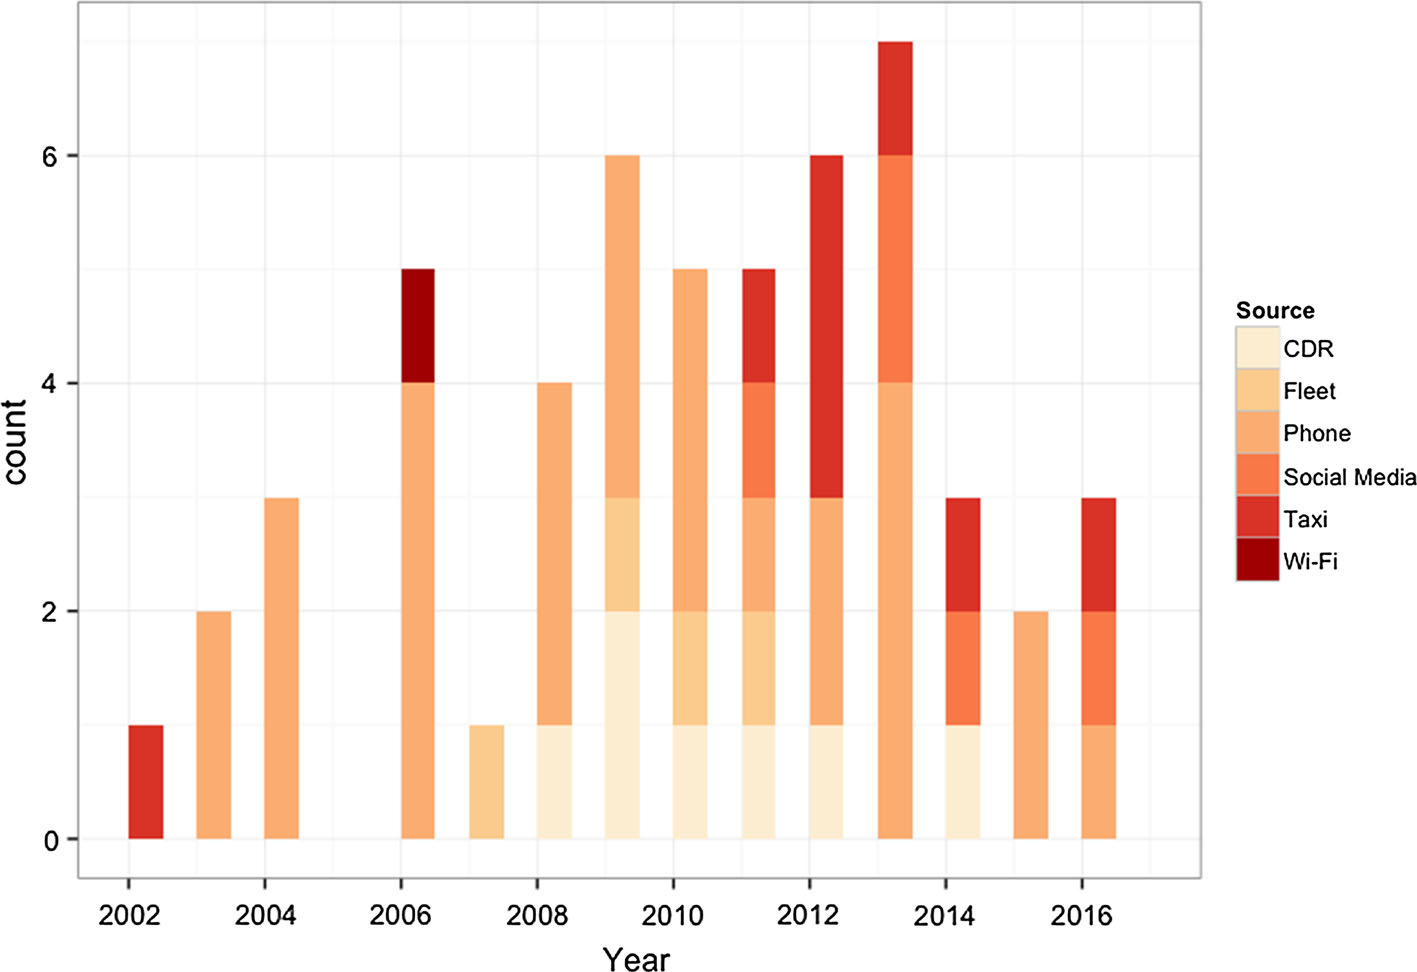
图 3|这些论文的位置记录从哪里来?
无字母子图。横轴是年份,纵轴是论文篇数,颜色区分通话详单、车队、手机、社交媒体、出租车和 Wi-Fi。2000年代早期的工作多用专用硬件或软件做手机传感,也有车队和 Wi-Fi。较晚的柱子里,出租车和社交媒体所占的色块更明显。纵轴是篇数,不是用户人数或定位点个数;各色块的精确篇数正文没有逐项列出。来源:原论文 Fig. 3。
来源的变化改变了能问的问题。出租车数据往往没有地点类型,也没有司机或车辆身份,综述认为它们主要服务于轨迹和交通分析,很难用来研究社会关系。社交媒体位置,尤其是 Twitter、Foursquare 和 Gowalla,带有场所类型或文字,但点是由签到、发帖这类动作触发的,不连续,也不按固定间隔采样,所以主要用于地点分析。
有标签时走监督,没有标签时为什么常落到聚类?
表2按三条建模途径,把方法对到三类应用,里面是代表性文献,不是一张完整的性能排行榜。
非机器学习里,广义模型用少量公式、规则或很粗的统计量概括整个人群,例如每日出行距离或随机游走的熵,而不是逐人、逐地给出细表。引力模型、连续时间随机游走、莱维游走(Lévy walk,步长可以很长的随机游走)、一套规则或一张社交网络,都属于这一类。统计模型则用回归、马尔可夫或核密度,去刻画一个具体的人、地点或轨迹。
监督学习在训练时使用带标签的样本,再给新样本预测类别或数值。用户和地点更容易出现已知的人或已知的场所,所以监督方法在这两类里常见。标签可以自动收集,也可以借助外部真值,例如场所的地理属性。类别型目标用分类,连续型目标用回归。分类可以判断一个新用户或新地点属于哪一类;回归可以估计经纬度,或估计某人、某商场每月的行驶里程。决策树还可以输出属于某一类的条件概率。综述列出的监督模型包括贝叶斯分类器、n-gram、随机森林、判别分析、支持向量机和神经网络;深度学习只作为近期例子被提到,正文没有给出网络结构、损失函数或训练步骤。
无监督方法里最常用的是聚类,轨迹建模尤其如此。原因是移动数据很难拿到专门的真值,而时空轨迹自带距离,常用欧氏距离,也可以用信息论里的度量。聚类回答的是哪些轨迹彼此相似,不是某一个标签的预测准确率。主题模型则被用来归纳行为和生活方式。高维数据还可以做降维和特征选择;因果模型,例如贝叶斯网络,被写成一种寻找隐藏原因的可能途径。综述没有报告这些途径在统一数据上的误差比较。
预测这个人下一步去哪,人群规律和一条语义路线是两层
用户建模的大部分下一地点预测,是给单个用户拟合机器学习或统计模型。它可以利用历史位置和当前情境。综述举例:贝叶斯方法、神经网络和随机森林都曾被用于这类预测。Sohn 等人的两步逻辑回归先判断人是否静止,再在非静止时区分步行和驾车。这是在给状态分类,不是在输出下一次停留的经纬度。
图4把用户模型分成三层。抽象层只保留一个数值性质,例如出行距离,描述的是一群对象的共同形态。地理层给出单个对象到过哪些具体位置。语义层用对人或活动有意义的类别来描述位置。
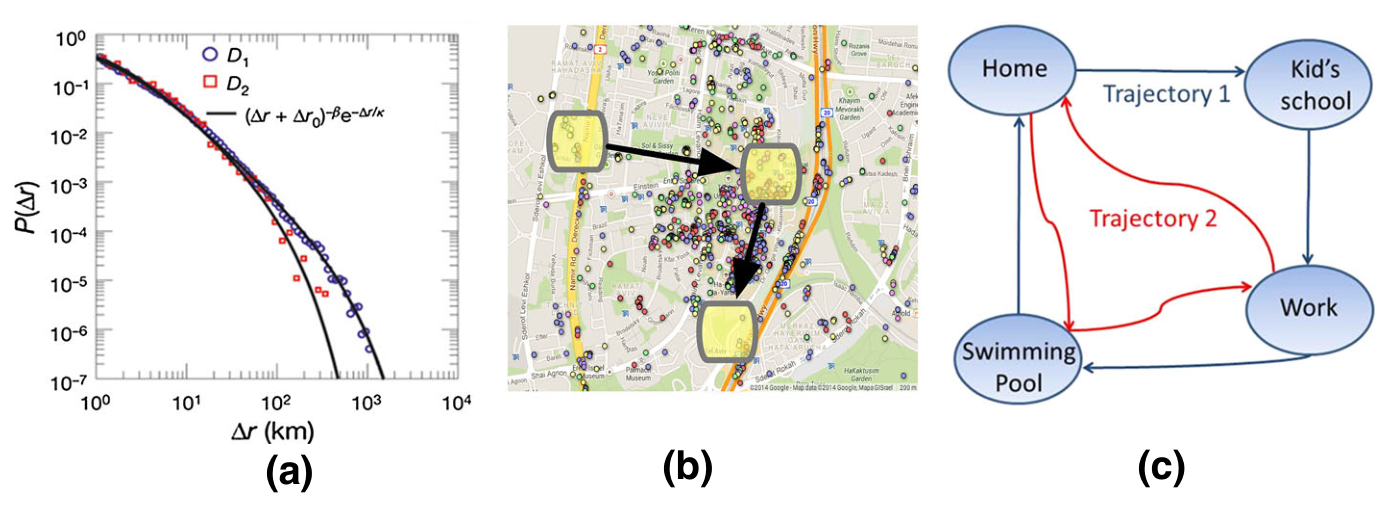
图 4|用户建模抽象到哪一层,预测的就不再是同一件事?
(a)双对数坐标。横轴是位移 Δr,单位公里;纵轴是该位移出现的概率。蓝圆和红方块是 D₁、D₂ 两条序列,综述没有说明各来自哪套数据。黑线是图上标出的截断幂律:概率先按位移的幂下降,很长的位移再被指数项压低。正文说 Gonzalez 等人基于约10万条手机轨迹发现出行距离服从幂律;图中的曲线在长距离处还有截断,因此不是一条可以无限延伸的纯幂律。参数没有在综述正文中重新估计。(b)地理层,黄框和箭头标出一个人访问过的具体位置。(c)语义层,地点被写成家、孩子的学校、单位和游泳馆,并画出方向不同的两条路线。综述正文把这个例子标成 Fig. 3c,图本身画在 Fig. 4c。来源:原论文 Fig. 4。
(c)是综述设置的例子,不是测得的概率。假定这两条路线都是这个人的惯例:若上班途中先送孩子到学校,模型可以较高概率预测下班途中会去游泳馆;若上班途中已经游过泳,就按另一条路线,预测下班不再去游泳馆。例子要说明的是,家和单位这两个端点保留下来之后,顺序仍然会改变下一步。它没有给出这条概率的数值。
Gonzalez 等人被综述同时写成用莱维飞行式的聚集来预测下一地点。这里沿用的是综述的表述。图4a能够直接核对的,是人群位移分布的形状,不是一个已部署预测器的命中率。
从一个人扩展到许多人,综述认为模型和用法都还开放。Cho 等人的结果被用来说明两种成分:地理上受限的周期性移动,以及看似随机、却与社交网络活动相伴的跳跃。社交关系大约解释人类移动的10%–30%,周期性行为大约解释50%–70%。两项都是“大约”,分母是该研究所说的人类移动。10%–30%与50%–70%的区间加在一起可以重叠,也可以留下空档,综述没有把它们定义成互斥份额。
另一条汇总路线是借用周围人的路径。WhereNext 不只使用这一个人的历史,还使用同一区域里所有人的移动来修正预测。前提是人常常跟着常见路径走。前提成立时,群体的典型行为可以用来推测群体中的个人;前提不成立时,这套修正没有被综述证明仍然有效。
坐标怎样才变成一个地点?
地点建模也不只是把经纬度留在地图上。连续、高精度的点如果不先抽象,很难直接抽出模式。图5把抽象分成四层。
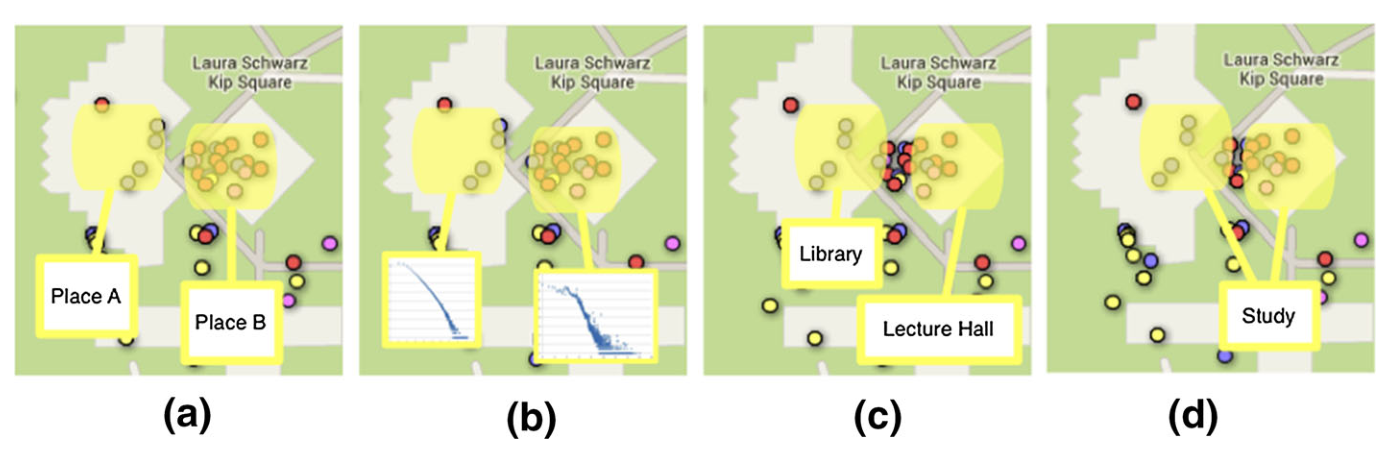
图 5|同一个广场上的点,可以依次被看成停留、分布、场所类型还是活动?
(a)个人地点层,按停留把点收成地点 A 和地点 B。多数研究里,地点是人停留过一段有意义时间的位置或多边形。(b)统计层,两个小图分别概括两地的到访分布;小图没有标出可核对的单位,只能看出形状不同。(c)语义层,相近的点被标成图书馆或讲堂。(d)活动层,图中可见的标签是学习。同一个人所在的地点,别人可以给出不同活动名。四层是抽象级别,不是同一次回归里的四个自变量。来源:原论文 Fig. 5。
第一层可以使用国家、州、城市或街区这类现成边界。Krings 等人用引力函数统计城市之间的移动。更细的做法是把空间切成有标签的片段,再用片段标签代替落在其中的点。这种切分仍带着物理位置的特点:两家餐馆即使语义相同,相距很远时一般仍会得到不同标签。
统计层把许多人的到访累积起来,再用回归或分布来描述。Reades 等人把罗马分成每块25万平方米的等面积区域,按到访模式描述每个区域。综述认为,等面积格子可以表现城市的大尺度动态,任意边界也限制了能得到的知识。综述还转述,按等大格子划分,不如依据人的移动做动态划分有效。这是对所引研究的概括,不是作者在罗马数据上重新做的对照。
语义层允许同一批点有粗细不同的名字,例如某教室、工程楼或大学校园。隐藏马尔可夫模型曾被用来推断场所类别,隐状态就是这些类别。活动层更进一步:同一间教室里,教师可能把它标成工作,学生可能把它标成学校。地点的名字因此同时取决于场所和人在其中做的事。
轨迹建模为什么可以不看这是谁?
轨迹是路线的抽象:一组带时间的空间点,表示经过一系列位置的移动。它和用户建模的差别是,移动者身份可以不进入分析,许多对象往往被汇总。用户建模关心长期痕迹,轨迹建模关心单次行程。它和地点建模的差别是,对象是一段路,而不是一个地点。路由移动定义,不一定固定在同一条几何线上。
不依赖已有地图的方法,只使用轨迹自身的性质。例如仅凭定位判断一段行程使用的交通方式,决策树、动态贝叶斯网络和条件随机场都被综述列入。判断两个对象是否共享同一条轨迹,是汇总分析的起点,例如两辆车是否走在同一条路线上。多篇研究用相似度做轨迹聚类,但用哪一种距离,综述认为仍未解决,而且常常取决于具体应用。
已经知道路网时,模型改为学习这些已知路线的性质。支持向量机被用于路网上的轨迹分类,加权马尔可夫模型被用于预测城市里车辆的行驶方向,也有工作寻找大数据里最常出现的路径,或从大量轨迹中抽出感兴趣区域和典型行程时间。交通状态预测是这一方向最常见的应用。这些都是综述对已有论文的归类。它没有用同一路网、同一指标重新比较上述模型。
异常移动也被列为用途,例如照护、健康监测和安全告警。综述只指出用途存在,没有在这里给出判定规则。
数据继续变多之后,哪些问题仍没有被回答?
综述看到的第一个缺口是:文献里还没有一套可以共用的、足够紧凑的移动模型,用来存储和分析位置轨迹。时间模型既用于地点预测,也用于惯例建模,占用的空间可以只是完整轨迹的一小部分。图2已经显示数据量在涨,细粒度分析会越来越难。作者希望这个领域有标准格式,以便放进 Hadoop 或其他大数据系统。这是建议,不是他们已经完成并验证的存储方案。
第二个缺口在使用者一端。当时依赖大规模移动数据的工业应用,主要向企业和机构提供汇总统计,例如运营商的消费者统计产品。直接服务终端用户的应用较少,大规模数据的终端用途主要集中在交通和导航。综述把“找到对用户有切实价值的应用”写成挑战,没有声称某一种应用已经胜出。
第三个缺口是标签。数据集变大,不等于更有用。研究者越来越使用现成数据,就更难再收集与之配套的信息。出租车和社交媒体在产生有意义结论方面都有限。综述给出的绕行办法包括收集带语义的大规模数据,以及把多个来源拼在一起。它没有比较这些办法的误差。
第四个缺口是隐私。收集、保存和分析位置轨迹会带来隐私后果。综述引用的工作表明,位置数据存在被重新对应到具体个人的可能。风险不限于知道一个人此刻在哪里,还可能涉及从大规模数据中抽出作息、生活方式和社交关系。作者同时认为,机器学习本来就是在做汇总,用语义地点代替原始坐标,有可能带来更强的匿名。他们留下三个没有在本文回答的问题:这种威胁能否被理解和量化,能否做出让用户自己管理位置隐私的工具,以及移动分析能否反过来用于增强隐私。
以这篇综述当时的概括,欧盟等地已有法规限制电信数据(含位置轨迹)的使用期限和目的;美国没有统一的数据保护框架,但电信数据的某些方面有专门规则。另有调查显示,用户担心位置数据的某些用途,或担心特定地点被暴露。综述没有给出这些担心的百分比。法规和态度都应按2018年在线发表时的文献来读,不能直接当成后来的法律现状。
这些边界叠在一起,决定了结论的形状。三类应用是组织文献的框架,类与类之间没有整齐的分界。入选取决于坐标数据、人或车辆,以及作者对影响力的判断。图2的回归线只描述入选样本。表2的方法名单不能换成准确率排名。10%–30%和50%–70%是被引研究的解释份额。图4a的幂律带有截断,图4c的游泳馆路线是假设。相关的社交结构、拟合的位移分布和示意的语义路线,都不能单独证明人已经按某一机制行动。
一句话总结
一个定位点是在认识人、认识地方还是认识一条路,先取决于模型把谁当作对象,以及这个点在时间和空间上细到什么程度;这篇综述给出的是这套对照,不是一个可以统一调用的预测器。
核心来源
- Knowledge and Information Systems 论文页面,核对正式题目、作者、2019年卷期页码与 DOI。正文图1至图5对应原论文 Fig. 1–5。
作者介绍
以下身份和研究方向来自论文首页的署名机构与文末作者简介。
- Eran Toch:通讯作者,特拉维夫大学工程学院工业工程系。简介称他为高级讲师,研究围绕可用的隐私与安全、人机交互和普适计算,以及人类行为的计算分析。
- Boaz Lerner:本古里安大学工业工程与管理系的机器学习教授。简介写明他自2007年起负责该系的机器学习与数据挖掘实验室。
- Eyal Ben-Zion:署名机构为本古里安大学工业工程与管理系。简介列出他于2011、2014和2018年在该校取得工业工程与管理的学士、硕士和博士学位。
- Irad Ben-Gal:特拉维夫大学工程学院教授。简介写明他负责人工智能与商业分析实验室,研究兴趣包括随机过程监测,以及机器学习与信息论在工业和服务系统中的应用。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一套通话详单如果同时被要求回答两件事,人在相邻两家店铺之间怎么走,以及这个扇区今天有没有人出现,分辨率会先把问题拆开。人若一直处在同一个基站扇区内,步行路径可以没有新的位置点;一旦发生通信,地点模型仍可能记下一次出现。轨迹问题需要的细路段,不会因为地点问题已经有了答案就自动得到。
图4c还提出一个值得单独检验的反例。若把周期性直接理解成家和单位两个端点,两条路线会得到同一种通勤;示意里的差别却是游泳馆发生在上班途中还是下班途中,下一步因此相反。位置集合看起来可预测,顺序仍可能不可预测。这需要新的误差比较,不能从50%–70%的周期性份额直接推出。
语义地点也被综述同时放在两个角色里:它既是用户模型想得到的有意义标签,也被希望用来代替原始坐标、从而加强匿名。若家、工作和购物这些标签本身就是敏感内容,把坐标变粗并不自动减少所暴露的事实。这个张力需要专门的隐私度量来检验。它不构成一种识别个人或隐藏个人的操作方法。