常去的地方换了,下一站还会按旧路线来猜吗?
论文名片|Wei Huang、Songnian Li、Xintao Liu、Yifang Ban,Predicting human mobility with activity changes,International Journal of Geographical Information Science,2015,29(9):1569–1587。2015年4月22日在线发表;收稿日期2014年7月15日,最终稿2015年3月19日。DOI:10.1080/13658816.2015.1033421。本文依据该期刊正式版解读。
一个人刚从旧公寓搬到新公寓。若模型只问“离开公司之后,哪个地点以前出现得更多”,旧公寓会因为过去很多个月的次数仍排在前面,下一站就被猜成旧家。Huang 等人用这个情形说明他们要处理的问题:人类移动性(human mobility,人在空间中的日常移动)若只累计地点之间的历史次数,已经换掉或停用的活动会把转移概率留在旧地点。
他们在微软 GeoLife 的北京 GPS 轨迹上,先抽出停留,再把同一地点、相近时段的停留收成活动簇,然后判断簇是换了地点还是已经停用,最后用带时段的马尔可夫链预测转移。方向性的结果是:对活动变化明显的用户,这样改写之后,训练期转移概率更接近随后三个月的实际比例;对活动本来就稳定的用户,改动很小。训练窗口结束之后才出现的新地点,两种做法给出的概率都是 0。
先说结论
- 182 名用户在 2007 年 4 月至 2012 年 8 月留下 17,621 条轨迹。按停留至少 20 分钟、范围直径 200 米,抽出 38,520 次单次活动。表 1 中有 7 人各超过 1,000 次,次数为 2,951、2,026、1,487、1,233、1,122、1,113 和 1,050,合计 10,982 次,占 38,520 次的 28.5%。
- 本文的活动变化有两类:相似活动簇的地点被较新的簇替换,或者一个簇在训练结束前空出的时间已经长于它自己的平均间隔。相似用到达时刻和停留时长围成的长方形重叠来度量。
- 定量评估只有用户 #153 和 #128。训练是 2010 年 1 月至 2011 年 6 月,对照是 2011 年 7 月至 9 月的转移概率。加入变化检测后,#153 的 R² 从 0.295 升到 0.762,#128 从 0.965 升到 0.971。论文把 R² 叫做预测准确度,但没有写出公式,也没有给出进入计算的转移条数。
153 在训练期从活动簇 A 出发、去往 B 的比例是 0.377;检测后改为 0,测试期也是 0。测试期才出现的 A→H 占 A 的出发转移的 0.255,检测前后的预测都是 0。
128 的主要转移在检测前后不变,例如 A→B 都是 0.843,测试期是 0.900。相似簇 B→E(new) 从 0.050 调到 0.100,测试期是 0.099。测试期才出现的 B→D 为 0.099,两种模型都是 0。
旧地点为什么会在概率里占上风
既有的下一地点预测常把停留收成地点,再看地点之间怎么连接。Ashbrook 和 Starner 用停留超过一定时间(例如 20 分钟)来找重要地点;Zheng 等人用时间和距离两个阈值定义停留点。Mathew 等人把时间粗分成工作日白天、工作日夜晚和周末三段。Song 等人和 Etter 等人讨论过住所变化,但依赖带有家、办公室这类语义的数据,并且假定一个人只有一个家。
GeoLife 的轨迹没有这些地点名称。一个人可以在同一时段只有一种活动,例如一个工作地点或一所学校,但 GPS 点本身不写出名称。若新地点刚出现,旧地点的历史次数仍然更高,只按次数取最大值就会停在旧地点。这篇文章要补的,是在没有地点名称的轨迹里找出这种活动变化,再让马尔可夫链使用更新后的地点。
数据来自微软 GeoLife:182 名用户、17,621 条轨迹、25,298,541 个 GPS 点,总距离约 120 万公里,总时长超过 48,000 小时,时间从 2007 年 4 月到 2012 年 8 月。轨迹里既有日常停留,也有购物、游览、就餐、徒步和骑行。这些总量是这篇文章转述的项目规模,分析单位后面会落到单次活动和活动簇,不能把 182 人理解成北京居民的随机样本。
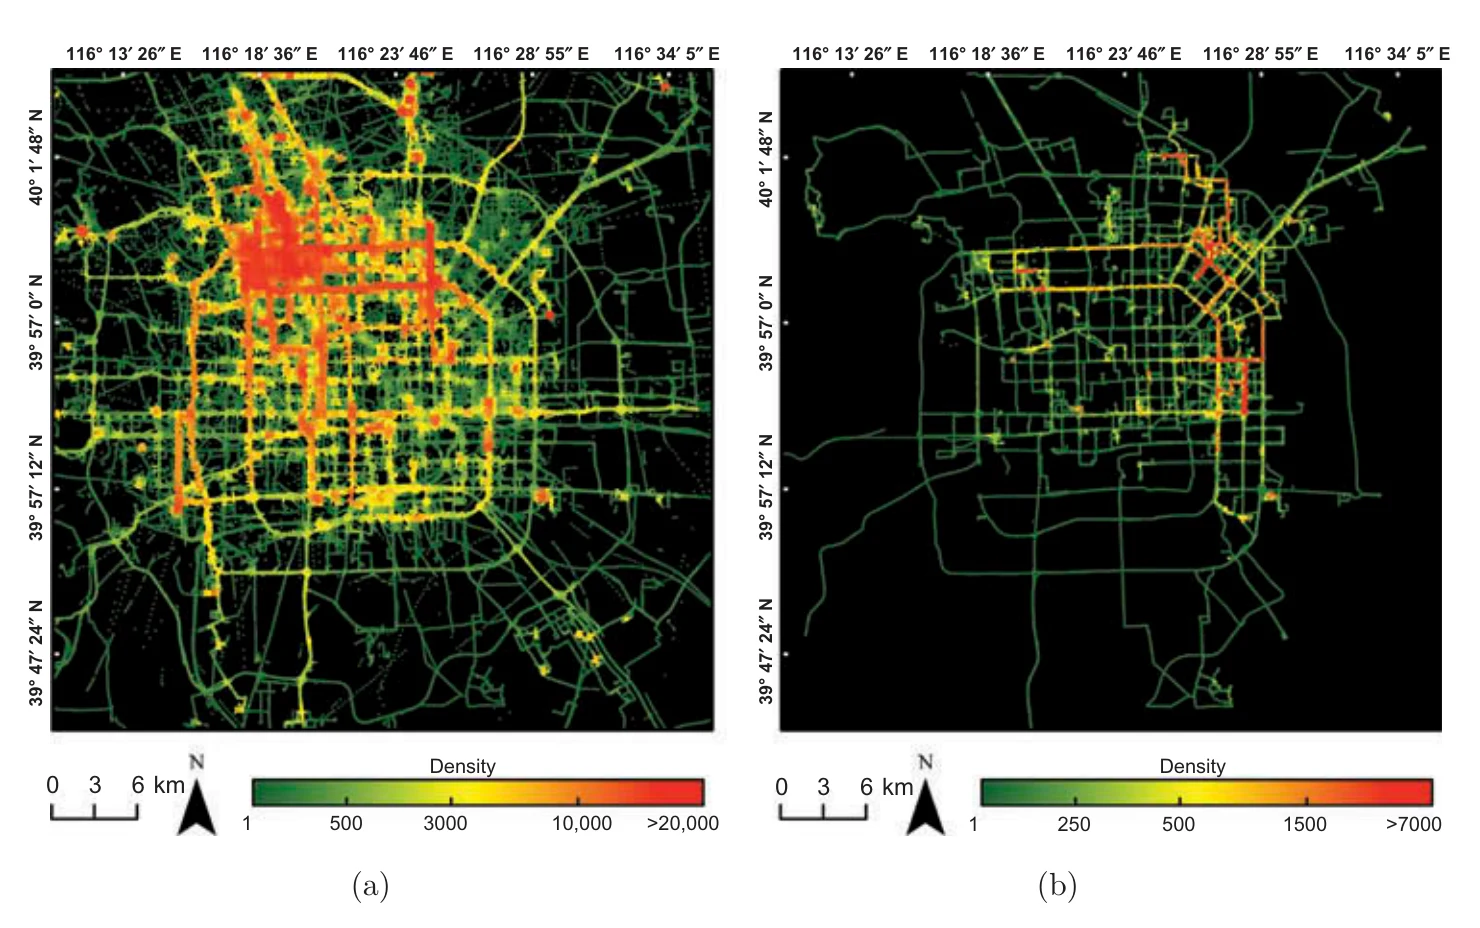
图 1|这些轨迹在北京的哪一片最密?
(a)全体用户。(b)用户 #153。颜色是 200 米乘 200 米窗口里的 GPS 点密度,两幅图的色标不同:(a)从 1、500、3,000、10,000 到大于 20,000,(b)从 1、250、500、1,500 到大于 7,000。比例尺都是 0、3、6 公里。同样的红色在两幅图里代表的点数不同。图中能看出轨迹集中在城区路网,还看不出哪一次停留构成活动。来源:原论文 Fig. 1。
一次停留要在多小的范围里待多久,才算活动
单次活动(single activity)沿用 Zheng 等人的规则:一个人在直径 200 米的范围内停留至少 20 分钟,记一次活动。20 分钟和 200 米是既有经验阈值。作者写明,不同数据里合适的阈值会变,用数据本身来定阈值是后续工作。因此,后文的 38,520 次是这套阈值下的计数,换一个停留定义,次数会变。
整条链路分成四步:从轨迹提取活动,按时空聚成活动簇,检测地点变化或停用,再做移动预测。
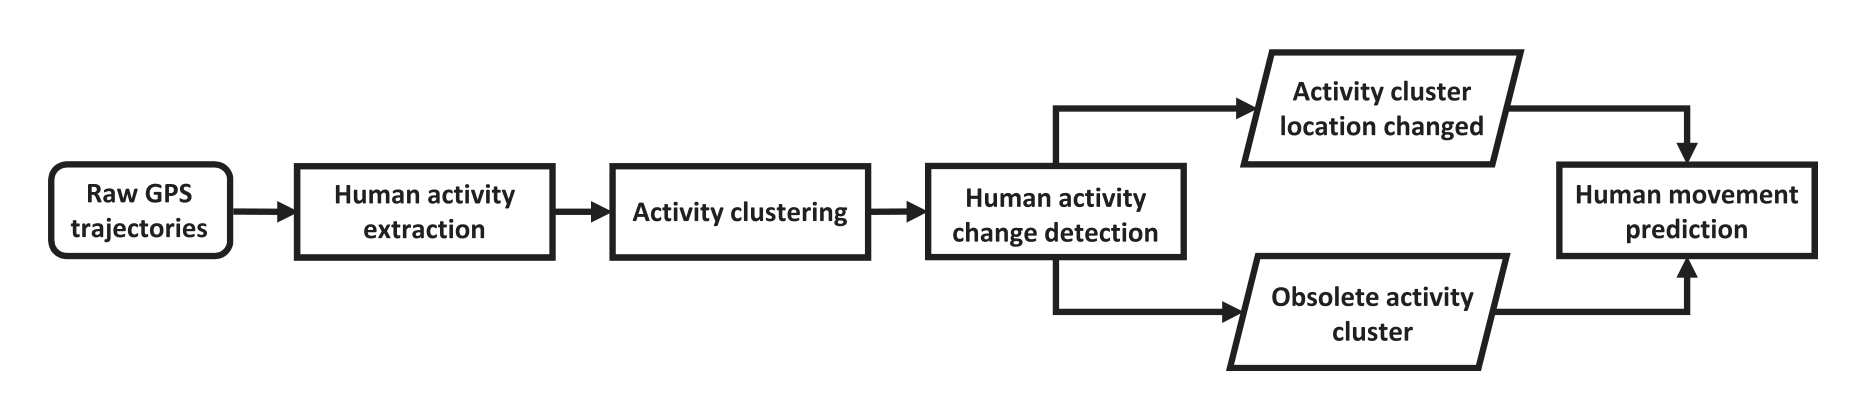
图 2|从原始轨迹到转移预测,中间经过哪些模块?
无字母子图。流程从原始 GPS 轨迹到活动提取、活动聚类、活动变化检测,再分出地点变化和停用活动簇,最后进入人类移动预测。这张图只说明模块顺序,不包含样本量或准确度。来源:原论文 Fig. 2。
182 名用户、六年轨迹一共抽出 38,520 次。有的用户一次也没有,有 7 名用户超过 1,000 次。表 1 按用户列出次数,最多的是 #153 的 2,951 次和 #128 的 2,026 次,其后 #4、#3、#17、#163、#68 分别为 1,487、1,233、1,122、1,113、1,050 次。这 7 人合计 10,982 次,占全部 38,520 次的 28.5%。分母是抽出的单次活动,也就是这 38,520 次;分子是上述 7 人的次数之和。
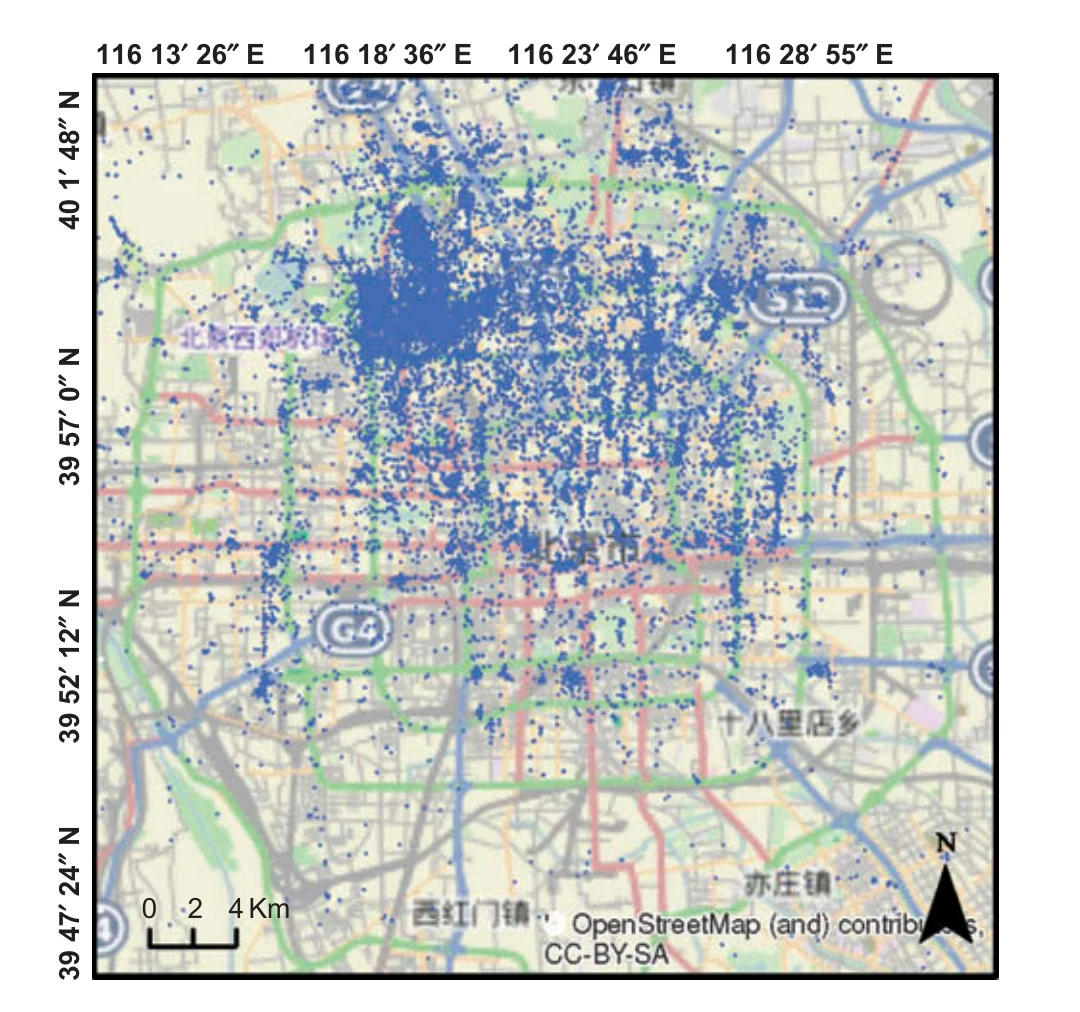
图 3|抽出的停留落在北京的什么位置?
无字母子图。蓝点是全体用户的单次活动,底图为北京,比例尺 0、2、4 公里,范围大约从 116°13′E 到 116°29′E、39°47′N 到 40°2′N。活动在西北一侧更密。作者据此推断多数用户来自北京大学、微软亚洲研究院一带,后文又提到清华大学和中国科学院。轨迹没有职业或单位标签,这是从位置作出的推断。来源:原论文 Fig. 3。
同一地点的早晨和晚上,为什么要分成不同状态
GPS 在同一地点也不会记下完全相同的坐标,文中把 GeoLife 接收器的平均误差 15 米用作空间阈值。更关键的是到达时刻不同:中午到家和晚上到家可以被看成不同的活动时段。活动簇(activity cluster)因此被定义成:在同一地点、一段特定时间里发生的一组单次活动。
聚类用 DBSCAN。空间搜索半径 15 米,形成一个簇所需的最少点数设为 1,所以单独一次停留也可以成为簇。时间半径不用统一常数,而用该用户相邻单次活动时间间隔的平均值。作者的理由是,间隔分布呈重尾,均值可以把大量较短间隔和少量较长间隔分开,从而代表主要活动在时间上的尺度。论文没有报告任何一位用户的这个平均分钟数。
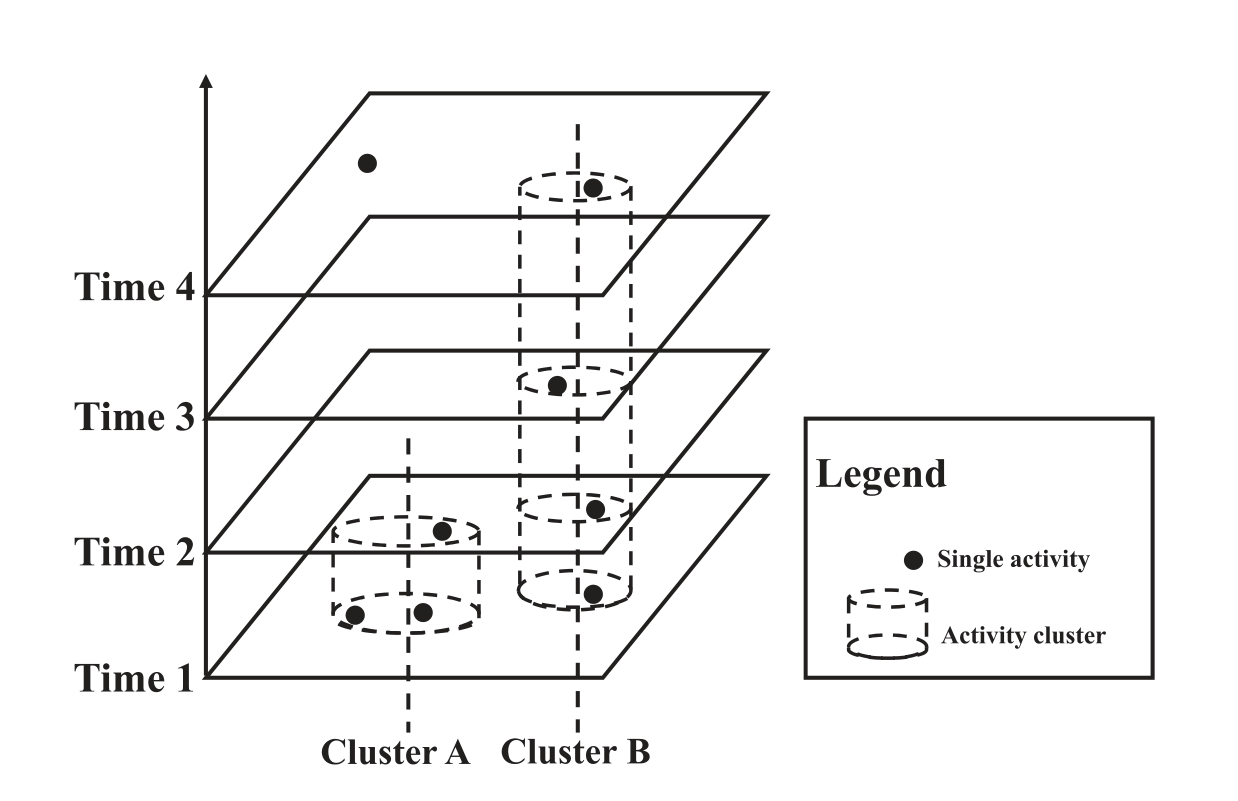
图 4|时间和空间怎样一起决定一个簇?
无字母子图。四层平面表示 Time 1 到 Time 4,黑点是单次活动,虚线椭圆是活动簇,下方标出 Cluster A 与 Cluster B。同一地点在不同时间层可以各有一簇。图是示意图,椭圆里的点数只用来表示簇的画法。来源:原论文 Fig. 4。
若两个簇里各有一次活动相距不超过 15 米,这些簇被看成同一地点,地点用相关单次活动的质心表示。15 米在这里用了两次:一次是聚类半径,一次是判断“是不是同一个地方”。它和抽取活动时的 200 米直径是两个口径。
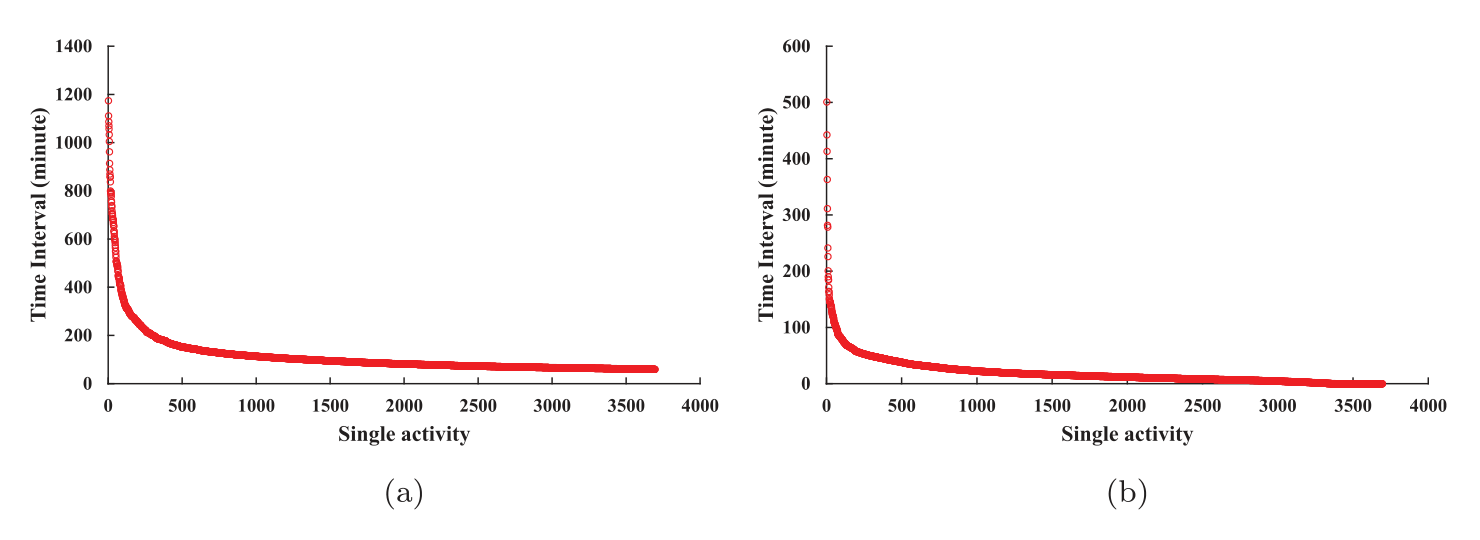
图 5|时间阈值为什么可以从间隔分布里取?
(a)全体用户。(b)一名用户。横轴标为 Single activity,刻度到 4,000;纵轴是时间间隔,单位分钟,(a)刻度到 1,400,(b)刻度到 600。两组点都从左侧的长间隔快速降到较短间隔,并沿横轴向右延伸。图形呈单调下降,外观接近按间隔从大到小排列。论文没有写明排序方式,也没有标出用作聚类阈值的均值。全体单次活动有 38,520 次,而(a)的横轴只画到 4,000,因此不能把这张图当成 38,520 个间隔的完整直方图。来源:原论文 Fig. 5。
换了地方和不再去,各用什么规则
活动变化被定义成两件事。一是活动簇的地点变了,例如办公室或校园换了地址。二是活动簇停用(obsolete),例如学业结束或停止上班,原有活动不再出现。GPS 没有这些名称,所以检测不依赖“家”或“公司”这两个词。
地点变化沿用一个强假设:在给定时段里,一个人只有一种该类活动。两个簇若到达时刻相近、停留时长也相近,就视为同一类活动。它们若按日期先后出现,就视为这一类活动换了地点。
相似用两个长方形的重叠来算。长方形的两边是到达时刻和停留时长。设两个长方形的面积为 a 和 b,重叠面积为 c,则
D = c / (a + b − c)。
到达时刻和停留时长完全相同的时候,D = 1。两个簇在 D > d 时被判为相似。d 由簇内部所有单次活动的长方形算出:各长方形面积为 aᵢ,个数为 n,全体重叠面积为 c,
d = c / (Σ aᵢ − (n − 1) c)。
论文没有给出 #153 或 #128 的 D 和 d 的数值。
停用看的是簇内节奏有没有在训练结束前断掉。簇内相邻单次活动的时间间隔为 Tₐ,次数为 n,平均间隔
Tᵢₙₜ = Σ Tₐ / (n − 1)。
训练样本结束时刻为 Tₑₙ𝒹,该簇最后一次活动的时刻为 Vₜ(L),空档
Dₜ = Tₑₙ𝒹 − Vₜ(L)。
若 Dₜ > Tᵢₙₜ,这个簇被移出预测。作者举的例子是:一月到六月的训练数据里,若某簇大约每天出现一次,却在六月结束前的最后一个月没有再出现,就把它视为停用。这是规则的说明例子,文中没有给出按这个例子实际删除了多少个簇。
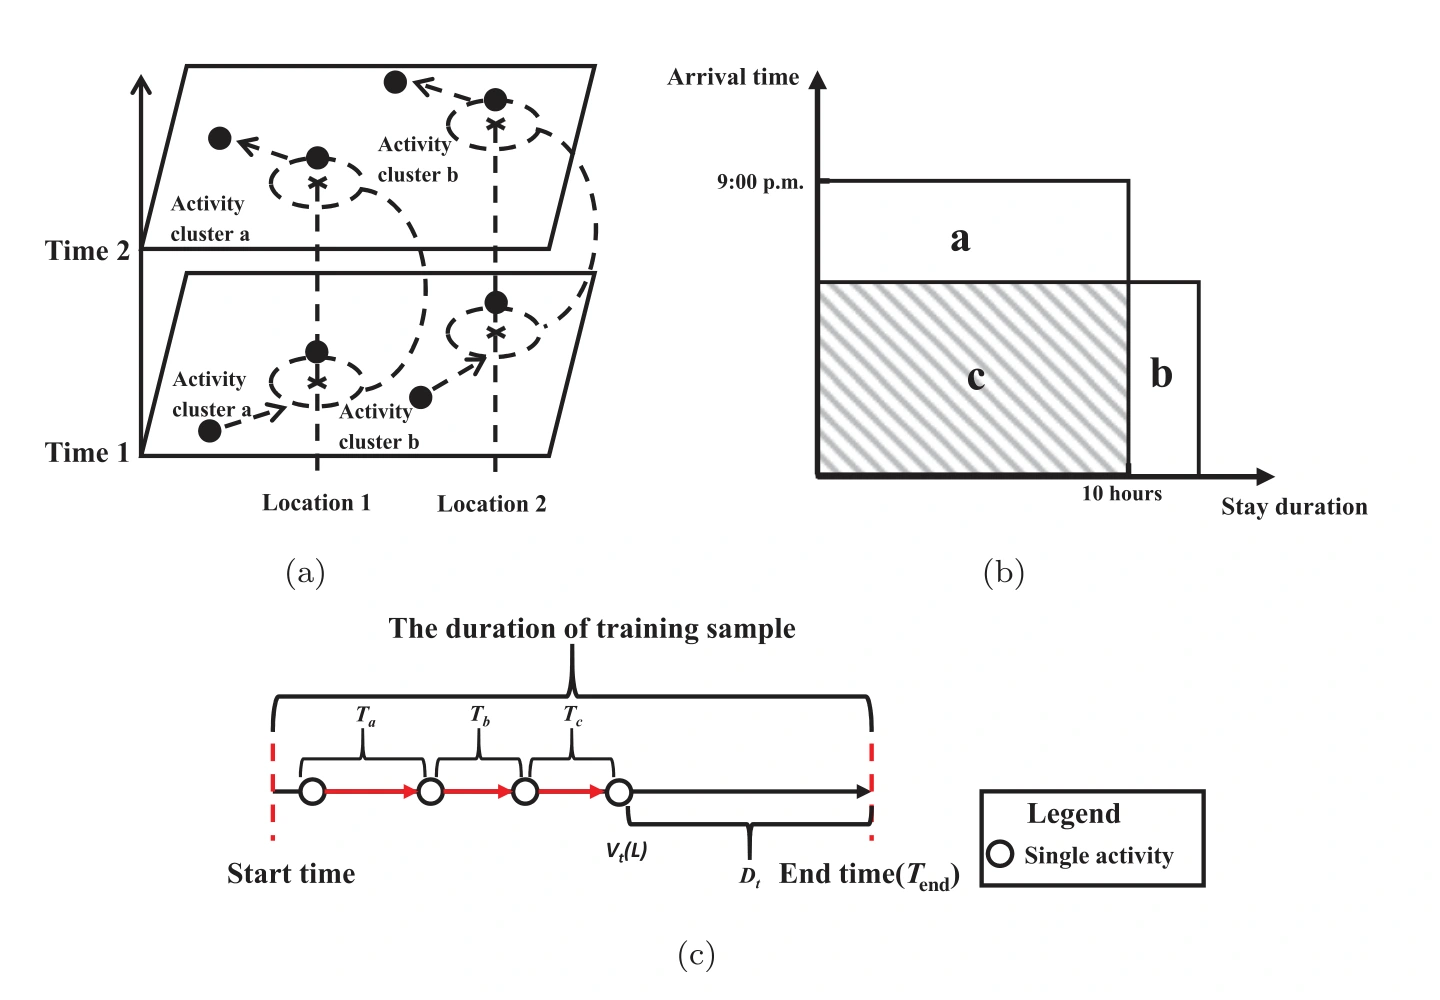
图 6|相似和停用分别在看哪两个量?
(a)两个时间层上,地点 1 和地点 2 各有活动簇 a、b;到达时刻同为 Time 1、停留都延伸到 Time 2 的簇被画成可对应的一类活动。(b)横轴停留时长、纵轴到达时刻,图中示例标到 9:00 p.m. 和 10 hours;c 是重叠区域。9 点和 10 小时是图上的示例刻度。(c)训练时段从 Start time 到 End time(Tₑₙ𝒹),圆点是单次活动,Tₐ、T_b、T_c 是相邻间隔,V_d(L) 是最后一次活动,Dₜ 是它到训练结束的空档。来源:原论文 Fig. 6。
算法对每个活动簇先找相似簇。找到之后,全部相似簇都改用最新那个簇的地点。找不到相似簇时,才计算 Tᵢₙₜ 和 Dₜ,并删除 Dₜ > Tᵢₙₜ 的簇。所以,地点替换和停用删除是两条分支:有后继相似簇时更新地点,没有后继时才检查是不是已经停了。
预测的状态是地点加时段
预测使用马尔可夫链:给定当前状态,下一步只依赖当前状态。这里的当前状态是一个活动簇,也就是一个地点质心加上它的时段。从状态 I 到状态 J 在时刻 t 的转移概率,是 I 到 J 的转移次数,除以从 I 出发的全部转移次数。每个活动簇有自己的一条链。同一地点若有多个时段的簇,就有多条链。
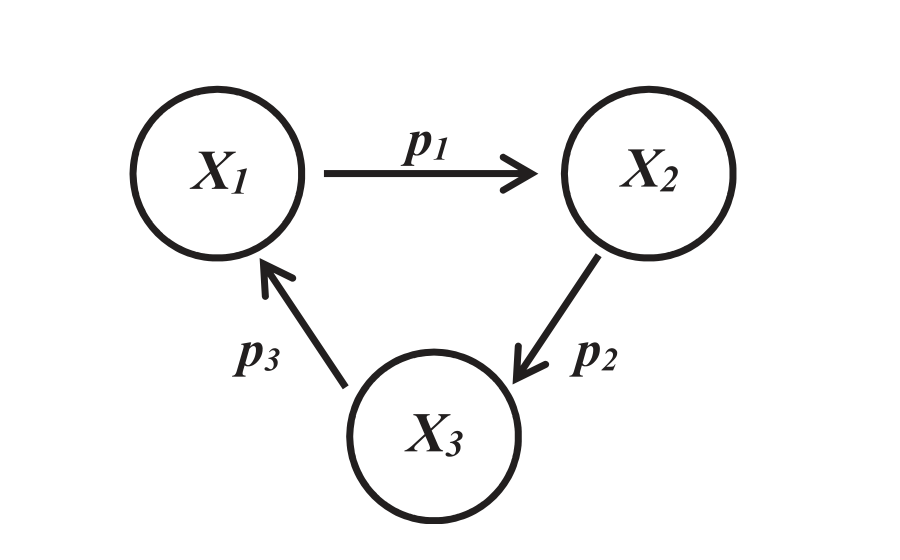
图 7|马尔可夫链在这里保留了什么性质?
无字母子图。三个状态 X₁、X₂、X₃ 按 p₁、p₂、p₃ 循环转移。它只说明下一步看当前状态。图上的 p 没有赋数值。来源:原论文 Fig. 7。
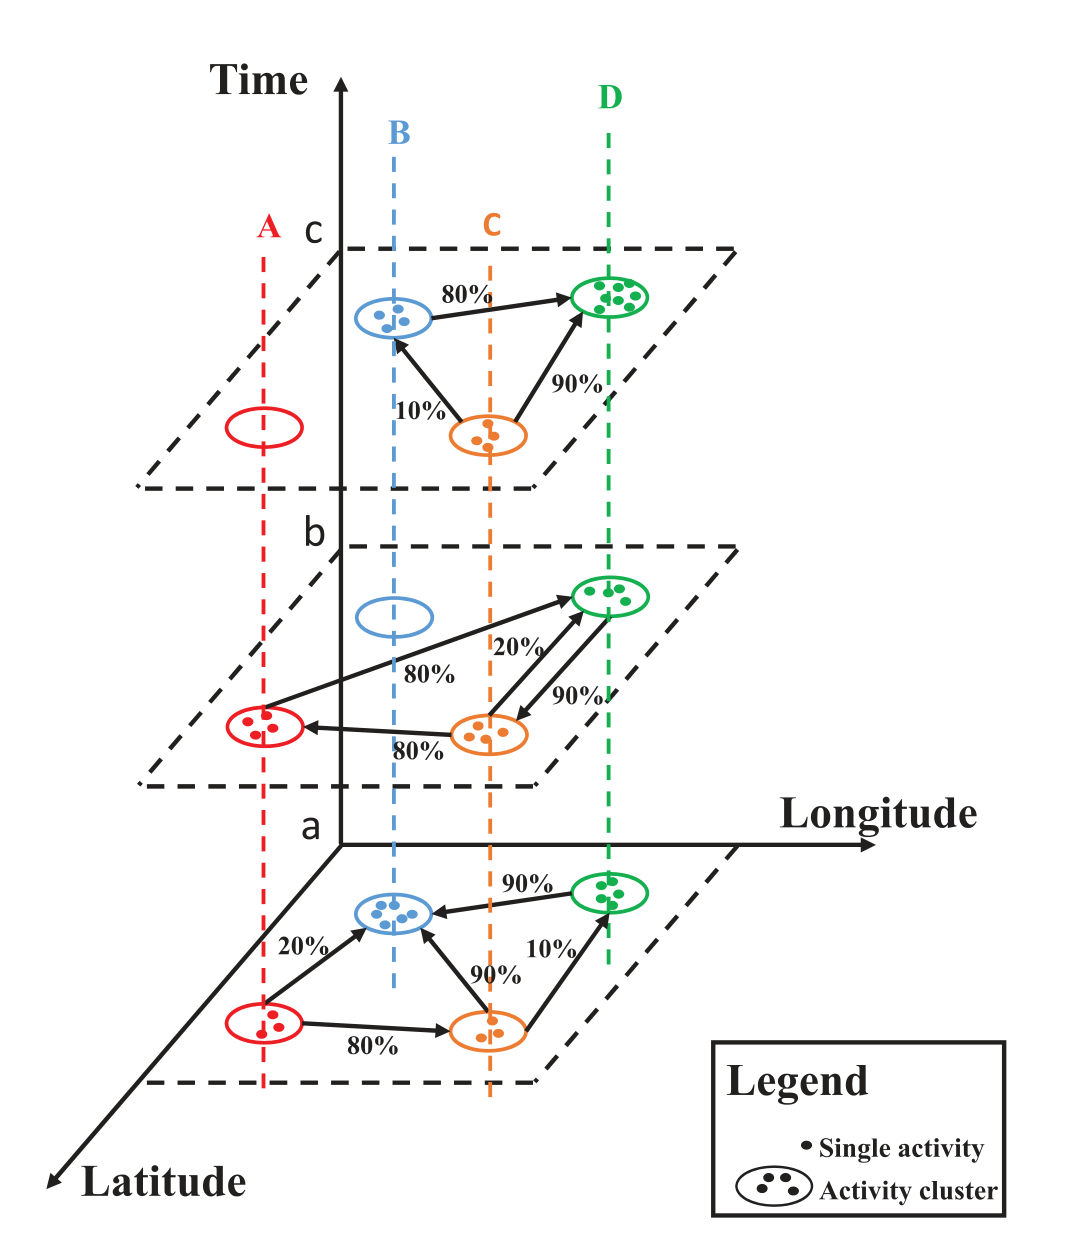
图 8|同一个地点,为什么在不同钟点会有不同的下一站?
无 (a)(b)(c) 子图。图中的 a、b、c 是时间层,A、B、C、D 是地点。正文给出的例子是:在时间 a,从 C 到 B、D 的概率为 90% 和 10%;在时间 c,这两个方向变为 10% 和 90%;在时间 b,从 C 到 A 为 80%,另外两个时间层没有到 A 的转移。图上还标有 20%、80% 等箭头。这些百分比都是示意图中的例子,分母是该时间层上从相应地点出发的示意转移。表 2、表 3 的实测比例另行给出。来源:原论文 Fig. 8。
给定当前地点 M,每个时段各取转移概率最大的下一地点。簇内各次到达可以相差十几分钟,例如晚上 8 点前后 10 到 15 分钟;模型把这样短的一段时间当成一个时间点来描述。预测因此回答的是这个时段最可能去哪个簇。
谁的活动在换,谁的活动看起来很稳
作者把单次活动放到三维场景里:平面是北京主要道路上的经纬度,高度是一天中的分钟,颜色表示年份,红为 2012,蓝为 2007。总高度对应 24 小时的分钟数乘以年数。他们把频繁、持续重访、在图上呈竖线的位置叫做地点。评估之所以选择 #153 和 #128,是因为两人代表两种典型形态,而且单次活动的时空分布比其他用户更多样。两人也是表 1 中活动次数最多的用户。
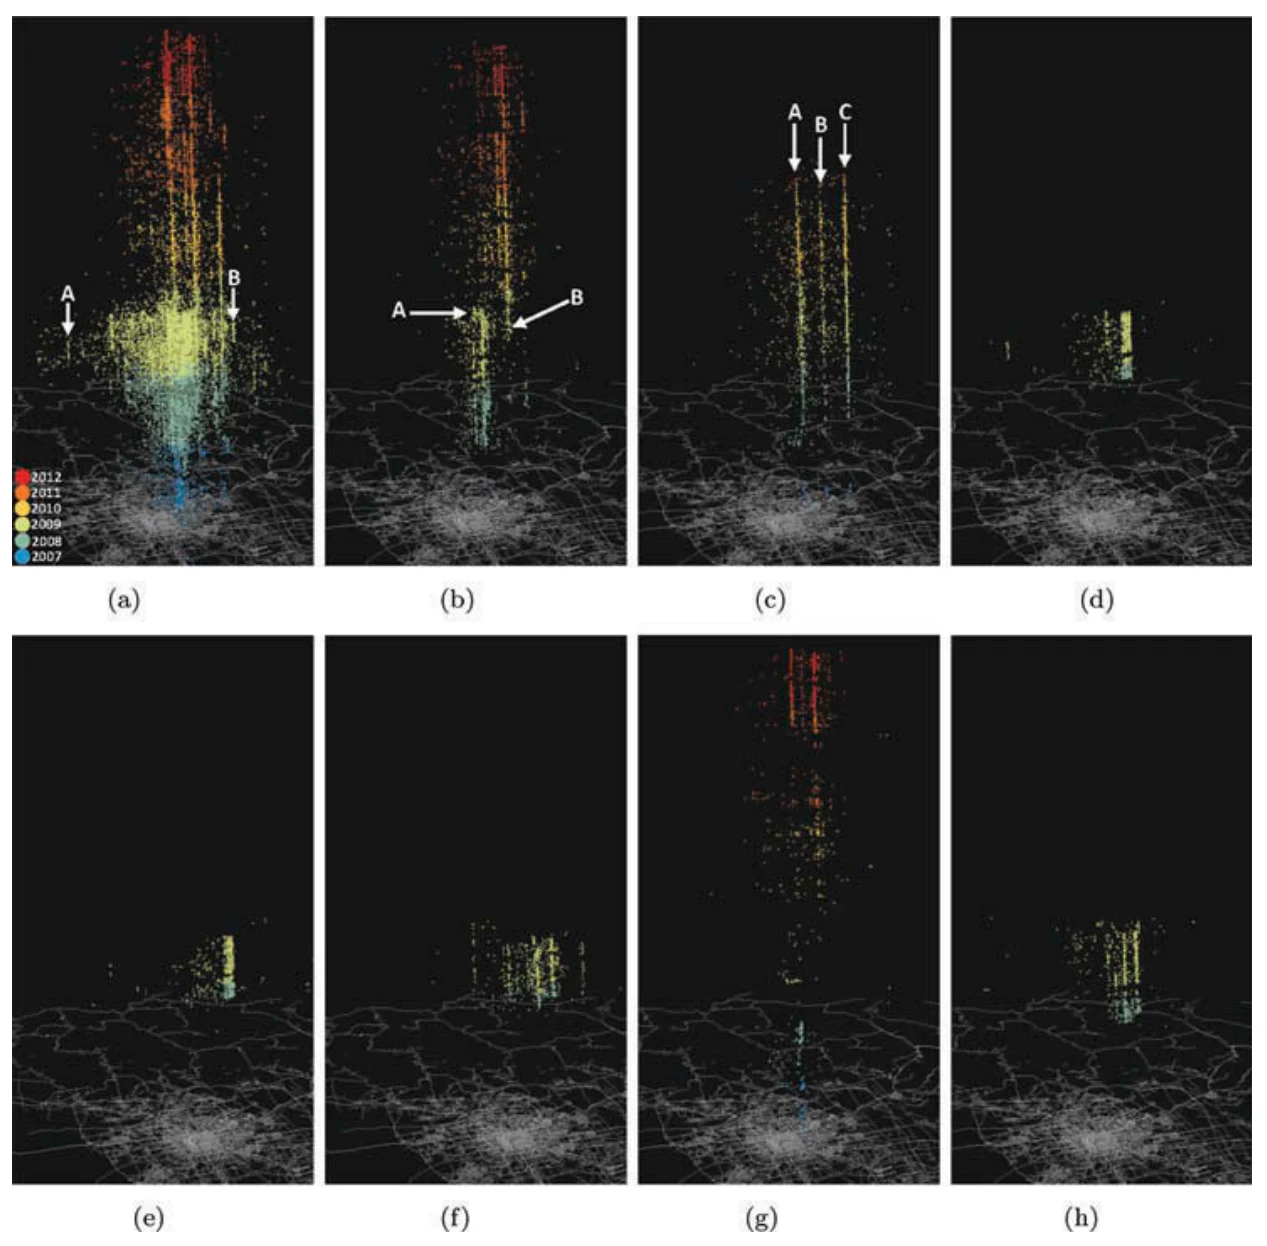
图 9|竖线代表的重复地点,会不会在年份之间换位置?
(a)全体用户。左下角色标由红到蓝对应 2012 至 2007。A、B 两处活动只在 2009 年的短时间里出现,来自不同用户,之后没有再访。作者认为 2008 和 2009 年的空间范围更大、密度更高,主要与北京奥运会及之后的场馆游览有关;文章没有统计场馆访问次数。(b)用户 #153。A、B 两处在 2009 年发生替换,正文把这看成定义 3 下的活动变化。(c)用户 #128。A、B、C 三处竖线持续存在,正文把这看成稳定形态。(d)用户 #4,(e)用户 #3。正文说两人的时空分布没有明显视觉差异。(f)用户 #17,(g)用户 #163,(h)用户 #68。这三张与(d)(e)同属活动次数超过 1,000 的用户,论文没有逐一给出地点数量。来源:原论文 Fig. 9。
到达时刻和停留时长的散点用来看这些竖线可能对应什么作息。纵轴是停留小时,横轴是北京时间的到达时刻。全体用户有两处大约 9 到 14 小时的停留:一处到达大约在上午 8:00 到 9:30,图中用黑圈标出;另一处到达大约在下午 6:00 到午夜 12:00,图中用红圈标出,其中大量点落在下午 6:00 到晚上 10:00。作者用日常作息解释这两处,认为晚上到达、停留较长的更像家,早晨到达的更像办公室或学校。图上没有家或办公室的标签,这个解释来自到达时刻和停留长度。
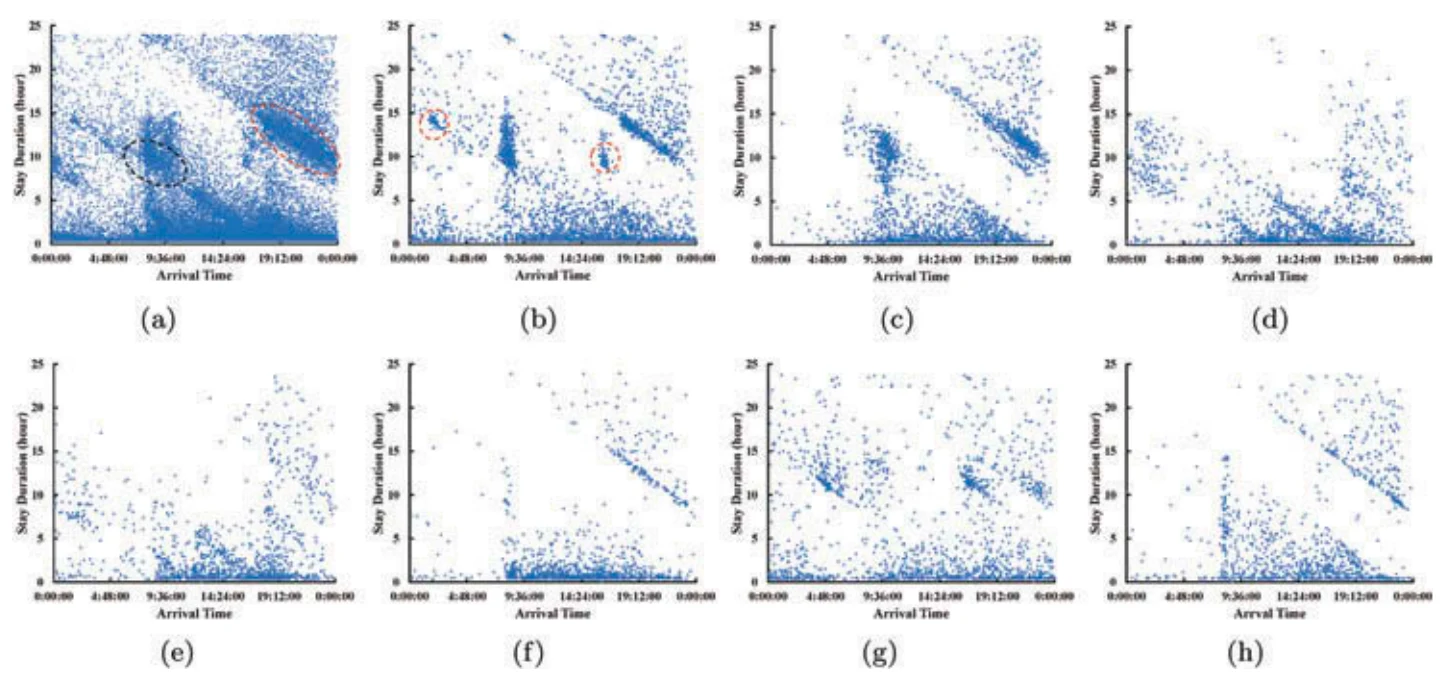
图 10|长时间停留集中在哪些到达时刻?
八张图的纵轴都是停留时长(小时),刻度到 25;横轴都是到达时刻。(a)全体用户,黑圈大约在早晨、红圈大约在傍晚到夜间,对应正文的 9–14 小时。(b)用户 #153,两个红圈标出大约 10 小时和 14 小时的另外两处到达。(c)用户 #128,(d)用户 #4,(e)用户 #3,(f)用户 #17,(g)用户 #163,(h)用户 #68。论文只解释了(a)和(b)的圆圈,没有报告各用户的相关或检验。作者还说图中 1 小时和 2 小时附近较密,并把它解释成用餐、上课或课余活动;这一解释依赖于“用户多在高校和研究所”这一推断。来源:原论文 Fig. 10。
五个活动簇里,哪些只是钟点不同
全体用户完成聚类后,作者按每个簇中单次活动数量的重尾,为 #153 和 #128 各取五个样本簇,并从 WGS84 投到 UTM 50N 带查看。横轴是东向米数,纵轴是北向米数,竖轴是一天中的时刻。各子图按簇缩放,坐标范围不一样,不能把某一小图里的点更散直接读成这个簇的空间不确定性更大。
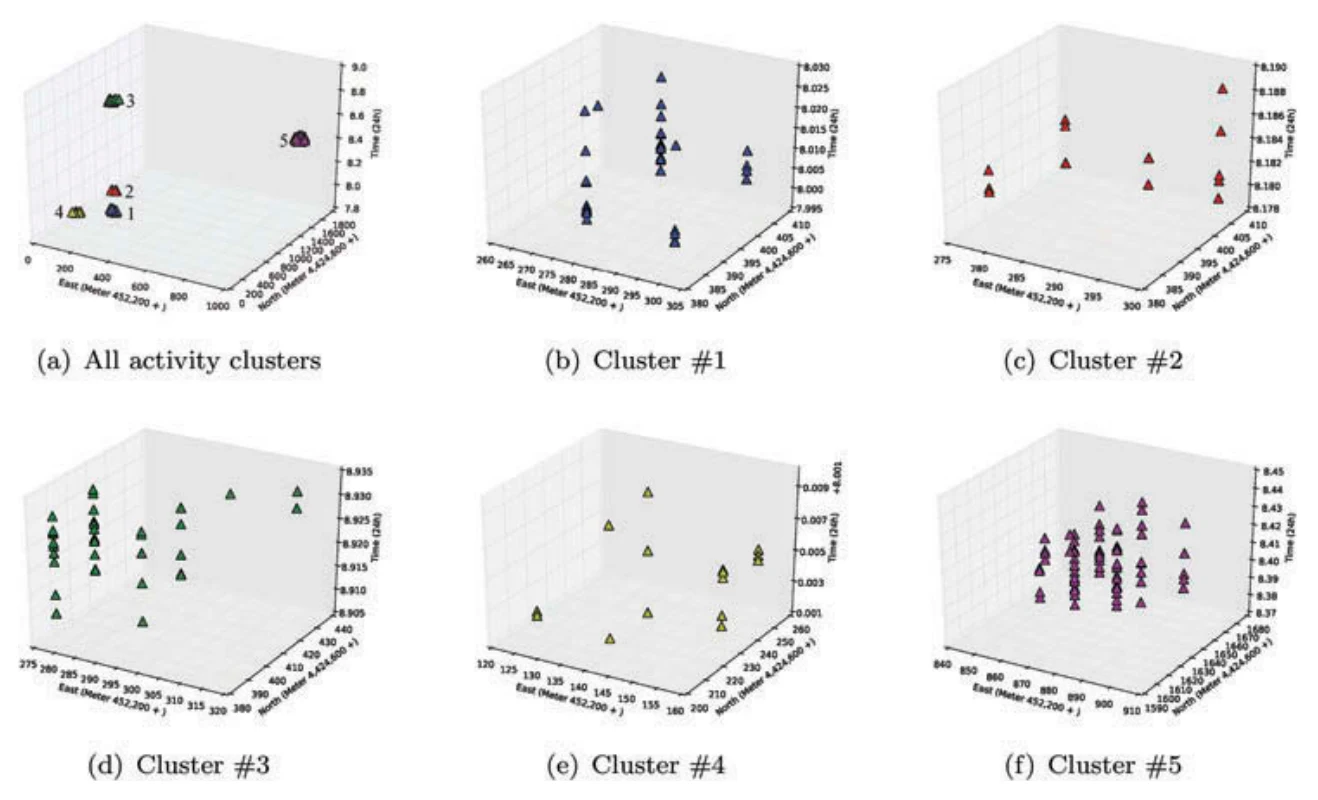
图 11|用户 #153 的五个簇是换地点,还是同一地点的不同时段?
(a)五个簇的相对位置,标号 1 到 5。(b)簇 #1,(c)簇 #2,(d)簇 #3,(e)簇 #4,(f)簇 #5。正文指出簇 #1、#2、#3 在同一地点、三个时段,既可以是一天三次回到同一处,也可以是班次时间变了而地点没变。簇 #4 按相似簇方法很可能与簇 #1 同类,因此可能发生过活动变化。簇 #5 的单次活动更密,表示该时段重访的机会高。图注写的是(b)–(e),图上实际标到(f);正文引用的是 Figure 11b–f。来源:原论文 Fig. 11。
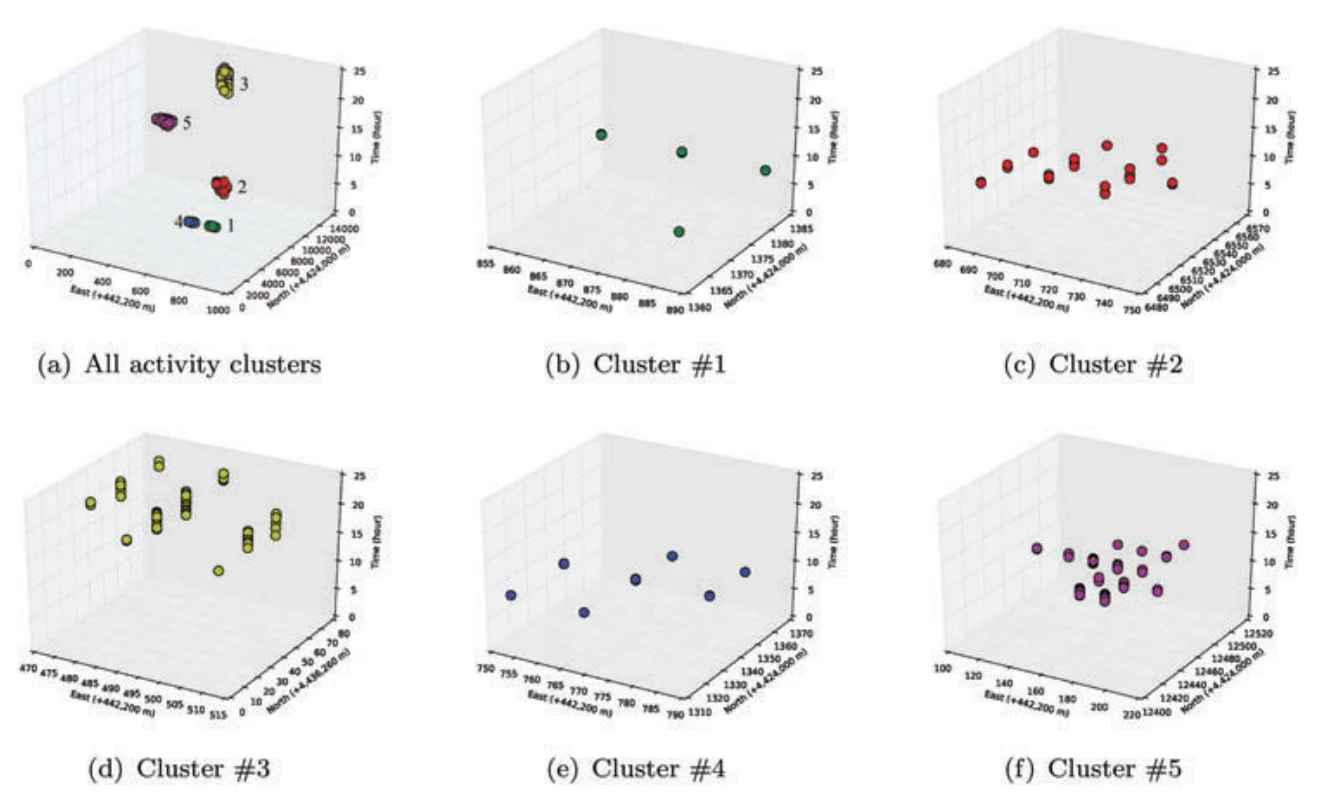
图 12|用户 #128 的五个簇有没有成对的地点替换?
(a)五个簇的相对位置。(b)簇 #1,(c)簇 #2,(d)簇 #3,(e)簇 #4,(f)簇 #5。正文说这些簇不像 #153 那样同一地点、不同时段叠在一起。簇 #1 和 #4 被判为相似,对应(b)和(e),单次活动不多。密度最高的是簇 #3 和 #5,它们没有相似簇,因此作者推断没有显著的活动变化,整体比 #153 稳定。图注写到(b)–(e),图上有(f)。来源:原论文 Fig. 12。
这两张簇图和前面的竖线图是同一对判断:#153 有可见的地点替换,#128 大体维持三处重复活动。它们仍是视觉和聚类规则下的判断,簇本身没有被标成家、办公室或体育馆。
概率更接近后来三个月,能说明什么
训练使用 2010 年 1 月至 2011 年 6 月的活动簇,分别在不做变化检测和运行算法 1 之后估计转移概率。2011 年 7 月至 9 月的活动簇之间的实际转移概率被当作对照。对照量是两段时间各自的转移概率。论文报告的 R² 建立在这些概率上,没有写出回归公式,也没有写出有多少条转移进入计算。表 2 和表 3 只列出从部分活动簇出发的转移,表的行数不能当作 R² 的样本量。
用户 #153 的表 2 里,每一格都是该行起点活动簇的出发转移中,去往指定簇的比例。三列分别是不做检测的训练期、算法 1 之后的训练期、2011 年 7–9 月。
| 转移 | 不做检测 | 算法 1 | 2011年7–9月 |
|---|---|---|---|
| A→B | 0.377 | 0.000 | 0.000 |
| A→C | 0.273 | 0.704 | 0.492 |
| A→D | 0.190 | 0.000 | 0.000 |
| A→E | 0.080 | 0.196 | 0.253 |
| A→F | 0.040 | 0.000 | 0.000 |
| A→G | 0.040 | 0.100 | 0.000 |
| A→H | 0.000 | 0.000 | 0.255 |
| B→A | 0.692 | 0.692 | 0.604 |
| B→F | 0.118 | 0.000 | 0.000 |
| B→F(new) | 0.070 | 0.188 | 0.198 |
| B→G | 0.120 | 0.120 | 0.000 |
| B→H | 0.000 | 0.000 | 0.198 |
从 A 出发时,不做检测的最大去向是 B,占 0.377。算法 1 把 A→B、A→D、A→F 都改为 0,测试期这三项也是 0。作者把 B、D、F 解释为已经变化的活动簇:它们在训练早期次数可以很高,却不该继续参与预测。概率被集中到剩下的去向之后,A→C 从 0.273 升到 0.704,测试期是 0.492。与测试期的绝对差从 0.219 变为 0.212。检测去掉了测试期已经为 0 的去向。保留下来的单项概率仍可偏离测试值。
A→H 在两种训练结果里都是 0,测试期却占 A 的出发转移的 0.255。H 是 2011 年 7 月之后才进入到访簇的新地点,训练样本里无法检测。B→H 同样是训练期 0、测试期 0.198。新地点只有出现在训练窗之内,地点替换才有对象。
B→F(new) 是成功对上的相似簇:不做检测为 0.070,算法 1 为 0.188,测试期为 0.198。作者认为 F 与 F(new) 对应图 11(a)的簇 #1 和 #4。正文把算法 1 的结果概括成 0.19、并把对照写成 0.12;表中 B→F(new) 的对照是 0.070,0.120 是 B→G 在检测前后的概率,而 B→G 的测试期是 0.000。读数以表 2 为准。B→G 保持 0.120,说明相似簇更新没有去掉所有后来消失的去向。
用户 #128 的表 3 用同样的三列和同样的分母口径。
| 转移 | 不做检测 | 算法 1 | 2011年7–9月 |
|---|---|---|---|
| A→B | 0.843 | 0.843 | 0.900 |
| A→C | 0.157 | 0.157 | 0.100 |
| B→A | 0.155 | 0.155 | 0.100 |
| B→C | 0.745 | 0.745 | 0.702 |
| B→D | 0.000 | 0.000 | 0.099 |
| B→E | 0.050 | 0.000 | 0.000 |
| B→E(new) | 0.050 | 0.100 | 0.099 |
A→B、A→C、B→A、B→C 在检测前后完全相同。稳定格局下,大多数概率本来就不用改。仍有一处短时段变化:B→E 从 0.050 改为 0,B→E(new) 从 0.050 改为 0.100,测试期分别为 0.000 和 0.099。B→D 只发生在 2011 年 7–9 月,训练期两种结果都是 0,测试期为 0.099。整体稳定的用户仍可以有局部替换,也可以有训练窗里根本没出现的新去向。
对应的 R²,以 2011 年 7–9 月的转移概率为参照:不做检测时,#153 为 0.295,#128 为 0.965;使用算法 1 后,#153 为 0.762,#128 为 0.971。#153 提高 0.467,#128 提高 0.006。这两个差是 R² 的差。由于论文没有公布转移条数和公式,不能把 0.762 读成 76.2% 的下一站被猜中,也不能把 0.467 读成命中率提高了 46.7 个百分点。
这套比较能说到哪里
证据最强的部分,是两名高频用户在同一训练窗、同一测试窗上的前后对比。变化检测会把测试期已经消失的去向从概率里拿掉,并把相似簇的地点改成较新的地点,因此 #153 的概率向量明显更接近后来三个月。#128 原来就已经接近,检测只改动了 E 和 E(new) 这一对。
评估用户是看着时空图选出的两个人。R² 比较的是聚合后的转移概率,单次出行仍可能走向概率较低的地点。训练结束之后才出现的 H 和 D,预测概率保持为 0。A→C 被抬到 0.704,测试期只有 0.492,去掉旧去向的同时会把剩余概率放大。
聚类把最少点数设为 1,孤立停留也能成簇。20 分钟和 200 米来自既有经验,15 米来自接收器平均误差,时间半径是未报告数值的用户均值。马尔可夫链不使用更早的状态,也不区分星期几。作者在结论里写明,数据的时空覆盖限制了结果;若数据更好,可以按星期几预测,并用一年中同一时段来减少季节影响,还可能推断部分语义。这些比较文章没有做。文中也没有与混合马尔可夫链、移动马尔可夫链或隐马尔可夫模型在同一次训练测试划分上比准确度。
2008–2009 年的空间扩散被归因于奥运会,西北侧的密集被归因于高校和研究所。两者都是作者对地图的解释。活动次数超过 1,000 的另外五人出现在图 9 和图 10 中,没有进入表 2、表 3 那种概率对照。
一句话总结
先把已替换或已停用的活动簇改出转移之后,活动变化明显的用户在随后三个月的转移比例上更接近实际,活动稳定的用户几乎不必改;训练结束之后才出现的新地点,概率仍然是 0。
核心来源
- International Journal of Geographical Information Science 正式版,核对题目、作者、页码 1569–1587 与 DOI:10.1080/13658816.2015.1033421。正文图 1–12、表 1–3 都在这一版本中。
- 数据集说明见论文第 2 节所引微软 GeoLife 项目页面(http://research.microsoft.com/en-us/projects/geolife/)及 Zheng 等(2009)对轨迹规模的说明。
- 停留提取依据 Zheng 等(2009,2011);时空聚类依据 Ester 等(1996)的 DBSCAN;相似系数的形式来自 Tversky(1977),并通过 Chen 等(2011)的时空活动日记与长方形表示相连接。
作者介绍
以下只写论文署名机构,以及能从论文本身确认的分工。论文没有逐条列出作者贡献声明。
- Wei Huang:第一作者,署名为加拿大多伦多瑞尔森大学土木工程系。
- Songnian Li:通讯作者,同一学系,论文给出的邮箱是 snli@ryerson.ca。
- Xintao Liu:同一学系。
- Yifang Ban:瑞典皇家理工学院城市规划与环境系地理信息学方向。
论文致谢写明,工作由加拿大自然科学与工程研究理事会资助,课题号 RGPIN/250346-2011,并感谢 Arnold Yuan 与 Wai-Yeung Yan。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果服务的是“搬家之后下一周会去哪”,表 2 的聚合 R² 还太粗。#153 的提高,主要来自把测试期已经为 0 的 B、D、F 清出概率。可以另行规定:一旦检测出地点替换,只统计替换之后的前 10 次出发,看最大概率是否已经落在新地点。若新地点在训练期末尾只出现两三次,0.762 的整体吻合仍可能对应着这 10 次里继续猜向旧地点。这个切分能把“三个月比例更像了”和“刚换完地点的那几次猜对了”分开。
另一项直接的核对,是把同样的训练窗和测试窗用到另外五名活动超过 1,000 次的用户:#4、#3、#17、#163、#68。图 9 已经显示他们的竖线形态并不一样。若其中有人的 R² 几乎不变,0.467 的提升就属于 #153 这种可见替换;若有人同样大幅上升,变化检测才更像高频用户里的一般步骤。现在的两个人正好是活动最多、而且事先被看成一变一稳的对照,外推到其余 180 人还缺少这张表。