一个人隔多久再发下一条消息,能用一条幂律概括吗?
论文名片|张天扬、崔鹏、宋朝明、朱文武、杨士强,A Multiscale Survival Process for Modeling Human Activity Patterns,PLOS ONE,2016,11(3):e0151473,2016年3月29日发表。DOI:10.1371/journal.pone.0151473。本文依据这一正式发表版及其补充材料解读。
群聊里常见这样一种节奏:几秒钟里连着发出两三条,然后几个小时不再说话。若把相邻两条消息的间隔放在一起,短间隔极多,长间隔拖出一条长尾。过去十年的人类动力学常把这条长尾写成幂律。幂律能描写“大多数回应很快、少数回应很久”,但一条直线往往只贴住中间那段。
这篇论文改问发生率:人已经等了 τ 这么久,此刻再发出下一条消息的倾向有多强。短等待、爆发段和很长的沉默,对应的发生率并不相同。把这三段写成同一个随 τ 下降、最后落到常数的函数,个体间隔分布可以在约五个数量级上同时对上,而不必先裁掉短间隔。
先说结论
- 单个在线聊天用户的消息间隔跨过大约五个数量级。幂律只近似覆盖中间段,大约 10² 到 10⁴ 秒;对这名用户,帕累托分布要裁掉约 30% 的短间隔才拟合得好。把帕累托用到总体时,即使裁掉 70%,通过统计检验的用户仍不到 10%。这句总体判断在正文里没有给出分母。
- 发生率写成 λ(τ) = λ₀ / ((τ/t₀)^α + 1) + λ₁。λ₀ 管短间隔,t₀ 是进入爆发段的临界尺度,α 管爆发段有多不均匀,λ₁ 管极长间隔的指数尾和平均间隔。
- 在线聊天里,两个月内记录超过 100 条的 26,648 名用户中,该模型在 5% 显著性下的 KS 通过率是 70.6%,平均 KS 统计量是 0.070。同一批用户、同一套全区间数据上,对数正态为 8.1% 和 0.145,韦伯为 1.7% 和 0.202,帕累托为 0.5% 和 0.281,泊松为 0.0% 和 0.713。把显著性放到 1%,模型的 KS 通过率升到 81.8%。
- 在这批在线聊天拟合里,t₀ 呈偏态对数正态,众数是 100 秒;α 呈偏态正态,平均值接近 1.45。作者猜想 t₀ 之后用户会离开当前话题,并写明这个猜想还需要另行检验。
一条幂律为什么要先丢掉短间隔?
间隔时间(interevent time)τ 是同一个人相邻两次行为之间等了多久。在线聊天里,两次行为就是这名用户先后发出的两条消息。概率密度 P(τ) 说的是间隔落在各个时长上的比例。幂律意味着在双对数坐标里,中间一段近似为直线。
图 1a 先看一名在线聊天用户。横轴是间隔秒数,纵轴是密度,两端都用对数。很短的间隔几乎落在一条平台上,中间才跟着一条下降的参考线,很长之后曲线明显弯折。图上把这三段标成短尺度、中尺度和长尺度,参考线标成 α = 1.4。正文说幂律大约只覆盖 τ 在 10² 到 10⁴ 秒的中间段;图注把区间写成闭区间 [10², 10⁴],并把指数写成 α = −1.4,同时又用 τ 的 −α 次方来称呼这条幂律。图中的参考线是向下的,和 α = 1.4 的标法一致,读成密度大致按 τ 的 −1.4 次方下降。图注里的负号和 “−α” 叠在一起时,符号并不自洽。
左下插图是同一名用户的生存率:等待时间长于横轴数值的比例。插图在 51.90 秒处加了竖线,并标出 38%。图注只说明它是生存率曲线,没有写 38% 的分子和分母。后文图 2a 把 51.90 标成这名用户的临界时间 t₀。38% 旁边另有 0.5 的纵轴刻度,所以不宜把 38% 直接读成“生存率等于 0.38”。
图 1b 问的是:若坚持用帕累托分布,要丢掉多少短间隔,KS 统计量才降到 5% 显著性的临界线以下。帕累托分布在这里的做法,是丢掉短于阈值 xₘ 的间隔,只在剩余部分上拟合幂律。横轴是被裁掉的比例,纵轴是 KS 统计量,越小表示经验分布和拟合分布越接近。红线是 5% 显著性下要通过检验的统计量上限;样本变少,这条上限会升高。正文对这名用户的结论是,大约裁掉 30% 之后幂律才拟合得好。把同一做法用到总体,即使裁掉 70%,通过检验的用户仍不到 10%。
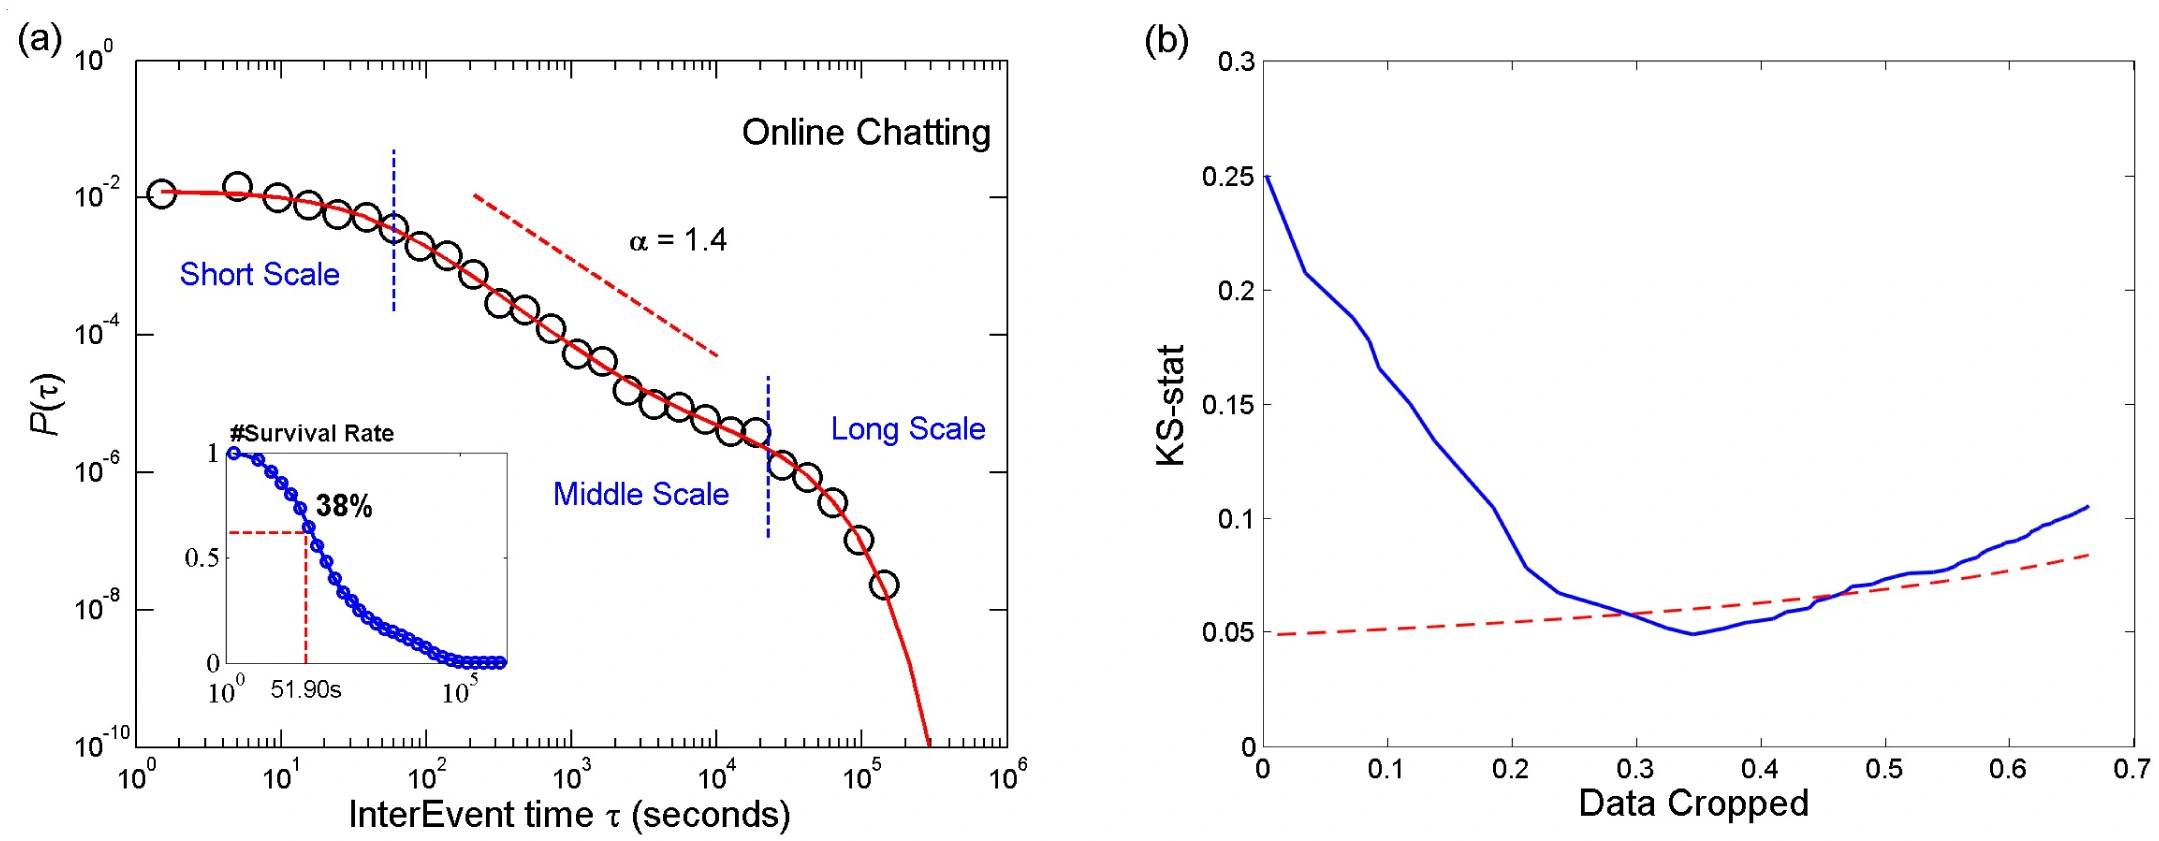
图 1|一条幂律能覆盖这名用户的全部消息间隔吗?
(a)一名在线聊天用户的间隔密度。黑圈是观测,横轴为秒、纵轴为密度,均为对数坐标。蓝色字标出短、中、长三个尺度;红色虚线标 α = 1.4,只沿中间段下降。左下插图是生存率,标有 51.90 秒和 38%。超过大约 10⁴ 秒后,密度向下弯折。(b)同一用户用帕累托分布拟合时,横轴是裁掉的短间隔比例,纵轴是 KS 统计量。蓝线先降后升,红虚线是 5% 显著性的通过阈值,并随剩余样本减少而上升。来源:原论文 Fig. 1。
中间段的幂律说明爆发段可以拉得很宽。几秒内的连发和数小时后的沉默落在这条直线两侧,需要一条随已经等待的时间改变的发生率。
三套记录量的是哪种间隔?
在线聊天来自腾讯 QQ 的群聊记录。QQ 当时覆盖超过 6 亿用户,这是平台规模。进入分析的是 50,000 个群、为期两个月的消息日志。摘要写 5,549,570 名用户,方法部分写 5,549,570 名群成员;每人有唯一 ID,并记录其发消息的全部时间戳。间隔按同一个人相邻两条消息计算。数据由腾讯按其条款提供,分析前已匿名,不能公开入库,研究者需联系作者并另行签约才能使用。
另外两套小数据用来对照,不进入后面那张大表。信件沿用既有通信研究的口径:爱因斯坦 28,511 封、弗洛伊德 6,944 封,并排除缺少日期或收发者的信件;正文没有再给出排除之后的剩余封数。这里计算的是回信等待时间,图 2d 的横轴是天。邮件来自一所大学环境中 3 个月内的 3,188 名用户、129,135 条收发记录。方法部分计算的是同一个人连续发出两封邮件的间隔;图 2c 的图注写成 Email reply。两处用词不同,正文没有解释它们是否指同一种间隔。
补充材料 S1 还定义了事件时间:用全体用户累计消息数把时钟重新拉开,使安静时段变短,以减弱大约 16 到 24 小时的昼夜空档。正文各图的横轴仍标成秒或天,也没有声明图中的 τ 已经换成事件时间。下文的 51.90 秒、100 秒和大约 6 小时,都按正文和图上的坐标理解。
活跃用户有单独门槛。模型比较使用两个月内记录超过 100 条的 26,648 人,通过率的分母就是这 26,648 人。5,549,570 名群成员和平台上的 6 亿用户是另外两个口径。发言不超过 100 条的人没有进入这张成绩表。
为什么先写发生率,再写间隔分布?
生存分析把“还要继续等”和“此刻恰好行动”连在一起。生存函数 S(τ) 是等待时间长于 τ 的概率,也就是 P(τ) 从 τ 积到无穷的互补累积。发生率 λ(τ) 是已经等到 τ、在紧接着的一小段时间里行动的条件倾向。二者的关系是:S 对 τ 的导数等于 −λ(τ) S(τ)。解出来,S(τ) = exp(−∫₀^τ λ(t) dt)。密度则是
P(τ) = λ(τ) × exp(−∫₀^τ λ(x) dx)。
这个式子先解决一个比较:同样一组间隔,是用一个不随时间变化的发生率去解释,还是允许发生率随已经等待的时间改变。发生率是常数时,得到的就是泊松过程的指数间隔。λ(τ) = γ/τ 时,密度正比于 τ 的 −(1+γ) 次方。λ(τ) = γ/τ^α 且 α < 1 时,可以回到韦伯分布。这些都是特例,各自只覆盖有限的时间段。
为了让短、中、长三段进入同一个函数,论文使用
λ(τ) = λ₀ / ((τ/t₀)^α + 1) + λ₁。
四个参数都是个人参数。τ 远小于 t₀、并且 λ₀ 远大于 λ₁ 时,分母接近 1,发生率接近 λ₀:λ₀ 越大,很快再次发言的倾向越高。t₀ 是高度不均匀的爆发段开始占主导的临界尺度。α > 0 越大,爆发段越不均匀。τ 很大时,发生率趋向 λ₁;指数尾和一个人的平均间隔主要由它决定。论文同时写出,拟合得到的 λ(τ) 随 τ 单调下降。
估计时,把这名用户观察到的间隔 τ₁…τₙ 放进似然。每个间隔贡献 S(τᵢ) λ(τᵢ),再对四个参数最大化对数似然。这是用同一个人的全部间隔估计他的分布。后文的 KS、卡方和克拉默–冯·米塞斯检验,比较的是这条拟合曲线和同一批间隔,属于样本内拟合优度。
四名随机选出的人,短中长三段能同时对上吗?
图 2 各取一名随机选出的人。黑圈是观测密度,红线是上述发生率推出的密度。左下插图是发生率对等待时间,右上插图是半对数坐标下的尾部。
两名聊天用户的横轴都是秒。图 2a 的临界尺度标成 t₀ = 51.90,中间参考线斜率标成 −1.35。图 2b 是 t₀ = 49.09,斜率 −1.53。邮件用户图 2c 仍以秒为横轴,t₀ = 103.78,斜率 −1.20。信件用户图 2d 以天为横轴,t₀ = 13.74,斜率 −1.54。这些斜率是密度图上的参考直线,正文没有把它们定义成模型参数 α。α 出现在发生率的分母里;密度在中间段的对数斜率还经过生存函数的指数项,二者不必相等。
四个人的红线都从短间隔的平台,经过一段下降,再在长间隔处加速下落。右上插图在半对数坐标里呈现这段下落,对应指数尾。正文举例说,在线聊天数据上这种截断大约从 6 小时开始,远短于两个月的记录长度,因此把它归为活动本身的尺度,而不是观测窗口太短造成的截断。左下插图里,发生率随等待时间下降,并在长等待处变得很平,和 λ₁ 是一条水平渐近线一致。
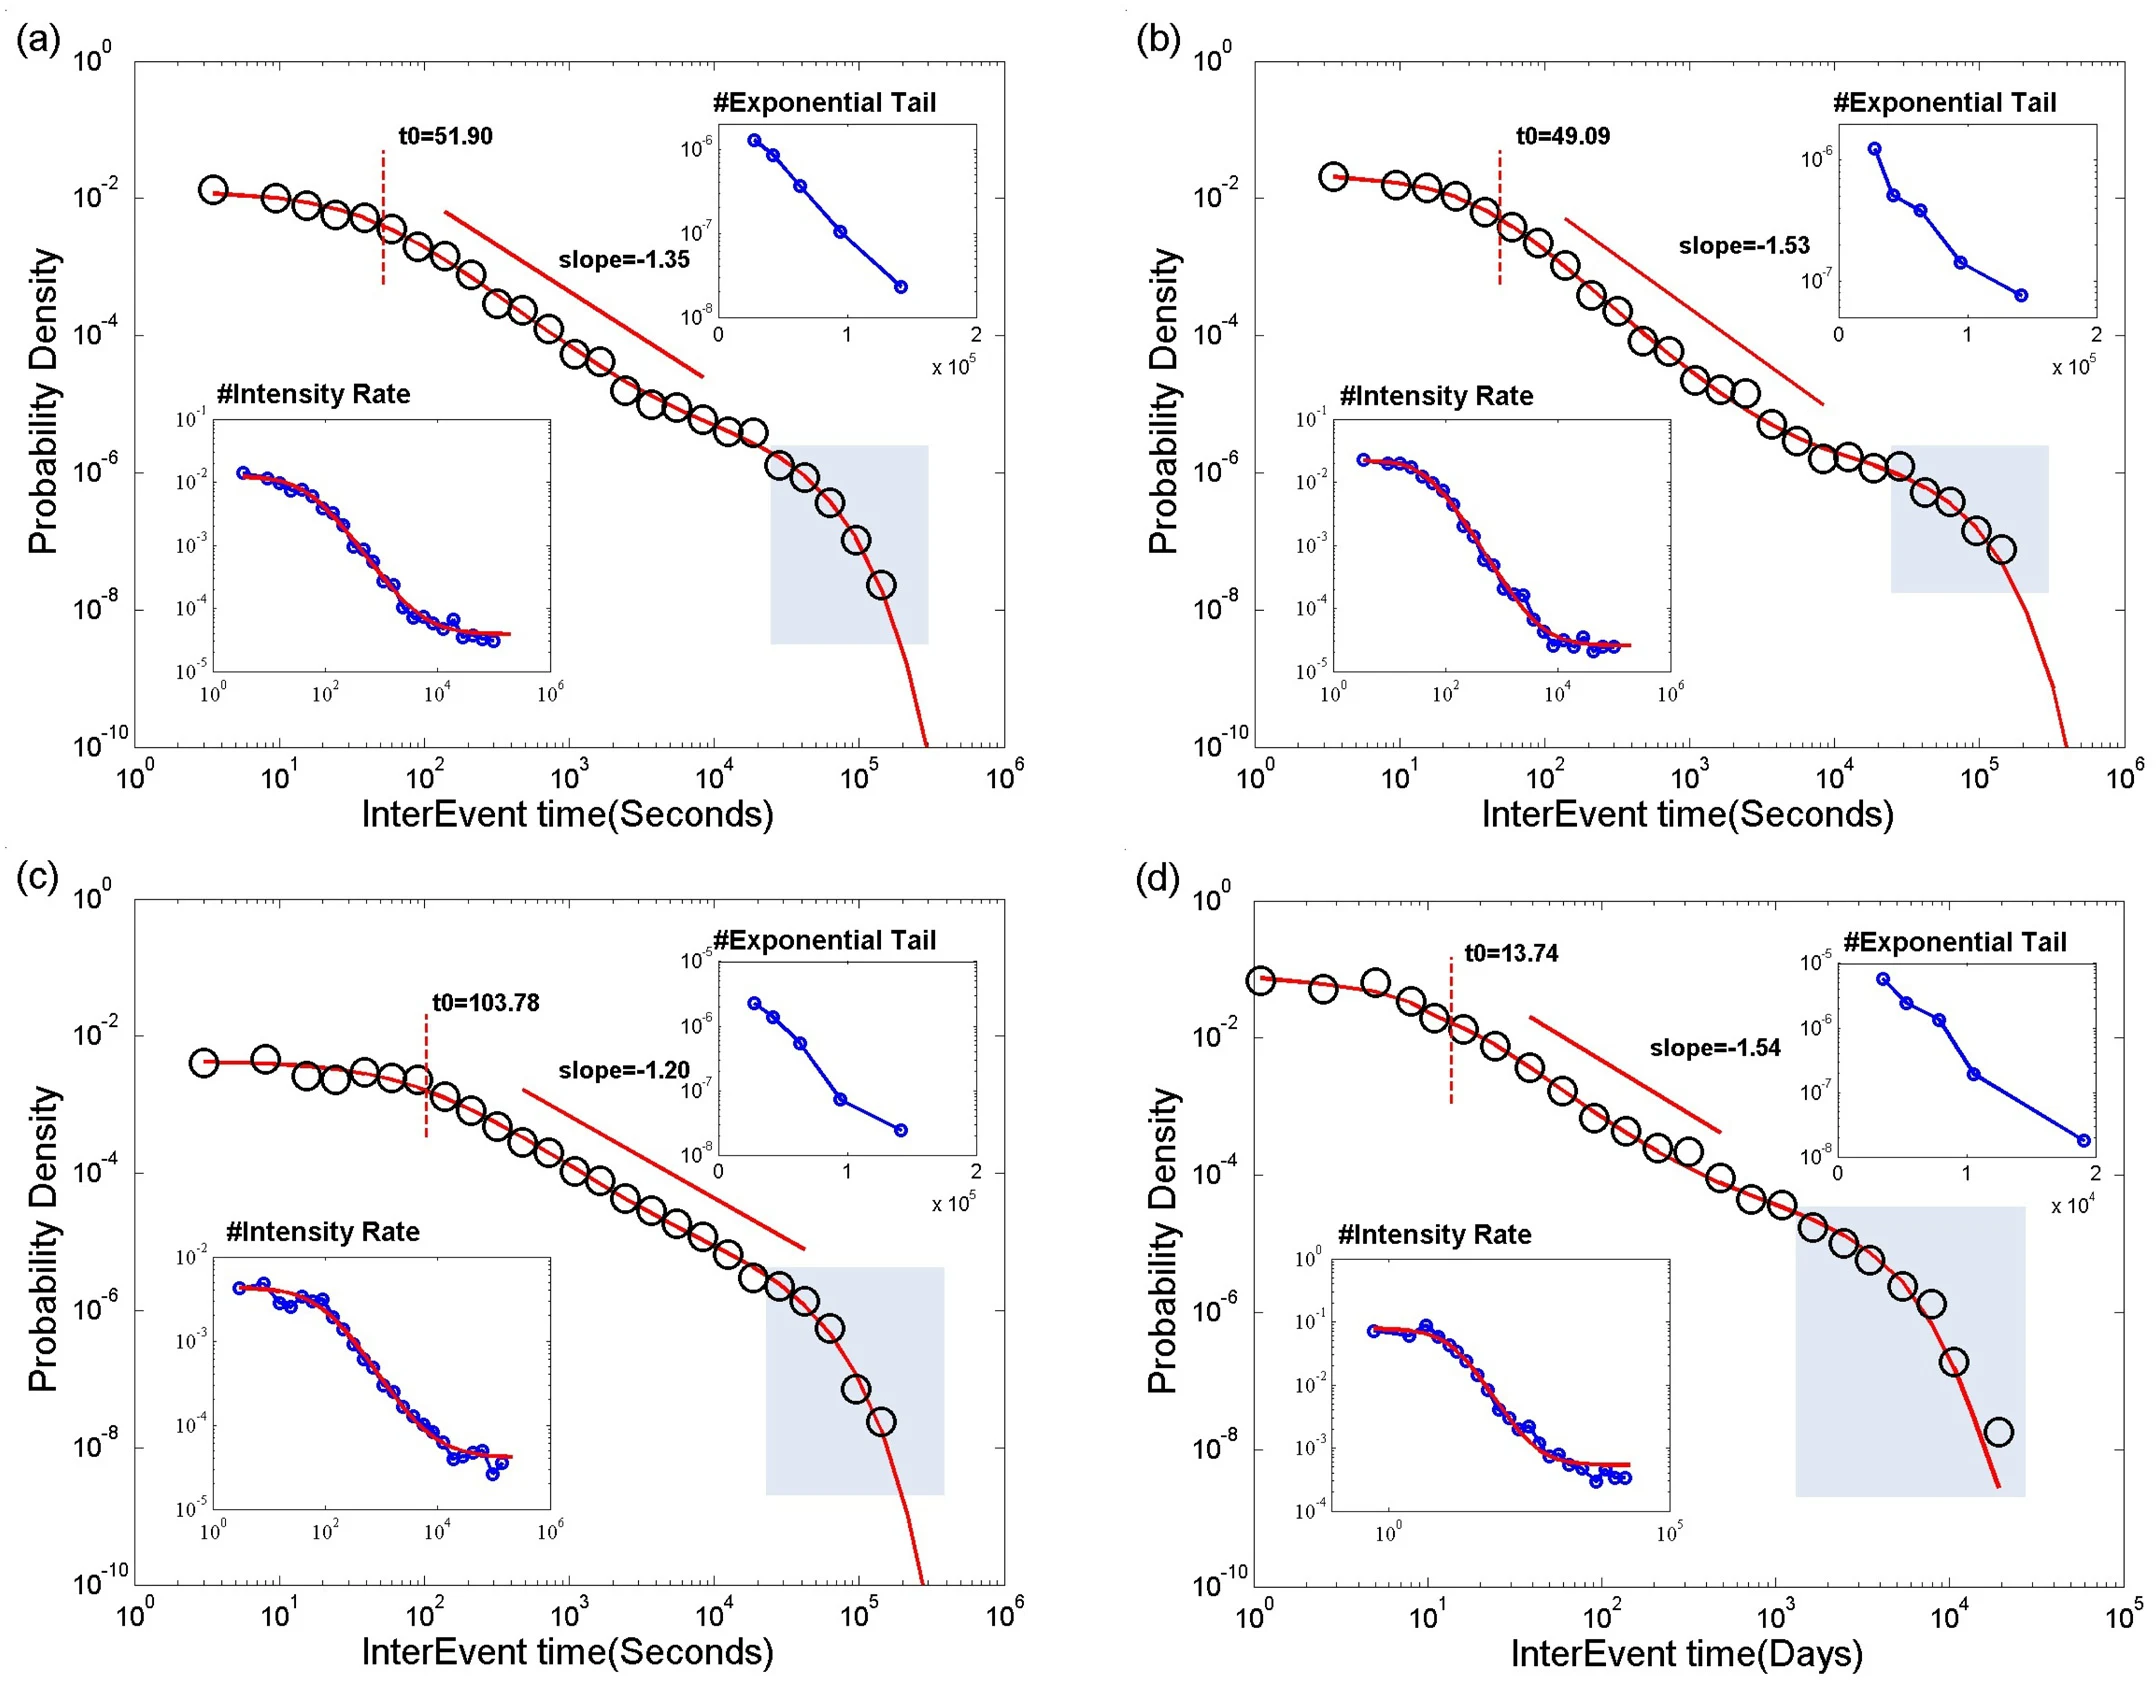
图 2|四名随机选出的人,一条发生率曲线能否同时对上短、中、长间隔?
(a、b)两名在线聊天用户,横轴为秒。黑圈为观测密度,红线为模型。图上标出 t₀ = 51.90、斜率 −1.35,以及 t₀ = 49.09、斜率 −1.53。(c)一名邮件用户,横轴为秒,t₀ = 103.78,斜率 −1.20。(d)一名信件通信者,横轴为天,t₀ = 13.74,斜率 −1.54。四张图的右上插图是半对数坐标下的指数尾,左下插图是发生率随等待时间下降并趋于平缓。来源:原论文 Fig. 2。
四个人说明模型的形状可以在聊天、邮件和信件三类记录里出现。他们是随机个例。人群通过率只在下一步的在线聊天活跃用户中计算。
26,648 名活跃用户里,通过检验的是多少人?
检验对象是两个月内记录超过 100 条的 26,648 名在线聊天用户。每名用户用自己的间隔做拟合,再做三种检验,显著性水平都取 5%。平均统计量表示经验分布和拟合分布的偏差大小,越小越好。通过率是这 26,648 人中、在该水平上没有被拒绝的比例。它衡量的是分布拟合,不衡量逐条消息是否被猜中,也不衡量用户是否活跃。
| 模型 | KS 平均统计量 | KS 通过率 | 卡方平均统计量 | 卡方通过率 | 克拉默平均统计量 | 克拉默通过率 |
|---|---|---|---|---|---|---|
| 泊松 | 0.713 | 0.0% | 8445.5 | 0.0% | 79.43 | 0.0% |
| 帕累托 | 0.281 | 0.5% | 612.91 | 0.0% | 19.91 | 0.5% |
| 韦伯 | 0.202 | 1.7% | 402.89 | 1.9% | 5.46 | 2.0% |
| 对数正态 | 0.145 | 8.1% | 216.24 | 3.7% | 2.16 | 8.0% |
| 本文模型 | 0.070 | 70.6% | 67.99 | 51.3% | 0.66 | 76.54% |
分母都是 26,648 名活跃用户,比较的都是不另作裁剪的全区间间隔。泊松在三种检验里的通过率都是 0.0%,因为它给不出重尾。帕累托、韦伯和对数正态能产生重尾,但一种固定形状仍要同时迁就短间隔和长尾,全区间通过率最高的对数正态也只有 KS 8.1%、卡方 3.7%、克拉默 8.0%。本文模型的 KS 通过率是 70.6%,卡方是 51.3%,克拉默是 76.54%。三种检验的高低并不相同:同一批拟合,卡方比 KS 更苛刻。只把显著性改到 1% 时,正文报告模型的通过率升到 81.8%;这句话紧接在 KS 的 70.6% 之后,没有同时给出另外两种检验或四个基线在 1% 下的通过率。
未通过的情形,正文主要归因于数据稀疏,并认为观测更多记录后拟合会更准。这里没有给出“稀疏”的条数界限,100 条已经是进入检验的最低门槛。
删掉短间隔之后,旧分布会不会追上来?
表 1 回答的是全区间。图 3 改问另一个问题:若从短的一端不断丢掉间隔,帕累托、韦伯和对数正态的平均 KS p 值会怎样变化。p 值越高,表示越不容易拒绝该拟合。横轴是裁掉比例,红点线是本文模型在不裁数据时的平均 p 值,所以它是水平线。蓝线是帕累托,橙线是韦伯,绿线是对数正态。图 3a 是在线聊天,图 3b 是邮件。正文没有给出邮件图里参与平均的用户数。
正文的读法是:平均 p 值随裁剪上升,裁到大约 30%–40% 之后相对平稳。帕累托在完整数据上最差,裁掉大约 30% 的短间隔后明显改善。对数正态较稳,并在较短和较长的尺度上优于帕累托。红线位于这些基线的完整数据结果之上,这是“不裁数据的模型”相对“全区间基线”的优势。
图上还有表 1 没有写成数字的比较。继续提高裁掉比例后,聊天数据的绿色对数正态、邮件数据的橙色韦伯会升到红色水平线以上。也就是说,大量丢掉短间隔之后,某些旧分布在剩余区间上的平均 p 值可以高于未经裁剪的模型。正文没有报告这些交叉点的精确横轴位置,也没有把模型同样裁掉短间隔后再检验。因此,图 3 支持的是全区间拟合的比较;它同时表明,裁掉短间隔会换成另一个问题。
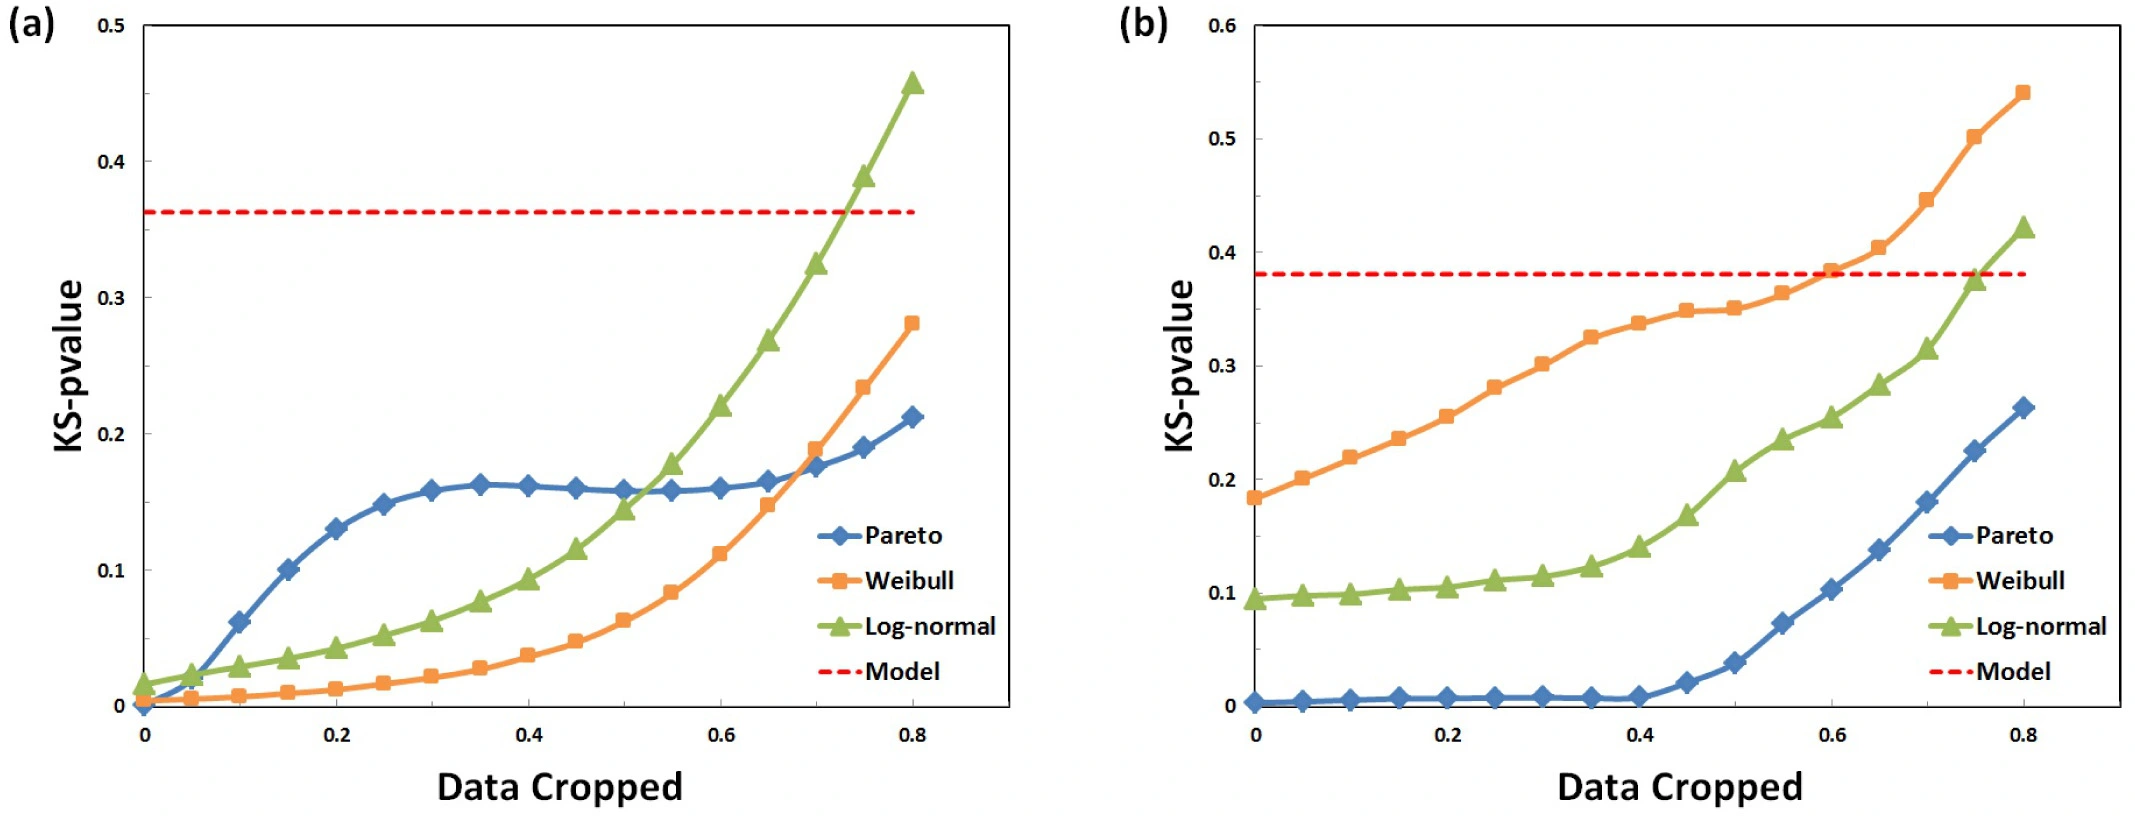
图 3|丢掉短间隔后,旧分布的拟合优度如何变化?
(a)在线聊天。横轴为裁掉的短间隔比例,纵轴为平均 KS p 值。蓝线帕累托、橙线韦伯、绿线对数正态都随裁剪上升;红点线是模型不裁数据时的平均 p 值。(b)邮件数据,坐标含义相同,纵轴刻度高于(a)。两图在高裁剪比例处,都有基线升到红线之上。来源:原论文 Fig. 3。
四个个人参数在人群里怎样分布?
图 4 是在线聊天数据上 λ₀、t₀、λ₁ 和 α 的直方图,纵轴是人数 N,刻度到 500。它接在活跃用户的拟合之后;λ₁ 小值一端的截断,被作者明确归因于去掉了不活跃用户。
λ₀ 在对数横轴上接近对数正态,图中刻度从 10⁻³ 到 10⁻¹,主体集中在 10⁻² 附近。它主要影响短间隔所占的比例。作者由此推断,用户之间的短时回应比较稳定,快速回应的比例也接近正态。这里的 λ₀ 是发生率参数。作者所说的“快速回应比例接近正态”,是从 λ₀ 的分布作出的推断;图 4a 的横轴就是 λ₀。
t₀ 是偏态对数正态。正文给出的众数是 100 秒,图 4b 的横轴从 10⁰ 到 10³,峰值就在 10² 附近,和 100 秒对齐。作者的读法是:对大多数人,幂律型的活动动态要在一段相对较长的时间之后才占主导。他们猜想,t₀ 是一个人还停在当前话题上的时间尺度,τ 大于 t₀ 后开始失去兴趣并转到其他话题。数据里没有话题标签,正文把这句话写成待检验的假设。
λ₁ 被描述为带小值截断的对数正态,并与平均间隔有强相关。正文没有给出相关系数。图 4c 的横轴从 10⁻⁵·⁵ 到 10⁻³·⁵,直方图在左端直接截断,没有向更小数值延伸的尾巴。λ₁ 的数值整体小于 λ₀ 的 10⁻³ 到 10⁻¹,和“长时发生率远小于短时发生率”的模型设定同向。坐标轴没有再标明每秒还是其他时间单位。
α 是偏态正态,平均值接近 1.45。图 4d 的横轴从 0 到 3,质量主要落在 1 到 2 之间,并向更大的 α 拖出长尾。作者认为这与可变队列长度的排队模型所预测的指数相一致。那个经典预测指的是间隔密度的幂律指数,固定队列常为 1、可变队列常为 1.5。本文的 α 是发生率函数里的指数,图 2 上的密度斜率又是另一组标注。接近 1.45 是作者给出的数量级对照。数据里没有队列长度,这篇论文没有直接检验排队模型。
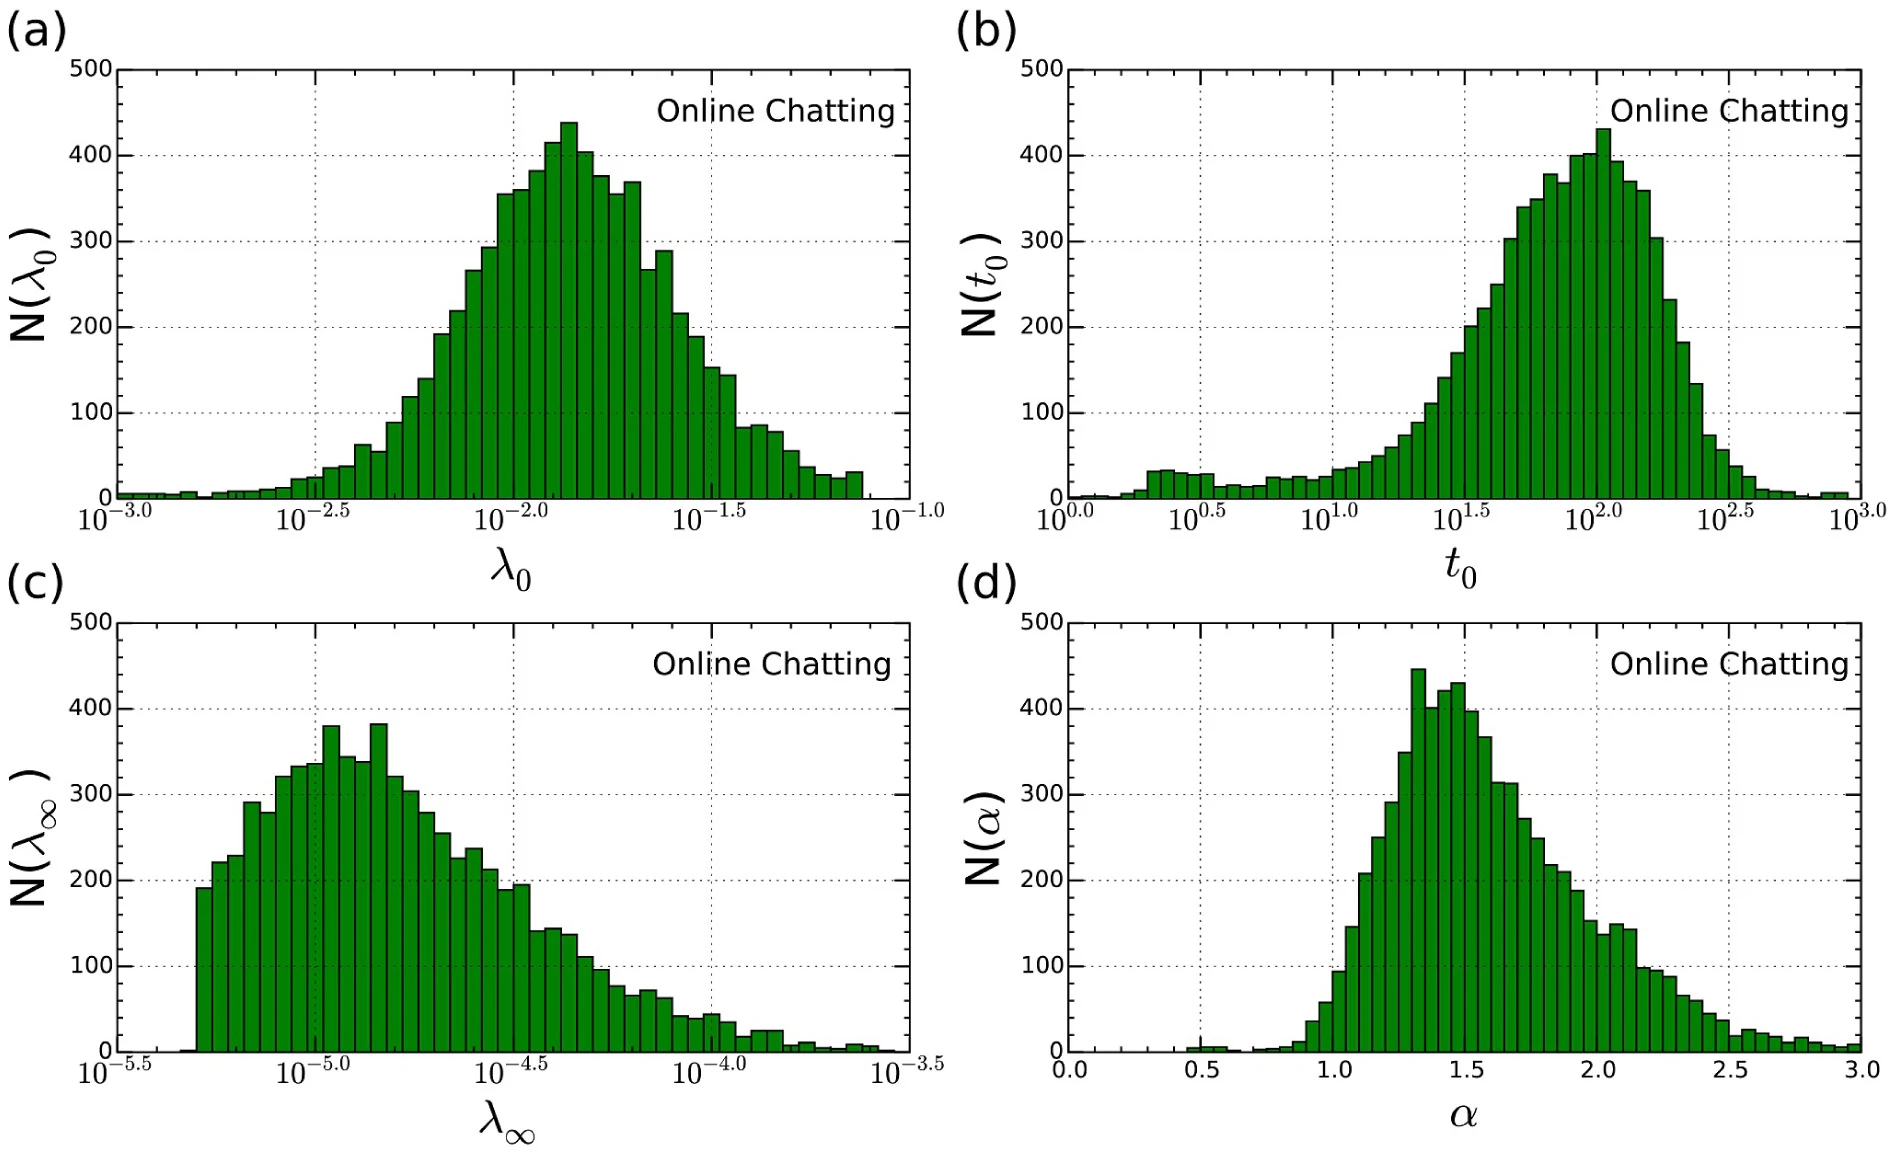
图 4|在线聊天用户的四个个人参数如何分布?
(a)λ₀,对数横轴刻度约从 10⁻³ 到 10⁻¹,分布接近对称的对数正态。(b)t₀,对数横轴从 10⁰ 到 10³,峰值在 10² 附近;正文给出的众数是 100 秒。(c)λ₁,对数横轴从 10⁻⁵·⁵ 到 10⁻³·⁵,左端截断。(d)α,横轴从 0 到 3,主体在 1 到 2 之间并向右偏斜;正文说平均值接近 1.45。四张图的纵轴都是人数,上限刻度为 500。来源:原论文 Fig. 4。
这些拟合能说明到哪一步?
模型对上的是每个人的间隔分布。它表明一个随等待时间下降、最后趋于常数的发生率,足以在短平台、中间下降段和指数尾之间连续过渡。它没有测量话题是否在 t₀ 处切换,也没有测量任务队列里哪一件事先被处理。排队模型的指数 1 和 1.5 只作为 α 接近 1.45 的文献对照出现。
检验是样本内拟合优度。26,648 人里,KS 通过 70.6%,其余 29.4% 在 5% 水平上被拒绝;卡方通过率是 51.3%。没有被拒绝,只说明这条分布与该用户的间隔还相容。泊松通过率为 0.0%,说明常数发生率与这批群聊间隔不符。其他重尾分布是否成立,要看它们自己的通过率。
记录本身是群聊发言时间。同一个人若加入多个群,唯一 ID 会把他的发言时间戳收在一起,但正文没有分开群内连发和跨群发言。邮件方法部分写的是连续发信,图注写成回复;信件计算的是回信等待。图 2 对这三类记录各展示随机选出的个人。通过率的分母只保留前面的 26,648 名活跃群聊用户。
λ₁ 的小值截断来自去掉不活跃用户。用这四个参数的分布描述全部注册用户,会把两个月内发言不超过 100 条的人排除在外。补充材料提出的 16 到 24 小时昼夜空档,也没有作为钟点效应写进 λ(τ);λ 只依赖距离上一条消息已经过了多久。
一句话总结
一个人下一条消息隔多久,短间隔、中间的爆发段和很长的沉默不是同一条幂律;在 26,648 名两个月内记录超过 100 条的群聊用户中,四参数发生率让 70.6% 的人通过 5% 显著性的 KS 检验,同一分母下的对数正态是 8.1%,泊松是 0.0%。
核心来源
张天扬、崔鹏、宋朝明、朱文武、杨士强。A Multiscale Survival Process for Modeling Human Activity Patterns。PLOS ONE,2016,11(3):e0151473。DOI:10.1371/journal.pone.0151473。
张天扬,论文署名为清华大学计算机科学与技术系。作者贡献写明他参与设计实验,完成实验和数据分析,并参与写稿。
崔鹏,通讯作者之一,署名为清华大学计算机科学与技术系,邮箱 cuip@tsinghua.edu.cn。他参与设计实验和写稿。其实验室主页介绍的研究方向包括社会动态建模、网络表示学习,以及带因果约束的机器学习。
宋朝明,另一位通讯作者,署名为美国迈阿密大学物理系,邮箱 csong@physics.miami.edu。他参与设计实验和写稿。迈阿密大学物理系教师名录把 Chaoming Song 列在复杂性与生物物理方向;其公开论文包括人类移动性的可预测性和移动标度。
朱文武,署名为清华大学计算机科学与技术系。作者贡献写明他提供分析工具,并对文稿提出建议。
杨士强,署名为清华大学计算机科学与技术系。作者贡献同样是提供分析工具,并对文稿提出建议。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
群聊机器人若按泊松过程估计“平均几分钟来一条”,会把几秒内的连发和数小时的沉默揉成同一个发生率。本文把短时的 λ₀ 和长时的 λ₁ 分开。图 4 里 λ₀ 的刻度在 10⁻³ 到 10⁻¹,λ₁ 的刻度在 10⁻⁵·⁵ 到 10⁻³·⁵,两段几乎不重叠,典型位置大约相差两个到三个数量级。产品上可以分别为“秒回有多密”和“沉默后何时回来”设超时。这仍然只是间隔分布的拟合。t₀ 的众数是 100 秒,作者把“100 秒后换话题”留作未检验的假设;数据没有话题标签,超时规则测不到兴趣是否转移。
另一个界限是时钟。λ(τ) 只知道距离上一条消息过了多久,不知道现在是凌晨还是下午。补充材料专门提到,邮件和群聊的间隔分布常在 16 到 24 小时出现一个峰,对应下班到第二天回到办公室。若传播或客服模型只接入这条 λ(τ),夜间没有新消息时,等待时间会继续变长、发生率向 λ₁ 下降,但模型并不知道整个群体都在睡觉。要描述“夜里群是静的”,还需要一条依赖钟点的发生率,那已经超出这篇论文的拟合。