人已经挤在目的地时,流量还会只看规模和距离吗?
论文名片|Xiao-Yong Yan、Tao Zhou,Destination choice game: A spatial interaction theory on human mobility,Scientific Reports,2019,9:9466,2019年7月1日在线发表。收稿日期2019年3月29日,接受日期2019年6月20日。DOI:10.1038/s41598-019-46026-w。
国庆或春节,几个最热的景区已经排起长队。一个人若只比较景点有多有名、路有多远,仍会挤进去;他同时也会想到,去的人越多,住宿越贵,路上越慢。这篇论文要计算的是任意两个地点之间的人流量。引力模型(gravity model,也称重力模型)、介入机会模型(intervening opportunities model)和辐射模型(radiation model)都把每个人的目的地选择当成互不影响的决定。目的地选择博弈(destination choice game,DCG)把别人造成的拥挤写进同一个人的效用。
方向已经比较清楚。去掉目的地拥挤之后,均衡流量就是起点约束的引力模型。把拥挤加回去,三套主数据上的起讫流量重叠都更高,但只比双参数引力模型略高一截。距离分布和目的地吸引量分布给出的排序与流量重叠不同。
先说结论
- 均衡要求同一起点的人无论去哪一个目的地,效用都相同。在四个点的示意局中,加入目的地拥挤后,较弱目的地的到达从4人增至8人,较强目的地从24人降至20人;两个起点的人数仍是15人和13人。
- 用于数据的效用取对数形式,包含吸引力、几何距离、目的地总到达和该条路径上的流量。吸引力直接使用观测到的到达人数,参数在同一批流量上搜索,目标是索伦森相似指数最大。
- 阿比让、中国和美国三套数据的流量相似指数都是DCG最高。按图3纵轴读到两位小数,它比双参数引力模型大约高出0.02、0.03和0.02。该指数上限为1,表示每个被平均的起讫对都完全重合。
- 补充材料用九组数据比较两种分布,共18次两样本KS检验。DCG取得最小或并列最小统计量的有9次。流量重叠上的领先,和分布距离上的领先,是两项不同的比较。
四个点的局,拥挤怎样把人推开?
先看一个写明了人数的局,它帮助理解机制,是论文的示意图。地点1、2是起点,各有15人和13人。地点3、4是目的地,固定吸引力分别是20和10。从1到3、1到4、2到3、2到4的固定旅行成本是1、2、2、1。
含目的地拥挤的效用写成:吸引力减去到达人数的三分之一,再减去固定成本和这条路上的人数。均衡时,起点1的两条路效用都是4/3,起点2的两条路都是7/3。流量是11、4、9、4,所以地点3到达20人,地点4到达8人。15和13分别等于两个起点的流出,20和8分别等于两条到达之和。
拿掉目的地拥挤后,效用只剩吸引力、固定成本和路上人数。均衡流量变成13、2、11、2,效用分别是6和7。地点3到达24人,地点4只剩4人。三分之一这个系数只属于这张示意图。后面拟合数据时,拥挤的权重是另一个待估参数,形式也改成对数。
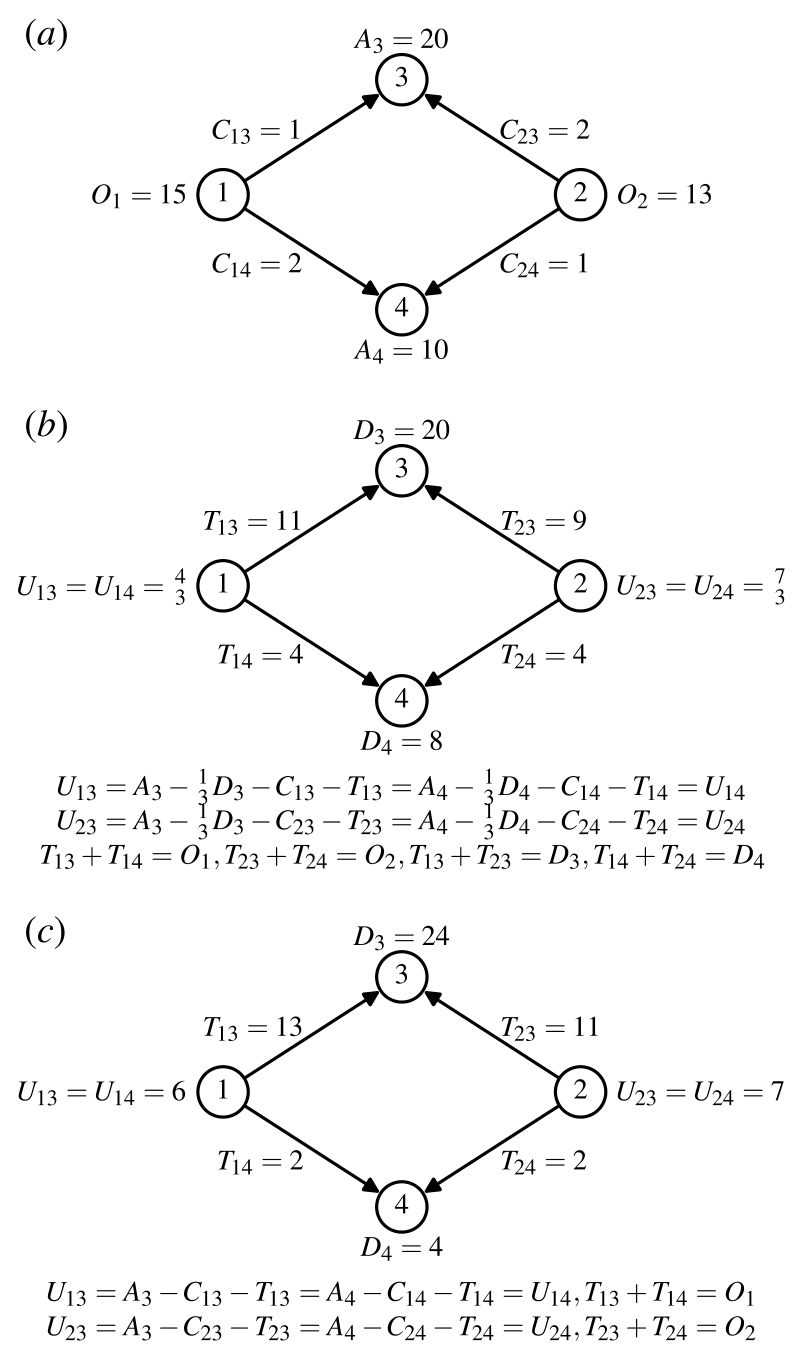
图 1|目的地拥挤会怎样改变同一个局的均衡流量?
(a)两个起点、两个目的地。圆圈旁是起点人数、目的地吸引力和固定旅行成本。(b)效用含目的地拥挤和路径拥挤。同一起点的两条路效用相等,较弱目的地到达8人。(c)效用去掉目的地拥挤。同一起点内部效用仍相等,较弱目的地到达降到4人。来源:原论文 Fig. 1。
这张图允许的结论很窄:在这组给定的人数、吸引力和成本下,目的地拥挤把一部分人从地点3推向地点4。它不能说明真实城市里热点会减少多少人,也不能代替后面的参数估计。
真正拿去拟合的效用,比较的是什么?
一个人从地点i去地点j的效用由四项组成:目的地固定收益、固定旅行成本、目的地拥挤,以及同一条路上的拥挤。收益随吸引力增加,两项拥挤成本随人数增加。地点j的模型到达量Dⱼ,是所有起点选择j的流量之和。
论文用韦伯–费希纳定律来选择函数形状:人对刺激的感受大约与刺激强度的对数成正比。于是收益写成α ln Aⱼ,目的地拥挤写成γ ln Dⱼ,路径拥挤写成ln Tᵢⱼ,系数固定为1。多方式交通里,旅行成本又常与距离近似成对数关系,所以固定成本用β ln dᵢⱼ。实用效用是:
Uᵢⱼ=α ln Aⱼ − β ln dᵢⱼ − γ ln Dⱼ − ln Tᵢⱼ。
α、β、γ都是非负参数。dᵢⱼ是地点代理位置之间的几何距离,是地图上的直线距离,计算里没有沿路里程、行程时间或费用。Aⱼ用该地点在真实数据中吸引到的人数近似。起点人数Oᵢ是从i出发的人数。模型把这些已知的流出分配到各个目的地,再让预测的Dⱼ与输入的Aⱼ可以不同。因此它是起点约束模型:每个起点的预测流出加总后回到Oᵢ,每个终点的预测到达却不必事先等于观测到达。
若每个人都知道全部信息,均衡使同一起点的所有被选目的地效用相等。流量要当成连续量,均衡才一定存在;人数很多时,这是近似。一般情形没有解析解,论文用相继平均法迭代。第一步先按不含拥挤的引力形式分配,随后用当时的Dⱼ更新流量,再与上一步各取一半平均。固定步长是0.5,相邻两步流量差的绝对值小于0.01时停止。
参数用网格搜索。α、β、γ各自从0取到10,步长0.01,选出使索伦森相似指数(Sørensen similarity index,SSI)最大的组合。SSI比较的是预测流量Tᵢⱼ和观测流量T′ᵢⱼ:
SSI=1/(N(N−1)) × Σᵢ≠ⱼ 2 min(Tᵢⱼ, T′ᵢⱼ) / (Tᵢⱼ+T′ᵢⱼ)。
完全重合时指数为1,预测与观测差得很远时接近0。分母N(N−1)是有序起讫对的个数,N为地点数,并且公式排除了起点与终点相同的项。某一对里若预测和观测都是0,分母也会变成0;正文没有说明这些对如何处理。搜索直接把SSI当作目标,评价又用同一个SSI,所以这是样本内拟合。多出来的参数γ只要能提高重叠,搜索就会留下它。
三套记录分别在数哪一种移动?
主文用三套数据。科特迪瓦阿比让的市内行程来自Orange用户匿名的通话和短信详单,位置用基站近似。中国城际出行来自新浪微博的匿名签到;同一地级市内的签到视为同一个地点,位置用城市中心。美国国内迁移来自所得税申报表上的跨年地址变化,分辨率到州,共51个单元,位置用州首府。论文给出的下载入口是美国国税局的税收迁移统计。三套数据里,每个地点都可以成为目的地。正文没有写出阿比让和中国数据的起止日期。
| 数据 | 人数 | 移动记录数 | 地点数 | 位置用什么代表 |
|---|---|---|---|---|
| 阿比让市内行程 | 154,849 | 519,710 | 381 | 基站 |
| 中国城际出行 | 1,571,056 | 4,976,255 | 340 | 地级市中心 |
| 美国国内迁移 | 未给出 | 2,498,464 | 51 | 州首府 |
表中的人数和记录数都来自表1。阿比让平均每人519,710÷154,849≈3.36条记录,中国是4,976,255÷1,571,056≈3.17条。分母是表中的人数,分子是移动记录,所以这是记录密度。美国没有精确人数。论文说明,迁移通常不频繁,人数应接近2,498,464条记录;这是作者的判断,表里仍写N/A。51是州级单元数,位置代理是州首府,距离因此是首府之间的几何距离。
补充材料另外使用Gowalla和Foursquare。Gowalla在2009年2月至2010年10月有6,442,890条签到;日本、英国和比利时的城际出行定义为不同城市上的连续两次签到。Foursquare数据含73,171名用户;纽约和洛杉矶的市内行程用2010年人口普查街区,连续两次不同地点的签到算一次行程,补充正文给出的行程总数是182,033,没有拆成两个城市各自的条数。奥斯陆被分成88个面积约1千米乘1千米的方格。这些国家各自的城市数和行程数,补充正文没有逐项列出。
距离、到达量和逐对流量,各对上了多少?
评价分三层。第一层是出行距离分布P(d)。第二层是随机抽一个地点时,它最终吸引到D次出行的概率P(D)。起点约束模型不能自动保证每个地点的预测到达等于真实到达,所以P(D)专门检查这件事。第三层才是每一对地点之间的流量。
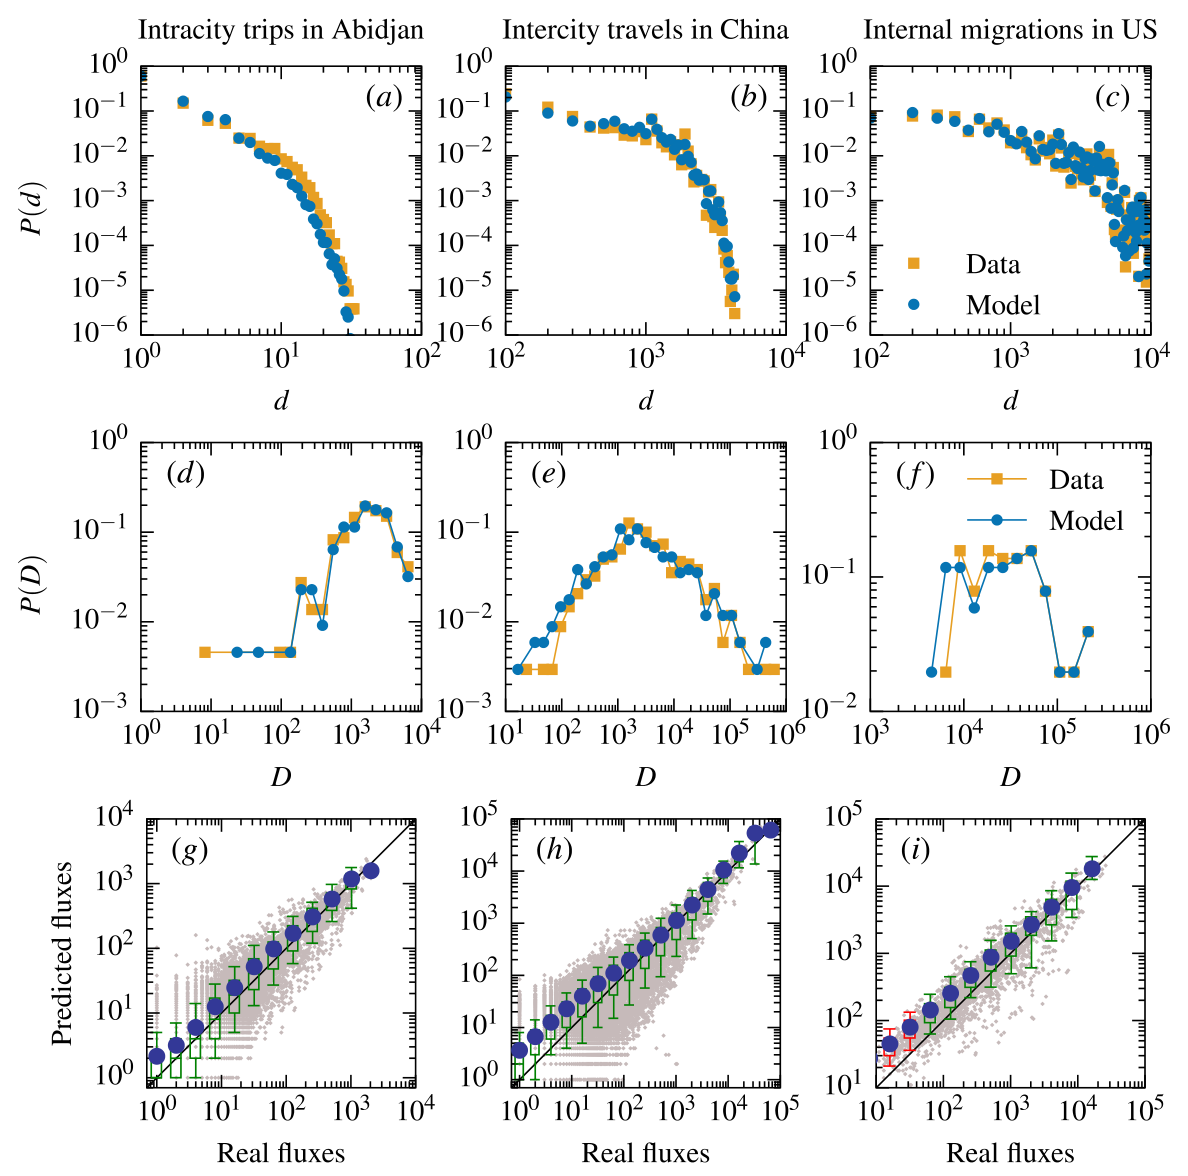
图 2|DCG复现的是距离、到达量,还是每一对流量?
(a、b、c)阿比让、中国和美国的距离分布。橙方块为数据,蓝圆点为模型,两轴都是对数坐标。阿比让随距离下降最整齐,美国长距离一端数据与模型都更分散。(d、e、f)地点吸引量分布,采用对数分箱。三套数据都呈现中间高、两端低的形状,模型曲线跟着这一形状走;美国的曲线起伏更大。(g、h、i)灰点是每一对地点,蓝点是分箱后的预测均值,箱子表示该箱预测值的分布,纵轴为预测流量,横轴为真实流量。绿箱表示对角线落在该箱预测值的10%到91%分位之间,红箱表示落在这个区间外。三组的最低流量档是红箱,更高流量档为绿箱。(d–i)使用对数分箱。来源:原论文 Fig. 2。
图2支持的是:在对数坐标上,DCG能跟上三套数据的距离衰减和到达量的单峰形状,中高流量档的对角线落在预测分布的10%到91%分位内。最低流量档的红箱表示,这些小流量的对角线落在该分位区间之外。图本身没有给出每条曲线的拟合优度小数,可核对的分布距离在表S2和表S3。论文写预测与真实的P(D)几乎无法从统计上区分;美国面板的起伏更大,具体差距用这两张表的KS统计量来看。
比重力模型高出的那一截,分母是什么?
流量层面的对照包括两个起点约束引力模型、介入机会模型、辐射模型和人口加权机会模型(population-weighted opportunities model,PWO)。引力1只有距离指数一个自由参数,引力2还有吸引力指数。辐射模型和人口加权机会模型没有待估参数。DCG有三个参数,并且参数就是按SSI选出来的。
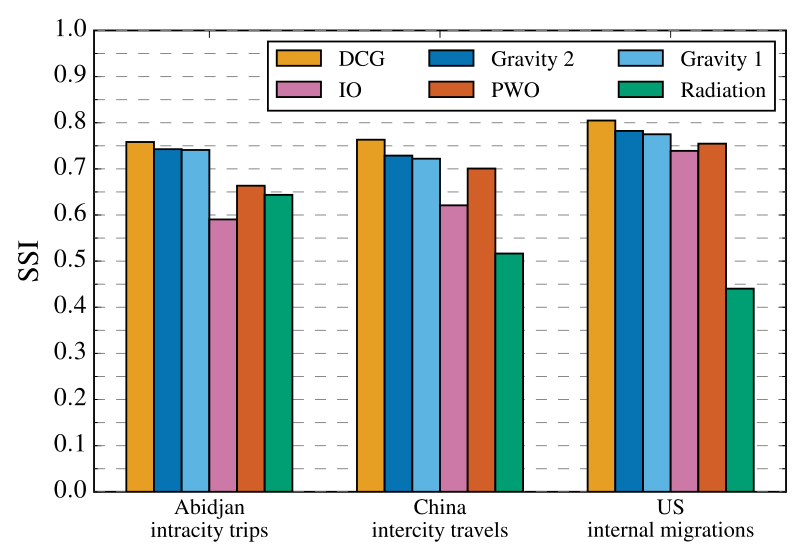
图 3|同一次流量重叠比较里,DCG比各对照高多少?
无字母子图。纵轴是SSI,范围0到1。三组从左到右为阿比让市内行程、中国城际出行、美国国内迁移。每一组六根柱依次是DCG、引力2、引力1、介入机会模型、人口加权机会模型和辐射模型。三组都是橙色DCG最高,绿色辐射模型在美国最低。正文没有印刷精确小数;按柱顶相对0到1的纵轴读取并保留两位小数,阿比让约为0.76、0.74、0.74、0.59、0.66、0.64,中国约为0.76、0.73、0.72、0.62、0.70、0.52,美国约为0.80、0.78、0.77、0.74、0.75、0.44。来源:原论文 Fig. 3。
SSI的平均范围由地点数决定。阿比让是381×380个有序起讫对,中国是340×339个,美国是51×50个。图上DCG相对引力2的优势大约是0.02、0.03和0.02,对照的是上限为1的重叠指数。美国辐射模型约0.44,与DCG约0.80之间的差距,远大于DCG和引力模型之间的差距。论文的主文结论是:DCG明显好于无参数模型,略好于双参数引力模型。DCG多一个参数,而且该参数专门用来提高这个指数,略高来自同一样本上的搜索。独立样本上的预测还需要另做留出检验,本文没有报告这种检验。
补充表S1给出使SSI最大的参数。三套主数据的α、β、γ分别是:阿比让2.99、2.53、2.28,中国3.85、1.07、2.68,美国4.45、0.60、2.88。同一张表里,引力2的距离指数是2.49、0.91和0.56,与DCG的β很接近。这三个γ都大于2,搜索留下了目的地拥挤项;对应的SSI提升仍大约只有0.02至0.03。论文把引力2到DCG的精度改进当作拥挤效应的一种量化。这个差是样本内的全矩阵重叠之差。个别目的地改道了多少人,要像图1那样单独列出到达人数。
拿掉目的地拥挤,为什么回到引力模型?
把效用中的γ ln Dⱼ去掉,只保留吸引力、距离和路径流量的对数。势博弈把均衡写成一个优化问题:在每个起点流出等于Oᵢ、流量非负的约束下,最大化各路径收益对流量的积分。被积函数含有−ln x,对流量的二阶导数是−1/Tᵢⱼ,所以目标函数严格凹,最大值唯一。论文原文写的是目标函数严格凸;唯一解这一结论仍然成立。拉格朗日乘子给出的流量是:
Tᵢⱼ=Oᵢ ×(Aⱼ的α次方 × dᵢⱼ的−β次方)÷ 对所有目的地的同一项求和。
这就是双参数的起点约束引力模型。再把α固定为1,就得到单参数引力模型。因此,路径流量上的对数成本本身就能产生引力形式。目的地拥挤是加在这层结构之外的项。Dⱼ又依赖全部Tᵢⱼ,完整DCG不再有这样的闭式解。迭代使用的更新式才把Dⱼ的−γ次方放进权重。
若进一步把Dⱼ当成已知并同时约束行列和,补充推导会走到双约束引力模型。主文的DCG没有把观测到达强制成预测到达,经验比较仍是起点约束。
论文据此讲了三层含义。DCG与引力模型可以放进同一个选择博弈。DCG的SSI更高,被用来支持目的地拥挤影响选择,并与少数者博弈的基本想法相呼应。引力2到DCG的改进被提议为拥挤强度的指标。前两层里,均衡推导是数学结果;“因此现实决策里存在拥挤”还依赖模型假设,以及样本内SSI的小幅上升。
讨论还比较了另外三条推导引力模型的老路:最大熵要求事先给定总旅行成本,确定性效用要求事先给定预算,随机效用要求未观测项服从独立同分布的冈贝尔分布。DCG使用的两条假设是,人选择使自己效用最大的目的地,拥挤和拥堵会降低效用。这是机制解释上的差别。它没有在本文里变成一次新的行为实验。
换城市之后,排序还一样吗?
补充材料把同一套比较扩展到日本、英国、比利时的城际签到,以及纽约、洛杉矶、奥斯陆的市内行程。补充材料写明,按SSI,DCG在这些数据上也好于所列对照,并给出了与主文类似的流量、距离和到达量图形。补充正文没有列出这些SSI的小数。
可以逐格核对的是表S2和表S3。两样本KS统计量比较模型分布与观测分布,同一行中越小越接近。九组数据的距离分布里,DCG取得最小或并列最小的是中国、英国、比利时和纽约,共4组。到达量分布里则是阿比让、日本、英国、比利时和洛杉矶,共5组。合起来是18次比较中的9次。
三套主数据已经能看出两种指标的分歧。距离分布的KS,阿比让是引力1的0.032、DCG的0.042;中国两者并列0.077;美国引力1是0.023,DCG和引力2都是0.031。到达量分布上,阿比让DCG最小,为0.032;中国引力1为0.082,小于DCG的0.103;美国引力1为0.098,小于DCG的0.137。辐射模型的距离KS在这三行分别是0.296、0.286和0.445,明显更大。
因此,补充材料支持的是流量SSI上的稳定排序,以及“DCG的分布距离总体上小于或接近引力模型”这句较宽的话。它同时留下一组反例:主数据的许多分布比较里,单参数引力模型的KS更小。无参数的辐射模型在纽约和奥斯陆的到达量分布上KS更小,分别是0.082和0.026,对应DCG的0.097和0.037。
这些结果能说到哪一步?
模型解释的是地点之间的流量分配。阿比让用基站代表位置,中国用市中心,美国用州首府。一个人在基站之间的多次通话,或一条税务地址变更,都进入地点对的计数。前面的人均约3.36条和3.17条,分母是表1的人数,分子是表1的移动记录数。
Aⱼ来自真实到达人数。模型在分配流量之前已经看到每个地点实际吸引了多少人。它检查的是:在已知到达规模时,这套吸引力、距离和拥挤规则能否重组起讫表。若要在不知道当期到达的情况下预测未来流量,还需要另一套不依赖当期到达的吸引力。
讨论里的北京中心区停车费、国庆和春节景区疏导,是在说明效用函数可以改写后响应政策。本文没有估计停车费上调后人流改变多少,也没有使用订票数据检验景区分流。辐射模型和人口加权机会模型的公式用人口表示机会,正文没有逐项声明三套主数据里的人口是否被换成与Aⱼ相同的到达人数。对照差距里因此混有输入定义的可能差别。
对数效用是韦伯–费希纳定律提示的选择。论文也写明,真实的收益和成本函数可能复杂得多,若能从数据里另估成本函数,精度还可能提高。当前结果系于对数形式、0.01的网格、样本内SSI,以及0.01的迭代阈值。
一句话总结
别人挤向同一个目的地时,均衡会把一部分人推向吸引力较低的地方;拿掉这种拥挤,流量公式回到起点约束的引力模型,加回去之后,全表重叠只比该引力模型略高。
核心来源
- Scientific Reports正式页面,核对题目、作者、在线发表日期与DOI。正文图1至图3、表1均出自该文。
- 同页附带的补充材料,含表S1至表S3、图S1至图S6,以及引力模型的势博弈、最大熵、确定性效用和随机效用推导。
- 数据说明:阿比让引用D4D手机数据挑战,中国城际签到引用作者2017年的跨尺度移动模型,美国迁移给出国税局税收统计入口。论文写明数据可向作者申请。
作者介绍
- Xiao-Yong Yan:论文署名为北京交通大学交通系统科学与工程研究院、电子科技大学大数据研究中心。北京交通大学教师名录中的中文姓名为闫小勇,研究方向包括复杂交通系统建模与调控。本文作者贡献写明他分析实证数据。文中作为对照的人口加权机会模型,以及中国城际数据所引用的2017年工作,也出自他与合作者。
- Tao Zhou:论文署名为电子科技大学大数据研究中心,并列为通讯作者,邮箱写作zhutou@ustc.edu。学校介绍页面确认中文姓名为周涛,并写明他在该大数据研究中心任职,研究方向包括复杂性与大数据。作者贡献写明他与闫小勇共同设计、完成研究并撰写论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
全表SSI只提高大约0.02,读起来像每个地点的人数几乎没变。示意图里,较弱目的地的到达从4人变成8人,较强目的地从24人变成20人,两个起点仍是15人和13人。若规划关心少数热点是否被分流,应单独列出这些地点的到达差,并写明差的分母是该地点原来的到达人数。全矩阵重叠会把这种局部改道平均进几十万个起讫对。
另一项需要分开的设计是吸引力的来源。现在的Aⱼ就是观测到达。用模型讨论一次尚未发生的收费或限流时,如果仍把旧的到达人数当作固定收益,拥挤项和收益项会同时带着旧均衡的信息。更干净的检验是先规定一项新的附加成本,再重新解出Dⱼ,并在收费前后的独立流量上比较热点的到达变化。这样得到的到达差,对应的是效用里新加入的那一项成本。