人口更多的城市,重卡出行会只按人等比增加吗?
论文名片|Xiao-Zhe Pang、Xu-Jie Lin、Yitao Yang、Erjian Liu、Xiang-Yu Jia、Ying-Yue Lv、Zile Guo、Yang Wang、Xiao-Yong Yan,Scaling laws of urban heavy truck mobility,Europhysics Letters(EPL),149(2025):11001。2024年10月15日收稿,2024年11月22日接收,2025年1月2日在线发表。DOI:10.1209/0295-5075/ad9630。本文是 Perspective,依据这一正式版解读。
一辆重卡在两周里反复做的事,常常是从自己停靠最多的地点出发,只去一处再开回来。四个直辖市的轨迹里,这种往返大约占全部行程模体的六成。把问题放到整座城市,人口更多并不等于卡车和出行一起按人口放大。335座中国城市中,重卡出行量随人口的标度指数约为1.08,重卡数量的指数约为0.95。指数1表示与人口成正比。大城市的人均出行量因此更高,人均重卡数量更低。
这篇视角把已有结果收成三层:多座城市之间的异速标度、一座城市内部的货运网络,以及单辆车的轨迹。它给出能覆盖这些指数的模型,也写明三层尚未被同一个模型同时再现。
先说结论
- 在335座中国城市中,重卡出行量相对人口的指数约为1.08,重卡数量的指数约为0.95。对照基线是指数1。人均出行量随城市变大而升高,人均卡车数量随城市变大而降低。
- 部分混合的城市运行模型把1.08换算成相互作用强度 α≈0.62。α 的两端是1/2和1:1/2表示只与最近对象相互作用,1表示以相同机会接触全城。既有城市运行模型给出的超线性区间7/6到3/2,盖不住1.08。
- 北京、上海、重庆、天津的货运网中,边权、节点强度和度都呈重尾。引力复制—连接模型在估计参数后能重现这些分布;正文没有印出估计出的参数值。图上边权参照线的幂指数,北京2.44,高于上海的2.31。
- 2018年5月18日至31日的单车轨迹中,0→1→0这一类往返模体大约占60%。不同地点数随时间的增长指数在四座城市为0.58到0.65,都低于线性的1。图上的齐夫参照线是示意,正文写明它不是由数据估计的。
城际货运早已有幂律,城里的重卡缺的是行程终点
异速标度(allometry)指一个量随系统规模呈幂律变化。对城市来说,规模用人口,指数大于1称为超线性,小于1称为亚线性。收入、GDP和一些商业设施相对人口超线性增长;道路、加油站、消防站和警察局则是亚线性。重卡出行既像社会经济活动,卡车本身又像基础设施,所以两种指数可能同时出现。
城际货运里,标度关系出现得更早。Zipf在1946年考察连接13个美国城市的铁路快运,城市之间的货运量与两城人口乘积、距离的倒数呈幂律,指数为0.85。后来的公路货运、951个港口构成的全球货船网络,以及航空货运,也报告过边权或度的幂律、截断幂律。这些对象都是城市与城市、港口与港口之间的联系。
市内货运长期缺少同样的统计,因为缺少足够密的市内轨迹。重卡GPS使行程终点可以被提取出来。一次出行(trip)定义成相邻两个行程终点之间的移动;同一辆车连续的出行连成一条个体轨迹。把一座城市里的轨迹叠在一起,可以得到出行总量,也可以连成城市重卡出行网络(文中记为UHTM network)。本文综述的,就是沿着这三步已经做出的规律:多城异速标度、单城网络,以及单车轨迹。
1.08和0.95为什么落在旧模型的区间外面?
Lin等用335座中国城市计算了两个关系。重卡出行量与人口的标度指数 β≈1.08,重卡数量与人口的指数 β≈0.95。出行量是把轨迹叠合后得到的UHTM数量,卡车数量是另一项。两者的分母都是城市人口规模,基线都是 β=1。这篇视角没有重印拟合区间、决定系数或城市名单,两个数都带约等号。
由指数可以直接读出人均量。出行量正比于人口的1.08次方,人均出行量就正比于人口的0.08次方,大城市更高。卡车数量正比于人口的0.95次方,人均卡车数量正比于人口的−0.05次方,大城市更低。两式相除,每辆车承担的出行量正比于人口的0.13次方。0.13是1.08减0.95,基线是指数0;它是两个已报告指数的差,正文没有再单独回归“每车出行次数”。
已有模型的指数区间盖不住这两个数。微观动力学模型给商业设施的指数是1,给公共设施的指数是2/3。考虑道路面积和城市分形的城市运行模型(city operation model,CO模型),超线性指数落在7/6到3/2,约1.17到1.50;亚线性指数落在1/2到5/6,约0.50到0.83。1.08低于7/6,0.95高于5/6,所以两个观测都在这组区间之外。
CO模型里有一个关键假定:每个人以相同概率去城市中任何位置与他人相互作用。不计分形时,人均出行距离与城市半径成正比,也就是与面积A的1/2次方成正比。总出行距离等于人数乘以人均距离,因而正比于 N A^{1/2}。另一极端来自Samaniego和Moses:每个人只与最近的对象相互作用,人均出行距离的平方正比于人均面积 A/N,总距离变成 N^{1/2} A^{1/2}。真实城市被放在两端之间,写成 L ∝ N^α A^{1/2},相互作用强度 α 落在1/2和1之间。
0.62量的是模型里的混合程度
Lin等把这段距离标度和CO模型接到一起,称为部分混合人口的城市运行模型(partially mixed population city operation model,PMPCO)。CO模型设两人相互作用平均占用面积 ā、平均产生社会经济产出 ḡ。一个人接触到的人数约为 ā 乘以人口密度 N/A,因此人均产出 y = ḡ ā N/A,全城产出 Y = N y,正比于 N²/A。模型再假定全城产出与总出行成本成正比,成本又与总出行距离成正比。
把 L ∝ N^α A^{1/2} 和 Y ∝ N²/A 联立,面积随人口的指数落在2/3到1,全城产出的指数是 (2+2α)/3,从1变到4/3,约1到1.33。1.08落在这个产出区间里。把 β=1.08代进 (2+2α)/3,得到 α≈0.62。Bettencourt等报告的犯罪率指数约为1.16,同一公式给出 α≈0.74。0.62低于0.74,表示在这套换算里,卡车对应的混合程度更靠近“只与近处相互作用”的一端。α 是模型参数,分母是这条换算式,不是观测到的会面次数,也不是卡车司机与犯罪者的行为比较。
卡车数量被放在基础设施一侧。模型认为基础设施数量与城市面积同向变化,而面积指数不超过1,因此可以解释卡车数量的亚线性。0.95本身不是从 α=0.62再算出来的第二个拟合。
若再计入分形维数 D,D取1到2,产出指数的范围扩成1到3/2,面积指数的范围是1/2到1。这个更宽的区间可以罩住收入、GDP、专利、犯罪率、城市面积、加油站、电网长度和道路长度等文献中的一批城市属性。能罩住指数范围,说明模型的参数区间足够宽;它还没有在同一组城市上逐项报告这些属性的新拟合。
四个直辖市的货运网,重尾长在边权、强度和度上
网络这一层转向一座城市内部。Yang等用重卡行程终点和货运兴趣点(point of interest,POI)为北京、上海、重庆、天津建立网络。行程终点先匹配到最近的货运POI,POI成为节点。两个节点之间只要有重卡出行,就连一条无向边。边权 wᵢⱼ 是两端之间的出行次数,节点强度 sᵢ 是连到该点的全部边权之和。度 k 是相连节点的个数。无向边把方向折在同一条边里,边权是出行次数,不是货重或运费。
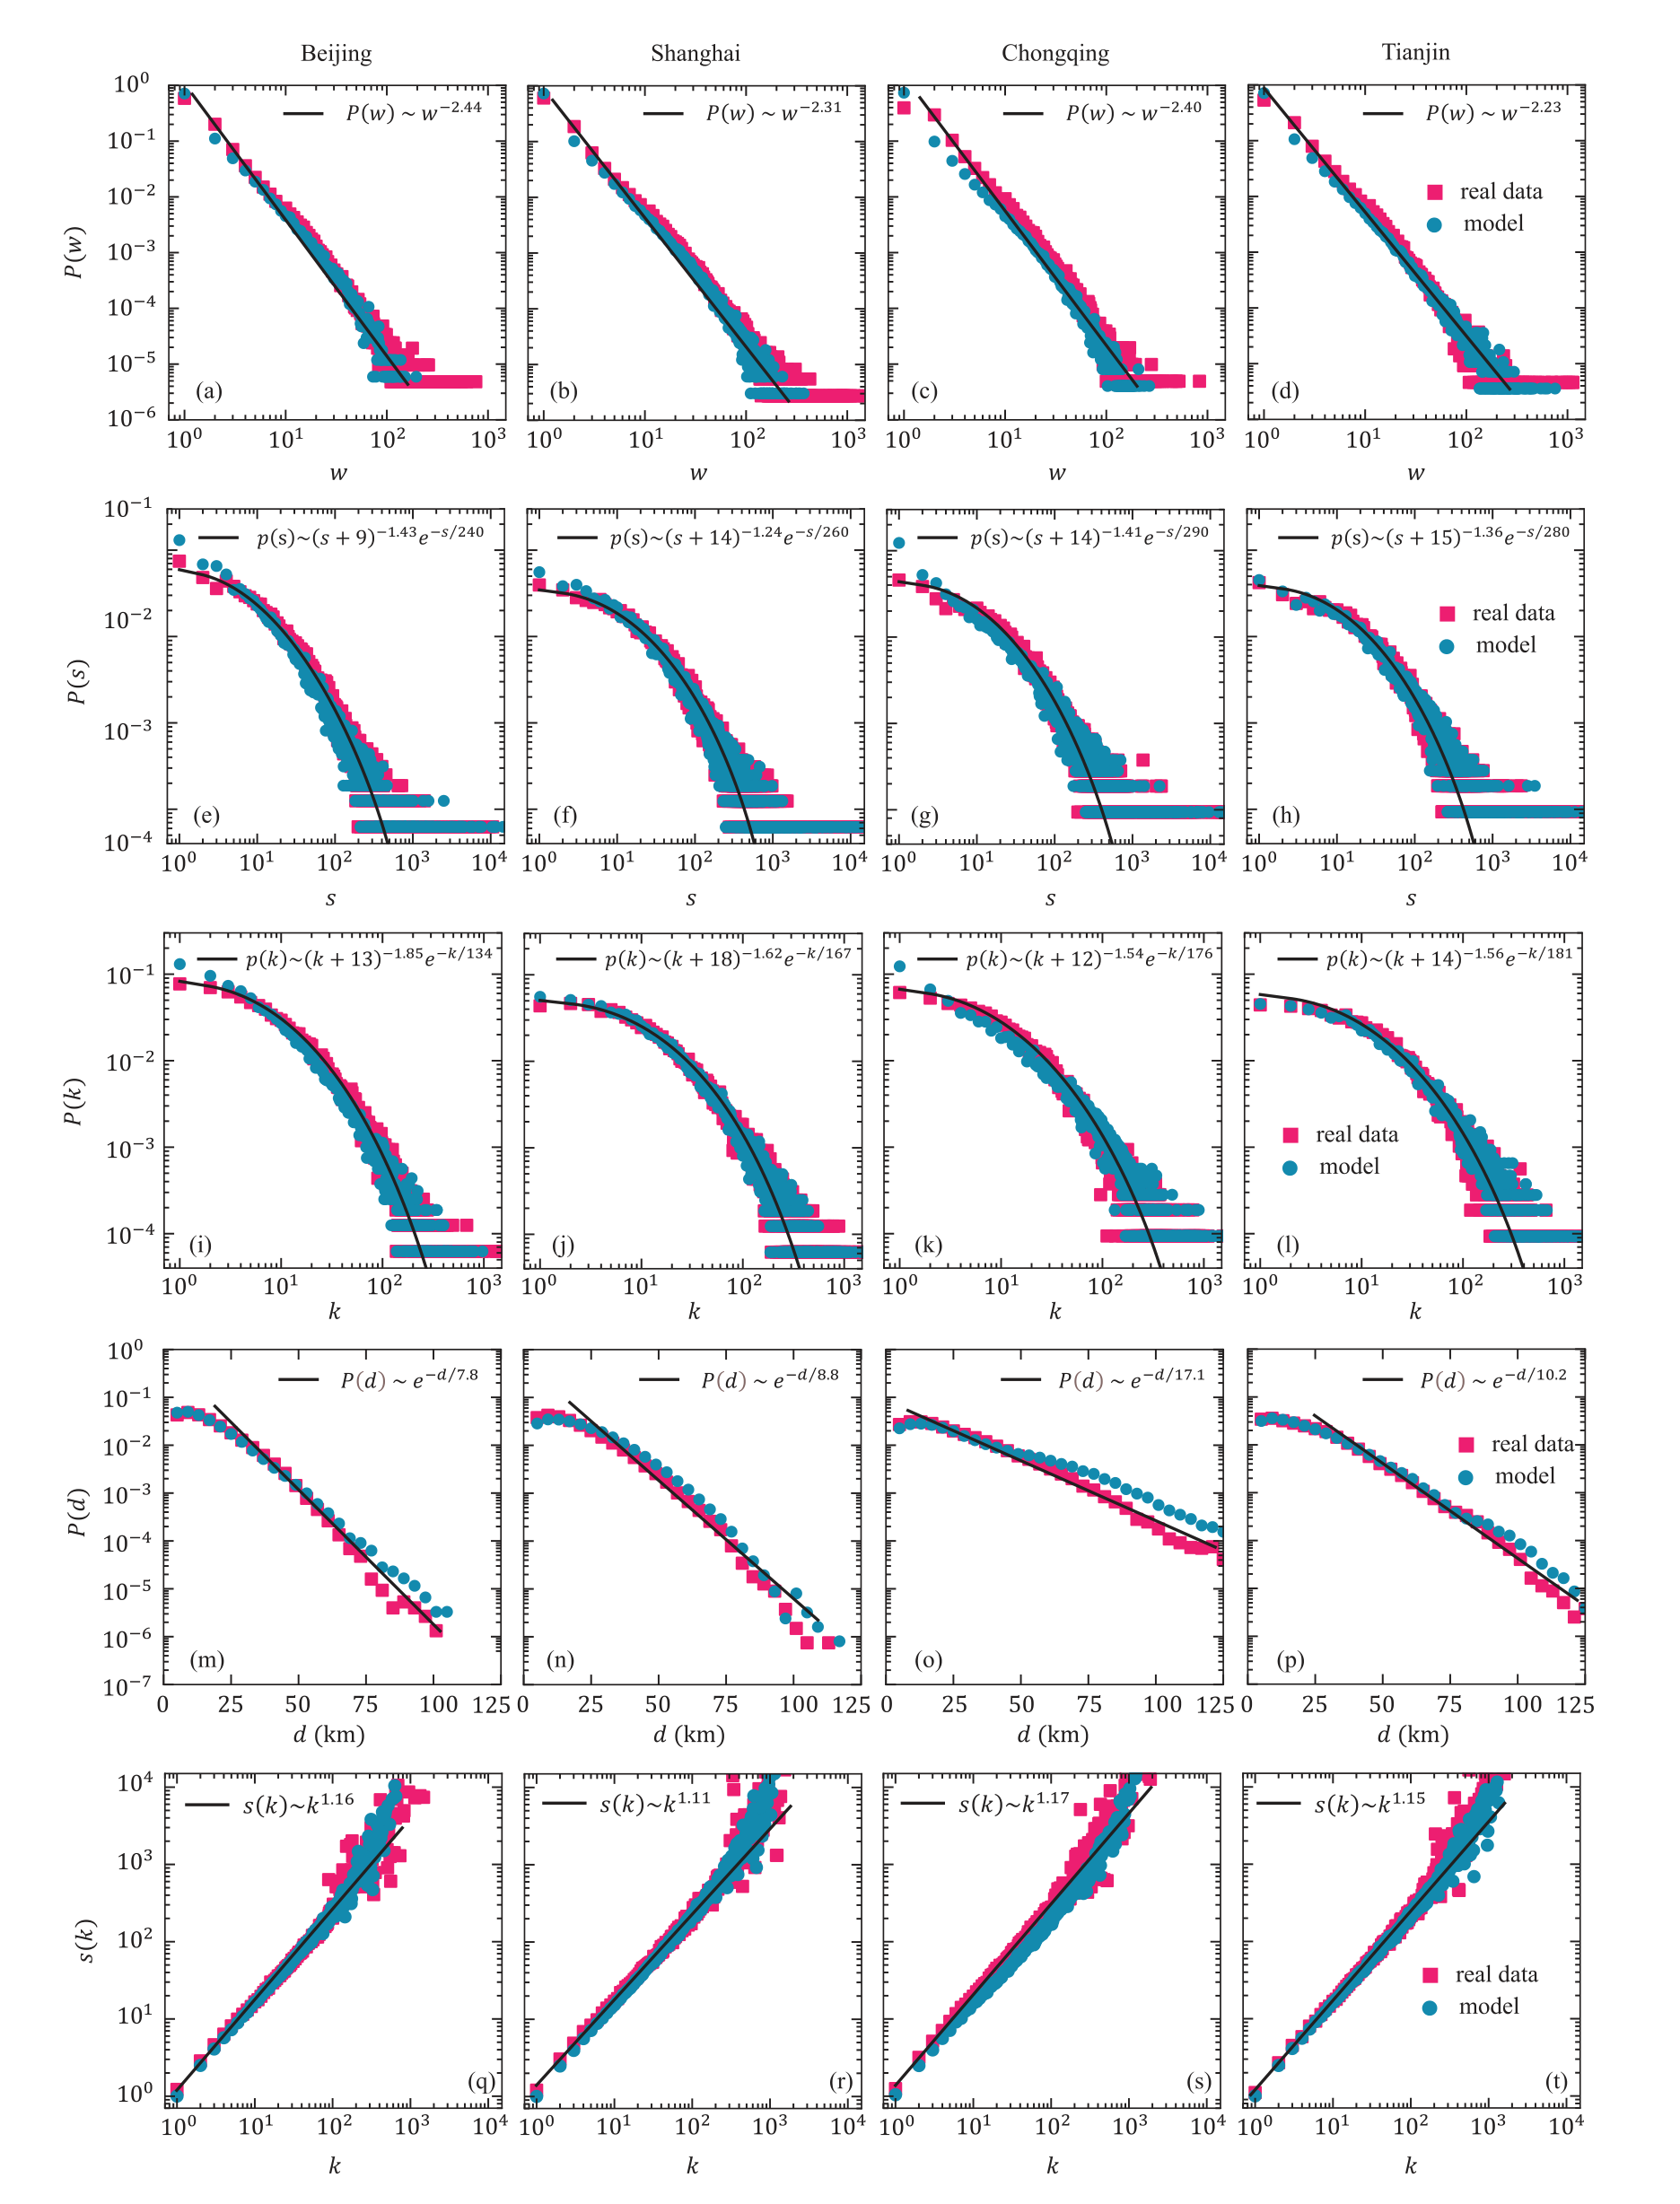
图 1|四个直辖市的重卡货运网,少数边和节点是否承担了多数往来?
四列依次是北京、上海、重庆、天津。红点为实测,蓝点为估计参数后的引力复制—连接模型。黑线是图上印出的参照曲线。
(a、b、c、d)边权分布。参照幂律 P(w)∼w 的负指数:北京2.44,上海2.31,重庆2.40,天津2.23。指数的底是边权 w;指数更大,分布下降更快。
(e、f、g、h)节点强度分布,参照曲线是幂律乘指数截断。(e)北京 p(s)∼(s+9)^{−1.43} e^{−s/240};(f)上海 (s+14)^{−1.24} e^{−s/260};(g)重庆 (s+14)^{−1.41} e^{−s/290};(h)天津 (s+15)^{−1.36} e^{−s/280}。截断项的分母240、260、290、280与强度 s 使用同一坐标。
(i、j、k、l)度分布,同样是截断幂律。(i)北京 p(k)∼(k+13)^{−1.85} e^{−k/134};(j)上海 (k+18)^{−1.62} e^{−k/167};(k)重庆 (k+12)^{−1.54} e^{−k/176};(l)天津 (k+14)^{−1.56} e^{−k/181}。
(m、n、o、p)边的距离分布,横轴为千米。参照指数为 e^{−d/λ},尺度 λ 是北京7.8、上海8.8、重庆17.1、天津10.2千米。d 增加一个 λ,这条指数降到原来的 1/e。λ 是参照曲线的尺度,正文没有把它们写成平均运距。
(q、r、s、t)平均节点强度 s(k) 随度 k 变化。参照关系 s(k)∼k^θ,θ 为北京1.16、上海1.11、重庆1.17、天津1.15,都大于1。度增加时,强度上升得更快。来源:原论文 Fig. 1。
分布的形状说明,少数边或节点承担大量货运往来,多数边和节点只承担很少往来。正文用二八定律称呼这种不均匀,并指出许多复杂网络也有类似形状。这里没有给出“恰好80%的出行落在20%的边上”这种份额。
最近POI这一步决定了节点是货运地点,不是原始GPS点。匹配误差和POI分类对边权的影响,这篇视角没有量化。
复制一家成功企业,为什么还要分出一段间接流量?
BBV、交通驱动、相互选择和资源分配等加权网络模型可以产生重尾,但它们不包含距离。货运网不能省掉距离。Yang等提出引力复制—连接模型(gravity duplication-connection model,GDC)。起点是从货运POI里随机取 N₀=5 个节点,连成完全图,每条边的初始权重 w₀=1。
之后每次从剩余POI中随机取一个新节点。模型假定新的货运企业会模仿一家已有企业,并与这家企业的一部分客户发生联系。新节点先以接近引力模型的概率选一个被复制节点 i:概率正比于 sᵢ^α e^{−d/rc}。α 表示节点吸引力,d 是空间距离,rc 是特征距离。然后从 i 的邻居中随机选取一半,再以同类概率与这些邻居相连。距离项用指数,是因为图1(m)到(p)的边距离本身接近指数分布,而不是引力模型里更常见的幂律距离。
新连接还会带来间接流量。新节点与被连节点的直接强度增加 w₀,另有强度 σ 按原有邻居的强度比例,分到这些邻居以及对应的旧边上。σ 越大,新连接越会把往来堆向已经很强的节点,边权越不均匀。α 越大、rc 越长,新节点越倾向连接强度已经很高的节点,节点强度和度也越不均匀。由于图1(q)到(t)中强度相对度超线性,度的不均匀会跟着强度一起变强。正文概括:影响边权分布的主要参数是 σ,影响强度和度的主要参数是 α 与 rc。
图1的蓝点说明,α、rc 和 σ 估计之后,模型可以重现边权、强度、度、距离和 s(k) 的形态。估计值没有印在这篇视角里,因此不能从正文读出上海的 σ 比北京大多少。作者对北京和上海的解读是:边权幂指数北京2.44、上海2.31,北京更大,对应上海的间接相互作用更强;强度与度的幂指数也是北京更大(强度1.43对1.24,度1.85对1.62),对应上海的重卡更倾向与吸引力更高的对象相连。这是用模型参数读图,不是另一项独立测到的企业偏好。
GDC给出一条能同时带上距离、复制和间接流量的生成路径。它与数据的接近,说明这组假设足够产生观测到的重尾;同一张图不能排除其他带距离的模型也能拟合。
两周之内,多数模体是出去一趟再回来
轨迹使用的是2018年5月18日至31日、四个直辖市的重卡个体移动,时间跨度是两周。一次出行仍是相邻行程终点之间的移动。图2统计的是这批轨迹,原图题写作UHTC,正文使用UHTM,指的是同一组城市重卡轨迹。
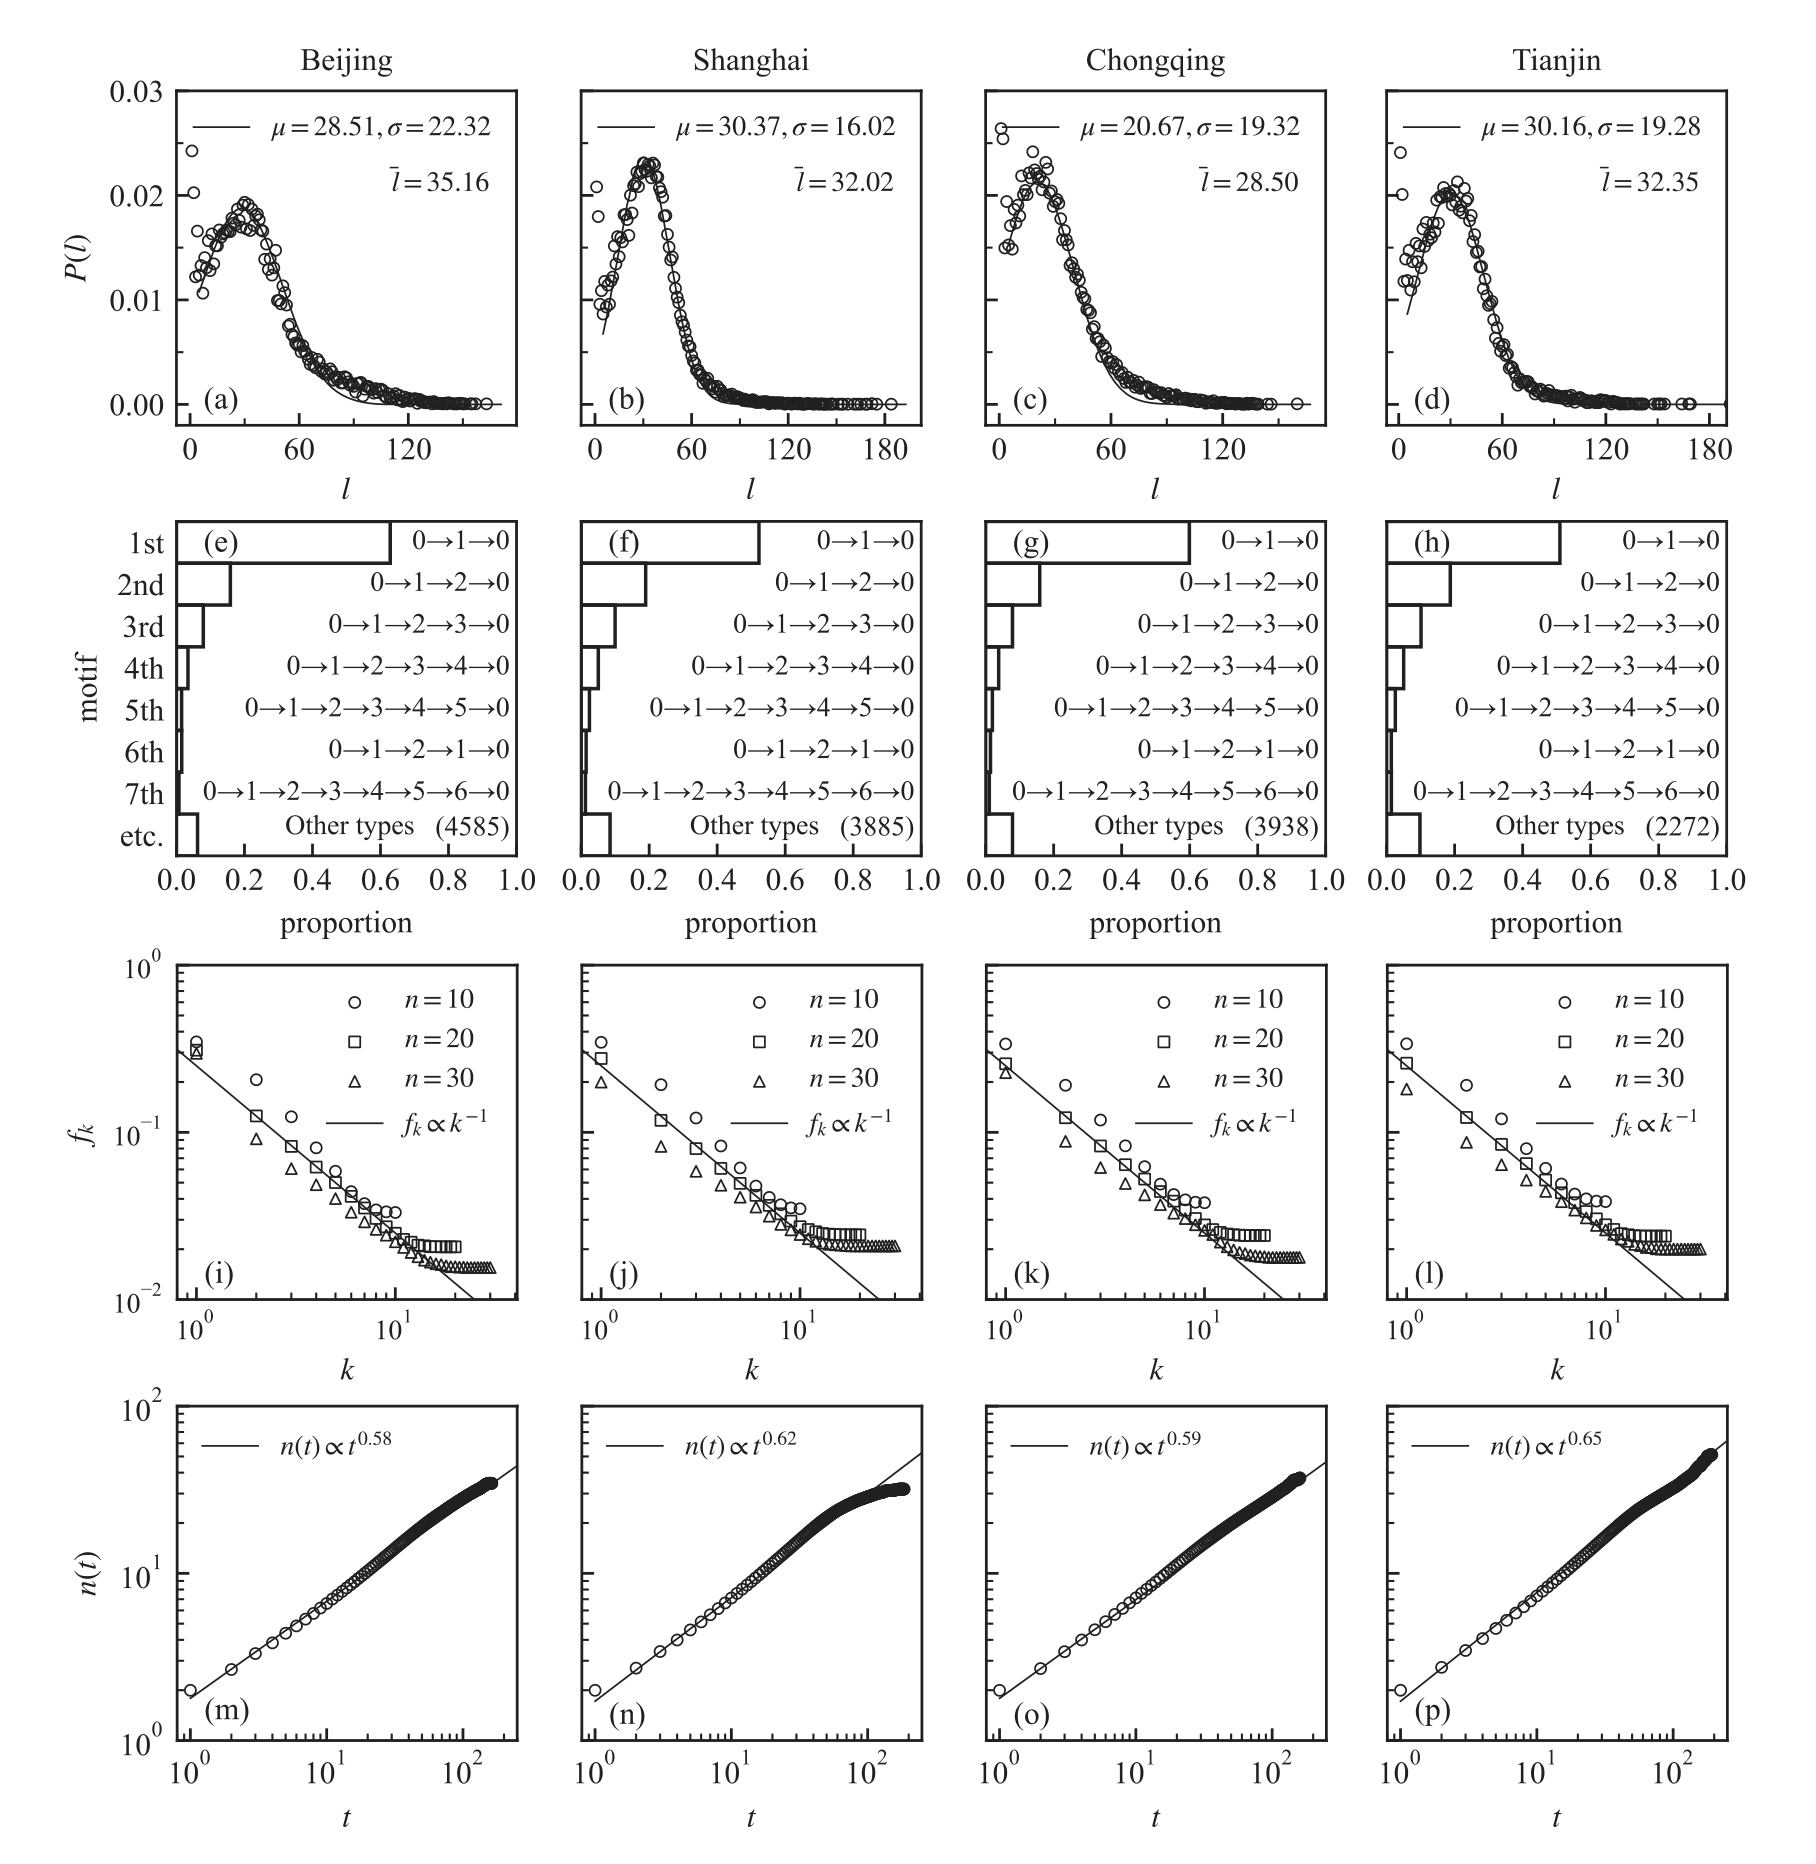
图 2|两周轨迹里,卡车是在少数地点之间往返,还是不断开辟新地点?
四列依次是北京、上海、重庆、天津。
(a、b、c、d)出行次数分布。P(l) 是出行次数为 l 的重卡占该城市样本卡车数的比例,分母是卡车数,样本总量正文没有给出。图上标注的正态参数与平均次数为:北京 μ=28.51、σ=22.32、平均35.16次;上海 μ=30.37、σ=16.02、平均32.02次;重庆 μ=20.67、σ=19.32、平均28.50次;天津 μ=30.16、σ=19.28、平均32.35次。平均次数的单位是两周内每车出行次数。正文说只有一两趟出行的车占比更高,并推测它们更多承担城际或专门任务;其余车辆的出行次数近似正态。图上的 μ 与总平均并不相同,正文没有写明 μ 是否已经去掉一两趟的车辆。
(e、f、g、h)模体占比,横轴是比例。家的操作定义是该轨迹中出现最多的地点,记为0,不是登记在册的车场。轨迹按这个地点切开,每一段模体两端都是0,中间地点按首次出现编号。0→1→0 是离开最常停靠点、只到一处再返回,正文写它大约占60%。更长的模体占比更低。括号中的数字是其余模体的种类数:北京4585、上海3885、重庆3938、天津2272。这是种类数,不是这些种类占行程的比例。
(i、j、k、l)不同地点的访问频率 fₖ。k 是地点按访问次数排列的名次,n 是一条轨迹中的不同地点总数,图例分出 n=10、20、30。直线 fₖ∝k^{−1} 是标准齐夫定律的示意,正文注明它不是由真实数据估计的。数据点大体随名次下降,接近准齐夫定律。
(m、n、o、p)到时间 t 为止访问过的不同地点数 n(t)。参照线为 n(t)∝t 的幂:北京0.58,上海0.62,重庆0.59,天津0.65。指数都小于1,地点数增加得比 t 慢。正文没有另行定义 t 是钟点时间还是出行序号。来源:原论文 Fig. 2。
0→1→0约占六成,加上访问频率向少数地点集中,共同指向同一幅画面:卡车主要在最常停靠点和一两家固定企业之间往返,偶尔去新地点。因为新地点增加得慢,不同地点总数呈亚线性,这被记为Heaps定律。访问频率的准齐夫形状,则被当作Heaps定律的一个经验对照。最常停靠点是统计上出现最多的点,把它叫做家,只是沿用轨迹研究的叫法。
记忆和优先返回能解释到轨迹的哪一层?
这些轨迹规律与人类移动性里已经见过的规律相近,所以解释人类轨迹的两类模型被借来说明重卡。探索—优先返回模型(exploration and preferential return,EPR)假定:去过的旧地点越多,再探索新地点的概率越低;若不去新地点,就按各旧地点以往被访问的频率返回。基于记忆的随机游走(memory-based random walk,MRW)按访问顺序或频率给旧地点赋记忆,越早或越常去的地点越可能再次被选中,探索新地点的机会逐渐变小。
两条机制都能让不同地点数亚线性增长,并让访问频率形成准齐夫分布。减弱记忆、也就是增加探索,会让不同地点增加得更快,同时让访问频率更不均匀。因此记忆或探索、再加上优先返回,被看成轨迹标度得以形成的关键因素。
图2本身是实测分布,没有叠上EPR或MRW的模拟曲线,正文也没有报告这两类模型在四座城市上的拟合参数。模型与数据的关系是:它们的假设能产生同样类型的亚线性增长和准齐夫频率。这支持把记忆和优先返回当作候选机制,还不足以说明它们是这四周数据的唯一生成过程。
三层规律可以并排成立,还没有被一个模型接起来
讨论里把模型机制写成货运系统可能用到的参考。轨迹一侧,企业可以按供需的时空特点安排链式行程,让卡车在一次出行中覆盖更多地点,从而减少卡车数量、成本和排放。网络一侧,GDC里距离越短、两地往来越强,因此可以用税收或用地成本引导企业靠近已有货运集群。这些是根据机制写出的政策设想,文中没有伴随实施前后的对比。
两套设想都碰到最开始的异速标度:既想用网络提高社会经济产出,又想用更紧凑的单车行程减少卡车数量。现有研究仍分成三层,多城异速、单城网络和单车轨迹各算各的。如何让一个模型同时再现三层,是正文列出的下一步。人类移动性里已有可借用的接口:同时再现个体轨迹和集体网络的普适模型、优先探索与优先返回模型,以及用引力模型连接个体相互作用和城市标度的地理网络。这些是建议的建模方向,不是本文已经完成的联合拟合。
范围也停在市内重卡。城市货运还有轻卡和快递三轮车;更大尺度上还有城际与国际的公路、铁路、水运和航空。它们通过货运枢纽衔接。正文认为,这些方式的轨迹变得可得之后,用相互依赖的多层网络研究它们,是后续方向。本文数据因法律和伦理原因不公开,合理请求下可向通讯作者索取。三层结果所依据的原始研究、人口口径和卡车样本总数,这篇视角都没有再附表说明。
一句话总结
人口更多时,重卡出行量比人口上升得稍快,卡车数量比人口上升得稍慢;落到单辆车上,两周轨迹里大约六成模体仍是从最常停靠点出发、只去一处再返回。
核心来源
- EPL正式版,Scaling laws of urban heavy truck mobility,149(2025):11001。核对题目、作者、收稿日期与在线发表日期。正文图1、图2即本文两张图。
- 异速标度来自正文引用的 Lin 等,EPL,143(2023):11002。335座城市、β≈1.08与 β≈0.95都出自这项被综述的研究。
- 货运网络来自正文引用的 Yang 等,Transportation Research Part C,158(2024):104442,以及其预印本 arXiv:2212.03672v1。GDC的规则和四座直辖市的网络图来自这一组工作。
- 单车轨迹来自正文引用的 Yan,Journal of Beijing Normal University (Natural Science),59(2023):740。2018年5月18日至31日的轨迹统计出自这项被综述的研究。
- 资助为 National Natural Science Foundation of China,Grant No. 72271019。数据声明写明,研究使用的数据出于法律和伦理原因不公开,可向通讯作者合理索取。
作者介绍
- Xiao-Zhe Pang:署名石家庄铁道大学交通运输学院,以及河北省交通安全与控制重点实验室。
- Xu-Jie Lin:署名北京交通大学系统科学学院。335座城市的异速标度,来自他与合作者被本文综述的EPL 2023研究。
- Yitao Yang:署名利兹大学地理学院。利兹大学地理学院人员页将其研究写为城市导航、人类移动性与交通地理。四个直辖市货运网络的原始结果,来自他与合作者发表、并被本文综述的工作。
- Erjian Liu:署名 Beijing Transport Institute。
- Xiang-Yu Jia、Ying-Yue Lv、Zile Guo:均署名北京交通大学系统科学学院。
- Yang Wang:通讯作者,署名石家庄铁道大学交通运输学院与河北省交通安全与控制重点实验室,邮箱 wy@stdu.edu.cn。
- Xiao-Yong Yan(闫小勇):通讯作者,论文同时署石家庄铁道大学交通运输学院与北京交通大学系统科学学院,邮箱 yanxy@bjtu.edu.cn。北京交通大学系统科学学院教师名录列其为教授,研究方向包括人类移动行为、交通数据挖掘与复杂系统。教师名录中的主持项目72271019,与本文致谢的基金号相同。轨迹标度来自他被本文综述的2023年论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
1.08与0.95相减,得到每辆车的出行量大约按人口的0.13次方上升。四座直辖市两周的平均次数是北京35.16、上海32.02、重庆28.50、天津32.35,看起来可以拿来核对“大城市的车跑得更勤”。这个核对现在做不了:视角没有给出这四座城市在同一口径下的人口,也没有说明2018年这两周与335座城市的统计年份是否相同。值得补的是一张表,在同一套GPS和同一种人口定义下,同时列出城市总出行、卡车数量和每车次数。只有这样,0.13才是一次回归,而不只是两个指数的差。
讨论里希望用链式行程减少卡车数量。图2里,0→1→0已经约占模体的60%,下一种0→1→2→0的比例明显更低。若政策只是把“出去一趟”改成“顺路多停一站”,卡车总数会不会下降,取决于新停靠能否替代另一辆车的行程。EPR和MRW还提示,探索变多时,不同地点增加得更快,访问频率也会更不均匀。链式配送因此同时改两件事:行程模体的长度,以及少数地点是否仍然吸走大部分停靠。只盯住卡车保有量,看不到后一件。