下一地点,要看刚才的路线,还是看历史上的同一钟点?
论文名片|Jie Feng、Yong Li、Chao Zhang、Funing Sun、Fanchao Meng、Ang Guo、Depeng Jin,DeepMove: Predicting Human Mobility with Attentional Recurrent Networks,WWW 2018: The 2018 Web Conference,2018年4月23–27日,法国里昂。ACM,10页,页码1459–1468。DOI:10.1145/3178876.3186058。这是一篇下一地点预测的方法论文。
晚上七点,一个人刚结束当前这段活动。下一个地点既可能顺着刚才的路线出现,也可能和昨天、上周同一个钟点重合。论文用一张标着 19:00 的时间轴说明模型在比较什么;那是示意图,对应后文的图 2。DeepMove 把两路信息放进同一次预测:当前这段轨迹交给循环网络,更长的历史交给注意力去挑。比较的结果是,去掉连续停留之后,它比只读当前序列的循环网络更准,签到数据上的相对差距最大;记录里如果还留着连续几个小时的原地停留,这点优势就很小。
引言引用 Song 等人 2010 年的工作,称大约 93% 的人类移动可以预测。那是先前文献里的可预测性说法。本文实际报告的是:在给定时间间隔后,真实地点编号有没有进入模型排出的前几名。
先说结论
- 时间被固定成 30 分钟,任务变成预测下一个地点编号。每人轨迹按时间顺序,前 80% 训练、后 20% 测试。80% 的分母是这个人自己的轨迹,测试里仍是同一批人。
- 相对一般循环网络,正文给出的平均提升是:Foursquare 签到约 31.63%,手机应用超过 8.04%,蜂窝网络 5.16%。百分比的分母是一般循环网络的准确率,两个绝对准确率都没有写出。摘要另称超过当时先进模型 10% 以上,正文没有给出这 10% 的算式;后两套相对循环网络的数字低于 10%。
- 不去掉同一时段的重复停留时,手机应用上本文模型是 0.694,循环网络是 0.690,相差 0.004;蜂窝网络上本文模型是 0.593,循环网络是 0.595。马尔可夫在手机应用上是 0.595,在蜂窝网络上是 0.459。
- 表 4 中 attention 2 的 top-1 准确率是蜂窝网络 0.24、手机应用 0.27,attention 1 是 0.22 和 0.24。对应耗时大约是 1600 秒对 600 秒、11200 秒对 2600 秒。
- 历史注意力在同一钟点上更深。给普通循环网络加上用户编号嵌入会明显提高准确率;同样的嵌入加到带历史注意力的模型上,额外增益可以忽略。
下一格究竟是 30 分钟后的哪个地点编号?
时空点是时间戳加地点编号。一条轨迹是同一个人的一串时空点。时间窗可以是一天、一周或一个月。原问题是预测下一个时空点。实践中把间隔固定成 30 分钟,预测目标收成下一个地点编号,发生时刻落在这个固定间隔之后。
三套记录来自三种生成方式,也来自三座城市。
| 数据 | 城市 | 时长 | 用户数 | 记录条数 | 地点数 | 人均地点 |
|---|---|---|---|---|---|---|
| Foursquare 签到 | 纽约 | 1 年 | 15639 | 293559 | 43379 | 40 |
| 手机应用定位 | 北京 | 1 个月 | 5000 | 15007511 | 31522 | 48 |
| 蜂窝网络详单 | 上海 | 1 个月 | 1075 | 491077 | 17785 | 40 |
人均记录可以由表 1 直接相除:293559÷15639=18.8,15007511÷5000=3001.5,491077÷1075=456.8。分母是用户数,分子是记录条数。18.8 与正文“一年里平均大约 18 条”一致。人均地点 40、48、40 是不同地点,和记录条数是两列数字。
签到采集于 2010 年 2 月到 2011 年 1 月的纽约,每条含用户、时间、GPS 和兴趣点编号,由用户主动公开发布。正文接着删去记录少于 10 条的用户,按相邻记录的间隔切成会话,默认间隔阈值 72 小时,再删去短于 5 条的会话和会话少于 5 段的用户,并把时间归一到一周、保留原来的先后。表 1 的 18.8 条出现在这组筛选之前。筛选后还剩多少用户、多少会话,正文没有给出。模型输入写的是时间、地点和用户编号,实验段没有再说明签到的地点编号取的是兴趣点还是离散后的坐标。
手机应用数据来自一家中国社交网络服务商,用户在应用里请求定位时才产生记录,定位主要靠手机 GPS,并辅以其他传感器,再投影成街区编号。正文把采集时间印成 2016 年 11 月 17 日到 2016 年 10 月 31 日。这个起止前后颠倒,具体日历窗口无法从本文核对;表 1 只写时长 1 个月、城市北京。论文没有写出应用的名称。三位作者署名为腾讯,数据集段落本身没有把记录写成某一款产品。
蜂窝详单来自一家中国运营商,时间是 2016 年 1 月 1 日到 1 月 31 日,城市上海。用户打电话、发短信或使用数据流量时,在基站留下记录,空间粒度与街区同级。
两套较密的数据按日期切开,一天再切成 48 段,同一时段的记录合成一条,并去掉重复。48 段对应 30 分钟。主实验用的是这套处理后的轨迹。基站编号、街区编号和用户编号都做了匿名化,正文写明只有核心研究人员能在保密约定下访问,数据放在本地服务器。文末说处理到不泄露隐私后会公开数据和代码,PDF 里没有给出网址。
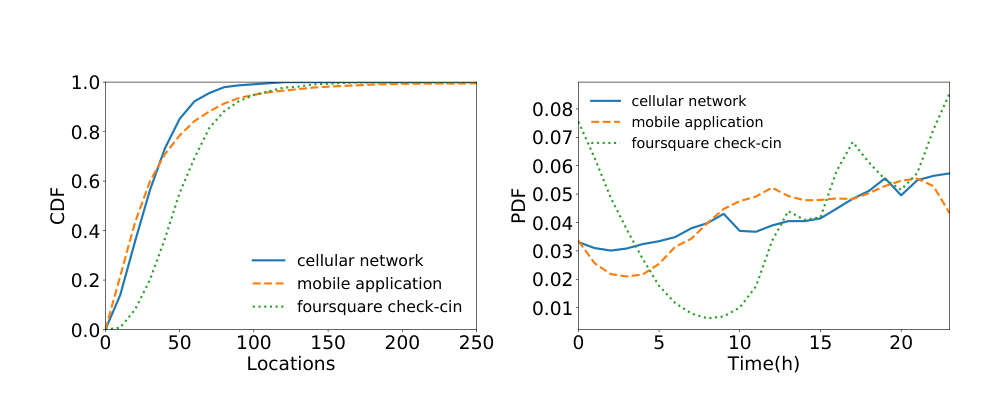
图 5|三套记录的地点数量和出现时刻,长得一样吗?
无字母子图。左图横轴是地点数,刻度 0 到 250,纵轴是累积分布。蜂窝曲线上升最快,手机应用次之,签到最慢,横轴后半段三条都接近 1。右图横轴是时刻,只画到 20 小时,纵轴是概率密度。签到在白天中段降到较低刻度,夜间两端更高;蜂窝和手机应用的曲线更平。图例把 check-in 印成 check-cin。左图的 250 是分布横轴的右端,表 1 的地点总数另为 43379、31522 和 17785。右图是记录出现的时刻:签到集中在用户主动发布的时间,蜂窝集中在通信或上网的时间。来源:原论文 Fig. 5。
后文有一处把蜂窝和手机应用说成完整记录了日常生活。采集段写的是:记录发生在发帖、请求定位,或打电话、发短信、使用流量之时。两套说法放在一起,读者能确认的是它们比签到更密,仍是事件触发的样本。
轨迹一长,只靠循环网络会怎样?
循环网络靠内部记忆读取序列。句子长过大约 20 个词时,它的效果会快速变差。正文说,手机应用数据里一天轨迹的典型长度在 20 到 100 之间,已经超过这个范围。这个 20 到 100 说的是日轨迹长度,和后面把一天收成最多 48 个半小时槽是两种计数。
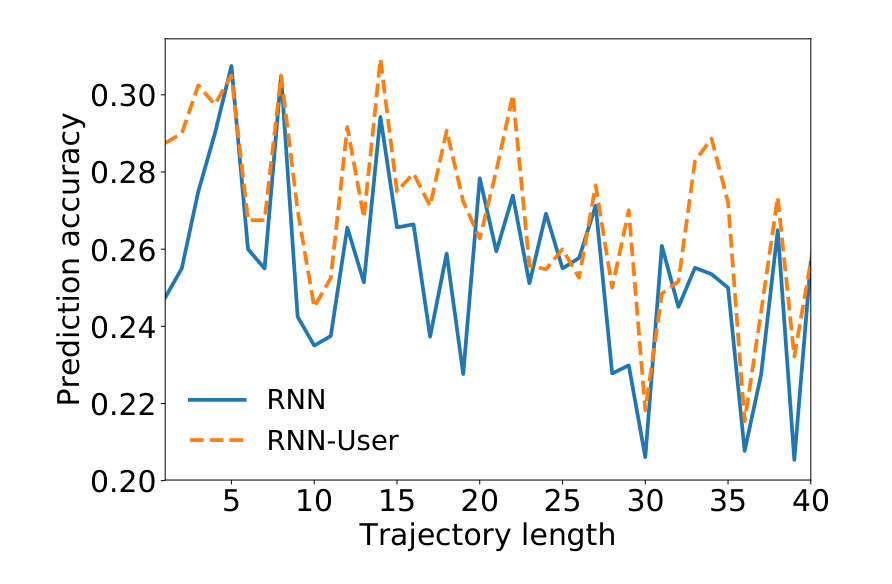
图 1|轨迹变长以后,预测准确率还稳得住吗?
无字母子图。横轴是轨迹长度,刻度 5 到 40;纵轴是预测准确率,刻度 0.20 到 0.30。实线是不加用户信息的循环网络,虚线是带用户信息的循环网络。两条线都在这个区间附近大幅波动,较长长度上多次落到更低的位置,短轨迹同样有低点。图没有注明来自三套数据中的哪一套,也没有标出每个长度的精确读数。正文据此认为轨迹越长、预测越差,并说明普通循环网络只能处理大约一天或更短的片段。图本身呈现的是波动,读不成一条平滑下降的直线。来源:原论文 Fig. 1。
除了长度,还有三件事先限制循环网络。转移会随钟点变化:工作日早晨从家到办公室的概率高,周末早晨往往低;通勤途中还可以先去吃早餐,下一步因此带有更高阶、不规则的转移。人的重复同时有日、周、月和个人自己的周期,这些周期叠在一起。签到只在用户发布时才有记录。缺失的点会让网络学到错误的转移,稀疏也使每个人单独训一个模型变得困难。全体用户共用一个模型时,还要用用户向量保住个人偏好。
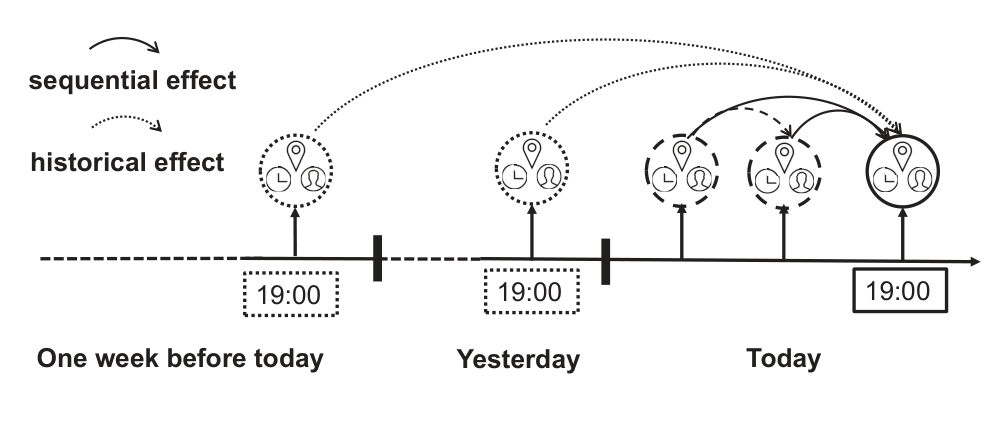
图 2|当前路线和历史钟点,各自指向哪里?
无字母子图,这是示意图。横轴从左到右是一周前的今天、昨天、今天,三处都标着 19:00。实线箭头表示当前序列里相邻活动的顺序作用,虚线箭头从更早的 19:00 连到今天。它说明预测可以同时使用眼下这段移动和历史上的对应时刻,图中没有数据、没有准确率。来源:原论文 Fig. 2。
一个模型怎样同时读到“刚才”和“以前的这个钟点”?
DeepMove 把轨迹分成当前段和历史段。时间、地点、用户编号先编成整数,再从独热向量变成稠密向量。稠密向量用来表达地点之间、时刻之间的关系,维度也更低。全体用户共用一套转移,用户向量负责个人偏好。
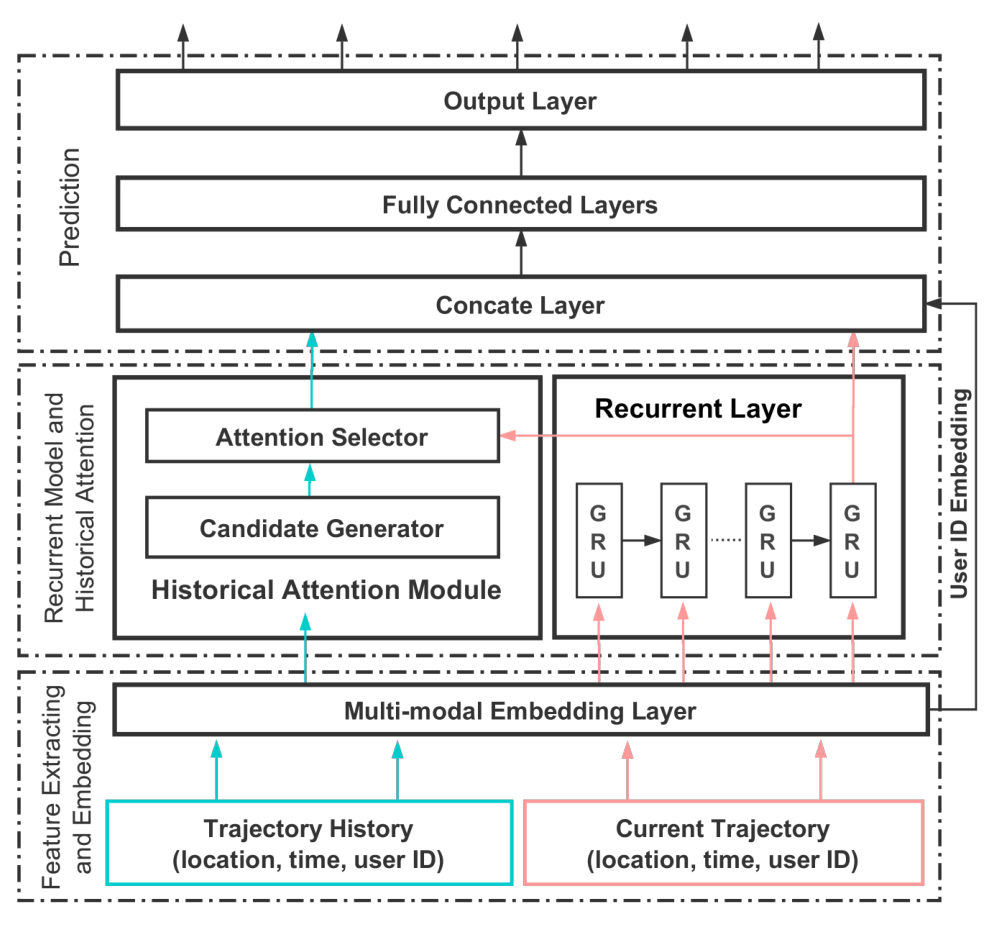
图 3|当前轨迹和历史轨迹在哪一层会合?
无字母子图,这是结构图。下方左侧是历史轨迹,右侧是当前轨迹,两者都含地点、时间和用户编号,先进入多模态嵌入层。当前轨迹进入一串门控循环单元,历史轨迹进入历史注意力:先由候选生成器产生历史表示,再由选择器接收当前状态。两路在拼接层合并,经过全连接层,从输出层给出结果。图中拼接层的英文写成 Concate。用户编号的嵌入同时连向循环层和拼接层。来源:原论文 Fig. 3。
循环单元选用门控循环单元(gated recurrent unit,GRU)。更新门决定保留多少上一时刻的状态,重置门决定有多少历史进入候选状态,输出是候选状态和旧状态的混合。论文选用它,是因为已有比较里它和长短期记忆接近、计算更少;本文也说二者接近,且都好于不加门控的普通循环网络。三套数据上长短期记忆的准确率没有单独列出。
每一步的隐状态同时送去历史注意力和预测头。预测头把注意力上下文、当前隐状态和嵌入拼在一起,再经全连接层。地点候选可以上万,输出用负采样近似 softmax,负样本按均匀分布抽取。损失是交叉熵,用沿时间的反向传播和 Adam 训练,历史注意力与循环网络一起训练。
表 2 给出默认训练设置。学习率 1e-3,学习率衰减 0.1,L2 惩罚 1e-5,梯度裁剪 1.0。地点一栏的输入约 10000、输出 256 维;时间输入写成 {48, 168}、输出 16 维;用户编号输入约 1000、输出 16 维;隐状态一栏的输入列是 300、输出列是 256。一天切成 48 段,与 30 分钟一致。168 写在同一格里,论文没有说明它对应哪一种时间编码。表 1 的地点总数是 43379、31522、17785,用户数是 15639、5000、1075。表 2 的约 10000 和约 1000 是默认输入尺寸,和表 1 的实际规模分属两张表。
实验把每个用户轨迹的前 80% 作为训练、后 20% 作为测试,至少用不同随机种子重复 3 次。训练集里没出现过的新用户,编号固定为 0。主结果使用的是同一批用户的后段,正文没有报告编号为 0 的新用户准确率。
对照有四档。马尔可夫把到过的地点当成状态,用一阶转移矩阵预测。PMM 引用 Cho、Myers 与 Leskovec 2011,把地点写成带周期性的时空混合。循环网络对照是去掉历史注意力的简化版,循环单元同样是 GRU;其中 RNN-Short 按天送入,RNN-Long 把长达一个月的整段直接送入。这个循环网络由 ST-RNN 改来,因为本文只有匿名地点编号,原 ST-RNN 建模的是连续时空量。Foursquare 的跨度是一年并按会话切开,正文没有单独说明 RNN-Long 的“一个月”在签到数据上如何对应。
那么多历史记录,权重按什么分配?
注意力要做的比较是:当前隐状态和每一条历史候选有多像。分数经过 softmax 变成权重,上下文是历史向量的加权和。分数写成当前隐状态、可学习参数和历史向量的匹配,再套 tanh。论文说这个形式受视觉注意和机器翻译中的注意力启发。这里的权重是模型参数学出来的匹配强度。
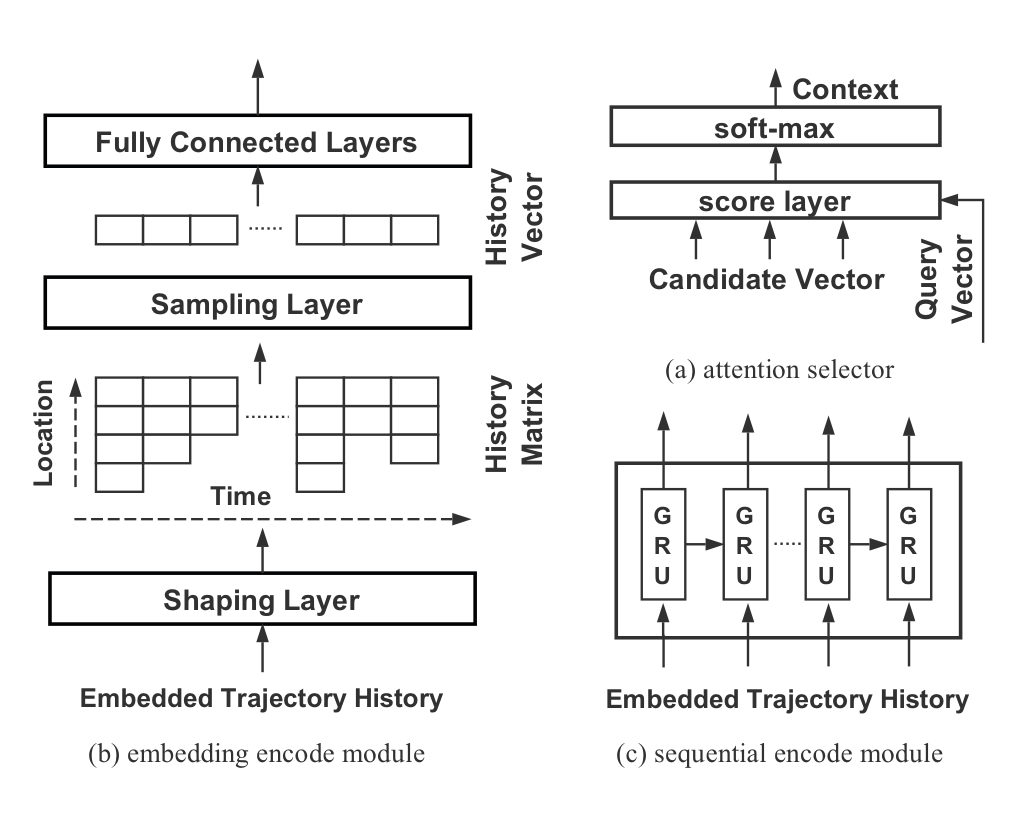
图 4|历史候选有两种生成办法,选择器如何打分?
(a)注意力选择器:候选向量和来自当前状态的查询向量进入打分层,softmax 后输出上下文。(b)嵌入编码:先把有序历史整理成时间维固定、地点维可变的矩阵,时间对齐到一周或两天,同一时间槽里出现过的地点收成一个集合;采样层再把每个时间槽收成一个向量,全连接层调整形状。(c)序列编码:另一串 GRU 按历史顺序读取,每一步的隐状态都留下当候选。来源:原论文 Fig. 4。
(b)的采样有三种。平均采样把同一时间槽里的地点向量求平均,这是嵌入编码的默认设置。最大采样只留该时间槽最常出现的地点。不采样则保留全部地点,沿时间维摊平。(c)不预先把历史对齐到日历周期,周期要靠后面的选择器去找;它的输出空间和当前状态更接近,因为两边都由循环单元产生。
去掉连续停留之后,相对谁提高了多少?
评价指标是 top-k 准确率:模型给候选地点排出概率,看真实地点 v 是否出现在前 k 名。图 6 报告 top-1 和 top-5。准确率的分母是被评分的下一步预测,预测步数正文没有给出。柱顶有误差线,标准差没有列表。
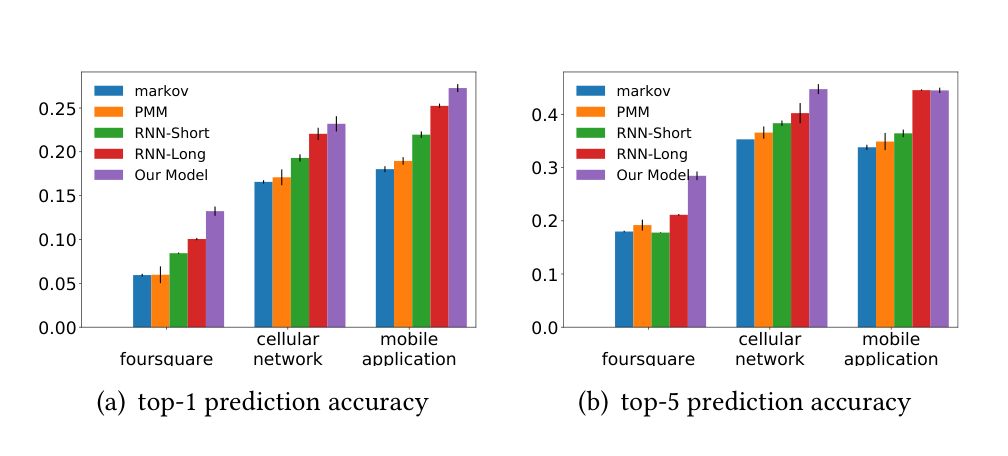
图 6|三套数据上,本文模型比四种基线高多少?
(a)top-1,纵轴刻度 0 到 0.25。(b)top-5,纵轴刻度 0 到 0.4。两组都是 Foursquare、蜂窝网络、手机应用,五种颜色依次为马尔可夫、PMM、RNN-Short、RNN-Long 和本文模型。签到的柱整体更低,循环网络高于马尔可夫和 PMM,本文模型在这组里最高。蜂窝和手机应用的 top-1 上,本文模型高于两种循环网络。手机应用的 top-5 上,RNN-Long 与本文模型的柱高接近,图中没有标出数值。来源:原论文 Fig. 6。
正文给出的是相对一般循环网络的平均提升,没有说明平均的是 RNN-Short、RNN-Long,还是再把 top-1 和 top-5 合在一起。签到约 31.63%,分母是一般循环网络的准确率:若该准确率是 A,本文模型约为 1.3163A,A 没有列出。手机应用超过 8.04%,蜂窝网络的增益是 5.16%,分母同样是一般循环网络。正文称三套数据上都高于各基线。马尔可夫和 PMM 在图上低于循环网络,正文没有再给它们相对本文模型的单独百分比。摘要写的是超过当时先进模型 10% 以上;正文相对循环网络写出的是 31.63%、8.04% 和 5.16%,没有给出 10% 的被减数与减数。
签到稀疏、由用户主动发布,相对提升最大。蜂窝和手机应用在去掉重复、收成半小时槽之后仍然更密,相对提升较小。三座城市、三种采集方式给出的是同方向的相对提升,每套数据仍保留自己的百分比。
人如果几个小时没有移动,复杂模型还增加多少?
作者又在两套日常数据的原始记录上做了比较,也就是不删除重复停留。许多人一天里会在同一地点停留几个小时。对这种轨迹,把当前输入照抄到下一步就已经很准,注意力能加的有限。
| 模型 | 蜂窝网络 | 手机应用 |
|---|---|---|
| 马尔可夫 | 0.459 | 0.595 |
| 循环网络 | 0.595 | 0.690 |
| 本文模型 | 0.593 | 0.694 |
表 3 的标题是密集数据上的预测表现,格子里没有写 top-1 或 top-5。正文把 0.694 称为 69.4% 的预测准确率。它明显高于图 6 去重后 top-1 的刻度范围,也高于表 4 明确标注的 top-1(0.22 到 0.27),所以这组数字属于保留重复停留的另一次评价。
手机应用上,0.694−0.690=0.004,相对增幅 0.004÷0.690=0.58%。正文把这一格概括为大约 1%,并把 0.694 写成 69.4%。蜂窝网络上,0.593−0.595=−0.002,相对差 −0.002÷0.595=−0.34%。马尔可夫在蜂窝网络上是 0.459,在手机应用上是 0.595。正文说两套数据上马尔可夫能到 50%:0.595 高于 50%,0.459 低于 50%。
因此,历史注意力的增益主要出现在去掉重复停留之后的换地点预测。保留连续停留时,表 3 的差距只有 0.004,蜂窝网络上还低 0.002。
模型看重的历史,落在哪个钟点?
作者抽取少量种子用户的历史注意力权重,按时间对齐后再归一化,画成热力图。人数没有给出。横纵轴都是时刻,颜色越深权重越大,图中没有数值色标。
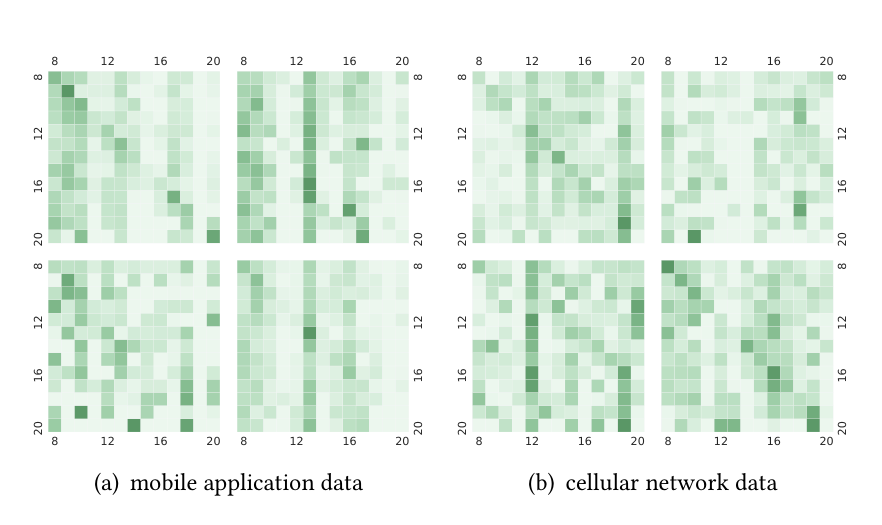
图 7|注意力是不是更强调历史上的同一个钟点?
(a)手机应用,四块矩阵,行列刻度都是 8、12、16、20 点。(b)蜂窝网络,同样四块。正文点名(a)的左上是工作日当前轨迹对工作日历史、从早上 8 点到晚上 8 点,对角线更深;(b)的左上类似;(b)的右下是周末,也呈现日尺度重复。每组另外两块矩阵印在图里,正文没有逐块写明是工作日还是周末。来源:原论文 Fig. 7。
图注把(a)的左上写成蜂窝网络的工作日,并说(b)的右下比工作日更有周期性。子图标题写(a)是手机应用、(b)是蜂窝网络,正文对(a)左上的说明也是手机应用。按子图标题和正文,左上角的日尺度重复同时出现在两套数据里。
这组热力图展示的是日尺度上的同一钟点。模型设计可以把历史对齐到一周或两天,动机里也提到月和年节。图 7 的轴是一天之中的 8 点到 20 点,画出的是日内时刻。权重表示预测下一个地点编号时哪些历史时段被强调,它是模型内部的量。
更准的那种注意力,要多付多少时间?
两种历史注意力里,序列编码在多数情况下更准,手机应用上尤其如此;嵌入编码计算更快。表 4 只写 attention 1 和 attention 2,没有在表内写模块名字。更低准确率、更短耗时的一行与嵌入编码的描述一致,更高准确率、更长耗时的一行与序列编码一致。
| 数据 | 模型 | top-1 准确率 | 耗时(秒) |
|---|---|---|---|
| 蜂窝网络 | attention 1 | 0.22 | 约 600 |
| 蜂窝网络 | attention 2 | 0.24 | 约 1600 |
| 手机应用 | attention 1 | 0.24 | 约 2600 |
| 手机应用 | attention 2 | 0.27 | 约 11200 |
蜂窝网络上,0.24−0.22=0.02,相对差 0.02÷0.22=9.1%。手机应用上,0.27−0.24=0.03,相对差 0.03÷0.24=12.5%。耗时大约是 1600÷600=2.7 倍、11200÷2600=4.3 倍。表中的秒数带有约等号,倍数也是粗算。正文给出两条原因:序列编码保留了长历史里的顺序,嵌入编码做不到;序列编码的输出空间和当前状态更像。
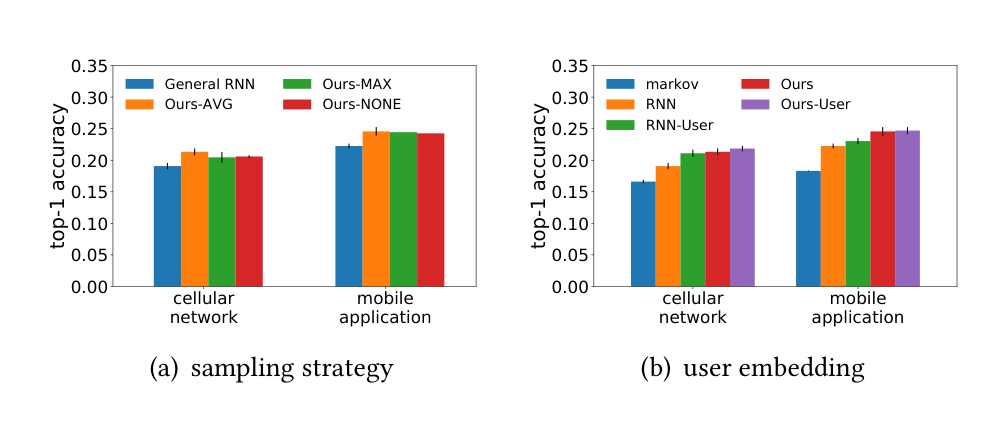
图 8|采样方式和用户编号,各自改变多少 top-1?
(a)平均、最大、不采样三种历史采样,对照是一般循环网络。纵轴 top-1,刻度 0 到 0.35。两套数据上三种采样都高于一般循环网络;正文说平均采样总体更好,最大采样略差,蜂窝网络上三者的差距大于手机应用。柱顶没有标数字。(b)马尔可夫、循环网络、带用户嵌入的循环网络、本文模型、带用户嵌入的本文模型。加上用户编号后,一般循环网络有明显提高;本文模型两条柱几乎持平。来源:原论文 Fig. 8。
(b)的读法是:历史注意力已经用个人历史带入了个人规律,再加一个用户编号向量,增益可以忽略。测试用户在训练段里已经出现,所以这条结果回答的是有历史时用户编号还增加多少。从未见过的人的准确率没有报告。作者把平均采样更好读成大多数人的地点集合有限。这个排序来自三种采样的 top-1;规律程度在后文用移动熵和探索比例再分组。
不那么规律的人,增益是不是更大?
用户按三个量分组。移动熵是轨迹里地点的熵,引用 Cranshaw 等人 2010,熵低对应更有规律。探索比例是测试段中、训练段没有出现过的地点所占比例,越低越有规律。回转半径描述活动的空间范围,引用 González、Hidalgo 与 Barabási 2008。图中三条横轴都写着 normalized,归一化算法没有给出,刻度也没有标成比特或公里。纵轴是相对一般循环网络的性能增益。图只包含蜂窝网络和手机应用。
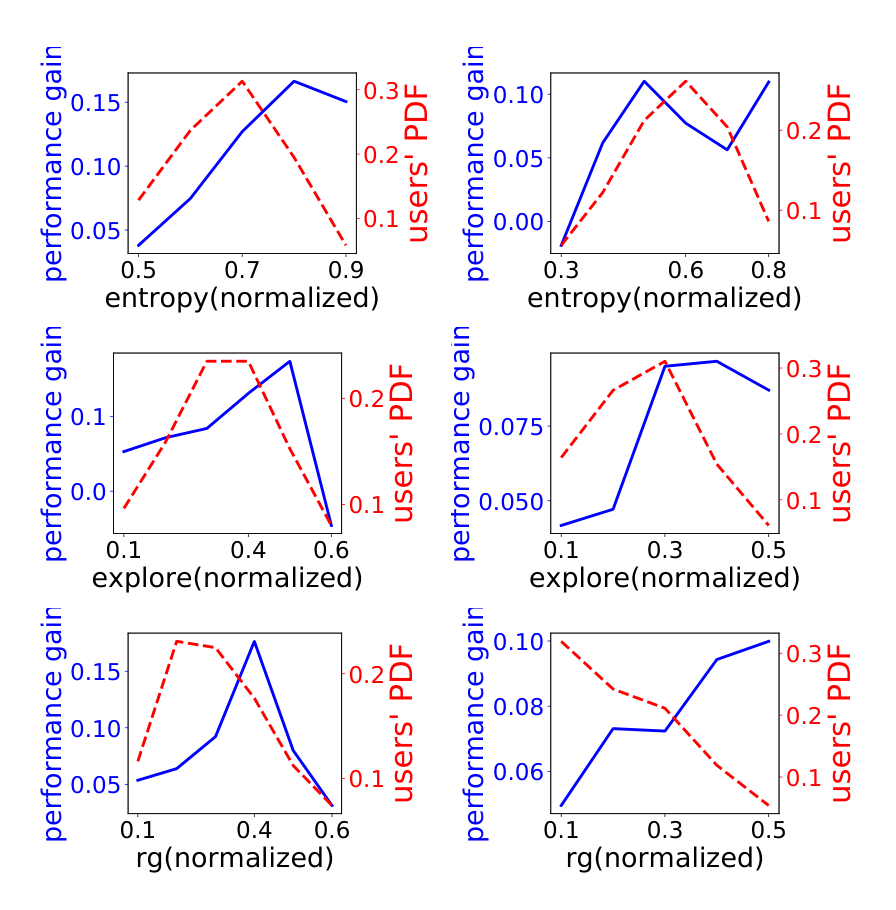
图 9|相对循环网络的增益,是否只集中在某一类人?
无字母子图。左列是蜂窝网络,右列是手机应用;自上而下是归一化移动熵、探索比例、回转半径。蓝线对应左轴的性能增益,红线对应右轴的用户分布,两套纵轴刻度不同。用户分布都在中间更高、两端更低。蜂窝网络的熵图上,增益随熵升高大体上升,右端略回落;手机应用的熵图先升后降再升。蜂窝网络的探索比例图先升,到右端 0.6 附近回到较低刻度;手机应用的探索比例图在中段升高后略回落,纵轴刻度标着 0.050 和 0.075。回转半径在蜂窝网络上中间高、右端回落,在手机应用上向右上升。来源:原论文 Fig. 9。
正文的两点阅读是:几乎所有用户组都高于一般循环网络;对不那么规律的人,模型比基线更好。举例是左上角,移动熵升高时预测准确率升高。图的纵轴印的是性能增益。增益变大,表示相对循环网络的优势变大;绝对 top-1 要另看准确率图。蜂窝网络上探索比例最高的右端,增益回到较低位置,右端的用户比例也更低。
这些准确率能用到哪一类下一地点?
能稳定说的是:在匿名地点编号上,用当前序列加上对历史钟点的加权,去重后的下一步预测高于只读当前序列的循环网络;三种采集上方向一致,签到的相对差距最大;保留连续停留时,这个差距缩到大约 0.4 个百分点或更小。比较使用同一批用户的后 20%,图 6 的绝对柱高没有列表,筛选后的签到样本量和测试步数也没有列表。
作者把两点列为后续工作:把固定时间间隔扩展成同时预测地点和停留时长,以及加入兴趣点、文本等语义。签到原始记录含有兴趣点编号,本次实验的输入描述仍是时间、地点和用户编号。热力图、用户分组和准确率都来自这三套平台记录。换一座城市或换一种传感器时,需要那套数据自己的留出测试。更高的命中率说明下一步地点编号更容易进入前 k 名。
一句话总结
下一地点既依赖刚才的路线,也依赖历史上的同一钟点;把后者检索进来,能在去重后的轨迹上超过只读当前序列的循环网络,而记录里若仍是长时间停在原地,这种优势就几乎看不见。
核心来源
- WWW 2018 论文页面,DOI 10.1145/3178876.3186058 印在 PDF 首页。会议时间为 2018 年 4 月 23–27 日,里昂,页码 1459–1468。
- 本文图 1–9 与表 1–4 均来自这一版 PDF。正文没有单独的补充材料,也没有给出数据或代码网址;文末只说隐私处理完成后将公开。
作者介绍
- Jie Feng:第一作者,论文署名为清华大学电子工程系。
- Yong Li(李勇):论文署名为清华大学电子工程系,首页列出的联系邮箱是 liyong07@tsinghua.edu.cn。其实验室主页介绍的研究兴趣包括人工智能、数据科学和移动计算,出版物列表收有本文。
- Chao Zhang:论文署名为伊利诺伊大学厄巴纳-香槟分校计算机科学系。2017 年他在该系教程中的简介写明,当时是博士生,研究带文本的时空数据挖掘。
- Funing Sun、Fanchao Meng、Ang Guo:均署名为北京腾讯。本文没有分别写三人的个人研究方向。
- Depeng Jin(金德鹏):论文署名为清华大学电子工程系。清华大学电子工程系页面列其为教授,研究包括通信网络、移动大数据和城市计算。
- 致谢写明,工作由清华大学—腾讯互联网创新技术联合实验室的研究经费支持。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
先把预测问题分成两种,再决定要不要用历史注意力。若问题是下一格是否还停在原地,表 3 里马尔可夫在蜂窝网络上是 0.459、在手机应用上是 0.595,循环网络分别是 0.595 和 0.690。注意力在手机应用上再增加 0.004,在蜂窝网络上低 0.002。序列编码相对嵌入编码的耗时大约是 2.7 倍和 4.3 倍。若问题是去掉连续停留后的下一个不同地点,相对提升重新出现,图 6 的 top-1 刻度只到 0.25,绝对柱高没有印出来。两种问题的分母不同,选模型时要先标明比的是停留还是换地方。
另一件需要单独检验的是没见过的人。主实验的测试段仍属于训练时见过的用户。新用户编号固定为 0 的规则写进了模型,对应准确率没有报告。图 8 里用户嵌入对 DeepMove 几乎不加分,说明的是个人历史已经在注意力里起了作用。要把这个结果用到首次出现的访客,需要另测编号为 0 的那一组。
热力图里 8 点到 20 点的对角线更深,表示模型在匿名地点编号上强调了同一钟点。这组比较测量的是下一步地点编号有没有进入前 k 名。出行意图,以及把匿名编号对回具体的人,都不在这项测量里。