全体出行的长尾,是不是把不同距离的出行混在一起造成的?
论文名片|Leo Ferres、Bruno Gonçalves,The power law in human mobility is a mixture artifact: evidence from a pandemic natural experiment,arXiv:2608.23194v1,2026年8月24日。arXiv:2608.23194v1。本文依据这一预印本及其同一 PDF 中的补充材料解读。PDF 首页和文末都没有印 DOI。
把一座城市里的短途和长途叠到同一张图上,距离取对数、比例也取对数,尾巴常常接近一条直线。直线的斜率写成指数 α,很多研究把它读成每个人自己的移动规则:越远越少,而且没有一个典型长度。这是第一种解释。每个人做截断列维飞行(truncated Lévy flight),个人的回转半径(radius of gyration,rg)只决定活动范围,重尾本身是个人位移的无标度性质。全体的幂律,就是这条个人规律在大样本上显出来。
第二种解释把直线看成混合的结果。近邻里的位移有一个典型长度,城市范围内另有一个,区域之间又有一个。每一层单独看接近对数正态(lognormal):取对数之后,距离集中在一个尺度附近。人们实际走出的层级不同,按条数混在一起,有限样本上的尾巴会很像幂律(power law)。全体指数于是只描述混合,并不说明某一个人没有典型尺度。
若“出行方式”指的是步行、公交和驾车,这篇论文没有在智利数据里做这个分解。它检验的方式是距离层级,也就是空间容器(spatial container):一次位移落在近邻、城市、区域,还是更远。讨论里引用过既有工作,同一交通方式内部、以及城市内部的位移并不是无标度的;那是旁证,操作本身按距离切层。
两条解释都能去拟合全体分布,所以要看一次把长距离压低、近处位移仍大量留下的时期。2020 年智利的移动限制提供了这个对比。方向性的结果偏向混合:幂律长尾是聚合之后的特征。全体指数变陡这件事本身,却分不开两种解释。
先说结论
- 全体截断幂律指数从封锁前的 1.657 升到全面限制时的 1.737,差 +0.080;图上部分限制为 1.722。只把封锁前的人按全面限制后的回转半径构成重新加权,补充材料给出指数从 1.673 到 1.814,差 +0.141,大于面板上真实的 +0.065。模拟的截断列维飞行在同样再加权下也会移动。
- 正文报告的约 1 万人样本里,对数正态从 49.5% 升到 60.9%,截断幂律从 18.1% 降到 13.9%。封锁前判为对数正态的人有 78.7% 仍判为对数正态,判为幂律的人只有 36.9% 仍判为幂律。摘要的 81% 和 32% 对应补充表里 991 人的较小样本。
- 1,537 名封锁前至少 300 次位移的用户,个人最长 20% 的尾巴有 52.9% 在 5% 水平拒绝幂律;同样条数的混合样本只有 16.7% 拒绝。幂律尾占该尾样本的中位比例,个人是 0.096,混合样本是 0.281。
- 约 200 万条的扫描里,对数超额的变异系数没有停在幂律要求的 1。与幂律相容的尾部比例在样本量为 1 万时降到 0。四层核密度混合的 R² 在封锁前是 0.977、全面限制是 0.984,部分限制只有 0.615。图 5 图例上的单条对数正态是 R² = 0.794。
- 按回转半径缩放之后,七个距离组的变异系数从 0.616 到 0.657 再到 0.762,高于论文写下的良好叠合标准 0.1。个体指数变陡从活动范围最低四分位的 +0.051 到最高四分位的 +0.184。
长距离少了,全体指数为什么仍说明不了机制?
数据是智利一家主要电信运营商的匿名基站记录。一次位移是同一用户连续两次服务基站之间的大圆距离。正文去掉距离为零的记录,得到 21 亿条、440 万名用户。补充材料还去掉间隔超过 24 小时的记录,但没有单独给出这一步删掉多少条。方法段把记录称为通话详单;补充材料改称为全部网络事件,并说明事件比通话更密。两套称呼会影响短间隔有多少,PDF 里没有并列两套距离分布。
时期以图 1 和补充表 S1 为准。方法段另印了一套更短的日历:2020 年 2 月 26 日至 4 月 13 日,部分限制只到 3 月 25 日,全面限制从 3 月 26 日算到 4 月 13 日。那套日期和下面的天数、每日位移对不上。
| 时期 | 图 1 与表 S1 的日期 | 天数 | 位移条数 | 用户数 | 图 1 的每日位移 |
|---|---|---|---|---|---|
| 封锁前 | 2 月 27 日–3 月 15 日 | 18 | 463,960,240 | 3,567,734 | 2580 万 |
| 部分限制 | 3 月 16 日–5 月 14 日 | 60 | 1,308,564,121 | 4,048,417 | 2180 万 |
| 全面限制 | 5 月 15 日–6 月 1 日 | 18 | 354,268,789 | 3,378,757 | 1970 万 |
三期位移合计 2,126,793,150 条,正文记为 21 亿。440 万是跨时期去重后的用户数,三期用户数相加会把同一个人算多次。每日位移的分母是该期天数。部分限制总条数最多,是因为有 60 天;按天算,它低于封锁前。
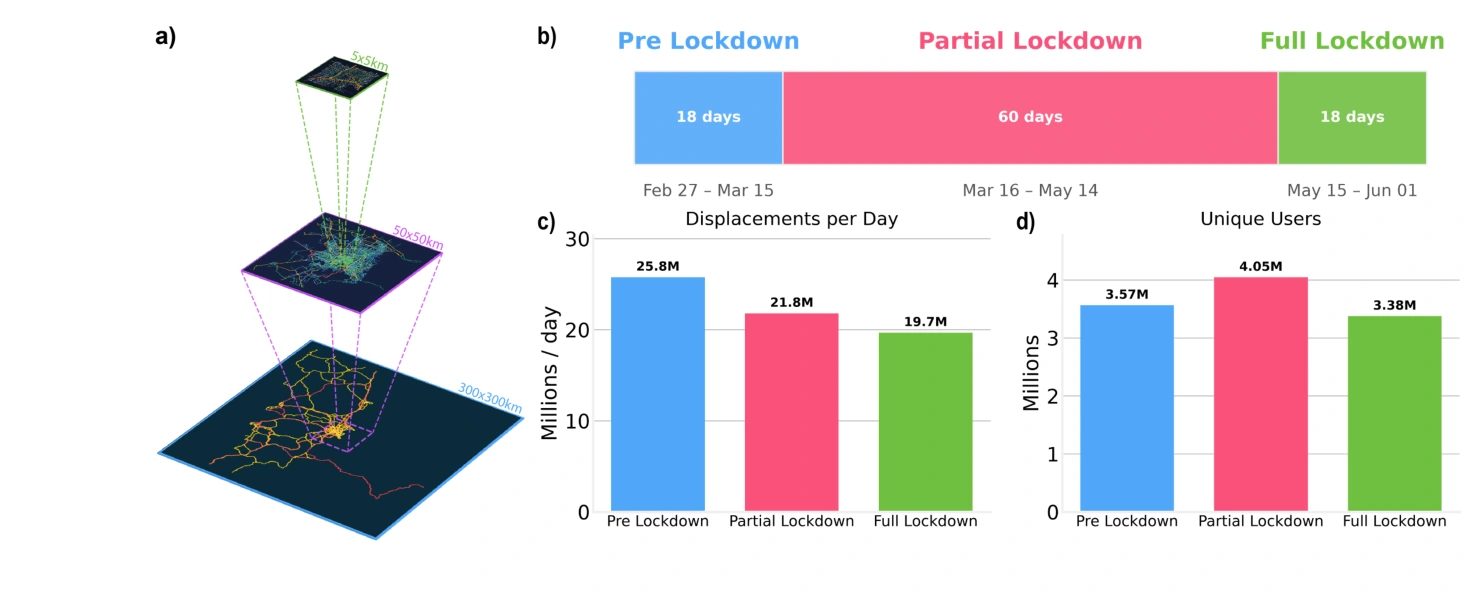
图 1|这套位移覆盖哪些距离层级,三个时期的条数和人数各是多少?
(a)示意三层空间范围:5×5 公里、50×50 公里、300×300 公里。图注写限制期间最大的一层被拿掉;这是示意图,不是实测的长距离份额变成零。(b)三个时期的日历和天数:18 天、60 天、18 天。(c)每日位移条数,纵轴为百万条每天:25.8、21.8、19.7。(d)各期去重用户数,纵轴为百万人:3.57、4.05、3.38。来源:原论文 Fig. 1。
全体分布在每个时期都可以套一个截断幂律,密度与 Δr 的 −α 次方成正比,再乘 exp(−Δr/λ)。α 描述尾巴有多陡,λ 是再把极远位移压下去的尺度。似然比在每个时期都更偏向对数正态,P 接近 0。所以“可以报出一个幂律指数”和“幂律比对数正态更符合全体数据”是两件事。指数从 1.657 升到 1.737,差 +0.080。图 2 把中间时期标成 1.722。
位移中位数只从 1.98 公里降到 1.90 公里。正文没有写明这条中位数是全体位移还是某个子样本。回转半径是另一个量:一个人在该时期各次位置到其重心的均方根距离,概括活动范围,不是单次出行长度。正文写,286 万名封锁前和全面限制都出现的用户,回转半径中位数从 7.31 公里降到 2.29 公里,降幅 69%,分母是 7.31 公里。图 2d 的图例则把三期中位数印成 10.5、6.3 和 3.8 公里。两个中位数都写在 PDF 里,论文没有解释差额。后文引用时会标明出处。
指数上升有一种很省事的来源:样本里远距离的人变少了,全体尾巴自然变陡,每个人的位移可以一条都没改。检验办法是只重排封锁前的人,让他们的回转半径分布对齐全面限制,再用这些人封锁前的位移重新拟合。补充材料里,有效样本量 5,788,与目标分布的 KS 距离从 0.27 降到 0.02。指数从 1.673 升到 1.814,构成造成的变化是 +0.141 ± 0.003。同一面板上,全面限制相对封锁前的真实变化只有 +0.065。脚注说明,+0.080 来自人口拟合,+0.065 和 +0.141 来自面板拟合。
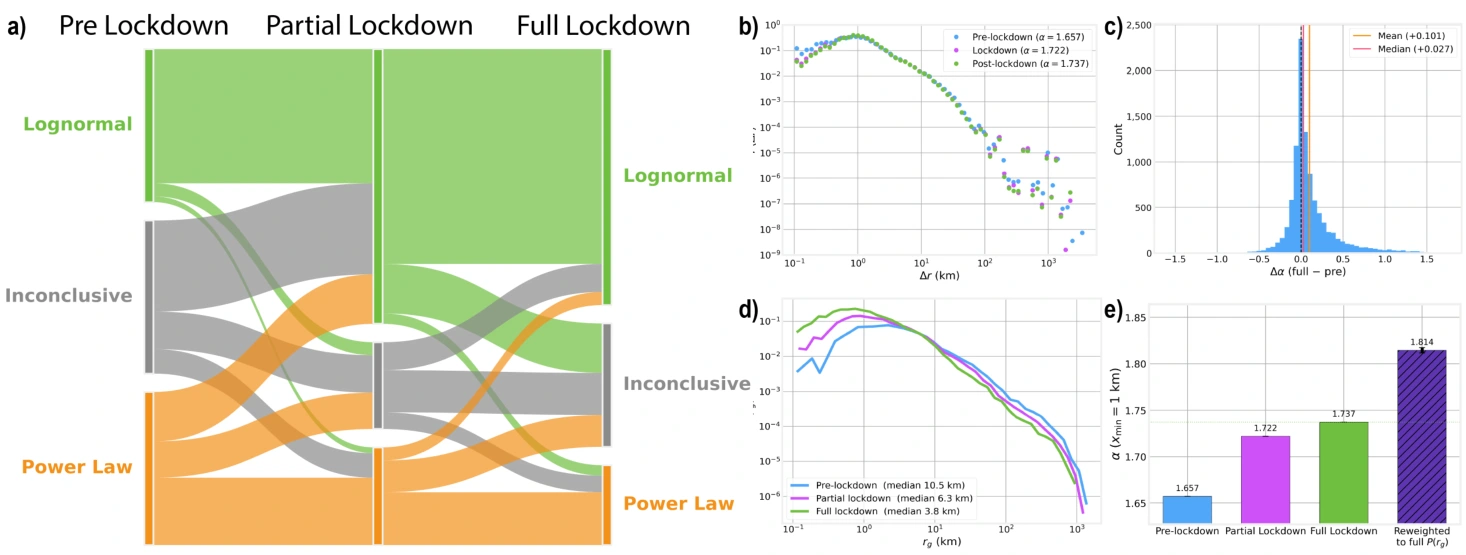
图 2|限制加深时,个人分类、全体指数和活动范围怎样一起变?
(a)约 1 万人在三个时期之间的模型类别流动。绿为对数正态,灰为无法判定,橙为截断幂律。对数正态的带子更稳,幂律的带子散向另外两类。(b)全体位移的分布,横轴距离(公里)。图例把三个指数印成封锁前 1.657、Lockdown 1.722、Post-lockdown 1.737;与(e)的 1.722、1.737 对照,后两个分别是部分限制和全面限制。(c)同一人全面限制减去封锁前的指数差。橙线均值 +0.101,粉线中位数 +0.027。正文把均值写成 +0.102,95% 区间 +0.096 到 +0.107。(d)回转半径分布。图例中位数为 10.5、6.3、3.8 公里,与正文 7.31 到 2.29 公里不是同一印刷值。(e)下限 1 公里时的全体指数:1.657、1.722、1.737,以及再加权条 1.814。来源:原论文 Fig. 2。
图 2e 把 1.657 和 1.814 放在同一轴上。1.814 减 1.657 等于 0.157,这个差不是论文报告的构成效应。构成效应的基线是面板拟合的 1.673。
若每个人本来就是截断列维飞行,同样的再加权也可能移动指数。补充材料用面板里真实的回转半径和位移条数做了模拟,每个人共用指数 1.66。
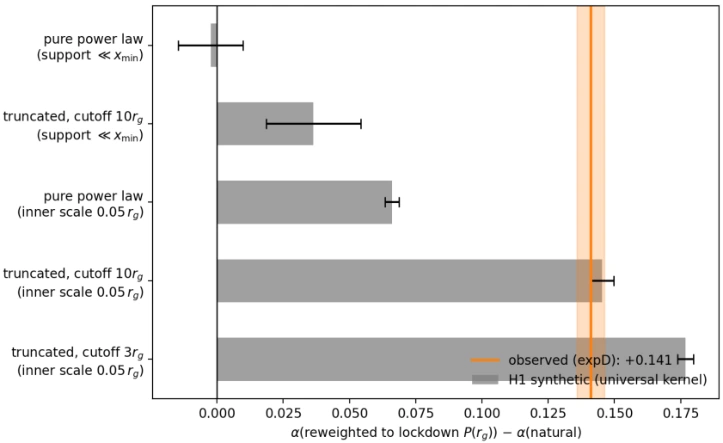
图 S13|若个人真是幂律,只改活动范围的构成,指数会动多少?
无字母子图。横轴是再加权之后的指数减去自然构成下的指数。橙线标成经验再加权 +0.141。灰条是同一再加权用到模拟的个人幂律世界上,误差线为 ±2 个标准差。纯幂律且支撑远小于下限时,变化是 −0.002 ± 0.006。加上截断或 0.05 倍回转半径的内尺度之后,变化为 +0.036 ± 0.009、+0.066 ± 0.001、+0.145 ± 0.002 和 +0.177 ± 0.001。这些幅度把 +0.141 夹在中间。来源:原论文 Fig. S13。
面板上真实的 +0.065 也落在后四条模拟幅度里。再加权因此是一句充分性陈述:构成变化足以让全体指数变陡。它没有证明只有容器混合才会变、列维飞行不会变。全体指数要退到后面,个人分类和与模型形式无关的尾巴检验才是主要证据。
同一些人身上,距离分布怎样移动?
为了把行为变化和“谁还在样本里”分开,作者先取三个时期都至少有 50 次位移的人。补充材料写明这一面板有 1,520,570 人,正文约记为 152 万。个体拟合从这个面板抽约 1 万人。补充表 S4 把 991 人称为原先的样本,把 1 万人称为正文所报告的样本;方法段则写种子 42 的 1 万人主样本和种子 43、重叠约 1% 的重复样本。比例以下面这组 1 万人的印刷值为准。
每个人、每个时期,在 0.5 公里以上的位移上同时拟合截断幂律和对数正态,用 Vuong 似然比选择。标准化差值大约低于 −1.64 判对数正态,高于 +1.64 判截断幂律,中间是无法判定。这个界限对应双侧 P < 0.1,比常见的 5% 更宽。判给某一类,是两个简单公式谁更好,不是该公式已经通过绝对拟合。
补充表 S3 在封锁前、最少 50 次位移时列出 9,995 人:截断幂律 18.1%,对数正态 49.5%,无法判定 32.4%。补充表 S5 的全面限制是 13.9%、60.9% 和 25.2%。对数正态上升,幂律下降,无法判定仍占四分之一左右。不能把 60.9% 的补数理解成“其余都是幂律”。
转移也不对称。封锁前判为对数正态的人,78.7% 在全面限制时仍是对数正态,4.9% 转到幂律。封锁前判为幂律的人,36.9% 保持,30.9% 转到对数正态。分母是封锁前属于该类的人,不是 1 万名全部用户。摘要写对数正态保留 81%、幂律保留 32%。表 S4 的 991 人列是 80.9% 和 32.3%,1 万人列是 78.7% 和 36.9%。摘要对齐的是较小的那一列。
图 2c 的配对指数差,均值标成 +0.101,中位数 +0.027。正文写均值 +0.102,95% 区间 +0.096 到 +0.107,Cohen’s d = 0.349,配对 t = 34.8,P = 8.8 × 10⁻²⁵¹。d 的分母是配对差值的标准差。P 很小,很大程度上是因为配对人数大约有 1 万;0.349 才是效应有多大。中位数远小于均值,因为右尾上少数升幅大的人把均值拉高。讨论写约 40% 的人指数是下降的。
全面限制时每人的位移条数更少,分类会不会只是因为点变少?作者把每个人的封锁前位移随机抽到与全面限制同样多,重复 10 轮。表 S5 的分母是同一批用户。
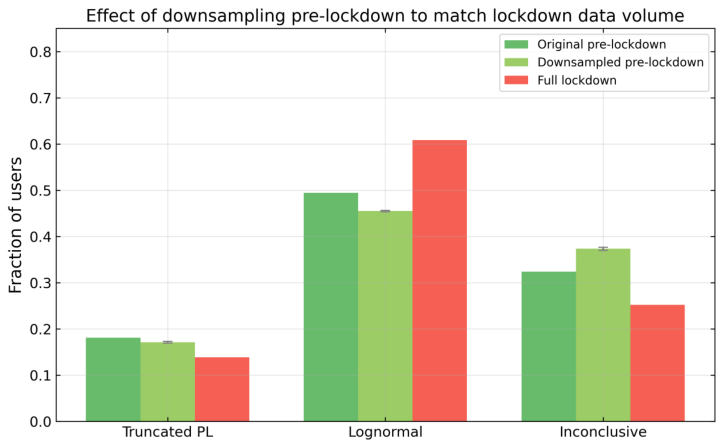
图 S4|分类变化是因为限制期间点数变少了吗?
无字母子图。三组柱从左到右是截断幂律、对数正态、无法判定,纵轴为用户比例。深绿是原来的封锁前,浅绿是把封锁前抽到与全面限制同样条数,红是全面限制。浅绿靠近深绿,红的对数正态柱明显更高。来源:原论文 Fig. S4。
抽稀之后,对数正态从 49.5% 变为 45.5% ± 0.2%,截断幂律从 18.1% 变为 17.1% ± 0.2%,无法判定从 32.4% 变为 37.4% ± 0.3%。全面限制的对数正态是 60.9%。条数变少带来的对数正态变化约 4.0 个百分点,限制前后的差别是 11.4 个百分点。个人指数的中位数从 1.720 到抽稀后的 1.700,全面限制是 1.807。这三个数是个人指数的中位数,不是全体的 1.657 和 1.737。
封锁前再对半切开,8,854 名两半都至少有 30 次位移的人,幂律比例为 17.3% 和 17.5%,个人指数的相关系数 r = 0.828,平均变化 +0.002,P = 0.39。封锁前这段基线在时间上是稳的。
绝对拟合则把两个模型都拉回地面。对 2,000 人重做检验后,在已经分出胜负的人里,获胜模型能通过 KS 检验的比例,封锁前和全面限制都只有 4.7%,部分限制只有 0.7%。方法段的自助法也写,两个模型都无法在超过 95% 的人–时期上通过 5% 水平的绝对检验。
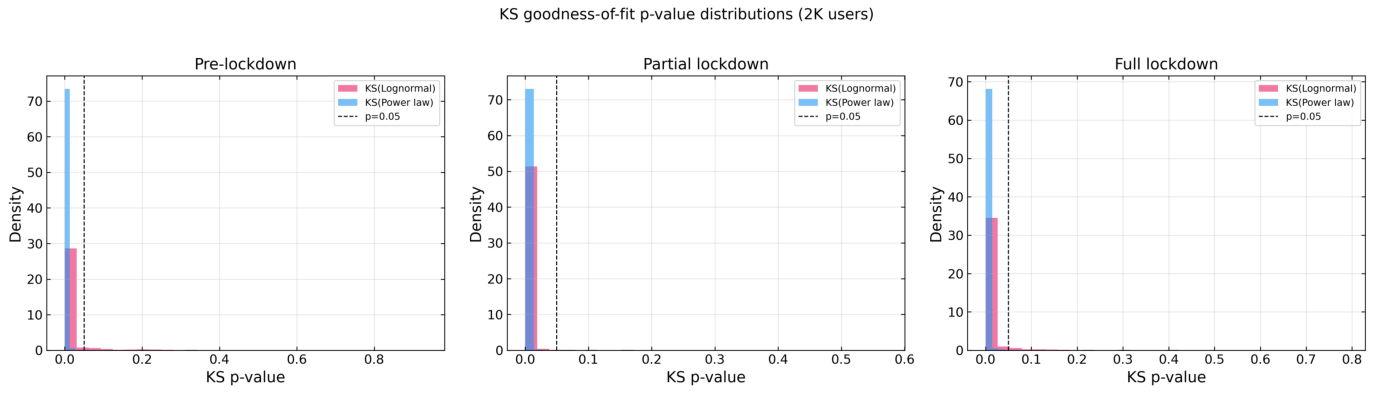
图 S1|对数正态赢了比较,是否就说明它拟合好了?
无字母子图,从左到右为封锁前、部分限制、全面限制,标题写 2,000 人。横轴是 KS 检验的 p 值,虚线为 0.05。粉柱是对数正态,蓝柱是幂律。两色的质量都堆在虚线左侧。来源:原论文 Fig. S1。
因此,对数正态是更稳的比较赢家,同时仍是近似。下限也会改比例。200 人的封锁前试探里,下限 0.5 公里时对数正态为 52.0%;数据驱动下限的中位数是 1.50 公里,与固定 0.5 公里的分类一致率只有 43.6%。方向还在,精确百分比依赖下限。这 200 人的 52.0% 不能换成 1 万人的 49.5%。
条数对齐之后,长尾还在个人身上吗?
个人点数少于全体,幂律检验本来就更难通过。作者把条数配平:1,537 名封锁前至少 300 次位移的用户,每人取最长的 20% 作为尾巴,再抽一个同样条数的全体混合样本,用最大熵方法检验这段是不是幂律。表 S3 在最少 300 次时也是 1,537 人,所以这是 1 万人拟合样本里点数足够的那一部分,不是 440 万用户的随机子集。
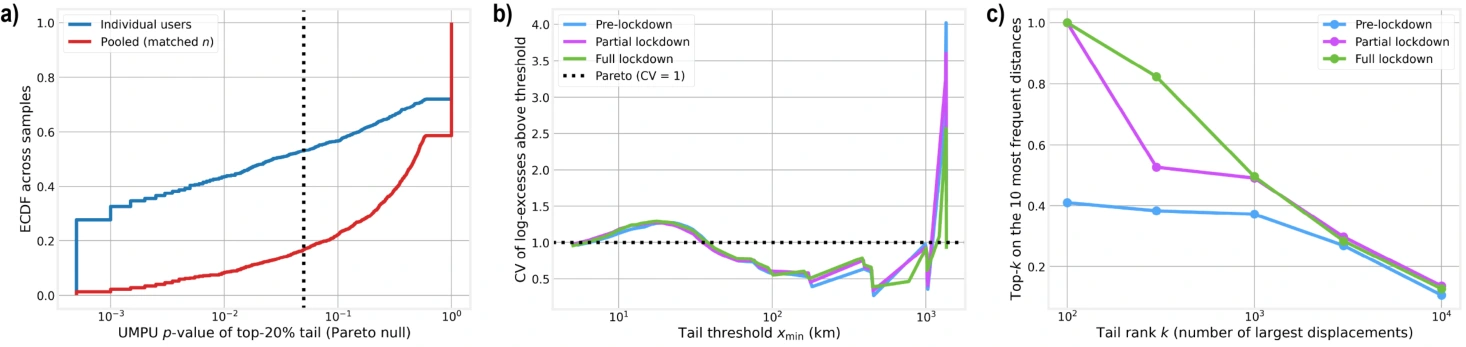
图 3|同样的尾巴长度下,幂律属于个人还是属于混合样本?有没有一个距离门槛真正停在幂律上?
(a)最长 20% 尾巴的最大熵检验 p 值的累积分布。蓝是个人,红是条数配平的混合样本,虚线在 0.05。蓝线上升更早,小 p 值更多。(b)对数超额的变异系数对尾巴门槛(公里)。三期各一条曲线,点线是幂律要求的 1。曲线在大约 10 到 30 公里高于 1,之后低于 1,最远端再冲高。(c)最长的 k 条位移里,出现次数最多的 10 个距离值占了多少。横轴是 k。部分限制和全面限制在最左端接近 1,封锁前大约在 0.4。来源:原论文 Fig. 3。
表 S13 给出配平后的数。5% 水平拒绝幂律的份额,个人 52.9%,混合样本 16.7%。p 值中位数分别是 0.027 和 0.476。被判成幂律的那一段占尾巴的中位比例,个人 0.096,混合样本 0.281,大约三倍。变异系数中位数个人 0.801,混合样本 0.973,幂律的参照值是 1。混合样本有 45% 顶到长度上限,个人只有 22%,所以“三倍”是偏向下界的比较。
重复的通勤距离也解释不了这个差距。几乎没有重复距离的 55 人仍有 51% 拒绝,他们对应的混合样本是 13%。分母是这 55 人及其配平样本,不是 1,537 人全体。
从近扫到远,有哪一段真是幂律?
真正的幂律尾巴里,对数超额的变异系数在每个门槛上都该等于 1。作者在每期大约 200 万条的样本上逐个门槛扫描。图 3b 的曲线没有停在 1 上。大约 10 到 30 公里高于 1,城市尺度和区域尺度的对数正态叠在这里;大约 50 到 800 公里低于 1,落在容器内部。双侧检验在三个时期都拒绝了 97% 到 98% 的门槛。补充图 S10 的文字说明把分工写得更细:大约 39 到 1,020 公里,单侧检验的 p 低于 10⁻⁴⁰;大约 35 公里以内对数超额过度离散,双侧检验的 p 低于 10⁻¹¹。连续模型在大约 1,330 到 1,580 公里的重复距离上不再适用。
最远的尾巴是少数重复距离,不是一条光滑曲线。200 万条样本里最长的 100 条,不同距离值的个数从封锁前的 67 降到部分限制和全面限制的 7。全面限制下最常见的一个值是 2,418.3 公里,在这 100 条里出现 40 次。表 S11 的分母分别是最长 100 条和最长 1,000 条。
| 时期 | 最长 100 条里的不同距离数 | 前 10 个距离占这 100 条的比例 | 最长 1,000 条里的不同距离数 | 前 10 个距离占这 1,000 条的比例 |
|---|---|---|---|---|
| 封锁前 | 67 | 41% | 261 | 37% |
| 部分限制 | 7 | 100% | 167 | 49% |
| 全面限制 | 7 | 100% | 140 | 50% |
大约 1,000 公里以上的这些重复距离约占记录的 0.3%。论文没有在这句话旁边再给绝对条数。图 3c 左端的高低,和这张表的 41% 与 100% 是同一件事:限制之后,最长的那些位移挤到更少的距离值上。
小样本会把对数正态的顶端看成幂律。表 S12 从封锁前的全体里逐级抽样本,k*/N 是与幂律相容的尾巴占该样本的比例。
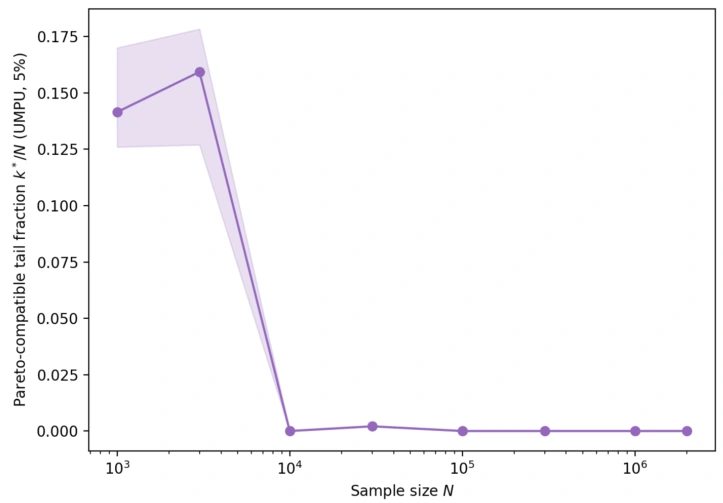
图 S11|样本要多大,看起来像幂律的那段尾巴才消失?
无字母子图。横轴样本量,纵轴是 5% 的 UMPU 检验下与幂律相容的尾巴比例 k*/N。几千条时大约在 0.14 到 0.16,到 1 万条落到 0 附近。浅色带是波动范围。来源:原论文 Fig. S11。
表上的比例是:1,000 条为 0.142,3,000 条为 0.159,1 万条为 0,3 万条为 0.002,10 万条及以上为 0。讨论把经典研究概括成 10³ 到 10⁵ 的样本、并说要到数百万条才消失。表 S12 更具体:尾巴比例在 1 万条时已经是 0。
模型比较的方向不靠这段尾巴才成立。下限取 1 公里时,Vuong 统计量在每个样本量都偏向对数正态,从 1,000 条的 R = −3.1 到 200 万条的 R = −155。负号在这里表示对数正态更好,绝对值随样本量的平方根变大。拟合出的指数一直在 1.66 附近。
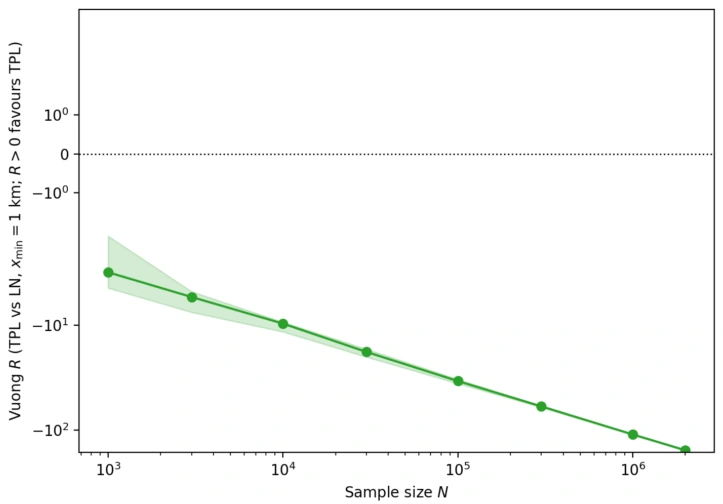
图 S12|样本量改变时,两个模型谁更好变了吗?
无字母子图。横轴样本量,纵轴是截断幂律相对对数正态的 Vuong 统计量,下限 1 公里,R > 0 偏向截断幂律。曲线全程低于 0,并随样本量更低。端点数值以正文的 −3.1 和 −155 为准。来源:原论文 Fig. S12。
同一数据上也复算过 González 等人 2008 年补充分析里的距离部分。位移指数是 1.74,对照文献为 1.75。普通 KS 检验拒绝位移分布的截断幂律;更看重尾巴的加权 KS 给出 p = 0.148,没有拒绝。这和上面的分工一致:身体偏离幂律,最远的一段在某些检验里仍可能过关。
四层距离拆开再拼回去,还像原来的全体吗?
四层阈值是:5 公里以内为近邻,5 到 50 公里为城市,50 到 300 公里为区域,300 公里以上为长距离。这和 Alessandretti 等人使用的 3、27、88、162 公里不同。作者写圣地亚哥的远尾更稀,所以把箱子放宽。阈值是距离代理,不是直接观察到的空间层级。
补充表 S8 只给了封锁前。四层条数相加是 463,960,238,比表 S1 的封锁前总数少 2 条。百分比是论文印刷值,相加为 100.1%,属于四舍五入。
| 距离层 | 位移条数 | 占封锁前位移的比例 | 表 S8 的 R(正值偏向对数正态) | 强行拟合的幂律指数 |
|---|---|---|---|---|
| 近邻,< 5 公里 | 340,985,722 | 73.5% | +100,070 | 1.108 |
| 城市,5–50 公里 | 116,393,937 | 25.1% | +3,543 | 2.258 |
| 区域,50–300 公里 | 3,947,837 | 0.9% | +713 | 2.847 |
| 长距离,> 300 公里 | 2,632,742 | 0.6% | +3,043 | 2.042 |
近邻一层就占封锁前位移的约四分之三。区域和长距离加起来约 1.5%。全体指数 1.66 附近,很大程度是这四层流量叠出来的斜率。表里的幂律指数是在该层上仍去拟合幂律时得到的数;近邻层的 1.108 明显扁于全体的 1.66。若该层的似然比已经偏向对数正态,这个指数就不是获胜模型的参数。
部分限制和全面限制的分层条数,表 S8 没有给。不能把图 1a 的示意图读成 300 公里以上的份额已经测到为零。
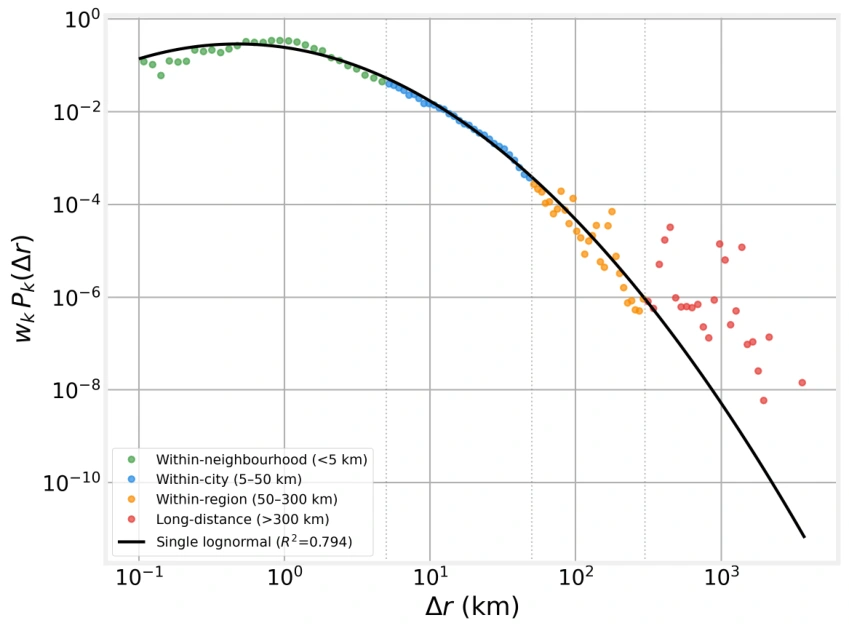
图 5|封锁前,四层距离叠在一起之后,一条对数正态盖得住吗?
无字母子图。横轴距离(公里),纵轴是该层权重乘以该层密度。绿点小于 5 公里,蓝点 5 到 50 公里,橙点 50 到 300 公里,红点大于 300 公里。黑线是单条对数正态,图例 R² = 0.794。红点在远尾散开,有些明显高出黑线。来源:原论文 Fig. 5。
正文说四层混合重建全体,并把 R² = 0.977 和 0.984 指到图 5。图例实际印的是单条对数正态 0.794。0.977 和 0.984 出现在表 S9 的核密度一列。核密度在对数距离上分别估计每一层,再按该层位移占比相加。硬生生把对数正态截在箱子边缘再相加,会在边界处掉到零,R² 是负数。
| 时期 | 各层硬截断对数正态的 R² | 按层核密度混合的 R² | 自由的四成分高斯混合 R² |
|---|---|---|---|
| 封锁前 | −5.547 | 0.977 | 0.898 |
| 部分限制 | −13.034 | 0.615 | 0.864 |
| 全面限制 | −13.895 | 0.984 | 0.863 |
两端时期,按观测权重混合的核密度能重建全体。部分限制只有 0.615,同一时期自由的四成分混合仍有 0.864。固定的 5、50、300 公里边界在过渡期跟不上位移构成的移动。混合成功依赖边界和时期是否合拍,不能概括成任何时期都有 0.98。
层内谁获胜,图和表也不完全同一句话。正文写,5 公里以内在试过的每一套阈值上都是对数正态,5 到 50 公里混合,五套阈值一共 23 次层内比较里对数正态赢 11 次、幂律赢 12 次。
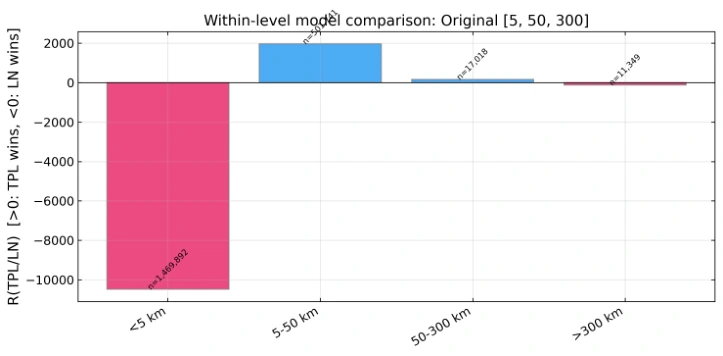
图 S6|原始阈值下,每一层更偏向哪个模型?
无字母子图。标题为原始阈值 5、50、300 公里。纵轴是截断幂律相对对数正态的统计量,正值偏向截断幂律,负值偏向对数正态。5 公里以内的柱为负,并落到 −10,000 以下;5 到 50 公里的柱为正,顶在 2,000 刻度。更远两档的柱接近 0。图注写最短层强力偏向对数正态,5 到 50 公里偏向截断幂律。来源:原论文 Fig. S6。
表 S8 却把四层的 R 都印成正值,并注明正值偏向对数正态,其中 5 到 50 公里是 +3,543。近邻层两边都指向对数正态。5 到 50 公里这一层,图 S6 指向截断幂律,表 S8 的符号指向对数正态。读的时候不能把表 S8 的四个正号理解成四层已经一致支持对数正态,也不能单用图 S6 宣布中间层已经定案。柱上的小字在 PDF 里太密,这里不把它们改写成精确的 R 或样本量。
一层之内为什么会接近对数正态,论文给的是定性理由:一层里的出行长度是许多正因子的乘积,例如目的地类型、路径和是否去得成。正因子的乘积趋向对数正态。补充图 S8 是 5 公里以内约 150 万条对数位移的正态分位图,身体接近直线,两端偏离。各层的正式正态检验都拒绝严格的对数正态。层内规律是近似。
图 S7 则表明,四条对数正态按设定权重相加,可以造出接近 α = 1.67 的全体曲线。图例权重是近邻 73%、城市 20%、区域 6%、长距离 1%。这是模拟设定。封锁前的观测份额是 73.5%、25.1%、0.9%、0.6%。73% 接近观测的近邻份额,另外三层并不相同。
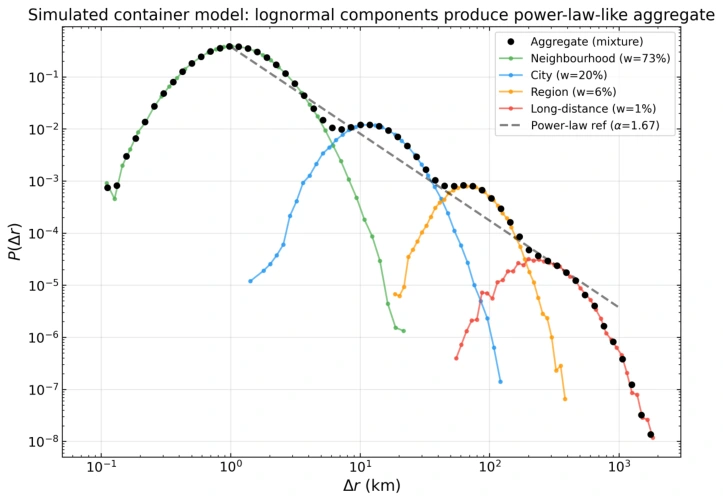
图 S7|只把四层对数正态加起来,能不能看起来像幂律?
无字母子图。横轴距离,纵轴密度。绿、蓝、橙、红是四层对数正态,黑点是它们的混合,灰虚线是 α = 1.67 的参照。图例权重是模拟用的 73%、20%、6%、1%。来源:原论文 Fig. S7。
这张图说明混合在机制上做得到,不说明智利数据就是用这四个权重生成的。
按每个人的活动范围缩放,曲线会叠到一起吗?
列维飞行有一个尖锐的预测:把每个人的位移除以自己的回转半径,不同活动范围的人应落到同一条曲线上。作者把人按回转半径分成七箱。图 4 的图例是 1–3、3–5、5–10、10–20、20–50、50–100、100–300 公里,与补充材料的切点一致。方法段把第二个切点写成 2 公里,和这张图不同。叠合好坏用七箱密度的变异系数衡量,远低于 0.1 才算叠得好。方法段写 100 个评估点,补充材料写 40 个;图上印出的三个数是 0.616、0.657、0.762。
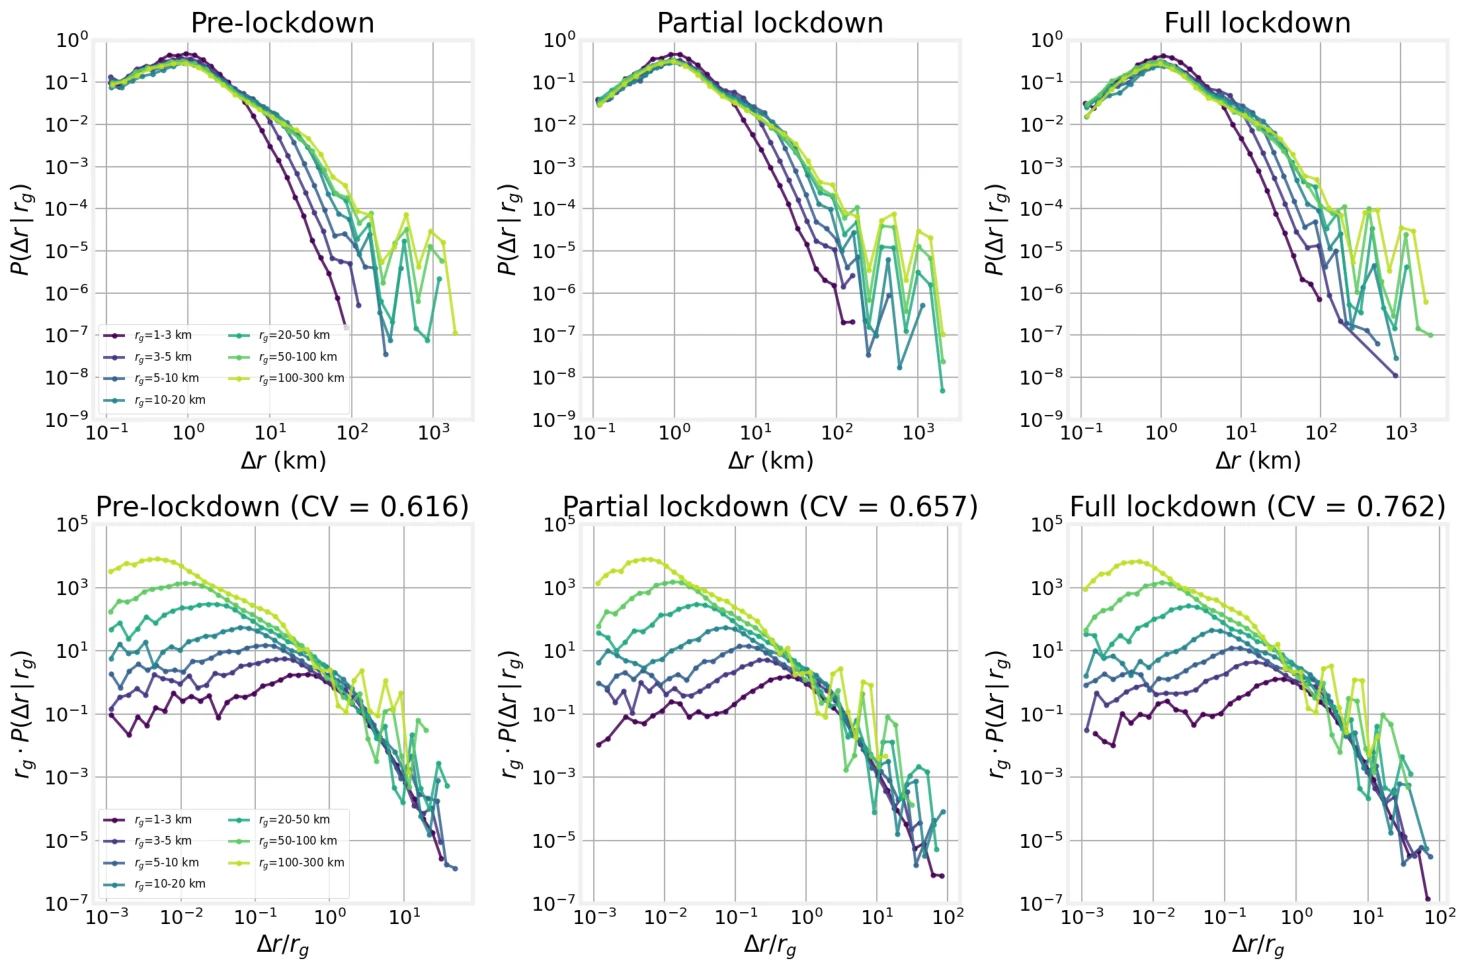
图 4|用回转半径把位移缩放之后,不同活动范围的人会落到同一条曲线吗?
无字母子图,上排从左到右是封锁前、部分限制、全面限制的条件分布 P(Δr | rg),横轴为距离(公里)。下排是乘回 rg 之后对 Δr/rg 的分布,标题中的变异系数依次为 0.616、0.657、0.762。颜色对应七个回转半径箱。下排的线在横轴左端分开,右端抖动,没有合成一条细线。来源:原论文 Fig. 4。
变异系数随限制加深而上升。若指数属于每个人自己的过程,缩放后的重合不该依赖活动范围,也不该在长距离被压低后变差。容器解释则预期:远箱的人平时跨层,跨层的位移被拿掉以后,他们的曲线更难和近箱重合。
正文还按封锁前回转半径的四分位比较配对指数变化:最低四分位平均变陡 +0.051,最高四分位 +0.184,两样本 t = 15.0,P < 10⁻⁴。这是 1 万人主结果的文字,图 4 里没有四分位面板。摘要的 P = 0.0003 与表 S4 里 991 人那一列相同,1 万人列写的是 P < 10⁻⁴。PDF 没有给出每个四分位的人数。活动范围大的人变陡更多,和“他们失去的是跨层位移”相符;列维飞行没有给出这条梯度的理由。这条梯度仍是时期对比下的差异,不是对每一个人出行决策的因果分解。
这些比较能说到哪里?
个人分类、配平后的尾巴、全样本门槛扫描和缩放失败,指向同一件事:重尾在把人混在一起之后才明显,近处位移更接近对数正态。全体指数从 1.657 到 1.737 的方向与此相符,但再加权和模拟都表明,这个方向单独成立不了机制判断。
还有几条边界要留在结论旁边。比较赢家不等于绝对拟合,4.7% 的通过率已经说明。下限从固定 0.5 公里改成数据驱动之后,分类一致率只有 43.6%。约 40% 的人指数下降,d = 0.349 是小到中等的配对效应。距离阈值是容器的代理。分析只用了位移长度,没有方向,也没有时刻。数据来自一个国家的一段特殊时期,具体幅度换一个国家或另一年不必相同。
空间取整也会改标签。补充表 S6 在封锁前、未取整的 2,029,724 条上判对数正态,指数印成 1.752;取整到 1 公里的 1,869,394 条上改为截断幂律,R = +159,指数 1.940。0.5、2 和 5 公里取整仍是对数正态。1.752 和 1.940 属于这张稳健性表,不是图 2 的 1.657。把基站重投到 1、2、5、10 公里格网后,表 S7 都判对数正态。4,858 个基站是这段检验里的塔数。聚合结论对多数空间粒度还在,但存在一个会翻盘的取整。
交通方式的分解不在这套操作里。不能从四层距离份额推出步行、公交或驾车各自的距离分布。
一句话总结
智利这三期位移里,像幂律的长尾出现在不同距离层级被放到一起之后;个人位移的比较拟合更偏向对数正态,长距离减少后这种偏向更稳,但两种简单公式都远不是完整描述,全体指数变陡也不能单独判定机制。
核心来源
- arXiv:2608.23194v1,2026 年 8 月 24 日,physics.soc-ph。同一 PDF 共 23 页,含正文与补充材料。首页和文末未印 DOI。
- 正文图 1–5,补充图 S1–S13,补充表 S1–S14。本文图片来自该 PDF。方法段提到的 Extended Data 没有另一份独立文件,最少位移条数的结果写在同一 PDF 的表 S3。
- 两种对照解释在参考文献中的出处:González、Hidalgo、Barabási,Nature,2008;Alessandretti、Aslak、Lehmann,Nature,2020。
作者介绍
论文没有贡献声明。下面只写 PDF 上的署名。
- Leo Ferres:智利发展大学数据科学研究所,以及意大利都灵 ISI Foundation。参考文献中,他是一份智利移动变化数据集的共同作者。
- Bruno Gonçalves:ISI Foundation,以及纽约 Data For Science, Inc。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市只公布全体出行的一个指数,长途减少之后这个指数会变陡,即使留下来的每一层内部规则没变。论文已经给出数量级:只改回转半径的构成,指数可以增加 0.141,而面板上的真实变化是 0.065。和指数一起公布四层位移份额,才能看出变陡有多少来自混合权重。份额的分母需要固定为位移条数,并说明是全体记录还是某一类出行。
固定的 5、50、300 公里边界在两端时期能把全体拼回去,在部分限制时期 R² 降到 0.615。下一步值得让边界随时期移动,再看这个缺口是否闭合。若闭合,混合说法依赖边界跟着行为走;若仍留着缺口,过渡期就还有这四层没有吃掉的结构。这是一个可计算的问题,不是这篇预印本已经完成的检验。
取整到 1 公里会把封锁前的全体比较从对数正态翻成截断幂律,相邻的 0.5 公里和 2 公里又翻不了。以后报告一条距离分布时,至少同时给出两个相邻取整下的赢家和样本量。只在一个格子上宣布幂律或对数正态,还没有经过这张表已经显示会改变标签的那一项检查。