个人轨迹和城市人流,能不能由同一个生成网络一起学会?
论文名片|Yuan Yuan、Jingtao Ding、Depeng Jin、Yong Li,Learning the complexity of urban mobility with deep generative network,PNAS Nexus,2025,4(5):pgaf081,2025年5月6日提前在线发表;2024年7月21日收稿,2025年2月6日接收。DOI:10.1093/pnasnexus/pgaf081。研究快报。文末另印有预印本 DOI:10.21203/rs.3.rs-3666762/v1。
早上要从家里去下一个地方。昨天常去的店还在,可是今天那一片已经挤了,有的人会改去另一处。许多人一起改,区域之间的人数就变了;人数一变,下一个人看到的“别人怎么走”也不一样。个人轨迹和城市人流是互相牵着的。只把一条轨迹生成得像真的,或者只去拟合一张起讫流量表,都可能把这层牵制留在模型外面。
这项研究把两边放进同一个深度生成网络 DeepMobility。网络按历史选择下一步地点,同时让许多人的选择汇总成区域间人数。它没有证明某条物理公式是唯一机制。它表明:在北京、上海、深圳和塞内加尔这四套观测上,一个同时受个体分布和人口流量约束的生成模型,可以把流量重合提高到明显高于只按个体规则行走的模型,并在生成结果里重新看到若干已知标度律。个体的五项分布距离并没有因此每一项都更近。换到没有训练轨迹的城市时,作者还拿掉了流量反馈,精度也不再是完整模型的精度。
先说结论
- 生成器不是把每个人的下一步独立抽出来再相加。历史习惯和人口流向按一个不确定度二选一;流量误差再拆回单步选择。联合策略因此不等于个体策略的乘积。
- 流量重合 CPC 以各城最高的基线为分母:北京从 GAN 的 0.357 到 0.787,相对高 120%;上海从 GAN 的 0.324 到 0.686,相对高 112%;塞内加尔从 TimeGeo 的 0.359 到 0.650,相对高 81%。深圳从 TimeGeo 的 0.216 到 0.560,按这两数计算相对高 159%,正文写成 136%。
- 两个协作机制同时留下时,四城的 CPC 最高、流量平均绝对误差最低。个体五项分布距离不是每一格都由完整模型最好。
- 生成之后量到的跳转距离、回转半径、访问频率和距离—频率关系,呈截断幂律或幂律;指数随城市变化。三座中国城市之间换城生成时,跳转距离和停留时间的 JS 散度都小于 0.1,流量 CPC 约为同一简化模型在目标城市自训练时的 56% 到 95%。
复杂度卡在个人选择和人流互相改写
统计物理已经分别写下两类规律。个体上,单次位移、回转半径常呈截断幂律,人还会优先返回去过的地点,访问频率接近齐夫定律,不同地点的数目则增长得很慢。人口上,区域间流量可以用引力模型或辐射模型描述,到访人数与距离、访问频率的乘积也有接近平方反比的关系。这些规律尺度不同,写成互不相关的公式时,就没有地方表达“人流由个体走出来,个体又被当下的人流牵着”。
Alessandretti 等和 Yan 等曾用简化的物理模型连接不同地理尺度。DeepMobility 换了一条路:不先规定跳跃或返回的公式,而让网络直接从位置记录里学习下一步。作者认为,既有深度模型通常只生成轨迹,或只预测区域流量,没有把两个方向的影响放进同一次训练。
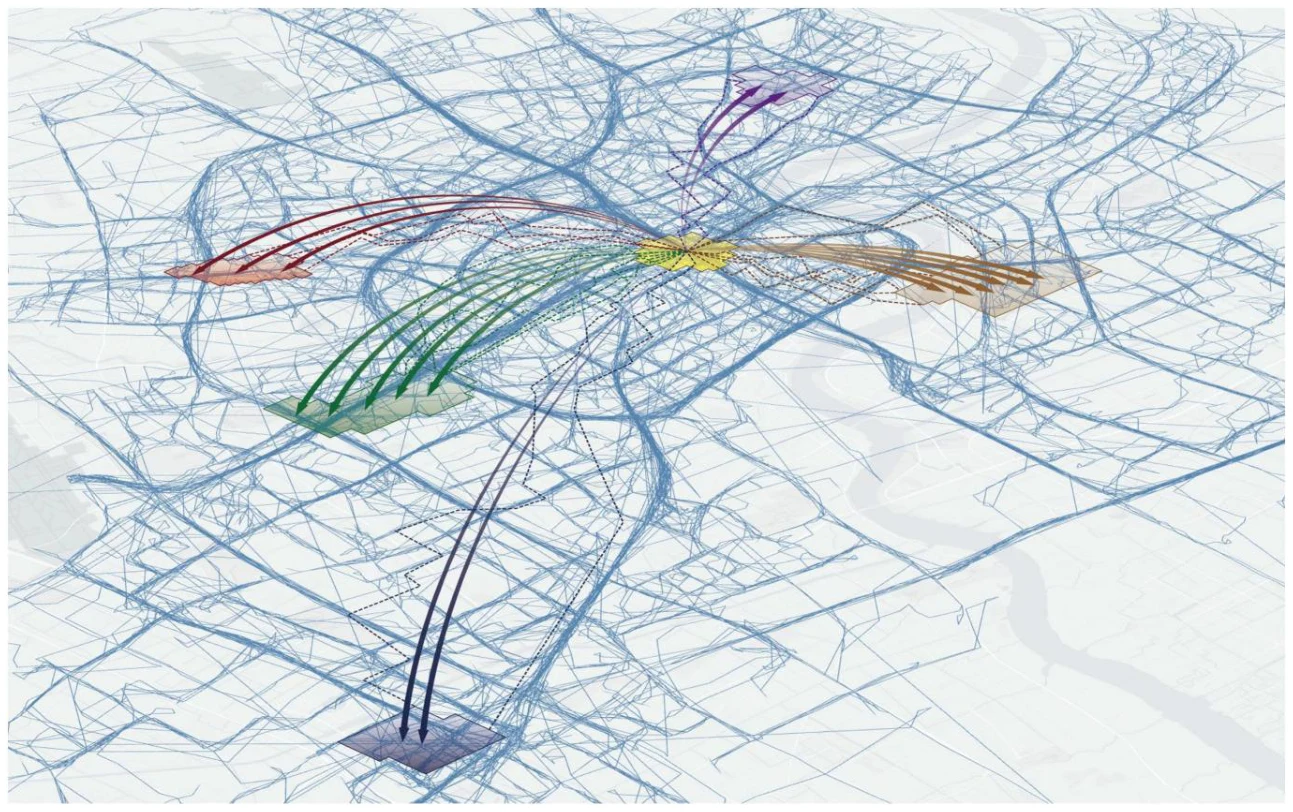
图 1|个体移动和区域人流是同一套出行的两层读法吗?
无字母子图。细线是地点之间的个体移动,较粗的彩色箭头是区域之间人数更多的流量;同色用来标出属于同一股流量的若干轨迹,多边形是区域。线多并不等于已经测到了互相影响,它只是把两层对象画在一起。来源:原论文 Fig. 1。
后文要学习的,就是这两层能否由同一个决策过程产生。给定某人在时刻 t 之前的历史,模型给出下一步地点的概率,再一个一个地点抽下去,得到轨迹。全体人使用联合策略。作者把训练写成两个目标:生成的下一步分布要接近观测分布,由联合策略汇总出的流量矩阵也要接近观测流量。难处在于联合策略不等于每个人策略的乘积;若可以相乘,人与人就没有通过当前人流发生影响。与此同时,个体策略还要接受人口层流量的约束。
四套记录,并不是同一种出行
主实验使用四套匿名位置记录。方法给出的是数据源里的大约用户数,不是清洗后的轨迹条数,也不是起讫对的个数。清洗、停留点与区域划分写在补充材料,主 PDF 没有印出区域个数和留出样本的切分方式。
| 数据 | 大约用户数 | 位置如何记下 | 时长 |
|---|---|---|---|
| 北京 | 约 180 万 | 位置服务注册用户,大约每小时一个位置 | 1 个月 |
| 深圳 | 约 32 万 | 与北京相同的记录方式 | 1 个月 |
| 上海 | 约 190 万 | 电信公司计费记录,在通话、短信或上网开始和结束时记位置 | 1 周 |
| 塞内加尔 | 约 30 万 | 匿名通话详单,时间分辨率 10 分钟 | 2 周 |
因此,停留时间在北京、上海、塞内加尔里不是同一把尺子:整点抽样、事件起止和 10 分钟,会把同一次停留切成不同长度。后文的分布比较都是在同一套数据内部,拿生成结果对真实结果,不能把四城的停留时间分布直接读成行为差异。流量定义为一段时间内从一个区域到另一个区域的人数。时段本身有多长,主文没有写死。
正文还说,主模型训练只使用位置记录,不另加城市专属信息。方法部分的人口模块又写入区域人口和兴趣点分布。若这两项是从同一份位置记录汇总出来的,它们仍来自移动数据;主文没有说明是否使用了独立的人口普查或地图数据。这个差别留到换城实验时会变得重要。
手机数据也不是全体居民。作者写明采集依赖手机使用,普及率随人群和地区变化;他们用随机抽样减少额外偏差,但没有在主文给出抽样比例。生成结果因此更接近这些记录里的移动,而不是一座城市每个居民的完整日程。
生成器为什么不能把每个人分开抽
DeepMobility 把移动看成一连串决策,并用生成对抗模仿学习来训练。地点是动作,到当前为止的访问历史是状态。一个人看不到全体人的完整状态,只能看到自己的历史,以及从当前区域出发、其他人流向各处的分布。作者用这套设定表达“别人怎么走”是有限可见的,而不是让模型读取每个他人的身份。
网络有三块。生成器产生轨迹和汇总流量。判别器判断这些轨迹、流量像不像观测。评价器把判别结果变成更新生成器的方向,算法用的是近端策略优化。个体判别器是一个门控循环单元,给“像不像真实轨迹”打分;人口侧不另训一个网络,直接计算真实流量和生成流量的相对差。
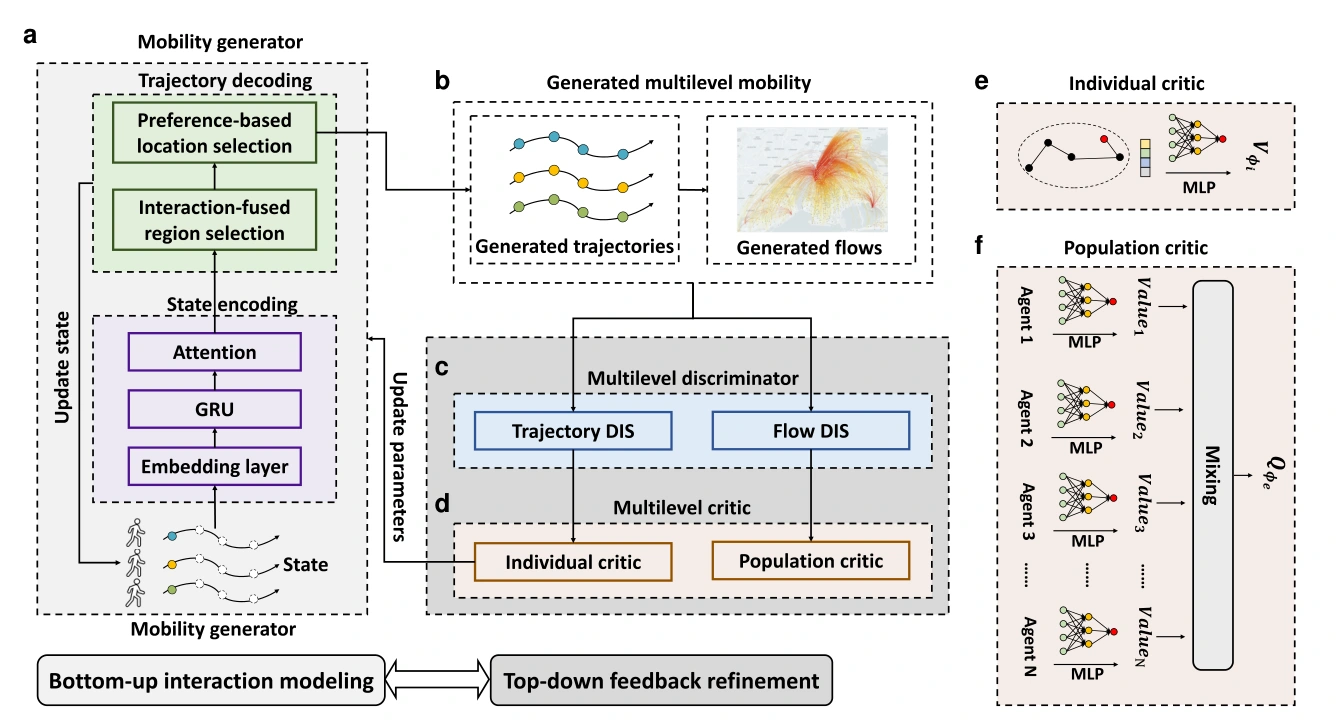
图 2|同一次训练里,个人选择和人口流量怎样互相送回梯度?
(a)生成器。嵌入层、门控循环单元和注意力把历史压成状态;解码时先做融合互动的区域选择,再按个人偏好在区域内选具体地点。(b)生成结果同时包含轨迹和由轨迹汇总的流量。(c)多层判别器分成轨迹判别与流量判别。(d)多层评价器分成个体评价与人口评价。(e)个体评价器由多层感知机给出这一步状态的价值。(f)人口评价器把许多个体的价值加总,再用来更新生成器。底部两个箭头分别标出生成器里的自下而上互动,以及评价器里的自上而下反馈。来源:原论文 Fig. 2。
自下而上发生在选区域的时候。一个模块只看个人历史,另一个模块看区域人口、兴趣点、距离和时间,用 10 个 64 维隐藏层的多层感知机给出各区域的人口侧概率。最终不是把两个概率平均,而是按一次伯努利选择:不确定度高,就更可能跟着人口模块;不确定度低,就跟着个人历史。不确定度来自历史向量经过多个头之后的方差,再压到 0 和 1 之间。头的个数主文没有给出。选完区域,再用注意力在该区域里选具体地点,因为各区域的地点数量不一样。
自上而下发生在评价器。人口层的价值若只对整张流量矩阵打一个分,就没法告诉某一次地点选择该往哪边改。作者把联合价值写成每个人价值的和,使流量反馈能回到单步决策。人口侧反馈的形式是真实流量减去生成流量,再除以真实流量。这是带符号的相对差,主文没有写明是对整张矩阵求平均还是逐格处理。它不是把生成轨迹配到某一个真实的人。
这套设计要回答的是表示问题:个体规律和人口流量能否在同一个策略里互相约束。它还不等于已经识别出人在街上使用的决策规则。
流量更重合,个体分布是否也全面更近
比较放在同一套观测内部。个体侧看五项目:单次跳转距离、一周出行距离、回转半径、同一地点的停留时间、一天访问的地点数。分布距离用 JS 散度,并以 KS 统计量作补充;两者都在 0 到 1,0 表示两个分布重合。人口侧看 CPC 和平均绝对误差。CPC 在 0 到 1,论文定义为 1 是两套流量相同、0 是没有重合;代数式正文没有写出。平均绝对误差与流量人数使用同一单位,但时段和区域划分未在主文给出,所以不同城市的绝对误差不能横向比大小。
基线有四个:连续时间随机游走 CTRW、探索与优先返回模型 EPR、TimeGeo,以及一次生成整条轨迹的 GAN。图中横轴把 GAN 写成 SeqGAN,图例仍写 GAN,对应正文引用的序列生成对抗网络。
需要先看清图号。正文和图注文字把分布差异、CPC 和流量散点放在 Fig. 3,把四条标度律放在 Fig. 4。这份 PDF 里两张结果图的画面位置是反的:标度律图印在 Fig. 3 图注上方,流量对比图印在 Fig. 4 图注上方。下面的图 3、图 4 按正文和图注文字编号。
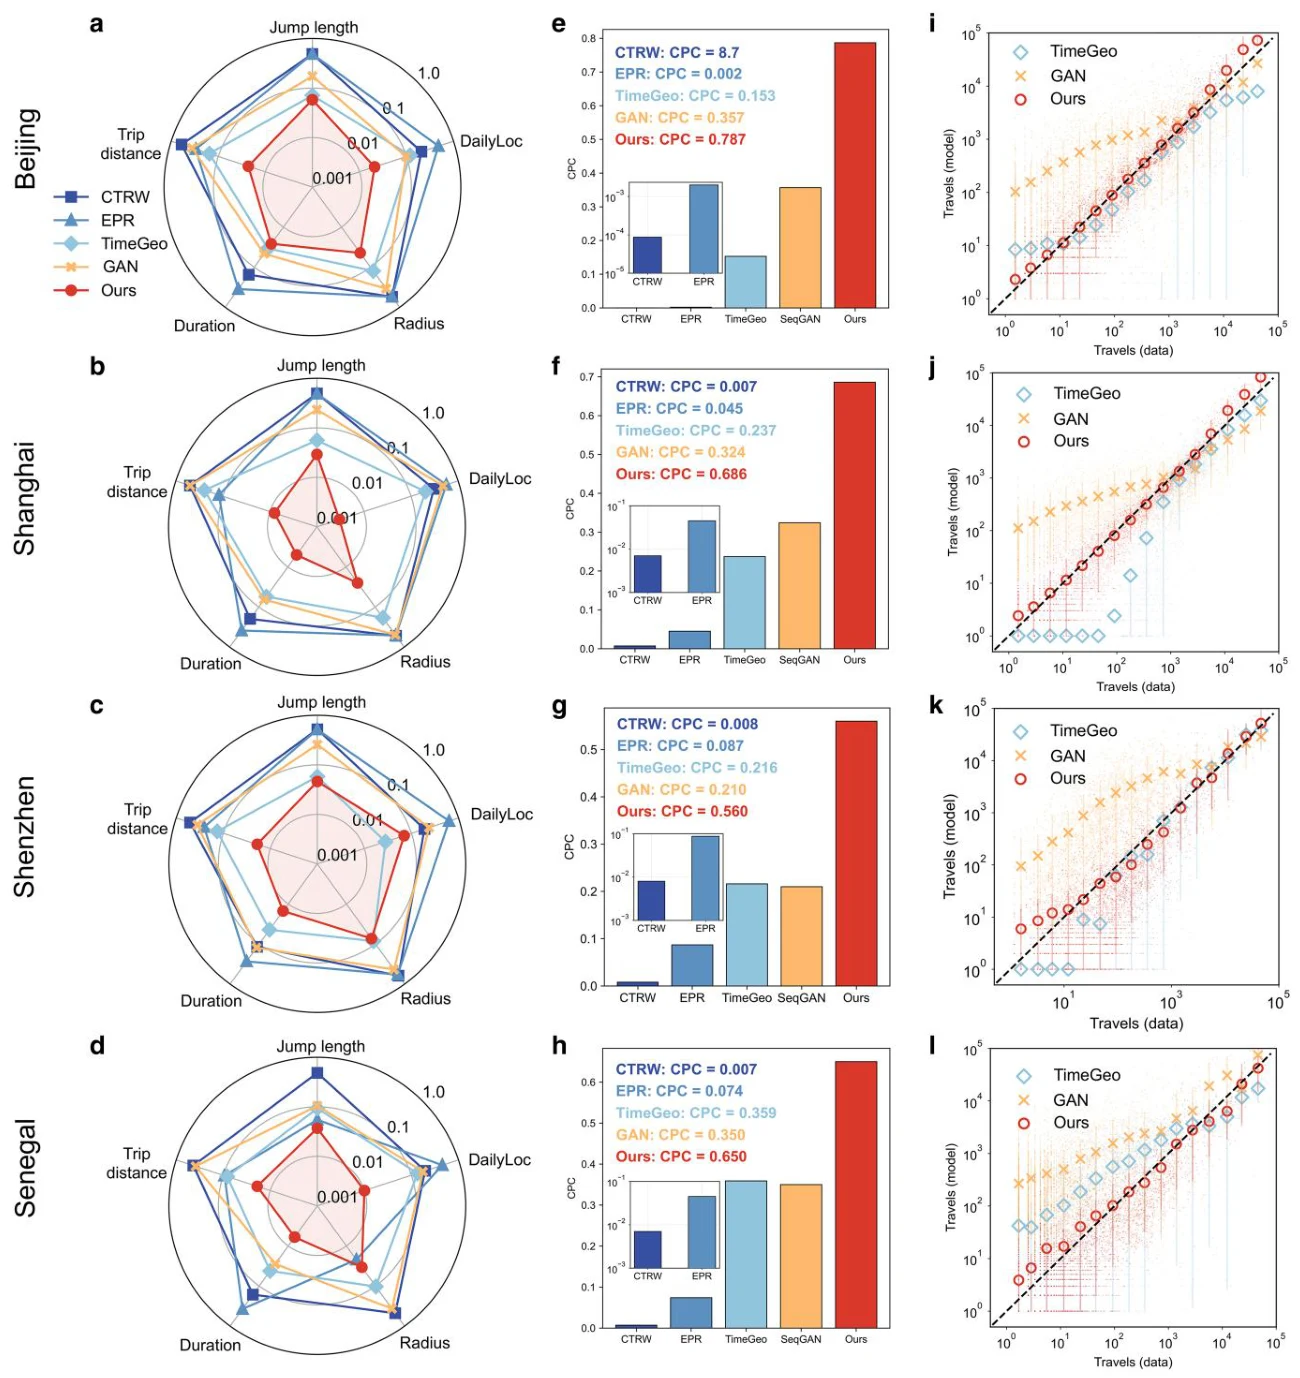
图 3|生成轨迹的分布、区域流量的重合,比哪一个基线更近?
(a、b、c、d)北京、上海、深圳、塞内加尔的五项 JS 散度,雷达图为对数刻度,环线标在 0.001、0.01、0.1 和 1。越靠近中心越好。深蓝 CTRW、浅蓝 EPR、橙色 TimeGeo、黄色 GAN、红色为本模型。红色多边形多落在内侧,但辐条上没有印出五项的具体数字。(e、f、g、h)同一顺序下的 CPC,越高越好;过小的 CTRW 与 EPR 另用对数小窗。北京图例把 CTRW 印成 8.7,已超出 CPC 的 0–1 范围,小窗纵轴却是 10 的负次方,这个 8.7 不能当作重合比例。其余可读数值:北京 EPR 0.002、TimeGeo 0.153、GAN 0.357、本模型 0.787;上海依次为 0.007、0.045、0.237、0.324、0.686;深圳 CTRW 0.008、EPR 0.087、TimeGeo 0.216、GAN 0.210、本模型 0.560;塞内加尔 CTRW 0.007、EPR 0.074、TimeGeo 0.359、GAN 0.350、本模型 0.650。(i、j、k、l)横轴真实区域间出行人数,纵轴模型人数,均为对数轴;虚线是完全一致。菱形 TimeGeo、叉号 GAN、圆点为本模型;符号是分箱平均,线是 10% 到 90% 分位,背景点是每个区域对。GAN 在出行人数少于 1,000 的区域对上偏高,TimeGeo 在上海和深圳则偏向另一侧。来源:原论文 Fig. 3;该画面印在 Fig. 4 图注上方。
以各城 CPC 最高的基线为分母,北京的最高基线是 GAN 0.357,(0.787 − 0.357) / 0.357 = 120%;上海最高基线是 GAN 0.324,相对高 112%;塞内加尔最高基线是 TimeGeo 0.359,相对高 81%。深圳的最高基线是 TimeGeo 0.216 而不是 GAN 的 0.210,(0.560 − 0.216) / 0.216 = 159%。正文把深圳写成 136%,与这一对 CPC 的相对增幅不一致。另外三城的百分数与括号里的两个 CPC 相符。若改用很低的 CTRW 或 EPR 做分母,百分数会更大,但那不是论文声称的比较。
正文还说,本模型的平均绝对误差相当于最优基线的 17%–30%,依据是补充表 3。那张表不在主 PDF 里,四个基线的绝对误差这里不补。KS 方面,正文说 20 个分布比较里有 15 个统计量不超过 0.2。按四套数据和五项个体指标,这 20 个就是 4×5;哪 5 个超过 0.2,主文没有列出。
流量散点说明 CPC 变高不等于每一对区域都落在对角线上。GAN 把少于 1,000 人次的联系估高,TimeGeo 在上海和深圳估向相反的一侧。补充的流量网络图不在主 PDF 中,主文只概括:本模型更接近观测网络的整体结构,GAN 更密,TimeGeo 更稀。
表 1 把两个机制拆开。M1 是生成器里的自下而上互动,M2 是评价器里的自上而下反馈。个体五列是 JS 散度,越低越近;MAE 越低越好,CPC 越高越好。
| 模型 | 日访问地点 | 跳转距离 | 一周出行距离 | 停留时间 | 回转半径 | MAE | CPC |
|---|---|---|---|---|---|---|---|
| 北京,去掉 M1 和 M2 | 0.011 | 0.066 | 0.023 | 0.013 | 0.044 | 62.54 | 0.490 |
| 北京,去掉 M1 | 0.008 | 0.067 | 0.021 | 0.018 | 0.058 | 44.34 | 0.587 |
| 北京,去掉 M2 | 0.010 | 0.063 | 0.019 | 0.015 | 0.046 | 61.09 | 0.507 |
| 北京,完整模型 | 0.021 | 0.058 | 0.023 | 0.026 | 0.044 | 22.68 | 0.787 |
| 上海,去掉 M1 和 M2 | 0.004 | 0.033 | 0.041 | 0.004 | 0.070 | 100.7 | 0.531 |
| 上海,去掉 M1 | 0.002 | 0.028 | 0.011 | 0.003 | 0.025 | 78.84 | 0.635 |
| 上海,去掉 M2 | 0.003 | 0.042 | 0.030 | 0.003 | 0.043 | 100.0 | 0.545 |
| 上海,完整模型 | 0.003 | 0.029 | 0.008 | 0.005 | 0.025 | 63.12 | 0.686 |
| 深圳,去掉 M1 和 M2 | 0.100 | 0.141 | 0.042 | 0.013 | 0.148 | 346.5 | 0.464 |
| 深圳,去掉 M1 | 0.077 | 0.150 | 0.063 | 0.022 | 0.170 | 266.4 | 0.548 |
| 深圳,去掉 M2 | 0.073 | 0.158 | 0.053 | 0.011 | 0.156 | 287.4 | 0.490 |
| 深圳,完整模型 | 0.070 | 0.046 | 0.019 | 0.015 | 0.073 | 253.0 | 0.560 |
| 塞内加尔,去掉 M1 和 M2 | 0.028 | 0.095 | 0.035 | 0.006 | 0.056 | 324.6 | 0.599 |
| 塞内加尔,去掉 M1 | 0.053 | 0.035 | 0.004 | 0.006 | 0.032 | 255.1 | 0.620 |
| 塞内加尔,去掉 M2 | 0.009 | 0.044 | 0.035 | 0.007 | 0.036 | 277.9 | 0.610 |
| 塞内加尔,完整模型 | 0.010 | 0.037 | 0.019 | 0.006 | 0.034 | 223.0 | 0.650 |
相对没有任何协作机制的版本,完整模型的 CPC 提高 (0.787 − 0.490) / 0.490 = 60.6%(北京)、29.2%(上海,分母 0.531)、20.7%(深圳,分母 0.464)、8.5%(塞内加尔,分母 0.599)。四城都是完整模型的 CPC 最高、MAE 最低。只去掉自下而上、保留自上而下时,CPC 又都高于只保留自下而上的那一行。正文写的是自下而上把人口影响送进个体决策、贡献大于自上而下的修正;表 1 的 CPC 和 MAE 排序与这句话相反。两个机制的收益也不能从两行相加得到。以去掉两个机制后的 CPC 为分母侧的起点:北京只保留自上而下时增加 0.587 − 0.490 = 0.097,只保留自下而上时增加 0.507 − 0.490 = 0.017,两者之和为 0.114,同时使用的增量是 0.787 − 0.490 = 0.297。深圳同时使用的增量是 0.560 − 0.464 = 0.096,小于分开增量 0.084 与 0.026 之和 0.110。
个体侧更不均匀。北京完整模型的日访问地点 JS 散度是 0.021,高于去掉 M1 时的 0.008;停留时间 0.026,高于两个机制都去掉时的 0.013。塞内加尔的一周出行距离在去掉 M1 时为 0.004,完整模型为 0.019。深圳的跳转距离则从去掉两个机制时的 0.141 降到完整模型的 0.046。所以协作主要买到的是人口流量上的接近,不是五项个体分布的全面胜利。正文说两个机制都没有损害个体真实性,比这张表的部分格子更强。
主文还报告,用生成轨迹识别出的家位置,空间分布与观测接近;九种日常出行模体的 JS 散度在四城都低于 0.084。模体图和家位置图不在主 PDF,这里不描述图面,也不把 0.084 拆成九个模体各自的数字。
标度律是训练损失,还是生成之后才量出来的
训练目标是下一步分布和流量误差,不是把幂律指数写成损失函数。标度律是生成之后再测量的。因此,点落在经验曲线附近,说明生成分布带有这些形态;它不是证明网络内部使用了同一条物理公式。
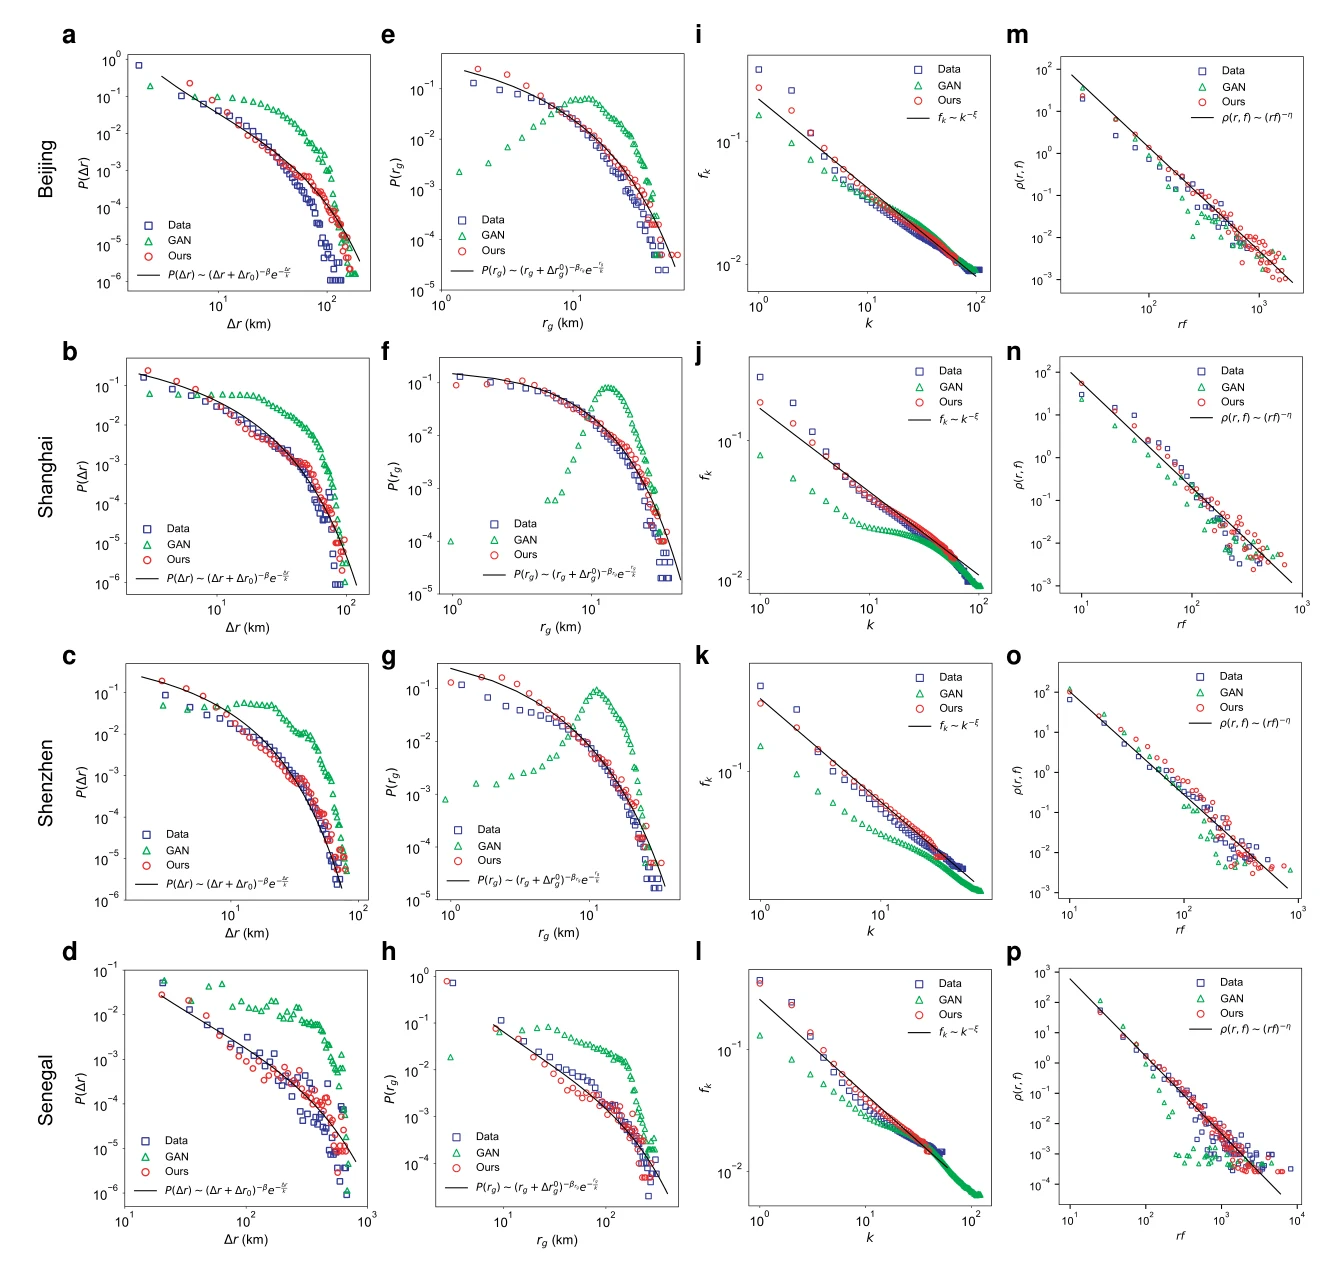
图 4|生成结果是否重新出现个体和人口两侧的已知规律?
蓝方块为观测,绿三角为 GAN,红圆为本模型,黑线为拟合。纵轴都是概率或计数的对数。(a、b、c、d)跳转距离,北京、上海、深圳、塞内加尔。分布写成截断幂律:距离加上一个常数后再取幂,并乘上指数截断。图注给出的指数依次为 1.28、1.25、1.34、1.28,拟合优度 R² 为 0.976、0.942、0.971、0.914。(e、f、g、h)回转半径,同样是截断幂律,指数 1.20、1.28、1.22、1.32,R² 为 0.991、0.981、0.976、0.954。绿三角在中间距离常拱起,不跟着黑线。(i、j、k、l)第 k 常去地点的访问频率,幂律指数 1.15、1.05、1.01、1.10,R² 为 0.973、0.981、0.966、0.963。(m、n、o、p)人口层的距离—频率关系,横轴是距离与访问频率的乘积,纵轴是相应的到访人数。拟合为该乘积的负幂,指数 2.01、2.04、2.09、2.08,R² 为 0.926、0.927、0.940、0.964。来源:原论文 Fig. 4;该画面印在 Fig. 3 图注上方。
图注的指数是每座城市一条拟合,没有分别给出观测点和生成点各自的指数。R² 是这条曲线对图中关系的拟合优度,不是留出日期上的预测分数。正文把跳转距离指数概括为大约 1.2 到 1.3,并说小于较早文献里大约 1.75 的报告;深圳图注中的 1.34 已经略高于 1.3。回转半径方面,正文写大约 1.10 到 1.17,并与 Gonzalez 等 2008 年的 1.65 对比;图注的四个指数是 1.20、1.28、1.22、1.32,与正文这个区间对不上。齐夫指数在正文里写成大约 1.0 到 1.1、接近经验上的大约 1.2,图注里北京是 1.15。距离—频率指数接近 2,与“到访人数随距离和频率的乘积平方反比下降”同向,但是拟合值,不是逐个地点都严格等于 2。
绿三角偏离,尤其是回转半径,说明一次生成整条轨迹的 GAN 没有跟着这些形态走。红圆更靠近蓝方块。去掉记忆后访问频率会更均匀,以及地点数的次线性增长、长期位移的极慢扩散,正文指向补充图,主 PDF 没有这些图,这里不补曲线形状。高可预测性同样只在正文中被说成与既有发现一致,没有印出可预测性的数值。
这些规律在生成数据里出现,支持“模型没有只记住某几条训练轨迹的表面形状”。它仍是分布层面的再现。主文没有做干预实验,不能由此推出居民真的按网络里的不确定度开关做决定。
没见过这座城市的轨迹,生成还像不像
换城被用来区分“背下训练城市”和“学到可搬的结构”。作者为此改了网络,所以图 5 不是表 1 那个完整模型。地点不再用只能在一座城市里使用的嵌入,而改成到访热度和按类别汇总的兴趣点数量。论文举位置数据服务和开放地图作为低成本来源,没有写明中国三座城市实际取自哪一份兴趣点。自上而下的流量反馈被去掉,因为作者认为它准确,但也容易把训练城市的流量背下来。他们选择的是更能迁移的生成器,而不是统计上最像训练城市的那一个。
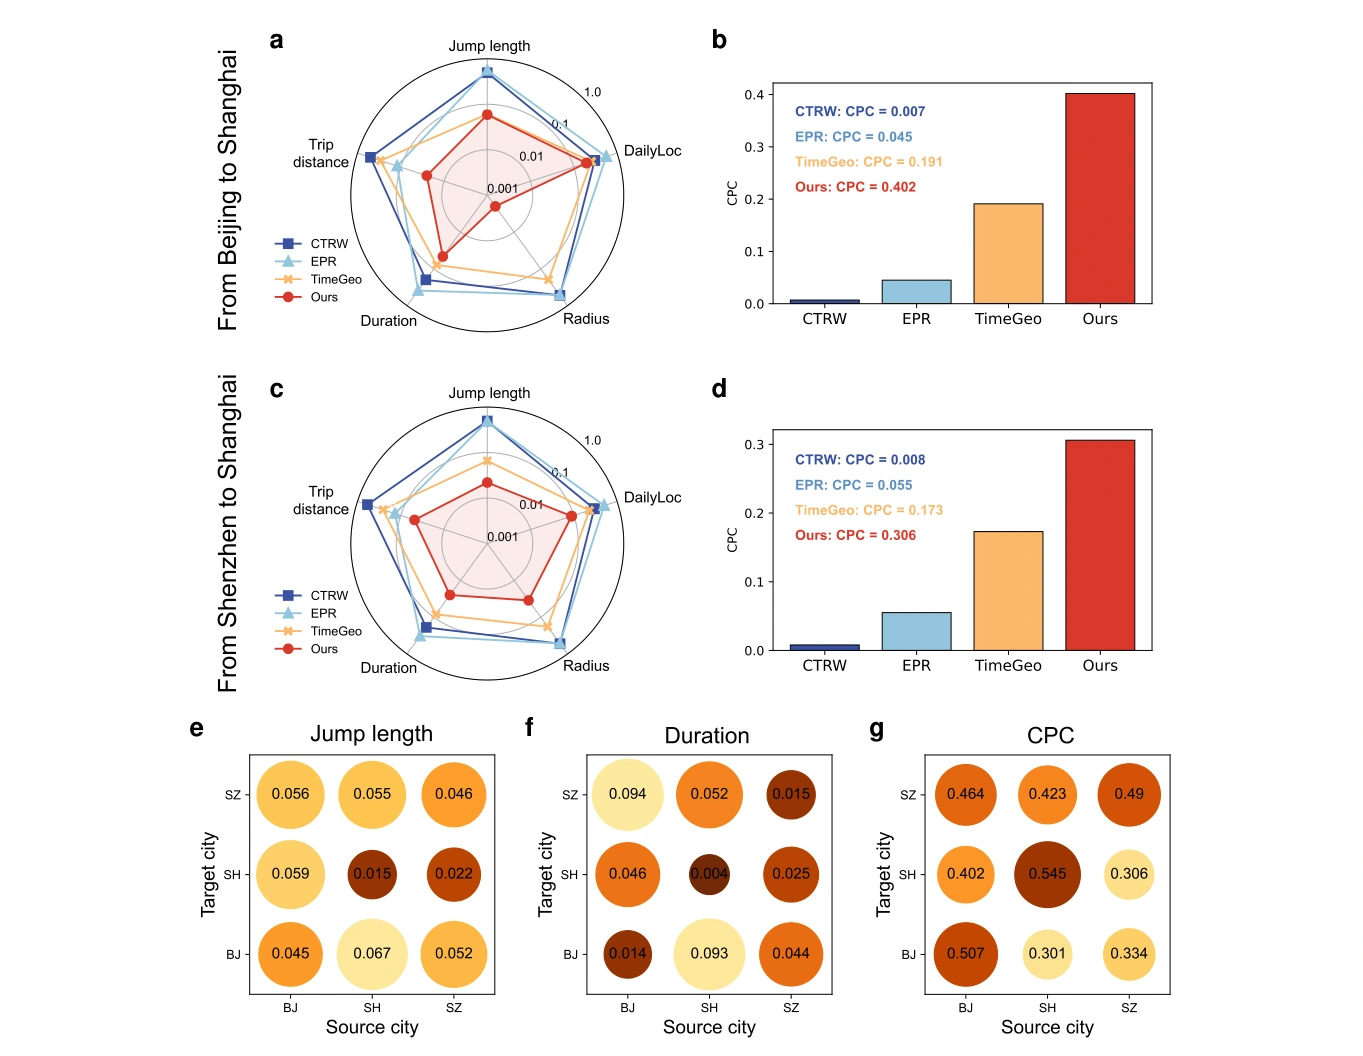
图 5|在一座城市训练后,另一座城市的轨迹和流量还剩多少重合?
(a、b)北京训练、上海测试,不微调。雷达图仍是五项 JS 散度,对数环线同图 3;柱状图只有 CTRW、EPR、TimeGeo 和本模型,没有 GAN。CPC 为 0.007、0.045、0.191、0.402。(c、d)深圳训练、上海测试,CPC 为 0.008、0.055、0.173、0.306。(e、f、g)三座中国城市的全部来源—目标组合。行是目标城市,列是来源城市,依次为北京、上海、深圳。圆的大小是指标数值,颜色越深表示在该指标上越好:JS 散度越低越好,CPC 越高越好。(e)跳转距离的九个 JS 散度为:到深圳 0.056、0.055、0.046,到上海 0.059、0.015、0.022,到北京 0.045、0.067、0.052。(f)停留时间:到深圳 0.094、0.052、0.015,到上海 0.046、0.004、0.025,到北京 0.014、0.093、0.044。(g)CPC:到深圳 0.464、0.423、0.49,到上海 0.402、0.545、0.306,到北京 0.507、0.301、0.334。对角格是简化模型在同一城市训练并测试。来源:原论文 Fig. 5。
图上 18 个 JS 散度都小于 0.1。最大的跳转距离散度是 0.067,出现在上海训练、北京测试;最大的停留时间散度是 0.094,出现在北京训练、深圳测试。流量不能只看“小于 0.1”这种句子。对角线上,简化模型在北京、上海、深圳的 CPC 是 0.507、0.545 和 0.49。表 1 完整模型的对应 CPC 是 0.787、0.686 和 0.560。北京从 0.787 降到 0.507,是换了结构,不是同一模型在留出样本上的下降。
跨城 CPC 除以该目标城市的对角 CPC:北京到深圳为 0.464 / 0.49 = 95%,上海到深圳为 0.423 / 0.49 = 86%,北京到上海为 0.402 / 0.545 = 74%,深圳到北京为 0.334 / 0.507 = 66%,上海到北京为 0.301 / 0.507 = 59%,深圳到上海为 0.306 / 0.545 = 56%。这就是正文所说的 56%–95%。最低的一格是上海训练、北京测试的 0.301,不是“每座目标城市都还保持 0.5 以上”。
相对机制模型的提高,图 5 只把到达上海的两组画成柱。北京到上海,(0.402 − 0.191) / 0.191 = 110%,分母是 TimeGeo。深圳到上海,(0.306 − 0.173) / 0.173 = 77%,分母同样是 TimeGeo。正文说 3×2 共六组来源—目标对的 CPC 提高都超过 60%。另外四组的基线 CPC 在补充表,主图没有印出。
到塞内加尔的迁移也不在图 5 的矩阵里。正文给出的范围是 JS 散度小于 0.1、CPC 大于 0.4,城市对包括北京、上海、深圳分别到塞内加尔。大于 0.4 仍远低于这些城市完整模型的 0.560 到 0.787。主文据此认为模型有可能服务缺少轨迹数据的城市;实验覆盖的是这四套记录之间的迁移,不是任意城市。
这些比较还停在哪里
主文没有写明,城市内部的“像不像”是按留出的日期计算,还是在参与训练的同一批记录上计算。实验细节指向补充材料。因此 CPC 和 JS 散度首先表示生成分布与这批观测的接近程度,不能直接换成对下一个月的预测误差。
讨论里还用生成轨迹和真实轨迹的重合来论证模型不是在背样本,并认为把真实个体混进生成结果后难以对上具体的人。对照做法和数值都在补充图里。这里不复述那套对照,也不把“主文说难以对上”写成隐私风险已经消失。轨迹本身仍可能很独特,这是作者引用既有研究时承认的前提。
手机用户、记录时钟和区域划分都会进入生成分布。四套数据的用户规模、采样间隔和观测周数不同,跨城 JS 散度小于 0.1 只说明简化模型跟住了目标城市的边际分布,不说明四座城市的出行机制相同。讨论提到的疫情、交通和规划,在本文中没有对应实验。道路网、土地利用和社会经济指标也还没有进入主模型。
一句话总结
个人下一步和城市人流可以放进同一个生成网络,流量重合会明显高于只走个体规则的模型,若干经典标度律也会在生成结果里重新出现;这还不是每项个体分布都更近,也不是换一座城之后仍保持完整模型的精度。
核心来源
- PNAS Nexus 正式版,核对题目、作者、卷期、提前发表日期与 DOI。本文数值和图面来自该正式版主 PDF 的图 1–5 与表 1。
- 文末所印预印本 DOI:10.21203/rs.3.rs-3666762/v1。本文没有用预印本改写正式版的数字。
- 论文写明代码与支持结果的数据位于 DeepMobility 仓库。补充材料在期刊网站,不在这份 14 页主 PDF 中。
作者介绍
四位作者的署名单位都是清华大学电子工程系、北京信息科学与技术国家研究中心(BNRist)。以下只按论文署名、同等贡献说明和作者贡献陈述介绍。
- Yuan Yuan:与 Jingtao Ding 同等贡献。参与启动研究、提出想法、设计方法,搭建 DeepMobility 并完成实验,参与结果分析和写作。
- Jingtao Ding:同等贡献,通讯作者。参与启动研究、提出想法、设计方法、文稿修改、结果分析和写作。
- Depeng Jin:参与启动研究、文稿修改和项目管理,参与结果分析和写作。
- Yong Li:通讯作者。参与启动研究、提出想法、设计方法、文稿修改和项目管理,参与结果分析和写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
不确定度开关给出了一个可以再检验的分界。表 1 里,两个机制同时使用带来的 CPC 增量,在北京大于两个机制分开使用的增量之和,在深圳却不是这样。若把区域对按学到的不确定度分成高低两组,高不确定度那一组恰好集中了完整模型相对消融模型的流量改进,开关本身就更像 CPC 提高的载体;若改进均匀地落在低不确定度的惯常出行上,提高就更可能来自联合优化的其他部分。这个分组不需要新的采集,只需要模型已经输出的不确定度和逐格流量误差。
换城结果也不该借用完整模型的头条数字。北京完整模型的 CPC 是 0.787,可是迁移时使用的简化模型即使在北京本地也只有 0.507;深圳训练、上海测试是 0.306,而上海完整模型是 0.686。若合成人流要用来估计设施压力,报告里至少应并列三个数:简化模型在目标城市自训练的 CPC、跨城 CPC,以及完整模型只在有轨迹的城市才能达到的 CPC。0.306 相对于 0.173 的提高,回答的是“比 TimeGeo 好多少”,不是“已经接近有轨迹时的 0.686”。
四套时钟不同,也限制了“指数小于 2008 年那次报告”这句话能走多远。跳转距离的四条拟合是 1.25 到 1.34,正文用来对比的较早结果大约是 1.75。若把塞内加尔的 10 分钟记录并成小时,或把北京的小时记录拆回更细的事件时间,指数明显挪动,那么较小的指数里就有测量尺度的成分;若并到同一时间网格后四城仍聚在 1.3 附近、远离 1.75,才更适合讨论出行本身是否更不均匀。论文已经具备做这次重采样的原始时间分辨率,只是主文没有做。