在别的城区训练之后,这块城区一年后的出发地—目的地流量还能预测吗?
论文名片|Jinwei Zeng、Guozhen Zhang、Can Rong、Jingtao Ding、Jian Yuan、Yong Li,Causal Learning Empowered OD Prediction for Urban Planning,Proceedings of the 31st ACM International Conference on Information and Knowledge Management(CIKM ’22),2022年10月17–21日,美国亚特兰大,10页。DOI:10.1145/3511808.3557255。
望城区和长沙县在这项研究里是待预测的一侧,天心区和雨花区是拿来训练的一侧。规划上想知道的是:兴趣点数量若按某种方式变化,大约一年后,区域和区域之间的人流会怎样。论文认为缺数据的往往是还在发育的地区,所以要用其他城区已经发生过的开发来训练。实验在预测时仍会看到待预测城区自己较早一个月的流量,缺的是“同样的开发在本地如何改变下一年流量”这种可学习的成对样本。跨区使用会碰到两件连在一起的事。待预测城区的条件分布和训练城区不一样;一个地方的兴趣点会增加多少,又和它原来的条件有关,分配方式并不是随机的。
这篇论文把兴趣点数量的变化当作规划干预,在深度重力模型外面加了两步:先把区域属性拆开,预测流量时不用那些只跟着干预走、却不被认为影响流量的因素;再把少见的干预组合加权,减轻干预和区域原有条件缠在一起的程度。三套跨区数据上,相对七个基线里最好的深度重力模型,平均绝对误差的相对降幅分别是 10.29%、12.99% 和 5.50%,简单平均为 9.59%。这是三套数据各算一次、再取平均的拟合改进,分母是深度重力模型自己的平均绝对误差。每条流量的误差下降并不都等于 9.59%,规划也没有被随机分配到区域上。
先说结论
- 任务是用较早一个月的出发地—目的地流量、35 维区域属性和 12 维兴趣点数量变化,预测约一年后的流量。长沙用 2019 年 11 月预测 2020 年 11 月,北京用 2020 年 7 月预测 2021 年 7 月。训练放在较发达的区,测试放在另一批区。
- 相对深度重力模型,表 2 列出的 CPC 提升为 4.25%、5.60%、1.34%,MAE 相对下降为 10.29%、12.99%、5.50%。9.59% 只是后三个百分数的简单平均,没有按起讫对数量加权;PDF 也没有给出起讫对数量。
- 北京的改进最小:CPC 从 0.745 到 0.755,只增加 0.010;MAE 从 17.28 到 16.33,绝对差为 0.95。流量单位没有写出,这个 0.95 不能换算成人次。
- 按目的地区域的初始兴趣点数量和增长率分成四格后,MAE 相对增益是 7.69%、4.78%、11.60%、12.78%。最低的 4.78% 落在初始开发低、规划增量高的那一格。
- 真实流量超过 10⁵ 的起讫对里,论文报告 75% 的预测误差下降,73% 的相对误差降幅高于 10%。这里的 10% 以该起讫对的真实流量为分母。图上同时有落在 0 以下的点。
待预测的区和拿来训练的区,差在哪一层?
一般的出发地—目的地流量预测,常常在同一批区域里用历史序列往后推。城市规划里的问法不一样:人关心的是规划改动之后流量会怎样,而且缺数据的往往是还在发育的地区。论文把这种预测写成反事实回归,把兴趣点数量变化叫作干预。干预若和区域条件相关,只拟合相关关系,就会把“本来就很发达”和“因为新增了兴趣点”混在一起。
分布外在这里有具体所指:模型在一批区域上训练,到另一批区域上测试。训练区和测试区是不同的行政区,成绩也来自这组跨区划分,而不是同一城市内起讫对的随机留出。
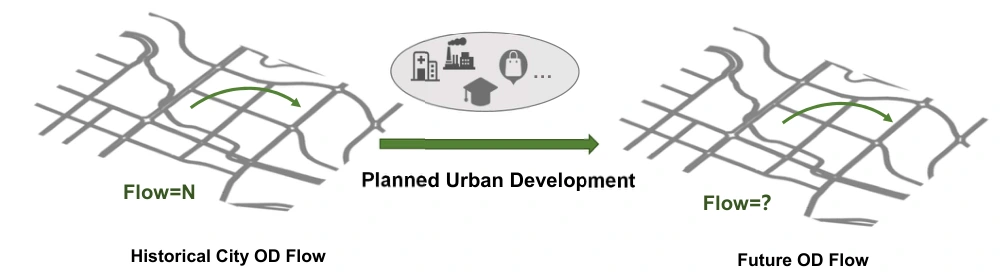
图 1|已知历史流量和一份规划,要问的未来流量是什么?
无字母子图。左侧是历史城市出发地—目的地流量,图中标 Flow=N;中间是规划中的城市开发,用一组设施图标和向右的箭头表示;右侧是未来流量,标成 Flow=?。这张图只定任务,没有数据或误差。来源:原论文 Fig. 1。
三套数据都遵循“发达区训练、另一组区测试”。长沙局部用天心、雨花训练,望城和长沙县测试。长沙全市把开福、岳麓、芙蓉也放进训练,测试区仍是望城和长沙县。北京用朝阳训练、通州测试。
| 项目 | 长沙局部 | 长沙全市 | 北京局部 |
|---|---|---|---|
| 城市 | 长沙 | 长沙 | 北京 |
| 训练行政区 | 天心、雨花 | 天心、雨花、开福、岳麓、芙蓉 | 朝阳 |
| 测试行政区 | 望城、长沙县 | 望城、长沙县 | 通州 |
| 训练区域数 | 287 | 688 | 510 |
| 测试区域数 | 457 | 457 | 481 |
| 属性维度 | 35 | 35 | 35 |
| 干预维度 | 12 | 12 | 12 |
区域数来自表 1,计数单位是论文定义的区域。天心和雨花被分成 287 个区域,望城和长沙县被分成 457 个区域,朝阳一个区有 510 个区域,所以这里的区域小于行政区。PDF 没有给出网格边长、街道或交通小区边界,也没有列出 35 维属性和 12 维干预各自的变量名。人数和起讫对数量都没有出现在表 1。
长沙的输入包括这些区的属性、2019 年 11 月到 2020 年 11 月的兴趣点数量变化,以及 2019 年 11 月的流量,目标是 2020 年 11 月的流量。属性快照本身的月份没有单独写明。北京段落写的是:给定 2020 年 7 月流量和这一年间的兴趣点变化,预测 2021 年 7 月流量。两套长沙数据的测试区域数都是 457,训练行政区是包含关系;PDF 没有证明两套数据的小区域边界逐一重合。
流量从哪一种观测变成区域之间的矩阵,PDF 没有写。分析单位停在区域对上。后面的误差也都是这一层的误差。
一条未来流量,是怎样从起点的流出里分出去的?
论文沿用深度重力模型的骨架:每个起点先给所有可能终点打分,再对同一起点的分数做 softmax,得到流出分配到各终点的概率,最后乘上该起点的流出量,得到起讫流量。若这笔流出取自目标月,模型负责的是已知总量下的终点分配;若取自历史月,总量变化也会进入误差。PDF 只写乘以起点 i 的流出,没有写月份。
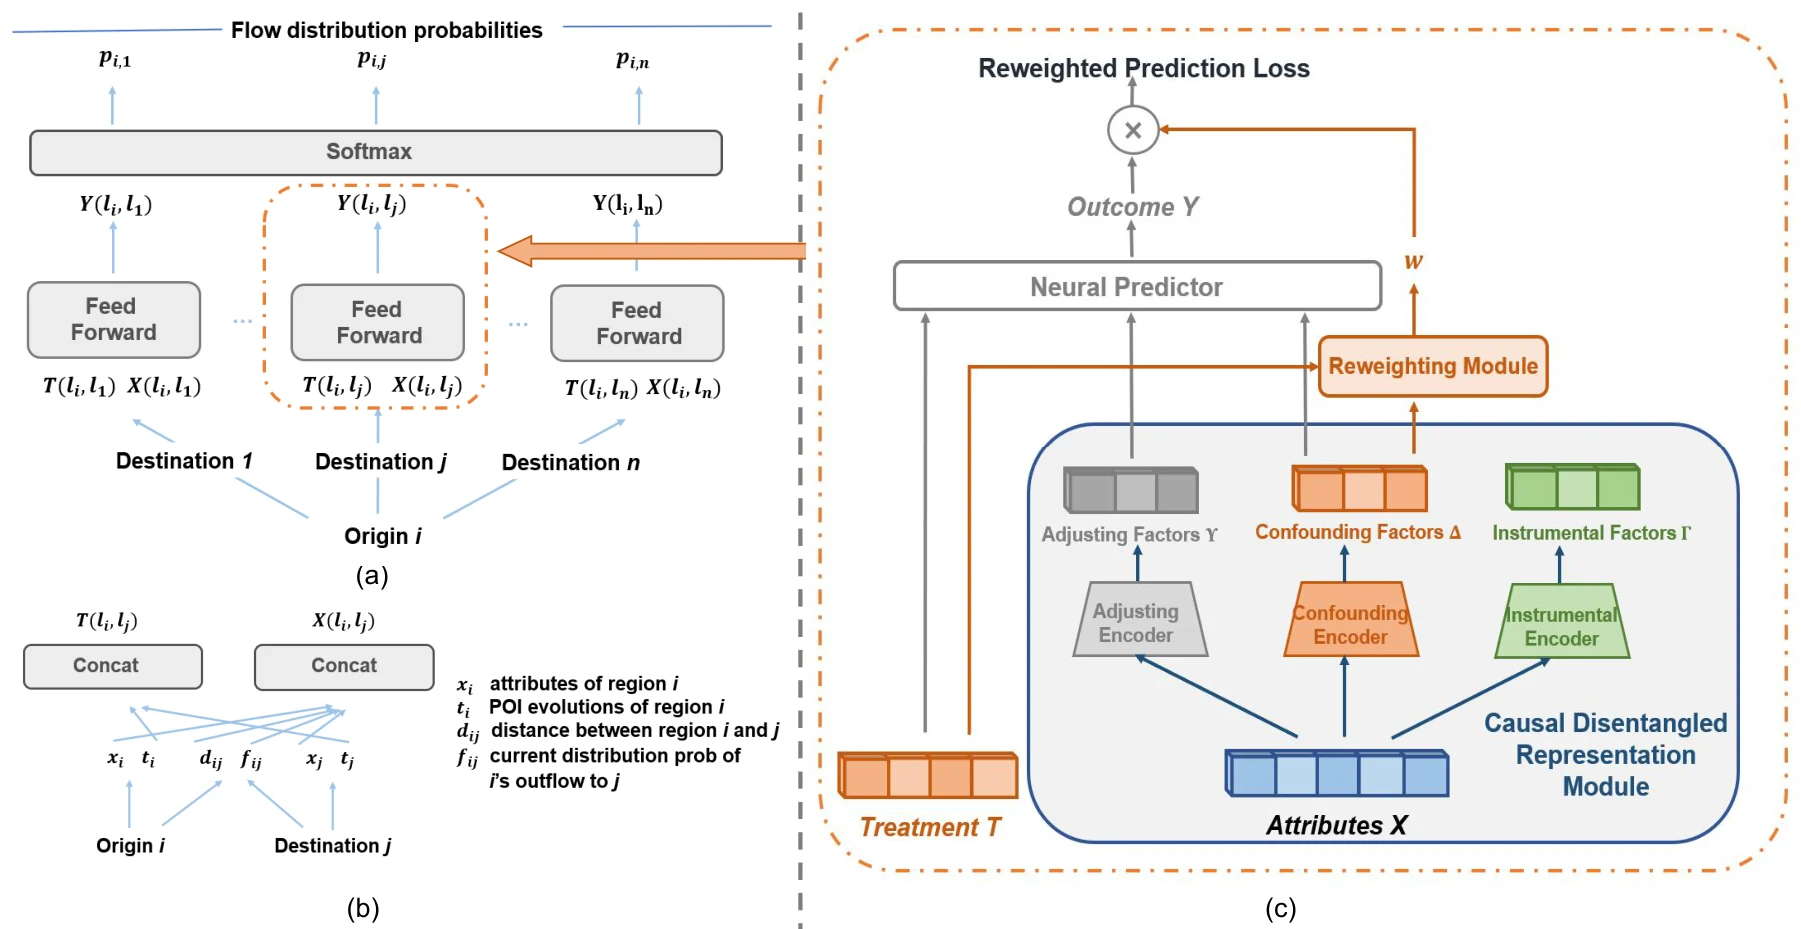
图 2|因果模块替换的是前馈网络的哪一段?
(a)深度重力骨架。同一起点通往各个终点的前馈网络输出分数,经 softmax 变成流量分配概率 pi,1 到 pi,n。(b)每一对起讫点的输入:起点与终点的属性、距离和 fij 拼成环境变量 X,两侧的兴趣点变化拼成干预 T。图例把 fij 写成起点 i 流向 j 的当前流出分配概率;正文把同一个符号写成该起讫对的历史流量。PDF 没有说明二者是否已经归一成概率。(c)用来替换前馈网络的 SIRI:属性经三个编码器分成调整、混杂和工具因素,重加权模块给出权重 w,再乘进结果 Y 的预测损失。左侧橙色箭头表示用(c)换掉原来的前馈块。来源:原论文 Fig. 2。
模型名称 SIRI 来自因果解耦表征和重加权(cauSal dIsentangled Representation and re-weIghting)。最终仍通过上面的分配骨架输出整张流量矩阵。历史流量已经进入每一对起讫点的输入,模型使用的是一个月的流量加上兴趣点变化,而不是多个月序列的滚动预报。相关工作把任务归到“用当下的区域条件生成流量”这一类,理由是没有历史序列;同一节也写明,当前流量会被提供给模型。
区域属性里,哪一部分被允许参加流量预测?
论文把属性背后的因素分成三类。只影响干预的叫工具因素 Γ,只影响结果的叫调整因素 Υ,两边都影响的叫混杂因素 Δ。预测流量时使用 Δ 和 Υ,不使用 Γ。理由是 Γ 与结果没有被画成直接的因果箭头。分类本身要靠后面的对抗训练从数据里分开,并不是规划师事先标好的名单。
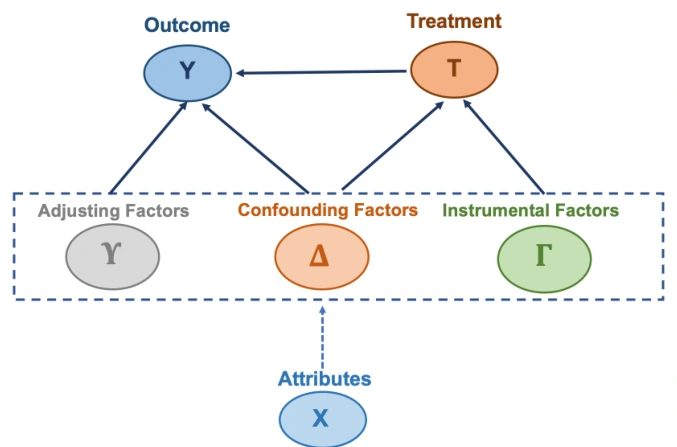
图 3|三类因素和干预、结果之间,箭头是怎样连的?
无字母子图。属性 X 指向调整因素 Υ、混杂因素 Δ 和工具因素 Γ。Υ 只指向结果 Y,Γ 只指向干预 T,Δ 同时指向 Y 和 T,T 再指向 Y。图表达的是模型采用的结构,不是从长沙或北京数据里估计出来的路径系数。来源:原论文 Fig. 3。
以往的解耦做法多半针对干预只有“做或不做”两种取值。这里的干预是 12 维的兴趣点数量变化,每一维都是连续数值,组合成束之后难以再分成两组去配平。论文改用一条工作假设:若连尽力拟合的预测器都无法用 Υ 预测 T,就认为 Υ 里已经没有 T 的信息;Γ 对 Y 也做同样的事。
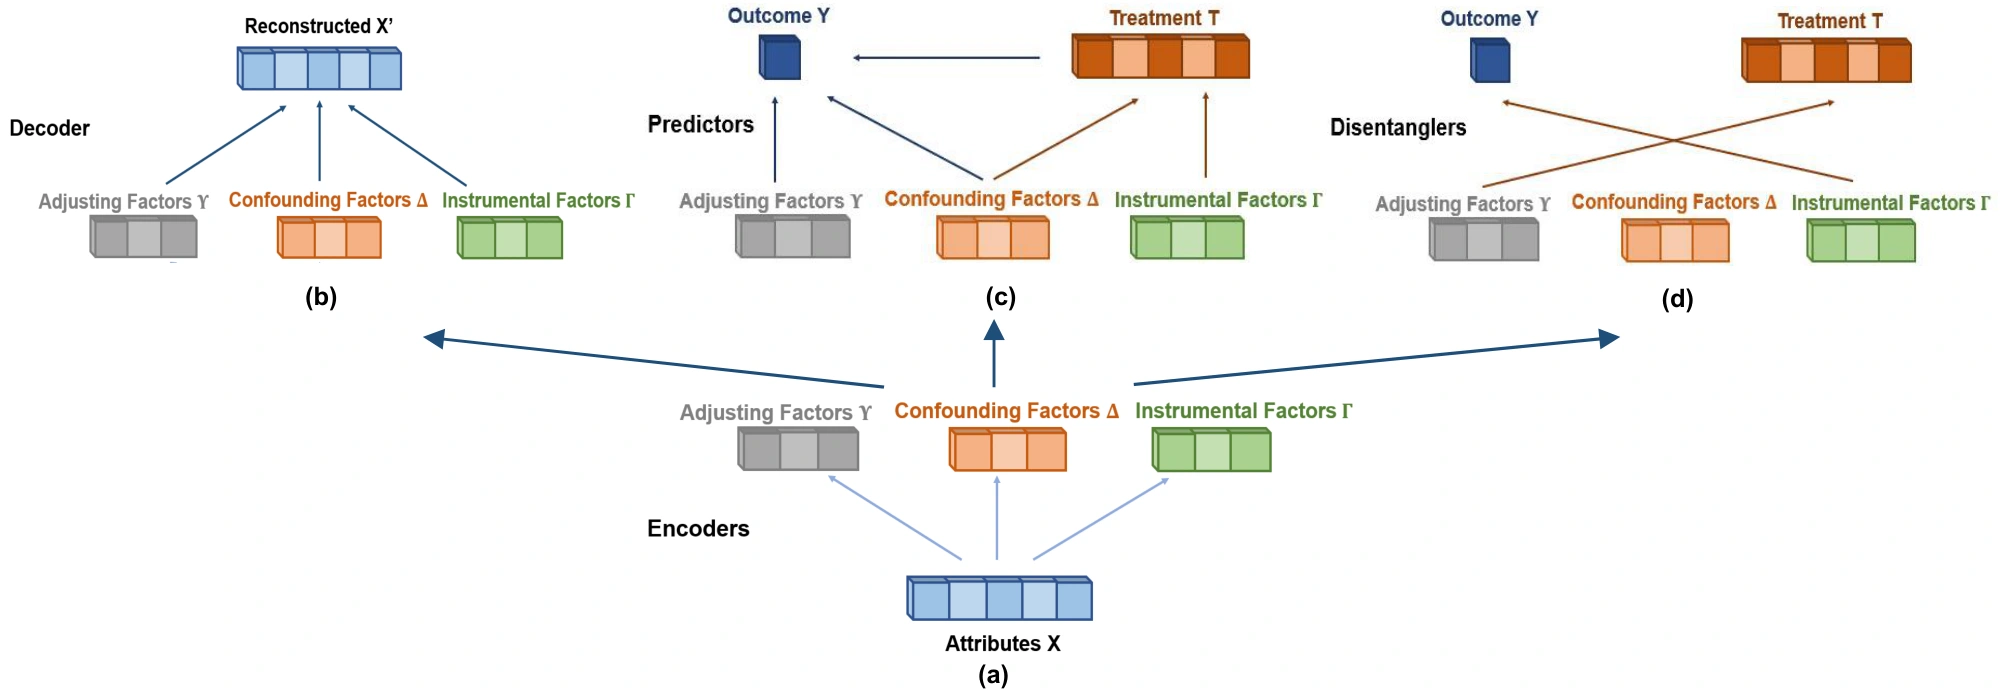
图 4|解耦模块怎样同时要求“信息够用”和“不该知道的不要知道”?
(a)位于整图下方:三个编码器把属性 X 分成 Υ、Δ、Γ。(b)上方左侧:解码器用这三类表征重建属性,用来要求三类合在一起不要丢掉属性里的信息。(c)上方中间:预测器用 Γ 和 Δ 预测干预 T,并用 Δ、Υ 和 T 预测结果 Y。正文如此写;式(2)里结果项的预测器又写成 H2(Δ, Υ),式中没有 T。两处写法不完全相同。(d)上方右侧:分解器的箭头交叉。按正文,Γ 去预测 Y,Υ 去预测 T,Δ 不进入这一对。训练先把这对损失往大推,使表征躲开不该携带的信息,再把预测器往小拟合。最好的预测器仍然失败,才被当成已经拆开。来源:原论文 Fig. 4。
损失由重建、两项预测和两项对抗项合成,用 α、β、γ、δ 平衡。PDF 没有给出这四个权重的数值,也没有给出两阶段停止阈值 ε1、ε2。因此图 4 说明的是约束方向,读者无法只凭 PDF 复原训练时各项损失的相对力气。
兴趣点为什么增加,本身就算一种需要降权的信息吗?
规划不是随机试验。论文举的例子是:老龄化城市可能被安排更多生活设施,于是设施数量的变化和居民年龄缠在一起,流量变化就分不清来自哪一边。这是作者用来说明混杂的例子,不是长沙或北京数据里报告的年龄效应。
常见的倾向得分重加权大多处理两种干预,或有限个取值。这里要处理的是一束连续的数量变化。论文沿用 Zou 等人针对成束干预的变分重加权,并认为其推导可以延伸到连续取值。直观上,它要提高那些“在当前区域条件下很少出现的兴趣点变化”的权重,降低很常见的组合的权重,使干预和混杂因素在加权后的样本里少一些缠结。
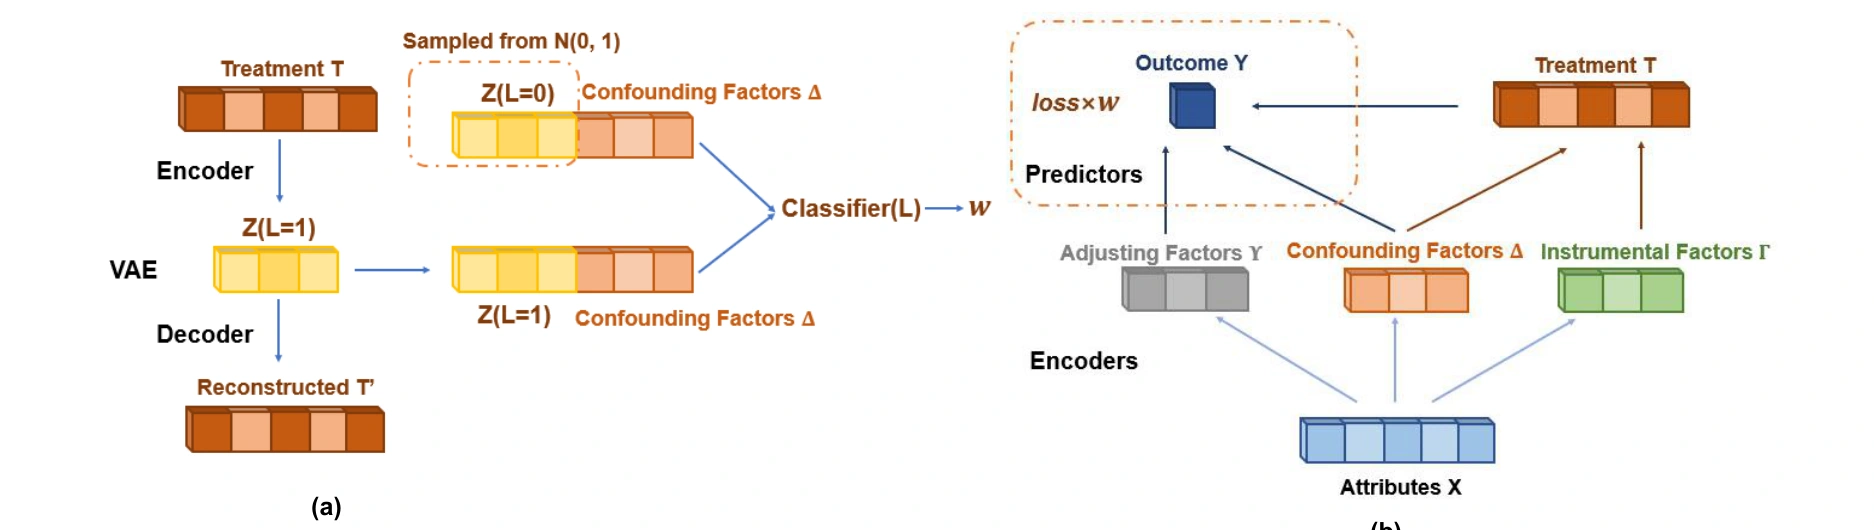
图 5|样本权重从哪里来,又乘到哪一项损失上?
(a)变分自编码器把干预 T 编成潜变量 Z,再解码回重建的 T′。与真实 T 对应的 Z 标成 Z(L=1),并与混杂因素 Δ 拼在一起;图中从 N(0, 1) 抽出的 Z 标成 Z(L=0),也与 Δ 拼接。正文把这一先验写成标准正态 N(0, I)。分类器据此区分观察到的配对和按先验重新搭配的对照,输出权重 w。(b)权重乘进结果 Y 的预测损失,图中记为 loss×w;属性仍由三个编码器分成三类。来源:原论文 Fig. 5。
只加重加权、还没有解耦时,论文写明权重是对全部输入属性计算的。完整模型则先找出 Δ,再只把 Δ 和干预解开,避免把工具因素造成的干预分布也一起改掉。训练分两段:先优化解耦损失,算出权重,再把权重写进结果损失继续训练。
这套权重改变的是观察样本在损失里的影响力。它没有把某几类兴趣点随机建到区域内,因此加权后的拟合更接近“少让常见规划捆绑常见城区”,还不是干预效应的实验估计。
同一张表里,CPC 和 MAE 为什么不是同一个名次?
比较对象有七个,分成四组。辐射模型只用区域人口和圆内的介入人口。修正重力模型把流量写成起点推动项、终点吸引项和距离的幂,三项各有指数;PDF 没有列出拟合到的指数。随机森林是唯一的传统机器学习基线。图方法包括按邻接做图卷积的 SI-GCN,以及用两套图注意力学习起点、终点表征的 GMEL。非图的深度模型是重力神经网络和作为骨架的深度重力模型。
论文写明 SI-GCN 经过改写,用起点和终点的表征再加上历史流量来预测未来流量。GMEL 还附带预测流入和流出,最后用梯度提升机读历史流量和表征。表中分数是这些改写在三套数据上的结果。
CPC 是两倍的“预测与真实逐对取较小值之和”,除以真实流量总和加预测流量总和,介于 0 和 1,越高表示重叠越多。它的名字里有通勤者,论文却把它用作一般起讫流量的重叠指标,不能据此认为数据只含通勤。MAE 是各起讫对绝对误差的平均,分母 |f| 是参加平均的起讫对个数。个数和流量单位都没有给出,所以 MAE 可以在同一套数据里比大小,不能把 35.31 和 16.33 读成北京少了多少人次。
| 模型 | 长沙局部 CPC | 长沙局部 MAE | 长沙全市 CPC | 长沙全市 MAE | 北京局部 CPC | 北京局部 MAE |
|---|---|---|---|---|---|---|
| 辐射模型 | 0.204 | 201.60 | 0.223 | 137.22 | 0.280 | 60.20 |
| 修正重力模型 | 0.406 | 56.16 | 0.388 | 42.99 | 0.367 | 32.74 |
| 随机森林 | 0.470 | 104.40 | 0.570 | 64.20 | 0.730 | 24.32 |
| SI-GCN | 0.270 | 121.80 | 0.270 | 81.31 | 0.690 | 37.40 |
| GMEL | 0.537 | 103.90 | 0.450 | 74.22 | 0.710 | 45.37 |
| 重力神经网络 | 0.305 | 114.70 | 0.457 | 71.99 | 0.731 | 26.52 |
| 深度重力模型 | 0.697 | 39.36 | 0.697 | 28.26 | 0.745 | 17.28 |
| 本文模型 | 0.728 | 35.31 | 0.736 | 24.59 | 0.755 | 16.33 |
| 表 2 所列相对提升 | 4.25% | 10.29% | 5.60% | 12.99% | 1.34% | 5.50% |
最后一行是论文印出的相对提升,比较对象是七个基线中最好的深度重力模型,不是七个基线的平均。MAE 三项可以由表中数字复核:(39.36−35.31)/39.36=10.29%,(28.26−24.59)/28.26=12.99%,(17.28−16.33)/17.28=5.50%。三者简单平均为 9.59%,与摘要一致。
CPC 后两项也能复核:(0.736−0.697)/0.697=5.60%,(0.755−0.745)/0.745=1.34%。第一项用表里已经保留三位小数的 0.728 和 0.697 相除,约为 4.45%,与印出的 4.25% 不完全相同。引用这项提升时,需要同时看绝对差:长沙局部 CPC 增加 0.031,长沙全市增加 0.039,北京只增加 0.010。
两项指标的名次也不总是一起移动。长沙局部数据上,修正重力模型的 MAE 是 56.16,低于随机森林的 104.40、GMEL 的 103.90、重力神经网络的 114.70 和 SI-GCN 的 121.80;同一套数据的 CPC 却是随机森林 0.470,高于修正重力模型的 0.406。深度模型并不自动同时赢过只使用人口、吸引力和距离的重力公式。在三套数据、两项指标共六次比较里,同时最好的已有方法是深度重力模型,本文模型再优于它。
图方法在长沙的 CPC 明显偏低,SI-GCN 两套都是 0.270。论文的解释是:训练区和测试区几乎是两张不重叠的图,邻接表征很难直接搬过去。这是对表中差距的一种解释,表本身只记录了预测误差。
两个模块分开看,谁的贡献更大?
消融比较四个版本:原来的深度重力模型、只加重加权、只加解耦表征,以及两者合在一起的 SIRI。只加重加权时,权重按全部输入属性计算。
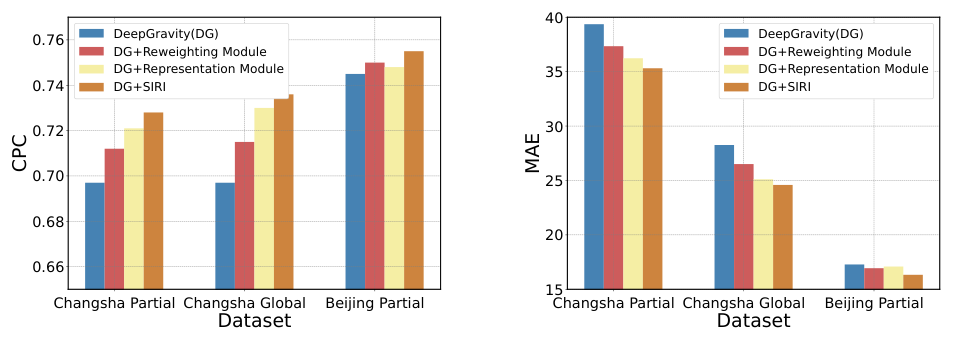
图 6|解耦和重加权是不是要叠在一起才最好?
无字母子图。左图纵轴 CPC,刻度从 0.66 到 0.76,越高越好;右图纵轴 MAE,刻度从 15 到 40,越低越好。横轴都是长沙局部、长沙全市、北京局部。图例顺序为深度重力模型、只加重加权、只加解耦表征、完整 SIRI,图中对应蓝、红、黄、橙。柱上没有印数字。能够和表 2 对上的是两端:长沙局部 CPC 从 0.697 到 0.728,MAE 从 39.36 到 35.31;北京的 MAE 四根柱都靠近 15 到 20 这一段。顺序与正文一致:长沙两套数据上,解耦带来的改进略大于重加权;北京两者接近;三组里完整模型的 CPC 最高、MAE 最低。中间柱的高度不宜目测成精确百分比。来源:原论文 Fig. 6。
正文据此认为,分布外问题需要解耦来处理,重加权则在三套数据上都有稳定的额外改进。图 6 支持“加上任何一块都好于原骨架、两块一起最好”这个方向。它没有给出单独模块的置信区间,也没有做统计检验。
四种规划情形里,增益最小的是哪一格?
整体提升之后,论文再按区域把流量切开。初始开发程度用兴趣点数量衡量,规划增量用兴趣点增长率衡量。正文把开发与否的阈值放在数量 50,并称之为五十分位点;增长率以 0.3 为阈值。图 7 的图注则写,阈值点定义为第三十百分位。图上的竖线只标注 POI Count=50 和 Growth Ratio=0.3,没有标百分位。四格的分界按图上的 50 和 0.3 来读;正文的五十分位点与图注的第三十百分位仍然对不上。
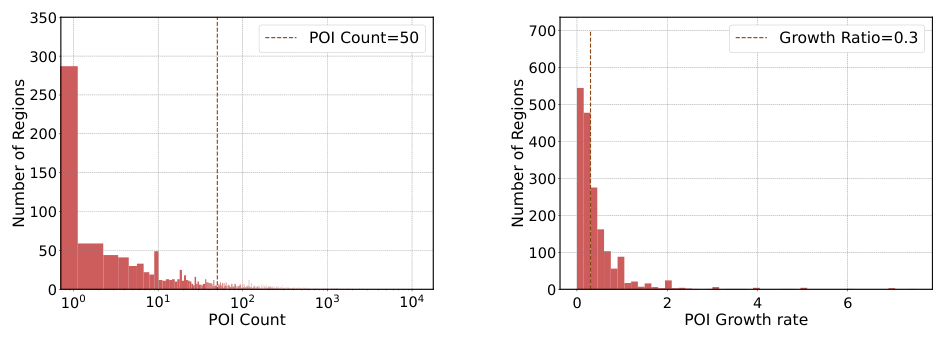
图 7|50 个兴趣点和 0.3 的增长率,落在分布的什么位置?
无字母子图。左图横轴是兴趣点数量,对数刻度从 10⁰ 到 10⁴,纵轴是区域个数,刻度到 350,竖线在 50。右图横轴是兴趣点增长率,刻度标到 6,纵轴区域个数刻度到 700,竖线在 0.3。两图都右偏,高数量和高增长的柱很矮。PDF 没有写直方图统计的是哪一套数据,也没有给出 50 左侧的区域比例。正文写五十分位点,图注写第三十百分位,图本身只标出 50 和 0.3。来源:原论文 Fig. 7。
四格比较的是流向这些区域的流量。增益定义为 MAE 的减少量除以这些流量的平均 MAE,对照是最好的基线。论文没有给出每一格的起讫对条数,也没有给出每一格未除之前的 MAE,所以四个百分数不能拼回前面的 9.59%。
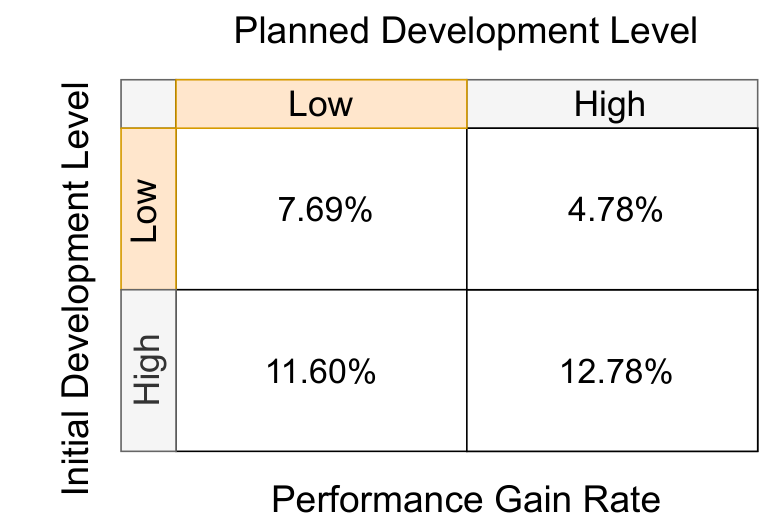
图 8|初始条件和规划增量交叉之后,MAE 相对增益差多少?
无字母子图。行是初始开发程度,上低下高;列是规划开发程度,左低右高。四格为:低初始且低增量 7.69%,低初始且高增量 4.78%,高初始且低增量 11.60%,高初始且高增量 12.78%。最低的一格仍高于论文所说的 4.5%。来源:原论文 Fig. 8。
低增量的两格是 7.69% 和 11.60%。论文认为这类区域在训练数据里更常见,所以不论原来发不发达,增益都比较大。高增量被写成更难的情形,因为这样的样本少,区域之间的开发方式也更不相同。文中点出的 4.78% 对应低初始、高增量这一格,不是高增量两格的共同数值;高初始且高增量的一格是 12.78%,反而是四格里最高的。
特别大的流量,误差是否一起下降?
大流量样本少,只靠相关关系不容易学到。论文同时认为它们在城市运行里更需要单独看,例如两个区域之间稳定的大量通勤可能对应拥堵。评估量叫相对误差降幅:本文方法带来的预测误差减少量,除以这条起讫流量的真实值。纵轴上的 0.1 表示误差减少量达到真实流量的 10%。它量的是误差相对流量规模的大小,深度重力模型原来的误差并不出现在这个分母里。
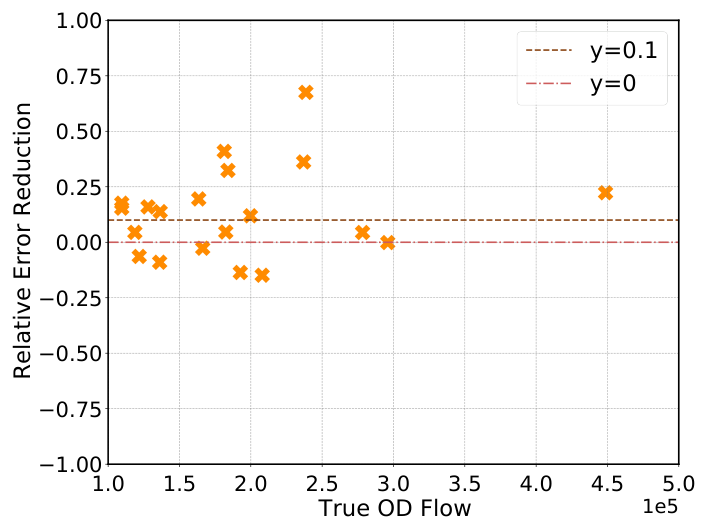
图 9|超过 10 万的流量,相对误差降幅散在哪里?
无字母子图。横轴是真实起讫流量,以 10⁵ 为单位,刻度从 1.0 到 5.0,对应约 10 万到 50 万。纵轴是相对误差降幅,从 −1 到 1。点为各起讫对,虚线标出 y=0.1 和 y=0。0 以上表示本文误差更小,0 以下表示更大。PDF 没有写这些点属于哪一套数据,也没有在图上逐点标数。来源:原论文 Fig. 9。
正文写:真实流量超过 10⁵ 的起讫对中,75% 得到性能提升,73% 的相对增益高于 10%。PDF 没有给出这批起讫对的条数,也没有分开统计“只是略有下降”和“下降超过真实流量的 10%”是否为同一批点。图中有落在 y=0 以下的点。论文认为变差的幅度相对整体进展较小,这个判断没有配一张分位数表。
合在一起看,超过 10⁵ 的流量上,论文给出的比例是 75% 的起讫对误差下降、73% 的相对降幅高于真实流量的 10%,同时图里保留了误差变大的点。
这些数字能支持到哪一步?
能支持的是:在这两座城市、约一年间隔、用已发生的兴趣点数量变化当作干预、并用另一组行政区做测试时,解耦加重加权优于所列七个基线里最强的深度重力模型,而且四格情景下的 MAE 相对增益都为正。CPC 与 MAE 的提升幅度随数据集变化,北京最小。
还需要停住的地方有四层。第一,测试使用的是那一年里实际发生的兴趣点变化和事后流量。规划文本里尚未建成的方案,没有作为单独的输入被评分。第二,重加权和解耦改变的是表征和样本权重。区域条件与兴趣点变化的缠结被减轻到什么程度,PDF 没有给出加权前后的相关或平衡表。第三,MAE 的单位和起讫对个数未知,CPC 与 MAE 又会给出不同名次,单一的 9.59% 不能代替一条走廊上的流量误差。第四,两套长沙实验共用望城和长沙县。开福、岳麓、芙蓉增加的是训练区;独立的另一座城市测试只有北京。
论文把后续工作放在更长的时间间隔,以及其他不只涉及兴趣点的规划形式上。当前证据停在约一年、且以兴趣点数量变化代表规划。
一句话总结
用较发达城区训练,再结合待预测城区较早一个月的流量和兴趣点数量变化,解耦属性并重加权之后,能把深度重力模型的平均绝对误差再平均压低 9.59%;这是跨区观察数据上的拟合改进,规划效应仍留在未做随机试验的范围内。
核心来源
- CIKM ’22 会议论文。首页题目为 Causal Learning Empowered OD Prediction for Urban Planning,并印有 DOI:10.1145/3511808.3557255。会议时间是 2022 年 10 月 17–21 日,地点为美国亚特兰大;ACM 引用写明 10 页。
- 数值来自正文 Table 1、Table 2 以及第 4 节对图 6 至图 9 的说明。图像对应正文 Fig. 1 至 Fig. 9。这份 PDF 共 10 页,页码 2455–2464,没有收录补充材料。
- 论文脚注给出的代码入口:tsinghua-fib-lab/SIRI。
作者介绍
六位作者在首页都署名为清华大学,北京。PDF 没有贡献声明,也没有标出通讯作者或院系,因此不补充职称和分工。
- Jinwei Zeng:署名顺序第一位。
- Guozhen Zhang:署名第二位。
- Can Rong:署名第三位。
- Jingtao Ding:署名第四位。
- Jian Yuan:署名第五位。
- Yong Li:署名第六位。
能够从 PDF 核实、并且和这篇研究直接相关的信息,是他们共同报告了 SIRI,以及长沙、北京三套区域尺度上的出发地—目的地流量比较。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个规划办公室最关心的是原来兴趣点不多、却准备大幅增加的区域,图 8 里对得上的数字是 4.78%。摘要中的 9.59% 是三套数据整体 MAE 相对降幅的简单平均,样本和分母都与这一格不同。4.78% 的分子是相对最好基线减少的 MAE,分母是该格流量的平均 MAE。流量单位和该格样本数都没有印出,这个百分数还换不成少误了多少出行,也看不出会不会改变一条路的宽度。把四格分开报告,更接近待决策的那一类地区。
另一项值得单独做的计分,是固定每个起点的流出总量之后,只看真实流量最高的那一成。图 9 已经显示,超过 10 万的起讫对里既有明显变好的点,也有落在 0 以下的点;表 2 又显示,长沙局部数据上随机森林的 CPC 为 0.470,高于修正重力模型的 0.406,MAE 却是 104.40 对 56.16。平均绝对误差对每条起讫对一视同仁,大走廊不会自动主导排名。若决策问的是最大的几条联系会不会被低估,上尾校准需要单独计分。全体起讫对的 MAE 下降 9.59%,回答的是另一道平均题。
两套长沙测试还提醒一件实验设计上的事:望城和长沙县考了两次,第二次只是把开福、岳麓、芙蓉加入训练。MAE 相对降幅从 10.29% 变为 12.99%,说明多三个较发达的区可能有帮助,但考卷没有换城市。下一步若要支撑“可以拿到另一座缺少历史的城市去用”,需要一座没有参与调参的城市,并且输入应是规划确定时已经写明的兴趣点方案,而不是那一年结束后才统计到的实际变化。一年的兴趣点数量也还接不住一条要修五年的线路。