总是一起出现的人,关注关系解释得了吗?
论文名片|Yunfei Lu、Linyun Yu、Tianyang Zhang、Chengxi Zang、Peng Cui、Chaoming Song、Wenwu Zhu,Exploring the collective human behavior in cascading systems: a comprehensive framework,Knowledge and Information Systems,2020,62:4599–4623,2020年8月27日在线发表。DOI:10.1007/s10115-020-01506-8。本文依据这一正式期刊版解读。2018年 IEEE ICDM 初稿题为 Collective human behavior in cascading system: discovery, modeling and applications;期刊版把时间层从单一泊松过程改成分段的泊松混合。
早晨有些车天天进城,有些货车天天去郊区。作者用这个画面说明一种集体行为:反复同行的是一批批人,把他们绑在一起的,可以是出门时间、目的地或别的共同之处。画面到此为止。后文的数字都来自转发记录。
真正计数的是腾讯微博上的转发。一个人发出不同内容,关注者并不会把每条都随机转走。早起的人更常转到日出的照片,同一所学校的人更常转到校园,喜欢体育的人更常转到赛事。于是同一个发布者下面会出现几组常客:组内的人反复出现在同一批级联里,组与组之间很少碰在一起。
方向性的结果是:只按关注关系或随机抽取,生成不出真实记录里那么强的“一起出现”。在生成过程里加上从历史行为学到的隐兴趣,并把每个人一天内的活跃分成五段之后,模拟出的转发才能同时贴近时间起伏、热度、树形和集体性。不知道转发发生在第几分钟,只凭根用户和随机看到的 4 名参与者,仍能估计这条级联的第一层会有多热、根用户的哪些关注者还会加入。这是生成模型对分布和局部身份的拟合,不是把隐变量证明成某一种真实动机。
先说结论
- 实验用的是 2011 年 11 月 15–25 日腾讯微博的一个子网络:7625 名用户、59828 条有向边、447453 条级联、598169 条推文。边由观察到的转发重建,用户标识已匿名,没有帖子正文。
- 按用户汇总后,超过 80% 的用户其集体性指标 Col 高于 0.2,超过 31% 高于 0.4。图上这两处的水平约为 0.81 和 0.31。随机挑选参与者时,这两个比例落到 69% 和 15%。
- 用全部 10 天拟合再生成同样长度的记录时,完整框架在热度、深度、直径和 Wiener 指数上的对数平均绝对误差,比该指标最好的基线分别低 32.68%、12.73%、36.44% 和 32.35%。宽度是例外,分支过程更小。
- 前 5 天训练、后 5 天测试,且不用时间特征:热度大于 5 的级联上,第一层热度的平均绝对百分比误差为 0.24;在正负样本配平之后,参与者预测的误差率为 18.14%。
这 10 天的子网络里,有多少人、多少条转发?
摘要写考察了超过 170 万条信息传播记录。实验节写的是腾讯微博一个子网络上、2011 年 11 月 15 日到 25 日共 10 天的全部级联。正文没有说明 170 万与下面这张计数的包含关系,两边都照论文保留。后文的分布和预测以实验节这组子网络为准。
| 项目 | 数量 | 单位 |
|---|---|---|
| 用户 | 7625 | 人 |
| 有向边 | 59828 | 条,由观察到的转发重建 |
| 级联 | 447453 | 条 |
| 推文 | 598169 | 条,含根帖与转发 |
| 观测窗 | 10 | 天,2011-11-15 至 2011-11-25 |
每条推文是一个三元组:谁发出、何时发出、回复的是哪一条父帖。根帖没有父帖。一条级联从一条根帖开始,沿转发长成一棵树;同一环境下的全部级联构成级联系统。分析单位因此有两层:比较两个人时,一个人是一个跨级联的 0/1 向量;比较一个发布者的集体性时,他的每一条推文是一个“哪些关注者转发了它”的向量。
帖子正文和用户画像都不在数据里,话题名称无法直接读出。后文的隐主题是行为上的潜变量。作者也指出,时间表、小团体和话题可以同时起作用,而且同一个人可以属于不止一组。模型要回答的是:只有行为记录时,这种混合原因造成的一起出现,能不能在行为层面上被抓住。
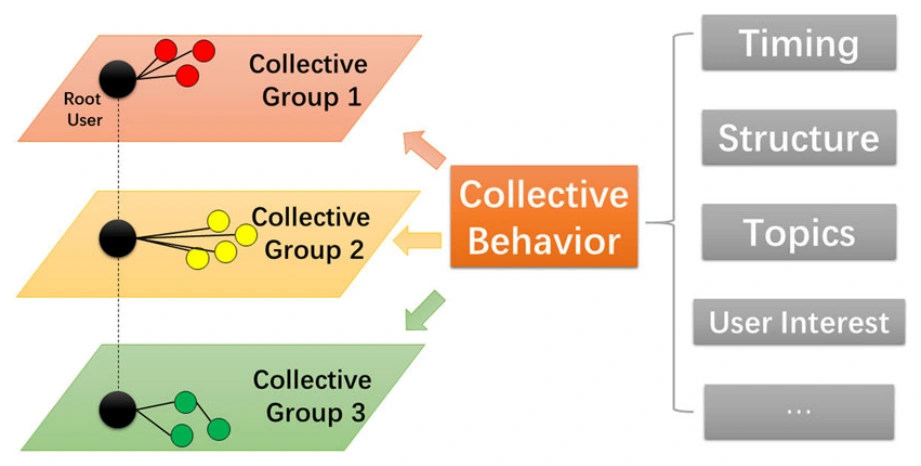
图 1|同一个根用户下面,为什么会分成几组常一起出现的人?
这是示意图,画的是机制,图中节点不对应这 7625 人。左侧同一个根用户连向三组不同颜色的关注者,用来表示组内常参加同一批级联、组间很少同时出现。右侧列出时间、结构、话题和用户兴趣,并留了一个省略项,表示这些因素可以同时起作用。来源:原论文 Fig. 1。
两个人的转发向量有多像?
对每个用户,按级联做成 0/1 向量:他发了这条根帖,或者转发了这条级联,记为 1,否则为 0。两个向量的皮尔逊相关系数若为正,表示两人同步出现;若为负,表示背离。集体性关心的是相关有多强,所以取绝对值。另一个指标是杰卡德指数:两人共同参加的级联数,除以至少一人参加的级联数。分母是两个人行为集合的并集,不是全部 447453 条级联。
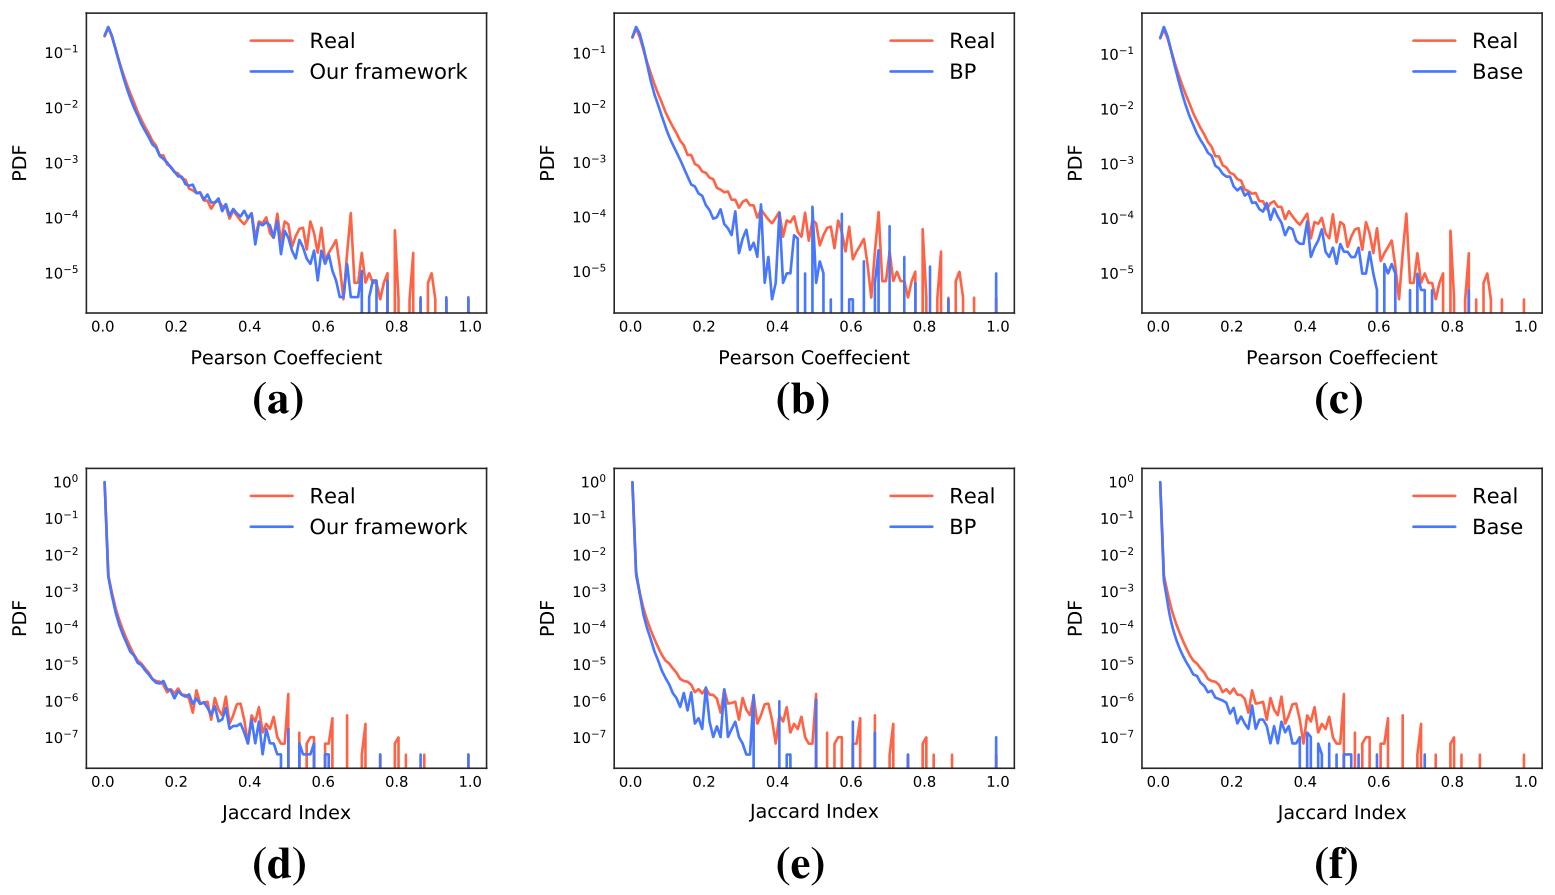
图 2|用户两两的行为相关,旧的选人方式能复现吗?
纵轴都是概率密度,取对数,所以左端的高峰会被压矮,右端稀少的高相关仍然看得见。横轴从 0 到 1。红线是真实子网络,蓝线是模型生成。上排是皮尔逊系数绝对值,下排是杰卡德指数。
(a、d)完整框架:按隐兴趣的匹配程度并加上关系强度来选参与者,蓝线能跟着红线走到高相关的尾部。(b、e)分支过程:从全部关注者里随机选人,高相关一端明显更稀。(c、f)去掉隐兴趣层的基线:只按关系强度选人,尾部同样偏轻。绝大多数用户对的重叠本来就很低,所以四条曲线都在 0 附近最高;集体性的差别在右尾,不在这个高峰。来源:原论文 Fig. 2。
用户对的相关容易被海量几乎不相干的点对稀释。论文因此再定义一个按发布者计算的集体性 Col。对用户 u 的推文两两计算皮尔逊系数,取绝对值再平均。绝对值大有两种读法:两条推文几乎被同一批关注者转发,或者几乎被完全不同的人转发。两种都算集体性,因为都是“一组人绑在一起、另一组人避开”。杰卡德不适合做这种平均:强烈同步接近 1,强烈回避接近 0,平均之后会把集体性抹平。
印刷公式把这个平均的分母写成关注者两两组合数,文字又说 N_u 是该用户的推文集合、平均的是推文向量两两之间的相关。组合数若按推文条数算,才是“推文两两平均”的分母。正文没有再解释这个差别。下面引用的比例来自 Col 在用户上的分布,不依赖读者自己重算每一对推文。
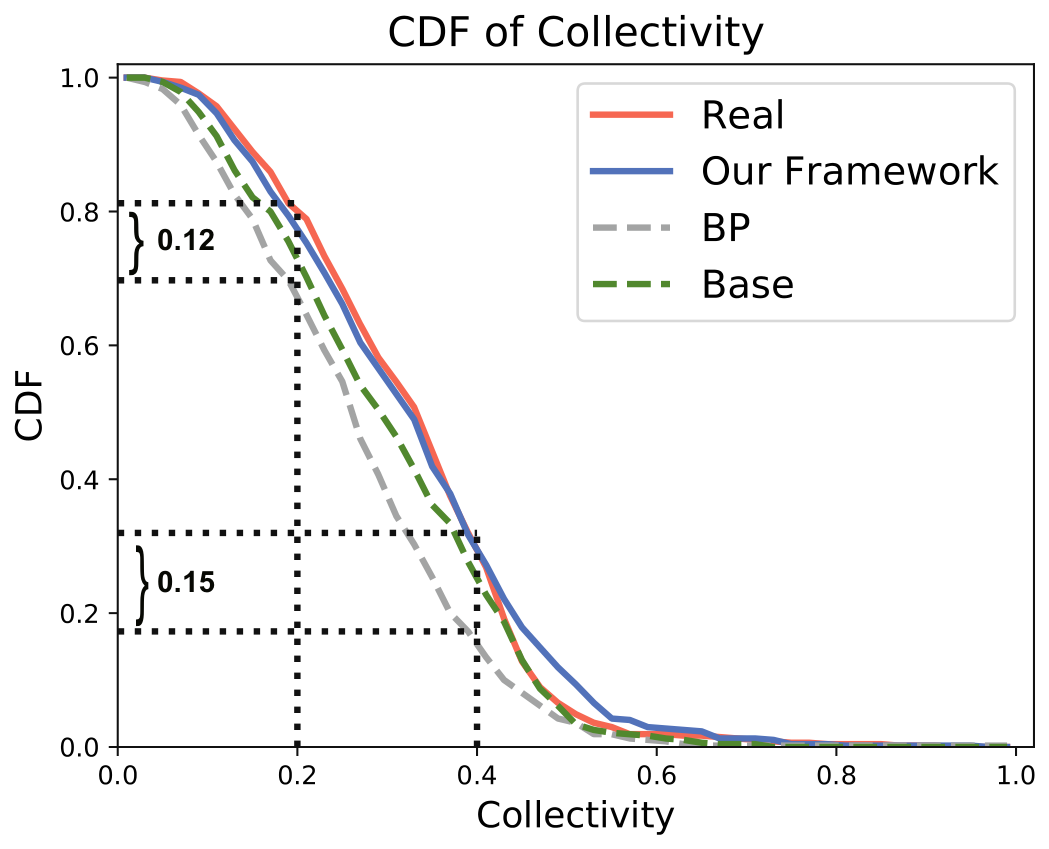
图 3|有多少用户的推文之间,转发者稳定地分成组?
横轴是 Col,纵轴标成累积分布,曲线从 1 降到 0,读作 Col 不低于该横轴值的用户比例。红线为真实数据,蓝线为完整框架,灰虚线为随机选人的分支过程,绿虚线为只保留关系强度的基线。
在 0.2 处,真实曲线约为 0.81,括号标出其他方法低 0.12。在 0.4 处,真实曲线约为 0.31,括号标出低 0.15。正文的对应说法是:真实数据里超过 80% 的用户 Col 大于 0.2,超过 31% 大于 0.4;随机选参与者时,这两个比例是 69% 和 15%。0.2 在文中被称作较弱但已经看得出来的相关,0.4 被称作中等。分母是用户。蓝线贴近红线,说明生成的 Col 分布接近记录。作息、小团体和话题都可能留在同一个隐变量里,图 3 没有把它们拆开。来源:原论文 Fig. 3。
每三个小时数一次,常数强度为什么是一条平线?
集体性也出现在时间上。把连续八天里的根帖和转发按每 3 小时计数,曲线有清楚的昼夜起伏和以天为单位的重复。多数人白天更活跃,也有人夜里活跃,不同活跃时段叠成高低不同的峰。历史上下一时间段活跃的人,以后更可能再次同步活跃。常数强度的泊松过程只能学到一个平均速率,生成的计数贴着一条水平带。
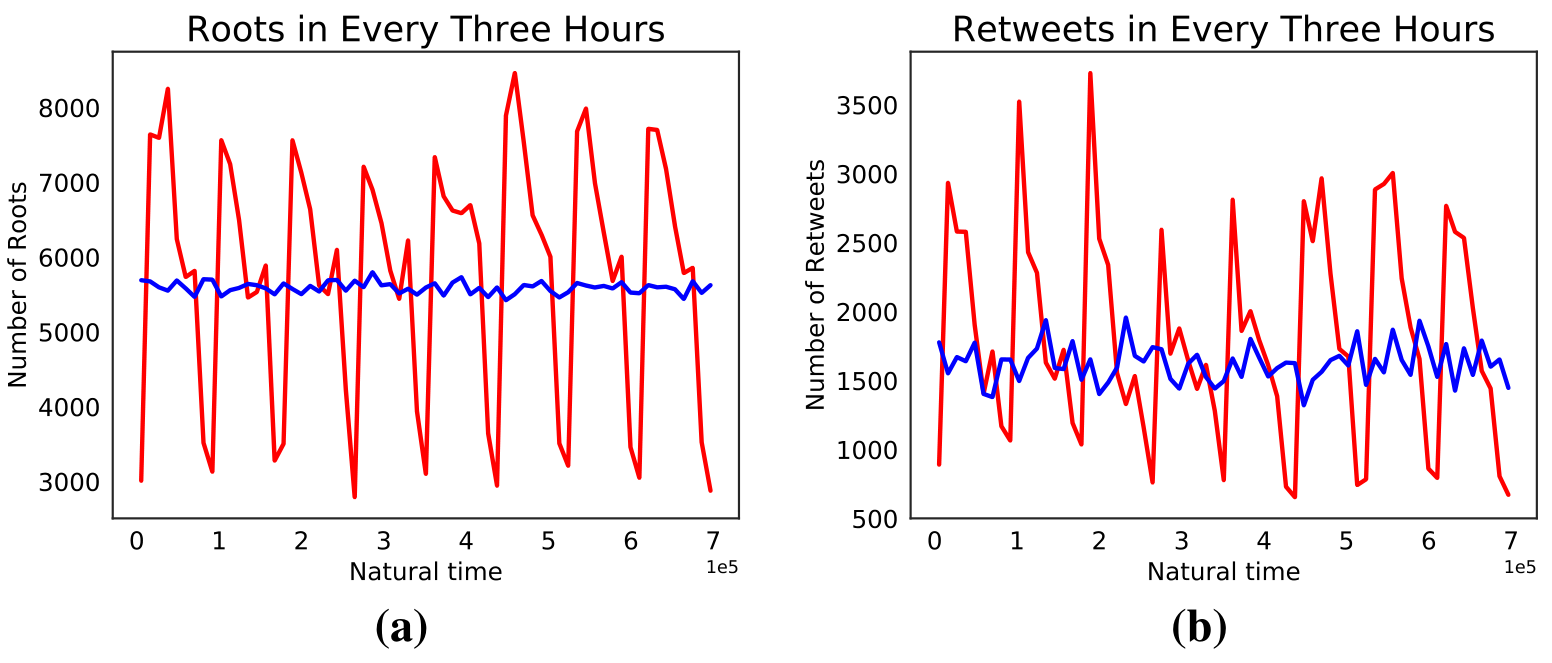
图 4|昼夜起伏里,常数泊松过程留下了什么?
红线是真实计数,蓝线是泊松过程的生成结果。横轴为自然时间,刻度到 7×10^5,覆盖论文所说的连续八天;坐标没有标注单位。纵轴是每 3 小时的条数,根帖面板的刻度到 8000,转发面板到 3500。
(a)根帖:红线每天冲高再落下,蓝线停在中部的一条窄带里。(b)转发:同样是红线大起大落,蓝线只在较低的平均水平附近抖动。它说明平均速率复现不了时间上的集体起伏。图上没有标出每个峰对应几点,也不能把峰高读成某一人群的人数。来源:原论文 Fig. 4。
一天五段,加上一层不看正文的隐兴趣
框架分两层。训练和生成都放在整个子网络上,各条级联的行为进入同一次似然。
时间层仍从泊松过程出发,但强度随钟点改变。用户 u 在时刻 t 发根帖的强度是 λ_u,t = λ_u × s_u,t。s 以一天为周期,而且在一天内的积分等于 1,所以它只重新分配一天里的活跃,不改变这一天的总尺度。看帖强度 ω_u,t 使用同一个 s。实验把一天切成五段:早晨 6:00–10:00、中午 10:00–14:00、下午 14:00–18:00、傍晚 18:00–22:00、夜间 22:00 至次日 6:00。λ 直接由观测窗里的根帖次数算出,s 由各段发出的消息数算出。
兴趣层不读取正文。每个用户有一个发根帖的主题分布,和一个转发时的兴趣分布,实验里都设成 5 个隐变量,各项非负且和为 1。论文写明,隐变量再多,拟合可以更细,训练也更慢,并增加过拟合风险;正文没有给出 5 以外的对照实验。这里的“兴趣”是任何让行为聚到一起的内部因素,由历史行为学出。分布越不均匀,这个人在不同隐主题上的行为差别越大。
一条帖会不会被转发,还取决于两样与主题无关的量。关系强度 π 表示接收者多么经常转发这个发送者,不随内容改变。深度衰减是全系统共用的一个数 x,介于 0 和 1:帖在级联中的深度为 d 时,转发倾向再乘 x 的 d 次方。根帖作者另有一个位置标记。论文说转发率随深度指数下降,但没有报告 x 的拟合值。
看到帖和决定转发是先后两步。没转发的人有两种可能:到观测结束还没看到,或者看到了但没有转。整个子网络的似然是所有用户、所有级联连乘。含隐变量的参数用期望最大化估计,M 步里用梯度下降,并用经验数据做初始值。生成时,观测窗结束之后的事件连同它会触发的后续事件一起丢掉。
对照有四组。分支过程按每个用户在真实数据里的后代数分布抽子节点,根帖和转发各学一个分布;它不生成时间戳,实验里让每个用户发出与真实记录相同数量的根帖。传播式基线只沿关系估计传递强度,同样把根帖和转发分开;论文没有给出这些强度的数值,后文只比较它生成的级联在热度和树形上的分布误差。第三组是去掉两个兴趣分布、只留其余部分的基线。第四组是常数强度的泊松过程,用来单独看时间层。
同样长的 10 天重放出来,间隔和昼夜贴到哪?
这一节是分布拟合:用全部 10 天估计参数,再生成同样长度的行为记录,然后比较分布。前 5 天对后 5 天的预测放在后面单说。分支过程和传播式基线没有时间戳,间隔时间和响应时间只比较完整框架、泊松过程和真实记录。
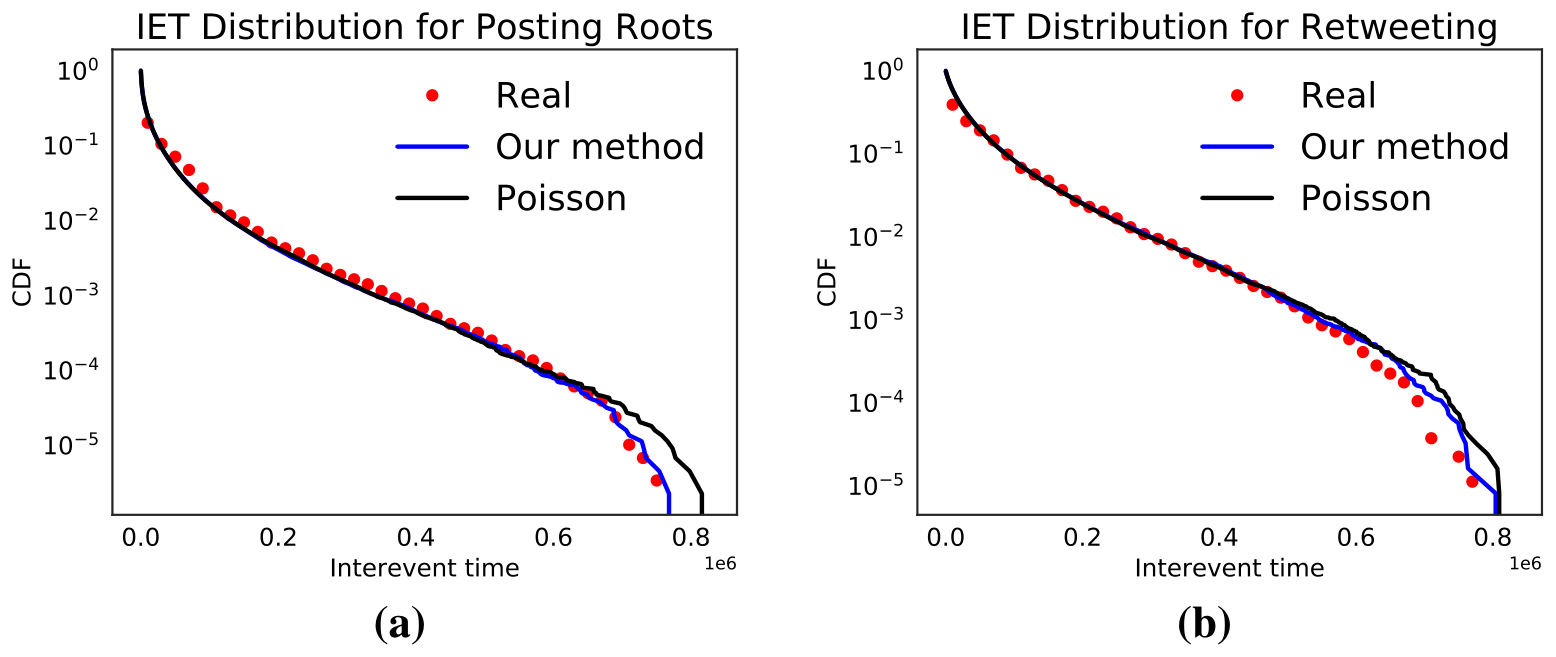
图 5|同一个人相邻两次行动的间隔,尾部谁更近?
纵轴是累积分布的对数坐标,横轴是间隔时间,右端刻度为 0.8×10^6。红点是真实数据,蓝线是完整框架,黑线是泊松过程。论文为了看清尾部才使用半对数坐标。
(a)发根帖的间隔:两条模型曲线在中段都接近红点,右端蓝线随红点下降,黑线留得更高一些。(b)转发的间隔:中段仍然接近,右端黑线高于红点,蓝线更贴着红点。论文的判断是完整框架在尾部更准确。图中没有给出某一个间隔上的精确概率差。来源:原论文 Fig. 5。
响应时间量的是另一段时长:从一条消息发出,到它得到回应。上面的间隔时间量的是同一个人自己的相邻两次行动。
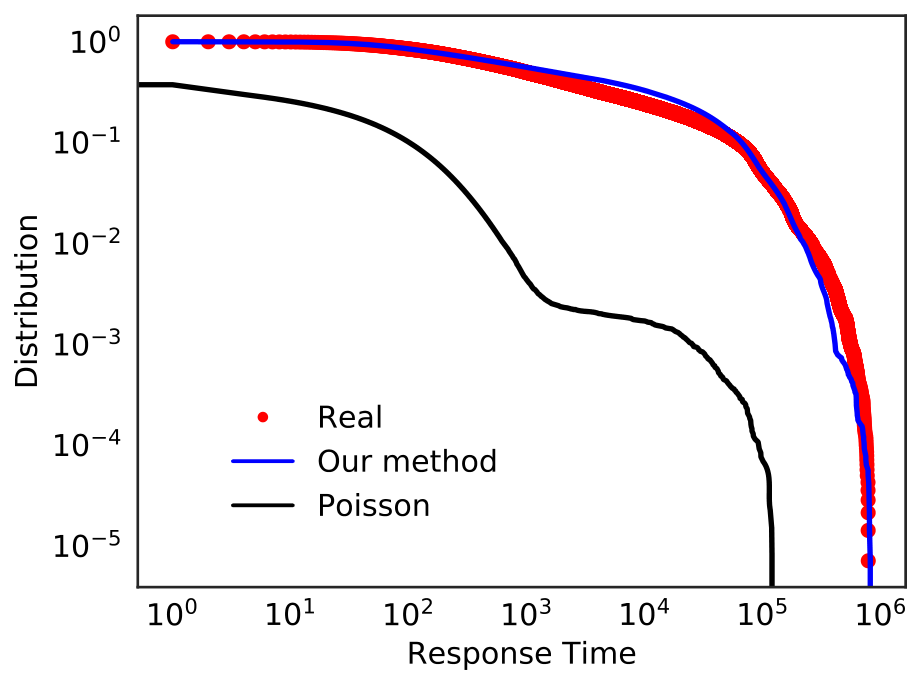
图 6|一条帖要多久才得到回应?
横轴是响应时间,对数刻度,右端在 10^6 处截断,论文写明这是数据范围造成的。纵轴是分布的对数坐标。红点为真实数据,蓝线为完整框架,黑线为泊松过程。红点与蓝线从接近 1 的位置一起下降,并在右端急剧落到 10^6 附近;黑线从左侧开始就明显更低,中段差距更大。常数泊松过程容易把响应时间集中在期望附近。乘上随时间变化的 s 之后,不活跃的时段可以拉出长响应,活跃时段可以留下短响应,分布才和记录一致。来源:原论文 Fig. 6。
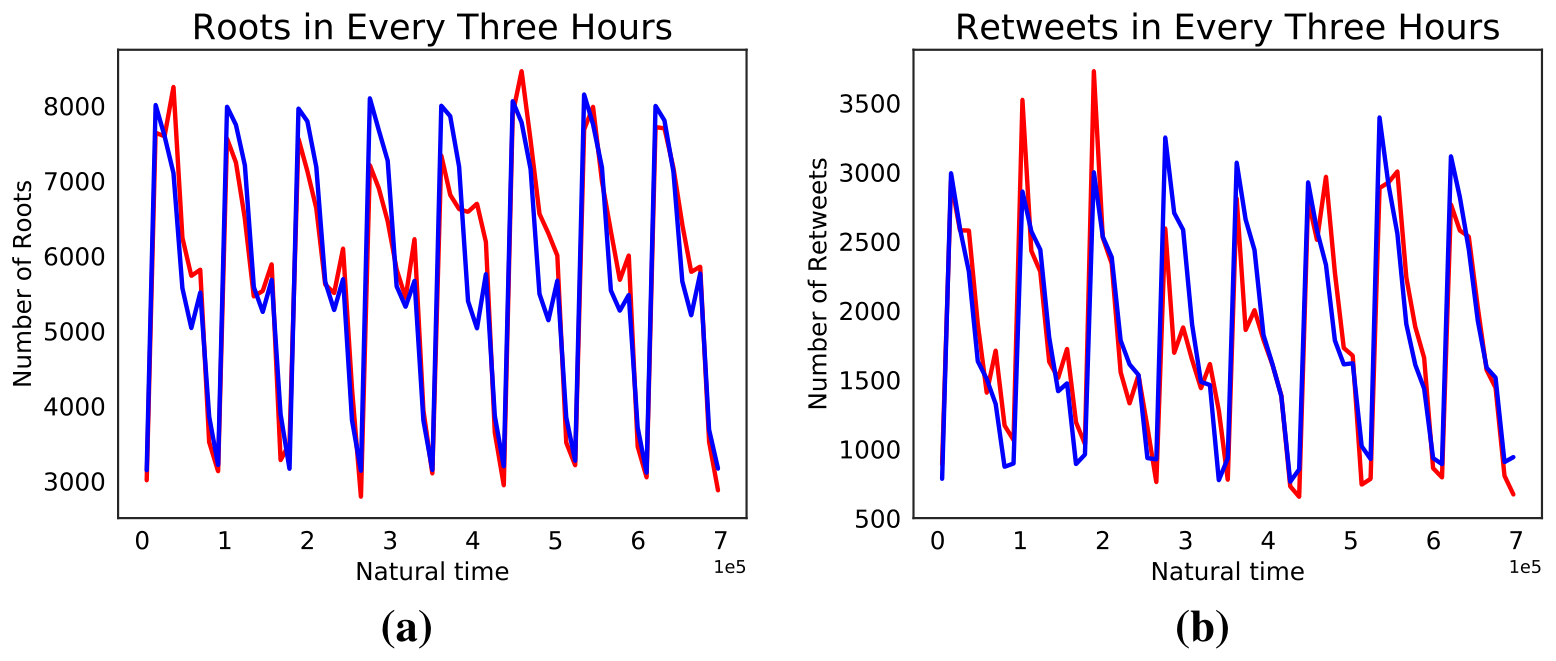
图 7|换成随钟点缩放的强度之后,八天的峰还在吗?
坐标与图 4 相同:每 3 小时计数,自然时间刻到 7×10^5。红线仍是真实数据,蓝线改成完整框架的生成结果。
(a)根帖:蓝线跟着红线每天升起和落下,不再是一条水平带。(b)转发:高峰和低谷的位置大部分重合,幅度也接近。论文同时写到,其中一两天仍有小的偏离,并归因于数据只有 10 天,框架只放进了以天为周期的变化,放不进以周为周期的变化。它没有指出是哪一天,也没有检验周周期。来源:原论文 Fig. 7。
一条级联的大小和树形,要同时接近
热度是一条级联里的推文总数。结构用四个量:深度是离根最远的距离;宽度是从同一条帖分出的最多子帖数;Wiener 指数是所有帖两两最短路径长度之和,链状更大、星状更小;直径是树里最长的那条路径。Wiener 指数和热度正相关太强,所以二维分布改看直径。
因为一次生成的偶然性大,横轴按对数等宽分箱,再在累积分布上计算对数平均绝对误差,避免对数里出现 0,也避免少数点主导。它的含义是对数坐标上两条累积曲线之间的面积。论文没有写出箱数。表头的因子是 e 的 −3 次方,大约 0.0498,不是 10 的 −3 次方。四个模型乘同一个常数,行与行之间的相对差距不变。
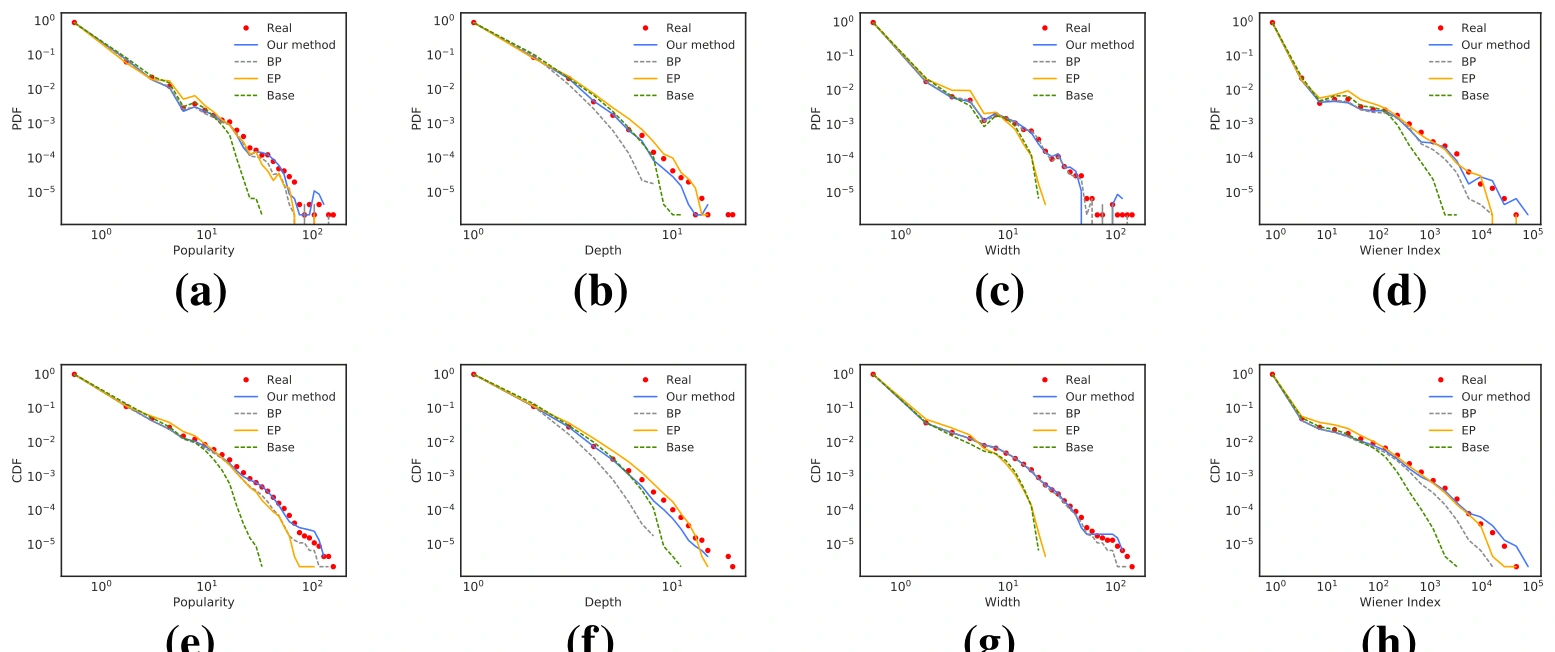
图 8|热度、深度、宽度和 Wiener 指数的分布,谁能同时贴近?
红点为真实数据,蓝线为完整框架,灰虚线为分支过程,橙线为只按边传递的基线,绿虚线为去掉兴趣层的基线。上排是概率密度,下排是累积分布,纵轴为对数。从左到右依次是热度、深度、宽度、Wiener 指数。
(a、e)热度:去掉兴趣层的绿线下降得最早,完整框架把右尾留得更接近红点。(b、f)深度:灰虚线整段偏低,蓝线更贴红点。(c、g)宽度:各线在左段接近,右尾分开;这一项的数值比较见下表,分支过程最小。(d、h)Wiener 指数:绿线再次偏早下降,蓝线跟随红点到更远处。单看其中一幅只能说明该指标的边缘分布,不能说明四个量在同一条级联上的搭配。来源:原论文 Fig. 8。
| 指标 | 完整框架 | 分支过程 | 传播式基线 | 去掉兴趣层 |
|---|---|---|---|---|
| 热度 | 2.088 | 3.102 | 4.447 | 9.813 |
| 深度 | 1.801 | 3.037 | 2.064 | 4.082 |
| 宽度 | 0.044 | 0.018 | 2.164 | 1.881 |
| 直径 | 1.158 | 3.007 | 2.106 | 1.822 |
| Wiener 指数 | 0.975 | 1.442 | 1.889 | 1.675 |
表中数字还要乘以 e^−3,才是对数平均绝对误差本身。除宽度外,每一行最小的都是完整框架。论文计算的相对改进,分母是该行最好基线:热度相对分支过程的 3.102,低 32.68%;深度相对传播式基线的 2.064,低 12.73%;直径相对去掉兴趣层之后的 1.822,低 36.44%;Wiener 指数相对分支过程的 1.442,低 32.35%。宽度上分支过程是 0.018,完整框架是 0.044。宽度的定义就是最多后代数,分支过程又直接学习后代数分布,所以它在这一项上更小,并不表示热度和树的其余形状也由它复现。
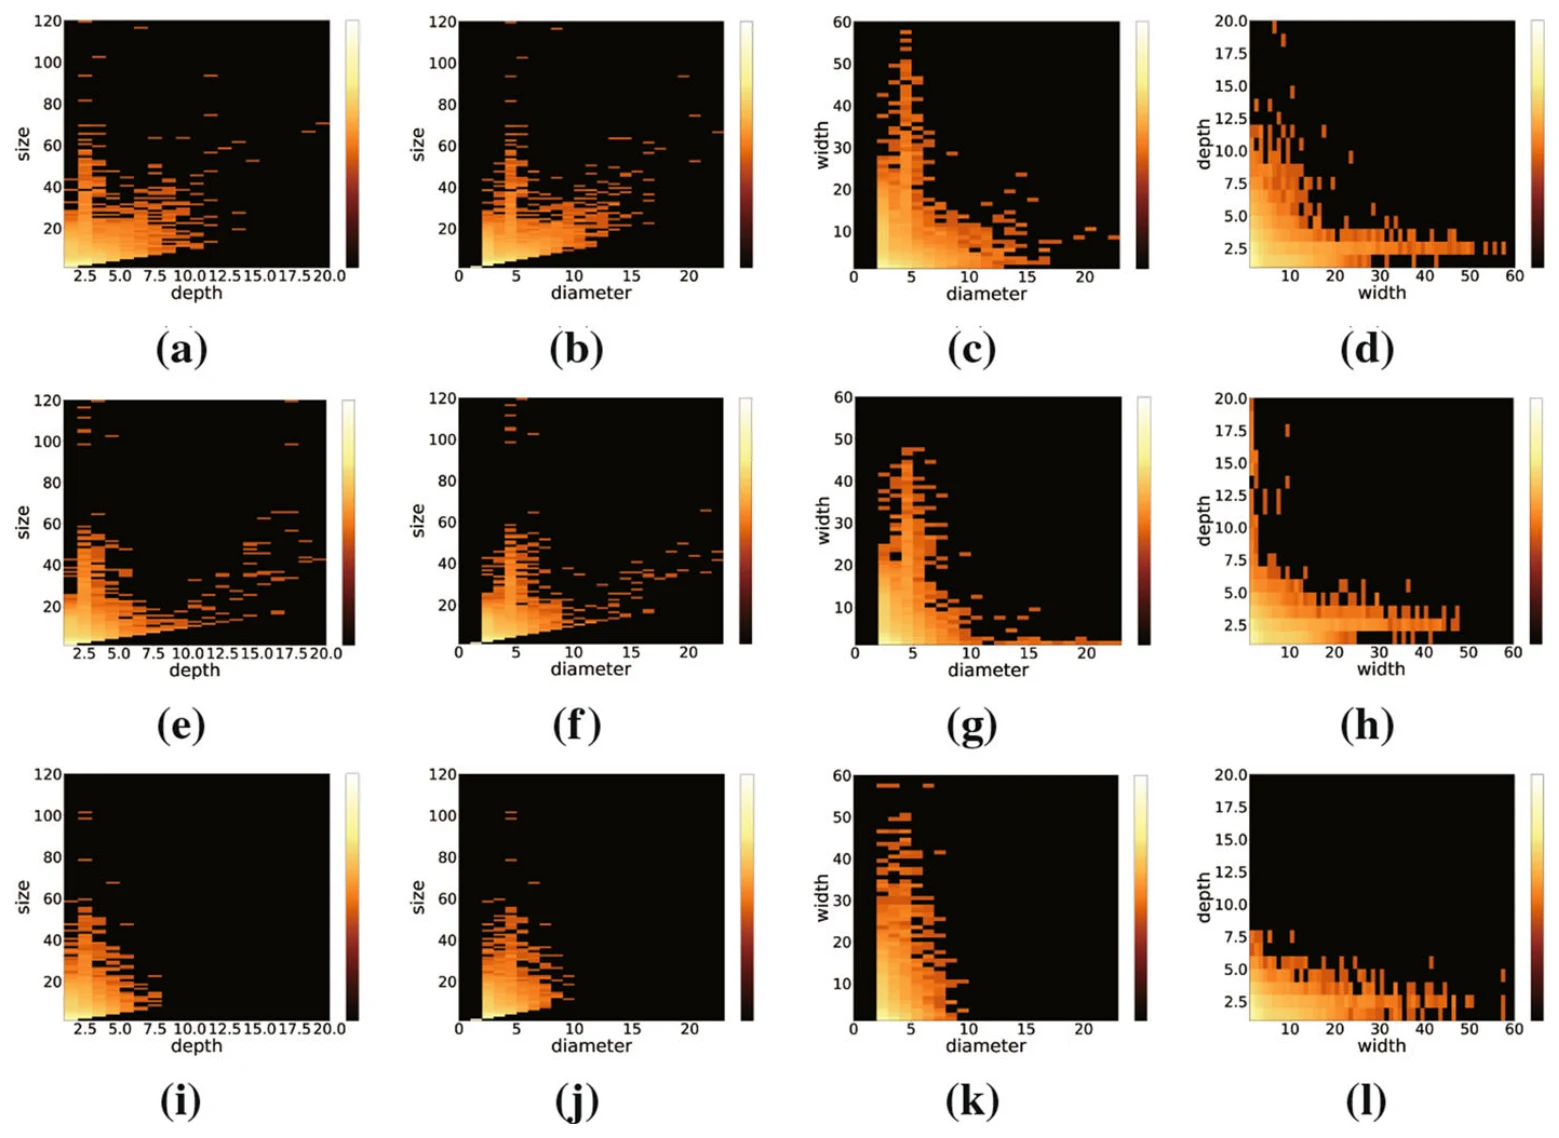
图 9|热度和树形的搭配,边缘分布对了就够吗?
颜色越亮,对数尺度上的密度越高。上排是真实数据,中排是完整框架,下排是图 8 里综合表现最好的分支过程;其余基线没有画进这张二维图。左列纵轴标为 size,对应正文的热度,即级联中的推文条数。
(a、e、i)热度对深度。(b、f、j)热度对直径。(c、g、k)宽度对直径。(d、h、l)深度对宽度。中排保持了上排里质量集中在较小深度、较小直径一侧的形状。下排更散,高直径、高宽度的区域更亮。因此,单个指标的边缘分布接近,仍可能配出不一样的树。图是生成结果与记录的联合分布比较,不是对某条级联的逐帖复原。来源:原论文 Fig. 9。
集体性的分布已经在图 2 和图 3 里比过:完整框架贴近真实的用户对相关和 Col,随机选人与只按关系强度选人都更低。图 7 则表明,时间维上的峰也可以由分段活跃缩放跟着走。这些仍是同一套参数生成出的分布相似性。
不看钟点,只看已经出现的四个人
预测实验和上面的重放分开。模型用前 5 天训练,测试来自后 5 天,并删去两段时期行为差异很大的用户。论文没有写出删了多少人。预测只用参与者身份,不用时间特征。分支过程随机指定后继,参与者是谁对它没有意义,所以这一节不再拿它比较。
第一问只预测第一层:根帖作者的关注者里,会有多少人加入。样本是热度大于 5 的级联。已知信息是根作者,再加随机抽出的 4 名参与者。热度已经达到 5,可以回头看该用户以往热度大于 5 的级联,推断这条级联的主题分布。这 4 个人确实一起转发了,又可以在 5 个隐主题上计算他们共同转发的概率,归一化后得到这条级联的兴趣权重。预测值是各主题“关注者期望转发数”的加权平均,权重正比于发帖主题概率与转发兴趣的乘积。传播式基线和去掉兴趣层的模型只按关系强度或传递强度计算期望。
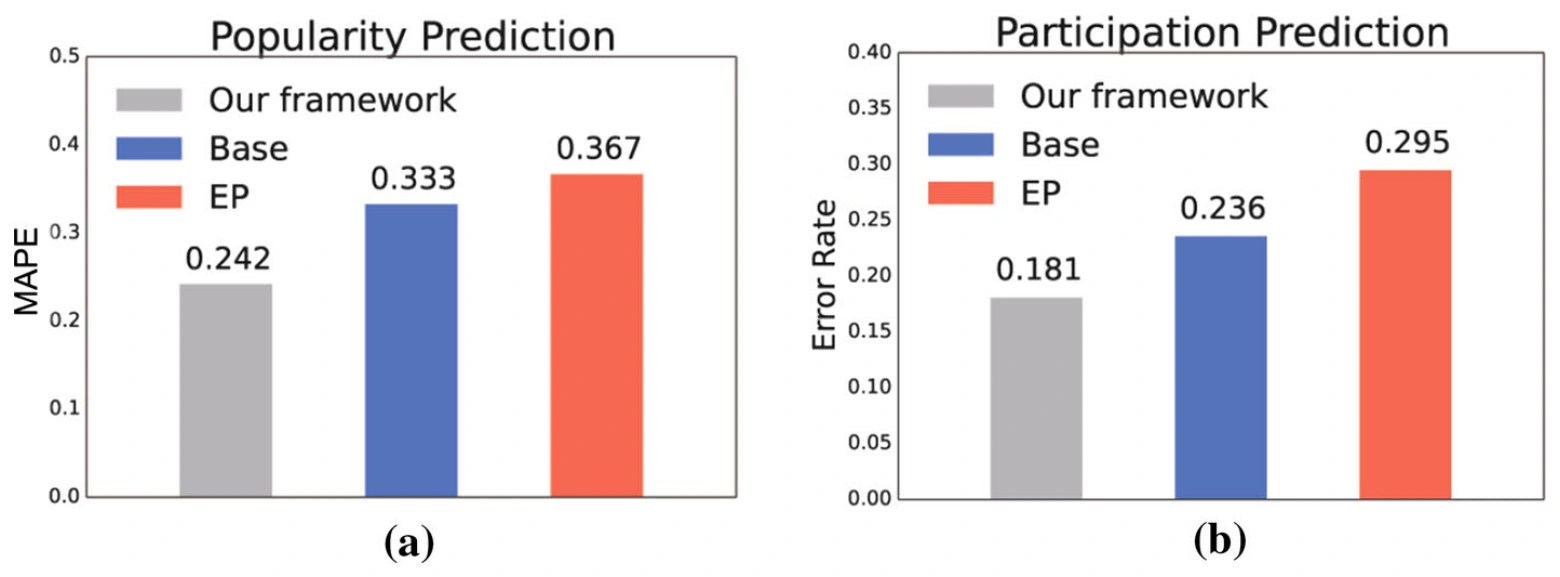
图 10|没有时间特征时,第一层热度和参与者还能预测到什么程度?
灰柱是完整框架,蓝柱是去掉兴趣层,橙柱是只按边传递的基线。
(a)纵轴是平均绝对百分比误差。柱顶分别为 0.242、0.333、0.367。正文把本框架的结果写成 0.24,图注同样写 0.24。论文没有展开这个误差的公式;按它使用的名称,0.24 是相对每条级联真实第一层规模的平均相对误差,分母是该级联第一层的真实人数,不是 0.24 个百分点,样本限于热度大于 5 的级联。(b)纵轴是参与者预测的误差率,柱顶分别为 0.181、0.236、0.295。正文写本框架为 18.14%,图注四舍五入为 0.18。来源:原论文 Fig. 10。
第二问预测根作者的哪些关注者会转发。仍然取热度大于 5 的级联,随机抽 4 名参与者,但避开根作者的关注者,并已知第一层热度。实际转发的关注者是正例,其余是负例。负例远多于正例,所以每次从关注者里随机抽取与正例一样多的负例,再在这个配平集合里排序。排序用看帖的基础强度,不再乘一天内的活跃缩放。本框架的误差率是 18.14%,分母是配平后的候选关注者,不是根用户的全部关注者。它低于只按互动频率或关系强度排序的基线,说明多出来的信息来自那 4 个人所暗示的隐主题。这仍不是在全量关注者上的命中率,也没有使用转发时刻。
这些比较停在什么地方
生成分布接近记录,表示这套参数足以重现若干边缘分布和部分联合形状。它没有排除别的潜变量层,也没有把时间、小团体和话题拆成可单独观测的原因。网络本身由转发重建,7625 人不是腾讯微博的全体用户,结果不能直接当成全站关注图上的规律。
10 天只能看见以天为周期的起伏。图 7 里一两天的偏离,作者自己归到缺失的周周期。五段钟点来自消息量,不是从这批数据里搜索出来的最优切分。预测又删去了行为在前后 5 天差异很大的用户,留下来的是相对稳定的人,删除人数未知。第一层热度也不是整棵树的最终大小。
交通画面停留在引言的例子。本文的测量对象是转发级联。文中把人类移动预测引向 Calabrese 等人 2010 年的工作,用来说明集体行为研究已有别的用途;那篇文献的结果不由本数据承担。
一句话总结
在这 10 天、7625 人的微博子网络里,谁会反复出现在同一些转发中,关注关系单独留不住;加上从历史行为学到的隐兴趣和一天五段的活跃缩放之后,生成记录才能同时接近时间、热度、树形和集体性,并在不知道时刻时把第一层热度的平均相对误差做到 0.24。
核心来源
Lu Y., Yu L., Zhang T., Zang C., Cui P., Song C., Zhu W. (2020). Exploring the collective human behavior in cascading systems: a comprehensive framework. Knowledge and Information Systems, 62, 4599–4623. https://doi.org/10.1007/s10115-020-01506-8
期刊版首页的署名单位是:Yunfei Lu、Linyun Yu、Tianyang Zhang、Chengxi Zang、Peng Cui 和 Wenwu Zhu 在清华大学计算机科学与技术系,Chaoming Song 在美国迈阿密大学物理系。文末说明 Wenwu Zhu 为通讯作者;首页把联系邮箱放在 Yunfei Lu 名下。下列介绍来自论文所附作者简介,写的是 2020 年刊出时的表述。
Yunfei Lu 的简介写他 2016 年本科毕业于清华大学计算机系并获优秀毕业生,当时在该系攻读博士,关注数据挖掘、社会计算、信息扩散和人类动态。
Linyun Yu 的简介写他 2012 年毕业于清华大学姚班,2017 年在清华计算机系获得博士学位,研究数据挖掘、社会计算和人类互动;2016 年 3 月至 8 月访问迈阿密大学,简介落款时在字节跳动工作。
Tianyang Zhang 的简介写他 2013 年本科、2018 年博士均毕业于清华计算机系,关注数据挖掘、社会动态和群体演化;简介中的当时身份是 PowerLaw AI 的联合创始人。
Chengxi Zang 的简介写他 2019 年获得清华大学博士学位,工作包括挖掘社交系统的结构与动态,并研究过腾讯微博上的大规模信息级联。
Peng Cui 的简介写他是清华大学长聘副教授,2010 年在清华获得博士学位,方向包括因果正则的机器学习、网络表示学习和社会动态建模。
Chaoming Song 的简介写他当时是迈阿密大学物理系助理教授,2008 年获纽约城市大学物理博士,研究统计物理、网络和计算社会科学,并把不同尺度上的人类移动与互动列为自己的问题。这是作者背景,不是本论文测量了出行。
Wenwu Zhu 的简介写他 1996 年获纽约大学博士学位,当时为清华大学教授、本文通讯作者,研究方向是多媒体通信与计算,并曾在贝尔实验室、微软亚洲研究院和英特尔中国通信技术实验室工作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
早高峰若也要回答“是不是同一批人”,需要的记录不是一条路的小时流量,而是同一批出行者在多日、多趟行程里是否反复同现。作者的货车与小汽车例子恰好提供一个反例:同一小时出发,仍可能是两组人。微博模型起作用,是因为同一个根用户下面允许有多组隐主题。搬到居住区,就是同一小区可以同时走出通勤、货运和夜间活动,一个平均出发率会把它们合成一条平线,就像图 4 里的蓝线。
一天五段来自微博消息量:6 点到 10 点、10 点到 14 点、14 点到 18 点、18 点到 22 点、22 点到次日 6 点。城市通勤的高峰通常更窄,周五夜间也不同于周一早晨。这批数据只有 10 天,图 7 已经在一两天上对不齐。把这五段原样用于道路,会把周内差别平均掉。
18.14% 的分母是正负样本一样多的候选关注者。地铁站若要猜下一班还有哪些常旅客出现,未出现的人远多于出现的人,这个比例不能当成漏报率。该预测还故意不用时间。早高峰恰恰是时刻表信息最强的场景,所以“不知道钟点也能估计第一层”在微博配平样本上成立,不能直接变成“不用时刻表也能调度”。