收入更高的地方,人就走得更远吗?
论文名片|Hugo Barbosa、Surendra Hazarie、Brian Dickinson、Aleix Bassolas、Adam Frank、Henry Kautz、Adam Sadilek、José J. Ramasco、Gourab Ghoshal,Uncovering the socioeconomic facets of human mobility,Scientific Reports,2021,11:8616,2021年1月15日收稿,2021年3月25日接收。DOI:10.1038/s41598-021-87407-4。本文依据该正式发表版解读。
同一座城市里,一个子区的家庭收入中位数更高。若只凭收入猜测出行,很容易以为那边走得更远,也走得更勤。既有单城研究并没有给出同一句话:波士顿和新加坡的不同社会经济群体出行很像,路易斯维尔的低收入居民平均走得更远,一项拉美手机研究里更富裕的人到达更多地点、也走得更远,波哥大最活跃的是中上阶层,利雅得和西班牙的失业者出行更少、在家更久,法国市镇的到访多样性与收入有关、出行距离则不然。这些研究城市少,数据和方法也不统一。
这篇论文用同一套子区流量,比较美国和巴西各 50 座人口最大的城市。方向已经清楚:收入更高,并不对应同一种出行。美国低收入子区的跨区距离往往更短,人均流出却更频繁;巴西收入更高的子区通常又远又频繁。美国城市还能分成两类,一类收入与出行明显一起变化,另一类几乎看不出稳定相关。
先说结论
- 比较单位是子区,不是个人。2016 年的年化流出连结美国邮政编码统计区和巴西普查加权区;高低组是每个城市内部、按家庭收入中位数排列后最高和最低的约 20% 子区。
- 美国这两组的距离分布大量重叠,低收入一侧略偏短,频率一侧更高;巴西两组分得更开,高收入子区的距离和频率都更高。
- 美国 50 城按收入—出行相关分成青色和橙色两簇。人口不少于 500 万的最大七座城市都在橙色簇,橙色簇使用公共交通的人口比例更高,相关也更平。
- 巴西两簇的相关大体都为正,蓝色簇更强。那里的优势同时出现在距离和频率上,公共交通没有表现出美国橙色簇那种拉平作用。
- 美国通勤表与这套流量的聚类相似度为 0.847。这个数比较的是两次分组像不像,不是 50 座城市里有 84.7% 保持原组。
这里的一条记录,是两个子区之间的流量
数据叫 Google Aggregated Mobility Research Dataset。汇总基础是 3 亿名打开了位置历史的用户,这个设置默认关闭。进入分析的是一张流量矩阵:元素 Tᵢⱼ 是 2016 年从地点 i 到地点 j 的年化流出。作者写明,研究使用的是经过匿名和差分隐私聚合之后的大群体流量,没有人工查看个人用户数据。
地点在美国是邮政编码统计区(ZIP Code Tabulation Area,ZCTA),在巴西是普查加权区(Weighting Area)。后文统称子区。城市取两国按人口排列的各 50 座最大城市,一共 100 座。两国被放在一起,是因为总人口和大型城市数量相近,一个是发达经济体,一个是新兴经济体。
收入来自美国 2016 年五年期美国社区调查,以及巴西 2010 年人口普查。因此巴西的收入地图比 2016 年的流量早大约六年,美国的五年期调查与流量年份有重叠。论文在多项普查指标里选用家庭收入中位数,理由是它与其他指标的斯皮尔曼秩相关最强,也因为它直接关系到负担出行成本的能力。这里有两种用法。IDq 是子区在本市的收入中位数五分位,最高档和最低档就是市内子区的前 20% 和后 20%。IDf 则按全国收入档,把一个子区写成各档居民所占比例;美国 8 档,巴西 9 档。
覆盖是否偏向高收入,论文在正文里报告了一项检查:两个收入档的流出都随子区人口单调上升。文中还写到,美巴家庭的手机拥有率都超过 90%,分母是家庭;两国在论文引用的智能手机使用比较里也位居前五。这两个数都不是这 100 座城市的抽样比例。位置历史仍然是选择加入的,论文在局限里说明,它不能代表所有地方的全部人口。
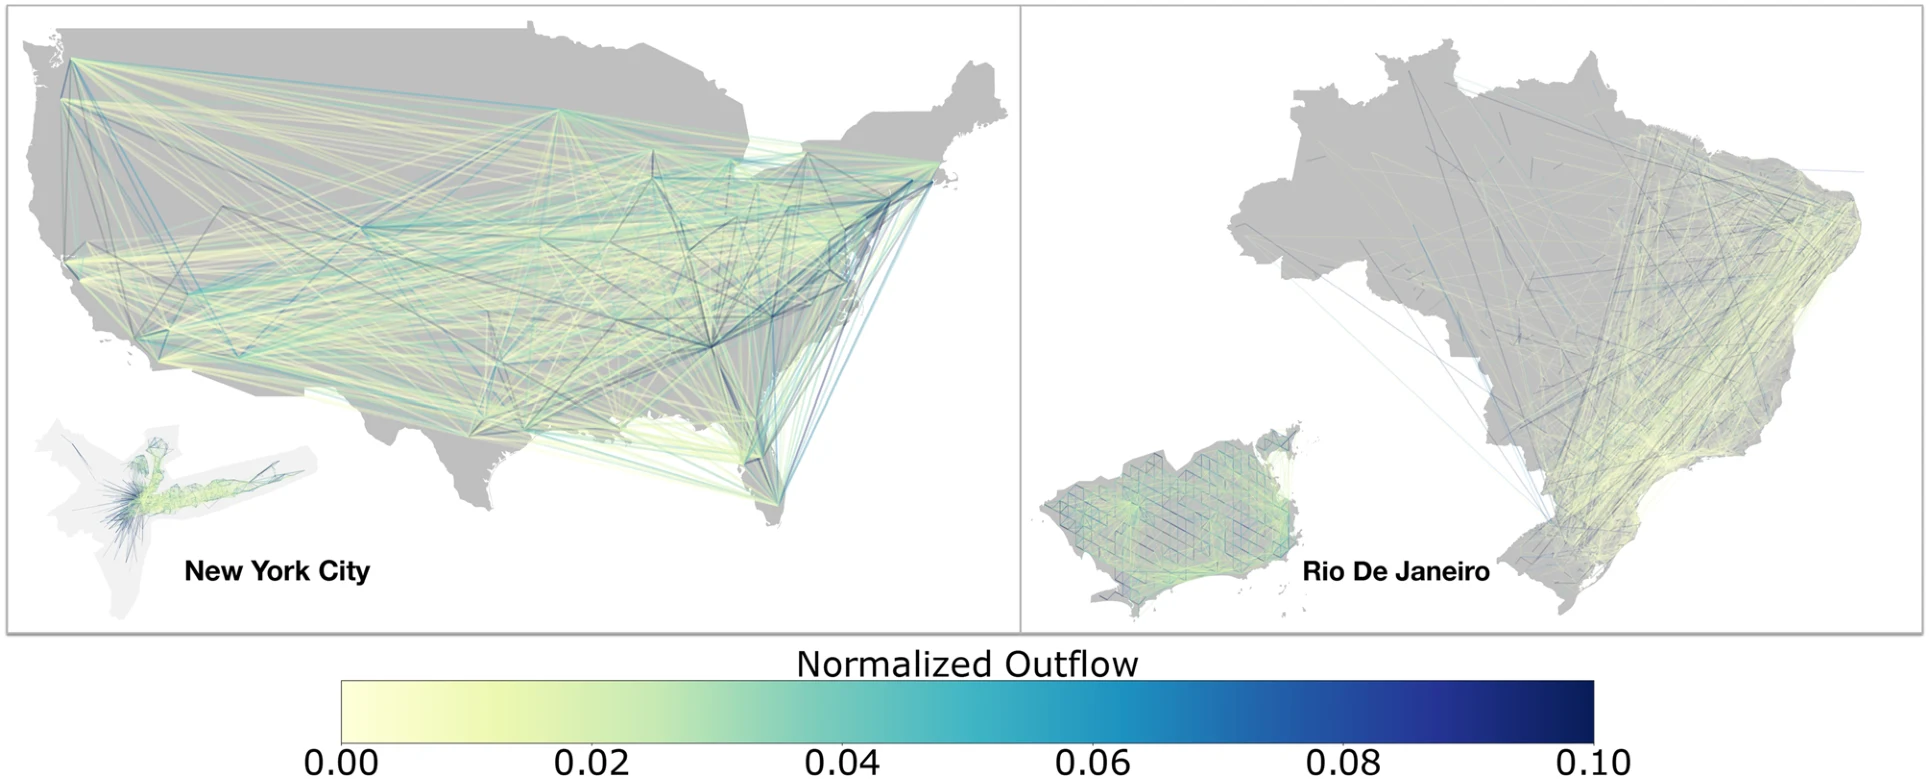
图 1|这一百座城市的流量,首先长什么样?
左图是美国城市之间的流量,插图是纽约;右图是巴西,插图是里约。线的颜色是归一化流出,色标从 0.00 到 0.10,不是出行人数。国家图的节点是城市。它说明后文用的是地点之间的汇总流量,还没有按收入分开。来源:原论文 Fig. 1。
距离和次数,各自在除什么?
远近用平均出行距离 Mdistᵢ,也就是子区 i 向外流出的加权平均长度。它要回答的是:从这里出发的那些跨区流量,平均要跨多远。
Mdistᵢ = Σⱼ (Tᵢⱼ × dᵢⱼ) / Σⱼ≠ᵢ Tᵢⱼ
Tᵢⱼ 是从 i 到 j 的年化流出,dᵢⱼ 是两个子区质心之间的测地距离,可以理解成地图上的直线距离,不是沿路里程,也不是通勤时间。分母去掉了起点等于终点的流量,所以留在本子区内部的移动不进入这个平均。
次数用人均流出 Mfreqᵢ。它要回答的是:相对这个子区的人口,向外的年化流量有多密。
Mfreqᵢ = Σⱼ Tᵢⱼ / Pᵢ
Pᵢ 是子区人口。纵轴上的 10⁰ 表示年化流出与人口数量同级,大约每人对应 1 个流量单位;10⁻² 表示大约 0.01。这是流量记录的代理,不是一份出行日记里的全部出门次数。
图 2 把每个城市内部最低和最高两个五分位的子区拿出来,再按国家画成概率密度。每一条曲线的样本是子区,不是居民个人;纵轴是密度,所以美国图上的 2 不能和巴西图上的 8 比成人数。
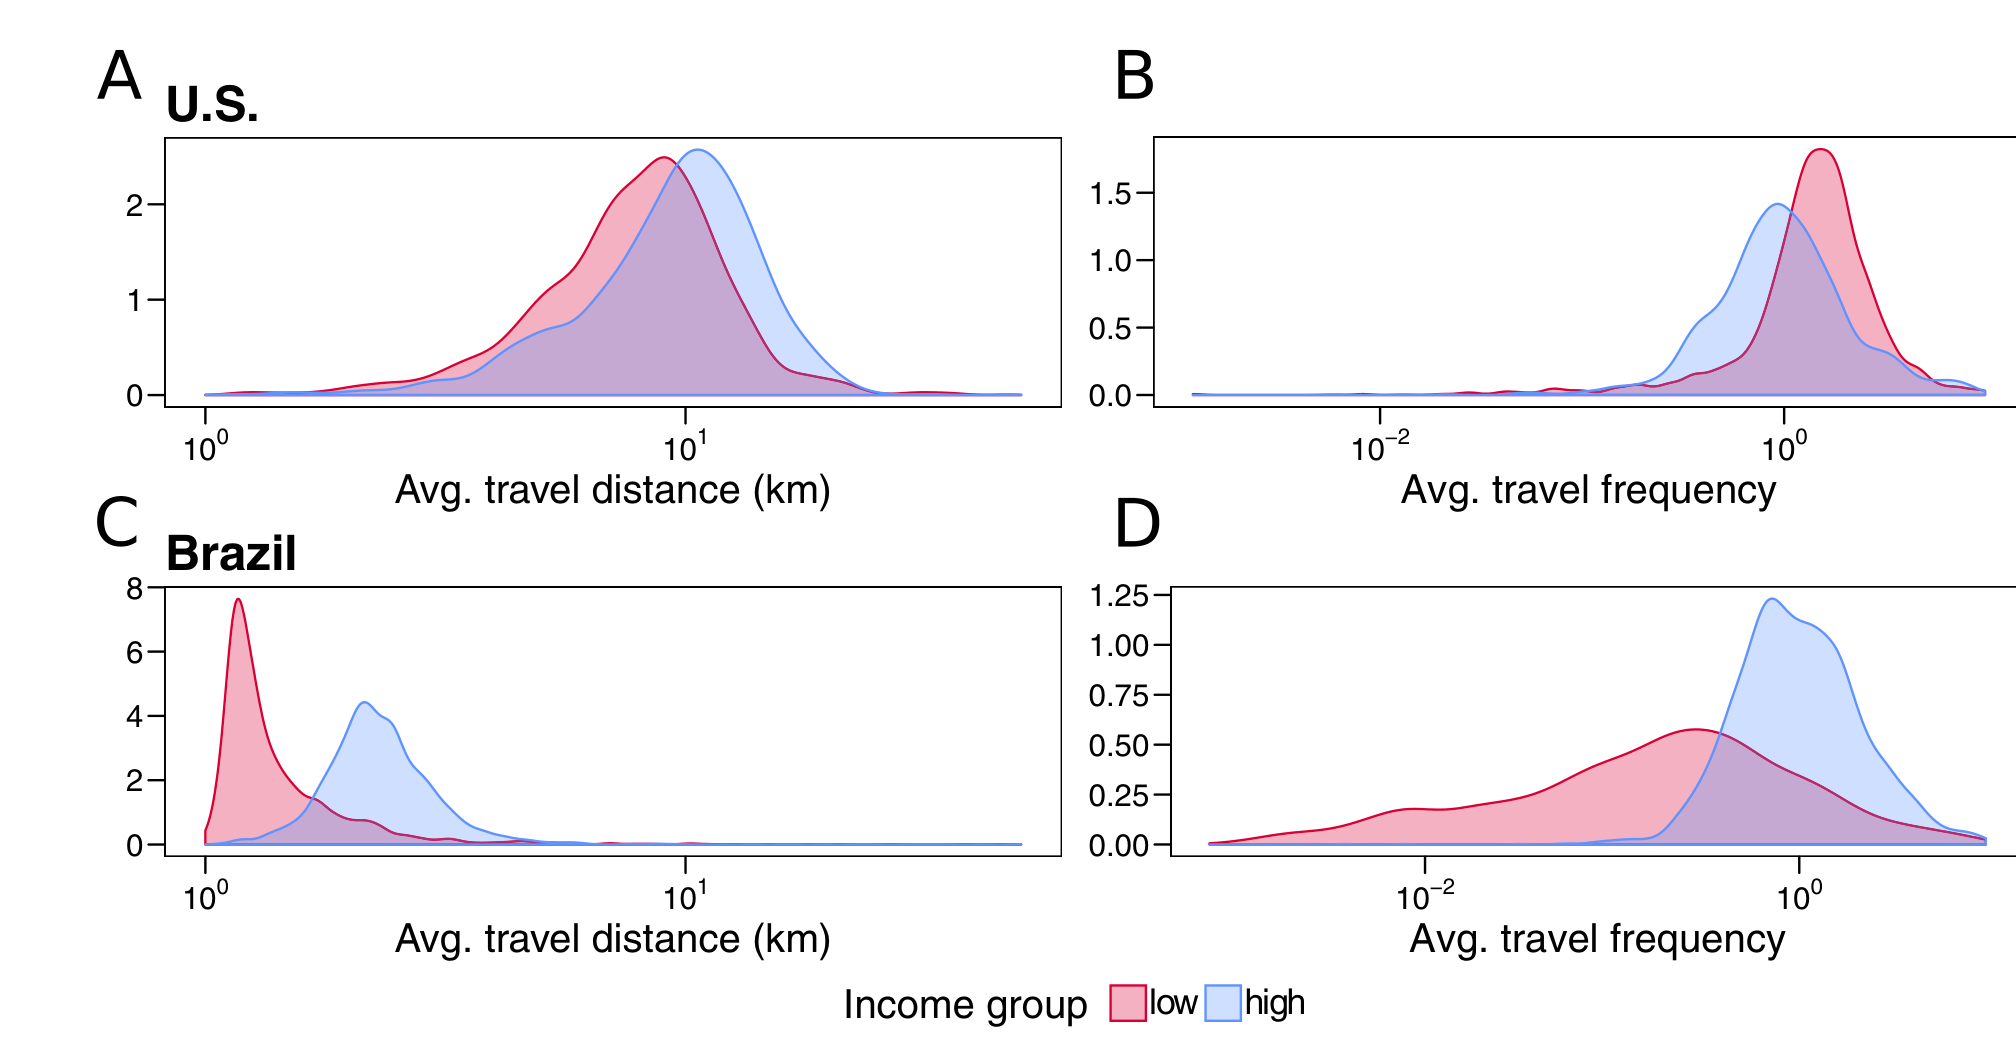
图 2|最低与最高收入子区的距离和频率,国家之间怎样不同?
红色是市内收入中位数最低的约 20% 子区,蓝色是最高的约 20% 子区。横轴为对数坐标。(A)美国平均距离,纵轴密度标到 2,横轴标出 10⁰ 和 10¹ 公里;两组大量重叠,红色略偏短。(B)美国人均流出,纵轴标到 1.5,横轴从 10⁻² 到 10⁰;红色的峰在蓝色右侧,也更高。(C)巴西平均距离,纵轴标到 8;红色集中在更短的一侧,蓝色的峰右移,分开的程度大于美国。(D)巴西人均流出,纵轴标到 1.25;蓝色的峰更高,方向与美国相反。来源:原论文 Fig. 2。
正文的概括与图一致:美国收入较低的子区通常更近、更频繁,巴西则是收入较高的子区又远又频繁,而且两组分得更开。两国的分布都很宽、重叠也大,所以国家曲线不能直接套到每一座城市。
一百座城市,是同一种相关吗?
下一步把 8 档或 9 档全部用上。对一座城市的每一个收入档,先做一条长度为 m 的向量,m 是该城市的子区数;向量里的一个位置,是该档居民落在这个子区的比例。再把这条向量与各子区的 Mdist、Mfreq 做斯皮尔曼秩相关。相关为正,表示该档居民比例更高的子区,在距离或频率上的排名也更高。它不是“收入每高一档,距离增加多少公里”,也不是个人行为的因果效应。
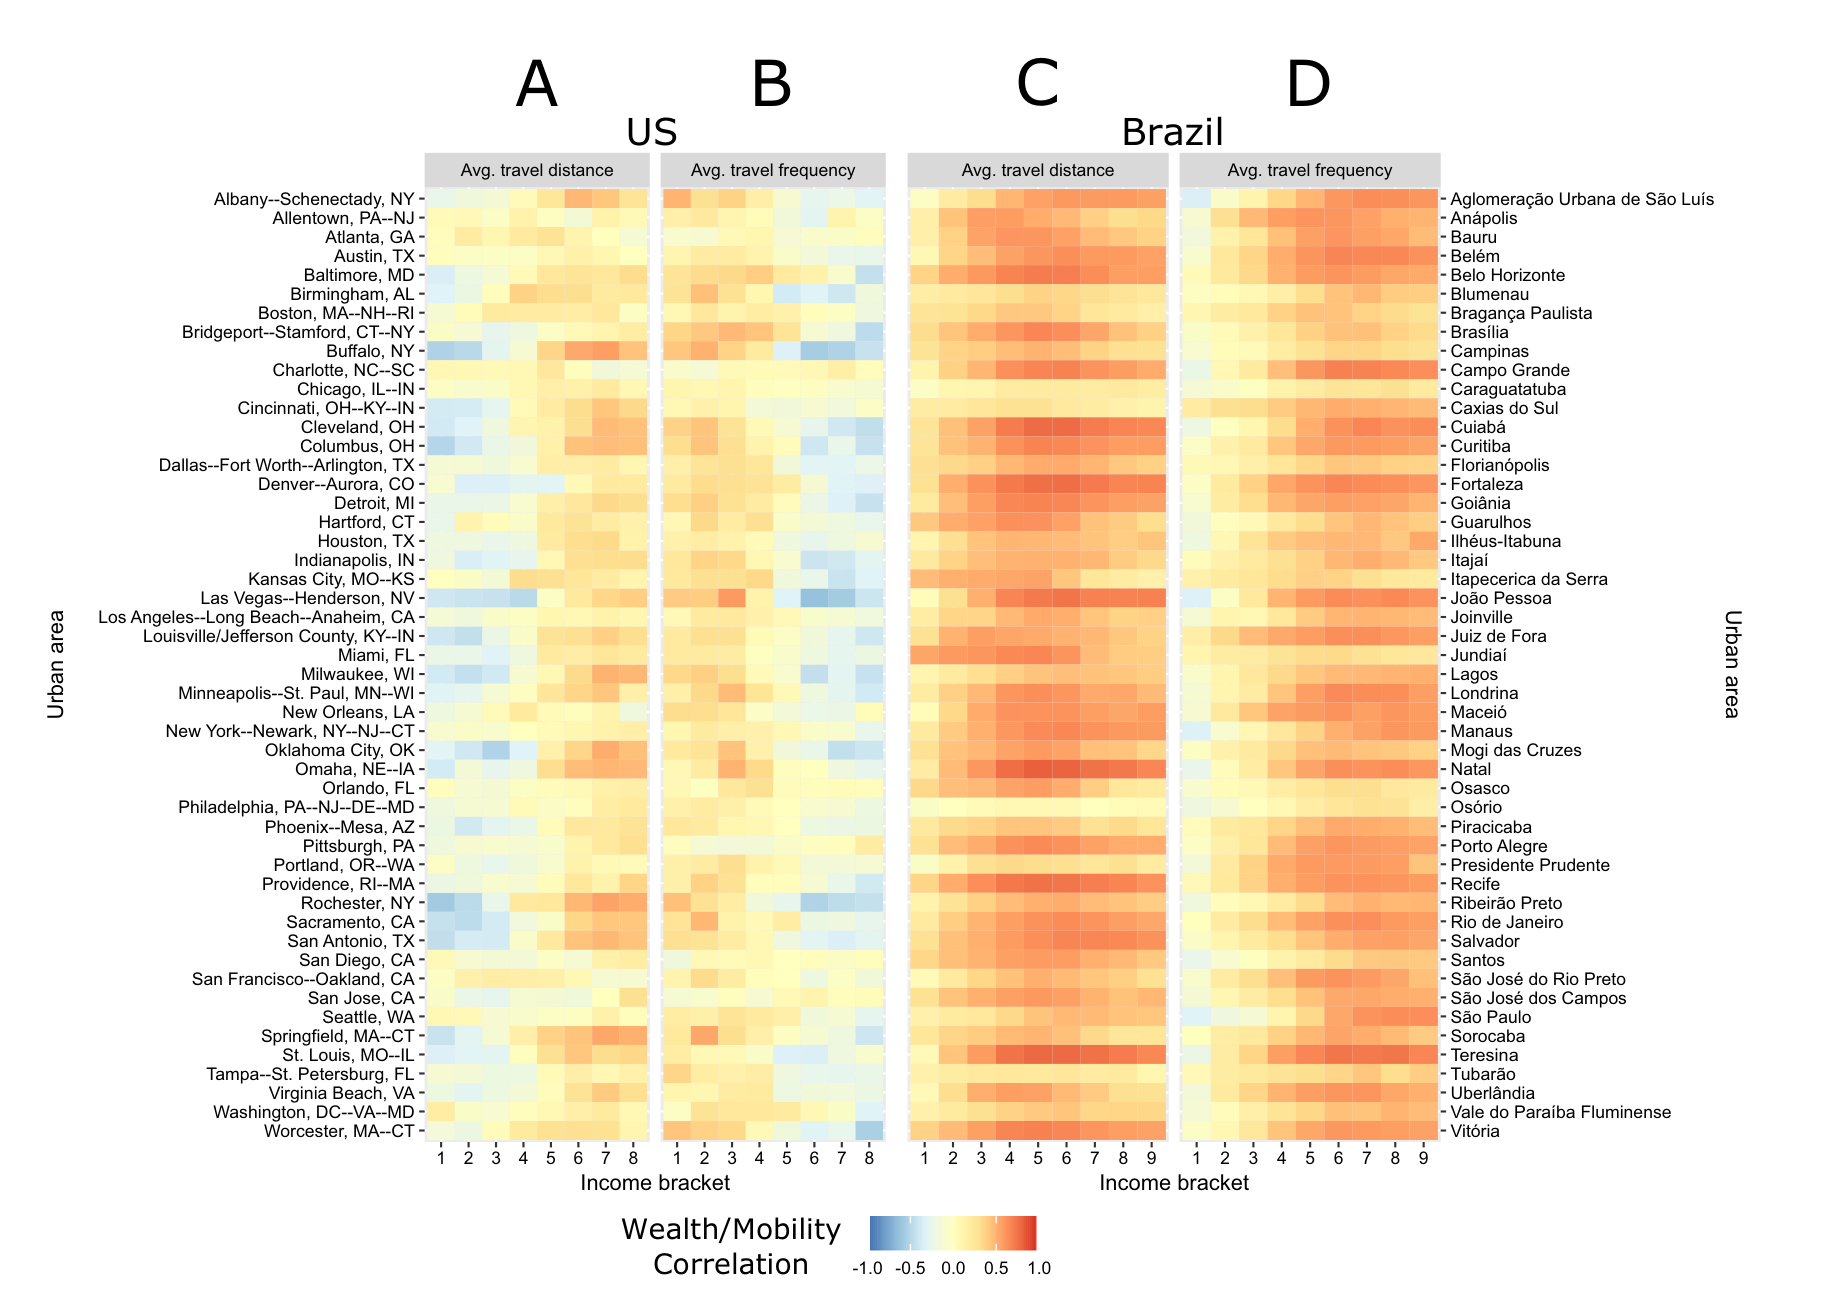
图 3|每一座城市里,收入档和出行是同向、反向,还是几乎无关?
每一行是一座城市,城市按字母排列;每一列是一个全国收入档。颜色从深蓝的 −1 到深橙的 +1。(A)美国,8 个收入档与平均距离的相关。(B)美国,同样 8 档与人均流出的相关。圣安东尼奥、萨克拉门托这类城市,低收入档与距离为负、与频率为正,高收入档方向反过来。纽约、西雅图、芝加哥、华盛顿的整行都较浅。(C)巴西 9 个收入档与距离的相关。(D)巴西 9 档与频率的相关。多数城市偏橙,中等收入档往往最深;卡希亚斯杜苏尔、坎皮纳斯、布卢梅瑙相对较浅。最低收入档在不少城市与频率反向。来源:原论文 Fig. 3。
美国因此同时存在深色城市和浅色城市。巴西则以正为主,收入越往上,距离和频率的优势越明显;最低档与频率的负相关是其中的例外,不是整张图的主色。
美国为什么能分成几乎无关和明显有关?
城市之间的相关向量用曼哈顿距离衡量,再用分裂式层次聚类分成两组。图 4 的图例把它们编号为簇 1 和簇 2;正文按颜色称为青色和橙色。对照图 4B 的曲线方向,簇 1 是相关更强的青色簇,簇 2 是更平坦的橙色簇。
人口不少于 500 万的最大七座美国城市都落在橙色簇。其余城市在两簇里大致均匀,所以人口规模本身不是这条分界的主因。正文把聚类细节放在补充部分,树状图纵轴标出 0 到 20,表示合并高度。
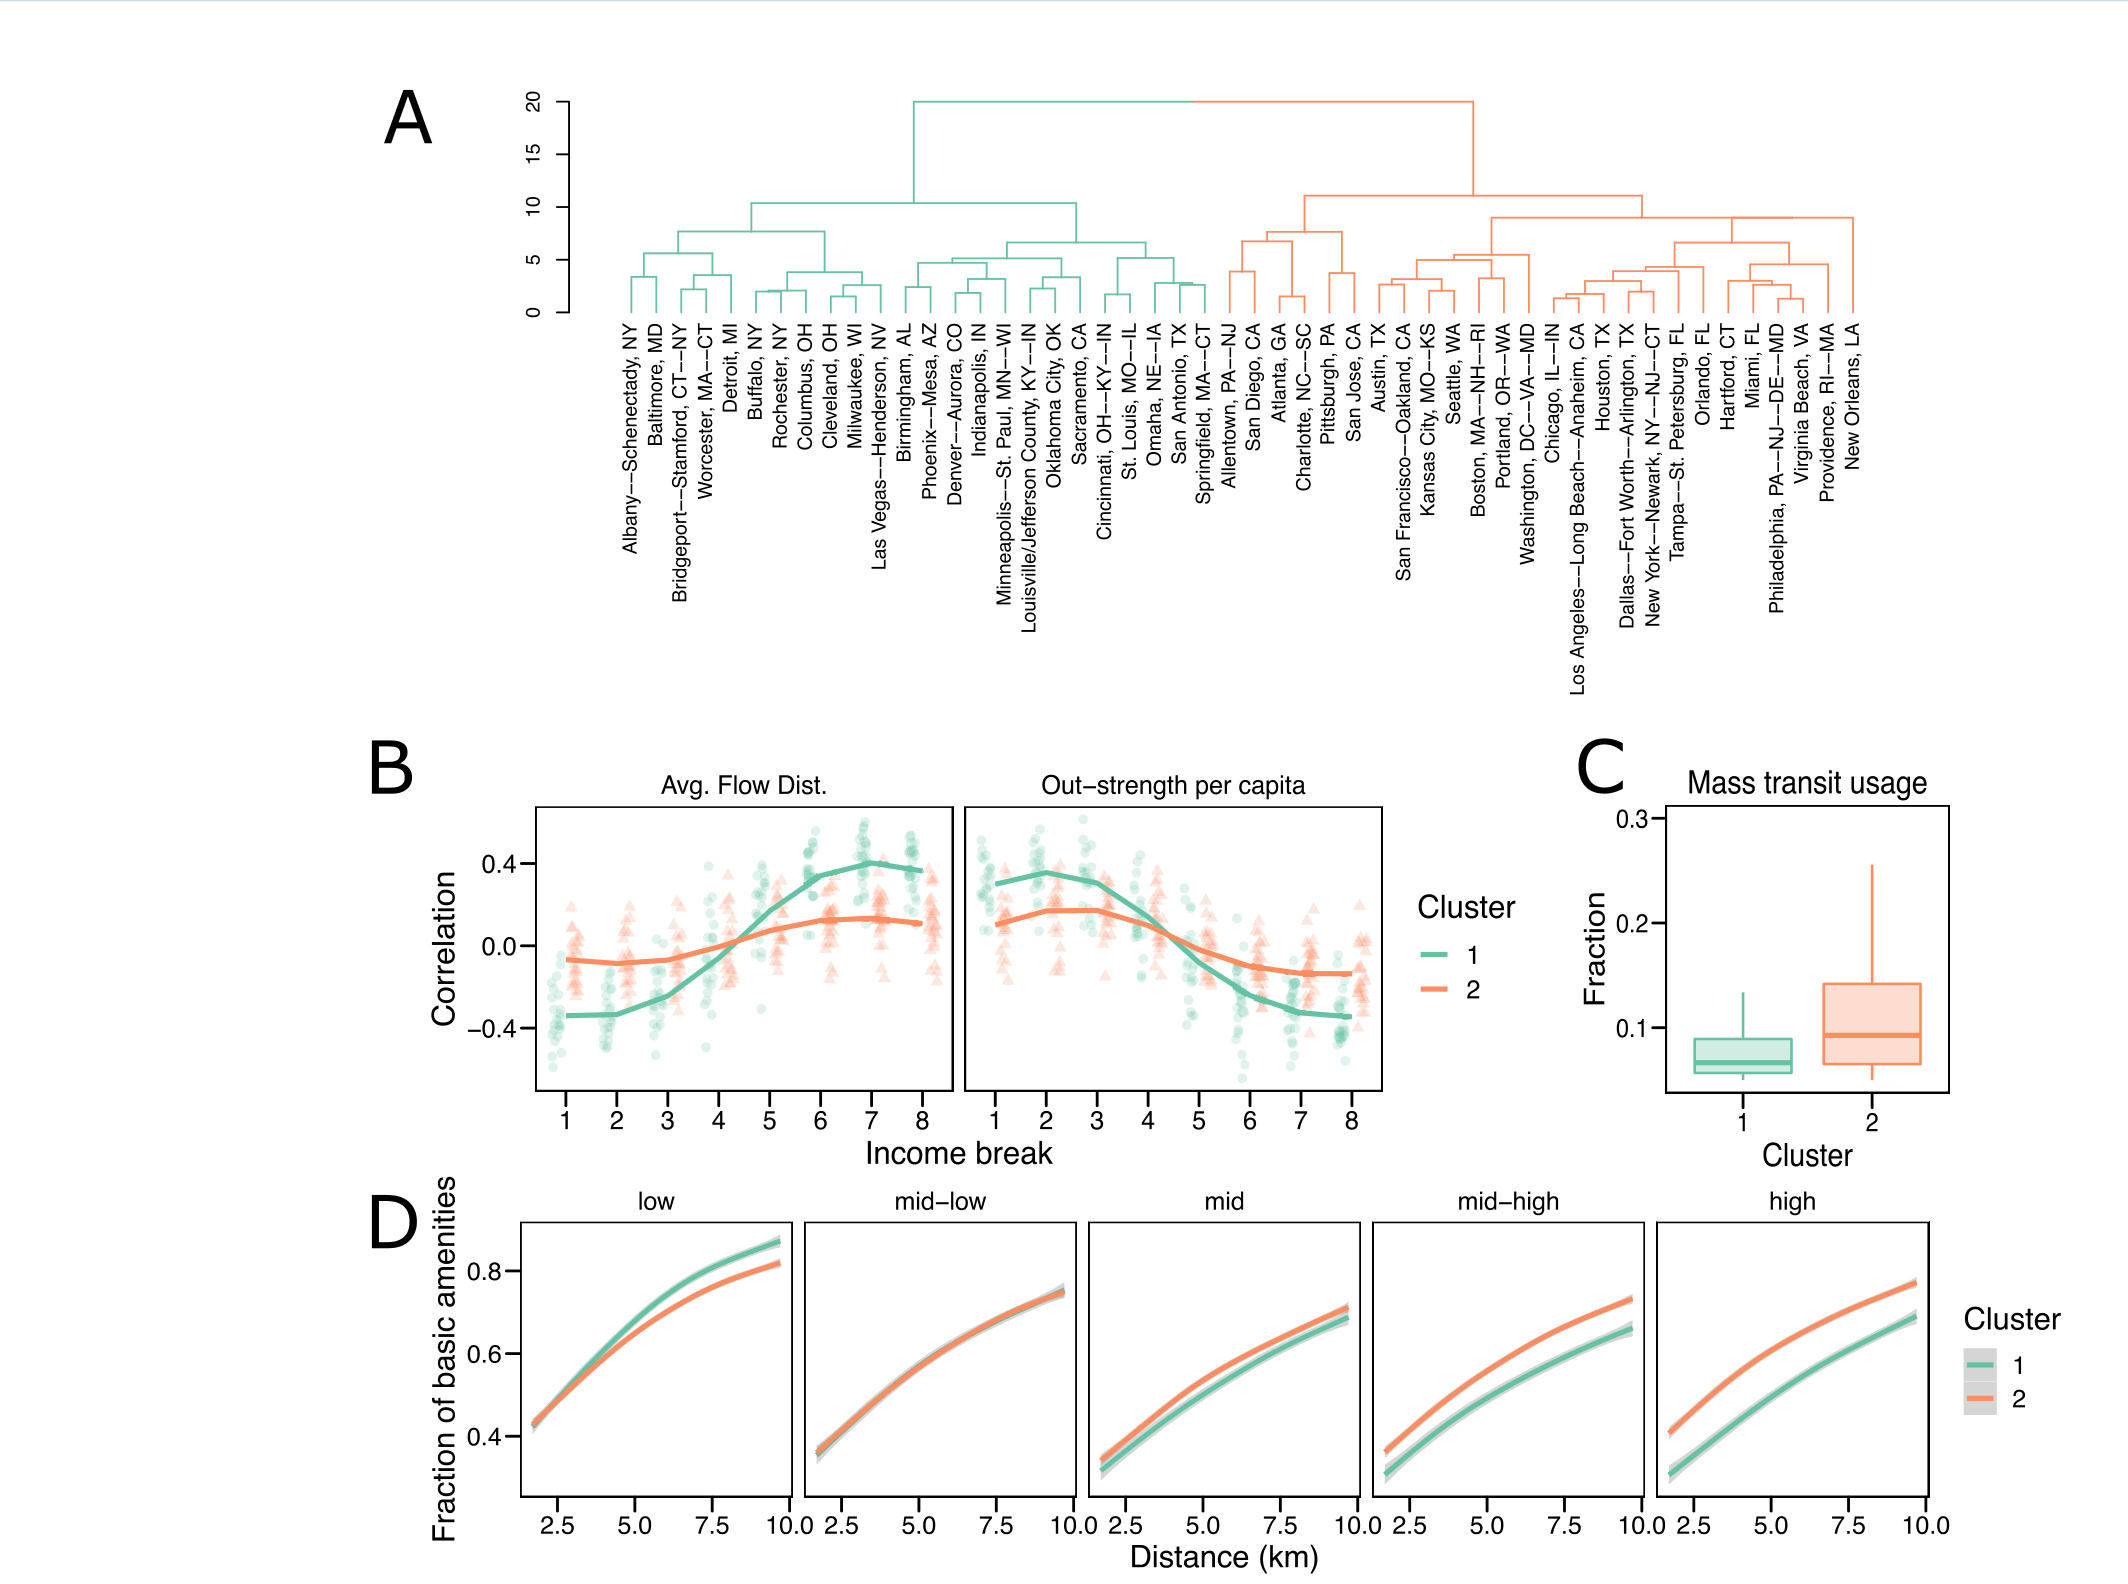
图 4|相关更强的城市,公交和基本设施有什么不同?
(A)分裂式层次聚类的树状图。左支为青色,右支为橙色;纵轴刻度 0 到 20。(B)8 个收入档上的斯皮尔曼相关,左为平均流出距离,右为人均流出。纵轴标出大约 −0.4 和 0.4。青色在低收入档距离为负、频率为正,到高收入档方向反转;橙色两条曲线更贴近 0。散点是城市,曲线是各簇的趋势。(C)使用公共交通的人口比例,数据来自人口普查。纵轴刻度为 0.1、0.2、0.3,也就是人口的 10%、20%、30%。橙色簇的盒子整体高于青色簇,须可以伸到 0.2 以上;须是簇内的极端城市,不是典型值。(D)在 10 公里范围内,食物、医疗、教育和金融这几类基本设施里,已经能够到达的比例。五个收入组来自市内五分位。低收入组两条曲线接近;收入越高,青色簇要到达同样比例,距离越长,橙色簇变化较小。来源:原论文 Fig. 4。
设施距离是子区质心到设施坐标的测地距离。它忽略子区内部的人口分布,也忽略建筑、地形和路网,所以是一个便于比较的特征距离,不是某位居民的实际路程。设施来自开放街图,库中有 691 类、8 个大类;这篇分析只用食物、医疗、教育、金融。开放街图靠自愿标绘,缺标会直接影响“附近有多少设施”。
橙色簇更高的公交比例,与作者引用的一项早先研究放在一起看:那些城市的人流更层级化、更向心,青色簇更分散。公交使用更高,既可能是居民选择,也对应这些城市确实有更密的公交设施。图 4 本身是分组后的对照,不是把公交班次随机增加之后的实验结果。
通勤表会把同一座城市分到另一边吗?
作者用美国人口普查局的就业—居住通勤数据 LODES 再做一次。它主要记录居住地和工作地之间的联系。正文报告,这套汇总流量与 LODES 在大约 10³、也就是约 1000 名通勤者以内密切相关;超过这个规模后明显分开,因为位置历史流量里还有大量非通勤。
距离的高低收入方向与图 2 定性一致。频率则几乎不再分开:一条居住—工作联系无论一年里往返多少次,在 LODES 里都只记一次。用这套只能记一次的通勤表重做聚类,与图 4 的福尔克斯—马洛斯指数为 0.847。指数越接近 1,两次分组越接近;0.847 表示大体相似,同时允许一部分城市换边。
换边是点名的。波特兰、西雅图、堪萨斯城在原分析中属于橙色,到通勤聚类里进入青色。底特律、密尔沃基、圣路易斯则从青色进入橙色。距离相关的两簇差别还在,只是没有图 4 那么分明。频率上,通勤数据里的青色簇变平,橙色簇随收入有轻微正相。公交比例的高低方向保持不变,因为公交使用很高的大都市区仍留在橙色簇。设施距离也仍是橙色簇少随收入变化、青色簇的高收入组更远。作者特别指出,把底特律和纽约分进同一簇会产生误导,后文的目的地地图会把这种差别画出来。巴西没有可比的普查通勤表,这项核对只覆盖美国。
离家更近的设施,种类也更全吗?
数量近,不表示种类全。作者用每个子区基本设施类型的熵来表示混合程度:熵更高,各类设施的分布更均匀;熵更低,子区被少数类型占据。这是种类结构的代理,正文也写明,质量很难定义,熵不能代替医院水平或食品价格。计算细节在补充部分,正文没有印出公式,所以这里只解释方向。
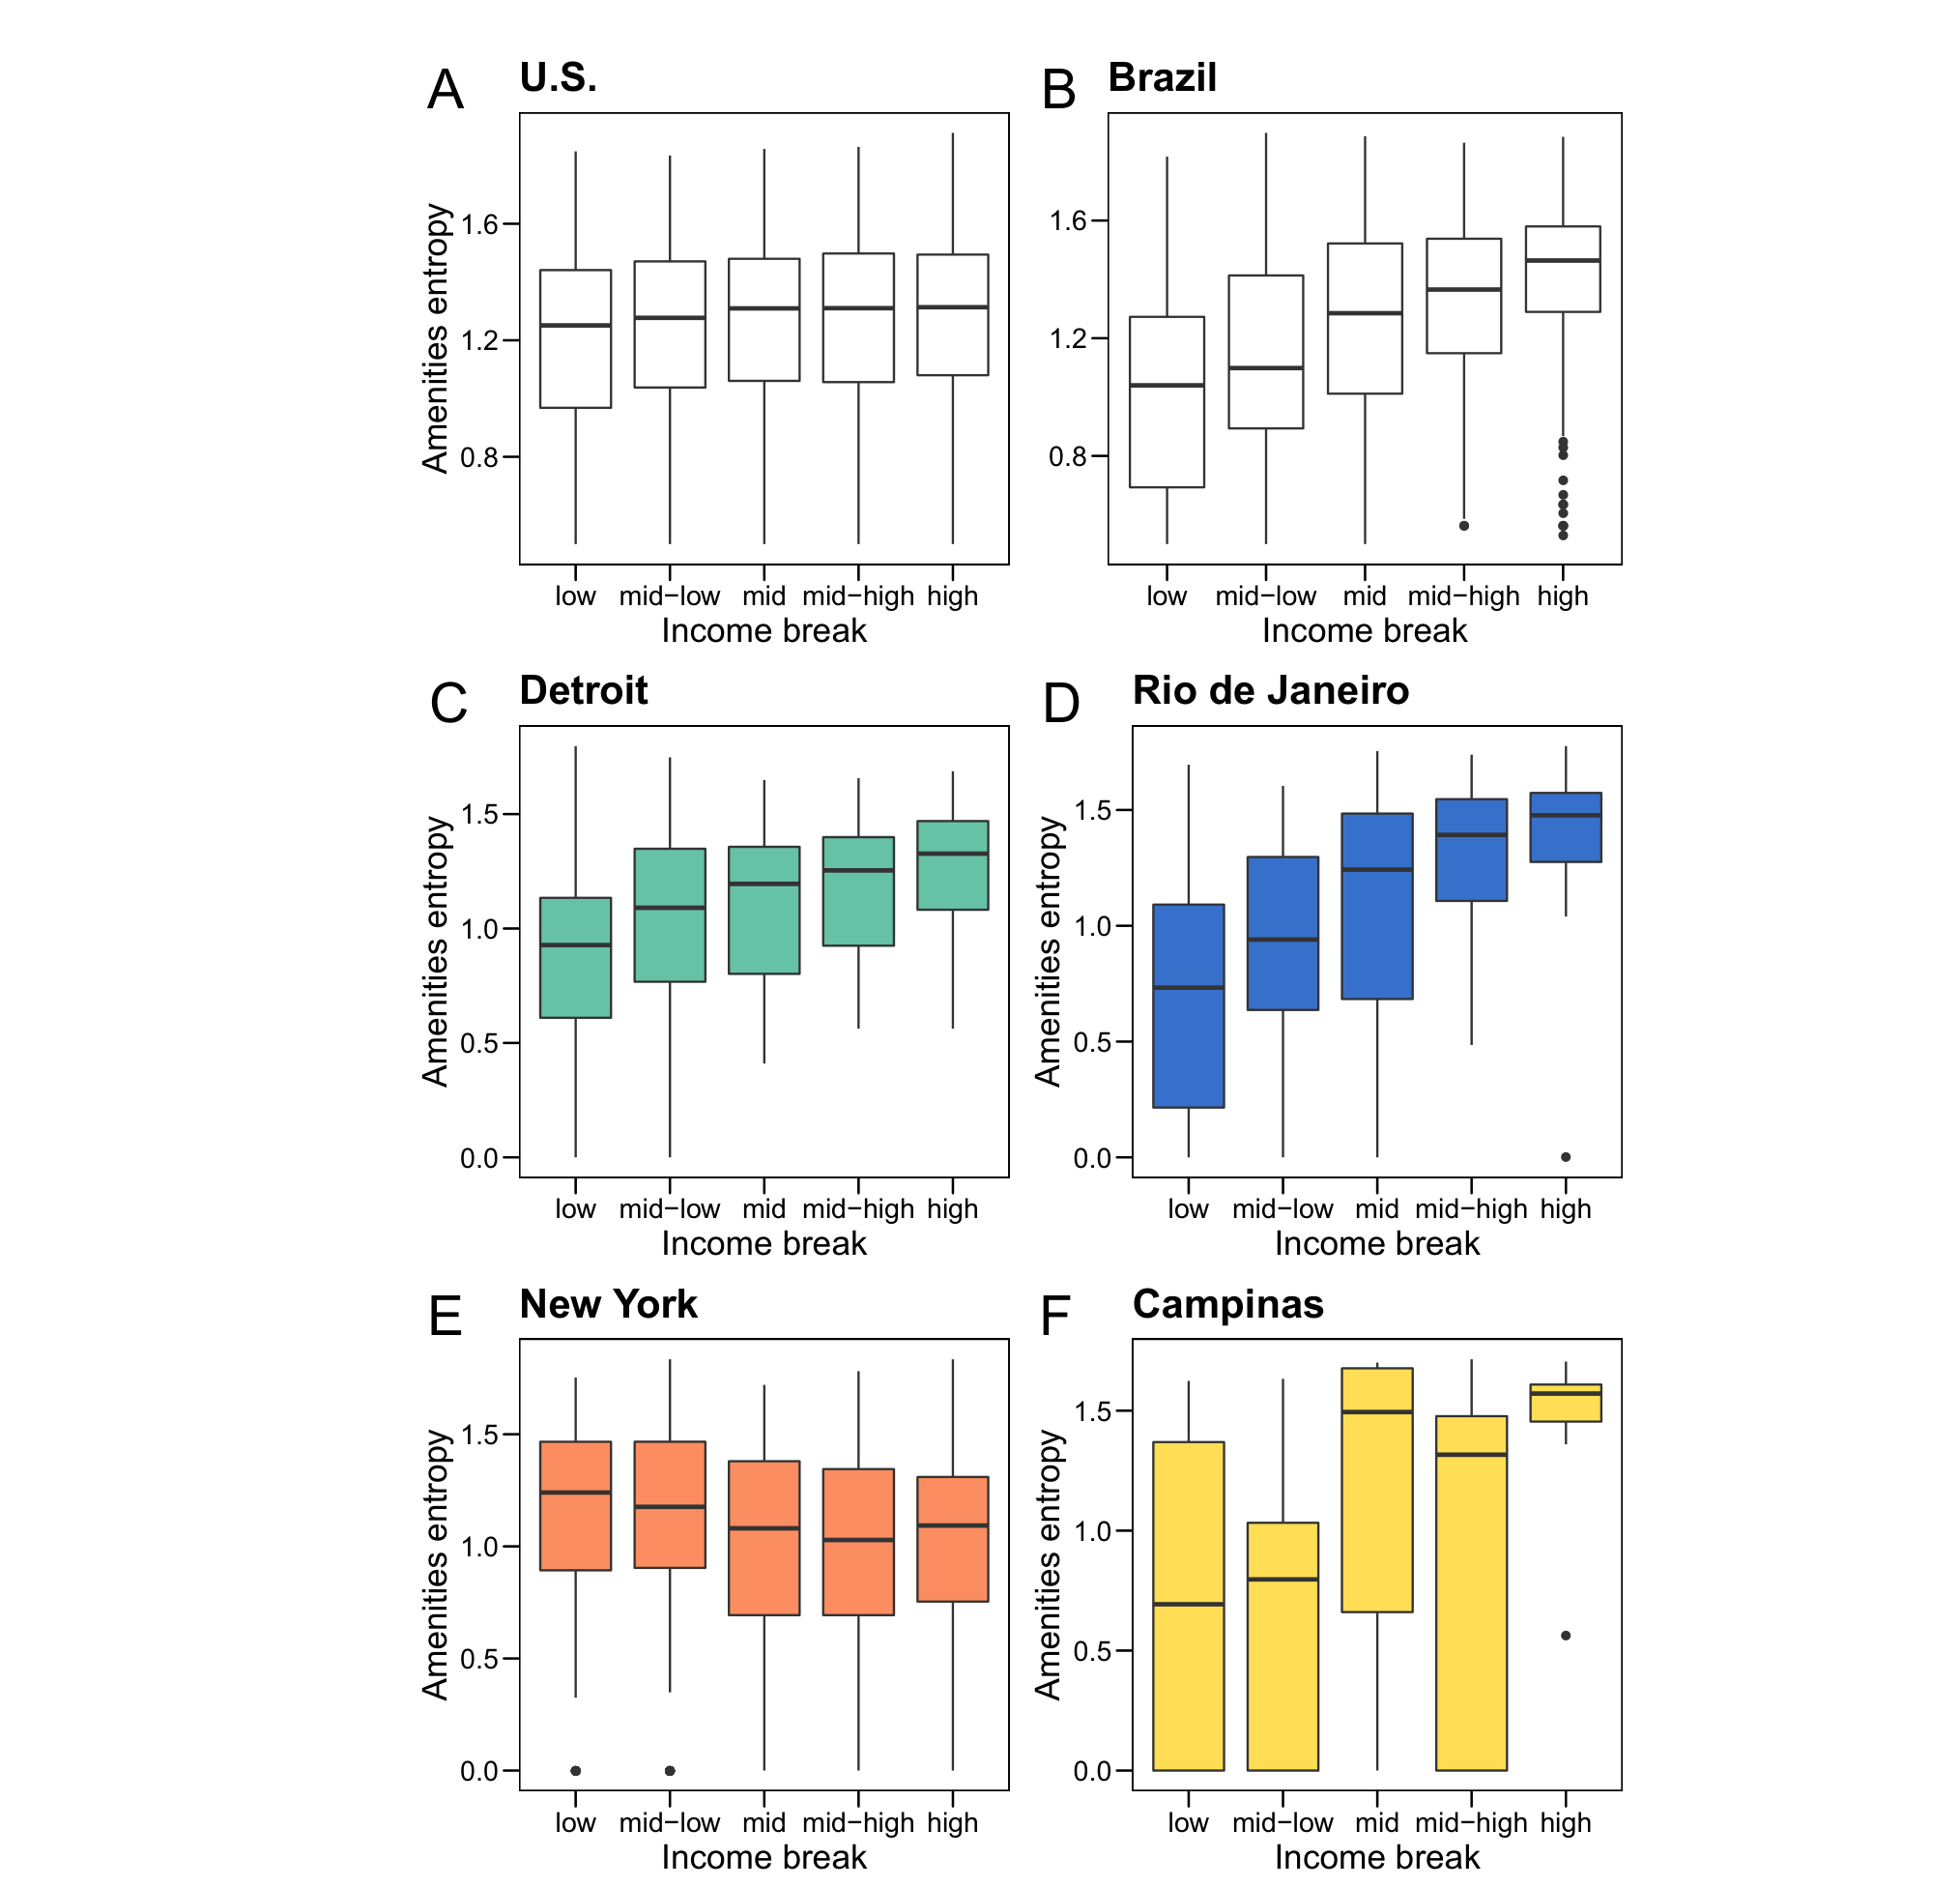
图 5|设施种类的混合程度,会不会跟着收入五分位上升?
横轴都是市内收入五分位:低、中低、中、中高、高。盒子是子区熵的分布。(A)美国全国,纵轴标出 0.8、1.2、1.6,五组的中位线接近,最低组略低。(B)巴西全国,同一纵轴标尺;从低到高整体上升,高收入组更高,并有低值离群点。(C)底特律,青色簇的例子,纵轴标出 0 到 1.5,中位线随收入上升。(D)里约,蓝色簇的例子,最低组与最高组的差距更明显。(E)纽约,橙色簇的例子,五组都较平。(F)坎皮纳斯,黄色簇的例子,中间档起伏大,最低组与最高组仍有差距。来源:原论文 Fig. 5。
底特律说明青色簇里的那句限定:低收入子区可以离更多数量的基本设施更近,种类混合仍然较低。纽约在数量距离和种类熵上都不随收入拉开。里约更接近底特律的上升形态,坎皮纳斯则是中间档不稳定、两端仍有差别。
高低收入的人流,落在城市的同一块吗?
目的地按流入的来源着色。对每个子区,回溯流入来自哪些子区,再看那些来源属于市内收入最高的 20% 子区,还是最低的 20% 子区。红色表示主要来自低收入子区,蓝色表示主要来自高收入子区,两类来源重叠的地方呈紫色。图例只标出红和蓝。
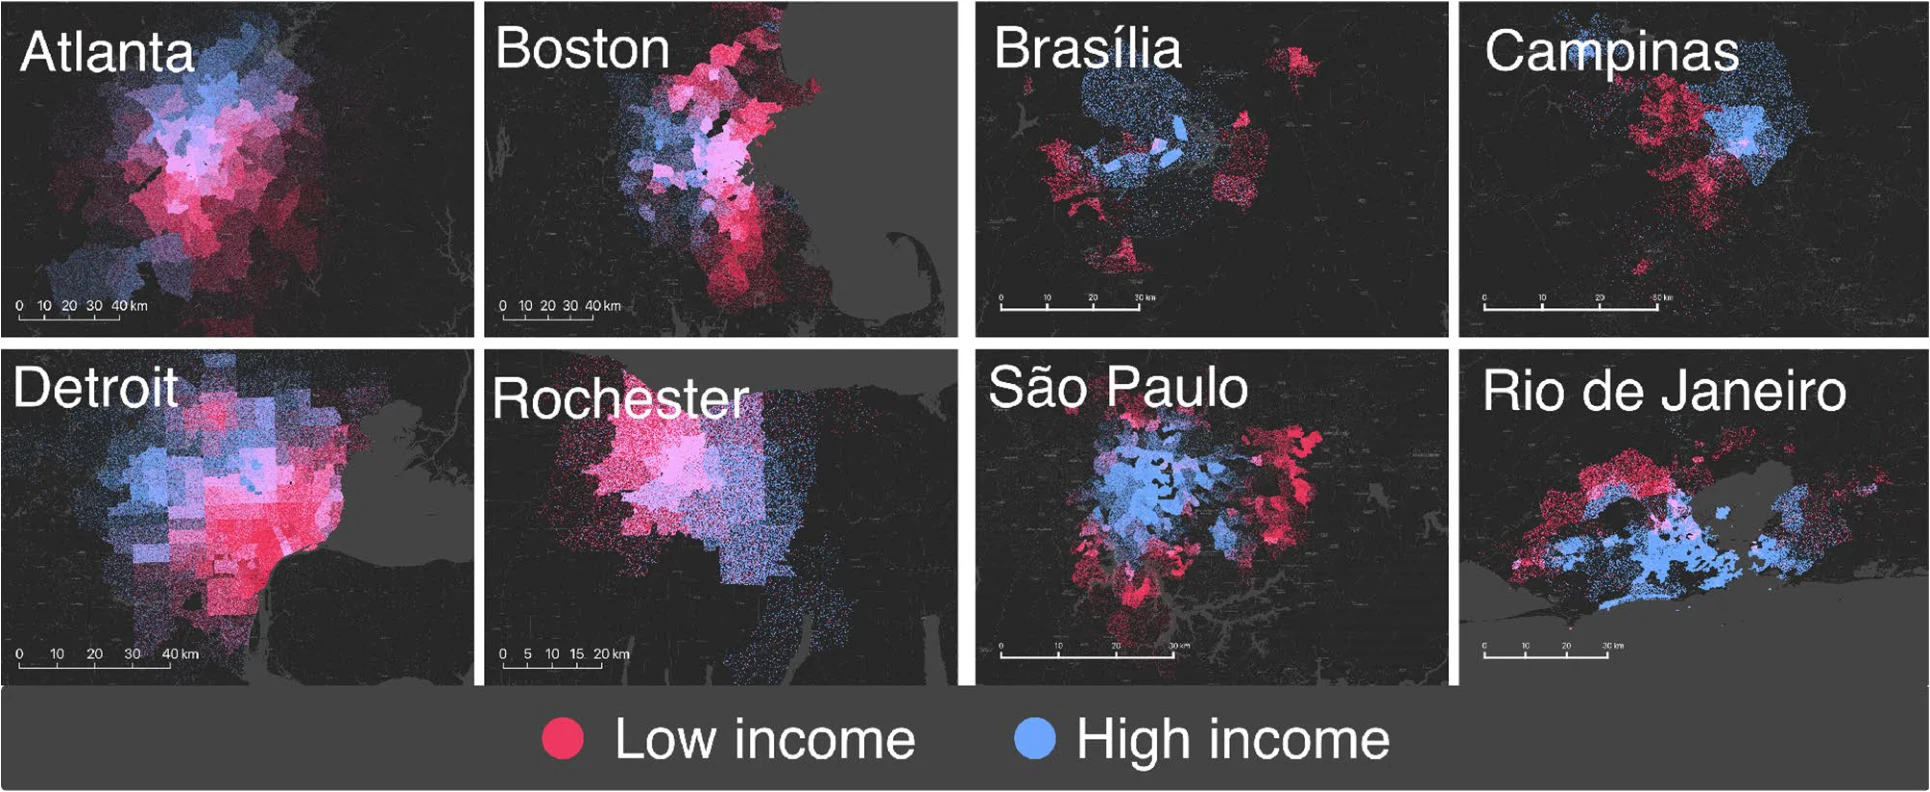
图 6|高收入和低收入子区的到访范围,有没有叠在一起?
上排从左到右是亚特兰大、波士顿、巴西利亚、坎皮纳斯,下排是底特律、罗切斯特、圣保罗、里约。各图自带比例尺,尺度并不相同。亚特兰大和波士顿属于橙色簇,市中心一带重叠较多,同时仍有各自独占的区域。底特律和罗切斯特属于青色簇,红蓝分区更清楚,低收入来源更集中于中心,高收入来源更偏向外围。右侧四座巴西城市几乎看不到成片重叠:高收入来源集中在中心,低收入来源更多留在外围。巴西利亚、坎皮纳斯属于后文的黄色簇,圣保罗、里约属于蓝色簇,两簇在这张图上的分隔同样明显。来源:原论文 Fig. 6。
到访范围和居住分布是连在一起的。作者接着计算各子区家庭收入中位数的莫兰指数 Iₘ,取值满足 −1 ≤ Iₘ ≤ 1。它衡量的是相邻子区的收入中位数像不像。接近 1,表示高收入子区彼此相邻、低收入子区也彼此相邻;接近 0,表示没有这种成团,更接近随机排列。高值的含义是同类相邻,不是富人挨着穷人。
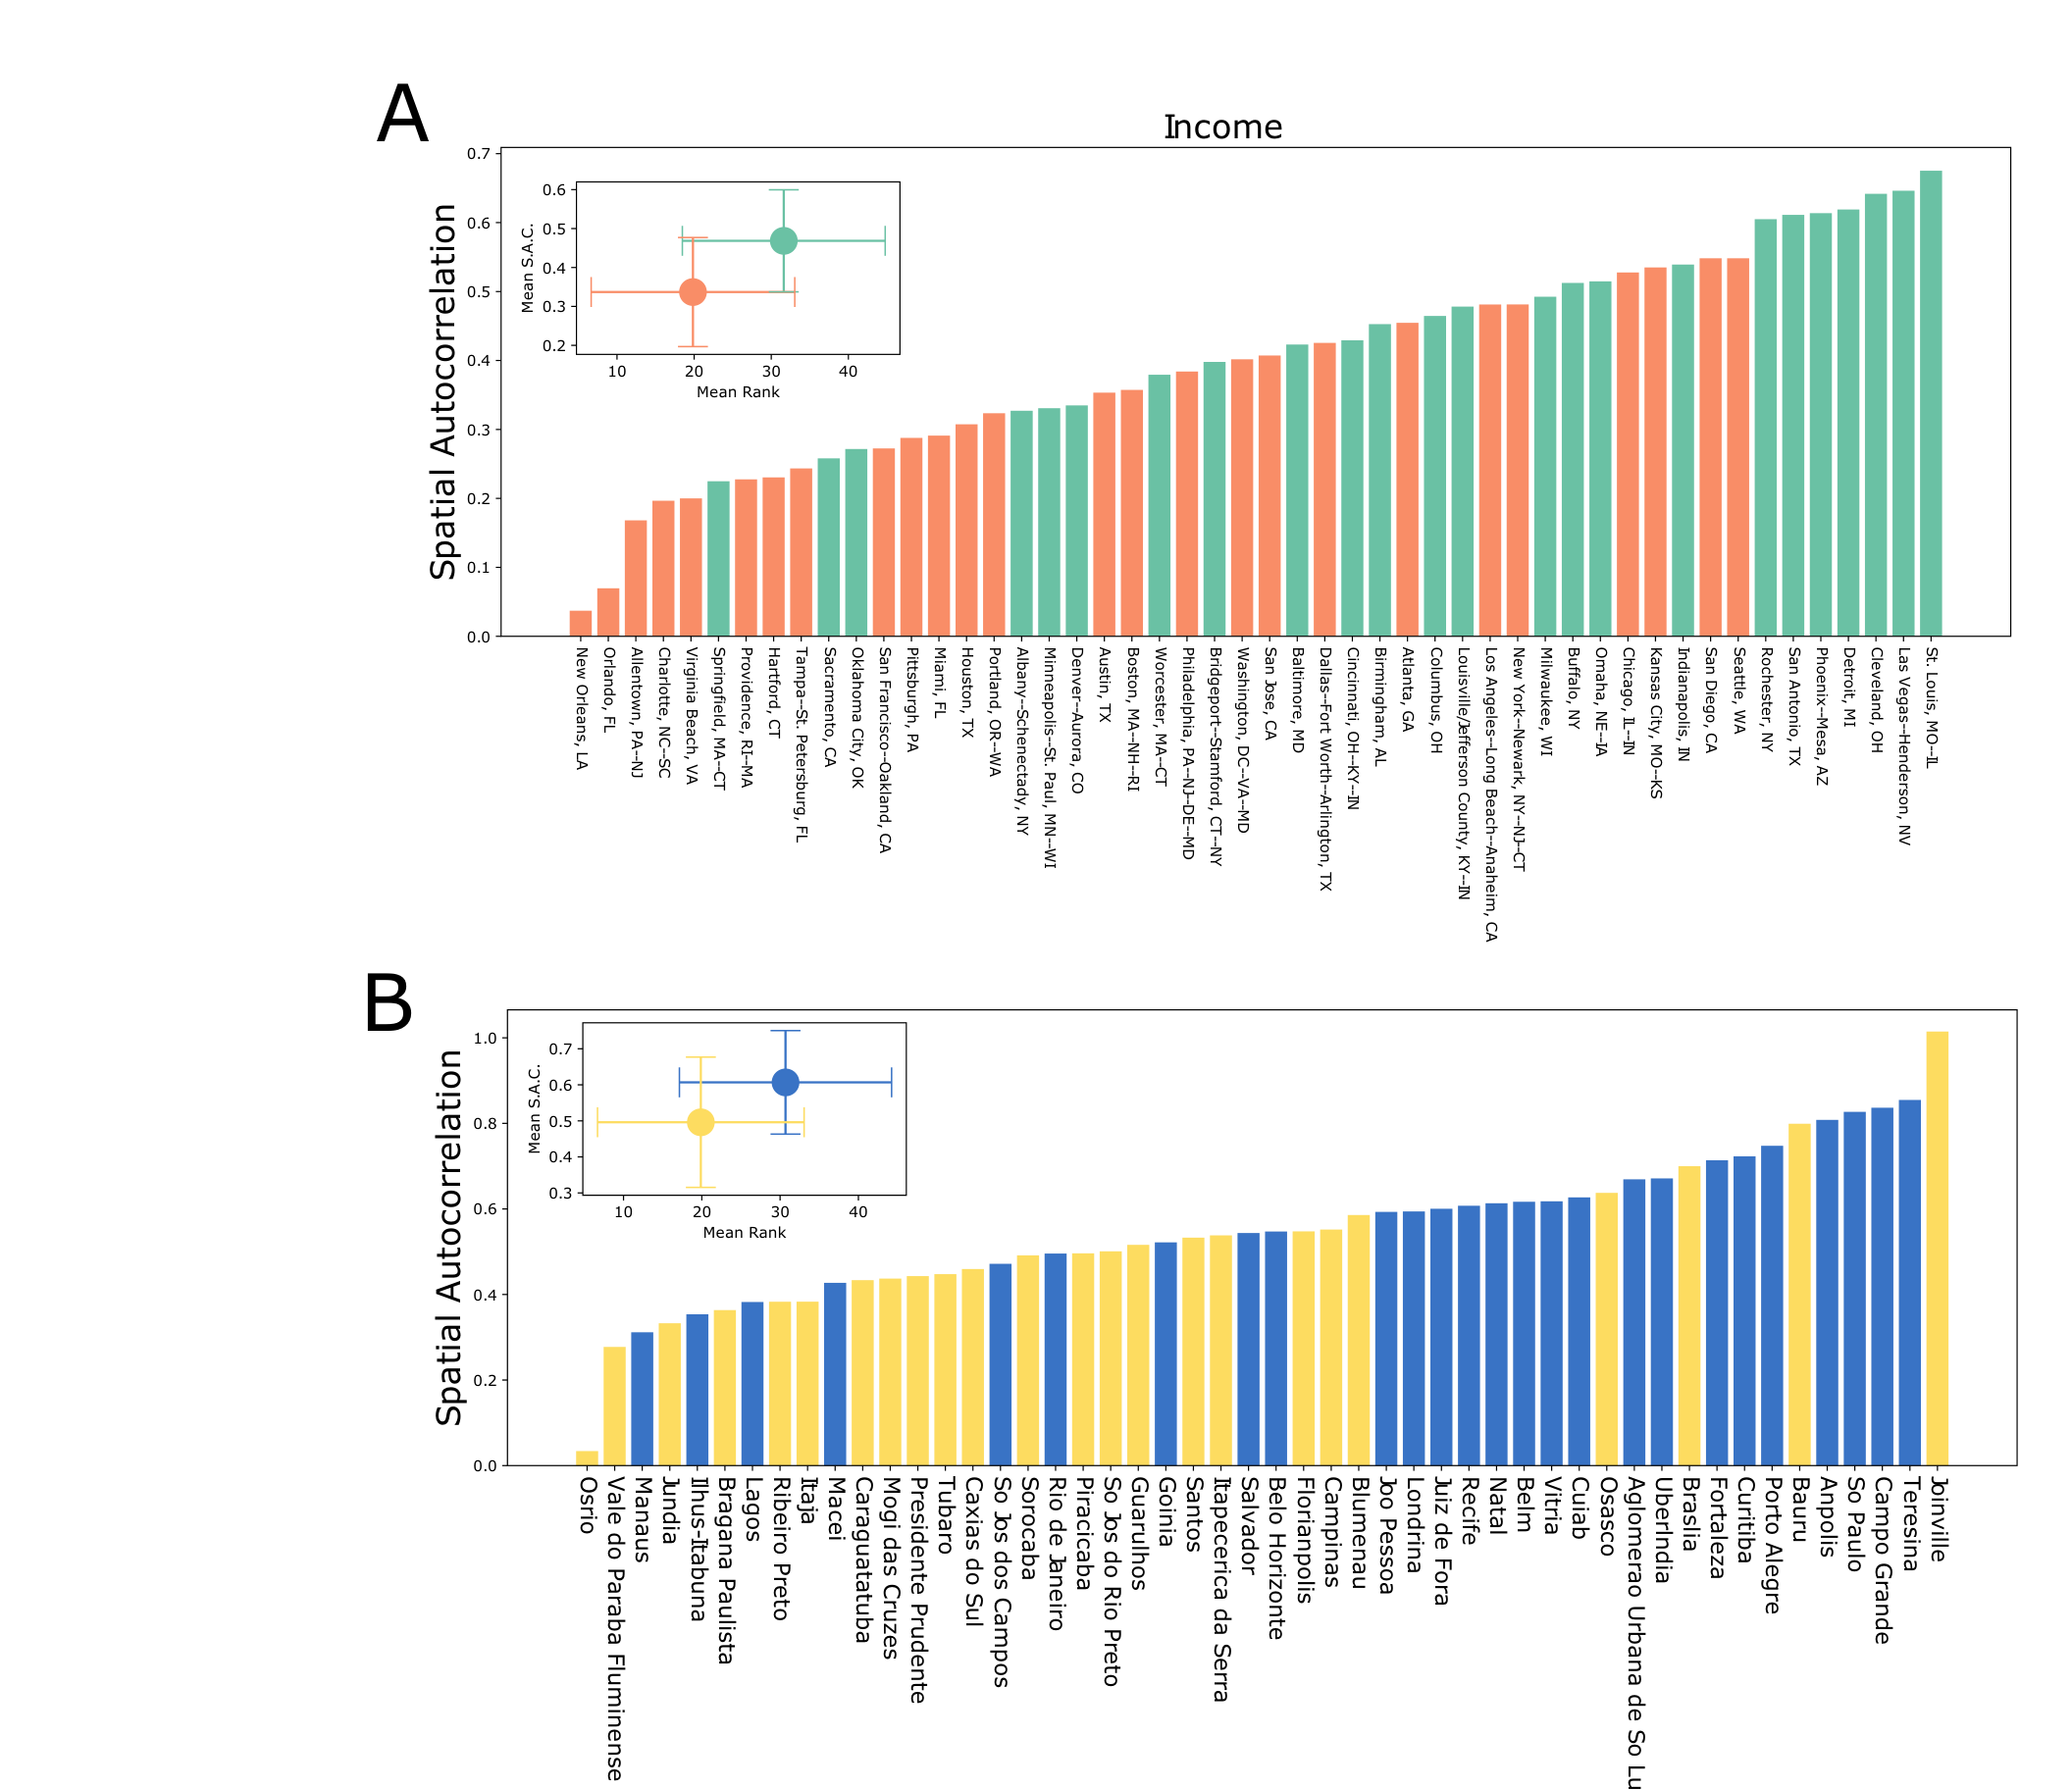
图 7|居住收入的成团程度,两簇的平均谁更高?
(A)美国 50 城,纵轴标到 0.7。最左的新奥尔良接近 0,最右的圣路易斯接近 0.7 刻度;青色和橙色在中间交错。插图的纵轴大约从 0.2 到 0.6,横轴是簇内城市的平均名次,青色点高于橙色点,并带有误差线。正文没有说明误差线是标准差还是置信区间。(B)巴西 50 城,纵轴标到 1.0。最左的奥索里奥接近 0,最右的若昂维尔接近 1.0 刻度;黄色和蓝色同样交错。插图纵轴大约从 0.3 到 0.7,蓝色点高于黄色点。来源:原论文 Fig. 7。
美国青色簇的平均莫兰指数明显高于橙色簇,巴西蓝色簇高于黄色簇。这与前面的相关、设施和到访范围方向一致,作者把它当作一种可能的形成机制。平均更高,并不表示该簇每一座城市都高于另一簇;图上的颜色交错已经说明范围有重叠。
巴西的两簇为什么都还跟着收入走?
巴西的聚类也得到大小相近的两簇,正文标成黄色和蓝色。蓝色簇几乎都是所在州最大的都市区或首府,例外是巴西城市名单里的 Lagos 和圣若泽杜斯坎普斯。黄色簇里唯一的州首府是弗洛里亚诺波利斯。
两簇都不是美国那种一强一平。相关随收入档上升,中等收入档最强,符号以正为主,幅度大于美国。黄色簇里,最低档和最高档的距离相近,但高收入子区的频率高得多。蓝色簇里,高收入子区的距离和频率都明显高于低收入子区。两簇的低收入子区本身倒比较接近。
蓝色簇的公共交通比例只是中等程度地更高,而且两簇的低收入流动仍然相似,所以公交在这里没有扮演美国橙色簇那种拉平角色。基本设施的可达比例在两簇都偏向高收入,高收入子区走更短的距离就能覆盖更多设施;蓝色簇里,高收入的这项优势更大。就“收入和出行绑在一起”而言,巴西的城市更接近美国青色簇,而且高收入在距离和频率上同时占优。
这些图案不能直接当成因果
相关、聚类和空间自相关都发生在子区的群体统计上。一个子区的中位数不能还原成里面每一个人的收入,跨子区的平均距离也不包含留在子区内部的移动。质心直线距离忽略了路网和子区内部的人口分布。
位置历史只包括选择打开该设置的智能手机用户,代表性会随地点变化;差分隐私聚合会抹去细部。开放街图的设施可能漏标。巴西收入是 2010 年普查,流量是 2016 年。通勤核对表明,换一种只记录居住—工作、且每条联系只计一次的数据,一部分城市会换簇,频率差异也会变弱。
作者在讨论里把公交、设施质量和混合收入住区当作可能缓解差距的方向,并提到纽约、波士顿、芝加哥尝试过混合收入住区,这三座城市恰好都在橙色簇。这是与结果相容的政策设想。论文同时写明,因果机制难以拆开,公交能起到多大作用也会因地区而不同。正文还指出收入与种族指标存在联系,因此美国的收入成团也带有种族居住分隔的含义;正文没有给出这组相关系数。
一句话总结
收入更高的地方并没有统一地走得更远:美国有一批城市几乎看不出收入档与跨区远近、次数的稳定相关,另一批则是低收入子区更近、更频繁;巴西更常见的是收入越高,流出越远,也越频繁。
核心来源
- Scientific Reports 正式发表页面,题目、作者、卷期 11:8616、DOI 与收稿、接收日期均以该版本为准。正文图为 Fig. 1 至 Fig. 7。
- 论文引用的早先城市层级研究:Bassolas 等,Hierarchical organization of urban mobility and its connection with city livability,Nature Communications,2019。橙色簇更向心的说法来自这项已发表研究,不是图 4 单独证明的因果。
- 美国社区调查 2016 年五年期、巴西 2010 年人口普查、开放街图,以及美国 LODES 通勤表,是论文写明的对照数据。
作者介绍
分工以论文末尾的作者贡献说明为准,机构以 2021 年署名机构为准。
- Hugo Barbosa:署名英国埃克塞特大学计算机科学系。与 Ghoshal、Hazarie 一起设计研究,并与 Hazarie、Dickinson 做统计分析。论文引用的《人类移动性:模型与应用》(Physics Reports,2018)亦以他为第一作者。
- Surendra Hazarie:署名罗切斯特大学物理与天文学系。参与研究设计与统计分析。
- Brian Dickinson:署名罗切斯特大学计算机科学系。参与统计分析。
- Aleix Bassolas:署名伦敦玛丽女王大学数学科学学院。参与结果分析,也是上文 2019 年城市人流层级论文的第一作者。
- Adam Frank:署名罗切斯特大学物理与天文学系。参与结果分析。
- Henry Kautz:署名罗切斯特大学计算机科学系。参与结果分析。
- Adam Sadilek:署名 Google(加利福尼亚州山景城)。参与结果分析。
- José J. Ramasco:署名帕尔马的跨学科物理与复杂系统研究所。参与结果分析。
- Gourab Ghoshal:署名罗切斯特大学物理与天文学系、计算机科学系,通讯作者。参与研究设计与结果分析。论文写明全体作者共同撰写文稿,并声明没有利益冲突。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市只缩短长距离出行,美国青色簇的格局未必会跟着变平。那里的低收入子区已经更近、更频繁,底特律还显示出种类熵更低。要分开的是两件事:附近设施的种类是否变全,以及人是否因此减少被迫的短途、增加可选择的长途。只看平均距离下降,无法回答哪一件发生了。
巴西的图案更提醒指标本身会选边。高收入子区离更多基本设施更近,同时流出更远、更频繁。把“距离长”单独当成出行负担,会把选择更多的群体标成负担更重。一个同时报告距离、频率和设施熵的城市比较,至少能让这三项各说各的方向。
另一个尚未在本文尺度上闭合的问题是区划大小。莫兰指数用的是子区中位数,相邻子区可以都很混合、中位数却仍然不同,也可以一个子区内部已经隔开、对外只呈现一个数。把同一套相关和聚类换到更小的普查单元,流量矩阵和收入向量会一起改变;若青橙分界和巴西的正相都还在,才更有理由说它不只是 ZCTA 或加权区画出来的。