活动范围更大,就等于每周路程更长吗?
论文名片|V. Frias-Martinez、J. Virseda、E. Frias-Martinez,Socio-Economic Levels and Human Mobility。首页与文末未印期刊、卷期或 DOI。稿件文件日期为 2010年10月15日。三位作者署名马德里 Telefonica Research 的数据挖掘与用户建模组(Data Mining and User Modeling Group)。这是一项基站尺度的观察研究:用手机通话记录描述人类移动性(human mobility),再与入户调查的区域社会经济水平做线性相关。这里的移动是城市里随通话暴露出来的空间活动,不是搬家。
同一座城里,有的居住区在入户调查里被标得更高,有的更低。若只看一个人一周里出现过的基站,社会经济水平更高的地区,居民平均活动的那一片地图更大。若改看相邻通话之间基站拉开了多远,这条差距就没有同样清楚。
论文要分开的就是这两件事:活动范围,以及由通话位置累加出来的路程。数据来自一座没有点名的拉丁美洲主要城市,2010年2月至7月。方向性结论是:在基站这个群体尺度上,社会经济水平越高,居住者平均用到的基站越多,回转半径和活动范围直径也越大;通话之间的路程、总路程和通话期间的路程,没有达到作者事先写下的相关标准。范围变大,并不自动等于每周路程更长。
先说结论
- 相关系数在 1,000 个基站上计算。每个点是该基站居住用户的移动平均,不是接近 50 万名用户一人一个点。
- 每周不同基站数、回转半径、活动影响范围直径与社会经济水平的皮尔逊相关系数为 0.58、0.54、0.53。六个系数的 p 值都小于 0.01。
- 通话之间路程、总路程、通话期间路程的相关系数为 0.39、0.37 和 −0.11。作者只把绝对值达到 0.5 的结果留下做直线拟合。
- 拟合直线把没有观测到的 E 级外推为回转半径 3.8 公里、影响范围直径 13 公里,把 A 级外推为约 15 公里和 46 公里。散点主要堆在 C 和 D。
- 60% 的通话开始和结束于同一座基站。这个 60% 的分母是通话次数,不是人数。
同一座基站上的人,被平均成一个点
通话详单(call detail record,CDR)在手机拨出、接听或使用短信、彩信时生成。本文使用加密后的主叫号码、被叫号码、时间、通话时长,以及通话开始和结束时所连的基站(base transceiver station,BTS)。基站只说明人当时落在哪一座塔的覆盖里,不知道人在覆盖区内部的精确位置。
记录覆盖这座城市的 6 个月。城市因社会经济水平差异较大而被选中,国名和城市名都没有写出。只保留平均每天通话两次的用户,用来去掉信息太少、不足以刻画移动的人。筛选后接近 50 万用户;筛选前的总人数没有给出。全城由 1,000 座基站覆盖。作者写道,密集市区一座基站的覆盖可以小于 1 平方公里,乡村可以大于 3 平方公里。分析时假定各基站覆盖互不重叠,并用泰森多边形(Voronoi diagram)划分边界。真实信号区会重叠,这是简化。
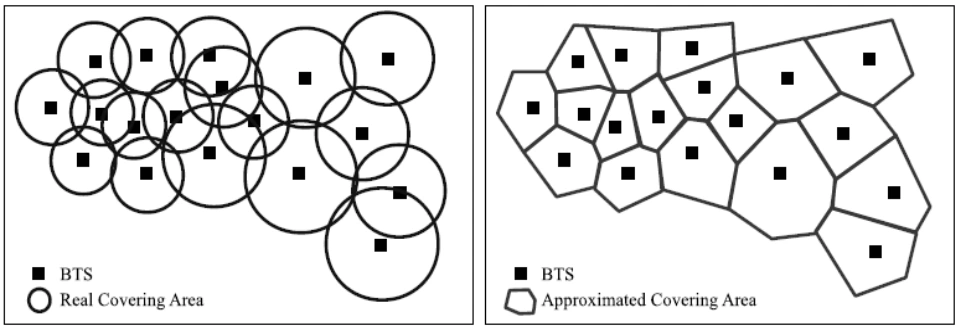
图 1|真实覆盖重叠时,分析用的边界是什么?
(左)黑点为基站,圆圈为真实覆盖,圆与圆相互重叠。(右)同一批基站被划成互不重叠的多边形,作为后文的小区。两幅都是示意图,不是这座城市的地图。来源:原论文 Fig. 1。
每个人的移动先按周计算,再对居住地被定在同一基站的用户取平均。相关分析的一个观测就是这样一座基站。半年里的各周如何收成这一个周平均,论文没有再拆开。因此后文的公里和基站数,都是基站上的群体平均。
签约用户的居住地是已知的。论文说,在新兴经济体,签约用户不到总人口的 10%。预付费用户的居住基站改由通话模式算法指定,步骤写在作者引用的另一篇 ICTD 2010 论文里,本文没有展开。不能把这个 10% 乘上 50 万,当成本市样本里的签约人数。
范围、半径和路程,量的不是同一件事
六个变量都是周平均,但回答的问题不同。
通话之间的路程,是前一次通话结束的基站,到下一次通话开始的基站,两座塔坐标之间的距离。它被用来近似用户走过的路,却不是沿街里程,也不是小区内部的位移。
通话期间的路程,是同一次通话开始基站到结束基站的距离。60% 的通话起止在同一座基站,这段距离就是 0。
总路程把相邻通话、短信或彩信之间的塔间距离,与每次通话期间的距离加在一起。
活动影响范围的直径(diameter of the area of influence),是这一周用过的所有基站里,相距最远的两座之间的公里数。每座基站在这里权重相同,不管通话多少。
回转半径(radius of gyration)仍看这些基站,但通话更多的位置权重大。先求各位置的质心,再计算位置到质心距离的均方根。Gonzalez、Hidalgo 与 Barabási 曾用它描述一个人轨迹的典型范围,并认为人常常往返于两座基站之间,因此它有可能接近家到工作地的距离。本文沿用这个读法,但没有在这座城市单独标出家和工作地。
每周不同基站数可以和前两个范围指标分开。范围不大而基站很多,表示人在一小片地区里频繁切换塔;范围很大而基站很少,表示活动集中在少数相距较远的地点。
入户调查的等级,怎么落到基站上?
社会经济水平(socio-economic level,SEL)来自该国统计机构的入户调查,表示一个人相对全国其他人的社会位置,不是单独测到的个人收入。全国分成 A、B、C、D、E 五级,A 最高。等级由 134 项指标合成,其中包括家庭成员受教育程度、房间数、手机和固话、电脑、合并收入、职业等。
统计机构把城市分成 1,200 个地理区域(geographical region,GR),每个区域大约 1 到 4 平方公里。在这 1,200 个区域里,A 占 8%,B 占 22%,C 占 38%,D 占 32%,没有 E。这四个百分比的分母是地理区域数,不是人口数。8%、22%、38% 与 32% 相加为 100%。
基站边界和统计区域对不齐。作者把每个统计区域占某座基站覆盖面积的比例当作权重,再把字母换成分数:A=100,B=75,C=50,D=25,E=0。一座基站的分数,是这些区域分数的面积加权。完全落在一个 B 级区域里的基站,分数就是 75。他们举的部分重叠例子是 0.68×75+0.17×50+0.15×75=70.75;三个权重相加为 1。重叠比例用扫描线算法计算,具体步骤同样不在本文。
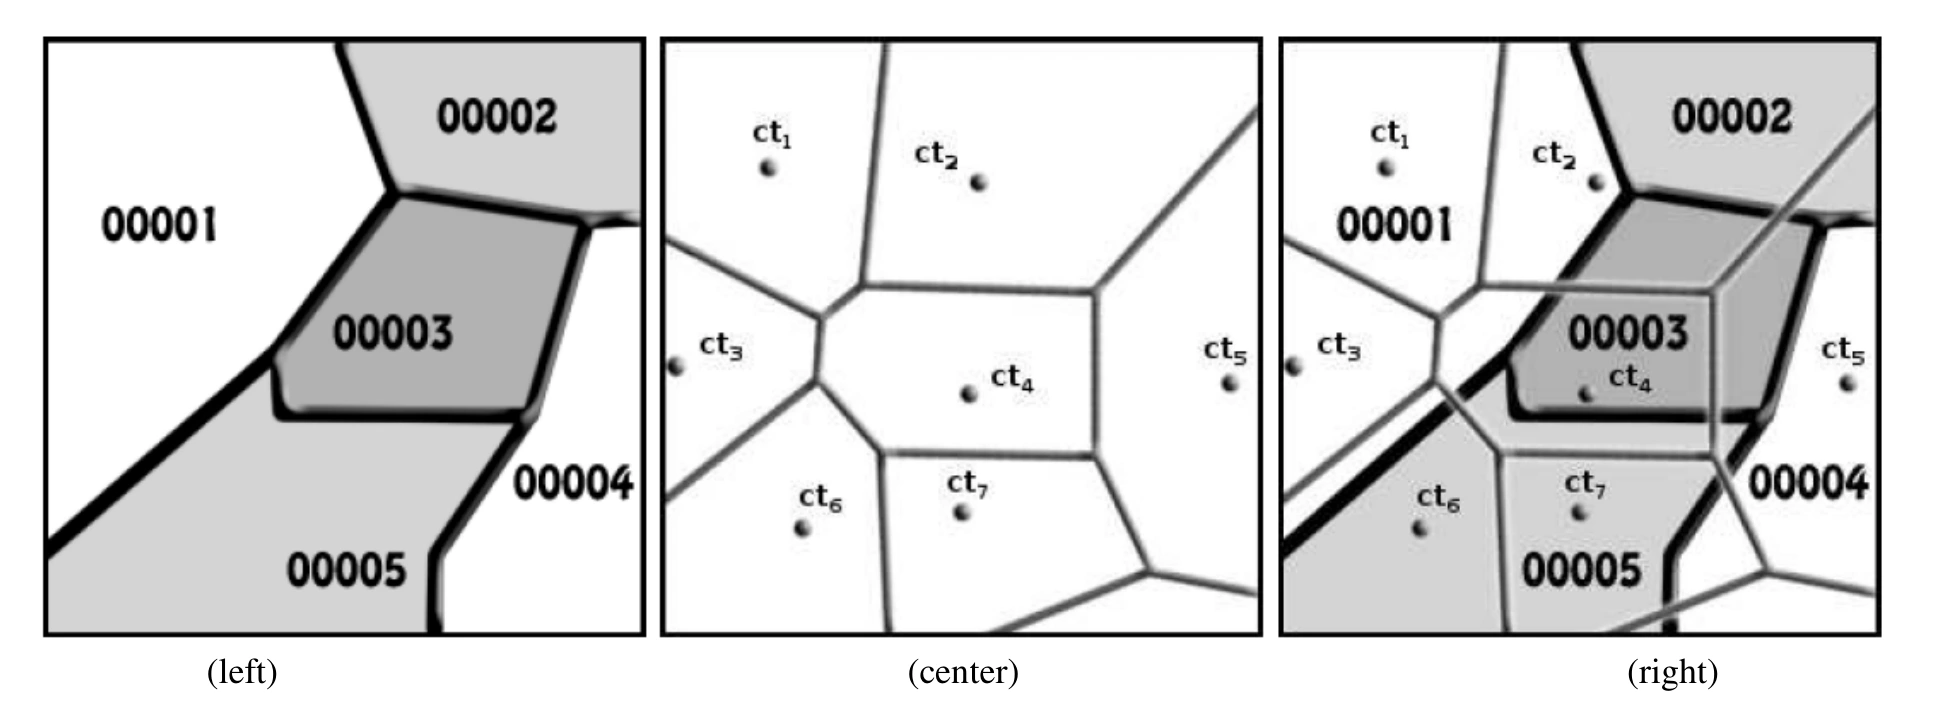
图 2|区域等级按什么权重摊到基站?
(左)示意性的地理区域,标号从 00001 到 00005,灰度用来区分区域,图面上没有印 A 到 D。(中)同一范围的基站 ct1 到 ct7,以及泰森多边形。(右)两套边界重叠,用来计算每个区域占基站面积的比例。这是方法示例,不是全城地图。来源:原论文 Fig. 2。
加权之后,原先的 A 级区域没有保留成分数为 100 的基站;因为城市没有 E 级区域,也没有基站低于 25 分。图 3 把 0 到 100 按 2.5 分一档计数。
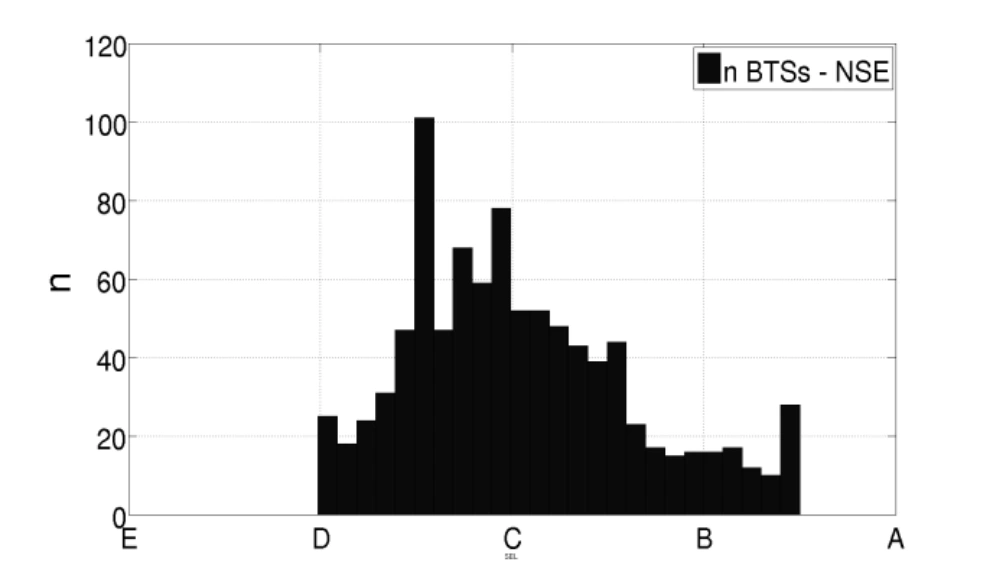
图 3|加权以后,基站还落在哪些等级?
无字母子图。横轴是社会经济水平,字母从 E 到 A;纵轴是基站数,组距 2.5。图例印着 n BTSs - NSE,正文没有解释 NSE。柱子从 D 开始,最高一档越过 100 的刻度,分布集中在 D 与 C,并向 B 延伸;E 和 A 的刻度上没有成片的柱。来源:原论文 Fig. 3。
1,000 个基站上,哪些关系过了 0.5?
每个基站这时有一个加权社会经济水平和六个移动平均。作者计算皮尔逊相关系数 r,范围在 −1 到 1。他们引用 Cohen 1988,只把绝对值达到 0.5 的相关视为值得继续拟合;正文把这个范围写成 [1, 0.5) 和 (−0.5, −1]。显著性用 n−2 个自由度的 t 统计量,n 为基站数 1,000,也就是 998 个自由度。论文只报告 p<0.01,没有给出每个系数的具体 p 值,并认为六个系数都显著,很可能是因为配对数有 1,000 这么大。p 值小,只说明这么多样本下不太像一条完全水平的线,并不说明关系强。0.5 才是他们自己的强度门槛。
| 社会经济水平与哪项移动平均 | 皮尔逊 r |
|---|---|
| 每周不同基站数 | 0.58 |
| 回转半径 | 0.54 |
| 活动影响范围直径 | 0.53 |
| 通话之间的路程 | 0.39 |
| 总路程 | 0.37 |
| 通话期间的路程 | −0.11 |
表中每一行的分母都是 1,000 个基站。前三行过了 0.5,后三行没有。过线的三项用最小二乘法拟合直线,x 是 0 到 100 的社会经济水平,y 是对应的移动平均。直线回答的是:等级分数每增加 1,基站平均增加多少,而不是某一个人会增加多少。
过线的三项,直线落在什么位置?
三条直线的平均二次误差(average quadratic error)依次是 0.66、6.42 和 58.13,分别对应每周基站数、回转半径和直径。论文没有把它们写成可解释方差的比例。三者单位不同,不能互相比较谁拟合得更好。
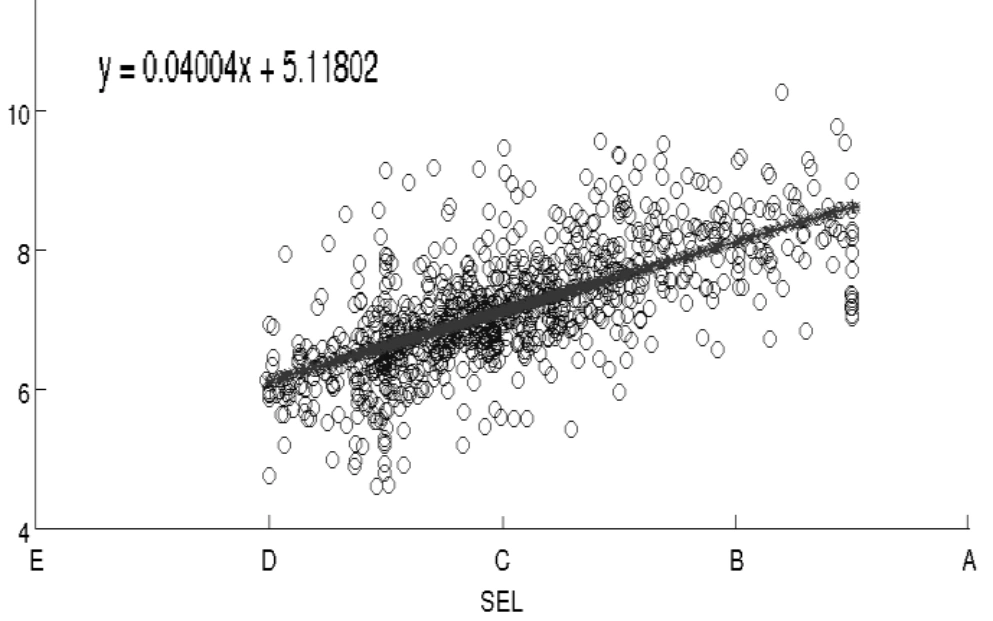
图 4|每周用到的不同基站数是否随等级上升?
无字母子图。横轴为社会经济水平,纵轴为每周不同基站数,圆点是基站。直线为 y=0.04004x+5.11802。云团主要在 D 到 B 之间,同一等级附近的点在纵向上分散。来源:原论文 Fig. 4。
按这条直线,x=0 时为 5.11802 座,正文说等级 E 大约用 5 座;x=100 时为 9.12202 座,正文说等级 A 大约用 9 座。x=25 的 D 为 6.11902 座,接近正文所说的较低水平大约 6 座;x=75 的 B 为 8.12102 座,接近较高水平高于 8 座。从 D 的 25 分到 B 的 75 分,直线上升 2.002 座。这是拟合线两端的差,不是两组基站的观测均值差。E 和 A 都落在散点之外。
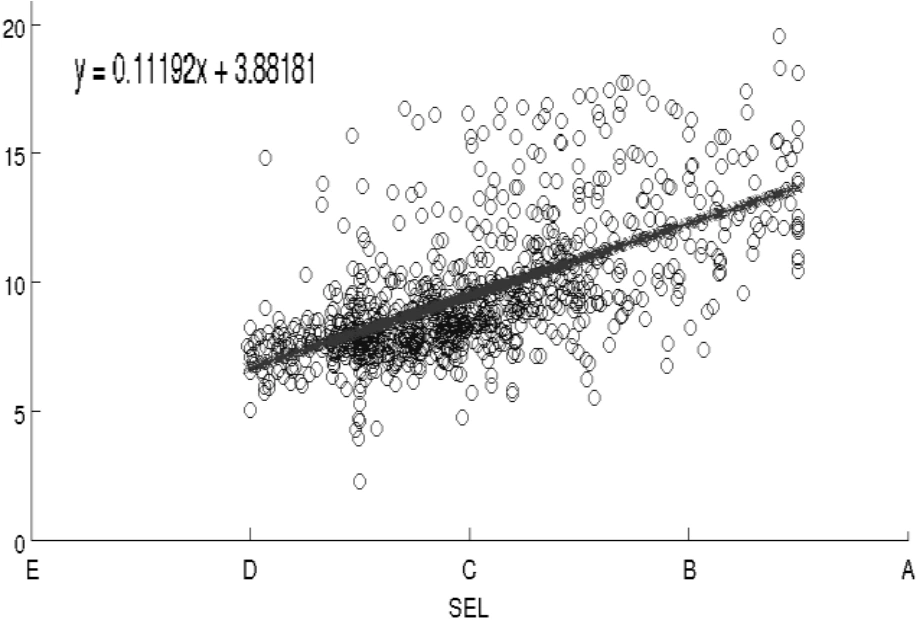
图 5|回转半径是否也随等级变大?
无字母子图。纵轴为公里。直线为 y=0.11192x+3.88181。点从 D 附近开始堆集,并一直散到 B 以外。来源:原论文 Fig. 5。
直线在 x=0 为 3.88181 公里,正文四舍五入写成等级 E 的 3.8 公里;在 x=100 为 15.07381 公里,正文写成等级 A 约 15 公里。D=25 时直线为 6.68 公里,C=50 时为 9.48 公里,落在正文所说的 C、D 大约 5 到 10 公里里。B=75 时直线为 12.28 公里;正文把 B 及以上读成 13 公里或更多,散点确实继续向上,但 B 这个刻度上的直线还不到 13 公里。从 D 到 B 的 50 分,直线增加 5.60 公里。
作者据此说,社会经济水平更高的人住得离工作地更远。这句话依赖回转半径可以代表家到工作地的距离。本文没有观测工作地,所以它是沿用既有解释后的推断,不是这座城市的通勤实测。
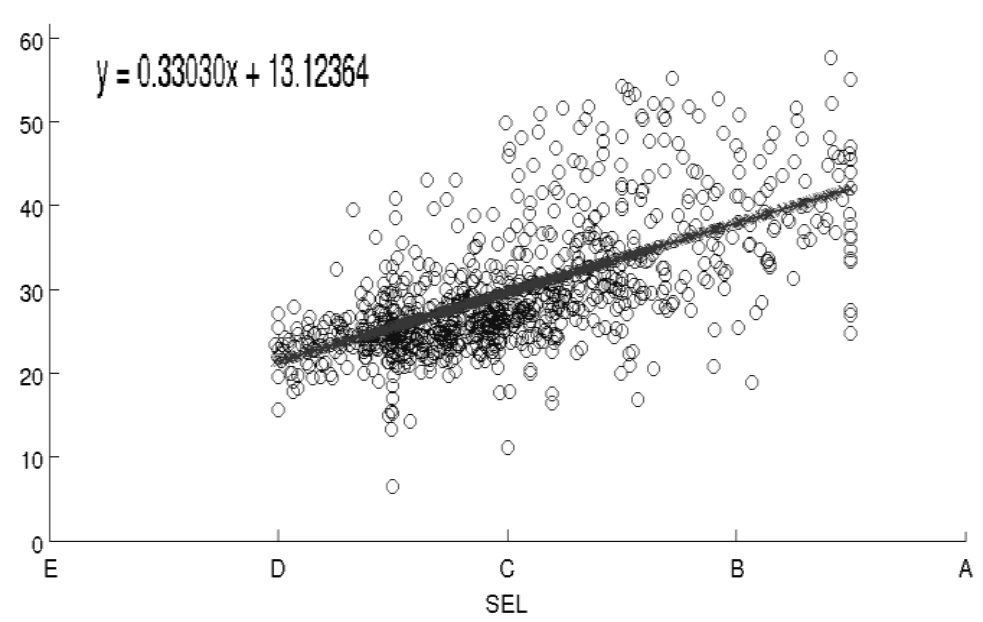
图 6|最远两座基站之间的距离是否一起变大?
无字母子图。纵轴为活动影响范围的直径,单位是公里。直线为 y=0.33030x+13.12364。来源:原论文 Fig. 6。
直线在 x=0 为 13.12364 公里,正文写成等级 E 的 13 公里;在 x=100 为 46.15364 公里,正文写成等级 A 的 46 公里。D=25 时为 21.4 公里,C=50 时为 29.6 公里,对应正文所说较低水平大约 20 到 30 公里。B=75 时为 37.9 公里,高于正文所说 B 及以上大于 35 公里的下限。从 D 到 B,直线增加 16.5 公里。同一等级上的点在直线上下分得很开,直线只描述平均趋势。
作者还把直径的一半叫做影响范围的半径,并说它大约是回转半径的两倍,而且这个比例不随社会经济水平改变。用两条直线核对:D、C、B、A 四处,直径的一半除以回转半径约为 1.60、1.56、1.54、1.53。比例确实稳定,数值更接近一倍半。以 D=25 为例,直径 21.4 公里的一半是 10.7 公里,回转半径 6.68 公里,10.7÷6.68≈1.60。
直径更大,曾被用来讨论病毒传得更远。作者由此认为,社会经济水平较低的地区也许更容易把疫情围住。本文没有观测感染或接触,这个判断是从直径外推到疫情,不是本数据里的流行病学结果。
路程同向,但没有过同一条线
另外三项没有进入回归。通话之间路程的 r=0.39,总路程的 r=0.37,都是正的,只是低于 0.5。通话期间路程的 r=−0.11,方向相反,绝对值更小。因此不能写成路程与社会经济水平完全无关,也不能写成等级越高、每周塔间路程越长已经得到同样强度的支持。
合在一起的读法是:社会经济水平较高的基站,居住者平均活动过的地理范围更大,用过的塔也更多;把通话位置一段段加起来的路程,却没有强到作者设定的标准。一个人可以在相距更远的几个地点之间活动,而相邻两次通话之间记录到的塔间距离并不成比例变长。60% 的通话本身就没有发生塔与塔之间的移动,也限制了通话期间路程能拉开的差距。
相关停在基站平均,也停在这座城市
这六条相关都是线性相关。没有放入基站密度、到市中心的距离、人口或城乡差别。公里直径随等级变大,不太像单纯因为高社会经济水平地区的基站更密:塔更密时,同样的活动范围通常对应更短而不是更长的公里数。但这只是对照测量定义后的疑问,论文没有做这个控制。
行文有时把基站平均说成个体差异。计算单位仍然是 1,000 个基站。同一条直线周围,基站数可以差一两座,回转半径可以差好几公里,所以等级分数不能逐座基站预测移动。
E=0 和 A=100 的公里数是直线外推。城市的统计区域里没有 E;加权之后也没有分数正好为 100 的基站。用 3.8 公里对 15 公里、13 公里对 46 公里来比较最两端,比的是方程在轴端的取值,不是两组被观察到的基站均值。
作者后来假定基站上的关系也适用于个人,并讨论把每周基站数倒过来估计个人社会经济水平。那个倒推多了一层没有在个人数据上检验的假设。社会经济水平又是 134 项指标合成的区域位置,其中只是包含合并收入,并不是测到的个人收入。本文只保留基站上的群体统计,不写出这套倒推。
作者也写明,结果不必在同一国家的其他地区重复出现,直线能否用到别的城市仍不确定。预测模型被留作后续工作,本文没有给出留出样本上的预测误差。
一句话总结
在这座城市的 1,000 个基站上,社会经济水平越高,居住者平均活动的地理范围越大;由通话位置累加出来的每周路程并没有过同一条相关标准。范围变大,不等于路程更长。
核心来源
- 本文依据的稿件:V. Frias-Martinez、J. Virseda、E. Frias-Martinez,Socio-Economic Levels and Human Mobility。首页与文末未印期刊、卷期或 DOI,稿件文件日期为 2010年10月15日。图 1 至图 6 与表 1 的相关系数均来自这份稿件。
- 居住基站的指定和面积重叠的算法细节不在本文,作者指向 V. Frias-Martinez、J. Virseda、A. Rubio、E. Frias-Martinez 被收入 ICTD 2010 的居住地识别论文,以及 Lane 等人 1980 年关于扫描线的方法论文。
- 回转半径接近家到工作地距离的读法,来自 Gonzalez、Hidalgo 与 Barabási,Nature,2008。本文没有在这座城市单独测量居住地和工作地。相关是否达到 0.5 才算值得关注,作者引用 Cohen,Statistical Power Analysis for the Behavioral Sciences,1988 年第 2 版。
作者介绍
三位作者都在论文脚注中署名马德里 Telefonica Research 的数据挖掘与用户建模组。稿件没有贡献声明,下面只写这份稿件和它的参考文献里能够核对的身份。
- V. Frias-Martinez:本文作者。同稿参考文献里,居住地识别论文和发达经济体与发展中经济体的移动比较,都列出了这个姓名。
- J. Virseda:本文作者。居住地识别那篇被引论文的作者列表中也有这个姓名。
- E. Frias-Martinez:本文作者。居住地识别和两类经济体移动比较的参考文献中都列出了这个姓名。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
下一步值得把每座基站的平均覆盖面积放进同一条回归。本文的直径用公里计量,又随社会经济水平变大;若高分地区只是塔更密,公里直径不一定会变大。把覆盖面积放进去之后,0.11192 公里每分和 0.33030 公里每分这两条斜率还在不在,可以区分两件事:人的活动地盘真的更大,还是塔的布局不同。
另一件被通话记录本身限制住的事,是不打电话的那段路不会留下塔。若高社会经济水平的人在往返途中较少打电话,总路程会被压低,回转半径仍可能因为两端的塔离得远而变大。这会造成本文看到的分裂:范围三项过了 0.5,路程停在 0.39 和 0.37。要检验它,需要同一批人的通话记录和一份不依赖通话的出行记录。
0.58 也没有把基站之间的差别解释完。论文没有报告决定系数。若只把相关系数平方,0.58²=0.3364,大约三分之一;0.54²=0.2916,0.53²=0.2809。这是由已发表系数做的换算,不是原表里的统计量。它提醒我们,直线适合描述 1,000 座基站的平均如何随等级变化,不适合把一座基站的分数当成它的移动预测。