多出来的那一层,是把同一件事看得更细,还是在看另一件事?
论文名片|Luca Serena、Moreno Marzolla、Gabriele D’Angelo、Stefano Ferretti,A review of multilevel modeling and simulation for human mobility and behavior,Simulation Modelling Practice and Theory,2023,127:102780,2023年5月26日在线发表。DOI:10.1016/j.simpat.2023.102780。正式期刊版。收稿日期2022年11月3日,修订稿2023年4月27日,接受日期2023年5月17日。
早高峰的路口,前车刹住,后车要决定跟车、换道,还是接受一个能插进去的空隙。同一时刻,高速路段上被记下来的往往是密度和平均速度;另一个区里,人的移动还可能改变谁和谁发生接触。把这三件事放在一起,只是为了看清同一次模拟里可能同时出现的对象。它不是这篇综述里的某一次实验。
只写一条全市平均速度,路口那一下刹车不会出现。给每辆车、每个人每一秒都做一个主体,计算量和行为数据又常常接不上。文献里的办法是分成几层。麻烦在于,层有时指粗细两种尺度,有时指出行和传染两套语义不同的模型,有时只是一张图上的友谊、同事和家庭。
这篇综述没有新测一组出行或疫情。它把1996年至2022年留下的127篇文献分类后认为:人类移动性及相关行为的多层模拟已经有几套反复出现的搭配,三个近义词却不统一;层与层交换信息时,车辆数或速度的一致也不会自动成立。公开代码仍然少。下面的数字是文献计数、检索命中、作者份额,或综述用来说明取整的例子,不是新算出的预测误差。
先说结论
- 三个常被换用的词可以拆开。多层建模指语义不同的子模型在同一次模拟里协作;多尺度指同一系统在时间、空间或行为上的粗细;多层网络指用图的不同层表示不同关系。统计学里的多层回归是另一套用法,社会科学文献里很常见。
- 筛选后纳入127篇。期刊96篇、会议或研讨会29篇、书章2篇。主题为疫情38篇、短距离步行人群25篇、长距离车辆交通22篇、社会科学20篇、城市规划与物流17篇,另有5篇进不了这些类。分母都是127。
- 按作者机构做分数计数,图例中的EU为56.81,USA为36.49,ASIA为22.80,世界其他地区为10.90,四项加总为127。这是作者份额,不是人数。交通文献的机构份额以EU为主;2020年以后疫情主题上升。亚洲作者近年增多,综述认为这很难用疫情论文来解释。
- 反复出现的搭配是:局部疫情把宿主内和宿主间接在一起,大范围疫情再接上移动;交通和人群用微观个体加宏观流量;疏散把烟火或洪水模型和行人模型接在一起;信息扩散用多层图。人口研究在表8里被写成多层逻辑回归,同一节正文又写成多层连续模型。
- 换尺度时要守住守恒。综述用一个例子说明:宏观侧平均125.4辆车,微观侧只能生成125或126辆。公开源代码的论文很少,而且集中在较近年份。模型再分层,精度也不会超过对真实系统的了解。
三个词拆开之后,层才有可交接的量
人类移动性在这里指人怎样在空间中移动、使用什么交通方式,以及这些模式怎样影响环境、又怎样被环境改变。污染、土地利用、疫情扩散和拥堵都算在内。它比日常通勤宽,也不等于居住地迁移。
模拟可以是确定性的,初始条件决定后续;也可以是随机的。常用范式包括:离散事件仿真(discrete-event simulation),状态在离散时刻变化;基于智能体的模型(agent-based model,ABM),每个主体按自己的规则与他人或环境互动;元胞自动机(cellular automata),格子上的状态随邻居更新;连续仿真,用微分方程描述持续变化;系统动力学(system dynamics),用微分方程和反馈回路更新状态变量;蒙特卡洛方法,靠反复随机抽样看结果出现的机会。并行与分布式仿真是把一次模拟分到多个计算单元上跑,用来缩短墙上时钟时间。它本身不是文中所说的层。
作者给三个词各定了一个工作定义。多层建模:同一次模拟里有语义不同的子模型,各自描述系统的一块,例如一块负责人怎么移动,另一块负责病原体怎么扩散。已有的专用模型可以接进来,精细算法也可以只用在关键局部。仅仅把一个整体模型按软件模块分层,不在这篇综述的范围内。文献有时把这种结构叫混合、嵌套或层次模型。统计学里的多层,经常指同时使用个体和汇总信息的回归,与这里的仿真结构不是一回事。
多尺度,也称多分辨率:同一系统用不同细节来表示。细节可以是时间或空间,例如把时间步缩小;也可以是行为,例如把真实系统里的大部分微观动作模仿出来。全用最细的模型,既慢,也会产生一大堆难以提炼指标的数据。典型做法是宏观仿真管全局,局部现象交给微观仿真。中观(mesoscale)位于两者之间。交通里的一个例子是把相关车辆编成车队,整队当作一辆车处理。原文在这句话里两次都写了microscopic:前一次指每辆车单独计算,后一次却用来指只看流量的那一层。按上文的定义,只看流量的是宏观。这里按流量那一层理解。
多层网络:主体被表示成含节点、边和层的图,层的含义由模型自己规定。多重网络(multiplex)是其中一种,层间边只连接代表同一个行动者的节点。友谊、同事、家庭可以各占一层。
综述明确说,这里的层和层都从语义上理解。软件工程式的分层若只实现一个整体模型,就不收入。
127篇是怎样从百万条检索里留下来的?
检索式可以写成:(multilevel 或 multilayer 或 multiscale)并且(modeling 或 simulation)。不是每个数据库都接受这样的布尔式,所以作者把它拆成六条短语,再手工合并。数据库是 Google Scholar、Scopus、ACM Digital Library 和 IEEEXplore。每条检索按相关性排序,只取前40条进入下一阶段。作者观察到,平均下来有意义的命中不到40条。
表1是筛选之前的命中条数。Scholar一列达到几十万到三百万,是因为这些词在化学、物理和材料里也大量出现,还没有限定人类移动性。
| 检索短语 | Scholar | Scopus | ACM DL | IEEEXplore |
|---|---|---|---|---|
| multilevel modeling | 3,000,000 | 16,752 | 483,265 | 12,538 |
| multilevel simulation | 1,260,000 | 3,955 | 235,720 | 13,001 |
| multiscale modeling | 877,000 | 16,739 | 482,544 | 7,974 |
| multiscale simulation | 732,000 | 3,974 | 233,658 | 2,127 |
| multilayer modeling | 1,960,000 | 16,785 | 482,755 | 17,341 |
| multilayer simulation | 1,760,000 | 3,993 | 235,733 | 7,932 |
来源还有两条:已读论文里的参考文献,以及作者事先知道的文献。有4篇已知相关论文被手工加入。Google Scholar的结果包含了IEEEXplore和ACM DL的全部命中;Scopus另有少量论文不在Google Scholar里。为了画图简单,后三个库只计入没有出现在Google Scholar结果中的论文。全文拿不到或无法访问的论文被排除,综述只说这类论文很少,完整性没有受到明显影响,没有给出精确篇数。
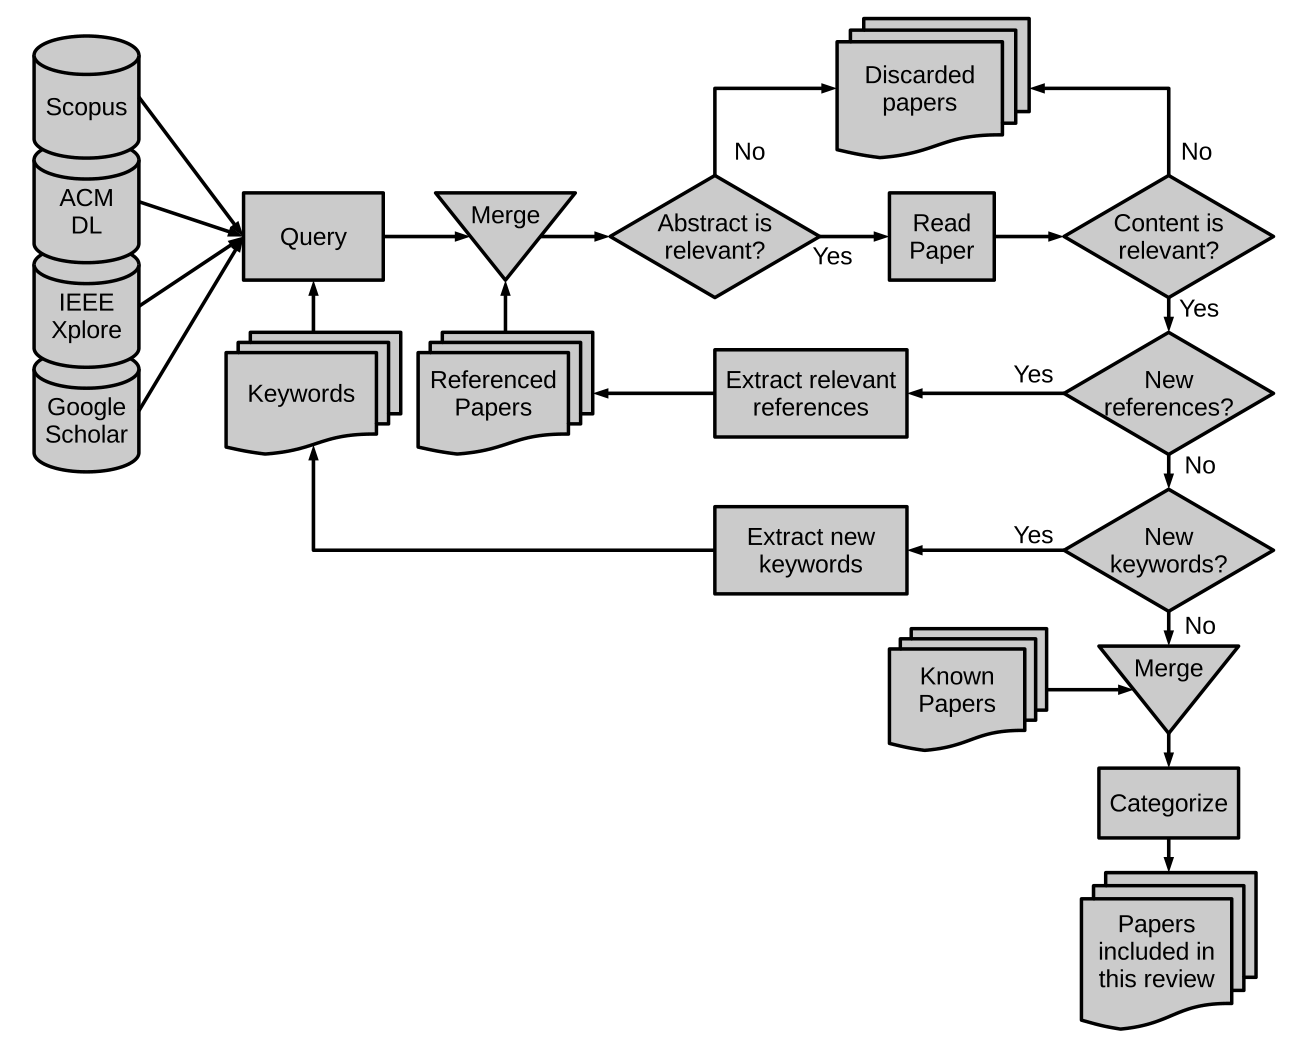
图 1|从检索词到127篇,中间有哪些人工回路?
无字母子图。左侧四个数据库进入查询,与关键词、被引论文合并后,先看摘要是否相关,再读全文看内容是否相关。无关文献进入丢弃。若读完又发现新参考文献或新关键词,就回到合并或查询。已知论文再并入一次,然后分类,得到纳入本综述的论文。图中没有各步骤淘汰的篇数。来源:原论文 Fig. 1。
正文给出的筛选规模是大约数:大约审阅250篇,大约40%在题目和摘要阶段剔除,10%在读完正文后排除,剩下127篇。若把250、40%和10%当成精确数,100加25等于125,与127差2篇。这三个大约不能改写成精确淘汰率。
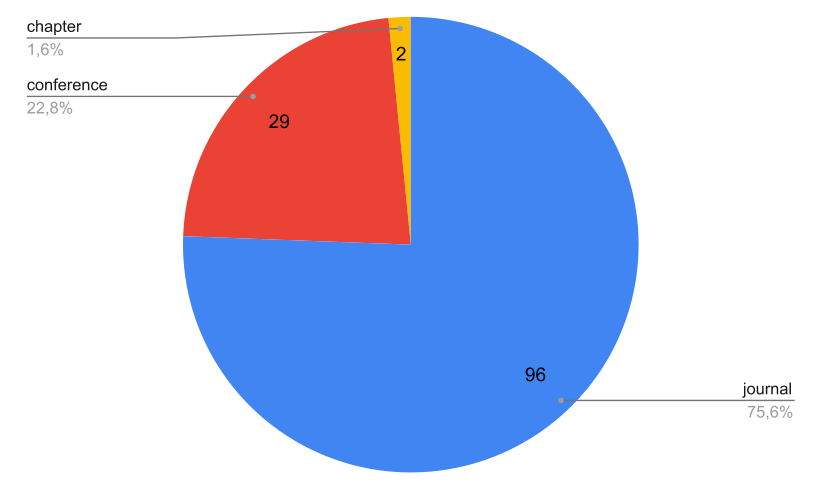
图 2|这张饼图画出的是文献类型,还是检索来源?
无字母子图。扇区标的是期刊96篇、会议29篇、书章2篇,百分比为75.6%、22.8%、1.6%,三者合计127。图题却写 fraction of papers by data source,紧接着的正文也说这张图展示通过筛选的论文来自哪里。来源构成并没有画在这张饼上。来源:原论文 Fig. 2。
正文另给了一组百分比:期刊75.59%,会议或研讨会23.83%,书章1.57%。96/127等于75.59%,2/127等于1.57%,与正文和饼图都能对上。29/127约等于22.83%,与饼图上的22.8%一致,与正文印刷的23.83%不一致。后文用96、29、2和分母127,会议论文的比例采用图上的22.8%。
127篇的时间范围是1996年至2022年。主题及占127篇的比例为:疫情建模38篇,29.92%;长距离车辆交通22篇,17.32%;短距离步行与拥挤25篇,19.69%;城市规划与物流17篇,13.39%;社会科学20篇,15.75%。五类之外还有5篇,3.94%。38+22+25+17+20+5等于127。
谁在写,写的是哪一类,代码公开了没有?
地区按作者撰写论文时所属机构的第一单位计算,用的是分数计数(fractional counting)。一篇论文有n位作者,每位把自己的1/n记到所在地区。因此一项地区合计的分母是论文篇数,不是作者人数。多单位时只取第一个。
地区定义需要连着图例读。ASIA包括中国、日本、韩国、越南、新加坡等,列举没有封闭。EU在图里用这个缩写,定义却比欧盟成员国宽:欧洲大陆加上英国、爱尔兰、冰岛,并写明包括瑞士和挪威。正文的地区清单把下一类写成北美洲,含美国和加拿大;图3、图4的图例和后文的36.49都写成USA。其他地区点名了澳大利亚、巴西、墨西哥、阿根廷、尼日利亚、塞内加尔和摩洛哥。
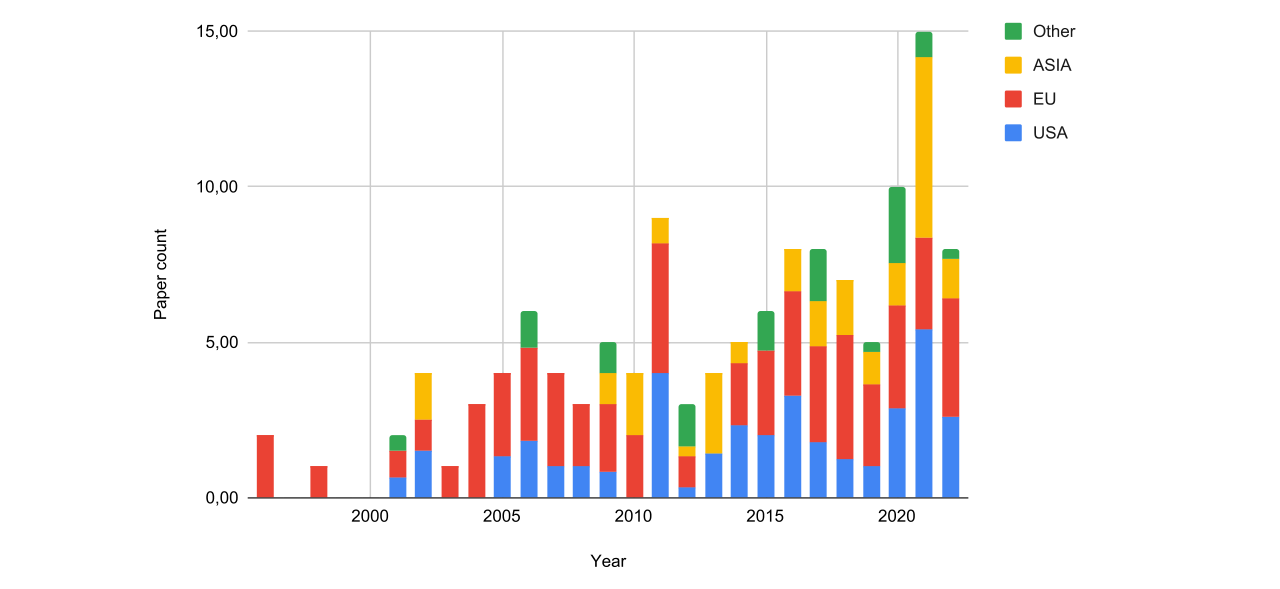
图 3|文献数量随年份怎样变化,新增的份额来自哪里?
无字母子图。横轴年份,纵轴论文数,刻度到15。颜色自下而上按图例为USA、EU、ASIA、Other,同一根柱里的颜色是该年论文的作者份额。2021年的柱顶到15,是图中最高的一年,黄色占了明显的一段。图上没有逐年分段的数字标签。正文同时提醒,电子图书馆对更老和更新的工作都有代表性不足。来源:原论文 Fig. 3。
四项份额为EU 56.81、USA 36.49、ASIA 22.80、其他10.90。56.81+36.49+22.80+10.90等于127.00。近年亚洲作者份额上升较快。
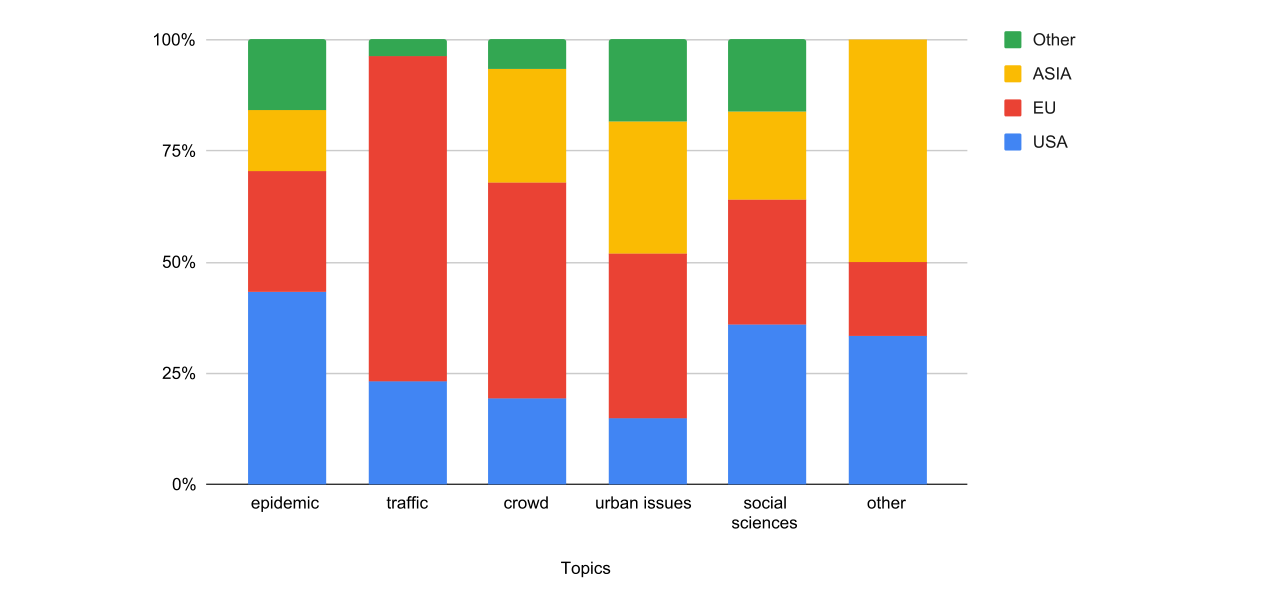
图 4|亚洲作者的增加,能不能看成疫情论文变多?
无字母子图。横轴六个主题,纵轴为该主题内部的作者份额,每根柱合计100%。颜色与图3相同。疫情列里蓝色和红色占了下部的大部分;交通列的主体是红色,一直铺到接近顶部。其他类看不到绿色,黄色占了上半段。图中没有印出各块的百分数。正文据此认为,疫情论文主要来自USA和EU的机构,因此亚洲作者近年的增加很难归因于疫情主题;交通多层模拟则以EU机构领先很多。正文还说按年份拆过原始数据来确认这一点,这张按年的交叉表没有印在正文图里。来源:原论文 Fig. 4。
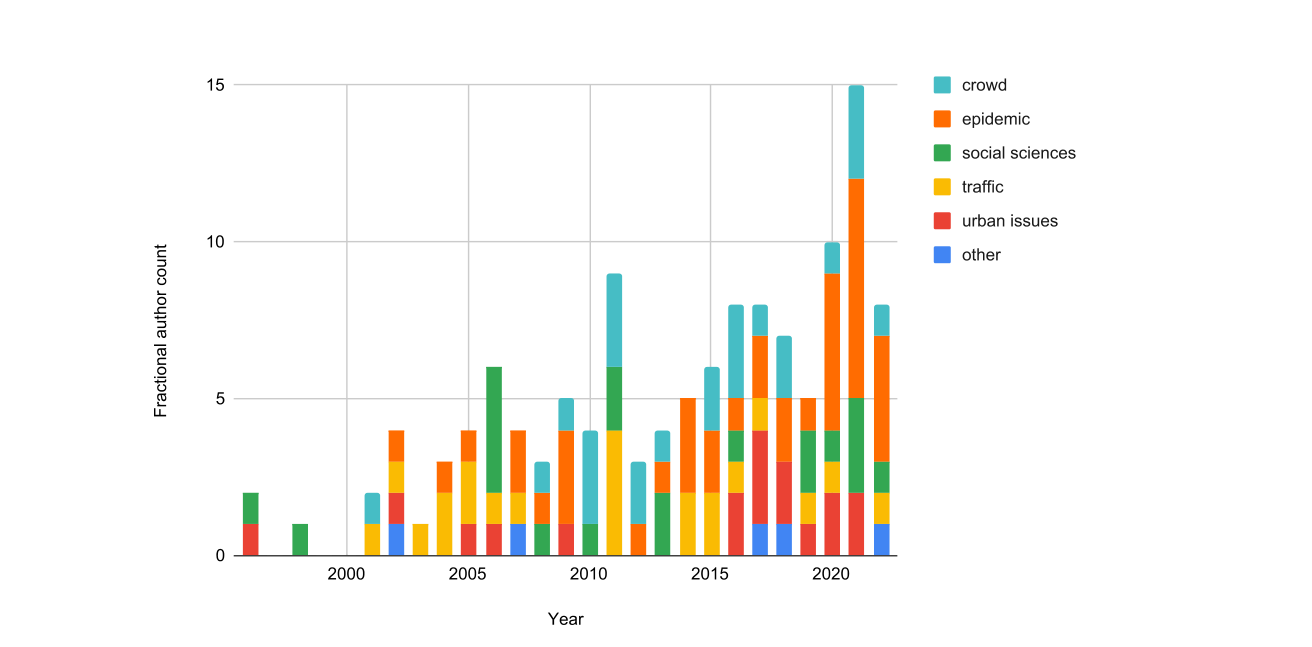
图 5|2020年以后多出来的是哪一类主题?
无字母子图。横轴年份,纵轴写的是 fractional author count,刻度到15。颜色按图例区分其他、城市问题、交通、社会科学、疫情和人群。若每篇论文只归一个主题,一篇论文的作者分数合计为1,柱高在这个定义下等于该年篇数。2021年的柱顶到15。2020年和2021年的橙色,也就是疫情,成为柱中很大的一块,2021年顶部仍有一段青色的人群研究。正文把2020年起的上升联系到新冠疫情。图上没有逐年主题的精确读数。来源:原论文 Fig. 5。
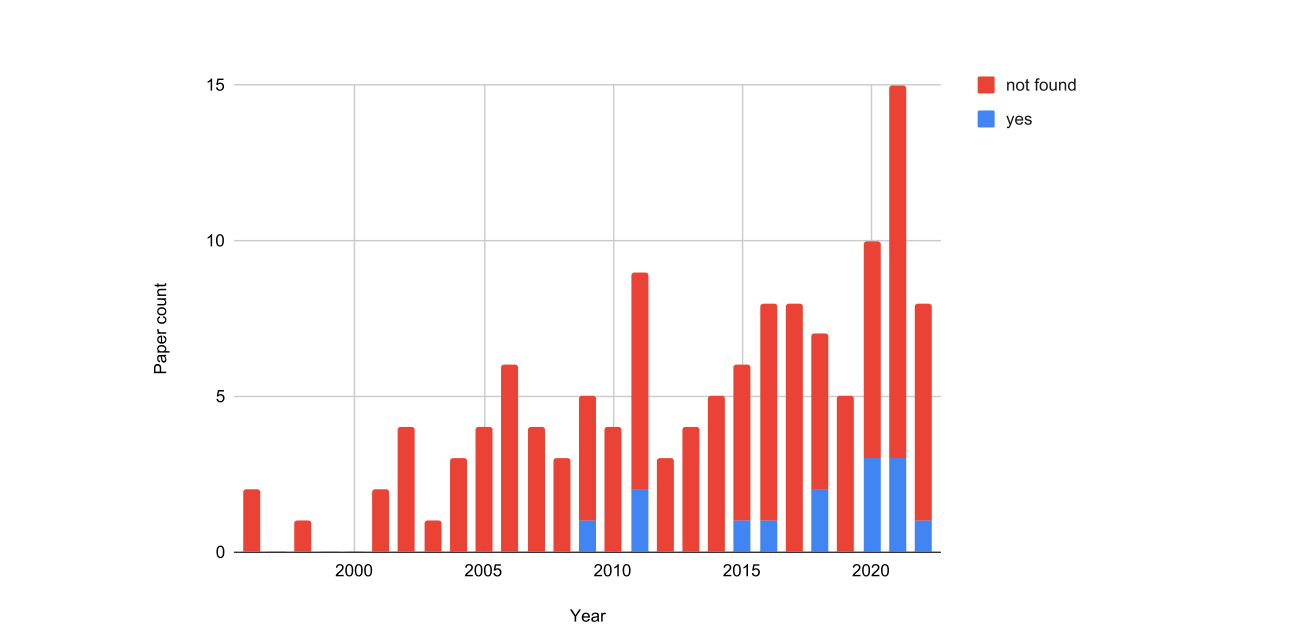
图 6|这些模拟里,有多少论文指向了公开代码?
无字母子图。横轴年份,纵轴论文数,刻度到15。红色为未找到源代码,蓝色为找到。对解析模型,作者找的是方程的机器可读实现。蓝色只出现在较后的年份,而且只占当年柱的一小段;多数柱整根是红色。2021年的柱顶到15,底部蓝色仍然很短。正文没有给出蓝色的精确篇数,只说近年少数论文指向公共仓库,并认为期刊开始鼓励或要求提供数据和代码后,情况会慢慢好转。来源:原论文 Fig. 6。
疫情的层,是身体里、人与人之间,还是人在移动?
第4节开头有一张未编号概念图,把疫情建模分成四支。后文的模型就沿着这四支长出来。
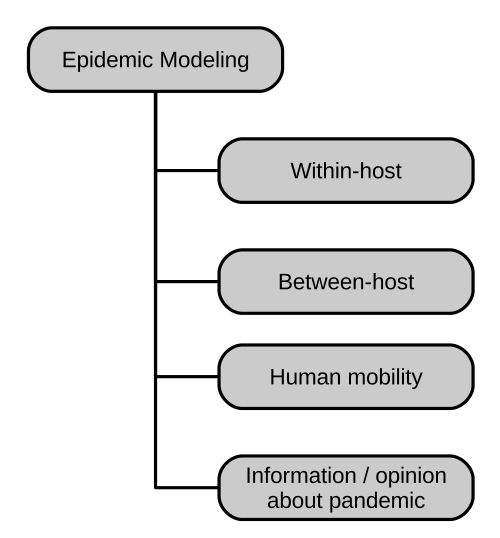
图 9|疫情文献里的层,先被分成哪几支?
无字母子图。根节点是疫情建模,四个分支为宿主内、宿主间、人类移动,以及关于疫情的信息或意见。图上没有篇数。来源:原论文第4节节首未编号概念图。
宿主内模型写病原体与宿主、免疫反应和治疗的相互作用,宿主间模型写病原体怎样在不同个体之间扩散。局部疫情里,一种反复出现的搭配是把两者接起来:宿主内模拟的结果用来决定宿主间使用的传染机会和恢复情况。两边通常都用微分方程。宿主内模型会按疾病改写,综述点到的对象包括埃博拉、流感、霍乱、弓形虫病、艾滋病毒、新冠变异株,也包括羊瘙痒症这类非人疾病。这里只保留耦合方式。综述没有给出传染率、恢复率或其他速率的数值。
宿主间模型常用仓室:人群被放进互斥的流行病学状态,再用转移规则说明怎样换状态。人口足够大时,这种写法可以近似整体趋势,而不追踪每一个人或每一个小群体。尺度变小以后,随机的传播事件和人群结构会明显影响结果,ABM就更合适。ABM在传染病模拟里很常见,放进多层框架却不常见。用得最多的仓室是易感、感染、康复。变体包括加上潜伏,以及康复后仍可能再次感染。另有工作把住院单独成层,因为住院既治疗感染者,也减少传播。易感者与无症状携带者接触时的暴露机会,会因家庭、工作场所和公共场所而不同。这些是状态和场合的划分,不是一组可直接代入的参数。
另一套更常出现的搭配,是把宿主间仓室与人的移动模型接在一起,同时表示局部传播和大范围扩散。移动多写成图:节点和边可以是人和人际关系,也可以是城市和路线。文献里的例子包括美国机场的航空网络、按交通方式分层的城市网络、带层间跳跃的多层网络,以及用两层分别表示稳定伴侣和偶然伴侣的时间多层图。也有完全用ABM的写法,微观主体是个人,中观主体是数百人的群体。另一些工作用方程区分长距离通勤者和短距离非通勤者,或用社会力描述机舱里的乘客、接触半径内的随机传染、社交距离和移动限制。
人口构成也会被放进移动。有的模型把总体写成按族裔、性别或年龄嵌套的子人群,有的同时放入小尺度通勤和长距离航空。精度和计算量之间的折中也有专门框架:一开始用ABM,感染人数越过某个阈值后改用方程,以便做人群平均。阈值本身没有在综述里给出。个体模型还可以先跑微观,再为宏观的易感—感染—康复模型提供输入。
第三支把病原体和社会反应接在一起。对疫情的知晓可以和仓室模型耦合,作者认为知晓会强烈影响实际扩散。信息层上的人可以支持保持距离、反对保持距离,或尚未形成看法;周围的社会联系影响他们是否遵守距离规则。也有工作同时模拟疾病传播和情绪传染,情绪状态被分成冷漠、担心、害怕和麻木。疾病和恐惧还可以都用仓室来写,人既会因接触感染者而感染,也会因接触害怕的人而害怕。
公共卫生系统、政策制定者这类外部主体,看起来很适合再加一层。综述在表2至表7的范围内没有找到这样做的论文。
这一节的讨论把证据边界说得很直:仓室模型省计算,ABM在需要更高精度时更受欢迎,但更高精度要求从免疫到个体行为的更多信息,而这些信息很少齐备。模型的精度至多等于开发者对真实系统的了解。在信息有限时,ABM仍可用来做假如式分析,用试错推断现实中尚未知道的性质。与后面的交通相比,疫情模拟更常关心随时间变化的趋势,所以基于人群的仓室模型通常就够用。纯ABM在流行病学里仍然流行,主要出现在单一整体仿真器里。
车流换尺度时,为什么人数会多出一辆或少掉一辆?
交通是多尺度用得最勤的领域。微观描述单辆车怎样响应道路和其他车,宏观把车流当成整体,中观仍保留一辆辆车,但用简化的流动力学推动它们。价值在于把费时的微观只用在拥堵、事故等关键位置。
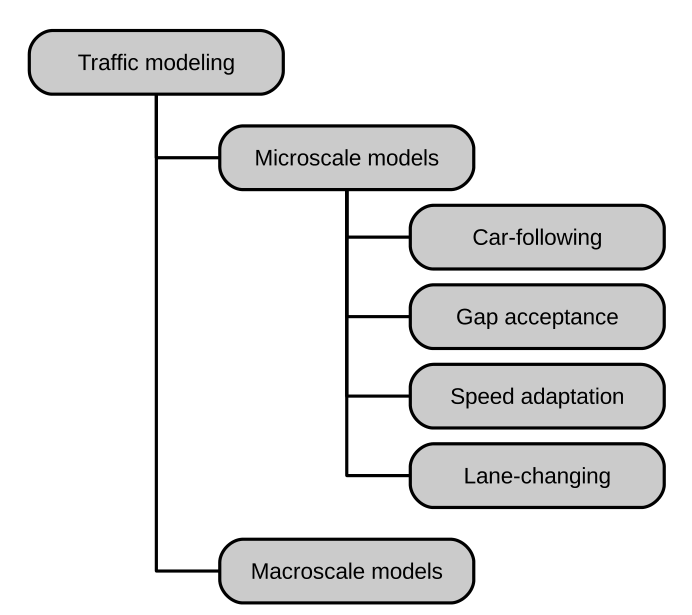
图 10|交通的概念图把微观拆成了哪几种决策?
无字母子图。交通建模下面只有微观和宏观两支。微观再分成跟车、间隙接受、速度适应和换道。中观、亚微观没有出现在这张图上,它们写在后文。来源:原论文第5节节首未编号概念图。
微观模型要决定何时加速、刹车或转向。车辆状态可以包括位置、速度、驾驶员反应时间、最大速度和最大加速度。空间可以是连续的,也可以是离散格子;道路也常画成图,节点是交叉口,边是路段。真实交通变化快,离散模型的虚拟时间通常一次只前进几秒,综述没有规定统一步长。
四类微观子模型对应四种决策。跟车看同一车道前车。间隙接受规定驶出支路时,主路车辆至少要留出多大空隙。速度适应按限速或路面调整车速。换道编码超车或遵守车道限制。常用框架包括:智能驾驶模型,用常微分方程更新单车的位置和速度,涉及期望速度、安全车头时距、最大加速度和舒适减速度;Nagel–Schreckenberg模型,格子或空或有一辆车,车速依赖前车和其他因素;ABM则把车写成处在微观环境中的主体。MATSim和SUMO是这一带常用的仿真器。车辆很多时,常用降尺度:只用总人口的一个比例k来跑整个系统的动态。综述没有给出k的数值。它的目标是省时间并尽量保住精度,和多尺度不是同一件事。多尺度是关键路段用微观,其余地方用中观或宏观。
宏观不单独追踪每辆车。密度是某一时刻单位路长上的车辆数,空间平均速度是某路段车辆的平均速度,流量是一段时间内通过某一点的车辆数。常见对象是高速或快速路。网络基本图联系路网中的车辆数和该区域的平均流量。Lighthill–Whitham–Richards模型用连续性方程和一条假定的均衡速度—密度关系。Payne–Whitham模型用微分方程写平均速度、密度和单位时间路段车辆数。Aw–Rascle–Zhang模型用二阶非线性双曲偏微分方程写密度和速度。
微观与宏观最常见的交接是聚合和分解。聚合把个体属性收成一个数据点,个体特征就此消失,除非另有机制把它们存下来。分解要把宏观量拆回个体,相当于造出原来没有的信息,所以新信息必须仍然有意义。例如某区域在宏观侧只有平均速度,分解出一批车时,这些车的速度平均值应与宏观值一致,并可以加一点随机起伏来反映真实交通。有的交接由称为agent upstream的实体完成:宏观到微观要按流量参数生成相应数量的车,微观到宏观则从车群计算流量和密度。
连续模型换成一辆辆整数车辆时,会出现取整损失。综述的例子是:一个区域平均有125.4辆车,微观仿真只能生成125或126辆,分别少一点或多一点。这种误差积累起来,总车辆数会明显漂移。一种处理是把小数部分存起来,凑满1再生成一辆新车。这是综述用来说明问题的例子,不是本文新跑出的仿真误差。
局部不一致指换尺度的当下,交通变量对不上,例如车辆不守恒、平均速度突然跳跃、出现不真实的瓶颈。全局不一致指换了几次尺度之后,交通构成丢了:微观里算过的路径选择、车辆特性和驾驶风格,若没有存下来,回到微观时就无法再用。也有工作用面向服务的中间层,让一个宏观仿真器调用若干微观仿真器,并负责翻译不同尺度的数据。更紧的耦合则用偏微分方程写交通流,用常微分方程写自动驾驶或特别慢、特别笨重的车辆。
中观因为仍然逐车处理,从微观切过来通常不必聚合,但尺度之间仍可能要满足一致性。亚微观,也称picoscopic,可以细到用键合图写加速、刹车、转向下的纵向、横向、横摆和执行器动力学。四层都有的框架里,最细的一层是驾驶员模型和车辆模型不断交换信息,以决定刹车或转向;中观则给出单位时间内、某个空间和速度范围里出现一辆车的概率。
还有一种变体假设车辆有短程通信,周围的交通数据先在车群内汇总,再在更高层的车群之间共享,高层由代表交通管理中心的智能体处理。环境用元胞自动机,主体是车和管理中心。工作负载既有真实地区的地理、环境和人口,也有与具体城市无关的通用测试环境。更复杂的一种按地区特征生成合成人口,再根据对一部分人口所做调查生成每日活动计划。
交通这一节的结论是:微观多用ABM,因为主体可以写入复杂的驾驶行为,并与街道形态、防护设施、人行横道、限速等环境交互;大范围模型则尽量把ABM留在拥堵、与行人发生危险交互的位置。多尺度因此被看成降尺度之外的一条路。换层时要保持一致的量包括断面或路口流量、平均速度、平均密度。宏观多为连续量,微观多为离散个体,取整必须单独处理,否则会无中生有或凭空消失车辆,破坏守恒。
表3放在交通这一节,行内是微观、中观、宏观以及IDM、LWR等交通模型,标题却写成人群移动。表4的情况相反,放到下一节再看。
人群多出来的层,有时是烟、水和出口,不是更细的脚步
人群建模关心行人在特定情境中的行为,例如火灾、地震时的疏散,以及行人和汽车、火车的相遇。
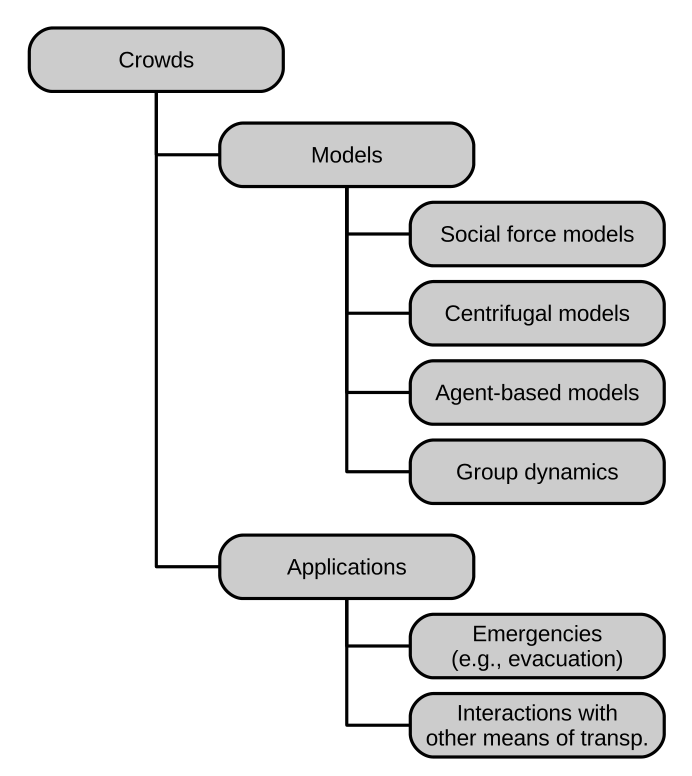
图 11|人群文献先按模型和用途分成了什么?
无字母子图。模型一支包括社会力、离心力、ABM和群体动态。用途一支包括紧急情况,例如疏散,以及与其他交通方式的交互。最下方节点的原文印成 Interactions with other means of transp.。来源:原论文第6节节首未编号概念图。
微观上,行人走向目的地,同时避开障碍和过挤的地方。社会力和离心力模型让环境中的物体对行人产生吸引或排斥;ABM把每个人写成自主主体。宏观看的是局部平均量,如密度、动量和能量。中观处理成群的行人,忽略群内互动,以便既写群体动态,又对个体保留一些控制。
尺度交接仍常靠聚合和分解:聚合从微观收集密度和速度,注入宏观;分解在分区边界按宏观密度和速度生成主体。也可以让微观和宏观同时跑同一片区域并不断交换信息。有的同步模块把宏观运动趋势传给个体;有的只在事件扰乱了稳定流动时,才从宏观切到微观;还有的按计算约束动态调整细节。
群体本身也可以是一层。一种层次是人群、小组、个人,行为从人群传到小组,再传到个人。另一类在微观方程里写入躲避碰撞、避开拥挤和结伴移动,宏观则用离散格子,每步更新格子密度。路径决策也可以单列:一层用A*算法算到目标的最短路,另一层管转向和局部避碰;个人差异体现在厌挤、地图知识和是否属于某个群体。战术层按环境寻找目的地的短路径,操作层在微观描述拥挤中的互动。
疏散里常有少数被称为领导者的主体负责找安全出口,其余人跟随。领导者可以在宏观层观察环境并做路线决策,跟随者的动作留在微观。海啸警报的例子里,微观标出知道如何反应的领导者和跟随者,宏观用LWR模型写路网上的行人流。
火灾疏散经常把行人模型和烟火传播分开。火焰演化可以用元胞自动机,烟和火也可以用方程;还有用马尔可夫链同时写烟雾和人员疏散的。电影院的疏散会把建筑模型和整座城市或街区模型接起来,以便看到建筑周围的日常活动。洪水用连续模型写水在城市中的蔓延,再用ABM写行人从危险区域走向安全区域。溃坝是更极端的例子:ABM写异质的个人行为和社会特征,水动力模型用扩散方程。两层保持同步,水力模拟先跑,结果再送进ABM。两侧时间尺度不同,一边是10分钟,一边是5秒,水深要等疏散模型走完120步才更新。10分钟等于600秒,600除以5等于120,与综述所写的步数一致。
极度拥挤时,人的移动也可以借用流体。一种做法把ABM和平滑粒子流体动力学接在一起,每个主体被当成一颗受多种力推动的流体粒子,力最终决定速度和加速度。
空间表示也可以换。需要细分辨率的区域用连续空间,主体有位置、速度、身体宽度等连续属性,不同类型的主体对环境刺激反应不同。不需要细分辨率的区域改用网络:房间或走廊是节点,门或其他连接是边。节点容量是该空间能容纳的人数,边的容量是给定时间内允许通过的最大主体数。综述没有给出这些容量的具体人数。
行人还会和其他交通方式放在一起。铁路道口可以用离散事件写行人、用连续模型写列车。道路交叉口的碰撞风险同时看微观环境,如标志、车流、道路和人行横道,以及宏观环境,如城市设计和交叉口周围的土地利用。低密度下,车辆、公共交通和行人可以用排队网络;高密度行人改用基于力的模型。公共活动中,宏观模型写班车到达,场地内的行人再分战略、战术、操作三层:战略定目标,战术定路线,操作写实际行走。狭窄处用微观,其余用元胞自动机式的中观,交接处设过渡带。轮渡码头则用元胞自动机写两座航站楼内的人,用中观图模型写渡轮航程。
人群与交通的共同点,是微观多用ABM,宏观用方程写密度、流量和平均速度。差别在于人群研究的目的更散,行人移动经常要和烟、火、洪水写在一起;空间通常也比整座城市小,所以元胞自动机适合建筑和一小段城区。行人比车辆更少受车道约束,因此经常多出一层,用来做中期的路径选择。
表4的标题写成交通建模,行内容却是动态环境中的人群、疏散、洪水、拥挤、列车与行人、渡轮码头等。第二列表头在PDF里只印出一个字母f,下面填的是这些场景。读表时要以行内容为准,不能按标题把这一页当成交通论文清单。
城市研究为什么收不成同一种搭配?
城市问题包括城市形态和居民活动。这一节是五类里最杂的,方法很难收成一种。多数工作有一个共同点:用真实地理数据,而不是随机生成的场景。研究既有城市时,环境要尽量像被检验的那座城市。假如式分析仍可以使用合成数据,用来看环境在另一种情形下会怎样反应。污染、土地利用这类问题同时出现时,语义不同的模型必须合作。交通和移动建模里发展出来的工具,在这里被大量沿用。
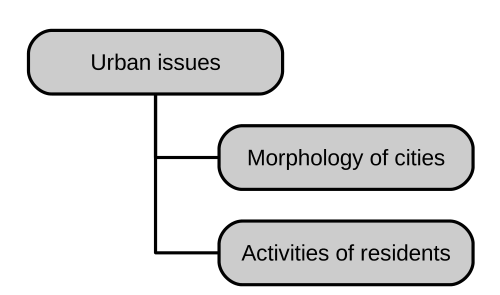
图 12|城市问题在概念图里只分成哪两支?
无字母子图。城市问题连接到城市形态和居民活动。气候、污染、停车、物联网都写在后文,没有单独成为图上的节点。来源:原论文第7节节首未编号概念图。
形态这一支把气候和经济变化放进规划。城市综合评估框架分三级:顶层城市模型用社会经济变化和气候预测分析未来人口的空间格局;城市分区模型把数据降到更细的空间分辨率,再用人口、交通和土地利用估计气候相关影响;地块模型则模拟各分区人口预测所对应的住房开发格局。热岛用三种空间尺度,中观看温度和风,微观看绿化、周围建筑和路面。
Simmobility把对移动敏感的行为模型放在一起,时间分辨率有三档,短到几分之一秒,长到数日甚至数年。长期是战略活动,如换工作、搬家、土地开发和买车。中期是每日活动安排、路线、目的地和出发时间,分成出发前模型和日内模型。短期负责人、车和货物的实际移动。
城市扩张有多座城市的案例。武汉的一套三尺度框架用宏观系统动力学预测新增城市用地需求,用中观模型考虑城际相互作用以确定可能扩张的区域,用微观逻辑回归表示邻里相互作用,三者再并入一个元胞自动机。奥克兰的例子里,政府主体按分区要求和居民需要在宏观层管理开发,居民主体在微观层寻找居住地点,ABM再与人工神经网络耦合,以支持主体选择哪些非城市区域可以扩张。综述表5对这两篇的方法标注,与这段正文的对应不一致。这里保留正文的城市和方法,不把表5的行当成已经对上的第二份说明。
武汉的另一项研究用多尺度层次框架:宏观定义整个研究区的变化概率,中观只在非城市变为城市的范围内定义变化密度,微观在局部定义变化强度。哥斯达黎加的土地利用与覆被变化用系统动力学,数据取不同聚合尺度,并显示地方、区域和国家趋势可以产生相反的效果。综述没有给出相反到什么程度的数值。也有工作在宏观用元胞自动机写土地利用和交通基础设施,在微观写行人;或把环境、社会、经济分成若干ABM子模型,按共同建模的想法,让微观模型成为更高层模型里的主体。
居民活动这一支更散。马德里的PM10扩散用计算流体力学,气象边界条件来自中观的天气研究和预报模型,包括风速、风向和地表热通量,小时PM10排放来自微观交通排放模型。亚马孙毁林把区域回归和局部ABM接在一起:宏观回归使用环境、人口、农地结构、技术和市场连通性等指标;局部有两类主体,小农户偏好靠近道路或城镇的土地,大农户寻找大片便宜土地。菲律宾的土地利用使用多层回归,数据在地块、家庭和村庄三层。这是统计学意义上的多层,与前文定义的仿真多层不同,综述仍把它收了进来。
智慧城区的例子是一个智能市场:用户订阅感兴趣的商品或服务,并收到附近活动与促销信息。粗尺度用ABM、并行分布式仿真和离散事件,描述整个区域上的销售、订阅和地理移动;需要时再启动细尺度仿真,写入市场内部的无线通信、交互和移动。后来又加了一层方程,写邻里中的客流和停车策略,用包装器协调两个细尺度仿真器并与高层同步。停车也可以让网络基本图写车流,微观算法模拟巡游找车位,决策受巡游速度、停车时长和占有率影响。综述没有给出这些量的数值。
塞内加尔的黑鼠借助商业运输扩散。模型单位叫世界:一个自足的子模型,有自己的地点、主体、空间分辨率和时间尺度。主体是鼠或运送它们的人。世界之间用门连接,门是离散空间里的格子,充当跨越点。结果取决于人的移动和鼠的繁殖。人只能乘特定车辆去有限的目的地,环境是否适合鼠则取决于生物气候和地形等信息。繁殖速率没有在综述里给出。
社会科学里的层,常常是回归的层级
社会科学模型的目的和实现差得很远,共同点是个人动态要放在与其他人或群体的关系里看。第8节的概念图只分成意见传播和人口动态,人口动态再分成健康状况的影响和搬迁。
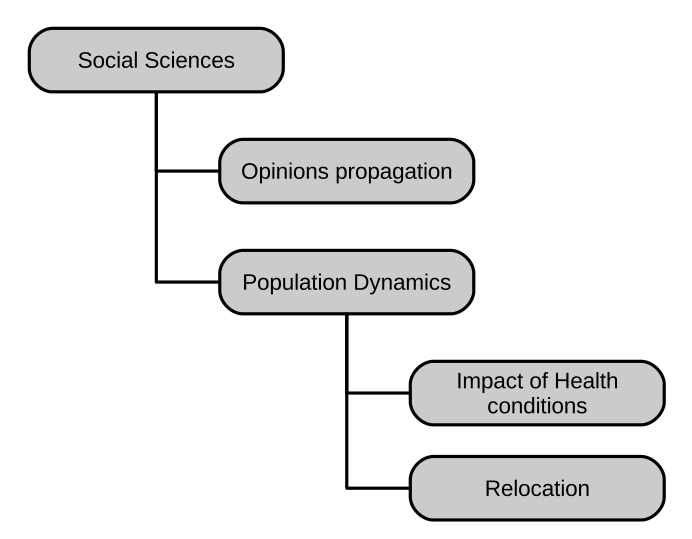
图 13|社会科学的概念图把层收成了哪几支?
无字母子图。社会科学下面是意见传播和人口动态;人口动态再连到健康状况的影响和搬迁。回归层级、多层图的具体层名都没有画在图上。来源:原论文第8节节首未编号概念图。
关系有很多种,所以信息、潮流和新闻的扩散常用多层图:节点是人,边是联系,层是发生特定联系的环境。Twitter和FriendFeed可以各占一层。信息传播会借用仓室的样子,人处于不知道、正在传播或不再传播。这里的状态说的是消息还在不在传。另一套状态包括不知情者、传播者、传播改动版本的人、收到但不再主动传播的人,以及不再传播的人。线上联系和所谓现实联系也可以分属不同层,中间再加一个认知过渡层。
多重网络被用来考察社会结构:社会由若干联系紧密的社区组成,社区之间靠弱联系相连。转推研究把变量放在三层:潜在转推者及其与话题的关系,例如兴趣相似度;父级,包括级联深度;级联级,包括内容特征和推文热度。综述没有报告这些变量的系数。
人口动态是另一大块,涉及疾病倾向、同质性、迁移和绅士化。绅士化在这里指中产或富裕人口进入原有社区,价格上升,低收入居民更难负担生活成本。这类研究依赖可靠数据,并同时在个体和汇总层寻找统计上站得住的关联。
健康与个体特征的一组,大多是逻辑回归。儿童肥胖同时使用个人的性别、年龄、族裔,邮编层的收入中位数、生活方式分类和城市化,以及县层的收入和城乡分布。肥胖与糖尿病、儿童疟疾、特雷西纳的内脏利什曼病、印度艾滋病预防项目Avahan、得克萨斯道路死亡、水果蔬菜消费、美国人性取向与收入,都同时放入个人变量和地区、家庭、社区或制度变量。综述几乎没有给出系数。少数被转述的实质结论来自得克萨斯的多尺度地理加权回归:地方尺度上与道路事故关联最强的因素之一,是上班所需的平均时间;区域和全球尺度上,独自驾车与道路安全变差有关。这是综述对那项研究的转述,没有系数,也不是这篇综述自己做的因果识别。
搬迁是第二组。费城的绅士化同时看个人的族裔、教育、婚姻和收入,以及邻里的绅士化过程和稳定性。亚特兰大把绅士化与投票率放在一起,个人变量是年龄、性别、族裔,邻里变量包括平均教育、绅士化率和自有住房比例,并放入绅士化与长期选民的跨层交互。挪威境内迁移用个人和汇总特征定义迁移概率,最复杂的是事件史模型,决策依据个人整个生命史里发生过的事件。中国农民工的社会融合用个人与城市两层,城市变量包括城市性质、经济、人口结构、语言文化和管理制度。另一项人类移动研究把微观定为家庭和住房单元,中观定为微观主体组和城市部门,宏观定为城市特征和规划,移动受主体相似度和群体与城市部门之间的亲和影响。这些段落列出的是变量层级,不是效应大小。
对象也不限于人。变温动物的个体模型按当前成年种群预测产卵数,仓室模型用微分方程写种群动态。捕食者—猎物模型在宏观用微分方程写两类数量的变化,微观写个体行为。
这一节的方法和其他领域差得最明显。社会科学里的层,常常指观察系统的一个视角,而不是模型里的一个组件。ABM在社会科学中很流行,在多层框架里却不常用。作者认为,随着LevelSpace这类多尺度ABM平台发展,多尺度方法以后可能更重要。LevelSpace是NetLogo的扩展,可以让多个NetLogo模型按层次相互作用,并便于接入已有模型。这是对以后的判断,不是这127篇里已经出现的频数。
五篇进不了以上各类的文献在拆什么?
进不了五类的是5篇,占127篇的3.94%。它们仍在拆层,只是对象换成了供应链、市场和情绪。
供应链的一篇同时用连续和离散模型。工厂里的短期操作是一层,战术和战略政策是更高层。客户订单和供应链组件被当成连续变量,运输是离散的。另一篇用纯ABM估计气候变化对马铃薯供应链各阶段的经济影响,模拟里出现栽培、运输、加工、零售和商品物流五层,并用机器学习按年趋势和季节性预测价格。货运的一篇用三个时间尺度:长期是商品流和物流网络,中期是发货、物流计划和车流,短期是调度、路径和派车。主体是机构和货运司机。
双公司市场的例子把ABM和系统动力学接在一起。个人顾客的行为被汇总成趋势;顾客又受产品流行度和邻里决策影响。公司吸引并留住顾客的能力用连续反馈回路来写。连续ABM构建器把主体输入变成待解方程,并处理邻里模型;求解器负责算出仿真结果。
最后一篇把情绪心理分成心情、情绪和性格三层,用一组方程把三层的相互作用映射成心情和情绪的变化。综述没有给出这组方程。
该用哪个词,交接时要守住什么?
结论把反复出现的搭配收成一张表。格子里没有篇数,所以最常是综述读完文献后的判断。
| 应用 | 综述写出的常见搭配 |
|---|---|
| 局部疫情扩散 | 宿主内模型 + 宿主间模型 |
| 大范围疫情扩散 | 大尺度移动模型 + 局部宿主间模型 |
| 交通 | 宏观模型 + 微观模型 |
| 人群行为 | 宏观模型 + 微观模型 |
| 人群疏散 | 烟火模型 + 微观模型 |
| 人口动态 | 多层逻辑回归 |
| 信息扩散 | 多层图 |
人口动态这一格与同一节的正文不完全一致。正文说人口动态研究通常基于多层连续模型,表里写的是多层逻辑回归。表6里这一类论文的类型列大多标成逻辑回归。两处不能合成一种更干净的说法。
结论还写考察了125项研究工作,主要为会议和期刊论文。期刊96篇加会议29篇等于125,加上2篇书章等于127。论文没有写明125是否故意去掉书章。
图7和图8把方法放进两个维度:模型类型是连续、离散或混合,细节水平是低、高或混合。混合指不同层使用不同类型的模型。其他应用的组合更杂,综述认为无法做同样的分类。格子里同样没有篇数。空格表示综述没有把一类反复出现的做法放在那里。
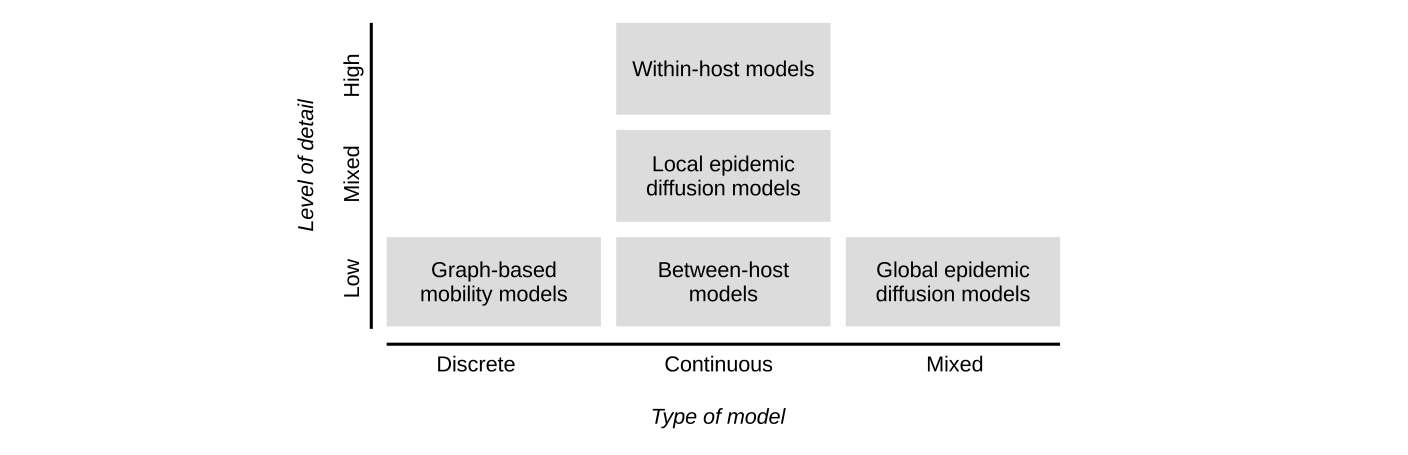
图 7|疫情模型被放进了哪几种类型和细节?
无字母子图。纵轴是细节水平,横轴是模型类型。高细节、连续:宿主内模型。混合细节、连续:局部疫情扩散模型。低细节、离散:基于图的移动模型。低细节、连续:宿主间模型。低细节、混合类型:全球疫情扩散模型。来源:原论文 Fig. 7。
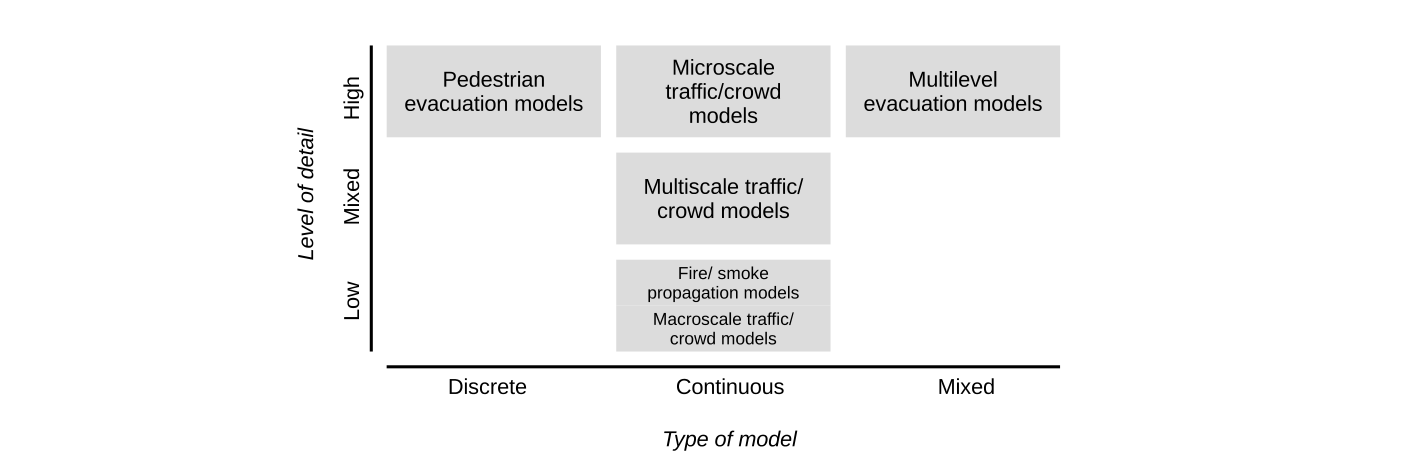
图 8|人群和交通的模型落在哪些格子里?
无字母子图。高细节、离散:行人疏散模型。高细节、连续:微观交通或人群模型。高细节、混合:多层疏散模型。混合细节、连续:多尺度交通或人群模型。低细节、连续这一格里叠放着火灾或烟雾传播模型,以及宏观交通或人群模型。来源:原论文 Fig. 8。
层与层交换状态,有两种反复出现的做法。一种是互相提供对方要用的量。疫情里,宿主内的感染结果用来产生宿主间的传染机会;健康人接触到感染者的机会又依赖大尺度扩散,并可能按宿主内的结果触发感染。另一种是聚合与分解,交通和人群里最典型:平均速度或密度交给宏观,宏观再给出可以带随机起伏的量,实例化到微观个体上。
什么时候用哪个词,综述收成三行。实体之间存在不同类型的关系,用多层网络,例如每种社会网络一层。需要把语义不同或已经存在的模型接进同一次仿真,用多层建模,例如烟火扩散和行人行为。需要在精度和运行时间之间取舍,或者同时需要粗和细的表示,用多尺度,例如只把市中心和拥堵路段写成细粒度。
精度是跨领域的限制。综述用garbage in, garbage out来概括:多层建模可以让人在需要的地方选择细节,但真实参数和工作负载仍要单独选择。社会科学以数据为核心,采集尤其重要。疫情研究可以使用来自真实地区的传染率、恢复率,并配上区域之间的真实移动;交通和人群则常常把合成信息与道路、地理、人的存在混在一起。综述强调工作负载的刻画和验证,没有在这里比较哪一组参数更接近实测。
这些数字和搭配不能推出什么
127篇是按相关性取前40条、再加人工程引用和4篇已知论文之后的集合,不是这六个检索词在四个库中的全部文献。大约250、大约40%和10%不能当成精确漏斗。电子图书馆对更老和更新的论文都有覆盖不足,图3里的上升要连着这句话读。
地区份额的分母是127篇论文。EU这个标签包含非欧盟国家,USA这个标签和含加拿大的北美洲定义并排出现在同一节。图4能支持疫情主题的作者份额主要来自USA和EU、交通主题由EU占优;它没有给出各块的百分数,也没有把按年的地区—主题交叉表印出来。
图2的图题和随后一句正文指向检索来源,饼图本身是期刊、会议和书章。正文里的23.83%与29/127、以及饼图上的22.8%对不上。结论中的125与分类中的127并排存在。表3、表4的标题与行内容互换,表5对两篇城市扩张论文的方法标注与正文段落不一致,表8的人口动态与同节正文用了不同的模型族。这些不一致留在原处,不在复述时抹平。
125.4辆车是取整问题的说明性例子。10分钟对5秒、更新间隔120步,是溃坝案例里两个模型的时间尺度。它们都不是这篇综述新跑出来的误差或实验。
搭配是这批文献里反复出现的设计,不是唯一合法的设计,也不是对某座城市的预测。仓室输出、流量方程和回归层级都不是直接观测。相关变量被放进同一回归,不能写成这篇综述已经识别了因果。ABM在信息不足时可以做假如式分析,试错结果仍是模型里的结果。公开代码少,意味着图6里的红色占优是这批论文的可重复性状况,不能改写成这些模型因此无效。
一句话总结
多出来的那一层,要看交接的是什么:更细的尺度、另一件语义不同的事,或另一种社会关系,三者都能出现在人类移动性的模拟里,但车辆数、速度和状态不会因为已经分层就自动对齐。
核心来源
- Simulation Modelling Practice and Theory, 127 (2023) 102780。正式版,2023年5月26日在线发表。题目、作者、DOI、收稿日期和正文图表均按该PDF核对。
- 论文脚注给出所评文献的数据页:https://pads.cs.unibo.it/doku.php?id=multiscale。正文数字不依赖该页。
- 作者介绍中Serena的学位论文信息来自博洛尼亚大学学位论文库记录:https://amsdottorato.unibo.it/id/eprint/11883/。
作者介绍
- Luca Serena:通讯作者,署名为博洛尼亚大学计算机科学与工程系。博洛尼亚大学学位论文库收录其2025年博士论文,研究多层建模与仿真的方法与应用,导师为本文作者Moreno Marzolla,合作导师为Gabriele D’Angelo。
- Moreno Marzolla:博洛尼亚大学计算机科学与工程系,以及跨系工业研究中心ICT。论文脚注写明,其部分经费来自INdAM-GNCS,以及下一代欧盟计划中的ICSC国家高性能计算、大数据与量子计算研究中心。
- Gabriele D’Angelo:与Marzolla同样署名为博洛尼亚大学计算机科学与工程系和跨系工业研究中心ICT。
- Stefano Ferretti:乌尔比诺卡洛博大学纯科学与应用科学系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市的数字孪生只在事故路段切换到微观,值得同时记账的不只是局部速度。一辆已经在微观层选定路线的配送车,一旦被收成密度,再分解回来时可能变成一辆没有原路线的普通车。可以设计一次只检查守恒的试验:来回切换许多次,看区域车辆总数、以及每辆车所服务的目的地清单是否还在。125.4这个例子说明整数车辆会漂;目的地清单会不会一起丢,是另一项独立的检查。
疫情与移动耦合时,还要先写清被交过去的那个机会是按一次接触、一次出行,还是按一天计算。宿主内过程可以是小时尺度,通勤图可能一年才更新一次。两边都叫概率时,数值仍可能对不上同一种事件。这不是把某一疾病的速率填进公式,而是在两层握手之前,先把事件的时间单位写成接口的一部分。