一天只去几个地方,为什么连法却高度重复?
论文名片|Christian M. Schneider、Vitaly Belik、Thomas Couronné、Zbigniew Smoreda、Marta C. González,Unravelling daily human mobility motifs,Journal of the Royal Society Interface,2013,10:20130246。DOI:10.1098/rsif.2013.0246。本文依据该刊正式版解读。PDF 首页写明 2013 年 3 月 18 日收稿、2013 年 4 月 15 日接受。
早上有人只在家和单位之间来回,有人下班以后连着办几件事再回家。把一天到过的地点当成点,把有方向的行程当成边,这两天会画出不同的小网络。若每个人都在随意组合地点,可行的连法会随地点数急剧变多。这篇论文要问的是:真实工作日里,这些小网络是散成无数种,还是反复落在少数几种形状上;一个人过几个月,还守不守得住自己的那一种。
方向性结论:工作日的地点网络高度集中。作者把平均出现频率超过 0.5% 的每日网络称为模体(motif)。调查和手机数据里,这样的模体只有 17 种。摘要说它们最多覆盖 90% 的人口,正文说最多 90% 的实测出行可以用这 17 种每日网络描述。要再现地点数的分布,关键是外出活动会连成一段,而不是在一天里均匀发生。
先说结论
- 芝加哥调查、巴黎调查和巴黎手机数据里,一天到访地点数都可以用同一条对数正态近似。正文给出的参数是 μ = 1 ± 0.1、σ = 0.5 ± 0.1;图上画出的曲线用 μ = 1、σ = 0.5。平均地点数约 3。90% 的人每天到访地点少于 7 个;图 2 图注另写,大多数人少于 5 个,调查中有人一天报到 17 个。
- 不加出行约束时,N 个地点的有向连法有 2 的 N(N−1) 次方种。加上从同一地点出发并回到该点、且每个地点至少到过一次之后,N = 6 仍有 1,047,008 种可行网络。平均频率超过 0.5% 的只有 17 种。摘要里这 17 种最多对应 90% 的人口,正文里最多对应 90% 的实测出行。
- 这 17 种大多能收成四条巡回规则。数据里没有“N 个地点、行程却多于 N+2 条”的模体。除编号 5 和 9 外,每种最多一个中心地点。
- 稳定性只用巴黎手机用户检验,因为调查最多记录两天。六个月里,同一种模体再次出现的机会,通常是按总体频率独立抽取的 10 到 30 倍。
- 模型把一天分成 48 个 30 分钟槽。人已经在外时,下一槽继续外出的概率设为居家时的 10 倍。这个放大去掉以后,地点数分布从近似对数正态变成二项分布,并出现调查中没有的星形网络。
为什么先丢掉距离、目的和停留时长?
既有研究已经用三件东西描述较长时间的人类移动性:全体出行的距离分布 p(r)、个人在时段 t 内的回转半径 rg(t),以及到过的地点数 S(t)。论文引用的结果是,p(r) 近似 r 的 −1.59 次方;S(t) 近似 t 的 0.6 次方。这些数字来自被引用的研究,不是本文重新估计的。本文指出,24 小时以内,S(t) 的这个指数并不稳;回转半径也要观察几个月才稳定。所以日内、城市内部的机制不能直接沿用长周期模型。
日内数据若要比较不同城市、不同采集方式,就得先丢掉彼此没有的信息。作者把一天收成有向网络:点是到过的地点,边只保留“从这里去了那里”。活动目的、路程、停留多久、同一方向走了几次,都不进入权重。这样,巴黎调查只有行程长度、没有坐标,也能和芝加哥调查、巴黎基站轨迹放在一起比形状。代价同样明确:同一种模体可以对应很远或很近的两组地点,模体频率不能换算成公里数。
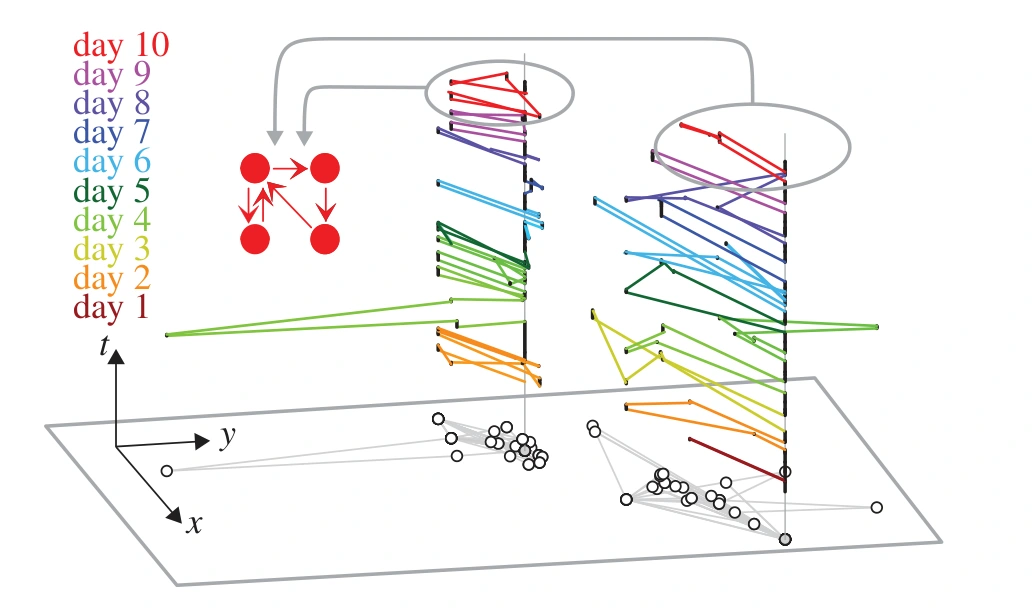
图 1|十天叠在一起很乱的轨迹,拆开每一天后还有没有共同形状?
图中是两名匿名手机用户。纵轴 t 从下到上由棕到红,对应第 1 天到第 10 天;灰线把每人的家在十天里连起来,底面上的灰线是十天轨迹的投影。左上红色小图是最后一天的网络。左用户十天合计 16 个地点、37 条边,平均度 2M/N = 4.6;每天平均 4.4 ± 1.8 个地点、5.3 ± 2.8 条边。右用户合计 22 个地点、43 条边,平均度 3.9;每天平均 3.9 ± 1.3 个地点、4.2 ± 2.2 条边。论文把 ± 直接写出,没有说明是标准差还是别的散布。左用户更像先通勤到一处,再在一次巡回里访问其余地点;右用户更像把当天地点放进一次巡回。最后一天两人都是四个地点,而且是同一种每日网络:两条巡回,分别带 1 个和 2 个目的地。来源:原论文 Fig. 1。
这个例子只说明“多天合成的大网络”和“一天一张小网络”不是同一个对象。后面的统计要回答,这种小网络在人群里有多少种。
一天到底会去几个地方?
三套数据都只保留工作日。芝加哥和巴黎的活动—出行调查分别使用 23,764 个和 23,429 个工作日,论文称其代表两座城市的全体人口。这里的分母是工作日,不是受访者人数。芝加哥每人填写一整天或两整天,因此 23,764 不能读成 23,764 个人。巴黎调查有行程长度,没有地理坐标。
手机数据来自巴黎数百万用户的通话和短信账单,位置是基站。作者只分析最活跃的 39,820 人,观察期六个月、154 天。一天从凌晨 3 点起,切成 48 个 30 分钟槽。整段观察期里到访频率低于 0.5% 的基站被去掉;同一天内来回切换超过 3 次的相邻基站被合并;下一条记录若不在同一基站,这条记录不计入停留。每个槽只保留出现最多的位置。有位置信息的槽少于 8 个,这一天就丢弃。家是该用户所有夜晚 0 点到 6 点最常出现的位置;若凌晨 3 点和 3 点半没有记录,这一天就从这家出发并回到这家。论文用调查检验过这条家的规则:对调查中的单日家庭位置,识别正确的比例超过 98%。正文称换掉“至少 8 个槽”这一阈值后结果仍然稳定,但没有列出试过的其他阈值。保留下来的手机工作日总数,正文也没有给出。
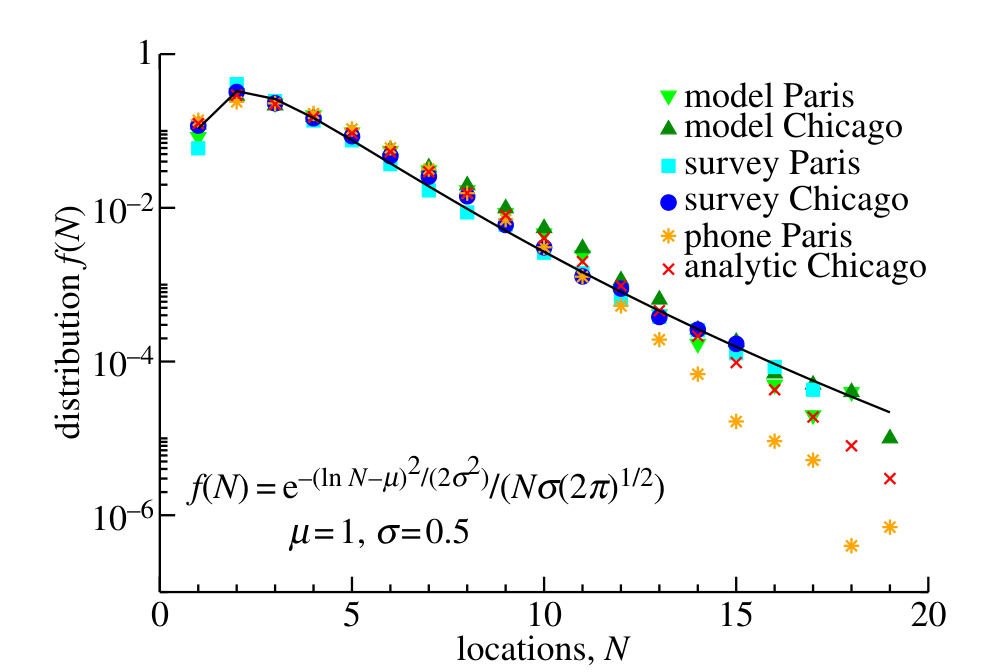
图 2|一天到访的地点数,三套数据和模型是否落在同一条曲线上?
横轴是一天的地点数 N,纵轴是分布 f(N),对数刻度。青色方块为巴黎调查,蓝色圆点为芝加哥调查,橙色星号为巴黎手机数据,绿色三角为两座城市的扰动模型,红色叉号为芝加哥的解析结果。黑线是 μ = 1、σ = 0.5 的对数正态。几套数据在小数目处叠在一起,峰值靠近两三个地点;N 较大时手机数据落到调查和模型下方。图注说明,这是手机数据的限制,调查则报到最多 17 个地点。来源:原论文 Fig. 2。
正文把这条分布写成对数正态,参数带 ±0.1 的余地,并给出平均地点数约 3,以及 90% 的人每天少于 7 个地点。图注的“大多数人少于 5 个”和正文的“90% 少于 7 个”是两句不同口径的话,都没有附分组频数表。曲线相似说明地点数的多寡在这三套数据里相近;它还不说明地点之间怎么连。
可行的连法远比人真正在走的多,17 种是怎么定出来的?
N 个地点之间,若不加任何出行约束,每条不含自环的有向边都可以有或没有。这样的有向连法一共有 2 的 N(N−1) 次方种,论文写成 Np(N) = 2^(N²−N)。
人的一天还要满足两件事。睡觉使行程从同一地点出发并回到该点,这个点多半是家。行程要自洽,N 个地点每一个至少被访问一次;因此 N 大于 1 时,每个点至少有一条进入的边和一条离开的边。满足这两条的可行网络数 Nf 仍涨得很快:N 从 1 到 6 依次是 1、1、5、83、5048、1,047,008。
作者没有拿随机打乱的网络当零模型。他们写明,移动网络的随机化版本不可行,所以这里的模体不是“比随机网络更常出现的子图”。操作定义是:在这些数据里平均出现频率超过 0.5% 的每日网络。按这个门槛,17 种就够用。摘要写的是最多覆盖 90% 的人口,正文写的是最多 90% 的实测出行,图 3 图注写的是最多 90% 的已识别每日移动网络。正文没有按城市或按数据源分开列出这个百分比。
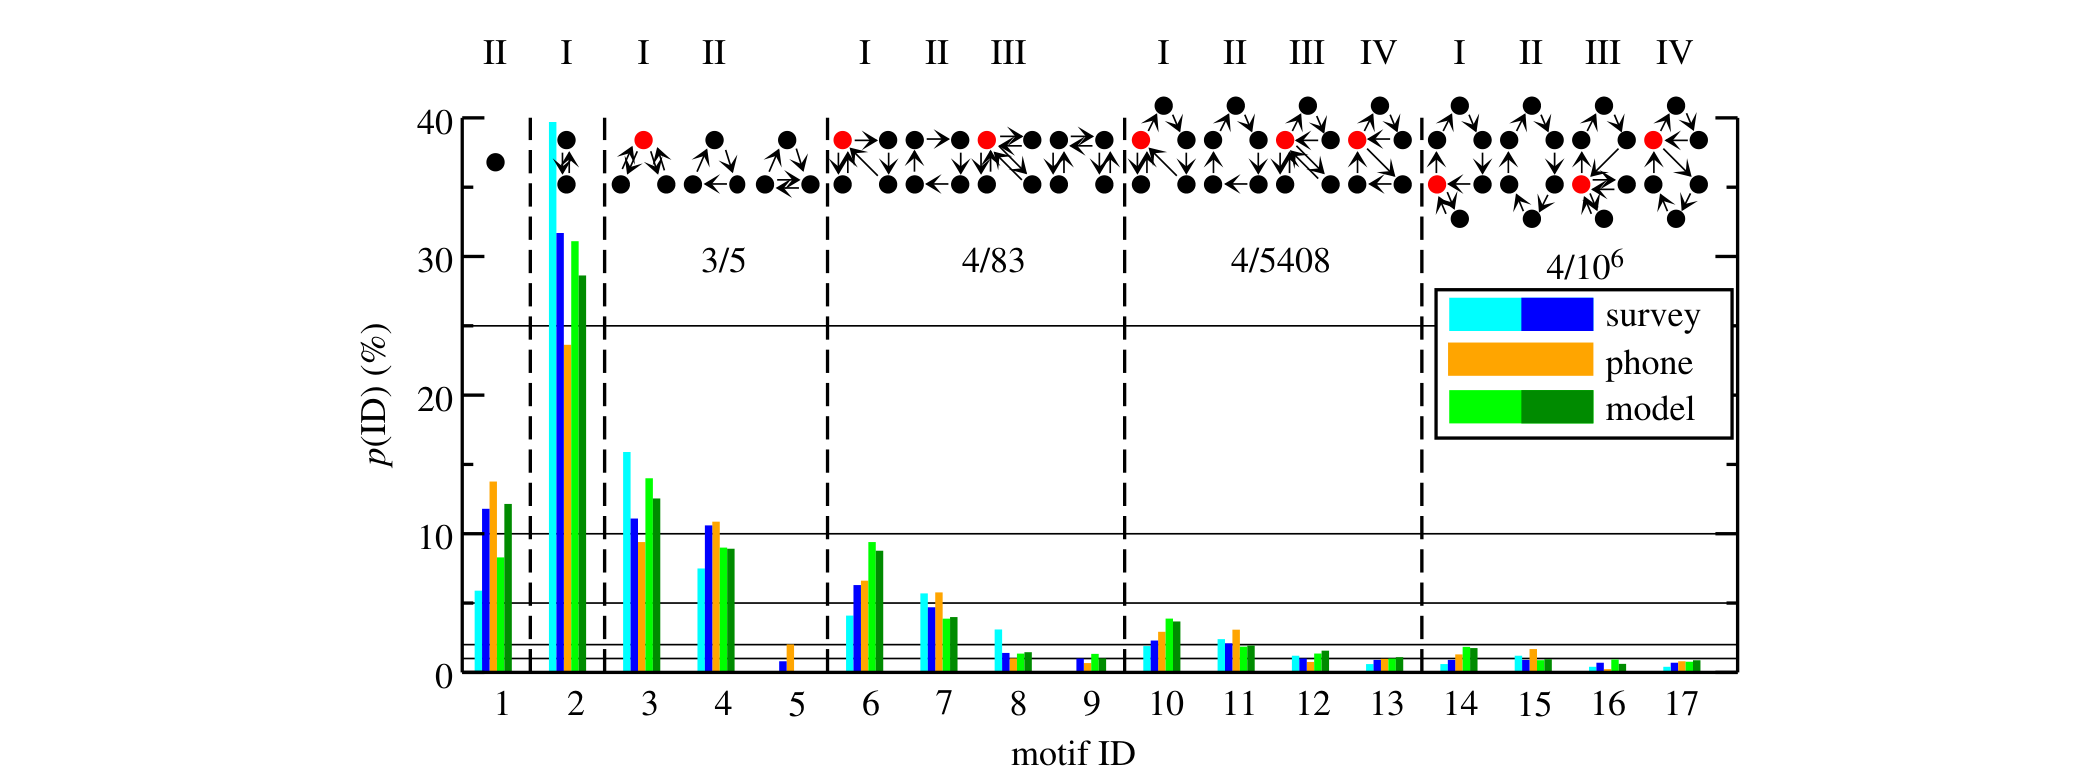
图 3|17 种每日网络各自占多少,四条规则标在哪几种上面?
纵轴 p(ID) 是该模体占每日网络的百分比,刻度到 40。青色是巴黎调查,蓝色是芝加哥调查,橙色是巴黎手机数据,浅绿和深绿分别是巴黎与芝加哥的模型。虚线按地点数把 17 种分开,红点是中心地点。上方罗马数字是规则编号。各组分数是该组观察到的种数除以可行种数。
编号 1 是单个地点,上方为规则 II。编号 2 是两个地点、两条方向相反的行程,上方为规则 I,也是最高的一组柱;巴黎调查接近 40% 刻度,芝加哥调查和模型低于它,巴黎手机数据再低一截。正文没有列出每根柱的精确百分数。编号 3 到 5 是三个地点,分数 3/5。编号 6 到 9 是四个地点,4/83。编号 10 到 13 是五个地点,图上印的是 4/5408。编号 14 到 17 是六个地点,4/10^6。编号 5 和 9 有两个红点,上方没有罗马数字。来源:原论文 Fig. 3。
正文枚举的可行数是 Nf(5) = 5048,图上这一组印的却是 4/5408。两处数字不一致,这里分别按正文和图面保留。N = 6 的 4/10^6 则是 4 / 1,047,008 的图面写法。最常见的是编号 2,其次是只有一个地点的编号 1,再往后是编号 3 和编号 4。编号 3 是三个地点、四条行程,每次都从同一地点出发并回到该点;编号 4 是一次环游。
巡回 T(x) 的定义是:从起点出去,访问另外 x 个地点,再回到起点,且 x 小于 N。四条规则是:
- I:一条只停 1 个其他地点的巡回,加上一条停 N−2 个其他地点的巡回。
- II:只有一条巡回,访问其余 N−1 个地点。正文的符号是 T(N−1)。图注写成 “a single tour with N stops”。若把起点也算进停点,两种说法指的是同一种环游。
- III:两条只停 1 个其他地点的巡回,再加一条停 N−3 个其他地点的巡回。
- IV:一条停 2 个其他地点的巡回,再加一条停 N−3 个其他地点的巡回。
某条规则若要求访问负数个地点,这种模体就不允许;若算出 0 个地点,就忽略这条空巡回。因此 N = 2 的规则 I 只剩下一条来回。规则 III 的行程条数是 N+2,是四条规则里最多的。这和观察一致:任一数据集中都没有 N 个地点却多于 N+2 条行程的模体。N 不小于 6 时,一天的巡回上限是三条,地点再多,增加的是某一条巡回内部的停点。正文还说,超过六个地点的常见每日网络也服从这些规则,计数放在电子补充材料里。
中心地点指有向边多于两条的点。除编号 5 和 9 外,每种模体最多一个中心。只有一个中心时,每条边恰好属于一条巡回,整张图可以沿每条边走一次并回到起点。图注写明两座城市的工作人数差得很明显,正文没有给出这个人数;模体的排序和出现概率仍然相近。
调查里,不算同一条有向边走多次的模体,已能正确再现超过 95% 的出行行为;T(x) 在 x 大于 1 时,一天只走一次。95% 的分母是调查中的出行行为,具体计数在补充材料。因此模体描述的是一天的连法,不是“同一条路在一天里的重复次数”。
同一个人过几个月,还是同一张图吗?
调查最多两天,看不出一个人是否长期重复同一种模体。这部分只用手机数据,观察期六个月。比较对象不是另一个城市,而是按图 3 的总体频率为这个人随机抽取模体。记 N(i) 为观察到的编号 i 的次数,Nr(i) 为按总体频率得到的期望次数。两者乘积高于期望时,相关 Cij 等于观察比上期望再减 1;低于期望时,Cij 等于 1 减去期望比上观察。正值表示比独立抽取更常一起出现。
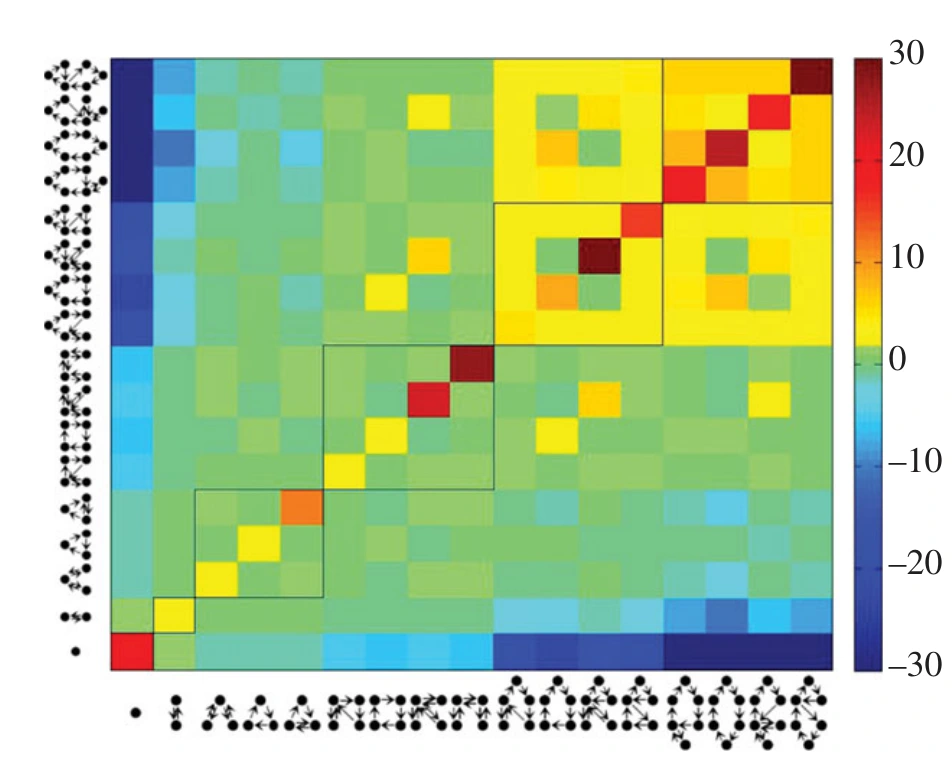
图 4|已知某天的模体,另一天更可能回到哪一种?
横纵轴都按图 3 的 17 种模体排列,左侧和底边是对应的小网络。颜色由公式 (2.3) 算出,色标从 −30 到 30:黄到红比期望更高,青到蓝被压低。方框标出地点数相同的模体。对角线最暖,表示最容易再次出现同一种。地点数只差大约 2 个时,格子接近平均;差得更大时变蓝。一天超过 4 个地点的人,在其他天也更常落到超过 4 个地点的模体;地点少的人保持地点少。来源:原论文 Fig. 4。
正文给出的倍数是:自相关通常是按总体分布独立抽取的 10 到 30 倍。色标的 30 与这个上限同一量级,但图中没有逐格数值表。同一条规则、地点数不同的两种模体之间相关偏高,例如都是一次把当天地点走完的巡回。巡回条数相差超过一条时相关偏低,规则 II 和规则 III 之间就是这样。
由此能说的是:在这 39,820 名最活跃用户的工作日里,一个人有自己偏好的每日地点数和连法,具体地点仍可以换。它不能推出全体巴黎人,也不能推出调查受访者在几个月后同样稳定,因为调查没有这么长的重复观察。模型本身也只生成单独一天,没有把这种跨天相关做进去。
外出为什么会挤成一段,而不是均匀撒在一天里?
地点数和模体频率都很集中,作者接着看时间。数据仍是两座城市的调查。活动分成家、工作和其余地点。比较两件事:一次停留持续多久;同一种活动两次开始之间隔了多久,且中间去过别的地点。
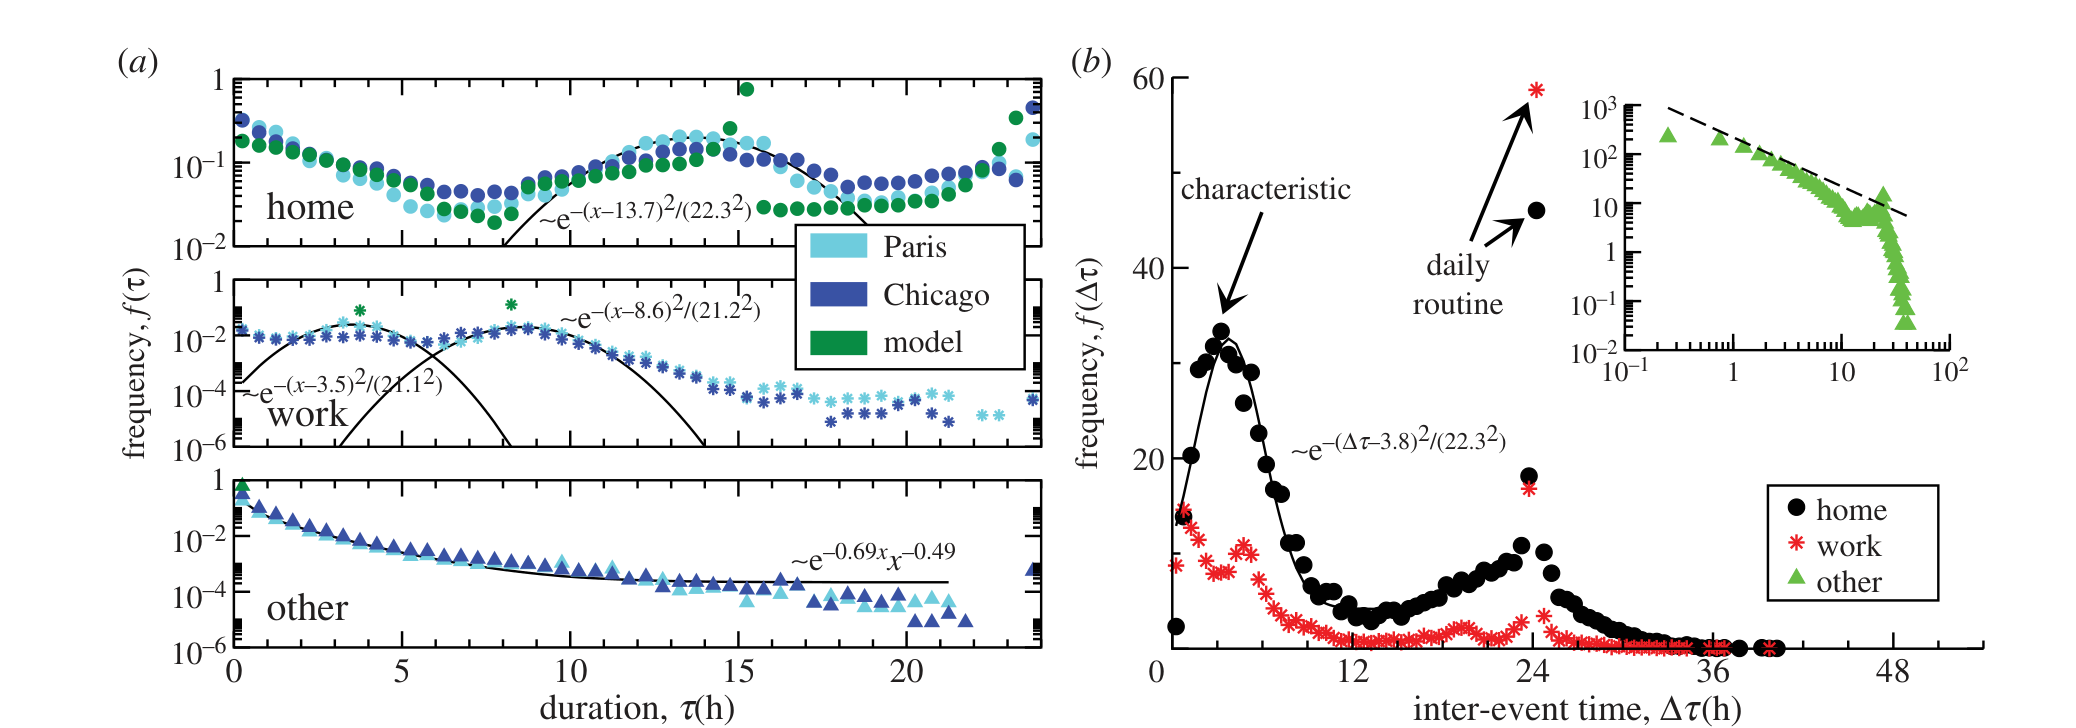
图 5|家、工作和其他地点的停留与间隔,哪里有固定时长,哪里没有?
(a)纵轴是停留时长的频率 f(τ),对数刻度;横轴是小时。上、中、下三块分别是家、工作和其他地点。青色为巴黎,蓝色为芝加哥,绿色为模型。家的分布较平,图上的高斯参考曲线中心在 13.7 小时,分母排成 2×2.3²。工作有两处峰,中心分别在 8.6 小时和 3.5 小时,分母分别是 2×1.2² 和 2×1.1²。其他地点随时长下降,参考曲线是 e^(−0.69x) 乘以 x 的 −0.49 次方。正文把这些特征时长概括为家里约 14 小时,工作约 3.5 和 8.6 小时。
(b)横轴是两次同类活动开始的间隔 Δτ,纵轴是频率,线性刻度到 60。黑圆点是家,红星是工作,绿三角是其他地点。家在几小时处有一个标为 characteristic 的峰,高斯中心为 3.8 小时、分母同样是 2×2.3²;24 小时附近另有每日作息的峰。工作在大约 24 小时处达到全图最高的一簇点。其他地点的间隔分布很宽、短间隔多,右上插图在双对数坐标里用指数为 −1 的幂律作参照。来源:原论文 Fig. 5。
这些高斯和幂律是图上的目视参考,不是从效用函数推导出来的停留定律。家和工作有特征时长,其他地点没有;其他地点的下一次访问也更常紧挨着上一次。作者由此认为,地点更换不是均匀撒在一天里,而是成串出现,中间隔着不外出的时段。调查最长只有两天,图 5b 的间隔分布有没有更重的长尾,正文明确写成尚未解决。
放大下一时段的外出概率,对数正态还在吗?
模型先写非工作代理人。家是固定活动,购物、游憩等是可灵活安排的活动。人偏好待在家;一组灵活活动做完,若没有下一件,就回家。已经出门时,接着再做一件灵活活动的可能更高。工作代理人只在补充材料里作了少量补充,正文没有展开。
一天分成 K = 48 个 30 分钟槽。槽的数目本身不重要,只要大于 20。夜间先留出 9 小时睡眠,其余槽起初都空着。每个槽按概率 pNW(t) 收到一件任务,并排到下一个空槽。这个概率跟着全体人口的手机活动昼夜节律 p(t) 走,24 小时内的积分等于参数 γNW。γNW 的数值在补充材料,正文没有写出。关键设定是:若这一槽按 p(t) 接到任务,下一槽的概率变成 α p(t+1),且 α 大于 1。为了简单,作者取 α = 10,也就是放大一个数量级。模型不事先规定任务在哪些坐标、一共几次出行;γNW 控制平均地点数,工作与非工作代理人的比例另行给定。这个比例的具体数值,正文也没有列出。
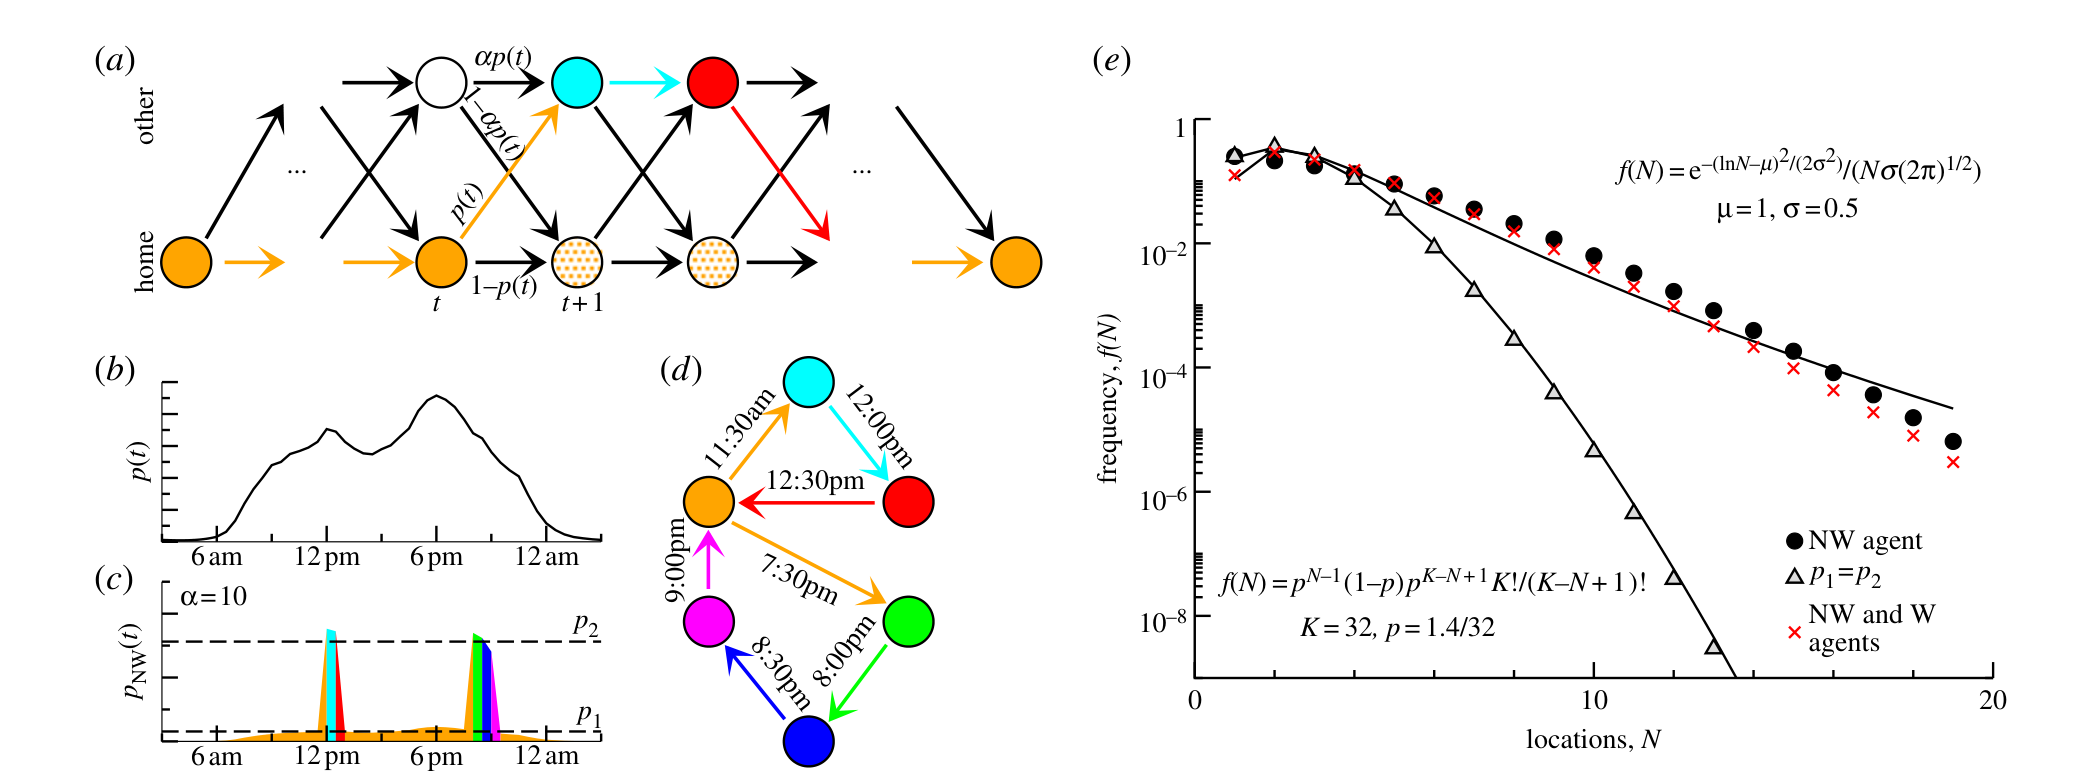
图 6|非工作代理人怎样从昼夜节律走到一张每日网络?
(a)下面一排是家,上面一排是其他地点。人在家时,下一槽留在家的概率是 1−p(t),出门是 p(t);已经在外时,再去另一处的概率是 αp(t),回家是 1−αp(t)。着色路径是一个例子,一天从家开始也在家结束。
(b)p(t) 是全体人口手机活动的昼夜节律,从早上 6 点画到午夜,白天有两个隆起。
(c)α = 10 时,pNW(t) 大部分时间贴着较低的 p1,在中午和傍晚出现贴近 p2 的尖峰。解析时把这两个高度当成常数,p2 = 10 p1。
(d)把例子中的停留换成模体。图上标出的时刻包括上午 11:30、中午 12:00 和 12:30,以及晚上 7:30、8:00、8:30 和 9:00。图注写明这张图有 6 个地点、7 条行程。
(e)横轴是地点数,纵轴是频率,对数刻度。黑圆点只有非工作代理人,红色叉号同时有工作和非工作代理人,两者都贴近 μ = 1、σ = 0.5 的对数正态。空心三角是 p1 = p2,也就是拿掉成串外出;它下降快得多。旁边的闭式用 K = 32、p = 1.4/32。来源:原论文 Fig. 6。
这里有两个不同的 K。模拟一天用 48 个槽;图 6e 那条对照曲线印的是 K = 32。图注认为槽数大于 20 以后,具体个数不改变要说明的形状。
解析做法是把“留在家或回家”和“去新地点”看成一串成功概率不相同的抛硬币,再用有限马尔可夫链嵌入写出访问 N 个地点的概率。转移矩阵的具体写法在补充材料。图 2 的 analytic Chicago 是这条解析结果。图 6 图注说,解析模型和数值模型在地点数分布上的绝对差小于 0.01。
图 6e 里,去掉工作代理人几乎不改变分布的尾部;去掉扰动、令 α = 1,近似对数正态就变成二项分布。正文还说,这时会出现调查中没有的、大多呈星形的网络。因此,被模型说明的是成串活动这一条,不是“有没有上班族”这一条。家、工作和其他地点之间的出行比例,模型的绝对误差最多 2%,分项表在补充材料。停留时长的主要峰能对上;间隔分布只共享一部分形状。因为其他活动的时长被固定,而且模型只有单独一天,它不能准确再现观察到的间隔分布,这一点正文写明,并指向补充材料。
这些结果能说到哪一步
17 种模体是频率门槛筛出来的常见网络,加上两座城市、三种数据源里的排序相近。它不是对一切有向网络作显著性检验,也不是证明只存在这 17 种走法。超过 0.5% 的才进入图 3,更少见的网络正文指向补充材料,没有在这里逐一画出。
手机样本是最活跃的 39,820 人,位置是基站,没有通话或短信的时段会被丢掉,所以大地点数的尾巴比调查更薄。调查的 90% 和手机数据的 90% 因此不是同一种观测下的同一批人。模体丢掉了距离,不能代替回转半径或出行里程。跨天稳定性只在手机用户中量到;模型又故意只做一天,所以“每个人有稳定模体”是观察,“α = 10 的扰动产生地点数分布和模体频率”是单日机制。两件事在论文里都成立,它们还没有被接成同一个多日模型。
α = 10 是选定的一个数量级,正文没有报告对 α 的扫描。工作代理人比例和 γNW 也没有在正文给出数值。相关矩阵说明同一个人偏向重复自己的模体,不能据此说模体导致了某种活动目的。
一句话总结
工作日之所以只反复出现十几种地点网络,是因为大多数人每天只在很少的地点之间走有限几条巡回,而且灵活的外出会连成一段,而不是均匀散在全天。
核心来源
Schneider C. M., Belik V., Couronné T., Smoreda Z., González M. C. Unravelling daily human mobility motifs. Journal of the Royal Society Interface, 2013, 10: 20130246. DOI:10.1098/rsif.2013.0246。
芝加哥调查在论文中写明为 Travel Tracker Survey。模体识别和扰动模型的 C++ 代码,论文给出的发布页是 humnetlab.mit.edu/downloads。电子补充材料与论文同一 DOI,不在这份 8 页正文 PDF 里。
Christian M. Schneider 是通讯作者,论文列出的邮箱为 schnechr@mit.edu,署名单位是麻省理工学院土木与环境工程系。2013 年麻省理工学院关于这项研究的新闻稿称他为第一作者、该系博士后,并引述他把这一模型称为扰动模型。
Vitaly Belik 的署名单位是麻省理工学院土木与环境工程系,以及哥廷根马克斯·普朗克动力学与自组织研究所。论文致谢写明他获得大众基金会资助。
Thomas Couronné 与 Zbigniew Smoreda 的署名单位都是 Orange Labs 的网络与服务社会学及经济学部门,地址在法国伊西莱穆利诺。巴黎的手机账单和调查比较是这篇论文的数据来源之一;方法部分没有另行写出运营商名称。
Marta C. González 的署名单位是麻省理工学院土木与环境工程系和工程系统部。同一篇麻省理工学院新闻稿称她为该系 Gilbert Winslow Career Development Assistant Professor,并称这项研究由她领衔。本文引用的 2008 年个体移动规律论文,作者栏中也有她。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
传染病模型若只给每个人家、工作和另外一个地点,覆盖的是编号 1 到 4 这一类最常见的日子。规则 III、IV 却允许一天里有多条巡回,中间停点并不都从家放射出去。对一个本来要在同一条环游里依次经过几个地点的人,把这些停点收成“家往外的星形”会改写他当天与谁相遇,即使一天的地点总数仍是三个。论文只指出既有模型常常最多放三个地点,没有比较这种改写会让传播模拟差多少。
拥堵收费若按每一次出行单独加价,和这篇模型的机制不完全对准。模型里,第一件灵活活动把下一槽的外出概率放大到 10 倍,后面几件是成串的。对“下班直接回家”和“已经在外、顺路再停一站”使用同一费率,改变的不是同一种决定。这只是从 α = 10 往政策上推的一步,论文没有估计费率。
模体相同也不表示交通负荷相同。图 1 里两名用户最后一天是同一种四个地点的网络,十天合计却分别是 16 个和 22 个地点,边数也不同。若规划模型只用模体频率分配道路流量,就会把这篇论文故意删掉的距离再悄悄加回去。模体适合压缩一天的选择顺序;里程和道路负荷仍要另用距离或回转半径。