市中心被低估、外围被高估时,市区和郊区还能共用一条引力公式吗?
论文名片|Yixuan Y. Zheng、Yohei Shida、Hideki Takayasu、Misako Takayasu,Enhancing the gravity model for commuters: Time-and-spatial-structure-based improvements in Japan’s metropolitan areas,PLOS One,2025,20(8):e0329603,2025年8月12日发表。DOI:10.1371/journal.pone.0329603。本文依据这一正式版及其补充材料 S1 解读。
一个人从 1 公里见方的格子出发去另一个格子上班。老的引力模型(gravity model)说:起点住的人越多、终点岗位越多,这条通勤越强;两地越“远”,通勤越弱。远近可以是地图上的直线距离,也可以是路上花的时间。
套到东京这类都市圈上,单一公式会在人口稀的地方把通勤估高,在人口密的地方把通勤估低。Zheng 等人因此把居住人数和就业人数各自切一刀,让市区和郊区使用不同的人口指数,时间指数仍然共用。他们把这个分段模型叫作空间分隔的都市引力模型(Spatially Segregated Urban Gravity,SSUG)。
在 2021 年工作日、日本六个大都市圈的手机定位通勤上,分段之后的流量重合高于不分段的距离模型和时间模型。重合提升主要出现在城区到城区的出行。阈值和指数是对这批数据的拟合,不是行政区界,也不是已经证明的个人选择。
先说结论
- 东京全部通勤的流量重合指数 CPC:直线距离引力模型为 0.27,正文另给 0.266;通勤时间引力模型为 0.37,正文另给 0.371;SSUG 为 0.41。CPC 的分子是两倍的“预测与观测里较小的那个流量”之和,分母是预测流量与观测流量之和,范围从 0 到 1。同一段正文还写过 SSUG 的 CPC 为 0.514,与图 2、表 2 和表 4 不符,下文不采用。
- 六个都市圈的总体 CPC 都是 SSUG 高于时间模型、时间模型高于距离模型。城区到城区的变化最大:札幌从时间模型的 0.16 到 SSUG 的 0.72。仙台的总体 SSUG 最低,为 0.34;补充图注写明仙台没有“市区居住且市区就业”的格网。
- 东京的居住阈值是每个 1 公里格网 12143 人,就业阈值是 11445 人。超过阈值的居住格网只占格网面积的 1.16%,就业格网占 1.92%。市区一侧的人口指数大于郊区一侧。正文把郊区起点指数印成 0.009,补充材料里的优化对照印成 0.09,两数不能当成同一个结果。
- 图例上东京的通勤最长:直线距离 14.7 公里、时间 39.9 分钟。时间统计截到 120 分钟,论文称由此覆盖超过 99.5% 的通勤时间数据。一条起讫点对使用的时间,是这对格子上观察到的最短行程,不是所有通勤者的平均时间。
这六座都市圈里,一条通勤是怎么数出来的?
研究对象不是跨城迁移,而是都市圈内部、工作日从家到第一个工作地的通勤。六个都市圈是东京、大阪、名古屋、福冈、仙台和札幌,论文按官方资料选取常住人口超过 200 万的地区。空间单位是 1 公里×1 公里格网。东京大约有 13000 个格网;表 3 里东京都市圈面积为 13564 平方公里,所以“格网个数”和“面积”并不逐格相等,水域和边界没有在正文逐项扣掉。
| 都市圈 | 面积(平方公里) | 常住人口(百万人) | GDP(万亿日元) |
|---|---|---|---|
| 东京 | 13,564 | 36.9 | 193.5 |
| 大阪 | 23,334 | 19.1 | 82.3 |
| 名古屋 | 21,570 | 11.3 | 57.1 |
| 福冈 | 4,987 | 5.1 | 19.5 |
| 仙台 | 7,282 | 2.3 | 9.6 |
| 札幌 | 3,036 | 2.4 | 8.7 |
表 3 没有写明 GDP 的年份。大阪的面积大于东京,用的是论文自己的都市圈范围,不是市町村建成区。
定位数据来自日本公司 Agoop 的点状人口数据,不能公开分享。正文先写全日本每天约 100 万智能手机用户,后又写六个研究区过滤之后每天约 1000 万匿名用户。若两句都按“每天的人数”理解,过滤后的子集不可能大于全国样本。本文同时保留这两句,不把它们合成一个样本量。可以单独使用的口径是:保留下来的每个用户、每个工作日平均 125 个轨迹点。
进入分析的条件有两条:当天定位点超过 100 个;家和工作地的市代码都落在目标都市圈内。研究期是 2021 年的工作日,去掉周末和节假日。用户编号每晚重置,不能把同一个人跨天连起来。供应商把居住地模糊到 1 公里格网,人口更少的地方模糊到 10 公里格网。论文改在 100 米格网上重新认家和单位,因为 1 公里按既往步行速度 1.1–1.4 米/秒,最多大约相当于 15 分钟,对通勤时间来说不能忽略。
家要同时满足:早上 5 点的第一条记录落在居住城市,并且当天在该格网停留超过 4 小时。单位要停留至少 5 小时、位于工作城市、且不是家所在格网。大约 3% 的人有多个单位或被格网边界切开,模型只保留离开家之后到达的第一个单位,保证一个人只贡献一条家—单位通勤。六个都市圈平均约 60% 的用户被标成通勤者。论文称这比总务省统计局的通勤率大约高 10%,没有给出统计局的原百分比,因此这里不把它改写成百分点。
手机样本少了老年人和 13 岁以下儿童。论文用每天 5 点的定位人数对照 2021 年 10 月各都道府县人口做重标定,并说比例见补充第 9 节。该节实际给出的是后文的散点:官方居住人口大约是 GPS 通勤居住者的 1.7 倍,没有逐府县的比例表。
直线距离和路上时间,量的是不是同一件事?
家到单位的距离,是两个格网中心的欧氏距离,也就是地图上的直线距离,不是道路里程,也不是票价。每个人的通勤时间,是家状态记录和工作状态记录之间的最短时间间隔。一条起讫点对上往往有很多人、多种交通方式和绕路。模型不用这些人的平均时间,而用其中最短的一次,写成 tᵢⱼ = min{tᵏᵢⱼ}。理由是通勤者倾向于把时间压短,而且最短时间较少把堵车和办事绕路算进“距离阻力”。
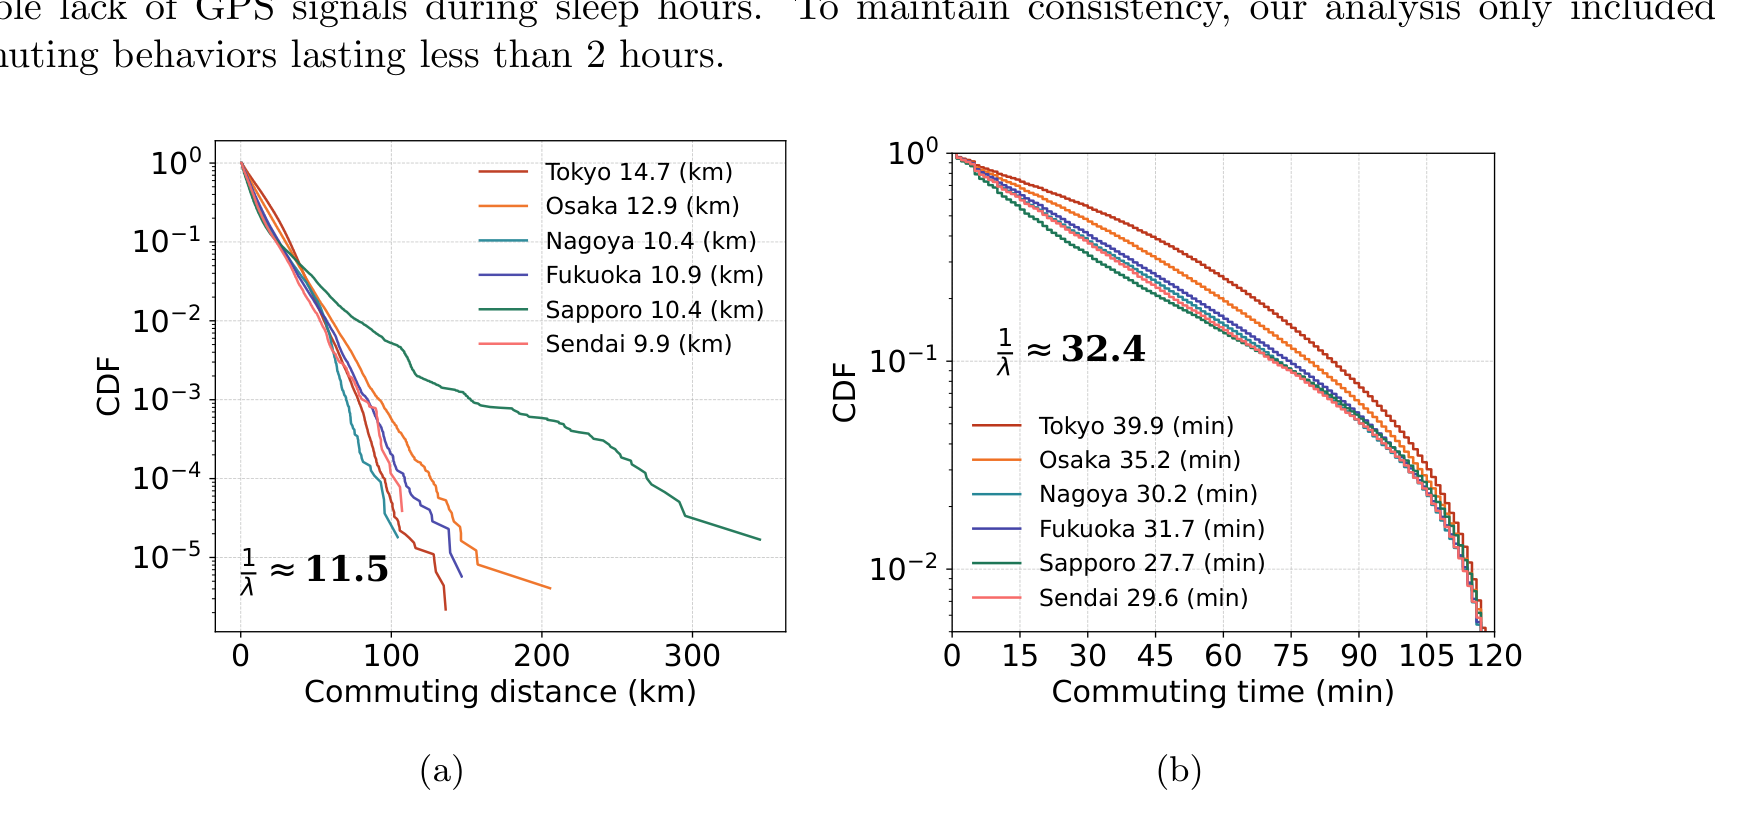
图 S3|六个都市圈的通勤有多远、花多久?
(a)横轴是家到单位的直线距离,纵轴标成 CDF。曲线从 1 向下降,读法接近“长于该距离的比例”,不是从 0 累加到 1 的普通累积分布。图例给出东京 14.7、大阪 12.9、名古屋 10.4、福冈 10.9、札幌 10.4、仙台 9.9 公里;正文只把东京的 14.7 公里明确称为平均值。图上另标 1/λ ≈ 11.5 公里,这是汇总曲线的特征尺度,不是东京均值。札幌的曲线在 100 公里以后仍高于其他城市。(b)横轴是通勤时间,上限 120 分钟。图例为东京 39.9、大阪 35.2、名古屋 30.2、福冈 31.7、札幌 27.7、仙台 29.6 分钟;正文明确称为平均值的是东京的 39.9 分钟。1/λ ≈ 32.4 分钟同样是汇总尺度。来源:补充材料 Fig. S3。
120 分钟这一刀保留了超过 99.5% 的通勤时间数据。论文没有写出被截掉的人数。东京 39.9 分钟短于论文所引总务省“户主平均 45.9 分钟”。该引文的链接指向 2000 年国势调查的通勤汇总,不是 2021 年的同期官方口径,所以 6 分钟之差不能单独当成定位数据偏短的证明。论文自己的解释还包括:样本含非户主,并且主动去掉了超过 2 小时的行程。
距离模型用的是直线距离的幂。SSUG 和时间模型用的是分钟尺度的时间。时间更贴近“还愿不愿意走这一趟”,但它仍是模型里的阻力项,不是观测到的感受。
人口一变,流量和人口的关系是不是已经折成两段?
单一引力公式在对数坐标上是一条直线:流量的对数等于常数,加上起点人口的对数、终点人口的对数,再减去时间的对数。如果市区和郊区的斜率不同,一条直线会把密集区的大流量当成残差。
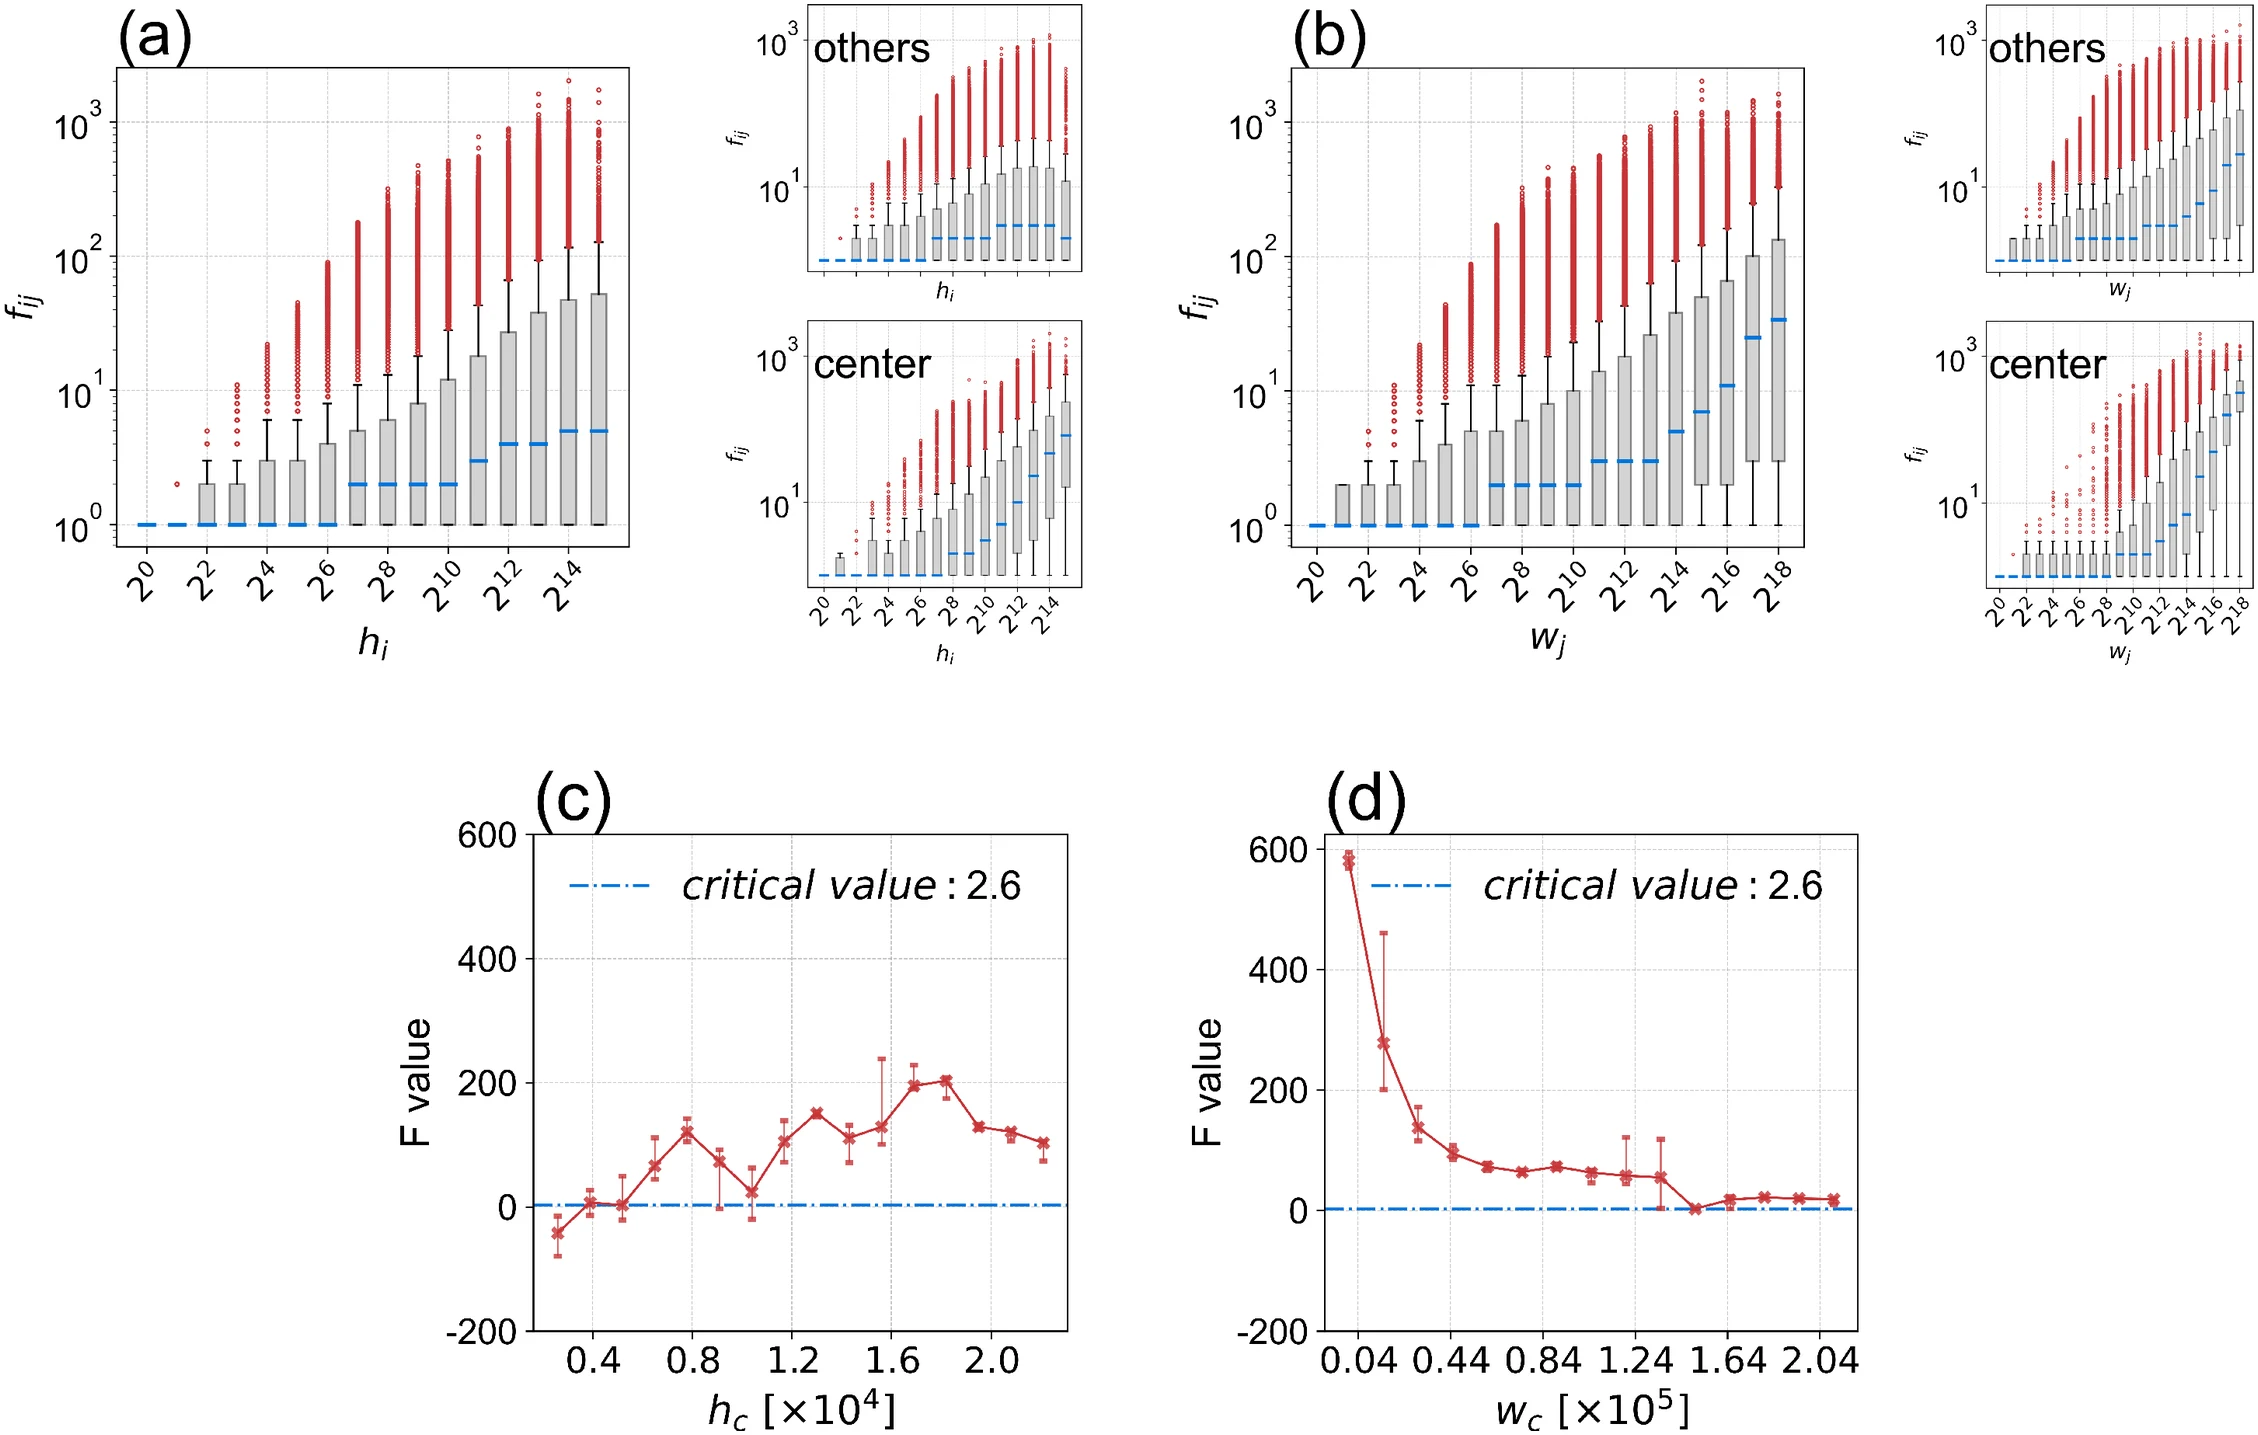
图 1|流量随人口上升时,有没有必要切成两段?
(a)横轴是起点居住人数 hᵢ,按 2 的幂分箱;纵轴是通勤流量 fᵢⱼ,对数坐标。箱线的蓝线是中位数,箱体约是四分位距,红点超出 1.5 倍四分位距。右侧小图把东京 23 区标为 center,其余标为 others。中心区的大流量更高。(b)横轴换成终点就业人数 wⱼ,读法相同:人口箱越大,流量的中位数和离群值越高,中心区更明显。(c)横轴是候选居住阈值 hᶜ,单位为万人;纵轴是比较“一条斜率”和“两条斜率”的 F 值。蓝色虚线标出临界值 2.6。多数点位于虚线之上,高点大约在 200 上下,并不是唯一尖峰。(d)横轴是候选就业阈值 wᶜ,单位为十万人。F 值在最左端接近图上 600 的顶端,随后下降,较大阈值处落到临界值附近。来源:原论文 Fig. 1。
F 检验的原假设是:切开之后,残差方差没有明显变小。显著性水平为 0.05,图上的临界值是 2.6。居住阈值的一大段、就业阈值的偏低一段,F 值都超过临界值,所以“存在某种两段结构”有统计支持。检验用的是最小二乘斜率,论文明确说这些斜率没有放进最终的 SSUG。最终阈值来自后面的贝叶斯优化。因此不能把图 1 里 F 最高的那个点,当成表 2 的 12143 和 11445。
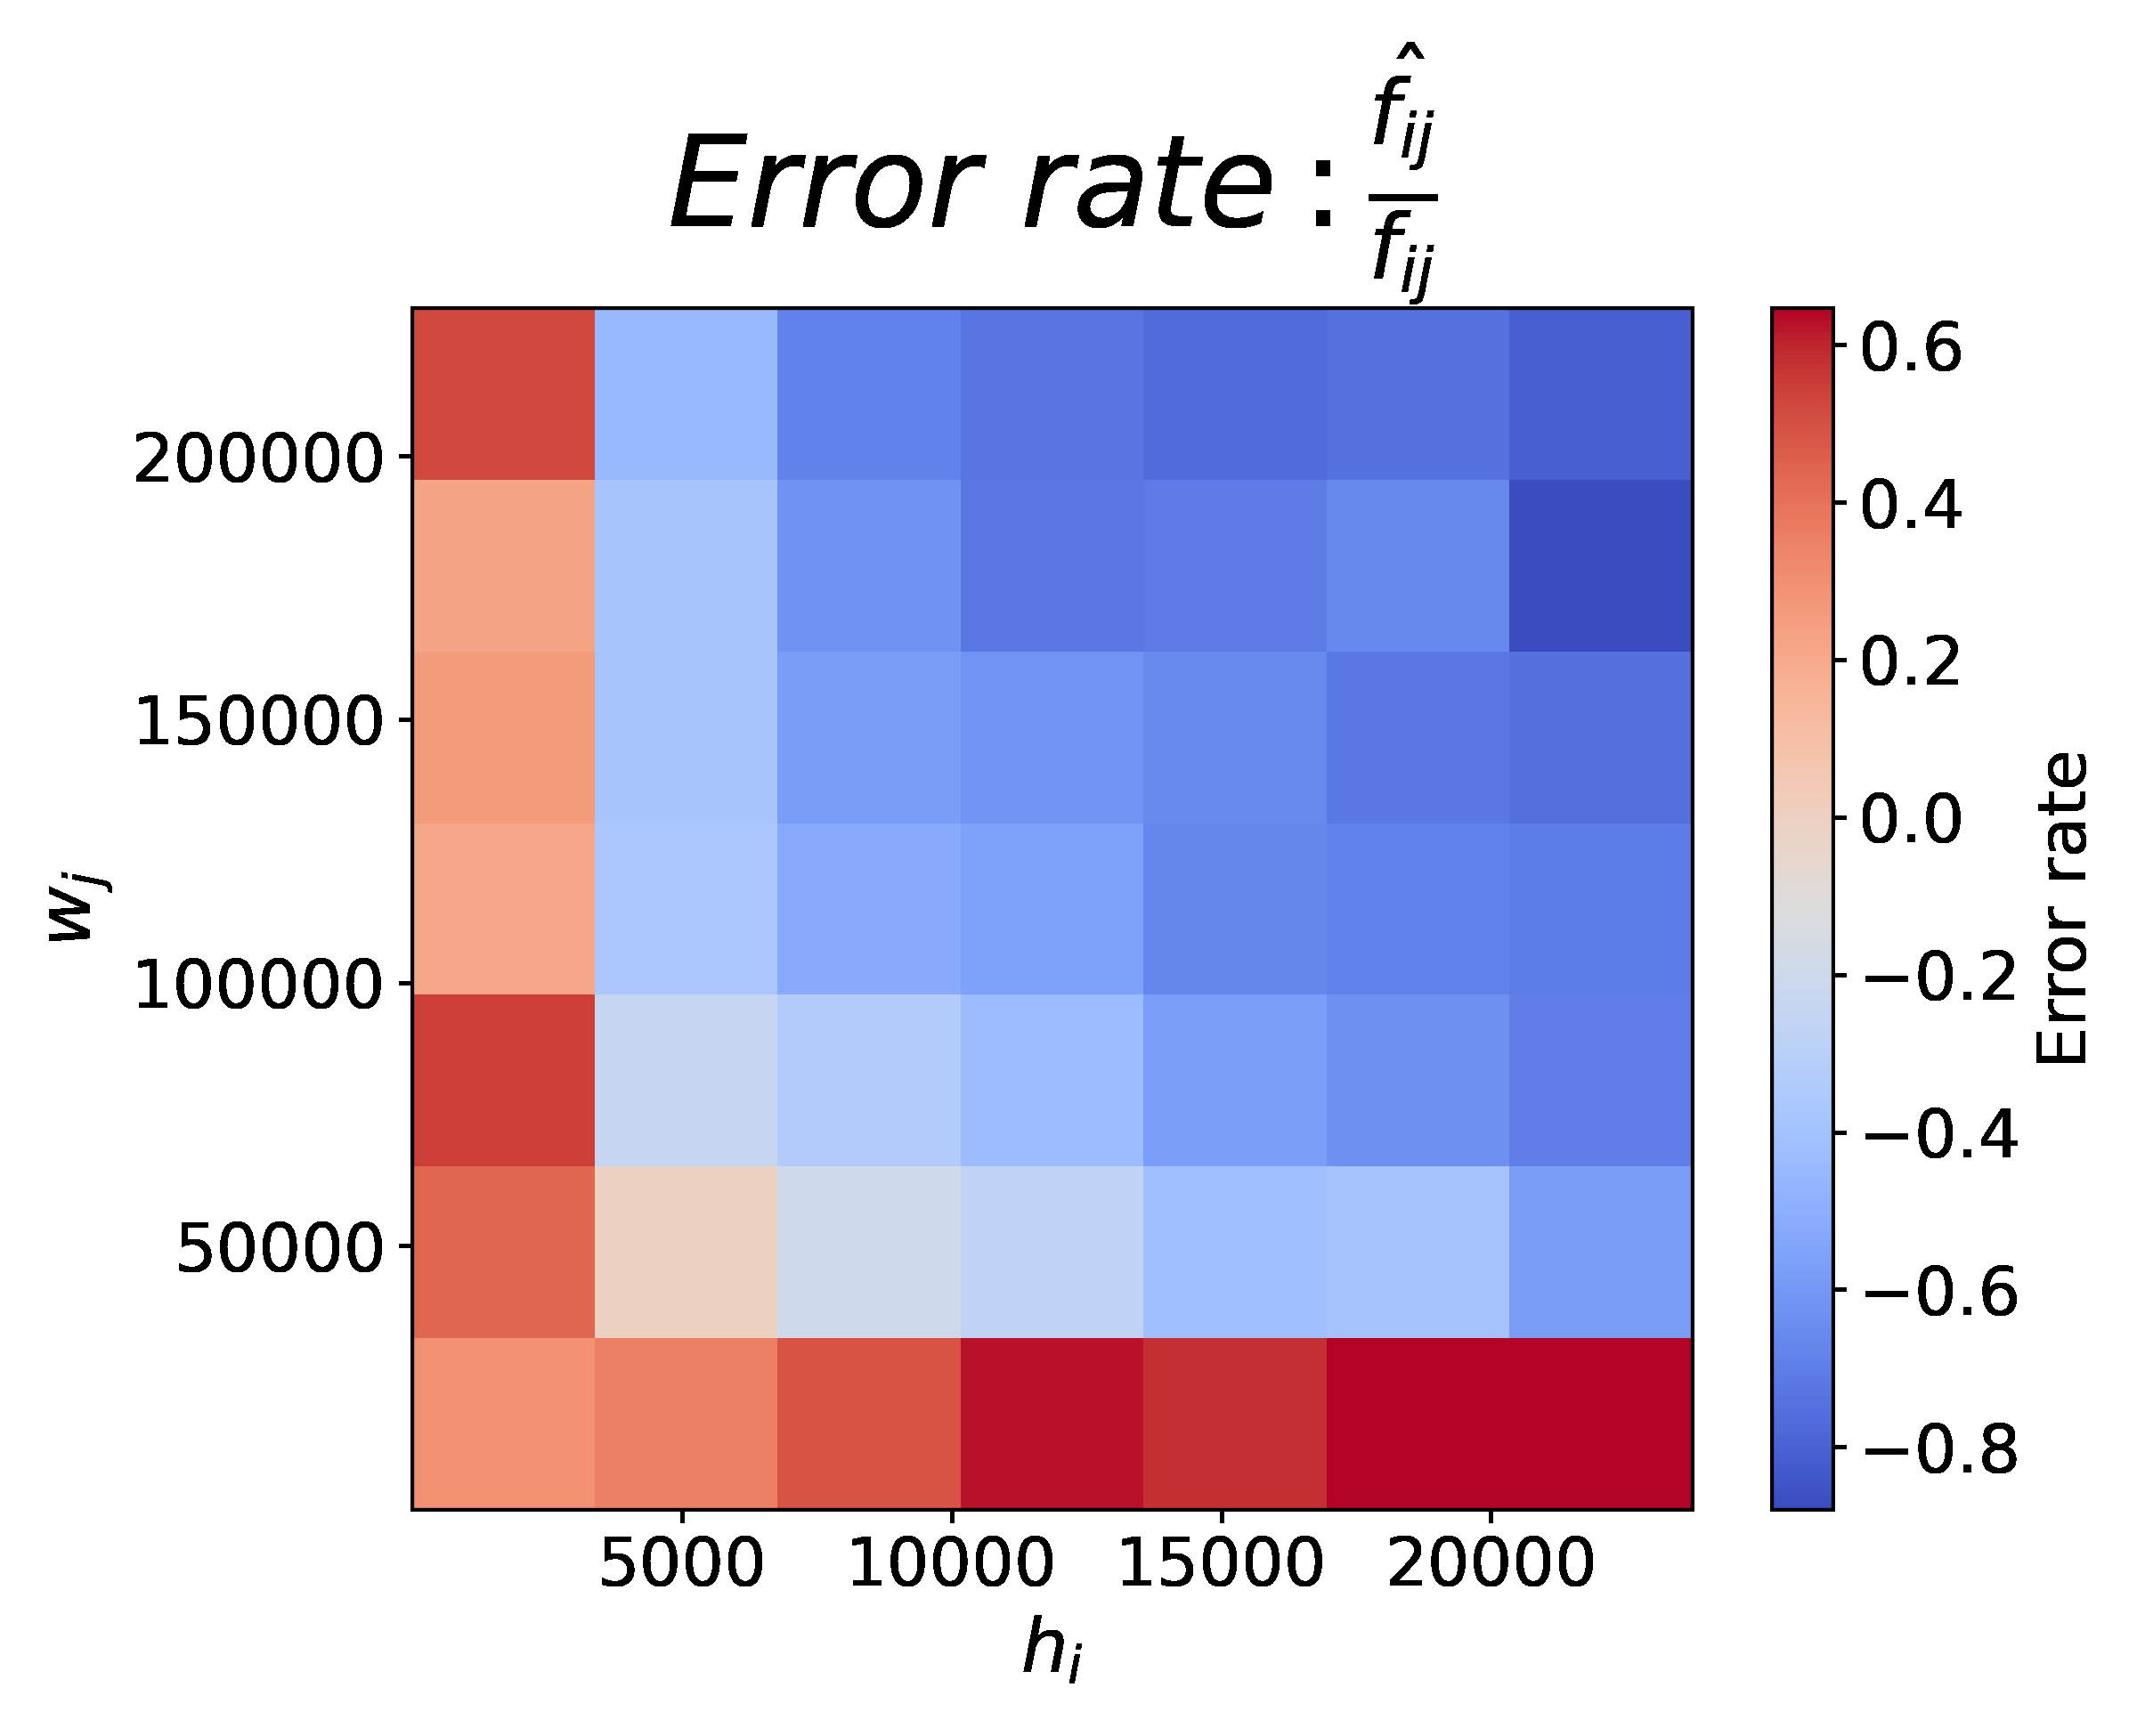
图 S4|传统引力模型偏在人口规模的哪一角?
无字母子图。横轴是起点居住人数,纵轴是终点就业人数。图题把误差率写成预测流量除以观测流量,色标却从负到正,而这个比值本身不会是负数。能按图注使用的方向是:红色表示高估,蓝色表示低估。居住人数很低的左侧、以及就业人数落在最低一档的底行偏红;两端人口都高的右上区域偏蓝。这与正文“稀的地方估高、密的地方估低”一致,但色标上的数字不能当成预测/观测的倍数。来源:补充材料 Fig. S4。
切成四类以后,公式到底改了哪一个指数?
SSUG 先按居住阈值 hᶜ 把起点分成郊区或市区,再按就业阈值 wᶜ 把终点分成郊区或市区。通勤因此有四类:郊区到郊区、郊区到市区、市区到郊区、市区到市区。郊区起点用指数 α₁,市区起点用 α₂;郊区终点用 β₁,市区终点用 β₂。四类共用同一个时间指数 δ。预测流量仍是:
起点居住人数的相应次方 × 终点就业人数的相应次方 ÷ 通勤时间的 δ 次方,再乘常数。
越过阈值时,公式再乘一个由阈值和两侧指数组成的因子,让四个式子在 hᵢ = hᶜ、wⱼ = wᶜ 时相等,避免预测在分界上突然跳动。另一条约束写的是:起点只有 1 名通勤者、终点只有 1 个岗位时,流量必须等于 1。这是为了给常数一个基准,不是数据里真的每一对单人格子都有 1 次通勤。补充材料第 11 节把常数写成时间的负幂,同时又丢掉阈值上的人口项,和原式对不齐。这里只采用“分界处连续”这一意图,不把那段推导当成已经闭合的归一化。
八个参数是 hᶜ、wᶜ、α₁、α₂、β₁、β₂、δ 和常数 K。优化目标是全部起讫点对上 log(预测流量/观测流量) 的平均值,每个起讫点对权重相同,不按人数加权。每个都市圈做 1000 次贝叶斯优化,留下目标值最低的一次。代理模型是高斯过程,采集函数是期望改进。
东京正文表 2 的印刷值如下。距离模型:α = 0.140,β = 0.300,距离指数 0.387,CPC = 0.27。时间模型:α = 0.134,β = 0.286,时间指数 0.669,CPC = 0.37。SSUG:hᶜ = 12143,其下另印 98.83%;wᶜ = 11445,其下另印 98.07%;α₁ = 0.009,α₂ = 1.912,β₁ = 0.010,β₂ = 1.312,时间指数 0.981,CPC = 0.41。
1.16% 和 1.92% 的分母是东京都市圈的格网面积:市区居住格网占 1.16%,市区就业格网占 1.92%。98.83% 与 1.16%、98.07% 与 1.92% 接近互补,但并不是精确的 100 减出来的,本文不替论文改齐。表 1 把阈值两侧都写成含等号,4.2 节又把“超过”称为市区、“低于”称为郊区。恰好等于阈值的格网没有唯一类别;连续约束只保证四个公式在这个点上流量相同。
α₁ 几乎不随郊区居住人数变化,α₂ 接近 1.9,表示在这条公式里,市区起点的人数每增加一个倍数,流量的放大远强于郊区起点。这是拟合指数,不是直接数出来的“岗位集中度”。
补充材料另有一张六城参数表。其中东京一行与正文冲突:就业阈值印成 13445 而不是 11445,α₁ 印成 0.09 而不是 0.009,CPC 印成 0.26 而不是 0.41。下表只保留指数和阈值,不采用该表的 CPC 列。δ 在这里是放在分母上的正指数。
| 都市圈 | 居住阈值 | 就业阈值 | α₁ | α₂ | β₁ | β₂ | δ |
|---|---|---|---|---|---|---|---|
| 东京 | 12,143 | 13,445 | 0.09 | 1.9 | 0.01 | 1.3 | 0.98 |
| 大阪 | 9,463 | 14,069 | 0.01 | 0.1 | 0.01 | 1.06 | 1.12 |
| 名古屋 | 7,963 | 13,135 | 0.07 | 1.47 | 0.01 | 0.87 | 0.99 |
| 福冈 | 10,121 | 17,687 | 0.08 | 2.0 | 0.08 | 1.0 | 1.11 |
| 仙台 | 3,210 | 19,327 | 0.01 | 0.31 | 0.01 | 0.69 | 0.96 |
| 札幌 | 5,336 | 40,962 | 0.12 | 0.25 | 0.23 | 1.23 | 1.11 |
六城都满足 α₂ > α₁、β₂ > β₁,所以“市区指数大于郊区指数”这一方向可以保留。幅度不能说成六城相同:补充表里大阪的 α₂ 只有 0.1,札幌只有 0.25,东京则是 1.9。东京的 1.9 与正文 1.912 可以看成舍入;0.09 与 0.009 不能。后文凡是引用东京 α₁,都会标明出自哪一张表。
同一补充材料里,东京贝叶斯优化的对照行又写成居住阈值 12143、就业阈值 11445、α₁ = 0.09、α₂ = 1.9、β₁ = 0.01、β₂ = 1.3,对数式中时间项的系数是 −0.98。负号对应“时间放在分母里”,绝对值与正文的 0.981 接近。因此就业阈值更支持正文的 11445,α₁ 更支持补充材料的 0.09。两套印刷没有一个完全一致的东京参数向量。
重合指数变高,是每一类通勤都更准了吗?
CPC 只衡量预测流量和观测流量有多少质量叠在一起。它不是分类准确率,也不是多预测出了百分之几的人。若两套流量的合计规模不同,CPC 也不等于“预测对了的人数比例”。
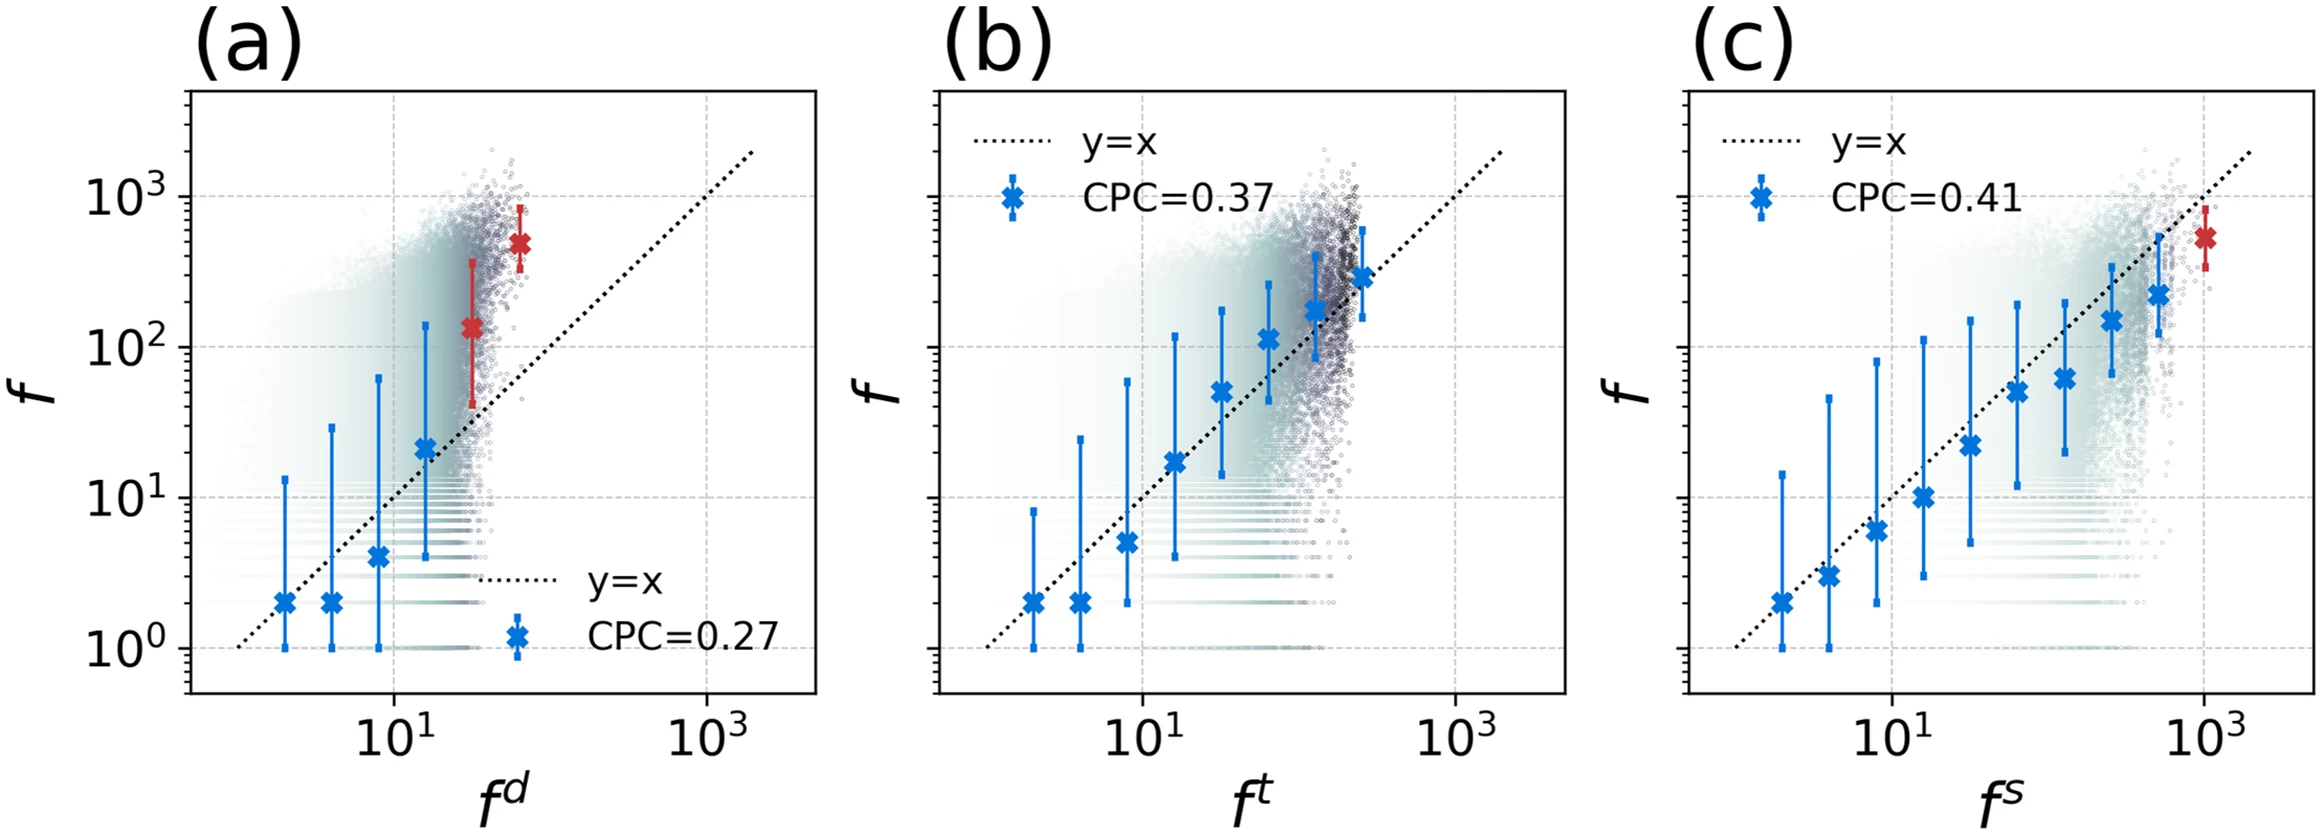
图 2|东京的预测流量和真实流量,哪一种模型更贴着对角线?
(a)距离模型,图内 CPC = 0.27。横轴是预测流量,纵轴是观测流量,均为对数坐标。点是起讫点对,圆点和误差棒是按预测值分箱后的观测中位数及第一、第三分位。黑色虚线是预测等于观测。点在虚线上方表示低估,下方表示高估。红色误差棒表示该箱明显偏离。(b)时间模型,CPC = 0.37。大流量一端仍有低估。(c)SSUG,CPC = 0.41。大流量更靠近对角线,极大流量仍有轻微高估,稀疏流量的偏差小于前两张。来源:原论文 Fig. 2。
0.41 比 0.37 高 0.04,比 0.27 高 0.14。差的是 CPC 本身,分母都是观测流量与预测流量之和,不是通勤人数增加了 4% 或 14%。
图 2 把所有起讫点对放在一起。四类通勤要分开看。
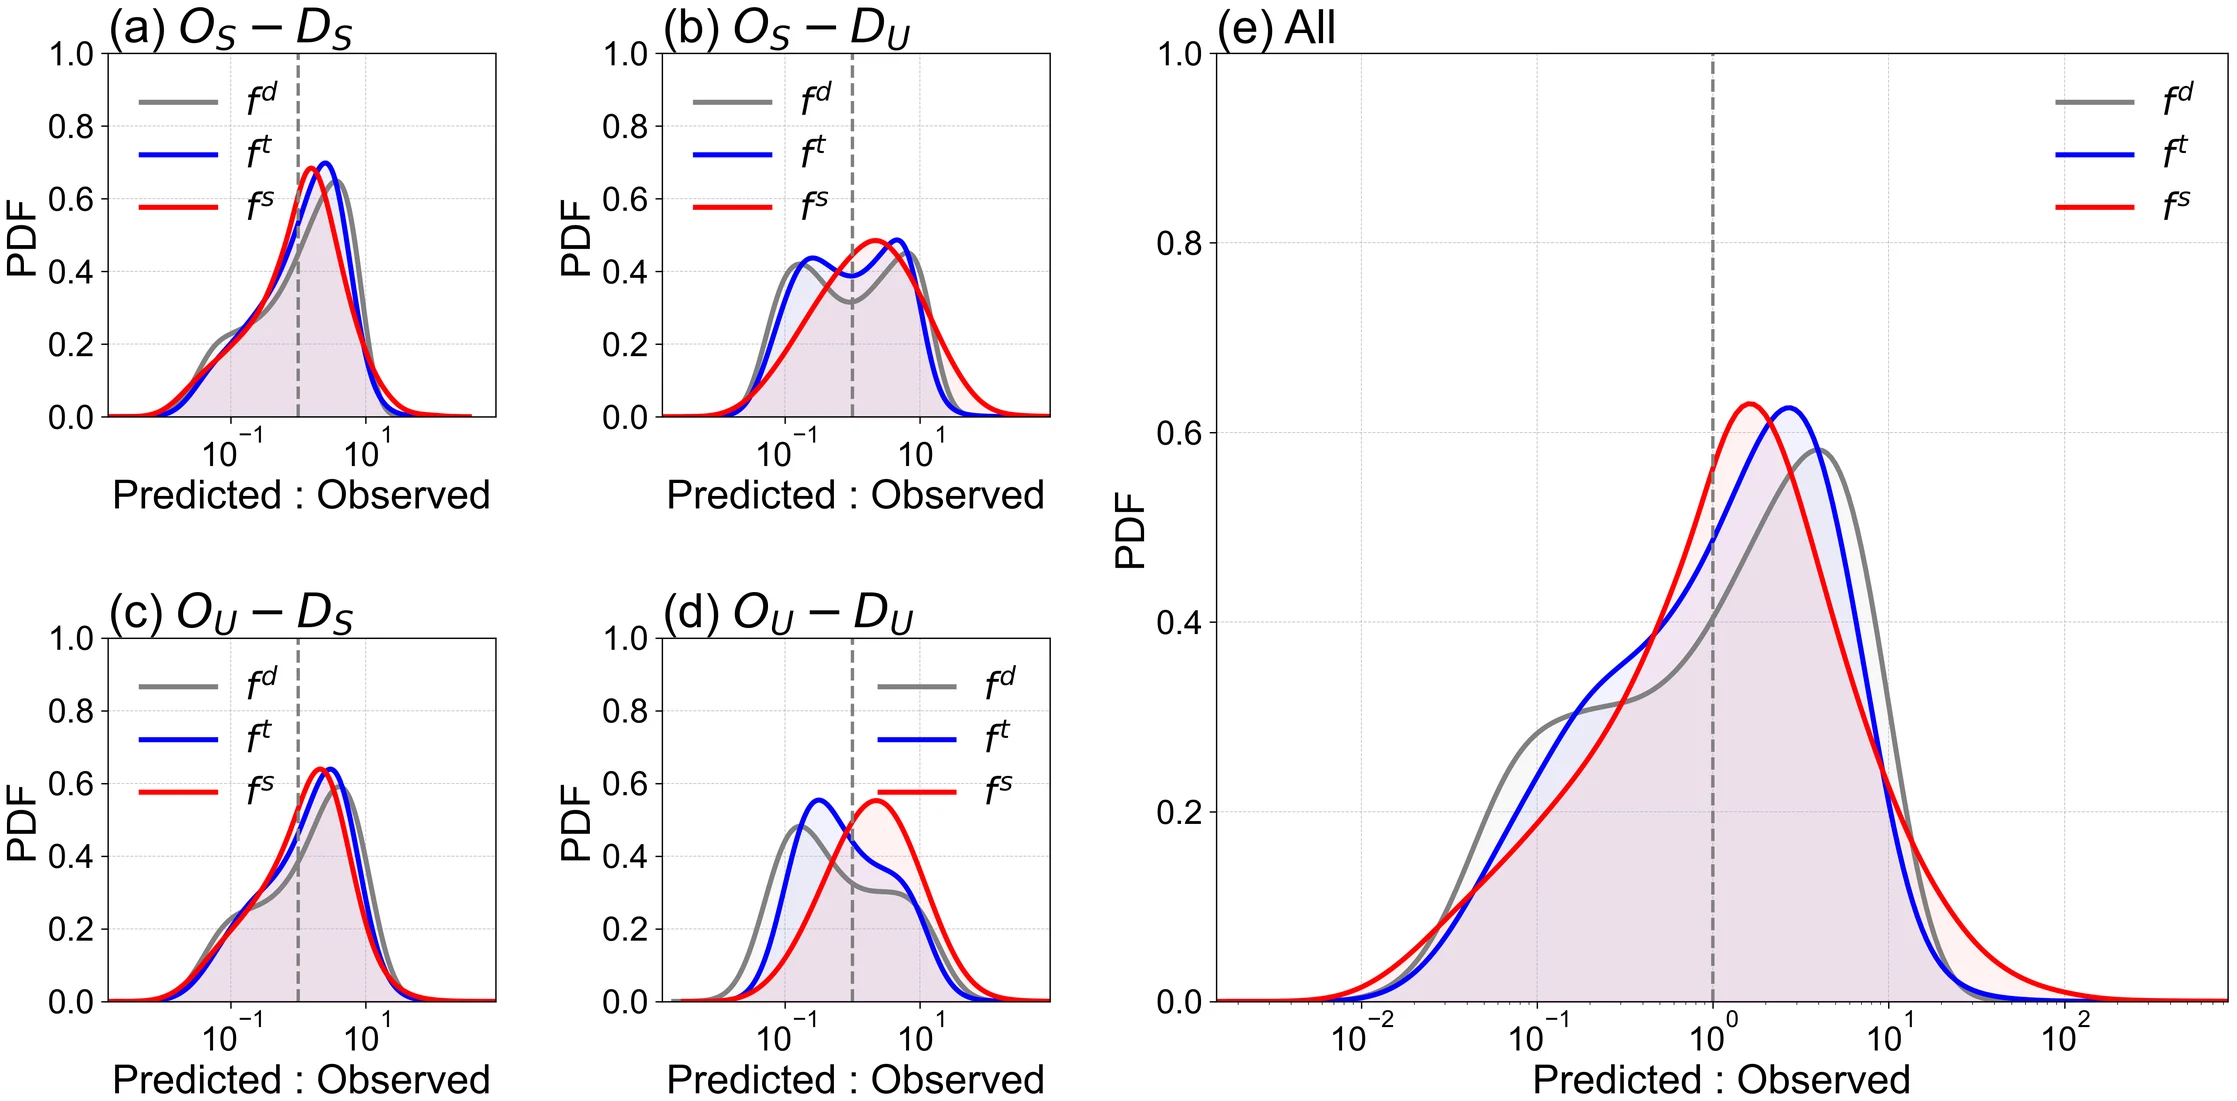
图 3|东京四类通勤里,预测相对观测是偏大还是偏小?
横轴都是预测流量除以观测流量,虚线为 1。灰线是距离模型,蓝线是时间模型,红线是 SSUG;纵轴是概率密度。(a)郊区到郊区。三条线的峰都在 1 的右侧,SSUG 的峰更靠近 1,高估还在。(b)郊区到市区。时间和距离模型呈双峰,SSUG 把质量收到更靠近 1 的位置,分布仍然很宽。(c)市区到郊区。三套模型的峰都偏在 1 的右侧,SSUG 最好,但这一类仍倾向高估。论文推测郊区岗位或设施还有公式没写入的限制,这是解释,不是另做的检验。(d)市区到市区。距离和时间模型的峰在 1 的左侧,即低估;SSUG 的峰移到 1 附近。(e)四类合计。SSUG 的峰最接近 1,右尾仍长,表示少数起讫点对仍被明显高估。来源:原论文 Fig. 3。
六城、四类的 CPC 都在表 4。列的含义按表注:郊区起点到郊区终点、郊区起点到市区终点、市区起点到郊区终点、市区起点到市区终点,最后一列是全部起讫点对。
| 都市圈 | 模型 | 郊—郊 | 郊—市 | 市—郊 | 市—市 | 全部 |
|---|---|---|---|---|---|---|
| 东京 | 距离 | 0.27 | 0.26 | 0.26 | 0.15 | 0.27 |
| 东京 | 时间 | 0.37 | 0.42 | 0.41 | 0.40 | 0.37 |
| 东京 | SSUG | 0.40 | 0.45 | 0.50 | 0.59 | 0.41 |
| 大阪 | 距离 | 0.26 | 0.24 | 0.26 | 0.17 | 0.24 |
| 大阪 | 时间 | 0.34 | 0.33 | 0.35 | 0.35 | 0.34 |
| 大阪 | SSUG | 0.48 | 0.43 | 0.40 | 0.62 | 0.40 |
| 名古屋 | 距离 | 0.25 | 0.21 | 0.26 | 0.12 | 0.24 |
| 名古屋 | 时间 | 0.31 | 0.29 | 0.35 | 0.27 | 0.31 |
| 名古屋 | SSUG | 0.34 | 0.43 | 0.41 | 0.67 | 0.36 |
| 福冈 | 距离 | 0.27 | 0.20 | 0.27 | 0.09 | 0.25 |
| 福冈 | 时间 | 0.34 | 0.30 | 0.38 | 0.21 | 0.33 |
| 福冈 | SSUG | 0.40 | 0.50 | 0.51 | 0.63 | 0.43 |
| 仙台 | 距离 | 0.26 | 0.21 | 0.26 | 0.08 | 0.24 |
| 仙台 | 时间 | 0.32 | 0.28 | 0.35 | 0.20 | 0.31 |
| 仙台 | SSUG | 0.34 | 0.29 | 0.39 | 0.32 | 0.34 |
| 札幌 | 距离 | 0.27 | 0.13 | 0.23 | 0.05 | 0.25 |
| 札幌 | 时间 | 0.34 | 0.21 | 0.33 | 0.16 | 0.33 |
| 札幌 | SSUG | 0.42 | 0.54 | 0.49 | 0.72 | 0.44 |
全部起讫点对的 CPC 不是四列的平均数。它按所有格子对的预测流量与观测流量合计来算,流量合计大的那一类把总分往自己那边拉。东京市区到市区是 0.59,总体仍是 0.41,接近郊区到郊区的 0.40。城区内部拟合变好,不会自动表现为总体 CPC 同样幅度变好。
也不是每一格都有明显提升。仙台郊区到市区只从时间模型的 0.28 到 SSUG 的 0.29。札幌市区到市区则从 0.16 到 0.72,距离模型这一格只有 0.05。论文把仙台总体偏低和缺少市区居住—市区就业格网放在一起讲。补充图 S8 的图注直接写仙台没有这类格网;那张图跨页拆开,这里不另作地图描述。
时间指数从距离模型的 0.387 升到时间模型的 0.669,再到 SSUG 的 0.981。指数变大表示,在各自拟合出来的公式里,时间每增加一个倍数,流量被压得更厉害。这不能单独证明“人们更在意时间”,因为三个模型的人口指数和是否分段并不相同,指数之间不能脱离公式比较。
指数更大,地图上是不是真的更挤在市中心?
论文沿用既有解释:起点指数更大,表示居民更集中地流向有限的工作地;终点指数更大,表示岗位更集中地吸引有限的居住地。图 4 用来看东京的居住地和就业地是否真的挤在中心,而不是把 1.912 直接读成“集中了 1.912 倍”。
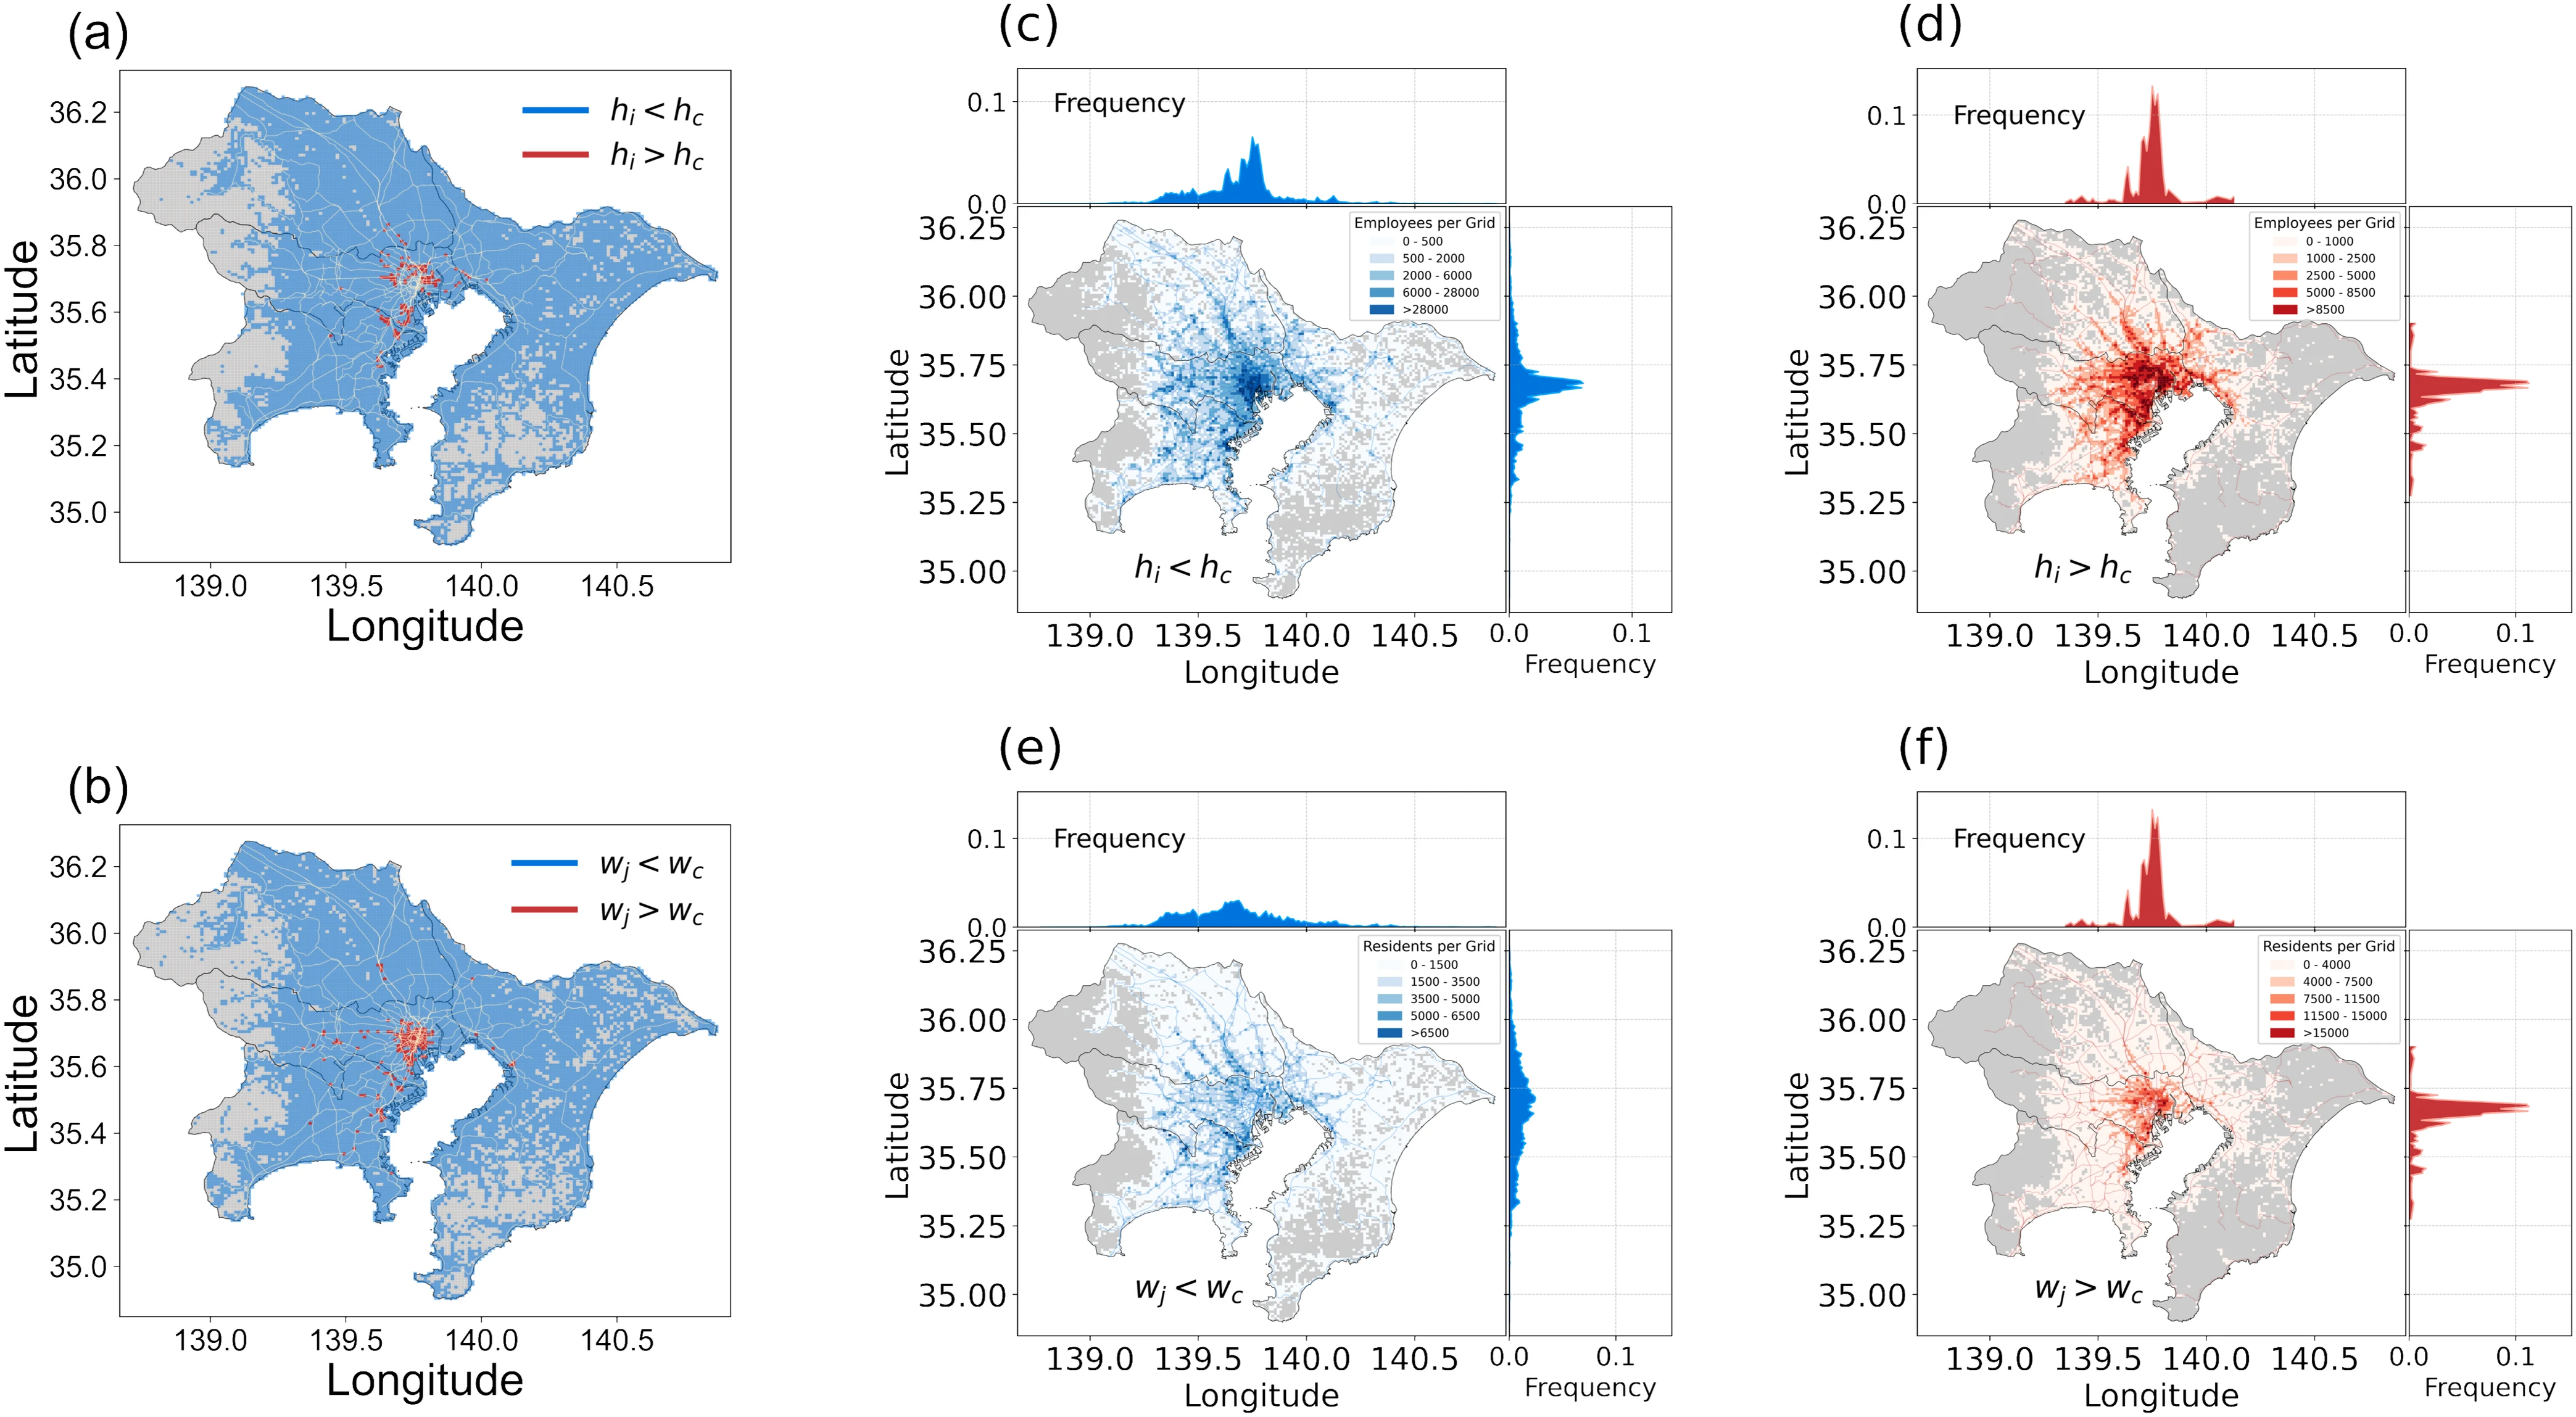
图 4|东京的市区居住地和市区岗位,是否比郊区更集中?
(a)居住人数地图。蓝格 hᵢ < hᶜ,红格 hᵢ > hᶜ,红格集中在靠东京湾的中心。(b)就业人数地图。蓝格 wⱼ < wᶜ,红格 wⱼ > wᶜ,高就业格网同样集中在中心,范围与红居住格网不完全重合。(c)郊区居民的工作地。颜色表示每个格网的就业人数,上方和右侧是经度、纬度方向的频率。工作地铺得比较开。(d)市区居民的工作地。就业人数用另一套色阶,中心峰又高又窄。(e)郊区岗位上的雇员住在哪里。居住地分布宽。(f)市区岗位上的雇员住在哪里。居住地收成中心附近的尖峰。两侧小图的纵轴频率都标到 0.1,但(c)(d)与(e)(f)的人数色阶不同,不能把颜色深浅跨图比较成同一人数。来源:原论文 Fig. 4。
图 4 用的是严格不等号,等于阈值的格网没有被涂成红或蓝。地图支持“市区起终点更集中在东京中心”这句空间描述。它不证明指数是集中的原因,也不证明居民先选中心再接受通勤。家和单位是同时观测到的结果。
补充材料在不分段的情况下还拟合了常替代弹性形式。六个城市的替代参数 ρ 都是负数:东京 −0.25、大阪 −0.24、名古屋 −0.48、福冈 −0.67、札幌 −0.81、仙台 −1.64。作者认为 ρ 越接近 0,越接近 SSUG 使用的乘积形式。这段估计没有使用 hᶜ 和 wᶜ,也不是表 4 的 CPC 比较。补充文字对 ρ = 0 和 ρ = 1 的经济学名称,与所引 Arrow 等人的常规定义不一致,因此这里只保留估计值。
一张格网上同时看家和岗位,都市圈被分成哪四种?
每个格网可以既是居住地又是工作地,于是有四类:郊区居住且郊区岗位、郊区居住且市区岗位、市区居住且郊区岗位、市区居住且市区岗位。论文分别记为 hₛwₛ、hₛwᵤ、hᵤwₛ、hᵤwᵤ。
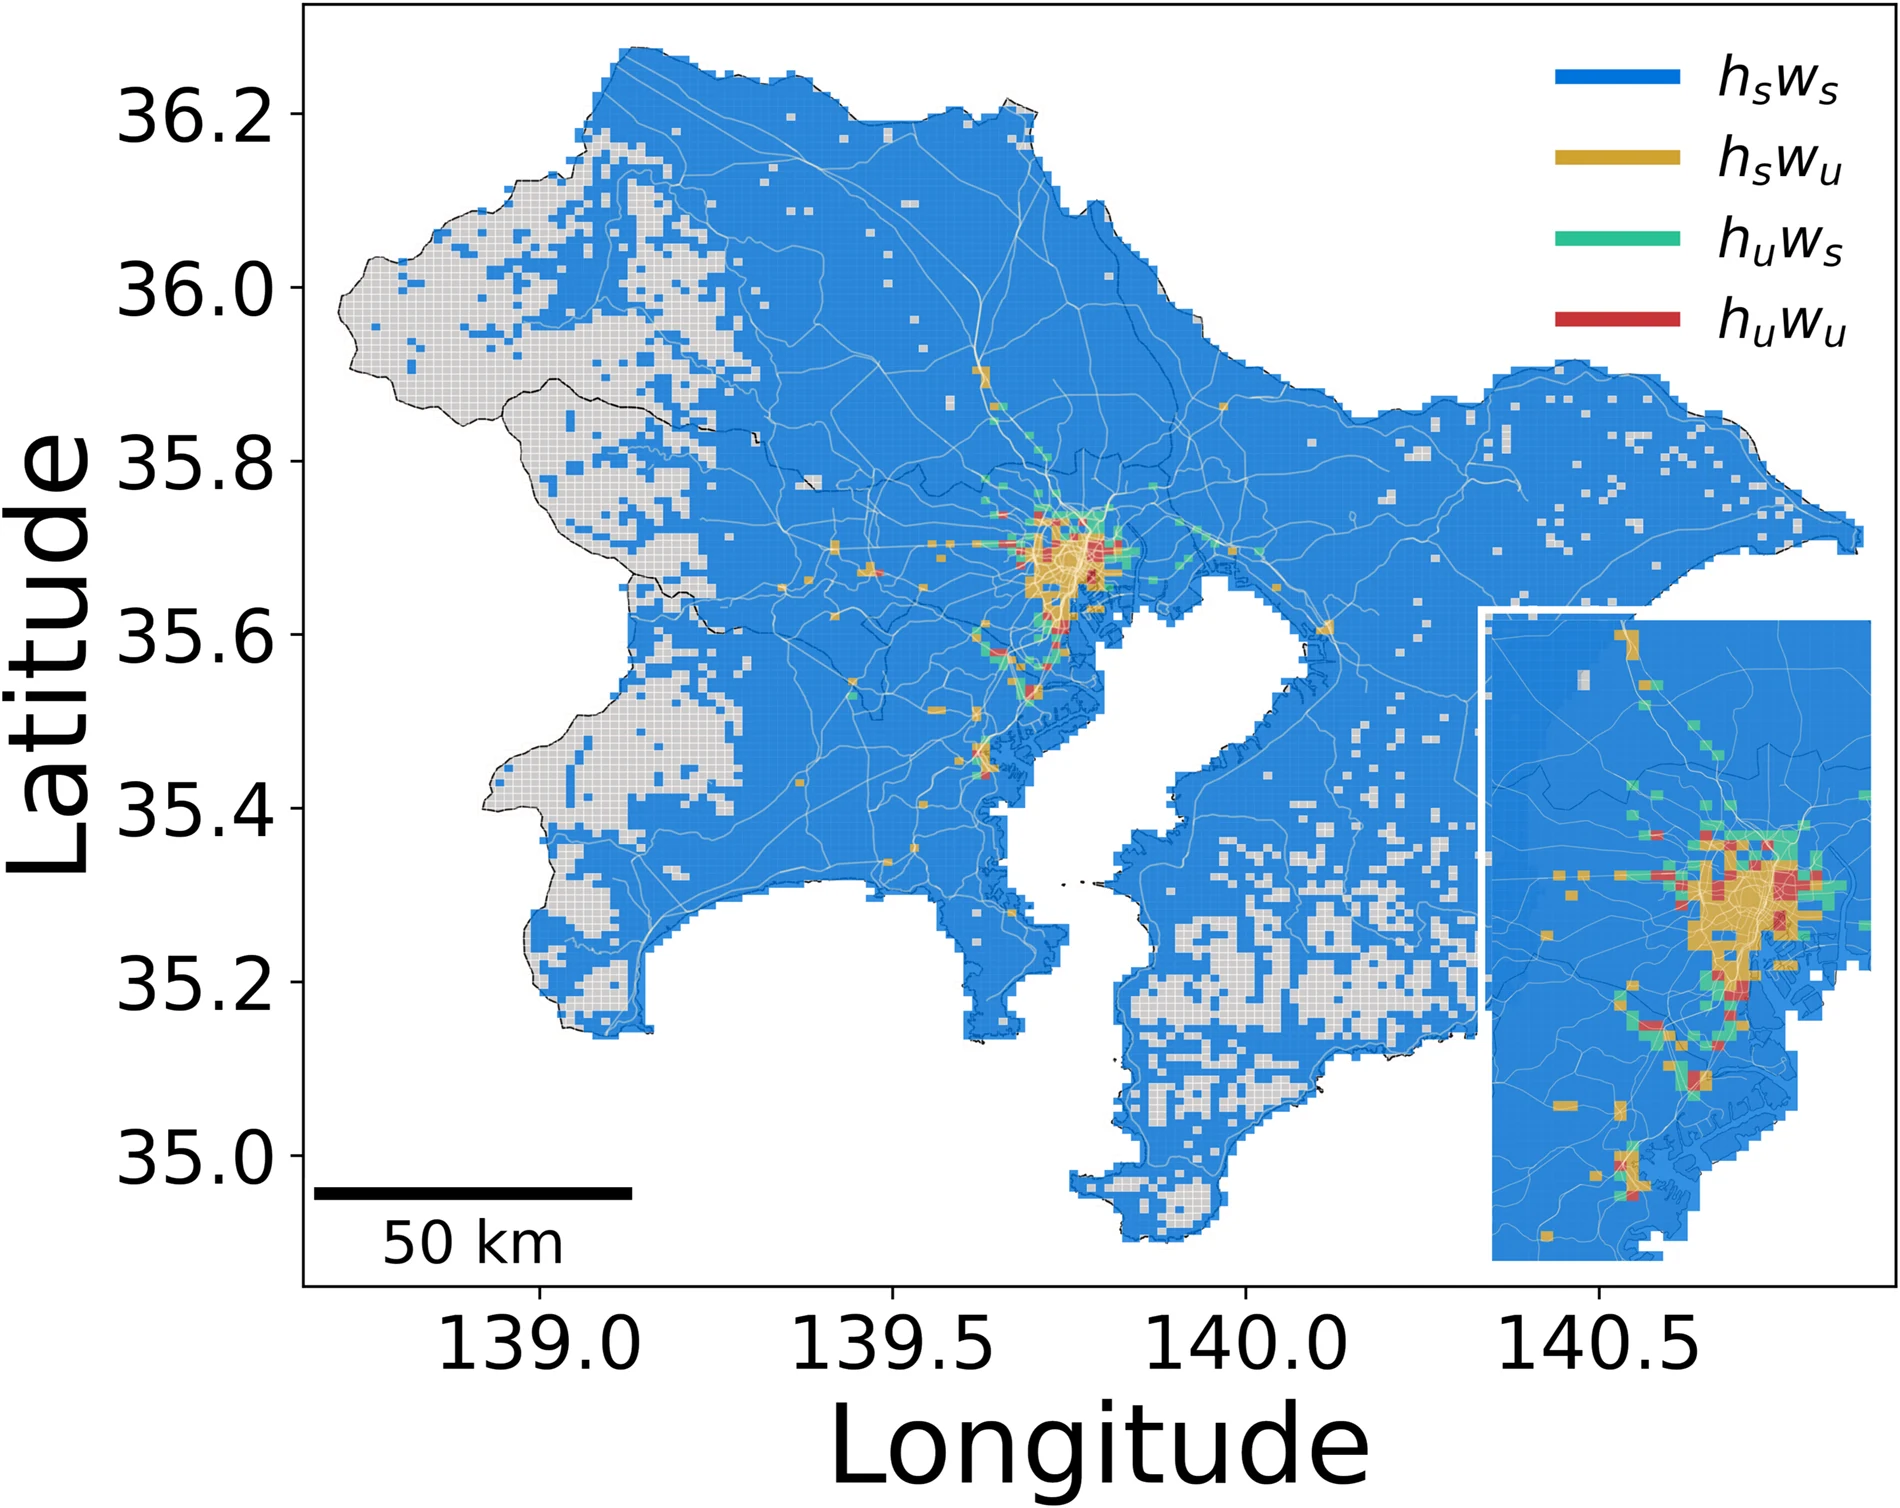
图 5|东京都市圈的四种格网怎样从中心排到外围?
无字母子图。蓝是 hₛwₛ,占外围的大部分;黄是 hₛwᵤ,沿放射走廊和若干外围节点分布;绿是 hᵤwₛ,贴着中心就业密集区的居住带;红是 hᵤwᵤ,集中在中心。灰色斜线格网不在这四类着色之内。右下角是中心放大图,比例尺为 50 公里。颜色是类别,不是流量。来源:原论文 Fig. 5。
论文给四类举了东京的例子:红核包括千代田区和新宿区这类中心,绿带以江东区的大规模集合住宅为例,黄点包括西边的立川,蓝的外围包括奥多摩山地。这些是作者用来说明功能的地名,不是模型从名字里识别出来的行政类别。补充图 S11 的图注认为,最粗的通勤流出现在居住主导格网和就业主导格网错开的地方。线宽图没有给出可逐条核对的人数表,所以“错位驱动通勤”仍是图示判断。
官方人口集中地区的密度线是每平方公里 4000 人,并考虑相邻区域。东京 SSUG 的居住阈值是 12143 人每个 1 公里格网。论文说模型阈值可以为官方定义提供数量参照。两个数并不相等,超过 12143 也不等于已经被划成人口集中地区。
换一批格网、换一种时间,0.41 还在吗?
补充材料把东京 SSUG 改成对数线性式,用最小二乘再估一次。贝叶斯优化一行是:阈值 12143 和 11445,α₁ = 0.09,α₂ = 1.9,β₁ = 0.01,β₂ = 1.3,时间项系数 −0.98。最小二乘一行是:12560 和 11752,α₁ = 0.13,α₂ = 2.01,β₁ = 0.03,β₂ = 1.31,时间项系数 −1.02。方向相同,α₁ 从 0.09 到 0.13,相对差距并不小。论文称二者支持参数稳定,读者仍应看到郊区起点指数最容易变。
再随机抽 90% 的 1 公里格网,东京共 12 次。居住阈值落在 11933 到 12512,就业阈值落在 10933 到 11512,α₁ 在 0.08 到 0.11,α₂ 在 1.72 到 2.20,β₁ 在 0.01 到 0.03。β₂ 每次都印成 1.31,时间项系数每次都是 −0.98。12 次都把 α₁ 放在 0.1 附近,这是反对正文 0.009 的重复证据;β₂ 完全不变,则不像是每次都自由重新搜索过。
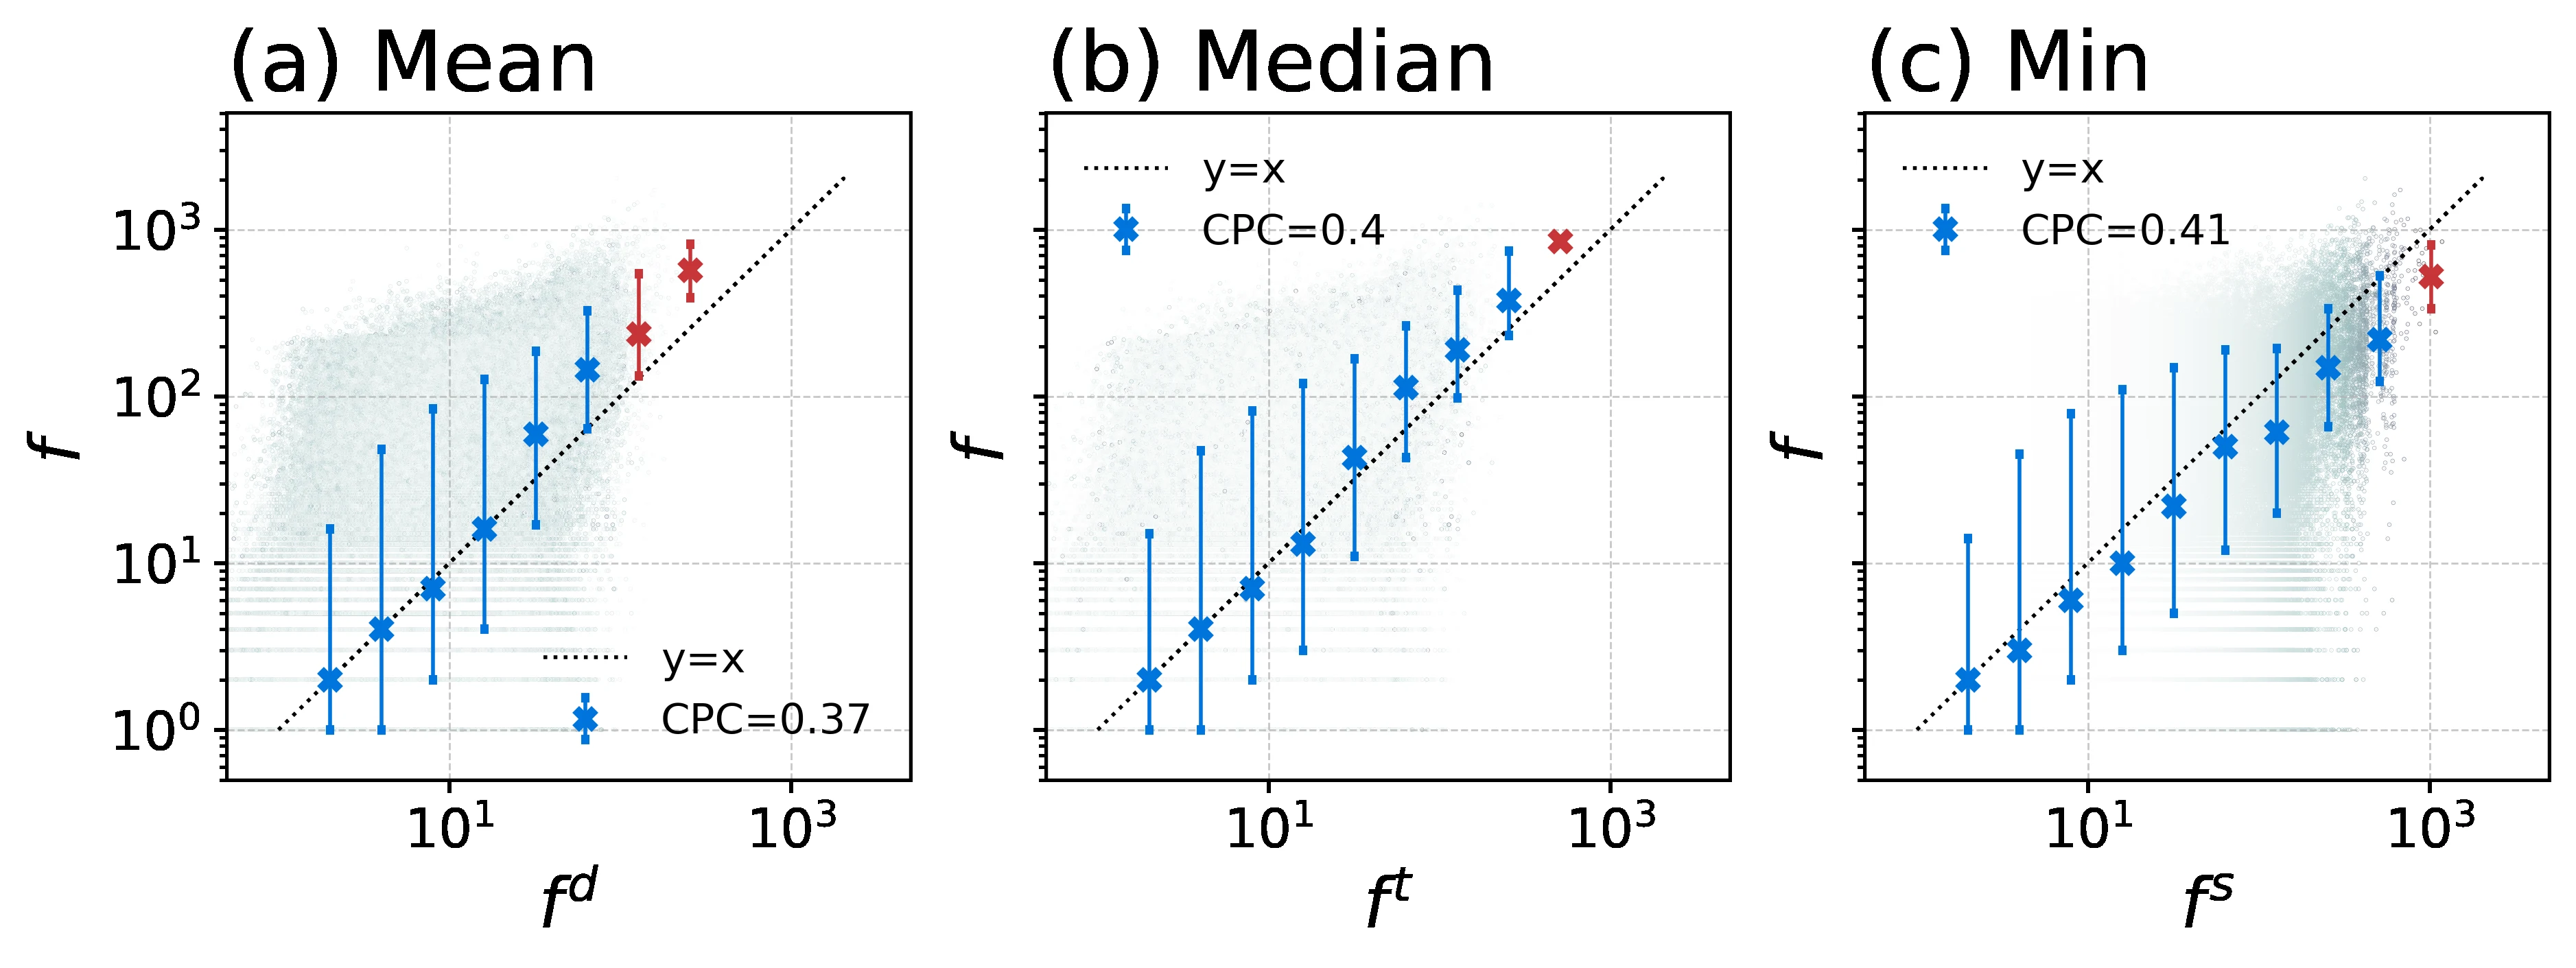
图 S9|起讫点对的通勤时间改用平均、中位数或最短值,重合指数怎么变?
(a)使用平均通勤时间,图内 CPC = 0.37。横轴符号印成 fᵈ,这里应按图题理解成平均时间,不要读成图 2 的距离模型;图 2 距离模型的 CPC 是 0.27。(b)使用中位数,CPC = 0.4,横轴符号印成 fᵗ。(c)使用最短时间,CPC = 0.41,横轴符号印成 fˢ。最短时间的对角线贴合最好,平均时间的大流量红棒更多。来源:补充材料 Fig. S9。
0.41、0.4 和 0.37 的分母仍是各自预测与观测流量之和。最短时间更好,符合“异常长的绕路会把平均时间拉高”这句统计说明。它不能证明每个通勤者都走了那条最短行程。郊区到市区的高估,论文自己也承认可能来自少数开车的人定义了最短时间,多数乘坐公共交通的人并没有这么快。
补充表还给出三个模型的优化目标值:SSUG 为 −0.1290,时间模型为 −7.81×10⁻¹²,距离模型为 −1.23×10⁻¹⁴。作者因为 SSUG 更负,称它在这个目标上最好。若目标就是平均 log(预测/观测),接近 0 表示预测与观测的几何平均比接近 1;−0.1290 按该式换算,几何平均比约为 0.88。这个 0.88 不是论文报告的准确率。CPC 按流量质量重合排序,优化目标按每个起讫点对的对数比排序。两套排序回答的不是同一个问题。
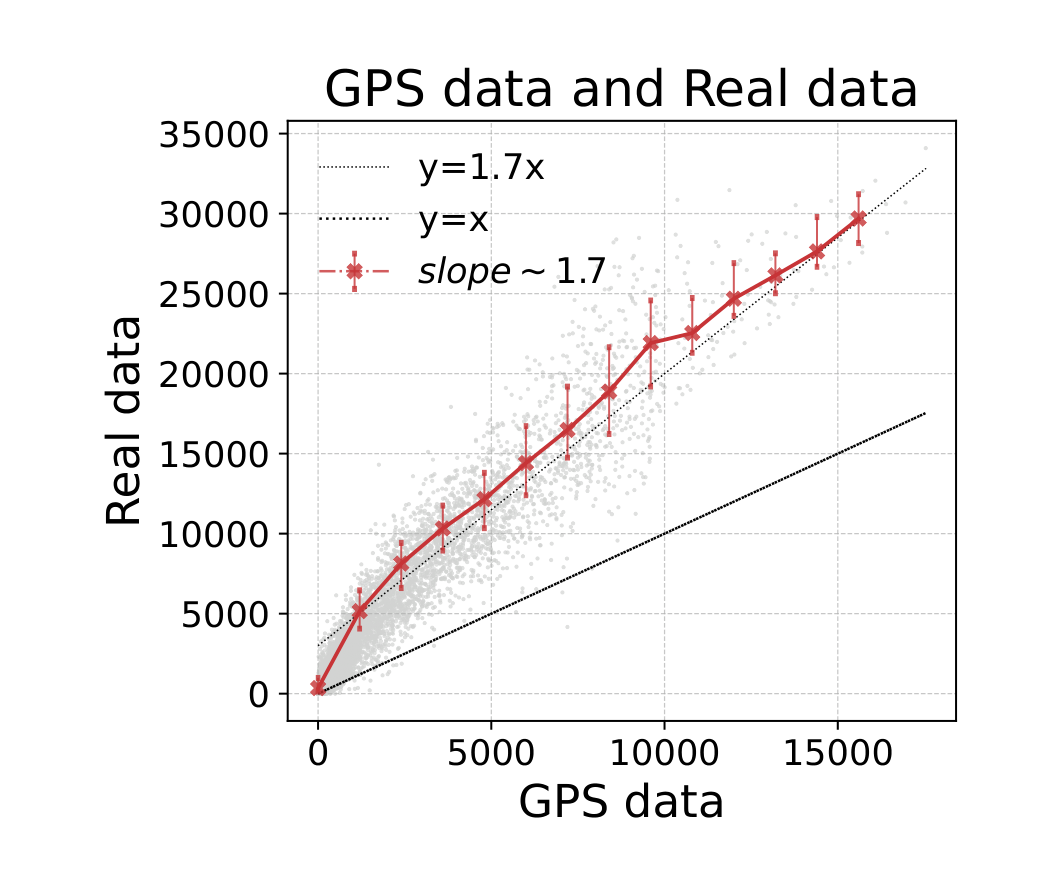
图 S10|GPS 推算的人数和官方居住人口差多少?
无字母子图。横轴是 GPS 数据,纵轴是官方真实数据。图注说明比较的是 GPS 推算的通勤居住者与实际居住人口。灰点是单个观测,红线是分箱平均,斜率约为 1.7,即官方人数 ≈ 1.7 × GPS 人数。y = x 位于红线下方。正文另用“大约一半”描述 GPS 相对官方人口的覆盖;1/1.7 约是 0.59,和“一半”接近,但图上能核对的是斜率 1.7,不是 2。一条总体直线只能说明低估大体成比例,不能排除老人和儿童被系统性漏掉。来源:补充材料 Fig. S10。
正文还说同一方法用到 2020 年,结果与 2021 年大体一致。补充材料没有给出 2020 年的 CPC 或参数对照,因此“大体一致”只能停留在这句定性判断。
这些比较停在哪一步?
SSUG 提高的是同一批 2021 年工作日通勤上的拟合重合,以及“两段斜率优于一段”的 F 检验。它没有把人随机分到市区或郊区,不能把指数差写成居住选择或就业集聚的因果效应。2021 年同时有新冠疫情和东京奥运会,论文把这一点列为通勤可能偏离平时的原因。
模型没有交通方式、票价、发车间隔或收入。最短时间把一辆更快的车和一列普通电车压成同一个阻力。夜间工作者可能因为睡眠时段缺少定位而被高估通勤时间;超过 120 分钟的行程被直接去掉。家和单位的规则——5 点、4 小时、5 小时、第一个单位——决定了谁算通勤者。换规则会换一批起讫点对,论文没有报告这组规则的敏感度。
小于仙台的城市没有测试。论文推测小城市更依赖汽车,公共交通不再把市区和郊区拉开,这仍是待查的边界。优化目标与 CPC 不一致,正文、补充六城表和东京优化对照又给出互相冲突的阈值与 α₁。在这些印刷值对齐之前,不宜把某一组指数当成可直接迁移到其他国家的参数。
一句话总结
把家和岗位按人口阈值分成市区与郊区之后,六个日本大都市圈的通勤流量比重力模型的单一公式更接近观测;这种接近主要集中在城区内部,而且阈值和指数仍是 2021 年工作日定位数据上的拟合,不是市区如何形成的证明。
核心来源
- PLOS One 正式发表页,核对题目、作者、2025年8月12日发表记录与数据声明。收稿日期为 2024年10月31日,接收日为 2025年7月19日。
- 正文 28 页:图 1–5,表 1–4。补充材料 S1 共 25 页,含图 S1–S17 及参数、稳健性和常替代弹性表格。本文使用了正文全部主图,以及补充图 S3、S4、S9、S10 和补充参数表;S8、S11 只采用图注中的明确语句。
- 数据为 Agoop 的点状人口数据,论文写明不能公开获取。资助为日本学术振兴会科学研究费补助金(基盘研究 B)23K22980,受资助者是 Misako Takayasu。
作者介绍
四位作者的单位和分工以论文署名页、贡献说明及参考文献中的可核对条目为准。
- Yixuan Y. Zheng:署名单位为东京科学大学工学院系统制御工学系。负责构思、数据整理、分析、调查、方法、验证、可视化和写作。
- Yohei Shida:署名单位为筑波大学系统信息工学系,以及东京科学大学计算学院计算机科学系。参与验证和改写。论文引用的 2022 年《Scientific Reports》中,Shida 与两位 Takayasu 曾用 GPS 讨论新冠有效再生数如何随日活动变化。
- Hideki Takayasu:署名单位为东京科学大学计算学院计算机科学系。参与方法、验证和改写。
- Misako Takayasu:通讯作者,同时署系统制御工学系与计算机科学系,邮箱为论文所载 takayasu@comp.isct.ac.jp。负责资助、项目管理、资源和指导,并参与改写。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若只用全部起讫点对的 CPC 验收模型,札幌城区内部从 0.16 升到 0.72 会被总体从 0.33 升到 0.44 盖住。两个数的分母都是该类预测流量与观测流量之和,不是同一批人。关心市中心轨道是否被低估时,应把市区到市区单独列为验收项,否则分段模型最大的改动会在总分里变轻。
另一个容易误用的边界是官方密度线和模型阈值。人口集中地区的密度参照是每平方公里 4000 人,东京 SSUG 的居住阈值是 12143 人。一个 1 公里格网若有 8000 名居民,按密度线已高于 4000,按 SSUG 仍走郊区起点、使用接近 0 的 α₁。直接把模型类别当成政府划定的市区,会换掉这一档格子的通勤弹性。论文没有做这张逐格对照。
更可检验的下一步是按交通方式分开拟合。现在的阻力是该起讫点对上的最短时间,最快的一次出行就能代表整格流量。补充图里改用平均时间后,CPC 从 0.41 降到 0.37。若在电车、驾车和骑行分开之后,市区与郊区的人口指数不再不同,所谓两套缩放规律就可能只是方式构成的替身,而不是居住人口本身的两段规律。