同一天的疫情数字,为什么过几个月再下载就变了?
论文名片|Emanuele Guidotti,A worldwide epidemiological database for COVID-19 at fine-grained spatial resolution,Scientific Data 9, 112(2022)。原论文 · 数据描述论文。
想象你用一份县级确诊病例表完成分析,几个月后为了复核重新下载。同一地区、同一日期的病例数却变了。模型和代码完全相同,结果仍无法重现。原因可能很朴素:统计部门追溯修订了历史数据,而你手里没有当初下载的版本。
这篇论文介绍的 COVID-19 Data Hub,不只是把各国病例数放进一张表。它同时解决三个问题:把细尺度行政区对齐,把不同来源的变量合并,并保存每天的数据版本。统一格式让研究可以开始,却不能自动消除各国诊断、检测和报告口径的差异。
先说结论
- 论文写作时数据库覆盖 230 多个国家级单元、760 多个次国家级地区和 12,000 多个更低层级行政区;不同变量的实际覆盖相差很大。
- 行政区统一标识把病例、疫苗、住院及政策数据接到一起,也为匹配出行、气象和地理数据预留接口。
- 数据源可能重写历史,所以系统抓取完整时间序列,而非只追加最新一天;自 2020 年 4 月 14 日起保存每日不可变快照。
- 它的质量目标是忠实反映原始来源。发现异常会检查、记录并反馈,但不会擅自把不顺眼的数据改成合理值。
只看全国总量,会错过多少地方差异?
疫情在一个国家内部并不同步:全国曲线可能把先后发生的地区波峰混在一起。细尺度数据还允许在同一国家内比较地区,在研究设计适当时控制国家层面的共同因素。但一张地图变细,并不会自动产生因果识别。
论文表 1 的覆盖统计截至 2021 年 11 月 27 日。确诊病例覆盖 226 个国家级单元、33 个国家中的 759 个次国家级地区,以及 16 个国家中的 12,119 个低层级地区。相比之下,检测数只有 139 个国家级单元、19 个国家中的 382 个次国家级地区和 6 个国家中的 686 个低层级地区;住院数据低层级覆盖仅为 3 个国家中的 164 个地区。
所以 12,000 多个地区不是每一项指标都有数据,也不能当作 12,000 条每日完整、口径相同的时间序列。
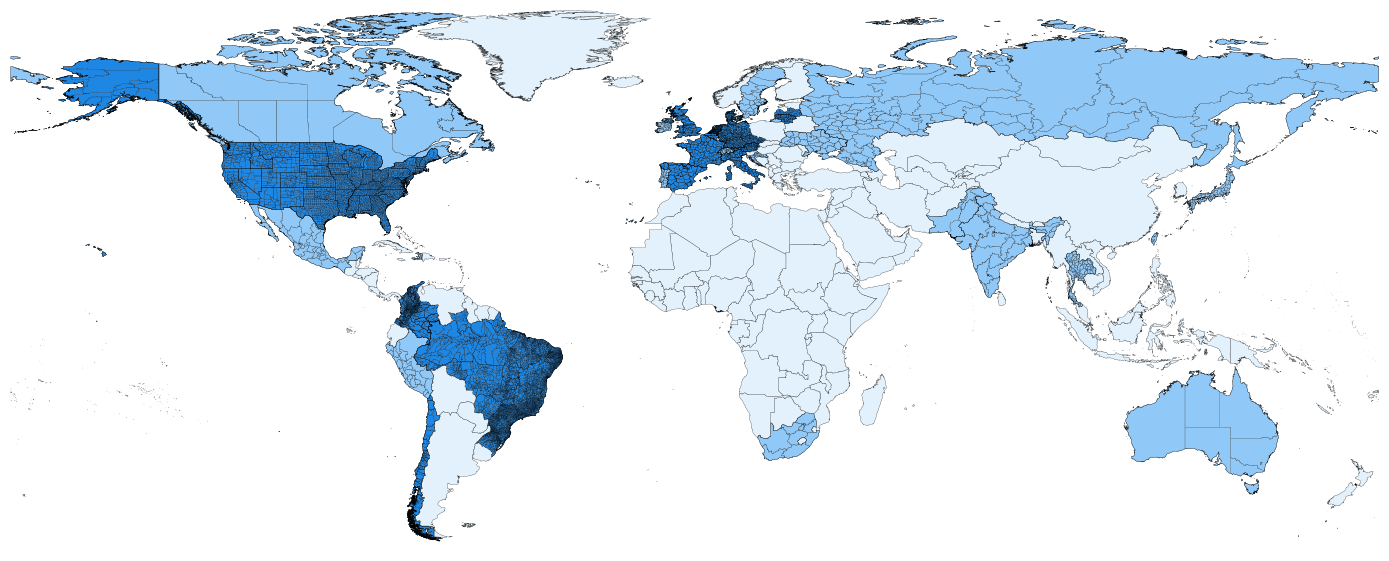
图 1|哪些地方可以越过全国平均值,看见更细的地区?
本图没有字母子图。浅蓝表示只提供国家级数据,中蓝表示有次国家级数据,深蓝表示有更低层级数据,展示的是截至 2021 年 11 月 27 日的空间覆盖与粒度。颜色不代表病例多少,也不意味着深蓝地区的每一项变量都完整。来源:原论文 Fig. 1。
不同网站说的是不是同一个地区?
数据库一行对应一个地区在某个日期的观察,列对应不同变量。这种整洁数据(tidy data)格式看起来简单,真正困难的是地点匹配。例如,同一个意大利大区,疫苗数据用 NUTS 编码,病例数据却只给名称;不先对齐,两张表就无法安全合并。
系统为每个地理实体生成唯一哈希标识,再用对照表(lookup table)关联原来源标识。数据源模块负责下载并统一列名和格式,国家模块负责把这个国家的多个来源接到同一标识上,顶层模块再汇总全球数据,加入政策和外部匹配字段。
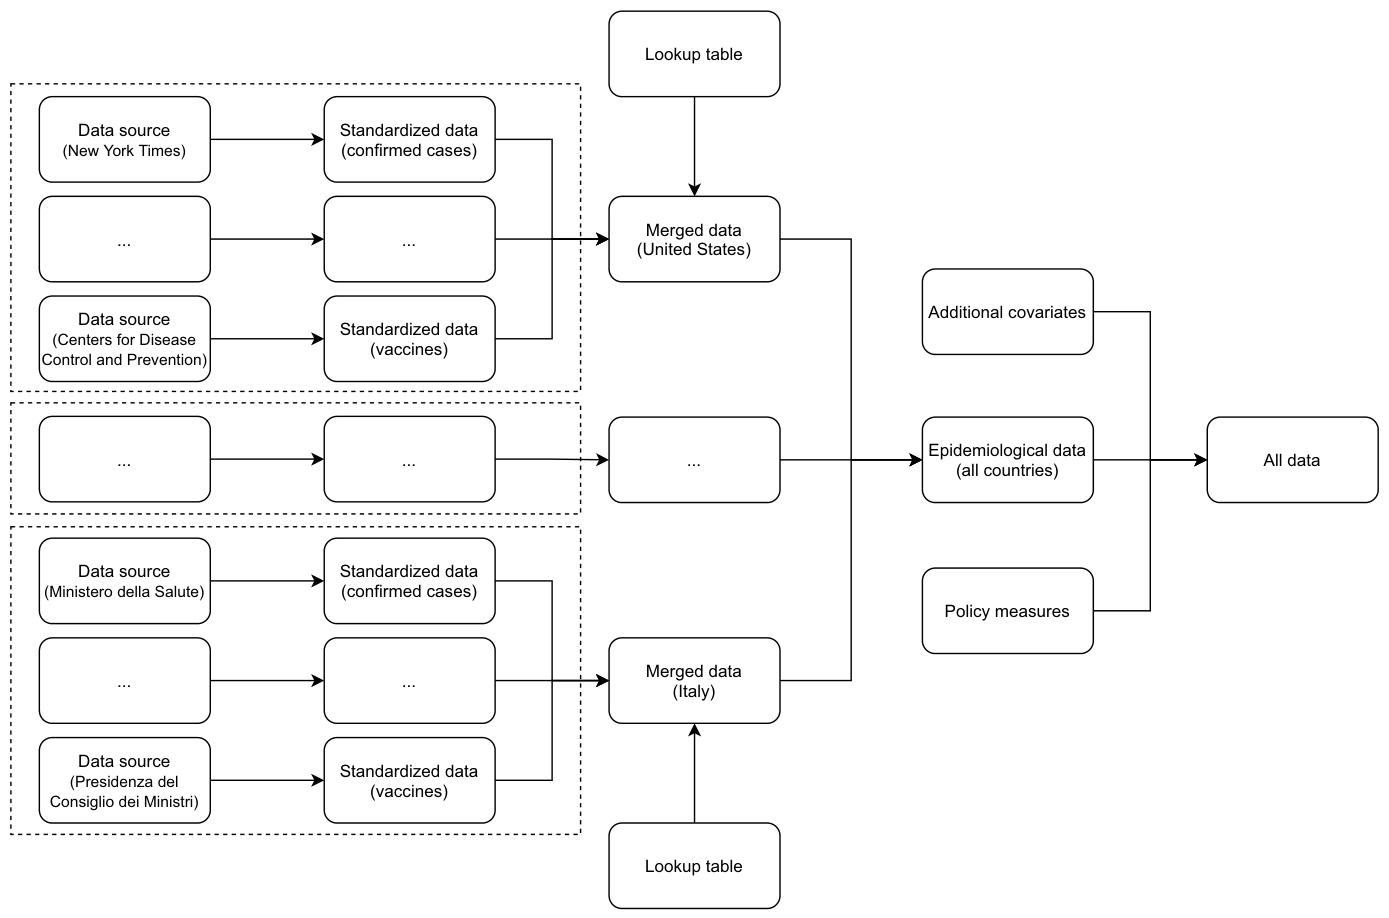
图 2|病例和疫苗来自不同机构,怎样仍能合并到一行?
本图没有字母子图。左侧以美国和意大利为例,原始数据先分别变成标准化变量;中间使用各国对照表形成国家内合并数据;右侧汇集各国流行病学记录,再接入额外协变量和政策措施。虚线框区分来源模块,箭头表示数据流。它展示的是数据组织方式,没有报告某种干预的效果。来源:原论文 Fig. 2。
表 2 列出了用户可以看到的外部匹配字段,包括本地统计编码、Google 和 Apple 出行数据标识、JHU 气象关联标识、NUTS 和 GADM 编码。字段存在并不等于边界严格一致。无法在 GADM 中找到一一对应区域时,系统有替代规则;若一个统计区覆盖多个 GADM 区域,会采用更接近其中心的区域编码。因此,研究面积、人口分母或空间邻接关系时,仍要检查实际边界,不能只凭成功连接就认定完全一致。
每日新增、累计数和住院人数,不能混成一种量
表 1 的确诊、死亡、康复、检测和疫苗接种相关变量主要是累计数;vaccines 是累计接种剂次数,people_vaccinated 是至少接种一剂的人数,people_fully_vaccinated 是完成当时接种方案的人数。剂次与人数不能互换。
hosp、icu、vent 则分别是当天住院、重症监护和需要侵入性通气的患者数,属于当日状态量,不能像累计病例一样差分后称作新增住院人数。
不同空间层级也不应随意加总。数据库通常分别从直接报告相应层级的来源取数,而不把下级数据简单加总为上级总数,因为下级可能缺报,或存在无法归属的病例。全国、地区和县市记录混在一起求和,还会造成重复统计。
为什么不能只补上今天的数据?
政府会因为迟报、重复记录或定义变化修改历史值。只把新一天追加到旧数据,会把不同统计版本拼成一条不存在的曲线。系统因此下载来源的完整序列,按原来源更新历史。
论文描述的架构由持续运行的服务器更新 SQLite 数据库,另一个定时任务每小时导出并上传公开文件。完整重建一次需要下载和处理数 GB 数据,约耗时 1—2 小时。这些都是论文所报告的运行设计,不能据此假定多年后的每个来源仍按同样频率更新。
对研究可重复性更关键的是 vintage data,即每日固定快照。你应记录分析使用哪个快照、什么时候下载,而不只记录一条会变化的下载地址。论文还把 2021 年 11 月 27 日版本单独归档。这样才能区分模型变了、原始数据修订了,还是下载版本不同。
SQLite 中,location 保存地区属性,timeseries 保存随时间变化的指标,按 id 连接;CSV 则提供按空间层级、国家或单独地区拆分的合并数据。下载国家文件时尤其要检查层级列,因为同一文件可能同时包含全国、地区和更低层级。
负数不一定是错误,更不一定都能当数字运算
一类负数来自历史修订:累计病例数下降,差分就可能得到负的每日新增。数据库保留原来源,而不自行平滑。这不意味着真实世界有人被负感染,而是记录被修订。把所有负值设为零,会改变累计关系并掩盖报告机制。
另一类负数是政策编码。数据库继承 Oxford COVID-19 Government Response Tracker 的有序政策值,并用负号标记区域定向政策;综合政策指数若从上级继承,也用负号与本地直接提供的值区分。这里的负号是来源与适用范围标记,不能当成政策方向相反或强度低于零。
当没有地区政策时,国家政策会传递给下级;有次国家级政策时,更低地区又可能继承次国家级值。因此,细尺度病例配上一列政策,不代表政策本身也经过同样细的本地观测。研究者若忽略继承与定向标记,可能把同一国家政策当成许多独立的地方政策变化。
质量控制,究竟保证了什么?
论文列出四道保障:首次接入时人工抽样核对;自动检查日期、重复地区—日期和变量关系;覆盖旧版本前检查历史是否意外丢失,并保留更新时间;公开代码供使用者持续检视。
自动规则会检查死亡是否超过确诊、完全接种人数是否超过至少接种一剂人数等关系。但原始来源有时因统计定义或起始日期不同而违反这些规则。系统记录并人工复核问题,向整理者反馈,不以自己的推断替换原始数值。
所以这是一套可追溯、可复核的数据汇集机制,不能证明官方记录等于真实感染人数,也不能让检测强度、死亡定义和报告延迟在跨国间自动可比。论文引用的政策、出行和气候研究是这套数据的应用案例;其效果结论并不是这篇数据论文重新识别出的结果。
一句话总结
把疫情数据统一起来,既要知道每个数对应哪个地方、哪种口径,也要保存它在当时的版本;否则一条看似稳定的历史曲线,也会悄悄改变。
核心来源
- Guidotti, E.(2022)原论文及完整图表,Scientific Data 9, 112。本文图 1—2 均源自该论文,所有覆盖数字均对应论文所述历史版本。
- 论文所列数据入口与文档。
- 数据库开源代码。
作者介绍
Emanuele Guidotti 为本文唯一作者,论文署名单位为瑞士纳沙泰尔大学金融分析研究所。按作者贡献说明,他设计数据库、开发软件、搭建云端基础设施、整理数据并撰写论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
实时预测与事后解释,需要的可能是两套历史数据。评价一个预测系统在 2020 年某一天能否及时报警,应使用那一天已经公开的信息;若用后来回填完整的历史序列训练或评估,就会把当时不知道的病例偷偷交给模型,形成前视偏差。
一个可实施的比较是:固定同一个模型,分别用当日快照与最终修订数据重跑预警,观察报警时间和误差如何变化。这能把预测能力与报告体系的修订影响分开。对出行限制的研究也是如此:若病例曲线被大幅追溯修订,所谓政策生效后几天出现转折,可能部分来自报告版本,而非传播机制本身。