手机不是人手一部,一个区的出行范围会被估偏多少?
论文名片|Amy Wesolowski、Nathan Eagle、Abdisalan M. Noor、Robert W. Snow、Caroline O. Buckee,The impact of biases in mobile phone ownership on estimates of human mobility,Journal of the Royal Society Interface,2013,10:20120986,2013年2月6日发表。DOI:10.1098/rsif.2012.0986。收稿日期2012年11月28日,接收日2013年1月15日。这是一项把通信记录和入户调查在区一级配对的观察研究。
一个区若想知道居民一年里离开自己的活动中心有多远,很难给每个人做出行日记。通话和短信能把通信时刻对到基站,于是常被拿来代表全区的人类移动(human mobility)。这里的移动是人在空间中的活动范围,不是搬家或户籍迁移。记录里出现的人,首先得有手机,还得真的发出通信。收入更高的人如果既更可能持有手机,也走得更远,全区的活动范围就会被写成持有者的活动范围。
这篇论文用2008年6月到2009年6月的肯尼亚通信记录,配上2009年同一国家的入户调查,检查持有偏差会把移动估计推偏多少。话费确实跟着收入走,高话费也对应更大的活动范围;按各区的收入结构把没有手机的人补回去之后,活动范围的分布几乎没变。方向上,多数区会把移动估得略高,分布整体的差别仍然很小。
先说结论
- 通信记录包含14,816,521名用户,约为肯尼亚人口的38%,时间是2008年6月到2009年6月,近120亿次通话和短信。数据来自当时占手机市场份额92%的在位运营商。对照调查在2009年访问了32,748名16岁及以上的人,分布在646个社区。38%的分母是全国人口,92%的分母是手机市场。
- 在这些手机用户里,话费更高的人活动范围更大。正文给出的统计量是 F=1.6752,p<0.0001。调查中话费与月收入的列联系数是0.47,p<0.001。各区内部,月收入与活动范围的平均相关系数是0.19,略为正,区与区之间并不一样强。
- 按调查里各收入档占该区人口的比例重加权之后,未调整分布与调整后分布的平均熵是0.0011。从均值和标准差都相同的正态分布中另抽两套数,平均熵是0.00252。作者把这两个数看成相近的量级。
- 分布接近的同时,方向并不对称:做了比较的区里,73%的区只用通信记录会把人口的移动估高。正文没有给出这73%平均高估了多少公里。
- 这种补全依赖每个收入档里都有一些手机持有者。同一档的持有者被用来代表非持有者。收入以外没有测到的因素,可能得到不同的调整。
这14,816,521人占全国人口的多少?
通信记录来自肯尼亚当时的在位运营商,覆盖2008年6月到2009年6月该运营商用户的全部通话和短信。用户数是14,816,521,摘要写成近1500万,正文写明约为肯尼亚人口的38%。近120亿次通信用来估计位置。数据里有12,502座基站,每次通信对应该用户当时所在基站的经纬度。这家运营商占手机市场份额的92%,因此记录覆盖全国绝大部分手机用户。不持有手机的人没有进入这套记录。
调查由 Financial Sector Deepening Kenya 在2009年完成,共32,748人,位于646个社区。抽样框是肯尼亚国家统计局的 National Sample Survey and Evaluation Programme(NASSEP IV)。第一层按省、以及省内城乡抽取社区,使全国、省和城乡都有代表性。第二层的设计目标是每个抽样簇10户。第三层在户内用 Kish 网格抽取16岁及以上的一个人。调查问了手机持有、每月话费、收入,以及教育、住房等状况。引言里的近3.3万人就是这32,748人。
两边都是肯尼亚、都落在2008至2009年,记录的是不同的人。通信记录是一家运营商的用户。调查按抽样设计代表全国、省和城乡的16岁及以上人口。论文写明,把某一名受访者对到某一条通信记录上会违反运营商的隐私规定,因此没有做个人层面的配对。后面的调整发生在每个区内部:用话费档把两组数据接起来,再用调查里的收入结构重加权。
引言另给了一个大陆尺度的背景:2008年非洲约有2.8亿手机用户,约占非洲人口的30%,并称这已经多于北美的用户数。这组数字引自引言中的既有文献。肯尼亚这套记录自身的人口比例是14,816,521人,约为肯尼亚人口的38%。
作者此前在卢旺达和肯尼亚的研究里写过,手机持有者相对总人口更偏男性、受教育程度更高、家庭也更大。男性、教育和家庭规模的新比例不在本文正文里。出行日记和定位研究发现,经济约束更少、更能使用交通工具的人,一天的出行更多、社交出行更多、距离也更远。这些结果来自此前的调查,构成本文预期移动会被估高的理由。
回转半径量的是基站记录离开活动中心有多远
每人先得到这一年的一个活动范围,再汇总到区。指标是回转半径(radius of gyration)。对用户 a,在考察时段 t 内记下 n 次基站位置。活动中心是这 n 个位置的平均。回转半径是这些位置离开活动中心的均方根距离:
r_g = √[ (1/n) × Σ (位置_i − 活动中心)² ]
图里的单位是公里。数值变大,表示记录更多地落在远离活动中心的基站。论文认为它同时反映出行的距离和频繁程度:更高的值对应更多出行、也对应更远的距离。公式清点的是通信时刻的基站,每次记录权重相同。沿路里程和单次最远距离要另算。
人在外面打得越勤,远方基站进入平均的次数就越多。作者报告,通话量与回转半径正相关,模拟显示这种关系会增大估计的方差。回转半径因此受采样密度影响。没有产生通信的路程不进入这个平均数。
调查询问的是受访者自报的每月话费。通信记录里的月话费由通话量折算,资费按当时每分钟3肯尼亚先令,文中写明1美元约等于75先令。位置估计使用通话和短信,话费折算使用通话量。
话费更高的人,活动范围的右尾更厚
在全部手机用户中,按通信记录算出的话费百分位分组,再看每组的回转半径分布。话费越高,活动范围越大。正文给出的检验是 F=1.6752,p<0.0001。p<0.0001表示这组差异在统计上站得住。补上各收入档人口之后分布移动多少,要看后面的熵。
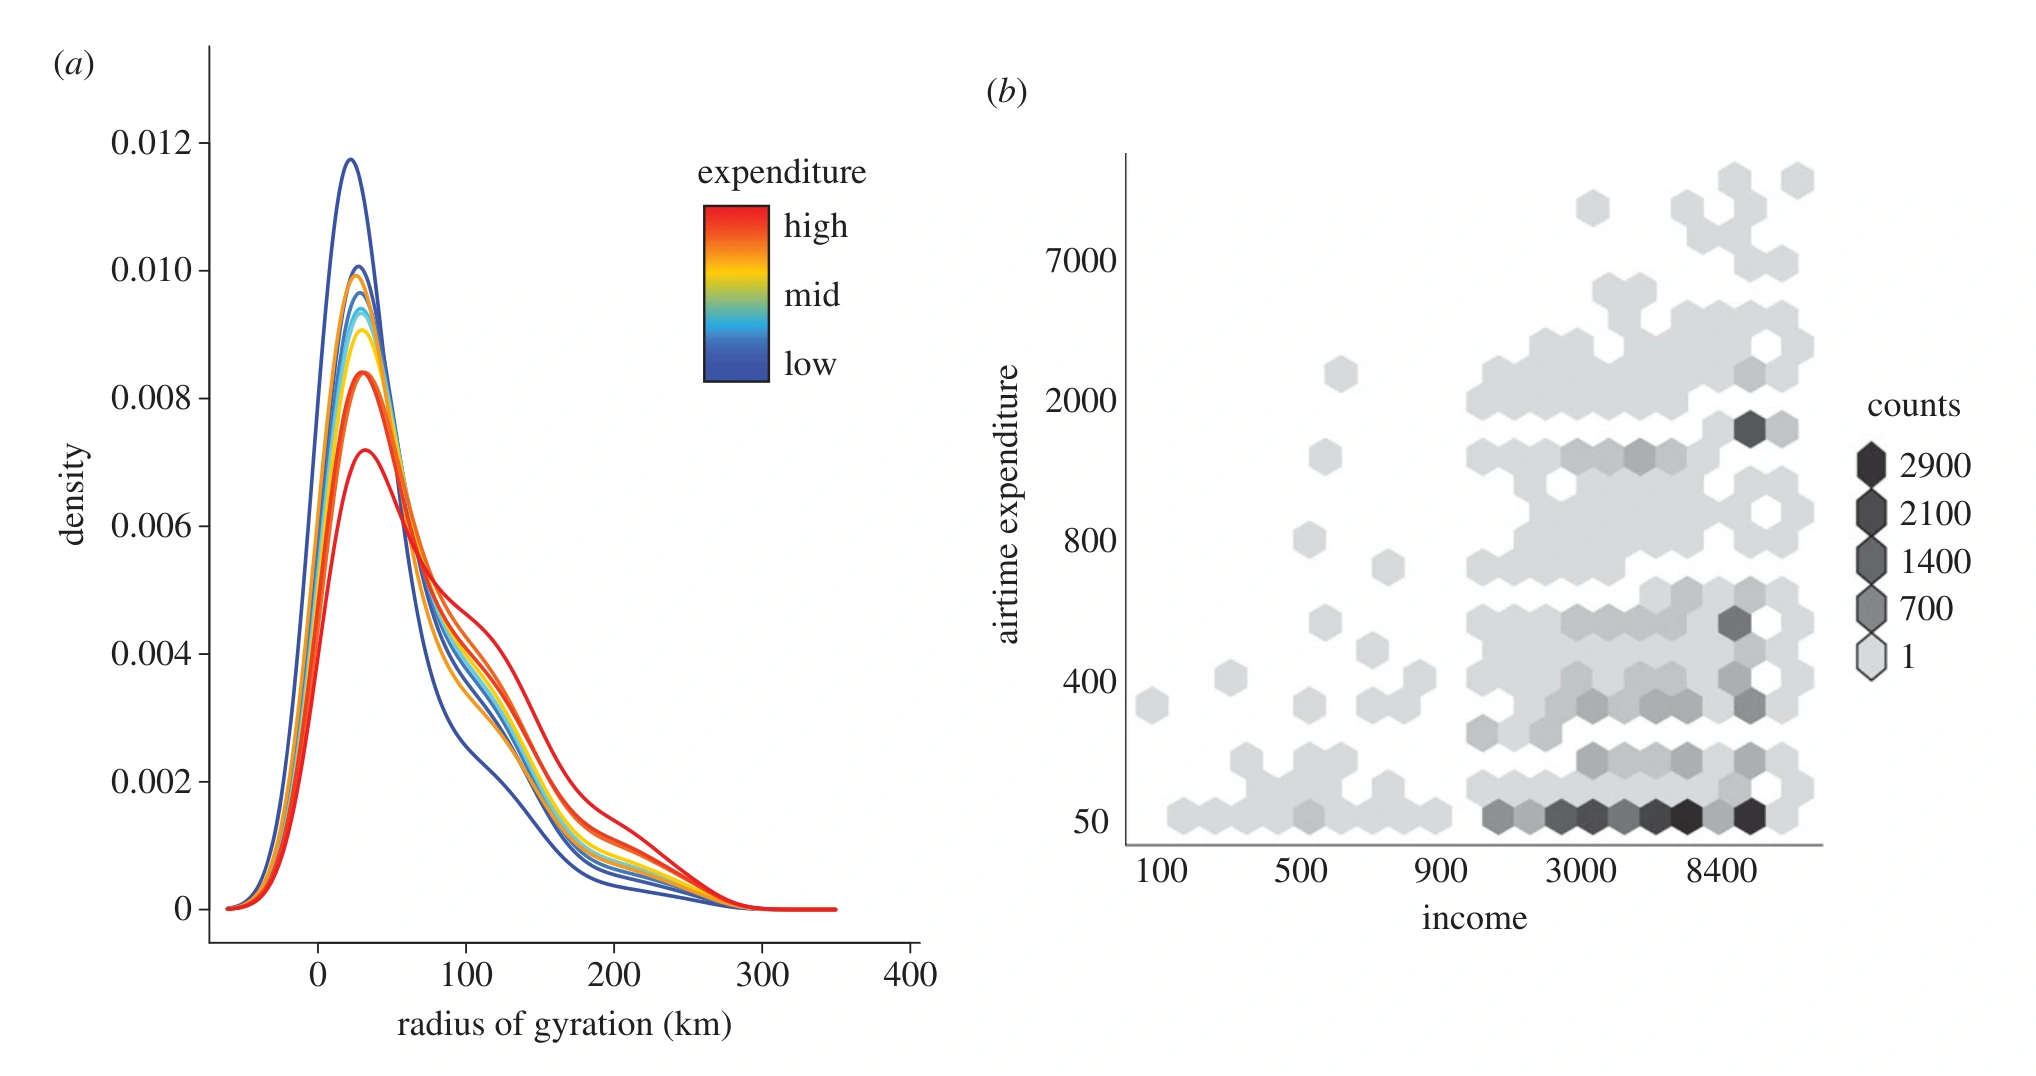
图 1|话费、收入和活动范围是不是一起升高?
(a)通信记录中的用户按话费百分位分组。横轴是回转半径,刻度从0到400公里;纵轴是密度,刻度到0.012。颜色从蓝到红表示话费从低到高。各组的最高峰都落在0到100公里这一段。低话费曲线的峰最高,峰顶接近0.012;高话费曲线的峰更低,过了峰值以后下降更慢,在100公里以外留下更厚的右尾。到300公里附近,各组密度都已经很低。(b)调查受访者的最低月收入与话费。横轴标出100、500、900、3000、8400,纵轴标出50、400、800、2000、7000,刻度间隔并不相等,图上没有印货币单位。格子深浅表示落在该收入与话费组合上的人数,图例从1到2900。话费大体随收入上升,同一收入刻度上的话费仍然可以差很多。来源:原论文 Fig. 1。
调查里,话费与月收入的列联系数是0.47,p<0.001。列联系数描述两个分类变量有多一起变动:0是无关,越接近1关联越强。0.47是关联强度,把它当成收入解释了话费变异的比例会读错。作者因此把话费当作经济状况的可用代理。图1b同时显示,同一收入上的话费仍然很散,代理是粗的。
到了各个区,通信记录里的活动范围与话费、调查里的月收入与话费,在大多数区都是正向关系。各区内部月收入与回转半径的相关略为正,平均相关系数是0.19,强弱随区变化。0.19是相关系数。相关说明这些量一起变动。这套区级配对识别不了持有手机是否使人走得更远。
没有手机的人,靠同一收入档的持有者进入分布
若只是全国平均,还看不出某个区的人口结构会把估计拉向哪一边。作者在每个区里,把通信记录按实际话费分成若干档,算出各档的回转半径,再对上调查里自报的月话费和收入。收入档按该区受访者报告收入的分位数划分。重加权使用的是各档人数占该区人口的比例,不论这些人有没有手机。
这一步能做完,是因为每个收入档里都有一部分人持有手机。没有持有者的档,就没有可借用的回转半径。调整因此有一个明确的假设:同一收入档里,没有手机的人与有手机的人共享持有者身上测到的活动范围。论文没有直接观察到非持有者的行程。
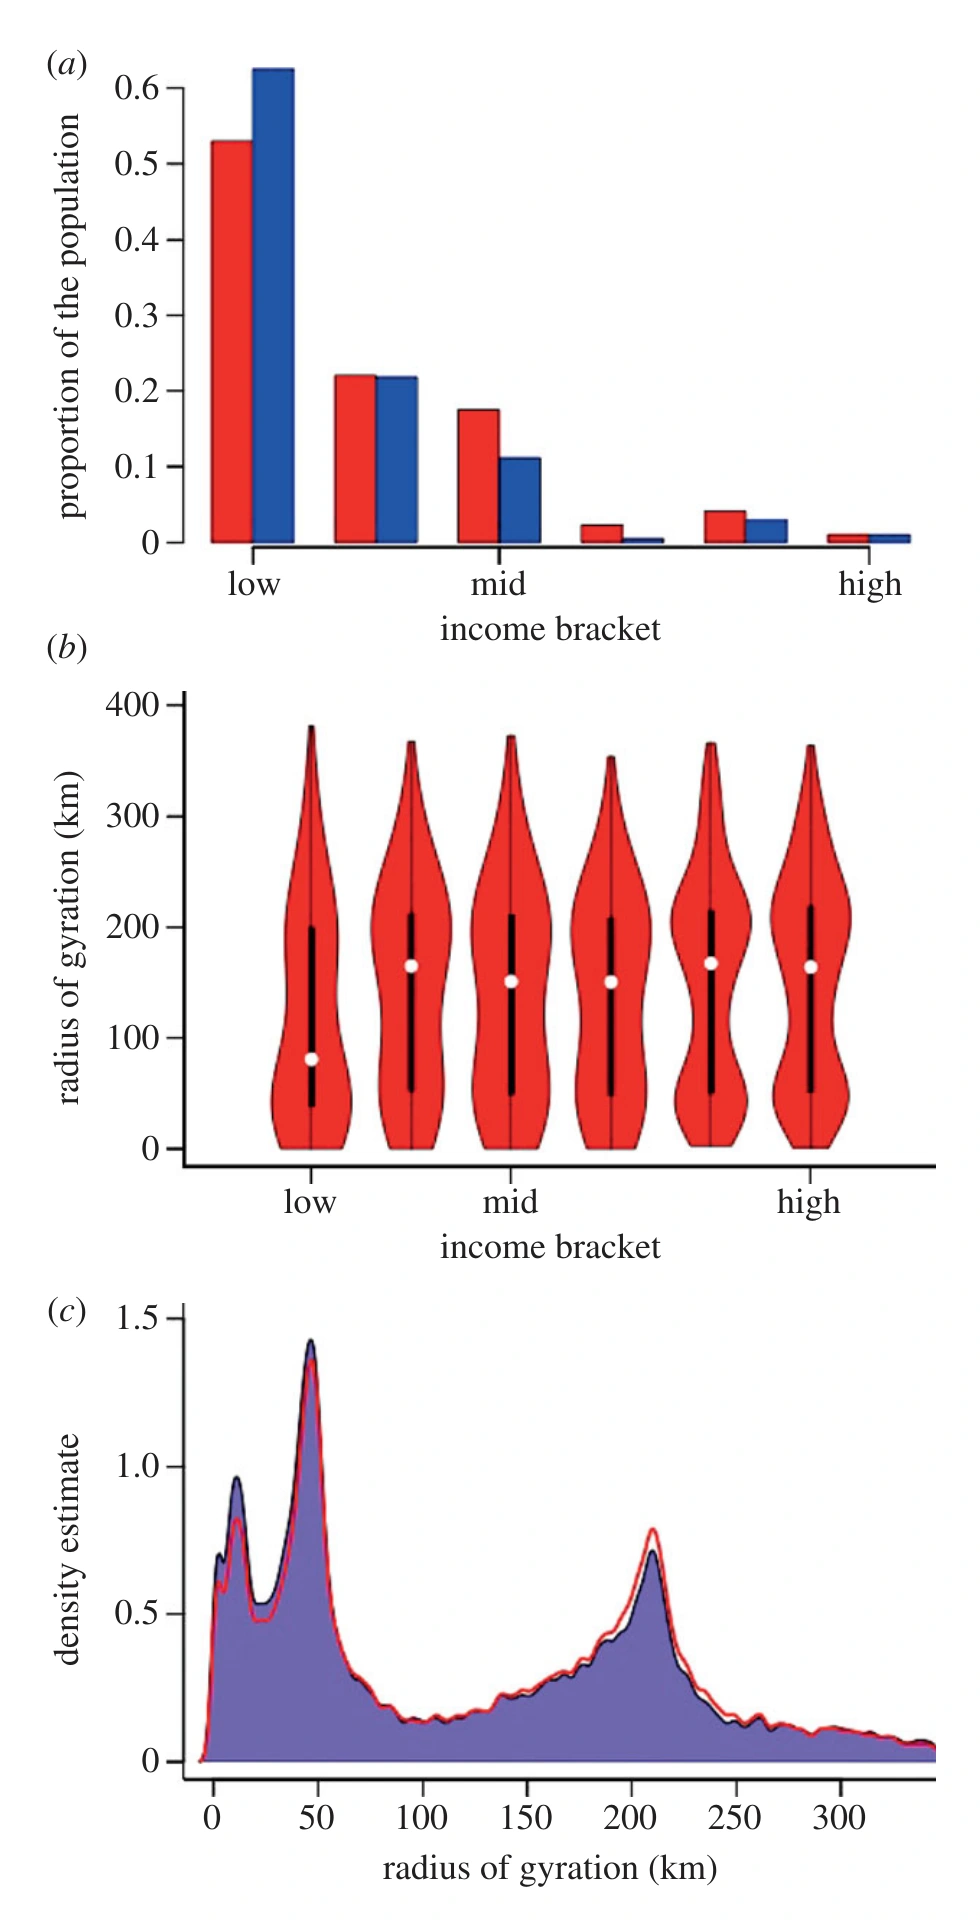
图 2|马林迪这一个区,怎样把持有者的活动范围调成全区人口的分布?
(a)样例区马林迪。横轴是低、中、高三个收入档,纵轴是占该区人口的比例,刻度从0到0.6。红色是手机持有者,蓝色是非持有者。低档的两条最高,蓝条到达0.6的刻度,红条低于蓝条。中档红条与蓝条高度接近,都明显矮于低档。高档两条都很矮,红条高于蓝条。全区人口的权重主要落在低档。(b)同一批收入档上,持有者回转半径的小提琴图。纵轴刻度到400公里。各档的分布都从贴近0拉到300公里以上,并带有长长的上尾。档与档之间的形状接近。图中的白点和黑色竖线,图注没有单独定义。(c)核密度。横轴是回转半径,标到300公里;纵轴是密度估计,刻度到1.5。红线只含手机持有者,紫色是按各收入档的人口比例重加权之后的密度。短距离有一个尖峰,200公里刻度附近还有一处隆起。两条曲线大部分重叠,差别主要出现在峰的高低。来源:原论文 Fig. 2。
马林迪用来示范一个区的算法。低档既占人口大头,蓝条又高于红条;高档两条都很矮,红条高于蓝条。低档持有者在重加权里权重大。图2b各档的形状本来就接近,所以图2c两条密度仍然叠在一起。各区是否都如此,要看下一张图的熵。
各区的相关强弱不同,作者按区的人口用非参数方法做了调整,并引用 Handcock 与 Morris 1998年的相对分布。比较分布是未按人口调整的回转半径,也就是只从手机用户测到的分布。参照分布是按人口调整后的回转半径。相对分布把两者放在同一个尺度上,看未调整分布相对调整后的分布,在低段、中段和高段是偏多还是偏少。它不要求原始分布呈钟形。
两条分布差多少,用库尔贝克–莱布勒散度(Kullback–Leibler divergence)概括,正文称之为熵。未调整分布若按调整后分布的方式来编码,平均要多付出多少信息,熵就是这个量。熵越接近0,两条分布越像。差异落在中间还是两端,用极化指数看。中位相对极化(median relative polarization,MRP)为正,表示两端更张开;为负,表示更向中间收拢;为0,表示形状没有差别。下尾相对极化(lower relative polarization,LRP)和上尾相对极化(upper relative polarization,URP)把这种差别拆到中位数的两侧。
各区的分布很像,多数区仍略偏向高估
合成例子先给这个统计量一个刻度。三幅小图的横轴写的是 value,单位不是公里。图注说明它们分别被拉向低尾、中部和上尾,并叠在另一套合成分布上。
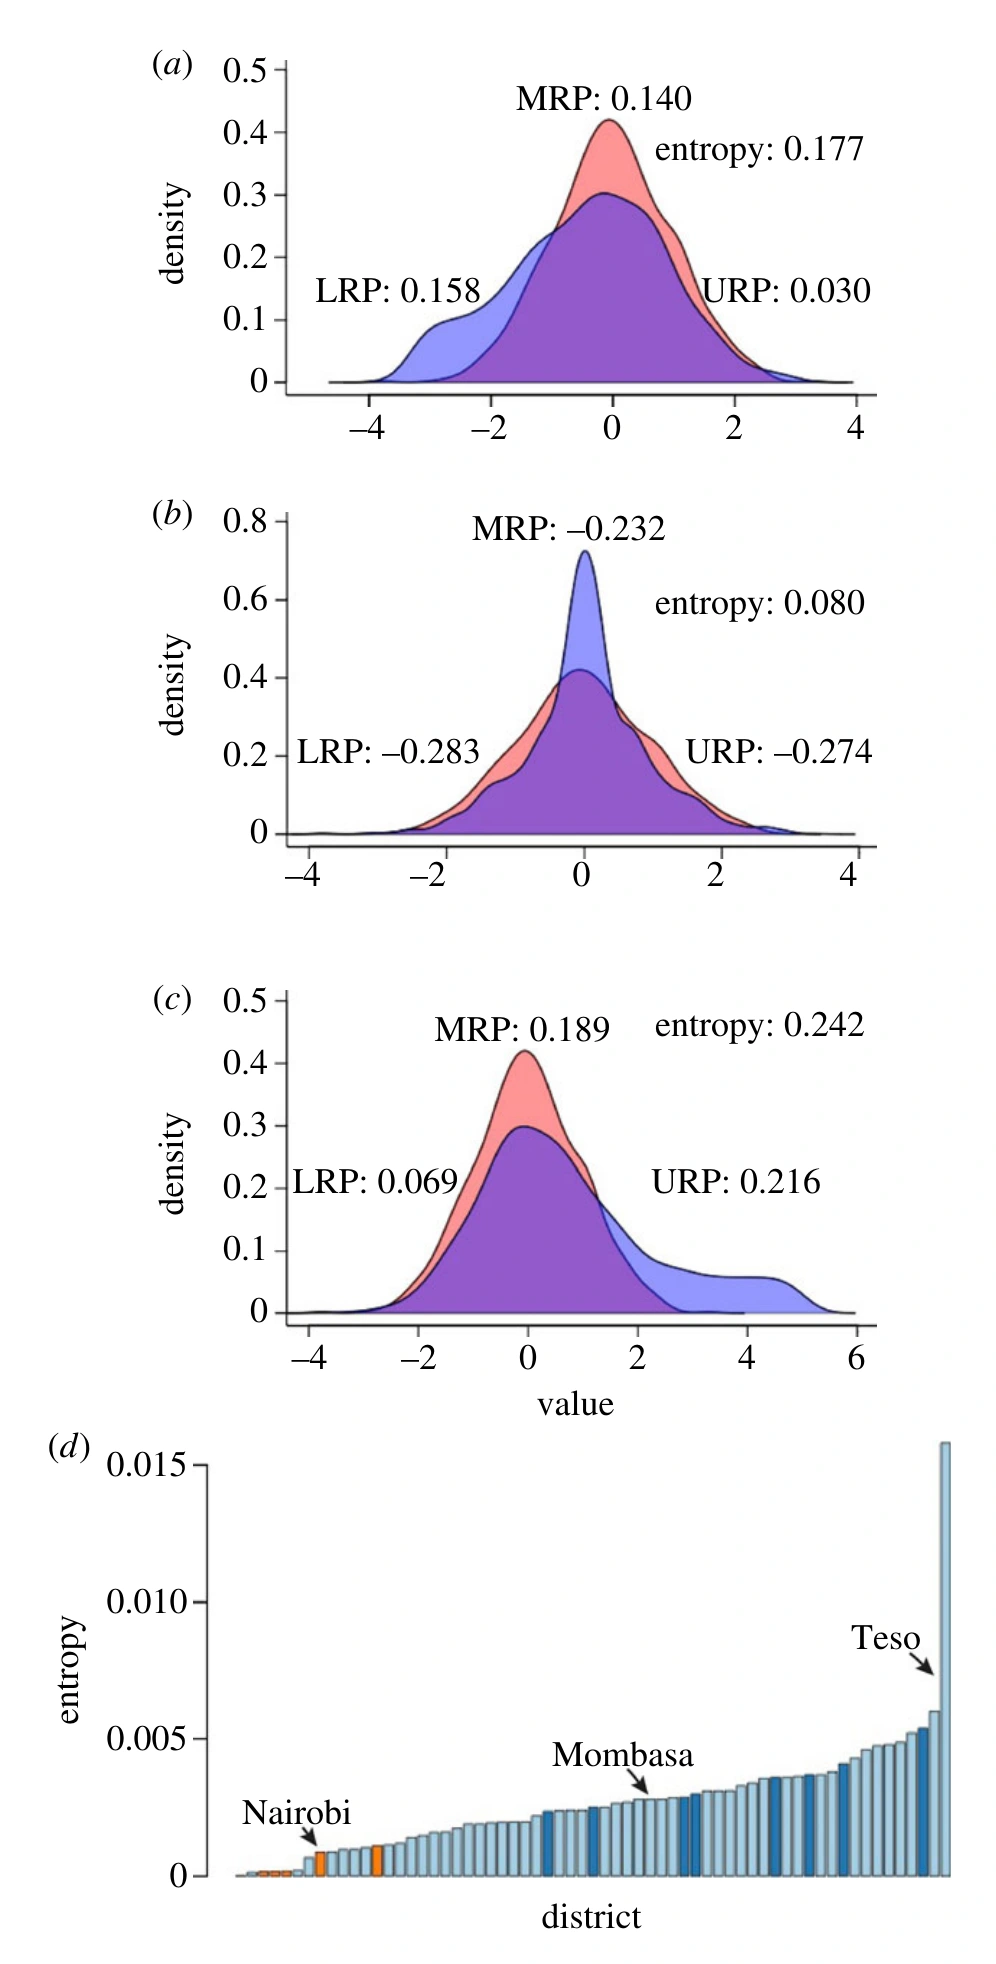
图 3|分布要差到什么程度,持有偏差才算把移动估计推歪了?
(a)合成数据被拉向低尾。两条密度叠在一起。图上标出 LRP=0.158、MRP=0.140、URP=0.030,熵=0.177。横轴标有−4到4,纵轴密度刻度到0.5。下尾指数大于上尾指数。(b)合成数据被拉向中部。三个极化指数都是负数:LRP=−0.283,MRP=−0.232,URP=−0.274,熵=0.080,是三幅合成图里最小的熵。纵轴密度刻度到0.8。(c)合成数据被拉向上尾。URP=0.216,大于 LRP=0.069;MRP=0.189,熵=0.242,是三幅里最大的熵。横轴标到6,纵轴密度刻度到0.5。(d)肯尼亚各区的真实比较。横轴是按熵从低到高排列的区,纵轴熵的刻度到0.015。颜色按偏斜位置区分:LRP 为蓝,MRP 为橙,URP 为深蓝。大多数柱子是蓝色系,橙色很少。内罗毕标在左端接近0的位置,蒙巴萨位于中段,特索标在右端;右端最高的柱子超出0.015。来源:原论文 Fig. 3。
各区这套真实比较的平均熵是0.0011,远小于合成例子里最小的0.080。作者又用均值和标准差完全相同的两套正态样本做参照,那组参照的平均熵是0.00252,并认为与0.0011相近。正文没有给出这组正态参照的样本量。就分布整体而言,只看手机用户和补上各收入档人口之后,差别与从同一个正态分布抽两套样本时的差别处于同一量级。
右端最高的柱子超过0.015,少数区的熵明显高于平均0.0011。图3d按熵给区排序。颜色表示剩余差别落在下尾、中部还是上尾。读高估还是低估,要看正文单独给出的73%,不能只看柱子的颜色。
方向要单独看。作者写明,尽管两条分布很像,只用通信记录仍倾向于高估人口的移动,这种情况出现在73%的区。分母是做了上述比较的区,不是人数。一个很小的熵和“多数区偏向同一侧”可以同时成立:各区的分布形状几乎重合,剩下的细小差别却更常落在“把移动估高”的那一侧。正文没有列出各区调整前后平均回转半径相差多少公里,所以这73%不能换成一个公里数。
它能支持到哪一步
作者的判断是谨慎乐观:在持有率差异很大的情况下,通信记录仍能给出跨收入范围的个人移动分布,而且一个区内的分布对持有偏差相当稳。这个判断限于肯尼亚2008至2009年、这家运营商的用户,以及用收入和话费搭起来的那一种调整。作者写明还需要在其他地方复核。
几条边界跟着结果一起成立。第一,同一收入档的持有者代表非持有者。非持有者若在同样收入下走得更近或更远,调整会漏掉这部分差别。第二,收入是他们选的桥梁,因为话费与收入相关;换用别的、同样跟持有相关的变量,结果可能略有不同。第三,通信记录难以单独识别因果。景观变化怎样改变出行,仍然要靠能问到出行目的的调查。第四,回转半径只看见产生了通信的基站。通话更频繁会增大估计的方差,高话费组更厚的右尾里同时混有走得更远和在外面打得更多。第五,各档人口比例来自16岁及以上人口的分层样本,调查没有逐人覆盖全体居民。
原始通信数据由匿名运营商提供,论文写明不能对外分发。公开文本里能核对的是已经汇总的分布比较。
一句话总结
在2008至2009年的肯尼亚,手机持有和话费确实偏向更高收入、更大的活动范围;按各区收入结构补上没有手机的人之后,活动范围的分布几乎没变,只是73%的区会把移动估得略高。
核心来源
Wesolowski A, Eagle N, Noor AM, Snow RW, Buckee CO. 2013. The impact of biases in mobile phone ownership on estimates of human mobility. J. R. Soc. Interface 10: 20120986. DOI:10.1098/rsif.2012.0986。
通信记录来自肯尼亚当时的在位运营商,论文未写出运营商名称。收入、持有和自报话费来自 Financial Sector Deepening Kenya 2009年调查;方法部分给出的调查说明网址是 http://www.fsdkenya.org 。相对分布方法引自论文参考文献中的 Handcock MS, Morris M. 1998. Relative distribution methods. Am. Sociol. Assoc. 28: 53–97,doi:10.2307/270964。
作者
Amy Wesolowski 是本文第一作者,署名单位是卡内基梅隆大学工程与公共政策系。致谢写明她当时由美国国家科学基金会研究生科研奖学金资助,编号0750271。
Nathan Eagle 的署名单位是美国东北大学计算机与信息科学学院,以及哈佛大学公共卫生学院流行病学系。本文参考文献中的 Reality Mining 来自他与 Pentland 2006年的合作,用手机数据观察日常行为。
Abdisalan M. Noor 署名于内罗毕 KEMRI–Wellcome Trust–牛津大学合作项目,以及牛津大学纳菲尔德临床医学系热带医学中心,地址在牛津丘吉尔医院。致谢写明他当时是惠康信托 Intermediary Research Fellow,编号095127。
Robert W. Snow 与 Noor 同属上述内罗毕合作项目和牛津大学热带医学中心。致谢写明他是惠康信托 Principal Research Fellow,编号079080;两人也接受该合作项目的惠康信托 Major Overseas Programme 支持,编号092654。
Caroline O. Buckee 是通讯作者,署名单位是哈佛大学公共卫生学院流行病学系和传染病动力学中心(Center for Communicable Disease Dynamics)。论文给出的联系邮箱是 cbuckee@hsph.harvard.edu。致谢写明她当时的资助编号是1U54GM088558。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个区用这套分布决定普通公交该覆盖多远,0.0011的平均熵几乎不会改动“大多数人活动范围落在哪里”的判断。图1a里各组高峰都在100公里以内,重加权前后的密度又叠在一起。换一个盯着最长出行的问题,情况就不同:高话费曲线的右尾更厚,而且73%的区把移动估得略高。远距离班次、季节性长途会更多反映买得起话费的人。论文没有做线路模拟,这个差别是从右尾和73%的方向一起推出来的。
重加权能做完,是因为肯尼亚这些区的每个收入档都有一些持有者。若另一个地方最穷的一档几乎没有手机,这一档就没有可借用的回转半径,重加权会在这一档停住,全体居民的活动范围就补不完整。本文确认了每一档都有一些持有者,正文没有给出最低一档占人口的比例。
话费在本文里做了两件事:它把通信记录和收入档接上,又与回转半径同向变化。一个人在远方基站打得更勤,那些远点会更多次进入均方根,回转半径变大,即使实际走过的地点差不多。作者已经报告通话量与回转半径正相关,并认为这会增大方差。0.19的区平均相关里,有多少来自走得更远,有多少来自采样更密,正文没有拆开。要拆开,需要一套不依赖“谁选择打电话”的位置记录。本文的基站位置来自通信本身,提供不了这套对照。