性别、年龄和职业,会把刷卡足迹拉开多远?
论文名片|Maxime Lenormand、Thomas Louail、Oliva G. Cantú-Ros、Miguel Picornell、Ricardo Herranz、Juan Murillo Arias、Marc Barthelemy、Maxi San Miguel、José J. Ramasco,Influence of sociodemographic characteristics on human mobility,Scientific Reports,2015,5:10075,2015年5月20日发表。DOI:10.1038/srep10075。2015年7月17日勘误(Scientific Reports 5:12188,DOI:10.1038/srep12188)只更正标题用词,原标题误作 Influence of sociodemographics on human mobility。这是一项观察研究:比较2011年巴塞罗那省和马德里省信用卡客户在性别、年龄和职业上的消费与移动。
设想两名都住在马德里省、都用同一家银行卡的人。工作日中午,一个人的付款落在住家邮区附近的超市;另一个人的卡更常出现在傍晚的餐馆、交通和更远的店。把一年里的付款点连起来,年轻、在职持卡人的足迹通常拉得更开,女性持卡人更收在自己活动中心附近。下面的数字都来自组别统计,不是这两个人的档案。
人类移动性(human mobility)在这里指人在省内更换活动地点的空间范围,不是搬家,也不是户籍迁移。以往用手机或刷卡记录概括“人怎样移动”时,常常缺少年龄、性别和职业。这篇论文要看的是:这些社会人口特征会把付款地点的远近拉开多少。结论是组别差异清楚,而且男女差异在单独看年龄或单独看职业时仍然留着;它没有把性别、年龄或职业从收入、子女和岗位位置里拆成因果。
先说结论
- 两省合计802,023名客户、37,998,074笔本省交易。马德里531,818人,占该省普查人口6,489,680的8.2%;巴塞罗那270,205人,占5,540,925的4.9%。正文把这两个比例概括为大约8%和大约5%。男性约占样本0.51,普查大约0.48;30–45岁约占样本0.40,普查大约0.31。就业者在图上大约占0.70,正文概括为约占八成,并说大约是西班牙就业人口比例的两倍。后文的比较按各组人数归一化。
- 按每人全年支出计算类别份额后,女性在时装、食品超市、健康、保健美容上更高,男性在汽车、酒吧餐馆、电子和交通上更高。时装、食品、体育玩具、电子和交通的份额随年龄下降,汽车、健康、旅行社和保健美容上升。
- 花钱的钟点分成两类。大约三分之一的人更集中在上午和工作日,女性、年长者、家务劳动者和退休者在其中的占比高于全体;另一类更多在18点以后和周末花钱。
- 连续两次交易的间隔,平均值大约5天,中位数大约2天。活动半径的分布在大约6公里处最高;位移超过大约40公里后,因为省的范围而迅速变少。女性更短,距离和活动半径随年龄下降;退休者、家务劳动者以及程度较轻的失业者,也比就业者和学生更靠近自己的质心。把间隔时间对齐之后,距离差仍然在。
- 男女的间隔、位移和活动半径,在每个年龄段、每个职业里都超过0.001水平的分布检验阈值。家到商户的直线距离保持同一组别顺序。食品超市、健康、保健美容和图书文具更近,这些类别也是女性交易更多的地方,所以只能部分解释女性路程更短。
足迹记在付款终端上
数据来自毕尔巴鄂比斯开银行(BBVA)2011年的信用卡交易。每笔交易有金额、时间和匿名的客户、商户编号。客户带有性别、年龄、职业和居住地邮编;商户带有类别和刷卡终端的经纬度。研究只保留住在该省、并且付款也发生在该省的记录。客户和商户都是匿名编号,居住地细到邮编,分析比较的是组别。
年龄分成五组,区间左开右闭:大于15岁至30岁、大于30岁至45岁、大于45岁至60岁、大于60岁至75岁,以及75岁以上。满30岁的人落在第一组。职业分成学生、失业、就业、家务劳动和退休。
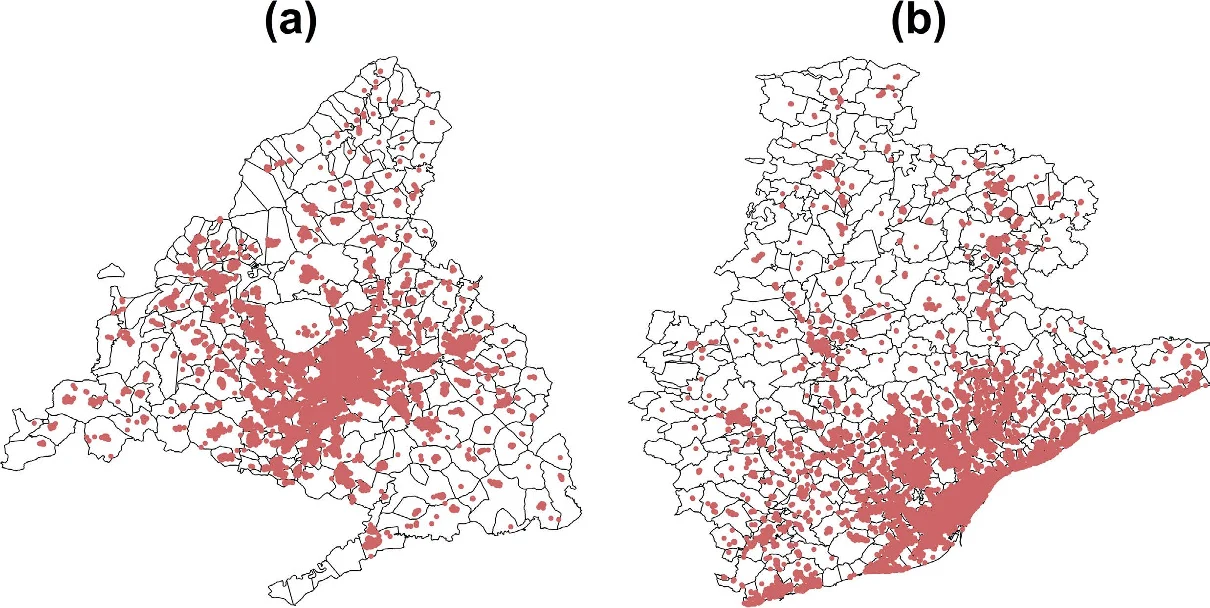
图 1|付款终端落在省内的哪些地方?
(a)马德里省,红点是交易位置,细线是邮编边界,密集区在省中部的城市。(b)巴塞罗那省,红点沿海岸和城市更密。两张图表示的是刷卡终端的位置,不是人口分布,也不是一个人的轨迹。来源:原论文 Fig. 1。
| 统计量 | 巴塞罗那省 | 马德里省 |
|---|---|---|
| 邮编数 | 368 | 271 |
| 普查人口 | 5,540,925 | 6,489,680 |
| 面积(平方公里) | 7,733 | 8,022 |
| 客户数 | 270,205 | 531,818 |
| 交易笔数 | 13,077,178 | 24,920,896 |
| 商户数 | 111,956 | 109,707 |
表1的笔数合计是37,998,074。方法部分把这次提取概括为4000万笔,表1是随后用于分析的本省居民、本省付款。两省人口和面积接近,马德里的客户和交易更多。一般特征和消费时间把两省合在一起,以便增加样本量;移动部分因为两省形状不同而分开。正文的移动图只画马德里。作者写明巴塞罗那有对应结果,并报告两边的分布差异和中位数差异大多达到同一显著性门槛。
谁在持卡人里偏多,钱又是怎样花出去的?
样本和普查并排之后,偏多的是男性、30–60岁和就业者。三个属性并不独立:学生和退休者的年龄结构不同,家务劳动者里女性更多。只按一个属性比较,另一个属性仍会混在里面。分布里离群值很多,所以笔数和金额都取中位数,而不是平均数。图上没有印出数据标签,下表是按坐标轴读出的大约值。比例的分母是样本中的客户,或2011年人口普查中的对应人口;金额和笔数的分母是该组每一名客户在2011年的记录。
| 组别 | 样本比例 | 普查比例 | 每人每年交易笔数中位数 | 每人每年金额中位数(欧元) | 每人平均单笔金额的中位数(欧元) |
|---|---|---|---|---|---|
| 男性 | 0.51 | 0.48 | 24 | 1,380 | 51 |
| 女性 | 0.48 | 0.51 | 31 | 1,510 | 44 |
| 15–30岁 | 0.15 | 0.19 | 29 | 1,100 | 35 |
| 30–45岁 | 0.40 | 0.31 | 35 | 1,670 | 44 |
| 45–60岁 | 0.27 | 0.23 | 25 | 1,570 | 55 |
| 60–75岁 | 0.12 | 0.15 | 16 | 1,210 | 64 |
| 75岁以上 | 0.02 | 0.09 | 10 | 890 | 74 |
职业面板没有并排普查柱。就业者的柱大约到0.70,正文概括为约占八成;学生、失业、家务劳动和退休都远低于0.10。每人每年的笔数和金额中位数大约是:学生20笔、710欧元,失业24笔、1,010欧元,就业31笔、1,630欧元,家务劳动27笔、1,480欧元,退休15笔、1,120欧元。每人平均单笔金额的中位数大约是学生33欧元、失业39欧元、就业47欧元、家务劳动50欧元、退休63欧元。
女性的全年笔数和总额更高,单笔更低。笔数和总额的高峰在30–45岁,不是最年轻的一组;45岁以后下降。单笔金额则随年龄上升。正文用“随年龄下降”概括笔数和总额,图上更准确的形状是30–45岁最高、其后下降。
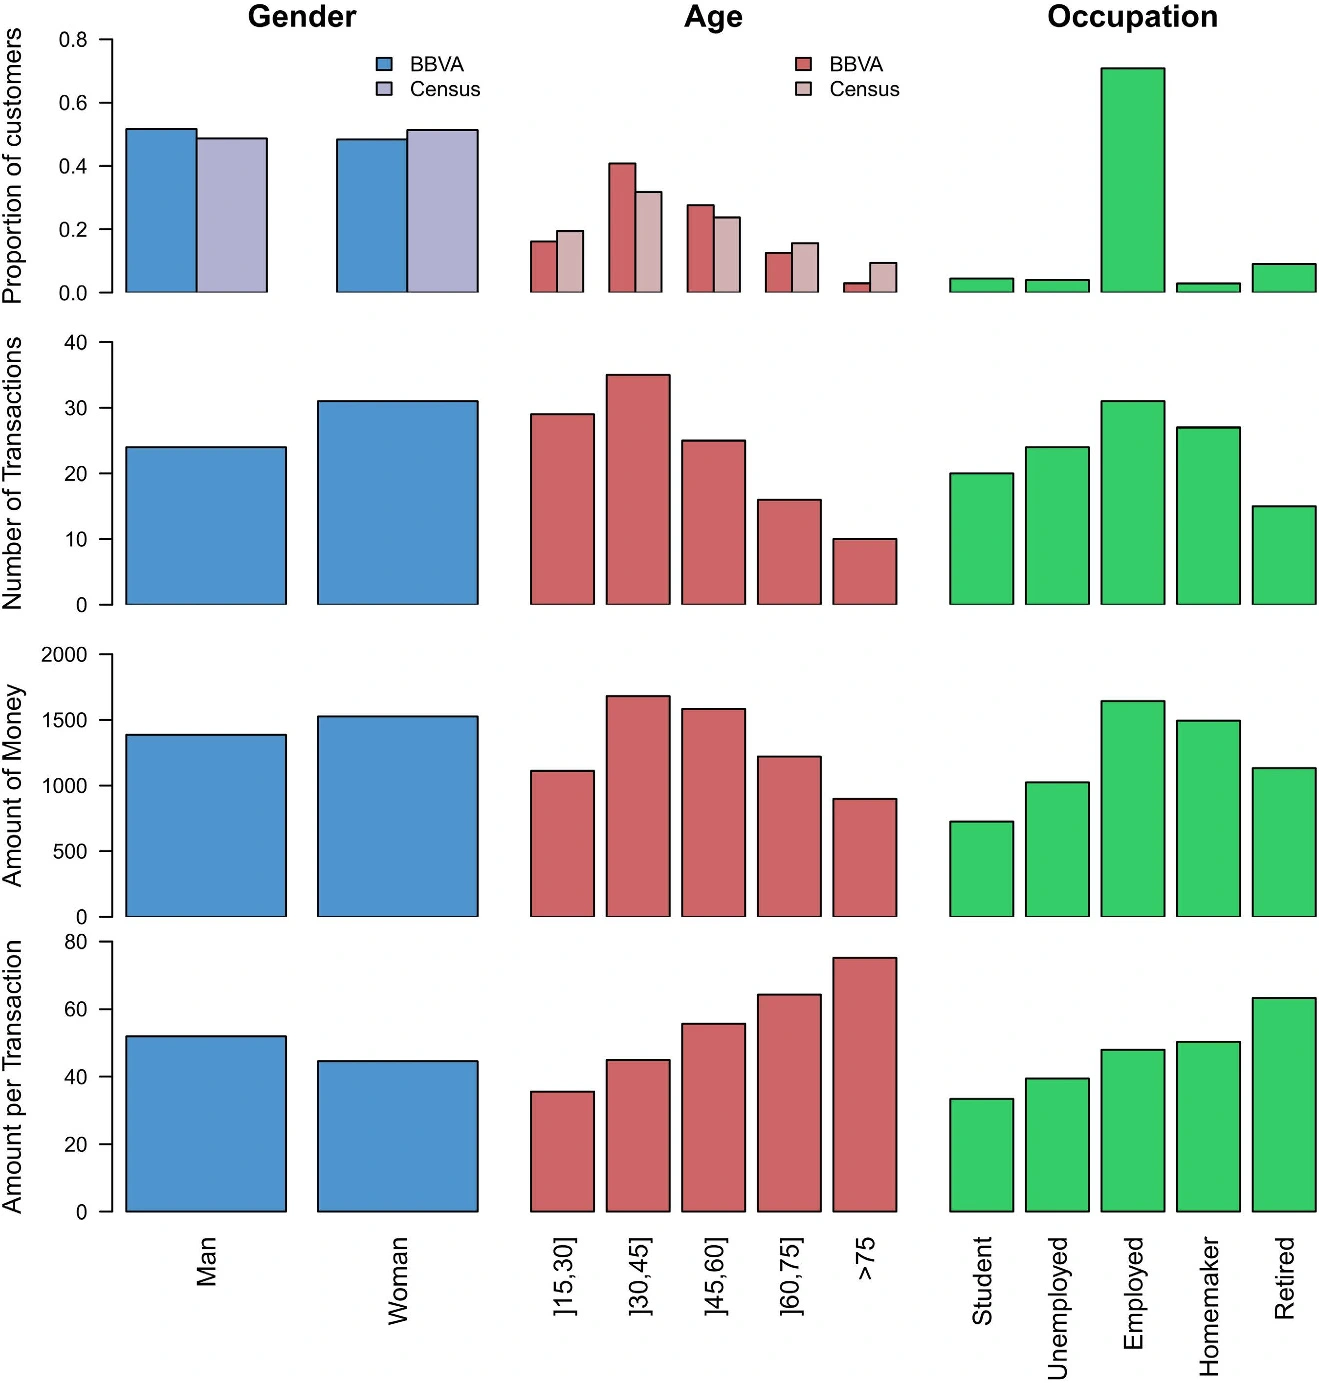
图 2|持卡人的构成和消费水平,与普查差在哪里?
图由上到下四行、由左到右三列,没有子图字母。第一行是客户比例:性别和年龄把样本与2011年普查并排,职业只画样本。蓝色为样本、浅紫色为普查;年龄的样本为红色、普查为浅色;职业为绿色。第二行是每人每年交易笔数的中位数,第三行是每人每年金额的中位数,第四行是先算每人的平均单笔金额、再取组内中位数。男性比例略高于普查,30–45岁和45–60岁高于普查,75岁以上明显低于普查;笔数和总额在女性、30–45岁、就业者和家务劳动者更高,单笔金额随年龄上升、男性高于女性。来源:原论文 Fig. 2。
类别份额的算法是:先把每个人2011年的总支出当成1,看各商户类别占这个人的比例,再对组内的人取平均。因此一个花钱少的人和一个花钱多的人权重相同。这是个人支出结构,不是全组欧元加总后的份额。
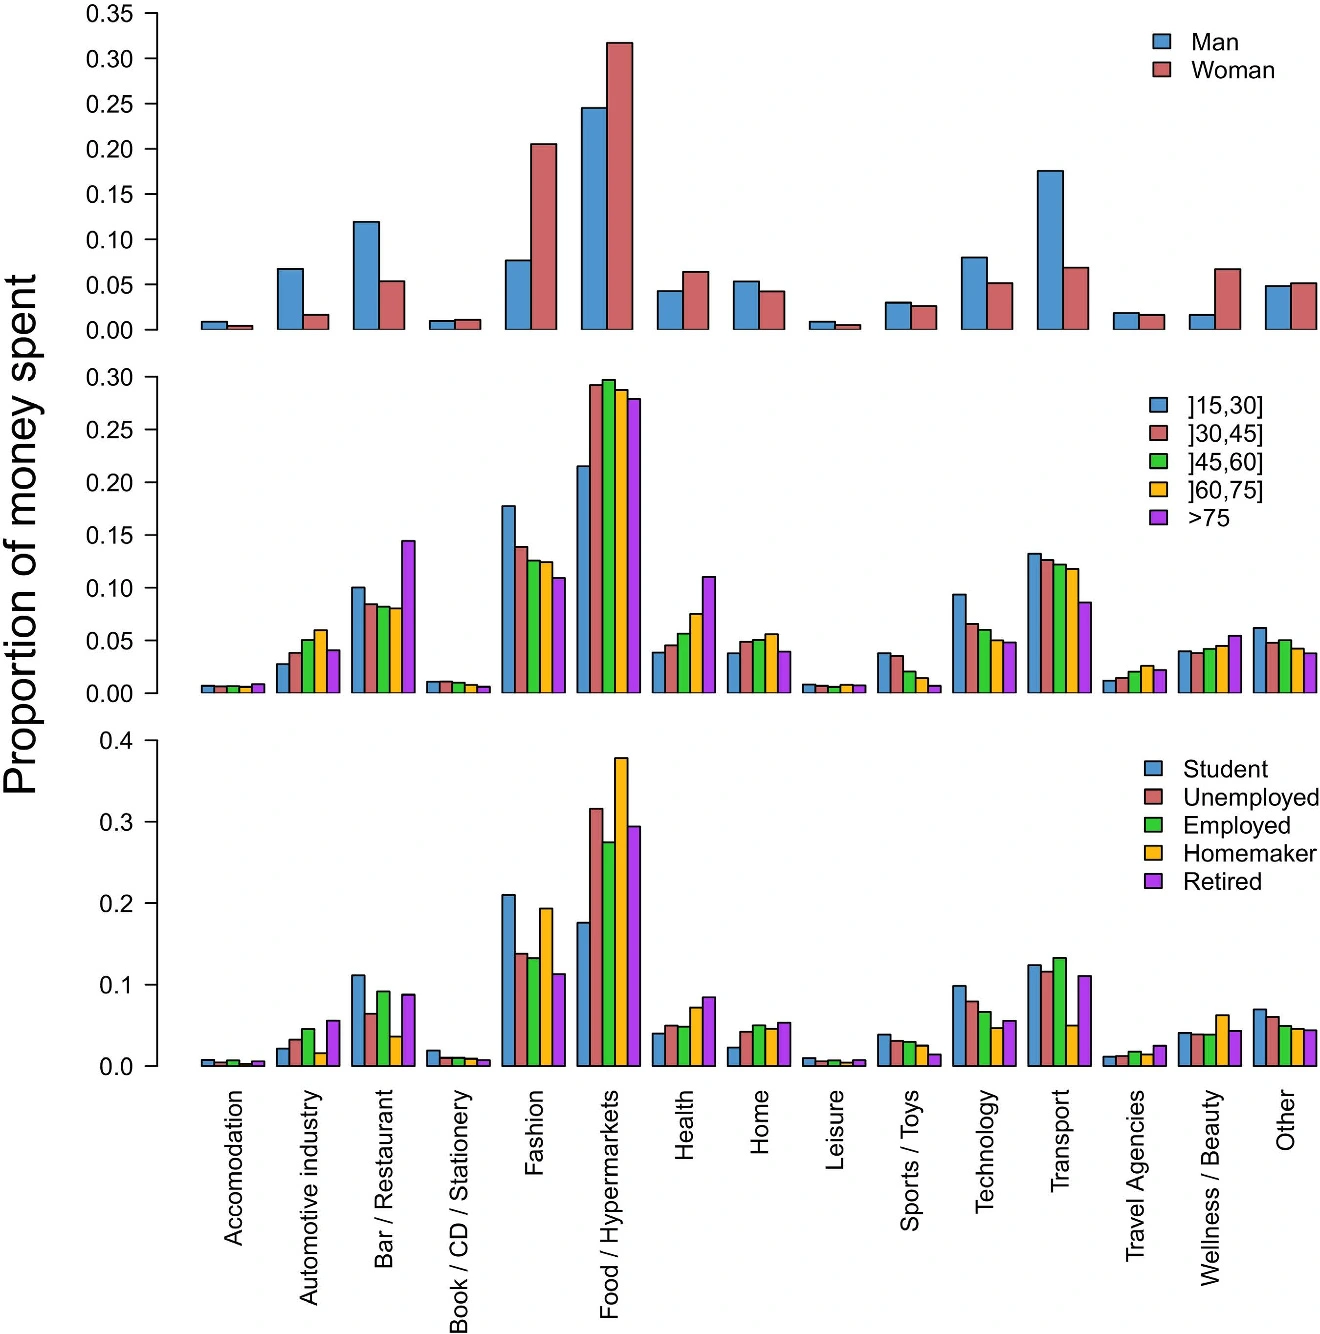
图 3|一个人的钱,在哪些店之间分配?
三行都没有子图字母,纵轴是个人支出份额的组内平均。上行为性别,蓝男红女。食品超市是两边最高的类别,女性更高;女性在时装、健康、保健美容上也更高,男性在汽车、酒吧餐馆、电子和交通上更高。中行是年龄,15–30岁为蓝、30–45岁为红、45–60岁为绿、60–75岁为黄、75岁以上为紫。时装、食品、体育玩具、电子和交通大体随年龄下降,汽车、健康、旅行社和保健美容上升。下行为职业,学生、失业、就业、家务劳动、退休依次为蓝、红、绿、黄、紫。学生在酒吧餐馆、时装、体育玩具和电子上高于其他职业。来源:原论文 Fig. 3。
作者写,只保留就业者后再看类别份额,结论不变。
钱花在上午,还是花在下班之后?
一周被分成四段:周一到周四合成工作日,周五、周六、周日各自单独。全体的支出在工作日、周五和周六明显高于周日。作者把周日偏低联系到2011年西班牙多数店铺周日关门。周日的活动大约在10点到19点,16点附近有一个小峰。工作日、周五和周六大约从8点到22点,午间和19点各有一峰;工作日和周五的19点峰更高,周六则是午间峰更高。工作日、周五和周六在23点附近还有一个夜生活小峰。
聚类用的是欧氏距离的k均值。每个人的时间分布先除以自己2011年的总支出。聚类个数用伪F统计量选取。伪F是组间方差与组内方差之比,取得最大值的个数被保留。作者得到两类。
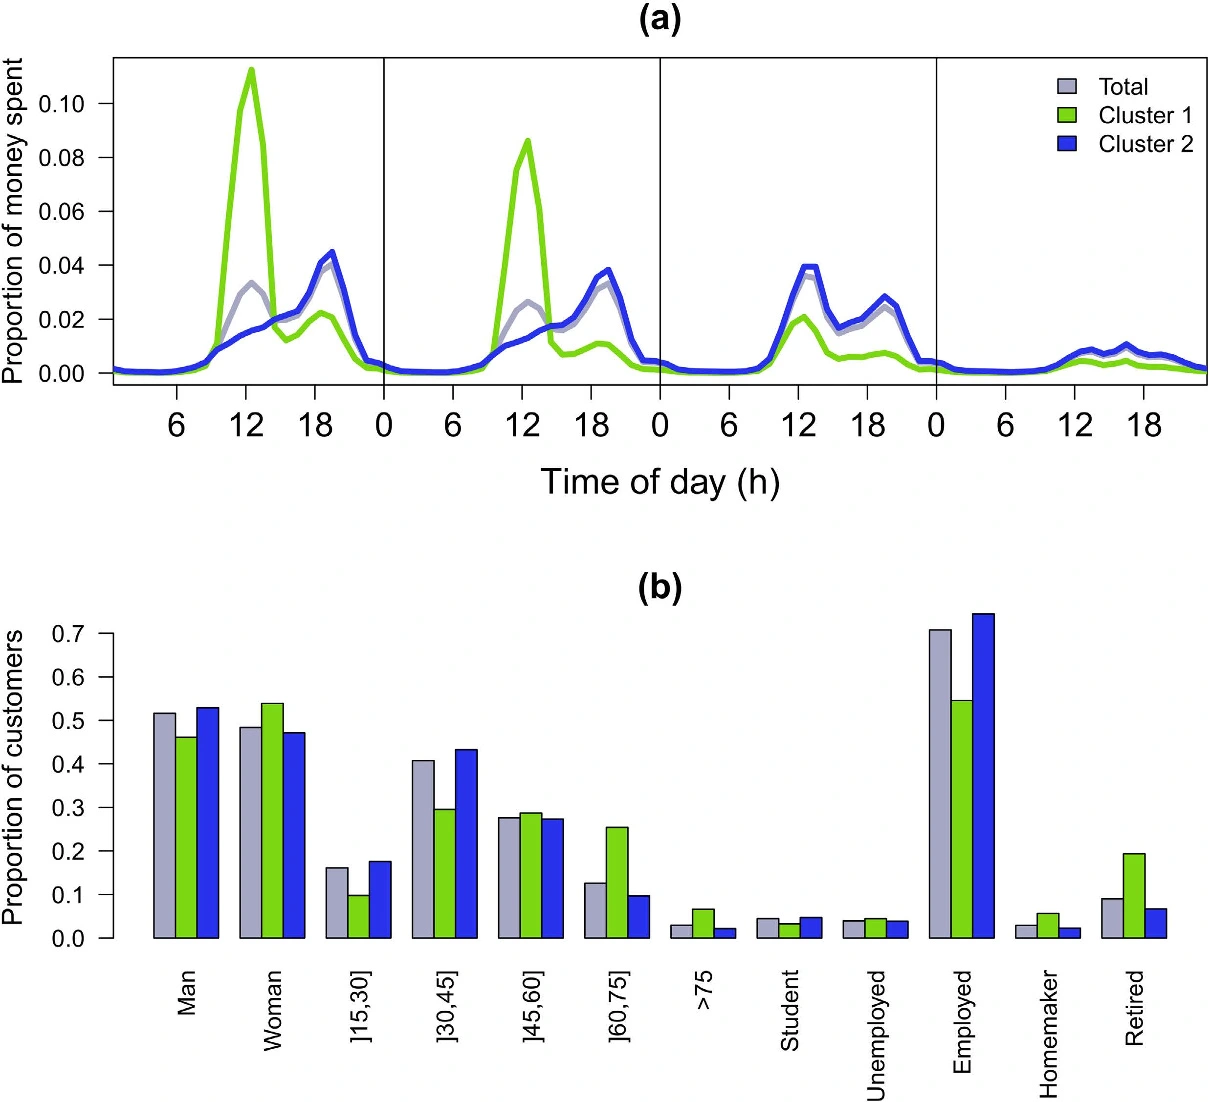
图 4|两类人的花钱时间差在一天中的哪一段?
(a)纵轴是支出比例,横轴是小时。四块从左到右为工作日、周五、周六、周日。灰色是全体,绿色是聚类1,蓝色是聚类2。聚类1的峰在午间和工作日,聚类2的峰在18点以后,周末也更高;周日三条线都低。(b)纵轴是客户比例。灰色是全体,绿色是聚类1,蓝色是聚类2;横轴依次为性别、五个年龄组和五种职业。聚类1大约占客户的三分之一,其中女性、年长者、家务劳动者和退休者的比例高于全体,就业者的比例低于全体。来源:原论文 Fig. 4。
聚类1里偏多的,正是后面移动范围更小的那些组别。不过这一步分的是花钱钟点,还不是路程。
两次付款隔多远,活动中心又有多大?
移动用三个量。Δt是同一人连续两次交易的时间间隔,Δr是这两次交易地点之间的距离,单位分别是小时和公里。活动半径 r_g(radius of gyration)按人计算:先求这个人2011年全部交易位置的质心,再看各位置到质心的均方根距离。写成
r_g = √[ (1/n) Σ (p_k − p_c)² ]
p_c = (1/n) Σ p_k
p_k是第k次交易的位置,n是交易次数,p_c是质心,平方表示平面上的距离平方。反复在同一台终端刷卡,会把质心拉向那个点。Δr会受刷卡频率影响,r_g把一年的位置放在一起,不按间隔逐段累加。为了不因删掉长间隔而歪曲路程,省内所有连续位置都保留,不管中间隔了多久。
位移和活动半径的分布图只画了马德里。两省都做了曼–惠特尼U检验(比较整个分布)和穆德中位数检验。分布差异和中位数差异的p值都低于10^-4,唯一例外是巴塞罗那15–30岁与30–45岁的活动半径,没有达到这个门槛。没有达到门槛,只说明这一个比较不能拒绝“两组相同”,不能写成两组完全一样。
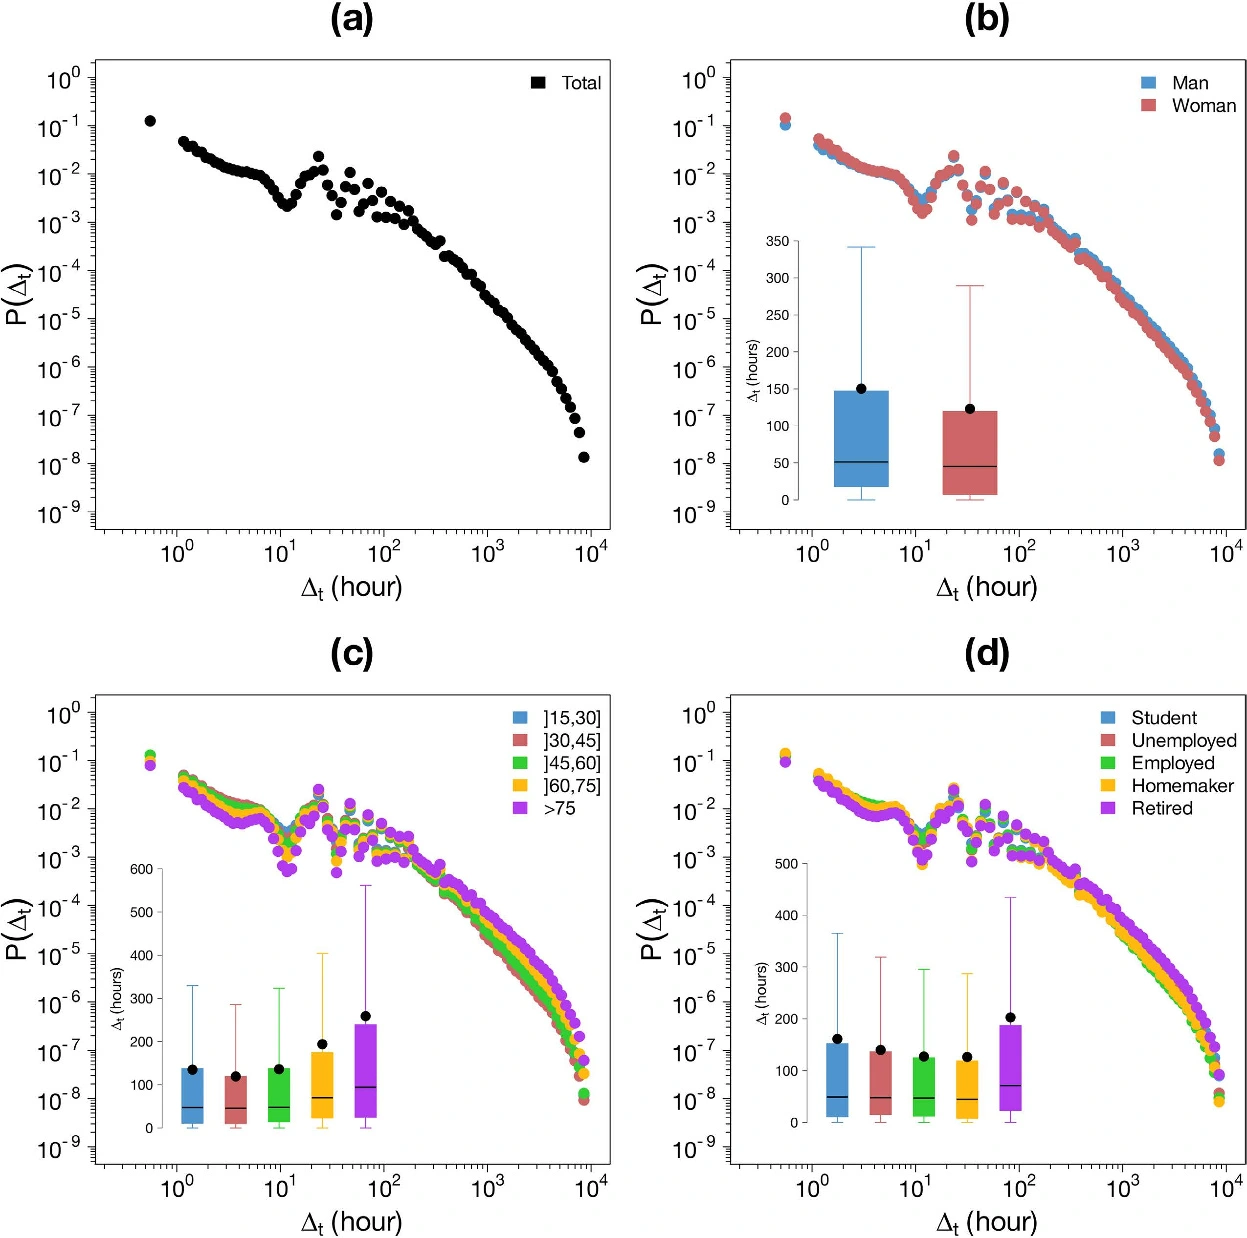
图 5|两次刷卡通常隔多久?
(a)全体的间隔分布。横轴是小时,纵轴是概率密度,都用对数刻度。密度总体下降,并带着大约以一天为周期的起伏。正文给出的平均值大约5天、中位数大约2天,长尾把平均值拉到中位数之上。(b)男性为蓝、女性为红。女性的密度在较短间隔上更高,箱线图的中位数和黑点所示的平均值都更低。(c)五个年龄组。中位数和平均值随年龄上升,75岁以上的平均值最高。(d)五种职业。失业、学生和退休的间隔长于就业和家务劳动。四张内嵌图都是Tukey箱线图,黑点是平均值。来源:原论文 Fig. 5。
间隔长的组别,也是图2里全年笔数更少的组别。两者是同一件事的两面:一年刷得少,连续两次之间就隔得更久。
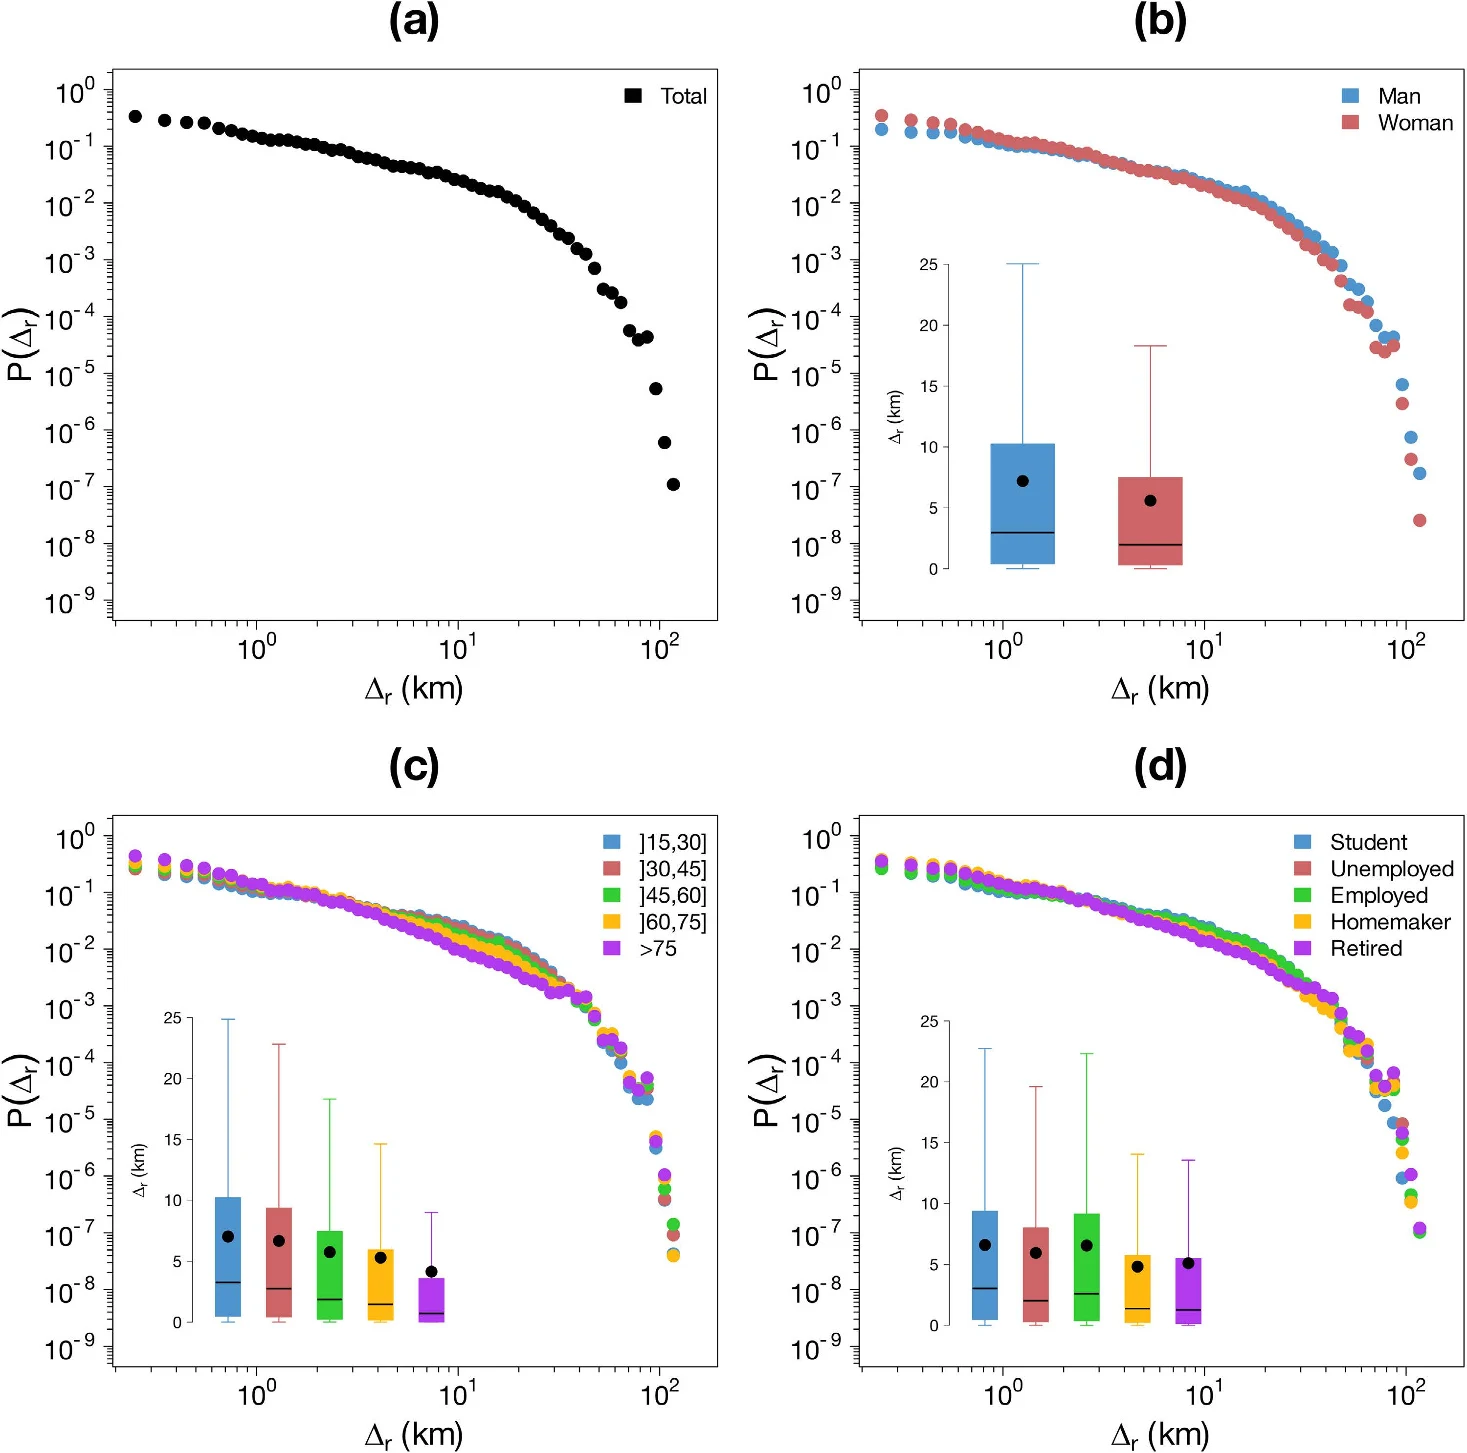
图 6|连续两次付款之间的直线距离有多长?
(a)全体。40公里以前下降较慢,超过大约40公里后迅速下降。这个截断来自省的地理范围,不是偏好在40公里处突然消失。马德里省面积8,022平方公里,巴塞罗那省7,733平方公里。(b)男性的分布比女性更伸向长距离,箱线图里男性的中位数和平均值都更高。(c)年龄越大,短距离的密度越高,箱线图逐档下降。(d)退休和家务劳动更集中在短距离,失业者也短于就业者和学生,差距小于退休者。来源:原论文 Fig. 6。
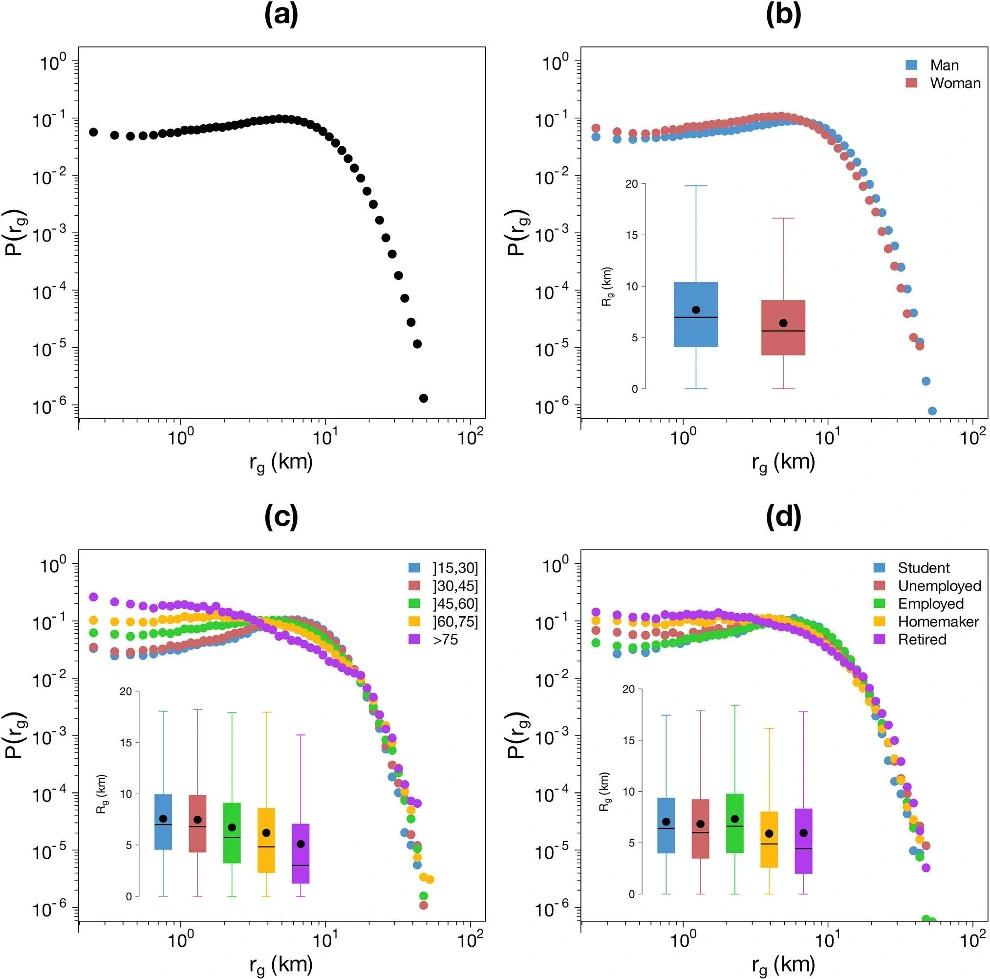
图 7|一年的付款点,绕着质心散得有多开?
(a)全体的活动半径先缓慢升高,大约在6公里达到最高,然后迅速下降。6公里是分布的峰,不是每个人的半径,也不是最远一次付款。(b)女性的峰更靠左,箱线图整体低于男性。(c)75岁以上在短半径处密度最高,15–45岁的分布更靠右。(d)就业者和学生的箱线图高于家务劳动和退休,失业者介于其间。来源:原论文 Fig. 7。
三组对照因此是:女性短于男性,年长者短于年轻人,退休者、家务劳动者和失业者短于就业者与学生。讨论里有一句把方向写反了,它称男性、年轻人和在职者路程更短、更靠近质心。结果段以及图6、图7、图8、图10都是相反方向。下文采用与图和结果段一致的方向。
刷得少的人,是不是只因为间隔长才显得远?
Δr的组别差有可能只是Δt的附带结果:隔得久,两次付款之间能走的路就更长。图8把平均位移按间隔长度重新排开。横轴的区间覆盖1小时以内,直到120小时以上。
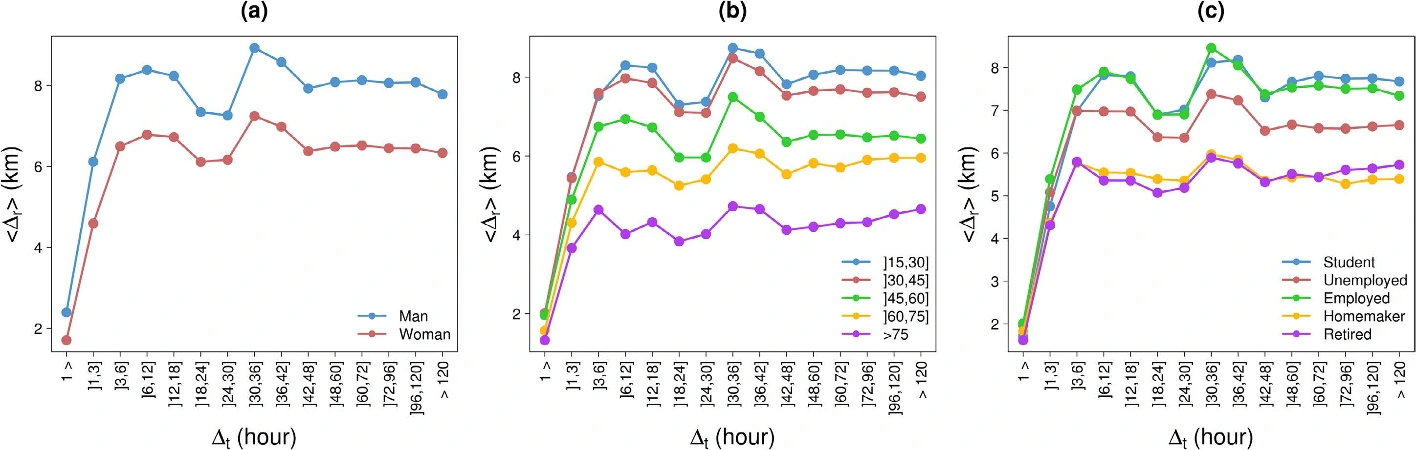
图 8|把间隔对齐之后,谁的平均位移仍然更长?
(a)男性为蓝、女性为红。1小时以内两边都在2公里附近;间隔拉长后曲线上升,此后男性稳定在女性之上,差距大约1到2公里。18–30小时出现一个谷,30–42小时出现一个峰。(b)15–30岁和30–45岁最高,其后按45–60岁、60–75岁、75岁以上下降;75岁以上在上升之后大约停在4到5公里。各年龄都有同样的谷和峰。(c)学生和就业者最高,失业者居中,家务劳动和退休较低。谷和峰在就业者、学生身上更明显。来源:原论文 Fig. 8。
6小时以内,平均距离随间隔变长,这是时间不够走到更远的地方。18–30小时的谷和30–42小时的峰不完全由这个物理限制决定。作者认为峰在在职和就学的人身上更清楚,可能对应住家与工作地或学校之间的往返。这是对曲线形状的一种解释,数据里没有工作地或学校的单独标记。可以确定的是:同一间隔区间内,性别、年龄和职业的距离排序仍然存在,所以图6的差距不能全部归到刷卡频率。
男女之差,会不会只是年龄和职业组成不同?
家务劳动者里女性更多,年龄结构也随职业变化。若男女路程不同只是因为女性更常落在退休和家务劳动里,把职业或年龄固定之后,差距应该消失。作者计算男女两个经验分布的科尔莫戈罗夫–斯米尔诺夫距离。原始距离是两条累积分布函数的最大垂直差距,最大不超过1。因为各组人数不同,他们再乘以样本量因子:
D̃ = √[ n_X n_Y / (n_X + n_Y) ] × sup |F_X − F_Y|
在0.001水平上,D̃大于1.95就拒绝“男女来自同一分布”。
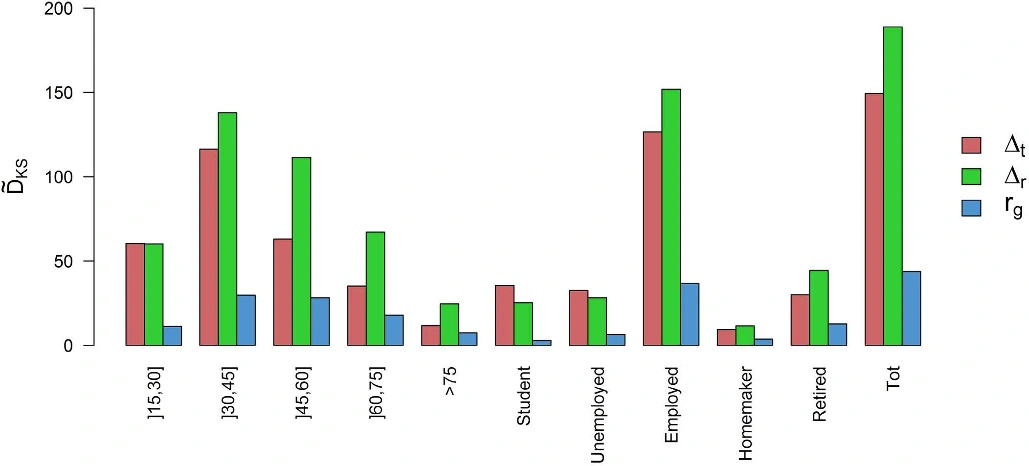
图 9|把年龄或职业分开之后,男女分布还分得开吗?
图没有子图字母。纵轴是归一化后的KS距离,横轴是五个年龄组、五种职业和全体。红色是间隔Δt,绿色是位移Δr,蓝色是活动半径r_g。每组三根柱都高于1.95的拒绝线;1.95在0到200的纵轴上几乎贴着底部。绿色的位移柱通常最高。15–30岁、75岁以上、学生、失业和家务劳动的柱较矮,30–45岁、就业者和全体的柱最高。来源:原论文 Fig. 9。
因此,只按年龄切开,或只按职业切开,男女分布仍然不同:女性的间隔更短,男性的位移更长。作者进一步把更高的柱读成中年人和就业者的性别差更大。这里要分开两件事。D̃会随切片样本量增加。就业者大约占客户的七成,全体样本更大,他们的柱即使原始分布差距相同也会更高。另外,Δt和Δr把每一段连续交易算作一个样本,r_g是每人一个样本。交易段远多于人数,所以红色和绿色的柱系统性更高。蓝色更矮,并不能说明活动半径的男女差距小于位移差距。能够稳妥说的是每个切片都超过1.95。图8给出的是各职业的平均距离,没有再按性别拆开。
另一个边界是:按年龄切开时,职业构成仍可以不同;按职业切开时,年龄构成仍可以不同。图9不是年龄和职业同时固定的交叉分层。
近处的店,能解释女性更短的路程吗?
家到商户的距离按每笔交易计算:居住地取邮编多边形的质心,商户取终端坐标,两者用半正矢公式求球面距离,再按人群和商户类别平均。这是邮编中心到店的直线距离,不是门牌到店的沿路里程,也没有通勤时间。
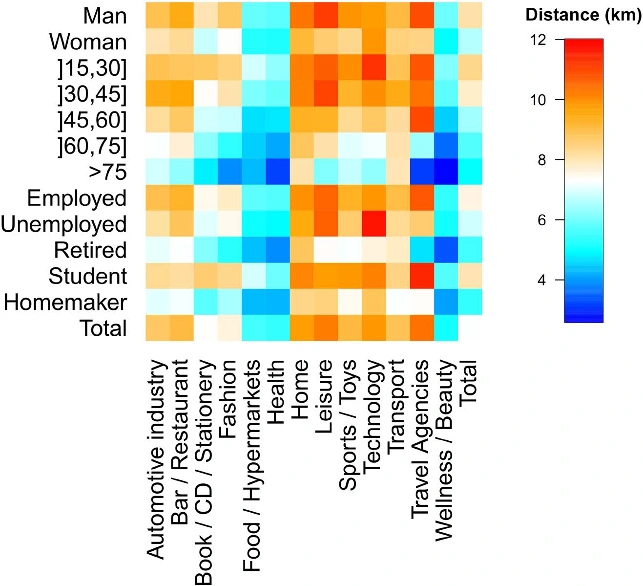
图 10|哪类人、为了哪类店,会离开邮编中心更远?
图没有子图字母。每一行是一个组别,从上到下为男性、女性、五个年龄组、就业、失业、退休、学生、家务劳动和全体。每一列是一种商户,最后一列是该行的合计。颜色表示公里,暖色更远、冷色更近。同一列里,男性暖于女性,年龄越大越偏冷,就业者和学生暖于退休、失业和家务劳动。食品超市、健康、保健美容、图书文具这几列整体更冷,旅行社、电子等列更暖。来源:原论文 Fig. 10。
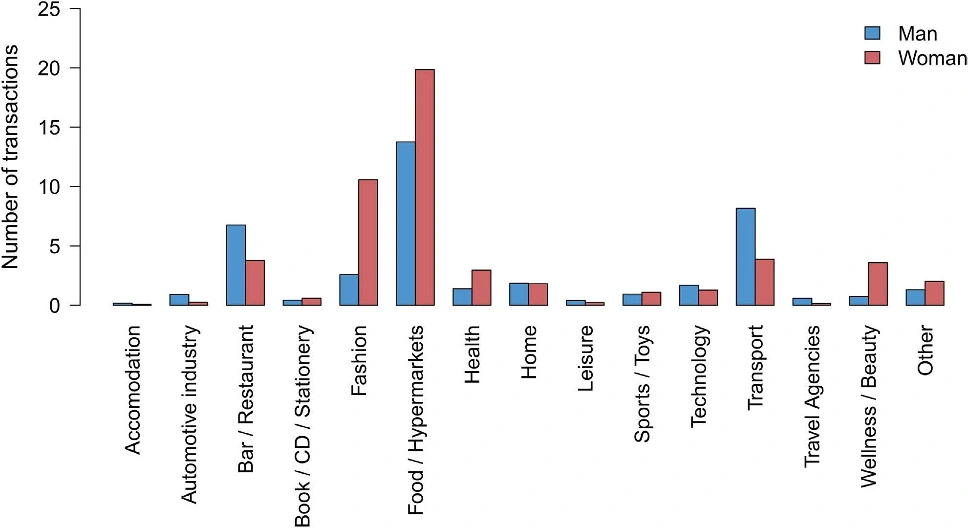
图 11|哪些店的交易笔数是女性更高?
图没有子图字母。横轴是商户类别,纵轴是交易笔数;图注没有写明这是人均还是合计,所以只比较同一类别里两根柱的高低。蓝色为男性,红色为女性。女性在食品超市、时装、健康和保健美容上更高,食品超市的两根柱都最高、女性更高;男性在交通、酒吧餐馆、汽车和电子上更高。图书文具两边都很矮。来源:原论文 Fig. 11。
论文点名的近距离类别,正是食品超市、健康、保健美容和图书文具,也是图11里女性笔数更高的类别。类别构成因此可以部分解释女性的购物距离更短。图10同时显示,即便在同一类店里,男性的颜色仍然暖于女性。店的类型分走了一部分差距,同类型内部的差距还在。
这些差别能说到哪一步
可以成立的是持卡人组别之间的稳定排序:年轻和在职的足迹更开,女性、年长者、退休者和家务劳动者更收。排序在马德里的距离图、活动半径图、按间隔对齐的平均距离,以及家到店的距离里方向一致。两省的分布和中位数检验大多达到 p < 10^-4。
几条边界跟着这些结果走。第一,客户不是省内人口的随机样本。男性只略多,30–45岁和就业者多出很多,75岁以上大约只占客户的0.02,普查里大约是0.09。论文把指标除以组内人数,避免大组仅因人多而主导;它没有把各组再加权回普查结构。全体曲线仍然是这份客户群的曲线。第二,付款点不是全天的行程。现金、其他银行卡、不产生消费的停留都不会出现。连续两次付款可以相隔数天,中间的移动被并进同一段Δr。第三,家是邮编质心。同一个邮编里的人共用一个家的坐标,短距离会被这个粗度影响。第四,40公里后的陡降是省界造成的截断,不能外推到跨省。第五,性别差经过了单层切片,还没有同时固定年龄和职业,也没有子女、收入、驾车或工作地。作者猜想,年长者和学生的性别差较小,可能与有孩子的女性移动方式不同;这是猜想,数据里没有子女人数。第六,花钱时间的两类来自聚类,周日偏低也被联系到店铺周日关门。聚类描述的是支出钟点,不能单独证明通勤机制。第七,引言把年龄和性别与传染病模型联系起来,正文没有估计传播参数。
一句话总结
在2011年这两省的BBVA持卡人中,年轻和在职者的付款足迹更远,女性、年长者和退休、家务劳动者更近,男女差别在单独按年龄或职业切开后仍然存在;这是客户组别的差异,不是从这些特征里分离出来的因果效应。
核心来源
- Scientific Reports 5:10075,2015年5月20日发表。题目、作者、DOI、样本和全部正文图以该文为准。
- Scientific Reports 5:12188,2015年7月17日勘误,只更正标题用词。
- 人口对照为西班牙2011年人口普查,论文参考文献指向国家统计研究所:http://www.ine.es/censos2011/tablas/Inicio.do。
- 论文写明另有补充信息。正文提到的补充图包括:S1–S3为三个属性的联合分布,S4–S6为消费分布的离群值,S7为只保留就业者后的类别份额,S8为聚类数的伪F,S9–S15为巴塞罗那的移动结果。上文对这些图只采用正文已经写明的结论。
作者介绍
下列身份和分工都来自论文的署名单位与作者贡献说明。
- Maxime Lenormand:署名西班牙国家研究委员会与巴利阿里群岛大学的跨学科物理与复杂系统研究所(IFISC)。论文写明由他统筹、设计、分析数据并撰写文稿,通讯邮箱为 maxime@ifisc.uib-csic.es。
- Thomas Louail:署名法国理论物理研究所(Institut de Physique Théorique, CEA-CNRS),以及巴黎第一大学、巴黎第七大学的 Géographie-Cités。他参与统筹并撰写文稿。
- Oliva G. Cantú-Ros:署名马德里 Nommon Solutions and Technologies,参与统筹。
- Miguel Picornell:同样署名 Nommon,参与统筹。
- Ricardo Herranz:同样署名 Nommon,参与统筹。
- Juan Murillo Arias:署名马德里 BBVA Data & Analytics。论文写明由他取得数据并参与统筹。
- Marc Barthelemy:署名理论物理研究所,以及法国社会科学高等研究院的社会分析与数学中心,参与统筹。
- Maxi San Miguel:署名 IFISC,参与统筹并撰写文稿。
- José J. Ramasco:署名 IFISC,参与统筹、设计并撰写文稿。致谢写明他得到西班牙经济部 Ramón y Cajal 计划资助。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若有人把全体持卡人大约6公里的活动半径峰,当成马德里或巴塞罗那居民的典型活动范围,这个数会偏大。样本里就业者和30–45岁偏多,而这两组的位移和活动半径更大;75岁以上在普查里大约占0.09、在客户里大约只占0.02,他们的半径更小。按普查年龄结构重新加权之后,总体的活动半径应当比这条未加权的客户曲线更短。性别的偏移只有大约三个百分点,对这种加权的影响会小于年龄和职业。
图10还留下一个更具体的建模问题。食品超市对所有人都更近,女性又更多在这些近店消费,类别构成确实能拉低女性的平均路程。可是同一列里男性仍然更远。只按商户类别重新分配出行目的,消不掉列内部的性别差。若差别主要来自学龄子女的接送,它应当在学生和75岁以上变小;图9里这两类的柱确实较矮,但柱高同时受人数影响,而且年龄切片里仍混着不同职业。要分辨这个猜想,需要在同一年龄、同一职业下比较有没有未成年子女。这份交易记录没有这个字段,图9本身还不能充当证据。