一个人跑得远,是两个常去地点撑起来的,还是许多少去地点撑起来的?
论文名片|Luca Pappalardo、Filippo Simini、Salvatore Rinzivillo、Dino Pedreschi、Fosca Giannotti、Albert-László Barabási,Returners and explorers dichotomy in human mobility,Nature Communications,2015,6:8166。2014年12月15日收稿,2015年7月24日接收,2015年9月8日发表。DOI:10.1038/ncomms9166。本文依据这一正式版本解读。
先把两个人想成一种比较,他们不是论文里的某位真实用户。甲的行程大多发生在家和单位之间,这两个地方隔着几十千米,其余地点都在附近。乙的家和单位几乎挨着,但隔一段时间会去另一个城市。两个人的活动范围都可以很大。若问最常去的两个地点能不能把这个范围解释出来,甲和乙会分开。
论文把这种差别写成返回者(returners)和探索者(explorers)。返回者反复出现在少数地点之间,总体活动范围大体可以由这些地点复现。探索者也会反复回到一些地点,可是那些地点解释不了他们走得有多远。手机详单和私家车 GPS 里都看得到这两组人。2010 年的探索与优先返回模型生成不出这种分裂;探索新地点时加上引力约束之后,群体形态更接近观测。由两类行程连成的地点网络,在一个扩散阈值上方向不同;手机用户的通话对象,也更常落在同一类里。这些是同一批轨迹和通话的对照,不能直接推出性格、职业,或谁影响了谁。
先说结论
- 手机样本是从约 300 万名用户中筛出的 67,000 人:三个月内到过的地点多于 2 个,平均通话频率不低于每小时 0.5 次。车辆样本是 2011 年 5 月经过意大利中部 250×250 千米区域的约 46,000 辆私家车。两组都按同一规则分类:前 k 个高频地点的回转半径若大于总回转半径的一半,就是 k 返回者,否则是 k 探索者。
- 手机数据在 k=4 时两类人数达到平衡。k 更小时探索者更多,k 更大时返回者超过探索者。车辆数据从 k=2 起,返回者一侧的峰就占优。私家车记录缺少火车、飞机等长途行程,总半径容易被估低,人更容易被标成返回者。
- 67,000 个合成个体跑探索与优先返回模型,两类人数要到 k≈60 才平衡。探索阶段改用引力模型后,平衡点降到 k≈9,更靠近手机数据的 k=4。这是群体分布的比较,不是逐人预测。
- 在 k=2 的手机用户中,返回者的最常通话对象也是返回者的比例约为 0.27;把最常通话对象随机重配 10 万次,参照比例约为 0.21,论文在这一比较后给出 P<10−5</sup>。探索者的同组比例约为 0.81,随机参照约为 0.78。同组偏离写到第 15 位通话对象。托斯卡纳的车辆网络里,探索者占比从 0% 增到 100% 时,平均全局入侵阈值上升;正文没有给出阈值本身的数值。
活动范围怎样量,才不会被一次远行带跑?
回转半径(radius of gyration)rg 量的是各地点相对质心的典型距离。去得越勤,或待得越久,这个地点的权重越大。它不是最远一次出行的里程。
rg = √[ (1/N) Σi∈L ni ‖ri − rcm‖² ]
L 是这个人去过的地点,ri 是地点坐标,ni 是访问次数或停留时间,N 是这些权重之和,rcm 是加权质心。正文把 ni 同时写成次数或时间,没有写明手机和车辆分别用哪一种。
地点按权重从高到低排列。L1 是最常出现的地点,人静止时最可能在这里,作者认为多半是家。Lk 是第 k 常去的地点。k 回转半径 rg(k) 只用前 k 个地点,质心也只用这 k 个地点重算,分母换成它们的权重和 Nk。k 已经覆盖全部地点时,k 回转半径等于总回转半径。因为质心换了,rg(k) 偶尔可以大于 rg。
手机数据是一家欧洲运营商三个月的匿名 GSM 详单,原本用于计费和网络运维。一个人的移动被记成按时间排列的基站序列。67,000 人来自约 300 万用户,条件是观测期内地点数多于 2,且平均通话频率 f ≥ 0.5 h−1。
车辆数据约 46,000 辆,时间是 2011 年 5 月的一个月,每辆车都经过意大利中部一块 250×250 千米的方形区域。行程起终点归到意大利国家统计局(ISTAT)的人口普查小区,轨迹是停车所在小区的时间序列。数据由 Octo Telematics 提供。图 1 是其中一段:蓝色轨迹从比萨都市区出发,红色从佛罗伦萨都市区出发。它展示两座城市的车流如何交织,不是返回者和探索者的统计检验。
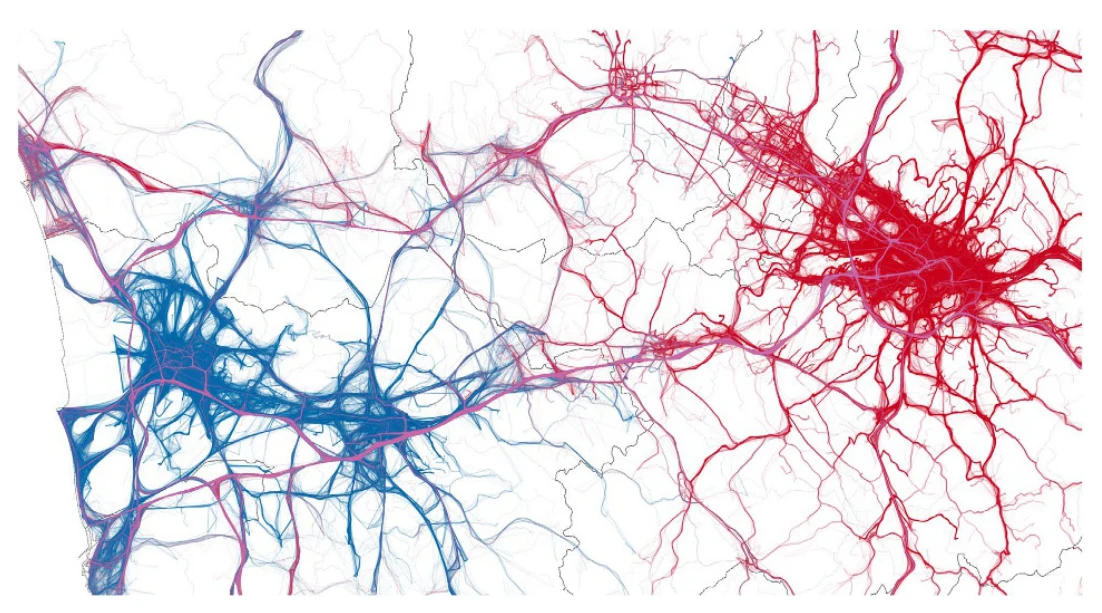
图 1|这些车流本身怎样交织?
这张图没有子图字母。蓝线是从比萨都市区出发的 GPS 行程片段,红线是从佛罗伦萨都市区出发的片段,灰线是底图道路。它是全部车辆轨迹的一个局部画面。来源:原论文 Fig. 1。
两套数据的地点单位也不一样。手机地点是基站,车辆地点是停车所在的普查小区。后面的千米数都在各自的地点定义下计算,不宜把两套半径当成同一种尺子上的读数。车辆对应的分析单位是车,手机对应的是用户。
只看前几个地点,距离分布会靠近总半径吗?
要知道高频地点能否代表一个人,先看整个人群的半径分布,再把同一个人的两个半径配成对。图 2 比较总回转半径和 k=2、6、10 的 k 回转半径。曲线都是长尾:多数人的半径小,少数人到数百千米。作者用截断幂律去拟合,
P(rg) = (rg + r0)−α exp(−rg / rcut)。
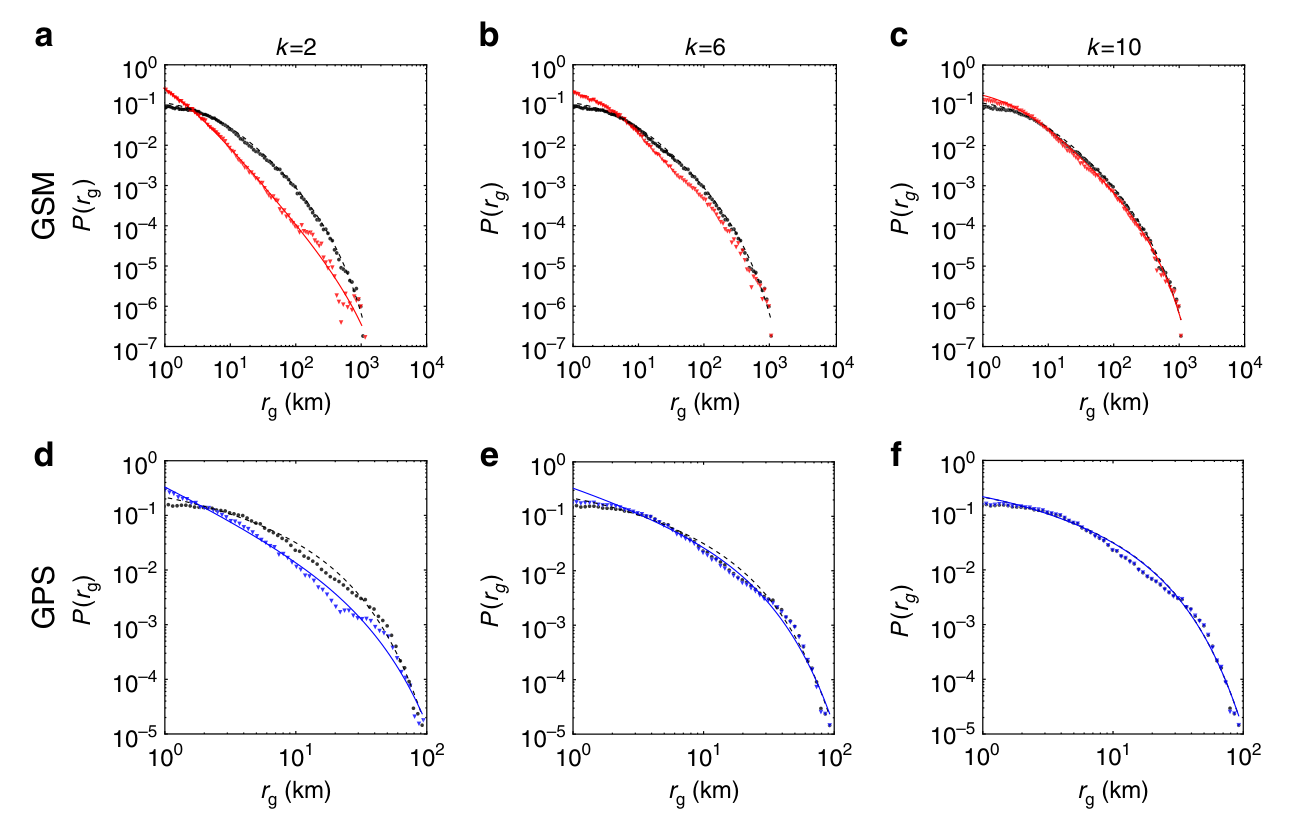
图 2|只保留前 k 个地点后,半径分布还像总半径吗?
(a–c)手机数据,k=2、6、10。黑点是总回转半径,红点是 k 回转半径;黑色虚线拟合总半径,红色实线拟合 k 半径。纵轴是概率密度,从 100 到 10−7;横轴是千米,刻度到 104。(d–f)车辆数据,颜色改成蓝点与蓝色实线。纵轴到 10−5,横轴到 102 千米。k 增大时,彩色点靠向黑点。来源:原论文 Fig. 2。
表 1 是这些拟合的参数。r0 和 rcut 与图中的半径用同一距离单位,轴上标的是千米。α 没有单位。
| 半径 | GSM 的 r0 | GSM 的 α | GSM 的 rcut | GPS 的 r0 | GPS 的 α | GPS 的 rcut |
|---|---|---|---|---|---|---|
| rg(2) | 0.82 | 1.89 | 691.03 | 0.07 | 1.25 | 22.92 |
| rg(6) | 1.44 | 1.61 | 308.47 | 0.13 | 0.9 | 16.36 |
| rg(10) | 2.88 | 1.6 | 275.22 | 0.91 | 0.76 | 14.56 |
| 总 rg | 5.5 | 1.6 | 250.11 | 0.96 | 0.75 | 14.44 |
正文概括说,k 半径的指数高于总半径,小 k 的截断距离更大。表里的差主要出现在较小的 k。手机数据 k=2 的 α 是 1.89,总半径是 1.6;k=6 是 1.61,k=10 是 1.6。车辆数据从 k=2 的 1.25 降到总半径的 0.75。截断距离则从手机 k=2 的 691.03 千米降到总半径的 250.11 千米,车辆从 22.92 千米降到 14.44 千米。表下没有另给显著性检验的统计量。k 越大,k 半径的分布越靠近总半径,这只说明“多纳入一些地点,人群分布会更像完整轨迹”,还没有回答同一个人的高频地点是否够用。
同一个人的两个半径,为什么分成两团?
图 3 把每一个人画成一个点。横轴是总回转半径,纵轴是 k 回转半径,k 取 2、4、8。颜色从蓝到红,表示该处点有多密。
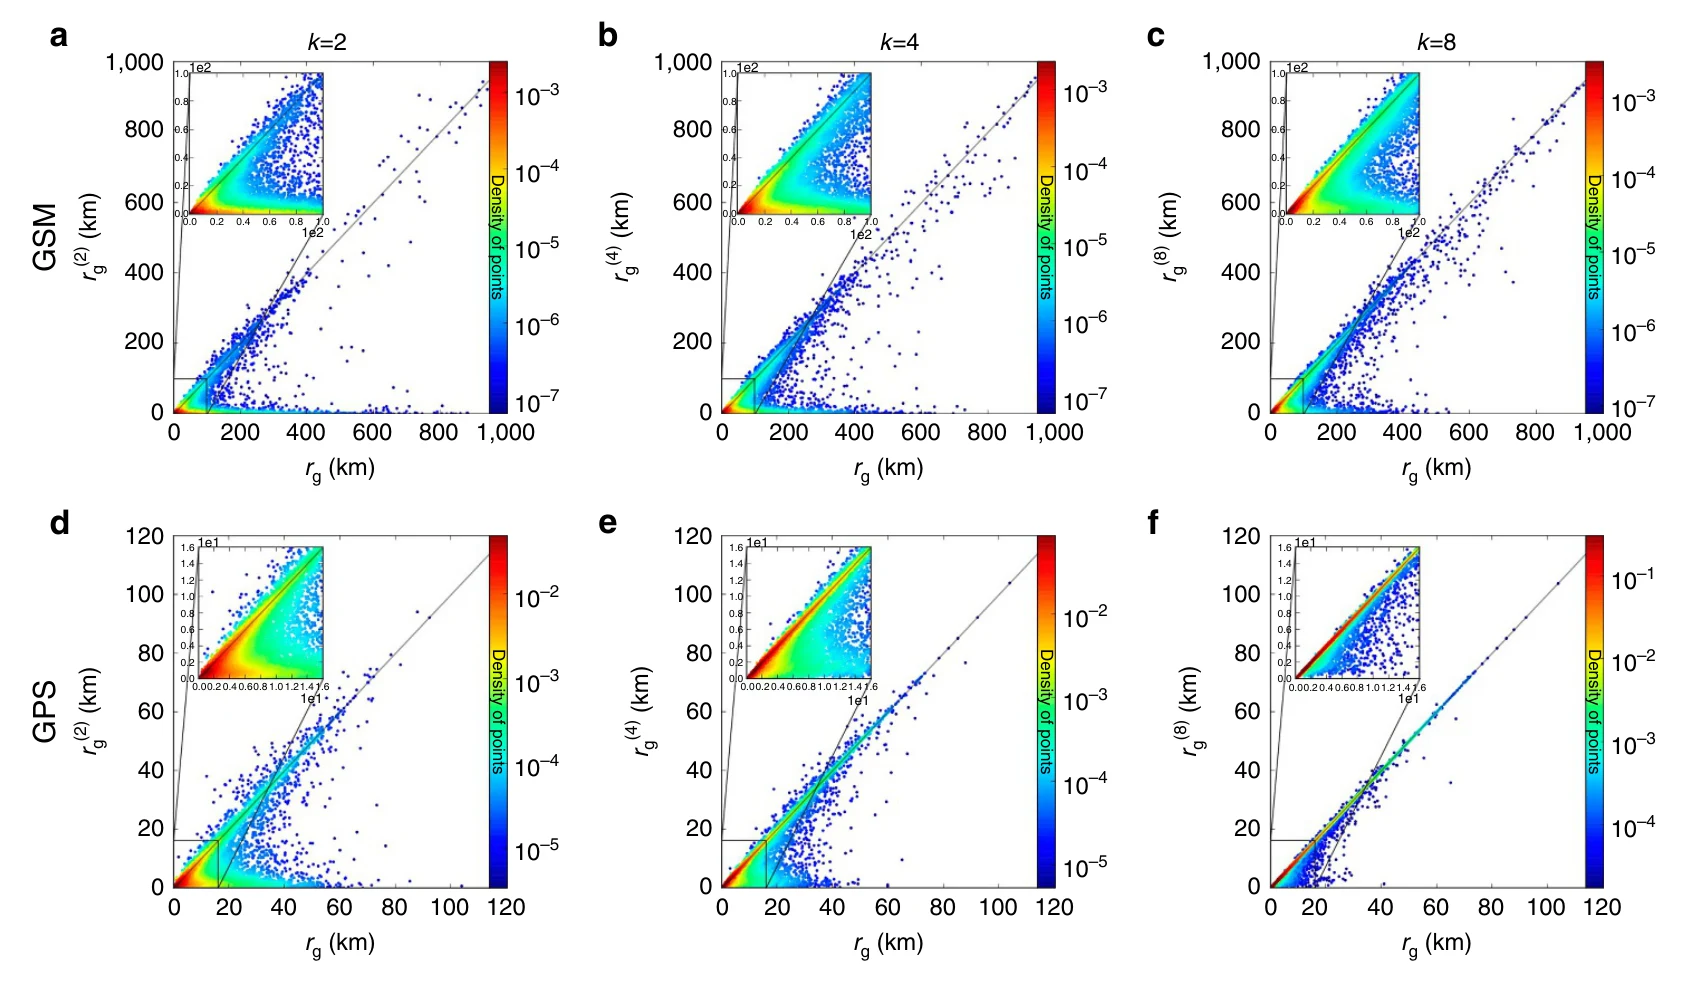
图 3|同一个人的总半径和前 k 个地点的半径,是贴在一起还是差得很远?
(a–c)手机,k=2、4、8。主图横轴、纵轴都到 1,000 千米。插图把原点附近放大到 0–100 千米。(d–f)车辆,同样三个 k。主图到 120 千米,插图放大到 0–16 千米。对角线附近是 k 返回者,横轴附近是 k 探索者。右侧色条是点的密度。k 增大后,点向对角线聚集,车辆比手机更快。来源:原论文 Fig. 3。
贴着对角线的人,k 半径和总半径差不多,前 k 个地点就撑起了活动范围,称为 k 返回者。贴着横轴的人,k 半径远小于总半径,前 k 个地点不够,称为 k 探索者。对 k=2 来说,返回者的活动范围主要由两个最常去的地点决定,这两个地点常常对应家和单位;探索者会在更多地点之间反复出现。总半径较大的区域,对角线和横轴之间的点很少。插图说明小半径处也能看见分裂,只是点更挤。
k 等于这个人去过的地点总数时,每个人都成为返回者。探索者随 k 增大变成返回者很常见,反向变化极少。正文还写明,这种划分不能归因于通话次数多少,也不能归因于居住市镇的人口结构。车辆转得更快,是因为车辆行程只是一个人全部出行的一部分,访问地点更少,较少的 k 就更能代表记录到的总半径。
作者用三种办法切分:二分线、支持向量机和期望最大化。三种结果相近,说明两团分得开。后文采用二分线:rg(k) > rg/2 标为 k 返回者,否则标为 k 探索者。这条线就是图 3 里从原点画出、斜率为 1/2 的那条界。
比值 sk = rg(k) / rg 把同一个人的两个半径收成一个数。越接近 1,前 k 个地点越能代表总活动范围。图 4 是 sk 的分布。
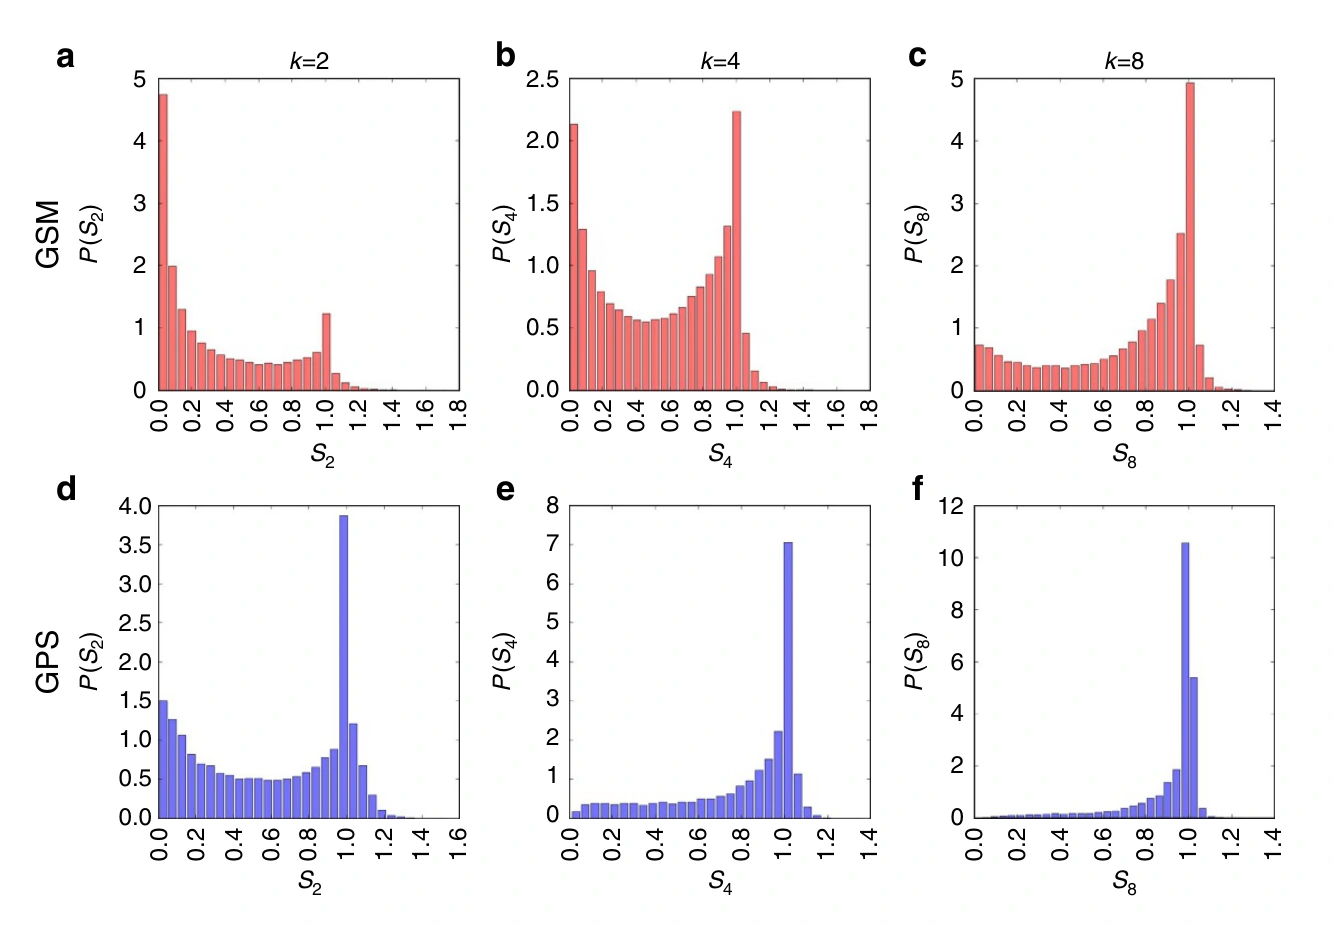
图 4|人群在“几乎为 0”和“接近 1”两处,哪一处人更多?
(a–c)手机,k=2、4、8,红色。纵轴是 sk 的概率密度,柱高不是人数。k=2 时 0 附近的峰更高;k=4 时两端都明显;k=8 时 1 附近的峰更高。(d–f)车辆,蓝色。k=2 时 1 附近已有尖峰,k=4 和 k=8 时这个峰更占优。横轴可以略大于 1。来源:原论文 Fig. 4。
峰在 0,对应 k 探索者;峰在 1,对应 k 返回者。手机数据在小 k 时探索者更多,k=4 时两类人数达到平衡,k 继续增大后返回者超过探索者。车辆数据在所有 k≥2 都是返回者更多。一个直接的原因是:私家车记录不到本人很少走、但由火车或飞机完成的长途地点。那些行程会抬高总半径,却几乎不改变前 k 个高频地点的半径。漏掉它们,总半径偏低,比值变大,车辆更容易被标成返回者。
只有少数人的 sk 大于 1。对绝大多数人,前 k 个地点平均比其余地点更靠近质心。密度图上的柱高不能换成人数百分比;人数多少的结论来自正文对两类人的计数,平衡点是 k=4 这一句。
两个最常去的地点是分开,还是挤在质心附近?
返回者和探索者的地点也不在同一种空间图案里。图 5 画出 k=2 的个体移动网络:圆点是去过的地点,连线是观测到的出行。红色和蓝色是两个最重要的地点,灰色叉是质心。
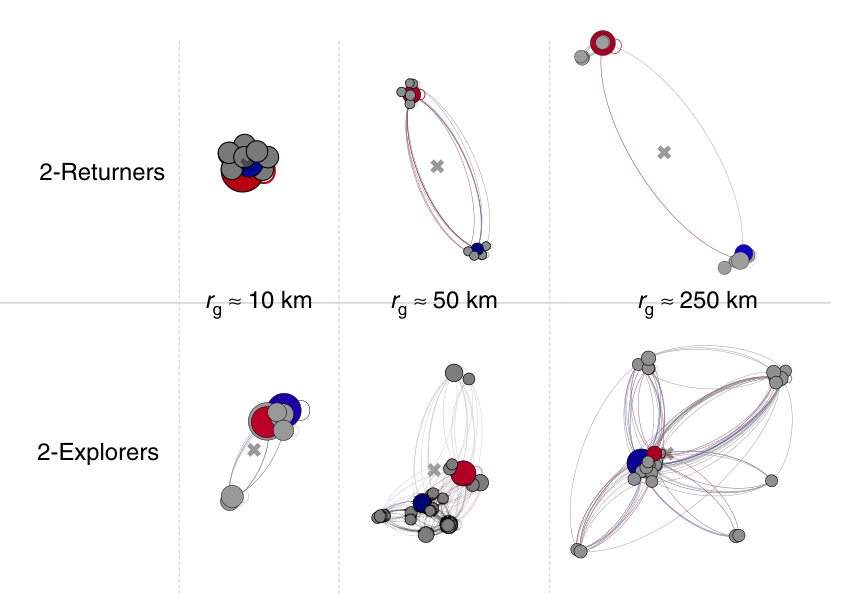
图 5|总半径变大以后,两个最常去的地点是拉开,还是仍挤在一起?
这张图没有 a–f 字母,按两行三列阅读。上排是 2 返回者,下排是 2 探索者;从左到右,总回转半径约为 10、50、250 千米。约 10 千米时,两类人的红点和蓝点都靠在一起。半径增大后,返回者的红点和蓝点拉开;探索者的红点和蓝点仍靠近,远处出现别的地点簇。灰色叉是质心。这些是挑选的例子,半径上的约等号不是组内均值。来源:原论文 Fig. 5。
正文的概括和这六张小图一致:返回者两个高频地点之间的距离随总半径增长得更快,其他地点聚在这两个点周围;探索者两个高频地点相距更小,总半径主要由远离质心、去得更少的地点决定。总半径越大,两种图案越清楚。地点间距和聚集程度的群体散点在补充图里,正文没有逐点列出距离。
旧的个体模型要数到多少个地点,才分得开?
探索与优先返回模型(exploration and preferential return,EPR)让一个人在两件事之间选择:探索一个新地点,或回到去过的地点。回到旧地点的概率正比于以往访问次数。新地点的概率写成 Pnew = ρ S−γ,S 是已经去过的不同地点数。这个模型能复现地点访问频率、人群回转半径的分布,以及半径随时间极慢增大。它不限制一次跳跃可以有多远。
作者用它生成 67,000 个合成个体,人数与手机样本相同。图 6 上排是 k=2 的结果。散点只是弱弱地靠向对角线,没有观测数据里那两团清楚的聚集;s2 几乎只有 0 附近一个峰。在画出的 k=2 到 20 这一段,探索者人数一直高于返回者。正文给出的人数平衡点是 k≈60,手机数据则是 k=4。60 相对 4 超过十倍,所以正文说:模型把“需要多少个地点才能代表总半径”高估了一个数量级以上。在这个模型里,总半径与前 k 个高频地点之间距离之和的皮尔逊相关系数接近 0,返回者和探索者都如此。正文没有写出具体系数。
d-EPR 改的是探索阶段。人当前在地点 i,新地点 j 的概率按引力模型计算:
pij = (1/N) ni nj / rij²。
ni 是所有人从地点 i 打出的通话总数,不是居住人口。rij 是两地地理距离。N 是全部候选地点的权重和,用来把概率归一。距离指数写死为 2,不是在这批数据上重新拟合的。返回阶段仍按个人以往访问次数抽样。等待时间从 P(Δt) ∼ Δt−1−β exp(−Δt/τ) 抽取,β=0.8,τ=17 小时。探索概率里的 ρ=0.6,γ=0.21。这些参数取自 Song 等人 2010 年的测量,也就是本文参考文献 4,正文没有在这 67,000 人上重新估计。每个合成个体从自己的手机最常基站 L1 出发,模拟 3 个月。引力项把新地点限制在实际有通话的地理范围内。
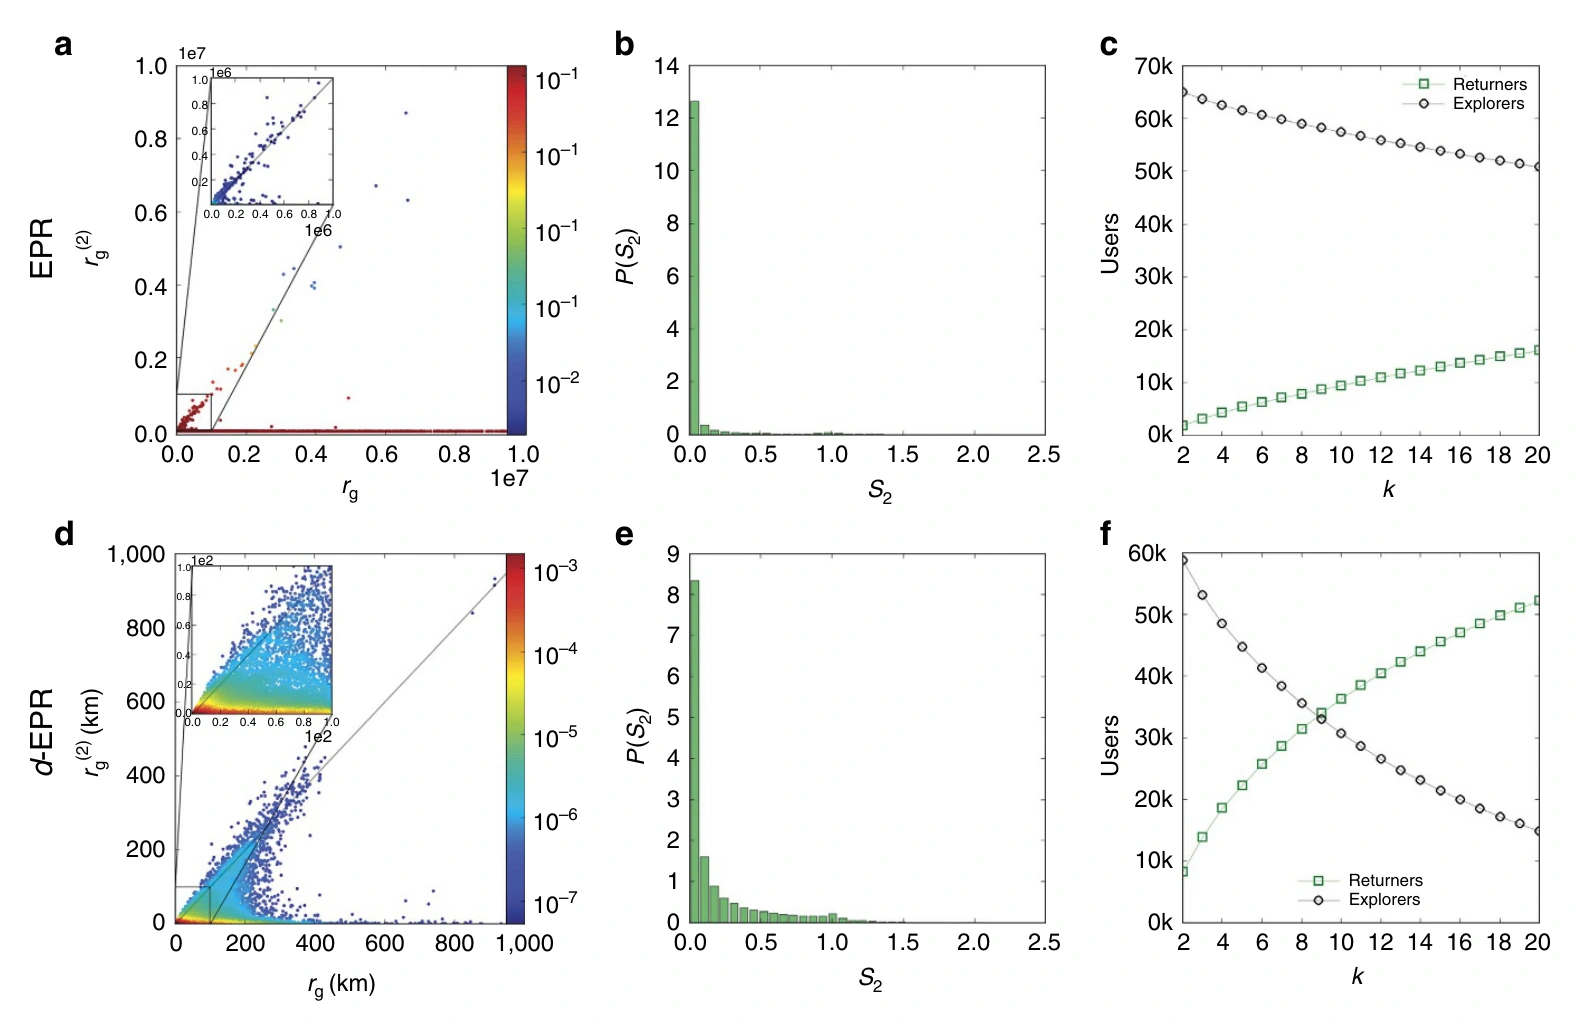
图 6|加上距离约束以后,两类人的分裂和人数平衡点有没有靠近数据?
(a)EPR 在 k=2 的散点。点大多贴着横轴,对角线一侧很稀;插图放大半径较小的区域。横轴数量级到 107,图上未标千米。(b)EPR 的 s2 分布,质量集中在 0。(c)EPR 中返回者与探索者人数随 k 的变化,k 只画到 20,两条线在这一段没有相交。纵轴是合成用户数,刻度到 70k;这批合成个体共 67,000 人。(d)d-EPR 在 k=2 的散点,横轴标为千米、到 1,000。对角线和横轴重新出现两团;插图放大较小半径。(e)d-EPR 的 s2 仍在 0 处最高,并向较大的 s2 拖出一条尾巴。(f)d-EPR 的两类人数在画出的范围内相交,正文把平衡点记为 k≈9。绿方块是返回者,灰圆点是探索者。来源:原论文 Fig. 6。
d-EPR 在 k=2 时已经能看见观测中的两团,但 s2 的主峰仍在 0,说明这一刀上探索者仍占多数。人数平衡点是 k≈9:低于 EPR 的 k≈60,高于手机数据的 k=4。车辆数据从 k=2 起返回者已经更多,所以 k≈9 也还没有贴近车辆。总半径与高频地点间距的相关高于原模型,并更接近两套观测。
这个改进可以这样理解。人返回时,吸引力来自自己去过的地点有多重要;人探索时,吸引力来自全体通话记录里这个地点有多重要,同时被地理距离压低。模型复现的是受限空间中的群体图案。它没有证明每个真实用户内部就是这个随机过程,也没有在车辆的普查小区上重新估计引力参数。
探索者变多时,扩散网络的阈值怎样变?
作者把一个人的轨迹按时间切开,用三个量描述走到时刻 t 的覆盖:去过的地点数、覆盖面积,以及当时的回转半径 rg(t)。探索者去过更多地点,盖住更大的地域,rg(t) 也更高。手机和车辆都是这个方向。正文没有给出三个量的具体差值。
另一项计算把行程收成一张全局移动网络。节点是地点,两地之间只要至少有一次行程,就连一条边。地理范围是托斯卡纳,行程来自车辆 GPS,地点上的居民数来自 ISTAT 普查小区。正文写构建 10 张这样的网络:每张随机抽 10,000 辆车,其中 k=2 探索者的比例从 0%、10% 直到 100%。从 0% 到 100%、每隔 10 个百分点一共有 11 档,与“10 张网络”在正文里同时出现。每张网络重复 1,000 次。
他们计算的是全局入侵阈值 R*。所用假设来自集合种群上的扩散:子人群规模大,再生数接近子人群内部的疫情阈值。R*>1 时,疫情才能侵入整个系统。网络的度越不均匀,R* 越高,全局侵入的机会越大。平均 R* 随探索者比例上升。正文没有列出各比例下的 R*,并写明还需要更精细的感染模型,才能估计入侵概率。因此这项结果支持的是:两类车辆行程所连成的网络,在这个理论阈值上方向不同。它不是一次真实疫情的传播速度,也不是把病毒在这些轨迹上重新模拟了一遍。
最常打电话的人,是否也属于同一类?
社交比较只用手机通话。最常通话联系人是通话次数最多的对象,论文称为 best friend。类别仍用 k=2 的二分线。
返回者的最常联系人也是返回者的比例 RR≈0.27。把每个人的最常联系人随机重新指定,做 100,000 次,参照比例 RRrand≈0.21。论文在报告这个差距后给出 P<10−5</sup>。探索者的同组比例 EE≈0.81,随机参照 EErand≈0.78,正文把探索者写成同样的模式。0.21 和 0.78 离 0.5 很远,因为 k=2 时两类手机用户本来就不等多;随机重配会把这种人数差带进参照。观测高于参照,两个差距大约是 0.06 和 0.03。
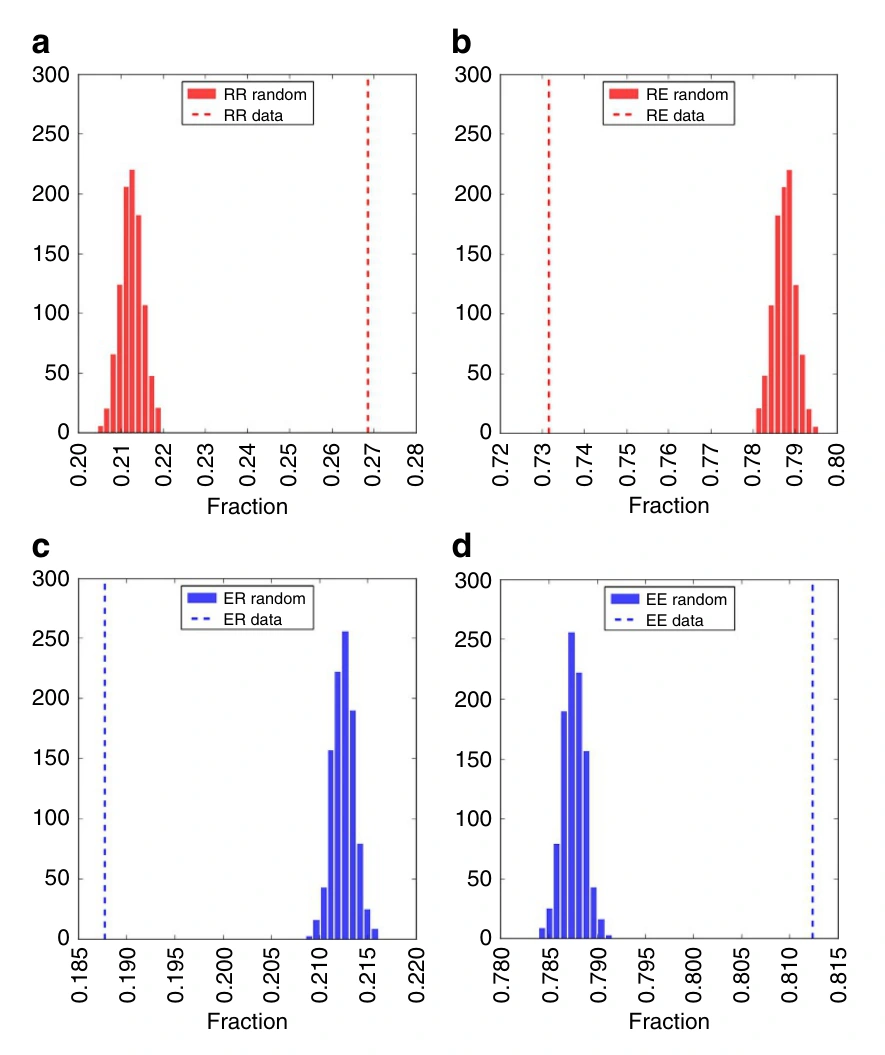
图 7|最常通话的人属于同一类,是否高于随机重配?
直方图是 100,000 次随机重配得到的比例,纵轴是这些实验的次数,刻度到 300。虚线是观测比例。(a)返回者的最常联系人也是返回者,随机结果集中在约 0.21,观测虚线在 0.27 附近。(b)返回者的最常联系人是探索者,观测虚线贴在横轴左端,随机直方图在 0.78–0.79 一带。(c)探索者的最常联系人是返回者,观测虚线在横轴左端,随机直方图在 0.21 附近。(d)探索者的最常联系人也是探索者,随机结果在 0.78–0.79,观测虚线靠近 0.81。正文写出的精确参照是 RR≈0.27 对 0.21,以及 EE≈0.81 对 0.78。来源:原论文 Fig. 7。
图 8 把联系人从第 1 位放到更后面。同组比例高于随机,交叉比例低于随机。正文把显著差别写到第 15 位。图的横轴画到第 20 位,返回者一侧在较大的 n 上误差棒变宽;第 16 到 20 位没有被正文单独声明为显著。
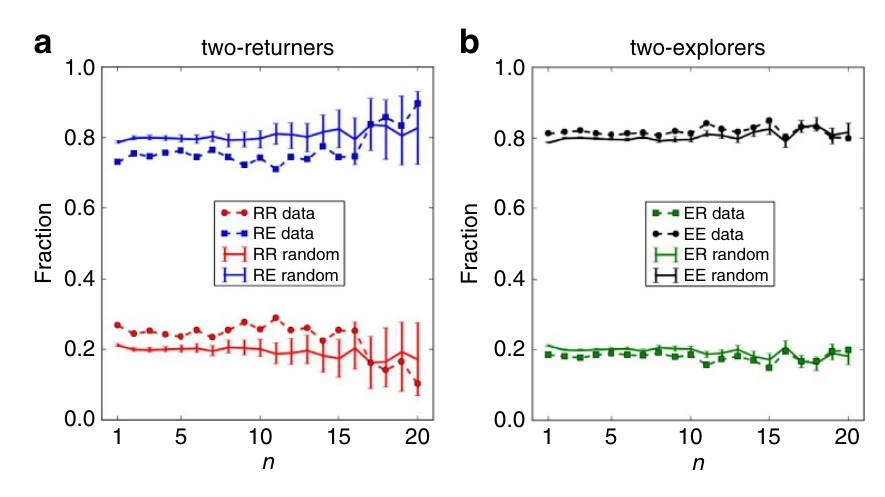
图 8|把联系人从最常通话换到第 n 位,同类比例还高于随机吗?
(a)分母是 2 返回者。红点是第 n 位联系人也为返回者的观测比例,蓝点是该联系人为探索者的观测比例;红色、蓝色误差棒是随机重配。横轴 n 从 1 到 20。(b)分母是 2 探索者。绿点是第 n 位联系人为返回者,黑点是同为探索者。正文写明直到 n=15,同组比例显著高于随机,交叉比例显著低于随机。来源:原论文 Fig. 8。
这是移动类别和通话关系的相关。作者写明,还需要进一步实验,才能区分同型相吸和相互影响。0.27 高于 0.21,同时意味着:在最常联系人已经分成两类的前提下,多数返回者的最常联系人并不是返回者。统计显著来自大样本和很窄的随机分布,不能单独当成“看一个朋友就知道本人类别”的个人规则。
这些比较能支持到哪一步
二分线用的是总半径的一半。总半径很大时,两团之间的空白更明显;小半径处插图里仍有分裂,点也更密,边界上的人换一条切分线就可能改组。支持向量机和期望最大化与二分线相近,说明主要结构不只靠这一条 1/2 线,但正文没有给出三种方法不一致的人数。
手机样本同时要求地点多于 2 个、平均每小时至少 0.5 次通话,描述的是这三个月里通话频繁、而且基站有变化的用户。车辆样本是经过一块 250×250 千米区域的私家车,一个月,缺少其他交通方式。两套地点的空间单位不同,分析单位一个是人、一个是车。
d-EPR 的等待时间和探索指数来自另一项研究的测量,引力指数固定为 2,地点重要性用全体通话量。它把人数平衡点从 k≈60 拉到 k≈9,说明地理约束能够产生两团;k≈9 仍然大于手机数据的 k=4。模型输出是合成轨迹的群体统计,不是这些用户的真实日程。
扩散部分比较的是行程网络在理论阈值 R* 上的平均值。社交部分是同期通话与移动类别的相关,只包括能够对上 k=2 类别的联系人。
一句话总结
一个人的活动范围可以由少数常去地点撑起,也可以主要由少去的远处地点撑起;这种分裂在手机用户和私家车轨迹里都出现,限制跳跃距离的个体模型更接近它,但类别本身还不是性格、影响关系或疫情速度的证据。
核心来源
- Nature Communications 正式页面,Nature Communications 6:8166,2015年9月8日发表。正文图 1–8 与表 1 均来自该版本。GPS 数据致谢 Octo Telematics。资助包括欧盟 FP7 DataSim(FP7-ICT-270833)、H2020 CIMPLEX(641191),以及 Barabási 获得的 DTRA HDTRA1-10-0100 与 FET OPEN Multiplex(317532)。
- 论文写明补充信息刊于 Nature Communications 网站。正文引用补充说明 1–16、补充图 1–18 和补充表 1–2,其中包括三种分类算法、通话次数与市镇人口的稳健性、地点间距,以及覆盖范围和入侵阈值的曲线。上文的数字取自正文、表 1 和图注。
- Luca Pappalardo 的研究所人员页与个人网站。
- Salvatore Rinzivillo 的研究所人员页与 KDD 实验室介绍。
- Dino Pedreschi 的比萨大学页面与 KDD 实验室介绍。
- Fosca Giannotti 的 KDD 实验室页面。
- Albert-László Barabási 的东北大学页面。
- Simini、González、Maritan 与 Barabási 2012 年的辐射模型,即本文参考文献 36:Nature 484:96–100。
作者介绍
- Luca Pappalardo:论文署名意大利国家研究委员会信息科学与技术研究所、比萨大学计算机系、中欧大学网络科学中心和布达佩斯技术与经济大学物理研究所,是通讯作者之一。与 Simini、Rinzivillo 共同设计并完成全部实验,全体作者参与写作。研究所人员页列其为高级研究员;个人网站写明同时为比萨高等师范学校副教授,研究人类移动以及人与算法的相互塑造。
- Filippo Simini:论文署名布里斯托大学工程数学系、布达佩斯技术与经济大学物理研究所,以及东北大学复杂网络研究中心与物理系,是通讯作者之一。2012 年与 González、Maritan、Barabási 在《自然》提出由人口分布推算流动的辐射模型。本文参与全部实验。
- Salvatore Rinzivillo:论文署名信息科学与技术研究所。研究所人员页列其为高级研究员,实验室介绍写明他的工作包括空间与时空数据中的知识发现。本文参与全部实验。
- Dino Pedreschi:论文署名该研究所与比萨大学计算机系。比萨大学页面列其为计算机科学正教授,与 Giannotti 共同主持比萨 KDD 实验室,研究方向包括移动数据挖掘。本文参与写作。
- Fosca Giannotti:论文署名信息科学与技术研究所。KDD 实验室页面现列其为比萨高等师范学校正教授,方向包括从大数据中做社会挖掘和人类动态分析。本文参与写作。
- Albert-László Barabási:论文署名中欧大学网络科学中心、东北大学复杂网络研究中心与物理系,以及哈佛医学院布列根和妇女医院医学系,是通讯作者之一。东北大学页面列其为网络科学讲席教授,并主持复杂网络研究中心。本文参与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
0.27 和 0.21 的差距说明同组通话高于随机重配,分母是已经标成 2 返回者、并且最常联系人也能标上类别的人。若用最常联系人的类别去猜本人,返回者只有约 0.27 会被猜成同组。一个可以单独做的检验是:只用最常联系人的类别预测本人类别,再与“所有人都猜成人数更多的那一类”比较命中率。前者可能赢过 0.21 的参照,却仍然输给“多数人都是探索者”这个更笨的规则。论文给出的是聚合相关,没有做这个预测。
另一个可以拆开的旋钮是 d-EPR 里写死的距离平方。现在的平衡点是 k≈9,手机数据是 k=4,合成人数都是 67,000。若只把引力指数从 2 改成一组邻近数值,其余参数仍用 β=0.8、τ=17 小时、ρ=0.6、γ=0.21,看人数平衡点会不会从 9 移向 4,就能知道差距主要来自这条固定的距离衰减,还是来自探索概率和返回规则。论文没有做这组指数扫描。