两地之间有多少人,该看距离、沿途机会,还是你已经掌握的数据?
论文名片|Can Rong、Jingtao Ding、Yong Li,An Interdisciplinary Survey on Origin-destination Flows Modeling: Theory and Techniques,ACM Computing Surveys,2024,57(1):Article 4,1–49,2024年10月7日发表。DOI:10.1145/3682058。本文依据 arXiv:2306.10048v4(2024年10月9日)全文及文内附录 A–D 解读。该版本页脚仍印着模板字样 Vol. 1, No. 1 与 October 2022,正式卷期以 ACM 记录为准。这是一篇综述,下文的篇数、公式和案例都来自该文本对既有研究的整理,不是作者新做的一次出行实验。
规划师打开一张表,想知道早晨有多少人从甲小区去乙园区。地理学家习惯把两地人口相乘,再除以距离。交通工程师手里可能只有路口线圈记下的过车数,表上的格子仍是空的。另一位研究者拿到过去几周每一对区域的人数,想要的是明天同一小时。四个人都会说自己在研究起讫流量,可他们缺的信息并不一样,公式也就不能互换。
这篇综述把理论收成三个模型,把工程任务收成四个问题。三个模型分别把距离、沿途机会和人口放进解释;四个问题则取决于你已经握有部分流量、完全没有目标城市的流量、只有路况,还是握有全部区域的历史流量。作者没有在这篇里重跑一场精度竞赛。他们自己给出的数量证据,主要是一张按学科统计的文献篇数图。
先说结论
- 引力模型、介入机会模型和辐射模型可以接在同一张关系图上:介入机会在空间上均匀或弱到可以忽略时,流量写成与距离的简单反比;介入机会与人口密度成正比时,关系写成辐射模型。这是综述的理论归纳,不是新数据上的拟合检验。
- 四个实际问题按已有信息分开。OD 预测补的是同一城市里尚未观测到的起讫对;OD 构建要在目标城市没有任何流量时生成整张表;OD 估计从交通观测反推流量;OD 预报用历史流量推未来时段。
- 图 6 的纵轴是论文篇数,柱上没有数字标签。对照刻度,OD 预测三类约为 9、13、7 篇,OD 构建约为 20、5、9 篇,OD 估计约为 11、13 篇,交通类柱顶略高于 27、约 28 篇,OD 预报约为 2、20、8 篇。分母是这张图所统计的文献,不是该领域的全部论文。
- 数据不能同时又细又全。表 1 里,GPS 的空间和时间粒度高、人口覆盖低;通话详单、蜂窝网络和签到的覆盖高、空间粒度低。附录写 GPS 常只覆盖至多数千人。被引的 Calabrese 等使用波士顿都市圈 100 万用户的通话详单,那是该项研究的用户数。
- 正文没有给出统一的误差表。评价附录定义了 RMSE、CPC 等指标,分母分别是起讫对的个数,或真实流量与预测流量之和。公开基准的链接写在文中,链接里的成绩没有在这篇正文里报告。
人流先被记成一张区域对区域的表
起讫流量(origin–destination flows,OD 流量)是人群在区域之间的移动量。城市被分成互不重叠的 N 个区域。从区域 i 到区域 j 的人数记为 fᵢⱼ,全部 fᵢⱼ 排成一张 N 行 N 列的 OD 矩阵。分析单位是区域对,不是某一个人的轨迹点。
按时间,流量可以是一段时期内结构较稳的静态表,通勤表常被这样使用;也可以是随时间变化的动态表。按活动,综述区分通勤和非通勤,后者包括休闲、社交和购物。按方式,还可以分成公交、铁路和道路车辆等。这些分类决定后面的模型在解释哪一种人数,不能把一张通勤表直接读成全天所有目的的出行。
传统的路边调查和入户调查费时、费钱。综述以此说明,为什么地理学、社会物理学、交通、城市规划和计算机科学会用各自的办法研究同一张表。不同学科还会把对象叫做空间交互(spatial interaction)或人口流。本文统一称 OD 流量,以免把货物、信息的空间交互和人的移动混成一件事。
四个方框问的是四件不同的事
图 1 把实践中的四类任务画成示意图。图注写着用雷达图表示各学科的贡献程度,但这张图里没有雷达图,也没有贡献分数。能读到的是四个任务各自从什么输入走到什么输出。
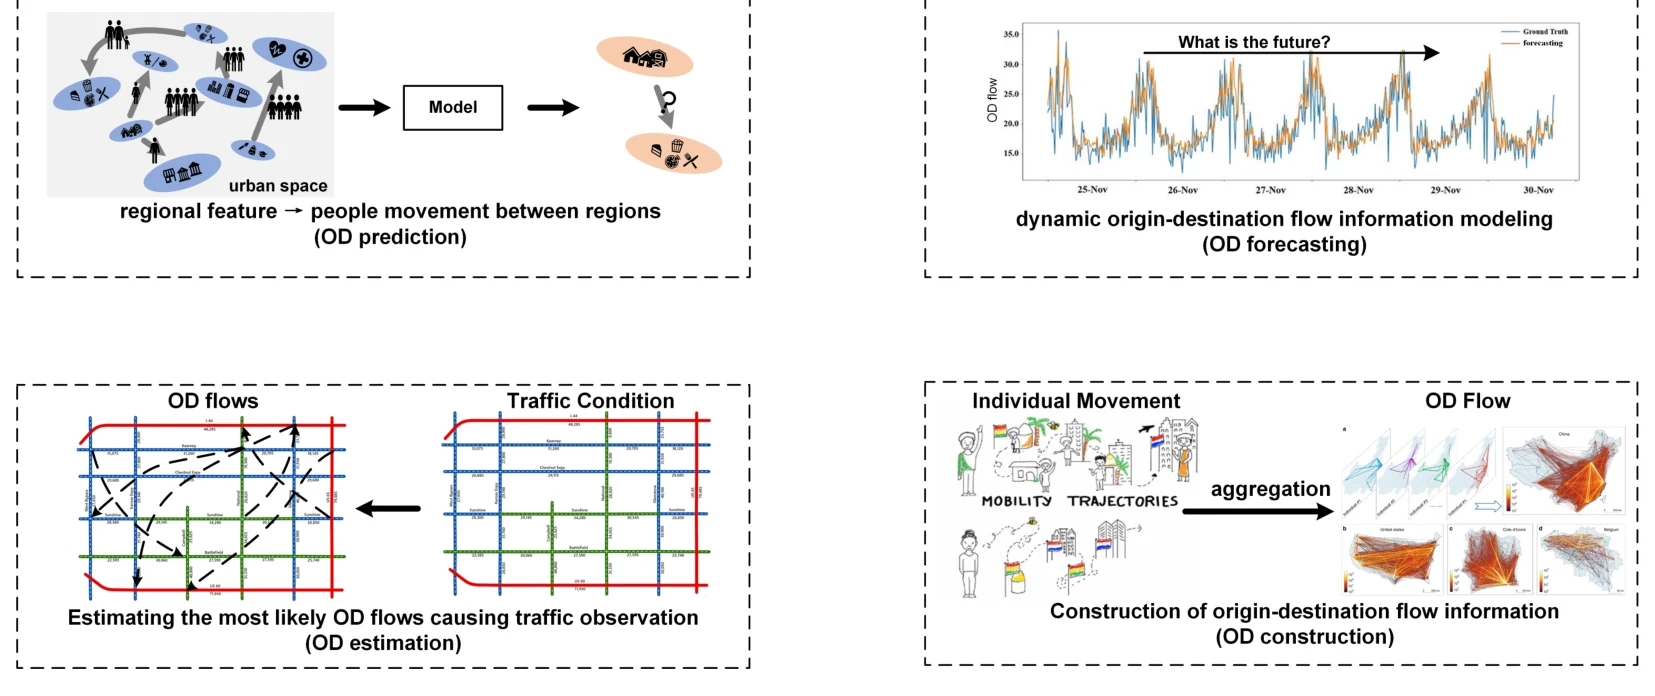
图 1|补全未知人流、预报下一时段、从路况反推、把个人轨迹汇总,各自拿什么做输入?
无字母子图,按位置看。左上是 OD 预测:区域特征经过模型,得到区域之间的人流。右上是 OD 预报:横轴为 11 月 25 日至 30 日,纵轴为 OD flow,蓝线标 Ground Truth,橙线标 Forecasting,箭头问未来是什么;综述没有说明城市、起讫对和单位。左下是 OD 估计:箭头从交通状况指向 OD 流量,文字写的是估计最可能造成这些交通观测的流量。右下是 OD 构建:个人移动轨迹经汇总变成 OD 流量。四格都是任务示意图,不能当成某次实验的精度。来源:原论文 Fig. 1。
图 2 把作者选出的节点放在四条研究线上:物理类比、由交通观测推断、大规模位置数据、计算模型。线上只有这些节点,没有按年份穷尽文献。
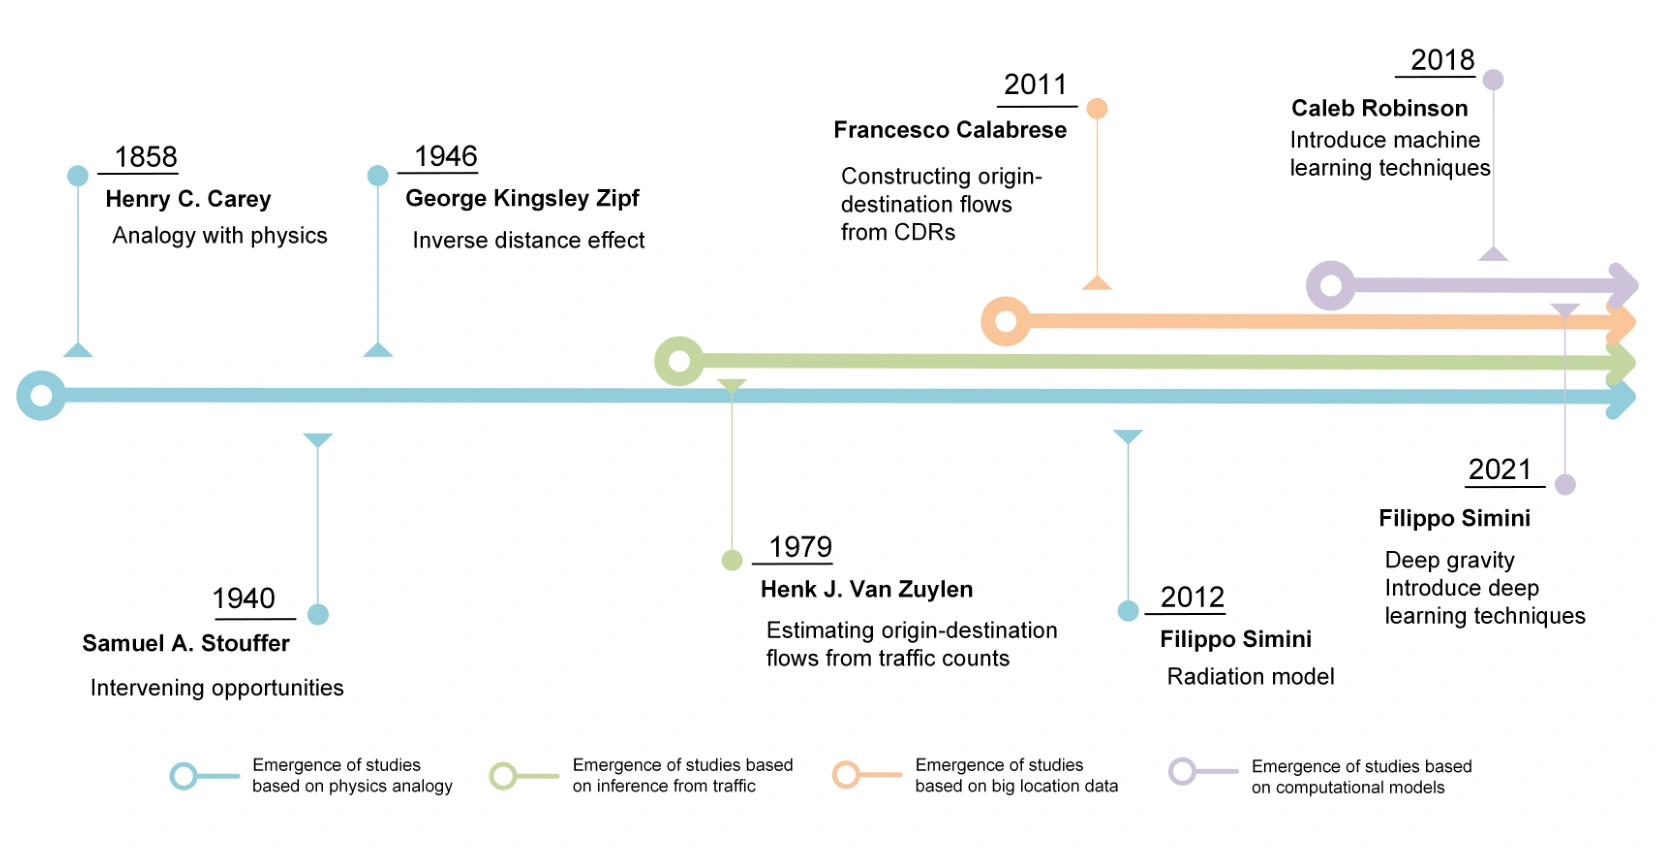
图 2|OD 研究的几条线分别从哪一年被标出来?
无字母。1858 年 Carey 用物理类比讨论;1940 年 Stouffer 提出介入机会;1946 年 Zipf 写出距离的反向作用;1979 年时间线将 Van Zuylen 标为从交通计数估计 OD;2011 年 Calabrese 等由通话详单构建 OD;2012 年 Simini 等提出辐射模型;2018 年 Robinson 引入机器学习;2021 年 Simini 等把深度重力模型放进计算模型这条线。蓝、绿、橙、紫四条线分别对应图例中的物理类比、交通推断、位置大数据和计算模型。来源:原论文 Fig. 2。
正文还有两处年份需要和参考文献对着看。Zipf 的正式条目 [262] 是 1946 年 American Sociological Review 上的 P₁P₂/D 假设;时间线和另外两处正文也写 1946,但 3.1 节有一处把同一条文献写成 1941。Van Zuylen 在时间线上是 1979,参考文献 [206] 是 Van Zuylen 与 Willumsen 1980 年关于由交通计数估计出行矩阵的论文。下文涉及这两人时,以参考文献的发表年为准,时间线上的年份同时保留。
学科分工在图 1 的文字里已经分开:计算机科学研究预测和预报,交通研究估计,城市规划面对的主要问题被写成构建。理论一侧,城市地理和区域经济做空间交互,社会物理借用物理模型解释移动从哪里来。
记录有多细,决定你能问多长的时间
移动数据被分成调查、个人轨迹和交通记录。个人轨迹包括通话详单(call detail records,CDR)、蜂窝网络接入、GPS 和基于位置的社交网络签到。交通记录包括监控视频、公交卡和出租车订单。表 1 只比较前一类轨迹,而且只用高、低两档,没有给出米或分钟的阈值。
| 数据 | 空间粒度 | 时间粒度 | 人口覆盖 |
|---|---|---|---|
| 通话详单 | 低 | 低 | 高 |
| 蜂窝网络 | 低 | 高 | 高 |
| GPS | 高 | 高 | 低 |
| 位置签到 | 低 | 低 | 高 |
高覆盖、粗粒度的通话详单、蜂窝数据和签到,常被用来估计通勤这类较长期的流量。GPS 能看到更细的活动,附录写它往往只覆盖至多数千人,成本高,不适合单独做全城研究。这里的分母是人,不是定位点;“至多数千”是综述的量级判断,不是某次抽样的精确人数。
Calabrese 等用 100 万用户的通话详单,先从个人轨迹得到出行,再汇总成波士顿都市圈的 OD 流量。100 万的分母是该项研究中的用户。Duan 等则按规则识别家和工地,再汇总通勤表。签到由用户主动上传,综述指出存在抽样偏差,时空上也更稀。
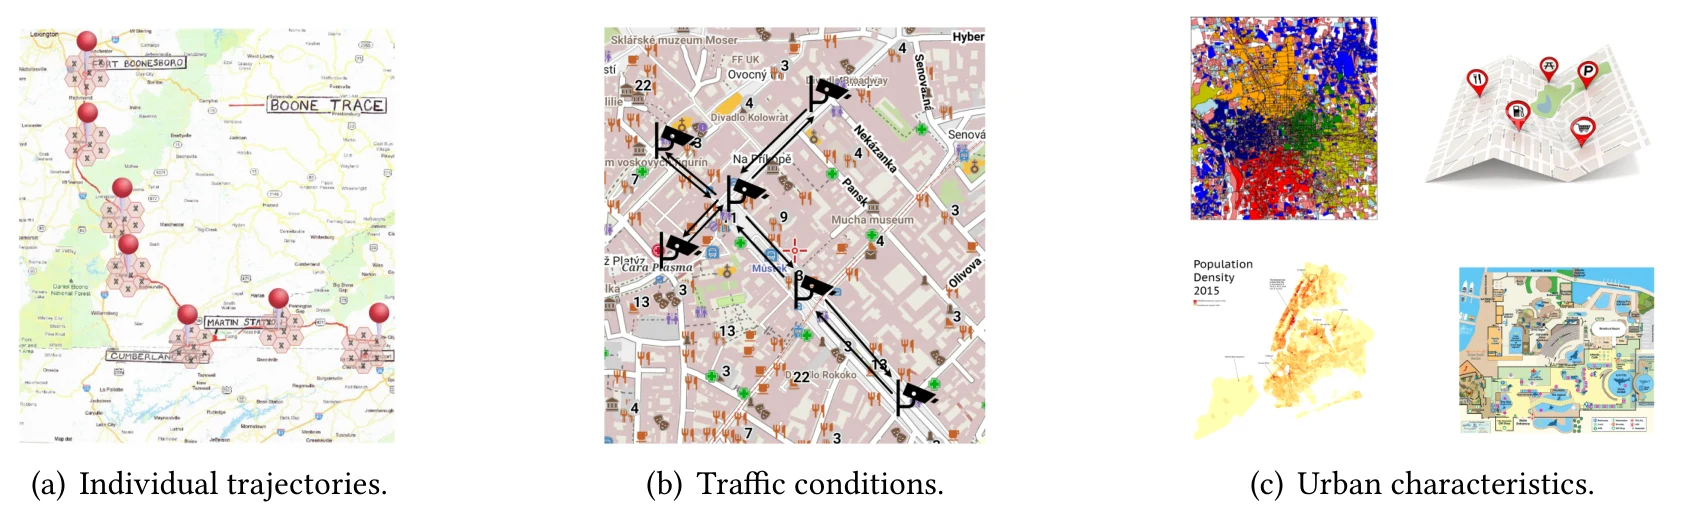
图 3|轨迹、路况和城市特征,分别长什么样?
(a)个人轨迹示意图,钉点沿一条道路分布,图中可见 Boone Trace 等地名。(b)交通状况示意图,路网上有车辆、信号和监测标记,街道名属于布拉格一带;综述没有报告该图的车辆数。(c)城市特征拼图,包括 2015 年人口密度、兴趣点、用地和路网。三格都是数据形态示意,没有样本量、城市边界或误差。来源:原论文 Fig. 3。
辅助信息分成三类。区域社会经济数据包括人口、用地、兴趣点(points of interest,POI)和基础设施,用来描述人为什么要去某个地方。交通观测主要是路段流量和车速:流量对应一段路上的车辆数,车速更瞬时,适合短时波动。城市地理数据提供空间背景。路段流量不等于 OD 表。一辆车经过某条路,只说明它的某一次出行使用了这条路,起点和终点仍可能有很多种组合。这正是后面 OD 估计欠定的原因。
引力模型在比较两地的规模和距离
引力模型(gravity model,也称重力模型)把两地之间的交互写成随规模增大、随距离增大而变化。Zipf 在 1946 年的表述是,流量与两地人口的乘积成正比,与距离成反比:
Tᵢⱼ 正比于 Pᵢ Pⱼ / dᵢⱼ。
Pᵢ、Pⱼ 是区域人口,dᵢⱼ 是距离。综述把这一步追溯到 19 世纪中叶 Carey 的物理类比,并把可标定参数的引入归到 1960 年代的 Huff;参考文献中 Huff 1963 年的文章讨论购物区贸易范围。带参数后,常见形式是
Tᵢⱼ = λ Pᵢ 的 βᵢ 次方 × Pⱼ 的 βⱼ 次方 / dᵢⱼ 的 α 次方。
λ、α、βᵢ、βⱼ 都可标定。更一般的写法把起点特征、终点特征和距离效果都换成函数。只有人口、并且函数取幂时,它退回上一式。距离用幂还是用指数,综述认为属于后续争论里的细节,没有在本文给出哪一种普遍更准的数字。
参数的作用是允许人口结构不同。综述举例:年轻人口更多的地区,作为起点时产出强度更高,βᵢ 可以更大。这是对参数含义的解释,不是一篇年龄数据的回归结果。
已知信息不同,约束就不同。表 2 用流入、流出和总出行量是否已知来分。
| 约束 | 流入 | 流出 | 总量 | 综述列出的应用领域 |
|---|---|---|---|---|
| 无约束 | 未知 | 未知 | 未知 | 城市地理、区域经济、城市规划 |
| 仅约束总出行量 | 未知 | 未知 | 已知 | 城市规划、景区规划 |
| 吸引约束 | 已知 | 未知 | 已知 | 区域经济、交通 |
| 产出约束 | 未知 | 已知 | 已知 | 计算机科学、交通 |
| 双约束 | 已知 | 已知 | 已知 | 交通 |
只知道研究区总出行量 T 时,比例系数 λ 用来把相对大小调到这个总量上:λ 等于 T 除以所有区域对的人口幂与距离幂之积的总和。知道每个起点的流出 Oᵢ 时,从 i 出发的预测流量之和必须等于 Oᵢ,终点人口和距离只决定这份流出怎么分。知道终点流入时,约束落在到达一侧。双约束同时卡住流出和流入,平衡因子通常要迭代求解。交通规划里的四阶段模型会用到双约束;商场、停车场的访客量则更接近只知道吸引端的情形。
四条理论推导都得到引力形式,微观假设却不同。Zipf 从最小努力出发:人会减少运输上的费力,并在原料附近的本地经济和消费集中的大城市经济之间形成平衡。Wilson 1967 年用统计力学的熵:每种微观出行选择先被看成等可能,宏观上看到的是微观状态数最多的那种分布,从而得到人口、距离和流量的关系。Roy 等用信息增益最小化,在双约束下更新先验。Niedercorn 1969 年用效用最大化:效用是经济学里对满足程度的理论度量,个人选择被写成使空间交互带来的效用最大,加总到集体后又得到与人口成正比、与距离成反比。综述指出,这些推导的共同点是优化,无论最大化熵、最小化费用还是最大化效用。同一条宏观公式因此可以对应多套微观故事,公式拟合本身不能选出其中哪一套已经发生。
距离变远人变少,可能是沿途机会变多了
1940 年 Stouffer 的介入机会模型(intervening opportunities model)认为,距离和移动之间没有被写成直接因果。人要去一个目的地时,会同时面对目的地本身的机会,以及路上已经遇到的其他机会。公式写成
Δy / Δs = a Δx / (x Δs)。
Δy 是从某个起点前往宽度为 Δs 的圆环的人数。圆环内缘到起点的距离约为 s − Δs/2,外缘约为 s + Δs/2。x 是内缘以内已经存在的介入机会,Δx 是这个圆环里吸引人们继续前往的机会,a 是系数。人数与 Δx 同向变化,与 x 反向变化。
若把 x 写成距离的函数,半径越大,圆内机会越多,x 单调增加,Δy 就单调下降。看起来仍像引力模型里的距离衰减(distance decay),机制叙述却换成了机会的分布。出行费用没有进入这套公式。综述把这一点写成理论贡献:流量不一定只因为距离变远而变少。它也说明,这条推论来自公式和机会随距离增加的假设,不是本文新测量的机会地图。
2012 年 Simini 等的辐射模型用另一套物理类比解释通勤:人从家这个区域被释放,再被其他区域吸收。每个区域的就业机会数与人口成正比,写成人口除以“产生一个岗位所需的人数”。岗位收入从某个分布 p(z) 里独立抽取。区域的吸引力被定义成当地最高收入。每个人的期望收入不低于家里能拿到的最高收入。规则是:选择最近的、收入高于这个期望的区域。
在这些假设下,一个人住在 i、选择到 j 工作的概率是
P = mᵢ nⱼ / ((mᵢ + Sᵢⱼ)(mᵢ + nⱼ + Sᵢⱼ))。
mᵢ 是起点人口,nⱼ 是终点人口,Sᵢⱼ 是以 i 为圆心、以 i 到 j 的距离为半径的圆内总人口。起点总流出为 Tᵢ 时,期望流量是
⟨Tᵢⱼ⟩ = Tᵢ × mᵢ nⱼ / ((mᵢ + Sᵢⱼ)(mᵢ + nⱼ + Sᵢⱼ))。
这是综述称为辐射模型基本方程的式 (14)。收入分布在积分之后不再出现在这个概率里。因此,公式给出的是上述假设下的期望流量,不是直接观测到的个人比了工资。Sᵢⱼ 变大,分母变大,期望流量下降。综述把 Sᵢⱼ 所代表的吸引力对应到介入机会,并把机会放在具体的圆里。
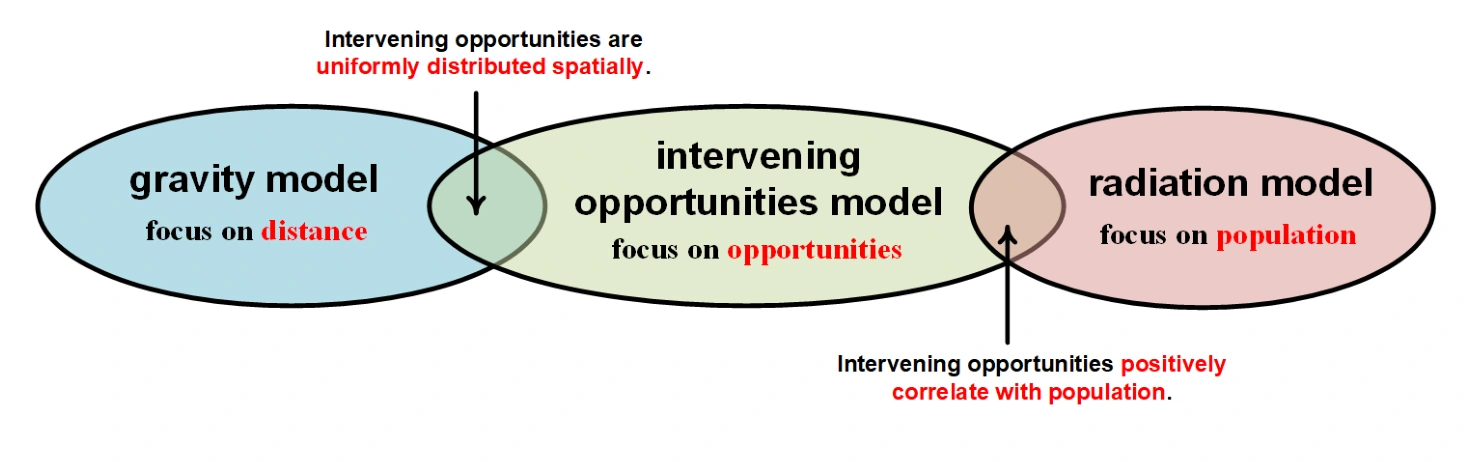
图 4|三个理论模型在哪一种机会分布下彼此接通?
无字母。蓝色为引力模型,焦点是距离;绿色为介入机会模型,焦点是机会;红色为辐射模型,焦点是人口。上方红字写:介入机会在空间上均匀分布时,指向引力模型一侧。下方红字写:介入机会与人口正相关时,指向辐射模型一侧。这是概念关系,没有拟合优度或城市样本。来源:原论文 Fig. 4。
已知的信息不同,任务的名字也不能混用
综述按目标和所用信息,把实践问题分成四个。评价方式放在附录 D:有真实 OD 时把数据分成训练和测试;没有真实 OD 时,只能靠小样本出行调查、交通分配、已有基准方法或下游任务间接查看。附录没有给出某一模型的误差数字。
OD 预测的定义是:区域已经带有社会经济和地理特征,而且一部分起讫对的流量已经被观测到,模型要预测其余未知的起讫对。它仍待在有流量观测的城市里面补洞。
方法被分成三类。传统模型就是前面的引力、介入机会和辐射模型,以及加入推特签到、Foursquare、路段计数、用地、人口密度、收入或教育等信息的变体。经典机器学习包括线性回归、逻辑回归、决策树、梯度提升回归树、随机森林、支持向量机和人工神经网络。综述依据若干被引研究写道,这些模型的精度高于传统模型;在多数被提到的比较里,人工神经网络不如支持向量回归和树模型。深度学习则用卷积神经网络和图神经网络提取空间特征,部分工作用多任务学习同时预测特定出行模式,再用它帮助总流量;也有工作把网格上的卷积和图网络合在一起,或用因果学习预测分布外的流量变化。综述的判断是:传统模型提供建模直觉,精度通常较差;经典机器学习能给出特征重要性;深度学习靠参数和结构取得文中所谓的最优表现,可解释性不足。这里没有一张统一测试集上的误差表,所以“通常较差”和“最优”是对文献的定性归纳。
OD 构建更难:目标是在没有任何 OD 流量可用时,凭较容易获得的信息生成完整矩阵。一条路是把个人轨迹汇总起来,用空间聚类、规则筛选和计数,替代昂贵的年度出行调查。它要求城市中大量个人的位置记录,隐私压力大。另一条路不使用目标城市的流量,分成预测式、生成式和迁移学习。
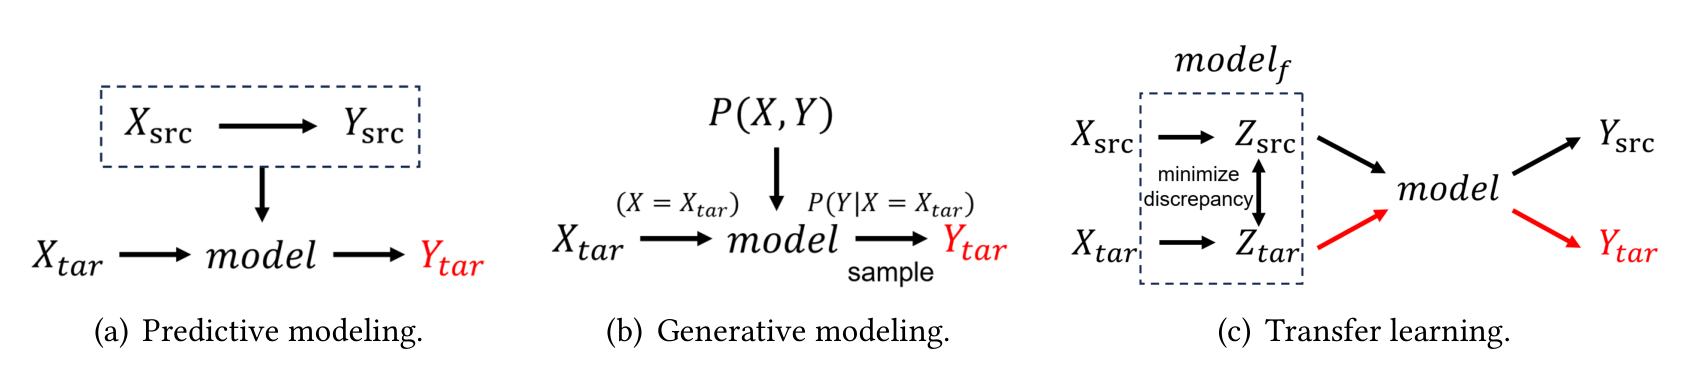
图 5|目标城市没有流量时,三种生成思路怎样使用别的城市?
(a)预测式:在有流量的源城市上学到模型,再把目标城市的特征送进同一模型,得到目标流量。跨城使用会带入转移误差。(b)生成式:由联合分布采样,或在给定目标城市特征时采样流量。综述把生成对抗网络和扩散模型归在这里,并强调整张 OD 矩阵的网络结构,而不只是两个区域的局部属性。(c)迁移:把源城市和目标城市的特征映到同一空间,缩小差异,再把源城市训练的模型用于没有标签的目标城市。综述写明,这一方向在成文时还没有足够有影响的研究。来源:原论文 Fig. 5。
OD 估计的输入是路段、路口或传感器上的交通计数或其他观测,输出是产生这些路况的分时段 OD 流量。问题严重欠定:同一组过车数可以由很多张 OD 表产生。传统做法把它写成优化,正文说目标函数包含五个凸项,随后点名的是贴近路段计数、满足流量守恒、让相近地点的起终点流量彼此相似,以及流量非负。五项没有被逐条命名。表 5 把熵最大化、最大似然主要放在静态估计,把最小二乘、原对偶、贝叶斯、梯度优化和遗传算法主要放在动态估计。数据驱动的做法有的直接学习路况到 OD 的映射,有的用神经网络近似原来很慢的交通模型,再回到优化。综述认为传统交通模型难以覆盖整个大城市,机器学习被用来提高效率。同样,正文没有报告加速了多少倍。
OD 预报是自回归的多变量时间序列:给定直到 k−1 时段的历史流量,预报 k 以及之后的流量。经典工具包括向量自回归、支持向量回归和 ARIMA。表 6 汇总了大量深度学习模型。空间特征常用图网络;构图时,综述先说大致有三种方式,随后列出的包括空间邻接、城市功能相似、历史序列形态相似,以及 OD 流量之间的相关。时间上常用 LSTM、GRU、时间卷积或自注意力。多数工作用预测和真实值的误差训练,少数用对抗损失或变分损失。稀疏被单独处理,有的用门控机制。这些是模型设计的清单,不是排名。
四类问题可以放在一张对照里。
| 问题 | 场景 | 已经拥有的移动信息 | 模型主要输入 |
|---|---|---|---|
| OD 预测 | 城市内部 | 一部分起讫流量 | 城市特征 |
| OD 构建 | 跨城市 | 目标城市之外的流量 | 城市特征 |
| OD 构建 | 城市内部 | 个人移动轨迹 | 轨迹 |
| OD 估计 | 城市内部 | 没有 OD | 交通状况 |
| OD 预报 | 城市内部 | 全部区域的历史流量 | 历史流量 |
预测和跨城市构建都把城市功能的空间差异当成驱动;城市内部的构建则把 OD 看成个人轨迹在区域尺度上的统计。估计依赖“人的移动会改变路况”。预报依赖流量自身的时间形态。所以,一个在预测任务上训练的模型,不能因为名字里也有 OD,就直接拿去从线圈数据反推,或拿去预报下一小时。
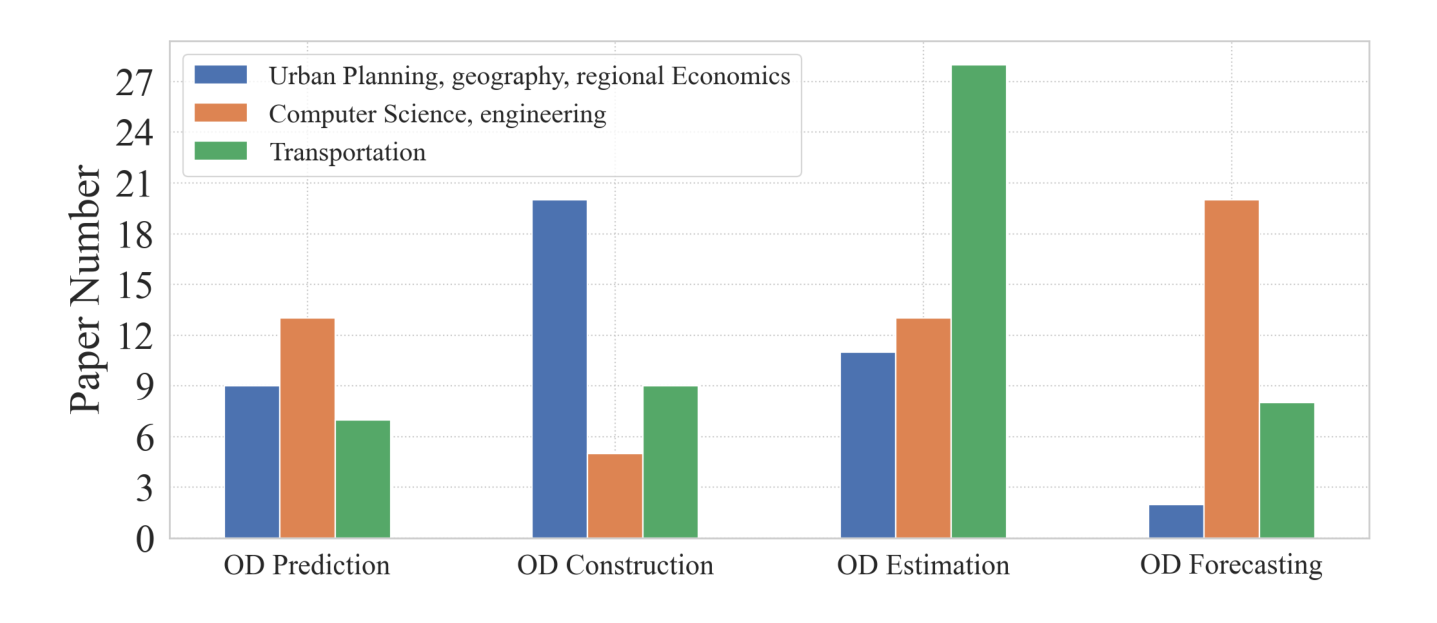
图 6|四个问题的论文篇数,在三类学科之间怎么分布?
无字母。纵轴 Paper Number,刻度为 0、3、6、…、27。蓝色是城市规划、地理与区域经济,橙色是计算机科学与工程,绿色是交通。柱上没有数字。对照刻度:OD 预测约为 9、13、7 篇;OD 构建约为 20、5、9 篇;OD 估计约为 11、13 篇,绿色柱略高于 27,按刻度间距约为 28 篇;OD 预报约为 2、20、8 篇。预测与构建里蓝色更高,估计里绿色最高,预报里橙色最高。综述没有在正文写出检索式和纳入标准,因此这些篇数是该图的读数,不能换成“全领域份额”。来源:原论文 Fig. 6。
作者把四个问题的基准收集并公开在 https://github.com/tsinghua-fib-lab/OD_benckmark 。仓库名在论文里拼作 OD_benckmark。正文只给出链接,没有报告基准上的准确率。
有真实值时,附录表 10 把指标分成误差和相似度。RMSE 先对每个起讫对的误差平方,再对起讫对个数 |F| 取平均,然后开方,单位与流量相同,大误差会被放得更大。MAE 是绝对误差对同样的 |F| 取平均,对离群值没那么敏感。CPC(common part of commuting,通勤共同部分)等于两倍的“真实与预测逐对取较小值之和”,再除以真实总流量与预测总流量之和。两张表完全一致时 CPC 为 1。它看的是流量重叠,和 RMSE 不保证同向。余弦距离看两个流量向量的夹角,对总量缩放较不敏感。没有真实 OD 时,附录列出四条间接途径:与小样本出行调查的空间分布对照、放进交通分配看路况是否相符、与已有基准方法对照、以及放进行程时间等下游任务。间接相符仍然不是逐格的真实流量。
规划、交通和疫情研究各自拿这张表做什么
应用一节举的是其他论文,不是本综述算出的新结果。城市规划方面,Zhong 等用已有 OD 做空间网络,看城市结构如何变化;Yuan 等把移动和 POI 一起用来划分城市功能区;Sun 等用人口移动模型讨论都市区的日常相遇。交通方面,Cats 等用 OD 和移动模型分析公交网络在服务中断时的脆弱性;Lättman 等提出感知可达性量表,并用 OD 看需求的空间分布如何影响乘客对可达性的感受;Pereira 等用网络数据和已有 OD 预测特殊事件期间的公交到达。
疫情方面,Balcan 等用来自普查和航空的 OD 讨论多尺度移动网络如何影响传染病的空间扩散;Zhang 等用航空 OD 和人口移动模型讨论寨卡病毒在美洲的传播;Jia 等用已有人口流讨论 COVID-19 在中国的时空分布;Huang 等的接触者追踪针对 16–23 岁的一组病例,并使用已有 OD 分析传播。16–23 岁是该项研究的年龄范围。这些例子说明 OD 可以被放进规划、交通和流行病模型,不说明任意一张估计出来的 OD 已经足够支持限行或隔离决定。
综述把哪些困难留在后面
可解释性和精度被写成一对尚未同时解决的困难。理论模型因素少、形式简单,解释清楚,精度有限。数据驱动模型可以纳入很多城市特征,精度更高,解释更弱。综述没有用一个数字定义“更高”。
数据方面,高分辨率、及时的 OD 在基础设施不足或隐私限制强的地区很难获得,不同来源的粒度和质量也不一样。灾害等特殊场景的数据更难拿到。算法方面,OD 矩阵的维度是区域数的平方,综述写它可以达到百万量级。这里没有给出具体的区域数 N,因此不能把“百万”读成某座城市的实测格子数。
未来方向也是建议,不是已经完成的实验。一条是把物理知识放进网络结构,或用机器学习重新发现知识。另一条是用全球多种数据做一个可迁移的移动模型,再按城市特征生成 OD;城市知识图谱被提到作为把交通、通信、人口、普查、地理信息和手机记录放进同一框架的候选。应用一侧,作者认为发达地区数据多、发展中地区数据少,分布不一致,因果学习和迁移学习可能用来抓住更稳的关联。大规模矩阵则需要更简的模型和更高的计算效率。与城市模拟耦合被写成仍不充分,文中主要提到强化学习用于交通信号,以及把 OD 放进事件、个人移动、步行和通信行为的模拟,以保持不同尺度的行为一致。
附录还说明,这篇综述和三类已有综述的差别在哪里。人类移动综述覆盖个人和集体、流入和流出,对区域之间的 OD 着墨较少。空间交互综述包含人、货物和信息,重心在机制。交通综述把由路段计数估计 OD 写成已经标准化的问题。本文把区域之间的人流单独拿出来,同时写理论和四个任务。
一句话总结
两地之间的人数可以被距离、沿途机会或人口布局写成理论公式,也可以因为你手里已有部分流量、个人轨迹、路况或历史流量,而变成补全、生成、反推或预报;这篇综述把这些任务拆开,并用文献篇数显示不同学科集中在不同任务上,它没有给出一个通用精度。
核心来源
- ACM Computing Surveys 正式记录,2024年10月7日,57卷1期第4篇,1–49页。
- arXiv:2306.10048v4,2024年10月9日。正文图 1–6、表 1–7 与附录 A–D 均出自这一版本;附录含约束引力模型的推导、评价指标和没有真实 OD 时的间接核对。
- 文中给出的基准入口:https://github.com/tsinghua-fib-lab/OD_benckmark 。正文没有报告该基准的误差。
作者介绍
三位作者在论文中的署名单位都是清华大学电子工程系、北京信息科学与技术国家研究中心(BNRist)。以下只写论文和公开出版物中能够核对的身份,不补充未在这些材料中出现的职务。
- Can Rong:论文联系邮箱为 rc20@mails.tsinghua.edu.cn。署名研究围绕城市起讫流量;同组后续公开工作包括用城市特征和交通信息生成时序 OD。
- Jingtao Ding:论文联系邮箱为 dingjt15@tsinghua.edu.cn,论文列表见于清华大学电子工程系站点上的个人页面。与 Rong、Li 共同署名城市移动和 OD 研究。
- Yong Li:论文联系邮箱为 liyong07@tsinghua.edu.cn。在同组的 OD 生成论文中被标为通讯作者,公开工作涉及城市计算与人类移动。本综述致谢写明资助来自国家自然科学基金 62272260、U20B2060,以及国家重点研发计划 2020YFA0711403。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个部门在比较“模型准不准”之前,可以先把每份数据标成四个问题中的哪一个。只有线圈计数时,手上的任务是估计;把另一个城市拟合好的引力模型直接套上来,失败可能来自输入里从来没有 OD,而不来自距离函数写错。图 6 的柱高也提醒,只检索计算机科学会把预报看成主流,只检索交通会把估计看成主流。若下一次综述公开检索式和文献清单,约 28 篇这种需要靠刻度外推的柱子就可以改成可核对的整数。
辐射模型的最终概率里,收入分布被积分消掉了。按这条公式,两座人口布局相同的城市,即使工资分布很不一样,通勤概率仍然相同。这是一个可以单独检验的预测:若在人口和距离不变时,工资分布改变了实际通勤,公式所依赖的“收入只通过最大值起作用、并在最后消失”就不成立。综述推导了这个形式,没有做这项检验。