早高峰离开车站,和晚高峰回到车站,在分区向量里是同一件事吗?
论文名片|Zijun Yao、Yanjie Fu、Bin Liu、Wangsu Hu、Hui Xiong,Representing Urban Functions through Zone Embedding with Human Mobility Patterns,Proceedings of the Twenty-Seventh International Joint Conference on Artificial Intelligence(IJCAI-18),2018,第 3919–3925 页。会议论文页面。方法论文:用出租车行程在分区间的来去学习分区向量,再与用地构成的聚类比较。
工作日早上八点多,人从车站附近离开,去中城的办公分区;下午五点多,联系又从办公分区回到车站。若只累计两个分区之间一共有多少次出租行程,这两段会被记成同一种关系。城市功能却正好写在方向和时间上:车站区在接驳,办公区在到达。
论文用纽约宾夕法尼亚车站附近的一个交通分区说明这个差别。它要学习的是每个分区的一条低维向量,也就是区域嵌入(zone embedding):功能相近的分区在向量空间里更靠近。向量来自行程汇总后的分区关系,不保存乘客是谁。
方向性的结果是:把离开还是到达、发生在哪个时段写进共现之后,分区向量比兴趣点数量、签到次数和主题模型更接近用地面积比例的分组;再按目的地吸引力和行程距离给共现加权,中城东西两侧和上东区的地图阅读也会分开。能够成立的是分组更一致。用地聚类不是规划图上的功能名称,黄色出租车也不是全部出行。
先说结论
- 训练数据是 2013 年 6–8 月纽约黄色出租车的全部行程记录,共 33,842,934 次。分析单位是行程,汇总到 193 个分区。这个数字的分母是行程次数,不是乘客人数。
- 每条行程在账本上记两笔:起点对应“终点、到达时刻、到达”,终点对应“起点、出发时刻、离开”。功能相近,指的是分区遇到的这类移动事件相似,不是起点和终点共用同一个向量。
- 共现误差再乘引力模型给出的 0 到 1 的权重。工作日距离参数 β 为 0.4674,周末为 0.3881。论文没有写出距离单位,也没有报告这次拟合的误差。分区向量维数取 50。
- 参照分组是 11 类用地的面积占比向量再做 k-means,不是官方功能区名称。论文报告,在 K 为 5、10、15、20 时,完整模型的 NMI、ARI、F 和 CID 都优于所列基线。图中柱顶没有印数值,正文也没有列表,差距的具体百分点无法逐柱抄出。
- K=10 的地图上,作者认为引力权重把中城东侧制造业和西侧商业分开,也避免把第五大道购物区并进以上宅为主的上东区。图上没有地名,这是对照用地图的阅读,不是逐区判对率。
分区里面发生了什么,为什么还不够?
城市功能在论文里指分区承担的用途,例如工作、居住和游憩。签到数据能描述分区内部有哪些活动,却很难提供嵌入所需要的上下文:这个分区经常和哪些别的分区、在什么时刻发生来往。
作者引用既有研究,说明基于位置的社交网络有三类偏差:签到偏向娱乐类兴趣点,热点以外的地点和时段很稀疏,用户按下签到也不等于真的完成了一次移动。这些是设计理由,不是本文重新测量的偏差比例。本文自己的数据对比放在后面:签到和兴趣点来自另一套、更小的样本,出租车行程才是嵌入的训练来源。
签到数据来自 Yang 等人整理的纽约 Foursquare 记录,时间为 2012–2013 年中的 10 个月。规模是 1,046 名用户、17,009 个兴趣点、139 个细类、109,073 条签到。四个数字的分母不同,不能把 109,073 除以 1,046 理解成全市居民的日均出行。论文也没有给出这 10 个月与 2013 年 6–8 月对齐后的重叠天数。
兴趣点基线把每个分区写成一条 TF-IDF 向量,长度等于兴趣点类别数;在这份数据里,细类共 139 个。签到基线用同一套算法,只是把类别频数从兴趣点个数换成签到次数。Livehoods 基线则把同一账号在不同兴趣点的签到当作地点之间的社会相似性,并加入兴趣点距离,再汇总到分区,分区位置取分区中心。这里只使用论文已经汇总到地点和分区的相似性,不涉及把账号还原成某一个人的行程。
一次行程在分区账本上记哪两笔?
出租车记录来自纽约市出租车与豪华轿车委员会的黄色出租车。每条记录含上下车地点、时间戳和行程距离。论文把地点落到美国人口普查局设计的城市分区,最终得到 193 个分区。作者给出选用理由:分区内部的人口和环境较一致,边界常沿主要道路,面积也相对小。这是选择理由,论文没有另测每个分区的人口方差。脚注中的分区链接只到 data.gov 的数据集目录首页,因此这 193 个分区对应哪一套官方地理编码,无法只凭脚注确定。
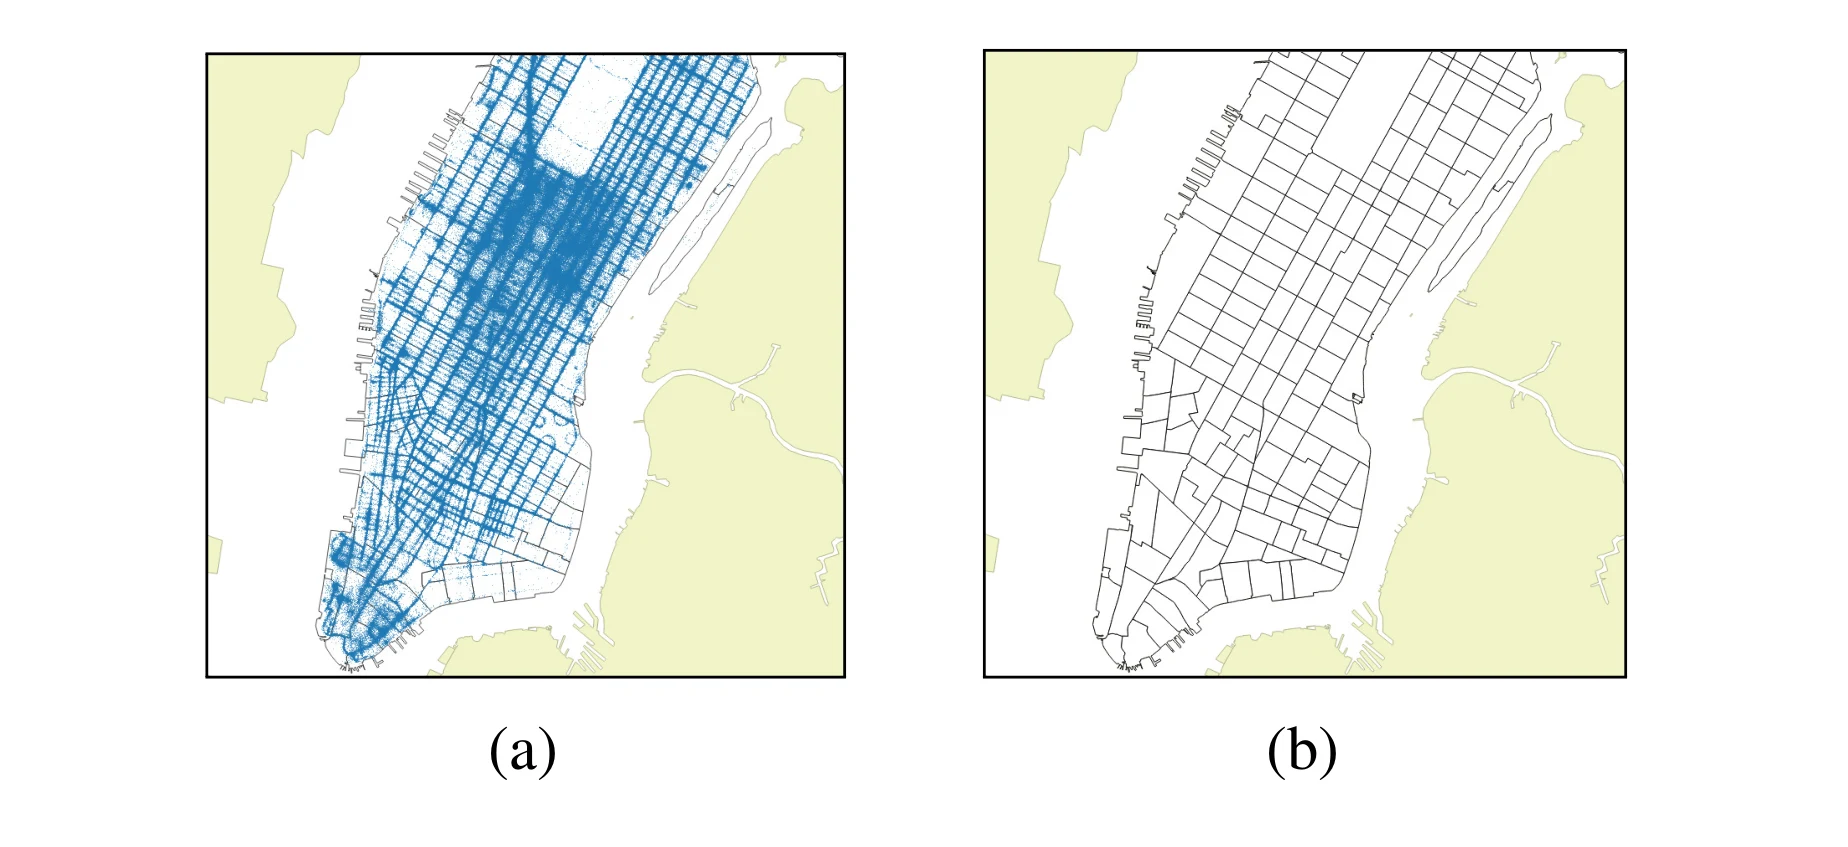
图 1|这 193 个分区和出租车上下车,落在什么样的空间范围里?
(a)蓝色为出租车上车位置,密密铺在一座网格状岛屿上。(b)同一范围被切成多边形分区。图中的分区网格集中在这一座岛屿上,图内没有标出 193;193 来自正文。上车点的疏密只说明黄色出租车在哪里被叫到,不能当成居住人口或全部出行的分布。来源:原论文 Fig. 1。
从每条行程抽出的人类移动模式(human mobility pattern)包含四项:起点分区、终点分区、出发时间、到达时间,另外保留行程距离供后面的权重使用。时间先变成时段和日类型。论文举例可以把一天分成 24 个小时,并区分工作日与周末;正文里的具体例子是工作日 12 时至 13 时到达。实验有没有把某些小时合并,论文没有另表说明。
若只把起点和终点看成无方向的一对分区,早高峰离开和晚高峰返回无法区分。论文因此改用移动事件(human mobility event)当上下文。一个事件由分区、时间和状态组成,状态只有到达或离开。每条行程记两笔共现:
| 作为嵌入目标的分区 | 作为上下文的移动事件 |
|---|---|
| 起点 | 终点、到达时间、到达 |
| 终点 | 起点、出发时间、离开 |
计数 #(分区, 事件) 是有多少次行程落到这一种分区与事件的配对。论文没有印出全部配对的总次数。按定义每条移动模式贡献两笔;33,842,934 是行程数,不能直接当成共现总次数。
词嵌入里,经常出现在相同邻近词旁边的词,向量会接近。分区嵌入沿用这个比较,角色却不对称。论文的对照表把目标写成分区、上下文写成移动事件、共现发生的场合写成一次移动模式。两个居住分区如果都在工作日早晨连接到同一批办公分区,它们会共享相似的到达事件,向量因此靠近。办公分区自己的向量,则由哪些分区在什么时刻离开并指向它来决定。起点和终点是配对的两端,不是同一个向量。
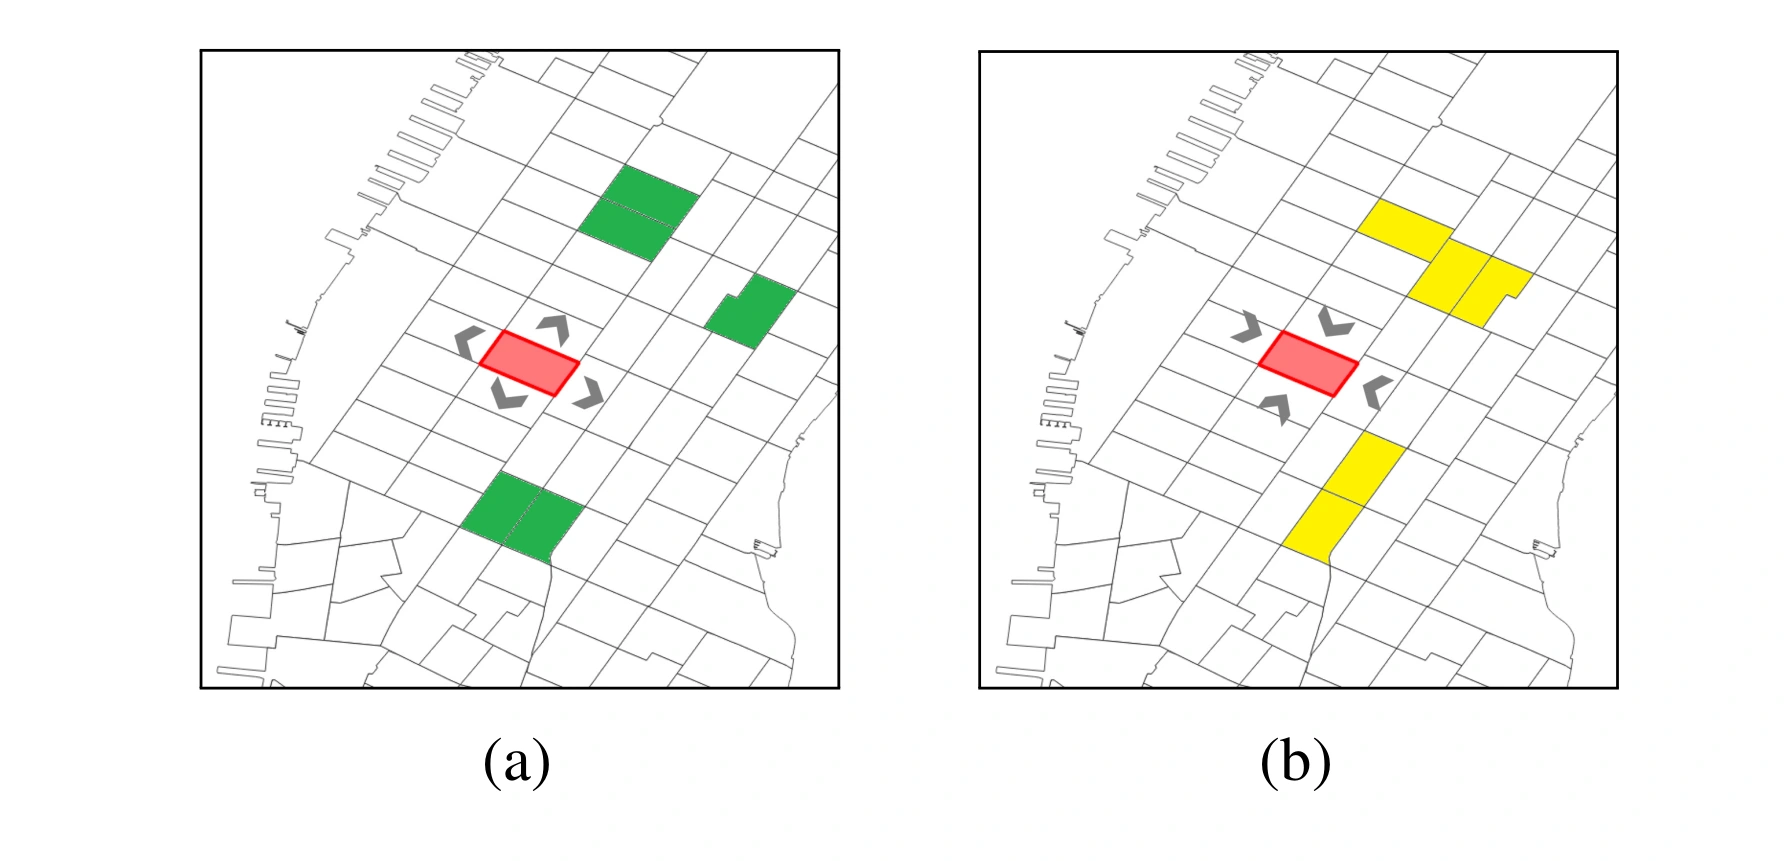
图 2|方向和时间怎样改变同一个交通分区的上下文?
(a)红色为宾夕法尼亚车站所在的交通分区,绿色为工作日 8–9 时离开这里后所指向的办公分区,箭头表示送出。(b)黄色为工作日 17–18 时返回联系所涉及的分区,箭头指向车站。图题写的是最突出的若干联系,没有印出行程数,也不能把绿色或黄色分区的块数当成全市办公区个数。来源:原论文 Fig. 2。
向量本身来自正点互信息(positive pointwise mutual information,PPMI)。它比较的是:分区和某个移动事件一起出现的次数,是否高于各自单独出现时的偶然相遇。记法是
M(z, e) = max(0, log( #(z, e) · |T| / (#(z) · #(e)) ))。
(z) 和 #(e) 是分区、事件各自出现的次数,|T| 是观察到的共现总次数。对数里的比值小于 1 时,互信息为负;PPMI 把负值截成 0,避免少数偶然配对把向量拉偏。论文没有公布 |T|、#(z) 或任何一格 PPMI 的数值。
学习时最小化全部配对上的平方误差。分区向量 v 和事件向量 v′ 的内积去逼近 M,维数 D 取 50。50 是作者设定的实验值,论文没有给出其他维数的对照。后面用于聚类的是分区向量;事件向量只在这个分解里充当上下文。
同样是共现,为什么有的更重要?
同样一次共现,目的地是否容易被到达、两区之间通常走多远,对功能的提示并不相同。论文用交通分析里的引力模型给每个起讫对一个权重。对固定起点,权重在全部可能终点上相加为 1,可看成这条起点的行程被各终点分走的比例。
目的地吸引力 A 是到达该分区的行程总数。距离阻力用负指数 e 的 −βd 次方,d 是这两区之间各次行程距离的平均值,不是地图直线距离。论文没有写 d 的单位。每一格的分子是目的地吸引力乘以距离阻力,分母是该起点对所有分区的同一乘积之和。估计行程数等于起点出发总次数乘以这个比例。β 用遗传算法去减小估计数和实际数的平方误差,工作日与周末分开估计,得到 β 为 0.4674 和 0.3881。
在同一距离单位下,0.3881 小于 0.4674,表示周末的负指数掉得更慢。论文没有解释这个差别,也没有给出拟合后的平方误差,所以这两个数只能说明权重公式里用了什么参数,不能单独证明周末出行更不怕远。
这个权重乘在对应共现的平方误差上。一天中的小时已经写进移动事件,引力权重却只按工作日或周末更换,不再按小时更换。于是,时段负责区分早高峰和晚高峰的上下文,日类型和距离负责决定哪一笔共现对向量的拉动更大。
还要分开两件使用了同一批行程的事:PPMI 用行程计数衡量共现有多超出偶然,引力权重再用行程计数决定这笔误差重不重要。权重不是一套独立调查来的需求。很大的起讫流量会同时抬高共现次数和权重。论文没有把某个月留出,用来检查权重换到没见过的行程后是否仍然有用。
赢过基线,比的是用地构成像不像?
评价没有使用下一次行程预测,也没有留出乘客或日期。做法是对分区向量做 k-means,再看分组是否接近用地构成的分组。
用地来自纽约市官方地块用途,共 11 类。每个分区先把地块按面积汇总成 11 个百分比,得到一条用地向量。然后对用地向量做 k-means,把结果当作参照标签。K 取 5、10、15、20 时,参照标签也跟着重新聚类。因此指标衡量的是两种聚类是否一致,不是分区被标成了图例里的哪一个官方名称。
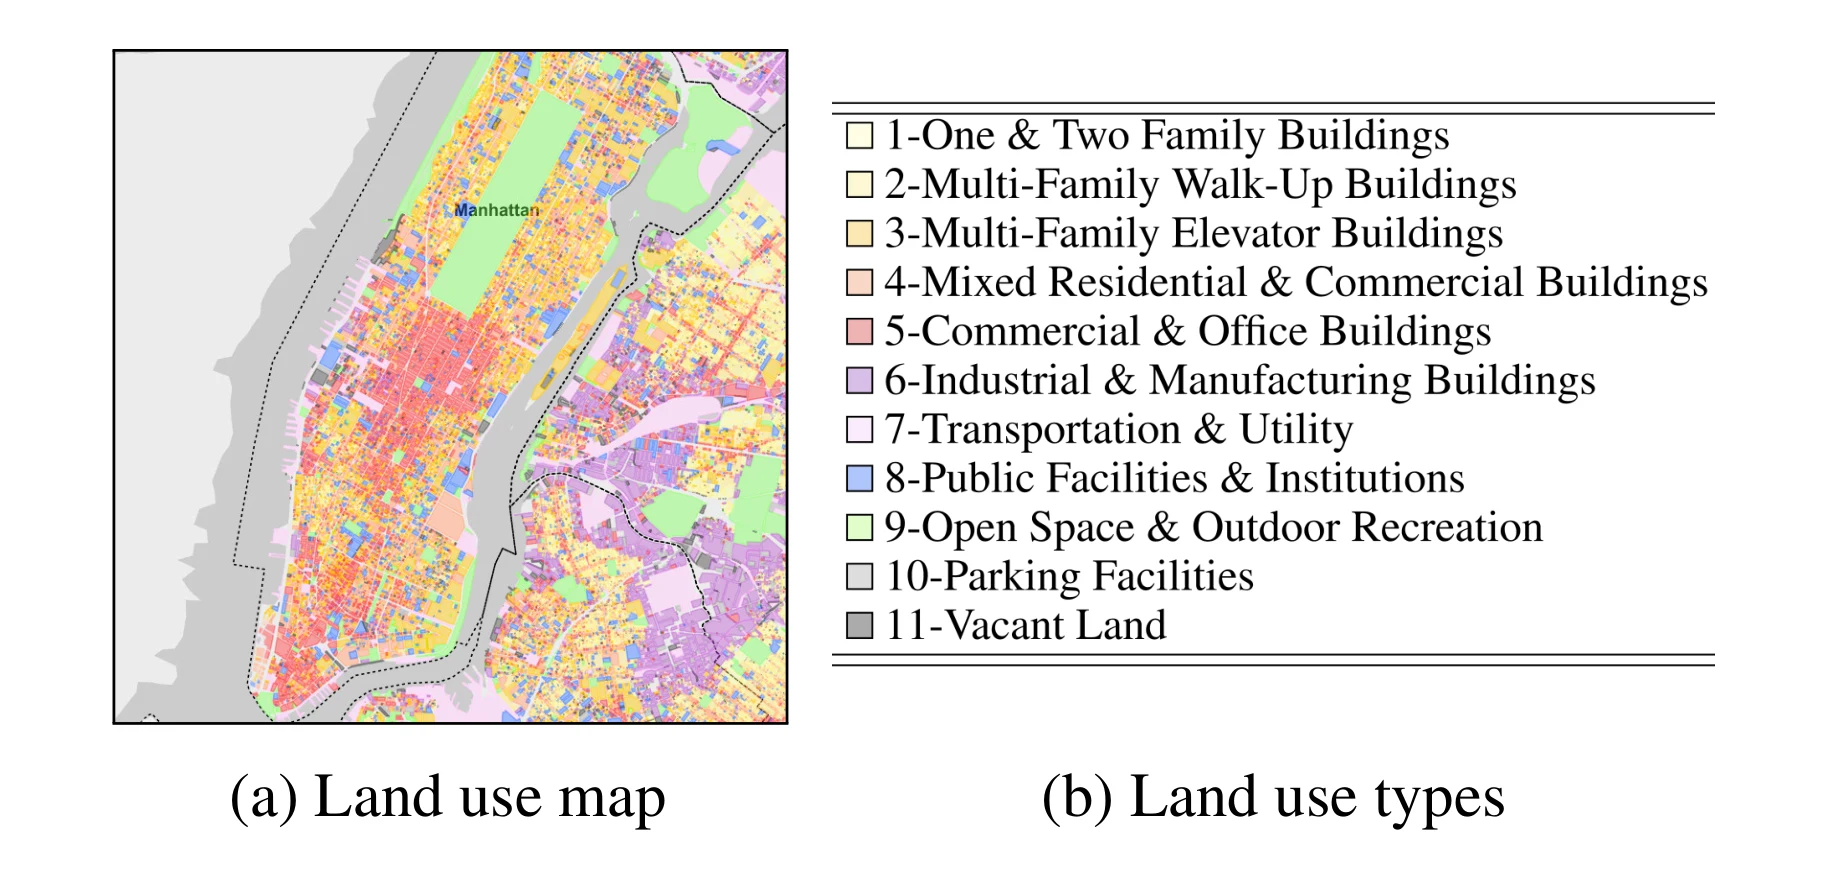
图 3|参照标准使用的用地,是地块颜色还是分区名称?
(a)地块按用途着色,图内标有 Manhattan,周围陆地也有颜色;虚线在图中可见,正文没有定义它是研究边界还是制图范围。(b)11 类图例:一户与两户住宅、无电梯多户住宅、有电梯多户住宅、居住与商业混合、商业与办公、工业与制造业、交通与公用设施、公共设施与机构、开放空间与户外游憩、停车设施、空地。分区向量的参照是这 11 类的面积占比,不是这张图上的某一种颜色本身。来源:原论文 Fig. 3。
四个指标都建立在分组之上。
归一化互信息 NMI 等于两组标签的互信息,除以两组熵的算术平均。分母是 (H(参照) + H(聚类)) / 2。它越大,表示两种分法从信息角度看越整齐。它不直接等于分对了多少个分区。
调整兰德指数 ARI 先把每对分区看成一次决定:参照聚类里它们是否同类,方法聚类里是否同类。兰德指数的分子是判对的配对,分母是全部配对。ARI 再扣除随机分组也能碰上的那一部分。论文给出的范围是 −1 到 1,随机标注接近 0,完全一致为 1。若按 193 个分区的全部无序配对计算,配对分母是 18,528;这个数由分区数推得,正文没有单列,也没有给出真正例的个数。
F 值同样按配对计算。精确率的分母是方法判成同类的分区对,召回率的分母是参照分组里真正同类的分区对。β 取 0.5,精确率在这个调和平均里的权重大于召回率。
簇内用地差异 CID 的分子是每个分区的用地向量到其所属簇平均用地向量的欧氏距离之和,分母 N 是分区总数,也就是 193。数值越小,同一簇的用地构成越接近。它量的是用地向量,不是 50 维嵌入里的距离。
基线有五种。兴趣点 TF-IDF、签到 TF-IDF 和 Livehoods 使用前面的社交网络数据。LDA Mobility 把分区当文档、移动事件当词,用主题向量再聚类,数据和嵌入模型一样来自行程。无引力的 ZE-Mob 去掉权重,只保留 PPMI 分解,用来单独看吸引力与距离有没有贡献。论文没有给出 LDA 的主题个数。
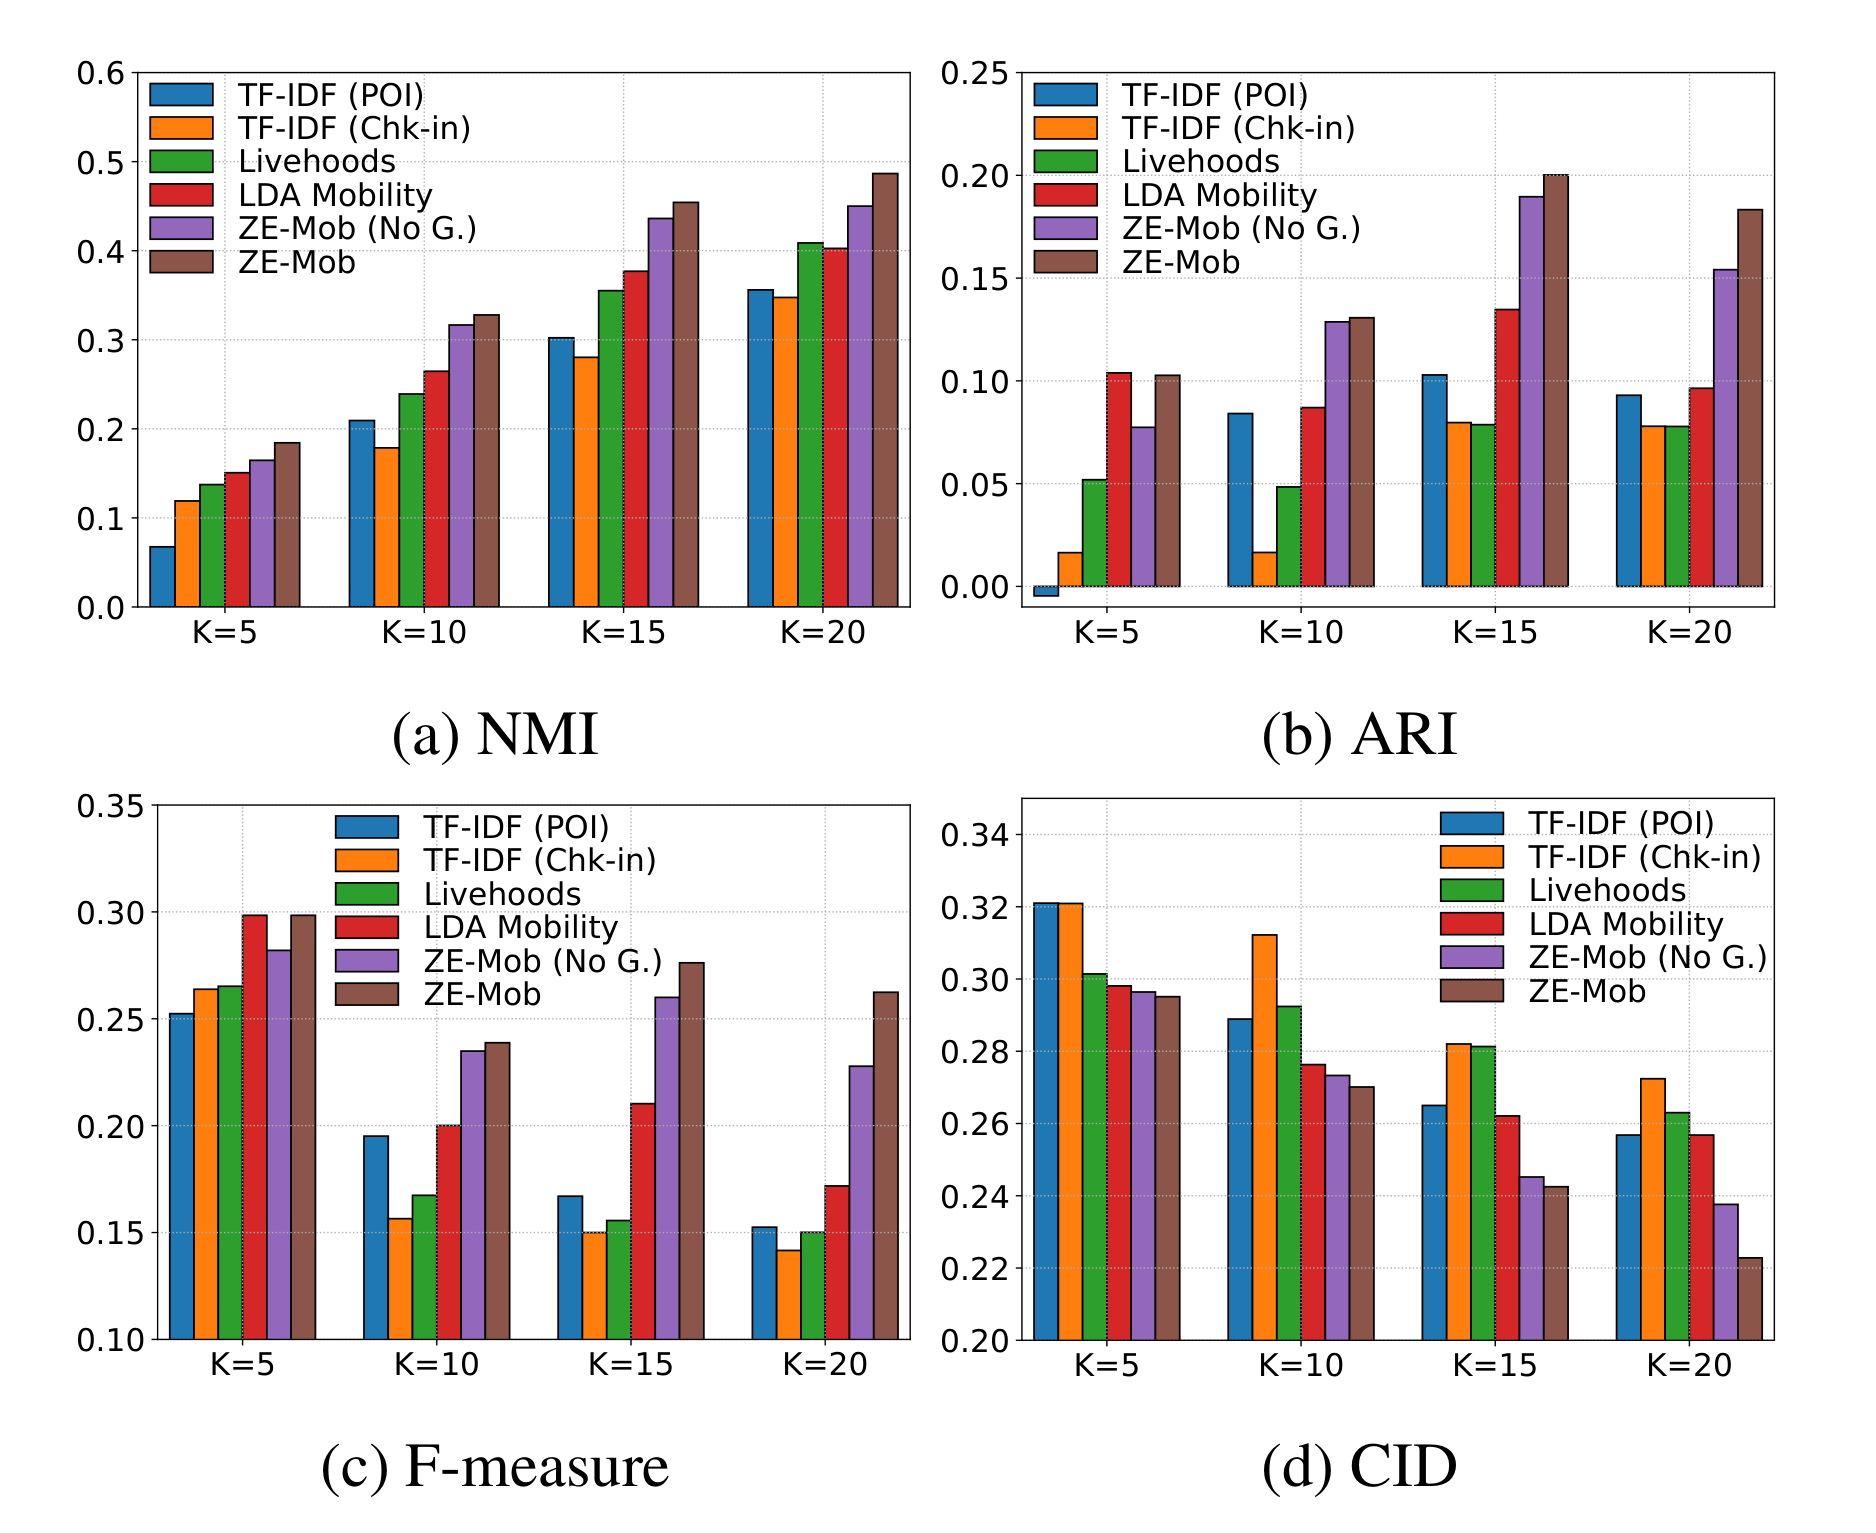
图 4|同一种簇数下,哪种分区表示更接近用地聚类?
(a)NMI,纵轴刻度 0 到 0.6,越高越一致。(b)ARI,纵轴刻度 0 到 0.25,越高越一致。(c)F 值,纵轴刻度 0.10 到 0.35,β 为 0.5,越高越一致。(d)CID,纵轴刻度 0.20 到 0.34,越低表示同一簇的用地构成越接近。每个 K 下面的六根柱依次是兴趣点 TF-IDF、签到 TF-IDF、Livehoods、LDA Mobility、无引力嵌入和完整嵌入。柱顶没有数字,也没有误差线,正文因此没有各柱的百分点差。来源:原论文 Fig. 4。
论文的总判断是:完整模型在四个指标、四个 K 上都优于这些基线。签到 TF-IDF 被评为最差,因为签到在兴趣点之间极不均匀,流行分区和不流行分区被分得更开,而这种分开并不对应用地构成。兴趣点 TF-IDF 也不好:住宅区的兴趣点稀疏,大量兴趣点又集中在用餐等少数类别,分区之间拉不开。Livehoods 与兴趣点 TF-IDF 相近或更好。LDA 由于使用了行程,高于只使用社交网络的方法。完整模型又高于去掉引力权重的版本,这是同一批行程内部的对照,比跨数据源的对照更直接。
跨数据源的胜利要分开读。兴趣点和签到只有 109,073 条签到、1,046 名用户,行程有 33,842,934 次,时间窗口也不相同。完整模型高于兴趣点基线,同时改变了数据和算法。完整模型高于 LDA、高于无引力版本,才是在行程数据内部的比较。图里没有置信区间,也没有重复 k-means 的波动,所以“全面更好”是这一次分组图上的结果,不是已经估计出的稳定增益。
分成十组后,曼哈顿地图上能叫出功能区吗?
K=10 时,论文把聚类颜色画回地图,用来看功能区域是否连成片。六种方法使用各自的表示,颜色只在同一幅小图内部区分簇,不能跨图比较同一种颜色。
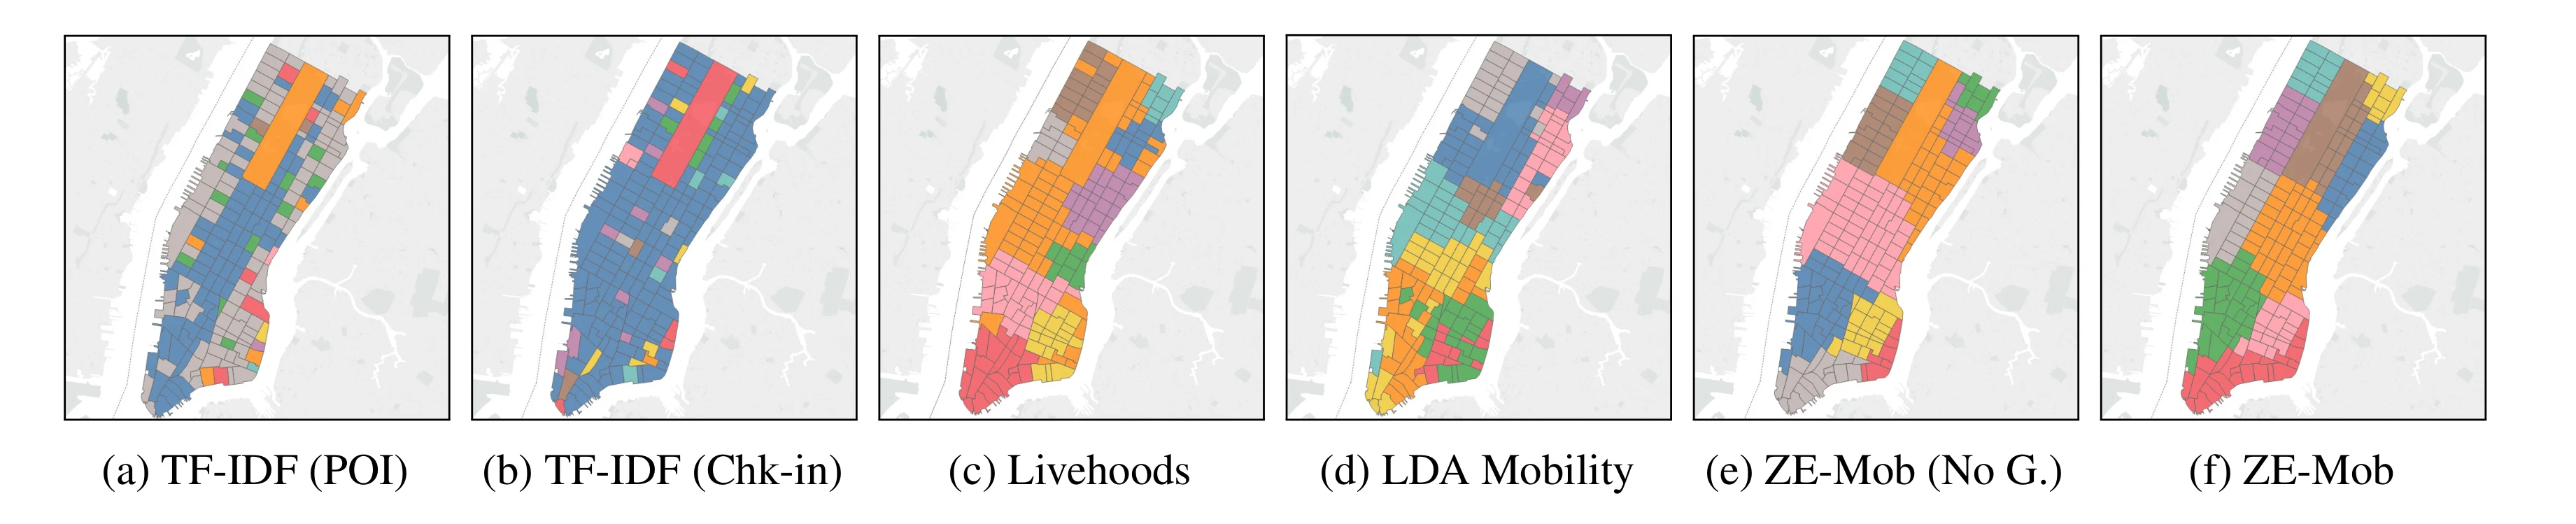
图 5|K=10 时,六种表示把曼哈顿分区涂成了怎样的块?
(a)兴趣点 TF-IDF。(b)签到 TF-IDF。二者都出现大片同一颜色,论文认为这主要分开了兴趣点够多和不够多的分区。(c)Livehoods 的色块更碎,但远距离分区仍难进入同一簇,区域不容易沿城市的实际功能延伸。(d)LDA Mobility 的南北差异更清楚,仍有不同颜色互相穿插。(e)无引力嵌入。(f)完整嵌入。两幅嵌入图都能分出论文所称的上城、中城和下城;下城一端与东村、西村在作者的阅读中被分开。(e)把中城涂成同一类,并把第五大道一带并进上东区;(f)把这些区域分开。图内没有印地名,东西两侧谁是制造业、谁是商业,作者指向的是图 3 的用地图,正文没有给出这两侧的面积占比。来源:原论文 Fig. 5。
作者的地图阅读还包括:下城被分成金融区,以及东村和西村这两个娱乐区域;无引力版本把中城全部归为一类,而用地图上东侧更偏制造业、西侧更偏商业;无引力版本还把第五大道购物区并进主要承担居住功能的上东区。这些句子里的“正确”和“错误”是作者对照用地图和地名知识作出的判断。图 5 没有逐区得分,不能换算成 193 个分区里判对了多少个。
这些结果还停在哪一层?
向量距离表示的是移动事件上下文有多像。它支持功能相近的分区在这套行程里被放近,不支持某个分区因为连接了办公区就在因果上变成了办公区。早高峰例子说明方向和时间应当进入记账方式,不是一次对车站客流的统计检验。
参照标签来自用地面积占比的聚类。一块被划成住宅的地,白天仍可以有大量到达;一种用地混合在 K 改变时也会改组。和这种标签一致,说明嵌入分组贴近地块用途的面积结构。它没有恢复图 3 图例中的 11 个名称,也没有测量人在该小时实际做什么。
行程只覆盖 2013 年夏季三个月的黄色出租车。论文认为纽约很少有人自己开车,所以出租车足以代表地面出行。这个理由没有附带方式分担率。地铁、公交、步行和私人汽车不在 33,842,934 次的分母里。图 1 和图 5 画出的分区集中在曼哈顿岛,正文仍把研究对象写成纽约市。远离这批上车点的分区,向量主要缺少的是出租车可见的联系。
β、PPMI 和聚类都使用同一批行程。维数 50 和地图所用的 K=10 也是选定后的展示,不是在独立数据上选出来的最优值。因此,图 4 的优势是拟合后的分组一致性,还不是换一个季节或换一种交通方式后的预测能力。
一句话总结
早高峰离开车站和晚高峰回到车站会被记成不同的共现;由此得到的分区向量,在这 193 个分区上更接近用地面积比例的聚类,但还没有直接读出功能名称,也还看不见黄色出租车以外的移动。
核心来源
- IJCAI-18 会议论文页面。正文页眉印有 Proceedings of the Twenty-Seventh International Joint Conference on Artificial Intelligence(IJCAI-18),页码 3919–3925。图 1–5 以及词与分区的角色对照都来自该文。
- 用地查询入口为论文脚注中的 Zola。分区脚注为 data.gov 数据集目录,只到目录首页。黄色出租车来自纽约市出租车与豪华轿车委员会 2013 年 6–8 月的行程记录。
- 签到与兴趣点来自论文引用的 Yang 等人 2015 年数据。Livehoods、LDA 功能和引力模型分别沿用论文引用的 Cranshaw 等人 2012、Yuan 等人 2012 和 Cascetta 等人 2007 的做法,比较结果以本文实验为准。
作者介绍
- Zijun Yao:第一作者,论文署名罗格斯大学。学位论文库记录显示,其 2018 年博士论文为 Mobile Intelligence Analytics for Urban Smart Living,导师是 Hui Xiong;摘要中的一项工作就是用起讫交通数据学习分区功能表示。
- Yanjie Fu:论文署名密苏里科技大学。该校智能系统中心页面将他列为计算机科学助理教授,公开邮箱与论文中的 fuyan@mst.edu 一致。2018 年合肥工业大学报告页使用中文名傅衍杰,并写明其博士毕业于罗格斯大学,研究包括时空数据挖掘与城市计算。
- Bin Liu:论文署名 IBM Thomas J. Watson Research Center。IBM Research 的论文条目列出同一作者名单。论文没有给出更具体的职务。
- Wangsu Hu:论文署名罗格斯大学。学位论文库收录 Wangsu Hu 2019 年的土木工程博士论文 Dynamic Origin-Destination Estimation with Location-Based Social Networking Data,委员会包含 Hui Xiong。那篇论文讨论签到与动态起讫估计,不是本文出租车实验的追加结果。
- Hui Xiong:通讯作者,论文署名罗格斯大学。罗格斯商学院教师页称他为杰出教授,研究方向为数据与知识工程。他同时是 Yao 2018 年博士论文的导师。本文致谢写明,研究部分受到科大讯飞和美国国家科学基金会项目 IIS-1648664 支持。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
评分用的用地向量没有时段,模型强调的却是早高峰和晚高峰不能混写。一个分区若白天像办公、晚上像娱乐,最终仍只有一条向量,也只对着一种全年不变的面积占比接受检查。把工作日 8–9 时和 17–18 时的共现拆成两套向量,再看同一分区是否跨簇,才能检验时间有没有留在表示里。CID 此时可能反而下降,因为参照标签本身不分早晚。那将说明当前分数奖励的是贴近静态用地,不一定奖励论文开头那个车站例子所强调的时间差别。
另一个可以计算、但论文没有报告的切分,是按到达总数 A 把 193 个分区分成出租车行程多和少的两组,分别重算 CID。A 已经在引力模型里定义,分母仍可取各组分区数。若优势主要留在上车点密集的一组,平均指标就更像高流量核心区的拟合;行程稀少的分区即使功能明确,也缺少进入 PPMI 的次数。这种分组不用新的个人记录,只把现有的分区到达总数当成分层变量。