只给卫星图和人口,能不能生成全球城市的通勤出发地—目的地流量?
论文名片|Can Rong、Xin Zhang、Yanxin Xi、Hongjie Sui、Jingtao Ding、Yong Li,Satellites Reveal Mobility: A Commuting Origin-destination Flow Generator for Global Cities,预印本,arXiv:2505.15870v1 [cs.CV],2025年5月21日。arXiv:2505.15870。这是一篇通勤起讫流量的生成方法论文,用已有的区域通勤表做对照。
安排跨区公交或就业用地时,需要一张表:住在甲区、到乙区上班的有多少人。许多城市没有入户通勤调查。较细的计算模型往往还要社会人口、经济和兴趣点,这些材料也不是全球都齐。只靠人口的引力模型、辐射模型更容易套用,对通勤流量的误差通常更大。
这篇预印本把输入换成两类更易获得的公开数据:卫星影像和人口。区域边界由使用者给定。模型要生成的是这些区域之间的通勤出发地—目的地流量,也就是每个起点区域到每个终点区域的上班人数。
实验分成三层。第一层留在美国,看公开输入能保住传统输入的多少流量重叠,人数误差同时如何变化。第二层用美国数据训练,再生成英国的流量,基线只拿到人口和区域间距离。第三层看北京、上海、伦敦、巴黎、里约和塞内加尔,参照数据的年份与采集方式各不相同。
方向已经清楚:在美国留出的县和都市区上,卫星影像加人口可以让数据驱动模型保住传统输入下的大部分通勤重叠,其中 WEDAN 的重叠比例最高,但均方根误差同时变大。转到英国以后,地方行政区上的平均重叠仍高于只使用人口和距离的基线,那次实验的划分和美国测试不同。六处案例的等级相关拉开明显距离,论文写明这些相关不能跨城市比较。生成结果是静态的区域通勤表。
先说结论
- 美国数据含 3,333 个城市单元(urban area):3,233 个县和 100 个都市区,按 8:1:1 划分成训练、验证和测试。通勤的起点和终点是单元内部的普查区或普查街区组。CPC 和 RMSE 先在每个留出的县或都市区上计算,再对这些测试单元取算术平均;加减号是 5 个随机种子的标准差。五个数据驱动模型里,公开输入的通勤公共部分(CPC)是同一模型传统输入 CPC 的 90.5% 到 98.3%。摘要中的超过 98%,对应的是 WEDAN 的 98.3%:公开输入 CPC 为 0.623,传统输入为 0.634。同一行的 RMSE 从 64.06 增到 67.88,表中差距为 −5.9%。
- 同一批美国测试单元上,公开输入 WEDAN 的 CPC 为 0.623,引力模型为 0.321,辐射模型为 0.347。这是和只依赖人口分布的物理模型比较。它和上一条“公开输入相对传统输入”的比值,分母不同。
- 英国实验用美国 90% 的县和都市区训练、其余 10% 调参,再对 326 个地方行政区取平均。GlODGen 的 CPC 为 0.485,RMSE 为 72.68。相对 CPC 最高的基线 GMEL(0.362),CPC 高 34.0%;相对 RMSE 最低的基线引力模型(101.6),RMSE 低 28.5%。表中的 IMP 列另以 NetGAN 为参照,GlODGen 的 CPC 为 +46.5%,RMSE 为 +63.5%。这些基线没有英国的社会经济或兴趣点数据。
- 北京、上海、伦敦、巴黎、里约、塞内加尔的斯皮尔曼等级相关 ρ 依次为 0.741、0.623、0.361、0.465、0.816、0.477。论文写明这些 ρ 不能跨城市直接比较。曲线经过归一化和平滑,纵轴不是人数。模型主要在美国数据上训练,输出的是静态通勤,不含分时交通。
这里的一格,是两个区域之间的上班人数
通勤起讫流量(commuting origin–destination flow)在本文里记为 F:住在起点区域、工作在终点区域的人数。它描述的是较稳定的日常居住地—工作地联系。分析单位有两层。城市区域(urban region)是流量的起点和终点,一张流量表由这些区域对构成。美国实验另有一层城市单元(urban area):一个县或一个都市区,里面包含许多城市区域,训练、测试和指标平均都发生在这一层。英国实验里与之对应的平均单位是地方行政区。
论文把城市写成一个完整的城市化地区,通勤只计边界以内。区域在不同数据里不一样:美国的县内部用人口普查区(census tract),美国都市区内部用普查街区组(census block group);英国每个地方行政区(Local Authority District,LAD)内部再用中层超级输出区(Middle layer Super Output Area,MSOA);北京和上海用街道,巴黎用市镇(commune),里约都市区用市镇(Município),塞内加尔用区(Arrondissement)。
因此,后文每个 CPC 或 RMSE 都先属于某一套区域划分,再在城市单元上汇总。换边界,格子就换了,数值对应的是另一套分区。
传统做法要么做入户出行调查,要么把大规模个人移动记录汇总成这种区域表。论文认为前者贵,后者受数据和隐私限制。物理模型只用人口分布,计算模型可以吃进更多城市属性,但社会人口、基础设施、土地利用和兴趣点在很多城市收集不到。本文要替换的是后面这一组难获取属性,生成的仍是区域人数表。
卫星图怎样变成可以进模型的区域特征?
GlODGen 把这件事分成三步:按区域边界整理卫星影像,抽出区域语义特征,再生成整张通勤流量表。图 1 是替换关系的示意图,图 2 是裁切后的区域影像,图 3 是三条流水线。
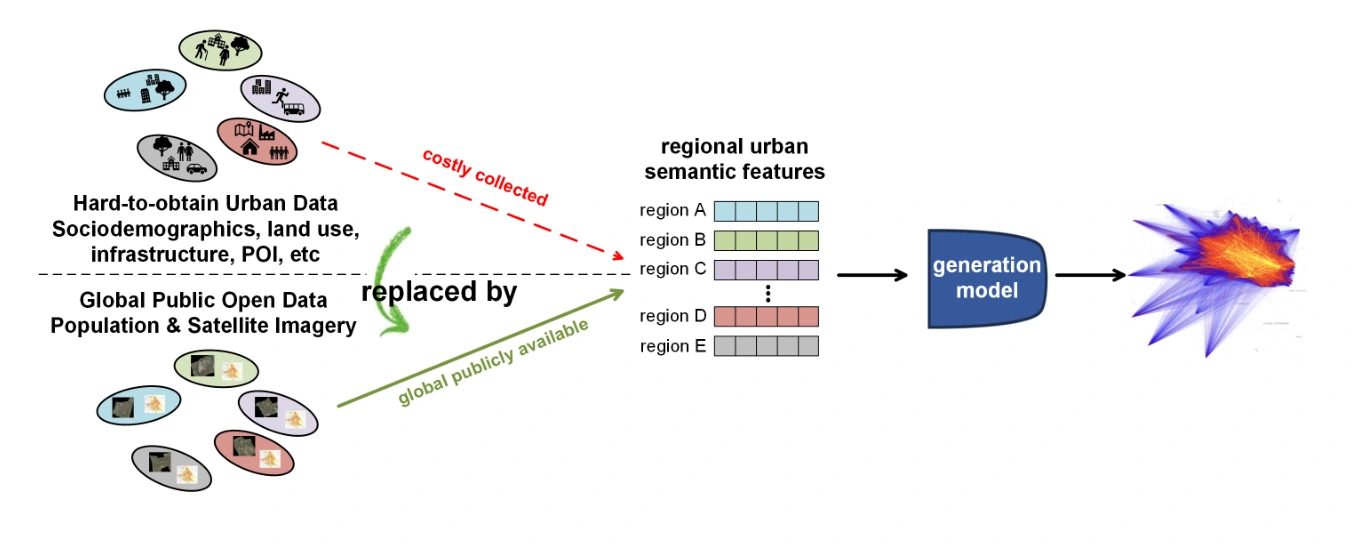
图 1|难收集的城市属性,在示意图里被哪一组公开数据替换?
无字母子图。左上是社会人口、土地利用、基础设施、兴趣点等难获取数据,红色虚线标为获取成本高;左下是人口与卫星影像,绿色箭头标为全球公开可得。中间是区域 A 到 E 的语义特征,进入生成模型后画出一张流量示意。这张图说明输入替换的设想,上面没有实测误差。来源:原论文 Fig. 1。
卫星影像按瓦片下载,论文举例的平台是 Google Earth 和 Esri World Imagery。每个区域先拼好覆盖自己的瓦片,再按边界裁切:边界内的像素保留,边界外乘零,避免把邻区算进来。图 2 的黑边就是这层遮罩。
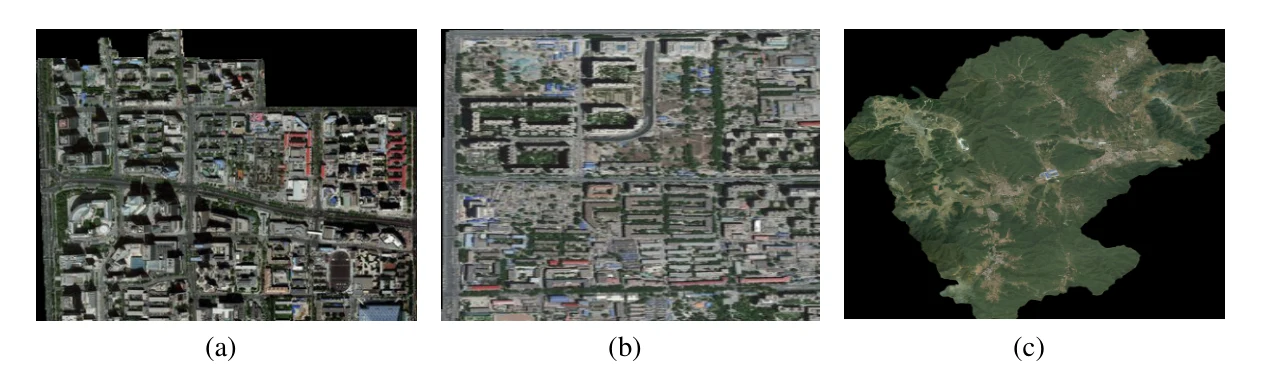
图 2|裁掉区域外像素之后,一张区域卫星图是什么样子?
(a)建筑较密、街块较小,左上和右下留有黑边。(b)街块更大、路网更正交,影像几乎铺满画幅。(c)绿地和山地占大部分,建成区分散,不规则边界外是黑色。三张都是俯视影像,论文没有标明所属城市。它们说明每个区域对应一张影像,不能从这三张例子读出流量精度。来源:原论文 Fig. 2。
原始像素太杂,论文不把它们直接送进流量模型,而是使用 RemoteCLIP 的视觉编码器。权重冻结,不在通勤任务上继续训练视觉编码器;作者引用的理由是,针对单一任务微调基础模型会损害预训练中的一般知识并造成过拟合。每个区域得到 1,024 维特征,再与该区域人口拼接。一个多层感知机在训练流量模型时一起学习,把这组拼接特征收成节点属性。
人口产品的具体名称,这一版正文没有写出。美国实验里的社会经济指标来自美国社区调查(American Community Survey,ACS);公开输入一侧写的是卫星影像加人口。人口字段是否与传统输入里的某个人口统计完全相同,正文没有逐项对照。
流量生成采用 WEDAN。城市被看成有向加权图:区域是节点,通勤人数是边的权重。训练时向观测流量逐步加入高斯噪声,图变换网络预测应当去掉的噪声;生成时从噪声出发,在全部区域特征的条件下恢复整张表。附录给出的损失是预测噪声与实际加入噪声的均方误差,优化器为 Adam。学习率和扩散步数,正文没有列出,只写明对可训练模型做了网格搜索。
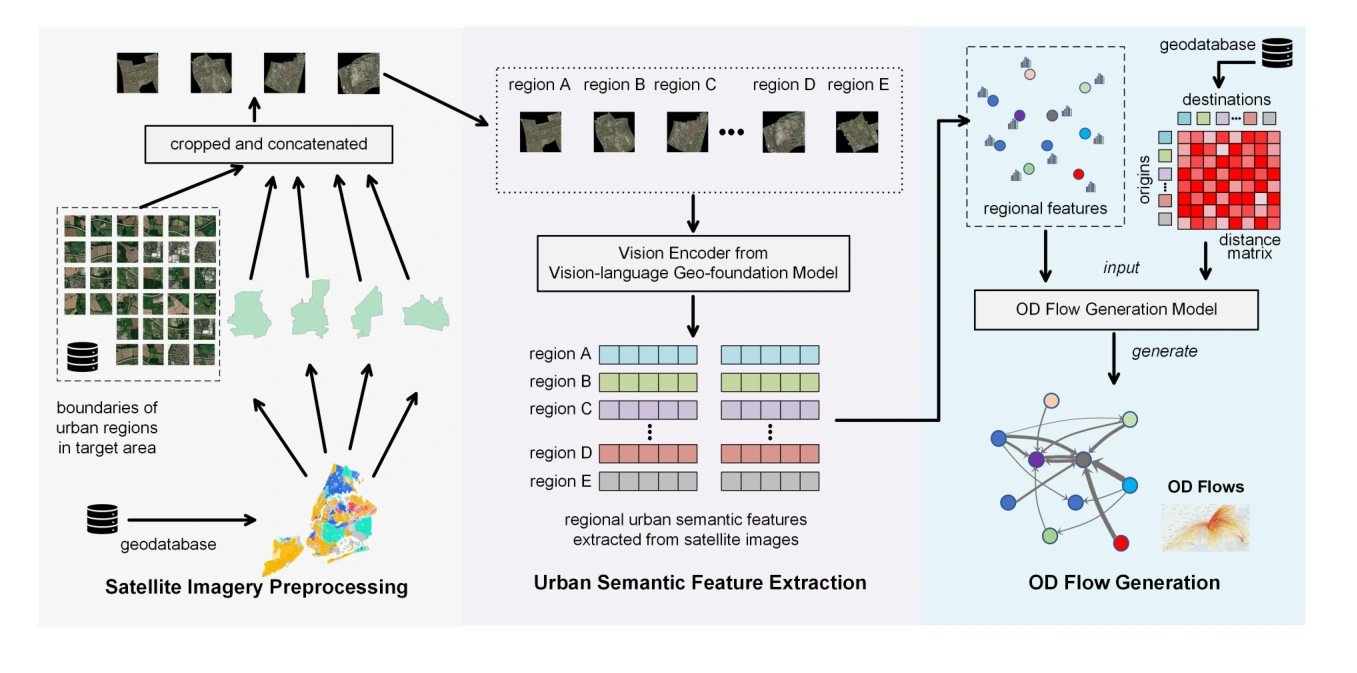
图 3|从区域边界到通勤流量表,中间经过哪三步?
无字母子图,从左到右三栏。(左)按目标区域边界拼接并裁切卫星瓦片,底图来自地理数据库。(中)视觉语言地理基础模型的视觉编码器抽出区域 A 到 E 的语义特征。(右)区域特征进入 OD 生成模型;图中同时画了起点—终点距离矩阵,输出有向加权网络和一张流量小图。正文公式把条件写成卫星特征与人口的拼接。距离矩阵画在流程图里,论文没有单独报告去掉距离后的性能变化。来源:原论文 Fig. 3。
在美国,公开数据留下了多少重叠?
第一组实验用美国数据回答:公开输入能不能代替难获取属性。数据来自 Rong 等人此前的通勤 OD 基准,共 3,333 个城市单元,其中 3,233 个县、100 个都市区。县内的城市区域是人口普查区,都市区内是普查街区组。通勤流量来自就业统计 LODES,本文使用 2018 年。传统输入在实验设置里写的是社会人口属性、经济指标和兴趣点分布;数据集说明中列出的 ACS 指标包括人口结构、教育、贫困、收入、车辆拥有和其他社会经济指标。摘要和示意图还提到土地利用与基础设施。表 1 没有把土地利用或基础设施单列成一行,比较时以实验段落写出的三类传统输入为准。
3,333 个县和都市区按 8:1:1 分成训练、验证、测试。正文没有给出三者的整数个数。所有模型共用这一划分。CPC 和 RMSE 先在一个测试单元内部的区域对上计算,再对全部测试单元取平均。一个小县和一个大都市区在总平均里各算一份,没有按人口或按 OD 对加权。实验重复 5 次,换随机种子,表中的加减号是这 5 次的标准差。论文没有报告公开输入与传统输入之间的显著性检验。
三个指标衡量的是不同问题。通勤公共部分 CPC 看两套流量有多少重叠:
CPC = 2 × Σ min(Fᵢⱼ, F̂ᵢⱼ) / (Σ Fᵢⱼ + Σ F̂ᵢⱼ)
分子是逐对取较小值之后的两倍,分母是参照流量总和加上生成流量总和。两套表完全一致时 CPC 为 1。它不直接回答某一格差了多少人。
均方根误差 RMSE 回答人数差。它对区域对上的流量差取平方、按 |F| 平均后再开方,|F| 是这个平均所用的流量条数。归一化 RMSE 再除以参照流量相对其均值 F̄ 的均方根,分母里的区域数写成 N,使用的是 N²。同一批参照数据上,这个分母不随模型改变,所以模型之间的 NRMSE 相对差距与 RMSE 相对差距一致。表 1 的 NRMSE 没有给出标准差。
| 模型 | 输入 | CPC | 占该模型传统输入 CPC | RMSE | RMSE 差距 | NRMSE |
|---|---|---|---|---|---|---|
| 引力模型 | 人口分布 | 0.321 ± 0.02 | — | 174.0 ± 10.4 | — | 2.222 |
| 辐射模型 | 人口分布 | 0.347 ± 0.04 | — | 196.9 ± 11.7 | — | 2.502 |
| 随机森林 | 传统 | 0.494 ± 0.02 | — | 100.4 ± 6.5 | — | 1.282 |
| 随机森林 | 公开 | 0.480 ± 0.03 | 97.1% | 114.0 ± 7.1 | −13.5% | 1.455 |
| DeepGravity | 传统 | 0.449 ± 0.01 | — | 92.9 ± 9.9 | — | 1.186 |
| DeepGravity | 公开 | 0.427 ± 0.05 | 95.1% | 99.9 ± 12.0 | −7.5% | 1.275 |
| GMEL | 传统 | 0.462 ± 0.01 | — | 94.3 ± 4.0 | — | 1.204 |
| GMEL | 公开 | 0.451 ± 0.02 | 97.6% | 105.4 ± 7.9 | −11.8% | 1.345 |
| NetGAN | 传统 | 0.517 ± 0.05 | — | 89.1 ± 17.0 | — | 1.138 |
| NetGAN | 公开 | 0.468 ± 0.06 | 90.5% | 98.0 ± 12.3 | −10.0% | 1.251 |
| WEDAN | 传统 | 0.634 ± 0.01 | — | 64.06 ± 3.3 | — | 0.818 |
| WEDAN | 公开 | 0.623 ± 0.02 | 98.3% | 67.88 ± 6.1 | −5.9% | 0.867 |
表 1 的“占传统输入 CPC”就是公开输入 CPC 除以同一模型的传统输入 CPC。RMSE 差距是(传统 RMSE − 公开 RMSE)除以传统 RMSE,负号表示公开输入的人数误差更大。五个数据驱动模型的方向一致:CPC 比值都低于 100%,RMSE 都上升。比值最低的是 NetGAN 的 90.5%,最高的是 WEDAN 的 98.3%。结论里的“公开数据达到传统数据约 98% 的表现”,说的是 WEDAN 这一格,而且是 CPC 之比。0.623 与 0.634 很接近,论文没有检验这个差值;±0.02 和 ±0.01 是 5 次种子的标准差。
人数误差的变化幅度和 CPC 比值并不成比例。随机森林的 CPC 仍有传统输入的 97.1%,RMSE 却从 100.4 增到 114.0,相对增大 13.5%。WEDAN 的 RMSE 相对增大 5.9%,是五者之中最小的一档。NetGAN 传统输入的 RMSE 标准差达到 ±17.0,比 WEDAN 的 ±3.3 宽得多,它的 90.5% 坐在一个更不稳定的对照上。
和物理模型比,要用另一列。公开输入 WEDAN 的 CPC 为 0.623,引力模型为 0.321,辐射模型为 0.347;RMSE 分别为 67.88、174.0 和 196.9。4.1 节把这两个物理模型写成只依赖人口分布的下限参照。公开数据上的计算模型高于这个下限,同时仍低于各自的传统输入。
还有一处任务设置需要分开。原始 DeepGravity 在已知起点流出总量时,用目的地概率去分配这些流出。附录写明,因为全球城市没有现成的流出总量,本文改为直接生成 OD 流量。表 1 里的 DeepGravity 与原始论文那种“已知总流出再分配”的设置不同。NetGAN 原用于无权网络,这里改成用城市的 OD 矩阵作为加权邻接矩阵。
转到英国以后,和谁比才算赢?
第二组实验把美国训好的 GlODGen 用到英国。训练用美国 90% 的县和都市区,其余 10% 用来调参,不再另留一块美国测试集。英国参照来自国家统计局 ONS,论文所引指南是英格兰和威尔士 2021 年人口普查的起讫数据说明。数据包含 326 个地方行政区,区内部按 MSOA 划分。指标是这 326 个行政区的算术平均。表 2 印有加减号,但 4.2 节没有再次说明它是 5 次种子还是行政区之间的离散;5 次种子只在 4.1 节对表 1 写明。
基线只获得人口和区域间距离。论文把这一点写成跨大陆实验里难以避免的限制:训练城市和测试城市对得齐的细粒度城市属性通常没有。所以表 2 的优势,是“卫星影像加人口”相对“人口加距离”,还看不到一组使用英国当地社会经济或兴趣点的计算模型。
| 模型 | CPC | 相对 NetGAN 的 CPC | RMSE | 相对 NetGAN 的 RMSE | NRMSE | 相对 NetGAN 的 NRMSE |
|---|---|---|---|---|---|---|
| 引力模型 | 0.240 ± 0.01 | −27.5% | 101.6 ± 3.42 | +48.9% | 1.752 ± 0.06 | +48.9% |
| 辐射模型 | 0.323 ± 0.07 | −2.4% | 211.6 ± 4.27 | −6.4% | 3.647 ± 0.07 | −6.4% |
| 随机森林 | 0.334 ± 0.03 | +0.9% | 223.2 ± 3.42 | −12.2% | 3.847 ± 0.06 | −12.2% |
| DeepGravity | 0.359 ± 0.04 | +8.5% | 157.0 ± 7.90 | +21.1% | 2.706 ± 0.13 | +21.1% |
| GMEL | 0.362 ± 0.01 | +9.4% | 149.1 ± 10.00 | +25.0% | 2.570 ± 0.17 | +25.1% |
| NetGAN | 0.331 ± 0.06 | — | 198.9 ± 15.21 | — | 3.429 ± 0.26 | — |
| GlODGen | 0.485 ± 0.03 | +46.5% | 72.68 ± 2.13 | +63.5% | 1.253 ± 0.04 | +63.5% |
IMP 的正号表示比 NetGAN 更好:CPC 更高,或 RMSE、NRMSE 更低。GlODGen 相对 NetGAN,CPC 从 0.331 到 0.485,增幅(0.485 − 0.331)/ 0.331 = 46.5%;RMSE 从 198.9 到 72.68,降幅为 63.5%。
正文另写的 34.0% 和 28.5%,分母是该项指标上最强的基线,不是 NetGAN。CPC 最高的基线是 GMEL 的 0.362,(0.485 − 0.362)/ 0.362 = 34.0%。RMSE 最低的基线是引力模型的 101.6,(101.6 − 72.68)/ 101.6 = 28.5%。NRMSE 从 1.752 到 1.253,相对降幅同样是 28.5%,因为归一化分母由参照流量决定,不随模型改变。
这两套“最强基线”还不是同一个模型。引力模型的 CPC 只有 0.240,是表中最低;它的 RMSE 却是基线里最低的。GMEL 的 CPC 最高,RMSE 为 149.1,仍明显高于引力模型。只看一个指标,会选出不同的对照。GlODGen 在 CPC 和 RMSE 上都好于表内每一个基线,这个判断成立;34.0% 与 28.5% 必须连着各自的分母一起读。
英国 326 个地方行政区的平均 CPC 是 0.485,美国测试单元上公开输入 WEDAN 的平均 CPC 是 0.623。两次实验的国家、划分和内部区域单位不同。0.485 是英国实验自己的结果,0.623 是美国实验自己的结果。
六处案例的排序,能横着比吗?
案例研究把生成流量和当地已有的移动数据放在一起。论文明确写,这些参照的采样、时间和空间粒度都不同,还带有噪声或偏差,只能当作近似参照,不适合用统一的误差指标横比。他们计算的是斯皮尔曼等级相关,并把结果画成按参照流量排序后的归一化曲线。
参照流量先按从小到大排序,生成流量放到同一顺序上,所以红线可以起伏。两条曲线再归一化到同一范围,并做了平滑。纵轴因此不是通勤人数,色带是曲线下方的填充,论文没有把它定义成置信区间。ρ 是等级相关;图上的平滑只为观看。各城市进入相关计算的 OD 对数量,正文没有给出。
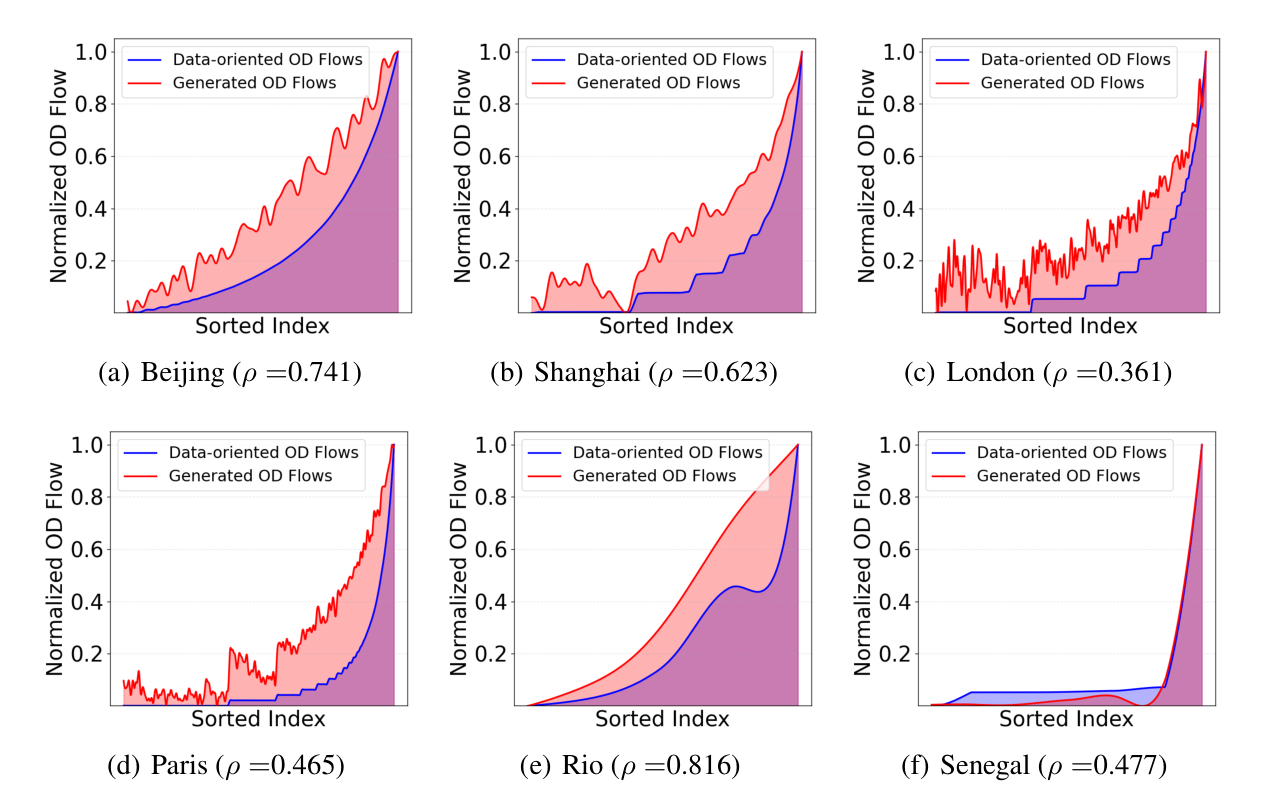
图 4|生成流量与参照流量在同一排序上有多接近?
横轴 Sorted Index 是按参照流量从小到大排列后的序号,纵轴 Normalized OD Flow 是归一化流量。蓝线为参照,红线为生成。
(a)北京,ρ = 0.741。两条线一起上升,红线多数位置高于蓝线,末端靠近。(b)上海,ρ = 0.623。蓝线在后段才明显抬升,红线前段已有起伏。(c)伦敦,ρ = 0.361,六处之中最低。红线在低流量段波动大,蓝线长时间更低,末端陡升。(d)巴黎,ρ = 0.465。两条线都在很长一段保持较低,末端陡升,红线中段有尖峰。(e)里约,ρ = 0.816,六处之中最高。两条线都较平滑地上升,红线位于蓝线上方。(f)塞内加尔,ρ = 0.477。两条线在大部分序号上都很低,接近末端才陡升,红线略早抬起。
论文写,参照分布更偏斜,两条曲线仍以相近的方式对齐。偏斜可以在蓝线的“前段低、末端陡”里看到。ρ 不能跨城市比较:数据质量和来源不同。来源:原论文 Fig. 4。
六处参照分别是:
- 北京,2016 年,来自一家未点名的互联网位置服务,区域为街道。
- 上海,2016 年,来自电信话单,区域为街道,汇总方法引自 Iqbal 等。
- 伦敦,来自 ONS。案例图讨论的是大伦敦,和表 2 那种对 326 个行政区取平均不是同一个数。
- 巴黎,区域为市镇。参照是 Hörl 与 Balac 基于 2015 年法国国家统计与经济研究所(INSEE)人口普查做出的合成出行需求。这里比的是生成表与一套合成需求,其中合成需求被当作参照。
- 里约热内卢都市区,2014 年话单,区域为市镇。数据计入同一人的重复记录,论文因此写明存在偏差。全体流量若只是同比放大,等级相关可以不变;论文没有证明里约的偏差只属于这种同比放大。
- 塞内加尔,2013 年 D4D 挑战的话单,按 Iqbal 等的方法汇总到区。论文写,非洲这一数据稀疏,空间粒度不能再细化。
上海的 ρ = 0.623 与美国公开输入 WEDAN 的 CPC = 0.623 数字相同,一个是等级相关,一个是流量重叠,不能互相代替。
地图上的放射中心,和排序是同一件事吗?
附录用地图看空间形态。图上没有数值色标。讨论伦敦时,作者把蓝色写成城市边界一带的流量,把红色和黄色写成市中心的密集联系。其他城市沿用同一冷暖画法,颜色不能换算成人数。左右对照是生成结果与参照,相似的放射结构回答的是大格局,图 4 的 ρ 回答的是 OD 对之间的相对大小。
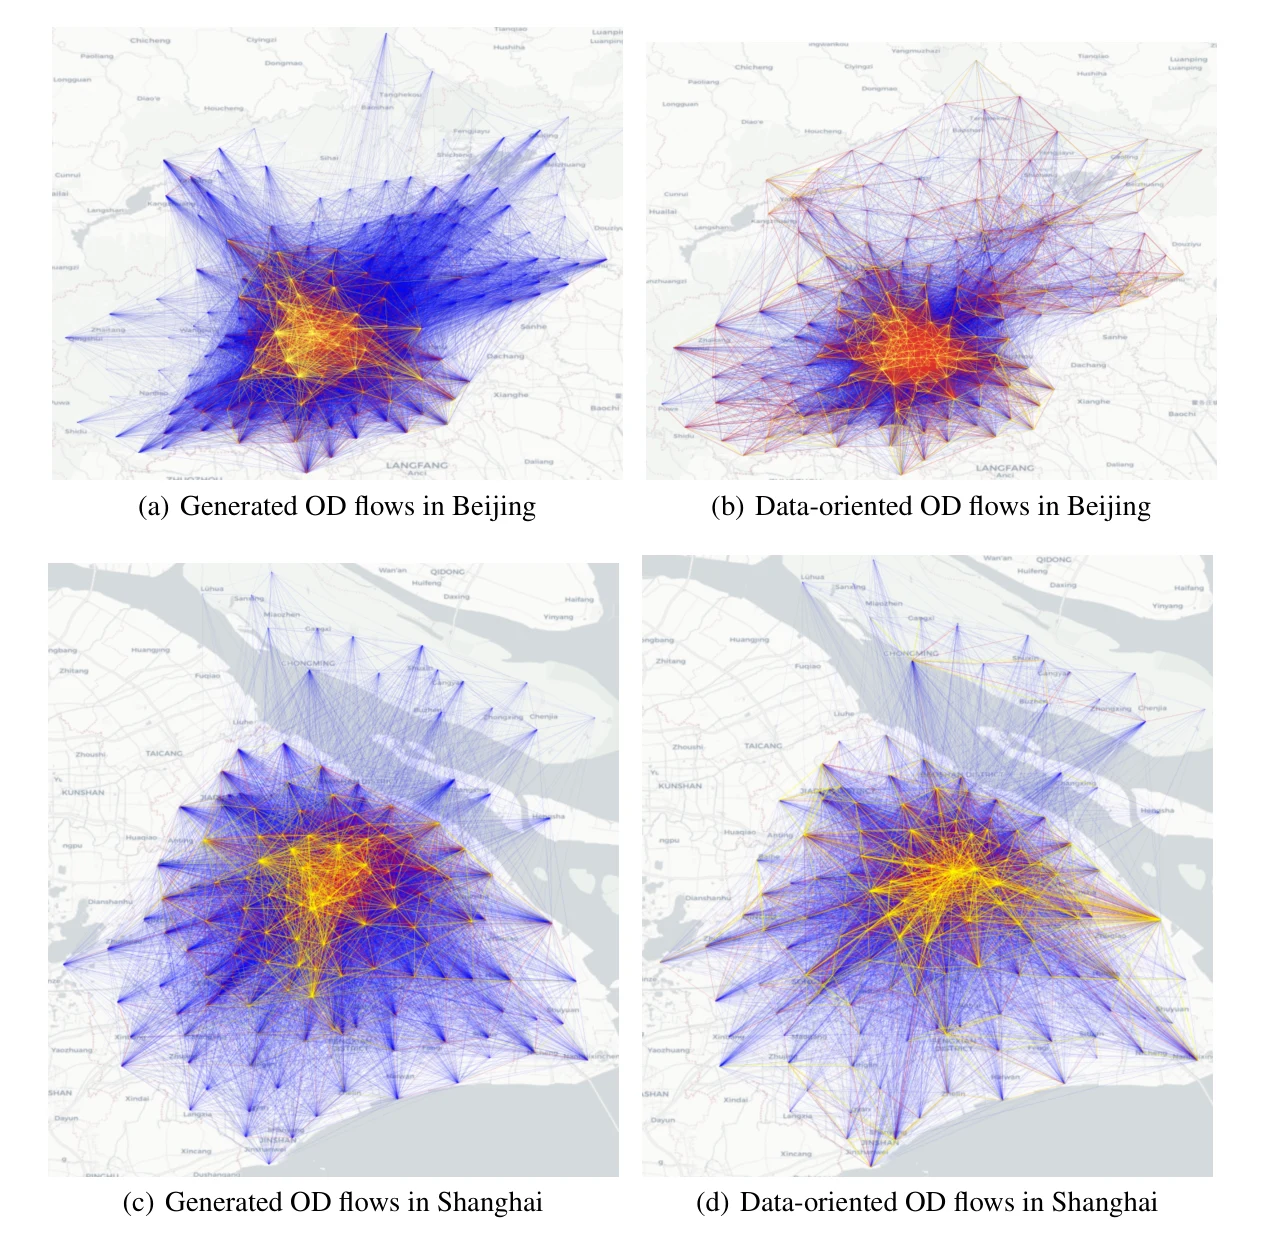
图 5|北京和上海的生成流量,在空间上哪里和参照对齐?
(a)北京生成结果,暖色集中在中部,外围以蓝色长线为主。(b)北京参照,核心的暖色更满,暖色联系伸得更开。作者写,北京郊区到市中心的流量在生成结果中偏少;图上没有标出少了多少人。(c)上海生成结果,核心为暖色,外围蓝色连接很密。(d)上海参照,同样呈放射状。作者写,上海外围的生成流量比观测更密。两城都是 2016 年的街道尺度参照。来源:原论文 Fig. 5。
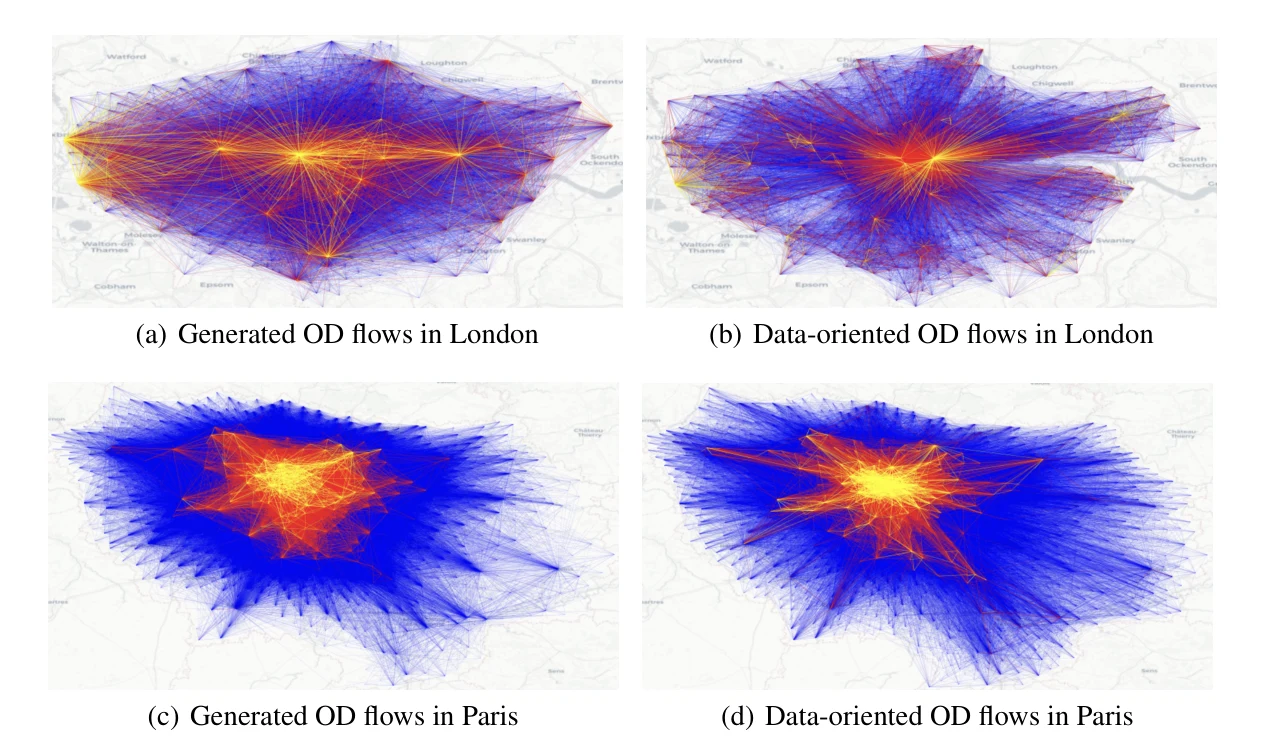
图 6|伦敦和巴黎都有暖色核心,这是否等于排序也接近?
(a)伦敦生成结果,中部暖色强,并有伸向边缘的长线;西侧还有一处较亮的汇合。(b)伦敦参照,暖色更集中在中部,边缘仍有长线。作者认为生成结果保住了中心与外围之间的长距离联系。(c)巴黎生成结果,暖色核心清楚,外围多为蓝色。(d)巴黎参照,核心更亮,长距离流量较少。作者把这一点读成巴黎较集中的城市结构。伦敦在图 4 的 ρ 只有 0.361,所以地图上的共同核心不能代替等级相关。巴黎参照是合成需求。来源:原论文 Fig. 6。
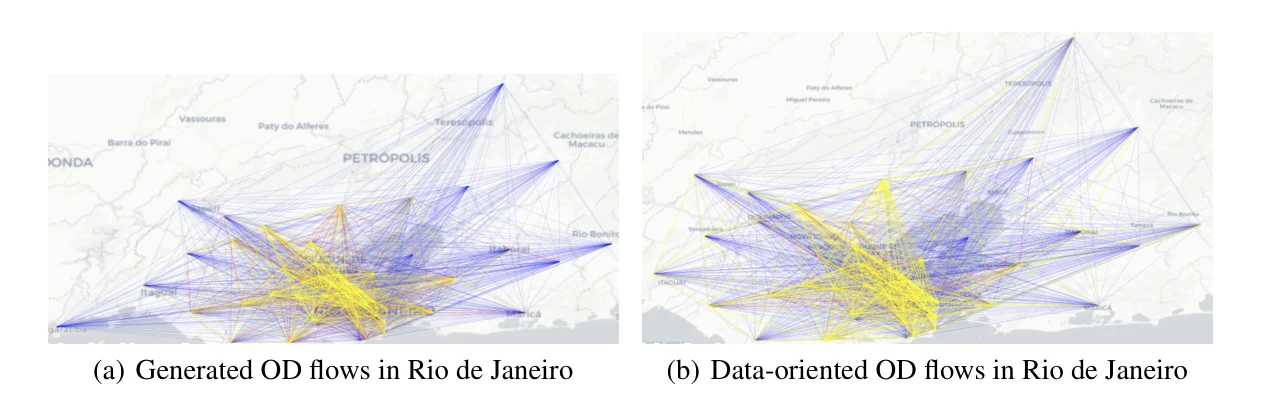
图 7|里约都市区的生成与参照是否聚在同一侧?
(a)生成结果,黄色联系集中在沿海都市一侧,更长的蓝线伸向内地。(b)参照呈现相近的聚集。作者称二者空间分布一致,并推测里约与美国的城市结构和移动格局相近,因此美国的公开数据和流量可能支持巴西的生成。后半句是作者解释,这两张图没有检验两国是否同一机制。参照是 2014 年话单,含重复记录。图 4 中里约的 ρ 为 0.816,是六处最高。来源:原论文 Fig. 7。
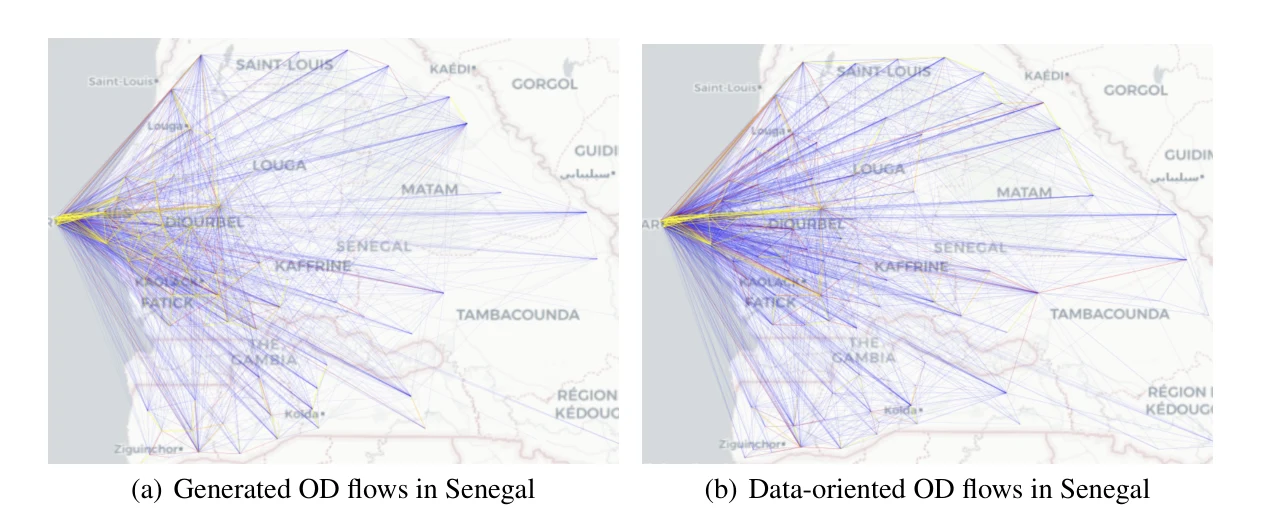
图 8|塞内加尔的区级流量是否从同一侧散开?
(a)生成结果,线条从国土西端向外散开,近处偏黄,远处偏蓝。(b)参照同样从西端散开,部分远距离连线的位置和颜色不同。作者认为生成结果辨认出中心和城市范围。区域是区,2013 年话单较稀疏,论文写明不能再细化。图 4 中的 ρ 为 0.477。来源:原论文 Fig. 8。
作者在附录说明,北京、上海、里约和塞内加尔的部分可视化也出现在另一篇当时仍在审的数据论文里,两篇用途不同。那篇数据论文不在本预印本内,这里只采用本篇已经画出的图和已经写出的比较。
这些结果能用到哪一步?
公开输入在美国测试单元上最有利的证据,是 WEDAN 的 CPC 从 0.634 到 0.623,同时 RMSE 从 64.06 增到 67.88。这句话的分母是同一模型、同一 8:1:1 划分、对留出的县和都市区取平均。表 1 里达到 98.3% 的是这一格 CPC 比值。NetGAN 的 CPC 比值是 90.5%,五个模型的 RMSE 都变大。
英国的 34.0% 建立在“基线只有人口和距离”之上。它支持卫星影像加人口优于这组弱输入,还没有回答公开数据能否替代英国当地的社会经济数据。
六处 ρ 里,里约 0.816 和伦敦 0.361 可以同时为真。等级相关、地图形态、CPC、RMSE 各看流量表的一个方面。参照本身还混有普查起讫、合成需求和话单汇总,年份从塞内加尔的 2013 年到美国实验的 2018 年,英国所引指南对应 2021 年普查。卫星影像的拍摄日期,正文没有写。影像年份和流量年份是否对齐,这版实验没有报告。
论文自己列出两条限制。生成模型主要在美国数据上训练,更多地区的覆盖会提高稳健性。生成的只有静态通勤,不能直接用于随时间变化的交通分析。论文还写明,研究中使用的个体位置数据已做匿名化,计算在本地进行。本文讨论的输出是区域之间的人数。
工具侧,论文给出的使用条件是:提供城市区域边界,即可串联数据获取、裁切、语义特征提取和流量生成。代码位置写在摘要中:tsinghua-fib-lab/generate-od-pubtools。流量表的每一格都落在这些已经划好的区域之间。
一句话总结
卫星影像和人口可以生成全球多个城市的区域通勤表,并在美国测试里保住传统输入下的大部分流量重叠;这张表仍是主要凭美国数据学来的静态生成结果,重叠比例、人数误差和跨城排序各自还要单独核对。
核心来源
- arXiv:2505.15870v1,2025年5月21日预印本。正文图 1–4、表 1–2,以及附录中的图 5–8、指标公式和模型说明都在这一版。
- 美国通勤参照为 2018 年 LODES,社会经济指标来自 ACS;英国参照引自 ONS 的 2021 年普查起讫数据说明,论文写明覆盖 326 个地方行政区。
- 案例参照:北京与上海为 2016 年,巴黎为基于 2015 年 INSEE 普查的合成需求,里约为 2014 年话单,塞内加尔为 2013 年 D4D 话单。论文列出的实现入口为 generate-od-pubtools。
作者介绍
六位作者的单位以论文首页为准。下面只补充同一 PDF 参考文献里能够对上姓名的相关工作,不写论文没有列出的职务。
- Can Rong:署名第一,单位为清华大学电子工程系、BNRist。参考文献中,他与 Jingtao Ding、Yong Li 共同署名通勤 OD 综述;WEDAN 一文的作者是 Can Rong、Jingtao Ding、Yan Liu、Yong Li。
- Xin Zhang:单位同为清华大学电子工程系、BNRist。参考文献列入 Xin Zhang 与 Yong Li 等的 UV-SAM,主题是卫星影像与城中村识别;同一名单中还有他参与的 CityBench。
- Yanxin Xi:单位为赫尔辛基大学计算机科学系。参考文献中有多篇与 Yong Li 等合作的卫星影像城市表征论文。
- Hongjie Sui:单位为清华大学电子工程系、BNRist。这一版的参考文献没有再单列他的其他论文。
- Jingtao Ding:单位同为清华大学电子工程系、BNRist。与 Can Rong、Yong Li 一起出现在上述 OD 生成参考文献中,也出现在利用 OD 估算道路交通碳排放的参考文献中。
- Yong Li:单位同为清华大学电子工程系、BNRist,位于作者列表最后。OD 生成和卫星影像这两组参考文献里都有他。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把生成表用于安排进城方向的公交,北京这一个案值得先拆开看。作者已经写明,郊区到市中心的流量在生成结果里偏少,图 5 的参照也比生成结果有更满的暖色核心。CPC 把所有 OD 对的重叠收成一个数,郊区长线即使系统性偏小,也可能被核心大流量的重合抵消。把同一张美国测试表按距离段或按郊区—中心重新计算 CPC 和 RMSE,才能知道误差落在哪些联系上。论文没有做这张误差地图。
另一个延伸是把指标和参照类型一起交给使用者。WEDAN 在美国测试里保住了传统输入 CPC 的 98.3%,RMSE 仍上升 5.9%。关心大走廊是否被点中的人,和关心人数差会不会改变运力的人,会从这两列走出不同的决定。英国的 34.0% 还建立在基线没有当地丰富属性的前提下。若要回答“只有卫星图和人口够不够”,需要再训一组使用英国当地属性、仍在同样 326 个行政区上测试的模型,并同时报告 CPC、RMSE,以及参照来自普查、合成需求还是话单。