一个商场,能不能只用一个向量来代表?
论文名片|Dakshak Keerthi Chandra、Jennifer Leopold、Yanjie Fu,NodeSense2Vec: Spatiotemporal Context-Aware Network Embedding for Heterogeneous Urban Mobility Data,2021 IEEE International Conference on Big Data (Big Data),2021,pp. 2884–2893。DOI:10.1109/BigData52589.2021.9672072。方法论文。密苏里科技大学的会议记录将该次会议标为 2021 年 12 月 15–18 日的线上会议。
共享单车在一座商场门口停下。这个落点在网络里可以是“购物”,也可以是“周末晚上的娱乐”,还可以是“签到很多的热门点”。若只保留一条无类型的边,这三种关系会叠成同一个邻居。地点向量若只有一个义项,工作日和周末、专卖店和综合商场就挤在同一个坐标里。
这篇论文把城市出行收成一张时空异构网络(Spatiotemporal Heterogeneous Network,SHN):节点是地点,边按日期、类别、签到频率等关系分开,再为同一节点保留多种语境,最后学成低维向量。向量用于兴趣点排序和类别预测。它在标注较多时优于文中的三种网络嵌入基线,在标注很少时并不占优;排序图能看出潜变量特征高于显式特征的方向,正文没有印出具体分数。
先说结论
- 三套记录被收进同一张地点网:摩拜 3,214,096 条行程、349,693 个用户;大众点评 328,668 个兴趣点、20 个类别;微博与街旁 2,020,967 条签到、212,362 个用户。节点按论文写法是访问次数大于 300 的行程起终点,共 1,765,025 个。这个节点数无法用行程总数复核。
- 边带有类型。同一天、兴趣点类别、签到频率可以串成不同路径,一个地点因此可以出现在多种语境里。
- 本文模型的向量维度是 300。把它当作排序模型的潜变量特征时,作者认为六个排序模型的 NDCG 和 F1 都高于直接使用显式特征。图 6 和图 7 没有标柱高,正文也没有分数表。
- 用向量预测兴趣点类别时,标注节点比例从 30% 到 90%,本文模型的 Macro-F1 和 Micro-F1 都是四者中最高。90% 标注下 Macro-F1 为 50.16,同格最高基线 DeepWalk 为 45.08,相差 5.08 个百分点。10% 和 20% 标注下,node2vec 的两项 F1 都更高。
- 聚类图是 k=5 的目视结果,没有聚类分数。兴趣点有 20 个类别,五种颜色对应的是聚类分组。
行程、店铺和签到,先要合成哪一张网?
人类移动性(human mobility)在这里指人在城市地点之间的到访和转移,分析单位是地点及其关系,不是一条可追踪到个人身份的全日轨迹。论文要保留的是两类信息:地理结构谁更重要,以及人在这些结构之间怎样依次转移。
数据来自表 II。摩拜行程出自 2017 年摩拜大数据挑战赛,时间为 2017 年 5 月 10 日至 5 月 24 日,共 15 个日历日,字段包括用户号、订单号、起止时间和起止位置、车辆号。兴趣点来自大众点评,论文写明是北京,328,668 个兴趣点分成医院、商场、餐馆、剧院等 20 类。微博与街旁合计 2,020,967 条北京兴趣点签到,212,362 个用户,字段包括名称、时间、地址和经纬度。正文一处把街旁写成 Jeipang,表 II 写作 Jiepang。摩拜段落没有单独写出城市名;三套数据随后被放进同一张 SHN。
| 数据 | 论文给出的规模 | 论文写明的范围 |
|---|---|---|
| 摩拜行程 | 3,214,096 条行程;349,693 个用户 | 2017-05-10 至 2017-05-24;未单列城市 |
| 大众点评兴趣点 | 328,668 个;20 个类别 | 北京 |
| 微博与街旁签到 | 2,020,967 条签到;212,362 个用户 | 北京兴趣点 |
3,214,096÷349,693≈9.19,是行程总数除以用户总数;2,020,967÷212,362≈9.52,是签到总数除以签到用户总数。两者都是两列合计之比,论文没有报告人均中位数,也不能当成每个人的典型出行次数。
建网时,论文把访问次数大于 300 的行程起终点初始化为节点,得到 1,765,025 个节点,再用点评兴趣点和签到补充地点之间的空间与时间关系。关系包括按日访问、按小时访问、地理距离、用户到访次数、高活动时段、低活动时段,以及 20 类兴趣点及其层级。若把“1,765,025 个地点、每个地点访问都大于 300”按字面理解,访问次数的下限会远高于 3,214,096 条行程。论文没有给出地点访问分布,这个节点数的分母因此无法从行程总数复核。它也大于 328,668 个点评兴趣点,所以网络节点并不等于点评兴趣点清单。
连接地点的,为什么不是一种边?
兴趣点(Point of Interest,POI)在定义里是用户签到的地理位置,写成兴趣点编号、经度和纬度。一次签到是某用户在某地点、某时刻的活动记录。SHN 写成有向图 G=(V, E, φ, ψ):φ 把节点映射到对象类型,ψ 把边映射到关系类型。目标是再学一个映射,把每个节点送到 d 维向量,并让地理结构的重要性和地点之间的转移顺序都留在这个向量里。
图 1 是示意图,用来说明一张区域网络里可以同时存在哪些关系。它画出 POI 1 到 POI 9,边上的盒子包括 CheckIn、visits、time、Entertainment、Transportation、shopping、Restaurant、Industry。箭头只标着 relation,没有权重,也没有北京地图。
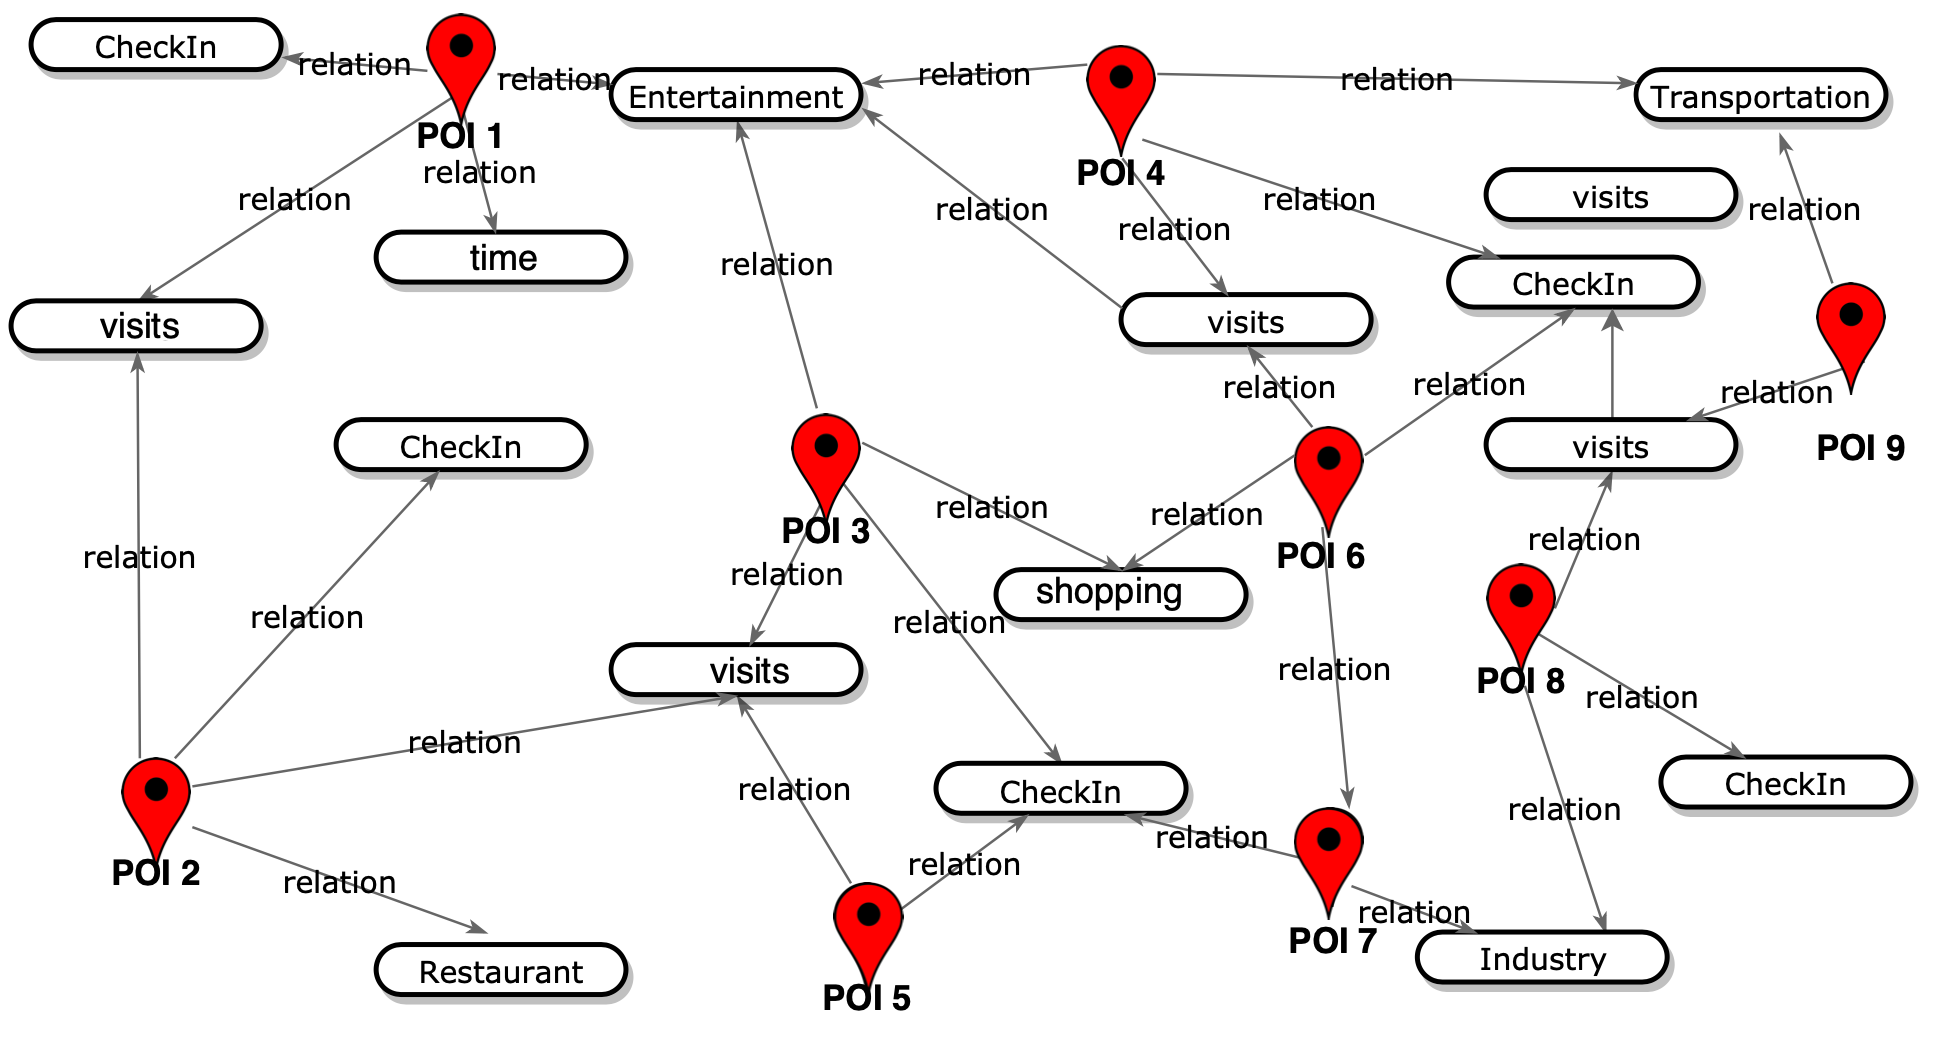
图 1|一张城市地点网里,关系为什么要分成很多种?
无字母子图。红针为兴趣点,圆角框为签到、到访、时间和店铺类别。它展示的是关系类型可以并存,不能从中读出北京任一地点的真实流量。来源:原论文 Fig. 1。
真实数据常常只有下车坐标,没有写明起点或终点店铺。论文用距离把下车点连到候选兴趣点。设 x 为下车点到候选兴趣点的距离,访问概率写成
Δ(x) = (β₁ / β₂) · x · exp(1 − x / β₂)。
β₁ 是这个函数下的最大概率,β₂ 是相对该最大值的最优步行距离,二者都是控制曲线形状的超参数。按印刷公式计算,极大值出现在 x=β₂,此时 Δ(β₂)=β₁;x=0 时函数值为 0。曲线在下车坐标本身取 0,在距离 β₂ 处达到 β₁,然后再下降。论文没有给出 β₁、β₂ 的数值,也没有给出实测步行距离分布,所以这条形状来自函数设定。
节点权重再由密度和多样性相乘得到。密度 δ(pᵢ) 被定义成用户访问该兴趣点的总次数,式 (2) 写成若干 Δₓ 之和,并说明 Δₓ 是访问次数。这里的 Δₓ 与上面的距离函数 Δ(x) 不是同一个量,论文也没有用数值例子把概率逐项加总成访问次数。多样性写成
γ(pᵢ) = 1 − Σᵢ Pᵢ(Pᵢ − 1) / [P_c(P_c − 1)]。
Pᵢ 是某一兴趣点类别里的兴趣点个数,P_c 是类别总数。节点权重 W=δ(pᵢ)·γ(pᵢ)。论文没有报告任何一个节点的密度、多样性或权重。按印刷定义,分母是类别数自己的 P_c(P_c−1),分子是各类别兴趣点数的 Pᵢ(Pᵢ−1) 之和。类别内部店铺很多、类别数只有 20 时,这个比值可以远大于 1。论文没有讨论权重的取值范围。
元路径(meta-path)是一串带关系类型的节点序列,用来区分“为什么相连”。表 I 给出四条例子:POI1 与 POI2 在同一天被访问;POI3 与 POI4 同属娱乐类别且同一天被访问;POI4 与 POI8 的签到频率相近且同一天被访问;POI5 经 POI7 连到 POI8,前一段签到频率相近,后一段同属工业类别。短路径被论文视为更有信息,因为长路径会连到语境更远的节点;可能的路径数又随长度指数增长,所以长度被一个阈值 l 截断。实验部分没有给出 l 的数值。
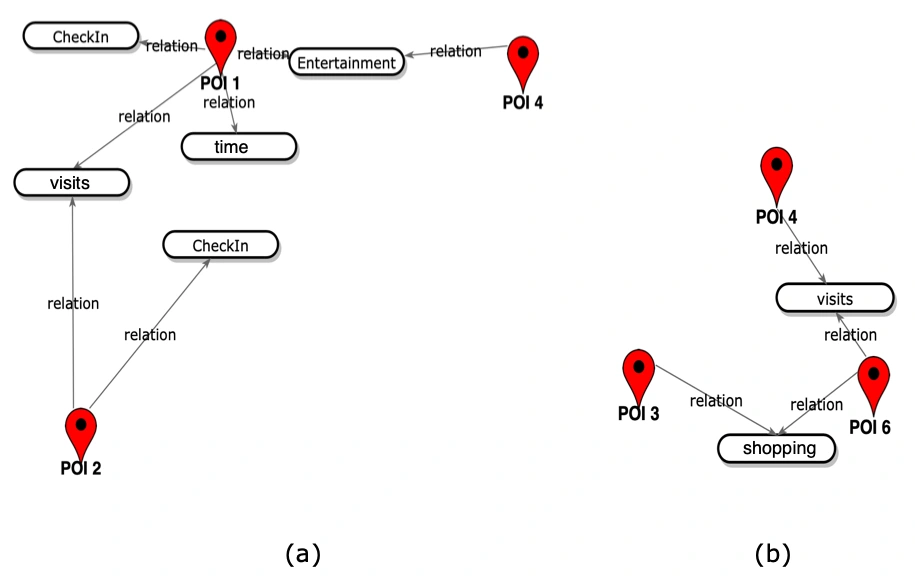
图 2|同一张网里,两条路径各保留了什么关系?
(a)论文将此面板读成 POI2 经“同一天”连到 POI1,再经签到频率连到 POI4。图上可见 POI1、POI2、POI4,以及 CheckIn、visits、time、Entertainment;箭头文字仍是 relation,没有印出 d 或 c。(b)论文将此面板读成 POI3 与 POI6 同属购物,POI6 再经访问日连到 POI4。图上可见 POI3、POI4、POI6、shopping 和 visits。两幅都是示意图,不是实测路径计数。来源:原论文 Fig. 2。
多个语境怎样进入同一个向量?
一个商场可以同时包含餐馆、影院和商店,所以同一个节点会落在多条元路径里。论文把这种多语境叫做对比节点义项(contrastive node sense):同一地点因所处关系不同而具有多个义项,类似一个词在不同句子里有不同意思。义项用谱聚类来分组,使指向同一语境的元路径实例进入同一簇,簇的中心被当作一种义项。
归一化拉普拉斯矩阵来自度矩阵和邻接矩阵。论文取第二小特征值对应的 Fiedler 向量,沿这个向量做切分,并用导通率 φ(S) 挑选切分,直到导通率达到阈值 t。t 的数值没有给出。谱聚类对给定的图总会给出一个划分,论文也写明,结构并不存在时算法仍会切开。因此分出若干义项,只说明算法按相似路径做了分组。
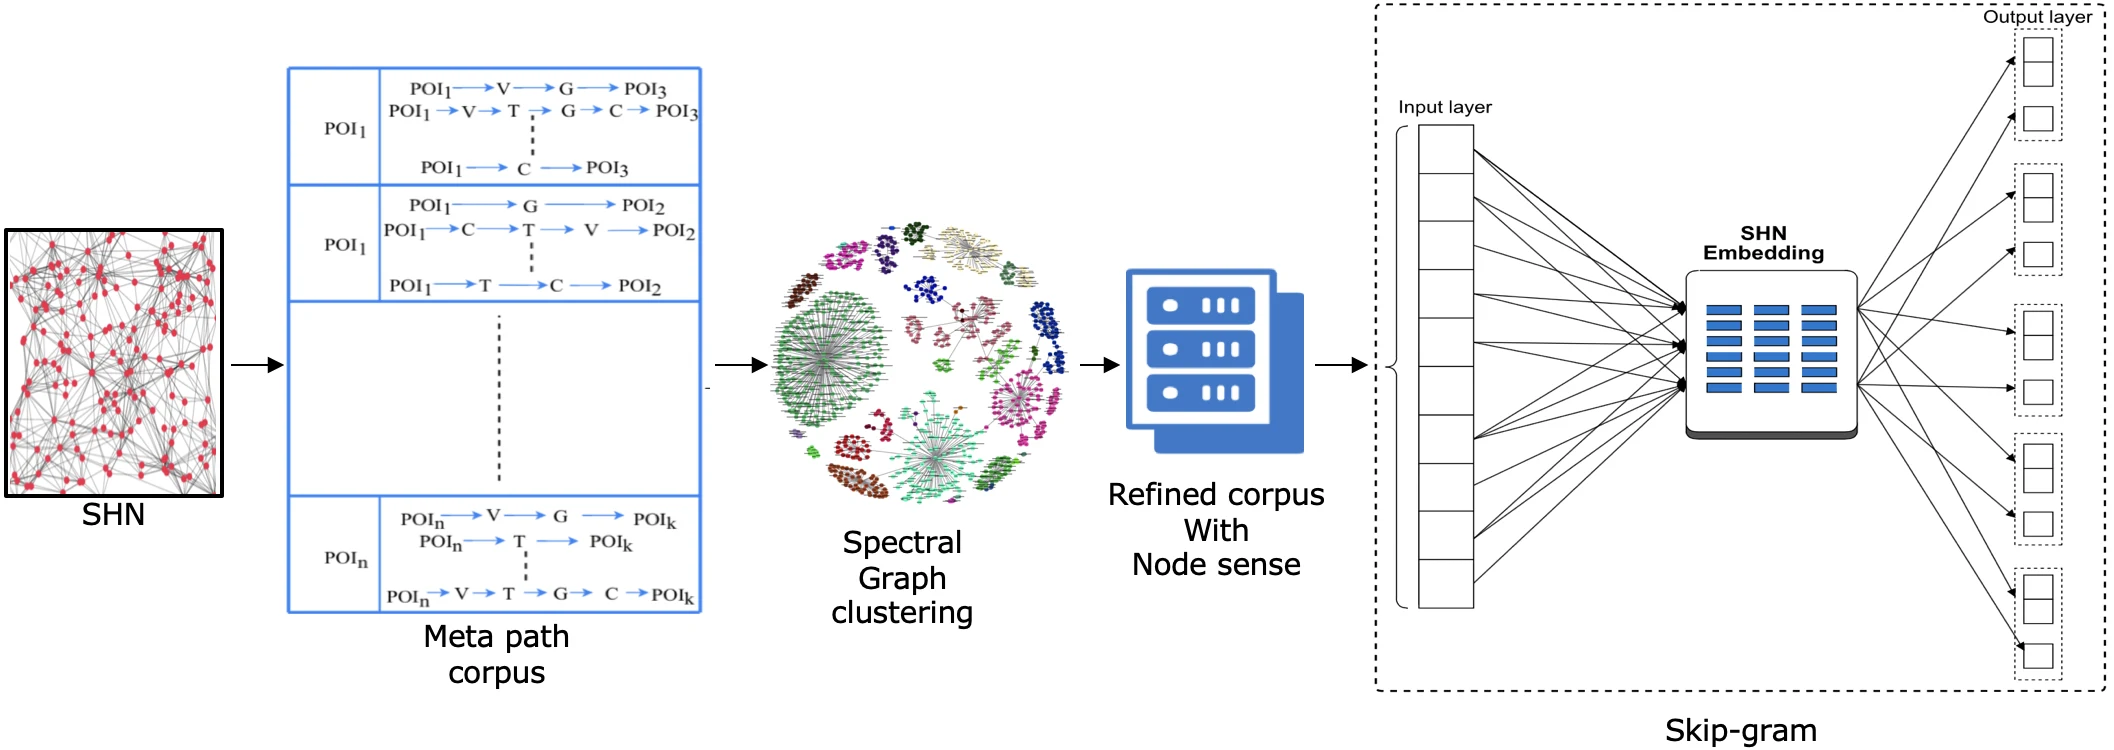
图 3|从地点网到向量,中间经过哪些表示?
无字母子图,从左到右五段。(1)SHN 是一张红点网络小图。(2)元路径语料把地点写成与字母 V、T、G、C 交替的序列;图内没有定义这四个字母。(3)谱聚类把路径分成彩色团簇。(4)带节点义项的精炼语料用服务器图标表示。(5)Skip-gram 从输入层连到标为 SHN Embedding 的中间表示,再连到输出层。这是流程示意图,不是某次实验的损失曲线。来源:原论文 Fig. 3。
游走用来生成这些路径。实验里,本文模型 ns2vec 的窗口为 10,游走长度为 20,每个节点 10 次游走,每个输入样本 5 个负样本,向量维度 d=300。DeepWalk 和 node2vec 也使用每个节点 10 次游走、游走长度 20、窗口 10。LINE 使用 5 个负样本、order=3。基线由 OpenNE 实现。论文只报告了 ns2vec 的维度,没有报告三种基线的向量维度,因此“维度相同”不是已经核对过的实验条件。元路径长度上限 l 和路径约束 C 也没有数值。
Skip-gram 沿窗口学习共现:目标地点与窗口内地点的向量内积被提高,随机抽到的负样本地点被压低。负采样用来避免对全部地点做一次归一化求和。论文用它的理由是,兴趣点签到次数看起来像词频,少数地点很高,多数地点很低。这个类比解释了为什么借用词向量模型,并不证明地点共现与词语共现服从同一机制。
签到很少的店占多数,这能说明什么?
图 4 是三套数据初步分析时给出的双对数散点。横轴是 Check-ins,从 10⁰ 到 10⁴;纵轴是 POIs,刻度从约 10⁰ 降到 10⁻⁷。点云整体向右下倾斜,右端有一条接近水平的稀点。纵轴数值小于 1,而兴趣点总数是 328,668,所以纵轴不是兴趣点的原始个数。论文没有说明它是比例、密度还是归一化频率,也没有报告拟合出的幂律指数。
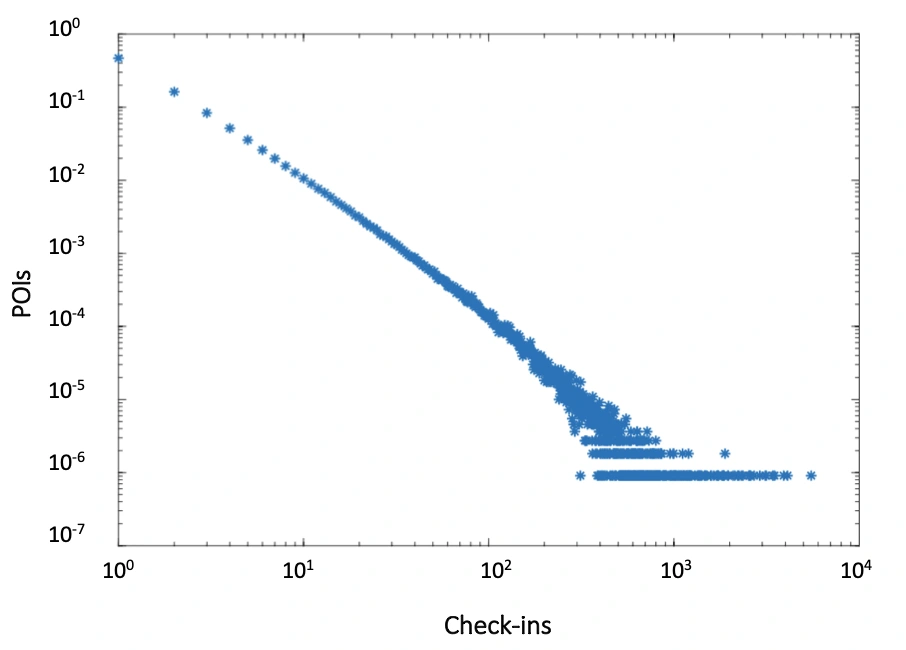
图 4|签到次数增加时,对应的兴趣点刻度如何变化?
无字母子图。横轴签到次数,纵轴标为 POIs,两轴都是对数。能读出的是下降的点云和一条高签到稀薄尾部;正文据此说少数热门兴趣点签到高,多数兴趣点接近或低于均值。图上没有均值线,也没有给出均值的分母。来源:原论文 Fig. 4。
正文图号从 Fig. 4 直接到 Fig. 6,这篇 PDF 里没有 Fig. 5。
拿向量去排序,对照的是什么?
排序实验比较的是同一批学习排序模型里的两类输入。显式特征是建网时直接抽出的关系;潜变量特征是 ns2vec 学到的向量。排序模型有 RankNet、RankBoost、ListNet、LambdaMART、AdaRank 和随机森林,用 RankLib 实现。数据的 75% 用于训练,25% 用于测试。论文只报告这一次划分,没有交叉验证,也没有多次划分的方差。
一个兴趣点的排序相关度 Q(u) 由论文定义,不是用户事后点击的观测。有时间窗内签到时,它加上节点权重、距离项和签到次数;没有签到时,只留下节点权重和距离项。距离项是 ‖λ − d‖ 的倒数:d 是当前位置到候选兴趣点的距离,λ 是当前位置到周围兴趣点距离的稳健平均。论文没有给出 λ、时间窗长度,也没有给出有多少用户落在“没有近期签到”这一支。因此 NDCG 衡量的是模型排序与这个自定义相关度有多接近。
评价指标是 NDCG 和 F1,位置 N 取 5、10、15、20。NDCG 是折损累计增益除以理想排序的折损累计增益,越大表示前 N 个更贴近理想相关度。F1 同时计入精确率和召回率。图 6 和图 7 的每个面板都有 12 根柱:6 个模型各一对,分别对应潜变量特征 LF 和显式特征 EF。纵轴从 0 到 0.9。柱上没有数字,也没有误差线。
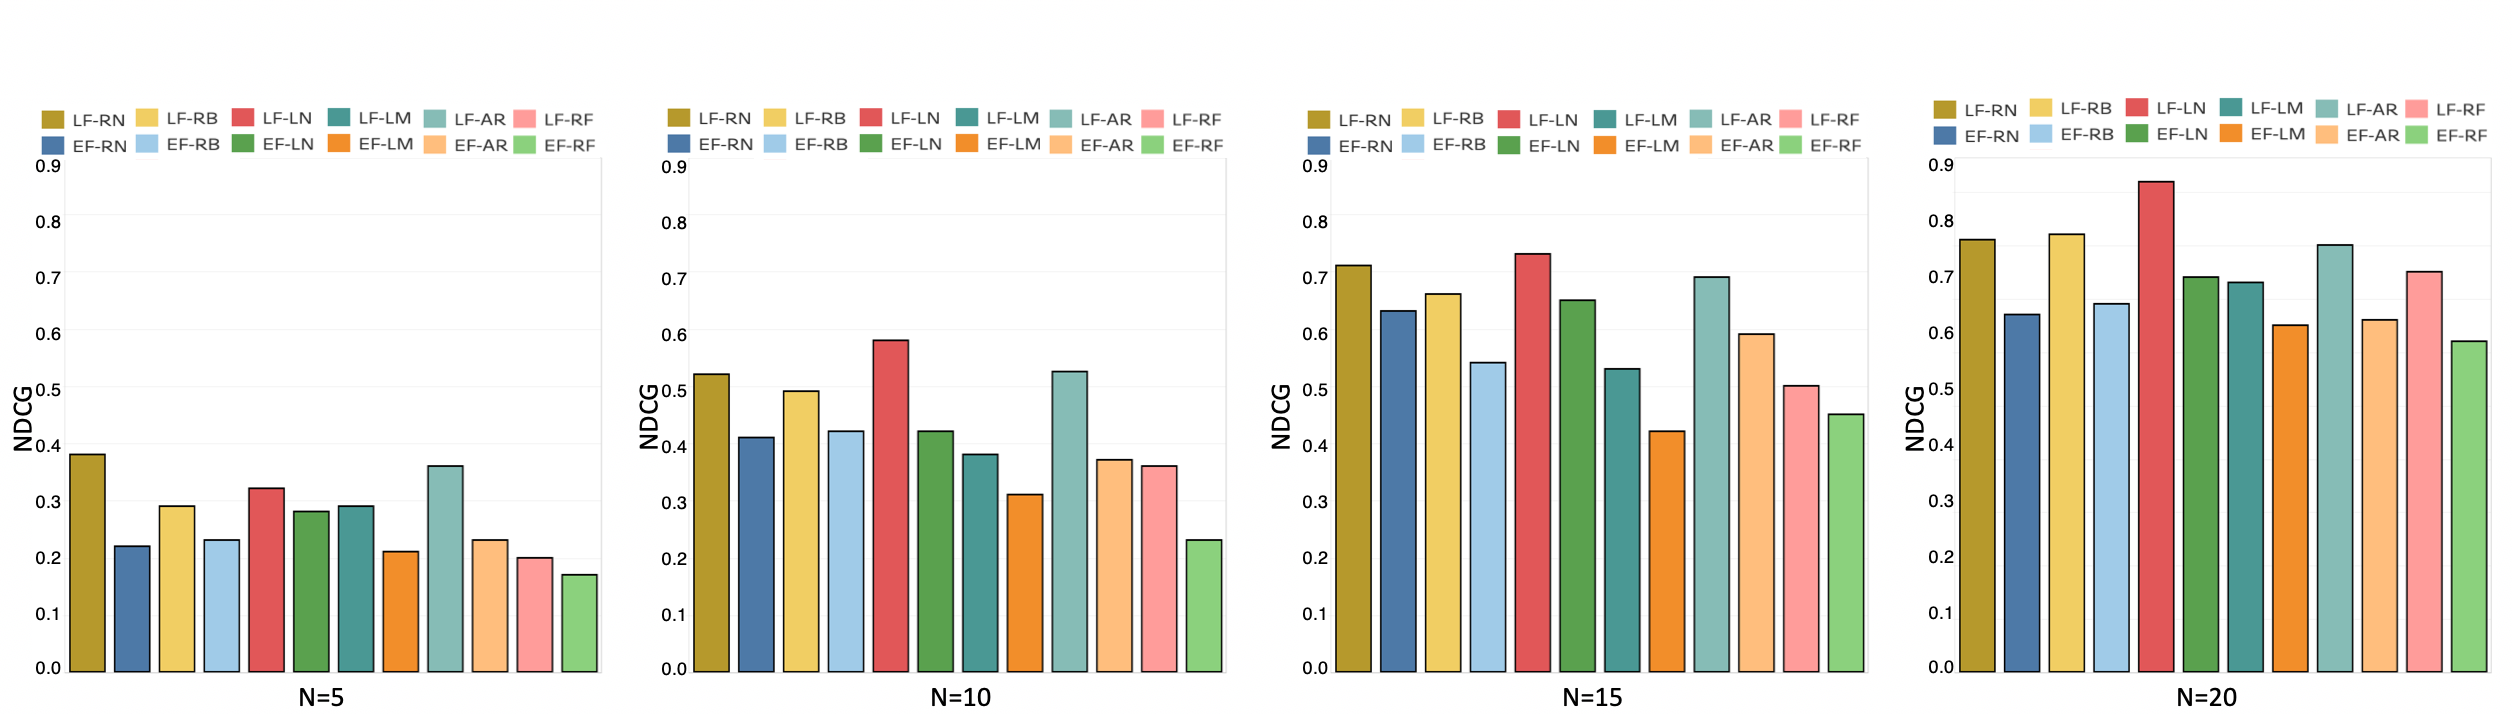
图 6|潜变量特征是否提高了前 N 个兴趣点的排序?
四个面板从左到右为 N=5、10、15、20,无 a–d 字母。图例区分 LF 与 EF 的 RankNet、RankBoost、ListNet、LambdaMART、AdaRank 和随机森林。纵轴为 NDCG。目视上,同一模型的 LF 柱多高于对应 EF 柱,N 增大时整组柱上移。正文用 significant improvements 称呼这一提升。PDF 没有 p 值、置信区间或重复实验方差,这个说法没有对应的检验统计量。来源:原论文 Fig. 6。
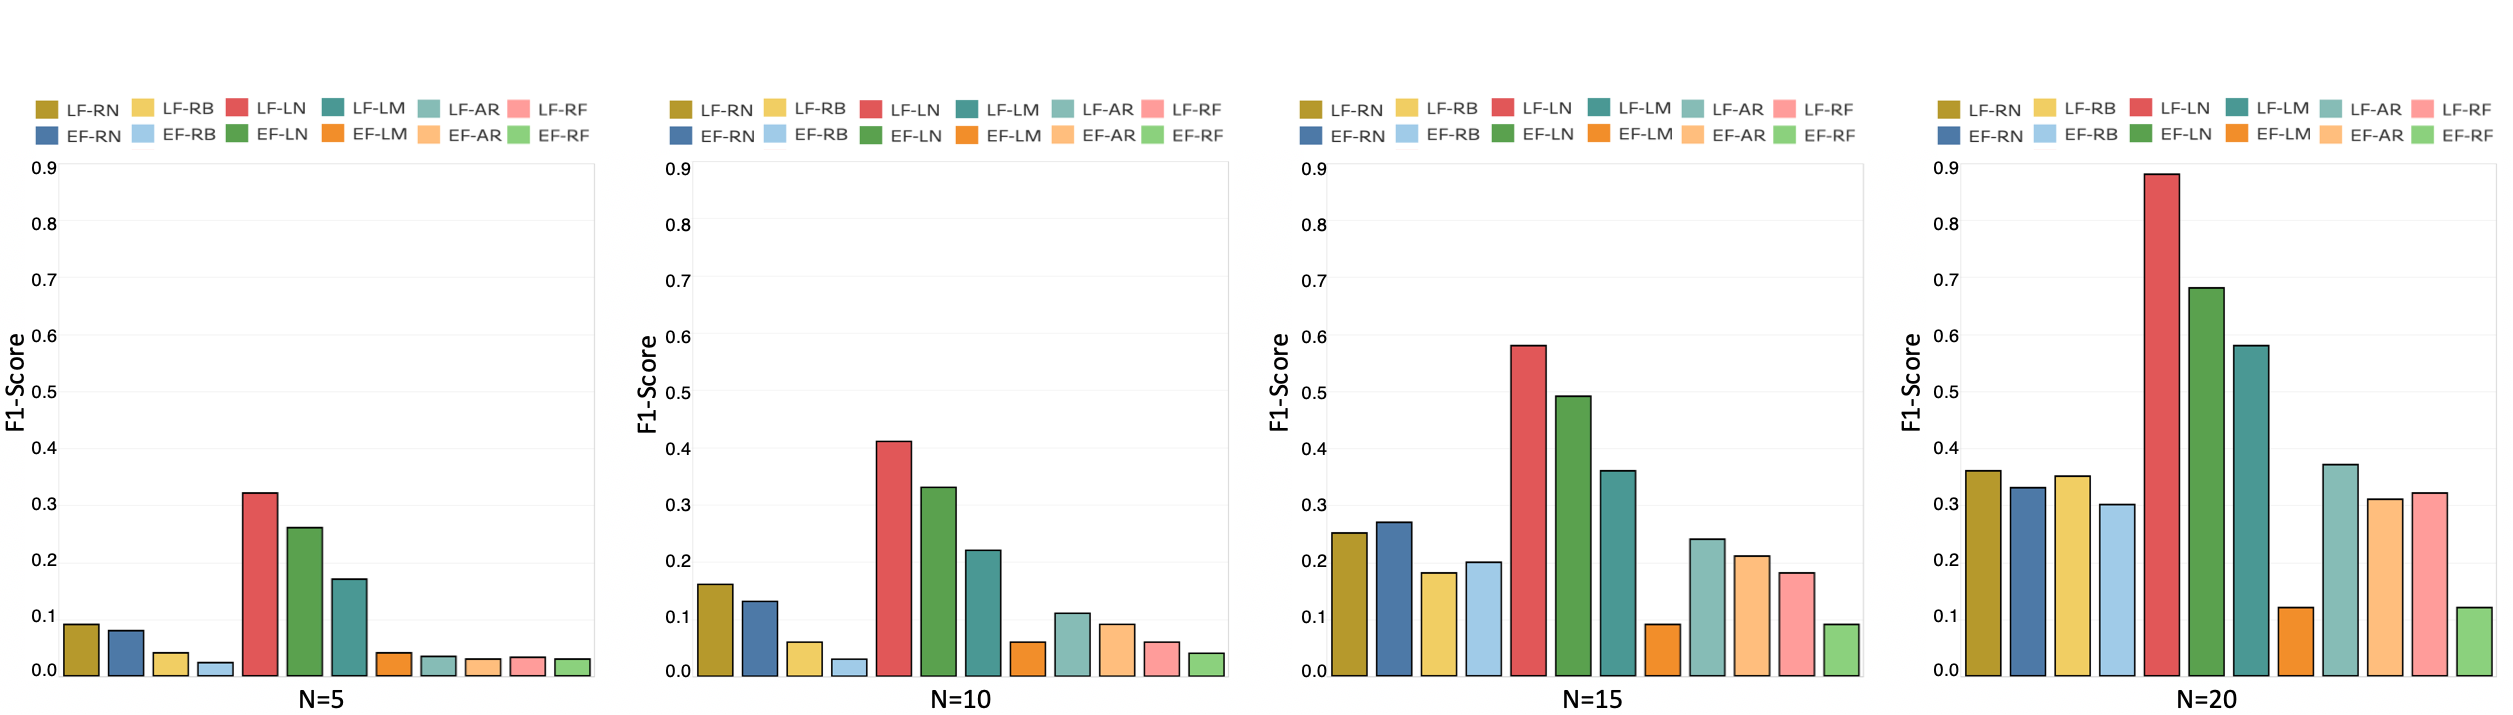
图 7|前 N 个推荐的 F1 随候选变长如何变化?
四个面板同样为 N=5、10、15、20。纵轴为 F1-Score,图例与图 6 相同。N=5 时多数柱很矮;N 增大后,ListNet 的潜变量柱成为目视最高的一簇,多根显式特征柱仍更矮。精确柱高没有印出。F1 与 NDCG 的分母不同,一根更高的 F1 柱不能换算成 NDCG 提高了多少。来源:原论文 Fig. 7。
这组图支持的结论停在特征比较:在这六个排序器和这一次 75/25 划分上,潜变量特征的柱高于显式特征。它没有比较六个排序器谁应被部署,也没有用未来日期的真实到访做检验。15 天数据若被随机切开,测试地点的邻居可能已经进入训练向量。
类别预测在标注变多时还稳吗?
第二项任务把学到的向量当作节点特征,把兴趣点类别当作标签,用逻辑回归做多标签分类。类别大小不均,所以同时报告 Macro-F1 和 Micro-F1。Macro-F1 更接近各类别 F1 的平均,小类别占的分量更大;Micro-F1 按实例汇总,常见类别占的分量更大。表题写着 Accuracy (%),行名却是这两项 F1。百分比是有标签节点的比例,从 10% 到 90%。论文没有写明分母是 1,765,025 个行程端点还是 328,668 个点评兴趣点,也没有写明其余节点是否就是测试集,以及划分是随机的还是按时间的。
| 指标 | 模型 | 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% |
|---|---|---|---|---|---|---|---|---|---|---|
| Macro-F1% | DeepWalk | 37.51 | 33.24 | 39.53 | 40.39 | 41.63 | 42.17 | 42.82 | 44.12 | 45.08 |
| Macro-F1% | LINE | 26.75 | 27.14 | 28.82 | 29.04 | 30.61 | 31.49 | 32.23 | 33.98 | 35.67 |
| Macro-F1% | node2vec | 38.15 | 40.42 | 34.07 | 35.61 | 36.19 | 37.82 | 39.56 | 41.33 | 42.71 |
| Macro-F1% | ns2vec | 36.35 | 39.81 | 43.91 | 45.72 | 46.38 | 47.34 | 49.05 | 49.62 | 50.16 |
| Micro-F1% | DeepWalk | 63.14 | 67.01 | 65.52 | 69.25 | 70.42 | 72.03 | 73.31 | 74.85 | 75.47 |
| Micro-F1% | LINE | 61.56 | 61.98 | 62.74 | 63.62 | 64.07 | 65.37 | 66.42 | 67.16 | 68.82 |
| Micro-F1% | node2vec | 67.22 | 65.09 | 68.63 | 66.51 | 67.78 | 68.04 | 68.85 | 69.16 | 69.94 |
| Micro-F1% | ns2vec | 65.73 | 64.87 | 70.81 | 71.43 | 73.18 | 74.62 | 75.84 | 76.36 | 77.31 |
表中数字来自表 III,单位是百分比,分母随格子变化:每一格是该模型在该标注比例下的 Macro-F1 或 Micro-F1。LINE 在全部 18 个格子里都是四者中最低。ns2vec 从 30% 到 90% 的 14 个格子里都是最高。
90% 标注时,ns2vec 的 Macro-F1 为 50.16,DeepWalk 为 45.08,相差 5.08 个百分点;5.08÷45.08≈11.3%,这是相对 DeepWalk 同一格的比例。同格 Micro-F1 为 77.31 对 75.47,相差 1.84 个百分点,1.84÷75.47≈2.4%。同一模型、同一标注比例下,Macro-F1 仍比 Micro-F1 低二十多个百分点,与“类别大小不均”相一致;论文没有给出每一类的兴趣点个数或每一类的 F1,所以看不出是哪些类别拉低了宏平均。
10% 标注时,node2vec 的 Macro-F1 为 38.15,ns2vec 为 36.35,低 1.80 个百分点;Micro-F1 为 67.22 对 65.73,低 1.49 个百分点。20% 标注时,node2vec 的 Macro-F1 为 40.42,ns2vec 为 39.81;Micro-F1 上 node2vec 为 65.09,ns2vec 为 64.87,而这一格最高的是 DeepWalk 的 67.01。论文说 node2vec 在标注很少的两种情形下略好于 ns2vec。表上还能看到曲线并不单调:DeepWalk 的 Macro-F1 从 10% 的 37.51 降到 20% 的 33.24,node2vec 的 Macro-F1 从 20% 的 40.42 降到 30% 的 34.07。论文没有解释这些下降。
从 30% 到 90%,ns2vec 的 Macro-F1 由 43.91 增到 50.16,只增加 6.25 个百分点,而标注比例增加了 60 个百分点。DeepWalk 同期由 39.53 增到 45.08,增加 5.55 个百分点。多给标签会提高分数,提高的幅度有限;90% 标注下最好的类别宏平均仍约为 0.50。
游走次数、游走长度和窗口与 DeepWalk、node2vec 相同,所以这张表比的不是“走得更久”。论文没有单独拿掉元路径约束或节点义项再训练,5.08 个百分点因此不能拆成某一步的贡献。基线维度未报告,也留下一种可能:一部分差异来自向量长度,而不只来自语境建模。
五个颜色团,是功能被分开了吗?
聚类用余弦距离的 k-means,k 设为 5,再把高维向量用 t-SNE 压到二维作图。论文期望功能语义相近的兴趣点在向量空间里更近,并认为本文模型的团块和边界更清楚。
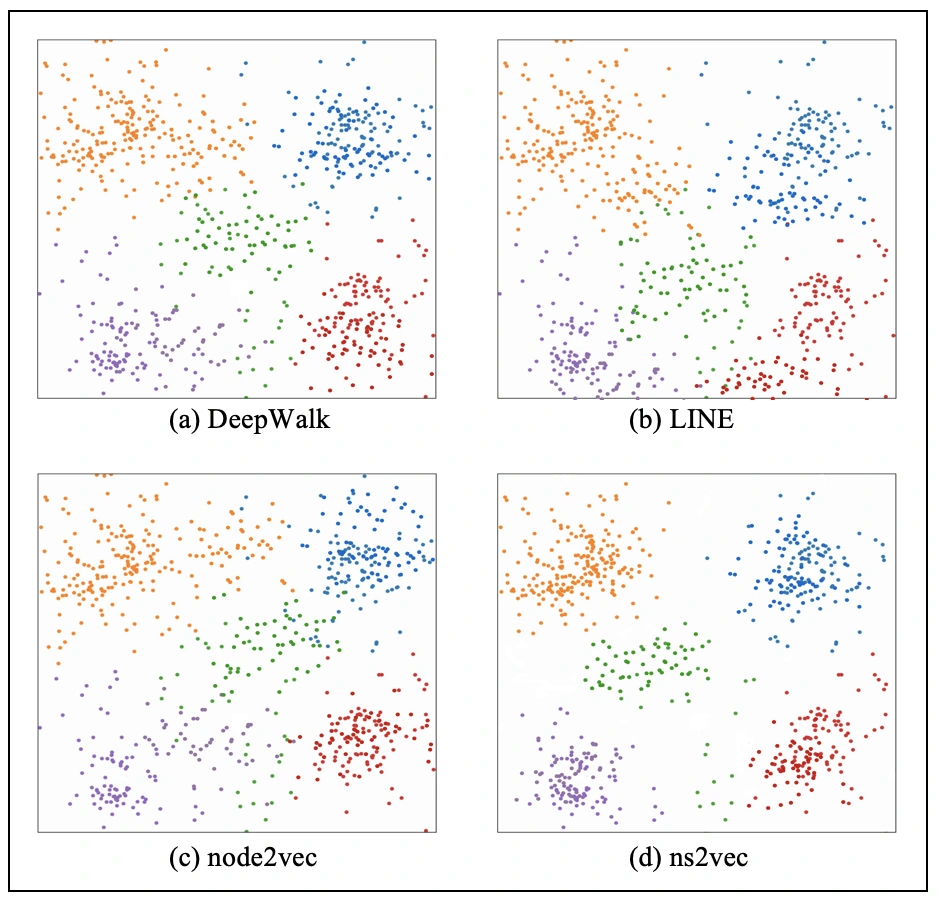
图 8|四种嵌入在二维投影里分成了几团?
(a)DeepWalk,(b)LINE,(c)node2vec,(d)ns2vec。每幅都是 t-SNE 后的散点,五种颜色对应 k=5 的聚类,没有颜色与 20 个兴趣点类别的图例,也没有坐标单位。四个面板都能看见分开的色团。(d)的团块看起来较紧,这与论文的目视判断同向;图中没有轮廓系数、NMI 或纯度。t-SNE 上的空隙不等于 300 维空间里的距离。来源:原论文 Fig. 8。
k=5 与 20 个类别不是同一套分组。这张图可以说明向量能被分成五个目视群落,不能说明 20 类城市功能已经被恢复。
这些结果停在哪里?
能够站住的结论是:在这一张由行程端点、北京点评兴趣点和北京签到合成的网络上,带元路径和节点义项的嵌入,在标注节点不少于 30% 的类别预测里高于 DeepWalk、LINE 和 node2vec,并在一次 75/25 划分中为六个排序器提供了高于显式特征的潜变量输入。
停住的地方同样具体。节点数 1,765,025 与行程总数对不上,分类百分比的节点总体没有写明。β₁、β₂、元路径长度、导通率阈值、距离稳健均值和时间窗都没有数值,节点权重也没有分布。排序分数相对的是自定义相关度 Q(u)。分类没有报告逐类 F1、检验和重复方差。聚类没有数值指标。没有第二座城市,也没有把前若干天的向量用来预测后若干天的到访。结论里提到的社会关系和兴趣点热度,论文写的是后续打算,不是本实验的结果。
一句话总结
一个商场值得保留多个语境向量;在这张北京相关的地点网上,这样做在标注较多时提高了类别预测,并让排序模型更贴近作者定义的相关度,至于人们为何在这些地点之间移动,向量本身还没有回答。
核心来源
- IEEE 正式记录,核对题目、作者、DOI 与 2021 年会议论文身份。PDF 首页页眉印有 DOI:10.1109/BigData52589.2021.9672072,页码 2884–2893。
- 密苏里科技大学 Scholars’ Mine 条目,会议记录写明 2021 年 12 月 15–18 日线上举行。
- 文中图 1–4、图 6–8 来自该会议 PDF 的 Fig. 1–4 与 Fig. 6–8。PDF 没有 Fig. 5,没有补充材料,也没有代码或数据链接。
作者介绍
- Dakshak Keerthi Chandra:论文署名为密苏里科技大学计算机科学系。他于 2022 年春在该校完成博士论文《Representation learning on heterogeneous spatiotemporal networks》,导师为 Jennifer Leopold,主题是时空异构网络的表示学习。
- Jennifer Leopold:论文通讯作者,署名为密苏里科技大学计算机科学系。学校公开页面称她为计算机科学副教授,研究包括图数据挖掘与数据分析。
- Yanjie Fu:论文署名为中佛罗里达大学计算机科学系。亚利桑那州立大学后来的教职介绍写明,他在加入该校前曾任中佛罗里达大学助理教授,研究方向包括数据挖掘与城市计算。2021 年这篇论文的署名机构是中佛罗里达大学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若下一步要检验向量是否保住了“以后还会这样走”,划分应按时间切开:用 5 月 10 日至 19 日的地点网学习向量,只在 5 月 20 日至 24 日的到访上计算 NDCG。随机 75/25 可能让同一商场的邻居同时出现在训练和测试里,图 6 的抬升会混入这种重叠。时间切分若仍能保持潜变量高于显式特征,才更接近论文想保留的转移顺序。
另一项可以直接做的分解,是分别去掉“同一天”边和“类别”边再跑表 III 的 90% 标注格。现在 5.08 个百分点是整套流程相对 DeepWalk 的差。若去掉日期边后 Macro-F1 掉得更多,多语境的主要来源是时间;若去掉类别边后掉得更多,收益主要来自店铺类型。图 8 的五种颜色也可以改成报告每种颜色里 20 个类别的占比。占比若仍混在一起,紧凑的色团说明的是嵌入空间能被切开,还没有说明城市功能被分开。