同一套粗采样,为什么会把爱跑的人测得更单调,把少出门的人测得更小?
论文名片|Zhiyuan Zhao、Zhangwei Zhu、Ling Yin、Zhixiang Fang、Sheng Wu,Population heterogeneity of the impact caused by temporal sampling intervals on typical human mobility indicators using mobile phone location data,Travel Behaviour and Society,2026,45:101340,2026年6月30日在线发表。DOI:10.1016/j.tbs.2026.101340。本文依据正式发表版解读。稿件2024年4月13日收稿,2025年3月21日修回,2026年6月21日接收。这是把同一批密集轨迹按时钟抽稀的测量研究。
设想两部手机都被隔两小时记下一个位置。一个人当天要跑很多客户,有的拜访只停十几分钟。另一个人上午出门一趟,其余时间都在住处附近。前一个人容易丢掉那些短停留,一天的地点种类变少。后一个人若唯一一次出门落在两次记录之间,轨迹会像几乎没有离开过住处,活动范围被压小。这是帮助阅读机制的设想,论文没有跟踪这两个人。
论文用深圳一个工作日的密集手机轨迹做了对应检验。先按细采样算出的日出行距离和日出行次数把人分开,再把同一批轨迹抽成 15 分钟到 4 小时的间隔,看三个常用指标怎样变化。粗采样整体把指标测低,低的方式随人群分开:走得又远又勤的人,地点多样性掉得更多;走得近、以及几乎停在一小片区域里的人,活动范围和形状掉得更多。全体用户的校正线,在地点多样性和活动范围上更接近走得远的人。
先说结论
- 分析样本是筛过的 19,370 条轨迹,分母是这一天留下的轨迹,也是表 1 的人数。其中高距离高频 HH 为 5,310/19,370(27.41%),低距离低频 LL 为 5,303/19,370(27.38%),单地点 OPP 为 4,360/19,370(22.51%)。
- 分组中位线在图 2 上标为日出行距离 8,916 米、日出行次数 4.16 次。1 小时采样时,移动熵相对细采样的低估幅度是 HH 12.68%、LL 6.35%、OPP 2.74%。12.68 除以 6.35 约等于 2.0,除以 2.74 约等于 4.6。
- 2 小时采样时,回转半径的低估幅度是低距离高频 LH 10.17%、LL 8.75%、HH 2.49%、高距离低频 HL 4.18%。2.49 除以 8.75,约为 0.28。
- 同一比较的离心率斜率:HH 的 β 为 0.99,LL 为 0.77,OPP 为 0.41。按两位小数换算,粗采样大约保留细采样数值的 99%、77% 和 41%。LL 的斯皮尔曼相关只有 0.49,组内很多人并不贴着这条斜线。
- 移动熵和回转半径的全体斜率更靠近距离长的人。用这条线把粗采样结果除回去,LL 和 OPP 的移动熵会高于细采样原值;LH、LL 和 OPP 的回转半径仍低于细采样原值。离心率的全体斜率落在 HH 和 LL 之间,校完以后 HH 偏高,LL 和 OPP 仍然偏低。
同一段空档,删掉的不一定是同一种停留
手机定位被广泛用来描述人类移动性(human mobility)。本文指的是一个人在一天里到过哪些地方。这些记录多半是通信系统的副产品。通话、上网的时间由用户和网络决定,研究用的采样间隔因此有粗有细。巴黎和哈尔滨的一组对比里,平均间隔大约是 3 小时和 4 小时;另一些活动空间研究把间隔放在 1 小时、30 分钟或 15 分钟。
间隔变粗带来的差别,属于可塑时间单元问题(modifiable temporal unit problem,MTUP)中的时间聚合效应:把时间切得更粗,统计结果会变。Zhao 等人 2016 年看到,通信变稀、间隔变大时,日出行距离和移动熵被低估,回转半径动得较小。Zhao 等人 2019 年又从全体用户估计了这种偏差。两篇都暗示,偏差在用户之间并不整齐。本文要回答的是:同一种抽稀,对活动模式不同的人是否同一幅度。
设计把“人怎么分组”和“间隔怎么变粗”拆开。原始轨迹先筛成密集样本 D0。D0 一方面用来识别停留和移动,得到日出行距离 tDis、日出行次数 tFreq,并分成五组;另一方面按固定间隔重采样,得到 D1 到 D16。三个指标在每一套轨迹上各算一遍。比较的是同一批人的记录变疏之后,指标相对 D0 降低多少。
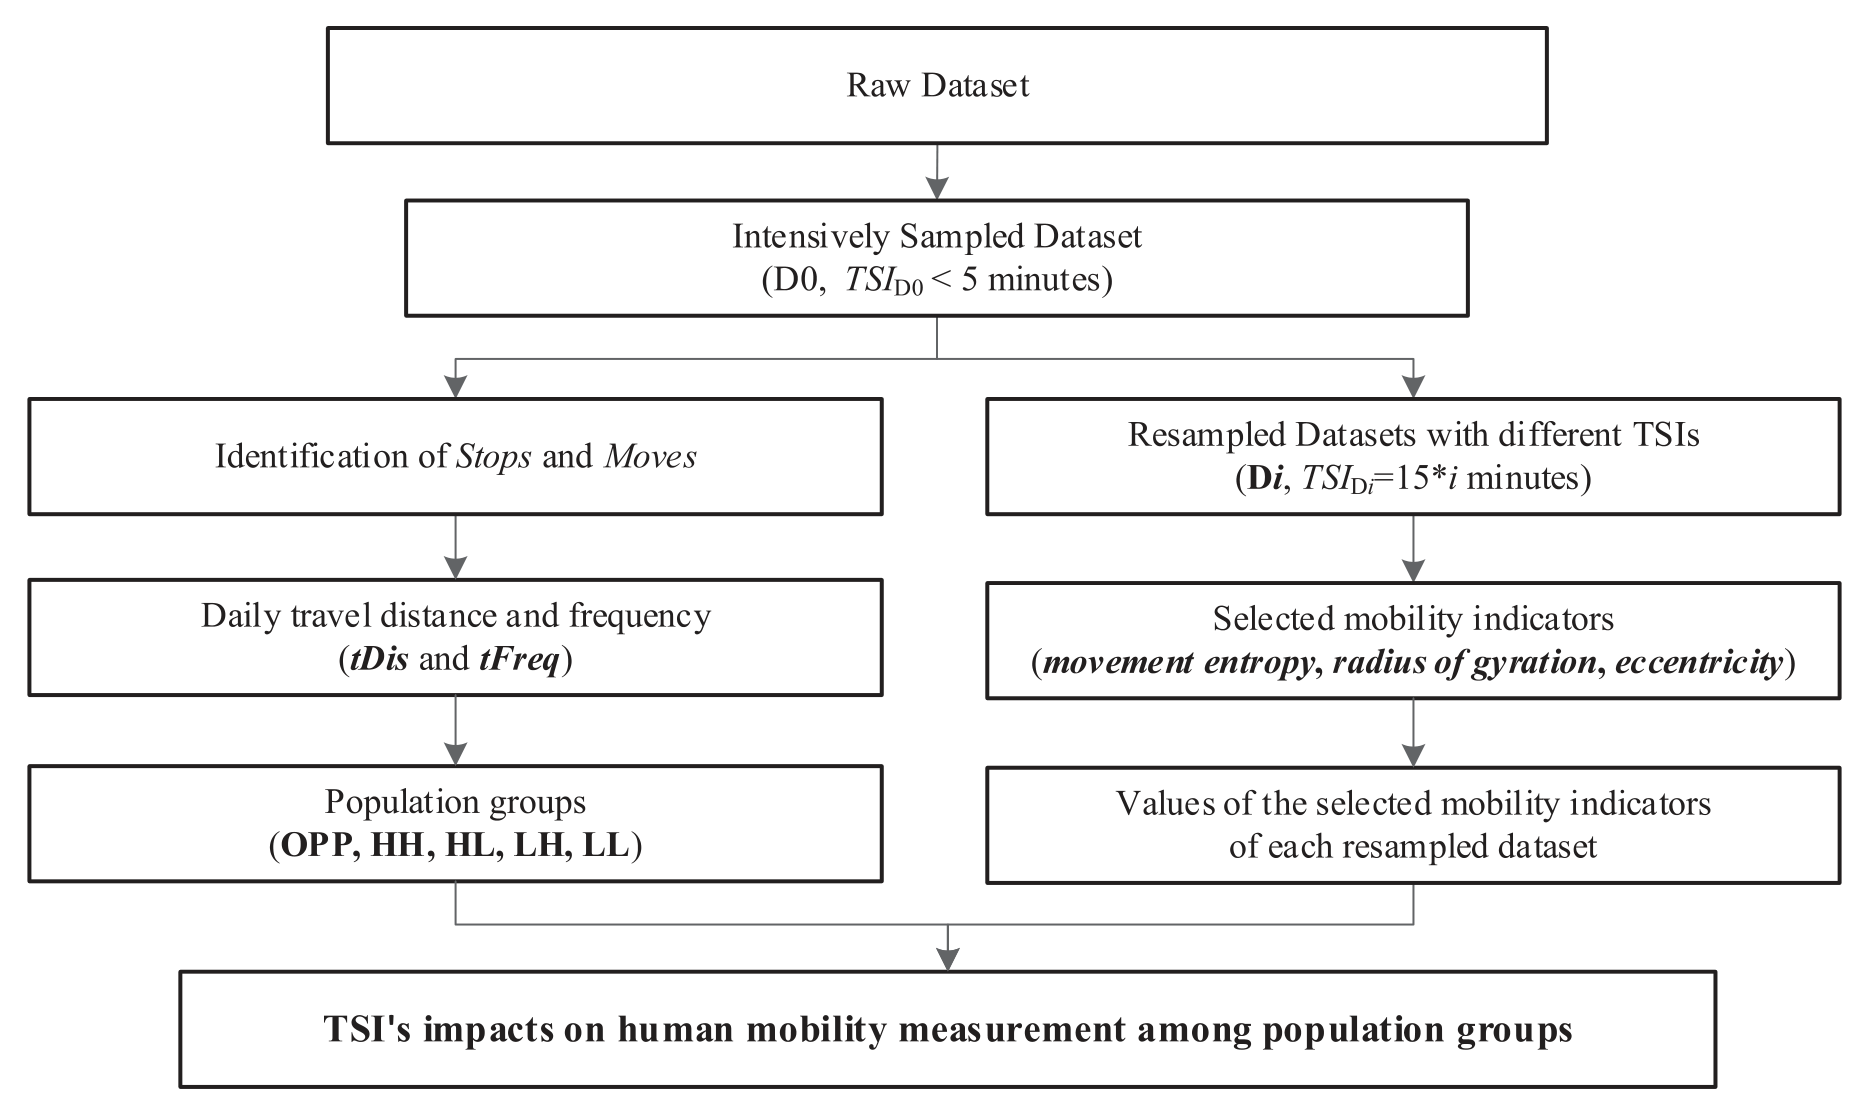
图 1|分组和抽稀怎样接到同一次比较上?
图中没有子图字母。上方从原始库筛出平均间隔短于 5 分钟的 D0。左侧由停留和移动得到 tDis、tFreq,再分成 OPP、HH、HL、LH、LL。右侧按 15×i 分钟重采样,计算移动熵、回转半径和离心率。两路在底部会合,比较的是各组指标随间隔的变化。来源:原论文 Fig. 1。
拿来比较的,是这一天里特别密的 19,370 条轨迹
数据来自深圳一家手机运营商,时间是 2014 年 10 月的一个工作日。论文写原始库包含超过 1.4 亿用户的轨迹。记录有三类:拨出电话、接听电话、使用移动互联网。每条记录留下服务基站的位置和时间,基站大约 3,400 个。每个基站到五个最近邻的平均距离约 550 米;全文后文又给出最近邻的平均距离约 0.19 千米。这两个距离一个看五个邻居,一个只看最近的一个,所以并排列在文中。
D0 用了三条规则。平均采样间隔短于 5 分钟;第一条到最后一条记录长于 16 小时;相邻记录的最大空隙短于 1 小时。筛出 19,370 条轨迹。D0 的平均间隔约 2 分钟;超过 75% 的轨迹平均间隔短于 200 秒,近 75% 的轨迹,采样间隔的标准差也短于 200 秒。图 5 的图注把 D0 写成约 3 分钟。后文比较的横轴都是这套细轨迹,人数和比例的分母都是这 19,370 条。
抽稀从 15 分钟开始,每步加 15 分钟,直到 4 小时,共 16 档。第 i 档 Di 的间隔是 i×15 分钟,所以 D4、D8、D16 分别是 1 小时、2 小时和 4 小时。每个时间窗里如果落有记录,就保留最靠近窗中心的那一条。起点时刻 t0 随机抽 50 次,每个指标取这 50 次的平均,用来减弱某一次起点刚好对准或刚好错过某次停留的影响。
这样得到的偏差,是“已经很密的轨迹被抽稀以后会少掉什么”。当天手机用得很稀、中间空档超过 1 小时、或者记录盖不满 16 小时的人,没有进入这 19,370 条。
三个指标各自在比较哪一种差别
移动熵(movement entropy)按记录落在各位置上的比例计算:
H = −Σ pₘ log₂(pₘ)
pₘ 是位置 m 上的记录占全部记录的比例,连加覆盖当天出现过的全部位置。它用 2 作底,单位是比特。人只在一个基站出现时,熵是 0;两个基站的记录数相等时,熵是 1。论文把它读成日常活动地点的多样性,并联系到下一地点有多难预测。公式计算的是这些记录比例的香农熵。记录越多的位置权重越大,因此待得久的基站把熵往下拉。地点的前后顺序没有单独进入这个公式。
回转半径(radius of gyration)描述活动地点离开中心有多远:
R₉² = (1/N) × Σ 距离(第 n 条记录, 全部记录的平均中心)²
N 是记录条数。R₉ 是上面这个平方再开方,单位在图 4 里为千米。每条记录权重相同。采样均匀时,待得久的地方记录更多,家和工作地通常会主导这个半径。一次短停留要明显改变它,得离中心足够远,或者它本身就是少数把人拉出中心的记录。
离心率(eccentricity)描述这些地点组成的形状有多扁:
ε² = 1 − (短半轴 / 长半轴)²
ε 在 0 到 1 之间。长半轴远大于短半轴时,ε 接近 1,地点呈狭长分布;两轴接近时,ε 接近 0,分布更圆,或者只剩一个位置。长短半轴的具体算法文中指向 González 等人 2008 年的做法,正文没有再展开。摘要把这个指标称作形状的圆形程度。方法部分的方向是:数值越大越狭长。下文按方法部分来读。粗采样若使 ε 变小,就是把形状测得更不狭长。
偏差用过原点的直线概括:粗采样指标 = β × 细采样指标。β 大于 1 表示整体偏高,小于 1 表示整体偏低。偏低幅度写成 (1−β)×100%,分母是这个人在 D0 上的指标值,不是人数。点在对角线以下,表示这个人的粗采样数值更小。点云越散,同一种间隔对组内不同人的影响越不整齐;这种整齐程度用细采样和粗采样数值之间的斯皮尔曼相关 R 表示,R 越大越整齐。
五个组按距离和次数切开,职业只是帮助想象
轨迹先用停留与移动模型(Stops and Moves of Trajectory,SMoT)拆成停留和移动。距离阈值取 500 米,停留至少 10 分钟才算一次停留。500 米接近前面的基站间距,一次停留表示人待在大约一个基站邻域里。日出行次数是移动段的个数。日出行距离把各段起点到终点的直线距离相加,用的是欧氏距离(Euclidean distance),也就是地图上的直线距离。沿路里程和停留期间的走动没有计进 tDis。
日出行距离和次数都为 0、活动范围很小的人先被分出,论文称为单地点人群(one place people,OPP),并举例说活动范围的直径可以小于 500 米。其余人按两个指标的中位数分成四组。第一个字母是距离,第二个字母是次数:高于中位数为 H,低于为 L。HH 是高距离高频,HL 是高距离低频,LH 是低距离高频,LL 是低距离低频。
正文写,为了减弱极端值,先去掉大于第三四分位数加 3 倍四分位距的数值,再取中位数。图 2 把两条中位线标成 8,916 米和 4.16 次。正文约写成 9 公里和 4 次,结论写成不少于 8.9 公里、不少于 4 次。恰好落在中位数上的人归入哪一侧,正文没有写。极端值删去了多少人,也没有写;表 1 的合计仍是全部 19,370。
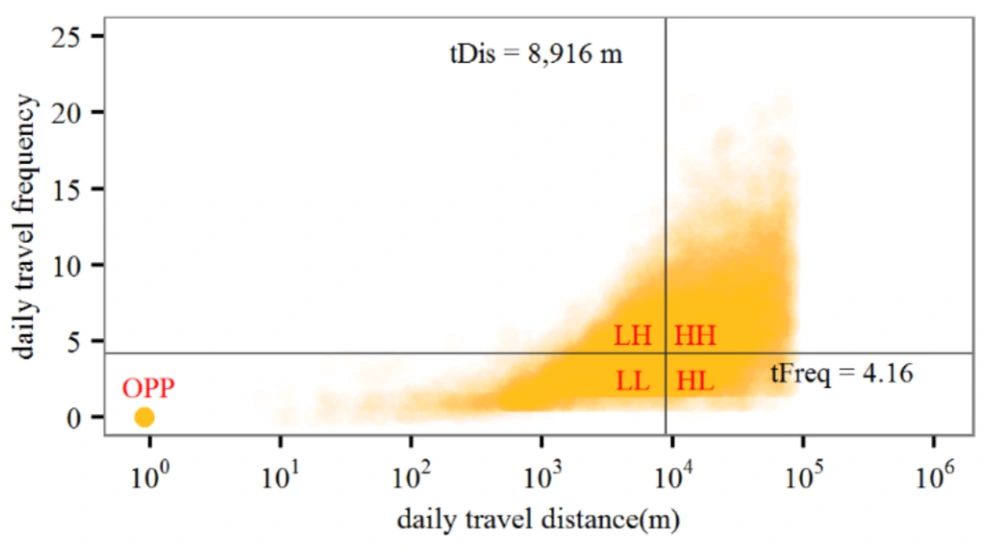
图 2|五个组切在哪两条线上?
图中没有子图字母。横轴是日出行距离,单位米,为对数轴;纵轴是日出行次数。垂线标 tDis = 8,916 米,横线标 tFreq = 4.16。垂线右侧、横线以上的红字是 HH,右侧以下是 HL,左侧以上是 LH,左侧以下是 LL。OPP 是左下角单独的黄点;距离为 0 时对数轴无法落点,所以它画在 10⁰ 附近。云团集中在几公里到几十公里、每天几次到十几次。来源:原论文 Fig. 2。
论文给四组配了帮助想象的角色:要拜访客户的销售更像 HH,早晚各有一次长通勤的上班族更像 HL,回家吃午饭的中学生或在附近送包裹的人更像 LH,在家附近买菜或锻炼的退休老人更像 LL。这些是示意。数据里没有职业、年龄和性别,图 3 也只是各组的时空路径例子。图中彩线的颜色没有图例,灰底是城市陆域轮廓,没有标地名和比例尺。
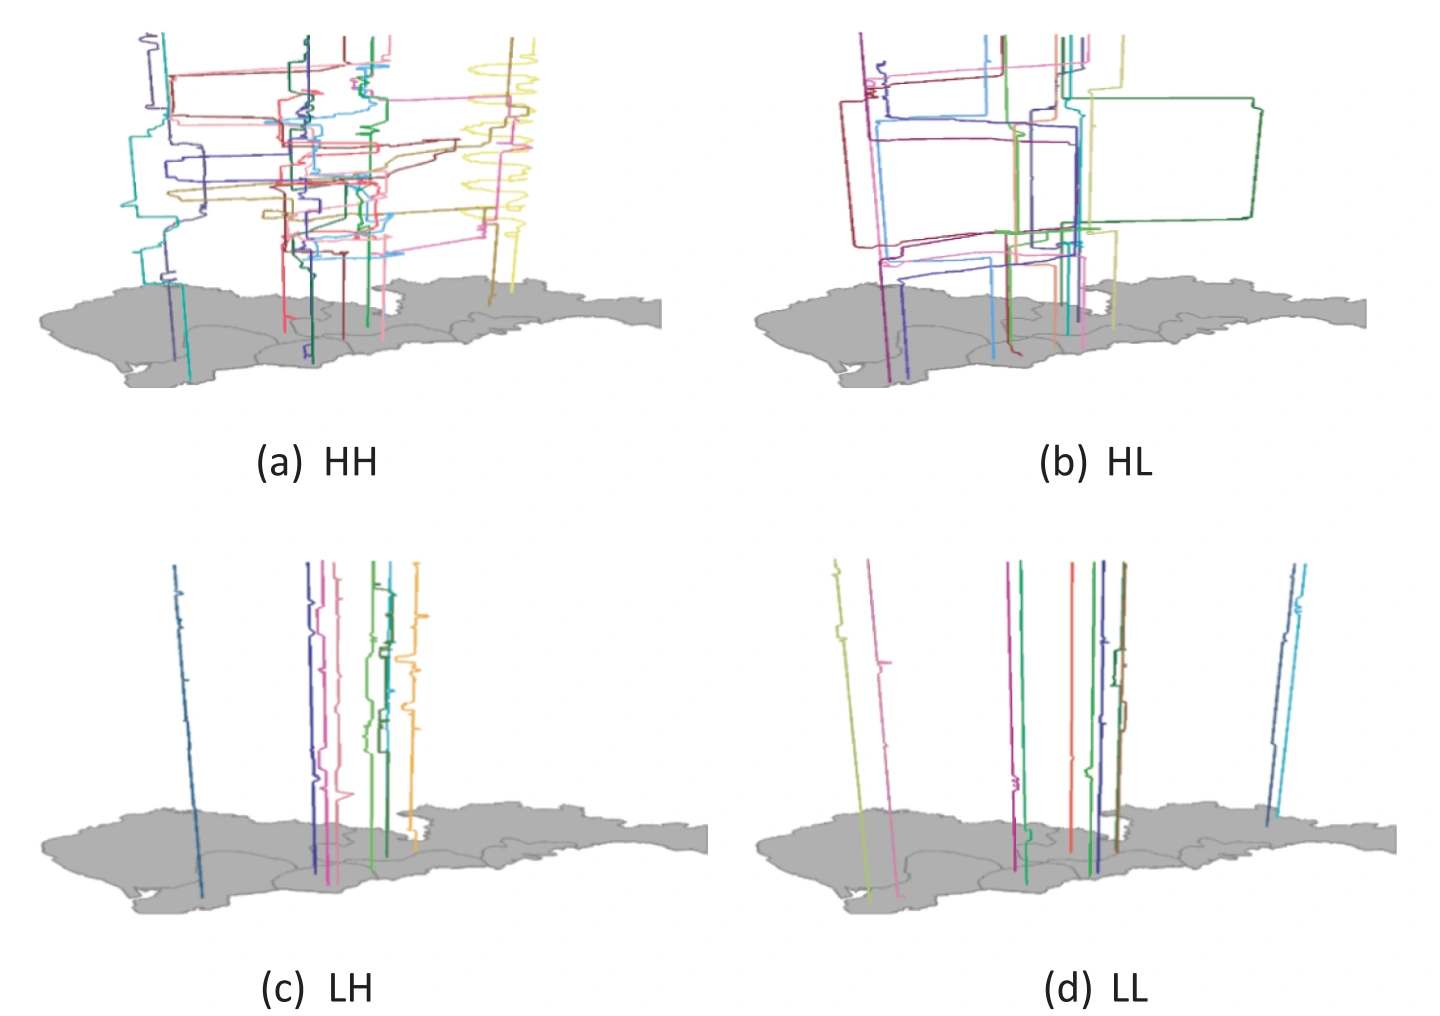
图 3|四组人的一天,在空间上各自铺开成什么样?
(a)HH 的路径在城内跳得更散,短的水平移动很多。(b)HL 能看到少数拉得很长的连接,停留段更集中。(c)LH 的竖线挤在较小一片区域,短移动更密。(d)LL 也留在较小范围,路径比 LH 更疏。四幅都是例子,不能把线条条数当成 5,310 或 5,303 人的合计。OPP 没有画在这张图里。来源:原论文 Fig. 3。
| 组别 | 人数 | 占 19,370 的比例 |
|---|---|---|
| HH | 5,310 | 27.41% |
| HL | 2,195 | 11.33% |
| LH | 2,202 | 11.37% |
| LL | 5,303 | 27.38% |
| OPP | 4,360 | 22.51% |
| 合计 | 19,370 | 100% |
人数来自表 1。HH 与 LL 几乎一样大,HL 与 LH 也几乎一样大;这是中位数交叉分组的结果,两组“高”并不意味着人数更多。
还没抽稀时,范围和形状就已经分开了
D0 上的三个指标说明,五组人在抽稀之前已经分开。移动熵上,HH 整体最高,LL 更低,HL 和 LH 居中,OPP 贴近 0。回转半径上,距离长的 HH 和 HL 明显更大,LH、LL 大多只有大约 1 公里量级,OPP 再次贴近 0。四个常规组的离心率都靠近 1,OPP 靠近 0。
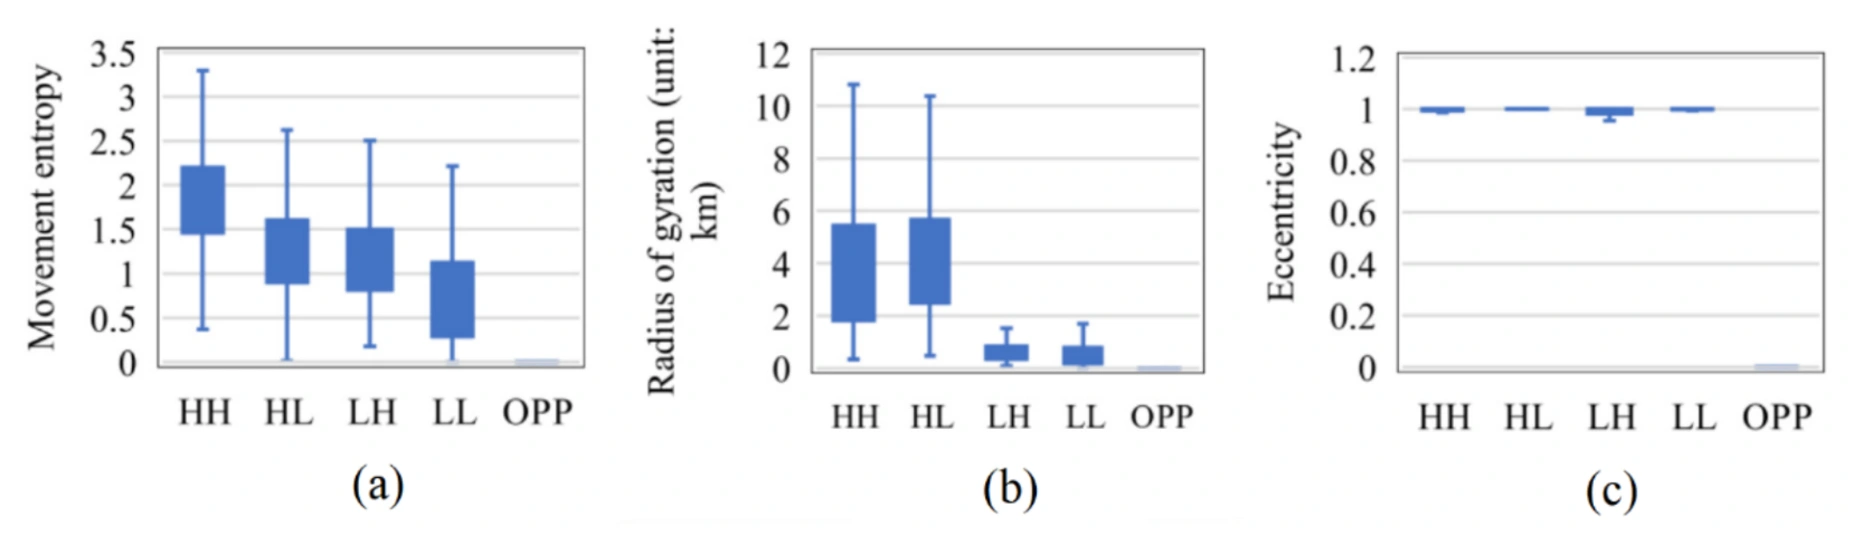
图 4|细采样时,三个指标的组间差别在哪里?
(a)纵轴是移动熵,箱线从 HH 到 LL 逐级下降,OPP 贴在 0 附近;纵轴画到 3.5。(b)纵轴是回转半径,单位千米,画到 12。HH 和 HL 的箱子高于 LH 和 LL,OPP 接近 0。(c)纵轴是离心率,画到 1.2。四个常规组挤在 1 附近,OPP 在 0 附近。箱子没有标出精确中位数,读的是高低和离散。来源:原论文 Fig. 4。
离心率靠近 1,表示四个常规组的地点分布很扁。论文把它理解成少数主要地点占了一天里很大份额,家和工作地是其中最自然的候选。图 4 本身没有列出每个人的地点个数,所以“很扁”可以直接看见,“恰好是家和单位两个点”仍是解释。OPP 的熵和半径都小、离心率接近 0,因为他们的记录集中在一小片区域,形状没有被拉长。
地点一被抽掉,走得又远又勤的人掉得更快
2 小时这一档,六条过原点斜率都小于 1,点云整体位于对角线下方。全体 β 为 0.84,R 为 0.99。HH 的 β 最低,是 0.81,R 为 0.95。接着是 HL 0.85、LH 0.87、LL 0.91、OPP 0.95。按 (1−β) 换算,2 小时大约吃掉 HH 细采样移动熵的 19%,吃掉 LL 的 9%,吃掉 OPP 的 5%。R 除 OPP 图上标成的 0.9 以外,最低是 HH 的 0.95。数值一起变小,人与人的高低顺序大体还在。
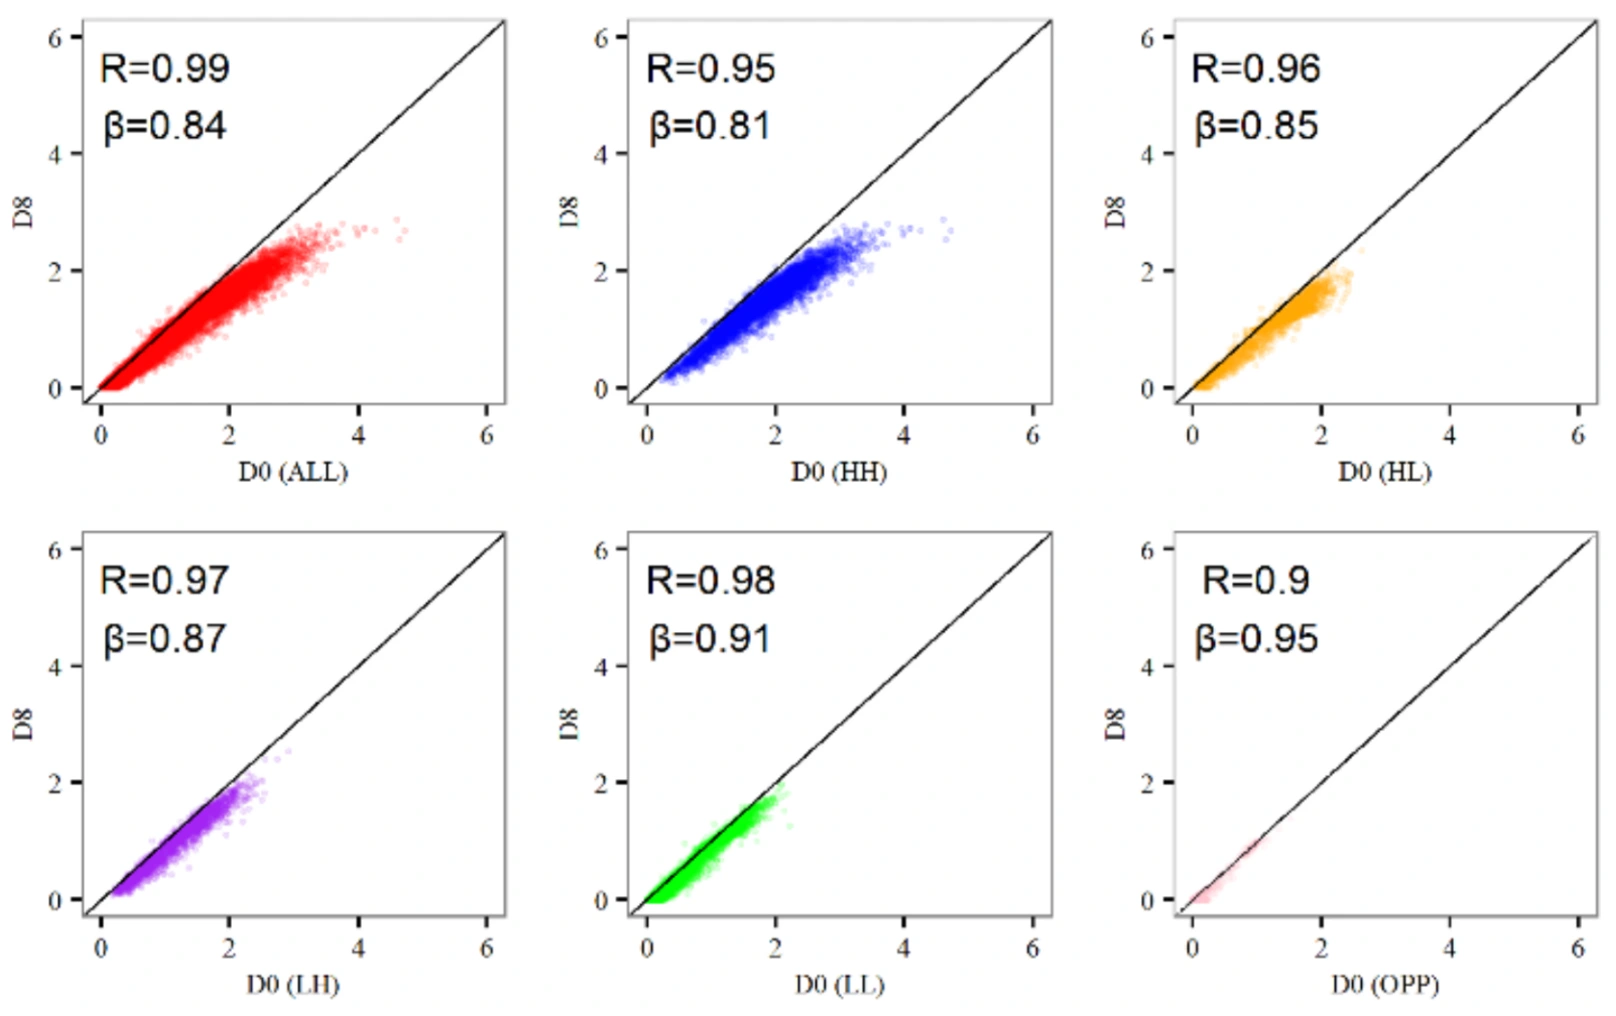
图 5|两小时采样把移动熵压低了多少?
图中没有子图字母。上排从左到右是全体、HH、HL,下排是 LH、LL、OPP。横轴是 D0 的移动熵,纵轴是 D8 的移动熵,对角线表示两次相等。红、蓝、橙、紫、绿、粉分别对应全体、HH、HL、LH、LL、OPP。HH 的点云明显掉到对角线下方,OPP 的点很少、挤在靠近原点的一小段。来源:原论文 Fig. 5。图注写 D0 约 3 分钟、D8 为 2 小时。
把 16 档都画出来,低估幅度随间隔上升,R 缓慢下降。1 小时时正文给出三个精确值:HH 12.68%,OPP 2.74%,LL 6.35%。全体曲线位于 HH 之下、其他组之上。到 4 小时,图上仍是 HH 最高、OPP 最低,HH 已经超过 30% 的刻度,OPP 仍远低于 20%。中间各档没有逐点数值表,精确比较仍以正文写出的 1 小时百分比和图 5 的 2 小时斜率作准。
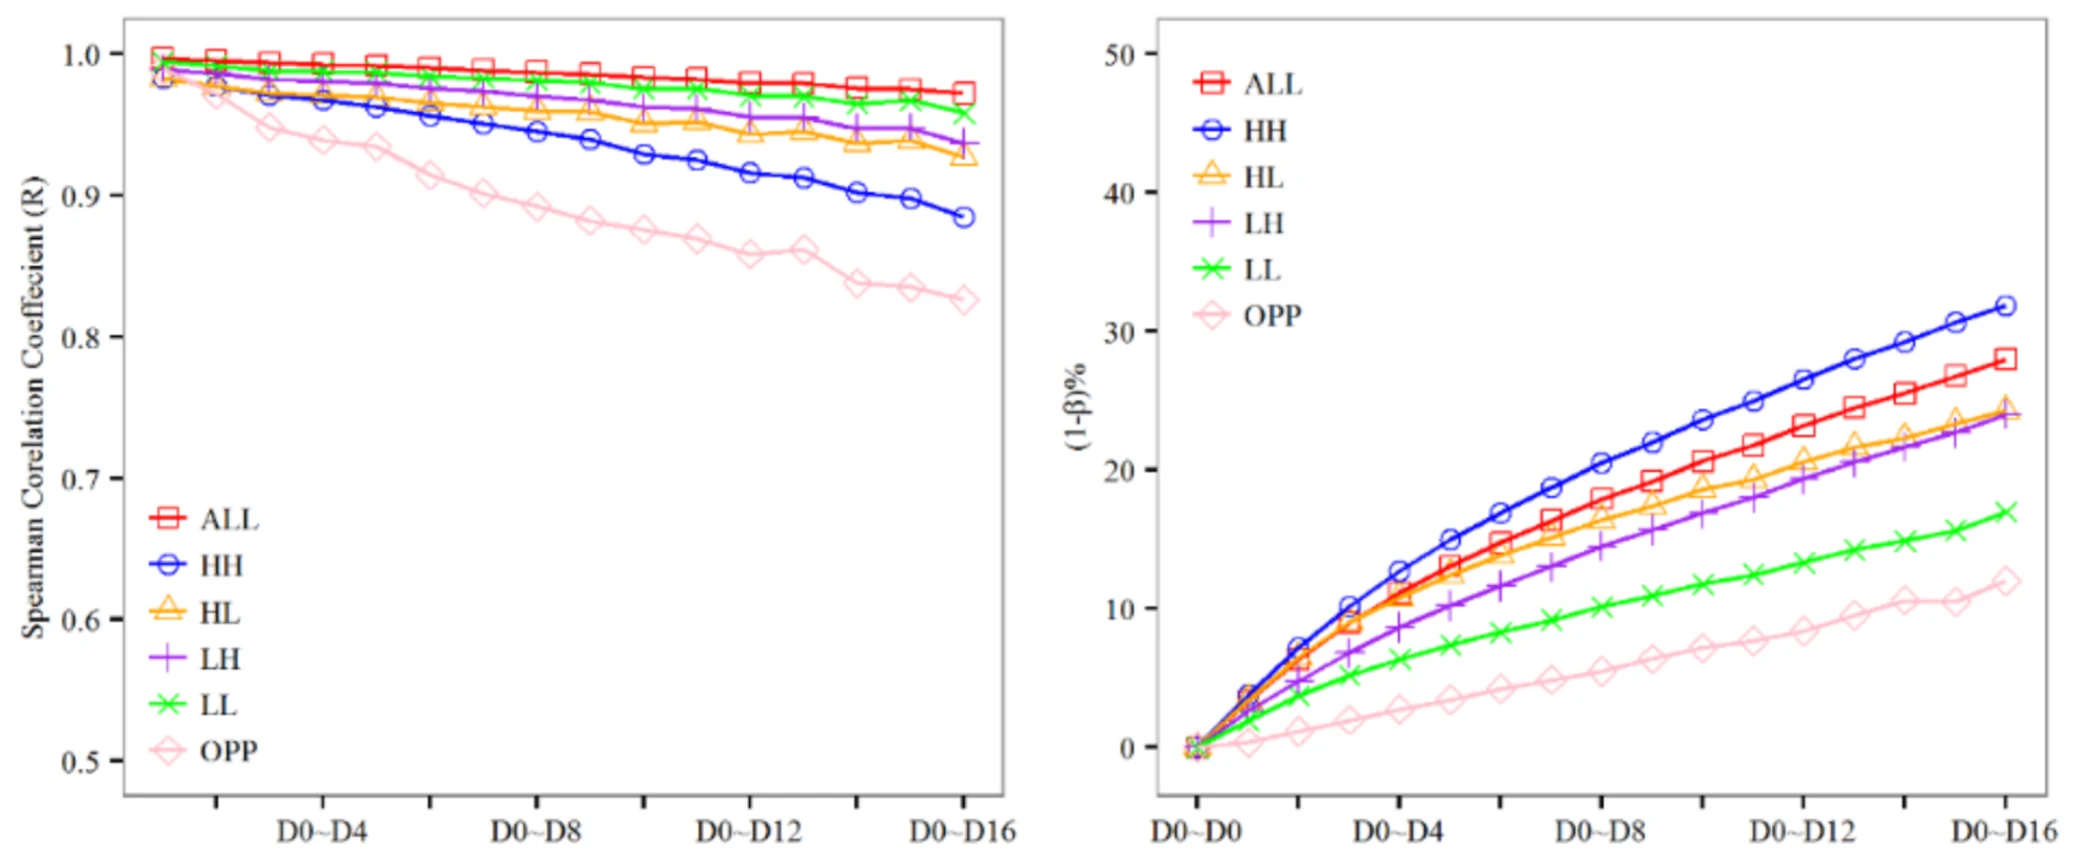
图 6|间隔从 0 加到 4 小时,移动熵的偏差怎样累积?
图中没有子图字母。左图纵轴是斯皮尔曼相关 R,右图纵轴是 (1−β) 的百分比。横轴从 D0 与自身相比,到 D0 与 D16 相比;标出的 D4、D8、D12、D16 对应 1、2、3、4 小时。颜色和符号在两幅图中一致:全体为红色方块,HH 为蓝色圆,HL 为橙色三角,LH 为紫色加号,LL 为绿色叉,OPP 为粉色菱形。右图自上而下大致是 HH、全体、HL、LH、LL、OPP。来源:原论文 Fig. 6。
论文的解释是:HH 的短停留多,间隔一拉长就容易整段消失,地点种类减少,熵下降。LL 和 OPP 的活动本来简单,可丢的短停留少。图 3a 的碎路径和这个解释相符。文中没有按组列出短于 10 分钟、15 分钟或 1 小时的停留次数,所以“短停留更多”是由分组结果和路径示例支持的机制,还不是一张停留时长表。
正文有一句写,HH 的低估大约是 OPP 的两倍、LL 的三倍。1 小时的三个百分比对不上这句:12.68 相对 6.35 约是 2.0 倍,相对 2.74 约是 4.6 倍。摘要和结论写的是大约两倍于 LL。读倍数时以这三个百分比为准。
活动范围反而更亏待走得近的人
回转半径对抽稀稳定得多。2 小时散点的 β 为:全体 0.97,HH 0.98,HL 0.96,LH 0.91,LL 0.92,OPP 0.9。R 除 HL 的 0.93 和 OPP 的 0.9 以外,都在 0.97 以上。点大体贴着对角线,但短距离三组的云更短,也更偏到线的下方。
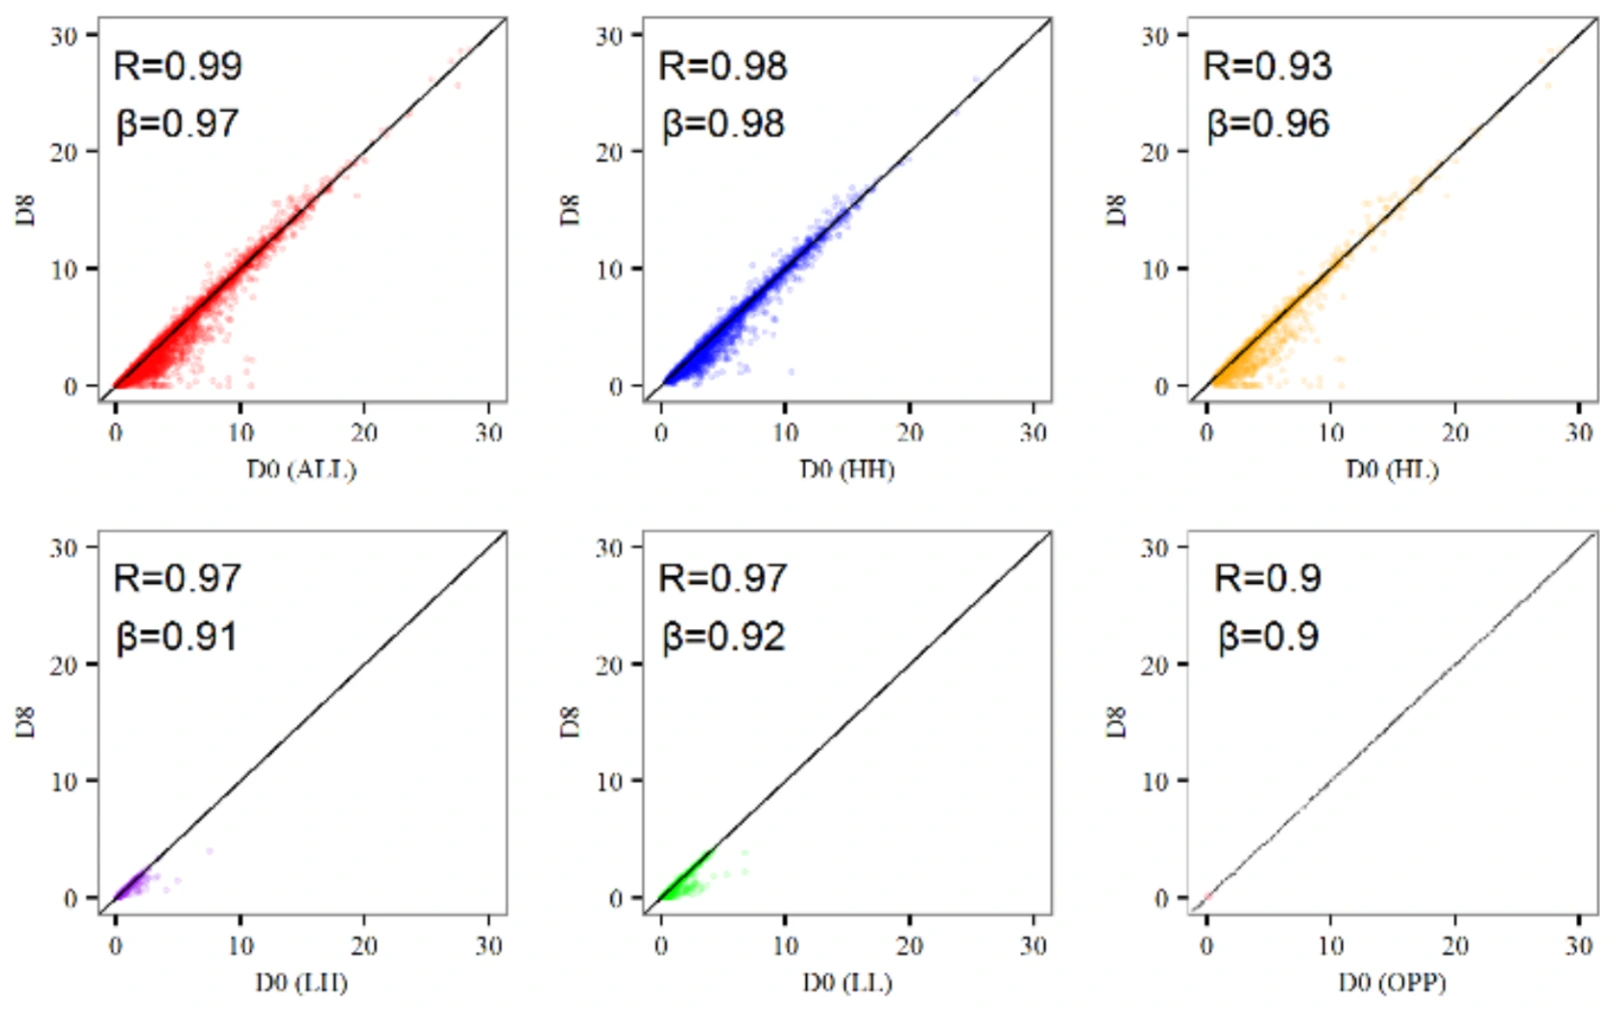
图 7|两小时采样对回转半径的压低,为什么比移动熵轻?
图中没有子图字母,排列和颜色与图 5 相同。横轴、纵轴都是回转半径,对角线表示两次相等,刻度画到 30。散点轴上没有再印单位;图 4 把同一指标标成千米。HH 的点可以拉到 10 以上仍贴近对角线;LH、LL、OPP 的点集中在很小的数值,斜率也更低。来源:原论文 Fig. 7。
正文给出的 2 小时低估幅度比两位小数的 β 更细:LH 10.17%,LL 8.75%,HH 2.49%,HL 4.18%。HH 不到 LL 的一半。16 档曲线分成两束。短距离的 LH、LL、OPP 上升更快;HH、HL 和全体缠在下方。全体曲线靠近距离长的两组。因此,若只用全体的偏低幅度去理解全市,长距离用户的半径差不多能被说中,短距离用户实际丢掉的份额更大。
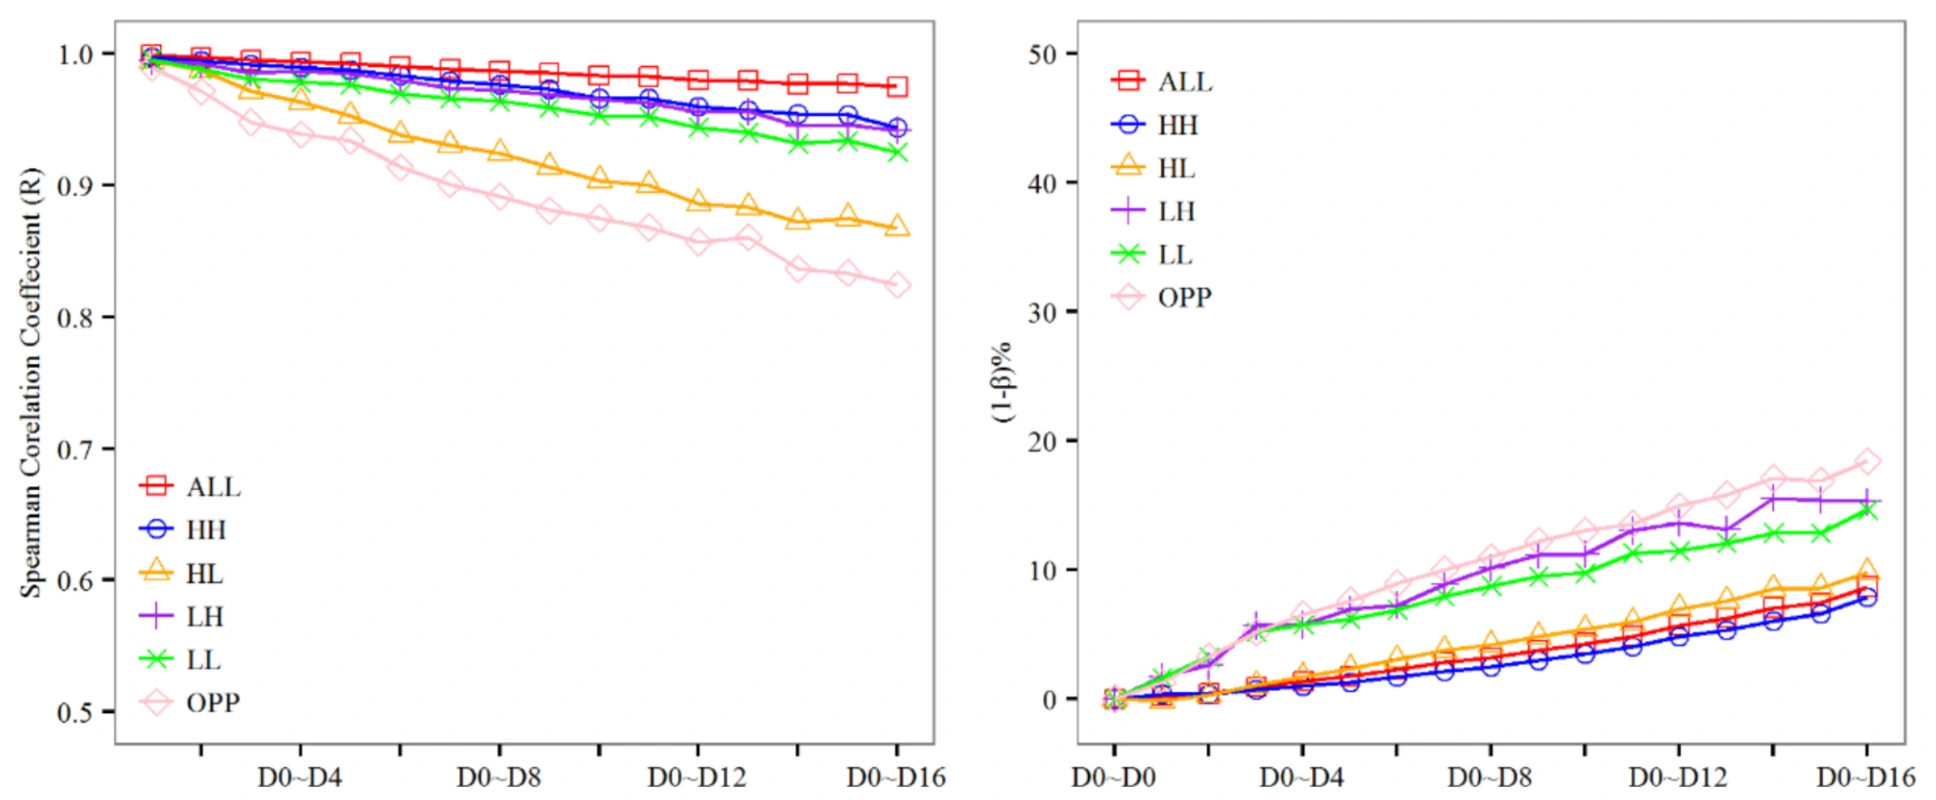
图 8|谁的活动范围随间隔变粗掉得更快?
图中没有子图字母,颜色和符号与图 6 相同。左图的 R 都从 1 附近下降,OPP 和 HL 降得更明显。右图的 (1−β) 在 4 小时处仍大多低于 20%:上方一束是 OPP、LH、LL,下方一束是 HL、全体和 HH。2 小时处应读正文的 10.17%、8.75%、4.18% 和 2.49%,图上其余点没有逐一标数。来源:原论文 Fig. 8。
原因仍和记录权重有关。工作日里,睡觉和上班往往是最长的两段,两者之间的距离构成回转半径的大头。这两段很长,抽稀也不容易把它们同时抹掉,所以已有很长家—工作距离的人,半径更稳。LH、LL 和 OPP 离开住处的活动通常更短。短记录一旦消失,本来就不大的半径会明显缩小。这解释了为什么移动熵和回转半径亏待的是不同的人:前者怕短地点被删掉,后者怕仅有的外出被删掉。
形状指标会跳,单地点组掉得最陡
离心率的散点不再是一条紧的带子。2 小时的 β 和 R 为:全体 0.88 与 0.78,HH 0.99 与 0.83,HL 0.92 与 0.52,LH 0.95 与 0.75,LL 0.77 与 0.49,OPP 0.41 与 0.9。HH 几乎停在对角线上。OPP 的许多点贴着纵轴 0,细采样时还有一定扁度,2 小时后形状数值塌下去。LL 同时有贴底的点、贴在 1 附近的点,R 只有 0.49。
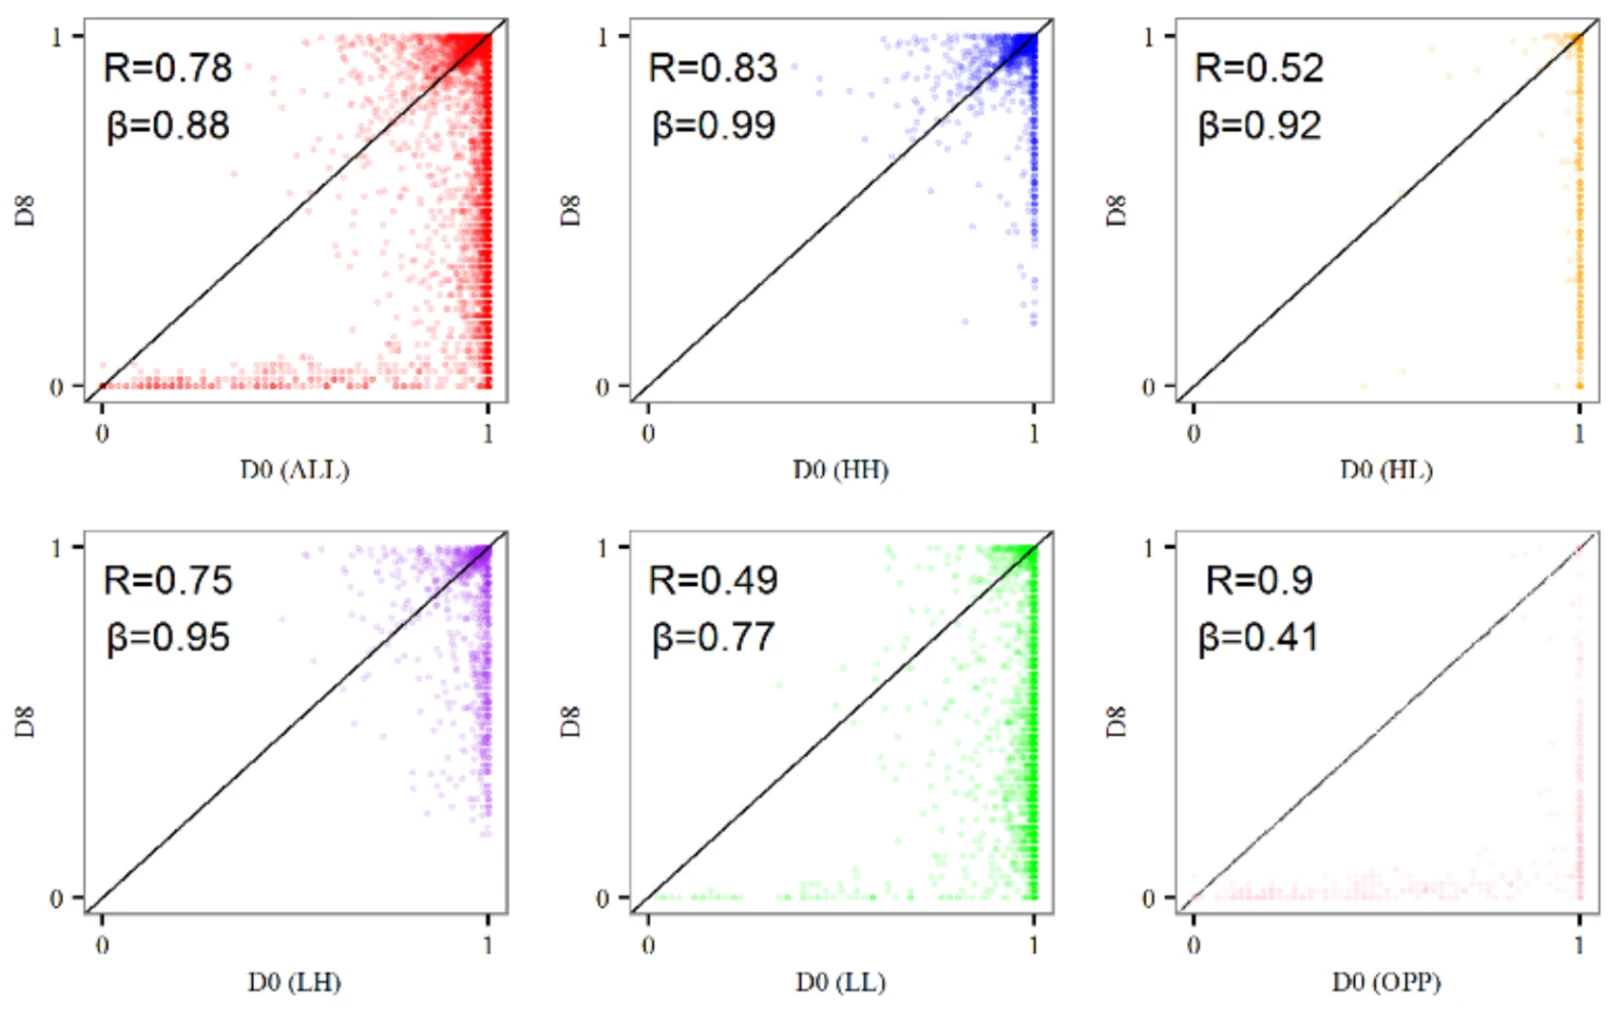
图 9|两小时采样怎样改写活动形状?
图中没有子图字母,排列与图 5 相同,横轴和纵轴都是 0 到 1 的离心率。HH 的点多在右上角。HL 有一批点贴在横轴为 1 的右边界。LL 的点从底部一直散布到右上角。OPP 的点大量落在纵轴靠近 0 的位置。β 只是过原点直线的斜率;R 为 0.49 或 0.52 时,这条线代表不了组内大多数人。来源:原论文 Fig. 9。
形状会跳,是因为地点从一大片收成两个点或一个点时,离心率可以从 0 与 1 之间的某个数突然变成 0 或 1。地点多、而且不排成一条线的人,不太容易一次就被抽成两个点,所以 HH 的变化更缓,R 也有 0.83。次数少的 HL 和 LL 更容易跨过这个门槛,1 小时以前 R 就下降得快。
16 档图把两件事分开。左图里,HL 和 LL 的 R 在 1 小时前陡降,4 小时时已经靠近 0.4;OPP 的 R 下降最慢,4 小时仍在 0.8 以上。右图里,OPP 的低估在 1 小时前升得最快,之后仍远高于其他组,4 小时读数靠近 70% 的刻度;LL 次之;HH 一直贴在最下方。70% 是从纵轴读出的位置,正文没有打印这个终点。定量比较仍以图 9 的 β 为准:OPP 的 0.41 对 HH 的 0.99。
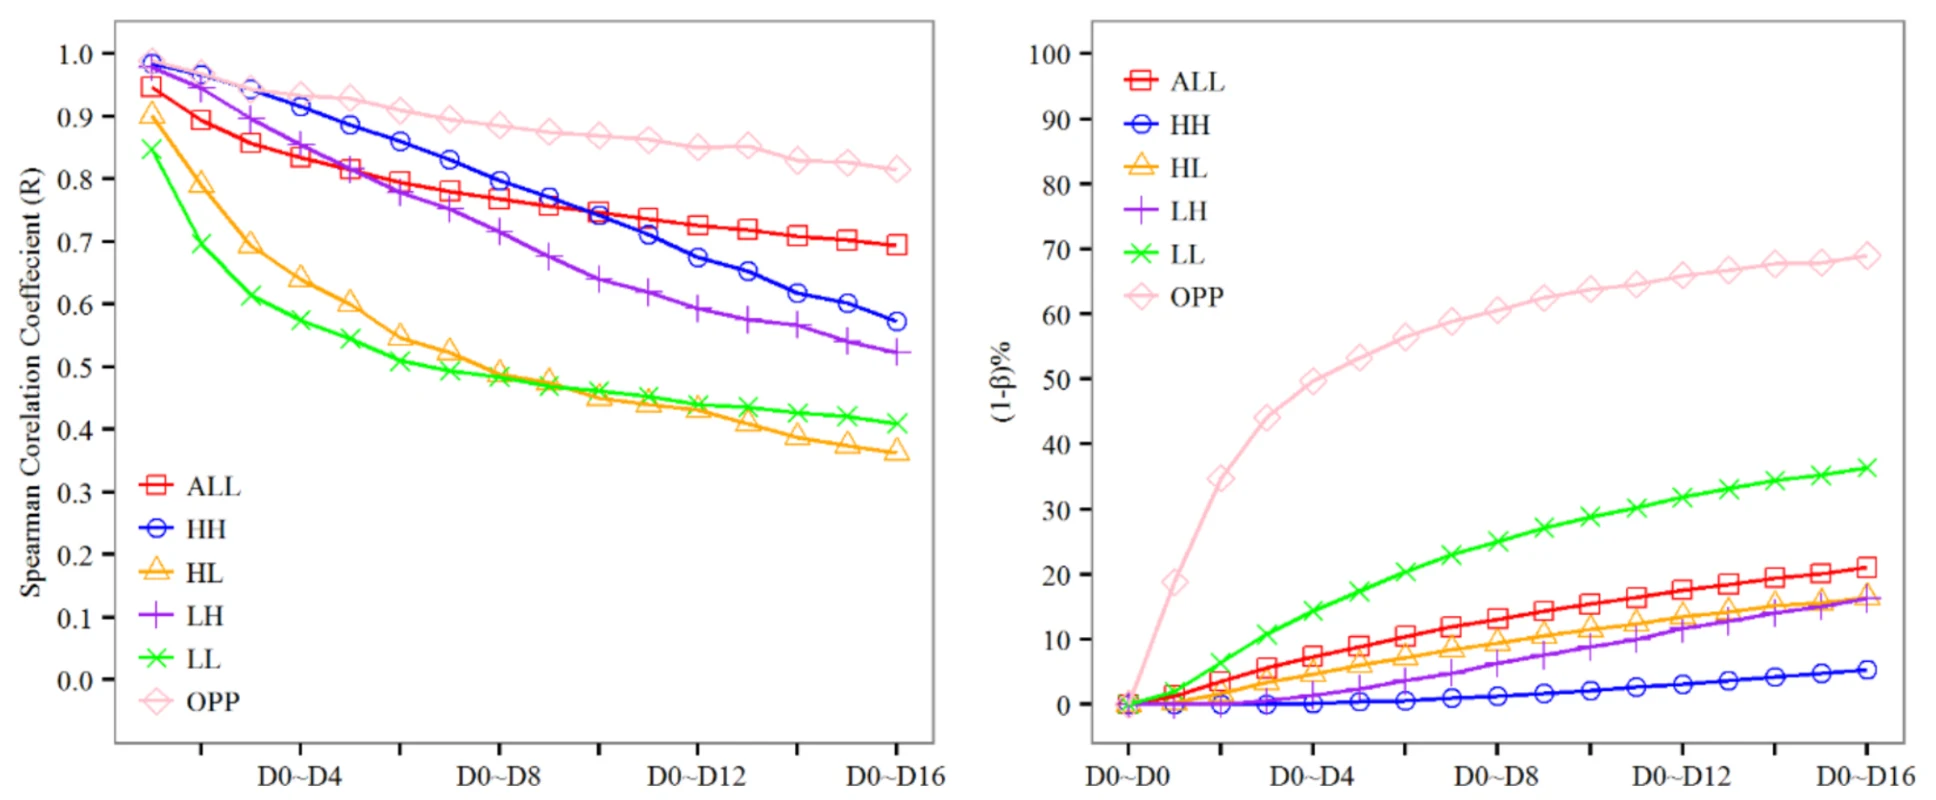
图 10|离心率的组间差别,是幅度大,还是人与人更不整齐?
图中没有子图字母,颜色和符号与图 6 相同。左图纵轴是 R,右图纵轴是 (1−β),右图刻度到 100%。OPP 在左图最高、在右图也最高:形状数值掉得最多,组内方向却相对整齐。HL 和 LL 在左图掉得最快。HH 在右图最低。来源:原论文 Fig. 10。
表 2 用“低、中、高、很高”总结三组指标。它把 R 注释成用户之间影响的多样性,把 1−β 注释成影响程度。移动熵和回转半径两列,与图 5、图 7 的高低顺序大体相符。离心率的 1−β 列对不上图 9:表中 HH 为 high、OPP 为 low,图上却是 HH 的 β=0.99、OPP 的 β=0.41。结论又写 OPP 的离心率低估最严重。读幅度时以图 9、图 10 和正文为准。另外,图上的 R 越大表示越整齐;表注却把 R 说成多样性。结论里“多样性随间隔下降”的句子,方向上跟着左图的 R 下降,名称则和方法部分相反。
| 组别 | 移动熵 R | 移动熵 1−β | 回转半径 R | 回转半径 1−β | 离心率 R | 离心率 1−β |
|---|---|---|---|---|---|---|
| HH | 中 | 高 | 低 | 低 | 低 | 高 |
| HL | 低 | 中 | 高 | 低 | 中 | 很高 |
| LH | 低 | 中 | 低 | 高 | 中 | 高 |
| LL | 低 | 低 | 低 | 高 | 高 | 很高 |
| OPP | 高 | 低 | 高 | 高 | 很高 | 低 |
表中等级照录原表。离心率最后一列与图 9 冲突,读幅度时回到散点。
全市一条校正线,会偏向移动距离长的人
先前有研究建议用线性关系把不同间隔的偏差校回去。本文的全体曲线说明,一条线校不了所有人。
移动熵在 2 小时的全体 β 是 0.84,HH 是 0.81,LL 是 0.91,OPP 是 0.95。把粗采样数值除以 0.84:LL 的 0.91 会被除得超过原来的细采样值,OPP 更是如此;HH 的 0.81 除完仍略低于细采样值。讨论因此写,低距离、低次数人群的移动熵会被高估。
回转半径的全体 β 是 0.97,靠近 HH 的 0.98 和 HL 的 0.96,高于 LH 的 0.91、LL 的 0.92 和 OPP 的 0.9。用 0.97 去除,短距离人群的半径仍然偏低。4.4 节把这一结果写成短距离人群会被高估,讨论部分写成仍然低估。按正文给出的 y=βx,除以较大的全体 β,短距离人群的回转半径回到不了 D0。
离心率的全体 β 是 0.88。HH 的 0.99 除以 0.88 会超过细采样值;LL 的 0.77 和 OPP 的 0.41 除完仍然偏低。讨论写的正是这个方向:长距离且高频的人,离心率会被这条全市校正抬高;相反活动特征的人仍被低估。
同一方向也改变组与组的对比。HH 的移动熵掉得比 LL 多,粗采样会把两组的熵差距缩小。短距离人群的回转半径掉得更多,粗采样会把他们和长距离人群的范围差距拉大。这是由各组 (1−β) 不同推出来的,文中没有单独检验差距本身的显著性。
讨论还联系到通话记录里的一个老观察:通话更频繁的人,活动范围往往更大。这里至少叠了三层。通话多的人间隔更短,测量损失更小;他们本身可能走得更远;若通话更频繁的人也出行更频繁,按本文的分组,移动熵会受到更重的低估,回转半径和离心率的低估更轻。本实验按时钟抽稀,没有按通话次数把这 19,370 条重新分组。这段是对文献中相关关系的解读。
结果能说到哪一步
这 19,370 条是一个工作日、一座城市、一家运营商里记录已经很密的人。D0 相对真正连续的出行仍可能偏低,作者也这样写。基站坐标还有大约数百米的空间粒度,500 米的停留阈值区分不开邻域内部的短走动。
分组用的是 D0 上的距离和次数。手里只有 1 小时数据的人,并不能先用 8,916 米和 4.16 次把同一批人分准,因为这两个分组指标自己也会被粗采样改变。本文没有检验粗采样之后组别是否还在。
数据没有社会经济属性。销售、上班族、学生和老人是示意。讨论引用其他研究说,老年人和承担更多家务的女性活动范围往往更小,因而可能更接近 LL;作者同时写明,这一社会经济猜测还需要带属性的数据才能检验。10.17% 和 8.75% 的分母是 LH、LL 相对各自 D0 回转半径少掉的份额,组别来自出行距离和次数。
表 2 的离心率列、4.4 节与讨论部分对回转半径校正方向的用词,以及“两倍、三倍”那一句,都要让位于正文百分比和图上的 β。极端值删去多少人、中位数上的人如何归组、16 档曲线的逐点数值,正文都没有给出。
一句话总结
同一套粗采样会把移动指标测低,而且低法随人群分开:走得又远又勤的人更易失去地点多样性,走得近和几乎不移动的人更易失去活动范围与狭长形状。在前两个指标上,全市一条校正线更贴近走得远的人。
核心来源
- Travel Behaviour and Society 正式版,卷 45,文章编号 101340。图 1 至图 10、表 1 和表 2 都出自这一版。正文未引用补充图,所依据的正式版也没有附上补充材料。
- 基金为国家自然科学基金 42201500。论文没有数据与代码可用性声明。
- 分组和指标所依赖的前序工作,已在正文引用:González、Hidalgo 与 Barabási,2008,个体移动模式与回转半径;Song 等,2010,移动可预测性;Spaccapietra 等,2008,停留与移动;Zhao 等,2016 与 2019,通话记录偏差和全体尺度上的采样间隔影响。
作者介绍
五位作者的单位和分工以论文署名页及贡献说明为准。
- Zhiyuan Zhao:通讯作者,署名福州大学数字中国研究院(福建)和福建省数字经济联盟。负责构思、方法、分析、可视化、验证、写作和基金。
- Zhangwei Zhu:署名福州大学数字中国研究院(福建)。参与调查、方法、数据整理、分析、验证、可视化和修改。
- Ling Yin:署名中国科学院深圳先进技术研究院。参与数据整理和概念构思。
- Zhixiang Fang:署名武汉大学测绘遥感信息工程国家重点实验室、地球空间信息技术协同创新中心。参与概念构思、数据整理和指导。
- Sheng Wu:署名福州大学数字中国研究院(福建)和福建省数字经济联盟。负责指导和项目管理。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市用 1 小时手机数据给社区的地点多样性排序,而两个社区的居民分别接近 HH 和 LL,论文的 12.68% 与 6.35% 意味着忙碌社区被压得更重,两社区的熵差距会被缩小。若改用回转半径看谁的日常范围更小,短距离社区又会被多压一截,差距被拉大。同一套抽稀因此会把“活力”和“活动范围”上的不平等读到相反方向。这一步把个人组别换成了社区构成,论文没有做社区聚合,只有在社区成员确实接近这两个组时才站得住。
可以检验的做法,是先只用粗采样能看见的特征判断一个人更接近哪一组,再使用该组的 β,看校正后的熵和半径是否比全体 β 更接近 D0。分错组的代价很大,因为 HH 的移动熵 β 是 0.81,OPP 是 0.95,方向相同但幅度差一截;离心率则是 0.99 对 0.41,校反的程度会更大。还有一个反例:HH 里如果多出来的距离只来自一次很长的通勤,中间没有那些十几分钟的停留,抽稀未必会像图 3a 那样吃掉很多地点。论文没有按停留时长再拆 HH,所以“远而且勤就一定更丢熵”仍可能被这种人打破。