只看一个人怎么出行,能反推出年龄、收入和家里有几个孩子吗?
论文名片|Ekin Uğurel、Cynthia Chen、Brian H.Y. Lee、Filipe Rodrigues,On predicting sociodemographics from mobility signals,Computers, Environment and Urban Systems,2026,127:102420,2026年3月18日在线发表。DOI:10.1016/j.compenvurbsys.2026.102420。收稿日期 2025年11月5日,修回 2026年2月7日,接收 2026年2月26日。这是一项用家庭出行调查做的预测研究,同时检查模型报出的把握是否诚实。
普吉特湾的规划机构拿到手机位置数据时,能看见设备在家、学校、商店和工作地之间怎么移动,看不见持有人的年龄、收入,也看不见家里有几个孩子。一个很自然的补法是看线索:常去学校的人更年轻,独自开车的人更年长,一辆车里坐着好几个人的家庭更可能有孩子。
这项研究用西雅图一带四县的家庭出行调查检验这些线索能走多远。上学、结伴和孩子的关联确实最清楚,性别的关联很弱。在混合划分下,多任务神经网络预测年龄的 top-1 准确率从 0.508 升到 0.526;同一网络预测收入只有 0.532 到 0.538,靠近三波里最高收入档 53.7% 的人数占比。模型还能报出把握,但这种把握经常比实际命中更保守。训练样本很少,或者测试年份和训练年份不同时,四个属性共用一个网络,平均看来比分开学更稳。这些结果缩小的是一个人可能落在哪一类的范围。
先说结论
- 在普吉特湾 2017、2019、2023 三波家庭出行调查里,上学目的的出行占比与年龄的斯皮尔曼相关约为 −0.50,独自开车约为 +0.30;孩子数的相关最高约 0.5;性别的相关绝对值不超过 0.08。用人口属性解释结伴比例,线性模型的 R² 为 0.22;多方式比例的 R² 只有 0.01。
- 混合划分下,多任务神经网络预测年龄的 top-1 准确率,从经典特征的 0.508±0.003 升到加入基序后的 0.526±0.002(五折均值±标准差)。同一设置下收入只有 0.532 到 0.538。随机森林预测收入可以到 0.563±0.001,比三波最高收入档占比 53.7%(7,961/14,823)大约高 2.6 个百分点;两个数字的分母不同,只说明量级。
- 更简单的特征组也会拿到最优。四个属性、两种划分、四项指标共 32 个最优格子里,正文统计有 9 个来自更简单的特征组。跨时间测试收入时,支持向量机只用经典特征的准确率就是 0.560±0.000。
- 把 14 类出行目的合并成 7 类、标签仍用调查真值时,各任务平均的准确率下降约 0.003,AUROC 下降约 0.011。结伴特征携带最清楚的家庭信号,但这套手机轨迹流程提取不出结伴。
手机轨迹缺的是人,调查才同时有出行和标签
交通研究通常把人的属性写成原因,把出行写成结果:年龄、收入和家庭责任影响何时出门、去哪里、用什么方式。被动采集的手机数据把这个问题翻过来。它记录设备在何时何地出现,不记录谁拿着这台设备。规划上要做的许多事,例如新收费道路影响到哪一类人、新公交线有没有覆盖收入较低的社区,都需要把轨迹和人接上。
这篇论文把任务写成条件概率:已知出行 T,求社会人口属性 S 的分布。同一种出行可以对应好几种人,所以它几乎不可能是一对一的映射。作者要看的是,更高阶的行为线索能不能把可能的范围收窄,以及模型报出的概率能不能当真。
真正的手机数据没有社会人口标签,没法直接算对错。因此正文的监督实验用家庭出行调查(household travel survey,HTS):同一批人既有出行日记,也有年龄、性别、收入和孩子数。2021 年那一波出行被新冠疫情打乱,只留作跨时间测试。目的和方式以后可以从原始轨迹里推断,本文第 5.4 节单独估计这种替换会掉多少;引用的其他算法可以把目的和方式的 F1 做到最高约 76% 和 92%,那是那些算法的成绩,不是本文这条推断流程的成绩。
三波调查留下多少人、多少次出行?
数据来自普吉特湾区域委员会的家庭出行调查,覆盖华盛顿州金县、基沙普县、皮尔斯县和斯诺霍米什县,抽样框是地址概率样本。2017、2019、2023 三波列入表 1。2021 年另外包含一份自愿加入的网络样本,为了和其他波次一致,本文把它删掉;删掉之后的人数没有单独列出。
进入分析前,出行记录要同时具备四样东西:有效的起点和终点活动目的、非空白的出行方式、能定位的终点坐标以及非零距离、非负的出行时长。缺任何一样就删掉。表 1 的家庭数、人数和出行数是各波表头数字;分类人数是清洗之后的分析样本,不必加总等于表头人数。
| 项目 | 2017 | 2019 | 2023 |
|---|---|---|---|
| 实地访问 | 4月10日–6月15日 | 3月11日–5月30日 | 4月24日–5月29日 |
| 家庭 | 3,160 | 2,902 | 3,504 |
| 人 | 5,545 | 5,116 | 5,959 |
| 出行 | 51,029 | 71,913 | 56,028 |
| 男 / 女 / 非二元 | 2,714(48.9%)/ 2,724(49.1%)/ 17(0.31%) | 2,475(48.4%)/ 2,533(49.5%)/ 23(0.45%) | 2,597(43.6%)/ 2,854(47.9%)/ 121(2.03%) |
| 0–11 岁 | 495(9.74%) | 477(10.1%) | 549(10.8%) |
| 12–17 岁 | 151(2.97%) | 159(3.36%) | 197(3.93%) |
| 18–34 岁 | 1,739(34.2%) | 1,514(31.9%) | 1,335(26.7%) |
| 35–54 岁 | 1,562(30.7%) | 1,480(31.3%) | 1,517(30.3%) |
| 55–74 岁 | 970(19.1%) | 941(19.9%) | 1,152(23.0%) |
| 75 岁及以上 | 165(3.25%) | 163(3.44%) | 267(5.33%) |
| 收入低于 2.5 万美元 | 410(8.07%) | 314(6.63%) | 354(7.07%) |
| 2.5 万–4.999 万 | 642(12.6%) | 588(12.4%) | 533(10.6%) |
| 5 万–7.499 万 | 744(14.6%) | 715(15.1%) | 646(12.9%) |
| 7.5 万–9.999 万 | 728(14.3%) | 657(13.9%) | 531(10.6%) |
| 10 万美元及以上 | 2,558(50.3%) | 2,460(51.9%) | 2,943(58.8%) |
| 家中 0 / 1 / 2 / 3 个及以上孩子 | 3,538(69.6%)/ 702(13.8%)/ 712(14.0%)/ 130(2.57%) | 3,297(69.6%)/ 586(12.4%)/ 580(12.2%)/ 250(5.28%) | 3,371(67.3%)/ 604(12.1%)/ 777(15.1%)/ 277(5.53%) |
百分比的分母并不统一,读的时候要看它除以谁。2017 年男性 2,714 人是表头 5,545 人的 48.9%;性别三档加总只有 5,455 人,还有 90 人没有落进这三档。2023 年非二元性别 121 人的 2.03%,是 121 除以表头 5,959,三档加总则是 5,572 人。年龄百分比对得上年龄各档之和:2017 年 0–11 岁 495 人占 5,082 人的 9.74%,不是占 5,545 人的 9.74%。家中 0 个孩子的 3,538 人也是这 5,082 人中的 69.6%。
三波表头相加,是 9,566 个家庭、16,620 人、178,970 次出行。这是三波表头的和,不是清洗后每个属性都有的人数。收入各档相加为 14,823 人,其中 10 万美元及以上 7,961 人,占 53.7%。年龄各档相加为 14,833 人,其中 18–34 岁 4,588 人,占 30.9%。这两个占比后面用来给命中率一个参照,它们不是论文自己报告的“总猜最大类”基线,也没有把 2021 年算进去。
年份之间的构成已经在变。18–34 岁从 2017 年的 34.2% 降到 2023 年的 26.7%,75 岁及以上从 3.25% 升到 5.33%,10 万美元及以上从 50.3% 升到 58.8%,非二元性别从 17 人升到 121 人。跨时间测试若变差,一部分来自出行习惯变了,一部分来自人群构成和标签本身变了。实地访问每次大约两个月,每个人的特征是在其被记录的出行上汇总的,不是全年轨迹。
实验有两种划分。混合分布划分把合并后的波次按 70%、10%、20% 分成训练、验证和测试,看的是同一套行为签名能不能稳定识别。跨时间划分用 2017 与 2019 训练和验证,用 2021 与 2023 测试。两种划分都在训练加验证部分做五折多标签交叉验证,最终数字报在固定测试集上。补充表里的均值和标准差是各折之间的。
预测的四个属性是年龄(6 档)、性别(3 档)、家庭收入(5 档)和家中孩子数(4 档:0、1、2、3 个及以上)。分析单位是人:出行先汇总成这个人的特征,再去猜这个人的属性。
一天的活动怎样变成一张有向图?
经典特征是日记里直接数出来的量,例如各种出行方式和活动目的的占比。更高阶的描述子要看行程之间的关系:目的是否分散、是否绕成环、是否中途换方式、是否有人同行。论文把一个人的活动链写成有向图。结点是活动目的,例如家、健身房、学校;边是按时间先后连接的出行。边可以标上方式,粗细表示观察期内出现的次数;虚线是已知、但这一天没有观察到的出行。
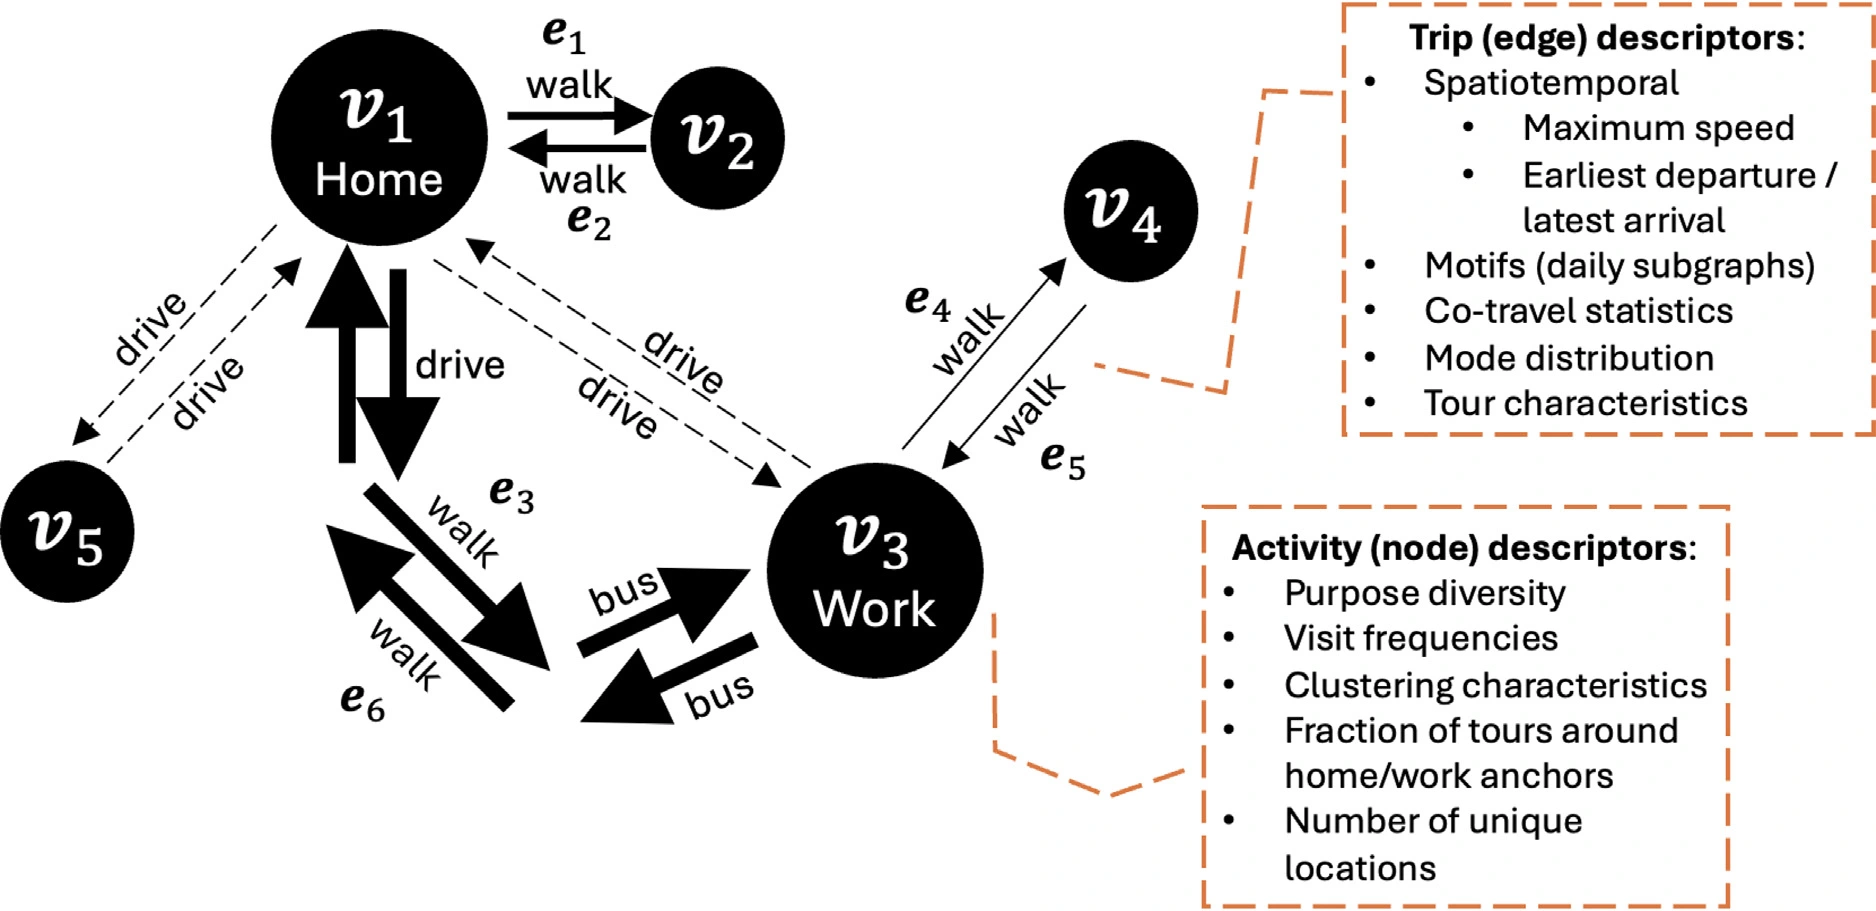
图 1|一张一天的出行图,结点、边和两类特征各管什么?
无字母子图。黑点是活动目的,实线是观察到的出行,虚线是当天未观察到的已知出行,箭头旁标步行、开车或公交。右侧两栏分别列出边的特征和结点的特征:边上看时间、速度、日基序、结伴、方式构成和行程结构;结点上看目的多样性、访问次数、聚类、围绕家或工作地的行程比例,以及独特地点数。这是示意图,不是某位受访者的统计结果。来源:原论文 Fig. 1。
结点层用四个量概括活动如何分布。把这个人所有起讫目的对的出行次数写成 x₁ 到 xₙ,总出行 T 是这些次数之和。香农熵看这些目的对占 T 的比例有多均匀,上限是 log₂(N);熵高表示没有挤在少数几种目的上。基尼系数看少数目的对是否占了大部分出行,越高越集中。全局聚类系数看三个目的之间有没有互相连成三角形,高则说明家、健身房、商店会串成一圈,而不只是从家出发再原路返回。平均局部聚类更照顾很少去的地点:连咖啡馆、孩子的学校这种辅助停靠,是否也被编进同一条行程。
边上看时间、基序和结伴。高峰占比的高峰是上午 7–9 时或下午 4–6 时,另外还有周末占比,以及最早、平均、最晚的出发时刻,行程时长、速度、距离的平均和最大。日基序把连续重复的目的先折叠掉,例如家、家、商店会收成家、商店,再归入六种每天反复出现的小子图。六种基序的占比再配一个基序熵,看这六种模式是否只用了其中一两种。
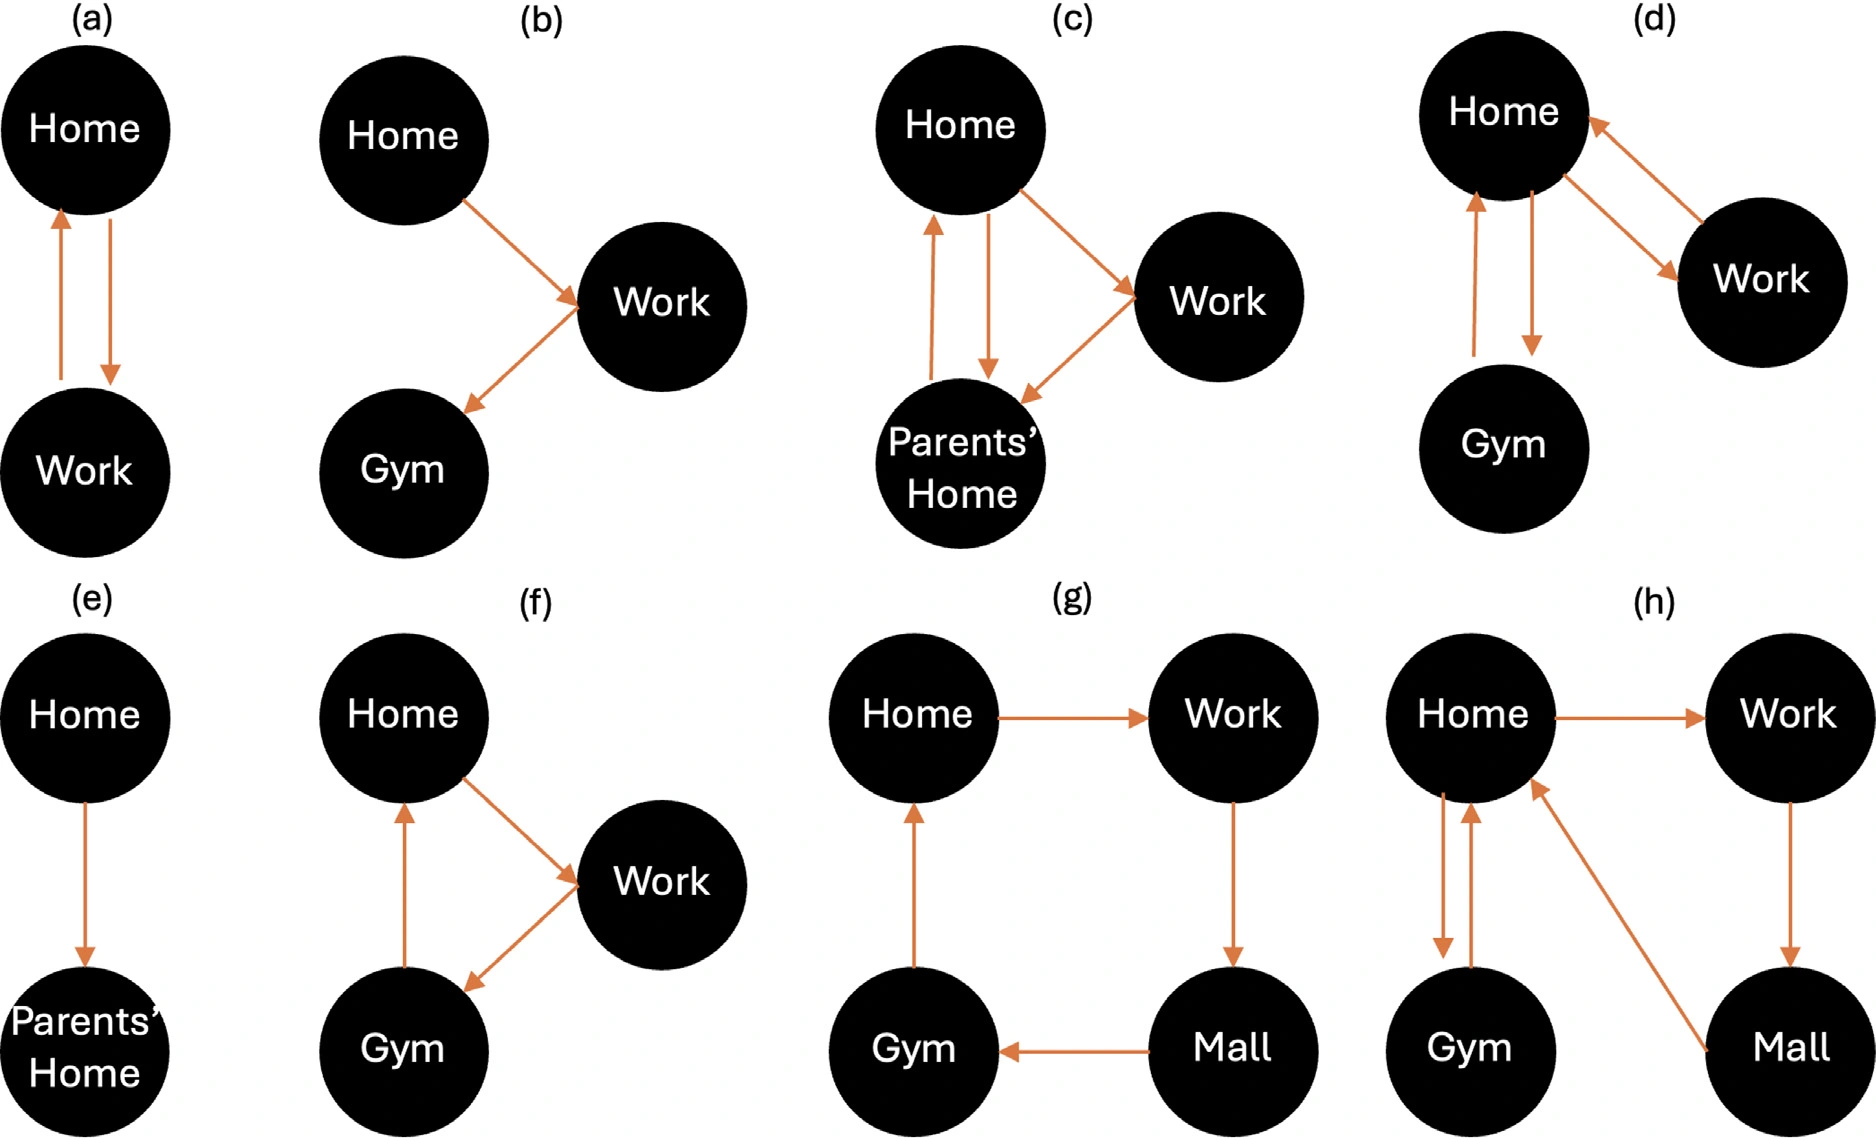
图 2|一天的行程被收成哪六种形状?
(a)往返:家与工作地之间来回。(b)链式:家连向工作地和健身房。(c)环链:家、父母家和工作地既有环又有外伸。(d、h)双环:家、工作地和第三个地点之间出现两组循环。(e)单程不返回:家到父母家,没有画返回。(f、g)单环:三个或四个目的围成一个圈。图中地点是示意,用来规定计数口径。来源:原论文 Fig. 2。
结伴把每次出行标成独自、与家庭成员、或与非家庭成员。结伴比例等于 1 减去独自出行占全部出行的比例,分母是出行次数。多方式比例的分母不同:它是至少使用两种方式的闭合行程数,除以锚在家或工作地的闭合行程数。图 3 给了一天的算法:7 次出行里结伴比例是 3/7;4 条闭合行程里多方式比例是 2/4。
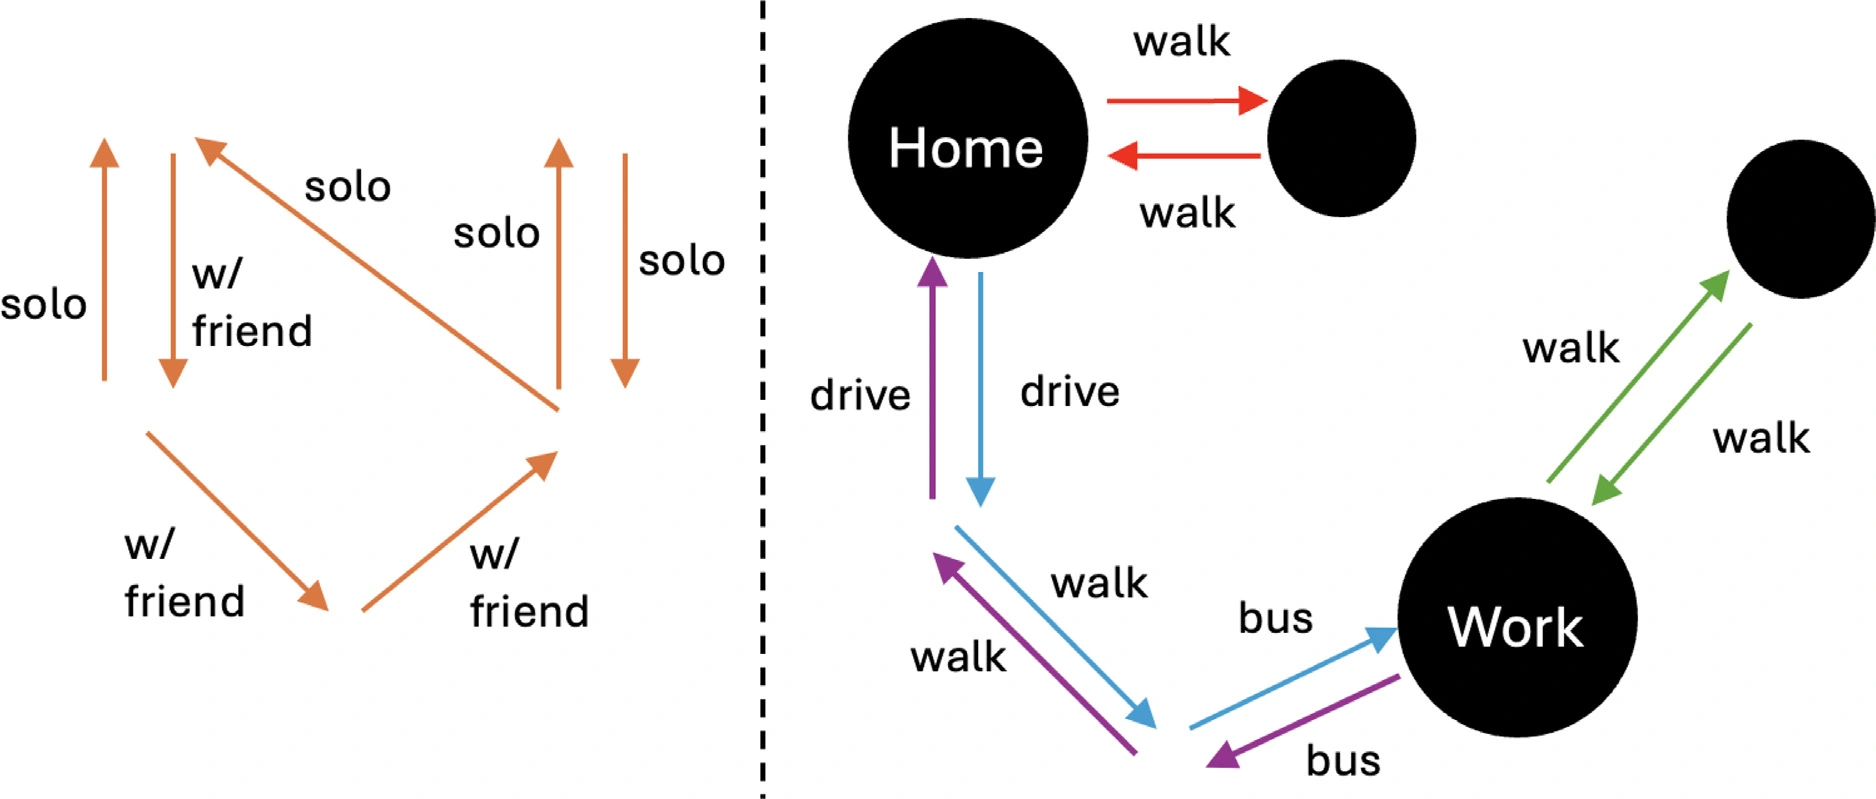
图 3|结伴比例和多方式比例的分母为什么不一样?
无字母子图。左图是一天的出行,箭头标独自或与朋友同行;论文给出的例子是 7 次出行、结伴比例 3/7,分母是出行次数。右图用颜色分开锚在家或工作地的闭合行程;例子是 4 条闭合行程、多方式比例 2/4,分母是闭合行程数。来源:原论文 Fig. 3。
后面的模型把特征分成嵌套的五组。经典组 C 是方式和目的占比。时空组 +ST 加上出发与到达时刻、时长、高峰与周末占比、速度和距离。多样性组 +D 加上目的熵、多方式行程比例,以及目的之间的三角闭合。基序组 +M 加上六种日基序的比例和基序熵。结伴组 +CT 加上独自、与家人、与非家人以及总体结伴比例。后一组永远包含前一组。结伴在大多数被动轨迹里拿不到:判断谁和谁同行需要跨设备关联或高频同步采样,常规隐私条件下做不到。因此结伴是调查级特征。
哪一种出行线索和社会人口属性贴得最紧?
图 5 画出与四个属性相关最强的那些特征,全部 p<0.001,条形向左为负、向右为正。年龄与上学目的占比的相关约为 −0.50,与独自开车约为 +0.30。更年轻的人更多坐公交、更多与 3 人及以上同车。样本包含 0–17 岁,上学本身就是低年龄档的直接线索;论文没有另行报告只在成年人中预测年龄。
收入与购物占比负相关,与高峰出行、公交、平均距离和最大速度正相关。正文用西雅图白领乘坐公交进入市中心来解释收入和公交的正相关。图里平均速度的条形在负侧,最大速度在正侧,所以高收入对应的是更长、最大速度更高的行程,不能读成每一段路都更快。性别的相关绝对值不超过 0.08:男性更多骑车、更多独自出行、更多工作出行;女性的行程停站更多,办事和购物更多。孩子数的相关最高约 0.5。孩子越多,与 3 人及以上同车、上学、校车和接送越多;独自开车、公交、步行、围绕工作地的行程、购物和行程时长越少。
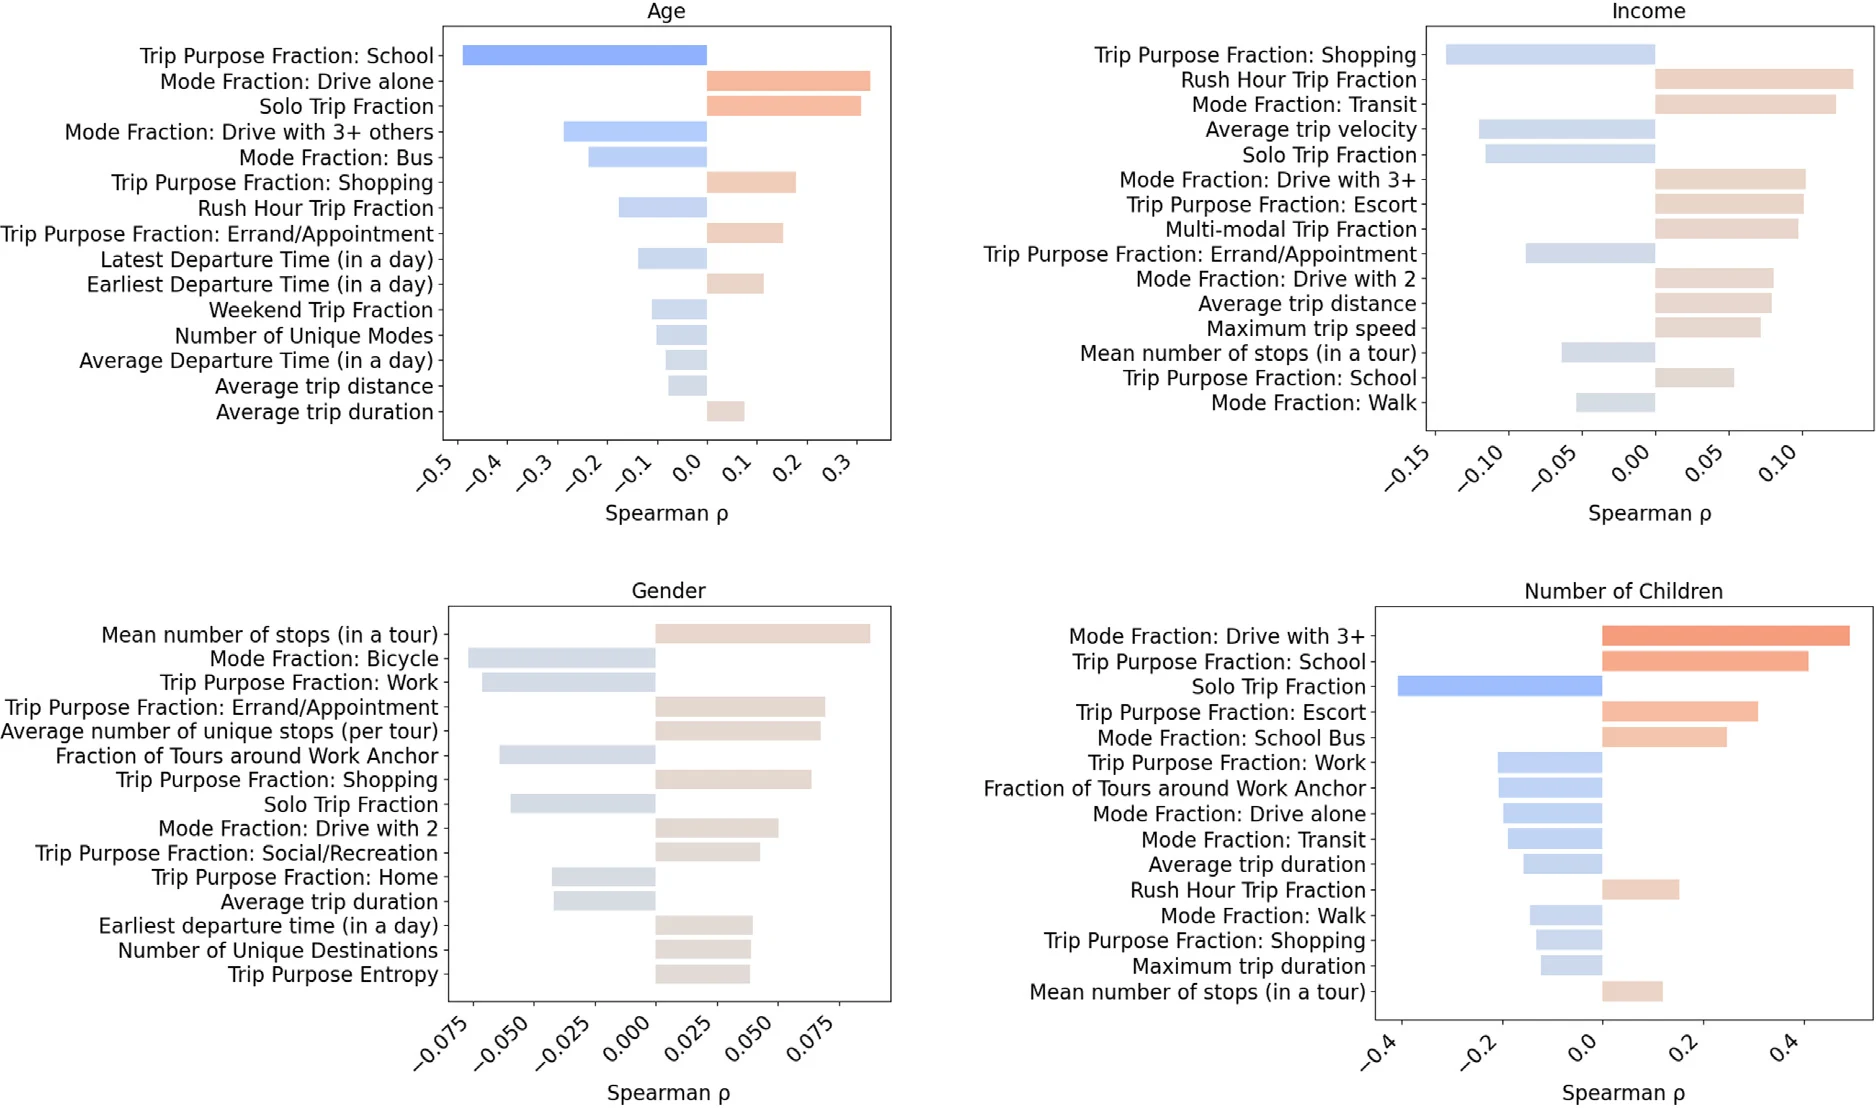
图 5|四个属性各自和哪些出行线索相关最强?
(左上)年龄,上学占比伸到约 −0.5,独自开车和独自出行伸到约 +0.3。(右上)收入,相关多在 ±0.15 以内,购物在负侧,公交、高峰和最大速度在正侧。(左下)性别,全部条形落在约 ±0.08 内。(右下)孩子数,与 3 人及以上同车和上学接近 +0.5,独自出行接近 −0.4。图中只保留相关绝对值最大的特征。来源:原论文 Fig. 5。
表 2 仍沿传统方向做线性回归:自变量是年龄、收入、性别和家庭规模,因变量是出行特征。年龄和家庭规模负相关很高,因为年纪较大的受访者往往孩子已经搬走、家庭更小,所以每个因变量做了两版,M2 去掉家庭规模。论文没有写明年龄和收入是按档位编码还是连续数值,系数只看方向,不能换算成每长一岁增加多少。
| 因变量 | 多方式比例 | 结伴比例 | 平均局部聚类 | 往返基序比例 |
|---|---|---|---|---|
| 年龄 M1 / M2 | 0.02∗∗ / 0.01∗∗ | −0.08∗∗ / −0.12∗∗ | −0.00 / 0.00 | −0.02∗∗ / −0.02∗∗ |
| 收入 M1 / M2 | 0.03∗∗ / 0.03∗∗ | 0.01∗∗ / 0.02∗∗ | −0.00∗ / −0.01∗ | −0.00 / −0.01 |
| 性别 M1 / M2 | 0.01 / 0.01 | 0.05∗∗ / 0.06∗∗ | 0.02∗∗ / 0.02∗∗ | −0.02∗∗ / −0.02∗∗ |
| 家庭规模 M1 | 0.03∗∗ | 0.12∗∗ | −0.01 | −0.01 |
| R² M1 / M2 | 0.01 / 0.01 | 0.22 / 0.16 | 0.002 / 0.001 | 0.004 / 0.003 |
两个星号表示 p<0.01,一个星号表示 p<0.05。截距依次约为 0.50、0.53、0.46、0.61、0.35、0.35、0.42、0.41,都是 p<0.01。结伴比例是唯一解释得较多的因变量:含家庭规模时 R² 为 0.22,去掉后降到 0.16,仍远高于另外三列的 0.001 到 0.01。方向是结伴随年龄下降,随收入、女性和家庭规模上升。多方式比例也随年龄、收入和家庭规模上升,但 R² 只有 0.01。
这里的 R² 回答的是“人口属性能解释多少出行差异”。它低,说明出行的大部分变异来自人口属性以外的因素。后面的分类器把方向倒过来,用出行去猜人。0.22 不是猜中家庭规模的比例,p<0.01 也不表示关系很强。
特征一层层加上去,命中率提高多少?
分类器要同时看两件事。top-1 准确率是概率最高的那一档正好等于真值的比例,分母是测试的人。类别不均衡时,它会被最大的那一档抬高,所以还要看 AUROC:随机排序是 0.5,完美排序是 1;多类别时用一对多的宏平均,每一档权重相同。图 6 是多任务神经网络在嵌套特征上的五折分布,横轴画到 +M。结伴组 +CT 的均值在补充表 C.3 至 C.10。
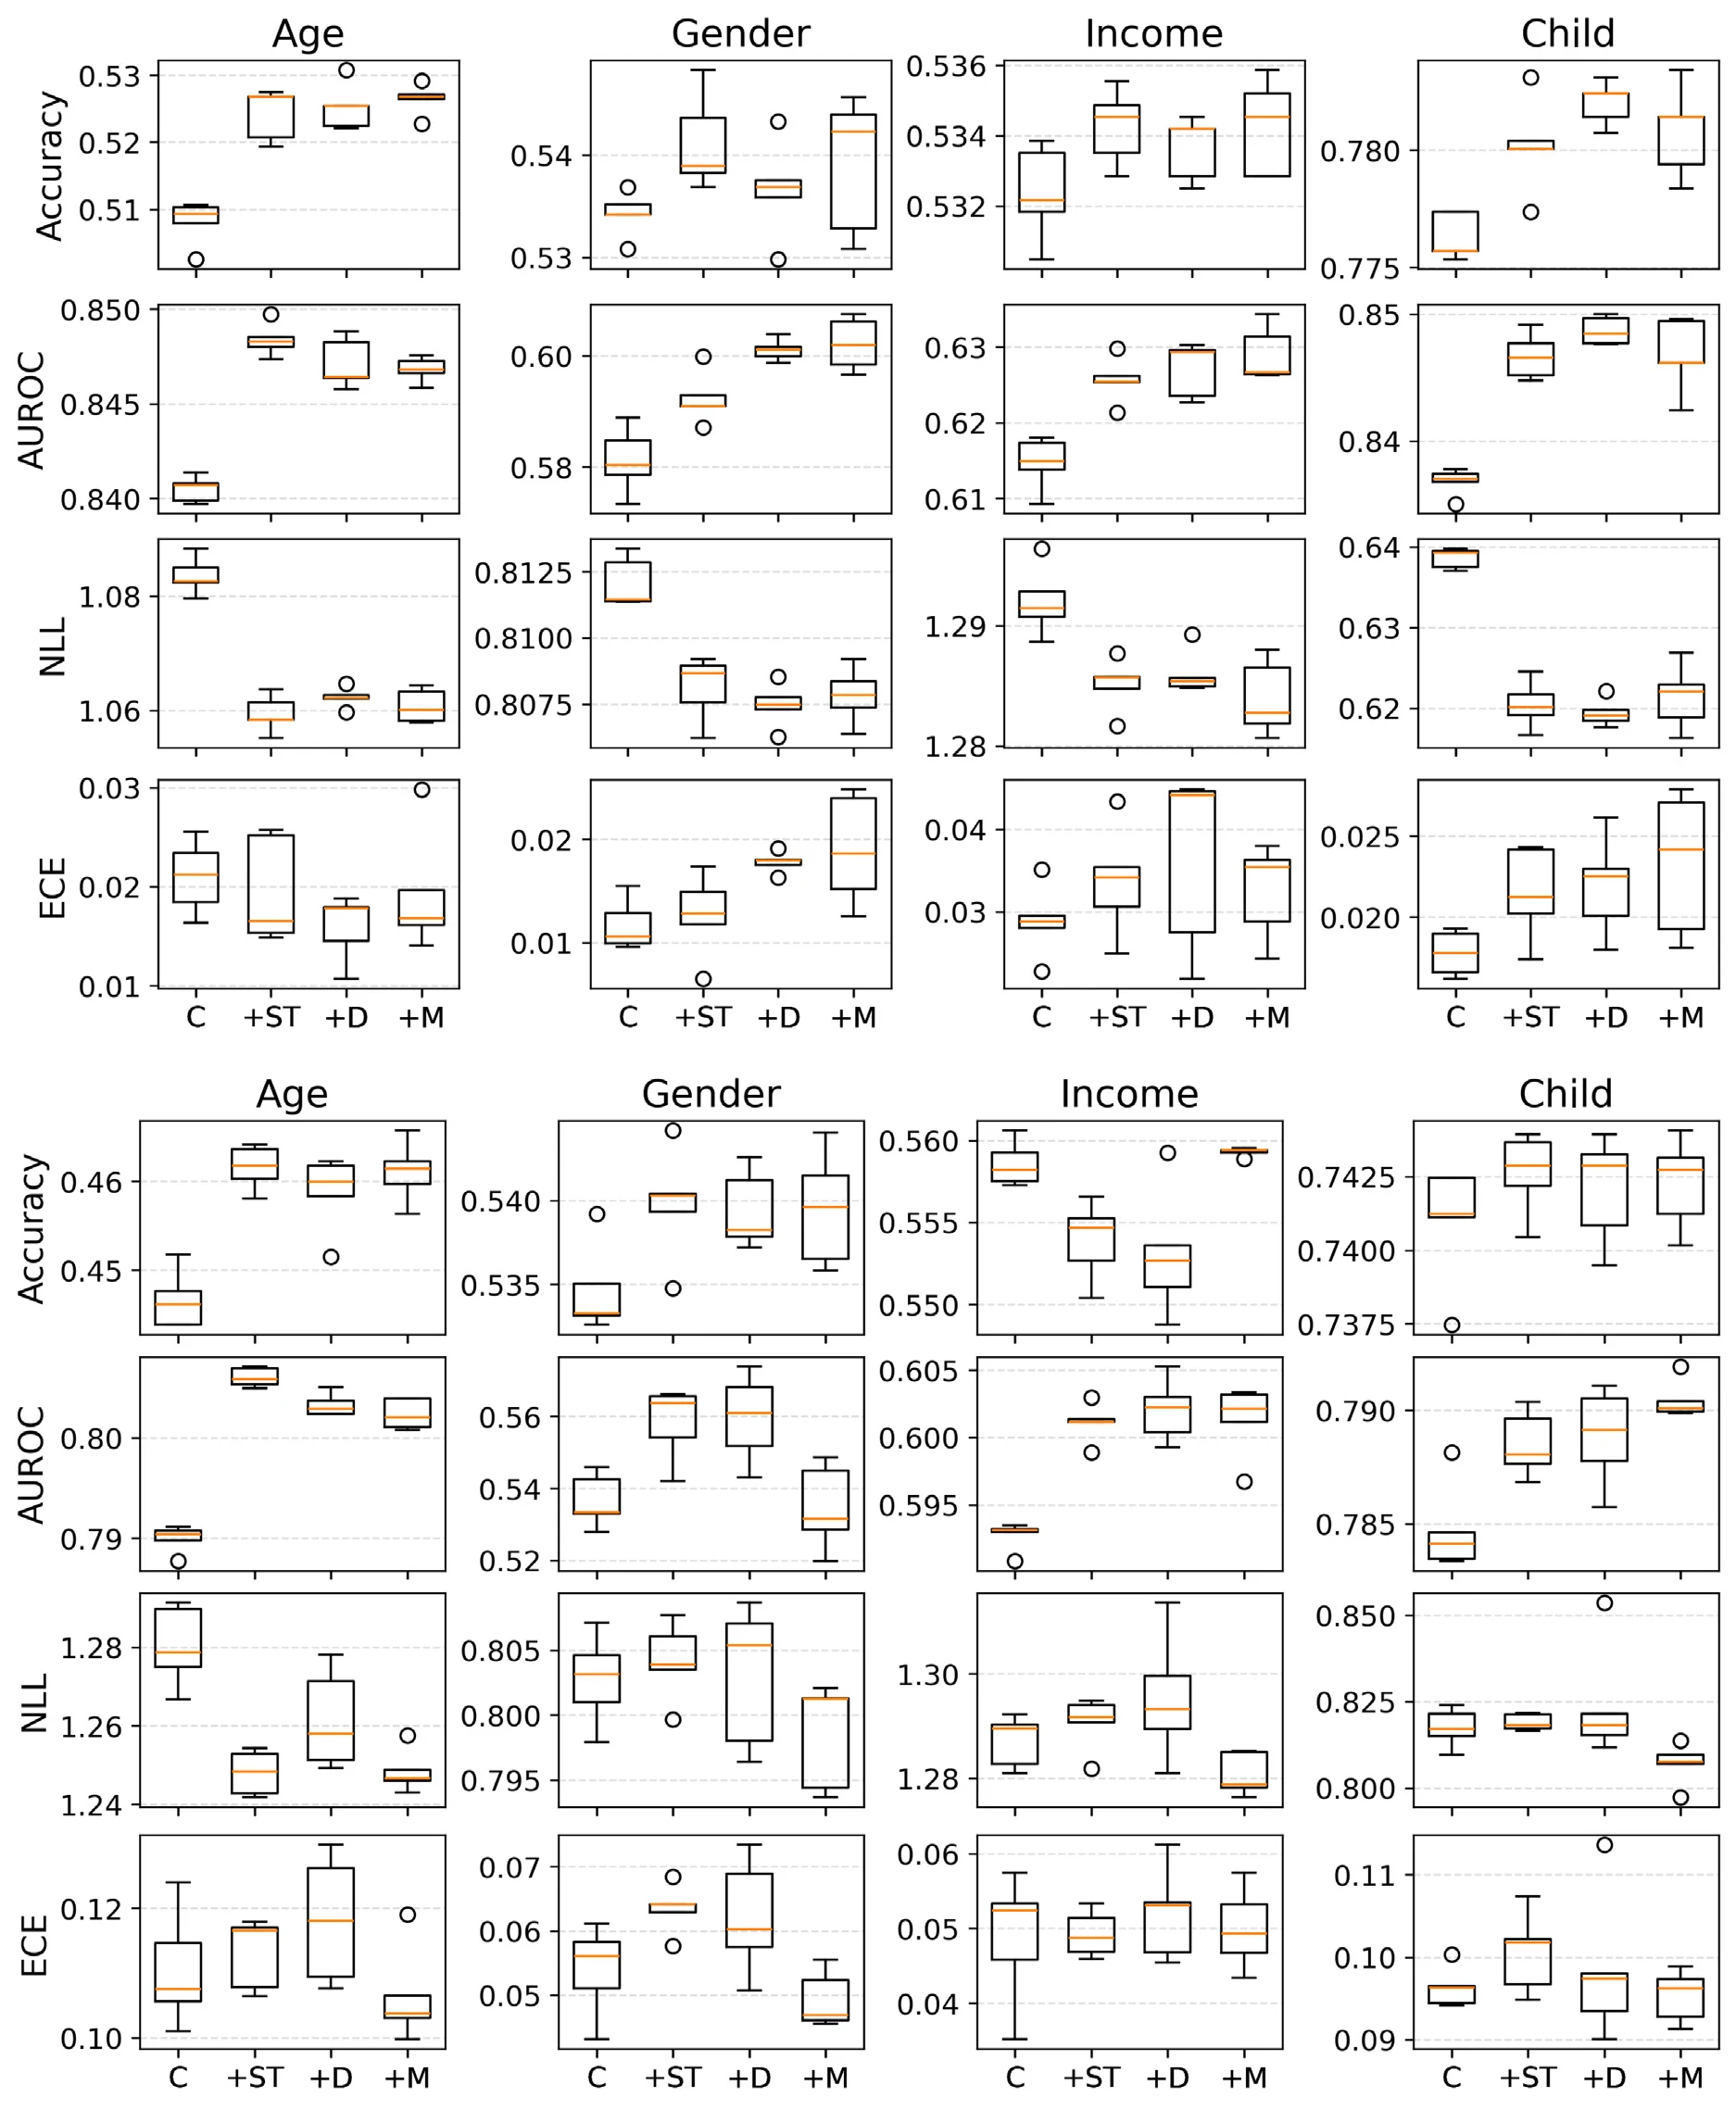
图 6|同一套神经网络,特征变多以后四项指标怎么动?
上四行是混合分布划分,下四行是用 2017 与 2019 训练、用 2021 与 2023 测试。四列依次为年龄、性别、收入、孩子数。四行依次为 top-1 准确率、AUROC、负对数似然、期望校准误差。横轴 C、+ST、+D、+M 是嵌套特征组,后一组包含前一组。箱子是各折的分布,橙色线是中位数。准确率和 AUROC 越高越好,后两行越低越好。来源:原论文 Fig. 6。
混合划分、多任务神经网络、五折均值:
| 属性 | 准确率 C → 该网络最高 | AUROC C → 该网络最高 |
|---|---|---|
| 年龄 | 0.508±0.003 → +M 的 0.526±0.002 | 0.840±0.001 → +CT 的 0.850±0.001 |
| 性别 | 0.534±0.002 → +ST 与 +CT 的 0.541 | 0.581±0.006 → +CT 的 0.611±0.002 |
| 收入 | 0.532±0.001 → +CT 的 0.538±0.000 | 0.615±0.003 → +CT 的 0.639±0.003 |
| 孩子数 | 0.776±0.001 → +CT 的 0.785±0.002 | 0.837±0.001 → +CT 的 0.854±0.002 |
年龄的负对数似然从经典特征的 1.084±0.003 降到 +CT 的 1.048±0.002。期望校准误差没有跟着特征变多而稳定下降:年龄在 +D 时最低,为 0.016±0.003,+CT 又回到 0.018±0.006。
把这些命中率放回表 1 的人数占比里看。人数最多的年龄档是 18–34 岁,三波合计 4,588/14,833,占 30.9%;神经网络的 0.508 到 0.526 明显高于这一档。家中 0 个孩子的人占 67.3% 到 69.6%,孩子数的 0.776 到 0.785 高于这个多数档,大约高出 8 到 11 个百分点,但两者的分母不同:一个是三波有孩子数记录的人,一个是五折测试的均值。收入几乎贴着多数档。10 万美元及以上占 7,961/14,823,即 53.7%;神经网络的收入准确率是 0.532 到 0.538。随机森林在多样性特征上可以到 0.563±0.001,比 53.7% 高 2.6 个百分点。图 6 比较的是这一个多任务网络在不同特征组之间的差别,随机森林在收入和孩子数上还可以更高。
跨时间之后,年龄明显更难,收入的准确率反而更高,这和 2023 年最高收入档升到 58.8% 的方向一致。2021 年人数缺失,不能把 58.8% 当成 2021 与 2023 合并测试集的多数类占比。神经网络的五折均值是:
| 属性 | 跨时间准确率 C → 该网络最高 | 跨时间 AUROC C → 该网络最高 |
|---|---|---|
| 年龄 | 0.447±0.003 → +ST 的 0.462±0.002 | 0.790±0.001 → +ST 的 0.806±0.001 |
| 性别 | 0.535±0.003 → +ST 的 0.540±0.003 | 0.537±0.007 → +D 的 0.560±0.012 |
| 收入 | 0.559±0.001 → 经典特征本身最高 | 0.593±0.001 → +D 的 0.602±0.002 |
| 孩子数 | 0.741±0.002 → +ST 与 +CT 的 0.743 | 0.785±0.002 → +CT 的 0.791±0.001 |
性别的跨时间 AUROC 在经典特征下只有 0.537,接近 0.5;加到基序时又落到 0.535±0.012。收入的跨时间准确率在经典特征上已经是 0.559,继续加特征没有更高。梯度提升在跨时间年龄上可以到准确率 0.468±0.000、AUROC 0.806。支持向量机预测跨时间收入,只用经典特征就是全部模型里最高的准确率 0.560±0.000。
正文统计,四个属性、两种划分、四项指标共 32 个最优格子里,有 9 个来自比 +M 或 +CT 更简单的特征组,而且更多出现在跨时间、训练人数更少的时候。相关特征变多以后,收益更难稳定估计。混合划分里训练更多、训练和测试更像,复杂特征才更经常占优。梯度提升树因为自身的正则,在跨时间设置里没有神经网络那么容易把噪声也学进去。
报出的把握,和实际命中对齐了吗?
规划部门如果只拿一个最可能的类别去算,等于假设这次分类是对的。概率要用,就得先看它是否诚实:模型若给 10 次预测都报 0.6 的把握,大约应有 6 次正确。期望校准误差(expected calibration error,ECE)把最高类别概率切成 15 个等宽箱,用每个箱的人数占全部测试人数的比例,去加权“箱内准确率减箱内平均把握”的绝对值。ECE 为 0 表示各箱对齐。它只看差距的大小,模型过于自信和过于保守都会被罚。负对数似然则惩罚把很低的概率放在正确类别上,越低越好。可靠性图把箱内准确率画成置信度的函数,对角线是完美校准;点在对角线上方是偏保守,下方是过于自信。灰色直方图才表示每个箱里有多少人,单看曲线不知道人集中在哪里。
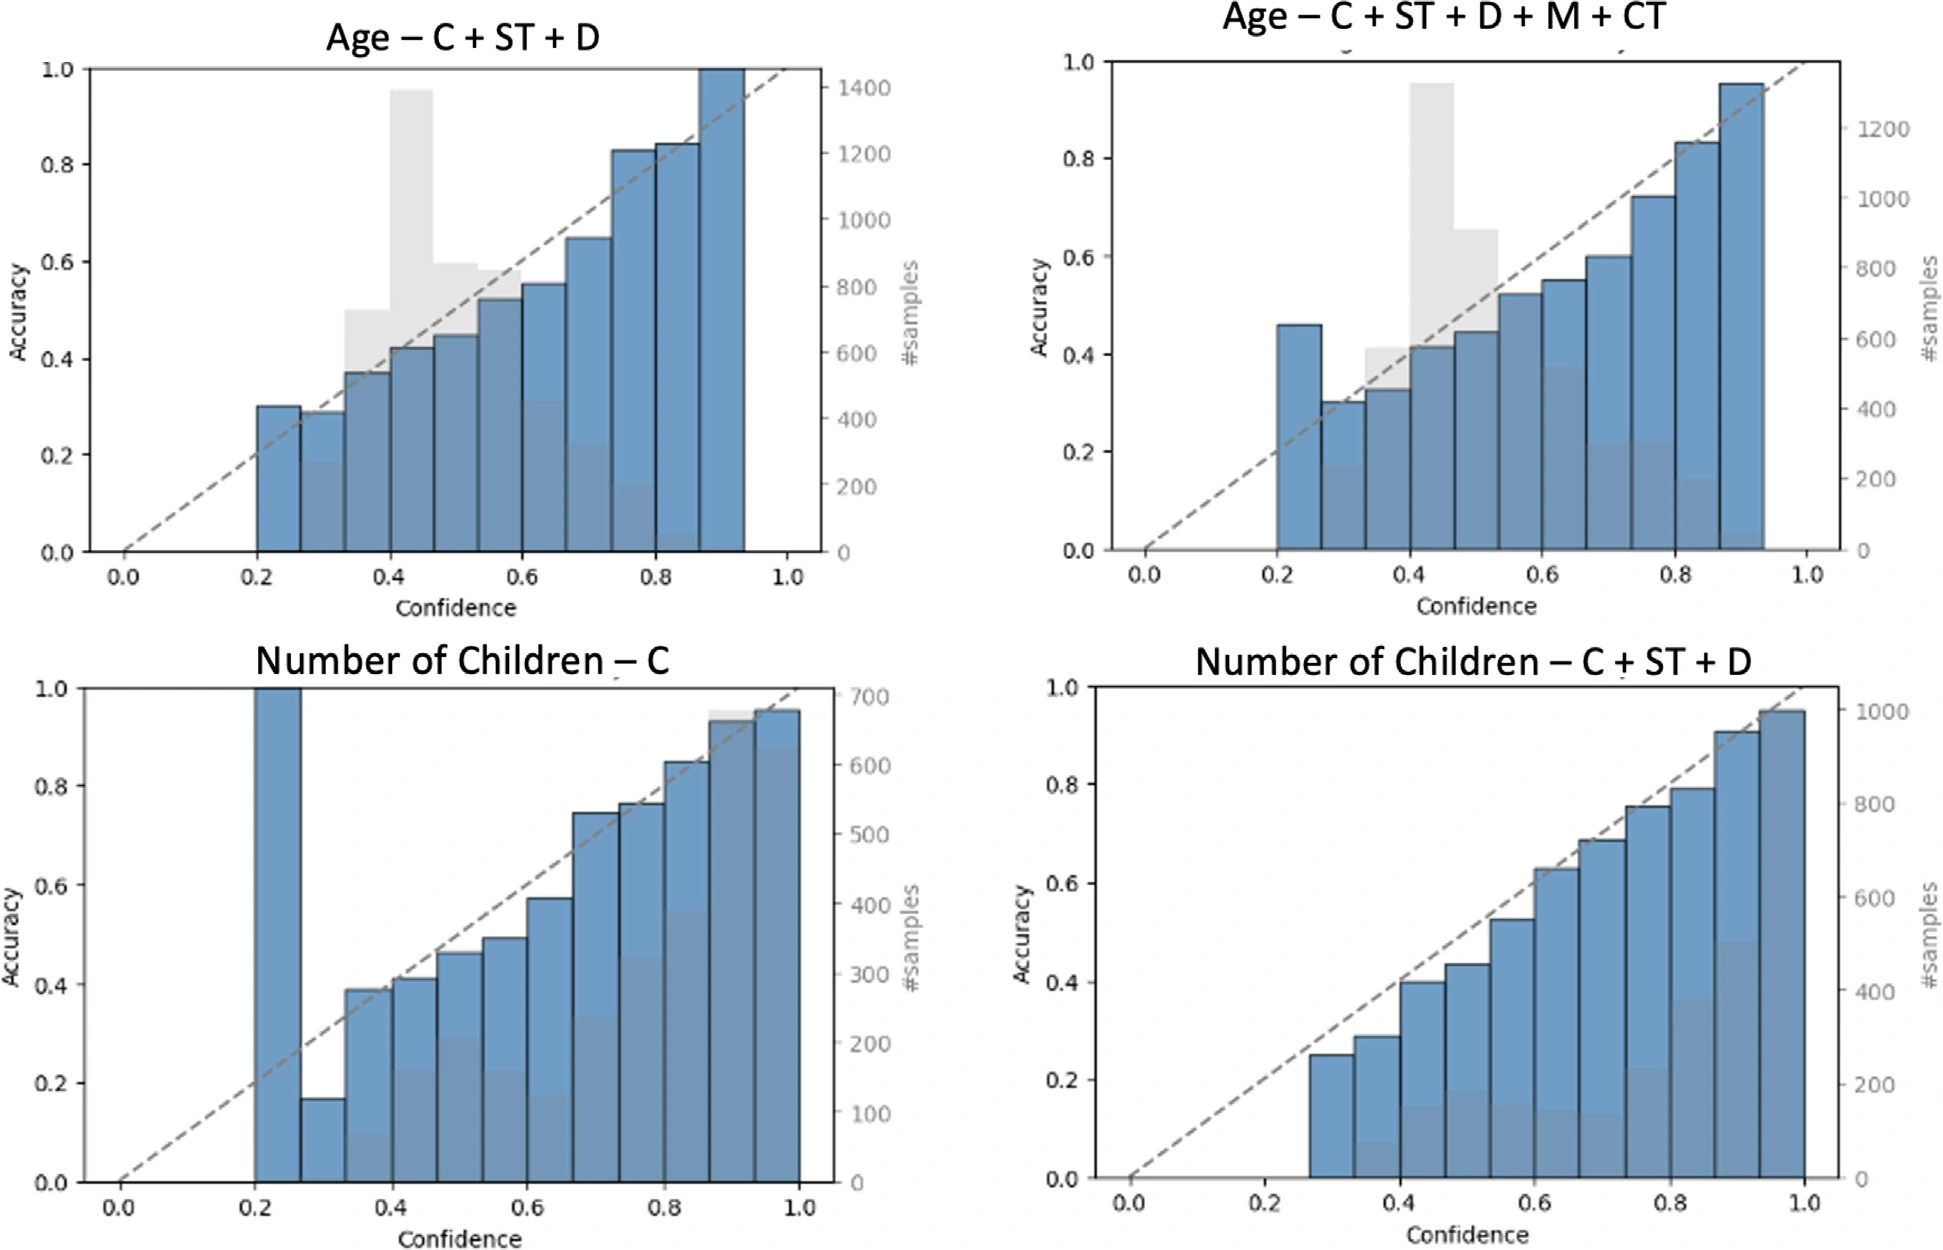
图 7|模型说的把握,和这个把握下的实际命中差多少?
无字母子图,四个面板。上排是混合划分的年龄任务,左为经典加时空加多样性,右为全部特征。下排是跨时间划分的孩子数任务,左为只用经典特征,右为经典加时空加多样性。横轴是最高类别概率,左纵轴是该箱准确率,蓝色柱对应 15 个等宽箱,虚线是对角线,右纵轴灰色柱是每个箱的人数。上排高把握一端靠近对角线;下排左侧在低把握处仍有很高的准确率,而且该箱人数不少。来源:原论文 Fig. 7。
偏保守时,准确率和 AUROC 可以保持,ECE 仍会上升,因为差距的绝对值变大了。这种图案在加特征时出现,在减特征时也出现。跨时间预测年龄时,神经网络的 ECE 约为 0.106 到 0.118;随机森林加到结伴特征后降到 0.013±0.001。校准同时取决于特征组和模型种类。
论文把校准说成下游计算的输入,而不是另一张成绩单。若富集后的轨迹要进入方式选择模型,类别概率可以当作权重或模拟次数,让属性不确定传到估计结果里。做可达性和公平性时,按收入分组的指标也可以写成期望值或区间,而不先把每个人硬分成低收入或高收入。
四个属性一起学,会在小样本和换年份时更稳吗?
多任务学习让年龄、性别、收入和孩子数共用前面的表示,各自只留一个小的输出头。相关任务共用参数,等于用数据本身做正则,达到同样准确率所需的标注可以少一些。本文的共享干线是两层全连接:256 个单元再到 128 个单元,中间是 ReLU 和丢弃率 0.3。四个头用 softmax 输出类别概率。四个任务的交叉熵等权相加。为了把“共用参数”和“网络更大”分开,四个单任务网络各用 64 再到 32 个单元,合起来的宽度与共享干线大致相当,差别在于表示是一起学还是分开学。
验证损失选出的训练设置是学习率 5×10⁻⁵、批大小 64、权重衰减 10⁻⁴,最多 200 轮,验证损失连续 20 轮不降就停止。可选的逐任务层归一化在每个头之前单独做,避免四个任务共用同一套归一化统计。
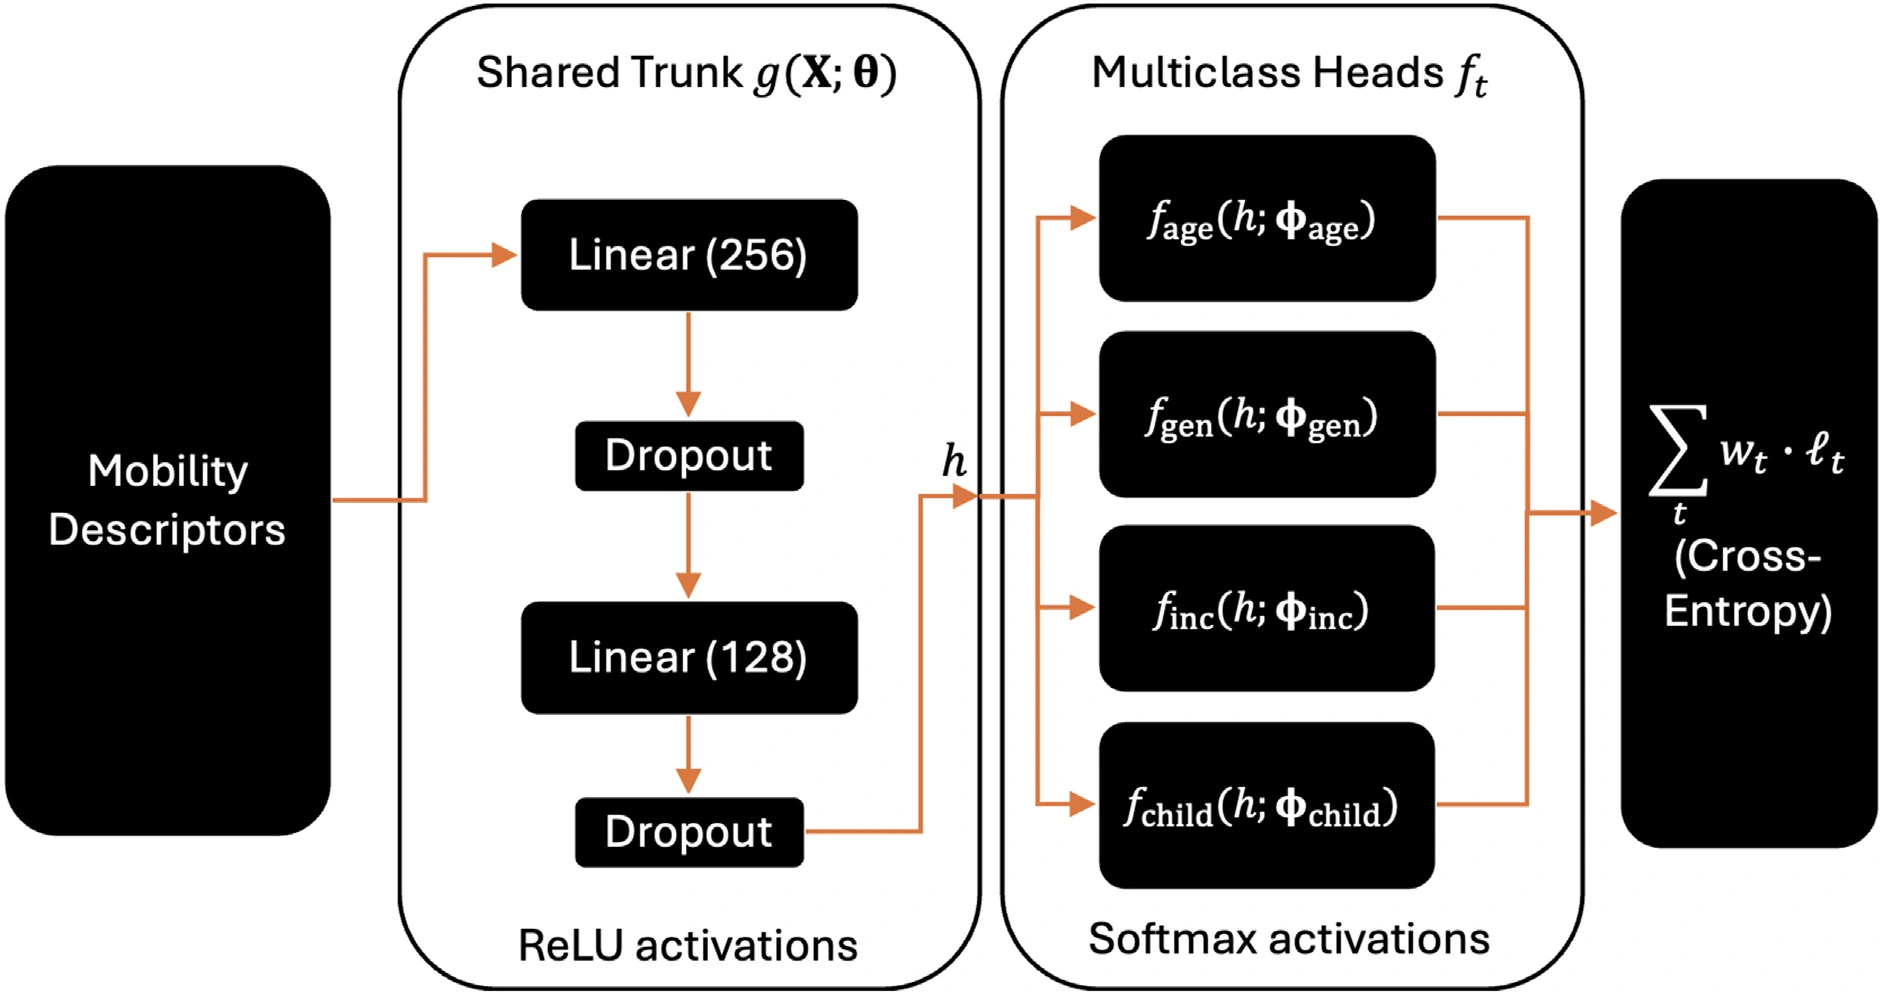
图 4|四个属性怎样共用一段表示?
无字母子图。左侧是出行描述子,中间共享干线先线性映射到 256 维并丢弃,再映射到 128 维并丢弃,激活是 ReLU。右侧四个头分别输出年龄、性别、收入和孩子数的类别概率,损失是四项交叉熵的等权之和。来源:原论文 Fig. 4。
小样本实验把训练集随机抽到原来的 1、0.1、0.01 和 0.001,验证集和测试集不动。为避免小样本过拟合,这里只用经典特征和时空特征。对照有两个:结构匹配的单任务网络,以及条件变分自编码器。后者要同时学潜变量和解码器,标注少时更容易欠拟合。图 8 的每个点是四个任务的平均。
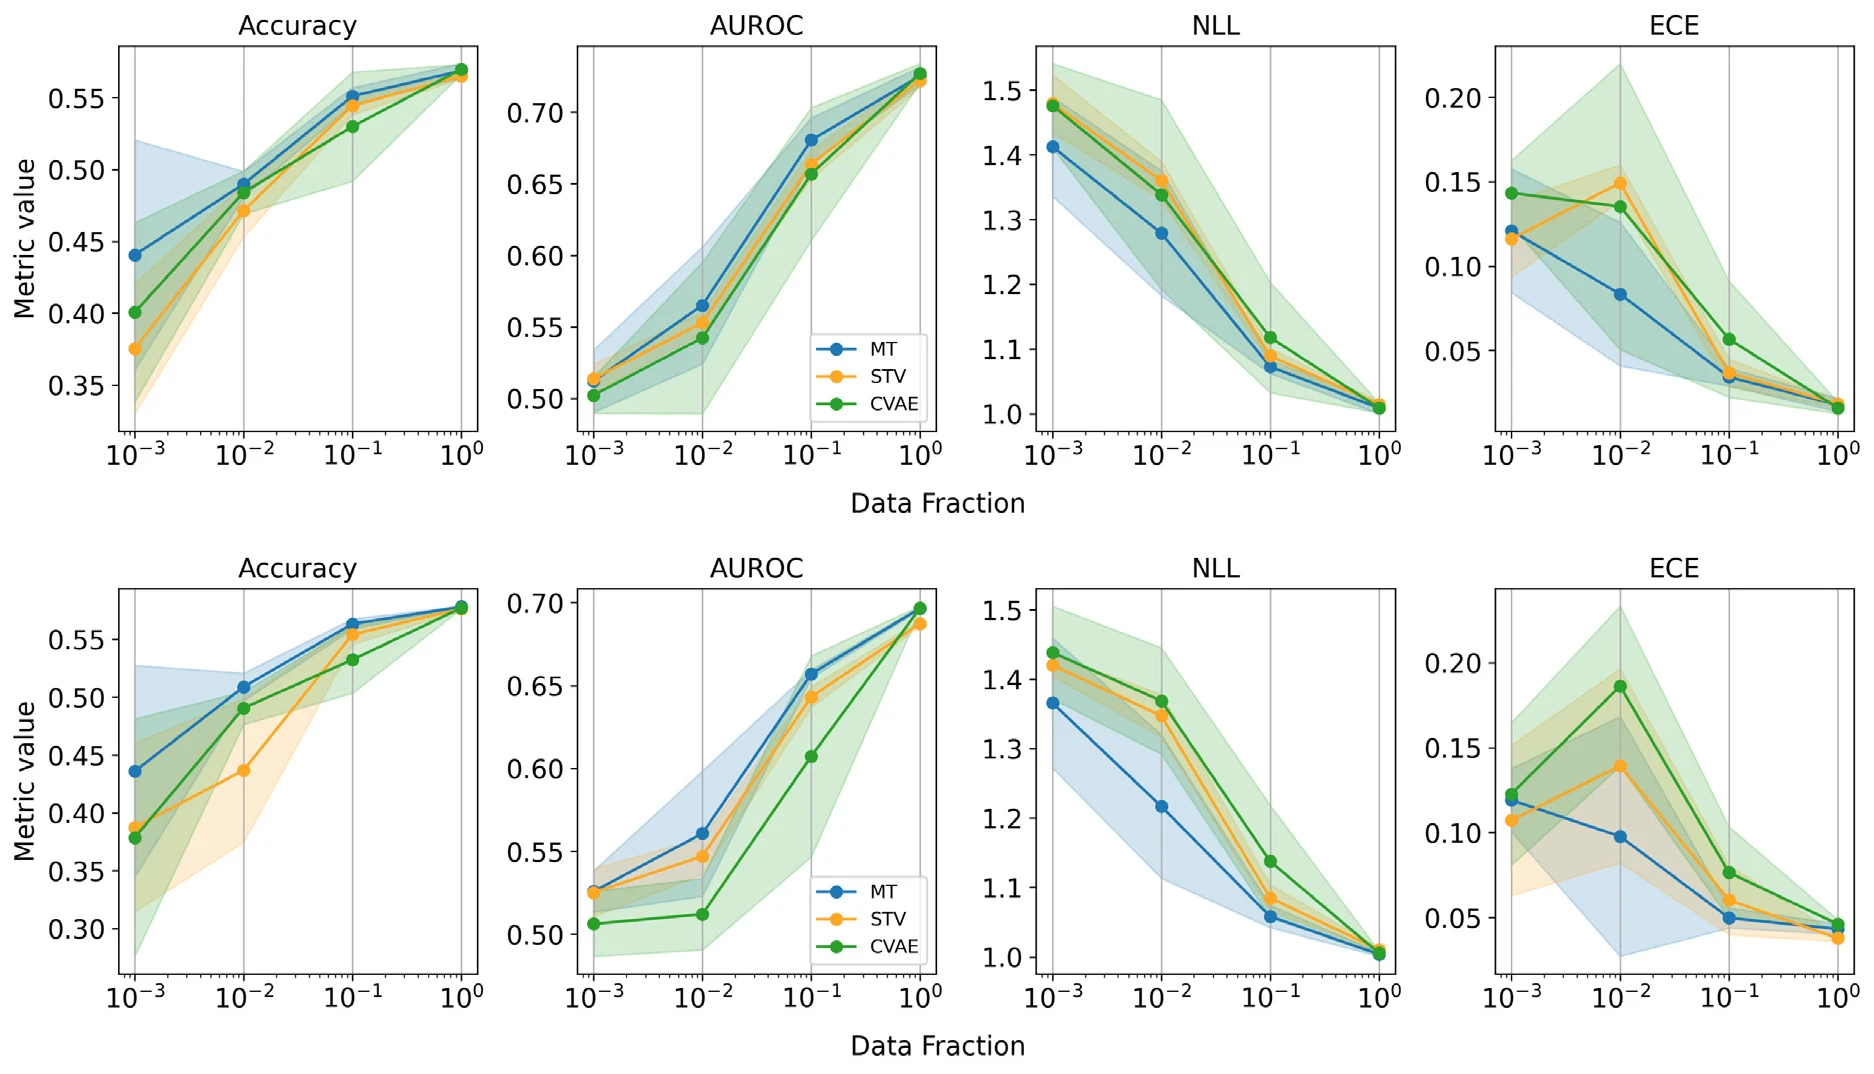
图 8|训练数据只剩 1% 或 0.1% 时,谁更稳?
上排是混合分布划分,下排是 2017 与 2019 训练、2021 与 2023 测试。四列依次为四个任务平均后的准确率、AUROC、负对数似然和 ECE。蓝色是多任务网络,橙色是单任务网络,绿色是条件变分自编码器,色带是波动范围。横轴是训练数据比例,从 10⁻³ 到 10⁰。全量时三条线靠近;比例降到 0.01 和 0.001 时,蓝色在准确率、AUROC 和负对数似然上更占优,色带也更宽。来源:原论文 Fig. 8。
全量数据上,三种方法的准确率和 AUROC 接近。训练比例下降后,多任务网络在可分性和概率指标上优于两个对照。跨时间设置里,准确率和 AUROC 的优势并不均匀,负对数似然的改善比混合划分更明显:共用表示减轻了分布变动时的过度自信。条件变分自编码器在小样本和中等样本上掉得更快。
结论里把这句话收紧了。对行为重叠较弱、或标签噪声较大的属性,任务会互相干扰,多任务模型会略逊于专门的单任务网络。共用表示能否帮忙,取决于任务之间有多相关,也取决于共享部分和各自输出头之间的平衡。图 8 的平均线因此不能读成每一个属性都在每一个比例上受益。
训练时间的方向和参数量相反。多任务模型更大,但干线只走一次;四个单任务网络要做四次前向和反向。图 A.10 里,全量数据时单任务曲线超过 80 秒,多任务曲线更低;误差线是各折的标准差。
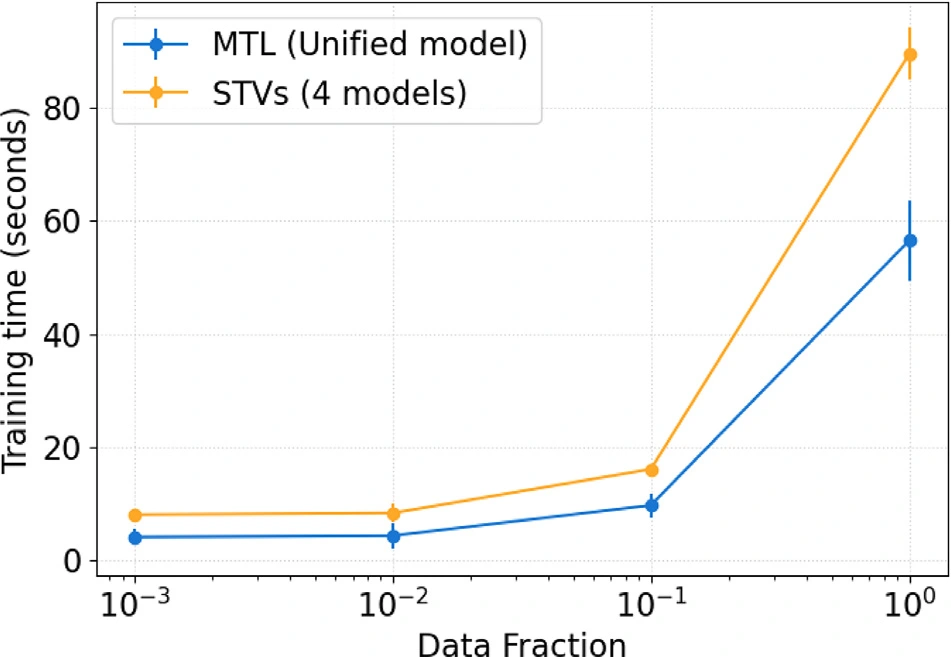
图 A.10|共用干线以后,训练时间为什么更短?
无字母子图。横轴是训练数据比例的对数刻度,纵轴是秒。蓝色是统一的多任务模型,橙色是四个单任务模型合计。全量时橙色超过 80 秒,蓝色位于 40 秒到 80 秒之间。误差线是交叉验证各折的标准差。来源:原论文 Fig. A.10。
目的若改由手机轨迹推断,会掉在哪里?
调查日记里的目的是受访者自报的,手机轨迹里的目的是推断的。推断更粗,也会系统性标错。本文用同时有调查记录和原始轨迹的子样本做了两个对照,训练人数和网络结构保持不变。这个子样本有多少人,论文没有给出。
第一条只改粗细:把调查的 14 类目的合并成推断流程使用的 7 类,标签仍是真值。各任务平均后,准确率下降约 0.003,AUROC 下降约 0.011,负对数似然上升约 0.017,ECE 上升约 0.0009。第二条把每个人的目的占比换成其轨迹推断出的占比,并把调查标签也收到同样的 7 类,从而把“词表变粗”和“标签有偏差”分开。偏差使 AUROC 和负对数似然变差,幅度与变粗相近;校准的变化仍然小。
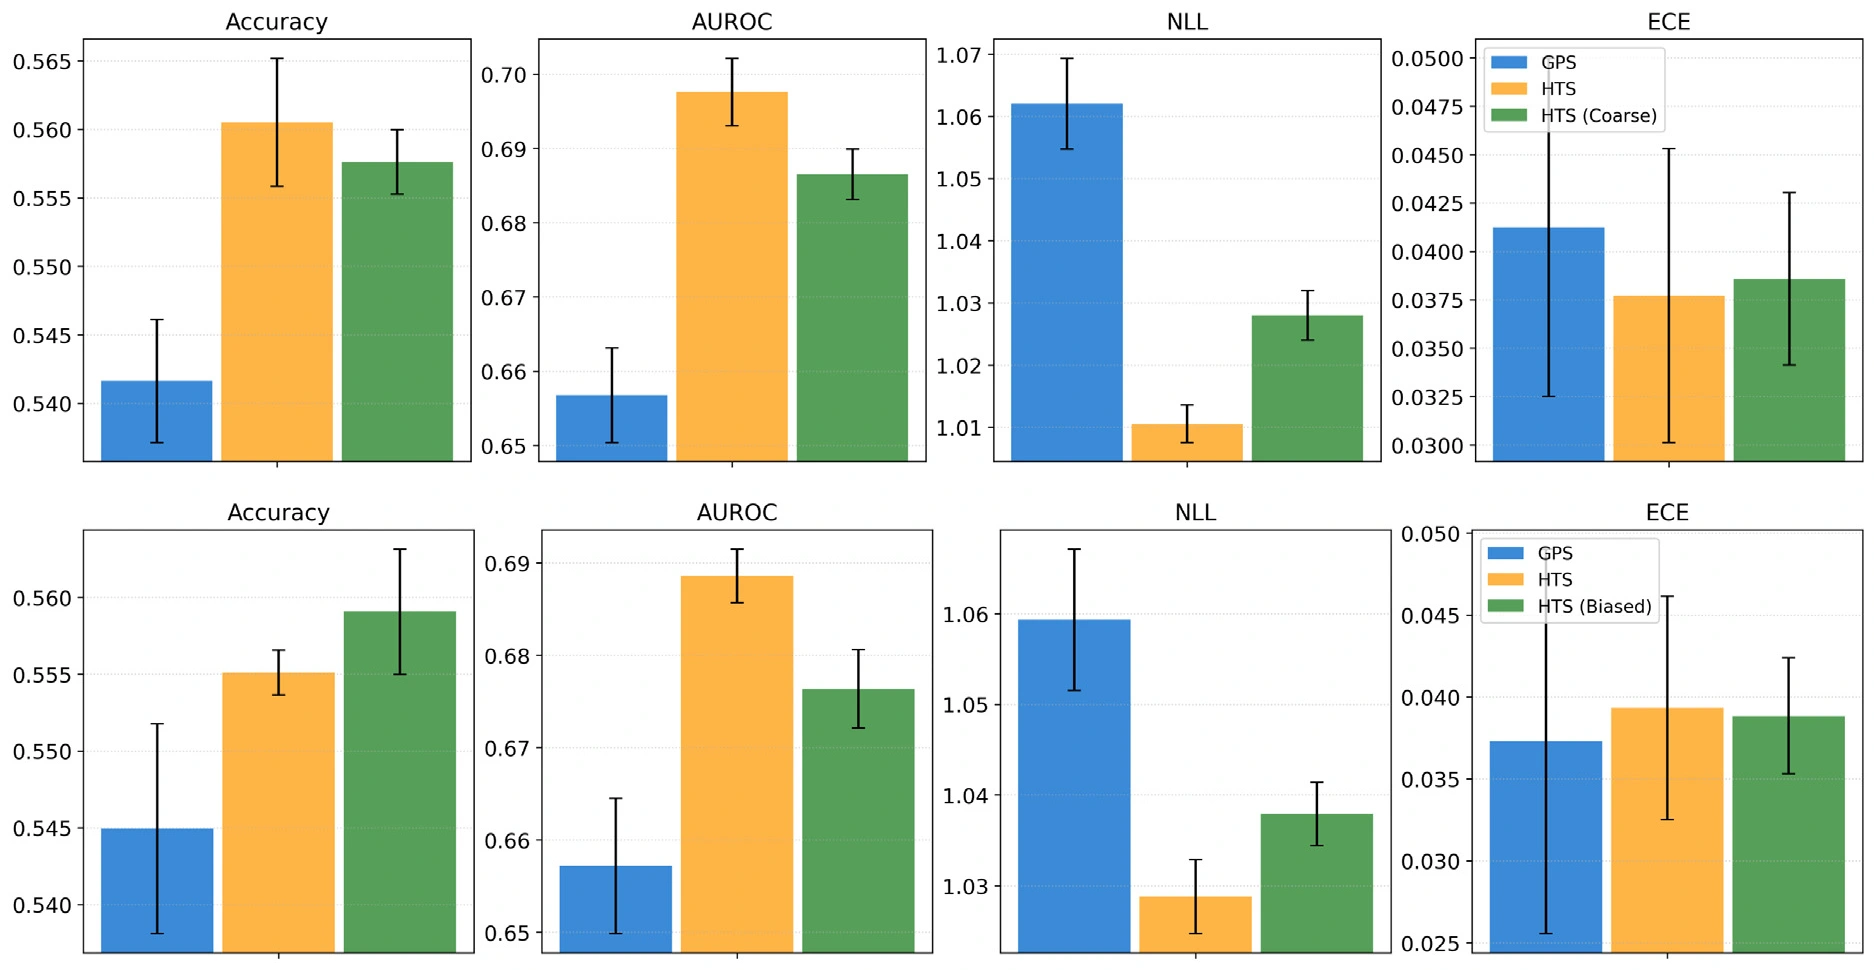
图 9|目的从 14 类收到 7 类,以及改用轨迹推断的目的,四项指标掉多少?
上排是保留真值、只把 14 类收成 7 类。下排是在同样的 7 类词表上,换入轨迹推断的有偏目的。四列依次为各任务平均的准确率、AUROC、负对数似然和 ECE。蓝色是 GPS,橙色是调查标签,绿色在上排是收粗后的调查标签、在下排是带偏差的调查标签。误差线画出任务之间的波动。橙色和绿色在准确率上很接近,蓝色更低、负对数似然更高。来源:原论文 Fig. 9。
轨迹侧的处理写在附录。停留点用距离、速度和时间阈值切开,再用固定半径 200 米的 DBSCAN 聚类。家是一天中首次出行最常见的起点,工作地是工作日早晨反复出现、且不同于家的目的地。其他活动靠反向地理编码和周边兴趣点;没有足够把握时,退回家或工作地的邻近,或标成其他。方式只根据平均速度和最大速度区分机动与非机动,分不出小汽车和公交,拥堵会把开车标慢,稀疏采样会把速度抬高。结伴不在这条流程里。
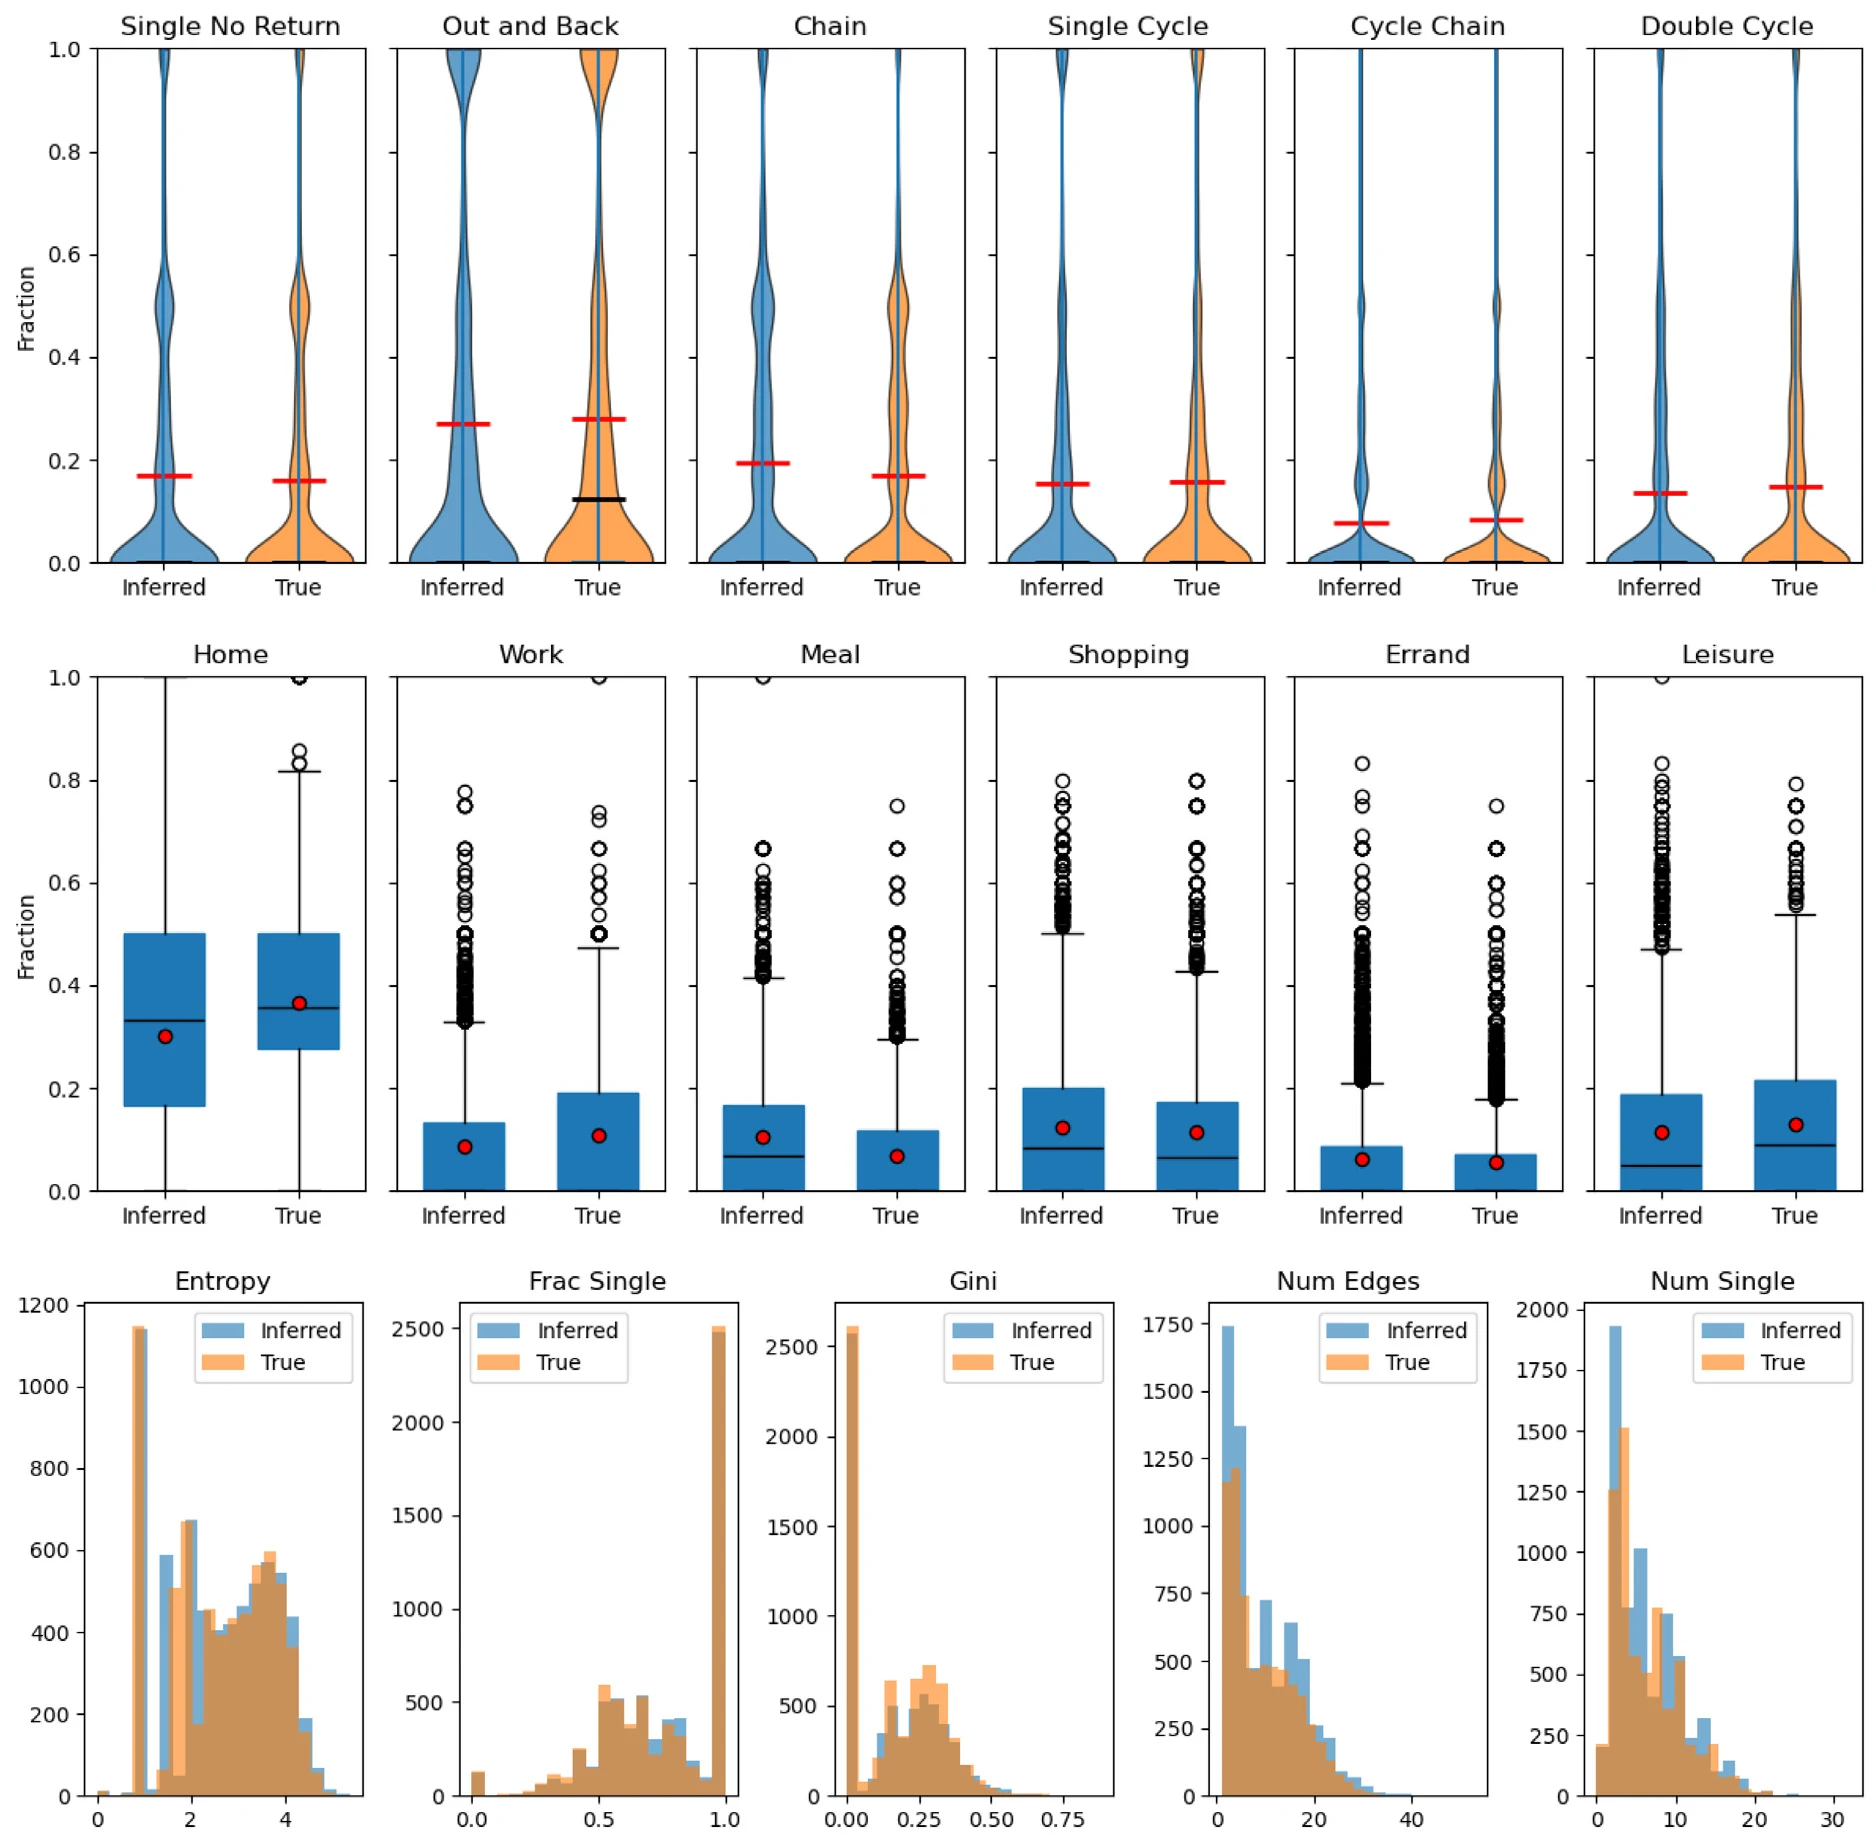
图 B.11|推断出的轨迹,在基序、目的和多样性上偏离调查真值多少?
(a)六种日基序的比例,蓝为推断、橙为调查。往返型在 0 和 1 两端都有人,环链和双环大多贴近 0,两侧形状接近。(b)家、工作、外出就餐、购物、办事和休闲的占比。家和工作在推断中相对更低,就餐、购物和办事相对更高。(c)熵、基尼系数、边数和独特目的数等多样性指标。推断轨迹的多样性略低,不同活动种类略少,与更粗的词表以及误分类把多种活动并到一起相一致。来源:原论文 Fig. B.11。
因此,部署到被动轨迹上时,可预期的损失来自两处:词表从 14 类收到 7 类,以及推断误差。图 9 给的是这一个地区、这一条子样本上的经验幅度。家和工作被低估、购物和办事被高估,会直接碰到图 5 里那些最有用的目的占比。结伴比例是表 2 里 R² 最高的特征,又恰好是手机轨迹通常没有的。
这些结果可以说到哪一步
信号最清楚的地方也最依赖测量条件。上学和年龄的相关约 −0.50,样本含 0–17 岁;结伴和家庭结构的线性解释度最高,分母是调查里能标出同行者的出行。换一个只有工作年龄成人、而且没有结伴字段的手机数据集,这两条最强线索都会变弱或消失。
top-1 准确率要和类别占比一起读。混合划分下,年龄从 18–34 岁这一档 30.9% 的占比,到神经网络的 0.508–0.526;孩子数从大约七成“没有孩子”,到 0.776–0.785;收入的神经网络结果贴着 53.7% 的最高档占比。AUROC 说明排序仍优于随机,尤其是年龄和孩子数。收入的 top-1 准确率停在最高档占比附近,相对“总猜最高档”多出来的正确分类很少。
跨时间测试只在同一个四县地区里更换年份。2023 年的年龄、收入和非二元性别占比都已不同于 2017 年,论文没有把测试集重新加权到训练年份的属性边际,因此性能变化里有多少是关系变了、有多少是人群构成变了,还没有拆开。也没有做跨城市检验。特征主要来自已经带有目的、方式和结伴的日记,不是直接从原始定位点计算;第 5.4 节的轨迹实验是敏感性分析,子样本人数未报告。
多任务的收益集中在样本变少和年份更换时的平均指标上,并且实验为了防止过拟合只用了经典与时空特征。全量、全特征时,随机森林和支持向量机在若干格子上高于这篇神经网络。校准良好的概率可以进入下游模型,论文没有在同一条收费道路或可达性指标上量化“硬分类”和“概率加权”相差多少。
一句话总结
出行记录里有社会人口信号,上学、结伴和孩子比性别清楚,收入的命中率则靠近最高收入档的人数占比;这些信号能在样本很少或年份更换时,靠共用表示和诚实的概率变得更可用,但不能从一个人的出行日记读出他的身份。
核心来源
- Computers, Environment and Urban Systems 正式页面,卷 127,文章编号 102420,2026年3月18日在线发表。正文图 1–9,附录图 A.10 与 B.11,表 1 与表 2。
- 在线补充材料中的表 C.3–C.10,报告四种模型、五组嵌套特征、两种划分下的五折均值和标准差。随机森林使用 500 棵树,支持向量机的 C 为 1,梯度提升使用 100 棵树。
- 论文写明数据可向作者申请。申请入口不等于个人出行记录已经公开。
作者介绍
以下只写论文署名机构和贡献说明里能够核对的内容。
- Ekin Uğurel:通讯作者,署名纽约大学技术管理与创新系。负责研究构思、方法、软件、验证、调查、数据整理、形式分析、可视化以及初稿和修改。
- Cynthia Chen:署名华盛顿大学土木与环境工程系。负责构思、监督、项目管理、经费获取和修改。
- Brian H.Y. Lee:署名普吉特湾区域委员会。负责构思、数据整理和修改。
- Filipe Rodrigues:署名丹麦技术大学技术、管理与经济系。负责构思、方法、调查、资源、监督、项目管理以及初稿和修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
公平性指标若先把每个人收成一个收入档,最高档占 53.7%、神经网络收入准确率只有 0.532 到 0.538 这件事会直接进结果。模型在没有把握时倾向输出最大的那一档,低档人数会被压下去,一条收费道路看起来就比实际更少影响到低收入出行。同一批测试出行可以算两遍:一遍用概率最高的类别,一遍用各类概率做加权,看低档人数占比相差多少。若这个差距已经大于政策上想检测的差别,硬分类就不该作为输入。论文说明了概率可以传下去,没有给出这个差距的数值。
换城市之前,值得先检查推断流程是否保住了真正起作用的线索。年龄这边最强的是上学占比,大约 −0.50;家庭这边线性模型里最强的是结伴,R² 为 0.22。轨迹流程提取不出结伴,又会低估家和工作、高估购物和办事。学校和商店位于同一栋楼时,200 米聚类和兴趣点匹配会把上学和其他目的并到一起,恰好打掉年龄最依赖的那一项。可以先只看上学占比和接送式停靠的误差,再决定这套图特征能不能迁到新城,而不必等全套社会人口标签齐了再发现信号已经没了。
跨年变差还有一个可以拆开的来源。非二元性别从 2017 年的 17 人、占 5,545 人的 0.31%,升到 2023 年的 121 人、占 5,959 人的 2.03%;10 万美元及以上从 50.3% 升到 58.8%。把 2023 年的测试样本重新加权到 2017 年的属性占比,再算一次 AUROC。若降幅大部分消失,年份之间变的主要是谁被调查到;若降幅还在,出行和社会人口属性之间的对应关系本身就变了。论文同时记录了构成变化和性能变化,没有做这一次加权。