人走得更远,为什么还不等于活动更没规律?
论文名片|Fabio Vanni、David Lambert,On an Aggregated Estimate for Human Mobility Regularities through Movement Trends and Population Density,Entropy,2024,26(5):398,2024年4月30日发表。DOI:10.3390/e26050398。研究类型是碰撞模型推导,加上美国州级手机汇总数据与经济指标的观察性比较。
设想 2020 年春天的一种情形,它只用来对照两个量,不是论文里的某一个人:某人仍开车去唯一必须去的工作地,一天的路程不一定变短,但一周里的时间几乎都堆在家和这个地点。走了多远,和去过的地点是否五花八门、时间是否摊匀,是两件不同的事。
这篇论文用回转半径表示前一件事,用熵表示后一件事,并在美国各州的汇总曲线上比较它们。方向性的结果是:2020 年 3 月以后,随机熵上升、不相关香农熵下降,二者可以反向变化;把移动强度和规律性一起放进密度修正后,体验到的拥挤不必等于普查总密度。熵与就业、消费支出、同步指数的州级相关中位数高于回转半径,用电需求和厂商收入则反过来。这些都是共同起伏,不是出行改变经济的因果估计。
先说结论
- 构型熵只随人口密度变化;信息熵同时随人口密度和移动强度变化。六个示例州里,信息熵的归一化曲线更贴近手机数据的不相关香农熵,构型熵只大致贴近随机熵。
- 论文写道,所举各州在 2020 年 3 月初之后随机熵上升、不相关香农熵下降。图上纽约、得克萨斯、佛罗里达、新墨西哥和新泽西更明显;加利福尼亚的随机熵偏离 1 较小。作者的解释是停留点变多,但时间更集中在少数必要地点。约一年后,不相关香农熵回到期初水平,随机熵维持新的平均水平。这是州级曲线的读法,不是逐人清点停留点。
- 2020 年熵加权人口密度与普查总密度可以差很多。得克萨斯州分别为每平方公里 4.8 人与 42.9 人;特拉华州分别为 1061.5 人与 193.0 人。修正项来自移动强度和香农熵,不是人口普查又数了一遍人。
- 在 50 个州的线性相关系数中,不相关香农熵与就业的中位数是 0.64,回转半径是 0.55;与同步指数分别是 0.69 和 0.61;与消费支出分别是 0.65 和 0.43。用电需求的中位数反而是回转半径 0.46、熵 0.36。区间是各州系数的第 10 与第 90 百分位,彼此重叠。
- 有效再生数被写成随香农熵相对期初差值的指数函数。其他量不变时,移动更规律对应更低的再生数。这是公式推论,本文没有报告用各州病例拟合出来的再生数。
走得远和走得乱,差在哪一个量?
人类移动性在这里指人在空间中的移动,不是搬家或户籍迁移。论文要量化的是大尺度活动有多难预测。熵低,表示各停留点上的时间更容易猜;熵高,表示难以猜这个人会把时间放在哪些地点。
随机熵假设下一次地点在已经去过的地点里完全随机。对 N 个个体取平均:
E[Ŝ_rand] = ⟨log L_i⟩_N
L_i 是个体 i 到过的不同地点数。它只数地点种类,不看每个地点占了多少时间。
不相关香农熵把访问频率放进来。p_k 是此人在第 k 个地点的访问频率,仍对个体取平均:
E[Ŝ_unc] = −⟨Σ_k p_k log p_k⟩_N
地点很多、而且时间摊得比较开时,这个熵高;反复去少数地点时,它低。均匀分布的熵不低于其他分布,所以 E[Ŝ_unc] ≤ E[Ŝ_rand],只有完全随机时相等。式中的 log 没有标明底数。后文理论公式使用自然对数 ln,不能把数据库里二十多的熵读成地点个数。
移动强度用回转半径(radius of gyration,RoG)。它是轨迹各点到轨迹质心的均方根距离,不是把一天的路程加总。人在一小块区域里来回折返,累计路程可以很长,回转半径仍然小。Camber Systems 把设备在 geohash-7 上汇总,网格大约 153 米 × 153 米;州级指标是在某地过夜设备的汇总。正文一处把它称为这些设备回转半径的中位数,表 1 的列名则是 Mean ROG。下面引用的米数来自表 1 的均值列。
表 1 只展示数据结构。得克萨斯州(FIPS 48)2020 年 1 月 15 日:熵的均值 29.225、标准差 11.540,回转半径均值 43,961.618 米、标准差 99,679.671 米,设备数 916,762。次日设备数 957,096;2021 年 3 月 13 日为 920,325,回转半径均值 41,653.951 米。分母是当日纳入的设备,不是得克萨斯州人口。回转半径的标准差大于均值,设备之间差得很开,州级均值不是一个典型居民的出行距离。样本在日尺度上大约一年,示例从 2020 年 1 月 15 日到 2021 年 3 月 13 日。
这些记录来自智能手机的 GPS、通话详单和无线局域网,并曾对照人口普查做归一化。论文写明它更偏向较年轻、较富裕的人群,农村代表性不足,也不应用于巩固居住和职业上的种族差异。
只知道密度时,公式能预言哪一种熵?
碰撞模型把人看成面积为 A 的容器里的点粒子:粒子与器壁相互作用,此外自由运动,容器形状保证运动是混沌的。构型熵进一步假设粒子彼此不相互作用。人口密度 δ = N/A。此时
S_R = ln(δ_o / δ)
δ_o 是特征密度,典型取法是 N 个人对应一块单位面积。这条式子只含密度,对应“人在地点上均匀分布”的随机熵,不包含走得快还是慢。
若还知道移动有多强,最大熵原理在 4N 维相空间里加入速度约束,得到信息熵:
S_U = 1 + ln[ (δ_o / δ) · (μ² / μ_o²) ]
μ 是移动强度,本文用回转半径充当;μ_o 是还能分辨的最小速度,也就是一天内、一个 geohash 网格上能测到的最小位移。密度不变时,μ 越大,信息熵越高。只有移动的分布在空间和时间上都不变,信息熵才和构型熵只差一个常数。
人在公式里互不相关,也不保留地点的先后顺序。论文自己指出,真实熵还会使用到访顺序和停留时间,那是另一项指标,本文没有计算。
六个州的曲线,公式跟上了没有?
直接从手机估计的熵,和用密度、回转半径代进去的熵,是否同一条曲线?图 1 用四个大州看这件事。每条线都除以自己在观测期初的值,纵轴 S(t) 等于 1 表示与期初相同,不是熵的绝对纳特数或比特数。
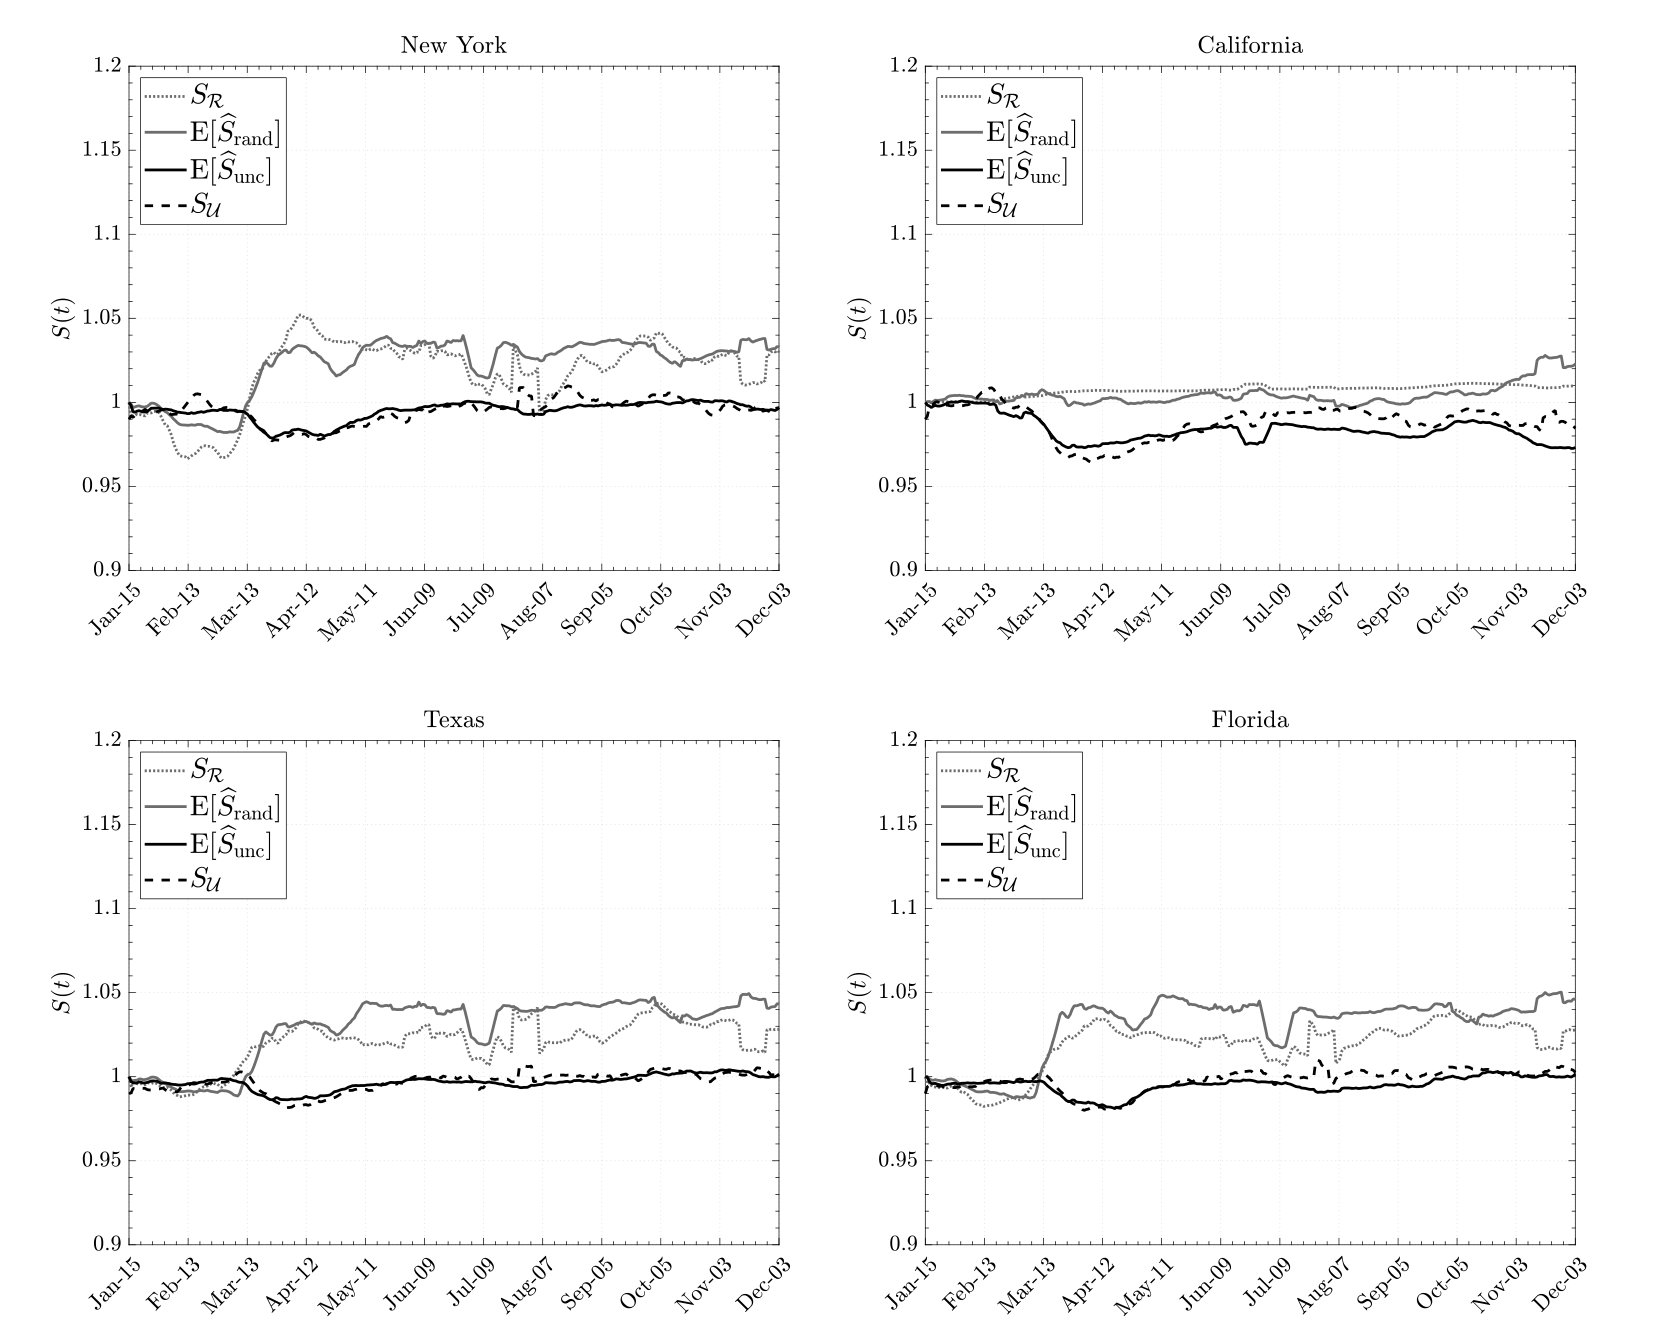
图 1|州级汇总熵在 2020 年怎样偏离期初,公式曲线跟不跟得上?
无字母子图,左上纽约、右上加利福尼亚、左下得克萨斯、右下佛罗里达。纵轴是各自期初归一后的 S(t),横轴为 2020 年 1 月至 12 月。点线是构型熵 S_R,细实线是数据估计的随机熵,粗实线是不相关香农熵,虚线是信息熵 S_U。纽约、得克萨斯和佛罗里达的随机熵在 3 月后升到 1 以上,不相关香农熵先落到 1 以下再回到期初附近;加利福尼亚的随机熵大部分时间贴着 1,不相关香农熵落到 1 以下。信息熵贴着不相关香农熵,构型熵只大致贴着随机熵。来源:原论文 Fig. 1。
论文对这一分叉的解释是:疫情发生后,人们去过的不同地点变多,所以随机熵上升;时间却更集中在必要的工作地等少数地点,酒吧、餐馆一类地点占的时间变少,所以不相关香农熵下降。一年之中,不相关香农熵回到原来的水平,随机熵停在新的平均水平上。作者据此推测活跃个体的密度下降,并把它和经济社会活动收缩联系在一起。曲线本身没有直接测量活跃人数,这一句是解释,不是另一个独立计数。
人口分布更均匀时,只含密度的构型熵是否更像样?图 2 把新墨西哥当作分布较均匀的州,新泽西当作分布不均匀的州。
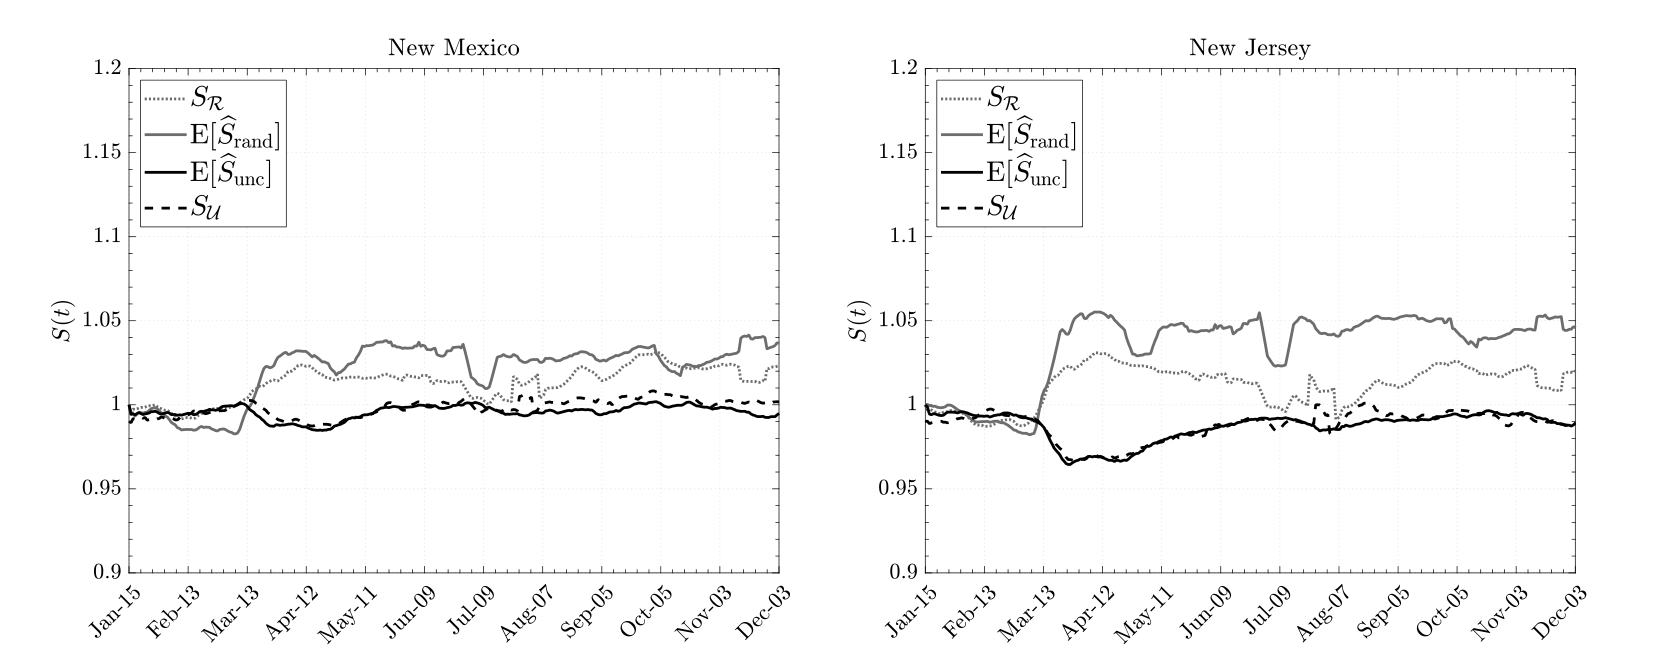
图 2|人口分布匀不匀,会不会改变“只靠密度”的近似?
无字母子图,左为新墨西哥,右为新泽西;线型与图 1 相同,纵轴仍是相对期初的 S(t)。两州都保留 3 月后的分叉:随机熵与构型熵升到 1 以上,不相关香农熵与信息熵落到 1 以下再回升。新泽西的随机熵抬升更明显,两条“随机”曲线之间的缝也更宽。论文认为人口更均匀的州里,构型熵的趋势更接近随机熵;图中的贴近仍是目视,没有给出逐日误差。来源:原论文 Fig. 2。
构型熵的公式只依赖密度,而正文使用的普查密度是年度值。图 1 和图 2 的点线却逐日起伏。论文没有写明这条日序列用的是哪一种逐日密度,因此不能把点线的起伏读成普查人口密度在几天之内改变。μ_o 和 δ_o 的具体取值也没有列出。
工作日和周末只被定性描述:疫情前,工作日和周末的汇总回转半径都更高;熵则是疫情前更低。高回转半径配低熵,可以被理解成必须跑很远办事、其余时间留在家里;低回转半径配高熵,可以被理解成住得很密、主要在邻里范围内活动。作者写明,这一对比还没有更稳健的统计,不能当成已经测得的幅度。
同一批人口,体验到的密度为什么可以差出很多?
普查总密度是人口除以陆地面积,单位是每平方公里人数。它受州界划在哪里影响,量的是土地的平均密度,不是一个人周围的密度。人口加权密度按较小普查单元的密度、用人口作权重再汇总,更接近“随机抽到的一个人所在地方有多密”。
论文从信息熵反解出一个熵加权密度,想表示移动强度和规律性改变之后的体验密度:
δ̂_ew = d_0 · (μ² / μ_o²) · exp{1 − E[Ŝ_unc]}
d_0 就是普查总密度。移动越强,这项越大;不相关香农熵越低,也就是活动越规律,指数项越大,体验密度越高。人口普查数字不变时,拥挤感仍可以变。这是模型定义下的修正,不是新观测到的居民数。
表 3 是 2020 年 50 个州的四种密度,单位都沿用每平方公里人数。熵加权只有一列,由上式用香农熵计算。正文有一处写 two entropy-weighted population densities,表中没有第二列。下表只摘对照最鲜明的几州,其余州在原论文表 3。
| 州 | 普查总密度 | 熵加权 | 按地理特征调整 | 人口加权中位数 |
|---|---|---|---|---|
| 新泽西 | 466.3 | 474.0 | 785.4 | 1713.7 |
| 罗得岛 | 395.6 | 1403.7 | 455.3 | 1403.3 |
| 特拉华 | 193.0 | 1061.5 | 259.8 | 977.0 |
| 纽约 | 159.4 | 67.5 | 1323.0 | 3132.5 |
| 加利福尼亚 | 97.9 | 43.9 | 329.1 | 2873.6 |
| 得克萨斯 | 42.9 | 4.8 | 245.4 | 1626.6 |
| 阿拉斯加 | 0.5 | 0.5 | 5.6 | 687.6 |
得克萨斯州的熵加权密度是普查总密度的 4.8/42.9。特拉华州是 1061.5/193.0,约为 5.5 倍,也是表中相对本州普查值抬升最明显的一州;罗得岛的熵加权水平最高,为 1403.7。纽约的熵加权密度 67.5 低于普查值 159.4,人口加权中位数却是 3132.5,等于熵加权密度的 3132.5/67.5,约 46 倍。两种“修正密度”可以把同一个州推向相反方向。阿拉斯加两种算法都是 0.5,人口加权中位数仍有 687.6。论文没有给出代入公式的 μ、μ_o 和熵,这些商数只能核对表 3 的结果,不能重算修正因子。
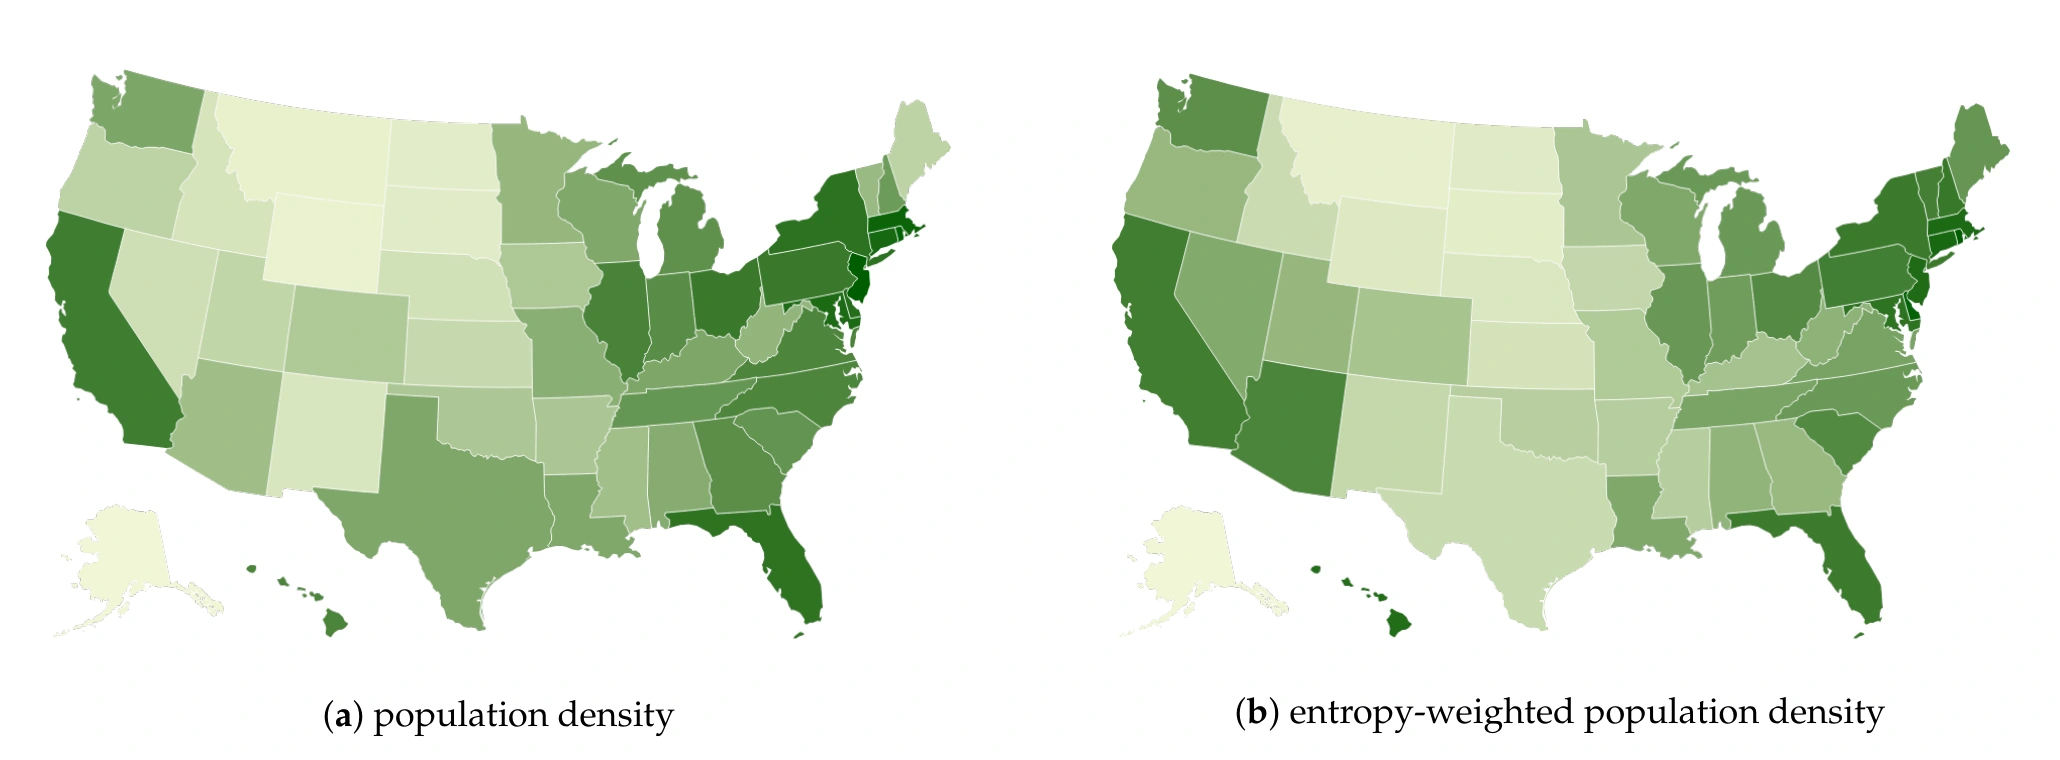
图 3|普查总密度和熵加权密度,哪些州被涂深了?
(a)普查总密度,人除以单位面积。(b)用香农熵修正后的密度。绿色越深越高,但图上没有色标,不能从颜色读出每平方公里人数,也不能把两幅图的同一种绿色当成同一个数值。深色在(b)里不再集中于东北走廊:加利福尼亚、亚利桑那一带相对变深,中部许多州更浅。来源:原论文 Fig. 3。
作者的读法是:移动多且混乱程度低时,人与人更常相遇,体验密度更高;移动不规则时,空间关系更难预测,体验密度更低。这依赖碰撞模型的假设,也依赖回转半径能不能代表平均速度。均方位移或直线距离会是另一种移动强度,本文没有替换检验。
五种经济指标里,谁更跟着熵走?
五个指标是就业、消费支出、用电需求、厂商收入和费城联储的州级同步指数。同步指数按月编制,由非农就业、失业率、制造业平均工时和实际工资薪金四项合成。就业、消费支出和厂商收入来自 Opportunity Insights 的 Economic Tracker;用电来自美国能源信息署的区域电力数据,单位是兆瓦时。图 4 把经济序列画成相对基线的比例,论文没有在正文写出基线的日历日期。图中也没有消费支出和厂商收入,这两项只出现在后面的相关系数里。
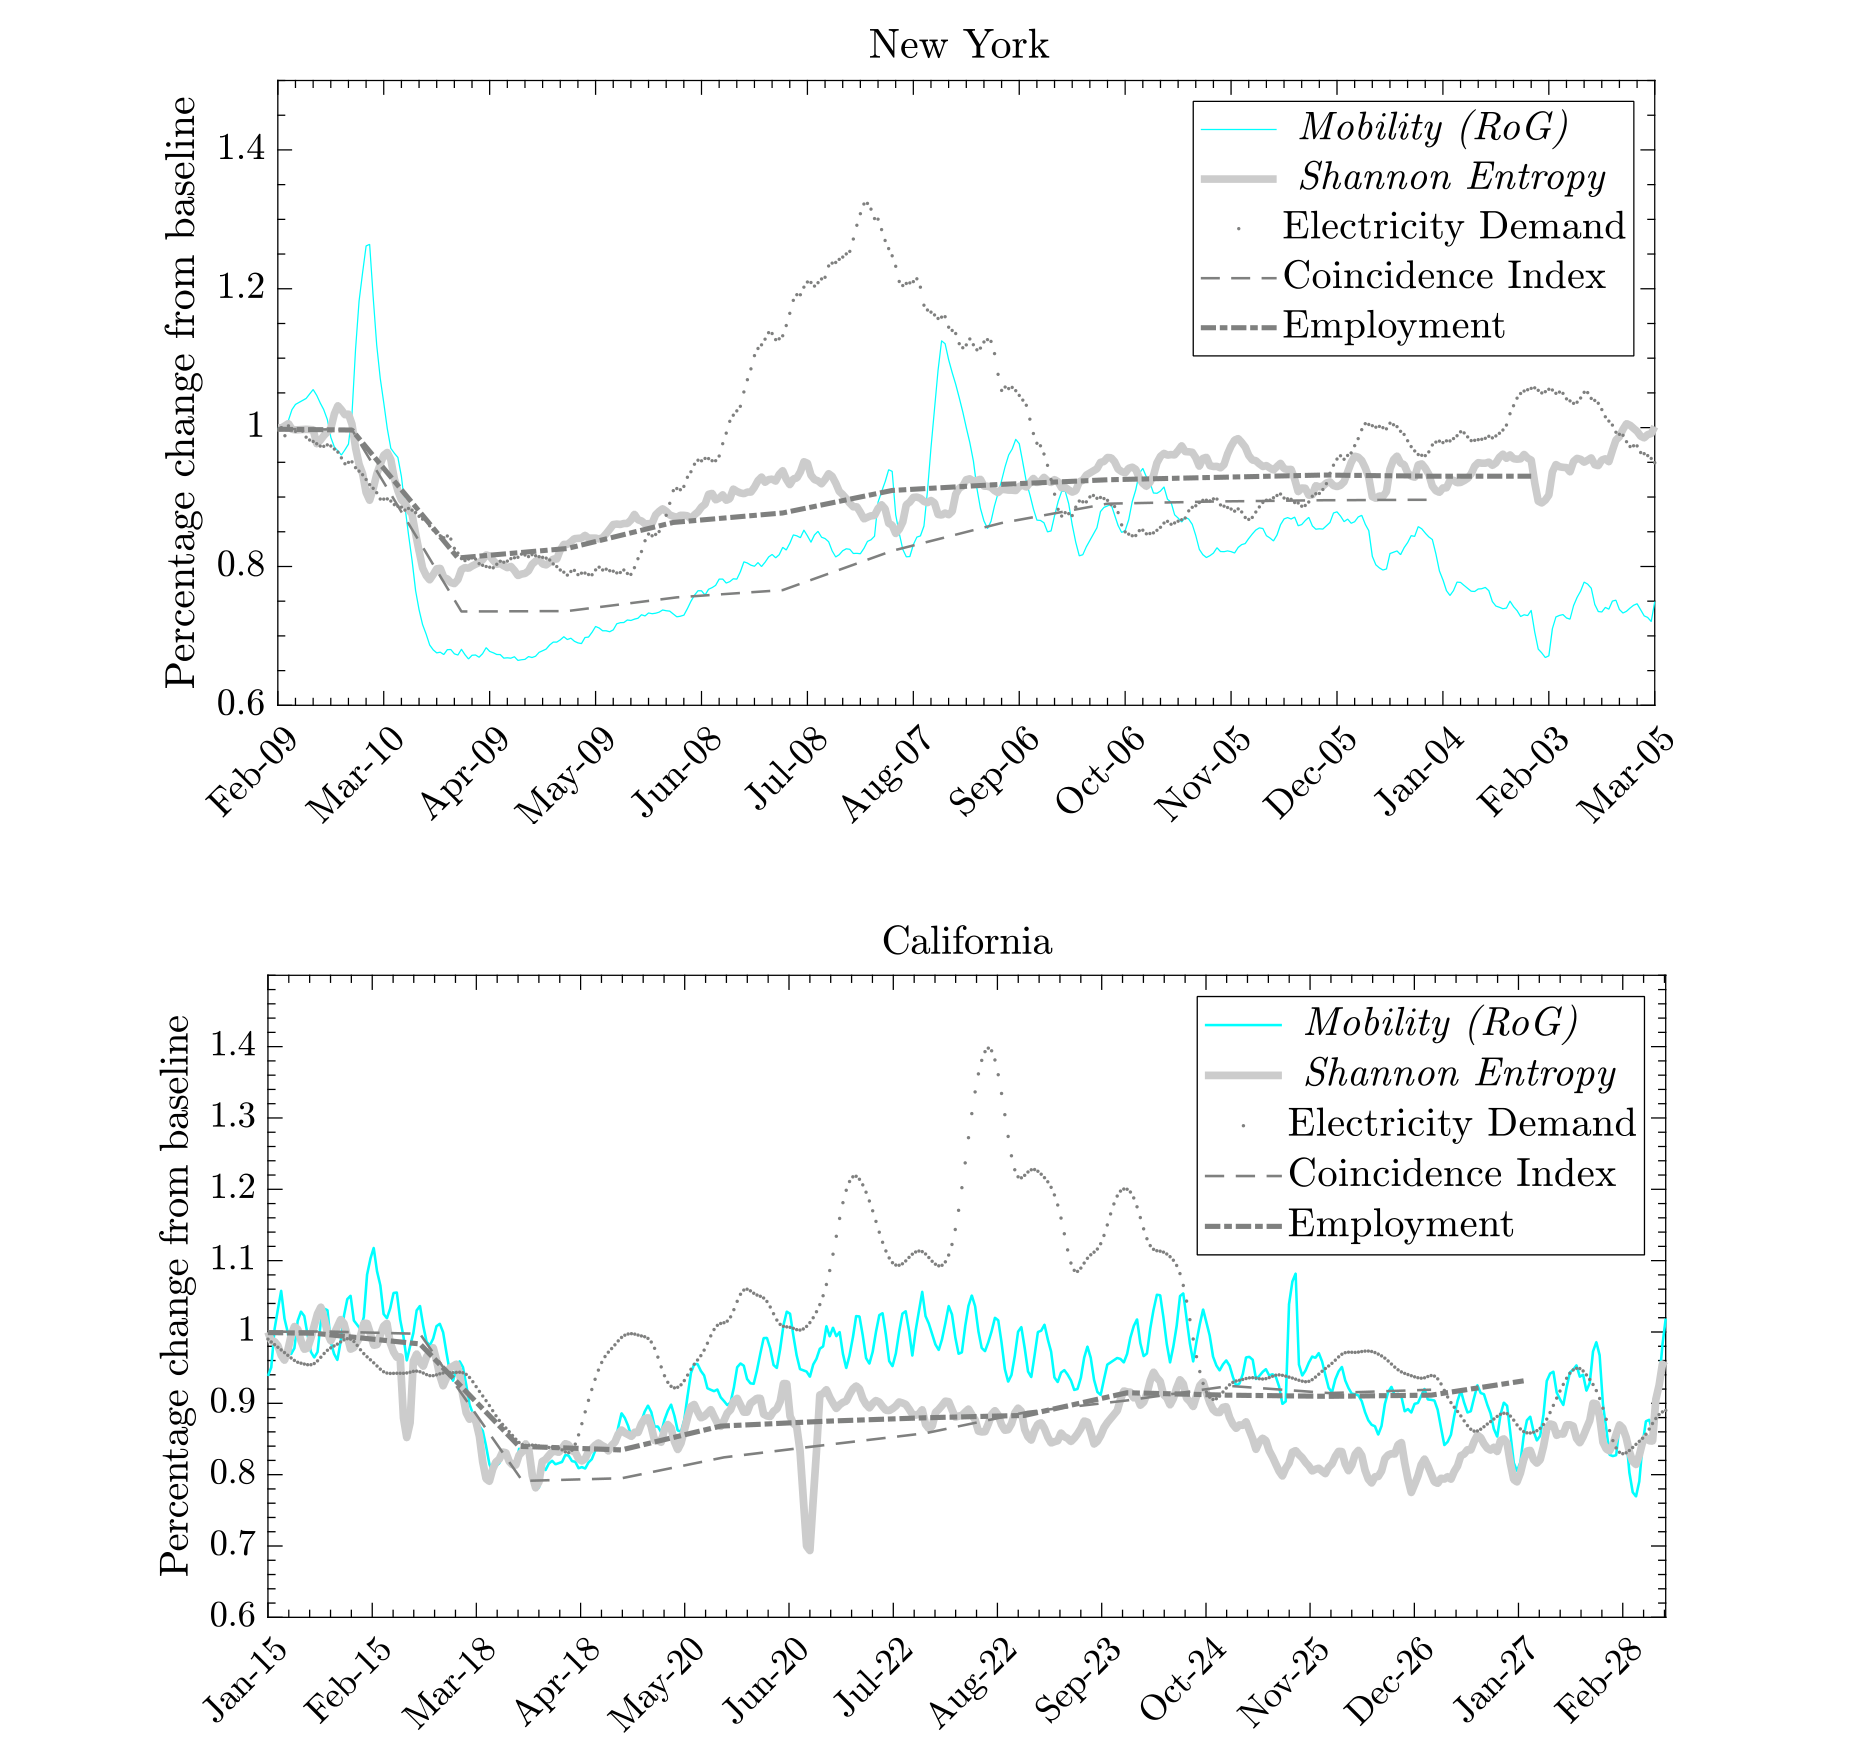
图 4|纽约和加利福尼亚里,经济曲线更贴着熵,还是更贴着回转半径?
无字母子图,上为纽约、下为加利福尼亚。纵轴是相对各自基线的比例,1 为基线;纽约大约从 2020 年 2 月到 2021 年 3 月,加利福尼亚从 2020 年 1 月到 2021 年 2 月末。青色为回转半径,灰色为香农熵,点线为用电需求,灰虚线为同步指数,黑虚线为就业。纽约春季回转半径落到 0.7 以下,用电需求在盛夏升过 1.2;香农熵跌得较少,2021 年初回到 1 附近,回转半径仍低于 0.8。加利福尼亚的回转半径和香农熵起伏更接近,用电需求在夏季升过 1.3。来源:原论文 Fig. 4。
论文用这张图说明:纽约一类州在 2021 年初熵和回转半径走向相反,经济曲线更靠近熵;加利福尼亚两类移动指标走势相近,就更难单凭图形分辨经济指标跟谁。图上的共同下降发生在同一轮疫情冲击里,不能单独证明是移动规律性带动了就业。
图 5 和图 6 把比较做成 50 个州的线性相关系数。浅色细柱是该州经济指标与回转半径的相关,深色粗柱是与不相关香农熵的相关。柱越长,两条时间序列越一起升降。论文没有写明计算前把日度移动合成月,还是把月度经济指标展开到日;因此这些系数的时间对齐方式不能从正文唯一确定。
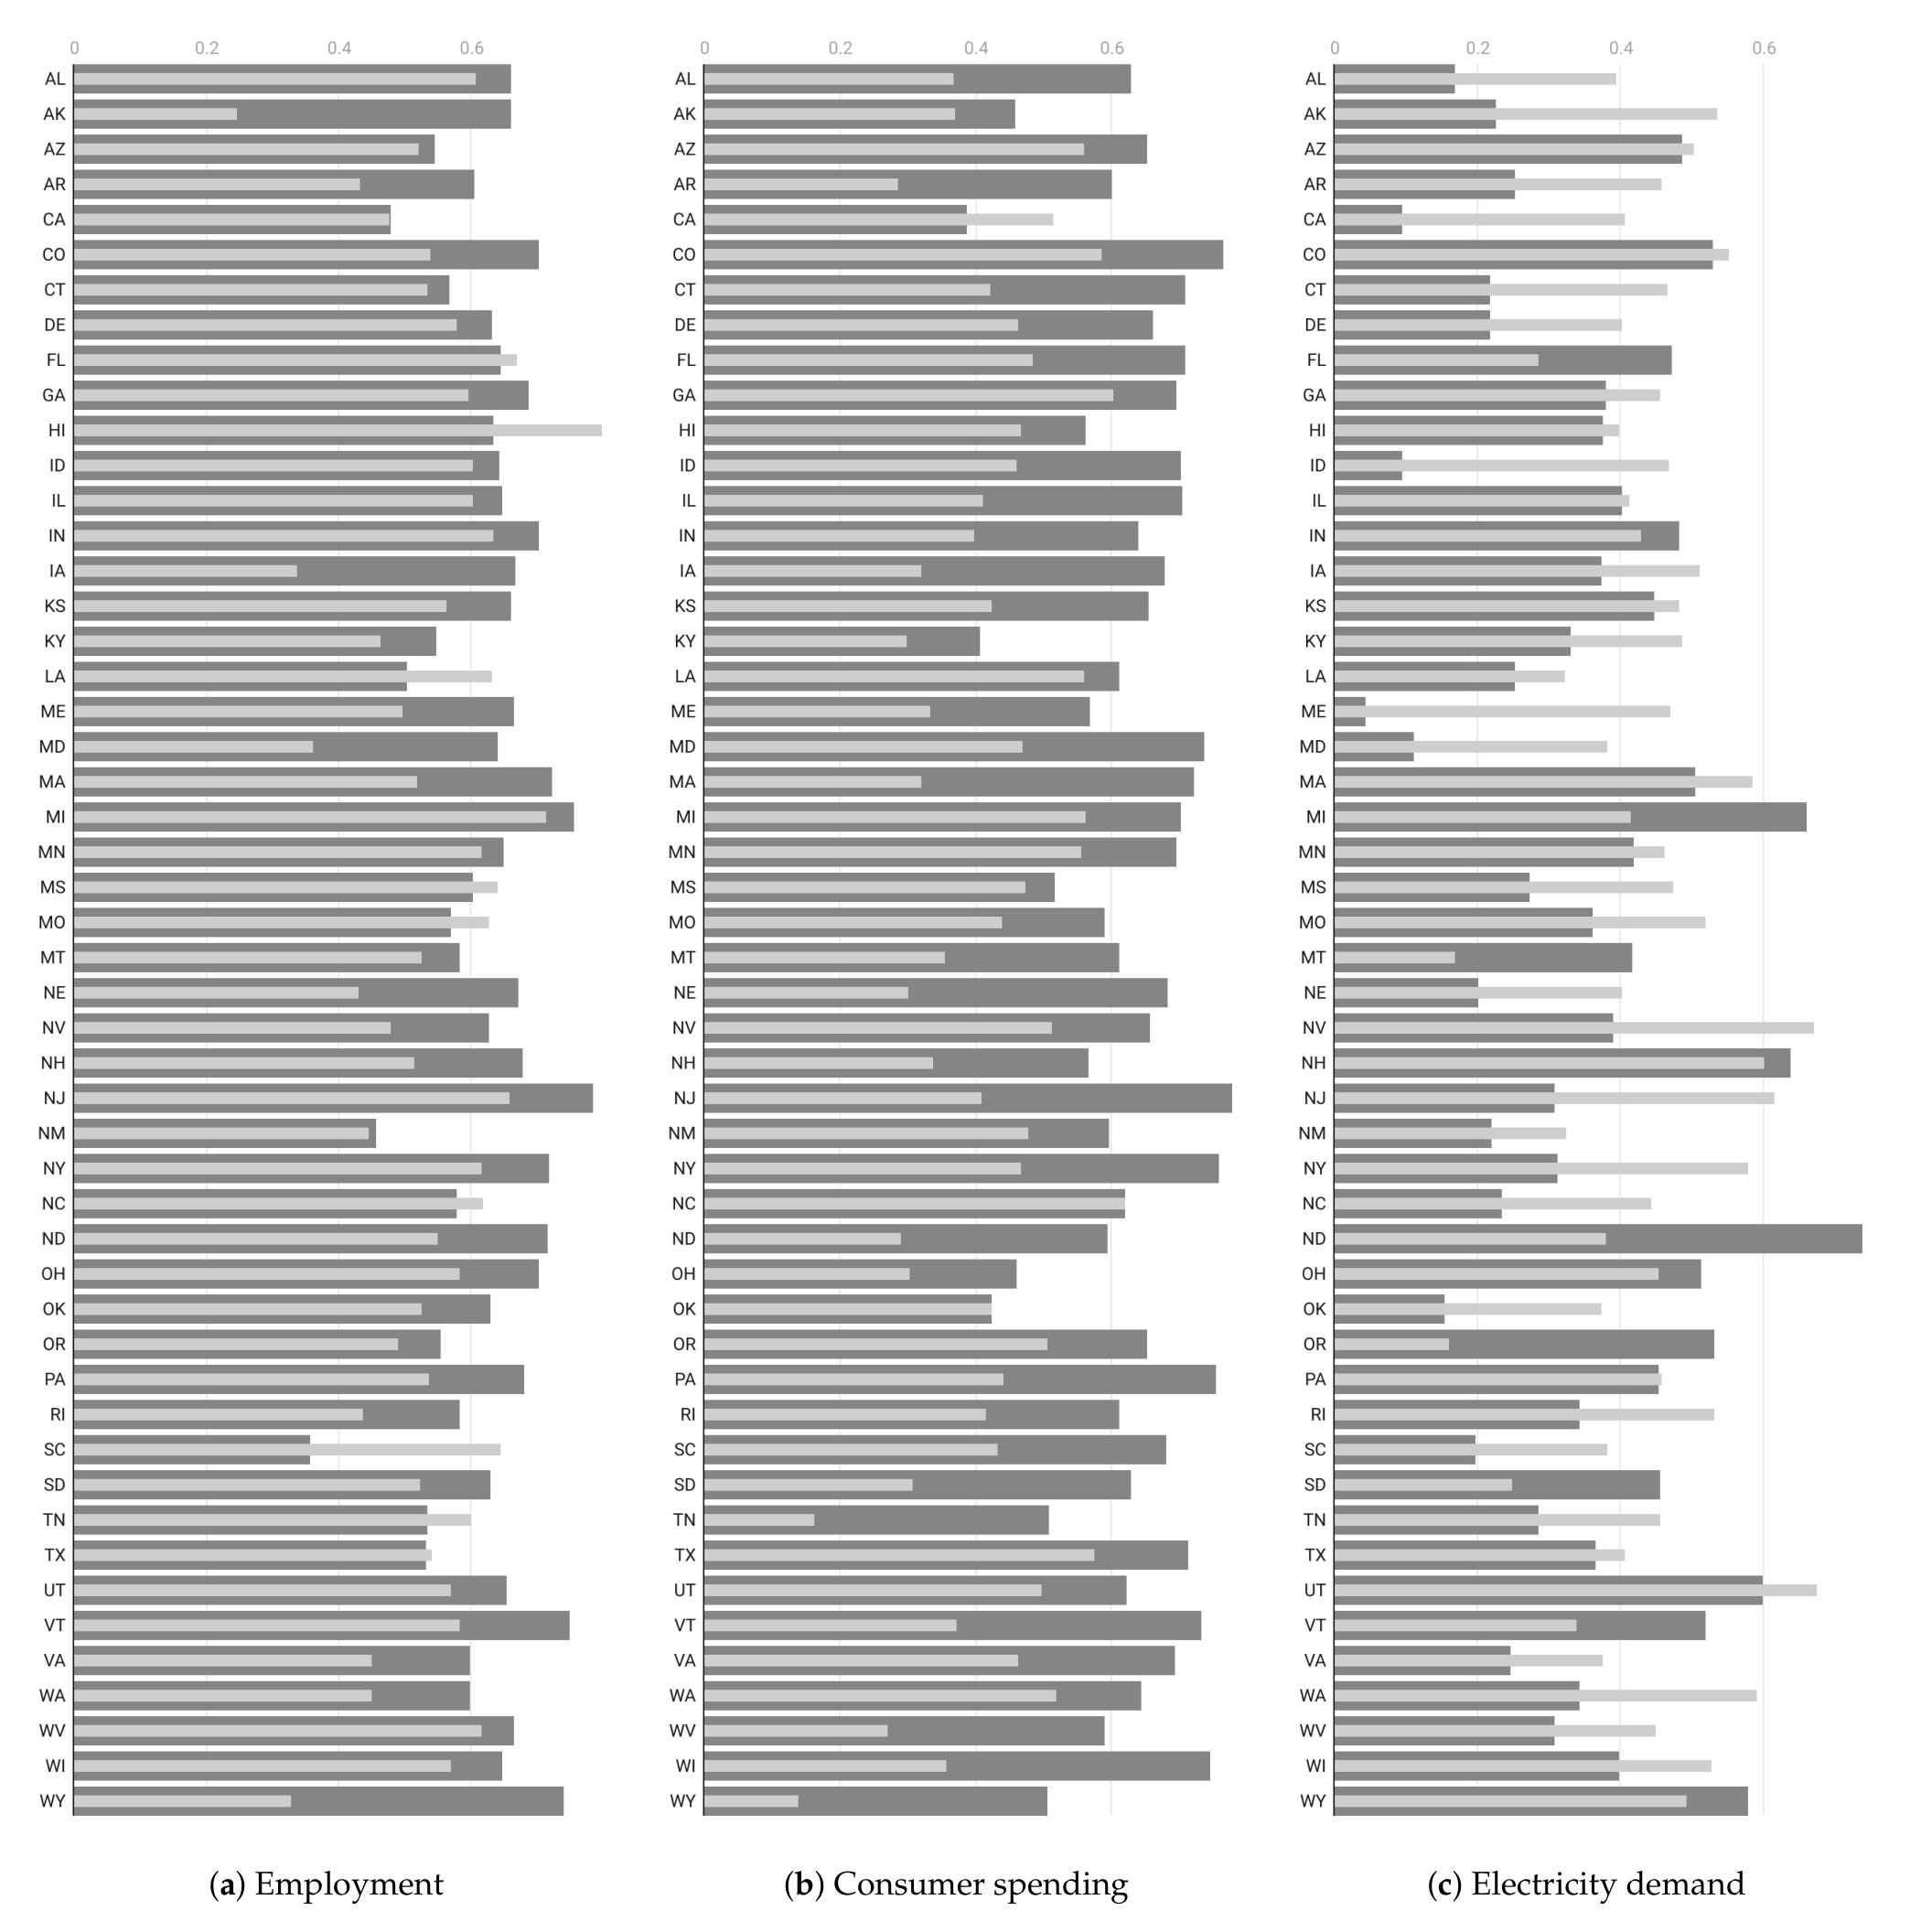
图 5|就业、消费和用电,各州更跟熵还是更跟回转半径?
(a)就业。(b)消费支出。(c)用电需求。横轴是相关系数,三块面板的刻度都画到 0.6;纵轴是州的缩写。表 4 里若干第 90 百分位高于 0.6,最长的柱会顶到或超出面板右缘,图上读不出超过 0.6 的具体数字。(a)(b)中深色柱在多数州更长。(c)并不一律是浅色柱更长:内华达、犹他的浅色柱更长,北达科他和密歇根则是深色柱顶到右缘。来源:原论文 Fig. 5。
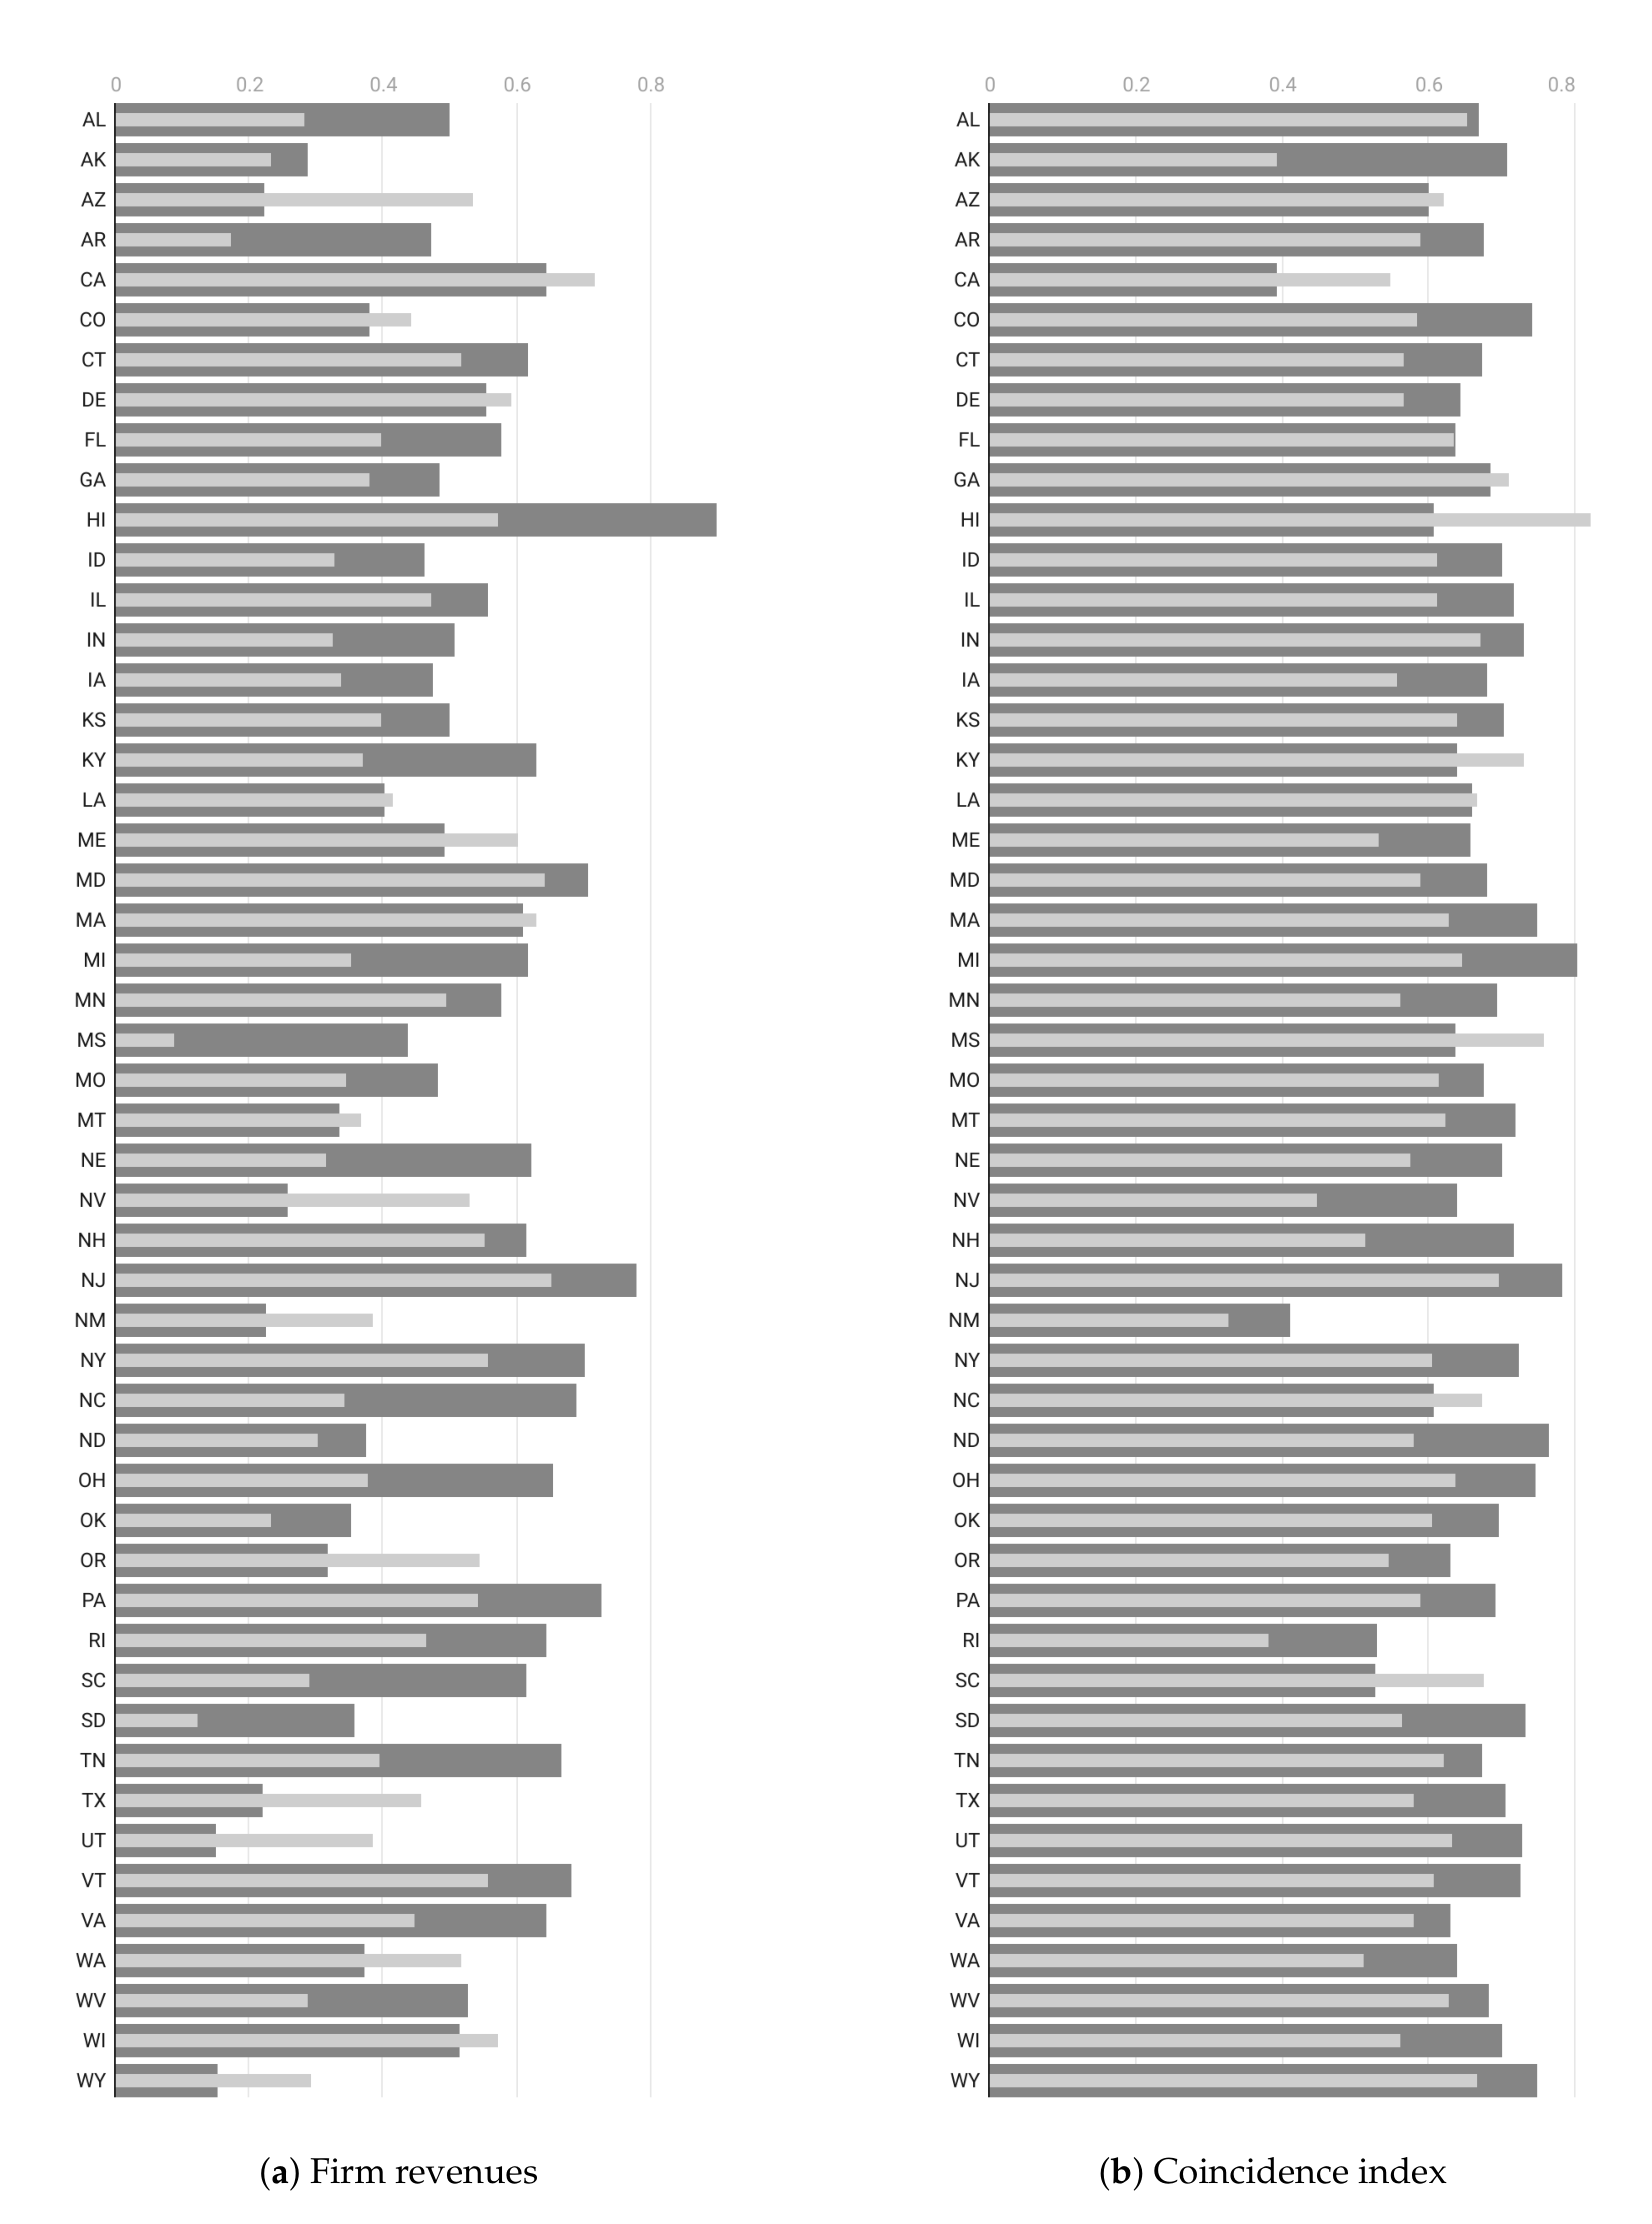
图 6|厂商收入和同步指数的相关,是否仍是熵更高?
(a)厂商收入。(b)同步指数。横轴刻度到 0.8,纵轴仍是 50 个州。(a)里浅色和深色谁更长并不统一;夏威夷的深色柱越过 0.8,浅色柱停在 0.6 附近。(b)里深色柱在多数州更长。新墨西哥两根柱都短于大多数州,深色柱落在 0.4 与 0.6 之间,仍略长于该州浅色柱;南卡罗来纳的浅色柱长于深色柱。来源:原论文 Fig. 6。
表 4 把 50 个州的相关系数取中位数,并给出第 10 与第 90 百分位。列名写作 C.I.,正文也曾称 confidence intervals;表注写明这是百分位,不是某一个相关系数的统计置信区间,论文也没有报告中位数之差的假设检验。
| 指标 | 回转半径中位数 | 第10–90百分位 | 香农熵中位数 | 第10–90百分位 |
|---|---|---|---|---|
| 就业 | 0.55 | 0.43–0.64 | 0.64 | 0.53–0.72 |
| 消费支出 | 0.43 | 0.29–0.56 | 0.65 | 0.48–0.74 |
| 用电需求 | 0.46 | 0.32–0.59 | 0.36 | 0.16–0.56 |
| 厂商收入 | 0.51 | 0.24–0.69 | 0.34 | 0.26–0.60 |
| 同步指数 | 0.61 | 0.51–0.69 | 0.69 | 0.61–0.75 |
作者强调,熵与就业、同步指数的相关程度更高,回转半径与用电需求更高,并把用电解释为对“人有没有在动”比对“动得规律不规律”更敏感。表中消费支出的中位数差距更大,熵比回转半径高 0.65−0.43=0.22;厂商收入则是回转半径的中位数更高。五组百分位区间都有重叠,所以“几乎所有州都是熵更高”不能从这张汇总表单独推出,要回到图 5 和图 6 看个别州。
再生数公式多出来的那一项,论文有没有拿病例检验?
在上述相关之外,论文把香农熵放进有效再生数。设 τ 为观察到新增阳性检测的典型延迟,S_t 为不相关香农熵,S_0 为其期初值,ΔS_t = (1/2)(S_t − S_0)。则
R_{t+τ} = s_t · γ_t · R_0 · e^{ΔS_t}
s_t 是相对期初的易感者比例,γ_t 是传染性因子,R_0 是基本再生数。ΔS_t 大于 0 时,熵这一项把再生数往上推;小于 0 时往下推;等于 0 时,再生数只随易感者比例和传染性变化。其他量不变,移动越规律,再生数越低。
系数 1/2 来自附录:先前模型里,密度通过人际距离的平方进入再生数,移动强度线性进入;再用信息熵把密度和移动强度换成熵,平方关系留下这个 1/2。病例数被写成以这个再生数和代际间隔为输入的泊松更新,代际间隔用伽马分布,形状 1.87、速率 0.28,参数引自 Flaxman 等 2020 年对欧洲干预效果的估计,不是本文拟合的。期望死亡数是估计病例除以 λ,λ 吸收病毒变异、预防措施、季节和年龄结构,正文没有给数值。
这些式子没有配上一张“预测病例对上实际病例”的图。论文把连接经济成本与熵的宏观指标写成 C = f(ω, L),并明确说经验部分仍是定性和初步的。因此,再生数公式说明熵可以怎样进入传染模型,不能说明 2020 年各州再生数的升降已经由这条式子解释了百分之多少。
这些结果不能推出什么?
手机样本不是全人口。州是分析单位,一天一条汇总曲线,推不到某个居民的下一次出行。回转半径与熵的相关,发生在疫情、停工和补助同时变化的一年里,共同下降不足以说明谁引起谁。
熵加权密度依赖查不到具体数值的 μ_o,也依赖“回转半径等于平均速度、人像容器中的不相关粒子”这两条假设。它和人口加权中位数在纽约相差约 46 倍,说明换一种密度定义,排序和倍数都会变。没有色标的地图不能代替表 3。
工作日与周末、真实熵、替代的移动强度定义,都被作者留作后续工作。Camber Systems 的移动数据只在疫情期间公开过一段时间,论文写明现在已不便于直接获取。
一句话总结
人走得更远,并不等于活动更没规律;在这套美国州级数据里,把地点多样性和时间占比放进熵之后,它比回转半径更贴近就业、消费支出和同步指数的共同起伏,但体验密度仍是模型修正,相关也还不是因果。
核心来源
- Entropy 正式论文,Vanni 与 Lambert,2024,26(5):398。附录 A 至 C 与正文在同一篇文章中,分别证明构型熵、信息熵和再生数公式。
- 移动熵与回转半径来自 Camber Systems Social Distancing Reporter。人口普查密度见美国人口普查局,2020 年人口加权密度见 WorldPop。经济序列见 Opportunity Insights Economic Tracker、美国能源信息署 EIA-930,以及费城联储州级同步指数。
- 再生数所依据的碰撞模型,是作者与 Palatella、Grigolini 2021 年发表在 Scientific Reports 的汇总移动与再生数研究,即本文参考文献 20。
作者介绍
- Fabio Vanni:通讯作者。论文署名为意大利因苏布里亚大学经济系,以及法国蔚蓝海岸大学 CNRS 下属 GREDEG。所在院系页面现介绍他为副教授,研究社会与经济动态中的随机过程、人类移动性和起讫网络;致谢写明他是 GNAMPA-INdAM 成员。
- David Lambert:论文署名为美国北得克萨斯大学物理系,通讯邮箱与其 Google Scholar 页面一致,该页面身份为北得克萨斯大学助教。他与 Vanni 等合作了上述 2021 年再生数论文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个州只公布回转半径是否回到疫情前,纽约 2021 年初的图会把“距离还没恢复”和“时间分配已经回到期初附近”混成一件事。复工政策若把前者当成接触模式已经恢复的证据,可能放得过早;若把后者当成人们已经重新跑起来,又可能过晚。更可核验的做法,是同时公布相对同一基线的回转半径和香农熵,并事先写明哪一个用于限制长距离出行、哪一个用于限制停留点的多样化。
另一项容易误用的是表 3 的倍数。得克萨斯州熵加权密度只有普查值的 4.8/42.9,纽约的人口加权中位数又是熵加权密度的大约 46 倍。若把熵加权密度直接写成场所可容纳人数,等于把尚未公开的速度分辨率和熵,当成了清点出来的人头。至少应同时列出普查值、人口加权中位数和熵加权值,并标明后一个数在 μ_o 改变时会缩放。
相关中位数也不适合直接拿来排名。就业上熵的中位数只比回转半径高 0.09,两组百分位却大量重叠;消费支出的中位数差距更大,作者正文反而没有把它和就业并列强调。下一次比较应先把 2020 年春季共同下跌的那几个月拿开,或改看各州自己的前后变化,再问熵是否仍比回转半径更贴近就业。否则,两条曲线一起掉进疫情,就会被算成稳定的相关。