只记下从哪到哪,模拟出来的人为什么午夜还不回家?
论文名片|Yunhan Du、Takaaki Aoki、Naoya Fujiwara,Unveiling realistic mobility patterns with home–origin–destination data aggregation,The European Physical Journal Plus,2024,139:403。2023年12月28日收稿,2024年3月29日接收,2024年5月10日在线发表。DOI:10.1140/epjp/s13360-024-05142-x。开放获取;补充材料与正文同一条目。本文是观测数据上的聚合与模拟比较,用来对照三种汇总方式下的人口分布。
池袋附近有一个 2 公里见方的网格,代码 533945865。数据里,估计家在这里的人有 61,666 名。早晨他们离开时,小时表只保留这一小时的起点和终点,中间穿过的格子不会留下。若下一步按“此刻站在这个格子里的所有人”分配去向,这 61,666 人会跟着别人的下一站继续散开。模拟到第 96 小时,人仍铺在东京及周边。把家从流量里分开之后,同一批人在正午铺开,在午夜收回家所在的位置。
家信息改变的是:回家这段行程还留不留在转移概率里。熵更低,表示这样模拟出来的人口在网格上更集中。这组比较使用的是 5 月和 6 月工作日的小时平均,并把它每 24 小时重复一次,还没有拿未来某一天做留出检验。
先说结论
- 研究对象是东京及周边大约 1,200 个有人口的 2 公里网格。2019 年约 440 万条、2021 年约 470 万条家—起点—终点小时流量记录;其中工作日约 270 万条和 300 万条。分母是汇总后的流量记录,不是手机用户人数。
- 以估计居住人口 61,666 人的池袋附近网格为起点,只含起终点的模拟在 96 小时内持续铺开;加上家之后,第 12 与 84 小时(正午)散开,第 24 与 96 小时(午夜)收回。只保留家和目的地时,也有收回,但分布比同时保留起点时更散。
- 香农熵以 2 为底。家—起点—终点的熵低于家—目的地,两者又低于只含起终点的结果。只含起终点时,熵至少在前 200 小时上升,随后停在更高的平台。这里量的是模拟人口铺开的程度。
- 每个家网格在首个 24 小时内的最大熵,2021 年三种算法都低于 2019 年。最大熵与家网格人口呈对数关系,相关系数为:只含起终点 0.706,家—目的地 0.720,家—起点—终点 0.743。相关系数的分母是参与拟合的家网格,论文没有写成解释率。
- 补充材料里,2020 年普查人口相对 2015 年沿等值线略增,作者据此认为熵下降不来自研究区总人口变少。第 8、12、18、24 小时分别比较时,只含起终点的熵仍然更高。隐私剔除阈值、逐小时熵数值表和回归公式系数,正文都没有给出。
这批数据记录的是小时流量,不是一个人的路线
数据产品是 LocationMind xPop,由 NTT DOCOMO 的手机定位经同意后汇总,个人身份被去掉。原始定位最短大约 5 分钟一次。分析时先落到日本统计局的网格,一格 2 公里乘 2 公里,用 9 位代码表示。研究范围是东京及周边大约 1,200 个有人口的网格。
每条记录给出某一个家、起点、终点组合在某一个小时的人数。人数来自 2019 年或 2021 年 5 月和 6 月全部日期里、同一小时的平均,并带有工作日或周末标记。本文只用工作日,用来看日常通勤这一类行程。全部记录大约 440 万条(2019)和 470 万条(2021);工作日大约 270 万条和 300 万条。一条记录是一个汇总流量,不是一次被单独保存的个人行程。
小时窗口只留起点格和终点格。图 1 的例子里,8 点到 9 点一个人从 3 号格走到 4 号格再走到 2 号格,表上只记 3 到 2。因此后面的人口分布描述的是小时两端,短于一小时的绕行不在表内。
家也是估计出来的。提供者把大约一个月的定位按小时做成每个用户的出现频率,再用 K 均值聚成 12 类,结果大体收成五种节奏:白天活动、夜间活动、早晨更活跃、傍晚更活跃,以及很少出门。然后取该用户不活跃时段里定位最多的网格当家。白天上班的人,不活跃时段多在夜里;夜班则相反。这是出现频率意义上的家,不是入户调查的住址。
手机用户覆盖不了全体居民。每个网格的放大系数,是该网格普查人口除以估计家在此格的样本人数。两年的放大都用 2015 年日本人口普查,不用当年普查。居住人数低于某个阈值的网格因隐私被整格删去,正文写明因此删掉将近一半用户。阈值本身没有写出。被删网格上的人不会进入后面的熵和地图。
家和起点,各自改的是哪一种概率?
三种表可以嵌套。最细的是家—起点—终点(home–origin–destination,HOD):某小时有多少估计家在 h 的人从 j 到 i。把家加总,得到传统起终点(origin–destination,OD)。把起点丢掉、只留家和当时所在格,得到家—目的地(home–destination,HD)。图 1 用一个教学例子说明差别:100 人从 A 到 B,其中 40 人家在 A,60 人家在 B。100、40、60 是例子里的人数,不是东京的实测流量。
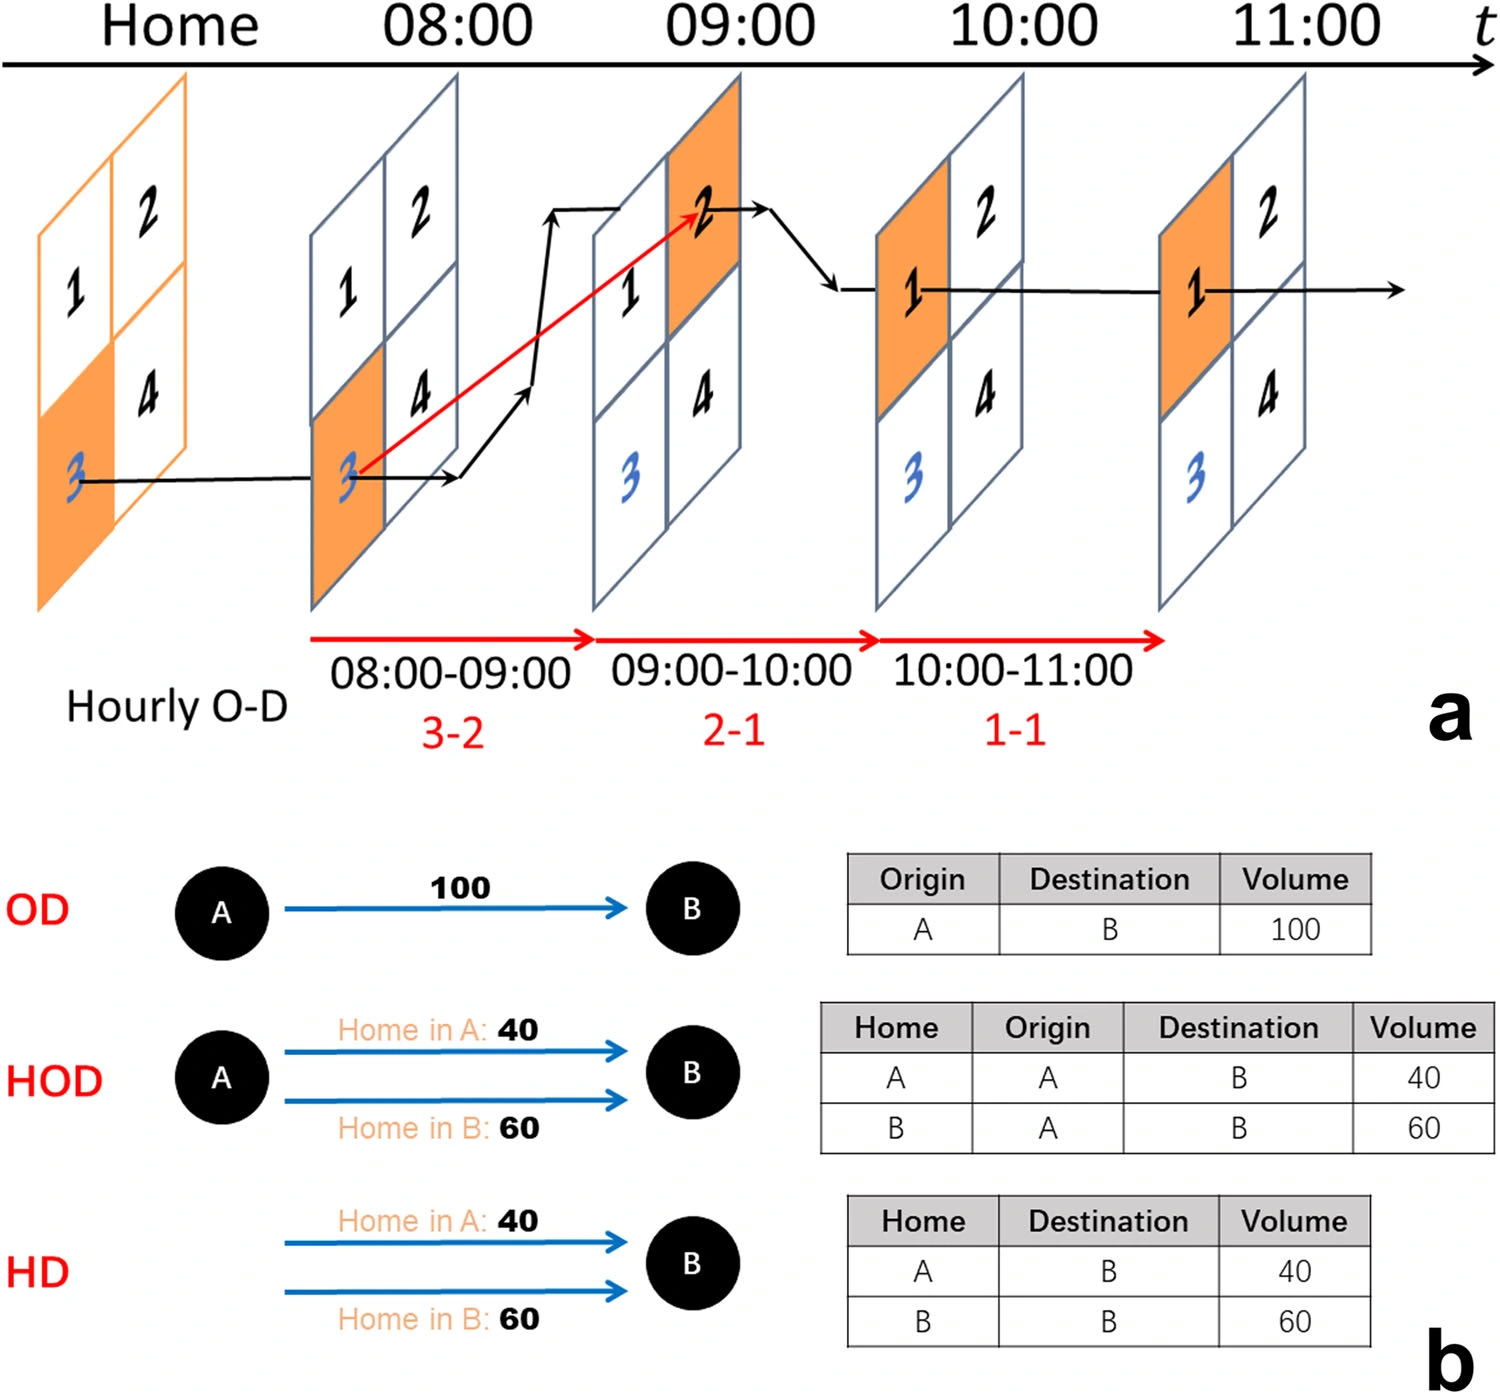
图 1|小时轨迹被收成三种表时,各自留下什么?
(a)时间轴从家到 11 点。黑线是一个人在网格间的移动,红线是小时表实际保存的起点和终点;8 点至 9 点记为 3 到 2,9 点至 10 点记为 2 到 1,10 点至 11 点记为 1 到 1。(b)同一小时 100 人从 A 到 B。OD 只留一行流量;HOD 按家拆成 40 与 60;HD 去掉起点,只留家和目的地。来源:原论文 Fig. 1。
要用这些表推下一小时的人口,先把流量改成比例。OD 和 HOD 的分母,是该小时从格子 j 出发的人数;分子是其中到达 i 的人数。HOD 的分子和分母都只统计家在 h 的人,所以每个家有自己的一张转移表。OD 的分母把所有家的人混在一起。
推演时,OD 和 HOD 用马尔可夫更新:下一小时的人口向量等于当前小时的转移矩阵乘当前人口向量。一个人的下一步只依赖现在所在的格子、当前小时,以及在 HOD 里所属的家,不依赖更早的地点。HD 没有起点,论文改用另一种随机过程:家在 j 的人于小时 t 出现在 i 的比例,直接乘最初只放在家网格上的人口,得到后一小时的分布。HD 每一小时都从家人口重新放置,不沿用上一小时人已经到达的位置。
转移矩阵按 24 小时循环,T(t) 等于 T(t+24)。这和数据形态一致:手头只有一份工作日的小时平均,没有连续许多个不同的日子。论文也写明,若要研究地震疏散这类异常移动,通常不必强加这个循环。
初始状态是:只有家网格 h 上有人,人数等于数据里估计家在 h 的总人数,其他网格为 0。三套算法从这个同一初始向量出发。后面的差别来自转移表里有没有家,以及更新时用不用上一小时的位置。
午夜人口收回来,说明了什么?
图 2 把上述实验画在地图上。初始家网格就是 533945865,人数 61,666。颜色是每个 2 公里网格上的模拟人数,色标按 10 的幂标注,从 10⁰ 到 10⁵。红框标出家的位置。图中没有标注这一组地图属于 2019 还是 2021。
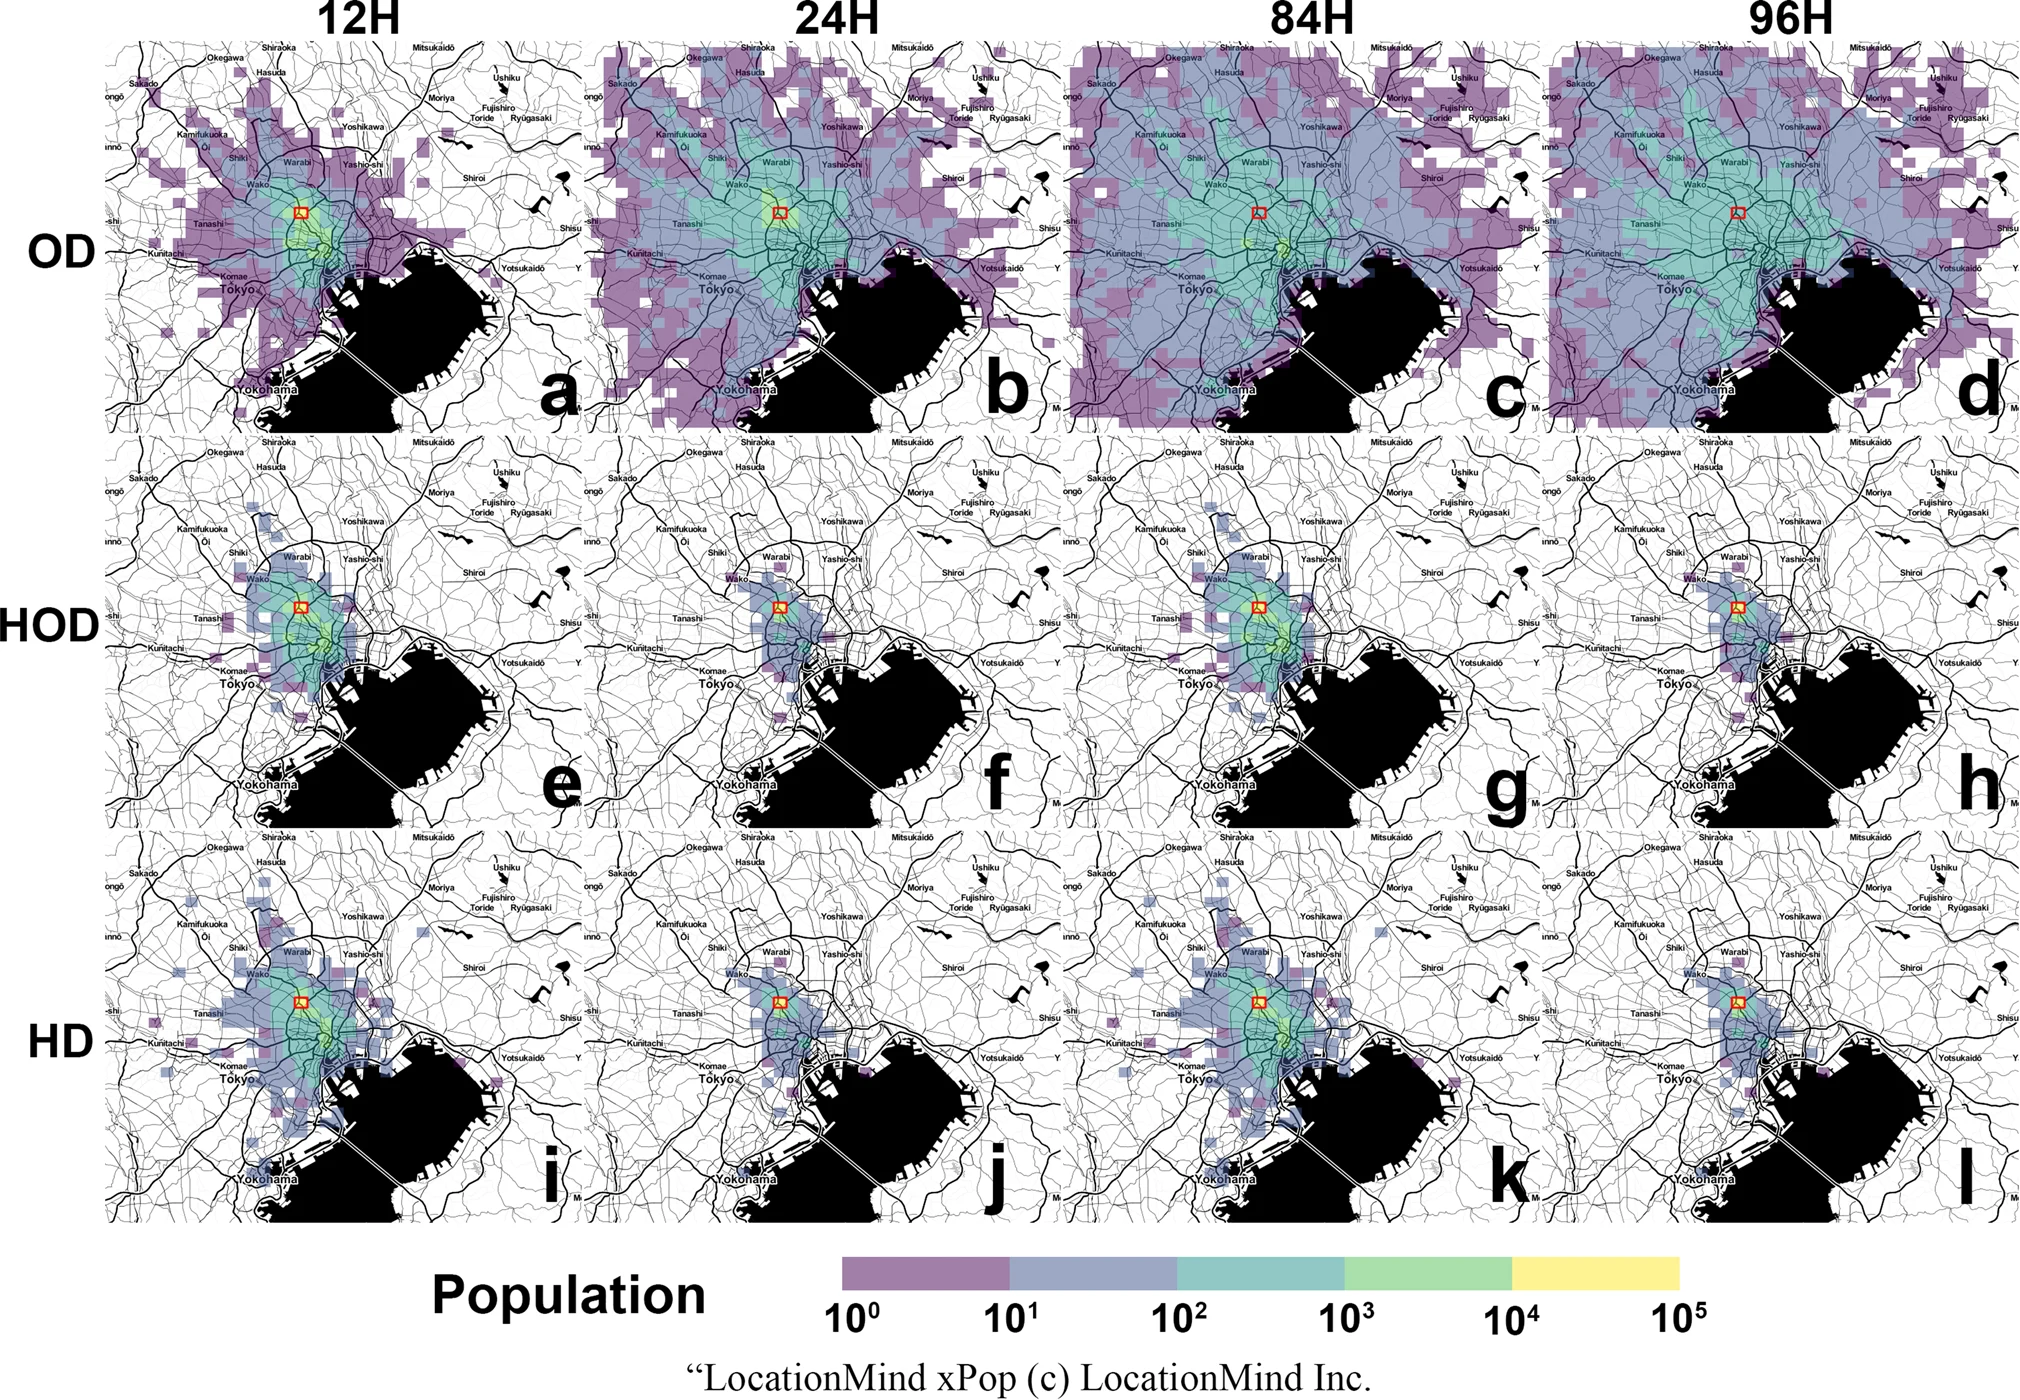
图 2|同一批家在池袋附近的人,96 小时后还在哪里?
(a、b、c、d)OD 在第 12、24、84、96 小时。人口从家网格向外铺开,午夜并没有收回;第 96 小时仍有大片低数量级的紫色。(e、f、g、h)HOD 在同样四个时刻。第 12 与 84 小时(正午)向外扩展,第 24 与 96 小时(午夜)收缩回家网格附近。(i、j、k、l)HD 也是正午扩展、午夜收缩,扩展范围看起来大于同一时刻的 HOD。黑色块为河、湖和海,黑线为主要道路与轨道交通。来源:原论文 Fig. 2。
OD 铺开,是因为回家的方向没有按这个家单独保存。人走到一个白天很忙的格子后,下一步用的是当时所有人的平均去向,其中许多人要回别的家。于是这 61,666 人被送向许多住宅区,下一天又从那些新位置继续走。HOD 在同一个格子上只采用“家也在 533945865”的人实际走过的比例,回这家的流量还在分母和分子里,所以午夜会收缩。
HD 同样能在午夜收缩,因为它直接使用“这个小时、这个家的人出现在哪里”的比例,夜里的比例本身就集中在家附近。它不需要、也没有使用上一小时的位置。图 2 里 HD 的白天色斑比 HOD 更散,和后文 HOD 熵更低是同一方向的证据。
这张图支持的结论是:在这份小时平均和马尔可夫(或 HD 的逐小时重放置)规则下,缺少家会把空间影响铺得更开。它还不支持“已经用独立日期证明 HOD 的预测误差更小”。讨论部分写明,现有数据是 24 小时平均流量,作者没有做训练与测试划分。
熵更低,低在分布更集中
人口铺得越开,越难用一个格子代表他们在哪里。论文用香农熵衡量这种不可预测性。对家为 h、时刻 t 的模拟人口,先把各网格人数除以总人数得到比例 p,再计算 H = −Σ p log₂ p。所有人挤在一个网格时,熵为 0。若大约 1,200 个网格上完全均匀,熵为 log₂(1200),约 10.2 比特;这个均匀参照是按论文所说的网格数量级算出的,论文没有单列这个数。
图 3 的纵轴就是这个熵。正文写的是所有家网格的平均,即 Σ H(h, t) / M,M 为网格数。图注则写初始条件与图 2 相同,也就是只从池袋附近这一格出发。两条说法对不上。曲线形状与后文“OD 升高、HOD 低于 HD”一致,但读者无法单凭此图确定纵轴是全体平均,还是 61,666 人这一格。图 4 改为每个家网格各自的最大熵,口径重新写清。
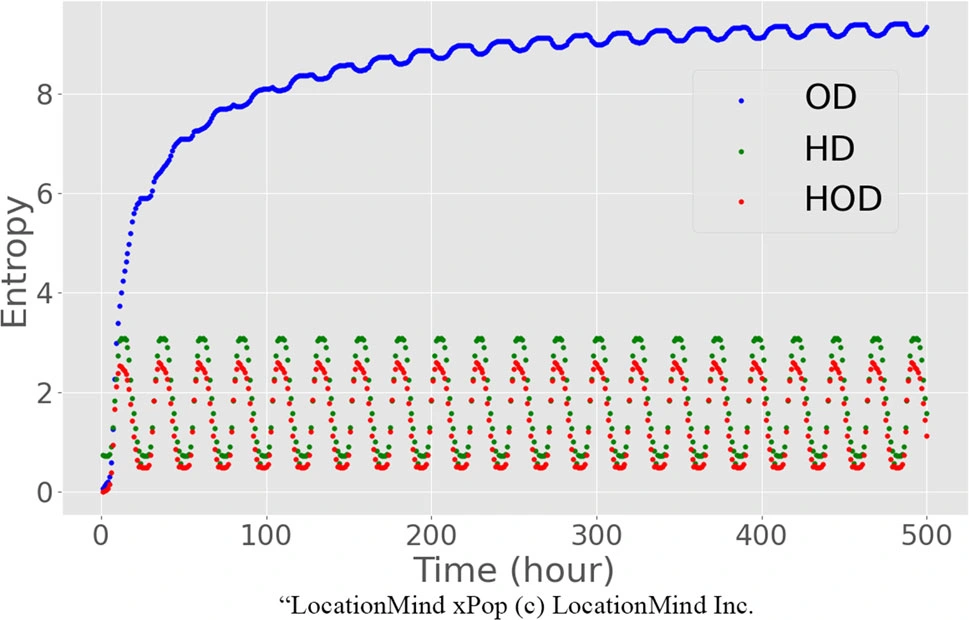
图 3|500 小时里,三种分布的熵怎样变化?
无字母子图。横轴为模拟小时,纵轴为香农熵。蓝色 OD 在前大约 200 小时上升,之后在接近 9 的高位小幅波动;绿色 HD 与红色 HOD 从一开始就按 24 小时起伏,HD 的日间高点大约在 3 附近,HOD 更低,夜间两者都落到 1 以下。这些高低是对照坐标轴的读数,正文没有逐小时数值表。来源:原论文 Fig. 3。
OD 在晚上仍然保持高熵。按作者的读法,模型此时仍让人去探索更远的格子,没有把回家算进去。HOD 和 HD 在夜间下降,对应人回到家、分布变集中;白天升高,对应离开家。HOD 整段低于 HD,说明在已经知道家之后,保留起点还会让分布更集中:当前所在的格子,仍然改变下一小时的去向。
接近 9 比特的平台,低于约 10.2 比特的完全均匀参照,又远高于 HOD 和 HD 的日间峰值。OD 把人口送到了研究区里相当多的网格,但没有把每个网格填成一样多。熵高表示模拟分布更散,可以直接说的是空间范围被放大;把它说成每个人实际到访的地点数,还需要个人轨迹,而这套小时表已经把轨迹收成了流量。
市中心的最大熵,为什么不一定最高?
熵每个小时都在变,地图需要一个可比的数。对 HOD 和 HD,图 3 在第一天就出现 24 小时振荡,于是每个家网格取开区间 (0, 24] 小时内的最大熵。0 小时被排除,因为初始时刻所有人都在家,熵为 0,留着它会把所有网格都比成 0。
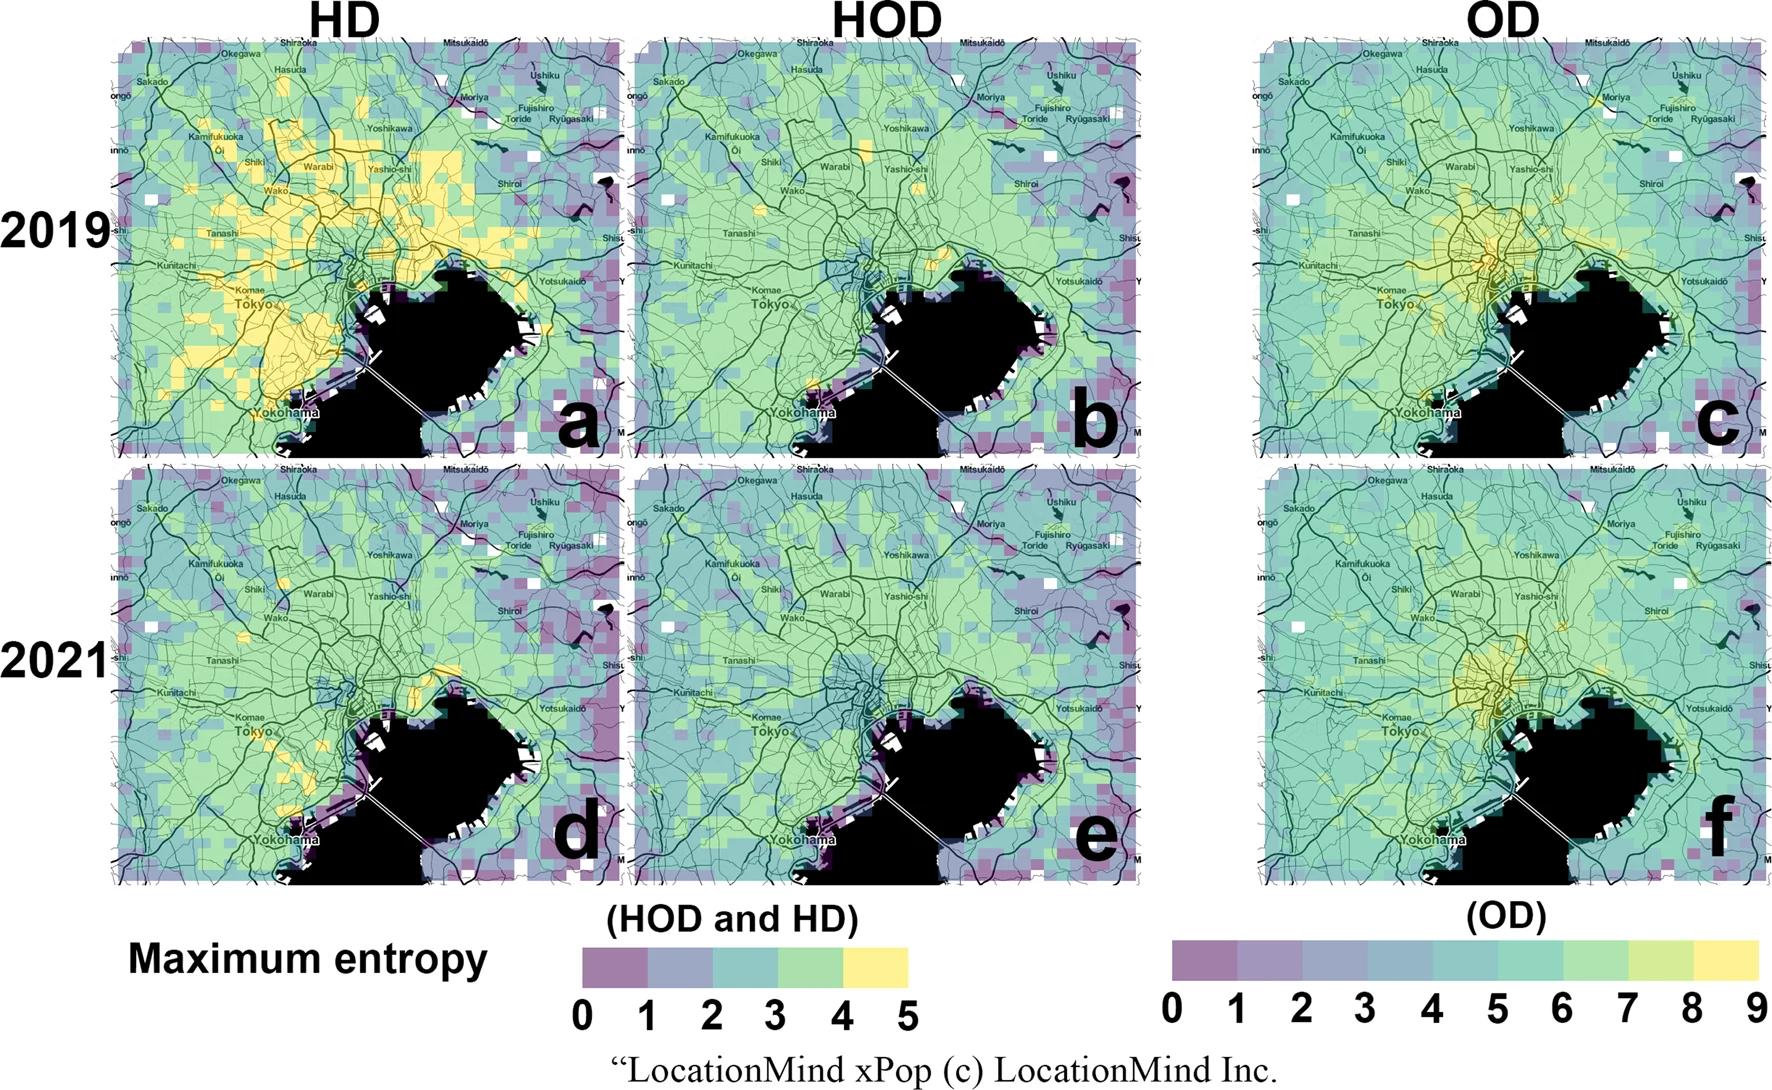
图 4|每个家网格的 24 小时最大熵,在城市里怎样分布?
(a)2019 年 HD,(b)2019 年 HOD,(c)2019 年 OD;(d)2021 年 HD,(e)2021 年 HOD,(f)2021 年 OD。HOD 与 HD 共用 0 到 5 的色标,OD 单独用 0 到 9。外围网格颜色更低。OD 从外围到中心升高;HOD 和 HD 的中心反而低于紧邻的外围。2021 年三列都比 2019 年同列更冷。空白小格的含义正文没有逐格说明。来源:原论文 Fig. 4。
两套色标不能按黄不黄直接比较。OD 的 9 对应 HOD 色标之外的数值,所以 OD 整幅更高,和正文的判断一致,也和补充材料里“同一小时比较时 OD 仍更高”一致。HOD 在两套年份里都是三列中更低的一列。
OD 的最大值落在午夜附近,因为熵在最初若干小时持续上升。HOD 和 HD 有回流,最大值落在白天。这两列的中心低于紧邻外围,比较的是白天峰值。作者另外用人口拟合的残差说明,中心还有低于人口规模所预期的日间移动,见下一节。
正文写“图 4d 显示 2019 年 HD 沿铁路或地铁熵较高”。按图注,d 是 2021 年 HD,2019 年 HD 是 a。对照图面,沿放射走廊的高熵主要出现在 a。这个图案被解释为轨道附近更容易去往多种目的地。论文没有报告到车站距离的统计检验,也没有把走廊内外的熵做差值。
年份比较的是 2019 年与 2021 年各自 5–6 月的工作日平均。三套算法都是 2021 年更低。作者把它解释为疫情之后人们去的地方更少,并提到出行态度和远程办公。数据里没有单独测量态度或是否在家工作。熵下降说明模拟分布更集中;它还不是每人到访地点数的普查。
同一时刻再比一次,最大熵会不会选错了小时?
最大熵在三种算法里可能落在一天中的不同小时。只比最大值,有可能把“午夜还在扩散”和“白天出门”放在一张地图上。补充材料因此固定模拟时钟,看第 8、12、18、24 小时。四张图的面板排列相同:上排 2019,下排 2021;从左到右为 HD、HOD、OD。作者的文字结论是,两个年份、这四个时刻,OD 的熵都高于 HOD 和 HD,和正文的方向一致。色标却并不总是共用,读图时要先看色条。
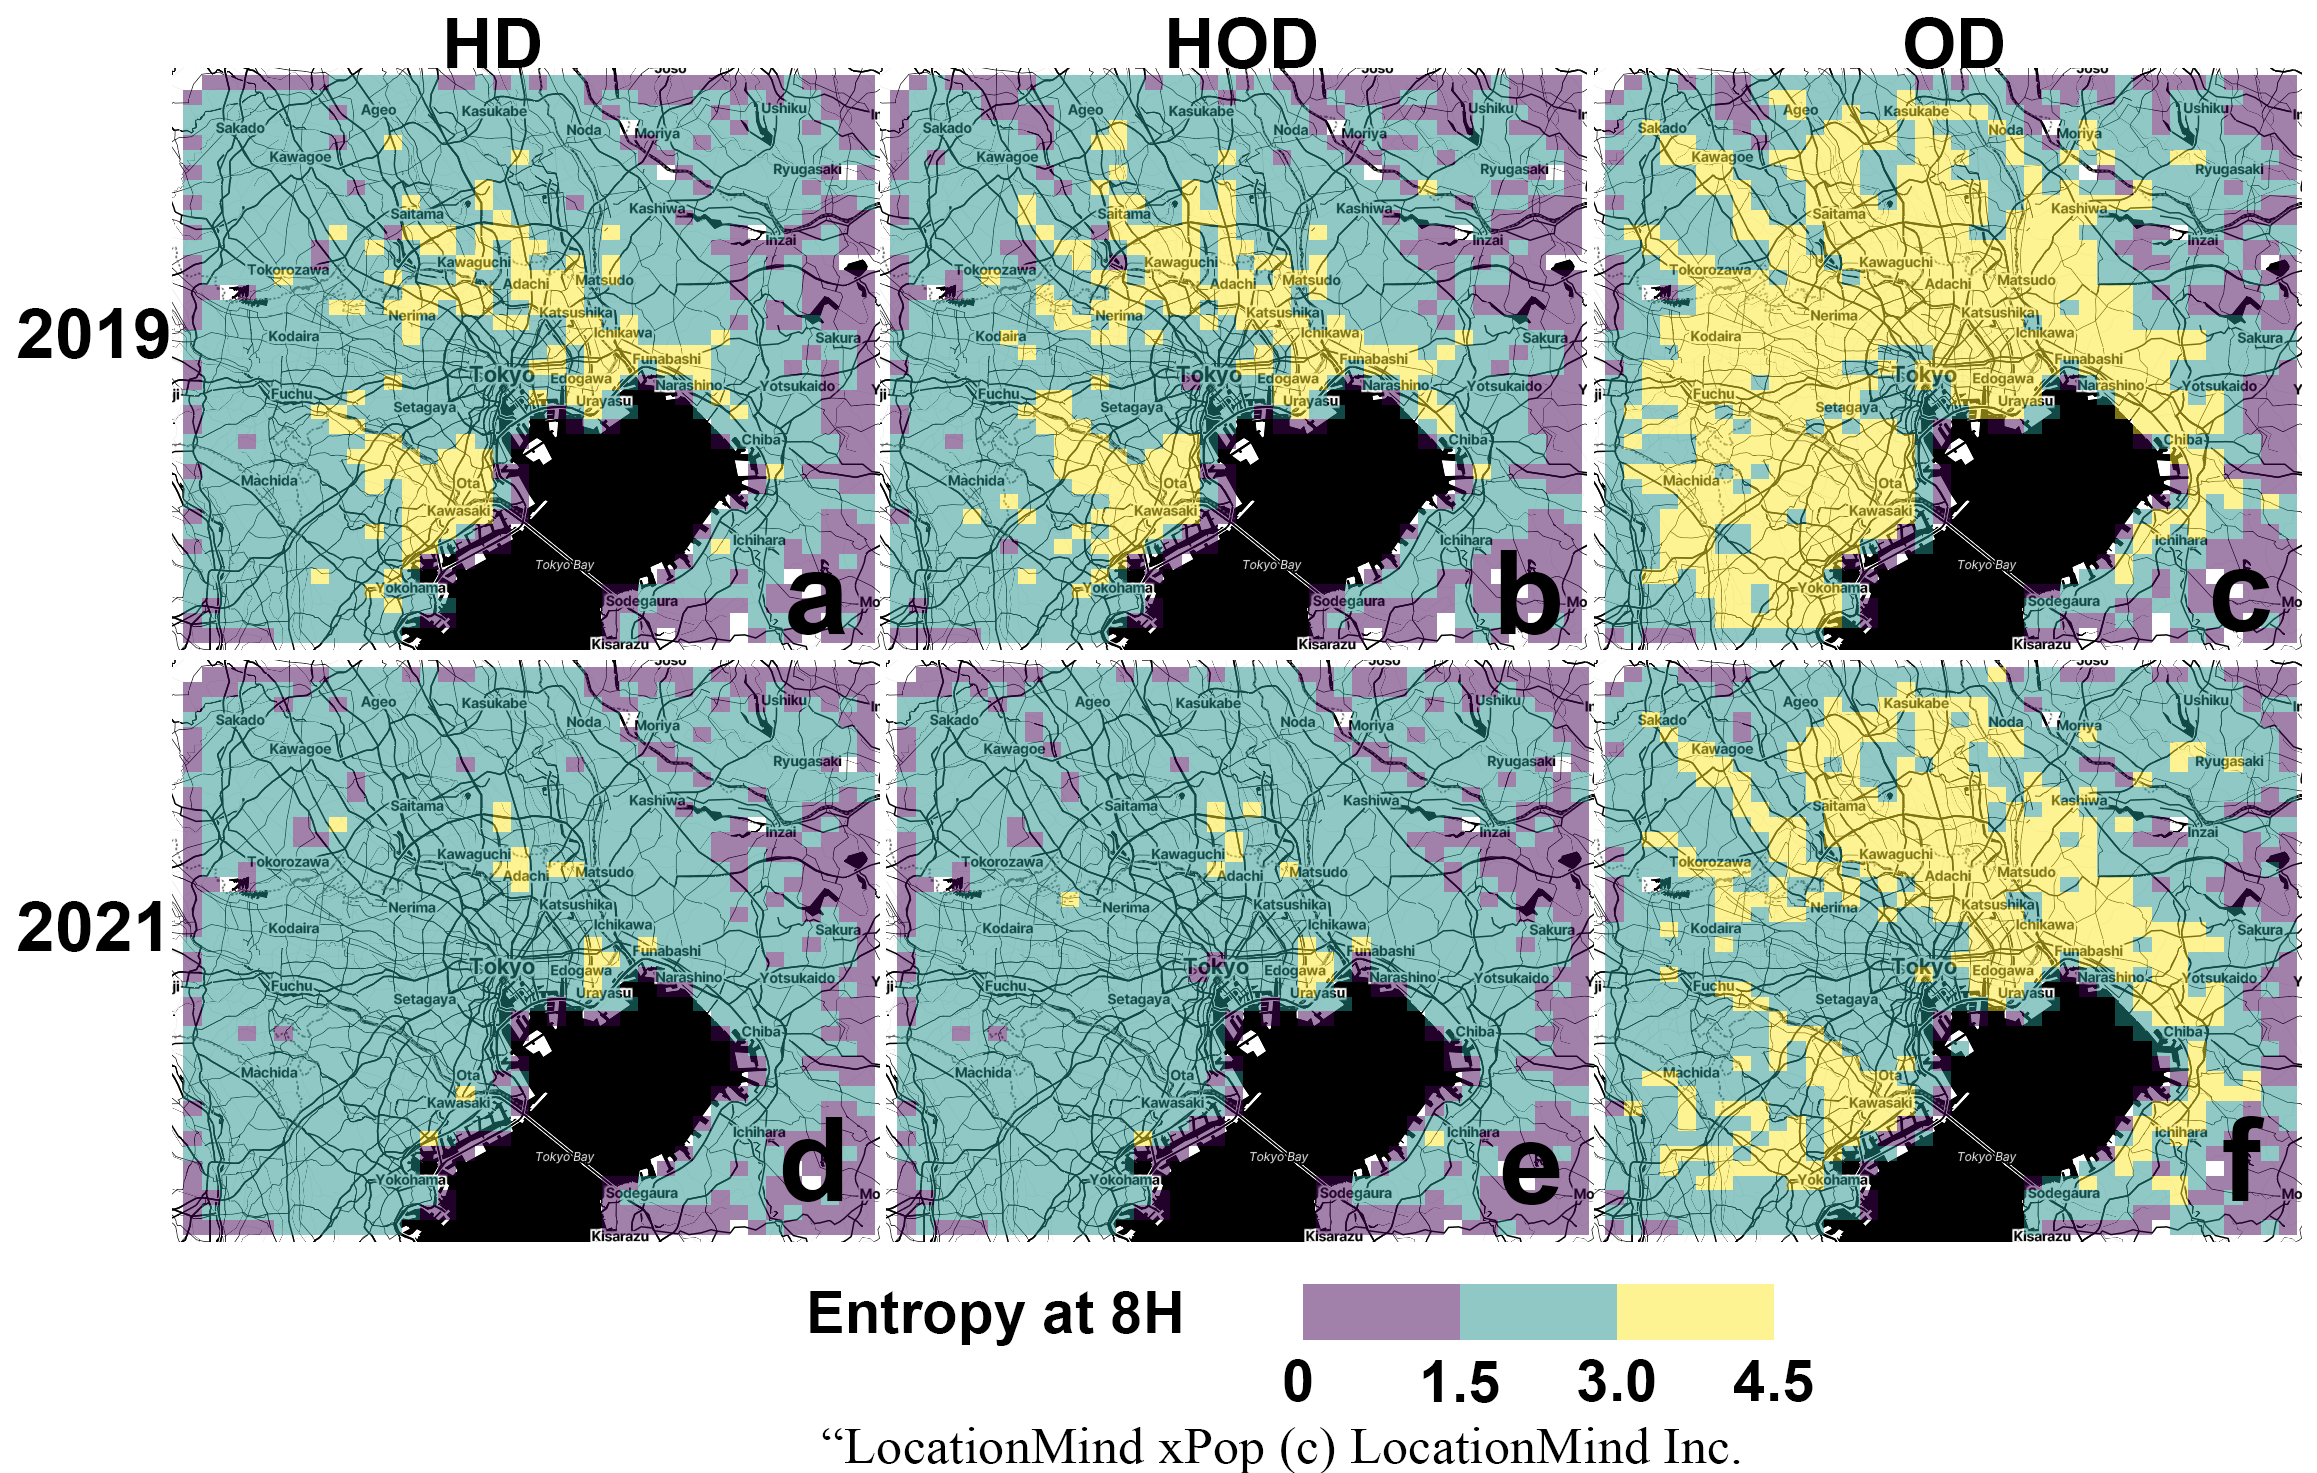
图 S2|第 8 小时,也就是第一天早晨,三种熵谁更高?
(a、d)HD,(b、e)HOD,(c、f)OD;上排 2019,下排 2021。六幅共用 0 到 4.5 的色标。早晨 OD 的黄色范围更大,HOD 比 HD 更收敛;2021 年三列都比 2019 年收敛。此时色标相同,黄色深浅可以直接比较。来源:补充材料 Fig. S2。
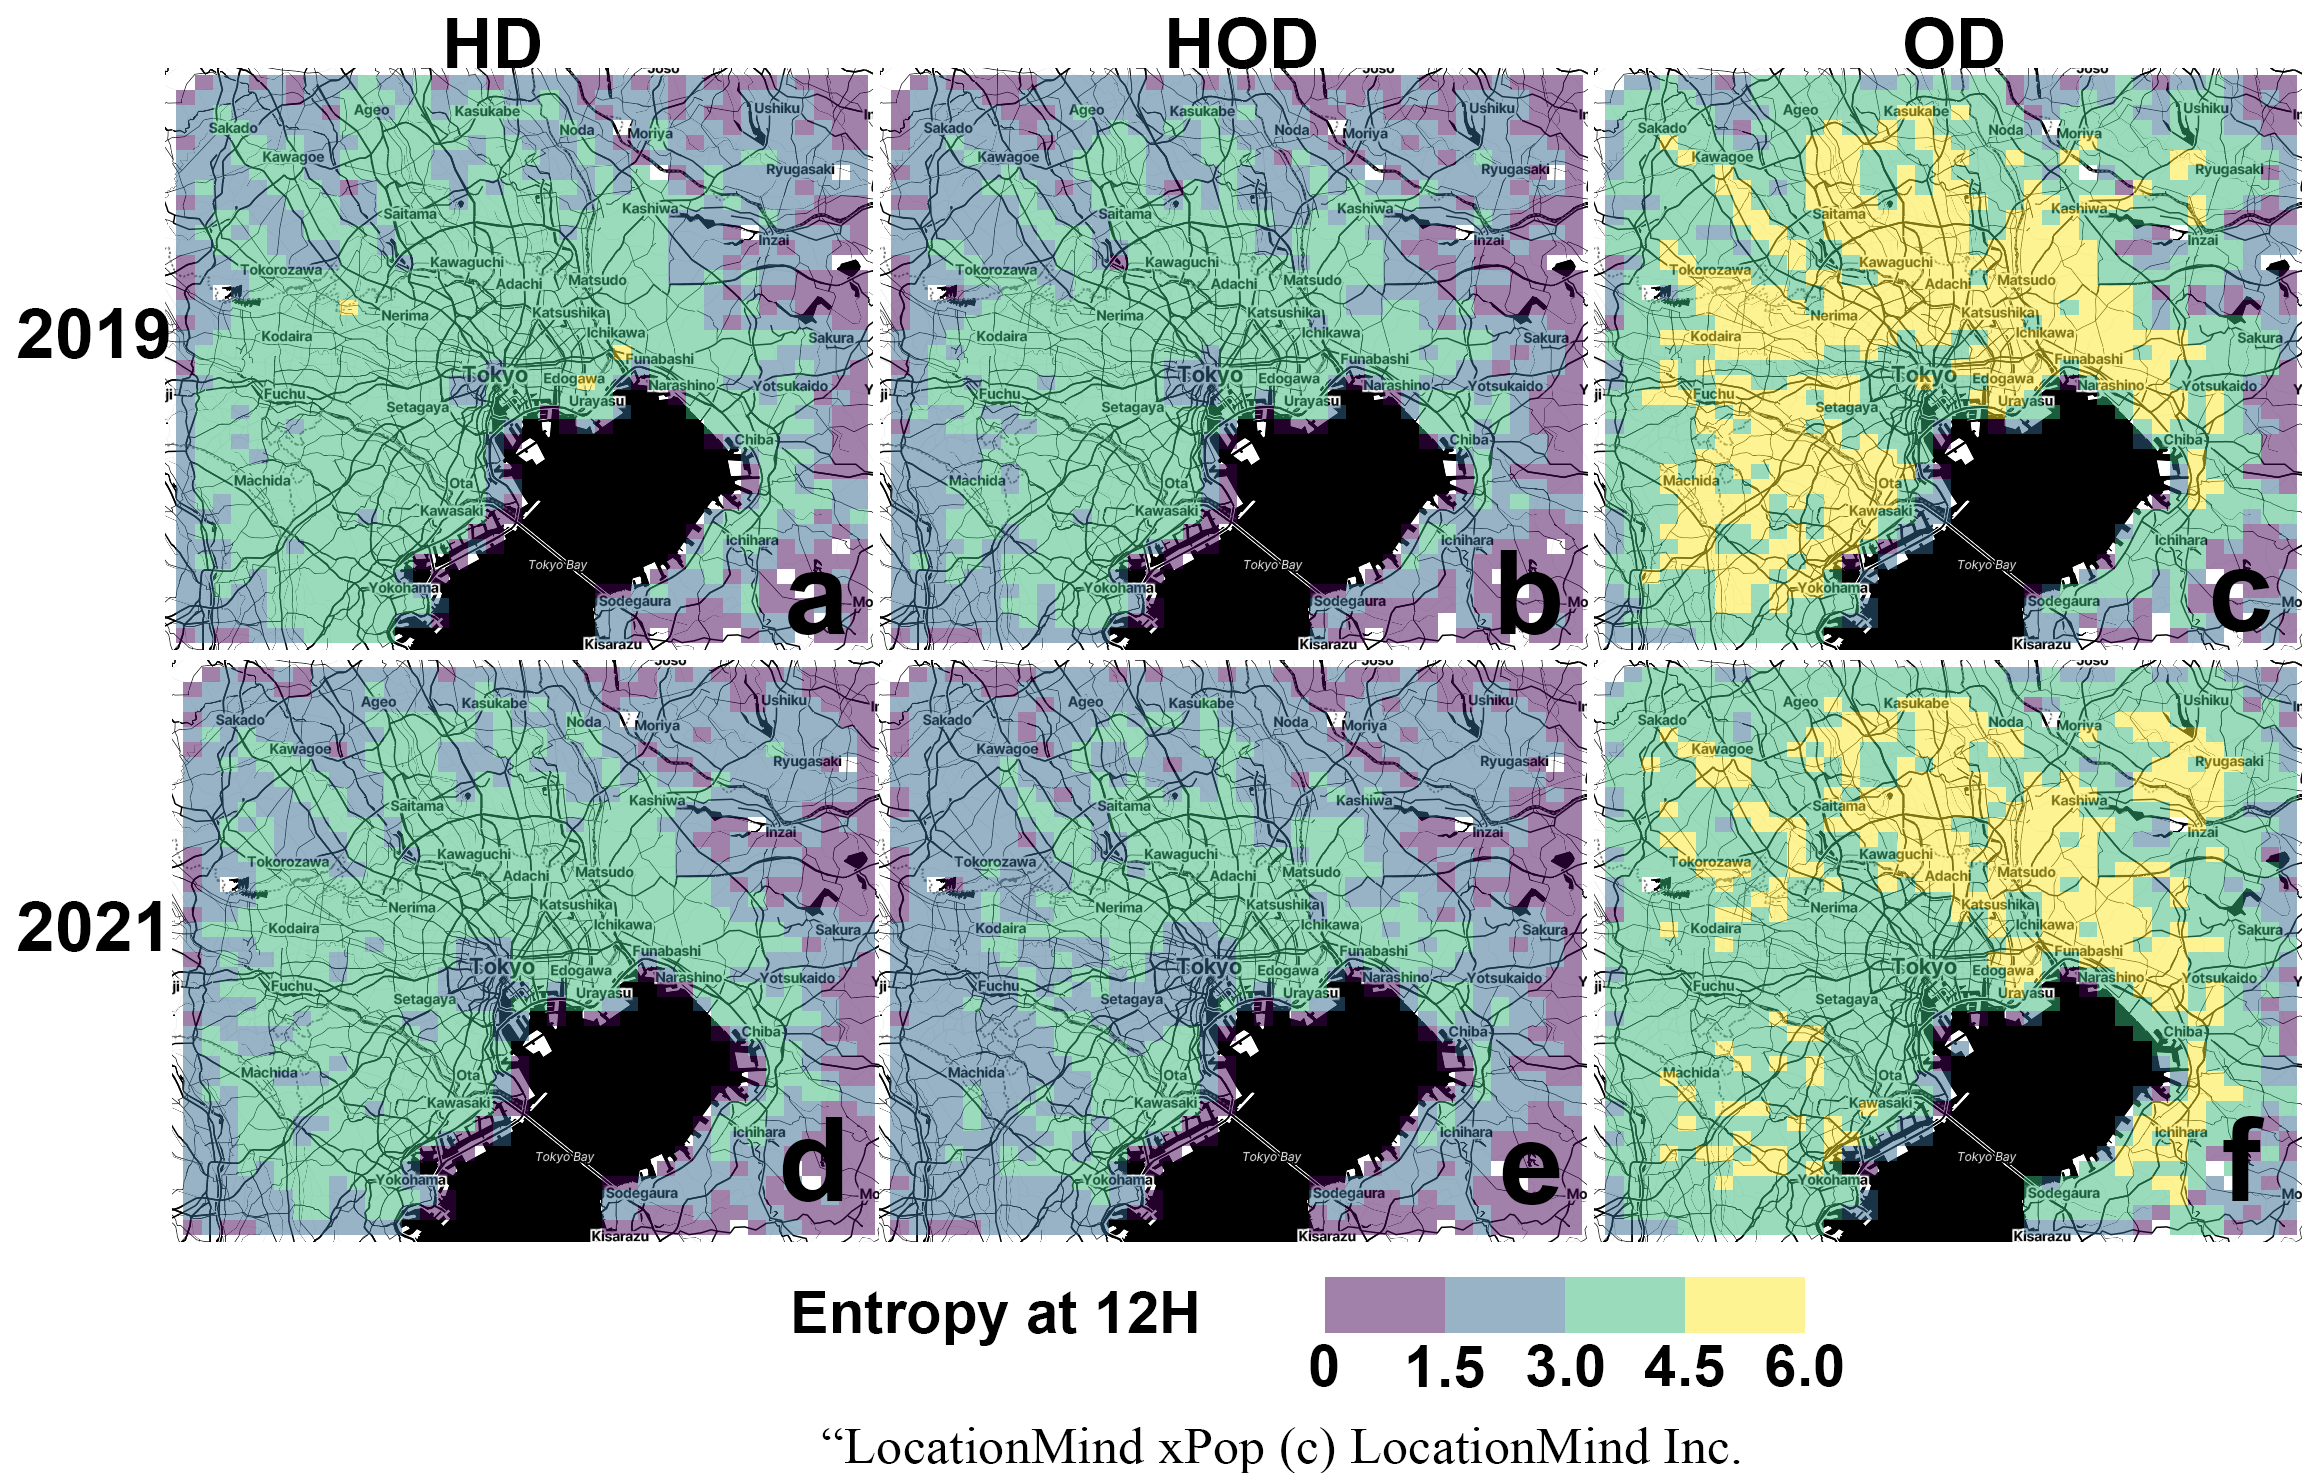
图 S3|第 12 小时的正午,差距还在吗?
(a、d)HD,(b、e)HOD,(c、f)OD;上排 2019,下排 2021。六幅共用 0 到 6.0 的色标。正午 OD 仍最黄,HOD 的高熵范围小于 HD;2021 年整体低于 2019 年。来源:补充材料 Fig. S3。
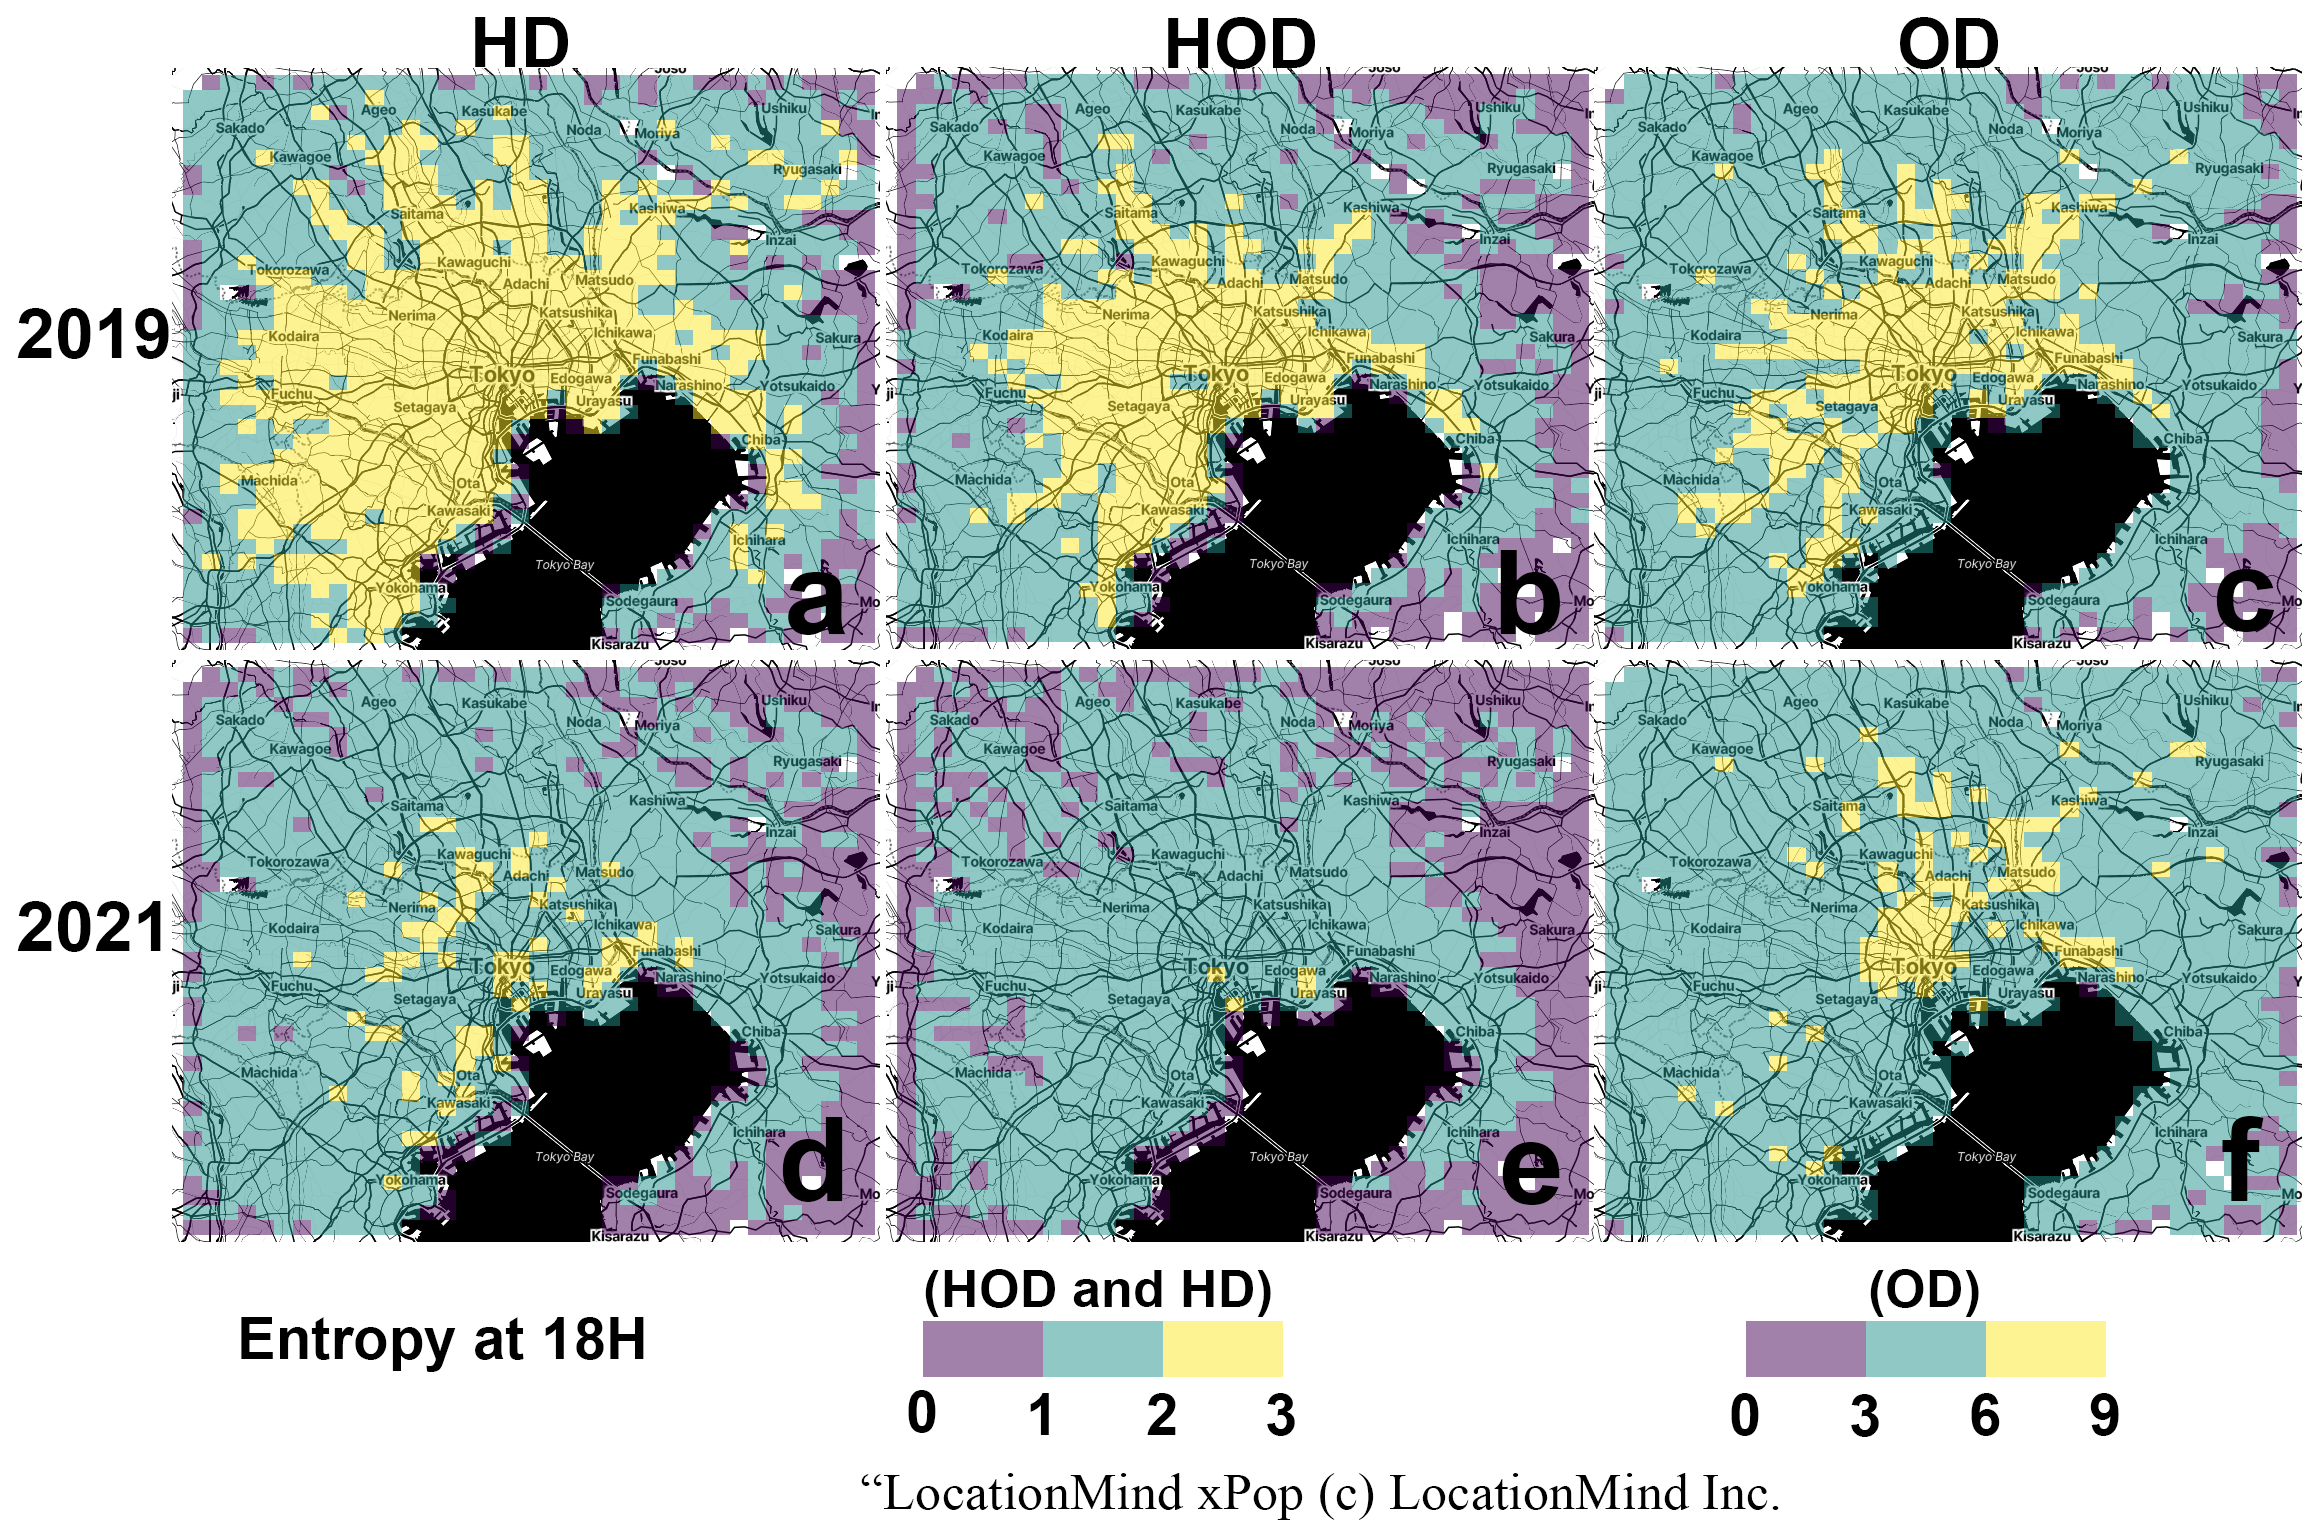
图 S4|第 18 小时的傍晚,色标为什么分成两套?
(a、d)HD,(b、e)HOD,色标 0 到 3;(c、f)OD,色标 0 到 9。上排 2019,下排 2021。HOD 与 HD 的黄色不能和 OD 的黄色当成同一个熵。即便如此,OD 的色条上限已经是另两列的 3 倍,图面仍以中心及走廊上的高值为主,2021 年高值范围缩小。来源:补充材料 Fig. S4。
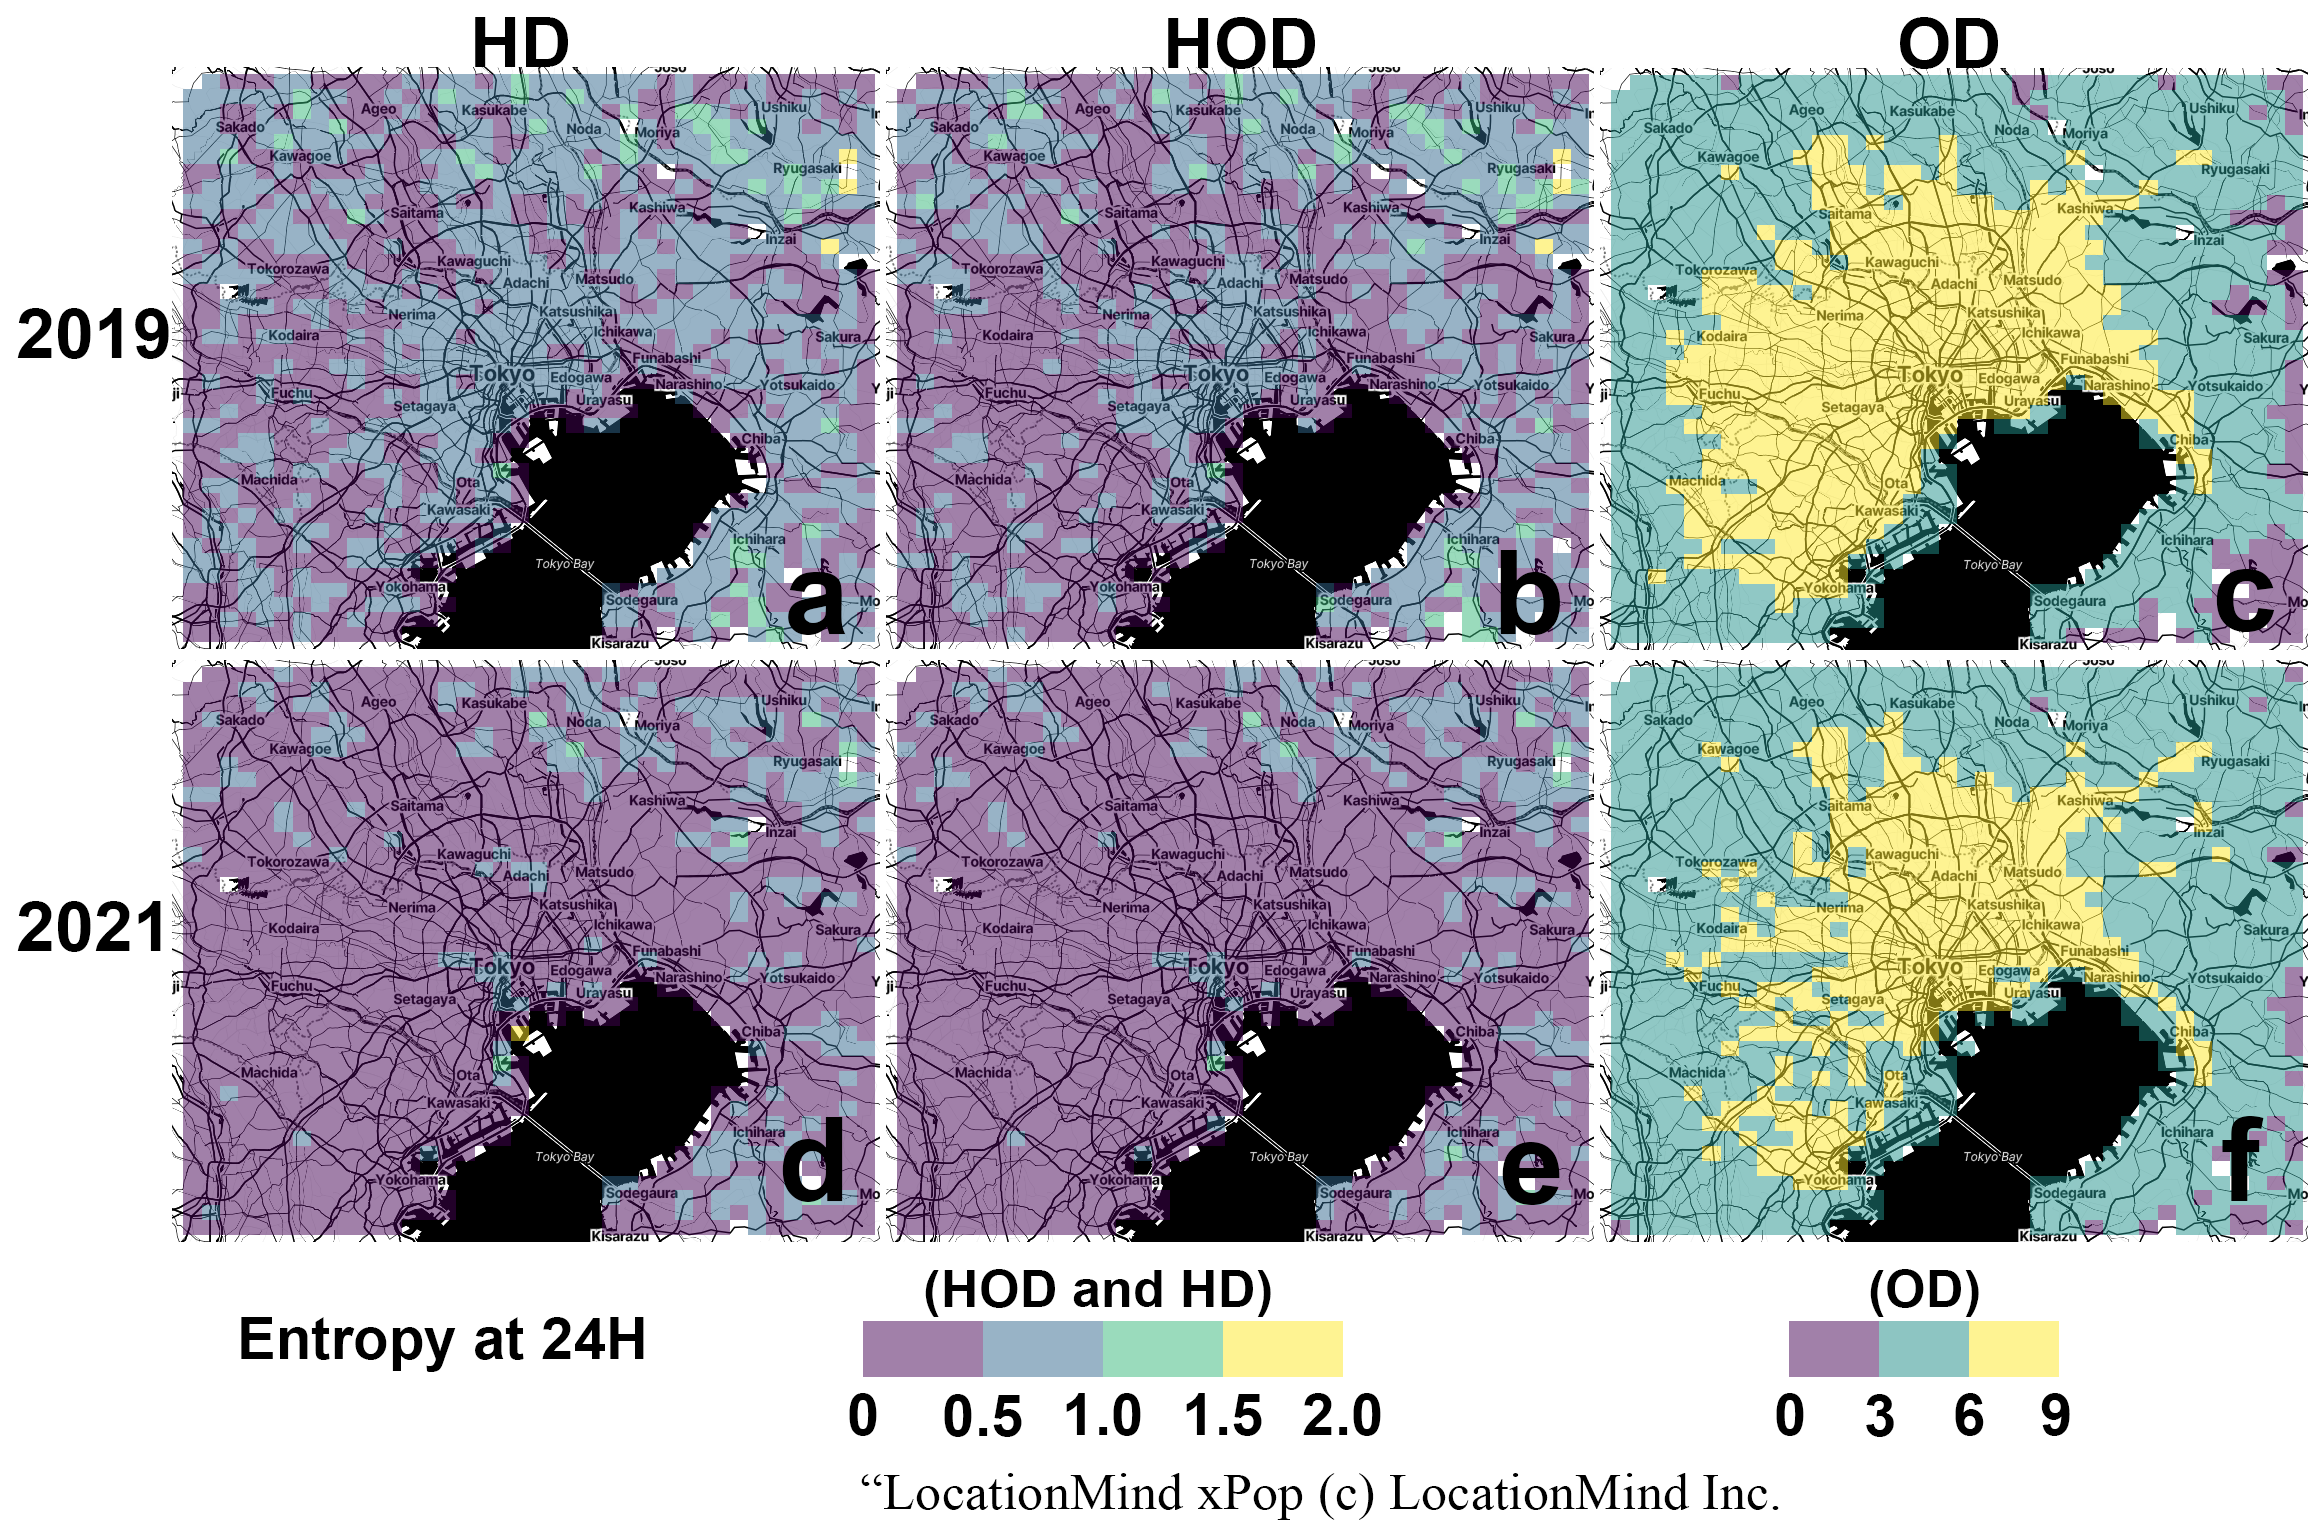
图 S5|第 24 小时的午夜,回家有没有出现在地图上?
(a、d)HD,(b、e)HOD,色标只到 2.0,大片处于低值;(c、f)OD,色标 0 到 9,中心附近仍是高熵。上排 2019,下排 2021。午夜把图 3 的夜间低谷画成了空间分布:有家信息的两种算法已经收回,只含起终点的算法仍铺在研究区中部。来源:补充材料 Fig. S5。
第 8 和 12 小时共用色标,OD 更高可以在同一色条上直接看见。第 24 小时色标分开,恰好对应两种完全不同的数量级:HOD 与 HD 大多不超过 2 比特,OD 仍用到 9 比特。补充说明写的是趋势一致,没有给出四小时的全区平均熵数值。
人口规模能解释多少最大熵?
人多的网格,去向可能更多,最大熵也可能更高。论文对每个家网格做对数曲线拟合,横轴是该家网格人口,纵轴是 24 小时最大熵。图 5 没有标注年份。人口轴以万人为刻度,右端大约到数万人,与 61,666 这个例子处于同一量级;图上没有标出 533945865 这个点。
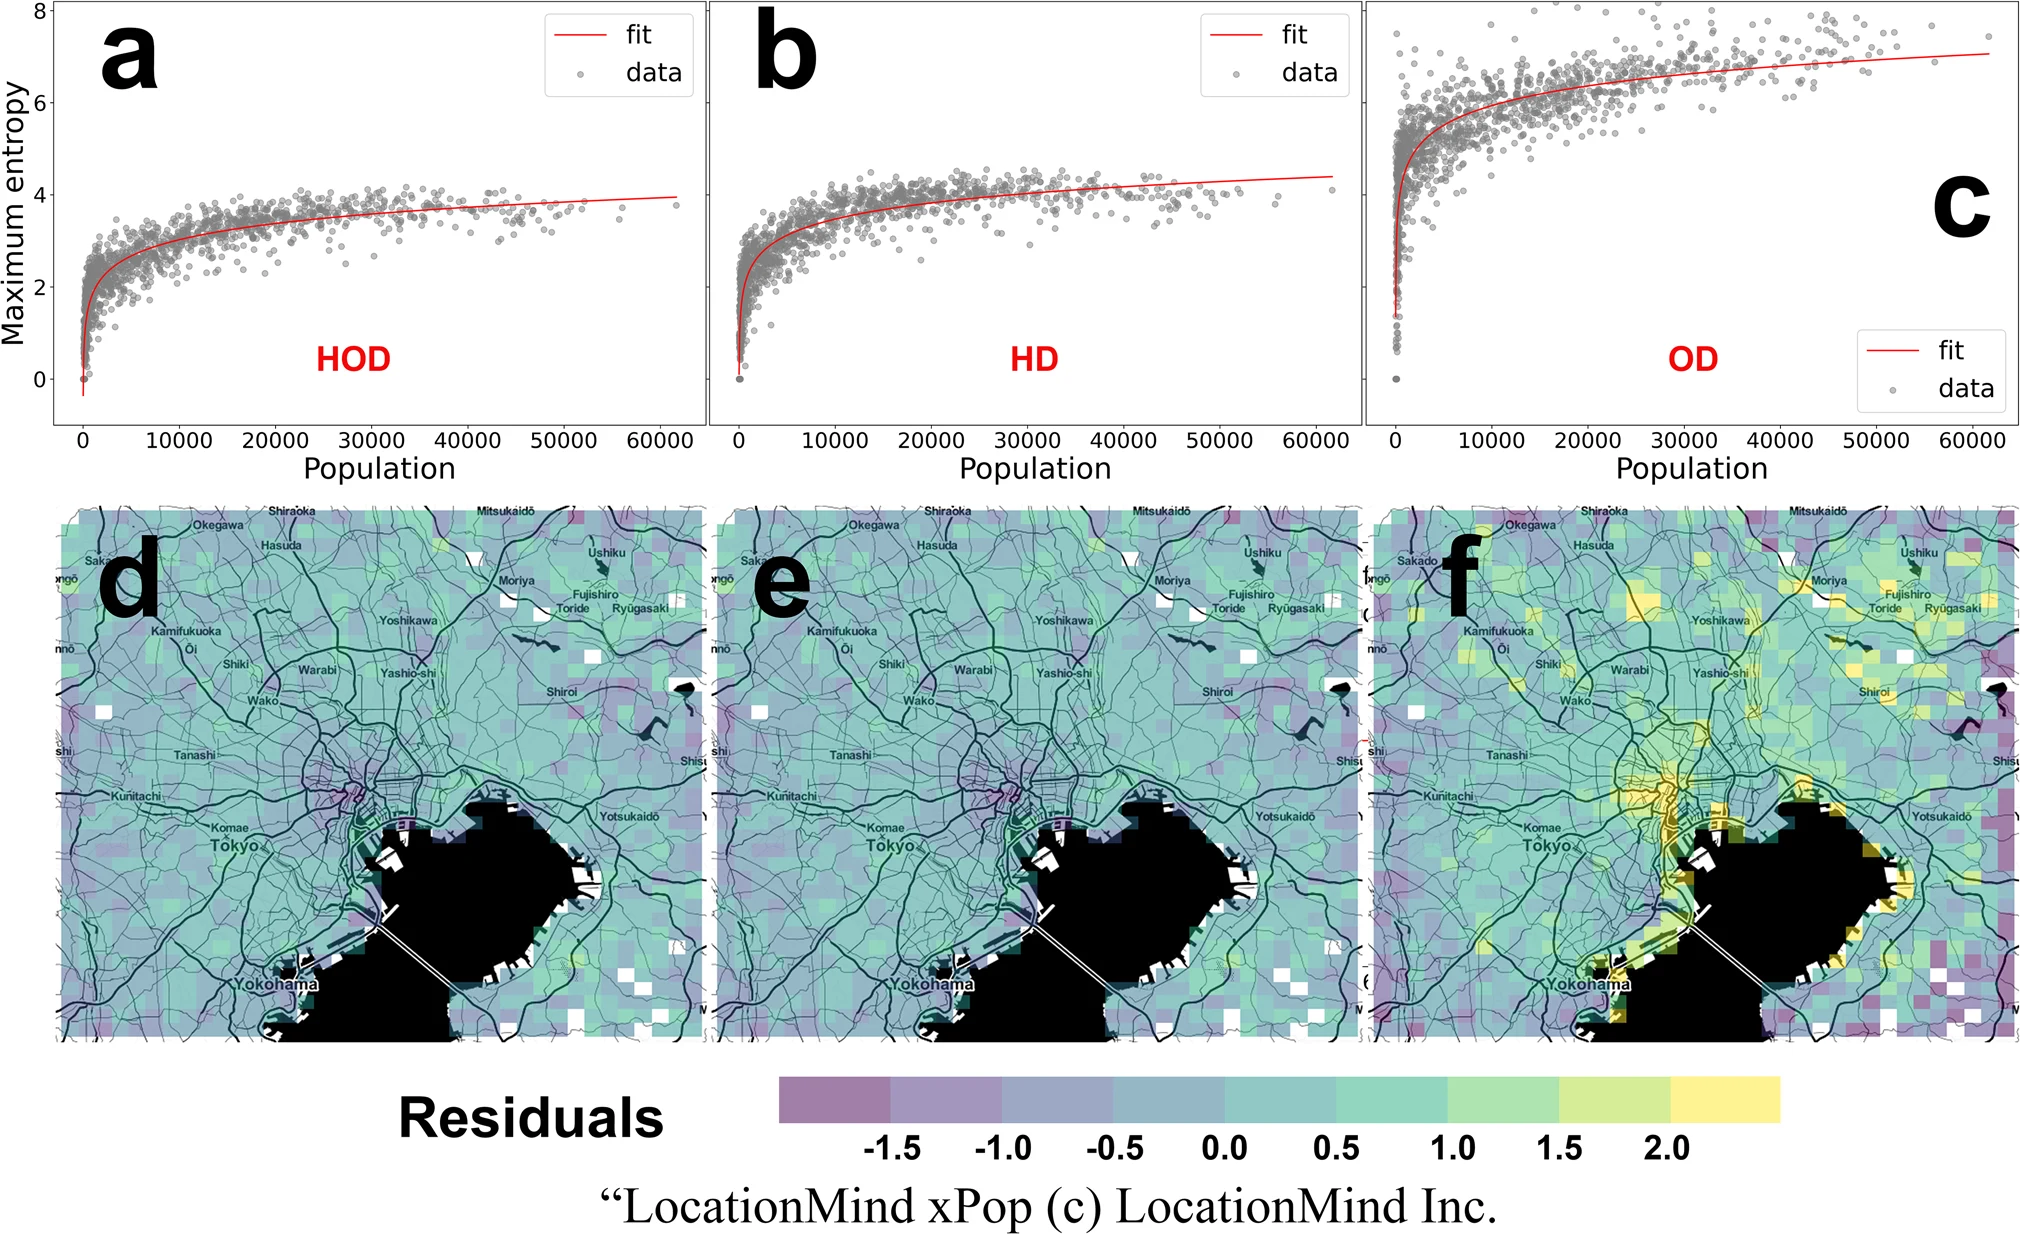
图 5|最大熵里,有多少只是因为家网格人口更多?
(a)HOD,(b)HD,(c)OD。灰点为家网格,红线为对数拟合。纵轴最大熵大约从 0 到 8;OD 的点整体更高、也更散。正文给出的相关系数按 OD、HD、HOD 的顺序为 0.706、0.720、0.743,因此最高的是 HOD,最低的是 OD。(d)HOD 残差,(e)HD 残差,(f)OD 残差。色标从 −1.5 到 2.0,单位仍是熵。中心在 d 和 e 上偏负,表示实际最大熵低于人口曲线的预测;f 在湾岸一带可见正残差,正文没有把它解释成同一种居住—就业机制。来源:原论文 Fig. 5。
0.743 是 HOD 的相关系数,不是 74.3% 的人口已经解释了熵。论文没有报告决定系数,也没有写出对数函数的斜率和截距。相关出现在三套算法里,说明人口规模与最大熵一起变化;它不证明人口规模造成了某一种出行机制。
残差是实际最大熵减去曲线预测。HOD 和 HD 的中心为负:按人口规模,中心本可以有更高的日间熵,实际更低。作者提出一种可能,中心有人居住和工作在同一网格,白天不必去别的网格。工作地并没有在这套表里单独标出,所以这是与残差相容的解释,还不是工作地识别的结果。
放大用的是 2015 年普查,而熵下降发生在 2019 到 2021。若这两年研究区人口本身变少,熵也可能下降。补充图 S1 把同一批网格的 2015 与 2020 年普查人口点在一起。
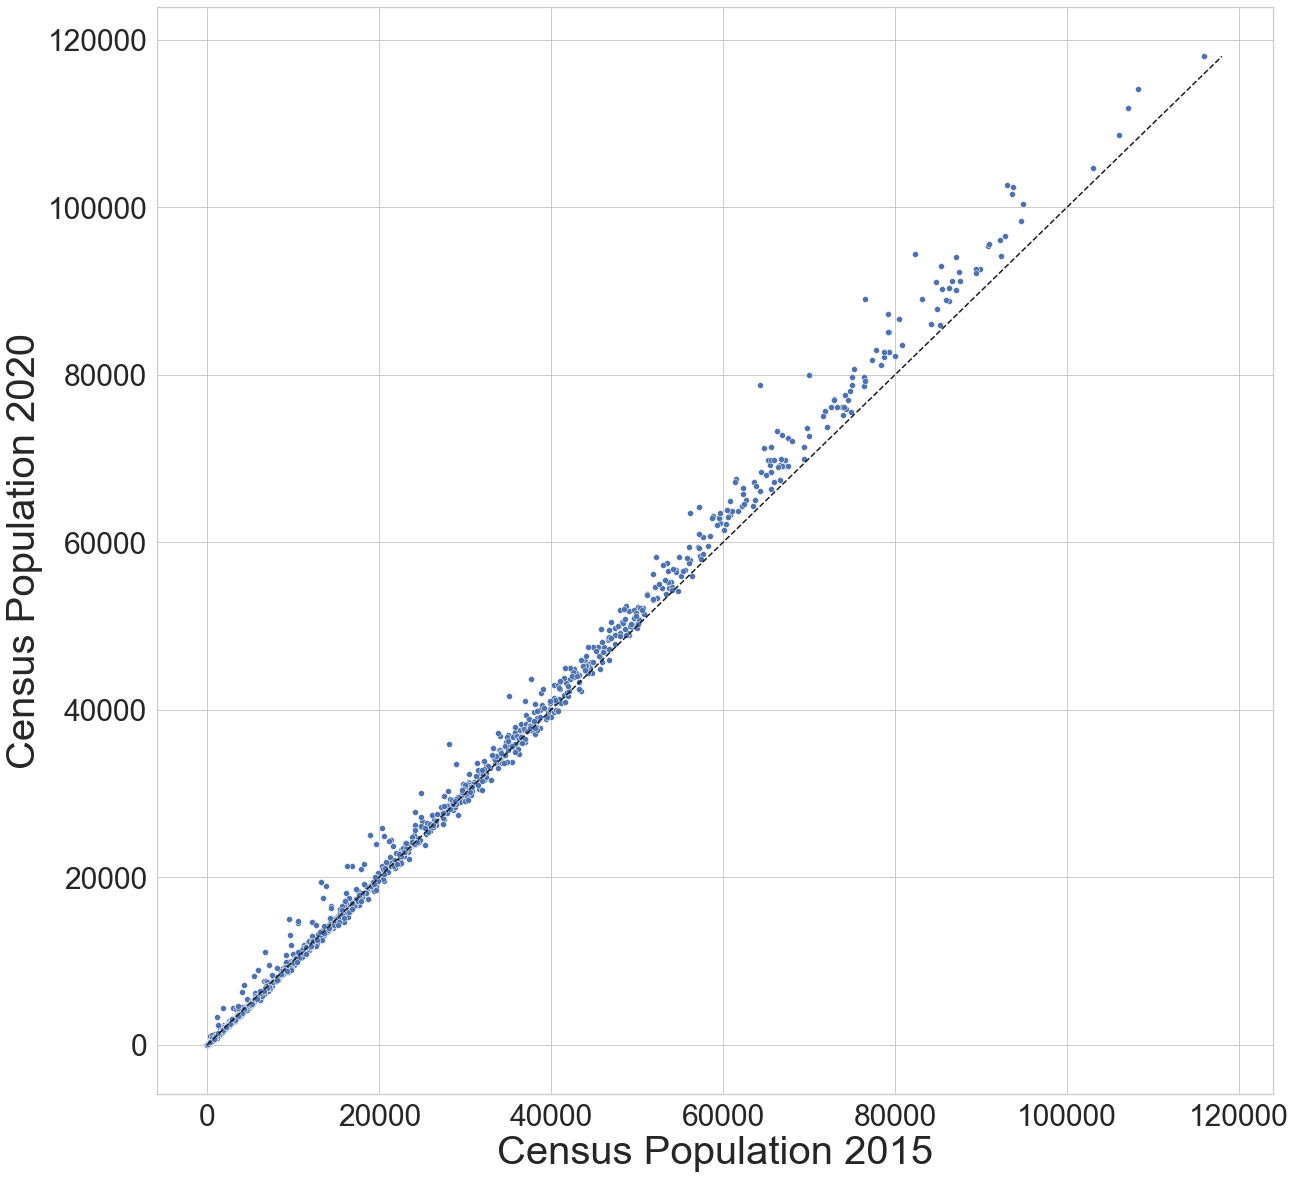
图 S1|熵下降之前,网格人口是否已经变少?
无字母子图。横轴 2015 年普查人口,纵轴 2020 年普查人口,虚线斜率为 1。点沿虚线分布。作者概括为 2020 年略有增加,因此 2019 到 2021 年最大熵下降不来自研究区总人口变少。图上没有平均增幅或相关系数。来源:补充材料 Fig. S1。
普查对照排除的是“网格人口大体变少”这一种替代解释。它不排除样本构成变化:手机用户、被阈值删掉的近一半用户,以及 2015 年普查与 2019、2021 年真实居住人口之间的差别,仍然留在放大系数里。
结论能用到哪一步
HOD 同时留下家、当前格子和下一格子,所以回流还在、当前地点也还在。OD 适合看全市尺度的流量本身,例如一条路上有多少人经过;用它做无家信息的马尔可夫外推,会把空间影响估大。HD 能表现回家,计算上不必为每个家保存一张起点转移表。讨论认为 HD 或可用于疫情模拟,并说它在计算量与纳入起点之间折中。按前文定义,HD 并不包含起点。这句应用建议和算法定义没有完全对齐,不宜当成已经比较过的疫情模型结论。
论文没有跑一个传染病模型,也没有给出 OD 会把传播规模高估百分之几。可以肯定的是图 2 和图 S5 里的空间范围:午夜时,OD 仍把人放在很多网格,HOD 把人放回家附近。
主要方法限制是随机游走。OD 与 HOD 无记忆,HD 甚至不依赖上一小时。作者引用既有研究,说明马尔可夫模型在下一地点预测上可以有效,并把它当作比较三种聚合时的简化。
数据限制同样具体。样本来自手机用户,老年人与低收入者使用手机的可能性更低,论文认为这会带来偏差。隐私阈值删掉将近一半用户,阈值未给出,低居住人数网格整格缺失。小时聚合丢掉小时内部的路径。家是不活跃时段的高频网格。两年共用 2015 年普查做放大。转移矩阵来自两个月份的工作日平均,周末未进入结果。
讨论提出的下一步,是用更长、更细的原始序列做训练与测试,看提前若干小时的人口分布误差。以现有平均日剖面,这个误差还没有被计算出来。
一句话总结
在这份东京及周边的工作日小时流量里,把估计的家放进聚合,模拟人口才会白天离开、午夜回来;只保留起终点,会把同一批人持续铺开,并用更高的分布熵把这种铺开记下来。
核心来源
- The European Physical Journal Plus 正式页面,核对题目、作者、卷期 139:403、收稿与接收日期,以及 2024 年 5 月 10 日在线发表。正文图 1–5 与全部数值口径来自该文。
- 同条目补充材料:普查人口对照为 Fig. S1,第 8、12、18、24 小时熵地图为 Fig. S2–S5。补充说明没有给出平均增幅或四小时的全区平均熵。
- 数据可用性声明:流量为 LocationMind xPop,向 LocationMind Inc. 购买;本文不公开可识别个人的轨迹。地图底图在图 2、4、5 中来自 Stamen Design 与 OpenStreetMap,补充地图来自 Stadia Maps 与 OpenStreetMap。
作者介绍
- Yunhan Du:通讯作者。论文署名为东北大学信息科学研究科,致谢中的资助为 JST SPRING(JPMJSP2114)。researchmap 记载其研究方向包括空间信息、人类移动数据分析与网络科学,并于 2025 年 3 月在东北大学取得信息科学博士。
- Takaaki Aoki:论文署名为滋贺大学数据科学研究科。滋贺大学研究者名录记载其在数据科学学部任教,研究人流与城市空间结构;本文参考文献中有其与 Fujiwara 关于城市人流空间结构的工作。
- Naoya Fujiwara:论文同时署东北大学信息科学研究科、日本科学技术振兴机构 PRESTO、东京大学空间信息科学研究中心与生产技术研究所。东北大学研究者名录记载其在信息科学研究科任教,研究方向为基于大规模人流的时空网络;本文参考文献包含其参与的灾后人口恢复和东京疫情期间出行研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市只发布起终点表,夜间的应急安置或末班运力会遇到图 S5 那种分叉:按混合转移矩阵把还在中心的人送走,午夜人口会落在许多个家;按家分层,同一批人应回到少数住宅网格。可以把一个住宅网格的午夜模拟人数与按家分层后的午夜人数相减,差值就是缺了家信息的那一部分。本文给出了 61,666 人这个初始分母和图上的数量级,没有给出每个网格的午夜人数差。
2021 年熵更低,还可能来自两种不同的流量结构。一种是目的地种类变少,一种是更多人停在家网格里,起点、终点和家变成同一个格子。后一种会直接压低熵,因为比例堆在一个格子上。可以按小时计算“家、起点、终点三者相同”的人数除以该小时总人数,再比较 2019 与 2021。若这个比例上升,熵下降里就有一段来自停在家网格。论文没有报告这个比例。
HD 每小时从家重新放置人口,白天“已经在工作地、下一小时去第三地”的人会被家到各地的出现比例盖住。HOD 熵更低,说明在同一个家网格内部,当前地点仍然在改写下一小时。用 HD 代替 HOD 做日间接触或客流,会保住回家的昼夜节奏,同时抹掉这一段二次移动。这是算法定义里已经能看见的差别,还需要独立日期的预测误差才能判断哪一种更接近第二天的真实分布。