一篇三人合作,画成三角形之后还认得出吗?
论文名片|Federico Battiston、Valerio Capraro、Fariba Karimi、Sune Lehmann、Andrea Bamberg Migliano、Onkar Sadekar、Angel Sánchez、Matjaž Perc,Higher-order interactions shape collective human behaviour,Nature Human Behaviour,2025,9(12):2441–2457,2025年12月17日在线发表。DOI:10.1038/s41562-025-02373-5。本文是视角文章(Perspective)。稿件2024年8月28日收到,2025年11月3日接收。通讯作者为 Federico Battiston。
三个人合写一篇论文,和这三个人两两各写一篇,普通网络图上都是一个三角形。四个人开一次会,若把每两人都连上,又会得到六条边。边还在,原来的那一篇论文、那一次会面,却已经不在图上。
这篇视角文章要说明的是:群体互动需要单独记下来。超图可以把任意人数的一次互动收成一条超边;把它强行投影成两两关系,群体规模就找不回来。文章自己的实证部分是 2007–2022 年 arXiv 四个学科的合作超图。传染、合作和诚实部分主要是在整理已有模型:群体压力可以让采纳从渐变变成突变,合作则同时依赖足够的三人互动和少量一开始就合作的人。作者同时写明,策略博弈的超图实验到他们写作时仍然空缺。
先说结论
- 超图用一条超边记录任意人数的一次互动。单纯复形会把更大群体的所有子集都算进去。两两投影把群体画成团,原来的群体规模留在图外。
- 在 2007–2022 年 arXiv 的物理、计算机科学、统计和数学合作中,数学的团队规模分布下降最快,到规模 10 时已低于 10⁻³ 刻度;物理下降最慢,到规模 10 时仍高于 10⁻²。互动次数接近 100 时,不同合作者由少到多是数学、统计、物理、计算机科学,右端分别靠近 50、落在 75 与 100 之间、略高于 100、超过 125。
- 三人模体里,统计和数学更常出现成对合作,以及大团队同时带有成对边。物理和计算机科学更常出现不靠成对边撑起来的三人群体。高阶嵌套性由低到高对应物理、计算机科学、统计、数学,两端分别靠近 0.04 和 0.14。
- 物理学的性别格子按行相加约为 1。成对合作中,F 行有 0.91 落在 M,M 行有 0.76 落在 M。更大群体中,F 行的 MM 为 0.81,M 行的 MM 为 0.64。这是构成比例,图注没有给出性别基数或标注方法。
- 在合作超图上的一条传染模型曲线里,加入群体机制后,感染节点比例从 0.5 升到接近 1;不加时降到 0.2 以下。这是模型输出。作者写明,超图上的策略博弈实验仍然没有。
同样一群人,五种记法各自留下什么?
社会网分析长期用节点表示人,用连线表示两个人的关系。这种图适合统计谁认识谁,却默认每次互动都能拆成一对一对。三个人的一次合作,和三次分开的两人合作,投影之后都可以变成同一个三角形。合影、会议和一封多人邮件若被画成全连接,传递性会被人为抬高。
高阶互动(higher-order interaction)指一次关系里同时有两个以上的人。超图(hypergraph)写成 ℋ = {V, E}:V 是人,E 是超边。一条 k-超边表示 k 个人的一次互动,k 可以是 2,也可以是 3 或更大。只有成对关系时,超图退回普通图。
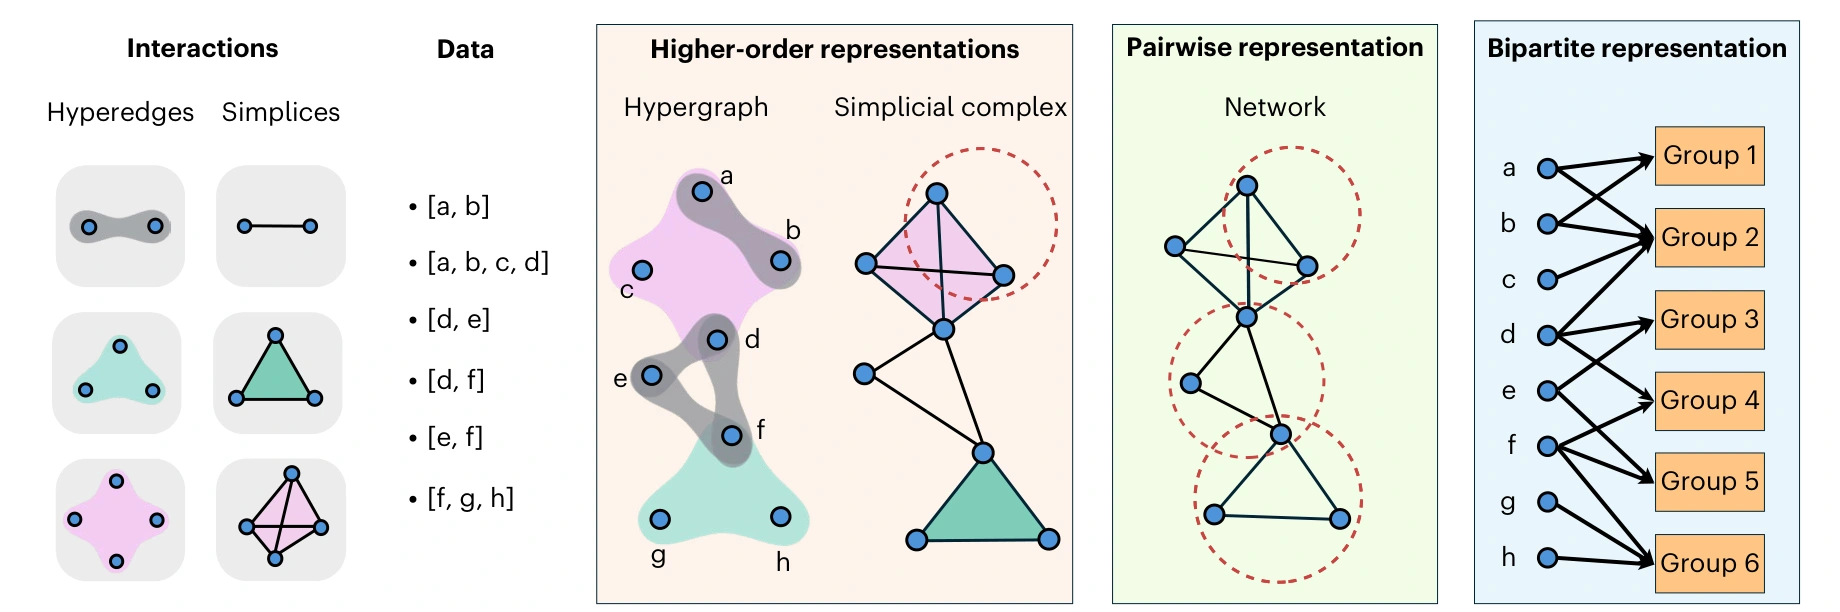
图 1|同一次群体互动,五种记法分别保留了什么?
图中没有子图字母。a–h 是人的节点名,Group 1–6 是群体名。最左一列比较超边和单纯形:两个人是一条边,三个人可以是一个三角形群体,四个人可以是一个更大的群体。旁边的 Data 列出若干真实互动,例如 [a, b]、[a, b, c, d] 和 [f, g, h]。
高阶表示分成两格。超图只画数据里实际出现的群体,颜色块可以重叠。单纯复形(simplicial complex)要求最大群体的所有子集也在图里,于是红圈标出的位置会把并未单独发生的低阶关系一并算上,重叠与不重叠也就分不开。
两两表示把每个群体投影成团。红圈标出的三角形和完全连接,已经看不出原来是一个三人群体,还是若干对两人关系。最右的二分图保留了人与 Group 1–6 的对应,群体仍可区分,但群体被画成另一层节点,而不是连线或超边。来源:原论文 Fig. 1。
单纯复形方便做拓扑数据分析,因为子集结构是现成的。它适合“大群体出现,就意味着所有子群体也出现”的场合。科学合作常常不满足这一点:三个人可以合写一篇论文,而这三对人未必各自再写过论文。二分图不歪曲归属,但人与互动不再共用“节点是人、连线是关系”这套语言。超图把节点留给行动者,把互动留给超边,因此后文的合作、接触和博弈都沿这条记法展开。
局部上,高阶聚集系数和模体用来看小群体怎么搭在一起。更大尺度上,已有方法可以找硬划分或重叠的社区,以及核心—边缘结构。这些工具说明超图能接过一部分网络分析,并不表示每一种社会过程都已经在超图上重新测过。
一篇论文怎样变成一条超边?
隶属网络天然就是群体数据:一个人参加若干组织、仪式或论文,每个群体都可以是一条超边。科学合作是其中被研究最多的一类。团队越来越重要,并不自动等于每一种两人合作都失去作用;它只说明,若把每篇论文压成许多两人边,论文本身这个单位就消失了。
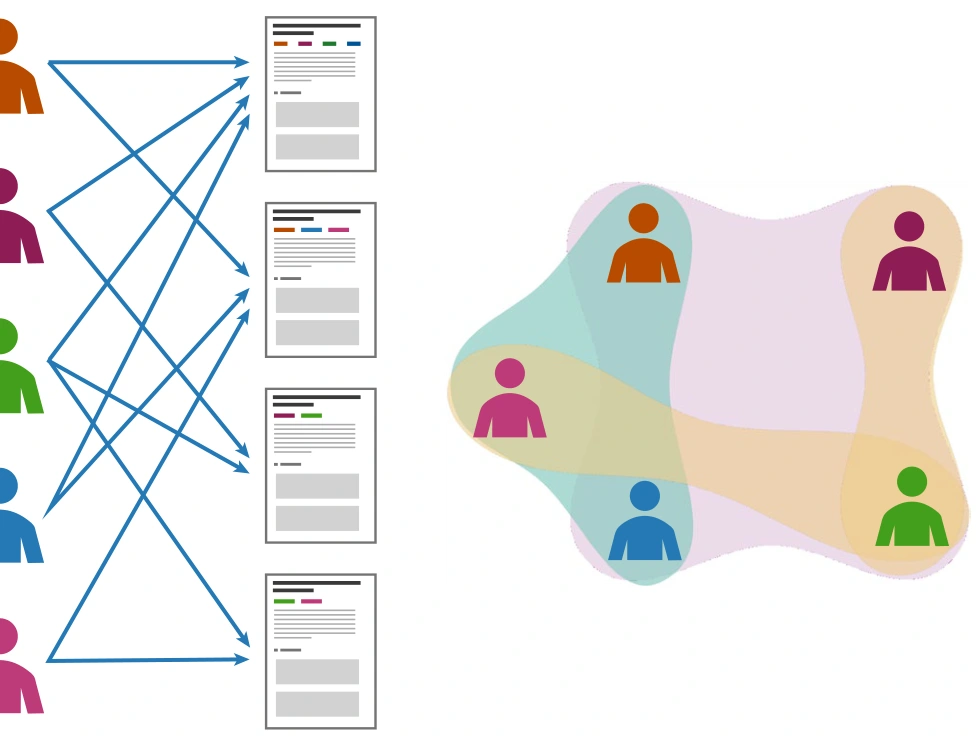
图 2|作者和论文的归属,怎样收成一张合作超图?
无子图字母。左侧是人与论文的隶属关系,箭头把每位作者连到其参与的论文。右侧把同一批关系画成超图:每一块颜色是一篇论文的全部作者,重叠表示同一个人参加多篇论文。一个人可以同时落在好几块颜色里。来源:原论文 Fig. 2。
如果同一组人反复一起出现,这组节点更像一个稳定的社会单位,而不只是一次偶然共现。科学合作和职场组队都有这种重复。由此可以相对零模型寻找统计上显著、并且反复出现的高阶互动。已有研究发现,这类持续合作多半大于两人,也更可能在地理上靠近;那是被引用的结果,不是本文专栏重新给出的距离或比例。
合作数据里还有一个不能从两人图直接读出的现象:单纯闭包(simplicial closure)。三个人如果已经两两合作过,他们三人再一起发表的机会会升高。这是结构洞在群体上的一种推广,强度随合作类型变化。不同学科的典型团队规模可以差很多,但每位科学家参与的合作次数往往更接近,大型实验如欧洲核子研究中心是例外。一种解释是注意力有上限。这个“次数接近”来自既有 arXiv 分析,本文没有在正文重新报告每位科学家的论文数。
团队更大,是否就换了更多合作者?
专栏用 2007–2022 年上传到 arXiv 的全部论文,分物理、计算机科学、统计、数学四个领域,各建一张合作超图。每条超边是一篇论文的作者集合。正文没有给出论文篇数或作者人数,因此下面的比较都是分布、模体丰度、嵌套性和条件构成,不是“多少人里有多少人”。
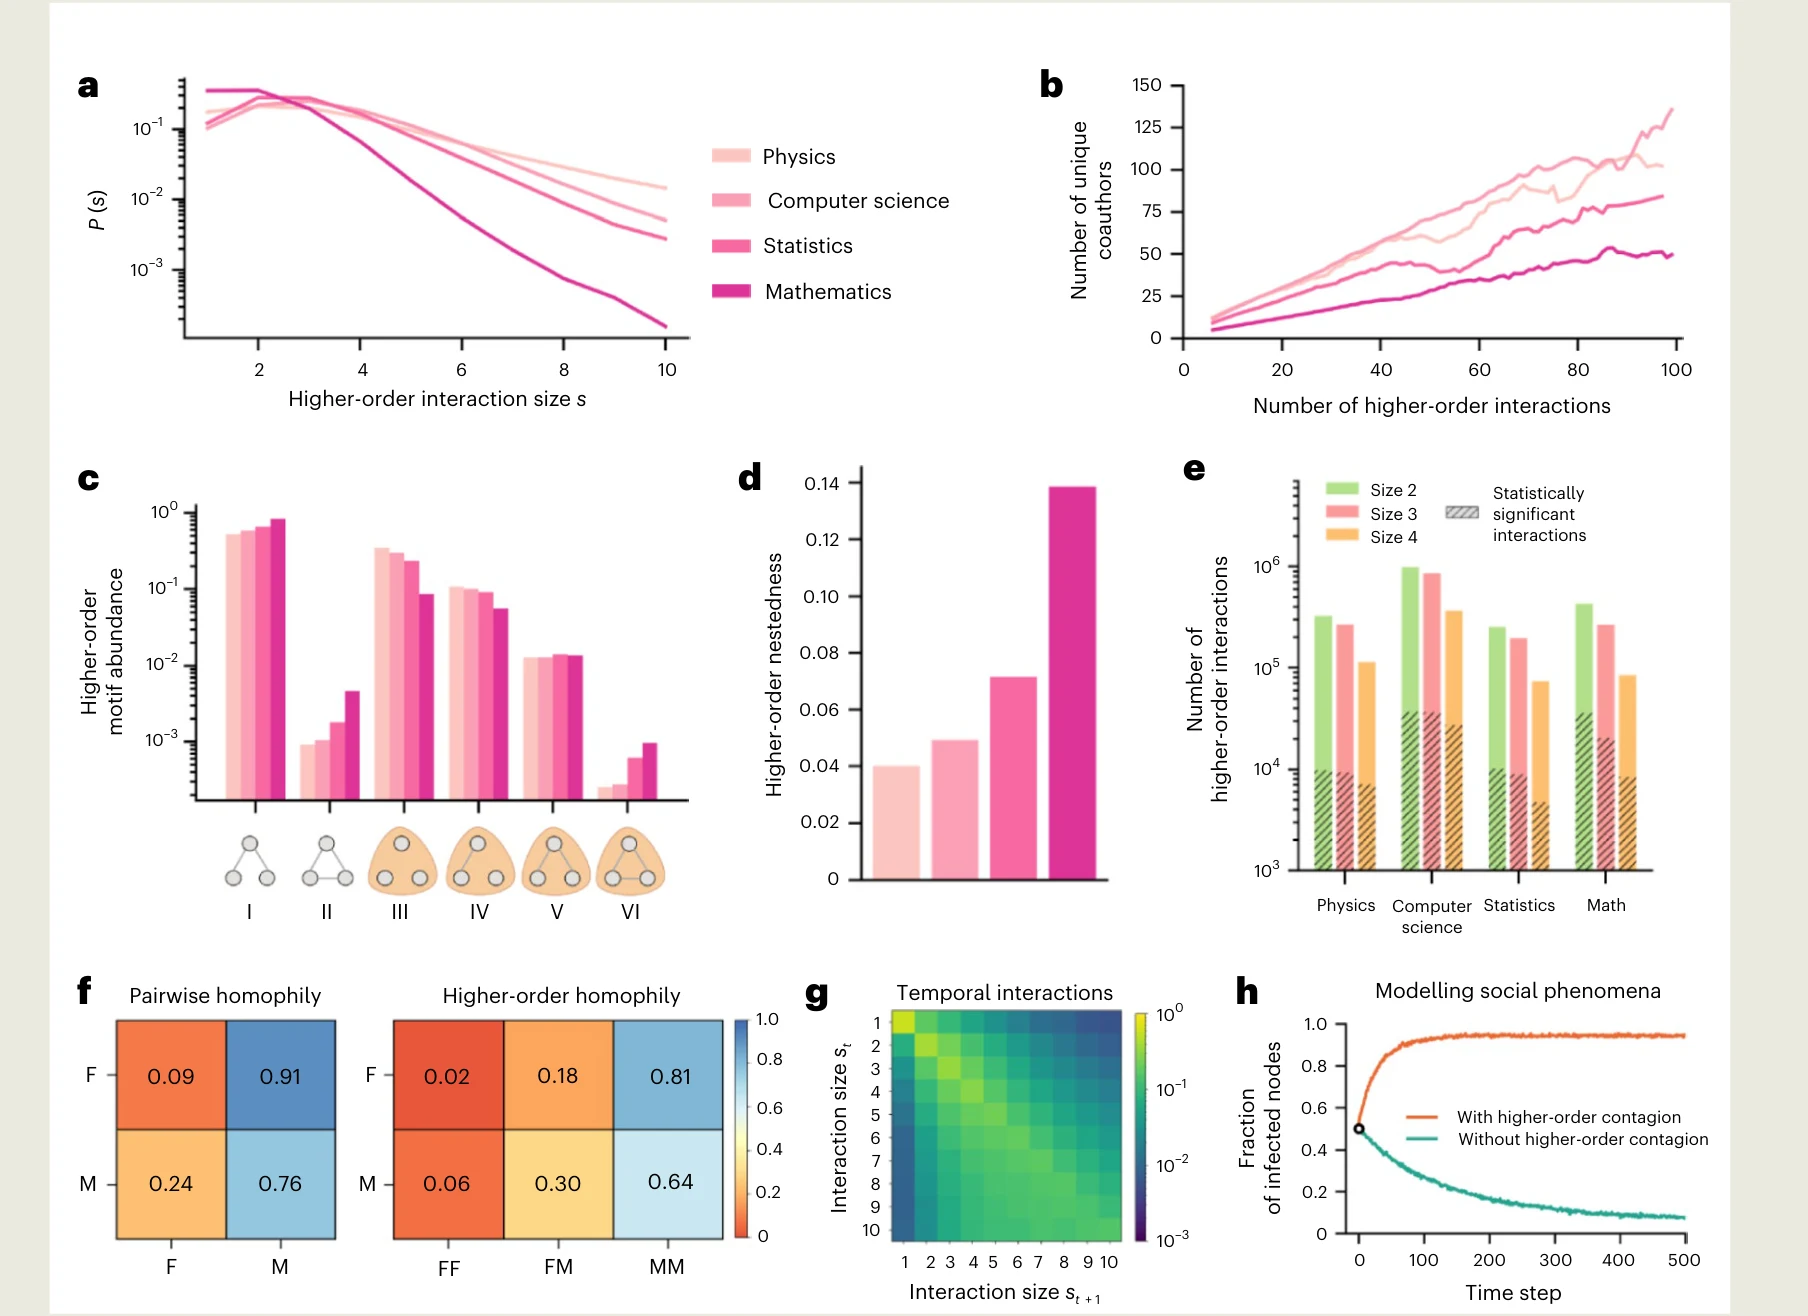
图 3|四个学科的合作超图,在哪些结构上分开?
(a)纵轴是互动规模分布 P(s),对数刻度,横轴是高阶互动规模 s,标到 2、4、6、8、10。浅到深依次为物理、计算机科学、统计、数学。几条曲线在小规模处靠近,随后交叉。数学下降最快,到 s = 10 时落到 10⁻³ 刻度以下;物理下降最慢,到 s = 10 时仍高于 10⁻²。团队更大,读的是分布的尾巴,不是平均每篇论文的精确人数。
(b)横轴是高阶互动次数,画到 100;纵轴是不同合作者人数,刻度到 150。这是作者职业生涯里的累计关系,不是单篇论文。右端由低到高是数学、统计、物理、计算机科学:数学靠近 50,统计落在 75 与 100 之间,物理略高于 100,计算机科学超过 125。物理的单篇团队往往更大,但在同样的互动次数下,物理学家的不同合作者少于计算机科学家。曲线没有逐点数值表,上面只对照轴上的刻度。
(c)纵轴是三人子图的高阶模体丰度,对数刻度从 10⁻³ 到 10⁰,每个模体里四根柱仍按(a)的颜色排列。I 是三条人里两条成对边、缺少闭合边;II 是一条成对边加上一个分开的人;III 是一个三人群体、图上没有成对边;IV、V 是三人群体再加一条或两条成对边;VI 是三人群体加上全部三条成对边。I 在四个学科都最高,柱顶位于 10⁻¹ 与 10⁰ 之间;VI 最低。图注指出,II 和 VI 在统计、数学中更突出:他们常成对工作,组成更大团队时也往往带着成对合作,这就是单纯闭包。III 在物理和计算机科学更高:群体可以不依赖底层的成对边。丰度高不表示某一种模体就是合作成功的原因。
(d)纵轴是高阶嵌套性,刻度从 0 到 0.14,衡量较小群体有多少被包进较大群体。图下没有再印学科名,颜色与(a)相同。从左到右柱高上升:物理靠近 0.04,数学靠近 0.14,计算机科学和统计落在中间,统计更高。嵌套性高,支持“小群体包在大群体里”;它不表示该学科的论文篇数更多。
(e)纵轴是高阶互动数量,对数刻度从 10³ 到 10⁶。每个学科三根柱为规模 2、3、4,斜线是相对“保留每位作者活跃度”的零模型后、统计上显著的共现群体。计算机科学的规模 2 和规模 3 柱顶靠近 10⁶,高于其余学科;各学科的规模 4 都更矮。斜线只占整根柱的下部,所以论文总数不能当成稳定团队数。零模型保住的是作者活跃度,没有在这张图上同时控制机构、国家和主题。
(f)只看物理。左为成对同质性,右为高阶同质性,颜色从低到高对应 0 到 1。行是 F 与 M。成对合作的列是 F、M:F 行的两个格子为 0.09 和 0.91,M 行为 0.24 和 0.76。高阶合作的列是 FF、FM、MM:F 行为 0.02、0.18、0.81,M 行为 0.06、0.30、0.64。每一行相加为 1,F 行的高阶三个数因四舍五入变成 1.01,因此格子是给定行标签后的构成比例。图注称这是性别互动,但没有说明 F、M 如何标注,也没有给出物理作者里 F 与 M 的基数。MM 占 0.81,不能单独写成某种偏好已经被证明。
(g)物理合作中,下一次团队规模 sₜ₊₁ 随当前规模 sₜ 变化的转移概率,两个轴都是 1 到 10,颜色取对数,从 10⁻³ 到 10⁰。最亮的格子在“规模 1 仍留在规模 1”。图注写明,物理里做过较大合作的人很少回到更小团队;数学家更经常在不同规模之间切换,但那张热图没有画出。
(h)在这张合作超图上演示传染模型。纵轴是感染节点比例,横轴是时间步,画到 500。两条曲线从 0.5 出发。加入高阶传染后,比例升到接近 1 并保持;不加时降到 0.2 以下。这是模型曲线,不是观察到的思想传播人数。来源:原论文 Box Fig. 1。
(a)到(e)说明,团队大小、合作者是否换人、三人关系能否拆开、小群体是否嵌进大群体,是四件不同的事。物理可以同时有较大的团队和较低的嵌套性。计算机科学的互动条数最多,也不因此成为嵌套性最高的学科。
面对面的一群人,怎样随时间聚散?
家庭、朋友和一次四人谈话都有同样的问题:同一组节点会反复出现,而四个人当时的关系也不能事先写成六对。接触数据因此也可以记成超边,并且超边会随时间出现和消失。
哥本哈根网络研究是文中着重提到的高频接触数据。Sekara 等人观察约 1,000 名本科新生,以 5 分钟为间隔,持续 36 个月,记录蓝牙近距离,也记录通话、短信和社交媒体。身体接近被描述成一串持续时间最长可达 12 小时的全连接聚集;规模为 K 的聚集就是 K 个人的一次会面。反复出现的聚集被称作核心。用聚集和核心,而不是只用两人关系,可以定义并预测个人的社会轨迹。这些数字属于被引用的研究,分母是该项研究中的学生、时间间隔和观察月数,不是本文新招募的样本。
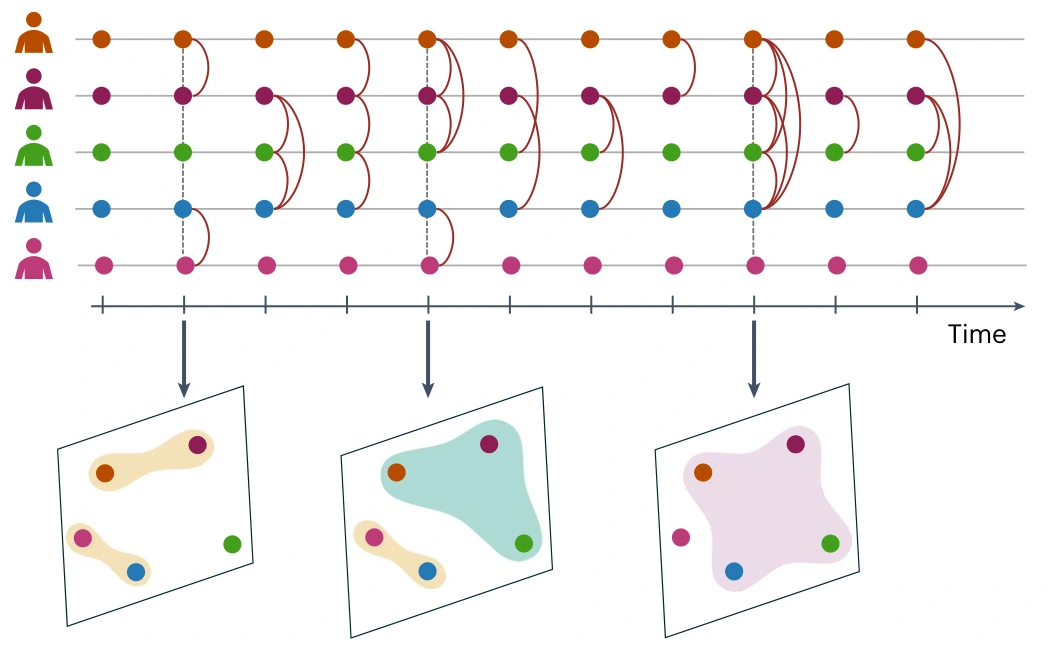
图 4|一次面对面聚集,怎样从时间线上摘成超边?
无子图字母。上方每个横行是一个人,圆点是该人在各时间点的在场,弧线把同一时刻靠近的人连起来。下方三个斜放的小图,是三个时刻抽出来的群体:颜色块是当时的超边,有的时刻是若干小群体,有的时刻合成一个更大的群体。来源:原论文 Fig. 3。
文中综述的其他接触数据包括宿舍里的感知手机、SocioPatterns 的工位、会议和医院、学校、办公室、博物馆,以及学前三年的面对面记录。它们的共同用途是看群体如何形成和拆开,不是给出一张统一的接触率表。
不论聚会规模大小,群体互动都倾向于在时间上挤在一起,这被称为爆发性。后续测量发现,规模相近的群体即使隔着较长的时间仍然显著相关,因此过去的聚会会在后来留下痕迹;群体合并与分开的方式还随规模变化。从个人一侧看,人常常从较大群体走到较小群体,群体的聚散多半是一小步一小步发生,而不是突然整组替换。这些是被引用的时间超图结果。本文图 4 本身是示意图,没有新的聚集持续时间。
动物群体也被用来说明高阶接触不只属于人类。一项关于白头秃鹫珠鸡的分析发现,雌性和低等级个体更多出现在两人互动中,雄性和更占优势的个体更多出现在两人以上的群体中。这是动物社会的观察,不能写成人类会议的性别规律。
人为什么加入附近的群体,群体又为什么按属性分开?
只让超边按照自己过去出现的次数更新,可以重现长期的群体相关,以及合并、分开的动态。从个人一侧建立的模型则让人在每个时间步选择留下,或离开后加入新群体,依据是在群体中待过的时间和过去遇见谁。两条路线都能对着接触数据检查聚散模式。它们说明“记忆中的群体”是一种够用的生成机制,不是唯一机制。
面对面接触还有空间。一个人只能加入附近的群体。模型给每个群体一个吸引力,吸引力依赖规模和组成;范围内的人据此决定加入或走开。这样可以重现群体规模分布、一个人同时参加小群体和大群体的相关性,以及群体在时间上的持续。两人模型复现不了这些群体性质。
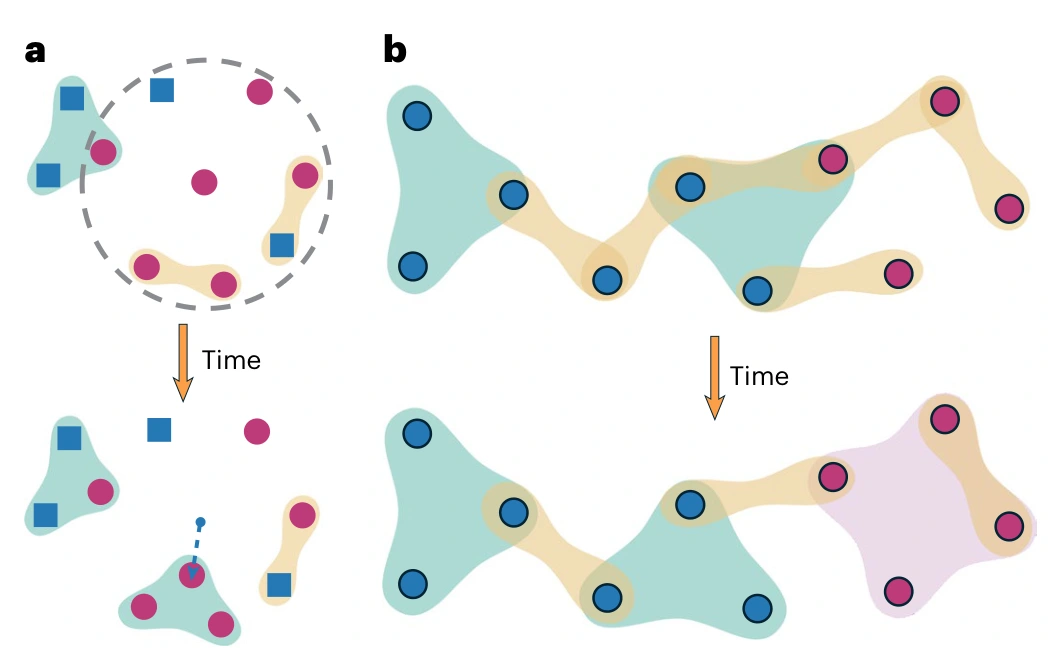
图 5|群体吸引力和同属性聚集,分别改变哪一步?
(a)上方虚线圆是一个人能够考虑的空间范围,圆内有若干已形成的小群体;粉红与蓝色表示两种属性,文中举例为性别。橙色箭头向下是时间。下方这个人移向其中一个群体。(b)上方是初始超图,不同属性的人通过两人边和更大的超边连在一起。下方经过按群体偏好的重连后,相同颜色更集中,超图的同质性变高。两幅都是模型示意图,没有标出人数或分离指数。来源:原论文 Fig. 4。
同质性(homophily)指人倾向于与自己相似的人来往。群体会把这种倾向放大:一个人同时在多个属性上与同伴相似时,社会经济地位、种族和族群上的隔离可以叠在一起。高阶互动可能加强这种叠加。图 5b 演示的是重连之后的分隔,不是某座城市或某个平台上测得的隔离比例。
十个人各讲一小时,和一个人讲十小时,差在哪里?
生物传染里,两人待在一起的时间越长,感染概率通常越高,所以每条边可以当成一个独立传染源。社会传染不同。一个人用十小时传递一种行为,和十个人各自用一小时传递同一种行为,暴露的总时长可以一样,社会效果不一定一样。
简单传染中,每条边以概率 β 独立传染。复杂传染要求足够多的暴露:邻居里已采纳者的比例达到 θ 才传染。复杂传染已经承认“一次不够”,但它把一个节点的所有邻居放进同一个比例,不再区分这些邻居是不是同一个群体里的人。高阶传染把群体放回模型:不同规模的超边可以有不同的传染强度,群体传染概率写成 βΔ。
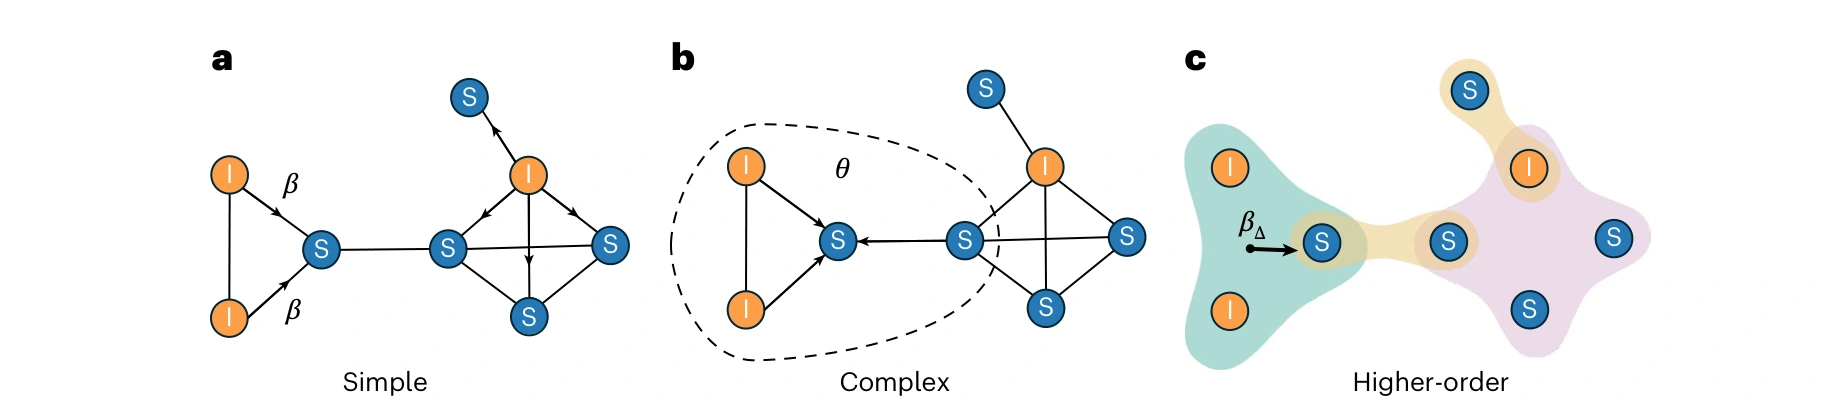
图 6|简单传染、复杂传染和高阶传染,各把哪一种暴露算进去?
(a)简单传染。橙红色 I 是已感染或已采纳,蓝色 S 是易感。每条指向 S 的边各自以概率 β 传染。(b)复杂传染。虚线围出的邻居要有足够高的比例 θ 已经是 I,中心的 S 才转变。这里使用的是邻居比例,不记录这些人是否组成一个群体。(c)高阶传染。颜色块是不同的超边,群体可以按规模使用不同的传染概率 βΔ。图中没有给出 β、θ 或 βΔ 的数值。来源:原论文 Fig. 5。
群体影响较弱时,系统表现得像传统的易感—感染—易感模型:存在一个成对传染率的临界阈值,阈值一侧新想法很快消失,另一侧会在人群中留下来。临界点附近的变化通常是渐变的,采纳者只占一小部分。群体压力很强时,阈值降低,转变变成突然的大规模采纳。均值场分析里还会出现地方性流行和消失两种稳定状态并存。于是,一开始有多少人已经采纳,会决定同一种规范是扩散开,还是消失。这就是模型里的临界规模。
上述定性结果最初来自比较均匀的单纯复形,后来推广到异质单纯复形和超图。图 3h 是在 arXiv 合作超图上的一条演示:起点放在 0.5,加入群体机制后感染比例接近 1,不加则下降。它支持“群体机制可以促进模型中的传播”,不能从这个起点反推现实合作网络的临界采纳率就是 50%。正文也没有重新给出 β 或 βΔ 的拟合值。
合作和诚实,什么时候不能拆成许多两人博弈?
多人同时行动、并一起承担后果时,经典网络上的“群体”往往有两种含糊:谁算一组,成本由谁分。把群体互动硬加到普通网络上,拓扑的作用还会被平均掉,大群体尤其接近充分混合。超图让一条超边直接成为一场多人博弈。
一个标准结果是:超图上的公共物品博弈,在充分混合极限下精确对应复制者动态。它提供的是零模型,也就是群体合作在没有额外结构时该如何演化,不是某次实验的合作率。收益若随组内每多一个合作者而发生非线性放大或折扣,这种收益就拆不成若干两人博弈。提高这种非线性,模型中的合作会增强。
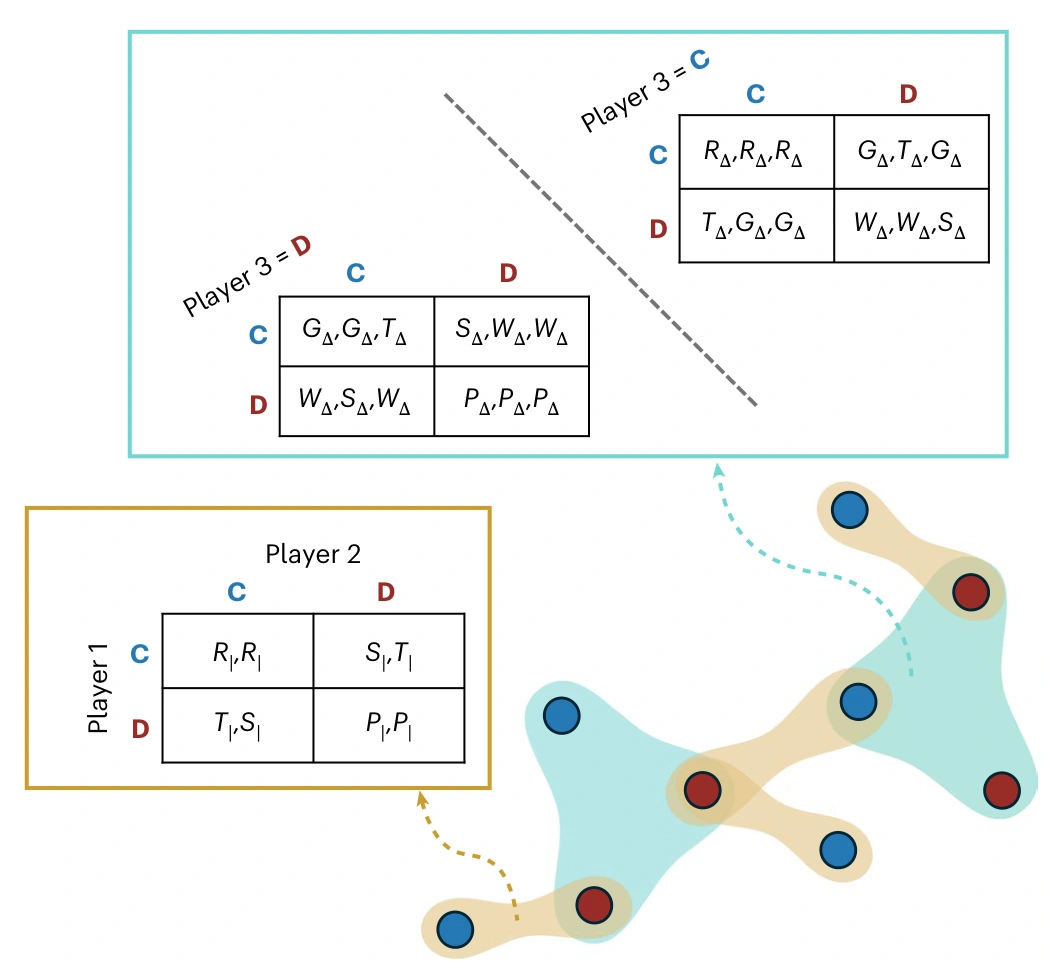
图 7|两人博弈和三人博弈的收益,怎样同时挂在一张超图上?
无子图字母。右下是一张同时含两人超边和三人超边的示意图,蓝色和红褐色表示两种策略。左下棕色框是两人收益:C 为合作,D 为背叛。双方合作的收益是 R,双方背叛是 P;合作者遇见背叛者得到 S,背叛者遇见合作者得到 T。下标竖线表示这是成对收益。上方青色框是第三人分别为 C 或 D 时的三人收益立方,下标 Δ 表示高阶收益。GΔ 是合作者面对“一合作、一背叛”这种混合组合时的收益,WΔ 是背叛者面对同一混合组合时的收益。图中全部是符号,没有数值。来源:原论文 Fig. 6。
在这套框架里,高阶囚徒困境中合作能否起来,依赖两件事:三人互动占有一个最低限度的足够比例,以及一开始就有一小群坚持合作的人。文中没有给出这个比例或这群人的百分比。若策略还可以随群体规模改变,并且不同规模的互动在结构上重叠更多,合作会进一步被促进。这些都是模型结论。图 7 把收益如何赋值画清楚,没有展示模拟曲线。
诚实也很少只发生在两个人之间。政客对公众说话、董事会决定是否披露信息,都是一个对多个,或一组对一组。文中写到,截至当时只有一项研究把发送者—接收者博弈放进高阶结构:一个发送者对多个接收者,群体之间连成超环;超边规模较小,以及使用 SocioPatterns 的真实高阶结构时,说实话可以演化出来。另一项研究让同一发送者面对一个社区里的多个接收者,发现“猜对真实状态”与“猜错”之间的收益差,对说实话的演化呈倒 U 形。两项都没有在本文留下具体百分比。信任、公平与效率、利他惩罚等其他道德行为,在高阶网络上的演化研究仍然很少。
超图上的策略实验,现在空在哪里?
过去三十年的网络行为实验已经覆盖协调、公共物品、合作、最后通牒和交易。参与者通常选择一个行动,这个行动再以成对方式影响其全部邻居。作者写明,就他们所知,还没有在超图上进行的策略博弈实验。
普通网络实验里的“邻居”也还不是这里说的群体。每个人还有自己的邻居,群体并不作为一个单位去连接另一个群体。组织里的团队常常是一组人共同承担一项任务,而不是许多私人配对的总和。超图实验要补上的就是这一层。
设计不能只把网络实验的人数换成超边人数。自愿合作本身就脆弱:多数人是条件合作者,不是纯粹的搭便车者。群体一开始是否贡献,会影响后来的贡献者,对一开始不贡献的人则不一定;把个人行为告诉群体,即使群体起初都不贡献,贡献也可能上升。群体很大时,信息用平均数还是用分布来呈现,会改变个人行为的分布。非线性收益下,实验里的群体规模本身就可能提高合作。网络实验还显示,社区、中心性、连接数是奇数还是偶数,都会让涌现行为明显变化;结构太复杂时,参与者可能理解不了自己所处的位置。因此,超图实验的第一步是检查参与者是否真的理解那些群体,而不是直接解释成现实组织的因果效应。
计算上也有三道限制。有些数据本来就是超图,例如论文作者;另一些数据只存成两人边,恢复群体需要足够细的时间,让同时出现的两人边重新合成超边。超图维度更高,软件往往同时保存哈希表和稀疏关联矩阵,用空间换查询速度。随机超图的可能构型比普通图多得多,零模型若抽样太少,显著与否可能站不稳。专栏(e)使用的活跃度零模型,就是这种对照里的一种,不是所有高阶零模型的代表。
文末还列出五处可能的推进方向:高阶数据的计算与零模型、群体形成中的偏差与不平等、团队随时间的变化、狩猎采集社会中的累积文化,以及语言如何在群体边界上分化。政策一节是另外写下的:气候、海洋资源和人工智能这类集体困境很难把所有干预都做进实验;超图模拟可以同时比较许多干预,但模拟排序仍然是理论建议。文中引用的一项村庄健康教育研究发现,按友谊提名选择传播对象,可以减少达到预定全村采纳水平所需的家庭数。本文没有写下减少了多少户。
这些方向都还停在“框架能够提出什么问题”。猎人和采集者的药用植物知识、团队的马太效应、方言作为群体边界,文中是作为值得用时间超图去追踪的例子,不是新的测量结果。
这些图能支持到哪一步?
本文是视角,不是一套新的随机实验。能够直接对着图核对的原始分析,是专栏里的 arXiv 合作超图。接触、传染、合作和诚实的具体结论,多数来自所引用的模型和数据;引用研究里的样本,不能改写成 Battiston 等人新招募的被试。
专栏内部也有边界。(a)到(e)没有论文篇数和作者人数,不能把 P(s) 或柱高换算成“某学科有百分之多少的论文是十人团队”。(d)没有印学科名,学科靠与(a)相同的颜色识别。(f)的性别格子没有基数,也没有标注流程。(g)只画了物理。(h)是传染模型,起点 0.5 是演示设定。显著共现依赖活跃度零模型,换一种零模型,斜线高度可以变。
模型部分的边界更明确。临界规模、双稳态和“足够比例的三人互动”描述的是方程或模拟的定性行为。图 5、图 6、图 7 是机制示意图。作者明确写道,超图上的策略实验仍然空缺,因此不能用这些模型证明人们已经按照图中的收益或传染率行动。
一句话总结
三人合作和三次两人合作可以画出同一个三角形;把群体本身记成超边之后,团队规模、嵌套和不可拆开的三人关系才分开,传染与合作模型的定性行为也会改变,但这些改变尚未被超图上的策略实验直接测到。
核心来源
- Nature Human Behaviour 论文页面,题目、作者、DOI 与 2025 年 12 月 17 日在线发表信息。正式出处为 2025 年 9 卷 12 期,2441–2457 页。
- 正文 Fig. 1–6 与 Box Fig. 1。专栏分析 2007–2022 年 arXiv 物理、计算机科学、统计、数学的论文合作,每条超边为一篇论文的作者集合。
- 作者贡献:Federico Battiston 与 Matjaž Perc 构思;Federico Battiston 与 Onkar Sadekar 设计专栏图和数据分析;Onkar Sadekar 绘制图并分析专栏数据;全体作者参与写作、修改和审阅。
作者介绍
- Federico Battiston:中欧大学网络与数据科学系,通讯作者。与 Matjaž Perc 共同构思本文,并与 Onkar Sadekar 设计专栏。
- Valerio Capraro:米兰比可卡大学心理学系。作者贡献说明其参与写作、修改和审阅。
- Fariba Karimi:格拉茨工业大学,同时隶属维也纳复杂性科学中心。作者贡献说明其参与写作、修改和审阅。
- Sune Lehmann:丹麦技术大学计算系,同时隶属哥本哈根大学哥本哈根社会数据科学中心。本文引用的哥本哈根网络研究数据论文中有他的共同作者署名。
- Andrea Bamberg Migliano:苏黎世大学进化人类学系人类进化生态组。作者贡献说明其参与写作、修改和审阅。
- Onkar Sadekar:中欧大学网络与数据科学系。绘制专栏图,并分析专栏使用的 arXiv 合作数据。
- Angel Sánchez:马德里卡洛斯三世大学数学系跨学科复杂系统组,同时隶属萨拉戈萨大学生物计算与复杂系统物理研究所。作者贡献说明其参与写作、修改和审阅。
- Matjaž Perc:马里博尔大学自然科学与数学学院,同时列有马里博尔 Adolf Drolc 社区医疗中心、首尔庆熙大学物理系和高丽大学大学学院。与 Federico Battiston 共同构思本文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
公司例会若只导出两人私聊,四个人的一次会议会变成六对关系。推荐系统若按共现次数找“常合作的人”,大型会议里的陌生人会被反复配对,真正每周一起写文档的三人组反而可能被稀释。图 3 的模体 III 和 VI 正好对应这两种记录:只有群体、没有成对边,和群体加上全部成对边,会把同一次出勤解释成不同的社会关系。
图 3f 里物理合作的 M 格子很高。若用它给招聘或分组算法打“偏好分”,会把学科里 M 更多这件事,算进个人选择。更合适的对照,是先固定 F 与 M 的人数和每位作者的论文数,再看 FF、FM、MM 是否仍然偏离。专栏(e)已经对群体共现使用了活跃度零模型,(f)没有展示同样的对照。
图 3h 从 0.5 出发后,两条曲线走向相反。若一个组织里的新规范已经有一半人采纳,模型会预期群体渠道让它继续扩散;若采纳者远少于这个演示起点,同一套群体渠道也可能让它消退。因此,把试点人数减半,并不只是把扩散速度减半。这个推断需要新的超图实验才能检查,而作者已经指出这类实验尚未进行。