已知下一次出发的时刻,语言模型能猜中这个人要去的地点编号吗?
论文名片|Xinglei Wang、Meng Fang、Zichao Zeng、Tao Cheng,Where Would I Go Next? Large Language Models as Human Mobility Predictors,arXiv:2308.15197v2,2024年1月9日。arXiv:2308.15197v2。Wang 与 Fang 为同等贡献。版本为这一预印本 v2。
星期二 19:50,表格里已经写着出发时刻和星期,时长和地点还空着。前面几行是这个人当天去过的地点编号、每次从几点开始、停了多久。要填的是最后一行的地点编号。
这是图 1 的示意图,用来说明问法。论文把这类停留写成文字,交给 GPT-3.5,看它能不能把记录中的下一个地点编号说出来。
在两套公开数据上,当目标停留的开始时刻和星期已经写进提示、并且只要求一个地点时,首条预测与记录一致的比例高于表中的马尔可夫链和几种深度模型。这个比例是地点编号的命中率。模型读到的是编号、时刻、星期和时长,写出的句子还可以给地点安上输入里没有的类型。
先说结论
- Geolife 的 3459 个测试样本中,告知目标时刻且只输出一个地点时,Acc@1 为 45.1%。同表 Acc@1 最高的非语言模型基线是 MHSA,为 31.4%。FSQ-NYC 的 12141 个测试样本上,相应数字是 27.4% 与 20.2%。
- 一次输出 10 个地点时,Geolife 的 Acc@10 在有目标时刻时为 87.4%,MHSA 为 60.8%。同一输出长度下,目标时刻把 Geolife 的 Acc@1 从 33.0% 提高到 36.6%;Acc@5 则是无目标时刻的 82.9%,有目标时刻为 82.5%。
- 无目标时刻、输出 10 个地点时,Geolife 的加权 F1 为 0.216,一阶移动马尔可夫链为 0.227。只输出一个地点且提供目标时刻时,加权 F1 为 0.404。加权 F1 按地点被访问的次数加权,分母口径与 Acc@1 不同。
- 在 Geolife 上只输出一个地点并提供目标时刻时,去掉较长时间的历史停留后,准确率和加权 F1 的柱都短于完整模型。图 5 没有印出各柱的精确读数。完整模型就是表 2 中的 45.1% 与 0.404。
- 表 4 的两则例子里,只输出一个地点时的编号,与十条列表的第一名不同。其中一条理由把地点称为餐厅,输入字段里没有地点类型。温度 0.5、改写提示和 GPT-4 的 Geolife Acc@1 落在 44.6% 到 45.3% 之间,分母仍是这套 Geolife 测试样本。
要填的是下一个地点编号,出发时刻可以先告诉模型
人类移动性(human mobility)在这里指一个人在城市或区域内从一个地点到另一个地点。论文预测的是个体的下一地点,分析单位是这个人的停留序列,不是区域之间的总人流。
原始轨迹上的每个点有坐标和时间。预处理之后,一次停留写成四项:开始时刻、星期、持续时长、地点编号。正文举的例子是星期二 17:30 在地点 1 停留 35 分钟,也就是留到 18:05。地点编号只区分“这是数据集里的哪一个地点”,本身不带餐厅、住宅或办公室这类类型。
给定这个人直到当前的一段停留,任务是预测下一个地点编号。序列用多长,决定模型能回看多少过去。实验里这段过去被拆开使用,而不是塞进一个不区分远近的窗口。
时间感知预测(time-aware prediction)事先给出目标停留的开始时刻和星期,持续时长和地点编号留空。时刻未知的预测则连下一次何时出发也不告诉模型。论文认为前一种更接近实际系统:交通预测通常要回答一小时或两小时后的状况,个人助理也会被问到某个具体钟点适合去哪里。后文的 45.1% 就是这种时刻已知、地点未知的命中率。时刻未知、并且一次输出 10 个地点时,Geolife 的 Acc@1 是另一格:33.0%。
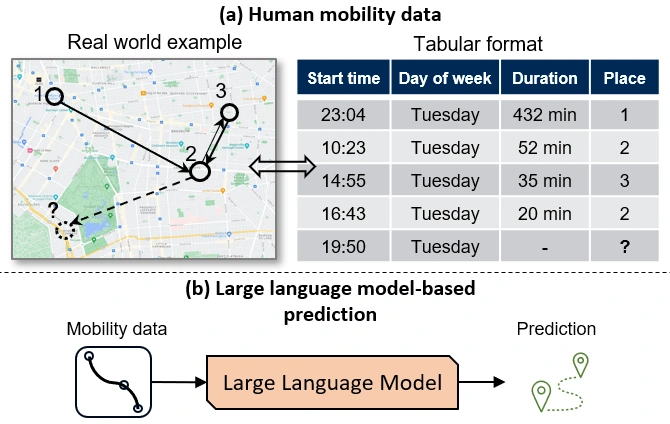
图 1|下一地点预测,交给语言模型的是什么样的记录?
(a)左侧是示意地图,编号 1、2、3 之间有连线,虚线指向问号。右侧表格把停留写成开始时刻、星期、时长和地点编号;最后一行是星期二 19:50,时长为空,地点为问号。表中的钟点和时长是这张示意图的例子。(b)停留记录进入大语言模型,输出被画成下一步的地点标记。这一面板没有实验数字。来源:原论文 Fig. 1。
较远的停留和刚刚的几站,为什么要分开写?
人的移动既有能重复出现的习惯,也有临近时段里更容易变化的选择。论文用历史停留(historical stays)表示离当前更远、跨度更长的那些停留,用近期停留(context stays)表示最近的少数几次。实验取历史停留 40 条、近期停留 5 条。这两个长度是经验设定,正文没有报告把它们搜过一遍之后的最优值。
这里的 context stays 是这个人刚刚去过的地点。后文会提到的上下文学习(in-context learning)是另一件事:模型参数不更新,只根据这次提示里的说明和数据作答。
目标时刻单独作为一项放进提示。模型因此同时看到三段材料:较长历史、最近几站、下一次的开始时刻和星期。
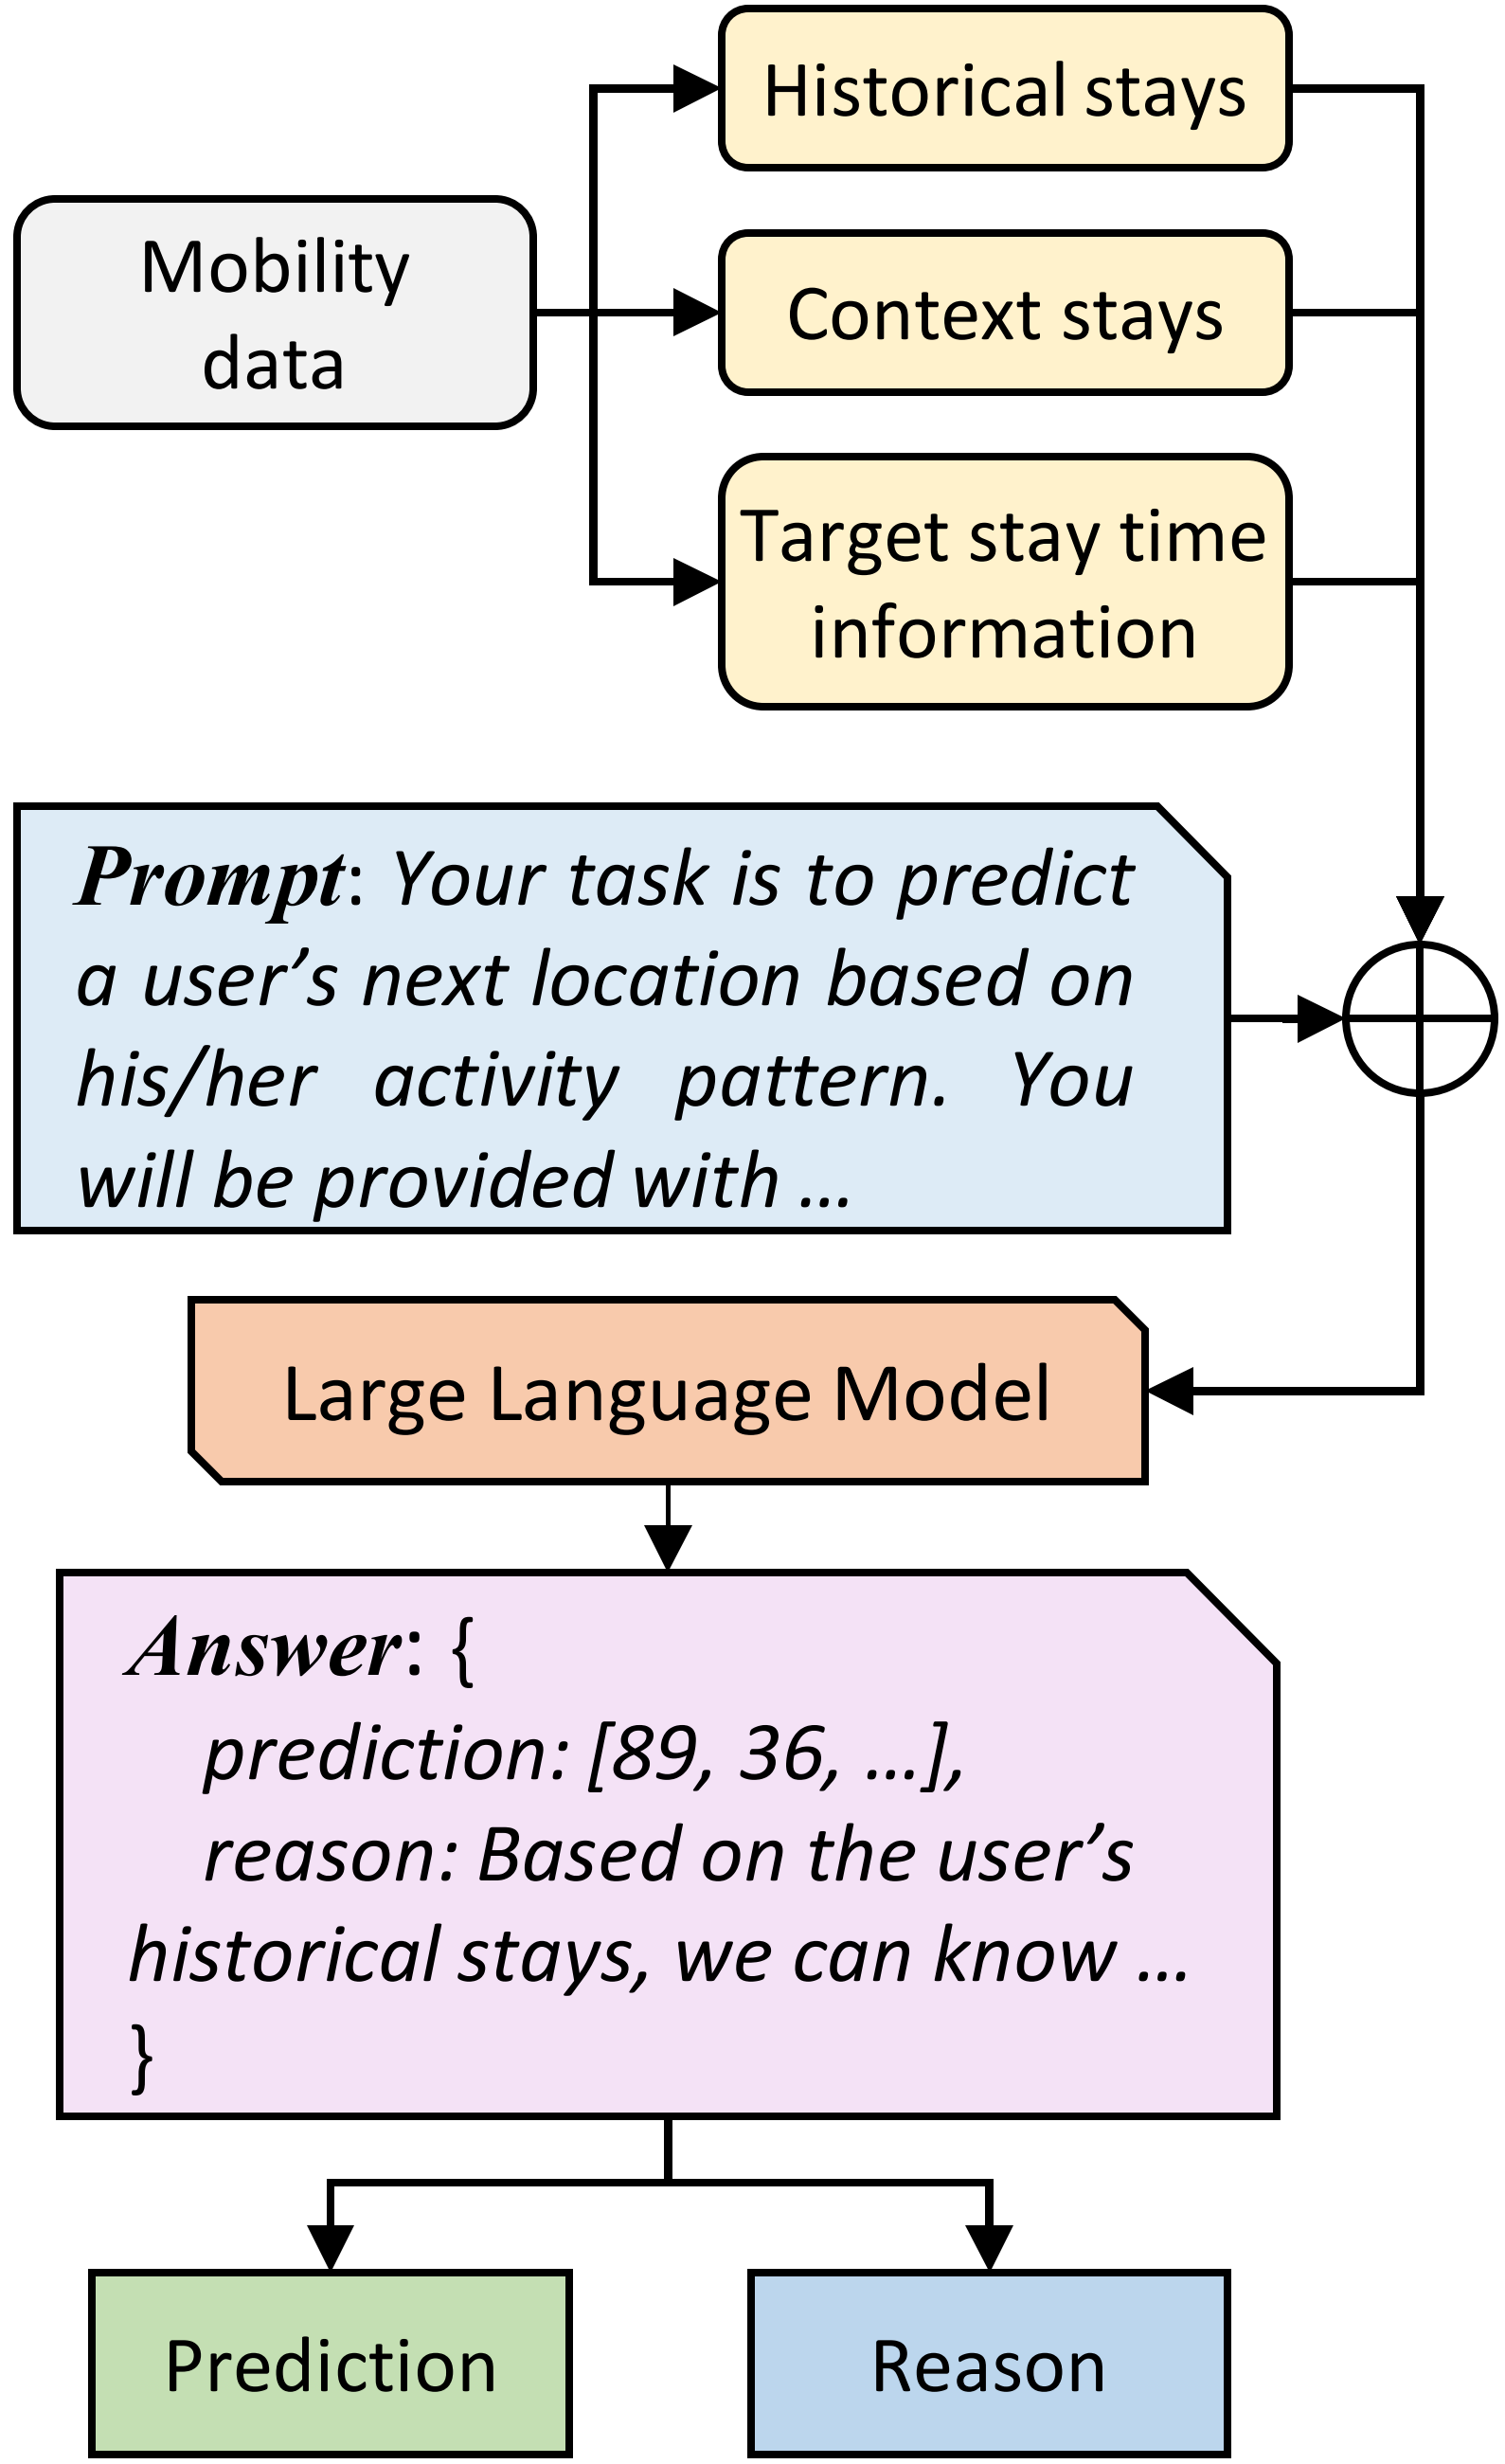
图 2|一次预测要同时交回地点和理由,材料怎样拼在一起?
无字母子图。停留数据分成历史停留、近期停留和目标停留的时间信息,与提示一起进入大语言模型。示意图的回答框里写着预测编号 89、36,并留有理由。这些编号是流程图上的示例,不是表 2 的测试结果。输出再拆成预测和理由两项。来源:原论文 Fig. 2。
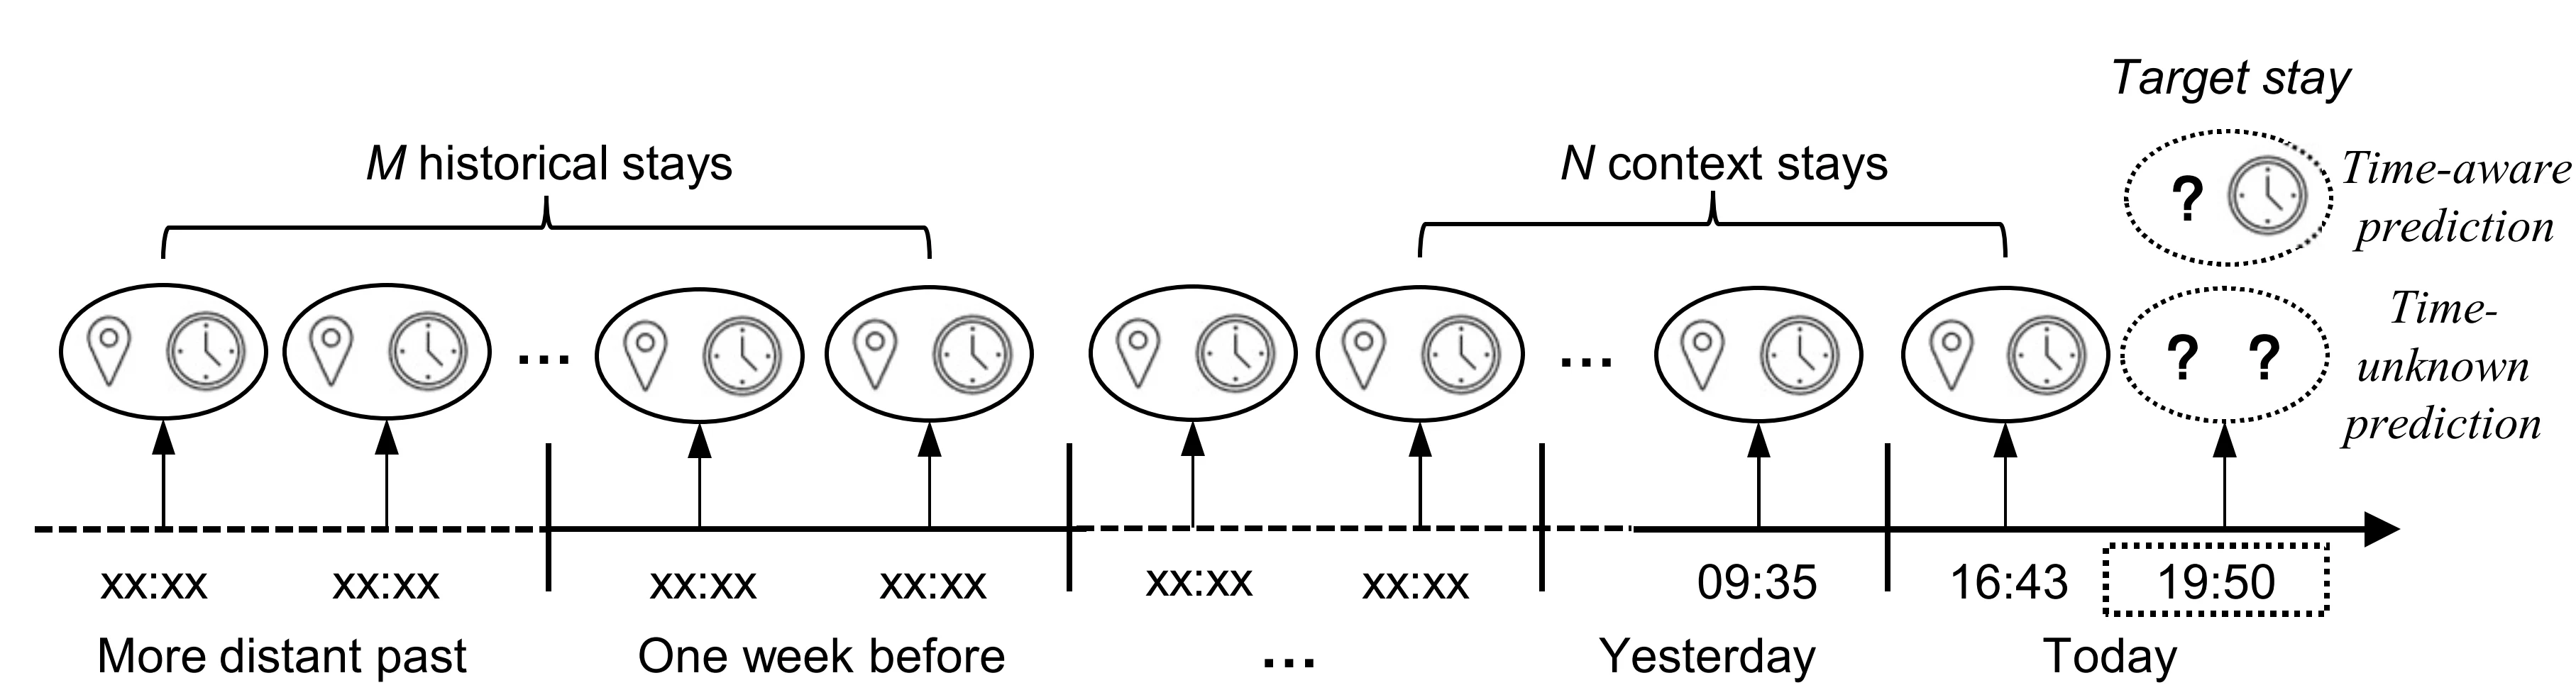
图 3|已知目标时刻,和连时刻也不知道,差在时间轴的哪一端?
无字母子图。时间从更远的过去指向今天。前段标为 M 条历史停留,后段标为 N 条近期停留;轴上的“一周前”“昨天 09:35”“今天 16:43”是示意图标注。右端目标停留画出两种问法:时间感知预测已知钟点、未知地点,轴端示例时刻为 19:50;时刻未知的预测把钟点和地点都画成问号。来源:原论文 Fig. 3。
提示各段分别约束什么?
模型是 GPT-3.5,具体版本为 gpt-3.5-turbo-0613。温度设为 0,用来减少同一输入下的随机改写。它没有在这两套移动数据上做梯度训练,而是靠提示里的说明直接作答。
提示在思维链(chain-of-thought)和先计划再求解(plan-and-solve)的思路上改过。图 4 的灰色标签是作者加上的功能说明,按论文所述,这些标签本身不放进真正送给模型的提示。各段依次做六件事:说明任务是预测这个人的下一个地点;解释历史停留、近期停留和目标停留各字段的含义;规定按可能性从高到低输出 k 个地点;要求作答时同时考虑长期重复、最近停留和目标时刻;要求用固定格式交回地点列表和一句支持该预测的理由;最后填入这三段数据。
k 会改变问题。k=10 时模型要排十个编号,k=1 时只要一个。后文的消融和稳健性都在 k=1、且提供目标时刻的设置下进行。正文还指出,要求模型写出理由,是为了让读者看到依据,并希望由此加强推理。理由是否真的对应输入,要看后面的例子,不能从“要求它解释”直接推出解释属实。
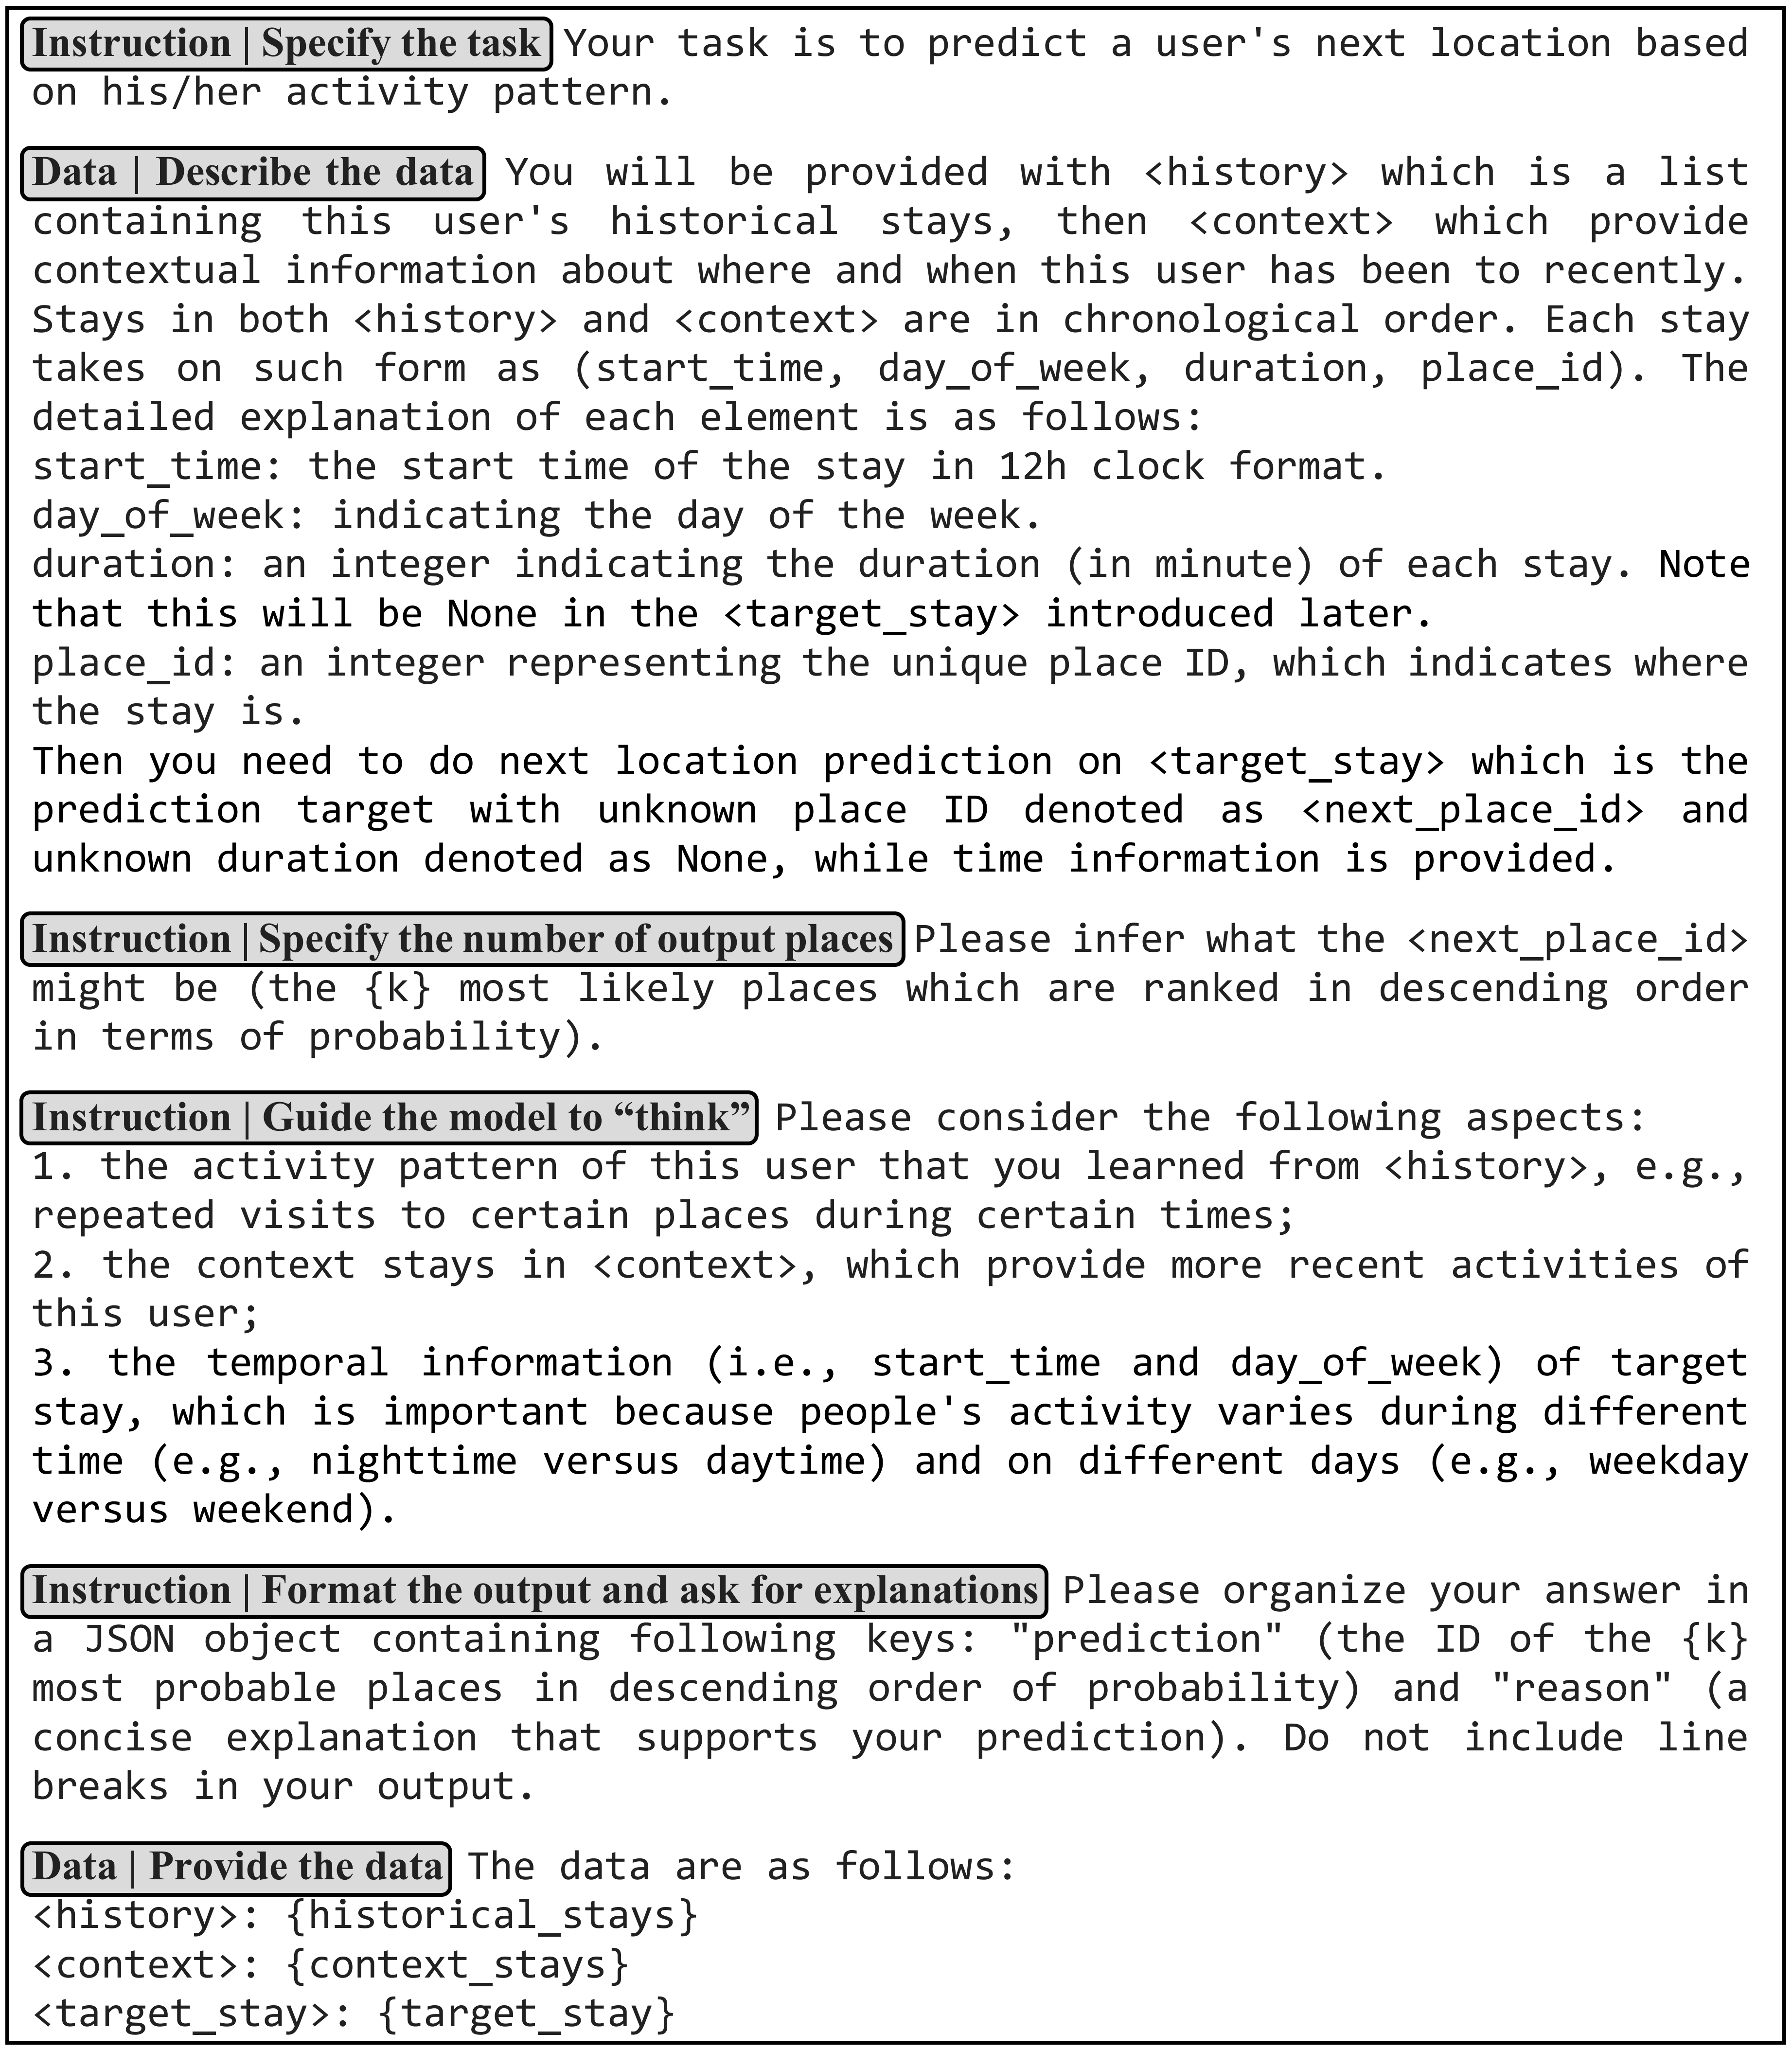
图 4|灰色标签把提示分成哪些功能?
无字母子图。灰色标签依次为:说明任务、描述数据、规定输出地点个数、引导模型考虑长期模式与近期停留和目标时刻、规定输出格式并要求理由、提供三段数据。地点在模板中是整数编号;目标停留的地点和时长留空,开始时刻和星期由数据填入。标签是图解,按论文说明不进入实际提示。来源:原论文 Fig. 4。
命中率的分母,是测试样本
实验用两类公开数据。Geolife 是 GNSS 轨迹,处理后变成停留。FSQ-NYC 是纽约市的签到。签到是人在平台上主动留下的地点,GNSS 停留也只保留处理之后的停留点,两者都不是一个人全天每一次移动的完整清单。
预处理按 Hong 等人 2023 年的步骤执行:去掉记录过少的用户,把原始轨迹变成停留,再划分训练和测试。这一预印本没有印出最少记录数、停留如何判定,以及训练与测试的切分比例。表 1 因此是筛选之后的规模。45 和 535 是用户数;准确率的分母是测试样本数。
| 数据 | 用户数 | 追踪天数 | 每人停留数 | 每人不同地点数 | 测试样本数 |
|---|---|---|---|---|---|
| Geolife | 45 | 345 ± 413 | 369 ± 456 | 77 ± 108 | 3459 |
| FSQ-NYC | 535 | 84 ± 36 | 178 ± 206 | 34 ± 21 | 12141 |
天数、停留数和地点数是用户之间的均值 ± 标准差。Geolife 上这三项的标准差都大于各自的均值:天数 413 对 345,停留数 456 对 369,地点数 108 对 77。345 天、369 次停留是这 45 人的平均,人与人之间相差很大。
对照模型是:一阶移动马尔可夫链(1-MMC),只根据当前地点考虑下一次;LSTM;带自注意力的 LSTM-Attn;DeepMove,用一条循环网络学习历史访问的周期,另一条学习当前轨迹的转移;MobTcast,用 Transformer 编码历史地点,并使用时间、语义、社交和地理上下文;MHSA,用多头自注意力,输入包括历史访问、访问时间、活动时长和周边土地利用。
这些模型使用的上下文各不相同。LLM-Mob 在正文里组织的是停留的时刻、星期、时长、地点编号和目标时刻。表 2 比较的是各自方法在同一测试任务上的排序质量,模型结构和输入信息的差别混在同一次比较里。
指标有三项。Acc@k 把预测按可能性从高到低排列,计算真实下一地点出现在前 k 个之中的比例,分母是该数据集的测试样本。加权 F1 按地点被访问的次数加权,因为有的地点反复出现、有的很少出现;它强调访问更多的地点。Acc@1 则是测试样本里的命中比例。nDCG@10 是前十名的归一化折损累计增益,对全部测试样本取平均。排在第 j 位的相关度只有 0 或 1:这一位正好是真实下一地点时为 1。真实地点排第一时,该样本的 nDCG 为 1;它不在前十名里时,该样本贡献 0。
第一条就说对的比例,高在哪一格?
表 2 的每一行里,最高值都落在 LLM-Mob 的某一列。列与列之间差很多。下表把每一格的最强非语言模型基线,和 LLM-Mob 的三种设置放在一起。Acc 的单位是占测试样本的百分比;加权 F1 和 nDCG 不是百分比。只输出一个地点时,论文没有计算 Acc@5、Acc@10 和 nDCG@10。
| 数据与指标 | 六种基线中的最高值 | 无目标时刻,输出 10 个 | 有目标时刻,输出 10 个 | 有目标时刻,只输出 1 个 |
|---|---|---|---|---|
| Geolife Acc@1 | MHSA 31.4% | 33.0% | 36.6% | 45.1% |
| Geolife Acc@5 | MHSA 56.4% | 82.9% | 82.5% | 未报告 |
| Geolife Acc@10 | MHSA 60.8% | 87.3% | 87.4% | 未报告 |
| Geolife 加权 F1 | 1-MMC 0.227 | 0.216 | 0.259 | 0.404 |
| Geolife nDCG@10 | MHSA 0.465 | 0.628 | 0.645 | 未报告 |
| FSQ-NYC Acc@1 | MobTcast 与 MHSA 均为 20.2% | 23.2% | 24.6% | 27.4% |
| FSQ-NYC Acc@5 | MHSA 47.0% | 57.4% | 57.9% | 未报告 |
| FSQ-NYC Acc@10 | MHSA 57.3% | 69.2% | 69.5% | 未报告 |
| FSQ-NYC 加权 F1 | MobTcast 0.166 | 0.147 | 0.172 | 0.221 |
| FSQ-NYC nDCG@10 | MHSA 0.376 | 0.451 | 0.459 | 未报告 |
Geolife 上,45.1% 与 31.4% 相差 13.7 个百分点,分母都是 3459 个测试样本。FSQ-NYC 上,27.4% 与 20.2% 相差 7.2 个百分点,分母是 12141。前十名的差距更大:Geolife 的 87.4% 比 MHSA 的 60.8% 高 26.6 个百分点,FSQ-NYC 的 69.5% 比 57.3% 高 12.2 个百分点。
目标时刻的作用随指标变化。下面按“无目标时刻 → 有目标时刻”排列,两边都输出 10 个地点。Geolife 的 Acc@1 从 33.0% 到 36.6%,加权 F1 从 0.216 到 0.259,nDCG@10 从 0.628 到 0.645,Acc@10 从 87.3% 到 87.4%;Acc@5 从 82.9% 到 82.5%。FSQ-NYC 上,有目标时刻的五个指标都更高:Acc@1 为 24.6% 对 23.2%,Acc@5 为 57.9% 对 57.4%,Acc@10 为 69.5% 对 69.2%,加权 F1 为 0.172 对 0.147,nDCG@10 为 0.459 对 0.451。
只要求一个地点,还会再改变 Acc@1。Geolife 从输出十个时的 36.6% 到 45.1%,FSQ-NYC 从 24.6% 到 27.4%。这是两次不同的提示。表 4 的例子表明,只回答一个编号时,结果可以与十条列表的第一名不同。45.1% 统计的是 Geolife 上已经告知目标时刻、并且只要求一个地点的测试样本。
加权 F1 把访问次数考虑进去之后,排序会换人。Geolife 上,一阶马尔可夫链的加权 F1 为 0.227,高于 MHSA 的 0.218、LSTM-Attn 的 0.213,也高于无目标时刻的 LLM-Mob(0.216)。它的 Acc@1 只有 24.1%,低于这些深度模型。FSQ-NYC 上,无目标时刻的加权 F1 为 0.147,MobTcast 为 0.166,DeepMove 为 0.155,MHSA 为 0.149。提供目标时刻并只输出一个地点之后,两套数据的加权 F1 才到 0.404 和 0.221,高于表中全部基线。
nDCG@10 与 Acc@10 方向一致,数值更低,因为排得靠后的正确地点会被折扣。Geolife 有目标时刻、输出十个时,平均 nDCG@10 为 0.645,MHSA 为 0.465。0.645 是 3459 个样本的平均,单个样本的上限是 1。
拿掉哪一段,柱子短得最明显?
消融在 Geolife 上、k=1、提供目标时刻。五个变体分别去掉历史停留、近期停留、目标时刻,或删掉提示中“引导考虑这三项”的段落,或不再要求写出理由。相应的提示内容也一起删去。
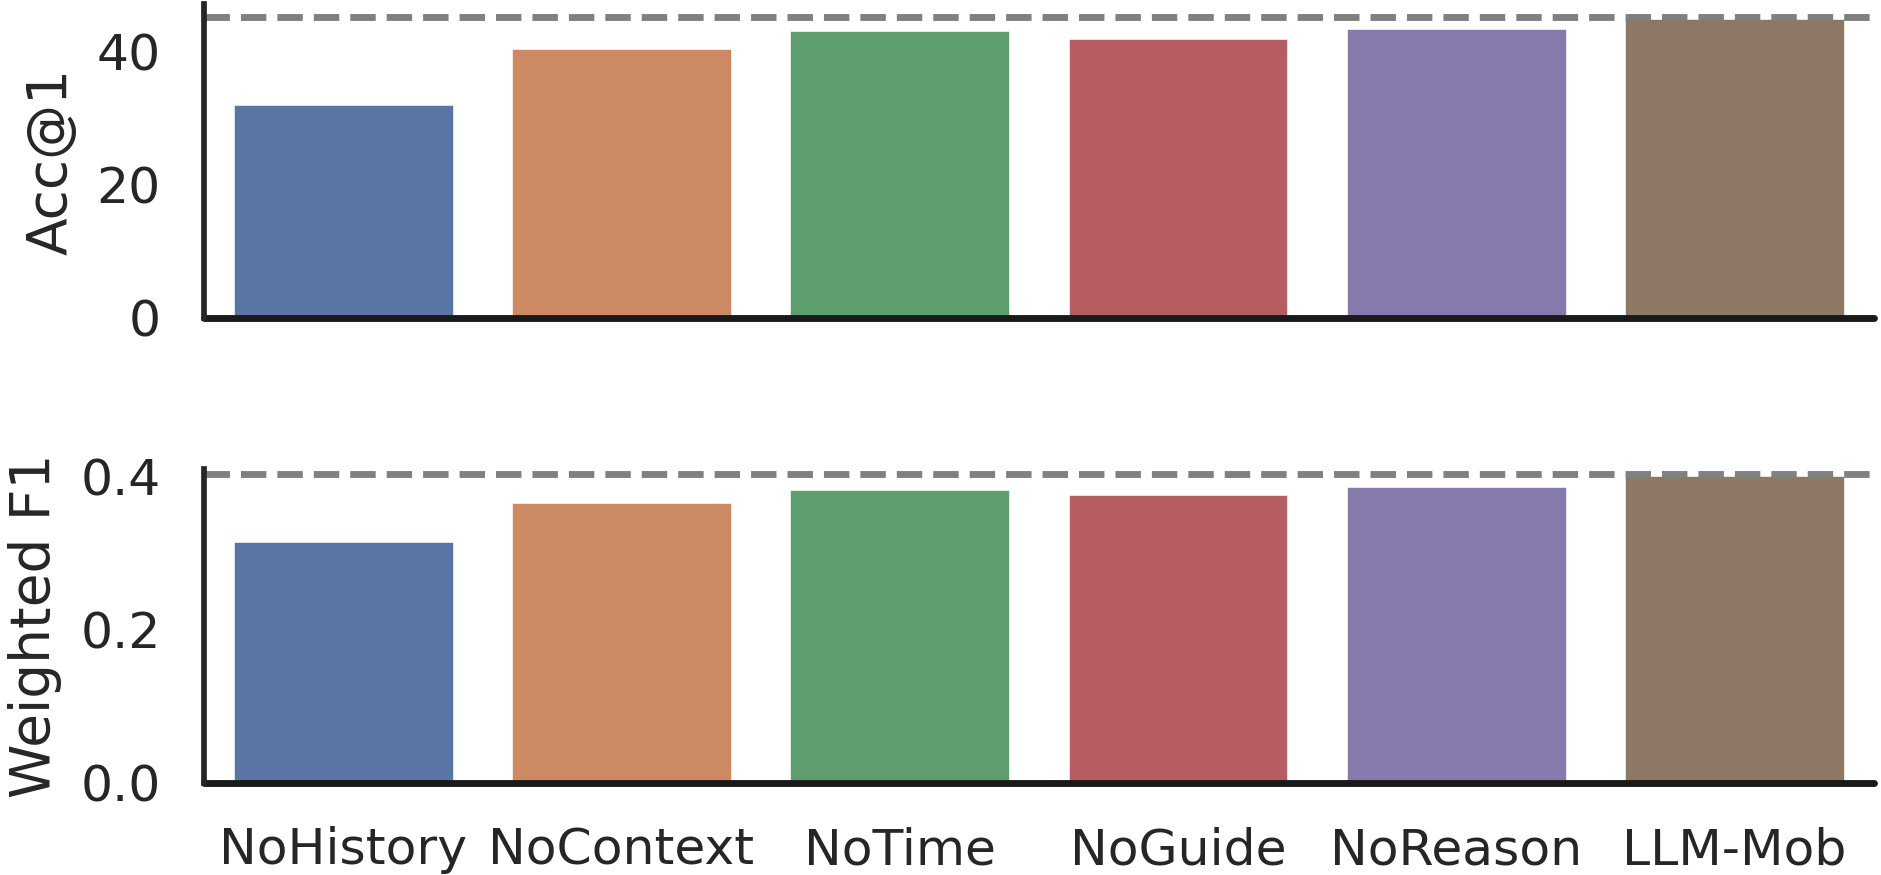
图 5|完整模型和五个删减版本,哪一个最低?
无字母子图,上下两栏。上栏纵轴为 Acc@1,印出的刻度是 0、20 和 40;下栏为加权 F1,印出的刻度是 0、0.2 和 0.4。从左到右是去掉历史停留、去掉近期停留、去掉目标时刻、去掉引导段落、不再要求理由,以及完整的 LLM-Mob。两栏都是去掉历史停留的柱最短,完整模型最高。柱顶没有数字,图上也没有误差线。完整模型在表 2 的同一设置里是 Acc@1 45.1%、加权 F1 0.404,所以上栏那根柱对应的读数高于刻度 40。来源:原论文 Fig. 5。
正文的判断是:完整模型高于每一个变体,去掉历史停留的下降大于其他删减。在这一设置下,较长的历史停留被拿掉后,两根柱都更短。正文没有给出每个变体的百分点,也没有检验各柱之间的差别是否稳定。完整模型与表 2 中 k=1、提供目标时刻的那一列是同一设置。
写出来的理由,核对过什么?
表 4 从 Geolife 取了两则测试样本,用来看理由是否可读。两则都带有目标时刻。只要求一个地点时,模型给出的编号与该则记录一致。要求十个地点时,第一则的正确编号出现在列表里,但排在第一的是另一个编号;MHSA 给出十条编号,没有文字理由,其列表中没有这个正确编号。第二则只要求一个地点时再次与记录一致,而十条列表的第一名是另一个编号,并且同一个编号在十条里出现了两次。论文把重复归因于该用户不同地点较少,把十条列表的第一名解释为模型偏向常去的地点。MHSA 在这则里给出了更多变化的候选。
其中一条理由把地点称为餐厅。输入只有开始时刻、星期、时长和地点编号。论文把这句话标成幻觉:餐厅这个类型是模型写出来的,停留记录里没有地点类型。
作者还用同一类停留做了三步定性检查:把结构化记录改写成句子,概括星期和出发时段上的活动节奏,并进一步推测家和工作地。示例回答把某个工作日反复出现的地点说成可能的工作地,并表示现有停留难以确定家。表 5 没有家或工作地的核对标签,也没有这三步的正确率。它展示的是模型会作出这类推断。本文没有用标注过的家和工作地给这次推测打分。
稳健性仍在 Geolife、k=1、提供目标时刻下测试。主实验温度 0 的 Acc@1 为 45.1%,加权 F1 为 0.404。温度 0.5 时,五次运行的 Acc@1 为 44.6,标准差 0.98 个百分点,加权 F1 为 0.398,标准差 0.020。提示改写后,五次运行的 Acc@1 为 44.9,标准差 0.56,加权 F1 为 0.406,标准差 0.012。换到 GPT-4、温度 0 时,Acc@1 为 45.3,加权 F1 为 0.405,表中没有标准差。四组 Acc@1 位于 44.6% 到 45.3%。作者认为这种变化不大,并预期温度更高或提示改动更大时不确定性会上升。表 3 没有印出改写后的提示,也没有做假设检验。这组结果只覆盖 Geolife 的一种设置。
这些比较停在哪一层?
每个测试样本单独调用一次接口。Geolife 有 3459 个测试样本,FSQ-NYC 有 12141 个。论文指出这种调用难以直接放到大规模预测上,费用随数据量上升,而且专有模型更新后,旧提示的表现可能改变。作者据此认为需要面向移动数据微调、研究者能够自己掌握的开源模型。这是对下一步的判断。本文没有报告这样一个微调模型已经取得更高命中率。
45.1% 和 27.4% 都是在目标时刻已知时、只输出一个地点编号的命中率。它们不回答“这个人什么时候会出门”,也不回答两个区域之间有多少人流。Geolife 筛选后只有 45 人,人与人之间的追踪长度差很大;FSQ-NYC 是签到。两套结果都限于各自的地点编号体系,换一套编号或换一座城市,表 2 没有给出可直接搬用的准确率。
伦理声明写明:所用数据是匿名的公开数据,不含可直接识别个人的信息;实际应用是否带来隐私问题,取决于具体的语言模型提供者;作者预期风险较低,因为这些专有模型有隐私政策;若用于出行需求预测,个人数据会在移动模式汇总到指定区域之后舍弃。声明里的风险判断是作者的预期。实验本身仍把含有个人停留历史的测试样本送入外部接口,报告的也是个人下一地点编号的命中率。汇总到区域之后的需求预测,是声明中的另一种用途,本文没有给出那一项的准确率。
一句话总结
在下一次的出发时刻和星期已经写明时,GPT-3.5 比表中的深度模型更常把记录里的下一个地点编号放在第一位;这个优势是匿名编号上的排序命中,文字理由还可以写出输入里不存在的地点类型。
核心来源
- arXiv:2308.15197v2,2024年1月9日的预印本。正文图 1–5、表 1–5 都出自这一版。
- LLM-Mob 代码入口,地址印在论文摘要中。上文数字来自这一版的表和图。
作者介绍
- Xinglei Wang:署名伦敦大学学院 SpaceTimeLab for Big Data Analytics,与 Meng Fang 为同等贡献。其公开页面写明,他在该实验室攻读博士,研究人类移动预测与城市时空分析,并由 Tao Cheng 共同指导。
- Meng Fang:署名利物浦大学,与 Xinglei Wang 为同等贡献。利物浦大学人员页列出他在计算机科学与信息学院从事人工智能研究,方向包括强化学习、基础模型和从交互中学习的智能体。
- Zichao Zeng:同时署名 SpaceTimeLab 与伦敦大学学院 3DIMPact。其学院页面和个人主页写明,他在该校攻读博士,研究面向步行导航的视觉定位,并隶属这两个组。
- Tao Cheng:署名 SpaceTimeLab。伦敦大学学院官方页面列她为地理信息学教授、SpaceTimeLab 创始人,研究时空数据分析、地理人工智能与城市移动。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果应用还不知道下一次出发的钟点,与这个问法最接近的已发表数字,是 Geolife 上不提供目标时刻、并且一次输出 10 个地点时的 Acc@1:3459 个测试样本中的 33.0%。45.1% 对应的是时刻已知、而且只输出一个地点。正文里只输出一个地点的实验都带有目标时刻,论文没有报告“不给时刻、只输出一个地点”的 Acc@1。引用时需要写明系统是否已经知道出发时刻,以及要求模型交出几个地点。
另一层是分析单位。45.1% 统计的是个人地点编号有没有排到第一。作者在伦理声明里设想的出行需求预测,是汇总到区域之后再丢弃个人记录。那一项要回答的是区域之间有多少移动。把个人编号的命中率说成路网或小区间流量的准确率,换了被预测的对象。若系统还把模型的句子展示给使用者,表 4 里的“餐厅”说明,句子里的地点类型需要单独核对:输入字段只有编号、时刻、星期和时长时,类型词是模型生成的。